# Archive for AI Study — Full Public Archive This file contains the public CV and the full authored Markdown body of every published article. Canonical URLs are included before each document. For discovery only, prefer llms.txt. ## CV ## Career - **Wrtn technologies** - *Internal Agent Builder*, Intern, 2026.03 - 2026.08 ## Education - **Naver BoostCamp AI Tech 8기** - *네이버 커넥트재단*, 2025.09 - 2026.02 - **LG aimers 8기** - *LG AI Research*, 2026.02 - **학사, 컴퓨터교육학과(Education of Computer Science)** - *광주교육대학교(Gwangju National University of Education)*, 2023.03 - 재학 ## Project ### 뤼튼에서 광고 소재 제작을 AX로 바꾸기 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-01-marketing-ax/ - Collection: Project - Published: 2026-10-12 - Tags: Project 뤼튼에서 그로스마케팅팀의 광고 소재 제작과 운영을 AX로 바꾸는 일을 맡았다. 스토리 데이터를 가져와서 광고에 쓸 소구점을 뽑고, 이미지 배너나 영상, 플레이어블로 만들어 e2e로 라이브까지할 수 있게 하는 작업이었다. Series C 투자를 대비해서(지금은 유니콘이 됐다!), 늘어난 광고 예산을 받아낼 수 있을 만큼 소재를 만들고, 실제로 내보낼 수 있는 흐름을 만드는 게 먼저였다. 생성 모델이 그림 한 장을 잘 만드는 것과, 매일 여러 스토리의 광고를 만들어 운영하는 것 사이에는 해야 할 일이 꽤 많았다. ## 왜 소재를 많이 만들어야 했나 기존에는 마케터가 광고 효율이 좋을 만한 스토리를 고르고, 어떤 형식으로 만들지 기획한 다음 디자이너와 소통해서 배너를 만들었다. 이 흐름에서 일주일에 제작하는 배너는 최대 7~10개 정도였다. 기획과 제작 자체도 시간이 들지만, 마케터와 디자이너 사이의 소통, 마케터들 사이의 조율도 제작량을 제한했다. 시리즈 C 투자 이후 광고 예산이 늘어나면서 그 예산을 집행할 소재가 필요했다. 내가 투입된 이유도 이 제작 병목을 줄이기 위해서였다. 그렇다고 사람이 기획하던 광고를 모두 자동 생성 광고로 바꾸지는 않았다. 사람은 가설과 기획을 거친 소재를 만들고, AX 쪽은 더 많은 스토리를 빠르게 광고로 만들어보는 두 흐름을 함께 운영했다. 초반에는 자동화 쪽에서도 광고 효율이 좋을 스토리를 골라야 한다고 생각했다. 그런데 CPO와 그로스 본부장님과 여러 미팅을 하면서, 좋아요 랭킹 순으로 후보를 넓게 가져오는 방향으로 정리됐다. 특정 스토리의 성과를 미리 맞히려고 하기보다, 상위권부터 많은 스토리를 내보내고 잘된 광고를 따로 모으자는 결정이었다. 하루 1,000개의 광고 배너를 내보내고 그중 성과가 좋은 소재를 위닝 캠페인으로 모으는 것이 당시 구상이었다. 넓게 탐색하는 광고 집행은 위닝 소재를 찾기 위한 비용으로 보고, 따로 모은 위닝 캠페인은 사람이 기획한 광고만큼 또는 그 이상의 효율을 내는 것을 목표로 했다. 목표 제작량과 실제 달성량, 위닝 캠페인의 성과는 구분해서 봐야 한다. 여기서는 그 목표를 받아서 어떤 시스템을 만들었는지부터 정리하려고 한다. ## 스토리 하나가 광고가 되기까지 입력은 서비스의 스토리 데이터였다. 제목과 소개만 있는 게 아니라 세계관, 시작 상황, 이미지, 장르 태그, 유저 댓글 등이 함께 있었다. 이 정보를 광고 제작에 쓸 수 있는 형태로 바꾸고, 생성 결과가 실제 매체 규격에 맞도록 후처리해야 했다. ![스토리 전처리부터 소재 제작까지의 전체 흐름](/assets/images/notion/ad8579faf15248023335/01-marketing-ax.png)

스토리 전처리부터 소재 제작까지의 전체 흐름
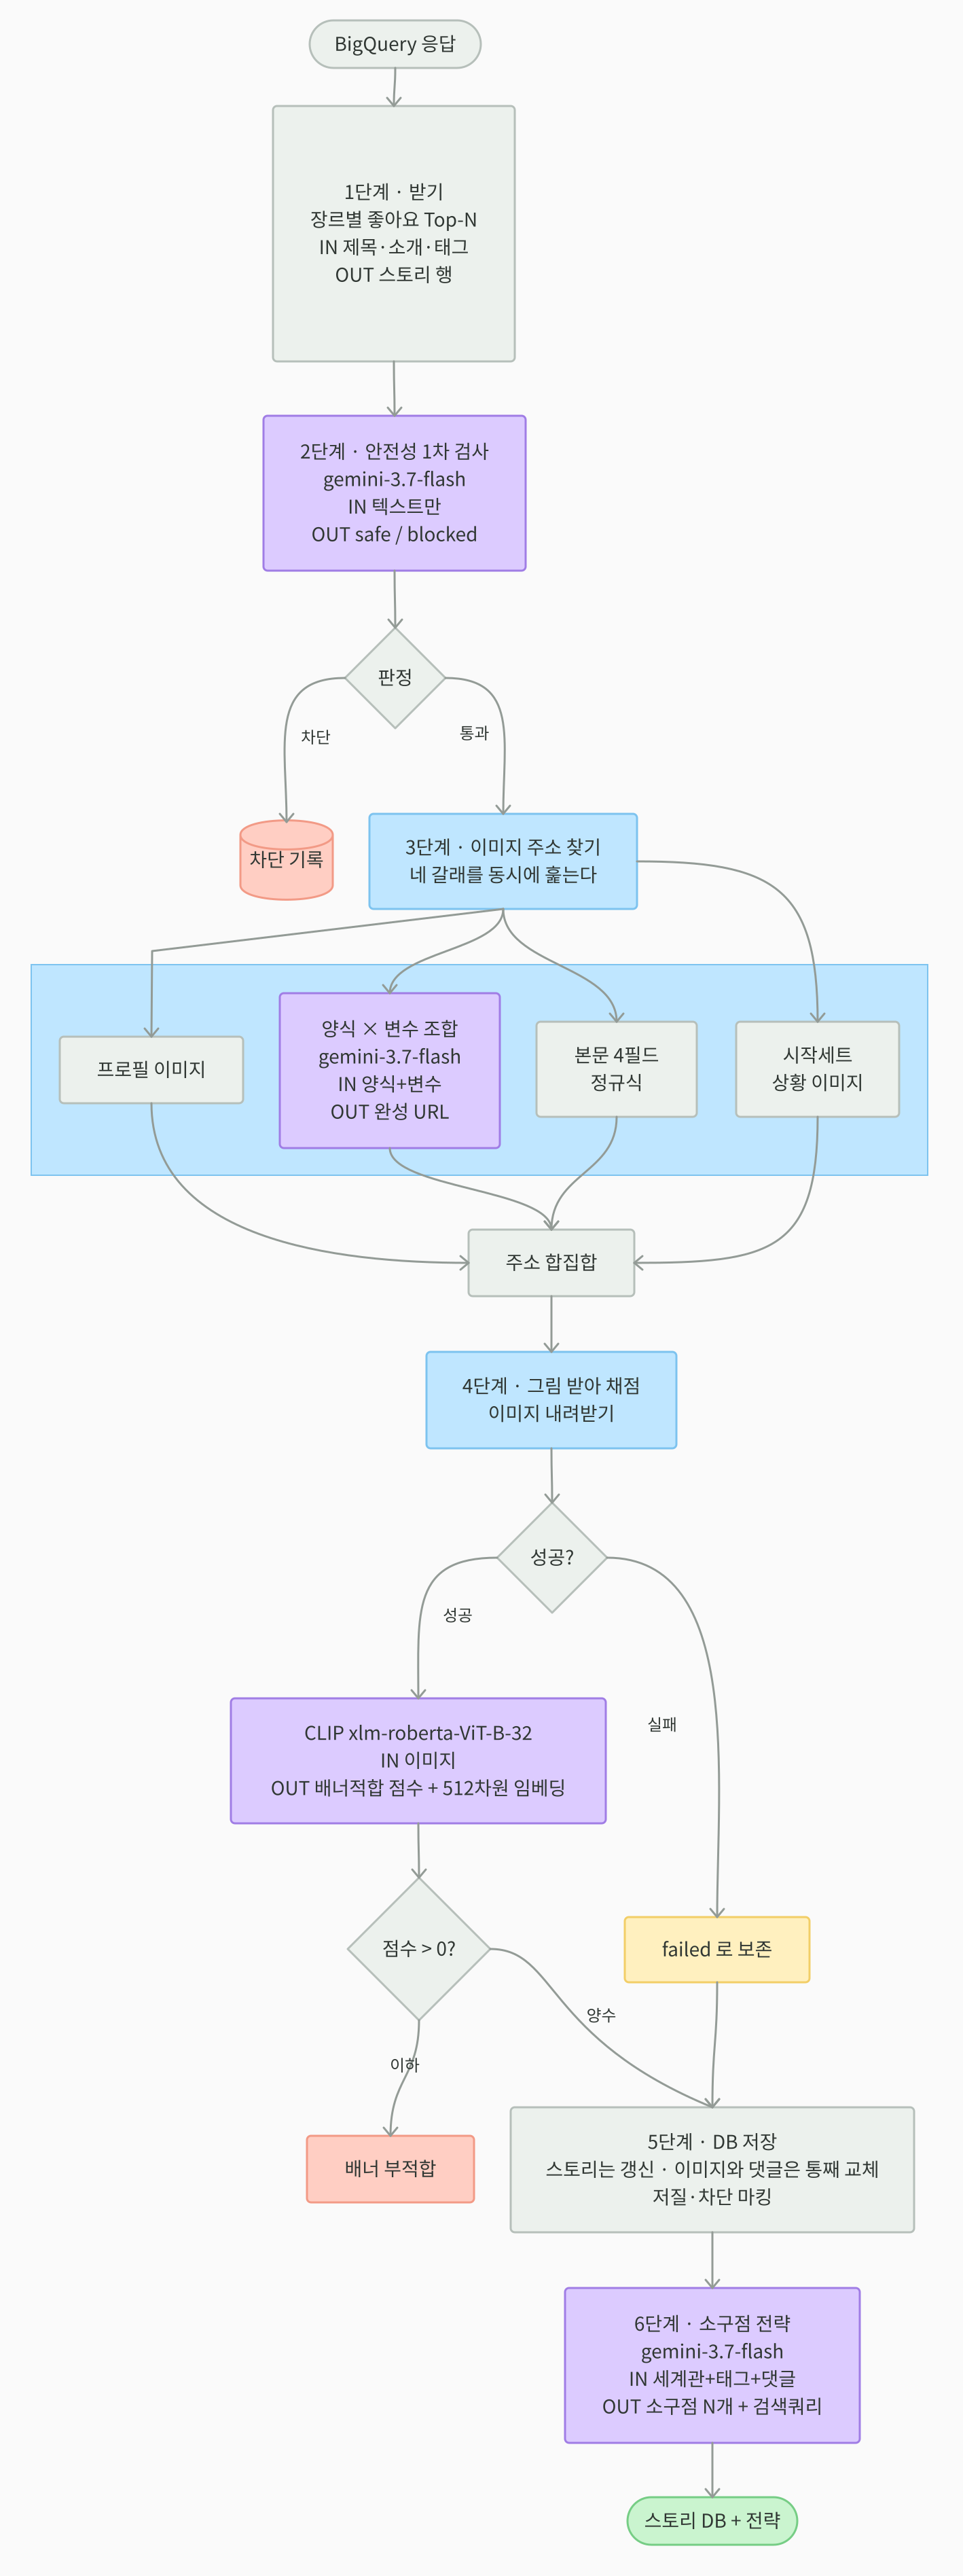
![스토리 전처리의 데이터 흐름](/assets/images/notion/ad8579faf15248023335/02-marketing-ax.png)

스토리 전처리의 데이터 흐름

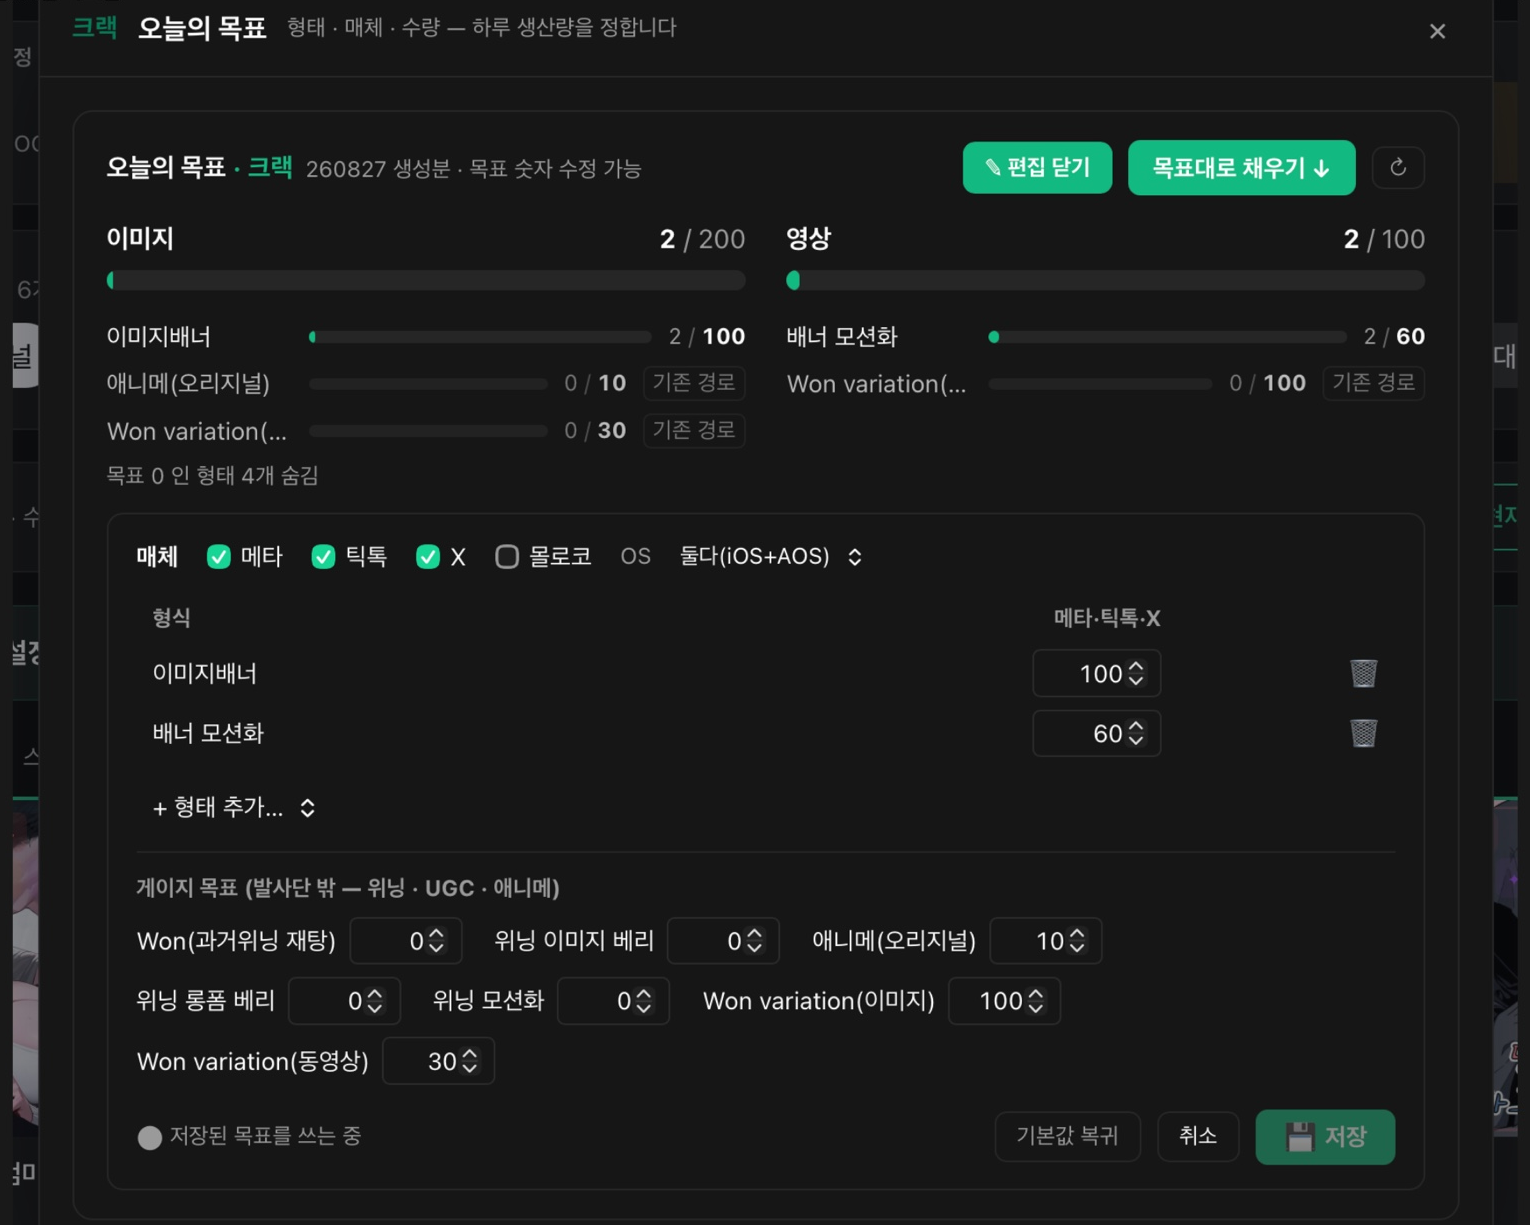
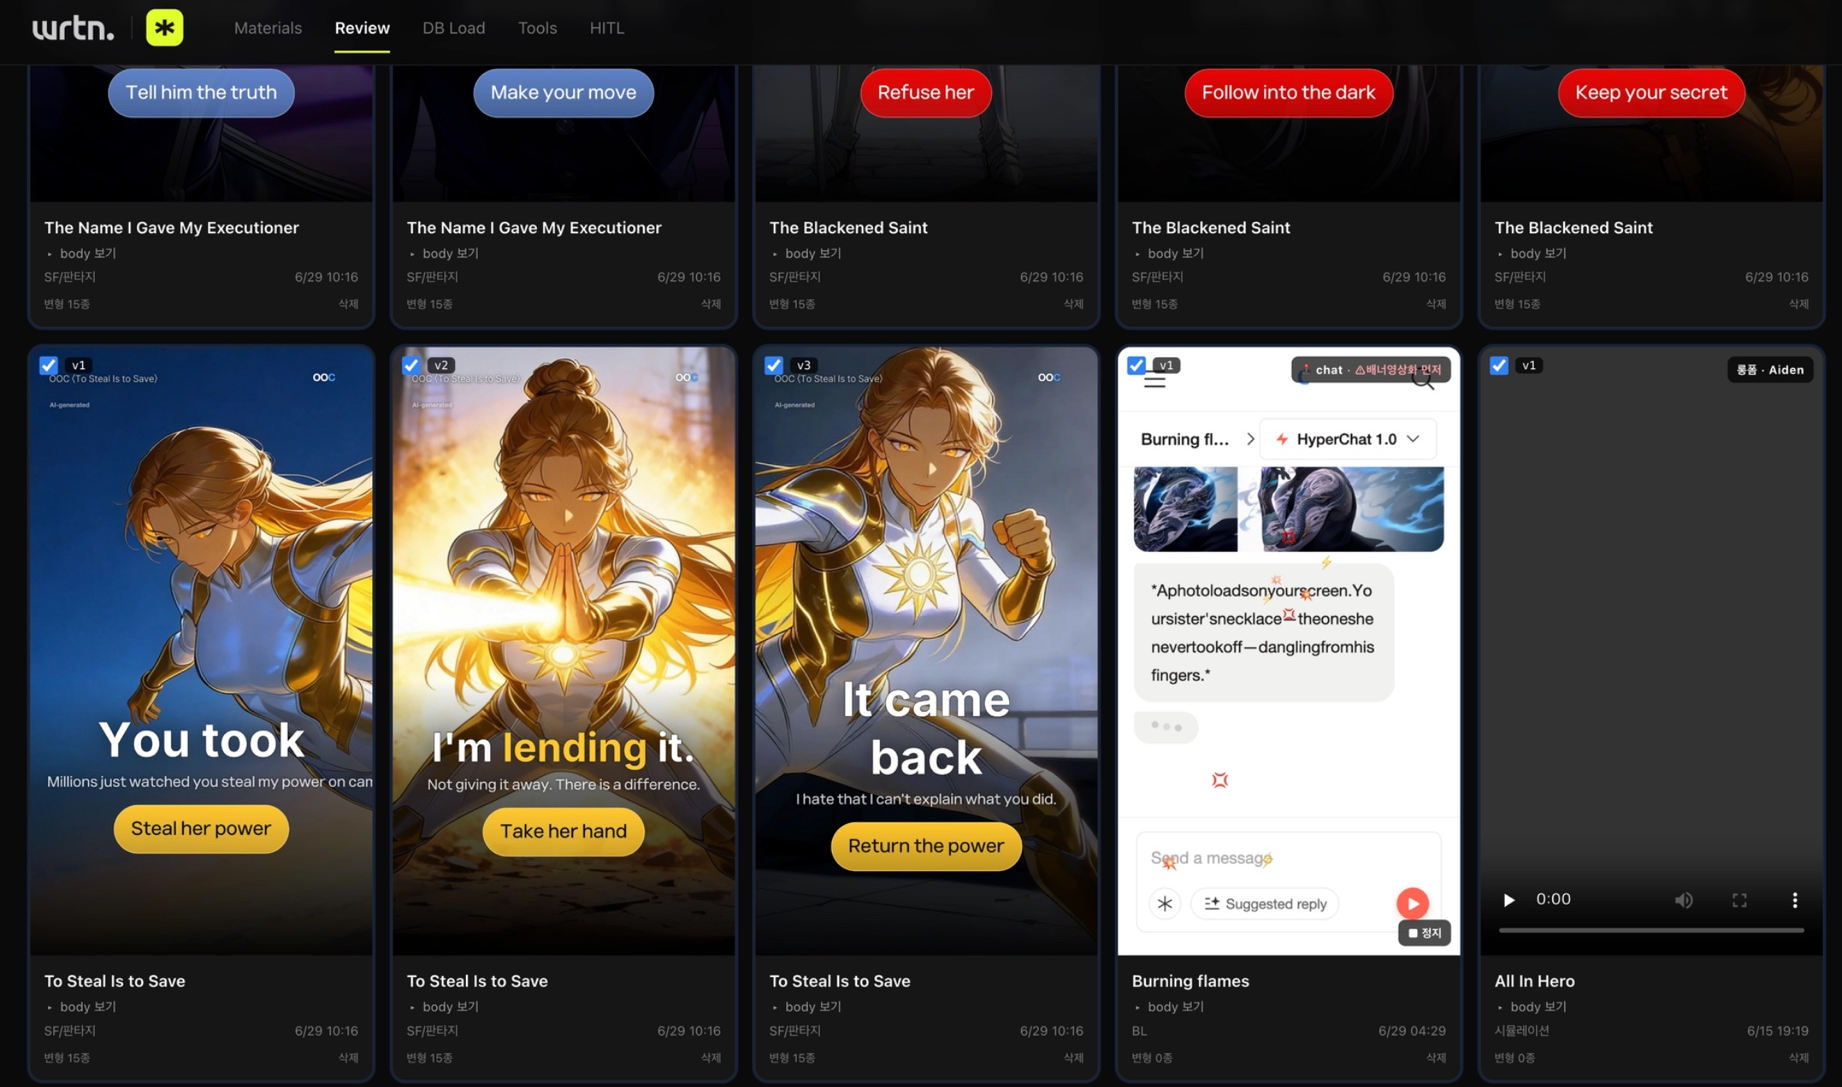
큰 흐름은 다음과 같다. 1. 운영 DB를 미러링한 BigQuery에서 광고 후보 스토리를 가져온다. 2. 삭제·비공개·차단된 스토리와 광고 대상에서 제외할 콘텐츠를 걸러낸다. 3. 스토리와 이미지 데이터를 정리하고 소구점 전략을 저장한다. 4. 같은 전략을 입력으로 이미지, 모션, 롱폼, 플레이어블 등의 소재를 만든다. 5. 규격별 결과물을 저장하고 검수·업로드 흐름으로 넘긴다. 여기서 공통 입력을 잘 만드는 게 중요했다. 형식마다 세계관과 소구점을 다시 해석하게 하면 같은 스토리인데도 광고가 서로 다른 이야기를 할 수 있다. 그래서 훅, 타깃 감정, 소구점, CTA 방향 등을 `strategy_json`으로 저장해 후속 제작에서 재사용했다. 기존에 다른 팀에서 만들어 둔 스토리 요약과 추천용 태그도 활용했다. 처음부터 모든 정보를 새로 만들 필요는 없었다. 이미 있는 데이터가 광고 제작에서는 어떤 역할을 할 수 있는지 찾고, 없는 정보는 어떻게 처리할지를 정하는 일이 전처리의 상당 부분이었다. ## 생성 버튼 뒤에 있어야 하는 것들 실제 운영 화면은 세 서비스의 소재를 통합해서 생성할 수 있게 구성했다. 목표 편집에서 형식별 비율과 소재 개수를 조정하고, 고급 설정에서는 장르 로테이션을 바꿀 수 있다. 운영자가 매번 내부 처리 순서를 이해해야 하는 방식보다는, 그날 필요한 제작량을 조정하고 결과를 확인할 수 있는 형태가 필요했다. ![세 서비스의 통합 소재 생성 화면](/assets/images/notion/ad8579faf15248023335/03-marketing-ax.png)
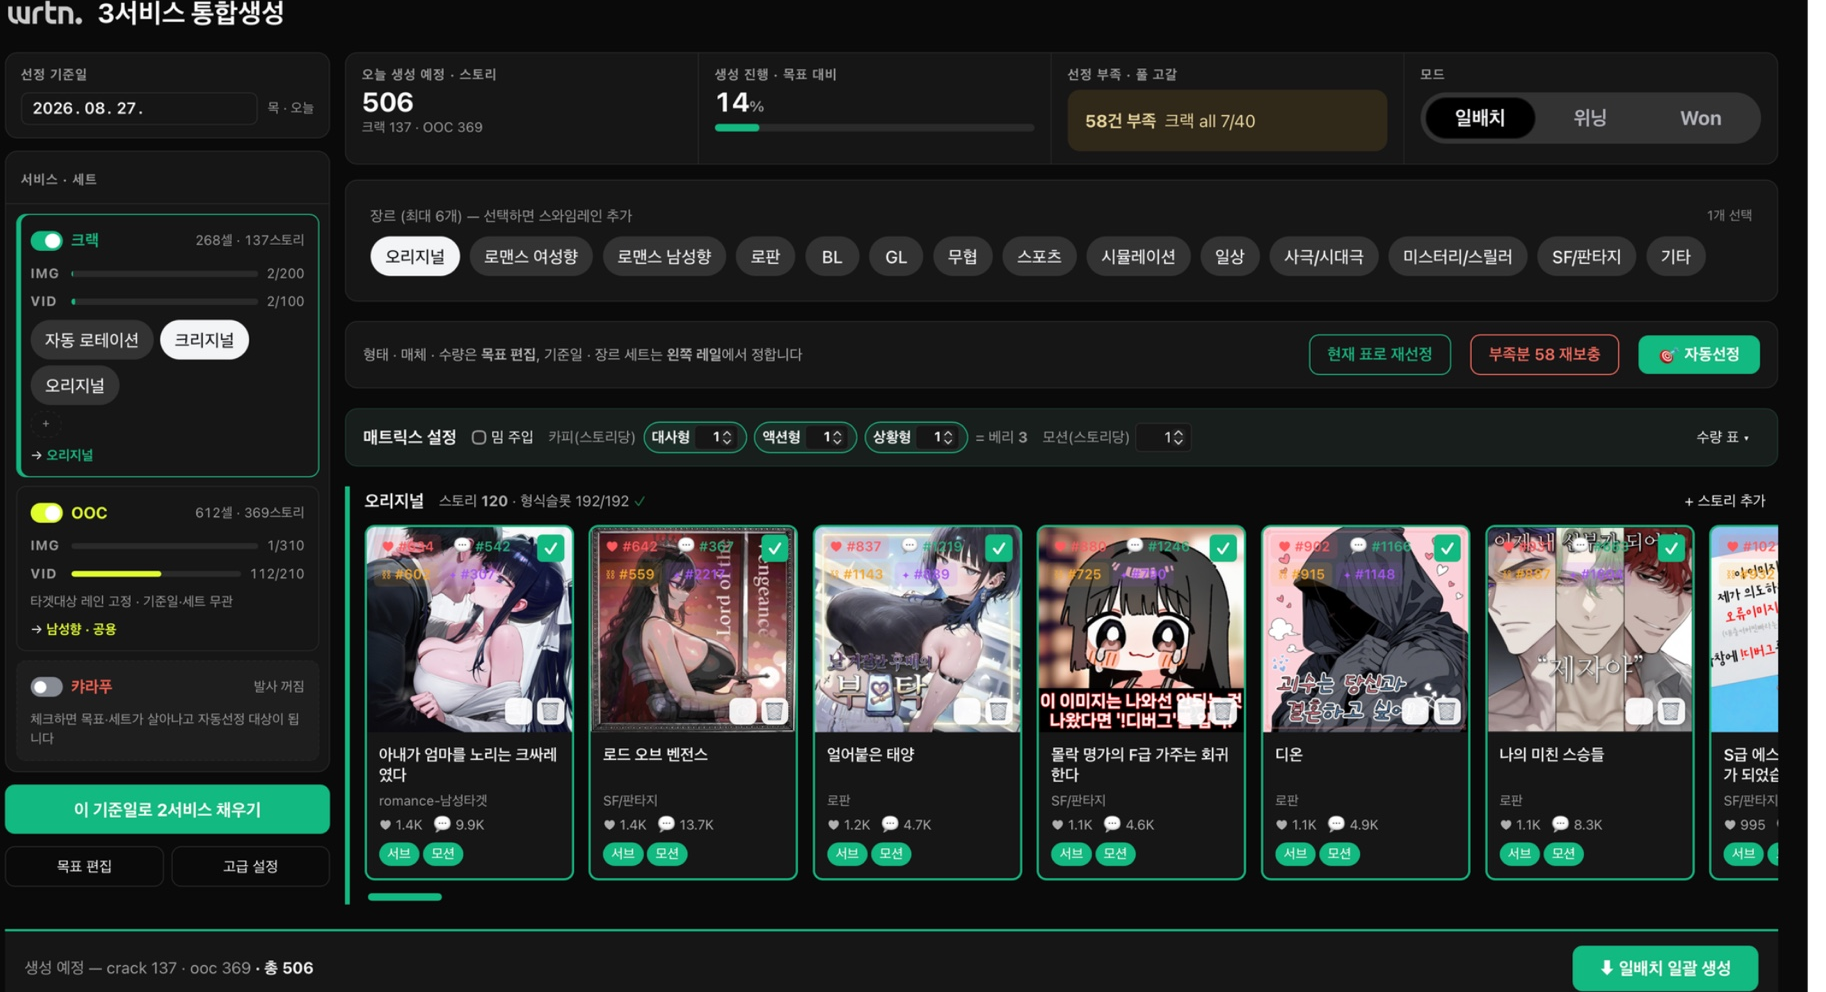
세 서비스의 통합 소재 생성 화면

![형식별 생성 목표와 장르 로테이션 설정](/assets/images/notion/ad8579faf15248023335/04-marketing-ax.png)

형식별 생성 목표와 장르 로테이션 설정

![애니메이션 티저의 플랜 생성 화면](/assets/images/notion/ad8579faf15248023335/05-marketing-ax.png)

애니메이션 티저의 플랜 생성 화면

![스토리보드 플랜을 확인하는 과정](/assets/images/notion/ad8579faf15248023335/06-marketing-ax.png)

스토리보드 플랜을 확인하는 과정

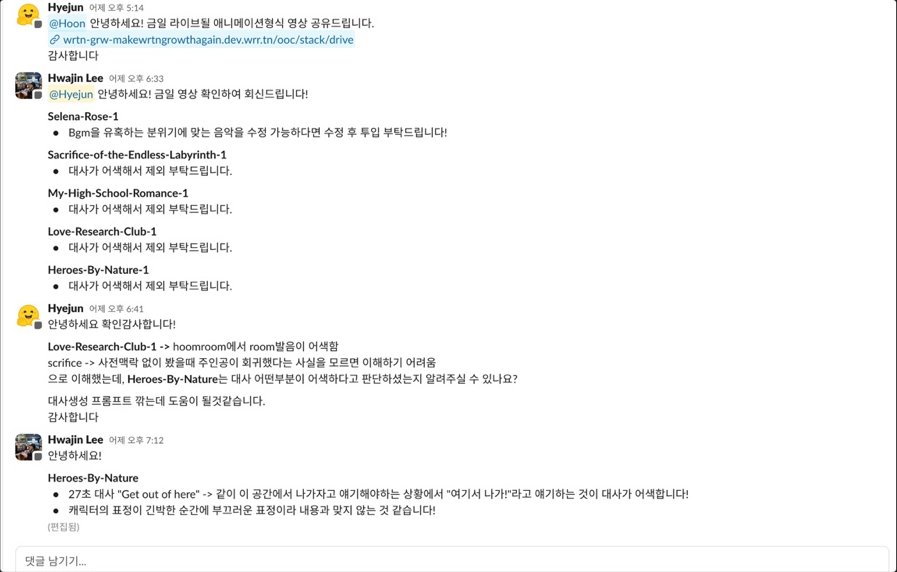
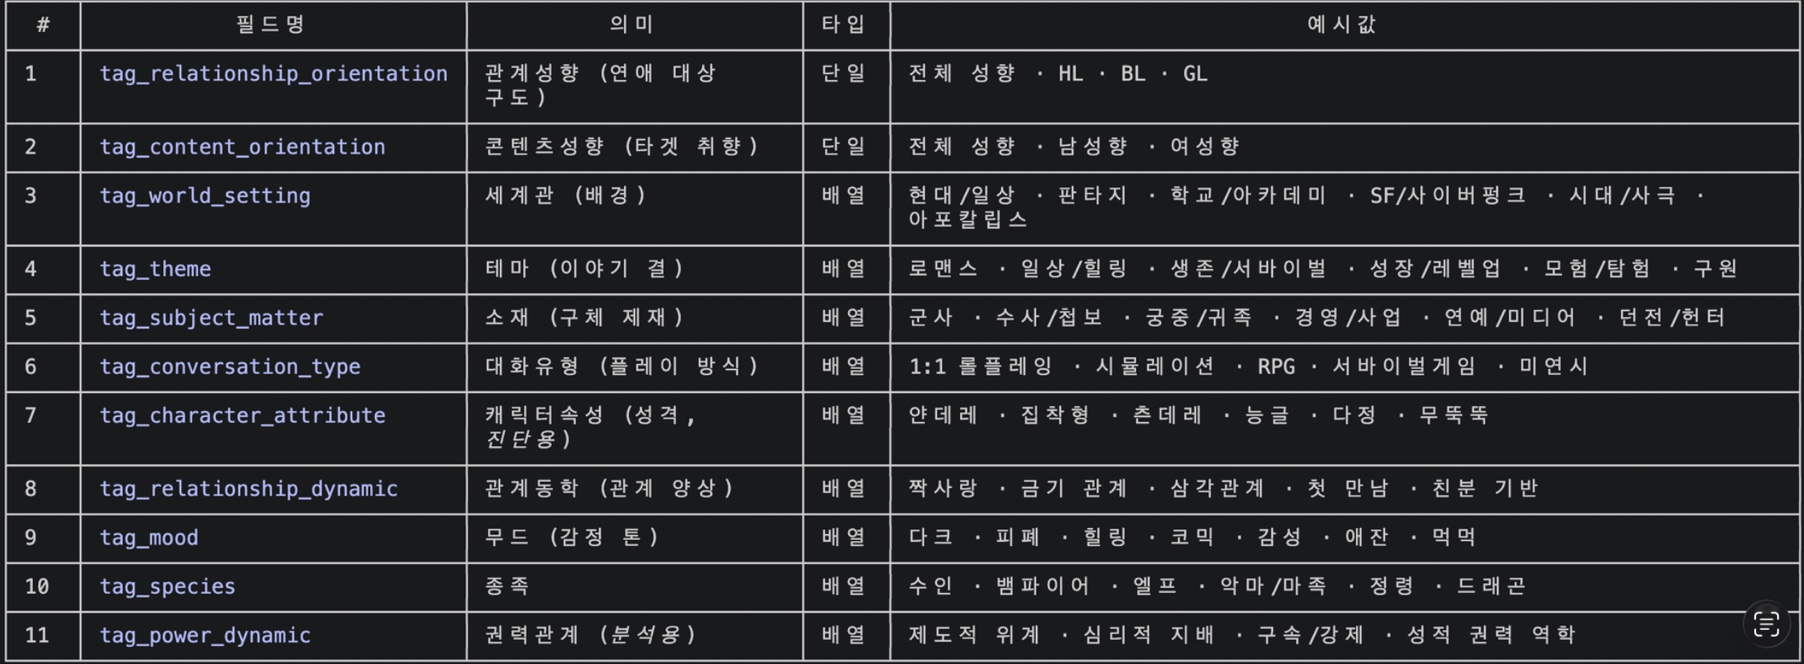
모든 형식을 같은 방식으로 처리하지는 않았다. 애니메이션 티저는 스토리를 선택해 먼저 스토리보드 플랜을 만들고, 플랜을 확인한 뒤 영상 생성 모델을 호출한다. 완성된 영상은 검수 탭에 노출하고, Drive에 올려 글로벌 마케터분들이 확인할 수 있게 했다. 비싼 영상 생성 전에 수정할 수 있는 단계를 두는 편이 운영에도 맞았다. 배너 한 장을 만드는 중에도 실패할 수 있는 지점이 여럿 있었다. 원본 이미지 URL이 죽어 있거나, 생성 모델이 정책상 차단하거나, 얼굴을 못 찾아 규격 변경 때 캐릭터가 잘릴 수 있다. 실제로 클릭했을 때 원본 스토리가 살아 있는지도 확인해야 한다. 제작 당시에는 공개 상태였는데 이후 제작자가 내리거나 차단되는 경우가 있었기 때문이다. 이런 문제들은 모델 호출 하나만 잘해서 해결되지는 않았다. ## 제작량 이후의 일 후반에는 만드는 형식을 늘리는 작업과 함께, 안전성·IP 탐지, 이미지 검색, 해외 서비스 디자인, 위닝 소재 기반 후보 발굴도 고도화했다. 처음에는 소재를 만들 수 있게 하는 일이 중심이었다면, 운영을 시작한 뒤에는 어떤 소재를 만들지, 만들면 안 되는 것은 무엇인지, 실패한 결과를 어떻게 다시 처리할지가 더 구체적인 문제가 됐다. 마케터분들의 가설과 디자이너분들의 레퍼런스도 계속 입력으로 들어왔다. 나는 그 판단을 생성 규칙과 데이터 흐름으로 옮겼다. 장르별 디자인을 맞추거나 위닝 소재를 재활용할 때도, 어떤 정보를 시스템에 남겨야 다음 제작에서 반복해서 쓸 수 있을지 고민했다. 이후 글에서는 이 흐름을 이루는 작업들을 나눠서 기록하려고 한다. 데이터가 광고 기획으로 바뀌는 과정부터 시작해서, 이미지 검색과 생성, 필터링, 해외 확장, 성과를 예측하려던 실험까지. 각각을 구현하면서 선택했던 방법과 실제로 잘 안 됐던 지점을 함께 남기려고 한다. ### 스토리 데이터를 광고 소구점으로 바꾸는 파이프라인 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-02-story-preprocessing/ - Collection: Project - Published: 2026-10-12 - Tags: Project 캐릭터챗 스토리를 광고로 만들려면 제목과 이미지를 가져오는 것만으로는 부족했다. 같은 로맨스 장르라도 유저가 끌리는 이유는 다르다. 소꿉친구의 철벽을 무너뜨리는 스토리와 계약 관계에서 시작하는 스토리를 모두 '설레는 로맨스'라고 표현하면, 각각의 스토리를 광고하는 의미가 줄어든다. 그래서 먼저 스토리마다 어떤 설정과 관계가 매력인지 정리하고, 그걸 광고 카피와 이미지 선택에 공통으로 쓸 수 있도록 전처리했다. ## 이미 있던 데이터부터 활용했다 스토리 데이터는 운영 DB를 미러링한 BigQuery에서 가져왔다. 광고 후보의 자격 조건과 장르별 랭킹을 적용한 다음 제목, 소개, 시작 상황, 프로필과 상황 이미지, 댓글 등을 읽었다. ```plaintext - 제목: 우주 - 장르: BL - 공개 태그: 연애, 여성향, 로맨스, 철벽, 내가, 짝사랑, 하는, 소꿉친구, 꼬시기 - 타겟: female - 챗타입: rolePlaying ``` | 테이블 | 여기서 뽑는 것 | 소재에서 쓰이는 곳 | | --- | --- | --- | | stories | 제목 · 소개 · 장르 · 타겟성별 · 좋아요수 · 성인여부 · 오리지널 여부 · 프로필 이미지 | 모든 형식의 기본 메타 | | story_starting_sets | 시작 상황 프롬프트 · 상황 이미지 · 첫 메시지 · 키워드북 · 엔딩 · 플레이 가이드 | 배너 이미지 · 롱폼 대본 · Anime 레퍼런스 | | character_comments | 좋아요순 상위 50개 댓글 | 소구점 도출의 보조 신호 | | profiles · genres | 작가 닉네임 · 장르 매핑 | 제작자 차단 · 장르 슬롯 | 입력 중에서 특히 활용하기 좋았던 것은 스토리 추천을 위해 미리 만들어 둔 세계관·줄거리와 11축 장르 태그였다. AI Engineer Kevin이 전처리해 둔 추천용 데이터였는데, 광고에서 스토리의 매력을 해석하는 데도 쓸 수 있었다. 관계 성향, 캐릭터 속성, 관계 동학, 분위기 등이 있으니 단순 장르보다 구체적으로 이야기를 읽을 수 있었다. ```plaintext tag_relationship_orientation BL tag_content_orientation 여성향 tag_world_setting 현대/일상, 학교/아카데미 tag_theme 로맨스, 청춘 tag_conversation_type 1:1 롤플레잉 tag_character_attribute 다정, 능글, 집착형 tag_relationship_dynamic 친분 기반, 짝사랑 tag_mood 청량, 설렘, 애잔 tag_subject_matter tag_species tag_power_dynamic ``` 세계관은 정제 후 길이를 제한해 넣었고, 비어 있으면 요약으로 대체했다. 모든 스토리에 같은 양과 품질의 정보가 있는 건 아니라서, 일부 필드가 비어 있어도 소구점을 만들 수 있는 입력 구조가 필요했다. ```plaintext ### 세계관 2025년 현대 대한민국을 배경으로 하며, 주된 무대는 한국대학교 캠퍼스와 그 주변 일대이다. 주인공들이 속한 대학에는 실용음악과 학생들로 구성된 '타임리스(Timeless)'라는 밴드부가 활발히 활동하고 있다. ... 두 주인공이 어린 시절부터 함께 뛰어놀던 동네 놀이터는 지금도 힘들거나 지칠 때 무의식적으로 찾아가는 둘만의 안식처이자, 향후 감정적 충돌과 화해가 일어나는 특별한 상징적 공간으로 기능한다. ### 숨겨진 설정 ...10%의 확률로 이성의 갑작스러운 고백이나 대학교 전체 MT 같은 새로운 서사적 분기점이 무작위로 발생할 수 있다. 우 주는 유저가 거짓말할 때 시선을 피하는 사소한 버릇까지 알아차린다. ``` | 항목 | 내용 | | --- | --- | | 스토리 정보 | title · genre_category (없으면 genre) · tags (공개 태그) · internal_tags (운영 태그) · target · chat_type | | 장르 태그 11축 | stories.tag_\* 열한 개 — tag_relationship_orientation (관계성향) · tag_content_orientation (콘텐츠성향) · tag_world_setting (세계관) · tag_theme (테마) · tag_subject_matter (소재) · tag_conversation_type (대화유형) · tag_character_attribute (캐릭터속성) · tag_relationship_dynamic (관계동학) · tag_mood (무드) · tag_species (종족) · tag_power_dynamic (권력관계) | | 세계관·줄거리 | world_settings 를 정제해 1,500자로 컷해 쓰고, 비어 있으면 content_summary 로 대체 | | 댓글 | comments\[\].content — 좋아요순 상위. 보조 신호일 뿐이라 별도 블록으로 붙이고, 없으면 "(댓글 없음 — 세계관·태그 기반으로 소구점 도출)"이라고 명시해 넣는다 | ## 댓글은 유용했지만, 그대로 믿을 수는 없었다 댓글은 유저가 어디에 반응했는지 직접 볼 수 있는 정보였다. 반복되는 키워드나 특정 캐릭터의 집착, 질투, 몰입을 표현한 반응은 스토리의 매력을 잡는 데 도움이 됐다. 다만 댓글이 많다고 모두 광고 기획에 쓸 만한 건 아니었다. 제작자의 공지나 유저노트 안내도 댓글에 섞여 있었다. ```plaintext - "💙등장 캐릭터 프로필" - "💙유저노트 TIP은 대댓확인 🆙!단축어 /커뮤니티 업데이트 …" - "헉 고백 받아내기 굿!! 전 매번 제가 고백합니다.. 😭😭" → 앞 두 개는 제작자 공지·안내라 소구점과 무관한 '뻘글'이다. 프롬프트가 댓글을 보조 신호로만 쓰라고 못박아 둔 이유가 이것이다. ``` 약 3만 개의 스토리를 전처리해야 했기 때문에 입력 비용도 고려했다. 이모티콘과 반복되는 자모, 여러 공백, 의미 없는 문자열을 정리했고 긴 댓글은 500자 이후를 잘랐다. 이모티콘에도 감정 정보가 있지만, 당시에는 토큰을 줄이는 쪽을 선택했다. 댓글의 역할은 보조 신호로 제한했다. 댓글이 없거나 적은 스토리에서도 세계관과 캐릭터 설정만으로 소구점을 만들 수 있어야 했다. 공지성 댓글 하나에 기획이 끌려가면 오히려 입력을 더 넣은 것이 문제가 된다. 프롬프트에도 댓글을 참고하되 과의존하지 말라고 명시했다. ## 스토리의 매력을 광고 카피로 옮기기 프롬프트에는 세 단계로 분석하도록 순서를 정했다. 먼저 세계관·태그·댓글에서 매료 포인트를 찾고, 그 매력이 왜 지금 이 스토리를 플레이하고 싶은 이유가 되는지 해석한 뒤, 앞의 분석에 연결된 결과를 만들게 했다. '흥미진진하다', '매력적이다', '몰입감이 있다' 같은 말은 거의 모든 스토리에 붙일 수 있었다. 그런 표현을 막고, 캐릭터가 실제로 하는 행동이나 관계의 긴장이 드러나게 하려고 했다. 소구점 세 개도 같은 내용을 바꿔 말하기보다는 캐릭터성, 관계성, 상황·전개처럼 다른 측면을 담도록 했다. ```plaintext 너는 모바일 앱 퍼포먼스 마케팅 전략가야. 크랙 앱의 캐릭터챗 콘텐츠를 타겟(여성향/남성향, 장르별 서브컬처)에 맞춰 광고 소재화하는 전문가야. 소구점은 스토리의 세계관·줄거리·장르 태그(11축)·유저 댓글을 종합해서 도출해 — 어느 한 신호에도 과의존하지 마. 특히 댓글은 '있으면 참고'하는 보조 신호일 뿐이야: 댓글이 없거나, 수가 적거나, 뻘글(무의미한 반응)만 있는 스토리가 많기 때문에, 댓글이 빈약하면 세계관·장르 컨벤션·캐릭터 설정·태그만으로 충분히 소구점을 도출하고 뻘글에 휘둘리지 마. 추상어·일반론 금지. 구체적인 캐릭터성·관계성·장면이 드러나야 해. CTR과 전환율을 높이는 것이 최우선 목표야. [분석 지시 — 반드시 이 순서로 사고할 것] Step 1. 매료 포인트 분석 (세계관·태그·댓글 종합): ... 유저 댓글이 있으면 보조 근거로 참고하되(반복 키워드·집착/몰입 표현 등), 댓글이 없거나 빈약해도 세계관·장르 컨벤션·캐릭터 설정만으로 매료 포인트를 잡아. 댓글에 과의존하거나 뻘글에 휘둘리지 마. Step 2. 소구 코어 정의: Step 1에서 뽑은 매료 포인트를 "이 스토리를 지금 당장 플레이하고 싶게 만드는 이유"로 번역해. 장르 컨벤션(멘헤라남·집착공·악역영애·계약결혼 등)이 명확하면 그 컨벤션의 어떤 변주/강도가 유저를 끌어당기는지 구체적으로. Step 3. 위 분석을 근거로 Output을 산출해. 일반론/추상어("흥미진진", "매력적", "몰입감") 금지. appeal_points: 소구점 3가지 (각 1문장). "사용자가 이 스토리를 실제로 플레이하고 싶어지는 이유"여야 함. 각 소구점은 서로 다른 축(캐릭터성/관계성/상황·전개/장르적 쾌감 등)을 다뤄야 하고, 가능한 경우 세계관·캐릭터·전개에서(및 있으면 댓글에서) 드러난 구체적 요소(캐릭터의 특정 행동·말투·집착 포인트 등)를 직접 반영할 것. 예: 멘헤라 남성향이면 "집착형 여주가 유저를 향해 무너지는 장면", "도망칠수록 더 깊어지는 소유욕" 같이 구체적으로. ``` 결과는 훅 포인트, 타깃 감정, 소구점, 시각 검색어, CTA 방향, 광고 본문 등을 가진 `strategy_json`으로 저장했다. 이 중 시각 검색어는 이미지 검색에서, 이상적인 폰트 샘플 문장은 폰트 선택에서 쓴다. 광고 기획을 사람이 읽는 문장으로만 끝내지 않고 다음 제작 단계가 사용할 수 있는 필드로 나눈 셈이다. | 항목 | 내용 | | --- | --- | | hook_point | 3초 안에 클릭하게 만들 후킹 한 문장 | | target_emotion | 자극하는 핵심 감정 — 설렘·질투·독점욕·구원욕구·서열역전쾌감처럼 구체적으로 | | appeal_points | 소구점 3개. 각 1문장이고 서로 다른 축이어야 한다 — 캐릭터성 / 관계성 / 상황·전개 / 장르적 쾌감. `strategy_json.appeal_points` 로 저장 | | hyde_visual_query | 그림 찾을 영어 시각 토큰 12~16개. 이게 이미지 선택의 검색어가 된다 | | cta_direction | 소구점 중 가장 강한 것을 행동으로 전환 | | ad_description | 매체별 광고 본문. | ```plaintext hook_point: 절대 선을 넘지 않는 완벽한 소꿉친구가 다른 남자 옆에 선 나를 보고 무너져 내렸다. target_emotion: 애가 타는 짝사랑의 아슬아슬함과 견고한 철벽을 무너뜨릴 때의 짜릿한 정복감 appeal_points: ① 절대 연애 감정을 주지 않으려 발버둥 치는 소꿉친구의 필사적인 철벽 ② 거짓말할 때 시선을 피하는 내 사소한 버릇까지 모두 꿰뚫어 보는 은밀한 집착 ③ 다른 밴드부원을 꼬셔서 그의 숨겨진 질투와 독점욕을 폭발시키는 아슬아슬한 밀당 hyde_visual_query: 1boy, handsome, blonde hair, yellow eyes, looking at viewer, intense expression, subtle jealousy, upper body, dramatic lighting, blurred background, masterpiece, best quality, anime illustration cta_direction: 다른 남자를 향한 질투심을 자극해 그의 철벽을 부수고 고백을 받아내세요 tiktok_body: 평생 친구라며 선 긋던 소꿉친구가 다른 남자와 웃는 내 모습에 이성을 잃고 질투하기 시작했다. ideal_font_sample_text: 팽팽한 긴장감 속에서 터져 나오는 질투를 담아낸 날렵하고 세련된 서체 ``` ```plaintext 검색용 소구점 텍스트 (AGENTS/APPEAL_EMBEDDER.PY · FORMAT_APPEAL_TEXT) [제목] {스토리 제목} [장르] {장르} [핵심감정] {target_emotion} [후킹] {hook_point} [소구점1] {appeal_points[0]} [소구점2] {appeal_points[1]} [소구점3] {appeal_points[2]} ``` 한 번 저장한 소구점을 배너 카피, 모션 연출, 위닝 검색에서 함께 사용했다. 이후 형식이 늘어날 때도 각 생성 경로가 스토리의 매력을 새로 정의하는 대신, 공통 기획을 받아 자기 형식에 맞게 표현하도록 했다. 나중에 위닝 소재와 비슷한 후보를 찾을 때는 스토리 정보 자체를 텍스트로 임베딩하기도 했고, 전처리해 둔 후킹 포인트와 소구점을 임베딩해서 사용하기도 했다. 위의 검색용 텍스트처럼 제목·장르·핵심 감정·후킹 문장·소구점을 묶어 두면, 스토리의 설정뿐 아니라 광고에서 강조할 매력을 기준으로도 후보를 찾을 수 있었다. 이 텍스트 임베딩은 성과가 났던 소재와 유사한 스토리·소재를 찾는 hybrid search에 활용했다. ## 이미지 URL도 그냥 한 필드에 있지 않았다 스토리마다 이미지를 저장해 둔 위치가 달랐다. 상황 이미지가 situation_images 같은 필드에 모여 있는 스토리도 있었지만, initial_images나 keyword_book 등 여러 필드에 이미지 주소가 흩어져 있는 경우도 있었다. 광고 제작에서 쓸 이미지를 놓치지 않으려면 한 필드만 읽는 것으로는 부족했다. 정규 이미지 목록은 URL·키워드·상황 정보로 형태를 맞췄다. 시작 세트가 여러 개면 각 세트의 이미지를 모두 펼쳐 합치고, 프로필 이미지도 함께 모았다. 본문에서는 system_prompt_variables, keyword_book, initial_messages, ending에 들어 있는 이미지 URL을 추출했다. 이렇게 서로 다른 필드에서 찾은 주소를 이미지 자산으로 정리하고, 이미지 한 장을 한 행으로 저장했다. 본문에 완성된 URL이 있으면 정규식으로 수집했다. 마크다운 이미지 선언은 링크 뒤의 문장까지 삼키지 않게 괄호의 깊이를 확인했고, GitHub blob 링크는 이미지 원본을 받을 수 있는 raw 주소로 바꿨다. URL 양식과 변수 값이 따로 적혀 있는 경우에는 LLM이 명시된 양식과 값만 조합해 완성된 주소를 만들도록 했다. 변수가 덜 채워진 URL은 제외했다. ```yaml AGENTS/LLM_IMAGE_EXTRACTOR.PY · 배치 프롬프트(발췌) 당신은 캐릭터 챗봇의 system_prompt_variables 필드에서 외부이미지 URL 을 추출 각 raw 는 종종 다음 패턴을 포함합니다: - 자연어/JSON 으로 외부이미지 URL 양식이 서술됨 (예: "이미지는 https://example.com/{캐릭터}_{상황}.png 형식") - {캐릭터}, {상황}, {이미지코드} 같은 placeholder 변수의 실제 값들이 같은 raw 안에 함께 정의됨 작업: 1. 양식(템플릿 URL) 식별 2. placeholder 의 실제 값 식별 3. 양식 × 모든 가능한 값 조합으로 완성된 URL 들을 만들어 반환 4. raw 안에 이미 완성된 https URL 이 있으면 그것도 그대로 포함 규칙: - placeholder 가 채워지지 않은 ({...} 가 남아있는) URL 은 절대 포함하지 말 것 - URL 이 완전히 없으면 빈 리스트 반환 - 추측하지 말 것 — raw 에 명시된 양식과 명시된 값들로만 조합 - 모든 입력 스토리에 대해 results 배열에 1개씩 응답 (story_id 정확히 매칭) - 코드펜스 / 설명 / 주석 없이 순수 JSON 만 반환 ``` 이미지 자산에는 출처와 URL뿐 아니라 내려받기 성공 여부, CLIP 점수, 임베딩, 후속 아웃페인팅 결과와 얼굴 좌표가 이어서 붙는다. URL 접근에 실패한 경우도 기록을 남겼다. 생성에서는 성공한 자산만 쓰더라도, 나중에 왜 특정 이미지가 빠졌는지 확인할 수 있어야 했다.
stories제목·세계관·줄거리·11축 태그·장르·타겟.
image_assets이미지 1장 = 1행. URL · 출처(situation/profile/external) · CLIP 점수 · fetch 성공여부 · 아웃페인트 결과 · 얼굴 좌표.
story_embeddings이미지 임베딩(512-dim). HyDE 쿼리와 내적해 "이 소구점에 어울리는 그림"을 고른다.
strategy_json소구점 전략 — 훅 포인트 · 소구점 N개 · HyDE 비주얼 쿼리 · 광고 설명문 · 틱톡 본문 · 이상적 폰트 샘플 문장.
comments좋아요순 상위 댓글. 소구점 도출
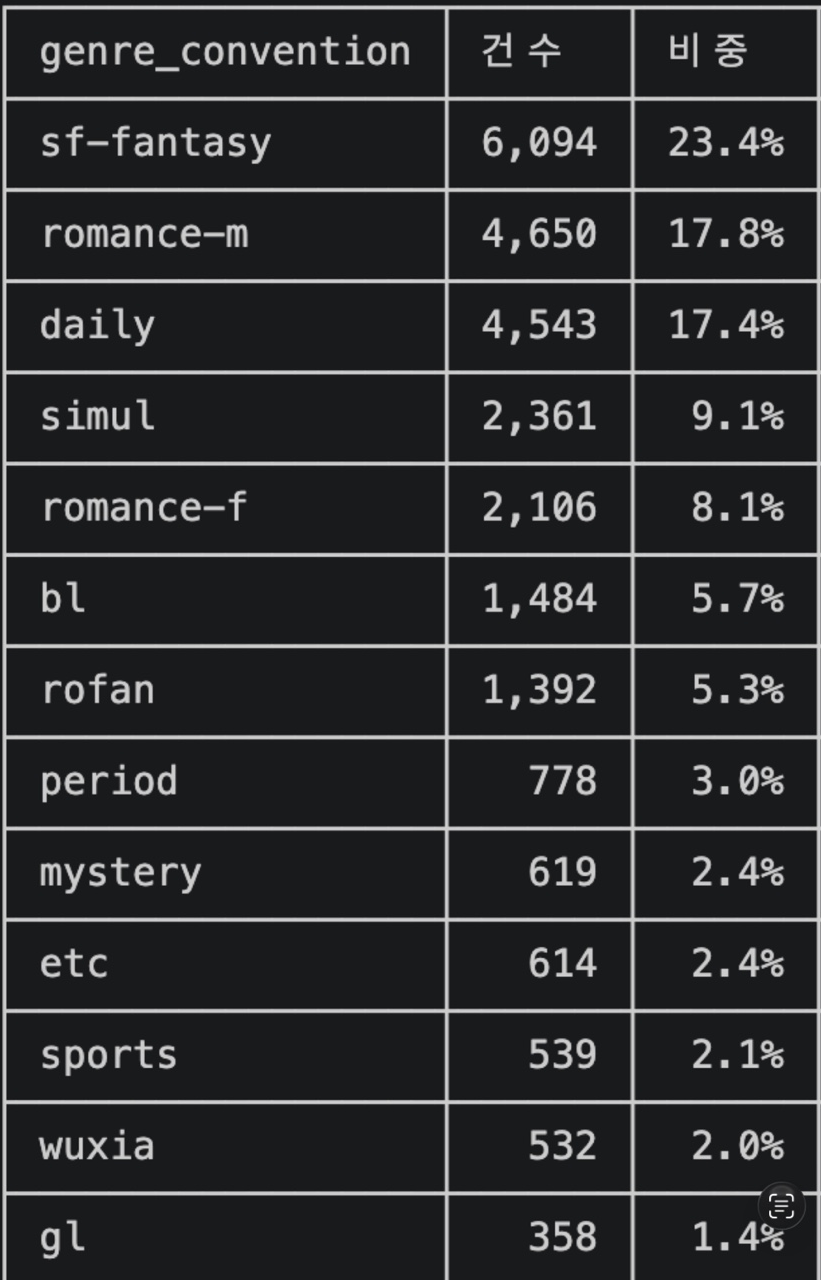
## 광고세트를 위해 장르를 다시 나눴다 원본 데이터에서 '기타' 장르가 24% 이상이었다. 광고세트에는 같은 타겟을 향한 소재를 묶어야 하는데, 너무 많은 스토리가 기타로 들어가면 그 구분을 활용하기 어렵다. 그래서 추천용 11축 태그로 장르를 다시 분류했다. 분류에는 추천용 11축 태그의 값을 조건으로 사용했다. 관계 성향, 세계관, 테마, 콘텐츠 성향, 소재와 대화 유형을 순서대로 확인하고, 먼저 맞는 규칙에 따라 장르를 정했다. BL·GL 관계 성향을 가장 먼저 확인한 뒤 무협과 로맨스 판타지, 스포츠, 남성향·여성향 로맨스, 시뮬레이션 등의 조건을 적용했다. 예를 들어 BL·GL에 해당하지 않으면서 여성향 로맨스와 판타지 세계관 조건을 갖춘 스토리는 로맨스 판타지 규칙을 먼저 만나 rofan으로 분류된다. 여러 조건에 걸리는 스토리를 어느 광고세트에 넣을지 정하려면 이런 우선순위가 필요했다. 아무 조건도 맞지 않을 때만 기타로 남겼다. 전후 비교에서는 전체 스토리 중 기타로 남은 비중을 확인했다. 계산은 기타로 분류된 스토리 수를 전체 스토리 수로 나눈 뒤 100을 곱하는 방식이다. 아래 분포는 원본 장르와 11축 태그로 재분류한 장르를 비교한 결과다. ![원본 데이터의 장르 분포](/assets/images/notion/45e4a902dfd7bc997b49/01-story-preprocessing.png)

원본 데이터의 장르 분포

![11축 태그로 재분류한 장르 분포](/assets/images/notion/45e4a902dfd7bc997b49/02-story-preprocessing.png)

11축 태그로 재분류한 장르 분포

![장르 분류에 활용한 태그 축](/assets/images/notion/45e4a902dfd7bc997b49/03-story-preprocessing.png)

장르 분류에 활용한 태그 축

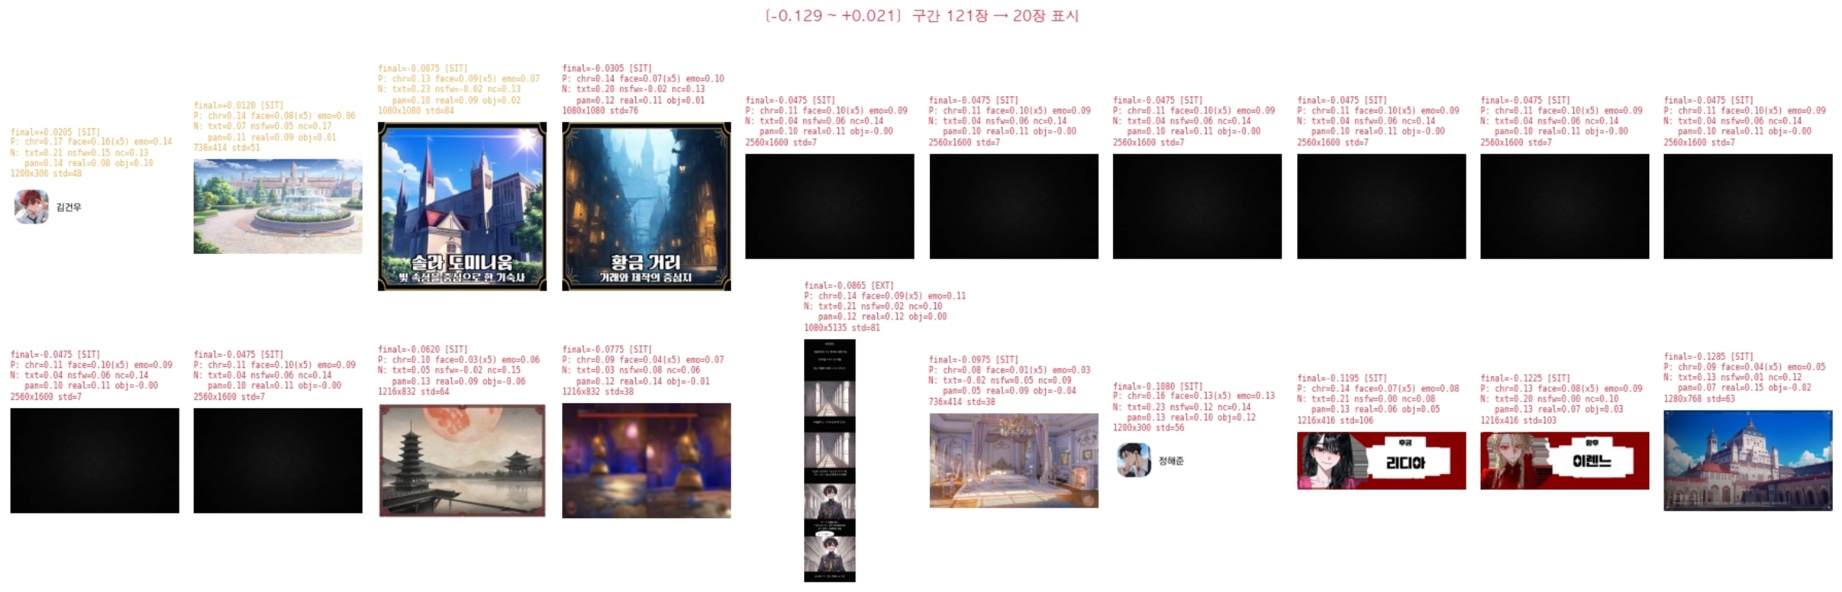
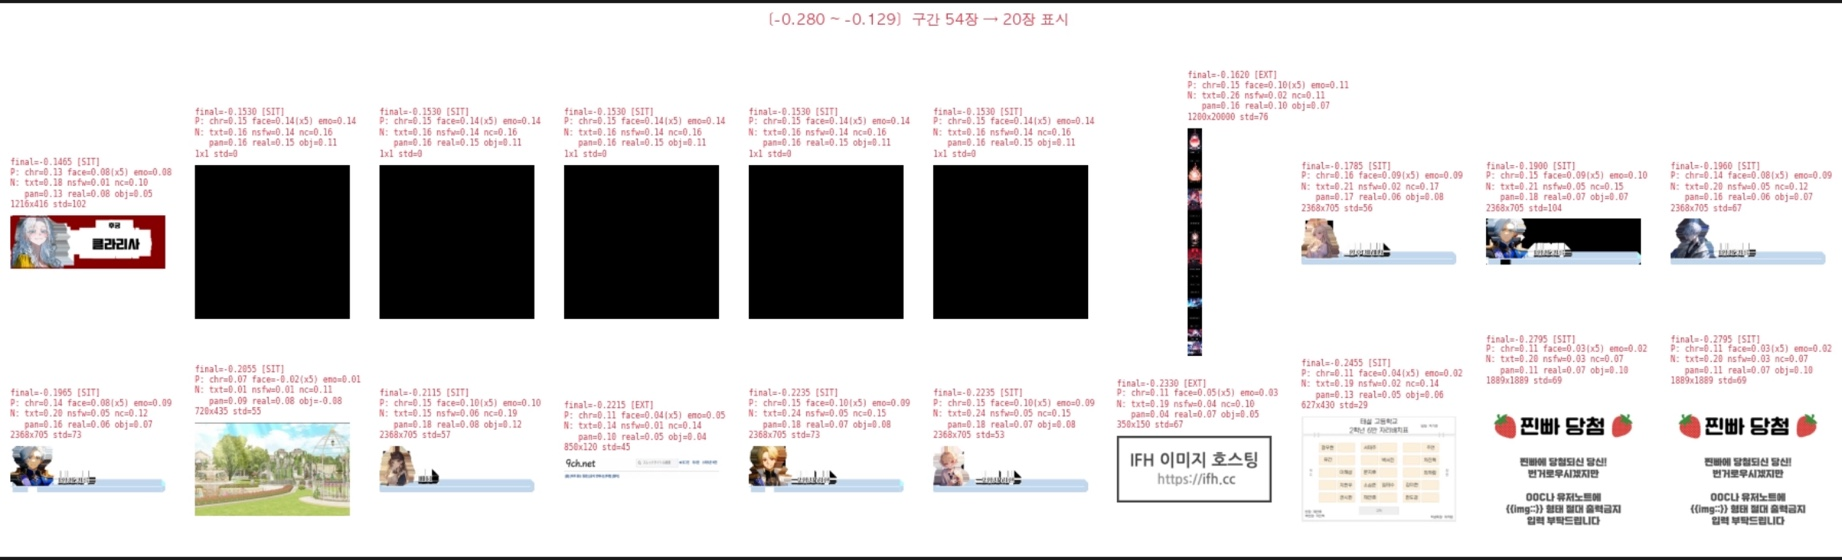
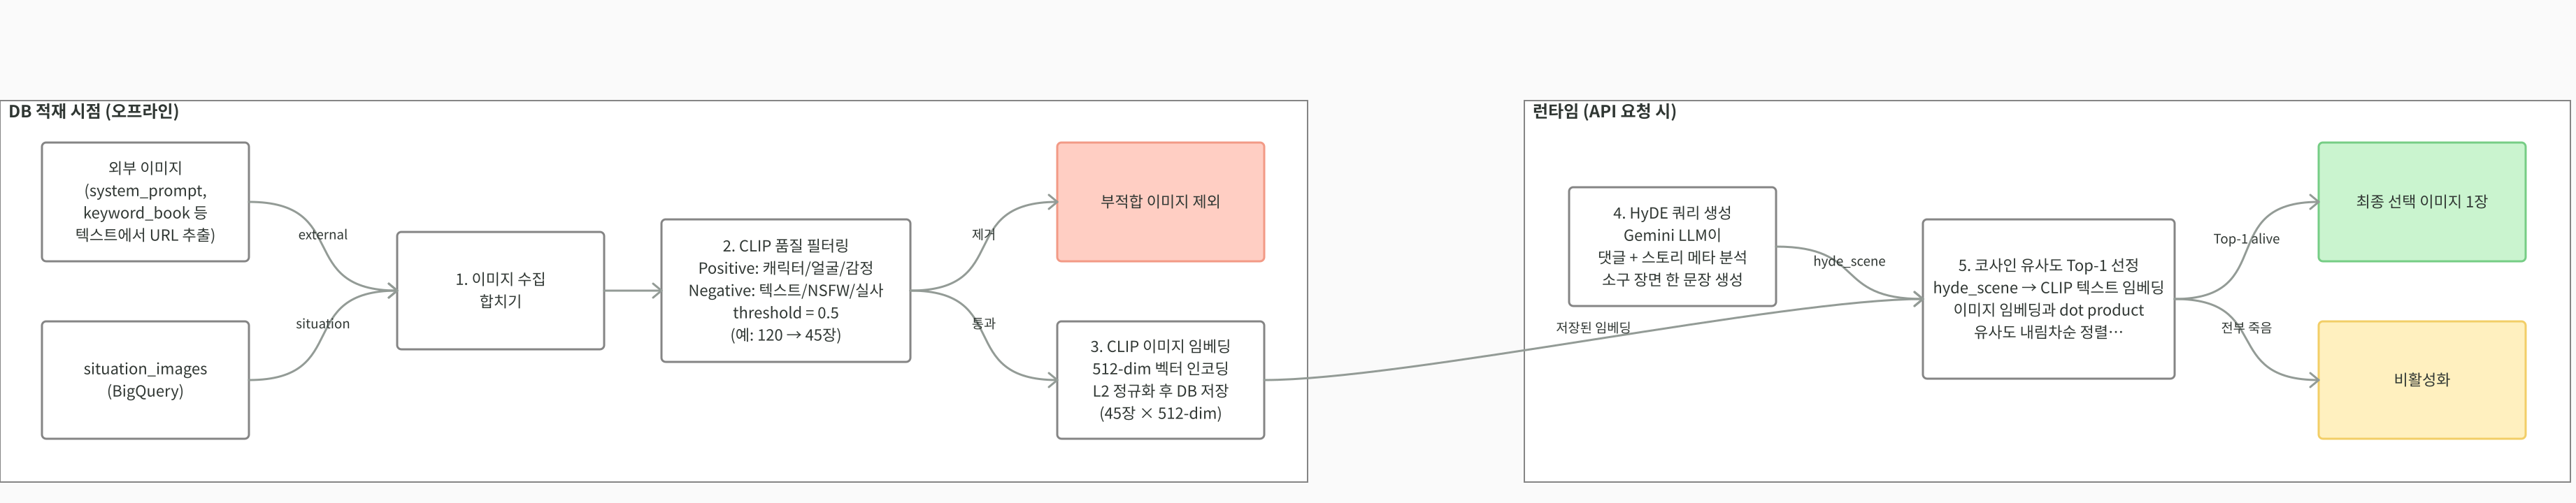
1. 관계성향(`relationship_orientation`)이 bl/gl이면 즉시 → bl / gl (최우선, 다른 축 무시). 2. 세계관(`world_setting`)에 "무협" → wuxia, "로판" 또는 (판타지 세계관 + 로맨스 테마 + 콘텐츠성향=여성향) → rofan. 3. 테마(`theme`)에 "스포츠" → sports. 4. 로맨스 신호(테마=로맨스 or 관계성향=hl)면 → 콘텐츠성향(`content_orientation`)으로 남성향→romance-m, 여성향→romance-f 가름. 5. 소재/대화유형(`subject_matter`, `conversation_type`)에 게임태그(시뮬·육성·키우기·타이쿤 등) → simul. 6. 세계관(`world_setting`)이 SF/판타지군(아포칼립스·이세계·가상현실 등) → sf-fantasy. 7. 테마(`theme`)가 추리/범죄/호러/스릴러 → mystery 8. 테마(`theme`)가 일상/힐링/드라마·일상대화 → daily 9. 그 외 → etc. 장르를 12종으로 확장한 뒤 기타 비중은 2.4%로 줄었다. 이 수치는 광고 성과가 오른 결과가 아니라, 원래 한 덩어리였던 후보를 타겟에 맞춰 구분할 수 있게 된 결과다. 이후 생성과 광고세트 구성에서 쓸 수 있는 데이터가 됐다는 점이 이 작업의 목적이었다. 전처리에서 만든 산출물은 눈에 보이는 광고보다 앞에 있지만, 뒤쪽 제작의 선택을 상당 부분 결정한다. 어느 댓글을 넣을지, 어떤 태그를 우선할지, 소구점을 어떤 필드로 남길지부터 정해 둬야 형식이 늘어나도 같은 스토리를 일관되게 광고할 수 있었다. ### 소구점에 맞는 이미지를 찾고 배너로 렌더링하기 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-03-image-retrieval-rendering/ - Collection: Project - Published: 2026-10-12 - Tags: Project 광고에 쓸 소구점을 만들고 나면 그 문장에 맞는 그림을 골라야 했다. 캐릭터챗에는 같은 캐릭터의 이미지가 여러 장 들어 있는데, 표정이나 구도가 조금씩 다르다. 어느 이미지든 캐릭터는 같지만, 질투를 강조하는 카피와 다정함을 강조하는 카피에 어울리는 장면은 같지 않을 수 있다. 그림을 고른 뒤에도 매체별 규격으로 바꾸고, 얼굴이 잘리지 않게 배치하고, 폰트와 카피를 얹는 과정이 남았다. 이 글에서는 이미지 후보를 정리하는 단계부터 실제 배너 파일로 렌더링하는 단계까지 이어서 정리한다. ## 배너에 못 쓰는 이미지부터 걸러냈다 수집한 이미지를 모두 검색 후보에 넣지는 않았다. 글자가 들어간 캡처, 실사, 풍경이나 도표, 캐릭터가 없는 이미지 등은 배너의 입력으로 적합하지 않았다. NSFW처럼 정해진 항목만 막는 필터로는 광고에서 쓸 만한 이미지를 충분히 구분하기 어려웠다. CLIP 계열 모델로 긍정·부정 프롬프트와의 유사도를 계산했다. 긍정 쪽에는 애니메이션 인물, 얼굴과 상반신, 감정적인 표정 등을 두고, 부정 쪽에는 자막·워터마크·말풍선, 노출, 풍경·UI, 실사·비인간 객체 등을 넣었다. ![CLIP 기반 이미지 필터링 흐름](/assets/images/notion/cefa5d36983575afeaaf/01-image-retrieval-rendering.png)
CLIP 기반 이미지 필터링 흐름

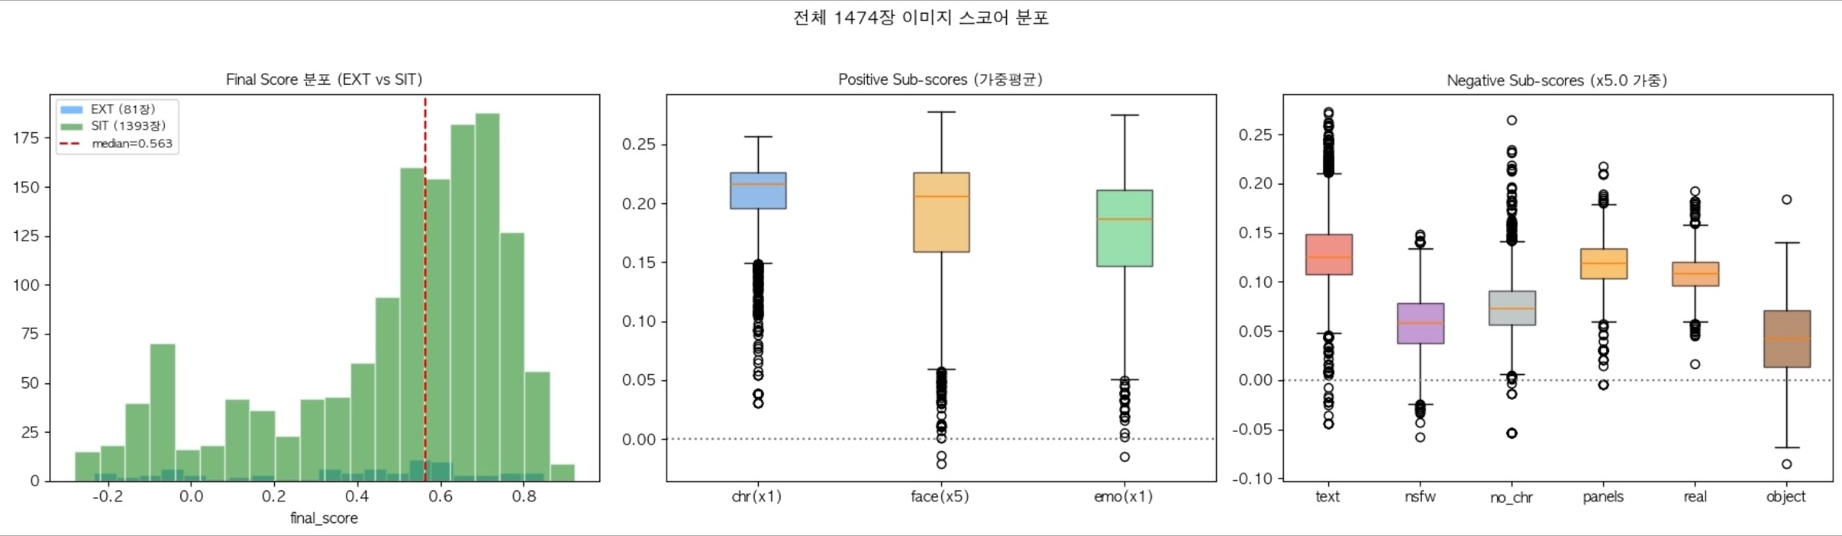
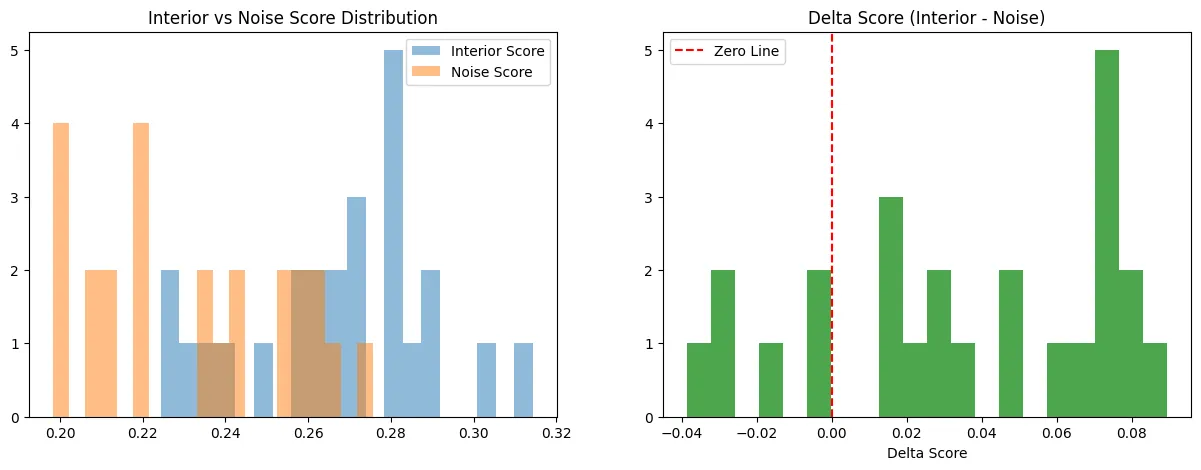
![이미지 점수 분포와 속성별 비교](/assets/images/notion/cefa5d36983575afeaaf/02-image-retrieval-rendering.png)

이미지 점수 분포와 속성별 비교

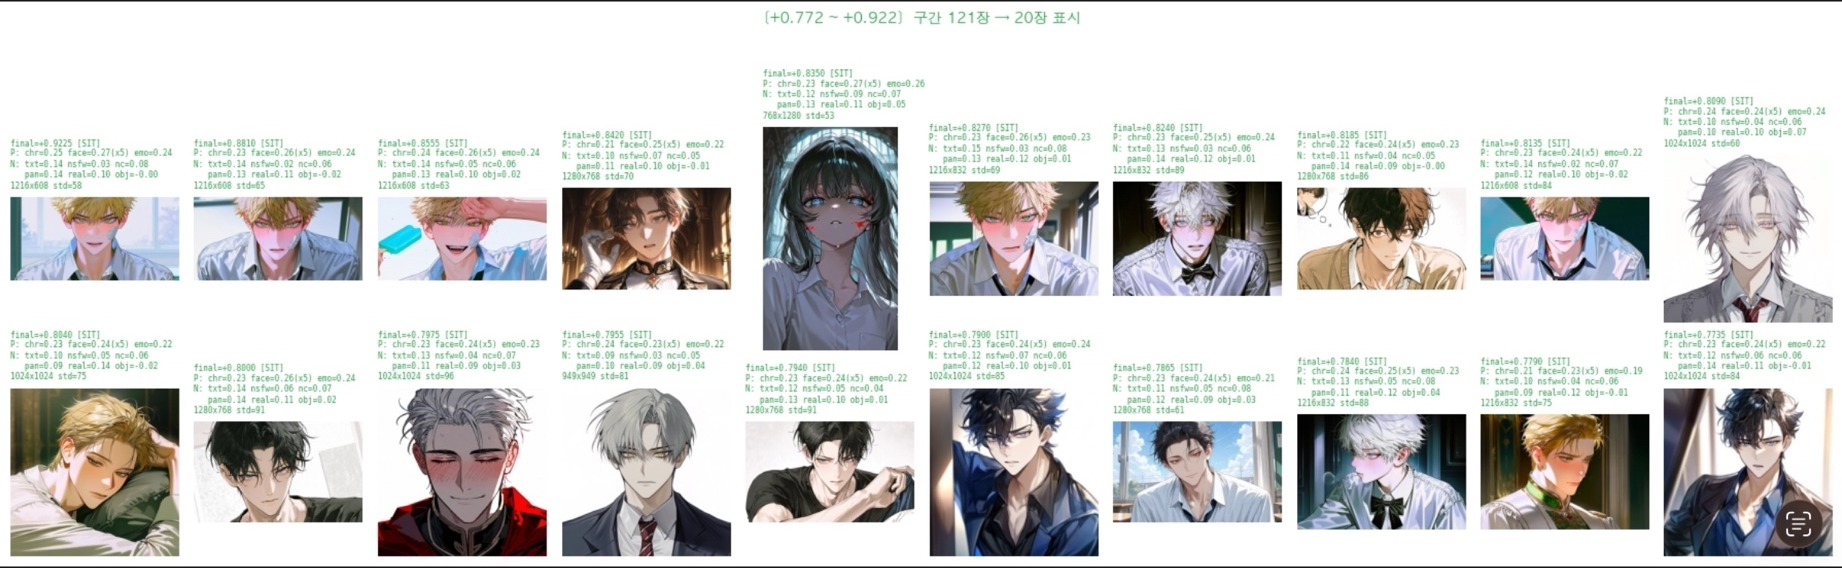
![필터링 점수별 이미지 사례](/assets/images/notion/cefa5d36983575afeaaf/03-image-retrieval-rendering.png)

필터링 점수별 이미지 사례

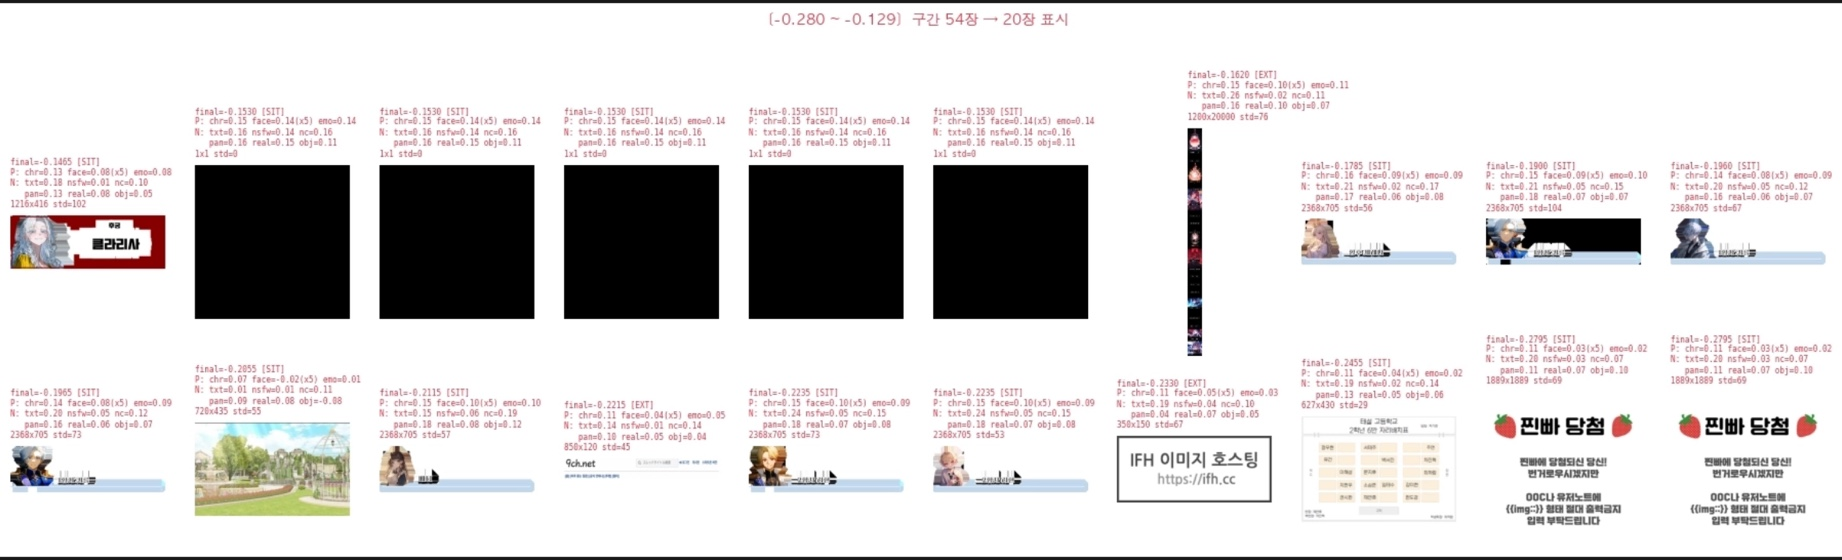
![광고 후보에서 제외한 이미지 사례](/assets/images/notion/cefa5d36983575afeaaf/04-image-retrieval-rendering.png)

광고 후보에서 제외한 이미지 사례

```python POSITIVE_PROMPTS = { 'p_character': "anime human character, illustrated person, human figure", 'p_face': "anime character face, human upper body portrait, clear face", 'p_emotion': "dramatic emotional expression, intense human gaze, expressive face", } POS_WEIGHT = 5.0 # Positive 전체 가중치 (final score) # Negative 프롬프트 — 전체 x5 가중치 NEGATIVE_PROMPTS = { 'n_text': ( "subtitled anime screenshot, image with Korean text, " "dialogue text bar, caption overlay, watermark, speech bubble, " "white text on black bar, colored subtitle" ), 'n_nsfw': "nude, explicit, nsfw, undressed, sexually suggestive content", 'n_no_char': "landscape, scenery, map, diagram, screenshot, UI, no human character", 'n_panels': "manga panels, comic strip layout, multiple frames, panel borders", 'n_real': ( "real photograph, real person, real animal, photo portrait, " "live action, 3D render, photorealistic" ), 'n_object': ( "cute mascot, chibi animal, cartoon penguin, cartoon creature, " "food illustration, small icon, item sprite, object illustration, " "illustrated animal, non-human cartoon creature" ), } NEG_WEIGHT = 5.0 # Negative 전체 가중치 (final score) ``` 초기 실험의 점수는 `5 × positiveScoreMean - 5 × NegativeScoreMean` 형태였다. 두 항에 같은 가중치를 곱하면 순위 자체가 달라지는 것은 아니다. 점수의 크기와 임계값의 관계를 함께 봐야 한다. 뒤의 제작 흐름에는 단색 이미지와 흡연에 대한 별도 페널티도 들어갔다. 이미지 필터링 실험에서는 0.5를 기준으로 보수적으로 후보를 남겼다. 한편 전체 전처리 기록에는 양수 점수만 통과시키는 0 기준도 있다. 이 두 설정을 같은 실험 결과로 섞지는 않으려고 한다. 아래는 이미지 필터링과 선정 단계에서 남긴 자료다. ![이미지 필터링 점수 분포](/assets/images/notion/cefa5d36983575afeaaf/05-image-retrieval-rendering.png)
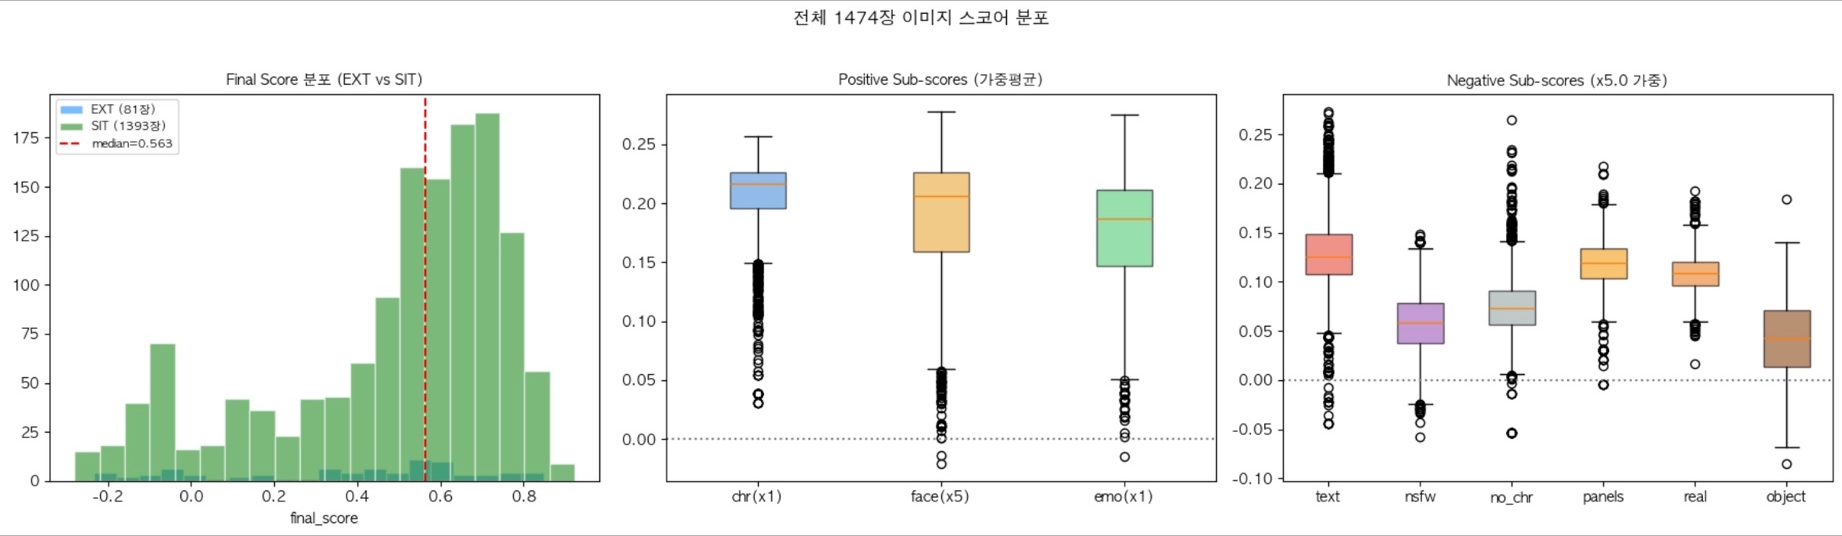
이미지 필터링 점수 분포

![이미지 필터링에서 확인한 후보와 제외 사례](/assets/images/notion/cefa5d36983575afeaaf/06-image-retrieval-rendering.png)

이미지 필터링에서 확인한 후보와 제외 사례

![이미지 필터링에서 확인한 후보와 제외 사례](/assets/images/notion/cefa5d36983575afeaaf/07-image-retrieval-rendering.png)

이미지 필터링에서 확인한 후보와 제외 사례

![이미지 필터링에서 확인한 후보와 제외 사례](/assets/images/notion/cefa5d36983575afeaaf/08-image-retrieval-rendering.png)

이미지 필터링에서 확인한 후보와 제외 사례

![이미지 필터링에서 확인한 후보와 제외 사례](/assets/images/notion/cefa5d36983575afeaaf/09-image-retrieval-rendering.png)

이미지 필터링에서 확인한 후보와 제외 사례

![이미지 필터링에서 확인한 후보와 제외 사례](/assets/images/notion/cefa5d36983575afeaaf/10-image-retrieval-rendering.png)

이미지 필터링에서 확인한 후보와 제외 사례

![이미지 필터링에서 확인한 후보와 제외 사례](/assets/images/notion/cefa5d36983575afeaaf/11-image-retrieval-rendering.png)

이미지 필터링에서 확인한 후보와 제외 사례

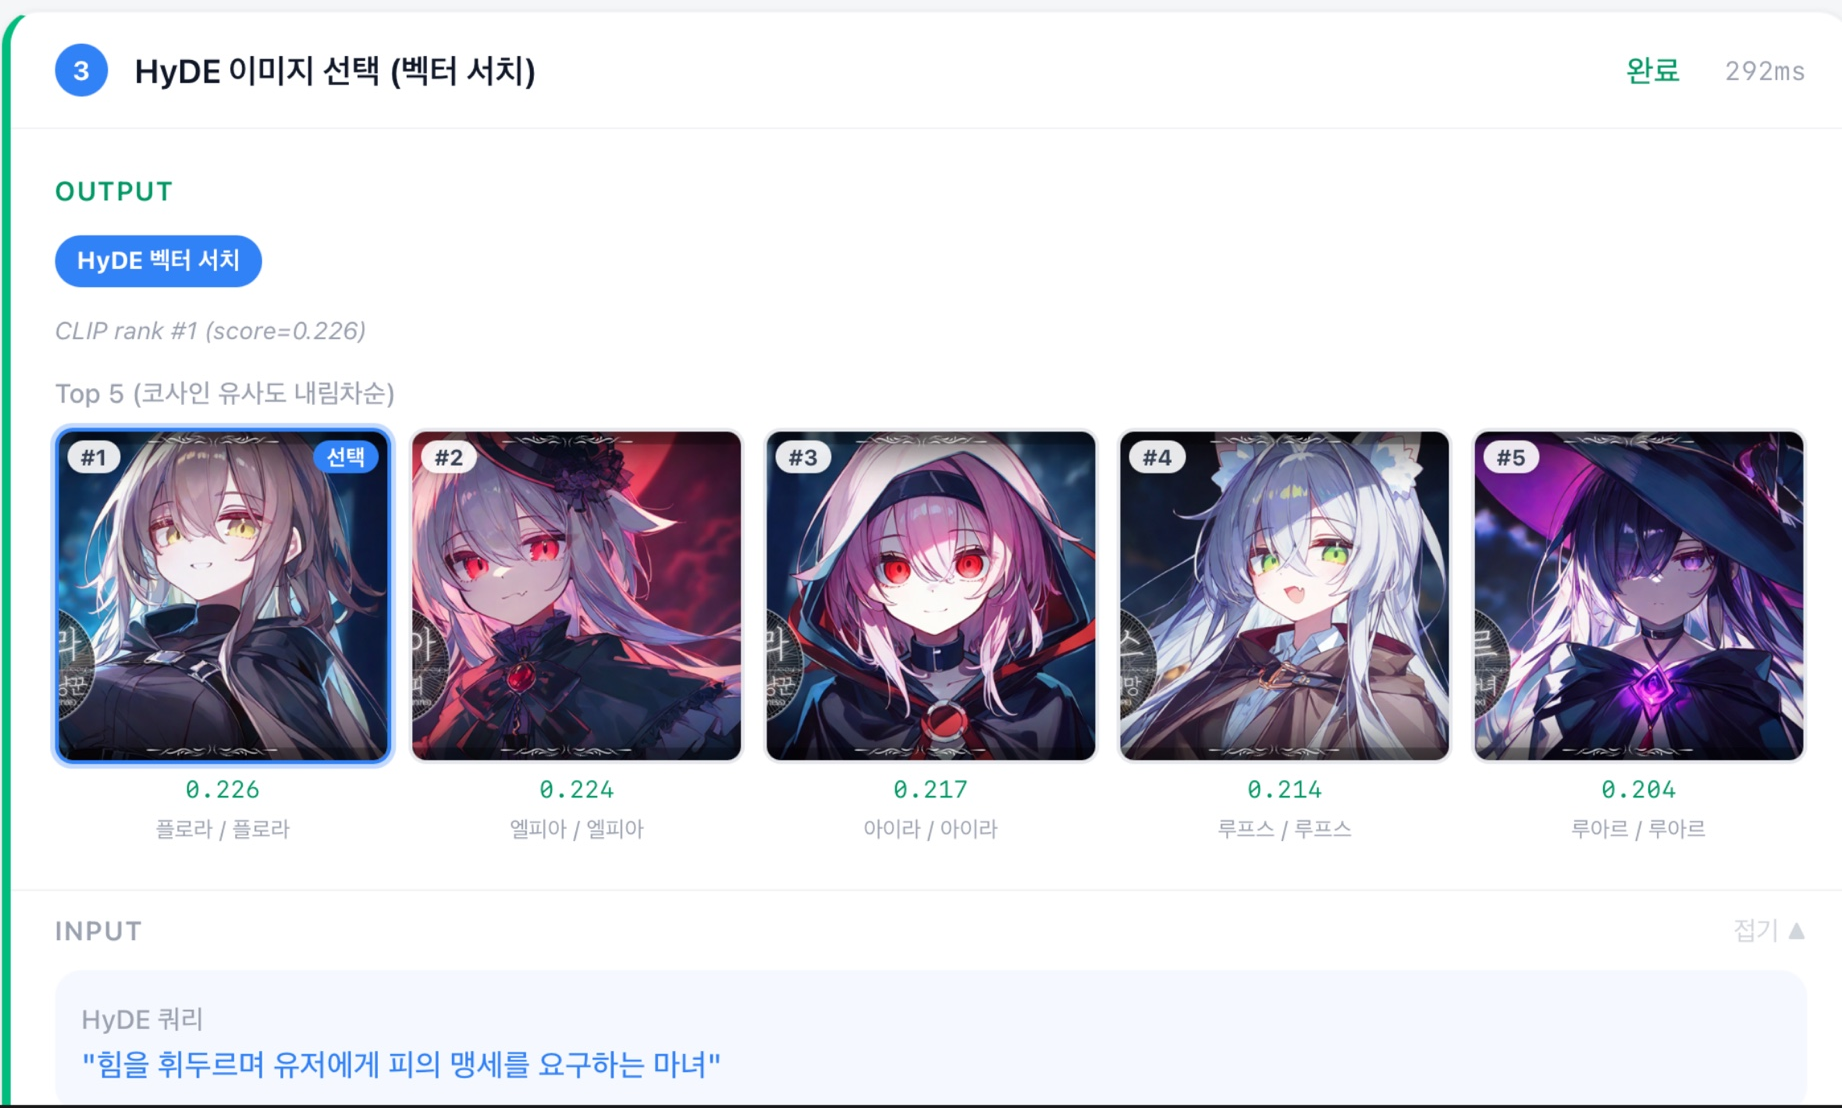
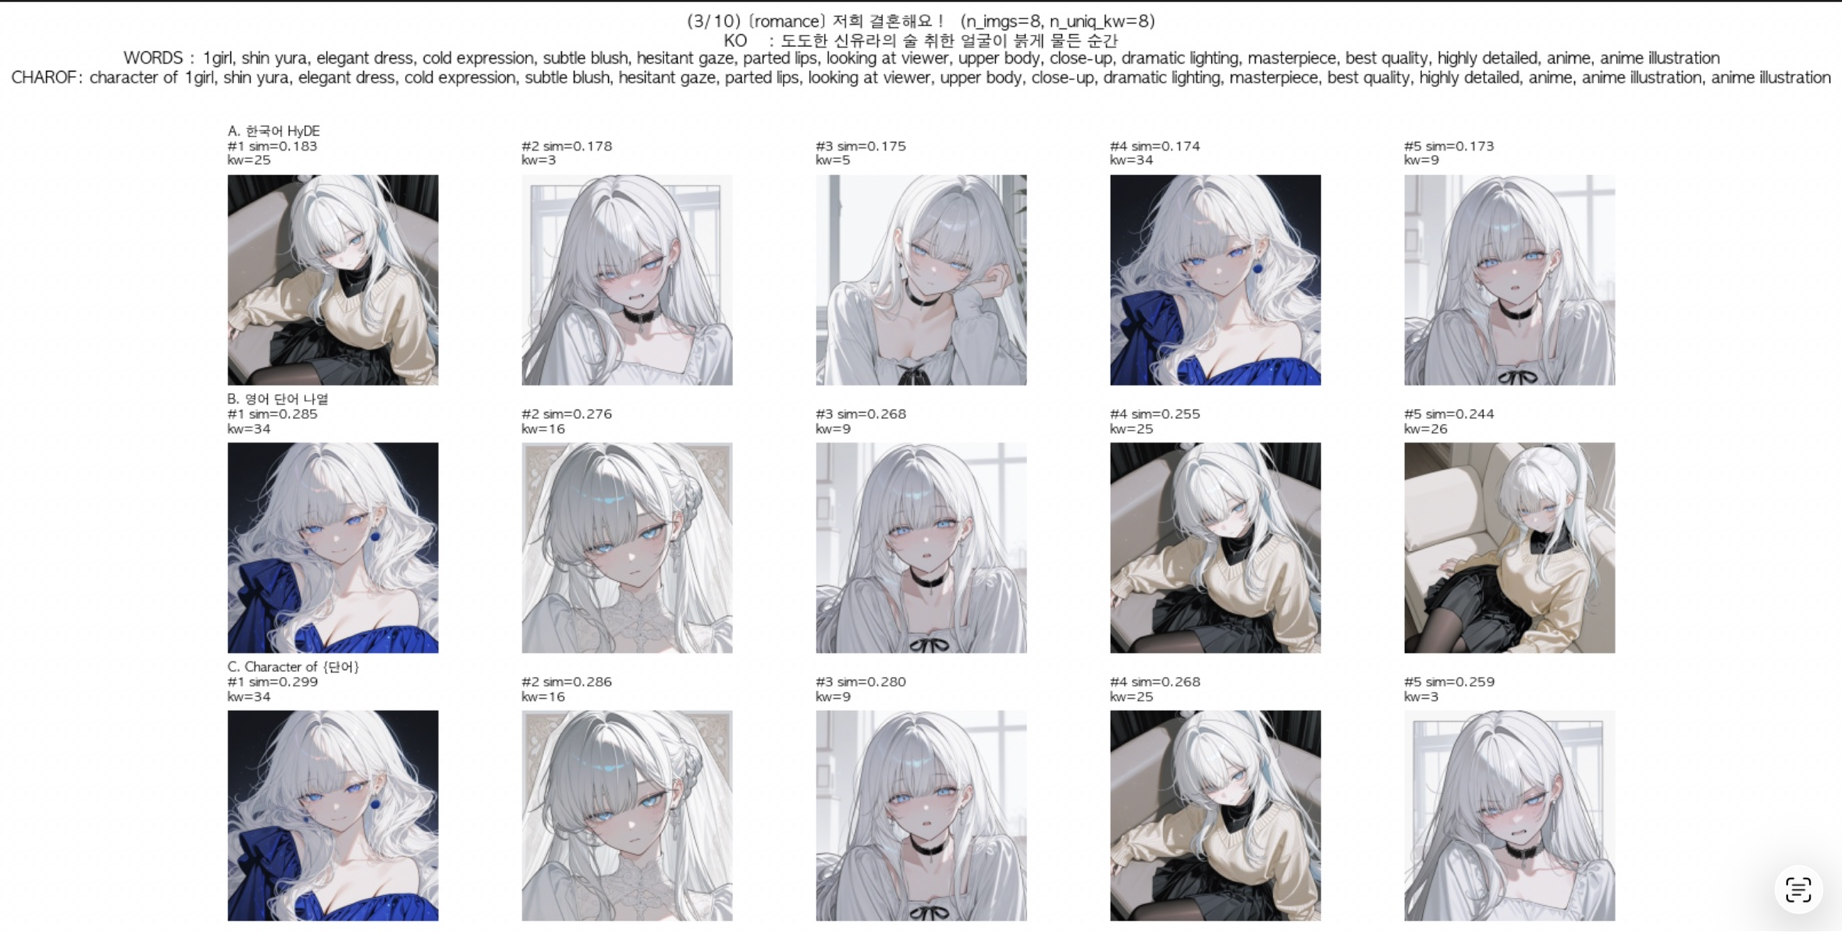
자동화에서는 잘못 남긴 이미지가 그대로 제작까지 갈 수 있어서, 쓸 수 있는 그림이 일부 빠지는 비용도 감수했다. 다만 모델 점수를 낮게 받았다는 사실만으로 그 이미지가 실제 광고에 부적합하다고 확정할 수는 없다. 필터가 무엇을 놓치고 무엇을 과하게 막는지 사례를 같이 확인해야 했다. 임베딩에는 `xlm-roberta-base-ViT-B-32`를 사용했다. 처음에는 한국 서비스인 크랙에서 개발했지만, 북미 OOC와 일본 캬라푸로 확장할 계획이 있었다. 처음부터 다국어 텍스트 인코더를 고려한 이유다. 이미지를 내려받지 못한 경우는 `fetch_status='failed'`로 남기고 생성 조회에서는 성공한 자산만 사용했다. ## 소구점을 그대로 검색하면 잘 맞지 않았다 소구점은 사람의 감정이나 관계를 설명하는 문장이다. '은밀한 집착' 같은 표현을 이미지 검색에 바로 넣으면 눈에 보이는 장면으로 대응하기 어렵다. 이런 추상적인 쿼리를 썼을 때 이미지들과의 코사인 유사도가 낮고, 상위 후보들 사이의 점수 차이도 작았다. 그래서 HyDE 시각 쿼리를 영어 단어 형태로 바꿨다. 머리색, 눈 색, 구도, 표정, 조명처럼 그림에서 확인할 수 있는 특징을 토큰으로 만들었다. 전처리의 소구점 JSON에 이 쿼리를 저장하고, 제작 단계에서는 이미지 벡터와 비교해 후보를 고른다. ![시각 쿼리와 이미지 후보를 CLIP 공간에서 비교해 선택하는 흐름](/assets/images/notion/cefa5d36983575afeaaf/12-image-retrieval-rendering.gif)
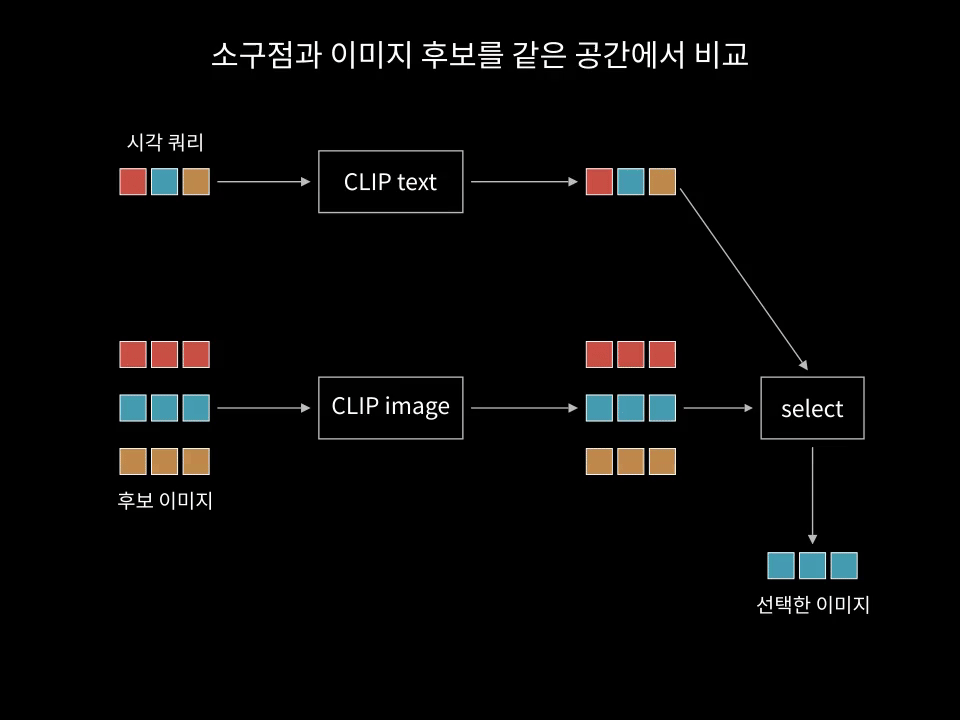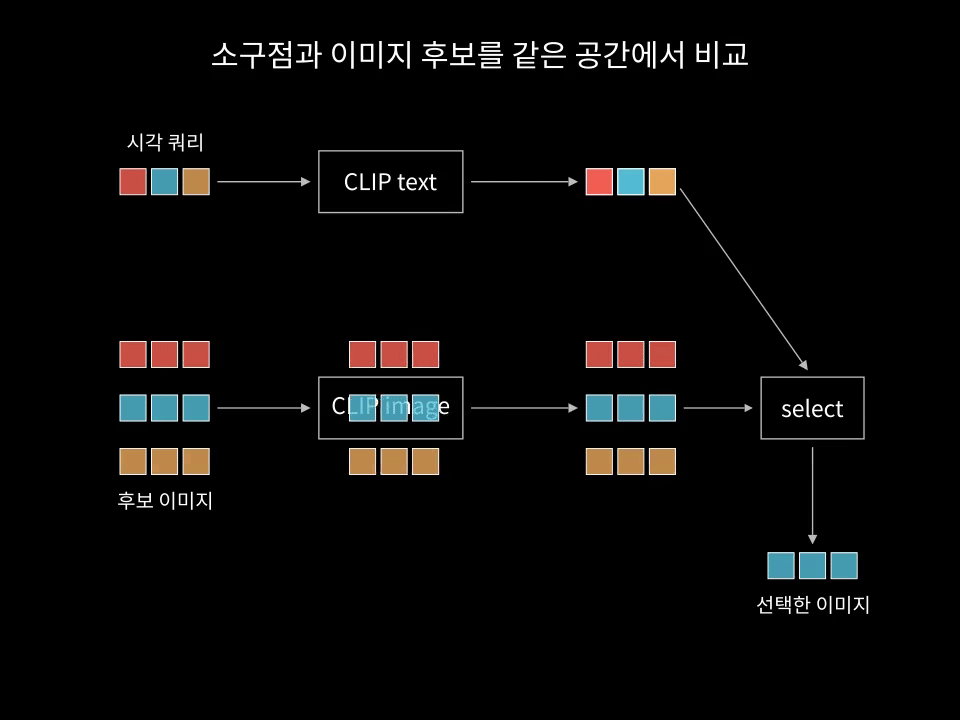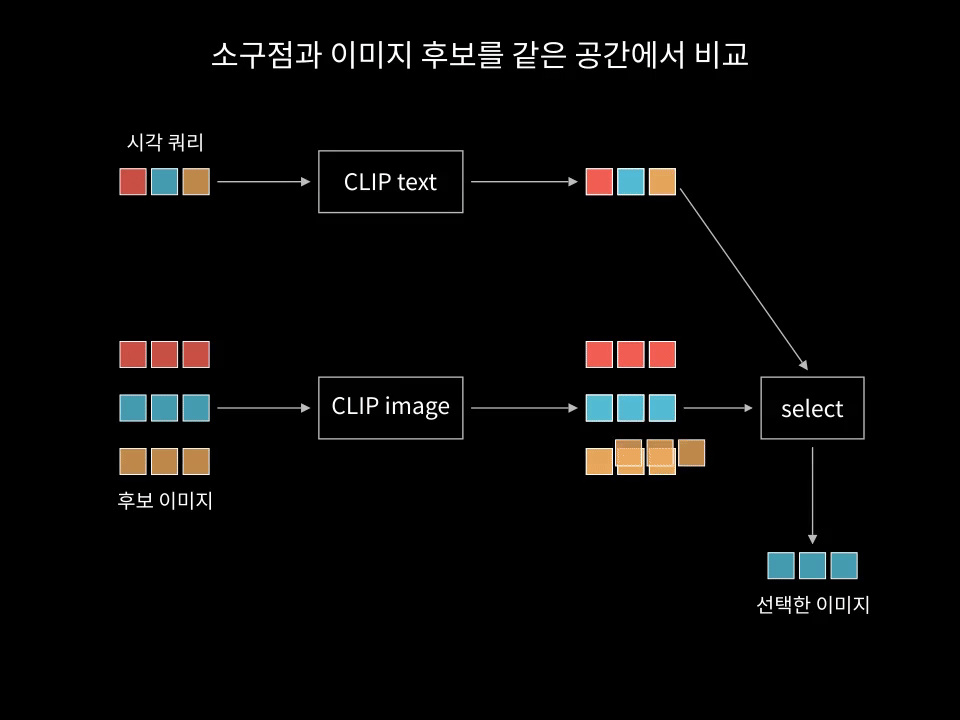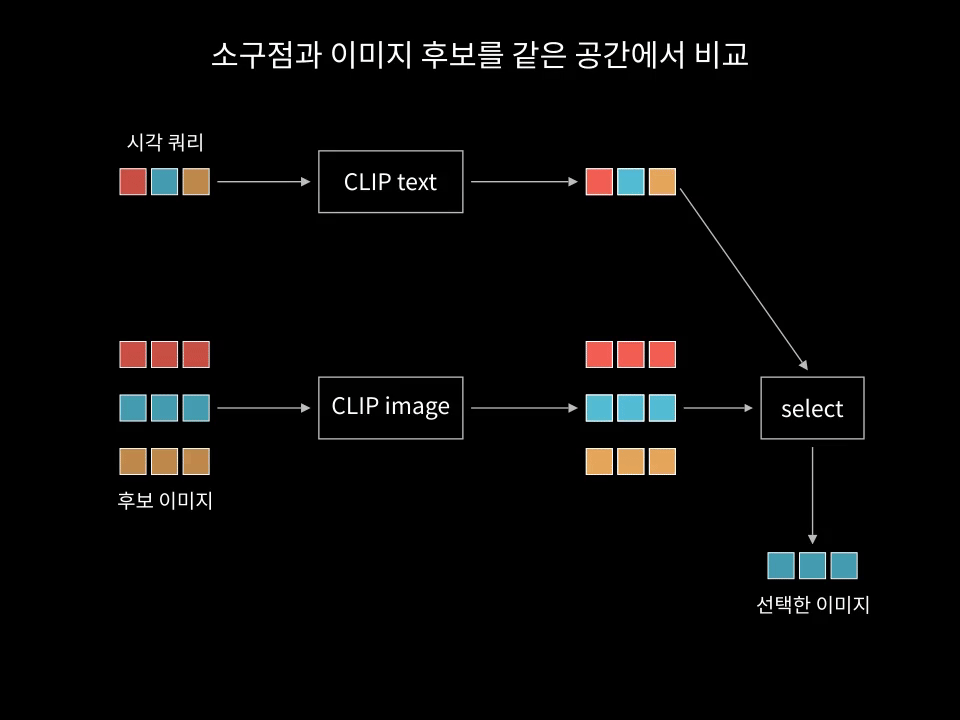
시각 쿼리와 이미지 후보를 CLIP 공간에서 비교해 선택하는 흐름

![소구점 시각 쿼리로 검색한 이미지 후보](/assets/images/notion/cefa5d36983575afeaaf/13-image-retrieval-rendering.png)

소구점 시각 쿼리로 검색한 이미지 후보

![쿼리별 이미지 검색 결과 비교](/assets/images/notion/cefa5d36983575afeaaf/14-image-retrieval-rendering.png)

쿼리별 이미지 검색 결과 비교

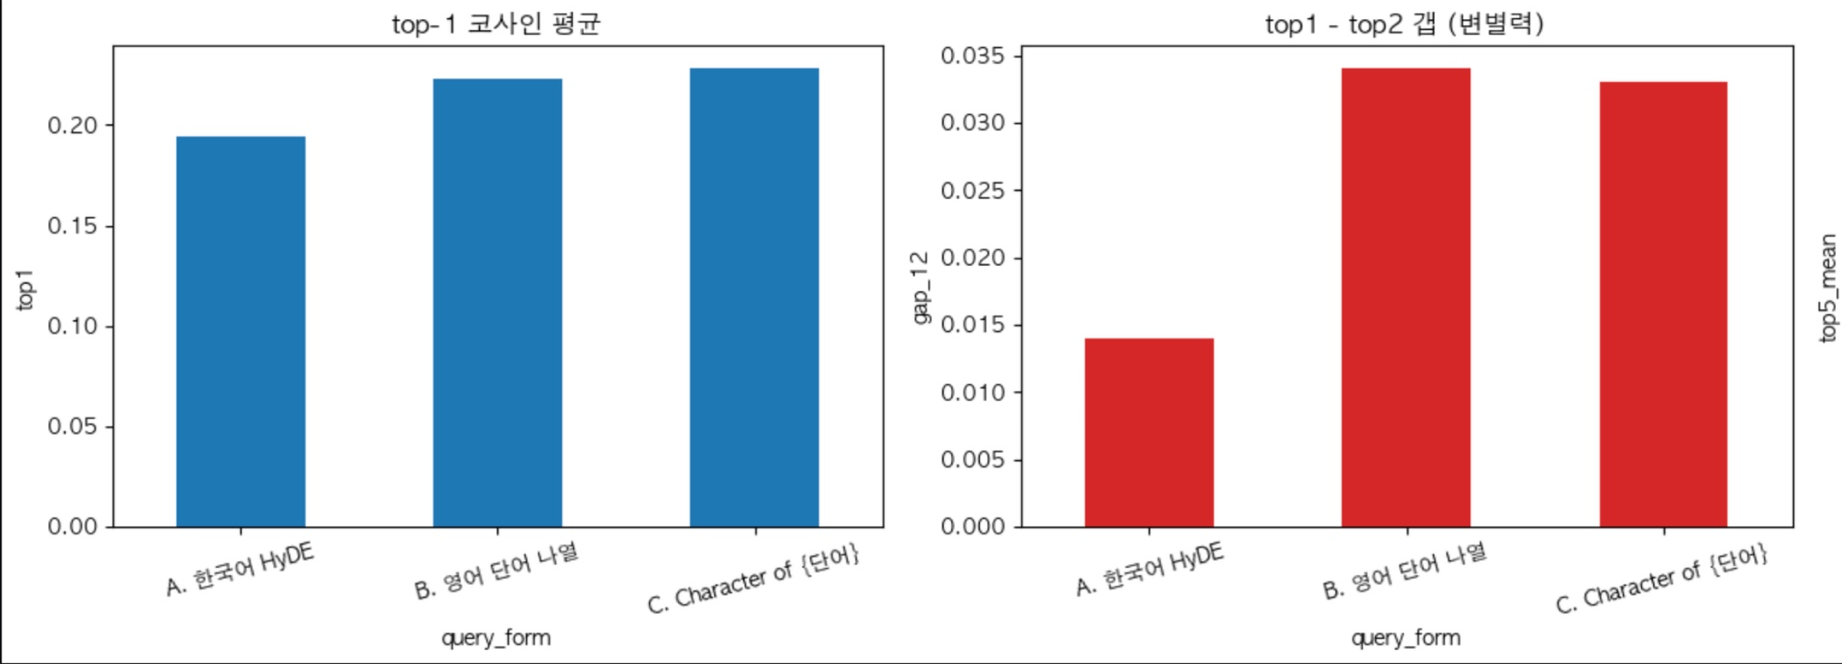
![단어형 쿼리의 점수와 후보 간 gap 비교](/assets/images/notion/cefa5d36983575afeaaf/15-image-retrieval-rendering.png)

단어형 쿼리의 점수와 후보 간 gap 비교

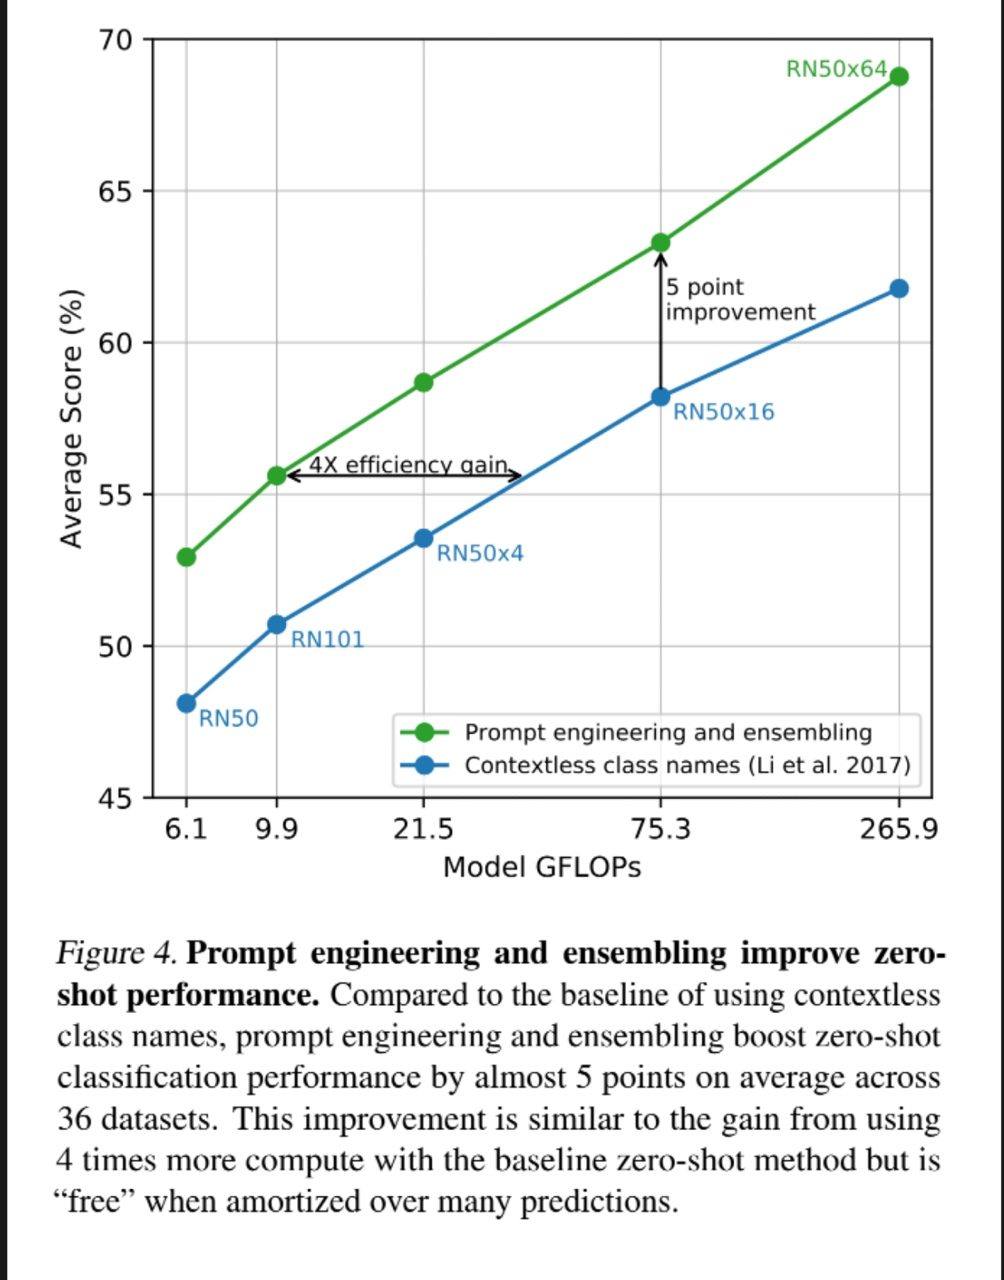
![CLIP 논문의 프롬프트별 ImageNet 성능 비교 — Radford et al., CLIP](/assets/images/notion/cefa5d36983575afeaaf/16-image-retrieval-rendering.png)

CLIP 논문의 프롬프트별 ImageNet 성능 비교 — Radford et al., CLIP
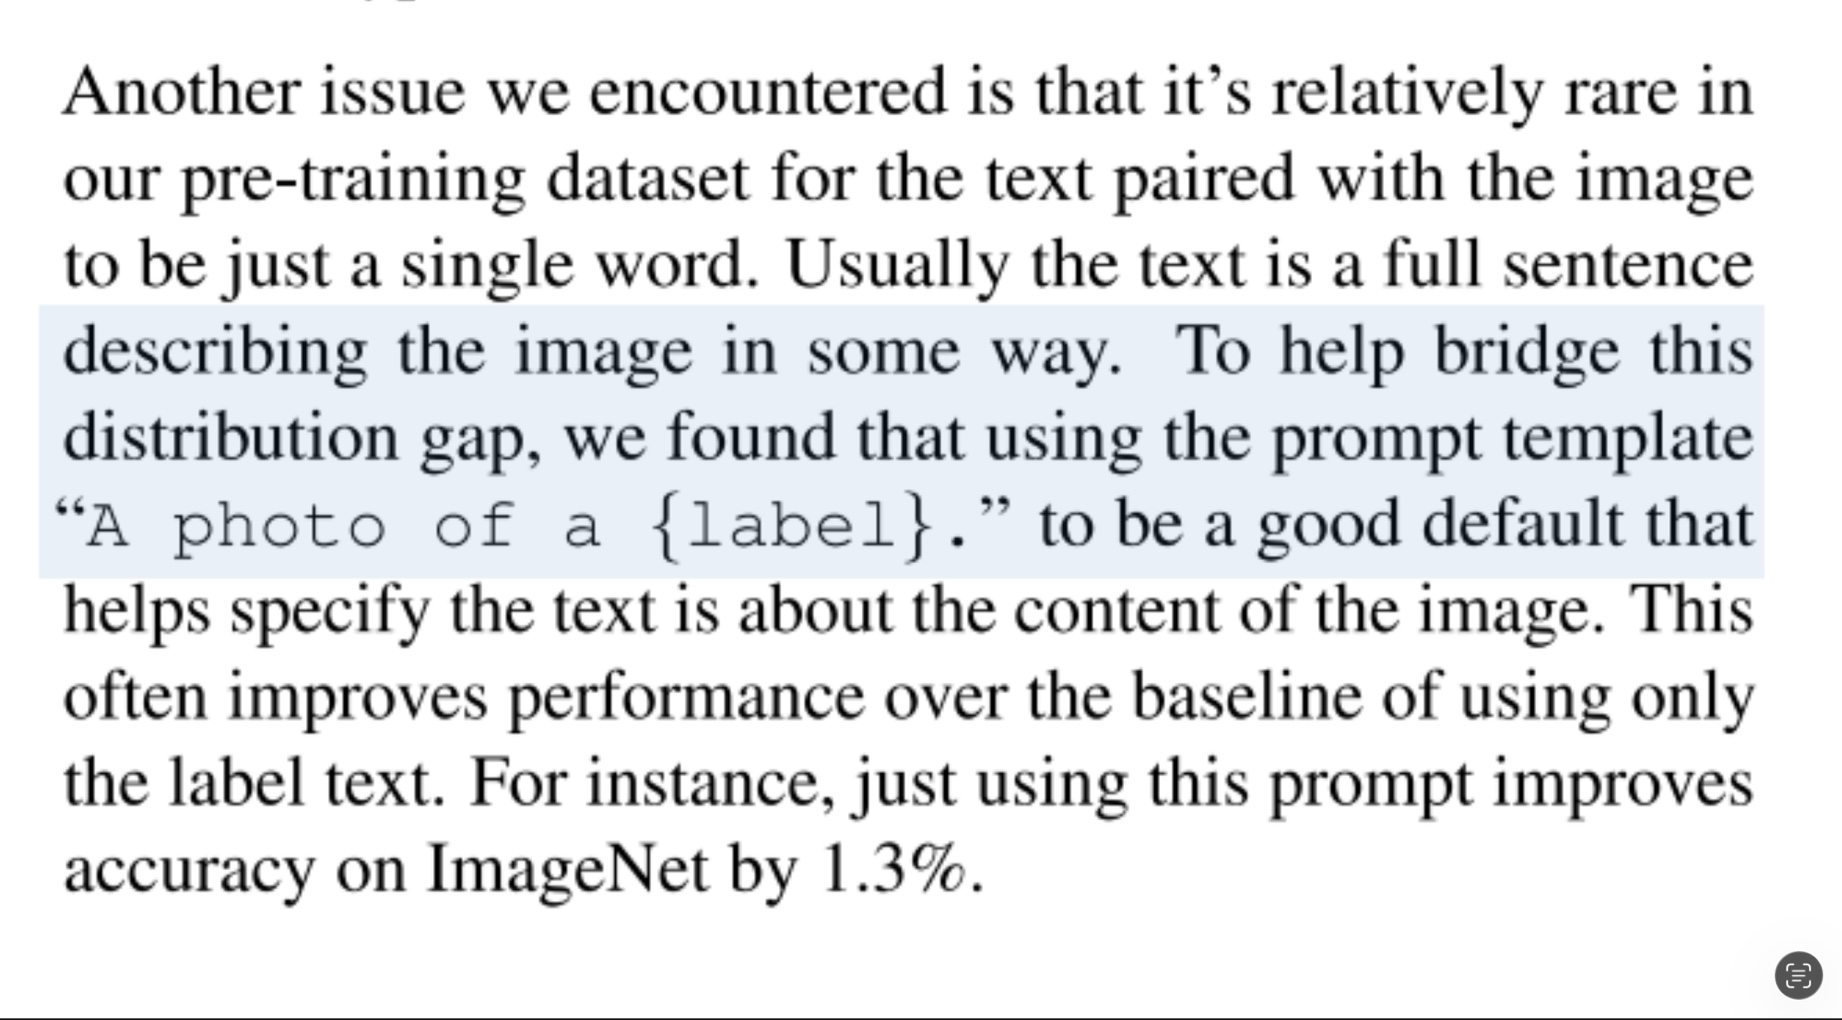
![CLIP 논문의 프롬프트 템플릿에 대한 설명 — Radford et al., CLIP](/assets/images/notion/cefa5d36983575afeaaf/17-image-retrieval-rendering.png)

CLIP 논문의 프롬프트 템플릿에 대한 설명 — Radford et al., CLIP

단어형 쿼리에서 코사인 점수와 Top1-Top2 gap이 커지는 경향은 있었다. 그렇지만 기대했던 만큼 크게 개선되지는 않았다. 이미지 에셋이 서로 다른 사물 사진처럼 다양하지 않고, 대부분 같은 캐릭터의 구도 차이였기 때문이라고 추정했다. 점수가 올랐다고 실제로 더 적절한 그림을 골랐다고 단정할 수는 없다. 검색 결과를 눈으로 같이 봐야 했다. 프롬프트를 바꾸는 것만으로 해결할 수 있는 범위가 어느 정도인지 확인한 실험이었다. 소구점마다 CLIP top-1 이미지를 선택하되, 앞의 소구점에서 이미 쓴 그림은 누적해서 제외했다. 서로 다른 카피를 만들었는데 같은 그림만 반복해서 나오는 것도 줄여야 했다. ## 선택한 그림을 실제 파일로 만들기 이미지 배너 렌더링에는 여러 단계가 들어갔다. 원본에 박힌 글자를 제거하고, 필요한 효과를 넣고, 세로 이미지를 가로 캔버스로 확장한다. 그런 다음 얼굴을 찾고, 카피·폰트·색상·그림을 렌더 상태로 조립한다. ![이미지 배너 제작 파이프라인](/assets/images/notion/cefa5d36983575afeaaf/18-image-retrieval-rendering.png)
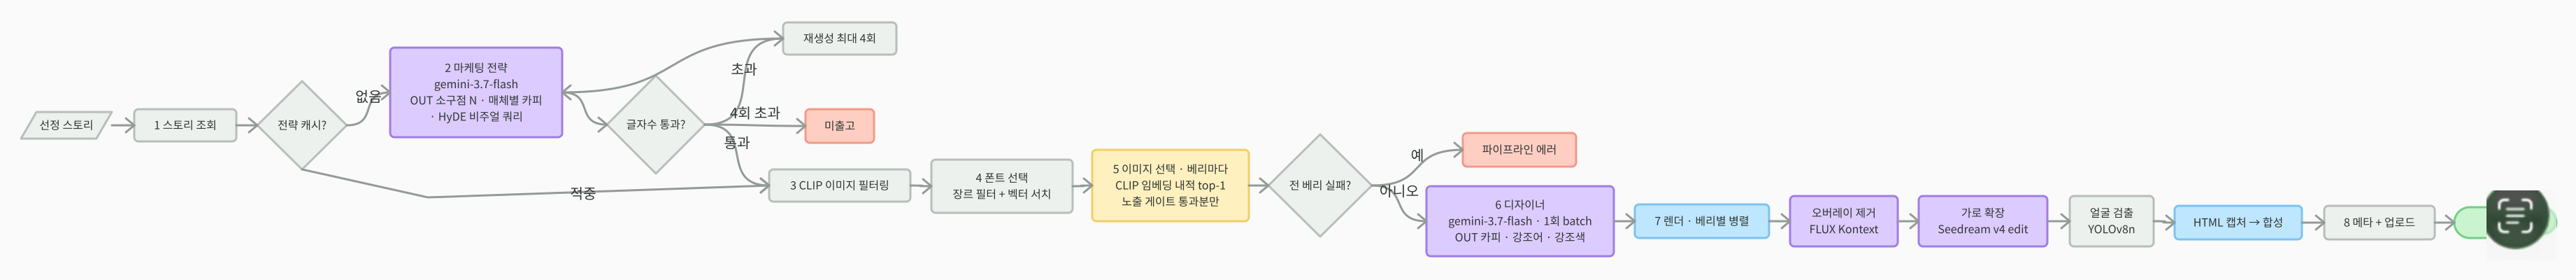
이미지 배너 제작 파이프라인

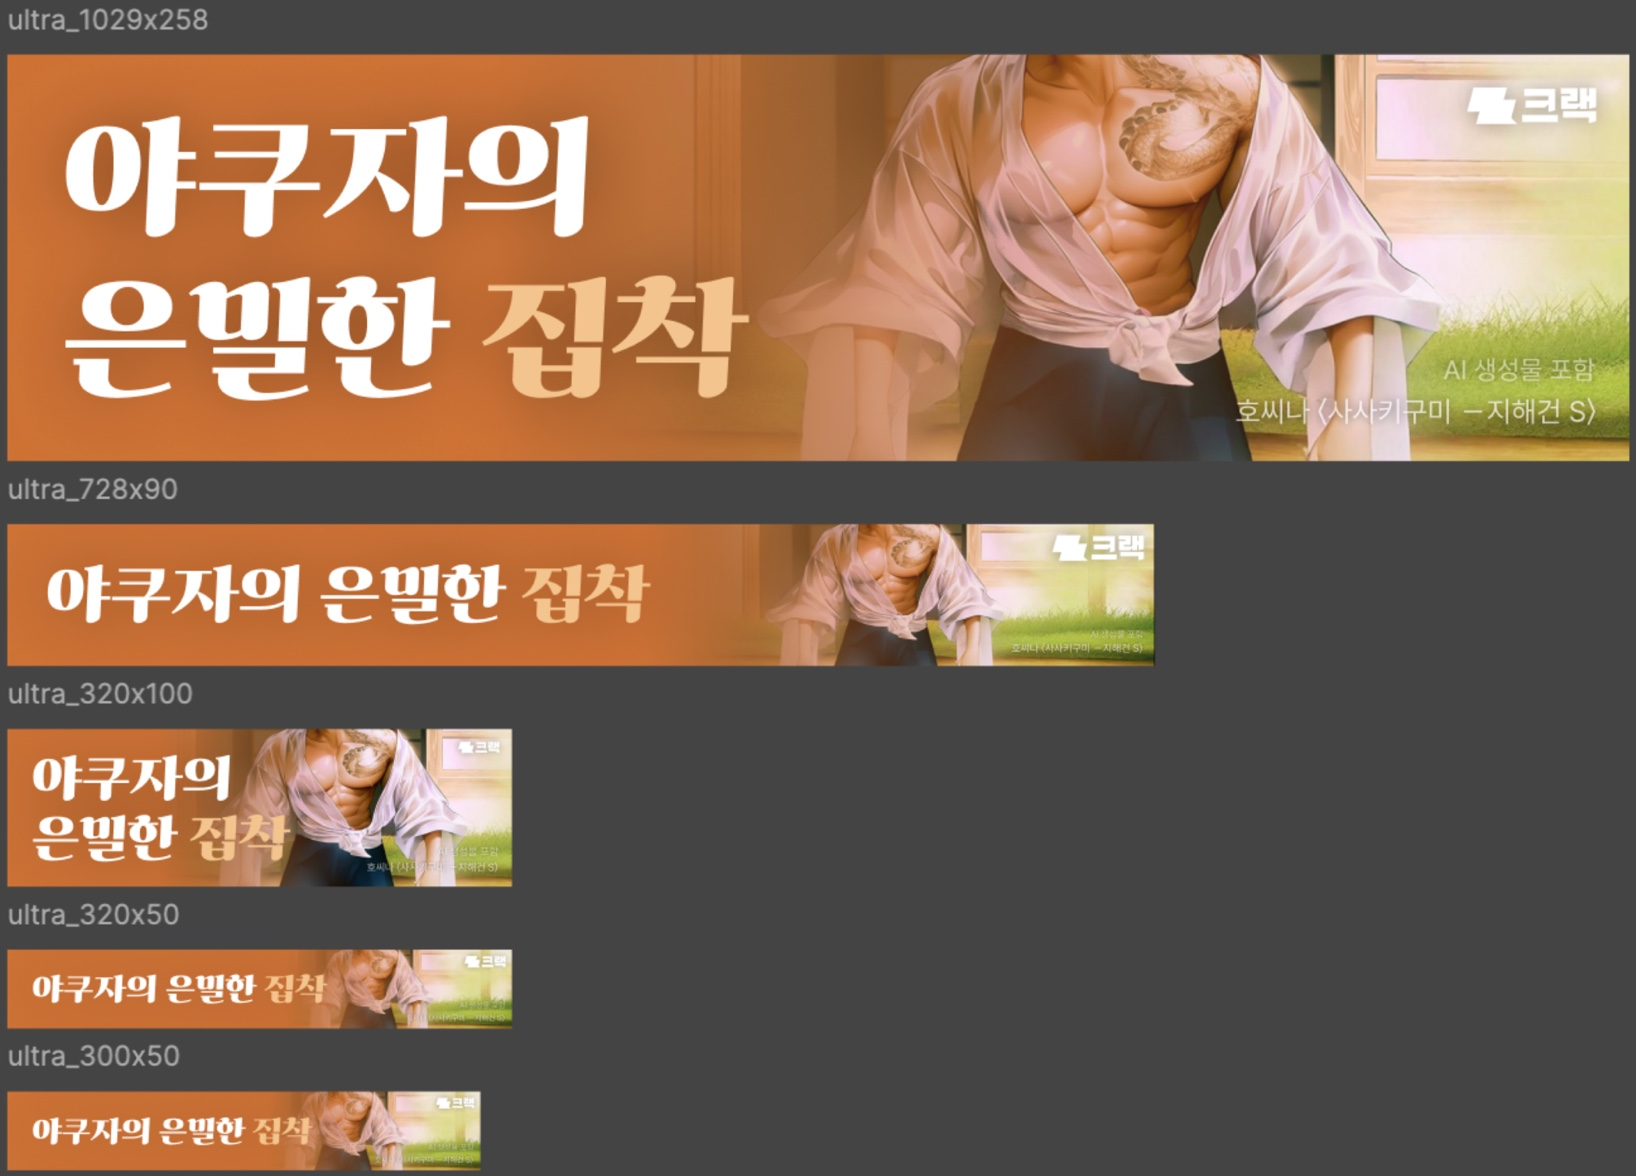
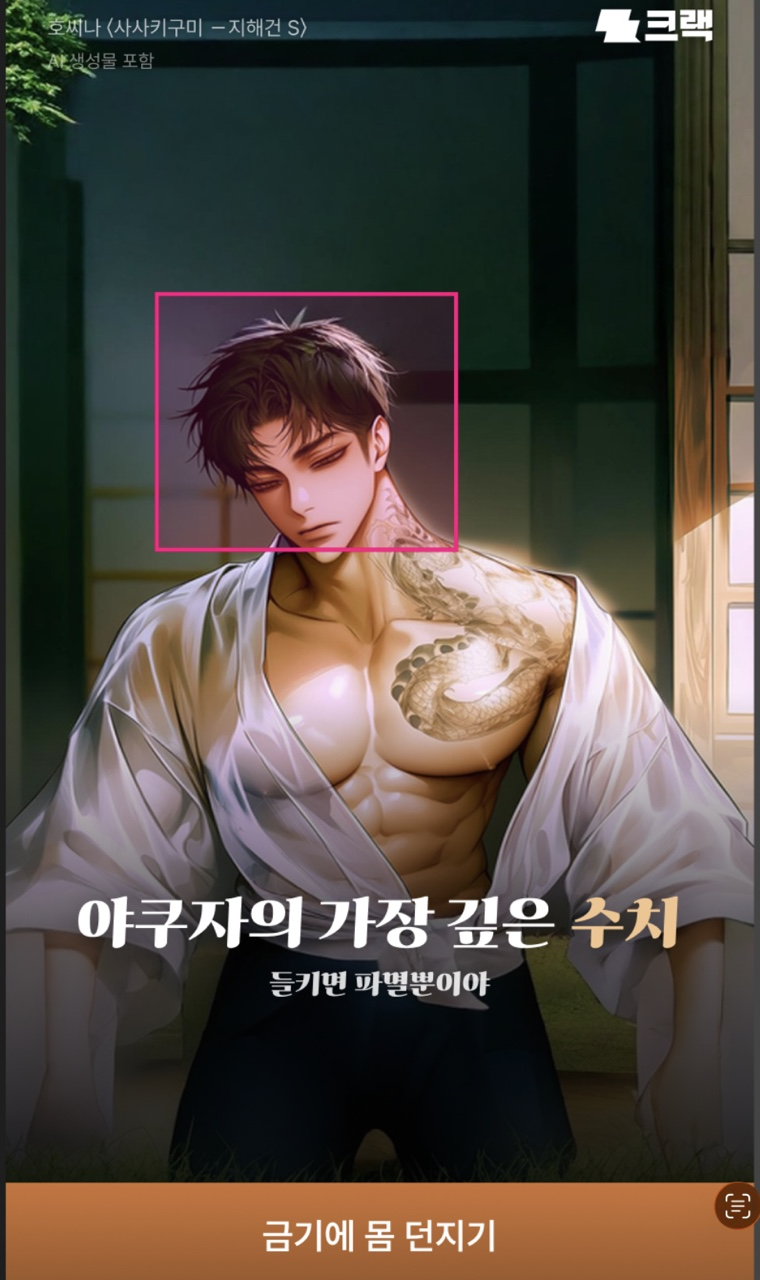
| # | 단계 | 무엇을 하나 | 산출·캐시 | | --- | --- | --- | --- | | ① | 오버레이 텍스트 제거 | 원본 그림에 박힌 글자를 FLUX Kontext로 지운다 | overlay_clean_{hash}.png · 실패는 원본으로 조용히 진행 | | ② | 임팩트 이펙트 (캬라푸) | 일본향 배너용 효과 선처리 | kyarapu_fx_pre_{hash}.png | | ③ | 가로 아웃페인팅 | 세로 그림을 4000×2000 캔버스로 확장 — 가로 배너 규격을 위해 | outpaint_v2_…_{hash}.png · DB에 캐시 | | ④ | 얼굴 검출 | 확장된 이미지에서 얼굴 좌표 검출 | image_assets.face | | ⑤ | state 조립 | 카피·폰트·색·이미지를 렌더러가 먹는 하나의 상태 객체로 | render state | | ⑥ | 캡처 | Chromium 하나 + 영속 컨텍스트 N개로 HTML을 2× 슈퍼샘플 캡처 | 1080×1920 원본 + 프리셋별 PNG | | ⑦ | 후처리 | 정확한 해상도로 다운샘플 + 500KB 이하로 압축 | {prefix}_{preset}.jpg | HTML을 Chromium으로 캡처한 뒤 매체별 해상도로 줄이고 파일 용량도 맞췄다. 같은 원본에 같은 처리를 반복하지 않도록 오버레이 제거와 아웃페인팅 결과는 캐시했다. 텍스트 제거에 실패하면 원본으로 진행하는 단계가 있는 반면, 아예 결과를 버려야 하는 생성 경로도 있다. 모든 실패에 똑같은 재시도 규칙을 쓰지는 않았다. ## 얼굴 검출 모델도 도메인을 맞춰야 했다 사이즈 베리에이션 로직은 얼굴 좌표를 기준으로 배치했다. 그래서 얼굴을 못 찾거나 엉뚱한 위치를 찾으면 가로·정사각 배너에서 캐릭터가 잘렸다. 실사 얼굴에 맞춰진 BlazeFace를 쓰다가, 애니메이션 도메인으로 학습한 YOLOv8 nano 기반 모델로 바꿨다. | 모델명 | BlazeFace | face_detect_v0_n(YOLOv8 nano) | | --- | --- | --- | | 학습 도메인 | 실사 인물 사진 (Google open dataset) | Anime 일러스트 | | 파라미터수 | 110k | 3.01M | | 모델 사이즈 | ~250KB | 12.1MB | ![얼굴 좌표를 활용한 세로 배너](/assets/images/notion/cefa5d36983575afeaaf/19-image-retrieval-rendering.png)
얼굴 좌표를 활용한 세로 배너

![얼굴 기준의 규격별 배너 베리에이션](/assets/images/notion/cefa5d36983575afeaaf/20-image-retrieval-rendering.png)

얼굴 기준의 규격별 배너 베리에이션

![다른 이미지에 적용한 얼굴 기준 배치](/assets/images/notion/cefa5d36983575afeaaf/21-image-retrieval-rendering.png)

다른 이미지에 적용한 얼굴 기준 배치

![규격 변경 후 캐릭터 배치 사례](/assets/images/notion/cefa5d36983575afeaaf/22-image-retrieval-rendering.png)

규격 변경 후 캐릭터 배치 사례

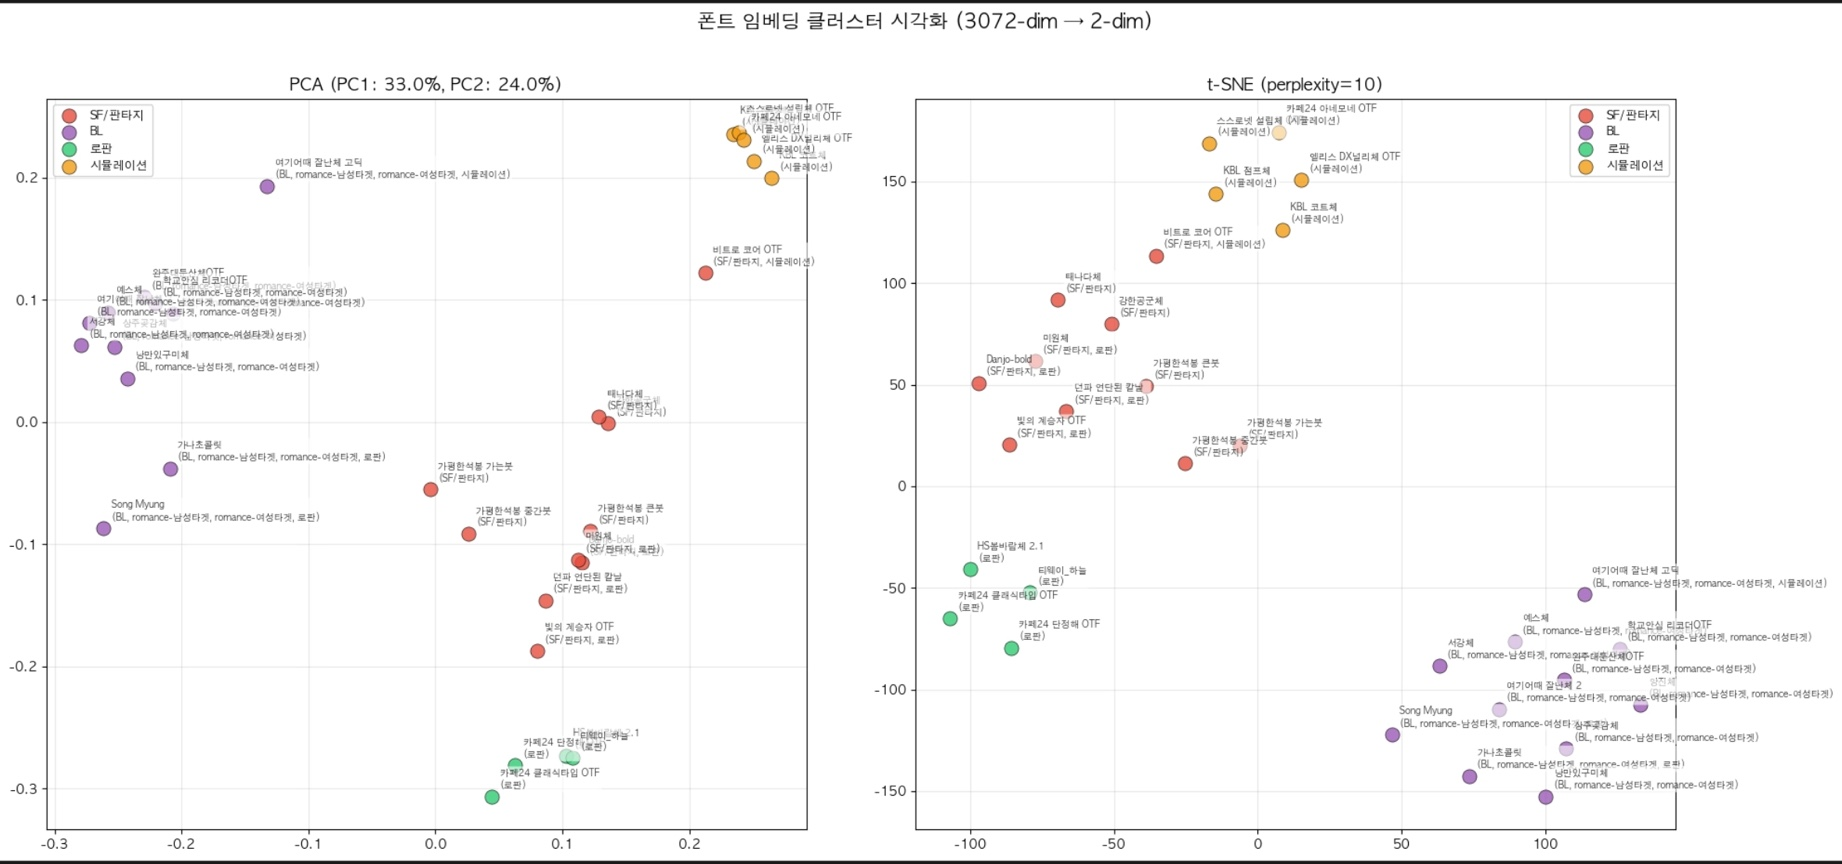
교체 후 얼굴 인식과 배너 오류 사례가 개선됐다. 모델의 크기는 더 커졌지만, 우리가 입력으로 넣는 그림은 실사 얼굴이 아니라 애니메이션 캐릭터였다. 이 작업에서는 그 도메인에 맞는 검출 결과가 후속 배치의 기준이 된다. 모델이 가볍다는 장점만 보고 선택할 수는 없었다. ## 폰트도 검색 대상으로 만들었다 디자이너분이 전달해 주신 폰트들을 임베딩하고, 작품의 장르와 소구점에 맞는 폰트를 벡터 검색으로 고르는 흐름을 만들었다. 같은 카피라도 어떤 폰트를 쓰느냐에 따라 분위기가 다르기 때문이다. 생성 단계에서 저장한 이상적인 폰트 샘플 문장도 이 선택에 연결했다. ![폰트 선택 파이프라인](/assets/images/notion/cefa5d36983575afeaaf/23-image-retrieval-rendering.png)
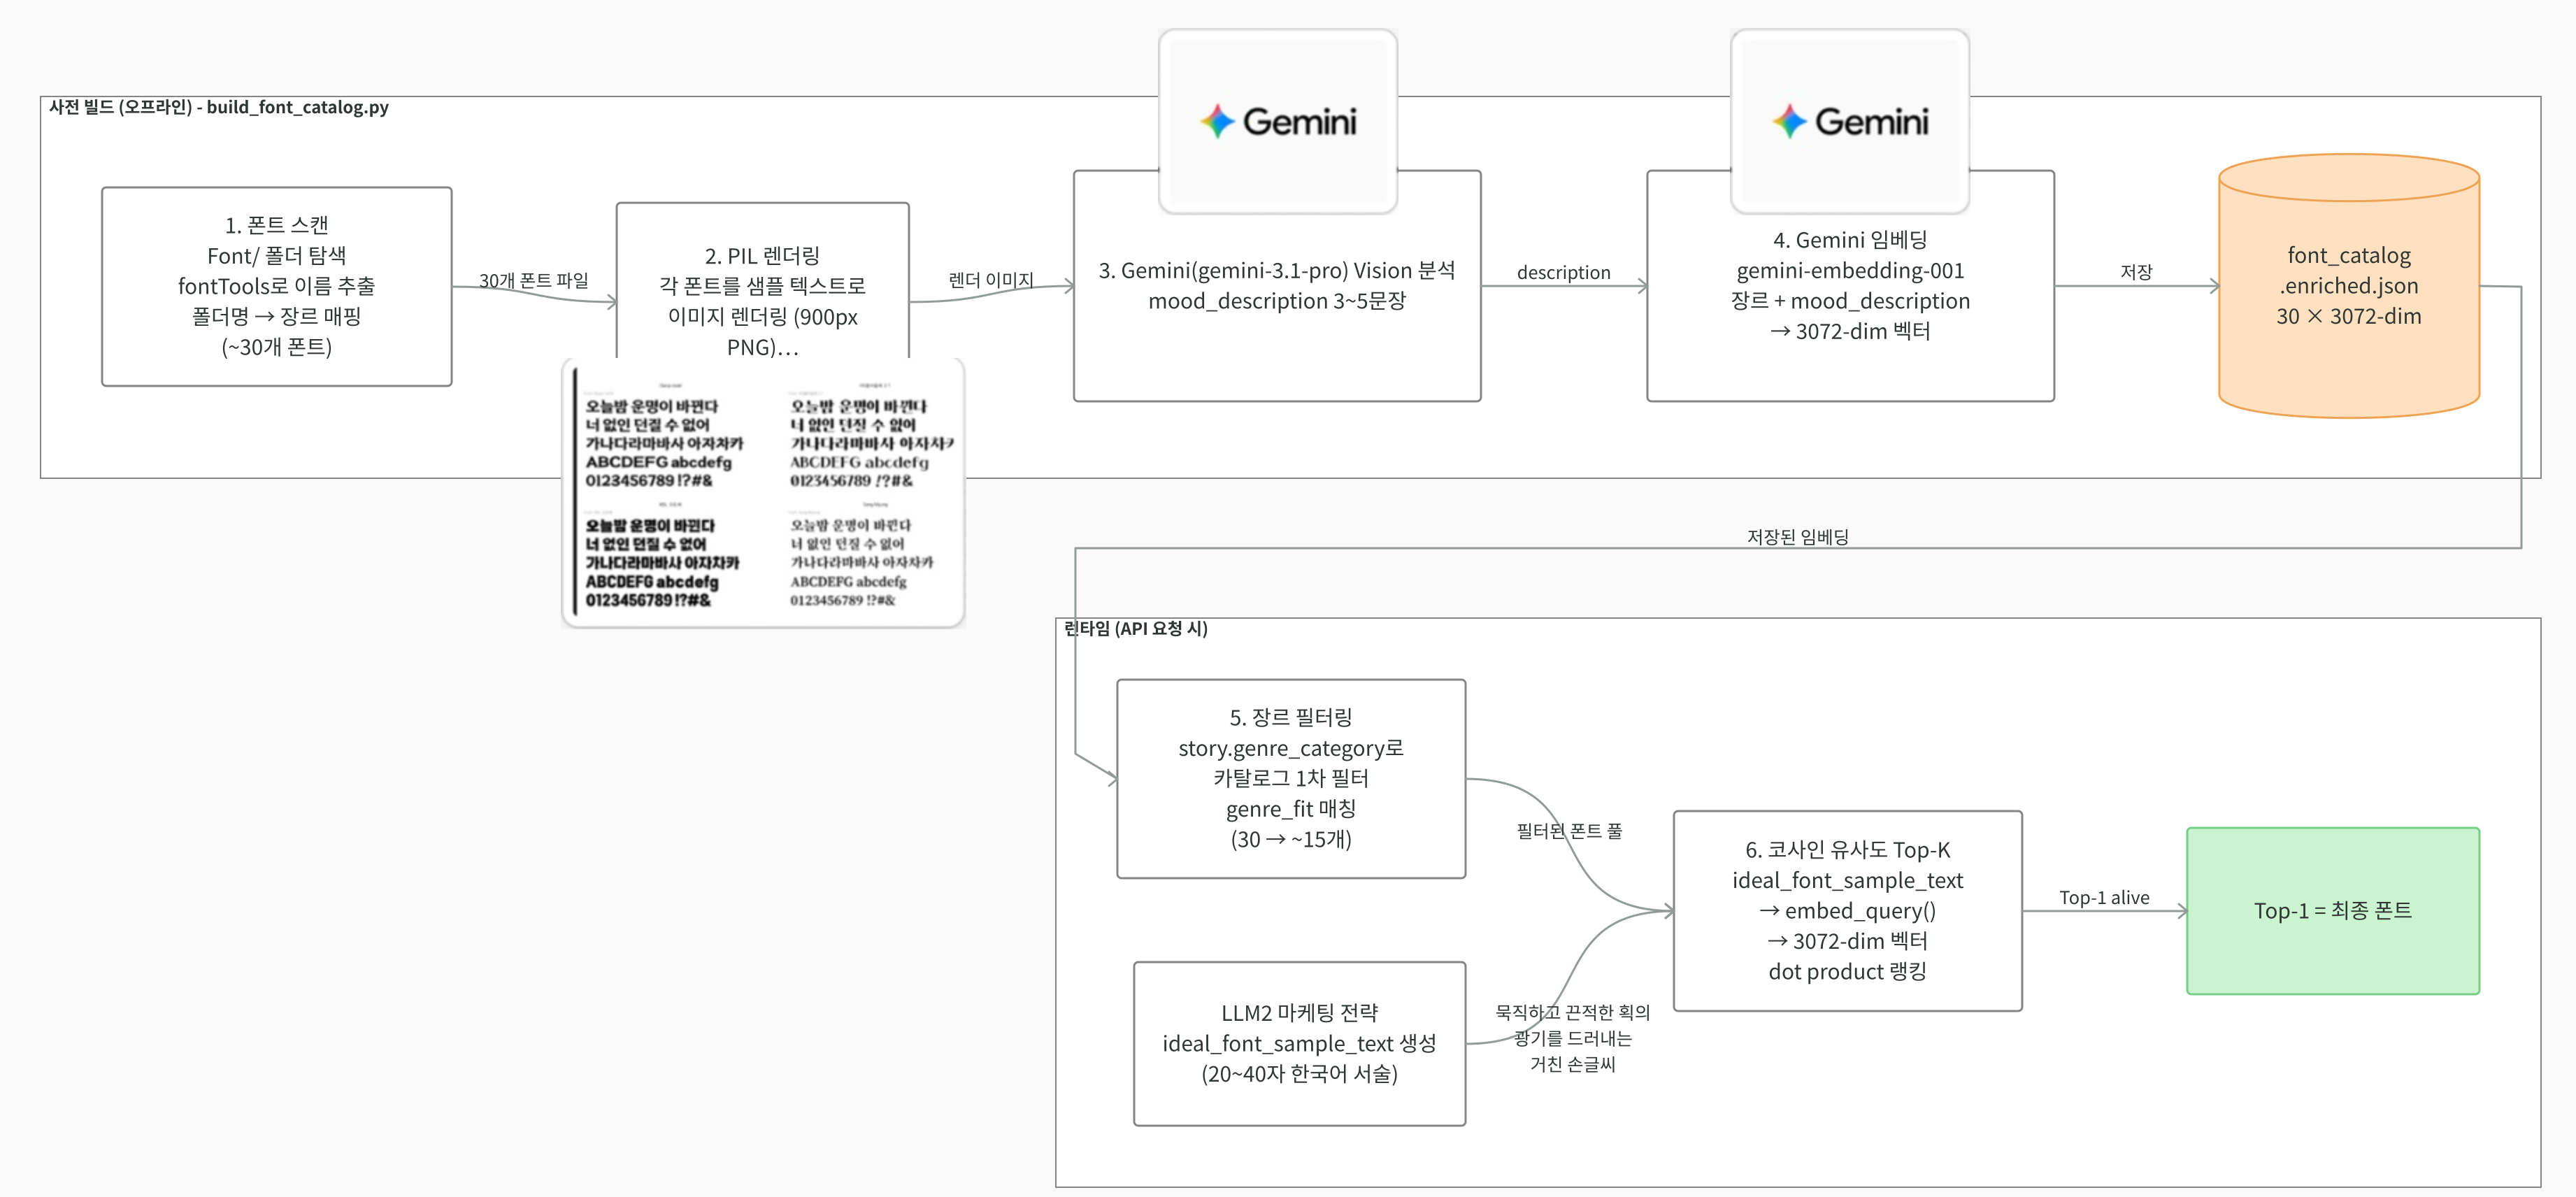
폰트 선택 파이프라인

![폰트 임베딩의 장르별 분포](/assets/images/notion/cefa5d36983575afeaaf/24-image-retrieval-rendering.png)

폰트 임베딩의 장르별 분포

임베딩을 보면 장르별로 폰트가 어느 정도 군집을 이뤘다. 같은 장르 안에서는 비슷한 폰트를 고를 수도 있겠다는 생각이 들었지만, 군집이 나뉘는 것과 실제 배너에서 잘 읽히는 것은 따로 봐야 했다. 플레이그라운드에서 기존 광고와 비교하고 정성적인 피드백을 반영하는 방향으로 고도화했다. 이미지 검색, 얼굴 검출, 폰트 선택은 각각 다른 모델의 결과지만 마지막에는 배너 한 장에서 만난다. 중간 점수가 좋아도 얼굴이 잘리거나 카피가 읽히지 않으면 쓸 수 없다. 그래서 개별 단계의 점수와 완성된 배너의 오류 사례를 함께 보면서 바꿔 나갔다. 본문의 데이터 흐름 애니메이션은 3Blue1Brown의 오픈소스 [Manim](https://github.com/3b1b/manim)에서 출발한 [Manim Community](https://www.manim.community/)로 만들었다. ### 하나의 스토리에서 이미지·영상·플레이어블 광고 만들기 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-04-creative-generation/ - Collection: Project - Published: 2026-10-12 - Tags: Project 스토리의 소구점과 이미지 자산을 정리한 뒤에는 표현할 수 있는 형식을 늘렸다. 정적 배너에 카피를 얹는 것부터 시작했지만, 같은 스토리를 짧은 모션 영상으로 보여줄 수도 있고, 읽히는 롱폼이나 직접 선택하는 플레이어블로 만들 수도 있었다. 형식이 늘어날수록 모든 것을 생성 모델에 한 번에 맡기기는 어려웠다. 어떤 단계는 모델이 기획하고, 어떤 단계는 코드가 결정적으로 조립하며, 비용이 큰 생성 앞에는 사람이 확인하는 지점을 두는 식으로 경로를 나눴다. ## 공통 기획과 형식별 제작 공통 입력은 스토리 정보, `strategy_json`, 이미지 자산이었다. 이 중 훅 포인트와 타깃 감정, 소구점, CTA 방향은 형식이 달라져도 유지한다. 정적 배너의 입력은 아래처럼 구성했다.
strategy_json소구점 N개 · 훅 포인트 · HyDE 비주얼 쿼리 · 이상적 폰트 샘플 문장.
image_assetsCLIP 통과 이미지 + 임베딩. 이미지 선택에 LLM은 쓰지 않는다 — Stage 2가 만든 HyDE 쿼리를 CLIP으로 임베딩해 이미지 벡터와 비교하고 가장 유사한 이미지를 고른다 (= CLIP top-1). 소구점마다 다른 그림이 뽑히도록 이미 쓴 이미지를 누적 제외한다.
폰트 카탈로그장르·소구점 임베딩으로 고른다.
카피 폼대사형 · 액션형 · 상황형 3폼. 언어별로 프롬프트 원본 파일이 따로 있고, 그 파일 하나가 유일한 기준이다.
```yaml AGENTS/APPEAL_EMBEDDER.PY · STRATEGY_SYSTEM_INSTRUCTION (크랙 원문) 너는 모바일 앱 퍼포먼스 마케팅 전략가야. 크랙 앱의 캐릭터챗 콘텐츠를 타겟(여성향/남성향, 장르별 서브컬처)에 맞춰 광고 소재화하는 전문가야. 소구점은 스토리의 세계관·줄거리·장르 태그(11축)·유저 댓글을 종합해서 도출해 — 어느 한 신호에도 과의존하지 마. 특히 댓글은 '있으면 참고'하는 보조 신호일 뿐이야: 댓글이 없거나, 수가 적거나, 뻘글(무의미한 반응)만 있는 스토리가 많기 때문에, 댓글이 빈약하면 세계관·장르 컨벤션·캐릭터 설정·태그만으로 충분히 소구점을 도출하고 뻘글에 휘둘리지 마. 추상어·일반론 금지. 구체적인 캐릭터성·관계성·장면이 드러나야 해. CTR과 전환율을 높이는 것이 최우선 목표야. ``` 이미지 광고에서 카피는 배너 이미지 위에 텍스트 오버레이로 얹는 문구다. 검색으로 그림을 선택하고 카피와 폰트를 얹으면, 배너 렌더러가 규격별 결과물을 만든다. 이 과정은 앞 글에서 정리했다. 모션이나 롱폼으로 확장할 때는 이 입력을 그대로 복사하는 게 아니라, 해당 형식에서 무엇을 보여줄지 다시 기획했다. ## 7초 모션: 먼저 그림에 무엇이 있는지 읽기 모션화는 배너 그림 한 장을 스토리 정보에 맞춰 움직이는 방식이었다. 처음부터 인물 동작을 지어내게 하기 전에, 비전 LLM이 `scene_read`로 이미지에 실제로 보이는 것을 적게 했다. 그 내용을 바탕으로 0~1.5초, 1.5~3.5초, 3.5~5초, 5~7초의 구간별 스토리보드를 만든다. ![7초 모션 영상 제작 흐름](/assets/images/notion/1bcbb67d0be297ea92ee/01-creative-generation.png)

7초 모션 영상 제작 흐름

구간에는 인물 동작뿐 아니라 신체 역학, 지속되는 움직임, 표정, 카메라 워크, 효과음이 들어갔다. 이 구조화된 결과를 i2v 프롬프트로 펼치는 단계는 LLM을 다시 호출하지 않고 코드로 처리했다. 기획에서 이미 정해진 구간을 재해석할 필요가 없어서였다. ```yaml 정규화 장르 (13슬러그): {슬러그} 캐릭터 속성: {tag_character_attribute} 대표 대사: {simple_description} 줄거리: {content_summary} [소구점] 훅포인트 / 타깃 감정 / 어필 포인트 / CTA 방향 세계관(발췌, 1500字) ``` ```yaml scene_read: "Akari stands angled in a low-angle perspective against a blood moon in a red sky, wearing black lacquered armor plates over a dark outfit." scene_concept: "Under the blood moon, Akari shifts her grip on her katana with a cautious, resolute gaze down toward the viewer." audio_plan: "Howling high-altitude wind, distant rhythmic taiko drums, and the slide of a katana habaki locking inside its wooden scabbard." physics_notes: "The long black hair strands and thin crimson ribbon whip in the crosswinds while the rigid black armor plates stay firmly anchored." segments: - time_range: "0-1.5s" character_action: "Akari pivots her shoulders slightly toward the camera, thumb clicking the katana guard forward out of its scabbard by an inch." body_mechanics: "Starting in a three-quarters back stance, her core rotates 45 degrees toward the viewer while her right thumb levers the gold tsuba forward and her other hand steadies the scabbard." ``` ```plaintext [0-1.5s] {동작}; body mechanics: {신체 역학}; moving continuously through the entire segment; expression: {표정}; camera: {카메라}; sfx: {효과음}. [1.5-3.5s] ... [3.5-5s] ... [5-7s] ... Global camera direction: {전역 카메라 지시} One continuous take. Keep the character moving throughout the shot. No on-screen text, captions, subtitles, or watermarks. ``` 영상 입력에는 오버레이 제거본을 썼다. 예전에는 21:9로 확장한 이미지를 넣었는데, 세로 영상으로 cover-crop되면서 캐릭터가 잘려서 그 경로를 폐기했다. 9:16 영상은 한 번만 만들고 가로·정사각은 좌우를 채워 파생했다. 정책 차단이 발생하면 같은 프롬프트를 계속 고치기보다 다른 후보 이미지로 최대 네 장까지 시도했다. 오디오를 켰을 때 의도하지 않은 사람 음성이 나오면 발화 가드로 처리했다. 생성 모델의 결과가 요청한 조건과 완전히 같다고 가정할 수 없어서 후처리가 필요했다. ## 롱폼: 대본을 HTML 화면으로 구성하고 녹화하기 롱폼은 스토리를 읽히는 형식으로 재구성해 HTML 페이지를 만들고, 스크롤되는 화면을 녹화했다. 대본 모델에 세계관과 인물 정보를 주고 참고 이미지 여러 장도 함께 넣었다. 이미지는 중립적인 파일명으로 표시하고, 어떤 장면에 어떤 그림을 쓸지는 대본 안의 마커로 선택하게 했다. ![롱폼 대본 생성과 HTML 화면 구성·녹화 흐름](/assets/images/notion/1bcbb67d0be297ea92ee/02-creative-generation.png)
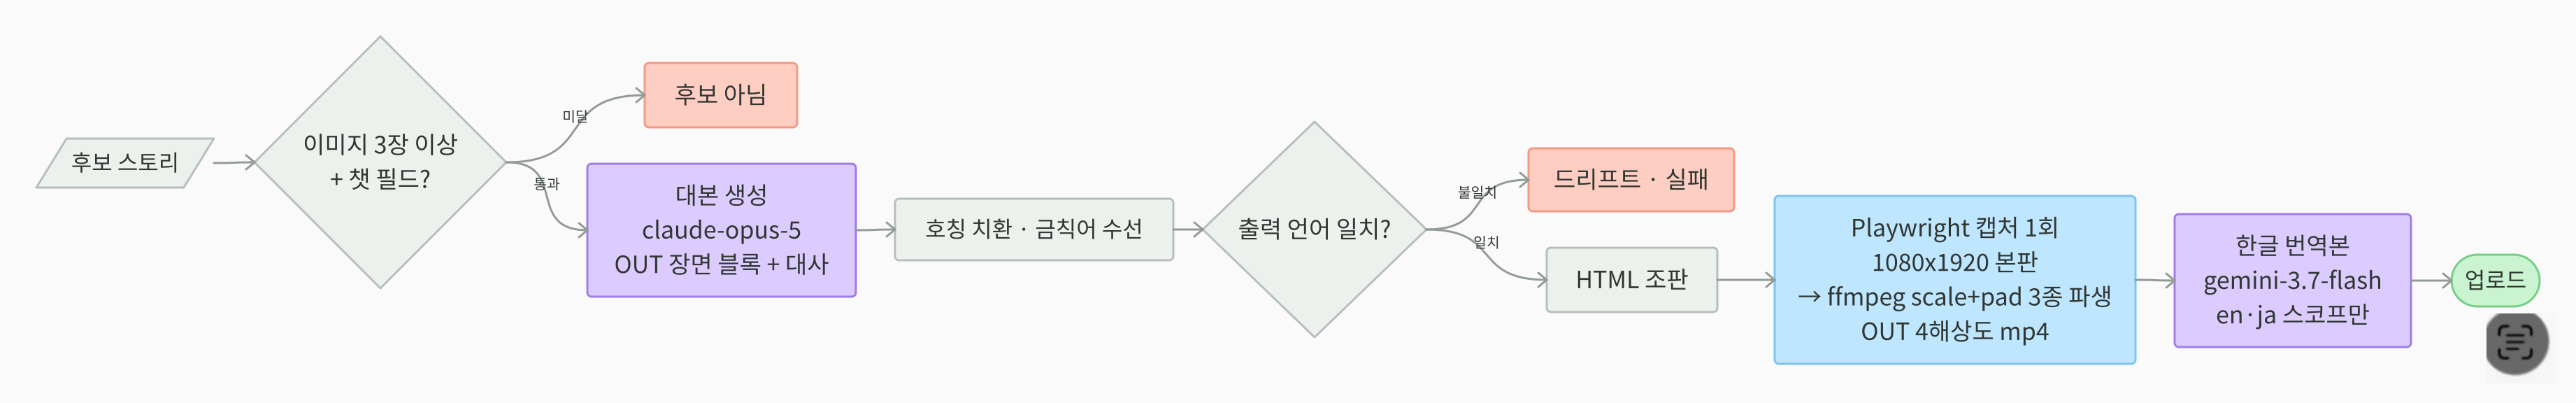
롱폼 대본 생성과 HTML 화면 구성·녹화 흐름

```yaml [S] 장면 블록 - 상황 서술 [U] 유저(시청자) 발화 블록 N 나레이션 D 대사 H 하이라이트 P 사진 배치 예: P img_3.jpg ← 참고 이미지를 그 장면에 배치 · 첫 [S] 블록 = 후킹 정점 장면이고, 여기엔 P 이미지를 반드시 1장 넣는다 · 참고 이미지가 0장이면 P 마커를 절대 쓰지 않는다 · 라이브 채팅용 출력 포맷(**이름**|내용, 상태창)은 쓰지 않는다 ``` 첫 블록에는 후킹할 정점 장면과 이미지 한 장, 짧은 문장을 두었다. 릴스에서 시작하자마자 스크롤이 올라가는데 글이 길면 읽히지 않았다. 첫 블록 위치도 0.8에서 시작했을 때는 초반이 비었고, 0.0에서는 이미지와 글이 바로 잘려서 0.5로 정착했다. 대본에 '유저'라는 호칭이 남는 것도 어색했다. 첫 줄에 이름 메타 정보를 선언하게 하고, 남은 호칭은 후처리로 치환했다. 금칙어는 해당 줄만 다시 수선하고, 출력 언어가 다른 언어로 흐르면 실패로 처리했다. HTML 화면 구성과 녹화는 1080×1920에서 한 번 하고 다른 규격은 scale과 pad로 만들었다. 규격 하나가 실패했다고 모두 버리지 않고, 저장 가능한 결과는 남겼다. 긴 영상은 상한을 넘으면 트림하도록 했다. ## 플레이어블: 시나리오를 실행 가능한 조합으로 플레이어블은 클릭할 수 있는 미니게임 형태의 광고다. 스토리를 자체완결 HTML 하나로 만들기 위해, 스토리보드와 실제 시나리오 조합을 분리했다. 아래는 플레이어블 형식을 보여주는 Google의 공개 참고 예시다. 광고 안에서 직접 게임을 조작해 볼 수 있고, 화면에는 설치 버튼도 함께 뜬다. 우리가 만든 스토리 광고에서는 이 상호작용을 캐릭터의 대화와 선택지로 구성했다. ![플레이어블 형식 참고 예시 — Google AdMob 공개 자료: Rewarded ads with playables](/assets/images/notion/1bcbb67d0be297ea92ee/07-playable-reference.gif)
플레이어블 형식 참고 예시 — Google AdMob 공개 자료: Rewarded ads with playables
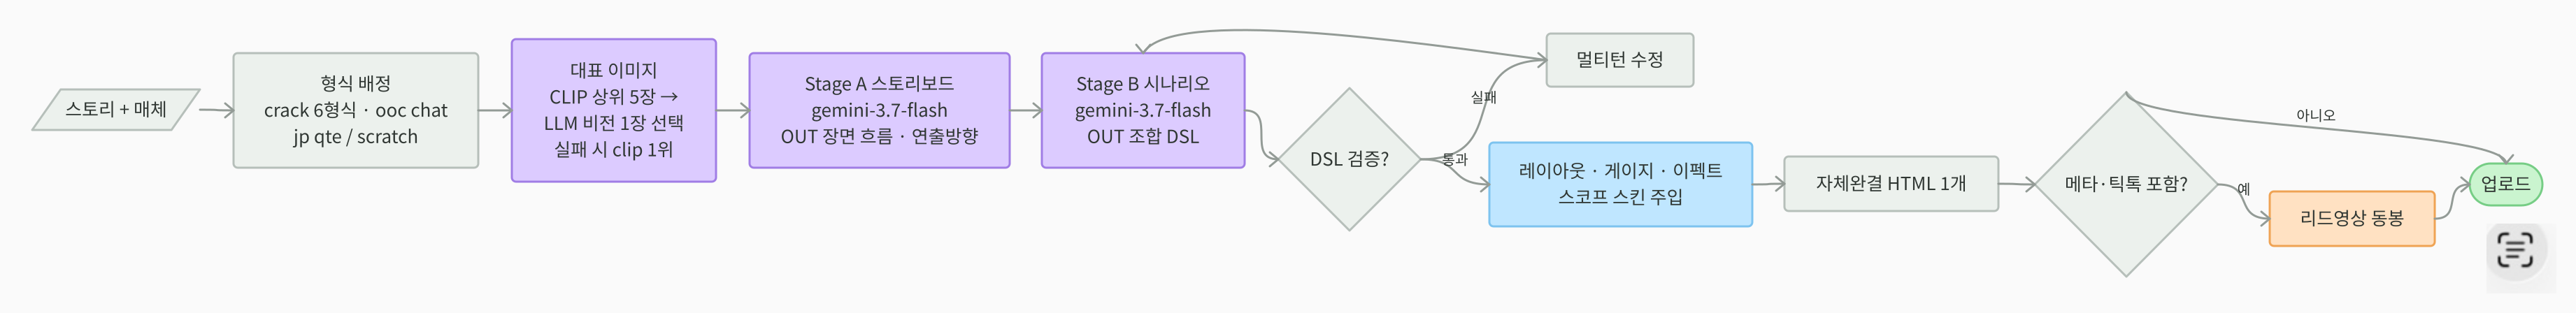
![플레이어블의 기획·검증·HTML 조립 흐름](/assets/images/notion/1bcbb67d0be297ea92ee/03-creative-generation.png)

플레이어블의 기획·검증·HTML 조립 흐름

대표 이미지는 CLIP 상위 후보 다섯 장을 비전 LLM에 보여주고 하나를 고르게 했다. 캐릭터가 선명한지, 장르와 무드가 맞는지 보게 했고, 파싱 실패나 범위를 벗어난 선택에는 CLIP 1위로 돌아가는 대체 경로를 뒀다. Stage A에서 장면 흐름과 연출 방향을 만든 뒤 Stage B에서 조합 DSL로 바꾼다. 검증에 걸리면 같은 세션에서 멀티턴으로 수정했다. 채팅·선택·게이지·공개·CTA 등 준비된 요소를 조합하는 방식이라, 결과를 검증하고 렌더러에 넘길 수 있었다. ```yaml { theme, gauges[], steps[], branches{} } steps 프리미티브: chat · choice · burst · cta (v1) card_pick · gauge · stat_panel · reveal (확장) scratch · qte_tap · swipepick 게이지 스타일: danger · heart · qi · bar · suspicion 화면 형태(layout): chat · battle · raise · harem · investigate immersion · scratch · swipe ``` 최종 HTML에는 레이아웃과 게이지, 이펙트, 서비스 스킨을 함께 넣었다. 외부 자산 요청이 없어도 실행되게 만드는 것은 매체에 전달할 때의 조건이었다. ## UGC 리메이크: 훅을 만드는 방법이 네 번 바뀌었다 UGC(User Generated Content)는 유저나 크리에이터가 직접 만든 콘텐츠를 뜻한다. 사람이 카메라를 보며 서비스를 소개하거나 사용 화면에 반응하는 영상이 익숙한 예다. 아래는 틱톡에서 확인한 OOC 크리에이터 광고들이다. ![틱톡에서 확인한 OOC 크리에이터 광고 예시 — OOC app 검색 화면](/assets/images/notion/1bcbb67d0be297ea92ee/08-ugc-ooc-tiktok.png)
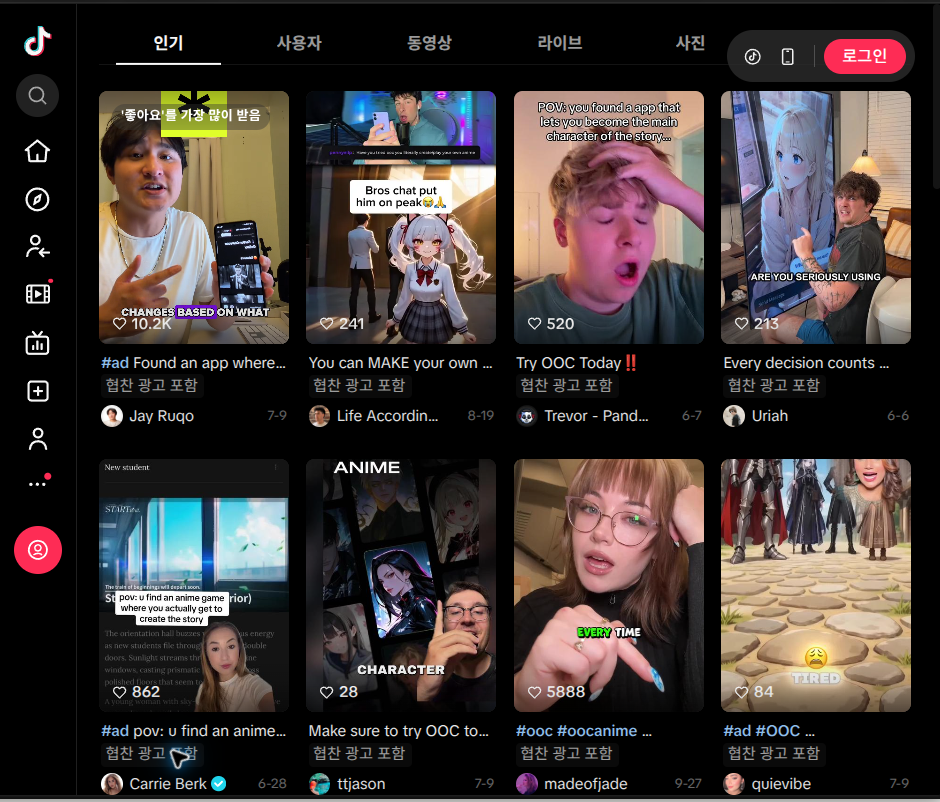
틱톡에서 확인한 OOC 크리에이터 광고 예시 — OOC app 검색 화면

OOC에서는 이미 잘된 UGC의 대본과 화면 구성을 유지하면서, 화면 속 인물을 AI로 바꾸는 경로도 만들었다. 원본 영상의 단어별 타임스탬프를 뽑고 컷을 나눈 다음, 훅과 발화 컷을 별도로 생성했다. ![UGC 리메이크의 생성과 합성 흐름](/assets/images/notion/1bcbb67d0be297ea92ee/04-creative-generation.png)
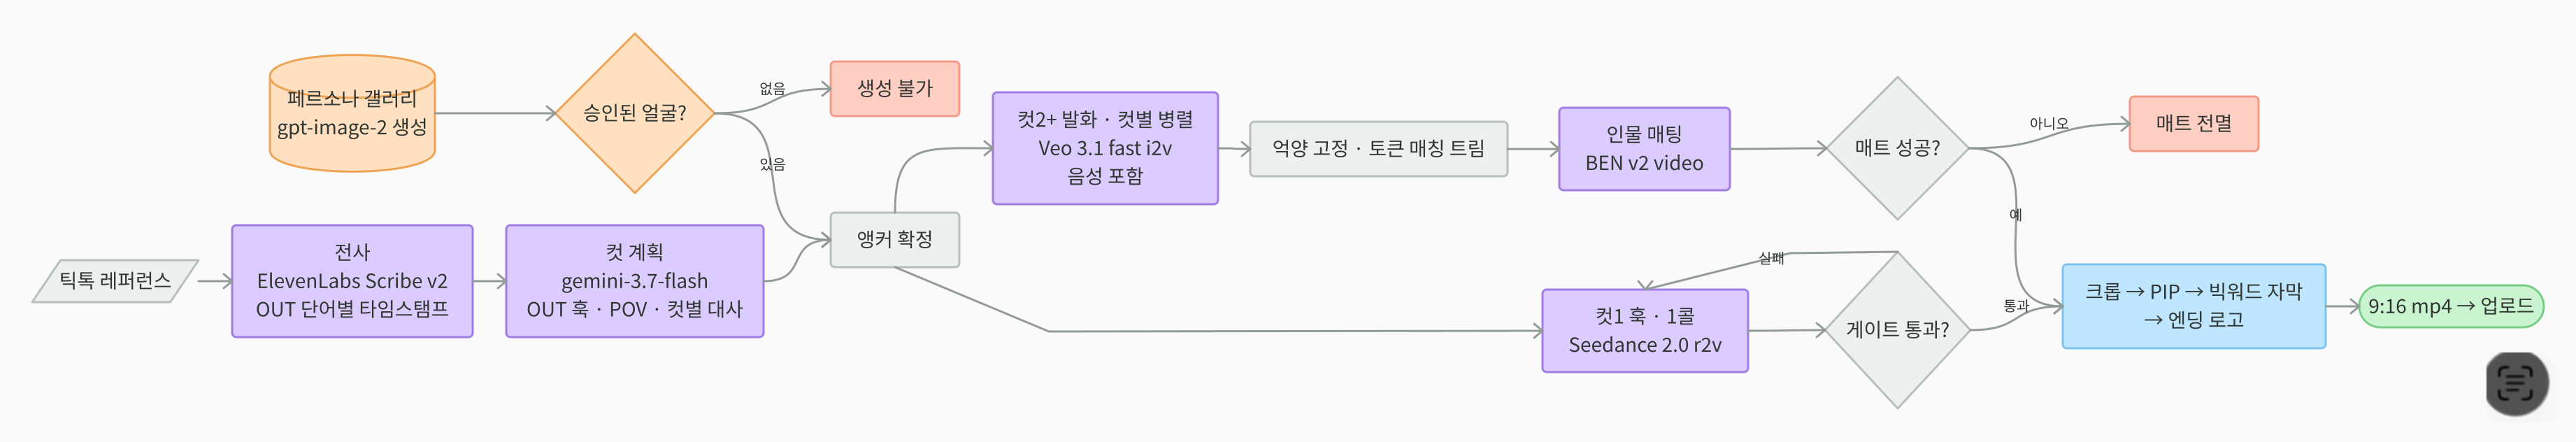
UGC 리메이크의 생성과 합성 흐름

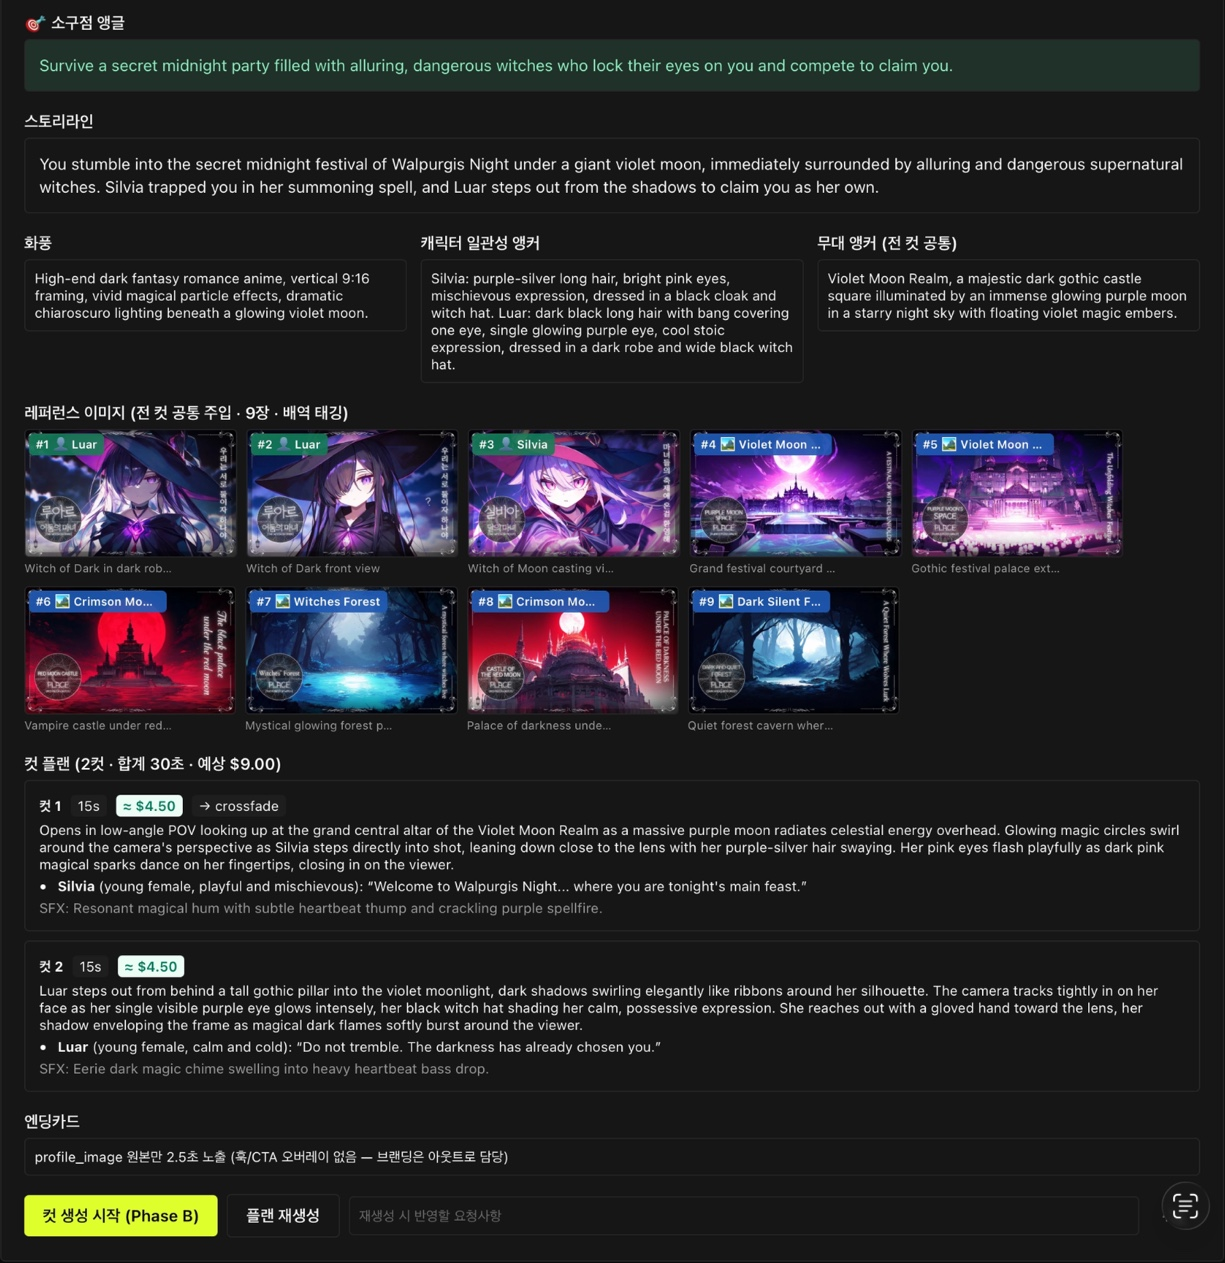
컷 경계는 문장 경계로 맞췄다. 훅이 첫 문장의 앞토막만 말하면 이후 편집이 잘돼도 어색하기 때문이다. 훅은 원본 클립을 움직임과 구도의 레퍼런스로, 승인된 얼굴 이미지를 인물 레퍼런스로 넣는 r2v 방식으로 만들었다. 이 구간의 소리는 원본을 다시 합성했다. 발화 컷은 앵커와 대사를 넣어 음성이 포함된 영상으로 만들고, 전사 결과를 맞춰 앞뒤를 잘랐다. 인물 매팅 이후에는 얼굴 기준 크롭, 우하단 PIP, 자막, 엔딩 로고를 합성했다. 얼굴 갤러리는 인종·성별별 앵커를 미리 만들어 사람이 승인한 것만 사용했다. 공식 틱톡 계정의 리포스트는 리메이크 대기 큐로 활용했다. 훅 생성 방식은 완전 재현, 프레임 스왑+i2v, 스토리보드 기반 생성, r2v 단일 호출까지 바뀌었다. 실배치에서는 발화가 사라지거나, DB 락이 생기거나, 매팅 결과가 전부 실패하는 문제가 드러났다. 단위테스트가 통과해도 이 형식을 쓸 수 있다고 말하기 어려웠던 이유다. 실제 실패 사례를 확인한 뒤 그 조건이 다음 가드가 됐다. ## Anime teaser: 비싼 생성 전에 플랜을 확인했다 오리지널 스토리에서는 30초 애니메이션 티저를 만드는 흐름도 구현했다. 감독 단계에서 세계관과 소구점, 레퍼런스 이미지를 받아 컷과 샷, 캐스트, 대사를 계획한다. 후보 이미지 풀에서 선택한 이미지를 캐릭터·배경·소품으로 나눠 컷에 연결했다. ![애니메이션 티저의 플랜·생성·합성 흐름](/assets/images/notion/1bcbb67d0be297ea92ee/05-creative-generation.png)
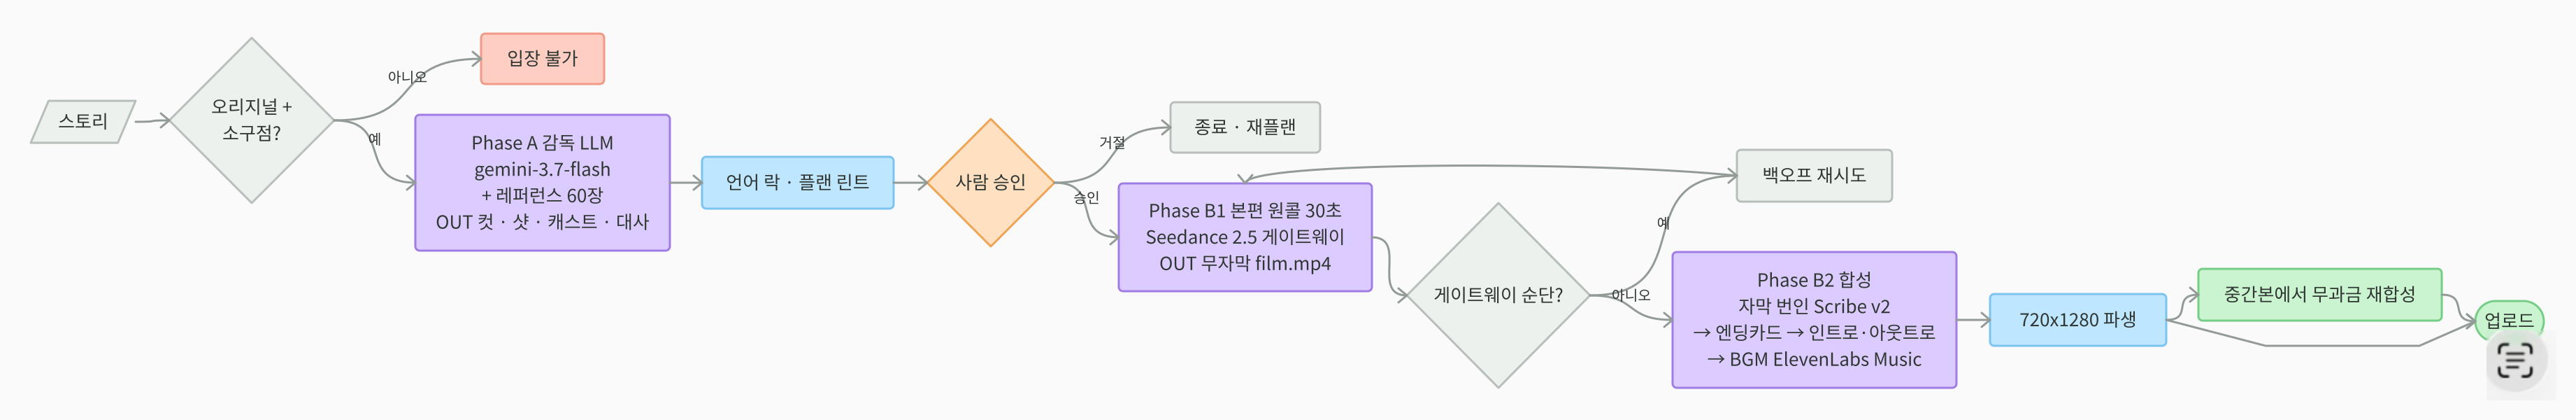
애니메이션 티저의 플랜·생성·합성 흐름

![애니메이션 티저 생성 화면과 컷 계획](/assets/images/notion/1bcbb67d0be297ea92ee/06-creative-generation.png)

애니메이션 티저 생성 화면과 컷 계획

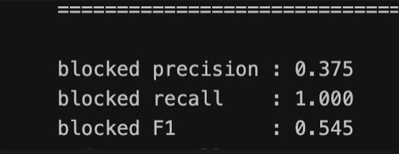
사람이 플랜을 확인한 다음 본편 영상 모델을 호출한다. 컷별 영상을 이어 붙이는 대신 컷 플랜과 캐스트를 넣어 본편을 한 번에 생성하는 경로였다. 실제 발화를 다시 전사해 자막 타이밍을 맞추고 서비스별 엔딩과 BGM을 합성했다. ```yaml shot_size: "medium" beat: "Chloe scrambles on the floor after spilling game pieces." motion: "Chloe hurriedly gathers scattered colorful plastic tokens off the floor, rushing back up toward the desk." action: "Chloe crouches low to scoop up dice from the linoleum floor, then moves back behind the wooden desk." scene: "Chloe crouches beside the cluster of desks in the sunset-lit classroom." line: speaker: "Chloe" from_source: true voice: "flustered and breathless, catching her voice in a panicked stammer" line: "Aah! S-sorry! My hand slipped! B-but... I will have everything picked up right away!" advances: "The spilled pieces are collected and placed back onto the playing surface on the desk." ``` | | 크랙 | OOC | | --- | --- | --- | | 대상 | IP 등록 오리지널만 | 공식계정 제작 레인 | | 프롬프트 | 한국어 별도 벌(번역 아님) | 영어 벌 | | 인트로 | 빨강 워드마크 + ORIGINAL 배지 | 로고 2.0초 | | 엔드카드 | 없음 | 섬네일 고정 2.5초 | | 아웃트로 | 세로 로고 애니 4.0초 | 로고 3.5초 | | 매체 | 메타 · 틱톡 · X | 틱톡 · X | 한국어와 영어는 발화량 기준도 달랐다. 영어 플랜을 한국어 기준으로 검사하면 발화 과다로 잘못 판단하는 경우가 생겼다. 원작에서 인용할 수 있는 대사가 있는 경우와 없는 경우도 나눴다. 소구점이 없으면 티저 생성은 실패로 처리했다. 무엇을 광고하는지 정해지지 않은 상태에서 영상부터 만드는 건 피하고 싶었다. 자막이나 BGM, 꼬리 부분만 잘못되면 저장된 중간 영상부터 합성 단계를 다시 실행했다. 본편 생성까지 다시 호출할 필요가 없게 만드는 것이 비용 면에서도 중요했다. 형식마다 모델과 검수 방식은 달랐지만, 입력과 산출물의 계약을 정하고 수정 가능한 중간본을 남기는 방향은 같았다. 생성 결과가 한 번에 잘 나오기를 기다리는 것보다, 어느 단계가 잘못됐는지 확인하고 그 부분만 다시 처리할 수 있어야 운영할 수 있었다. ### 광고 안전성 필터에서 과차단을 줄인 과정 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-05-safety-filtering/ - Collection: Project - Published: 2026-10-12 - Tags: Project 캐릭터챗은 유저가 자유롭게 스토리를 만드는 서비스다. 광고 제작을 자동화하려면 이미지를 잘 만드는 것만큼, 만들면 안 되는 광고를 먼저 거르는 것도 필요했다. 서비스에 있는 스토리라고 모두 광고로 내보낼 수 있는 건 아니었다. 문제가 있는 소재를 놓치는 것은 피해야 했지만, 민감한 단어가 한 번 등장했다는 이유로 모두 차단하면 정상적인 판타지까지 빠졌다. 처음에는 보수적으로 잡고, 실제 판정 사례를 보면서 범위를 좁혀 갔다. ## 살아 있는 스토리인지 먼저 확인했다 BigQuery에 적재된 데이터에는 삭제됐거나 비공개로 바뀐 스토리도 있었다. 광고를 클릭하면 딥링크로 해당 스토리에 들어가야 하는데, 서비스에 없는 작품을 광고하면 유입이 끊긴다. 그래서 공개·활성 상태, 삭제·차단 여부, 국가코드 등은 쿼리 단계에서 먼저 확인했다. 제작할 때는 살아 있었지만 집행 중에 제작자가 내리거나 차단되는 경우도 있었다. 전처리 한 번으로 끝낼 수 없는 문제여서 주간 크론으로 라이브 상태를 다시 조회하는 흐름을 뒀다. 성인물과 2차창작 여부도 데이터에 필드가 있으면 먼저 제외했다. 매체 가이드라인을 참고한 생성 가드레일과 별개로, 구조화된 데이터로 바로 판별할 수 있는 조건은 앞단에서 처리했다. ## 어느 단계에서 무엇을 거를 것인가 필터는 한 곳에만 두지 않았다. 데이터 적재에서는 스토리 자체의 광고 적합성을 보고, 이미지 후보에서는 광고에 쓸 수 없는 그림을 걸렀다. 카피 생성 프롬프트에도 안전 가이드를 넣었다. 원문 스토리가 통과해도 생성 과정에서 표현이 달라질 수 있기 때문이다. LLM 분류의 결과는 safe와 blocked로 받았다. 초기에는 애매하면 blocked로 분류하고, 한 축이라도 문제에 해당하면 차단하는 방향이었다. 오리지널 스토리는 서비스에서 별도 검수한 공식 작품이라 이 검사에서 면제했다. 자동 판정이 오리지널이면 안전하다고 알아낸 것이 아니라, 이미 검수한 콘텐츠를 별도 경로로 처리한 정책이었다. | 판정축 | 무엇 | 크랙 | OOC | 카라푸 | | --- | --- | --- | --- | --- | | minor_sexual | 미성년 성적 묘사 | ● | ● | ● | | discrimination | 차별 + 노예·인신매매의 노골적 성적 묘사 | ● | ● | ● | | self_harm | 자해 | ● | ● | ● | | gambling | 도박이 스토리의 중심 주제일 때만 | ● | ● | ● | | politically_sensitive | 선거·진영 갈등 | ● | — | — | | religion_political | 2026-08-05 전 스코프 은퇴 | — | — | — | 분류축과 적용 서비스는 운영 중에 바뀌었다. 정치 관련 기준은 한국 서비스와 해외 서비스에서 같지 않았고, 종교축은 이후 제거했다. 아래 실험도 당시 사용했던 기준 안에서 읽어야 한다. ## 문제 사례를 잡으면서 정상 스토리의 오차단 줄이기 초기 테스트셋은 문제가 있었던 스토리 세 개와 랜덤으로 뽑은 정상 스토리 97개였다. 당시에는 소재 수가 줄어드는 것보다 문제가 있는 광고가 나가는 것이 더 치명적이라고 봤다. 그래서 blocked recall을 우선했다. Claude Opus 4.6으로 분류했을 때 문제 사례는 3/3건을 잡았다. 반면 정상으로 라벨링한 97건 중 일곱 건도 blocked로 분류됐다. 이 일곱 건이 평가셋 기준의 False Positive, 즉 오차단이었다. 문제 사례를 놓치지 않는 수준을 유지하면서, 정상 소재가 어떤 이유로 걸렸는지 확인해 과차단을 줄이는 것이 다음 과제였다. blocked 예측 열 건 중 실제 문제 사례가 세 건이라 precision은 0.30이었다. | 지표 | 값 | 의미 | | --- | --- | --- | | blocked recall = 1.00 | 3/3 | 🎯 핵심 성과 – GT 누수 0건 | | safe recall = 0.928 | 90/97 | 7건 false positive (오차단) | | blocked precision = 0.30 | 3/10 | 모델 blocked라 한 10건 중 3건만 진짜 | | F1 = 0.46 | – | precision이 낮아 F1 저하 | | MCC = 0.528 | – | 불균형 데이터 고려 시 양호 | | Accuracy = 0.93 | – | 전체적으로 잘 분류 | 평가에서 차단 대상으로 지정한 세 사례는 장애를 대상화하는 맥락, 실존 정치인과 정치적 갈등을 중심으로 한 스토리, 영토 분쟁을 소재로 한 스토리였다. 정상 라벨과 판정이 달랐던 일곱 건의 이유도 따로 읽었다. 판타지 종교 설정, 역사적 배경, 본문 안의 자해나 미성년 관련 표현 등이 있었다. 처음 붙인 정상 라벨과 모델의 판단이 다르면, 모두 모델의 잘못이라고 바로 결론 내릴 수는 없다. 판정 기준과 라벨이 일치하는지도 다시 봐야 했다. 중요한 것은 모델이 어떤 근거로 차단했는지 남겨 다음 기준 조정에 쓸 수 있다는 점이었다. ```plaintext [오체불만족] (gt_category=discrimination) pred_status : blocked pred_category : discrimination reason : 장애(사지결손)를 핵심 소재로 다루며, 태그·시스템 프롬프트에서 장애를 대상화하는 맥락이 드러나 discrimination으로 판단함. latency : 59.4s → status ✓ | category ✓ [리버스 1979] (gt_category=politically_sensitive) pred_status : blocked pred_category : politically_sensitive reason : 박정희·김대중·전두환·김재규 등 실존 한국 정치인 실명이 다수 등장하고 정치적 사건·갈등을 스토리의 핵심 소재로 삼아 politically_sensitive로 판단함. latency : 59.4s → status ✓ | category ✓ [독도는 일본땅] (gt_category=politically_sensitive) pred_status : blocked pred_category : politically_sensitive reason : 제목·시스템 프롬프트·대사에서 독도/다케시마 영토 분쟁을 핵심 소재로 삼고 있어 politically_sensitive로 판단함. latency : 59.4s → status ✓ | category ✓ ``` ```plaintext False Positive: 7 건 - [사랑하는 나의 증오에게] → self_harm reason: content_summary에서 '시체를 끌어안은 채 제 심장을 찌를 겁니다'라며 직접적인 자해 표현을 사용해 self_harm으로 분류함. - [1933년 독일에서 살아남기s] → politically_sensitive reason: title·system_prompt·initial_messages에서 '1933년 독일'이라는 시대·정치적 배경이 명시되어 정치적으로 민감한 설정으로 판단함. - [지옥과 천국에서의 삶] → religion_political reason: userPrompt 및 세계관 설정에서 기독교의 실존 천사(미카엘, 가브리엘 등)와 종교 세계관이 등장해 religion_political로 분류함. - [조정혀] → minor_sexual reason: userPrompt 필드에서 중학교(꿈결중학교) 재학생 캐릭터가 '야한 드립을 한다'는 성적 대화 설정을 갖고 있어 미성년자와 성적 맥락의 결합으로 판단함. - [미래를 아는 자 과거를 바꾸다] → politically_sensitive reason: content_summary 및 initial_messages에서 '박정희 대통령 시해' 등 실존 정치인과 정치적 사건을 핵심 소재로 제시하여 politically_sensitive로 판단함. - [원효] → religion_political reason: title, tags, content_summary 등에서 실존 불교 승려 '원효대사'를 중심인물로 제시해 religion_political로 분류함. - [천국 시뮬레이션] → religion_political reason: customPrompt의 테마 필드에 '종교'가 명시되어 있고, 스토리 전체가 천국이라는 종교적 세계관을 중심으로 구성되어 religion_political로 분류함. ``` 이 실험의 총 비용은 5.07달러, 스토리당 평균은 0.0507달러였다. 이후 Gemini 3.1 Flash Lite로 바꿔 비교했고, 당시 기록에서는 비용이 약 52배 저렴하면서 문제 세 건의 recall을 유지했다. ![안전성 분류 모델의 비용·판정 결과 비교](/assets/images/notion/9a0cbebab1b54d20e926/01-safety-filtering.png)
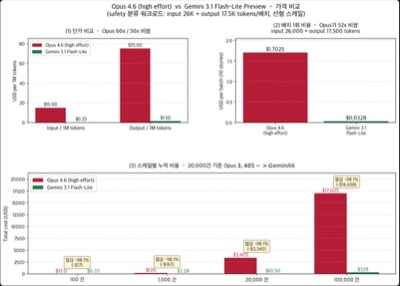
안전성 분류 모델의 비용·판정 결과 비교

![비교 실험의 blocked precision·recall·F1](/assets/images/notion/9a0cbebab1b54d20e926/02-safety-filtering.png)

비교 실험의 blocked precision·recall·F1

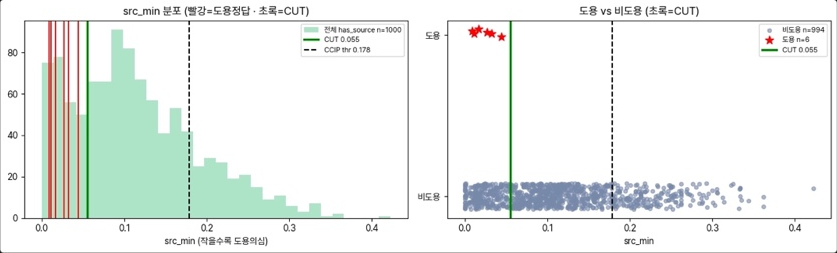
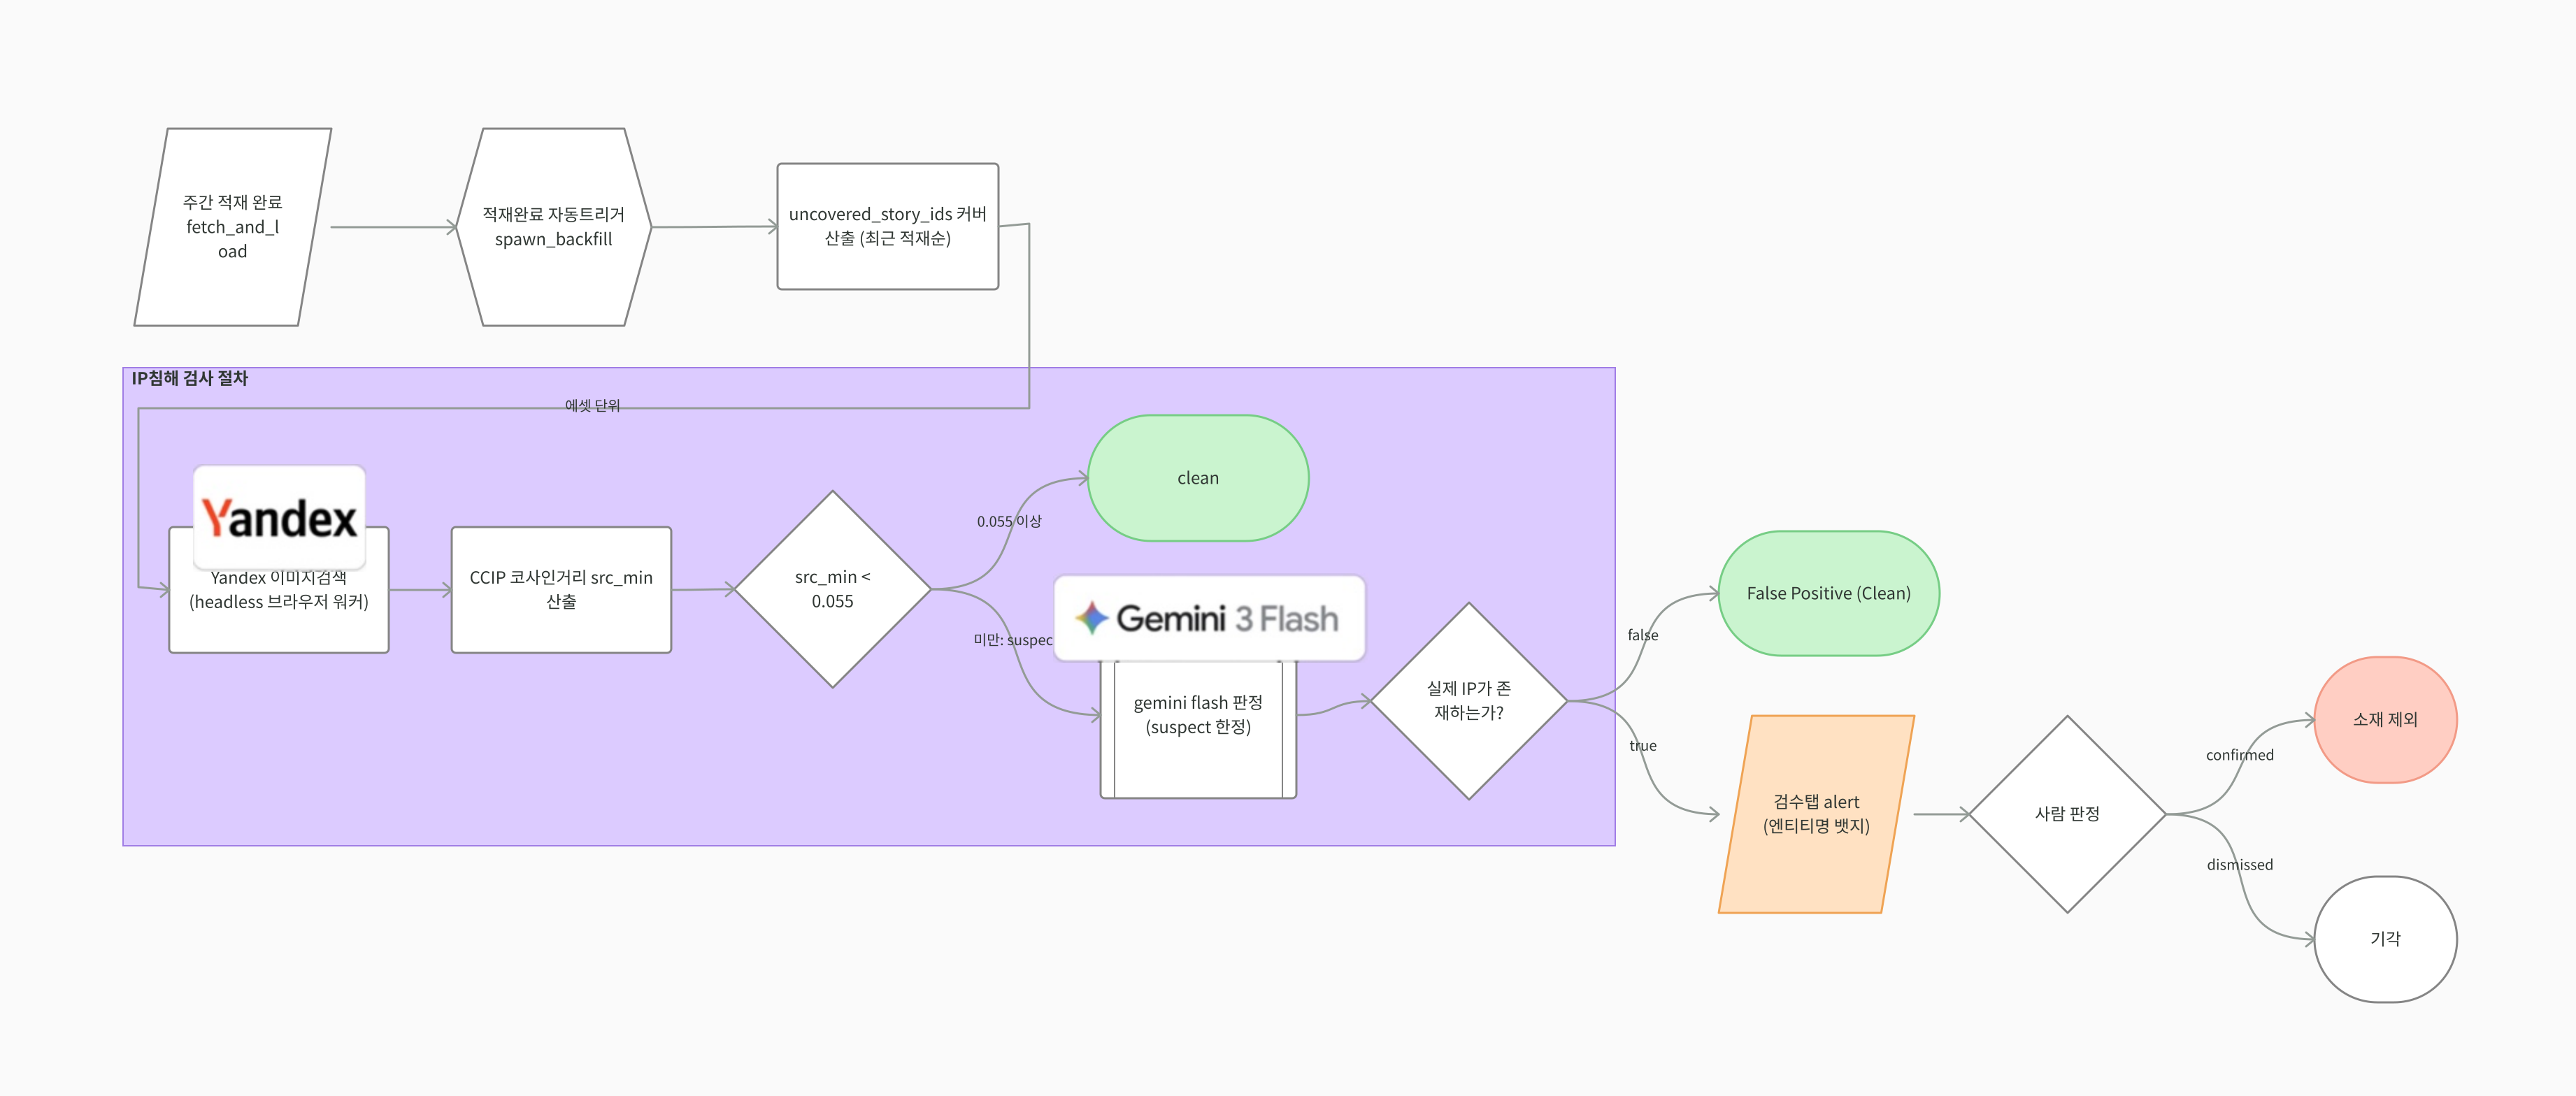
비교 이미지에는 blocked precision 0.375, recall 1.000, F1 0.545가 남아 있다. 다만 문제 사례가 세 개뿐인 실험의 recall 1을 일반적인 운영 성능으로 볼 수는 없다. 더 다양한 문제가 들어오면 놓치는 사례가 생길 수 있고, 모델을 바꾸는 것과 기준을 바꾸는 효과도 따로 봐야 한다. ## 엄격한 검사에서 SF·판타지까지 과차단됐다 검사를 엄격하게 적용하자 광고로 쓸 수 있는 SF·판타지 스토리까지 과차단됐다. 민감한 요소가 세계관에 등장하는 것과, 그 요소를 광고에 부적절한 맥락으로 다루는 것을 구분해야 했다. 크랙 200건의 dry-run에서도 노예·도박을 등장만으로 판정하자 차단률이 11%에서 31.5%로 올랐다. 많은 사례가 신분제 세계관에 '노예'라는 단어가 한 번 들어 있는 정도였다. 이 비율은 전체 차단률이고, 그 자체가 오탐률은 아니다. 다만 차단 근거를 읽어 보니 기준이 넓다는 문제가 드러났다. 그래서 차별이나 노예·인신매매의 노골적인 성적 맥락을 보도록 좁히고, 도박도 스토리의 중심 주제일 때 판정하는 식으로 조정했다. 민감한 단어가 등장한 사실보다 광고에 쓰기 어려운 맥락이 실제로 있는지를 보게 했다. OOC에서도 종교·정치축이 판타지 설정을 많이 잡았다. 3,762건 중 blocked는 196건이었고, 그중 33건의 근거가 Lucifer, 십자가 소품, 소림사, 윤회 같은 요소였다. 종교적 갈등을 광고하는 것과 종교에서 가져온 판타지 설정을 구분하지 못한 것이다. 이 사례를 확인하고 종교축을 제거했다. ## 기준은 운영 사례와 함께 바뀌어야 했다 처음 실험은 알려진 문제를 놓치지 않는지 확인하는 용도였다. 정상 사례 97건도 서비스 전체의 장르와 국가별 분포를 대표하도록 구성한 것은 아니었다. 따라서 낮은 비용의 모델이 비슷한 결과를 냈다는 관찰은 유용했지만, 그 테스트셋만으로 안전성 필터를 완성했다고 할 수는 없었다. 안전하게 자동화하려고 넓게 막았는데, 그 기준이 너무 넓으면 제작할 수 있는 정상 콘텐츠가 줄어든다. 판정축을 추가한 뒤에는 실제 차단 이유를 읽고, 맥락이 다른 사례를 모으고, 기준을 다시 조정해야 했다. 이후에도 신규 문제 사례를 평가셋에 추가하면서 확인하는 일이 남았다. ### IP침해차단 파이프라인 만들기 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-06-ip-detection/ - Collection: Project - Published: 2026-10-12 - Tags: Project 광고에 쓸 스토리 이미지에서 확인해야 하는 IP는 애니메이션에 한정되지 않았다. 애니메이션처럼 정해진 도메인의 IP는 WD-Tagger로 태깅한 뒤 걸러낼 수 있었고, ops팀도 이미 이 방식으로 자동 태깅과 필터링을 하고 있었다. 우리가 더 확인해야 했던 것은 영화, 버튜버, 삼국지나 콜오브듀티 같은 게임의 에셋 IP까지 포함한 범위였다. 태거가 아는 캐릭터만 확인해서는 이 범위를 다루기 어려워 이미지 역검색을 사용했다. 스토리의 2차창작 여부는 서비스 데이터에 필드로 있었다. 처음에는 그 값이 false인 스토리만 광고로 만들었다. 그런데 운영하면서 해당 필드가 false인 작품에 알려진 버튜버 IP가 들어 있는 사례가 생겼다. 신고가 들어온 콘텐츠를 사람이 처리하는 흐름만으로는 광고 생성 앞에서 모든 후보를 확인하기 어려웠다. 이미지의 IP를 찾는 모듈을 따로 만들었고, 그 과정에서 '웹에 같은 그림이 있다'는 것과 '알려진 IP를 사용했다'는 것이 다르다는 문제를 만나게 됐다. ## 역검색과 이미지 거리로 시작했다 처음에는 이미지 역검색 결과와 원본 이미지의 유사도를 사용했다. 실제 문제가 있었던 다섯 스토리의 이미지 쌍을 잘 찾는 임베딩 모델을 비교했고, CCIP가 해당 사례에서 높은 유사도를 보여 채택했다. 거리 지표는 `(1 - cosine similarity) / 2`였다. 값이 작을수록 비슷한 이미지다. 랜덤으로 뽑은 1,000개 스토리의 프로필 이미지에서 점수 분포를 보고, 이미지 쌍을 직접 확인해 0.055를 초기 후보 기준으로 정했다. ![IP 이미지 쌍의 임베딩 모델 비교](/assets/images/notion/9c9e5ee4759f74ffb566/01-ip-detection.png)
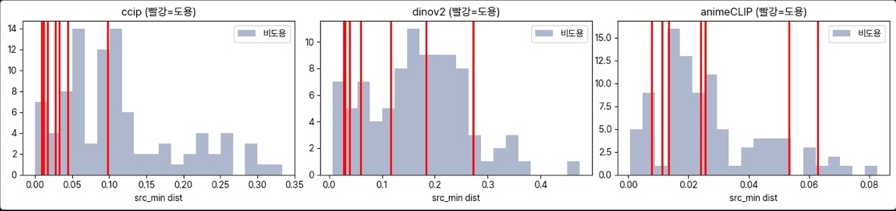
IP 이미지 쌍의 임베딩 모델 비교

![거리 기준을 정하기 위해 확인한 이미지 쌍](/assets/images/notion/9c9e5ee4759f74ffb566/02-ip-detection.png)

거리 기준을 정하기 위해 확인한 이미지 쌍

![이미지 쌍의 유사도와 오류 사례](/assets/images/notion/9c9e5ee4759f74ffb566/03-ip-detection.png)

이미지 쌍의 유사도와 오류 사례

![이미지 거리 분포와 후보 임계값](/assets/images/notion/9c9e5ee4759f74ffb566/04-ip-detection.png)

이미지 거리 분포와 후보 임계값

이 방식은 같은 이미지를 찾는 데는 쓸 수 있었지만, 다른 사이트에 그 이미지가 있다는 이유만으로 차단하면 문제가 있었다. 같은 제작자가 여러 캐릭터챗 서비스에 올릴 수도 있고, 누군가 핀터레스트에 재게시했을 수도 있다. 검색 결과만으로 어느 쪽이 원본인지 알 수 없는 경우도 있었다. 광고 제작에서는 애매한 경우까지 보수적으로 막는 선택을 할 수 있었지만, Ops 검수에도 이 기준을 그대로 적용하면 너무 많이 차단됐다. 랜덤 1,000건에서 약 20%가 검열되는 문제가 있어서 기준을 바꿀 필요가 있었다. ## 검색 결과가 가리키는 엔티티를 보게 했다 사례를 알려진 버튜버·게임·애니 캐릭터·실존인물이 있는 경우, 다른 서비스나 이미지 모음 사이트에 등장하지만 권리 관계가 불명확한 경우, 검수된 오리지널이나 제작자 자체 이미지인 경우로 나눠 봤다. ![다른 사이트에 등장한 이미지 사례](/assets/images/notion/9c9e5ee4759f74ffb566/05-ip-detection.png)
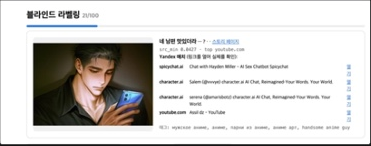
다른 사이트에 등장한 이미지 사례

![재게시와 IP 식별을 구분해야 하는 사례](/assets/images/notion/9c9e5ee4759f74ffb566/06-ip-detection.png)

재게시와 IP 식별을 구분해야 하는 사례

![동일 이미지가 검색되는 또 다른 사례](/assets/images/notion/9c9e5ee4759f74ffb566/07-ip-detection.png)

동일 이미지가 검색되는 또 다른 사례

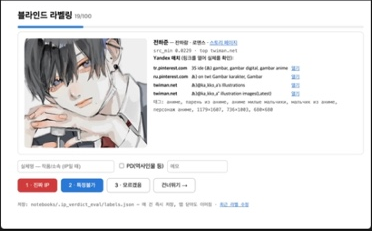
검색 결과를 그대로 차단 판정으로 쓰는 대신, 검색이 제공한 맥락을 LLM이 읽는 단계를 추가했다. 원본과 매치 이미지 쌍, 도메인, 페이지 제목과 URL, 역검색 태그를 함께 넣었다. 스토리 제목과 요약, 프롬프트, 태그도 판정 맥락으로 활용했다. ![이미지와 검색 결과 맥락을 함께 넣은 판정 입력](/assets/images/notion/9c9e5ee4759f74ffb566/08-ip-detection.png)
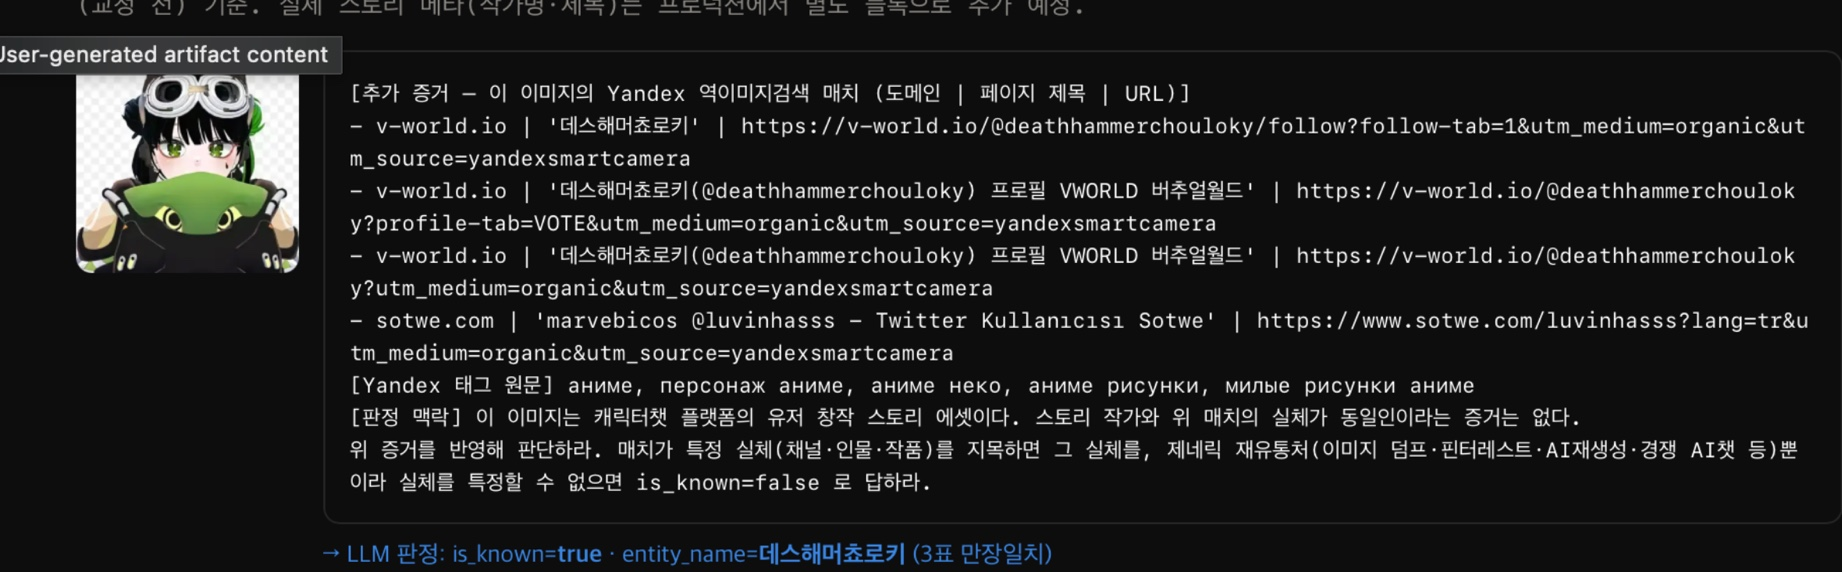
이미지와 검색 결과 맥락을 함께 넣은 판정 입력

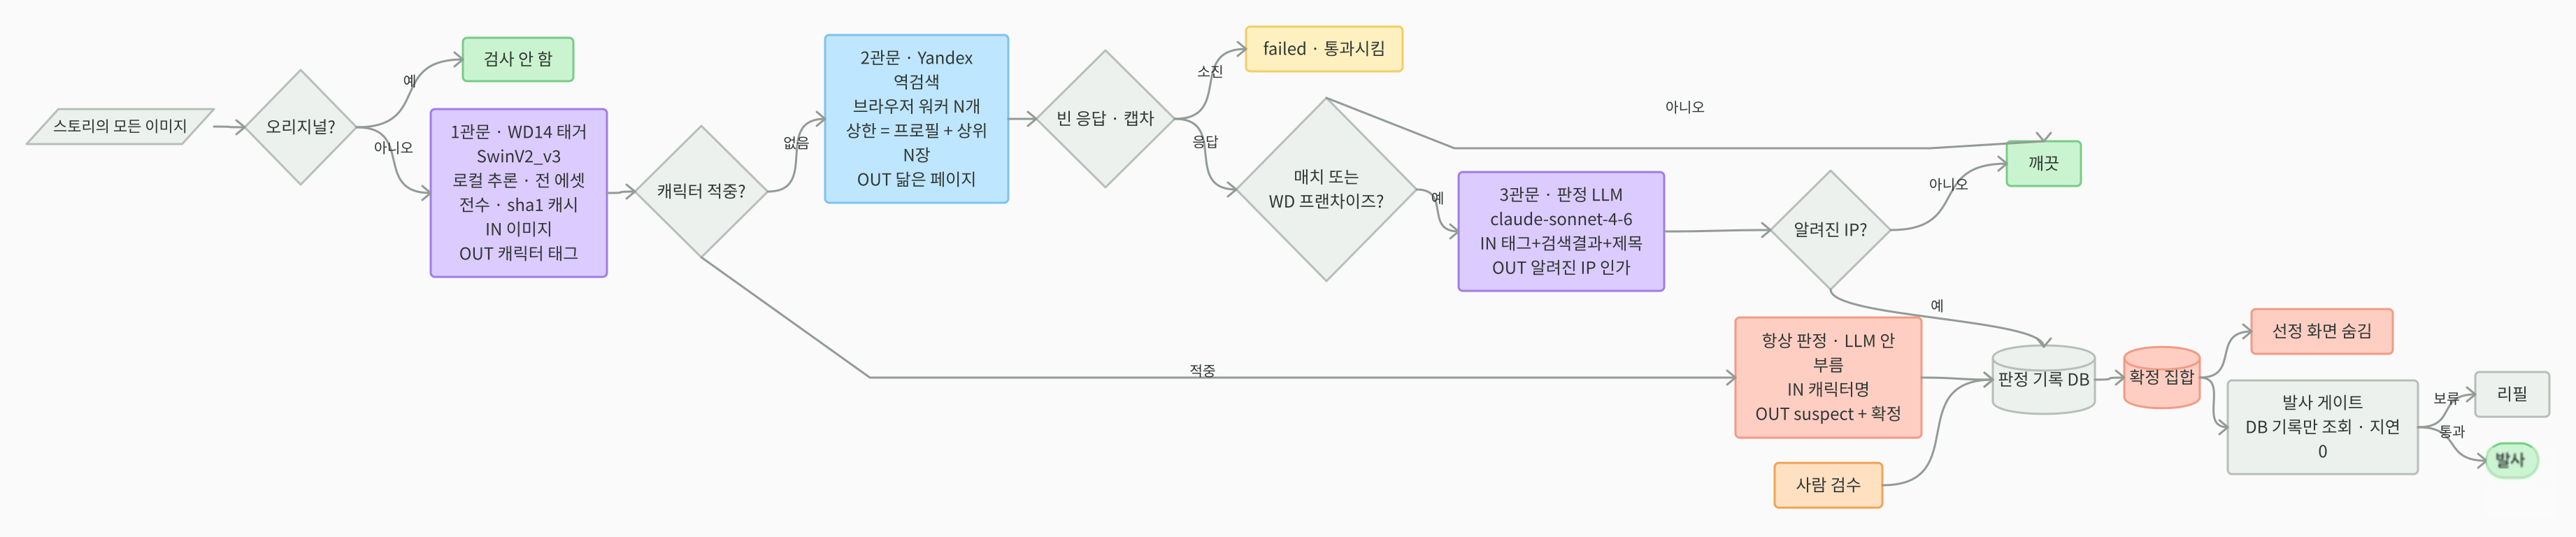
LLM에는 알려진 실체인지, 엔티티 이름과 소속 작품은 무엇인지, 어떤 유형인지, 어느 도메인의 증거가 결정적이었는지를 구조화해서 받았다. 이름을 이미지에서만 맞히게 했을 때 놓쳤던 한국 버튜버나 게임 캐릭터도, 관련 페이지 제목과 태그가 함께 있으면 식별할 수 있었다. ```python class Verdict(BaseModel): is_known: bool = False # 핵심 판정 — 증거가 실존 실체를 지목하는지 여부 entity_name: Optional[str] = None # 지목한 실체명 (예: "흥선대원군 (이하응)") franchise: Optional[str] = None # 소속 작품/그룹/회사 (예: "블루 아카이브") entity_type: str = "unknown" # 실체 유형 (실존인물/게임캐릭터/버튜버 등) confidence: float = 0.0 # 모델 자체 확신도 0~1 key_evidence_domain: Optional[str] = None # 결정적 근거가 된 매치 도메인 ``` ![WD tagger와 역검색 증거 기반 LLM 판정의 데이터 흐름](/assets/images/notion/9c9e5ee4759f74ffb566/09-ip-detection.gif)
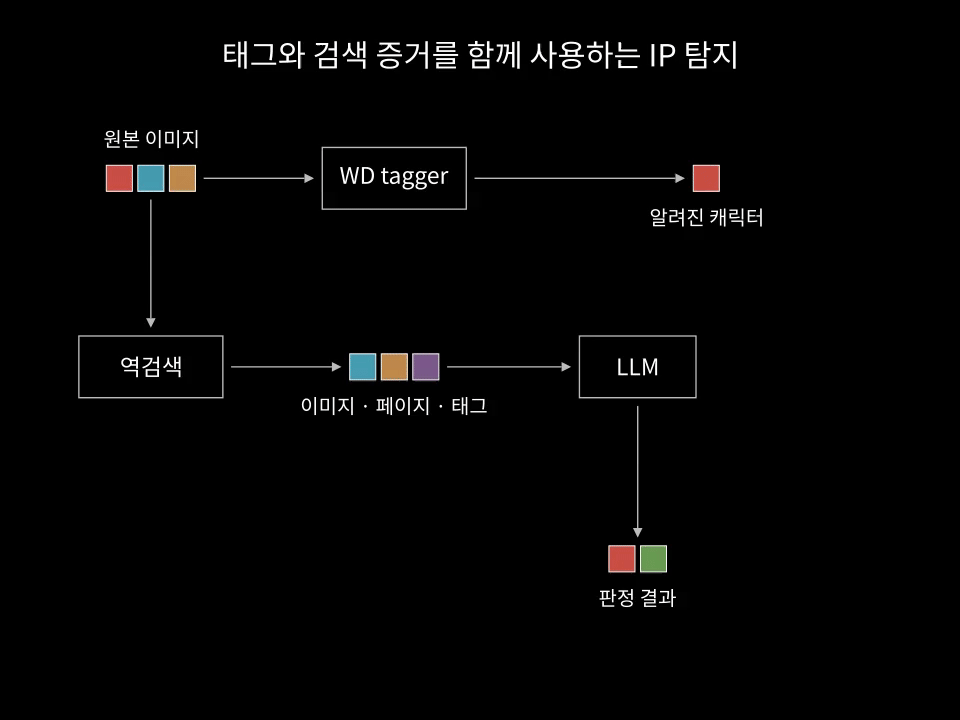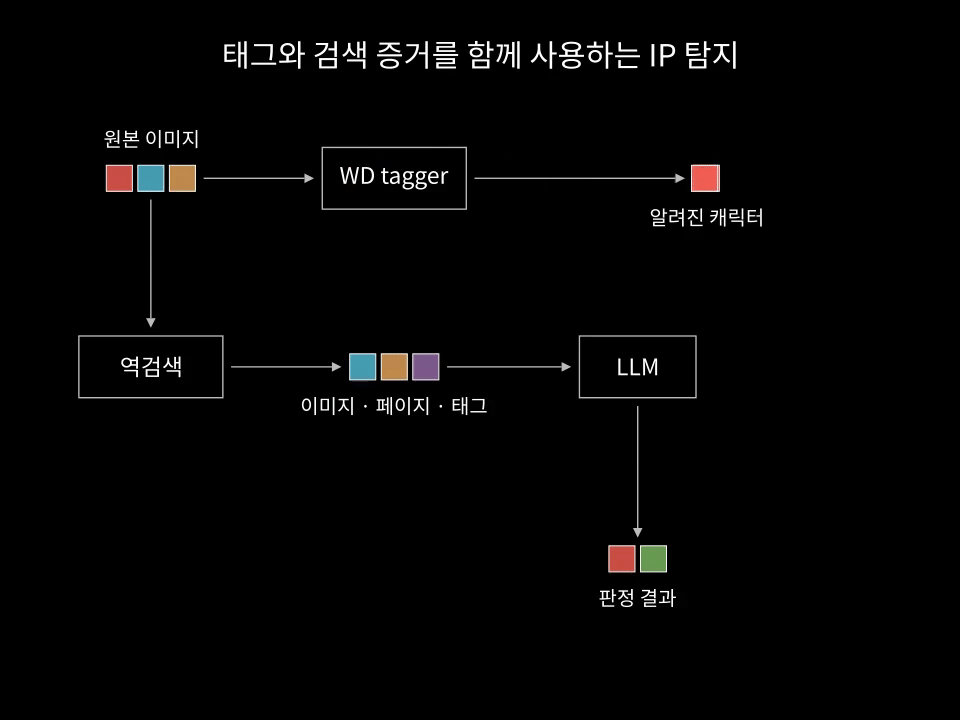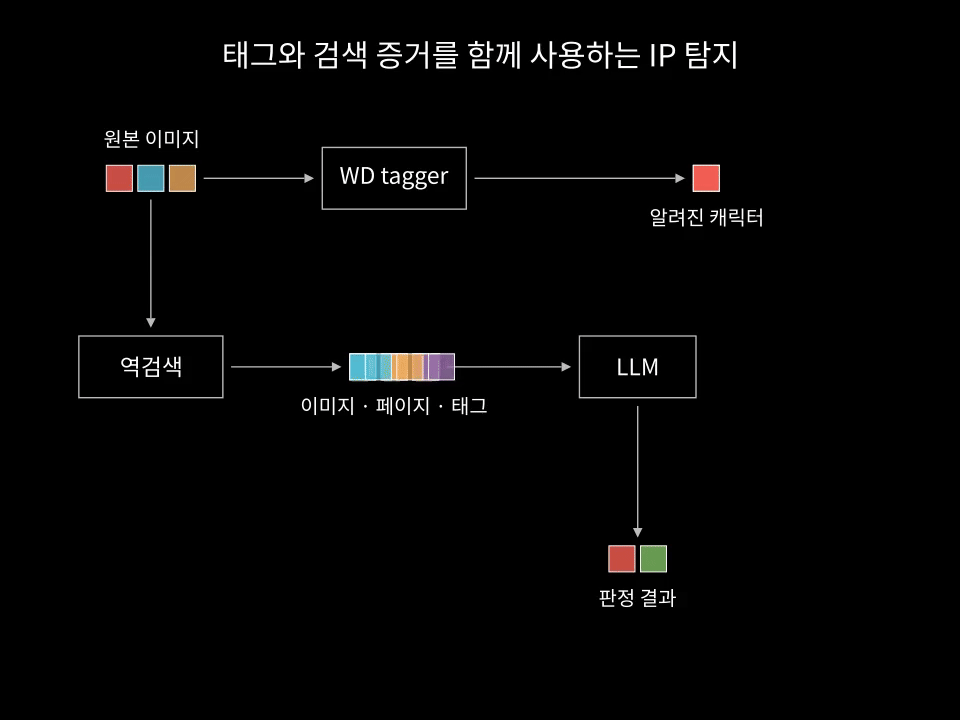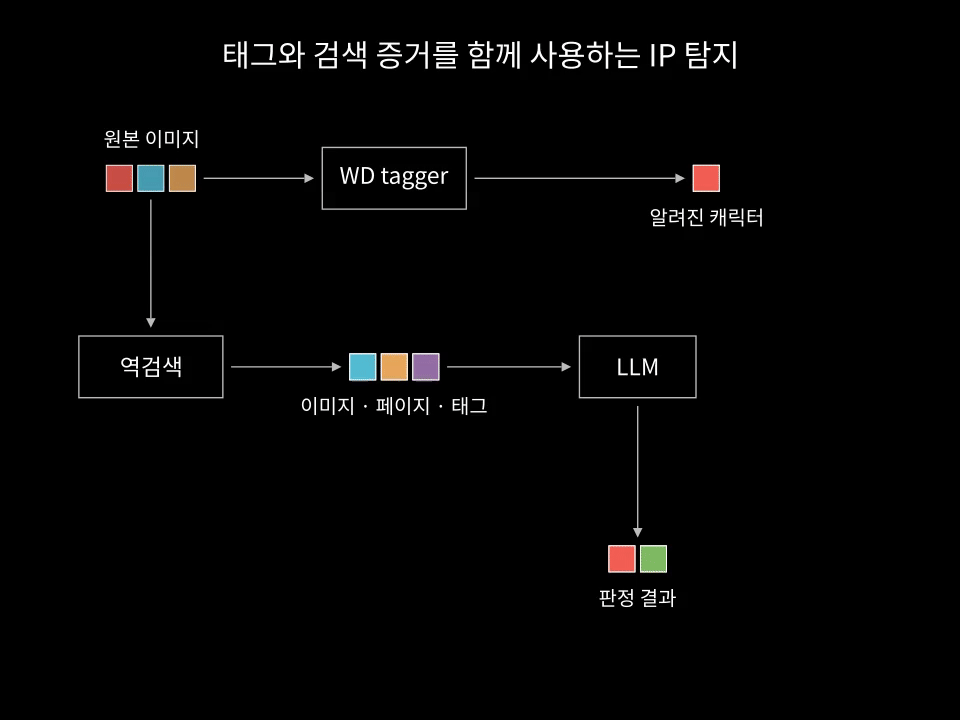
WD tagger와 역검색 증거 기반 LLM 판정의 데이터 흐름

![태거와 역검색을 결합한 IP 탐지 흐름](/assets/images/notion/9c9e5ee4759f74ffb566/10-ip-detection.png)

태거와 역검색을 결합한 IP 탐지 흐름

![역검색 증거를 LLM 판정으로 연결하는 흐름](/assets/images/notion/9c9e5ee4759f74ffb566/11-ip-detection.png)

역검색 증거를 LLM 판정으로 연결하는 흐름

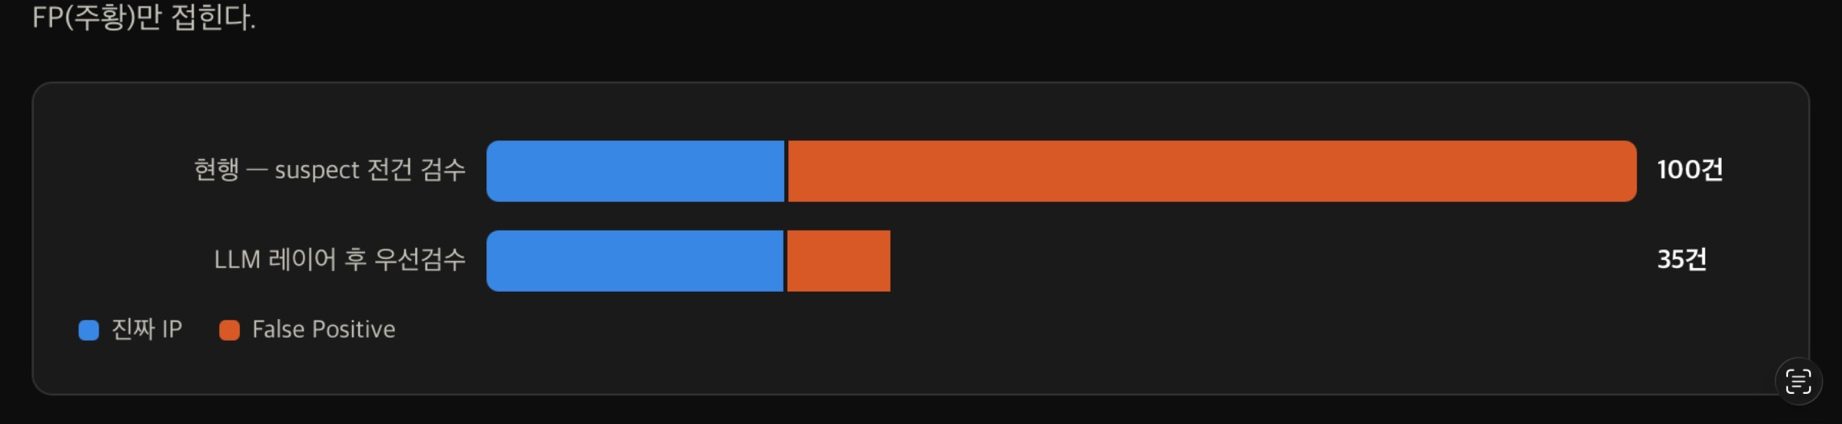
핵심은 웹상 존재 여부보다 검색 증거가 특정 IP나 인물을 가리키는지를 보는 것이었다. 다만 이 출력만으로 실제 권리 관계를 확정할 수 있는 것은 아니다. 우리가 만든 것은 광고·검수 흐름에서 확인할 후보를 가르는 판정 시스템이었다. ## 수동 라벨링으로 바뀐 결과를 확인했다 100건을 수동으로 라벨링해 진짜 문제 사례와 오탐을 구분했다. LLM 레이어를 추가한 평가에서는 문제 사례를 놓치지 않으면서 오탐이 줄었다. ![IP 판정 평가의 최종 지표](/assets/images/notion/9c9e5ee4759f74ffb566/12-ip-detection.png)
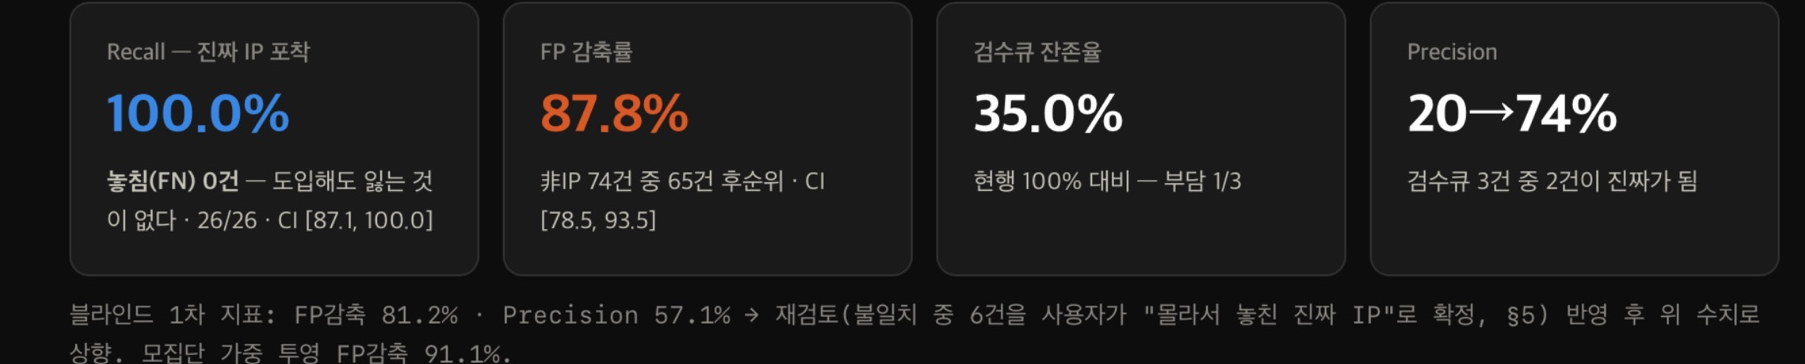
IP 판정 평가의 최종 지표

![판정 전후의 검수 후보 비교](/assets/images/notion/9c9e5ee4759f74ffb566/13-ip-detection.png)

판정 전후의 검수 후보 비교

실험 대시보드에는 recall 100%, FP 감소율 87.8%, precision 20% → 74%가 기록돼 있다. 표의 최종 수치는 불일치 사례를 재검토한 뒤 반영한 결과다. 알려진 문제 26건을 모두 남겼고, 비IP 74건 중 65건을 후순위로 돌려 검수 큐 잔존율은 35%가 됐다. precision은 전체 정확도가 아니라, 검수 큐에 남긴 후보 중 실제 문제 사례가 차지하는 비율이다. 여기서 recall 100%는 해당 평가 표본에서 FN이 없었다는 뜻이다. 이미지에도 26/26의 신뢰구간이 함께 표시돼 있다. 서비스의 모든 IP를 놓치지 않는다는 의미로 확대할 수는 없다. 초기 1,000건 EDA와 이후 라벨링 평가도 서로 다른 목적의 표본이었다. 단일 호출과 세 번 호출하는 앙상블도 비교했다. 120건에서 개선된 것은 한 건이어서, 그 실험에서는 호출을 세 배로 늘릴 만큼 큰 차이가 아니었다. JSON 파싱 오류가 나면 재시도하는 대체 경로는 남기고, 앙상블까지 사용할 필요는 없다고 판단했다. ![증거 기반 IP 판정 모델 비교](/assets/images/notion/9c9e5ee4759f74ffb566/14-ip-detection.png)
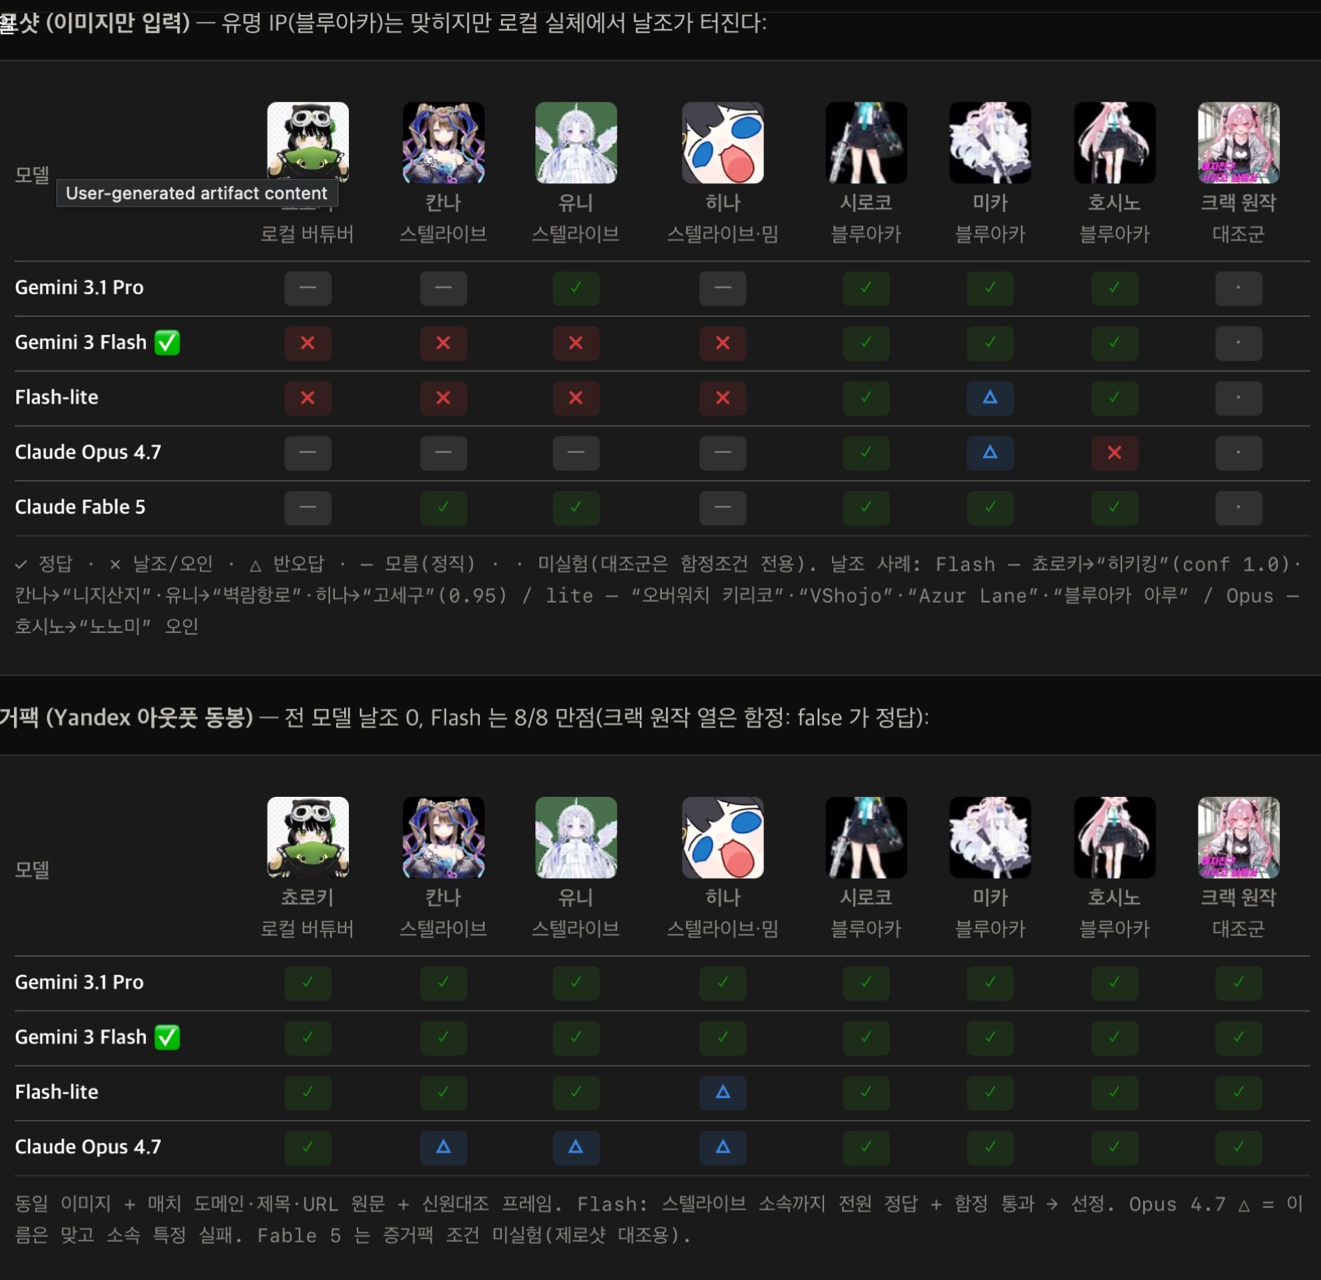
증거 기반 IP 판정 모델 비교

![단일 호출과 세 번 호출한 앙상블 비교](/assets/images/notion/9c9e5ee4759f74ffb566/15-ip-detection.png)

단일 호출과 세 번 호출한 앙상블 비교

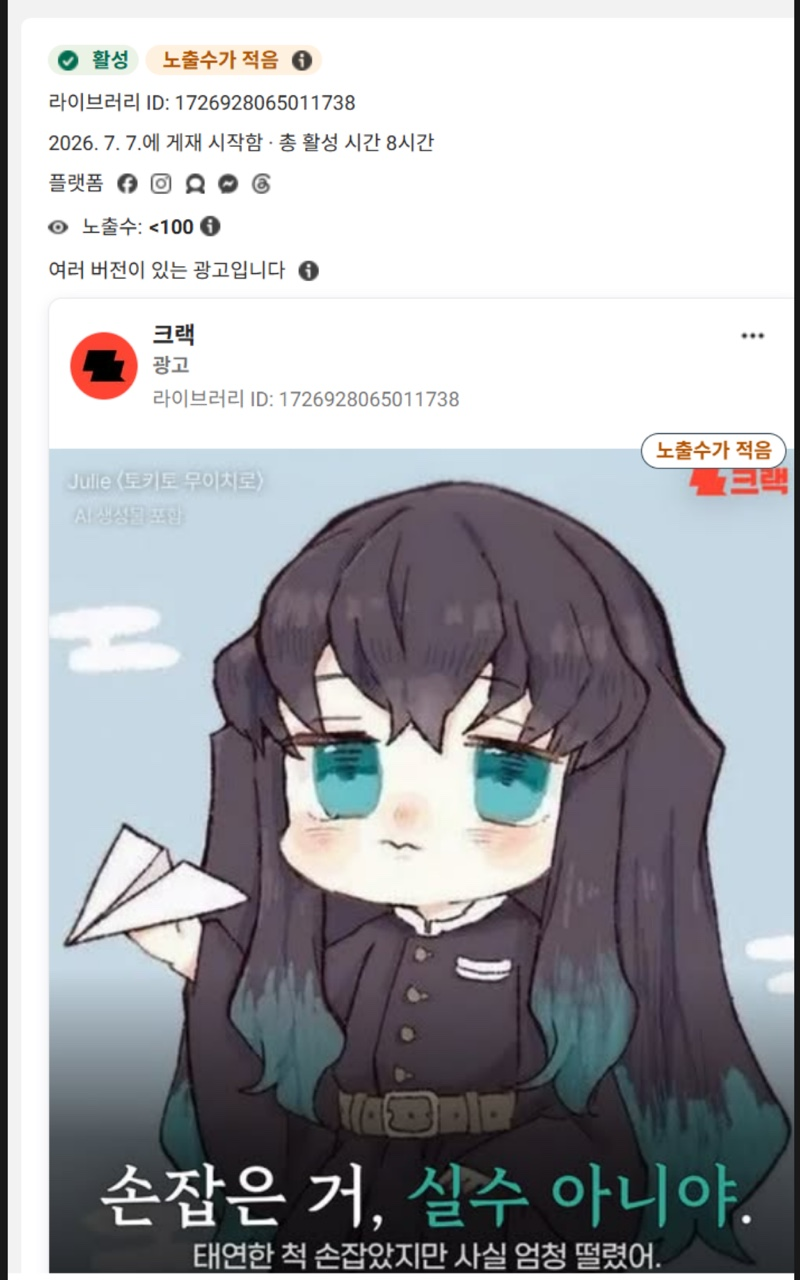
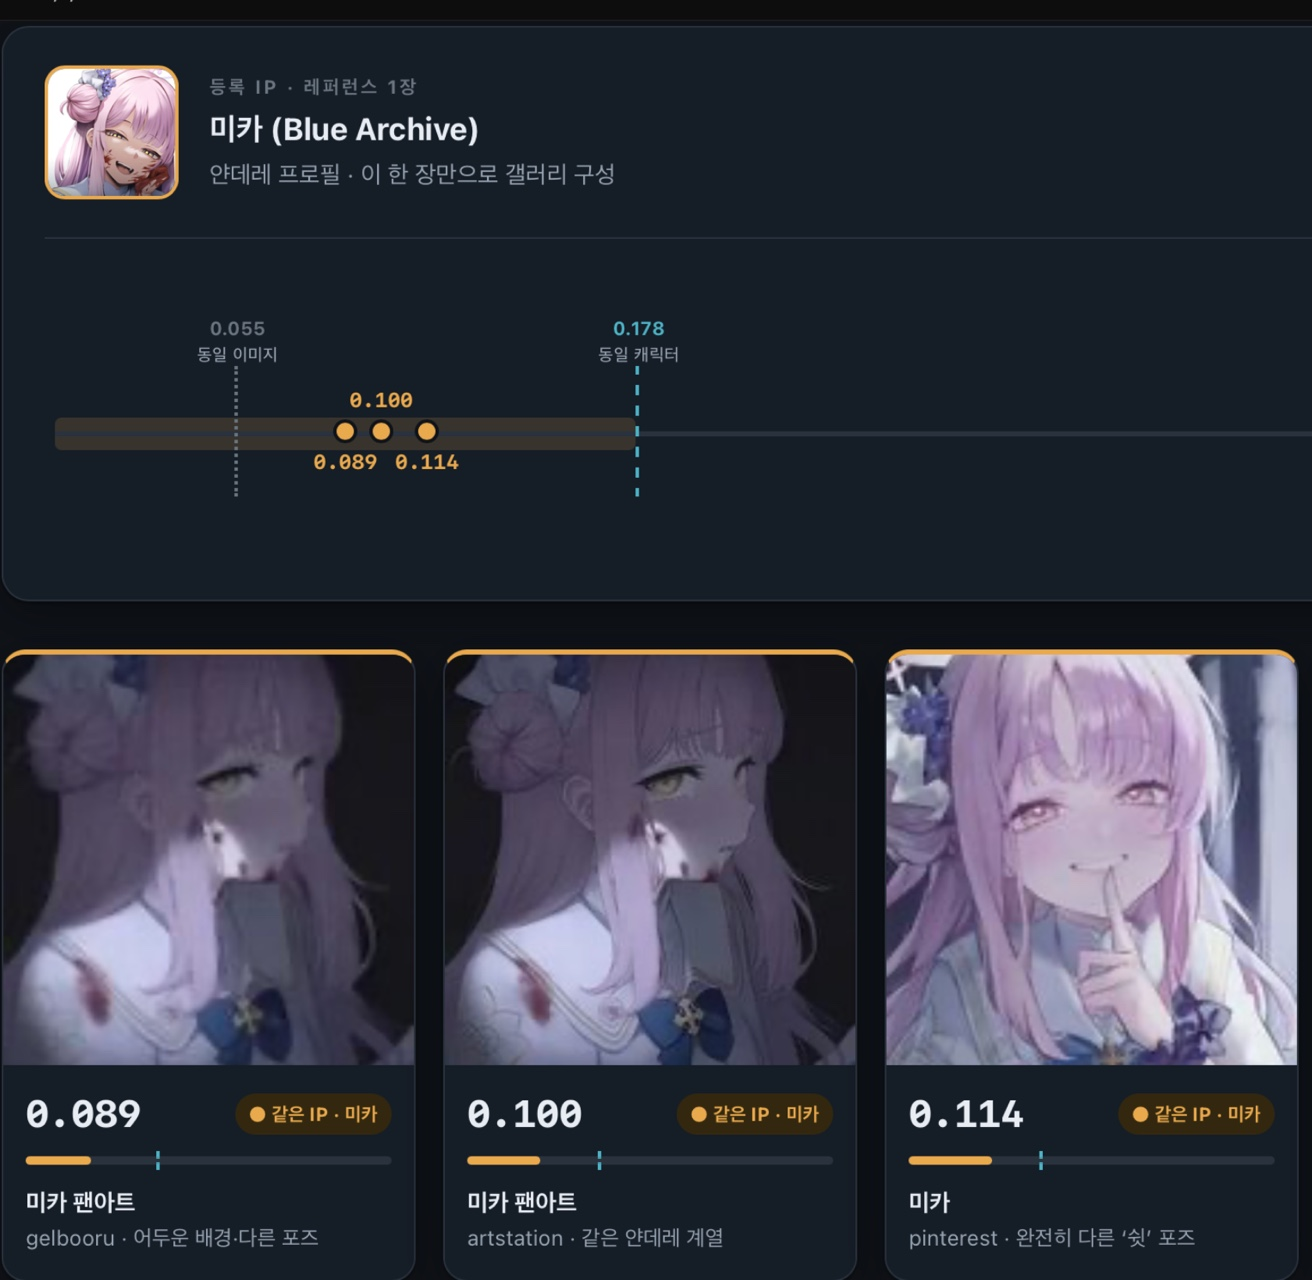
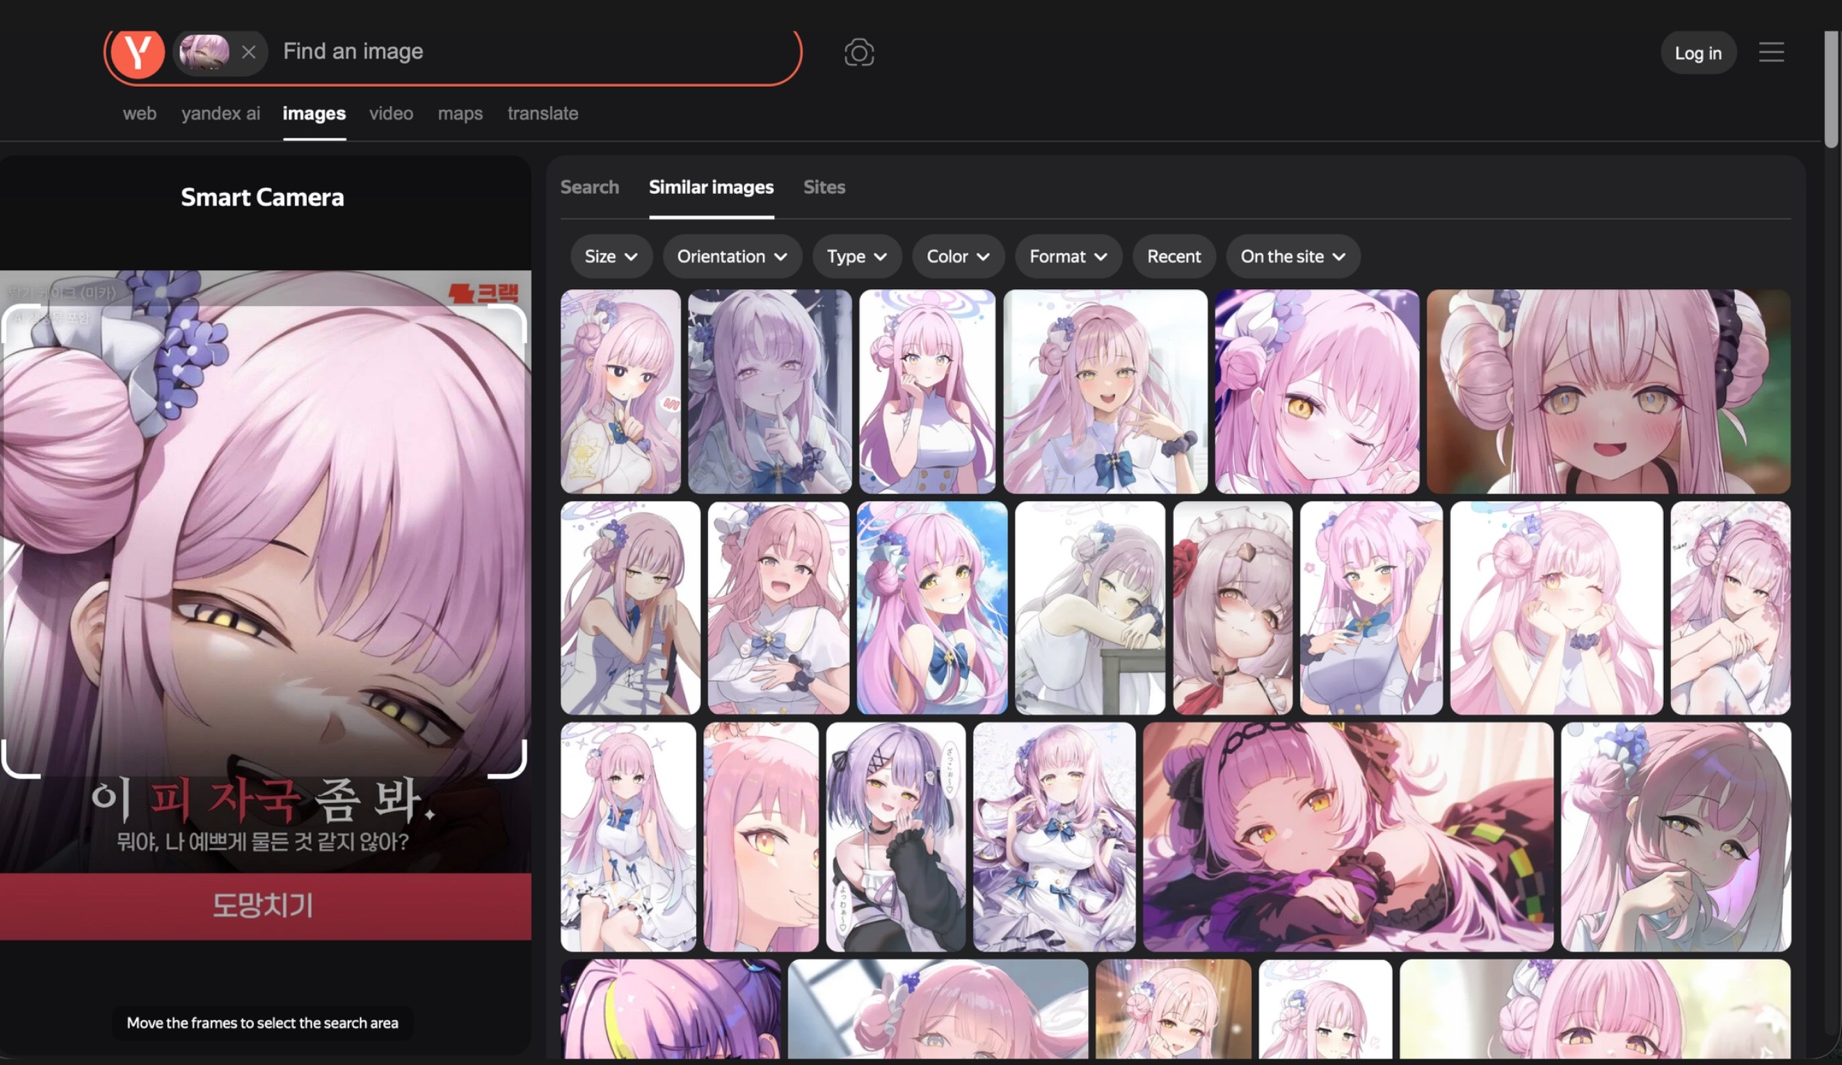
## 웹에 없는 변형 이미지는 또 다른 문제였다 반대로 역검색 결과가 없는데도 유명 IP인 그림이 있었다. 생성 모델로 변형한 이미지는 웹에 똑같은 원본이 없어서 검색에 걸리지 않을 수 있다. 블루아카이브와 귀멸의 칼날 캐릭터 사례에서 이 문제가 드러났다. ![변형 이미지에서 확인한 블루아카이브 사례](/assets/images/notion/9c9e5ee4759f74ffb566/16-ip-detection.png)
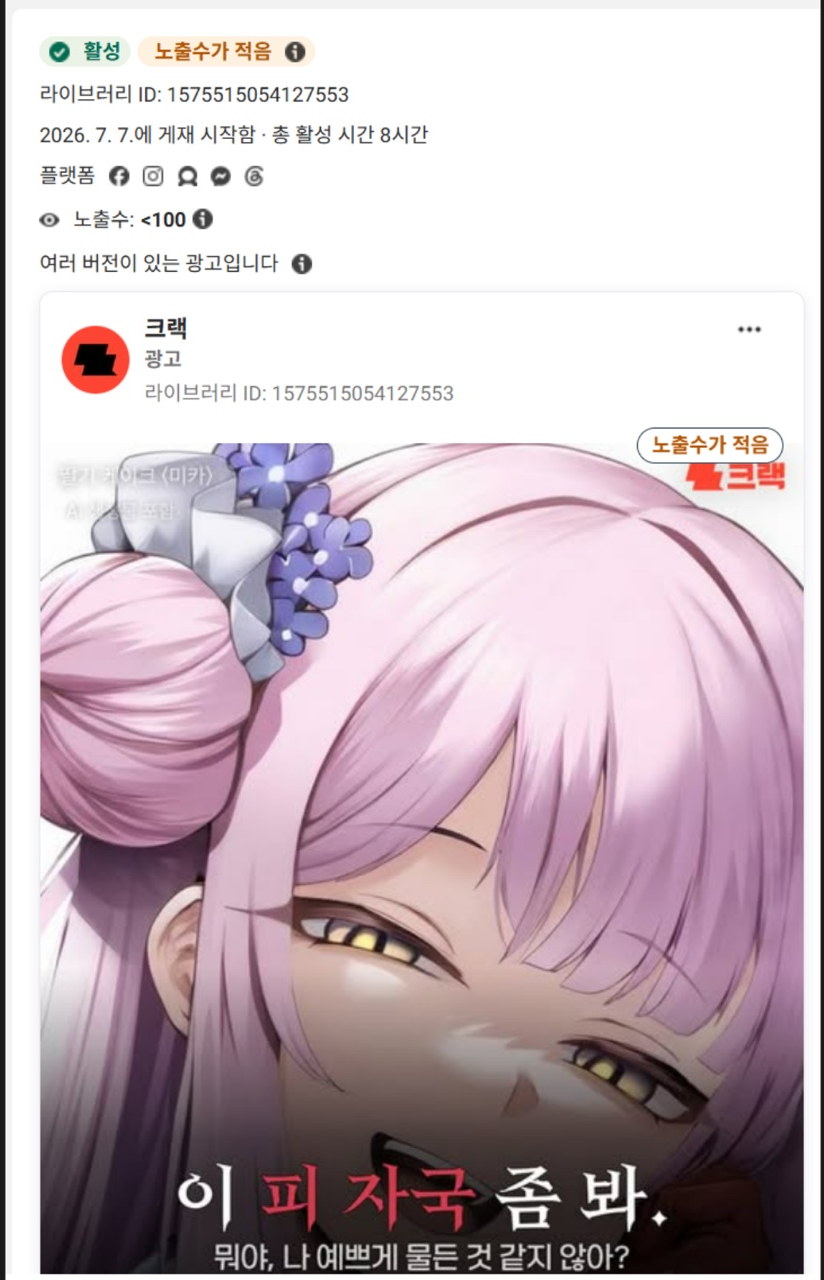
변형 이미지에서 확인한 블루아카이브 사례

![변형 이미지에서 확인한 귀멸의 칼날 사례](/assets/images/notion/9c9e5ee4759f74ffb566/17-ip-detection.png)

변형 이미지에서 확인한 귀멸의 칼날 사례

![웹 역검색에서 확인한 후보 이미지](/assets/images/notion/9c9e5ee4759f74ffb566/18-ip-detection.png)

웹 역검색에서 확인한 후보 이미지

![변형 이미지의 유사 후보 검색 결과](/assets/images/notion/9c9e5ee4759f74ffb566/19-ip-detection.png)

변형 이미지의 유사 후보 검색 결과

기존의 0.055 거리 기준은 완전히 같지 않은 이미지를 후보에서 빼는 데도 영향을 줬다. 그래서 후보 기준을 0.1로 넓혔다. 더 많은 후보가 들어와도 뒤의 LLM이 검색 태그와 맥락을 확인하도록 했다. 역검색을 보완하기 위해 파이프라인 앞단에도 WD-Tagger를 연결했다. Danbooru 어휘를 기반으로 유명 애니·게임 캐릭터를 식별하는 경로다. 역검색이 0건이었던 원피스 합성 포스터에서 태거는 roronoa_zoro를 높은 점수로 잡았다. 문제가 있었던 두 스토리도 유명 IP여서 태거로 걸러낼 수 있었다. ![WD tagger를 추가한 IP 탐지 흐름](/assets/images/notion/9c9e5ee4759f74ffb566/20-ip-detection.png)
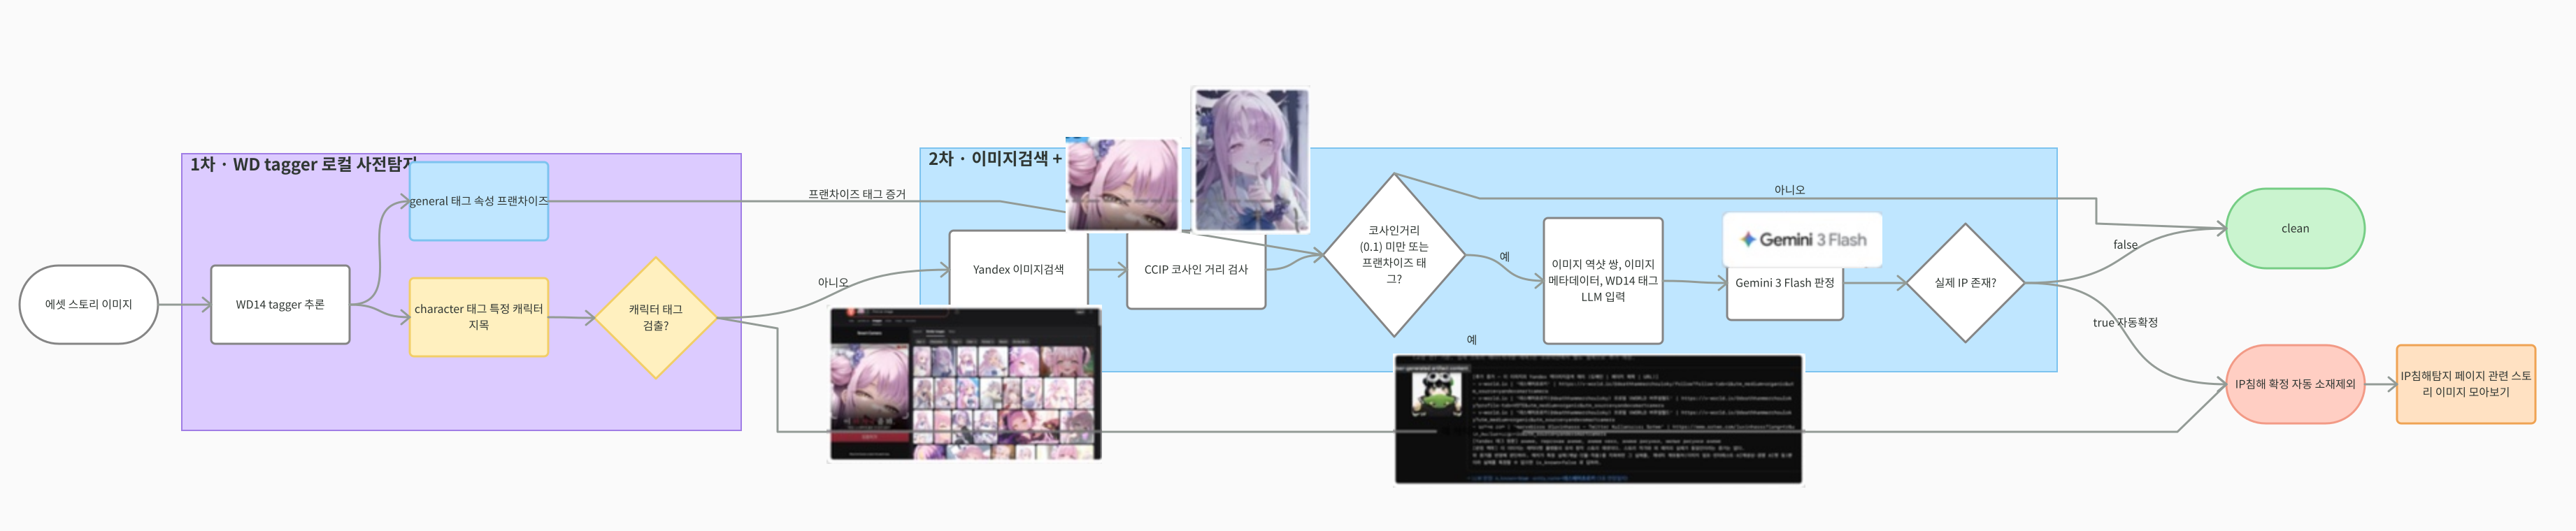
WD tagger를 추가한 IP 탐지 흐름

태거만으로 끝낼 수도 없었다. 일본 애니·게임에 강한 반면 한국 버튜버는 어휘 커버리지에 없어서 못 잡는 사례가 있었다. 태거와 역검색+LLM은 서로 다른 실패를 보완했다. 이미 서비스에서 검수한 오리지널 스토리는 이 검사에서 별도로 제외했다. 처음에는 이미지가 같은지를 잘 찾으면 문제가 해결될 거라고 봤다. 실제로는 같은 이미지가 있어도 판정을 보류해야 하는 경우와, 같은 이미지가 없어도 알려진 캐릭터인 경우가 함께 있었다. 운영 사례가 생길 때마다 그 차이를 분리하고, 어느 단계가 그 증거를 다룰 수 있는지 다시 설계했다. 본문의 데이터 흐름 애니메이션은 3Blue1Brown의 오픈소스 [Manim](https://github.com/3b1b/manim)에서 출발한 [Manim Community](https://www.manim.community/)로 만들었다. ### 한국에서 만든 광고 파이프라인을 북미·일본으로 확장하기 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-07-global-expansion/ - Collection: Project - Published: 2026-10-12 - Tags: Project 광고 소재 제작 파이프라인은 크랙에서 먼저 만들었다. 이후 북미 OOC와 일본 캬라푸로 확장했다. 이미 돌아가는 생성 흐름이 있으니 언어만 바꾸면 될 것 같지만, 실제로는 입력 데이터와 UI, 폰트, 디자인 레퍼런스가 달랐다. 공통으로 쓸 수 있는 제작 단계는 유지하고, 서비스마다 다른 조건을 어디에서 분기할지 정하는 작업이었다. ## 입력 스키마부터 달랐다 크랙에서 쓰던 `ending`, `play_guide`, `taste_score`, 추천용 11축 태그가 OOC·캬라푸 테이블에는 없었다. 같은 필드를 당연히 읽는 코드로는 확장할 수 없었다. 없는 값은 입력에서 빼고, 각 서비스가 제공하는 세계관과 시작 상황을 중심으로 기획하도록 구성했다. 소구점과 카피 프롬프트도 언어별로 분기했다. 한국어의 장르 표현을 그대로 번역하기보다는, 해당 언어에서 실제 광고로 쓸 수 있는 문장이 필요했다. 생성 결과의 폴더와 파일명에도 서비스가 드러나게 해서, 마케터분들이 결과를 구분할 수 있도록 했다. ![크랙·OOC·캬라푸 서비스별 제작 분기](/assets/images/notion/a64cb1cb140d8e54856c/01-global-expansion.png)
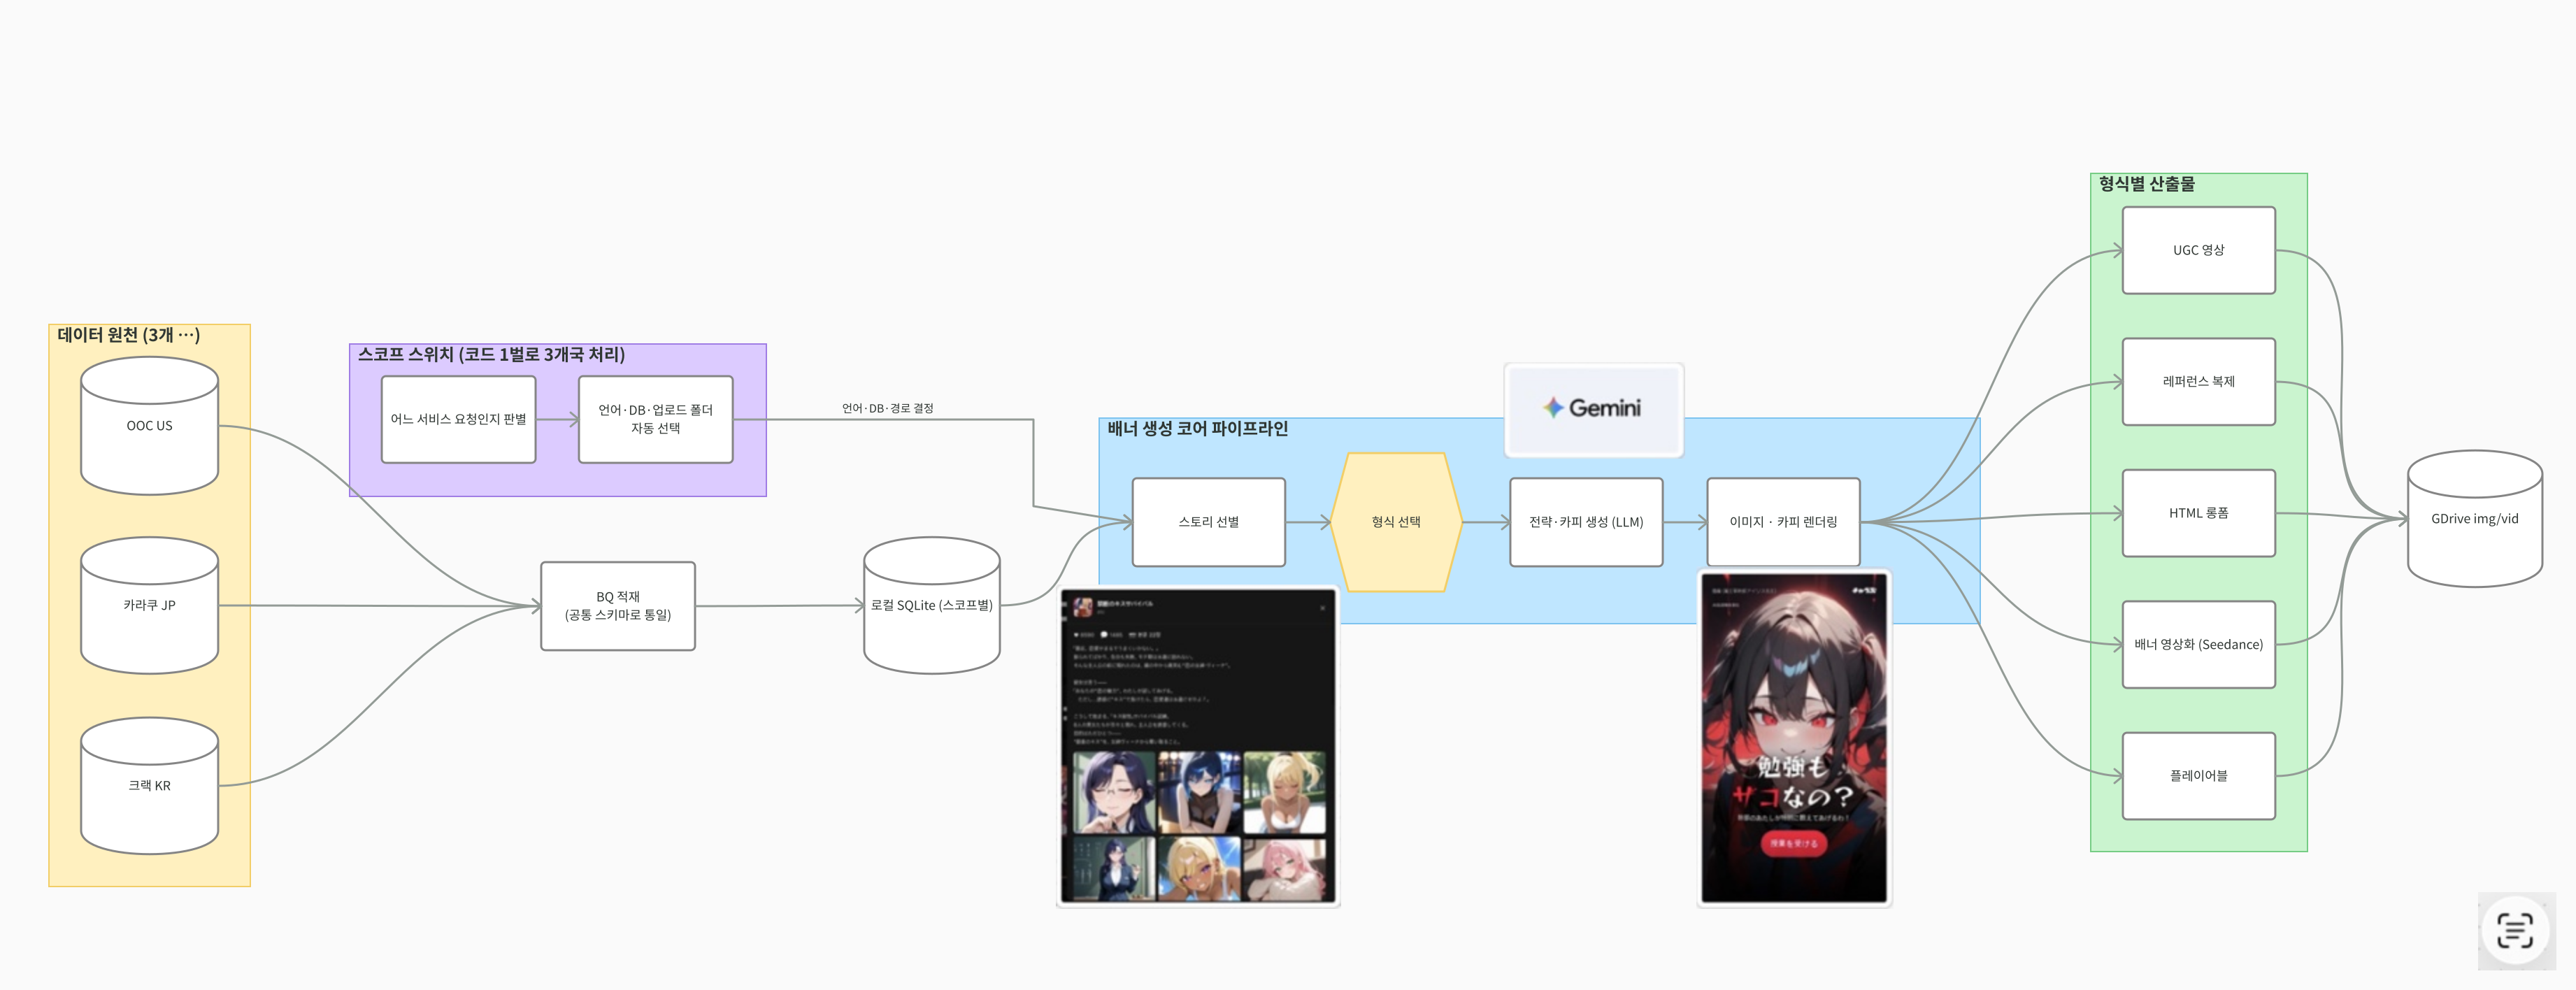
크랙·OOC·캬라푸 서비스별 제작 분기

같은 스토리→소구점→소재 흐름을 유지하되, 플레이어블 UI는 각 서비스에 맞춰 바꿨다. 이미지 배너와 플레이어블, 모션 등 기본 제작 경로를 먼저 확장하고, 현지 레퍼런스에 맞추는 작업을 이어서 했다. ## 폰트와 디자인도 서비스의 일부였다 기존 폰트가 일본어를 지원하지 않아 폰트 라이브러리를 새로 구성했다. 카피를 일본어로 잘 만들더라도 글자가 표시되지 않으면 배너로 쓸 수 없었다. 언어 지원은 스타일 이전에 확인해야 하는 조건이었다. ![일본어를 지원하는 폰트 라이브러리](/assets/images/notion/a64cb1cb140d8e54856c/02-global-expansion.png)
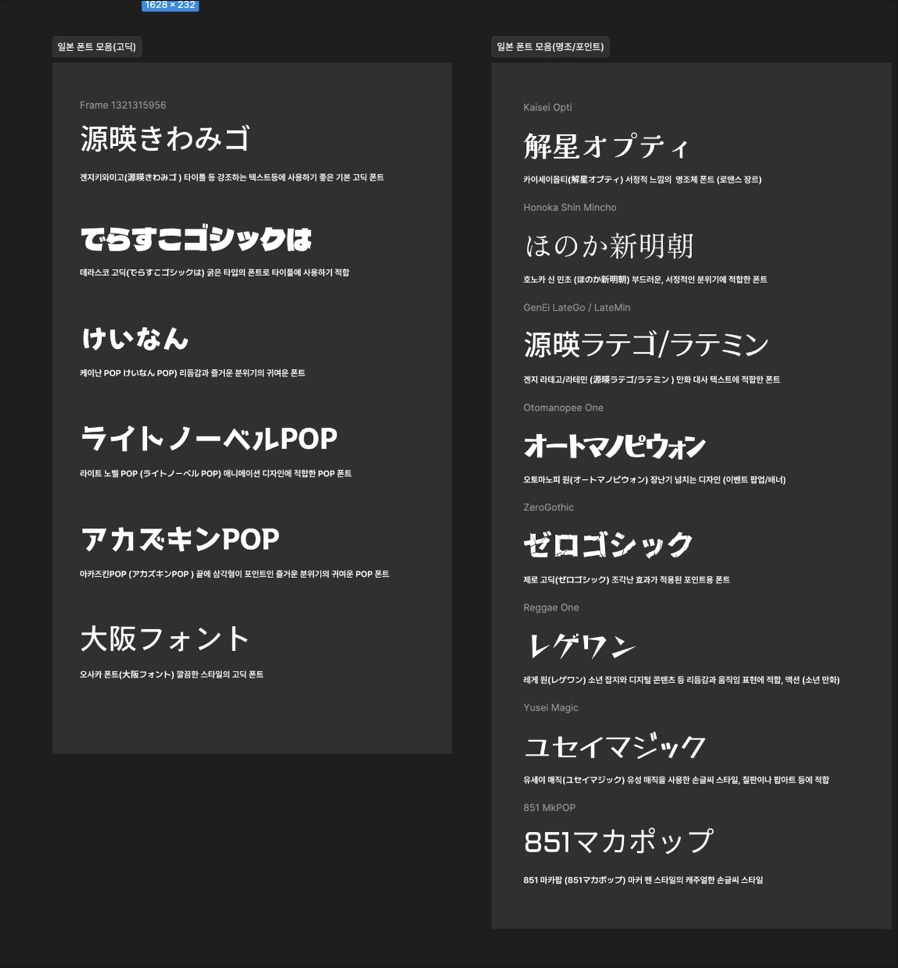
일본어를 지원하는 폰트 라이브러리

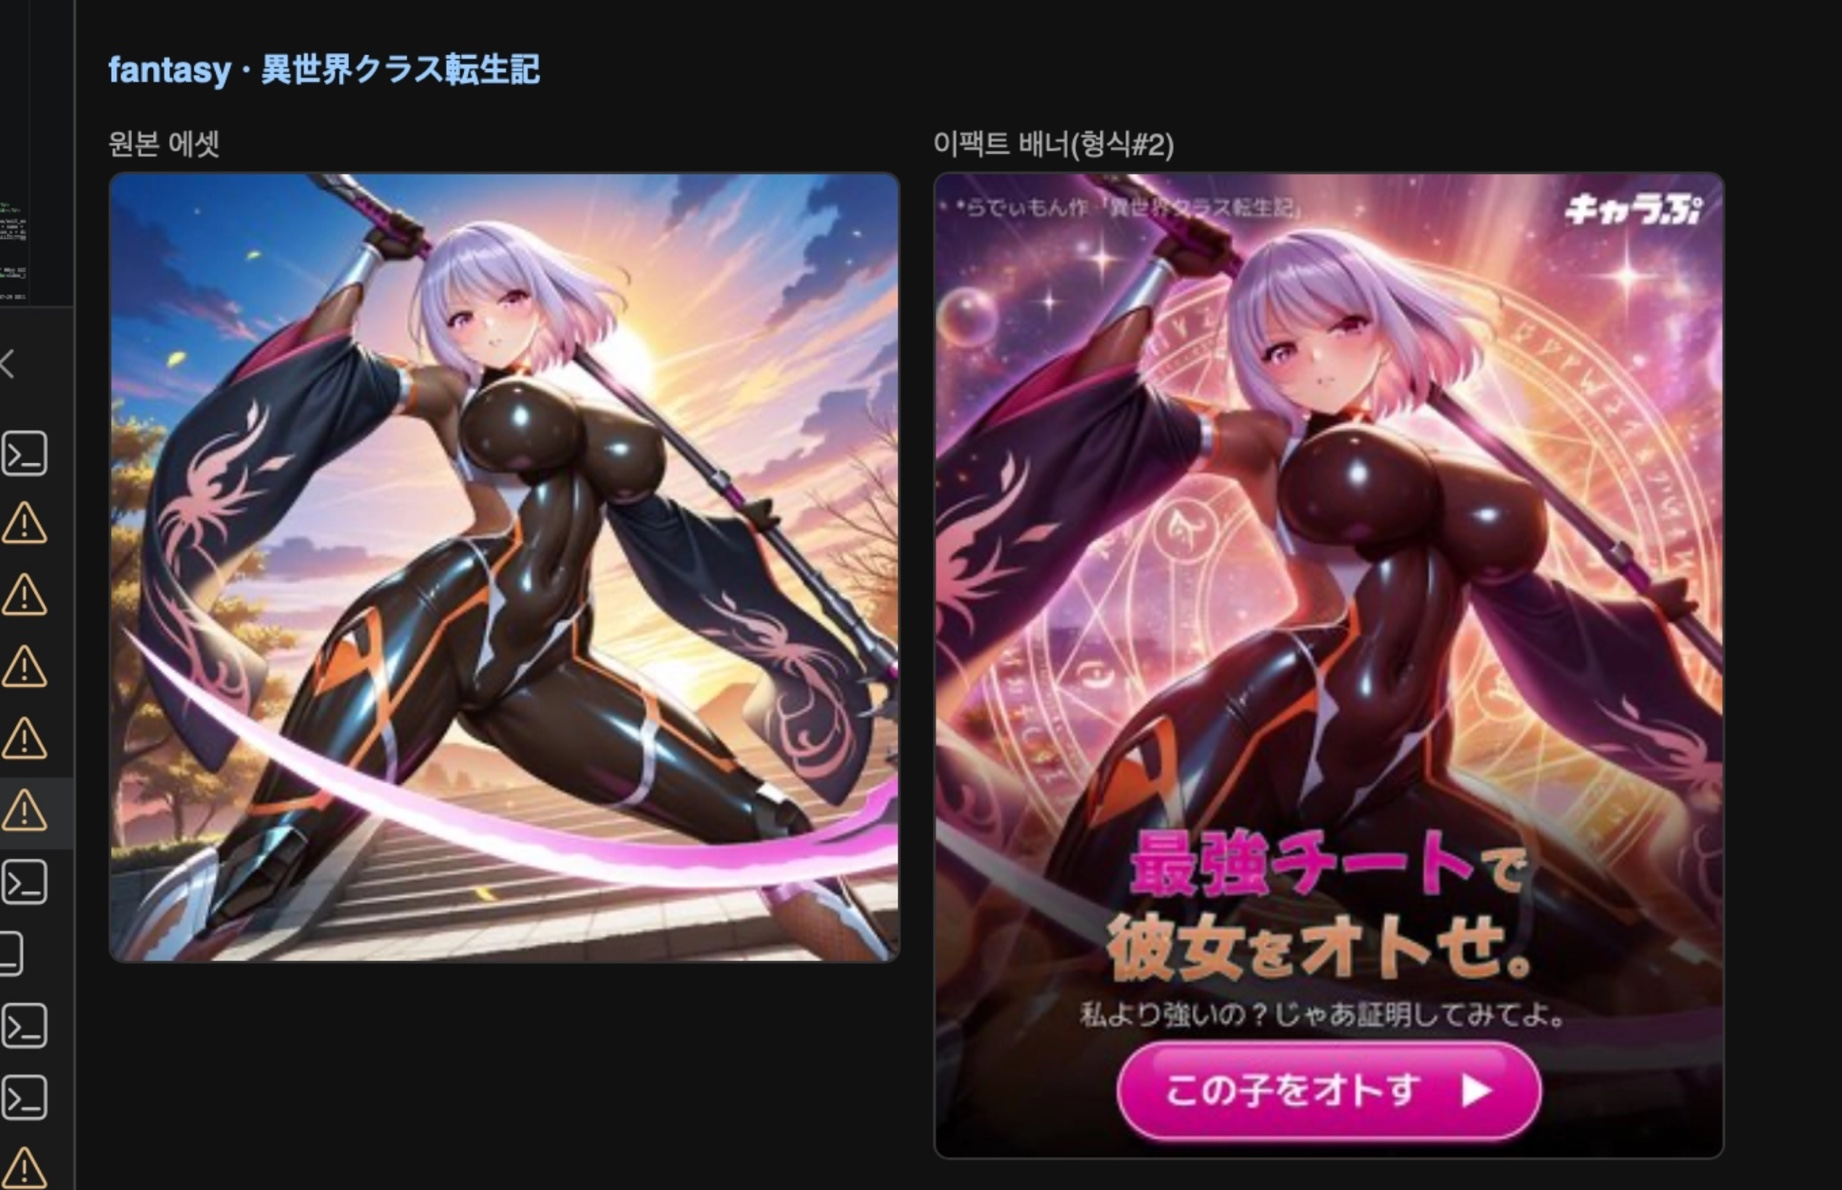
OOC에서는 기존 배너에 폰트 색상과 이펙트를 추가하는 식으로 시작할 수 있었다. 캬라푸의 레퍼런스는 더 다양했다. 일본 마케터분들과 싱크를 맞추고, 어떤 표현을 생성 규칙으로 옮길지 정리했다. ![캬라푸에서 생성한 이미지 배너](/assets/images/notion/a64cb1cb140d8e54856c/03-global-expansion.png)
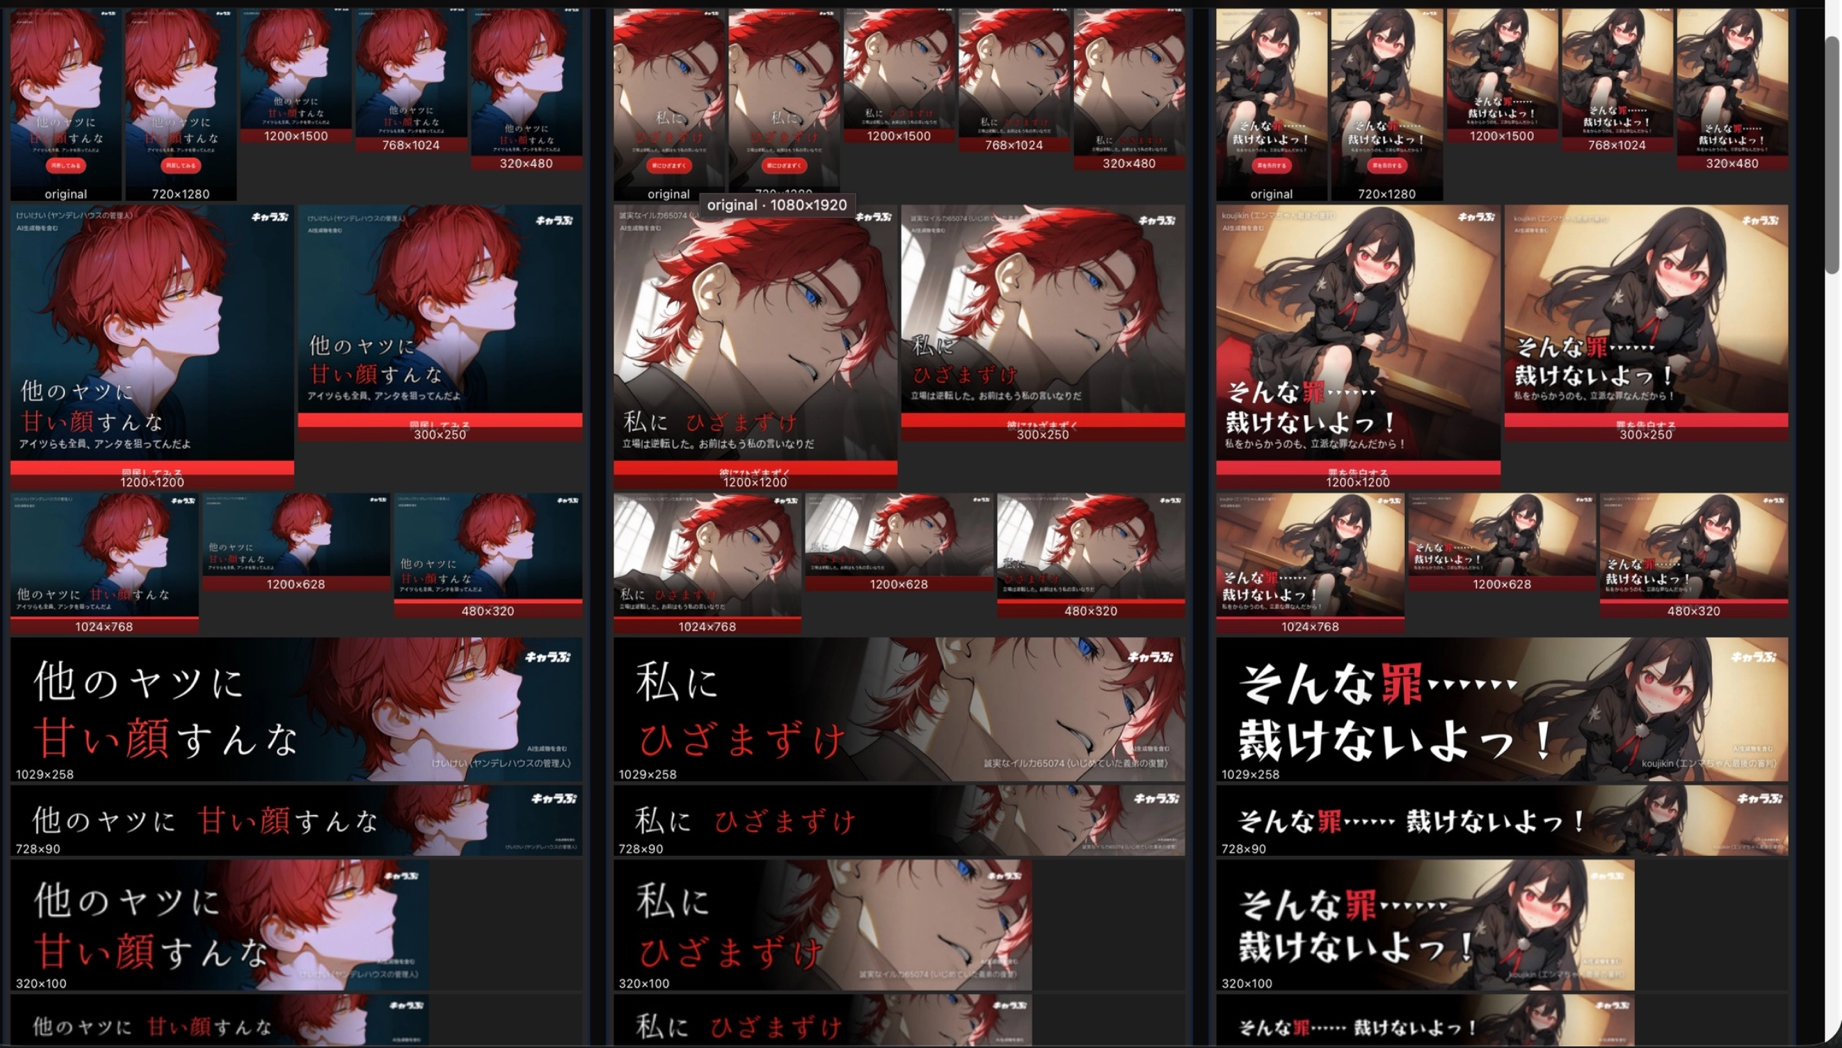
캬라푸에서 생성한 이미지 배너

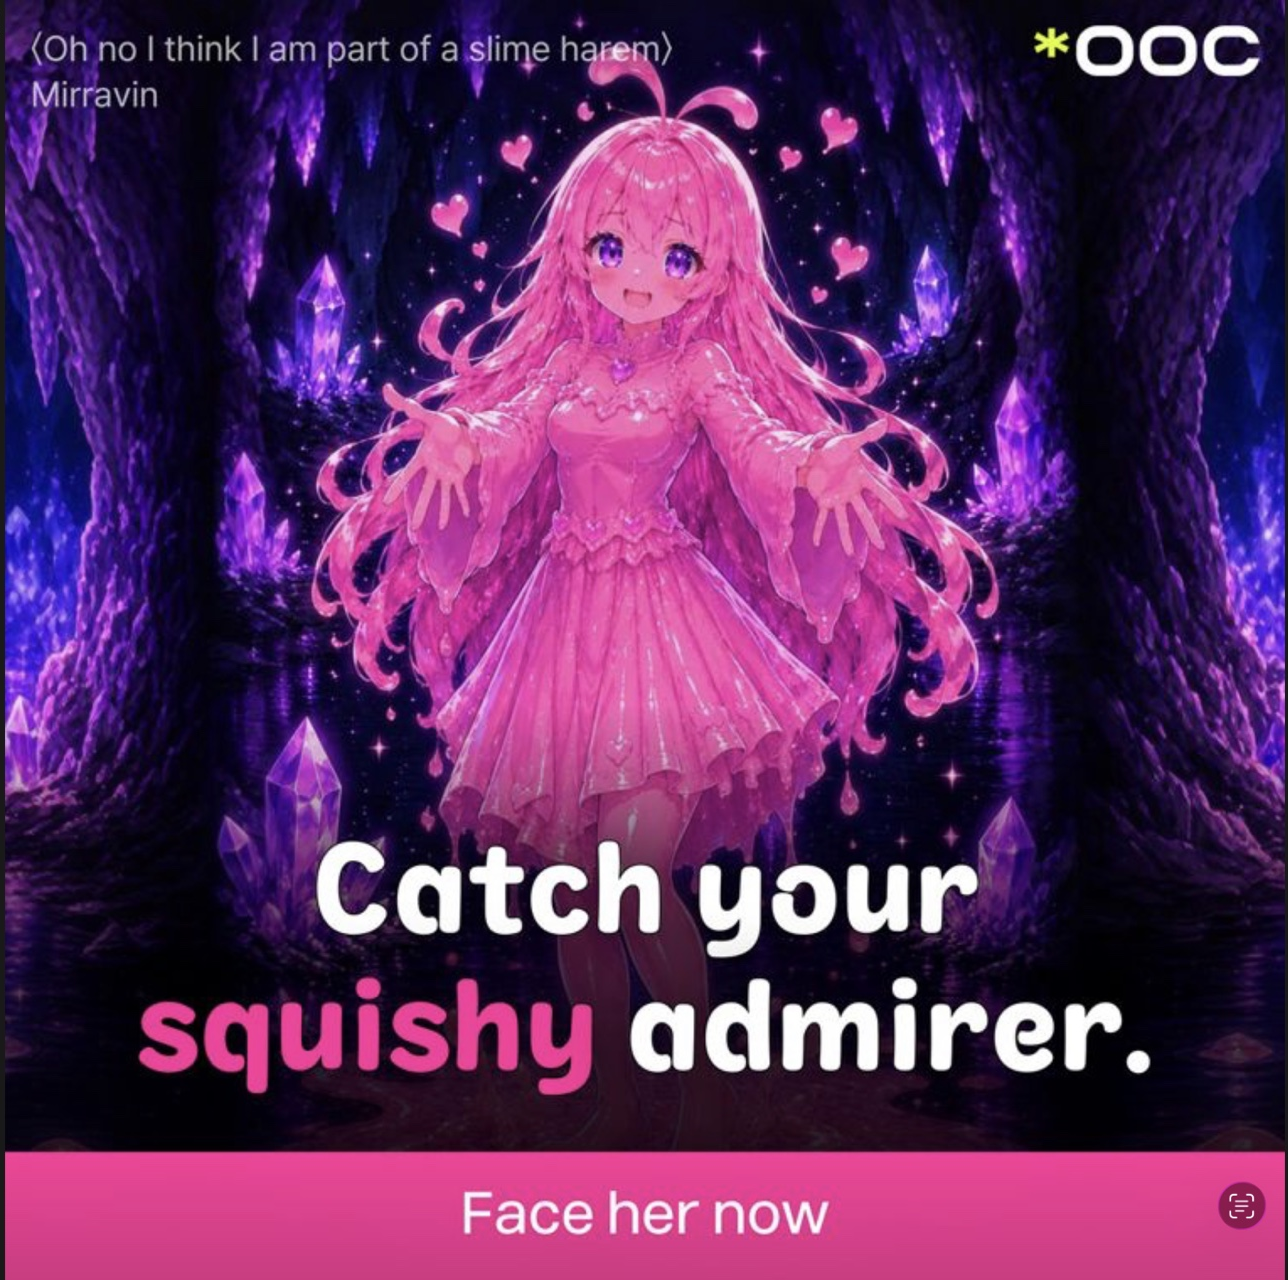
![OOC에서 생성한 소재 예시](/assets/images/notion/a64cb1cb140d8e54856c/04-global-expansion.png)

OOC에서 생성한 소재 예시

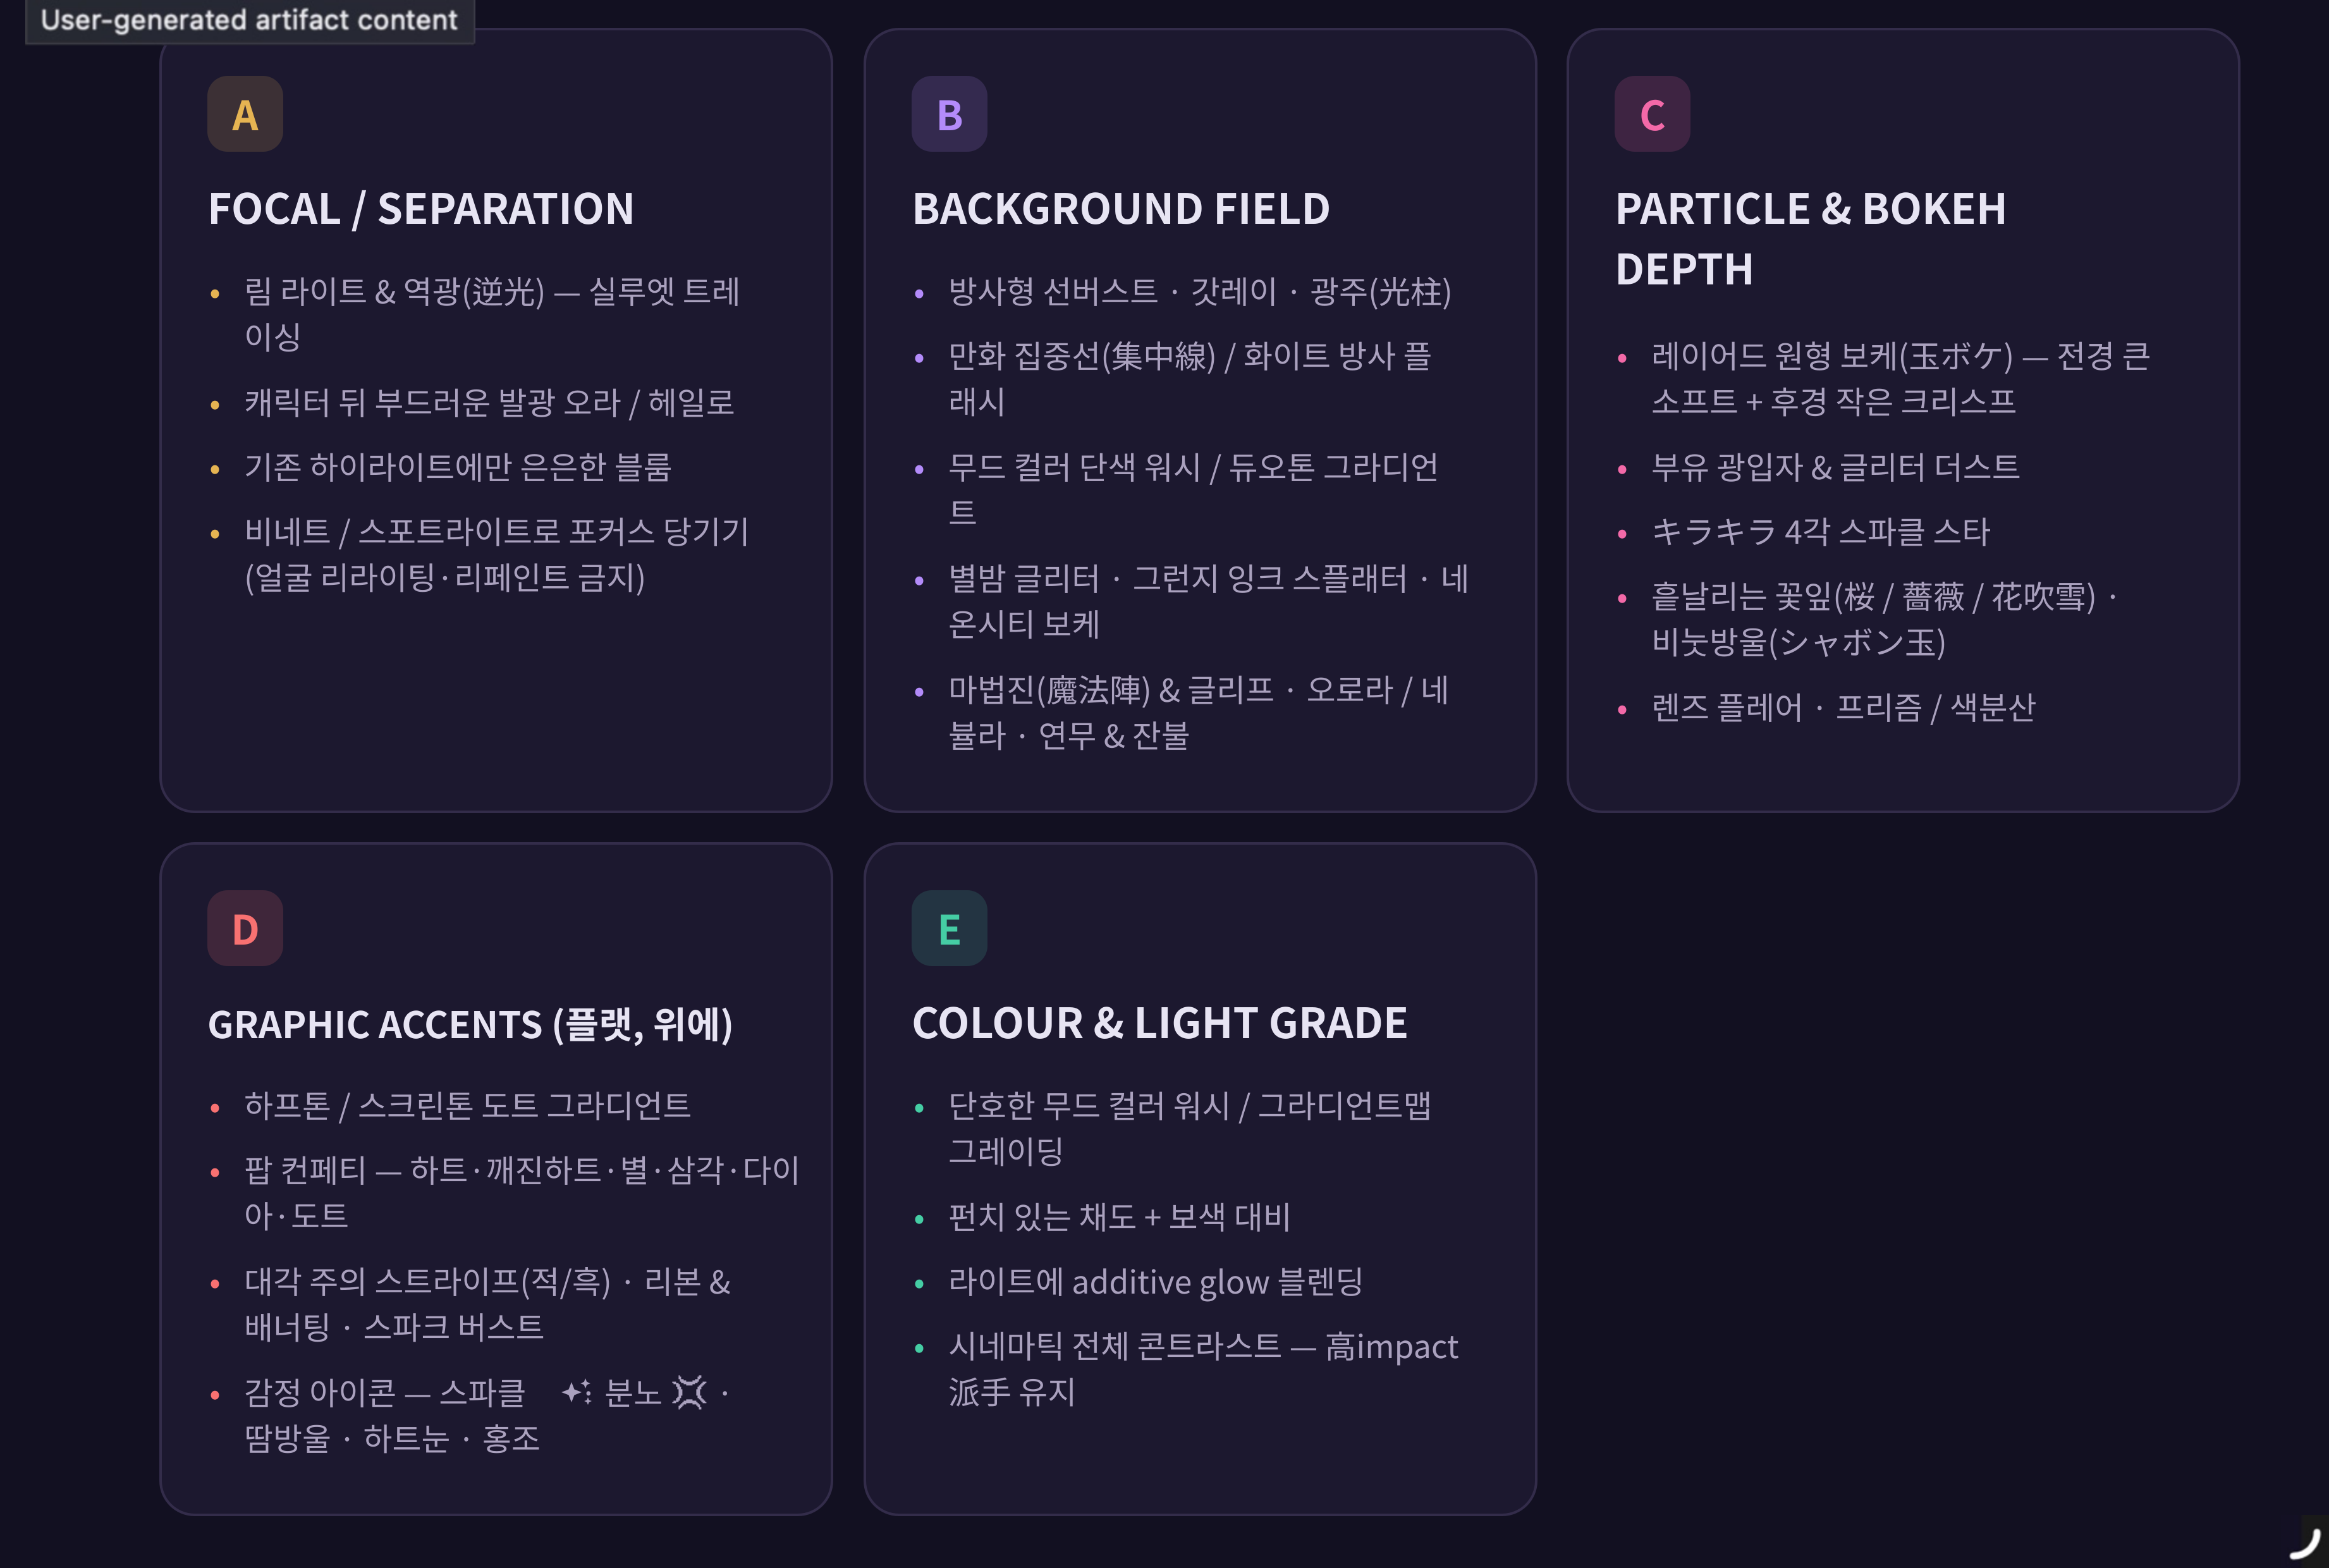
현지인이 아닌 내가 어울리는 효과를 혼자 정하기 어려워서, 레퍼런스를 기반으로 역설계하는 방식을 택했다. Figma에 정리된 일본향 배너 약 300장을 장르별로 보고, 자주 쓰이는 효과와 분위기를 텍스트 템플릿으로 만들었다. ## 장르 템플릿만으로는 모든 그림이 비슷해졌다 장르별 `mood_template`에는 색상, 조명, 꽃잎·입자·후광 같은 효과 방향을 넣었다. 로맨스와 판타지, 코미디, 미스터리는 레퍼런스에서 사용하는 표현이 달랐다. ![효과 설계에 활용한 일본향 배너 레퍼런스](/assets/images/notion/a64cb1cb140d8e54856c/05-global-expansion.png)
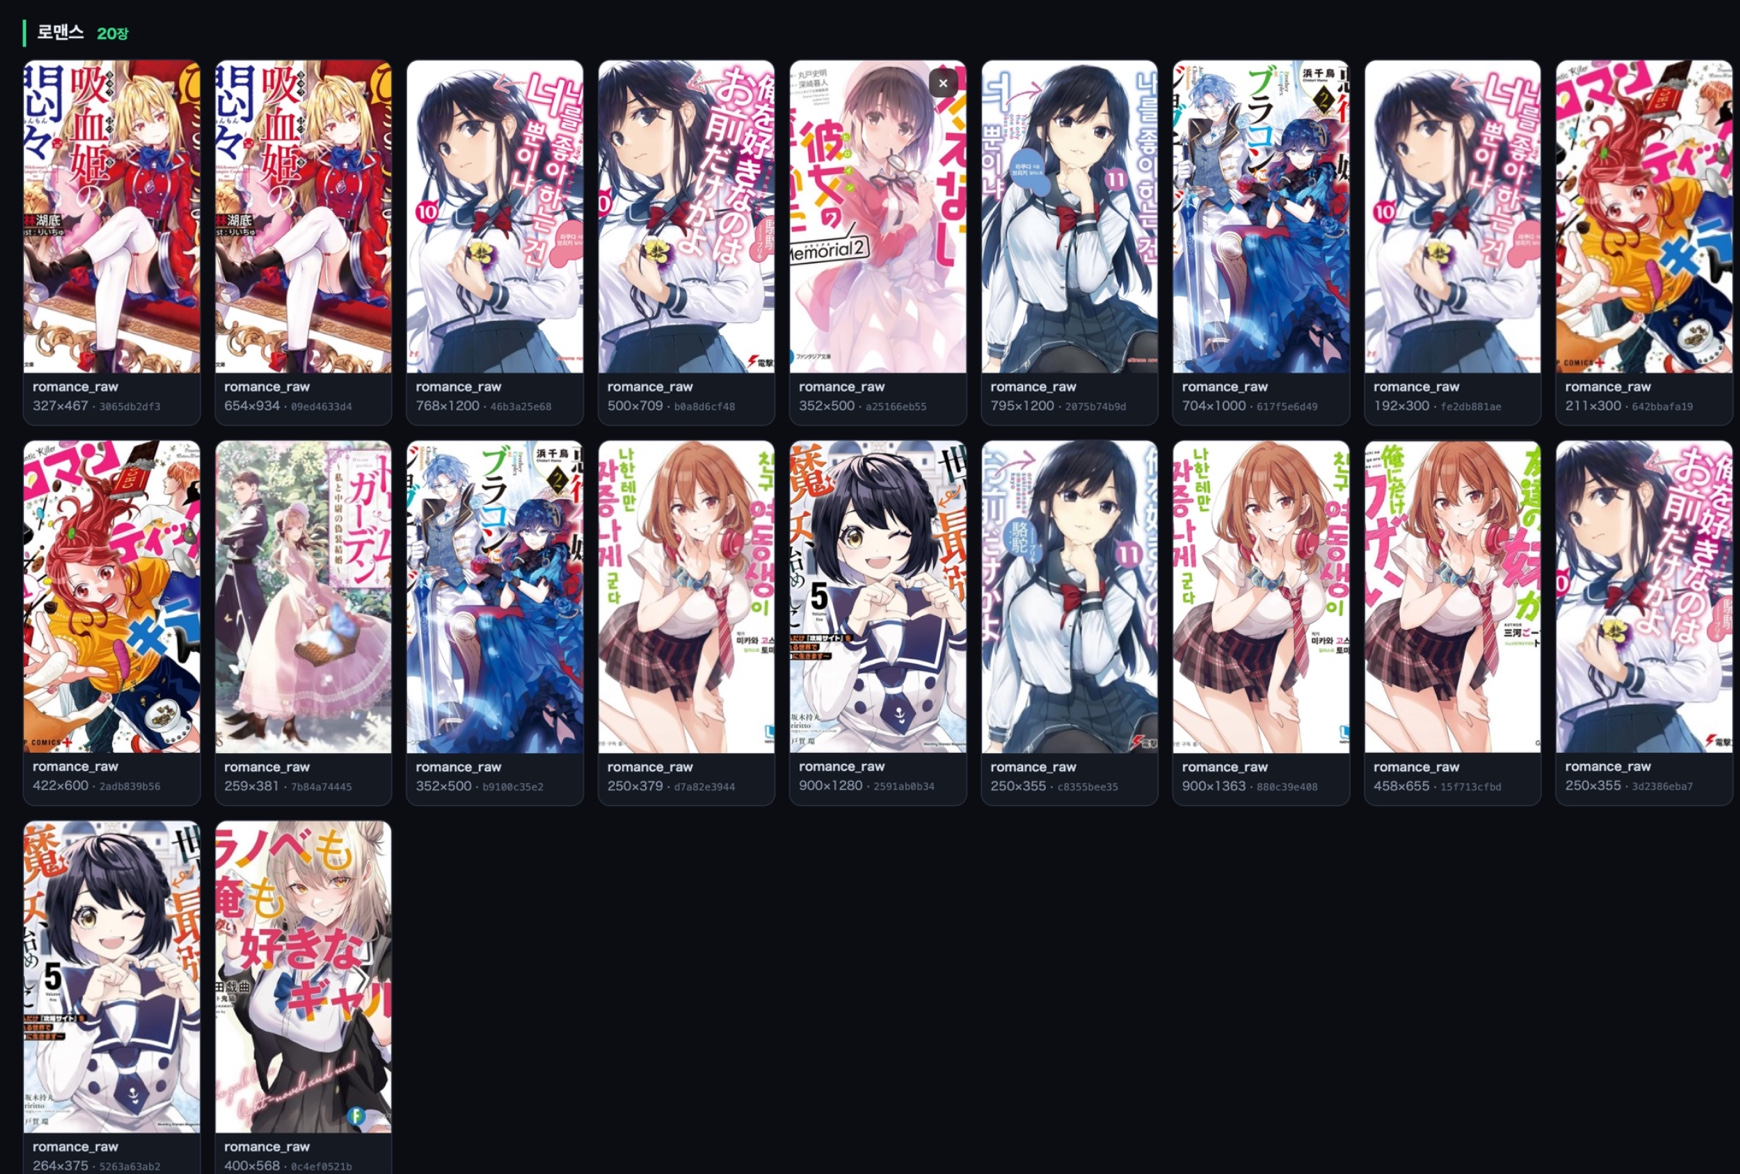
효과 설계에 활용한 일본향 배너 레퍼런스

![레퍼런스에서 정리한 효과 구성 요소](/assets/images/notion/a64cb1cb140d8e54856c/06-global-expansion.png)

레퍼런스에서 정리한 효과 구성 요소

romance-fsweet otome romance — warm pink/crimson/gold, soft dreamy soft-focus, layered 玉ボケbokeh, rose & sakura 花吹雪 petals, キラキラ sparkle, a tender glowing aura, floating hearts
romance-mwarm school romance (male lead) — pink & warm tones, bright rim light, soft bokeh, sakura petals, hearts and キラキラ, cheerful bright grade
bldramatic romance — cool blue/violet or moody warm gold, strong rim light & dramatic glow, rose petals, halftone, refined bokeh, tasteful sparkle
fantasyepic & magical — luminous god-rays/light-pillars, arcane 魔法陣 magic circle & glyphs, glowing aura, prism dispersion, aurora, floating orbs & light particles
humorbright poppy comedy (少女漫画 pop) — vivid CMYK pop colours, comic halftone burst, exclamation sparkles, hearts & confetti, high-key cheerful
mysterycool suspense / neon-noir — moody cyan/magenta, dramatic spotlight & deep shadow, faint glitch & chromatic aberration, cold sparkle, tense contrast
underworlddark & dangerous — grunge ink splatter, red/black high contrast, diagonal caution stripes, drifting embers & smoke, gold glints, broken-heart accents, deep shadow
dailysoft wholesome slice-of-life — warm sunlight 玉ボケ, gentle pastel bokeh, sakura petals, small hearts and sparkles, dreamy soft-focus
sfneon cyber — electric cyan/magenta, digital particles & data motes, non-text HUD glints, 稲妻 lightning, lens flare, glowing grid lines
periodelegant traditional — gold accents, 桜 sakura & 花吹雪, ink-wash (水墨) haze, seigaiha wave motifs, refined warm glow, stained-glass light
sportsdynamic & energetic — bold speed lines & 集中線, impact bursts, motion streaks, vivid punchy complementary contrast, sweat-drop energy
etc · (기본)vivid & eye-catching — bold mood grade, layered bokeh, sparkle-dust, confetti, dramatic rim light
그런데 같은 장르에 같은 템플릿만 넣으면 서로 다른 캐릭터에도 비슷한 효과가 붙었다. 그래서 이미지마다 따로 읽은 palette를 추가했다. 장르의 기본 분위기와 해당 캐릭터 그림의 색·표정·구도를 함께 쓰는 방식이다. 효과는 인물 주변과 뒤쪽에 배치하고 얼굴이나 몸을 가리지 않게 했다. 템플릿, 이미지별 효과 방향, 원본 이미지를 i2i 모델에 넣었다. 효과가 많아지는 것 자체보다 원본의 인물과 카피가 살아 있는지를 봐야 했다. ![코미디 장르의 이미지 효과 적용 예시](/assets/images/notion/a64cb1cb140d8e54856c/07-global-expansion.png)

코미디 장르의 이미지 효과 적용 예시

![판타지 장르의 이미지 효과 적용 예시](/assets/images/notion/a64cb1cb140d8e54856c/08-global-expansion.png)

판타지 장르의 이미지 효과 적용 예시

예시는 장르별 분위기를 반영한 산출물이다. 배너가 레퍼런스와 비슷한 형태가 됐다는 것과 실제 광고 성과가 좋다는 것은 별개라, 디자인 변화만으로 성과 개선을 주장하지는 않으려고 한다. ## 원본 썸네일을 규격에 맞추는 별도 경로 캬라푸에서는 앱 썸네일 원본 자체를 네 가지 광고 사이즈로 변형하는 경로도 만들었다. 여기는 카피를 새로 얹는 배너와 조건이 달랐다. 원본에 들어 있는 타이포를 유지하면서 크레딧과 로고만 붙여야 했다. ![앱 썸네일을 광고 규격으로 바꾸는 흐름](/assets/images/notion/a64cb1cb140d8e54856c/09-global-expansion.png)
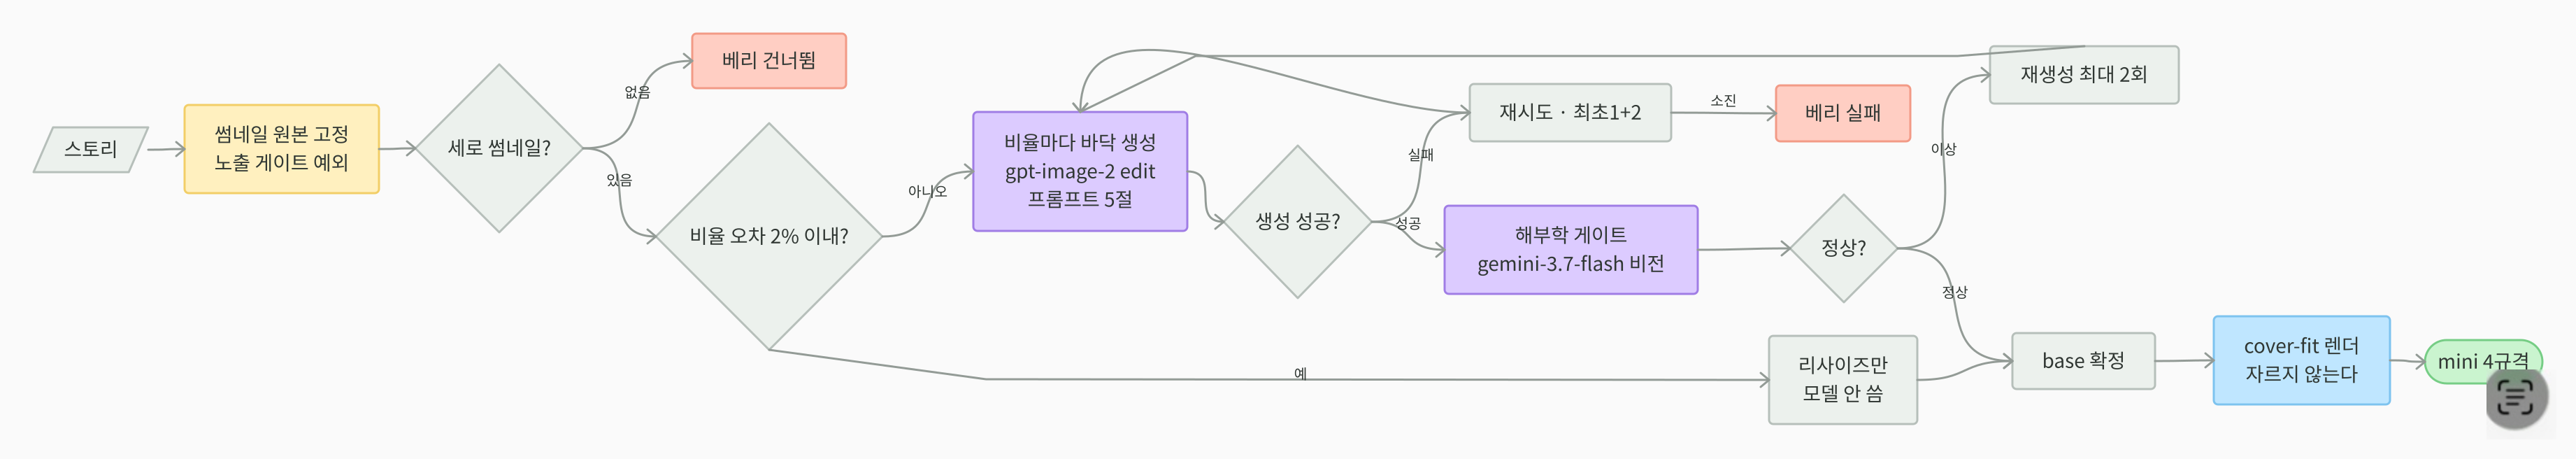
앱 썸네일을 광고 규격으로 바꾸는 흐름

모델을 부르기 전에 생성 크기부터 계산했다. 두 변은 16의 배수, 최종 결과와 같은 비율, 면적 하한과 최종 크기 이상이라는 조건을 맞췄다. 원본과 목표 비율의 상대오차가 2% 이내면 생성 모델을 호출하지 않고 리사이즈만 했다. 불필요하게 다시 그리게 하면 모델이 원본 문구를 바꾸는 문제가 있었기 때문이다. 원본의 글자는 하나의 고정된 이미지 자산으로 취급했다. 글자 블록을 통째로 옮기거나 줄일 수는 있어도, 새로운 문구를 쓰거나 글자 자체를 바꾸지 않게 했다. 원본에 글자가 없으면 결과에도 없어야 한다는 조건도 넣었다. 안전 영역을 알려주는 것만으로는 잘림 문제가 충분히 줄지 않았다. 글자 블록이 차지할 수 있는 높이를 숫자로 명시한 뒤에야 축소하는 결과가 나왔다. 상단에는 규격별로 로고·크레딧 공간을 예약했다. ```yaml AGENTS/KYARAPU_FX/MINIMAL_META.PY · REFRAME_PROMPT_TMPL (구조) ① 글자 불가침 선언 — 맨 앞에. 원본에 박힌 타이포는 "고정 자산"이며 새로 만들거나 바꾸지 않는다. ② ANATOMY 절. 가려진 신체를 예측해서 그리지 말 것. (손가락 4개/6개의 근원) ③ 상단 예약대 (reserved_top_frac). 9:16 = 11% · 1:1 = 18% · 4:5 = 14% — 크레딧·로고가 들어갈 자리. ④ 가로 SAFE AREA 가로 규격은 잘림 위험이 커서 안전 영역을 따로 선언한다. ⑤ 무자막 역방향 조항. 원본에 글자가 없으면 없는 채로 둔다 — 창작 금지. ``` 전송 장애 재시도와 해부학 오류 재생성은 따로 처리했다. 손가락이나 팔다리 형태가 계속 잘못 나오면 해당 베리에이션을 버렸다. 이 경로에서는 앱 썸네일을 광고하는 것이므로, 실패했다고 전혀 다른 그림으로 교체할 수는 없었다. ## 현지화는 계속 피드백을 받는 작업이었다 데이터 분기와 기본 제작 기능을 구현한 뒤에도 현지 고도화는 남았다. 언어가 맞고 파일이 생성된다는 사실만으로 현지 광고의 톤이 맞는 것은 아니었다. 마케터분들이 보는 카피 방향과 디자이너분들의 레퍼런스를 받아서, 반복해서 적용할 수 있는 조건으로 바꿔야 했다. 공통 파이프라인을 유지하면 새 형식과 수정사항을 여러 서비스에 전달하기 쉽다. 반면 서비스의 차이를 공통화하려고 억지로 없애면 입력도 디자인도 어색해질 수 있다. 같은 흐름을 쓰되, 없는 필드와 언어별 문장, 폰트와 규격 제약은 분명하게 나누는 쪽으로 확장했다. ### 성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-08-winning-angle-search/ - Collection: Project - Published: 2026-10-12 - Tags: Project 초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는 작업이다. 발굴 이후의 제작은 기존 서브카피·롱폼·모션 파이프라인을 그대로 사용했다. 새로 만든 것은 그 앞에서 어떤 스토리를 가져올지 정하는 검색 경로였다. ## 앵글과 실제 소재를 따로 저장했다 입력은 다른 팀원이 만든 에이전트에서 JSON 형태로 받은 광고 성과 분석과 인사이트였다. 여기에는 앵글 제목과 요약, 추천 크리에이티브 브리프, AI 분석 근거와 확신도, 뒷받침 소재 수, 위닝 형식과 매체가 들어 있었다. 이 분석 결과를 다음 스토리 검색의 입력으로 활용했고, 앵글을 뒷받침하는 배너와 원본 스토리는 별도 목록으로 남겼다. ```plaintext selection_id 앵글 고유 id title 위닝 앵글 제목 summary 요약 recommended_brief 추천 크리에이티브 브리프 (가설 시드) ai_rationale 왜 이겼는지에 대한 분석 근거 category genre_theme | copy_angle confidence 확신도 support_count 이 앵글을 뒷받침한 소재 수 media_type image | video ← 위닝 형식 platform meta | tiktok ← 위닝 매체 ``` ```plaintext folder_name Drive 폴더명 creative_name 소재 이름 material_type img | vid genre 파싱된 장르 form sub | tag | longform | motion story_id 딥링크에서 뽑은 원본 스토리 (없으면 데이터 오류) ``` '어떤 관계나 장면이 잘됐다'는 분석 문장과 실제 광고 파일이 연결돼 있어야 했다. 원본 스토리는 소재의 딥링크에서 식별했다. 이후 새 후보를 만들 때도 어떤 앵글과 검색축에서 왔는지 남겨서, 결과를 다시 확인할 수 있게 했다. ![텍스트축·이미지축의 후보를 순환 선택하는 흐름](/assets/images/notion/4f420410ac4af40875b1/01-winning-angle-search.gif)
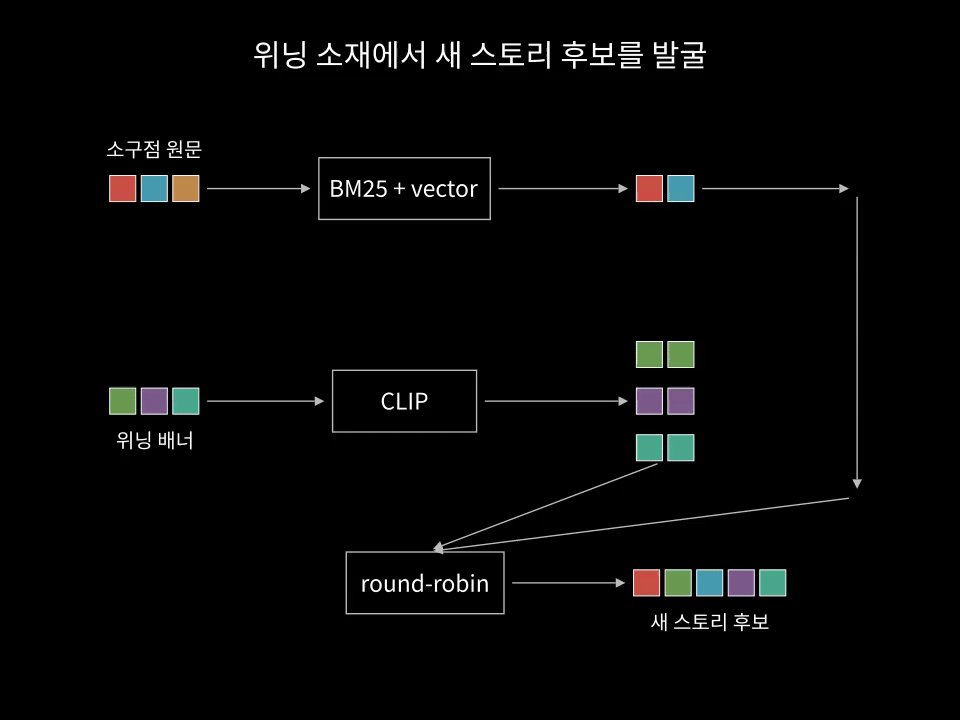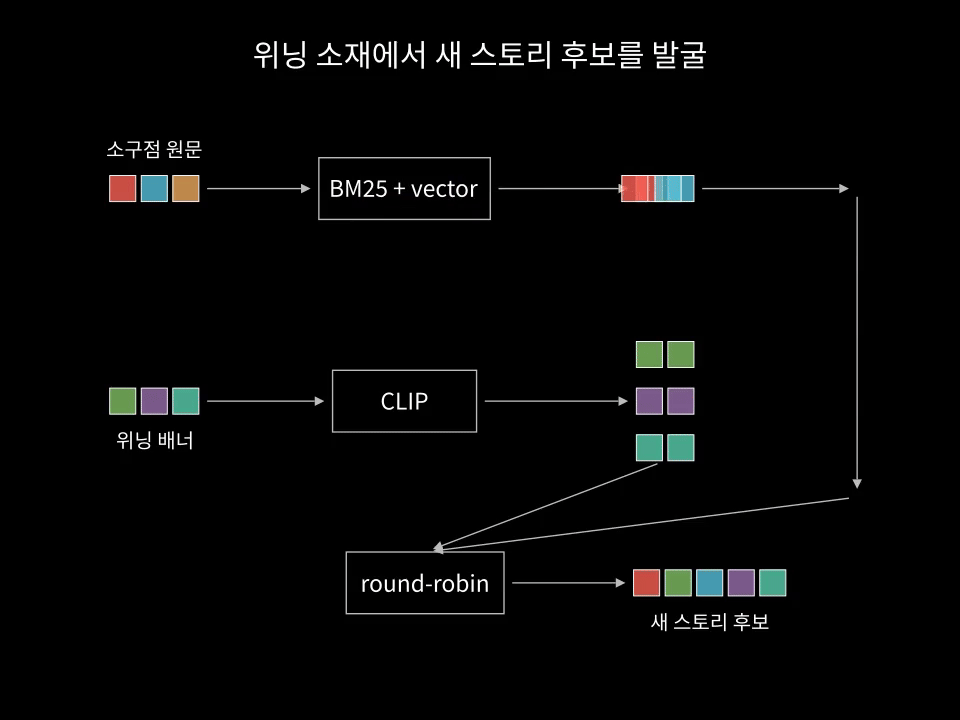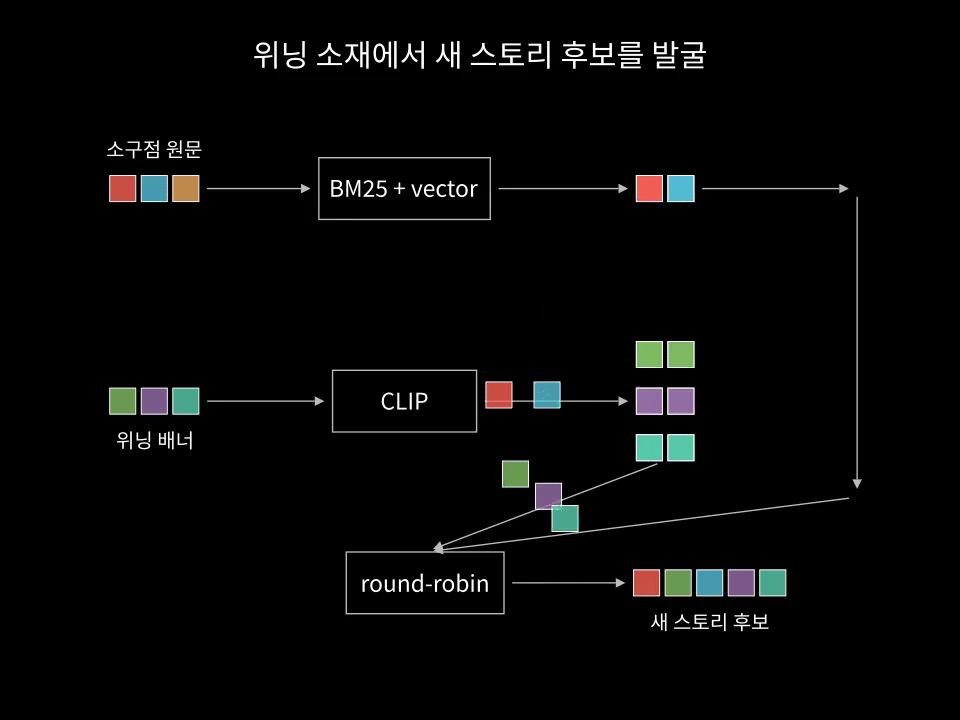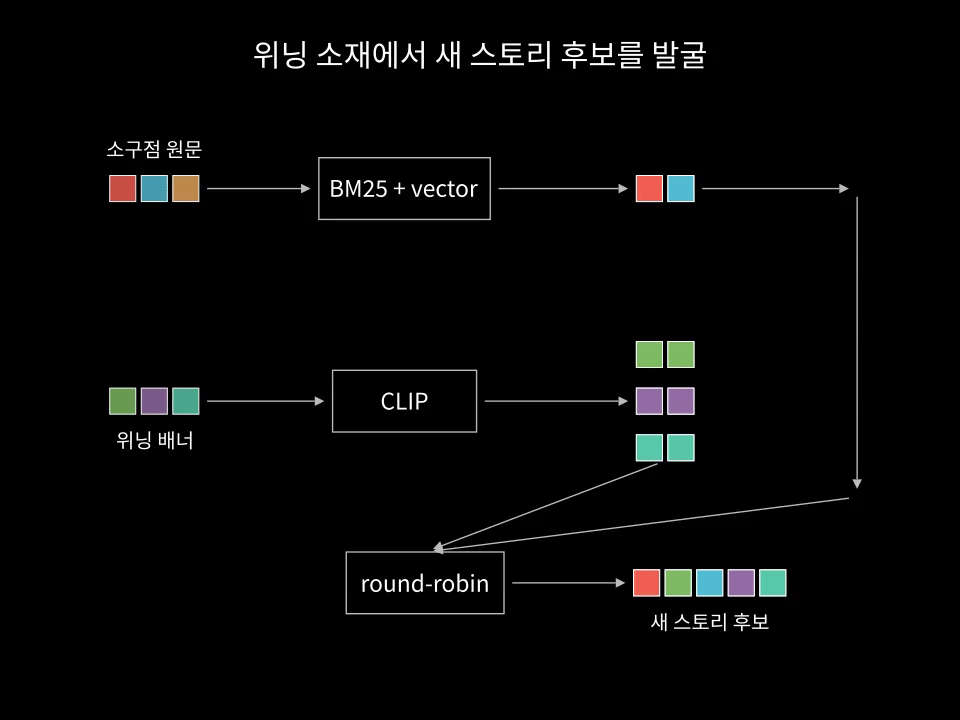
텍스트축·이미지축의 후보를 순환 선택하는 흐름

![위닝 앵글에서 스토리를 발굴하고 제작하는 흐름](/assets/images/notion/4f420410ac4af40875b1/02-winning-angle-search.png)

위닝 앵글에서 스토리를 발굴하고 제작하는 흐름

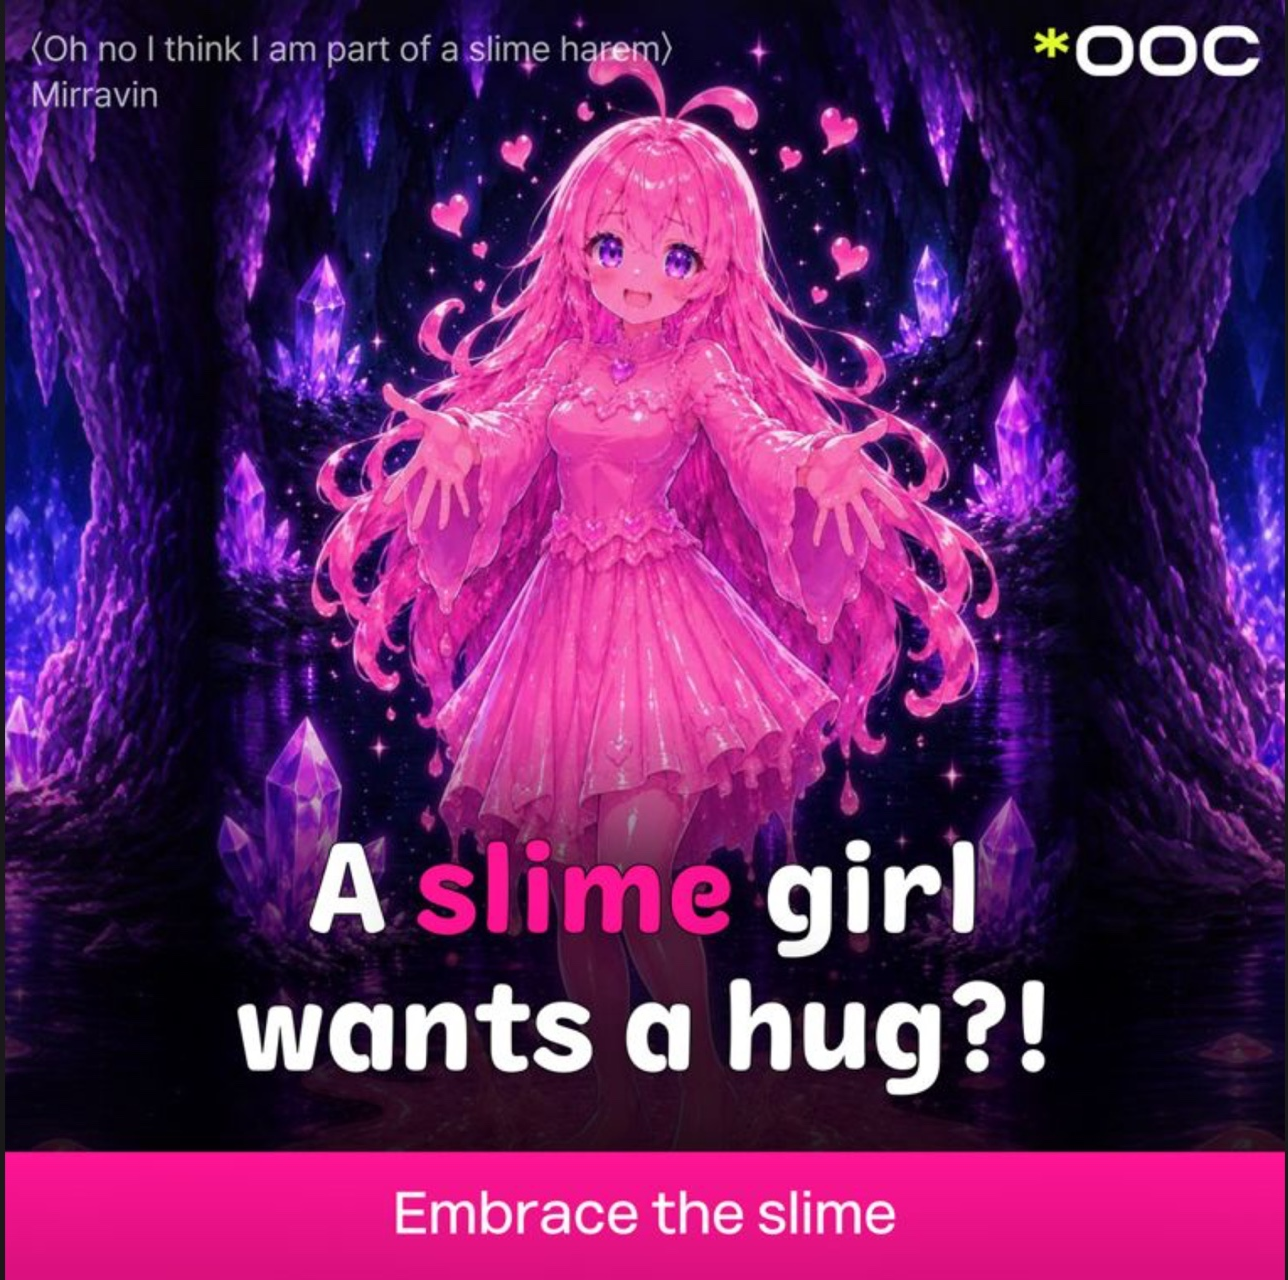
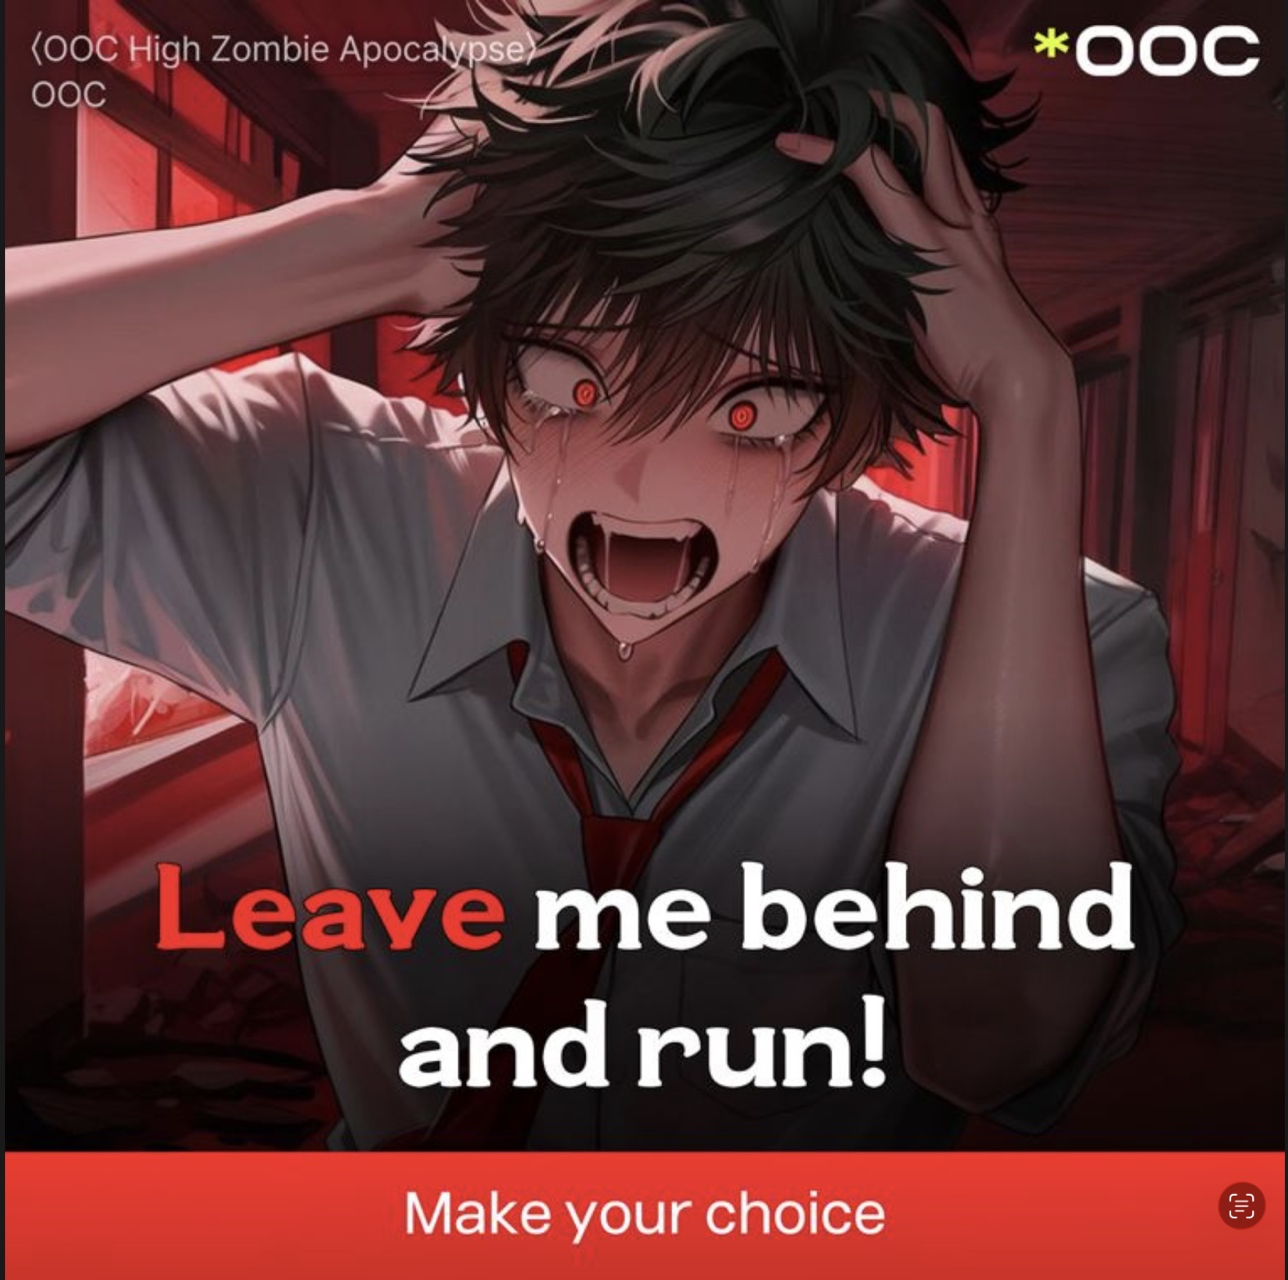
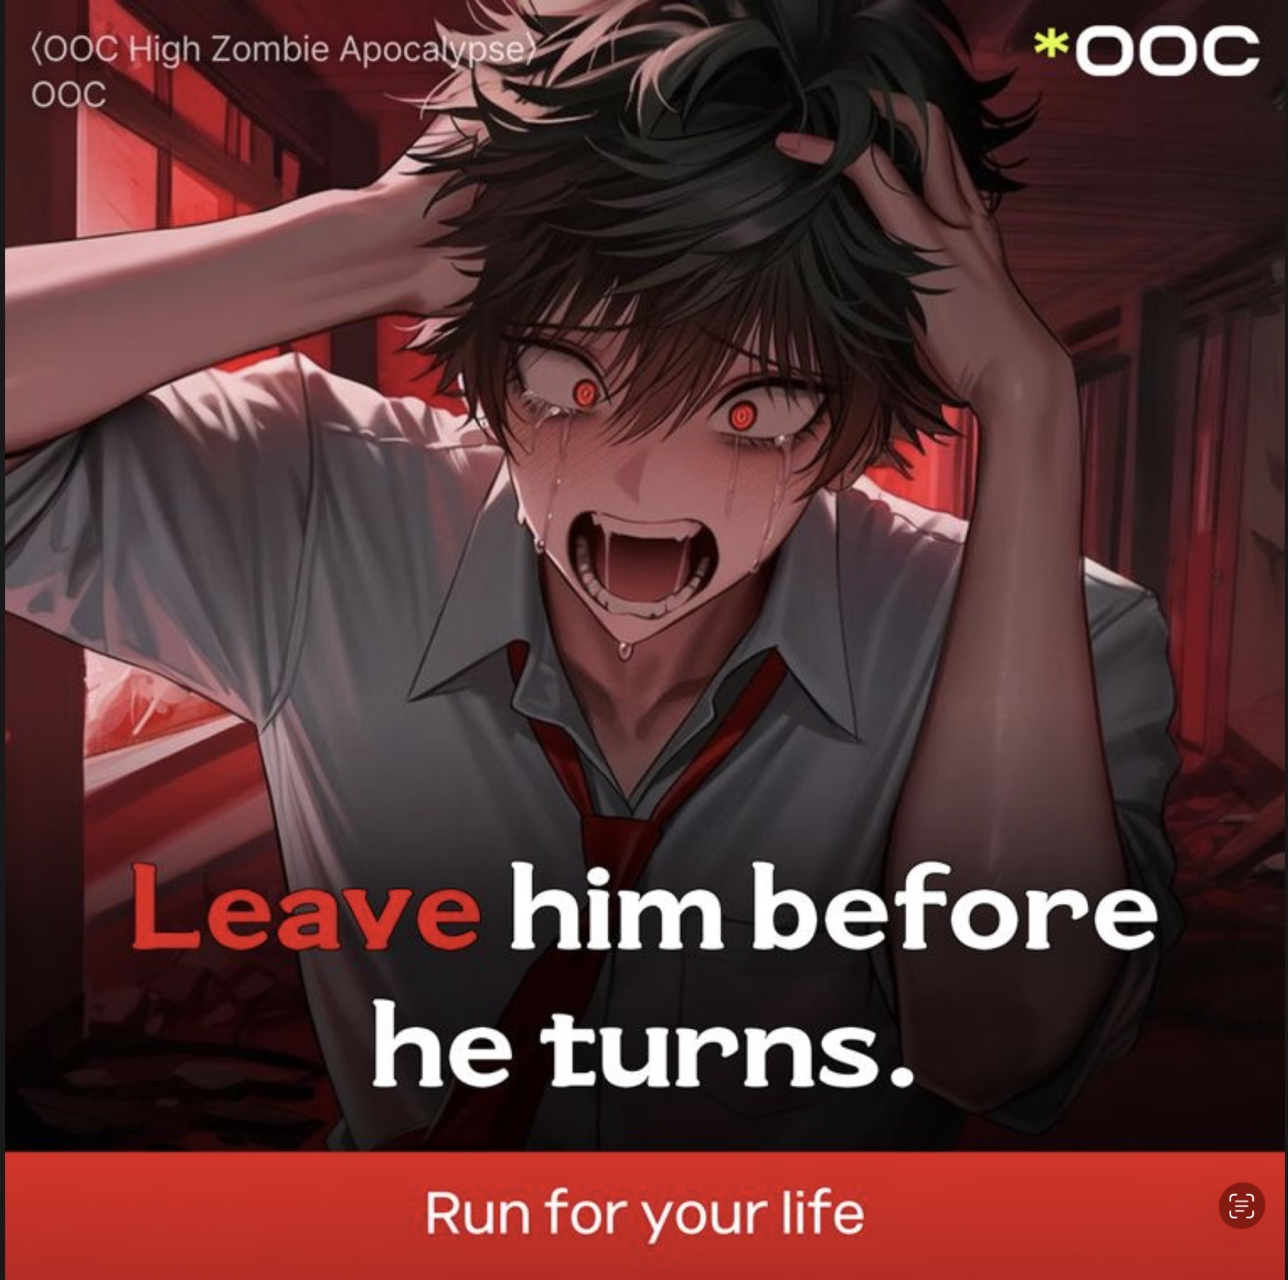
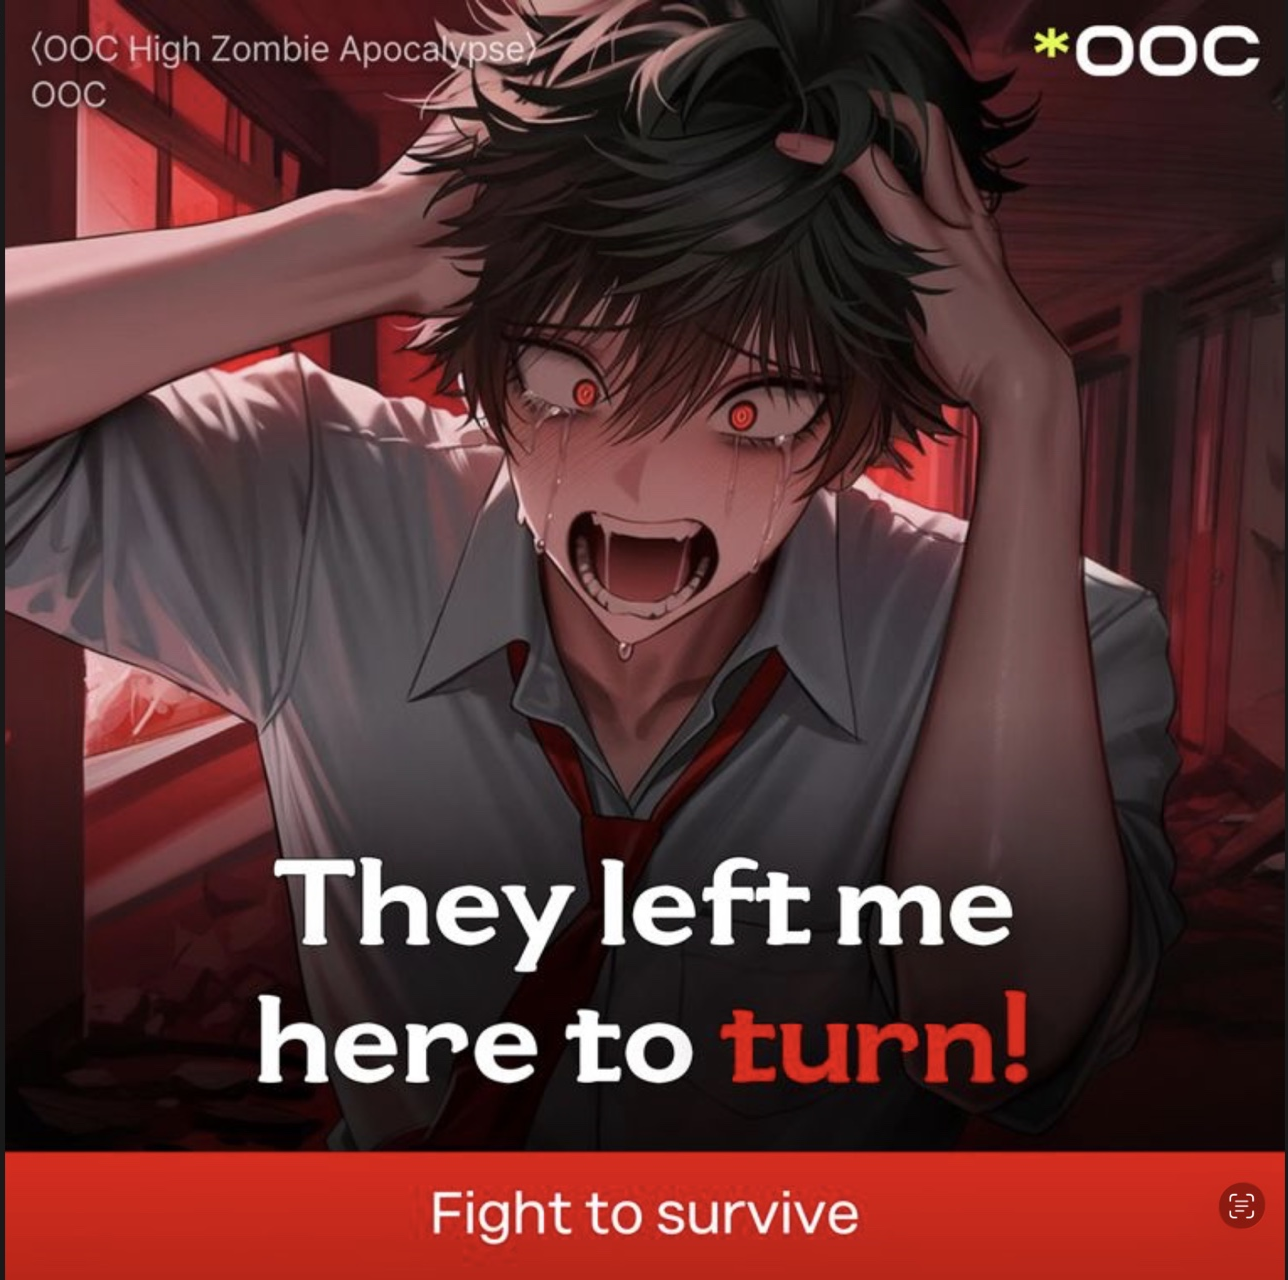
## 텍스트축은 실제 위닝 스토리의 소구점으로 처음처럼 LLM에게 가상의 소구점을 새로 만들게 하기보다, 위닝 앵글을 뒷받침한 실제 스토리의 감정·훅·소구점 원문을 검색어로 썼다. 그 문장은 검색 코퍼스가 임베딩한 원문이기도 했다. 검색을 위해 번역하거나 다시 해석하면서 뜻이 흔들리는 것을 줄일 수 있었다. 어휘 검색인 BM25와 의미 기반 벡터 검색을 순위 융합으로 합쳤다. 같은 키워드를 공유하는 후보와 표현은 달라도 의미가 비슷한 후보를 함께 찾으려는 방식이었다. 한쪽 검색이 실패해도 다른 쪽 결과를 반환하도록 했다. 위닝 스토리가 연결돼 있지 않을 때만 LLM이 가상 소구점을 만드는 기존 경로로 돌아갔다. 실제 원문이 있는데도 다시 만들어 쓰는 것과, 입력이 없어서 대체하는 경우를 나눴다. ## 이미지축에서는 배너마다 따로 검색했다 이미지축은 위닝 배너 그림 자체를 CLIP으로 인코딩하고, 스토리의 프로필 이미지에서 이웃을 찾았다. 여기서 여러 배너의 결과를 어떻게 합칠지가 문제였다. 실측 사례에서 배너 일곱 장이 있는 앵글의 상위 열 후보 중 일곱 개가 한 배너에서 나왔다. 인물 크롭이 큰 배너가 순위를 독식하는 현상이 있었다. 광고 배너와 캐릭터 일러스트는 종류가 달라 절대 코사인 점수도 낮게 나왔기 때문에, 다른 배너의 점수를 같은 기준으로 비교하기 어려웠다. 그래서 배너마다 후보를 따로 찾고 돌아가며 채웠다. 각 배너 내부의 순위를 사용하고, 하나의 배너가 전체 후보를 가져가지 않도록 했다. 여러 이미지의 평균 벡터도 쓰지 않았다. 서로 다른 그림체와 구도를 평균내면 어느 쪽도 제대로 나타내지 않는 중간점이 될 수 있어서였다. 이 선택은 다양성을 확보하기 위한 운영 규칙이었다. 서로 다른 배너의 점수를 섞어서 하나의 높은 숫자를 고르는 것이 이 작업의 목적과 맞는지부터 다시 봐야 했다. ## 검색 결과를 그날의 생성 목록으로 앵글들을 돌아가며 목표 개수만큼 새로운 스토리를 발굴했다. 개별 앵글 검색이 실패하면 그 앵글만 건너뛰고 전체 작업은 계속했다. 후보가 모자라면 목표 미만인 채로 끝냈다. 개수를 맞추려고 관련성이 낮은 후보를 억지로 넣지는 않았다. 발굴은 크론으로 미리 돌리고, 아침에 통합 생성 화면을 열면 사용할 세트가 준비돼 있게 했다. 운영자는 일괄 생성을 실행하고 결과를 확인할 수 있다. 선택된 스토리는 기존 제작 흐름에 들어간다. 다만 디자이너 프롬프트에는 위닝 카피의 헤드라인·서브·CTA와 그 톤을 예시로 넣었다. 결과물은 위닝 경로의 폴더로 올리고 소재 메타데이터에 어느 검색축에서 발굴했는지 기록했다. ## 실제 집행에서 확인한 성과 위닝 앵글에는 '왜 성과가 났는가'에 대한 해석이 들어 있다. 실제 소재를 근거로 한 분석이지만, 그것을 새로운 스토리에 적용했을 때 같은 성과가 난다고 확정할 수는 없다. 검색은 그 가설과 비슷한 후보를 찾아주는 단계다. 실제 집행에서는 차이가 나타났다. 서비스별로 차이는 있었지만, 위닝앵글을 기반으로 만든 광고 배너는 그리드서치 방식으로 만든 배너보다 약 두 배의 성과를 냈다. OOC에서는 핵심 지표로 봤던 D0 ROAS가 10% 이상으로 유지되는 결과도 나왔다. 이 작업에서는 모델이 새 기획을 계속 만드는 것보다, 운영팀이 이미 확인한 광고와 원본 스토리를 다음 제작에 연결하는 데 집중했다. 텍스트축과 이미지축을 분리하고, 후보가 어디서 왔는지 남긴 이유도 이후 집행 결과를 다시 읽기 위해서였다. 이후에도 어떤 앵글과 검색축이 유효한지는 새 광고의 집행 결과와 함께 계속 확인해야 한다. 본문의 데이터 흐름 애니메이션은 3Blue1Brown의 오픈소스 [Manim](https://github.com/3b1b/manim)에서 출발한 [Manim Community](https://www.manim.community/)로 만들었다. ### 카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기 - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-09-ad-performance-experiments/ - Collection: Project - Published: 2026-10-12 - Tags: Project 광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 그런데 어떤 형태의 카피가 효과적이라고 할 수 있을까? 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 광고 성과를 끌어올리는 AX를 하는 입장에서 이 부분이 가장 어려웠다. 답이 없는 문제를 풀고 있다는 느낌이었다. CTR이나 D0 ROAS처럼 집행 후에 볼 수 있는 지표는 있었다. 어려운 것은 집행 전에 카피만 보고 그 성과를 대신 평가할 명확한 metric을 정하는 일이었다. LLM as Judge를 쓴다고 해도 어떤 프롬프트로, 어떤 기준으로 점수를 매겨야 할까? 좋은 광고 카피란 무엇인지 정하지 못한 상태에서는 평가 점수를 높여도 실제 광고 성과가 좋아진다고 보기 어려웠다. 그래서 여러 톤앤매너로 카피를 만들고 실제로 라이브한 뒤, 성과가 좋은 톤앤매너를 다음 카피에 사용해 보기로 했다. 같은 스토리의 소구점도 행동을 권하는 문장으로 쓸 수 있고, 캐릭터의 대사나 상황을 보여주는 문장으로 쓸 수 있었다. 서비스별로 마케터분들이 선호하는 톤도 달랐으니, 그 의견을 테스트할 수 있는 후보로 만드는 것부터 시작했다. ## 현지 마케터의 의견을 테스트할 수 있는 형태로 OOC에서는 구어체 카피, 캬라푸에서는 행동유도형 카피가 좋을 것이라는 마케터분들의 의견이 있었다. 특정 방향으로 고정하기보다 여러 톤을 만들어 테스트해 보자는 방향으로 정리됐다. 같은 스토리 소구점에서 세 가지 형식을 만들었다. - 행동유도형: 헤드라인이 유저에게 행동을 요구하거나 권한다. - 캐릭터 대사형: 그림 속 캐릭터가 그 장면에서 할 법한 구어체 한마디다. - 상황형: 소구점의 상황을 경악·깨달음·곤경으로 표현한다. ![슬라임 스토리의 캐릭터 대사형 카피](/assets/images/notion/965ecbf938973af9b474/01-ad-performance-experiments.png)
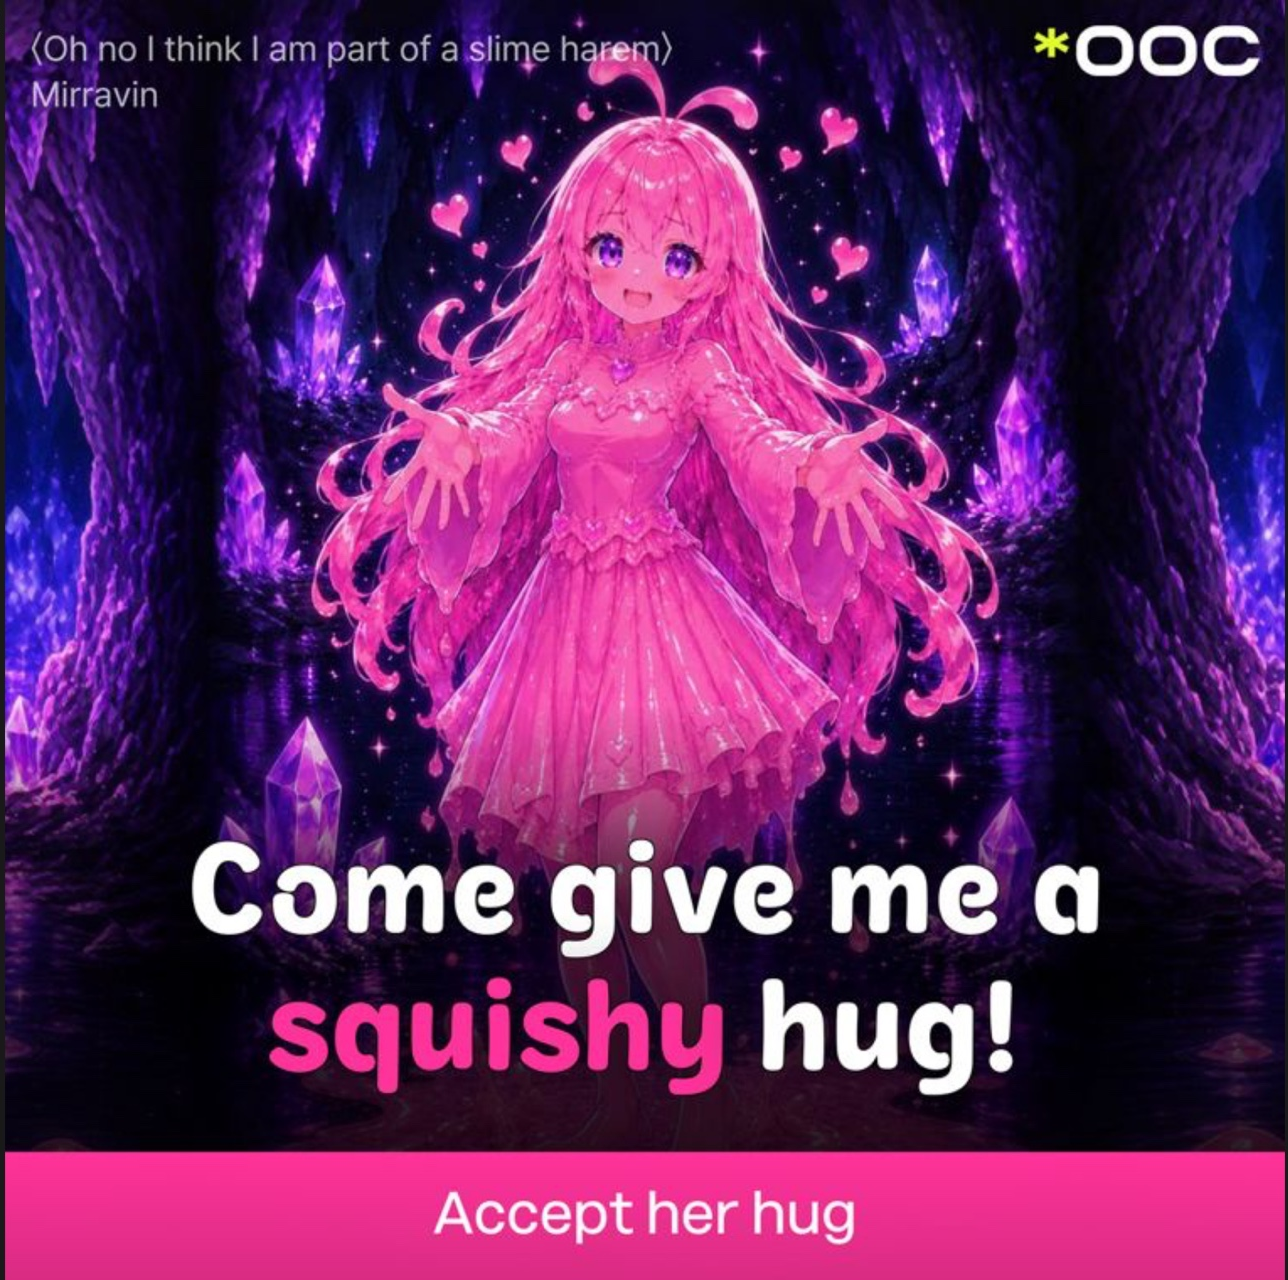
슬라임 스토리의 캐릭터 대사형 카피

![슬라임 스토리의 행동유도형 카피](/assets/images/notion/965ecbf938973af9b474/02-ad-performance-experiments.png)

슬라임 스토리의 행동유도형 카피

![슬라임 스토리의 상황형 카피](/assets/images/notion/965ecbf938973af9b474/03-ad-performance-experiments.png)

슬라임 스토리의 상황형 카피

![좀비 스토리의 캐릭터 대사형 카피](/assets/images/notion/965ecbf938973af9b474/04-ad-performance-experiments.png)

좀비 스토리의 캐릭터 대사형 카피

![좀비 스토리의 행동유도형 카피](/assets/images/notion/965ecbf938973af9b474/05-ad-performance-experiments.png)

좀비 스토리의 행동유도형 카피

![좀비 스토리의 상황형 카피](/assets/images/notion/965ecbf938973af9b474/06-ad-performance-experiments.png)

좀비 스토리의 상황형 카피

같은 소재에서도 헤드라인과 CTA가 어떻게 달라지는지 볼 수 있었다. 생성 경로는 공통 입력에서 유형별 카피를 만들고 렌더링하는 형태로 구성했다. ![카피 유형별 생성과 렌더링 흐름](/assets/images/notion/965ecbf938973af9b474/07-ad-performance-experiments.png)
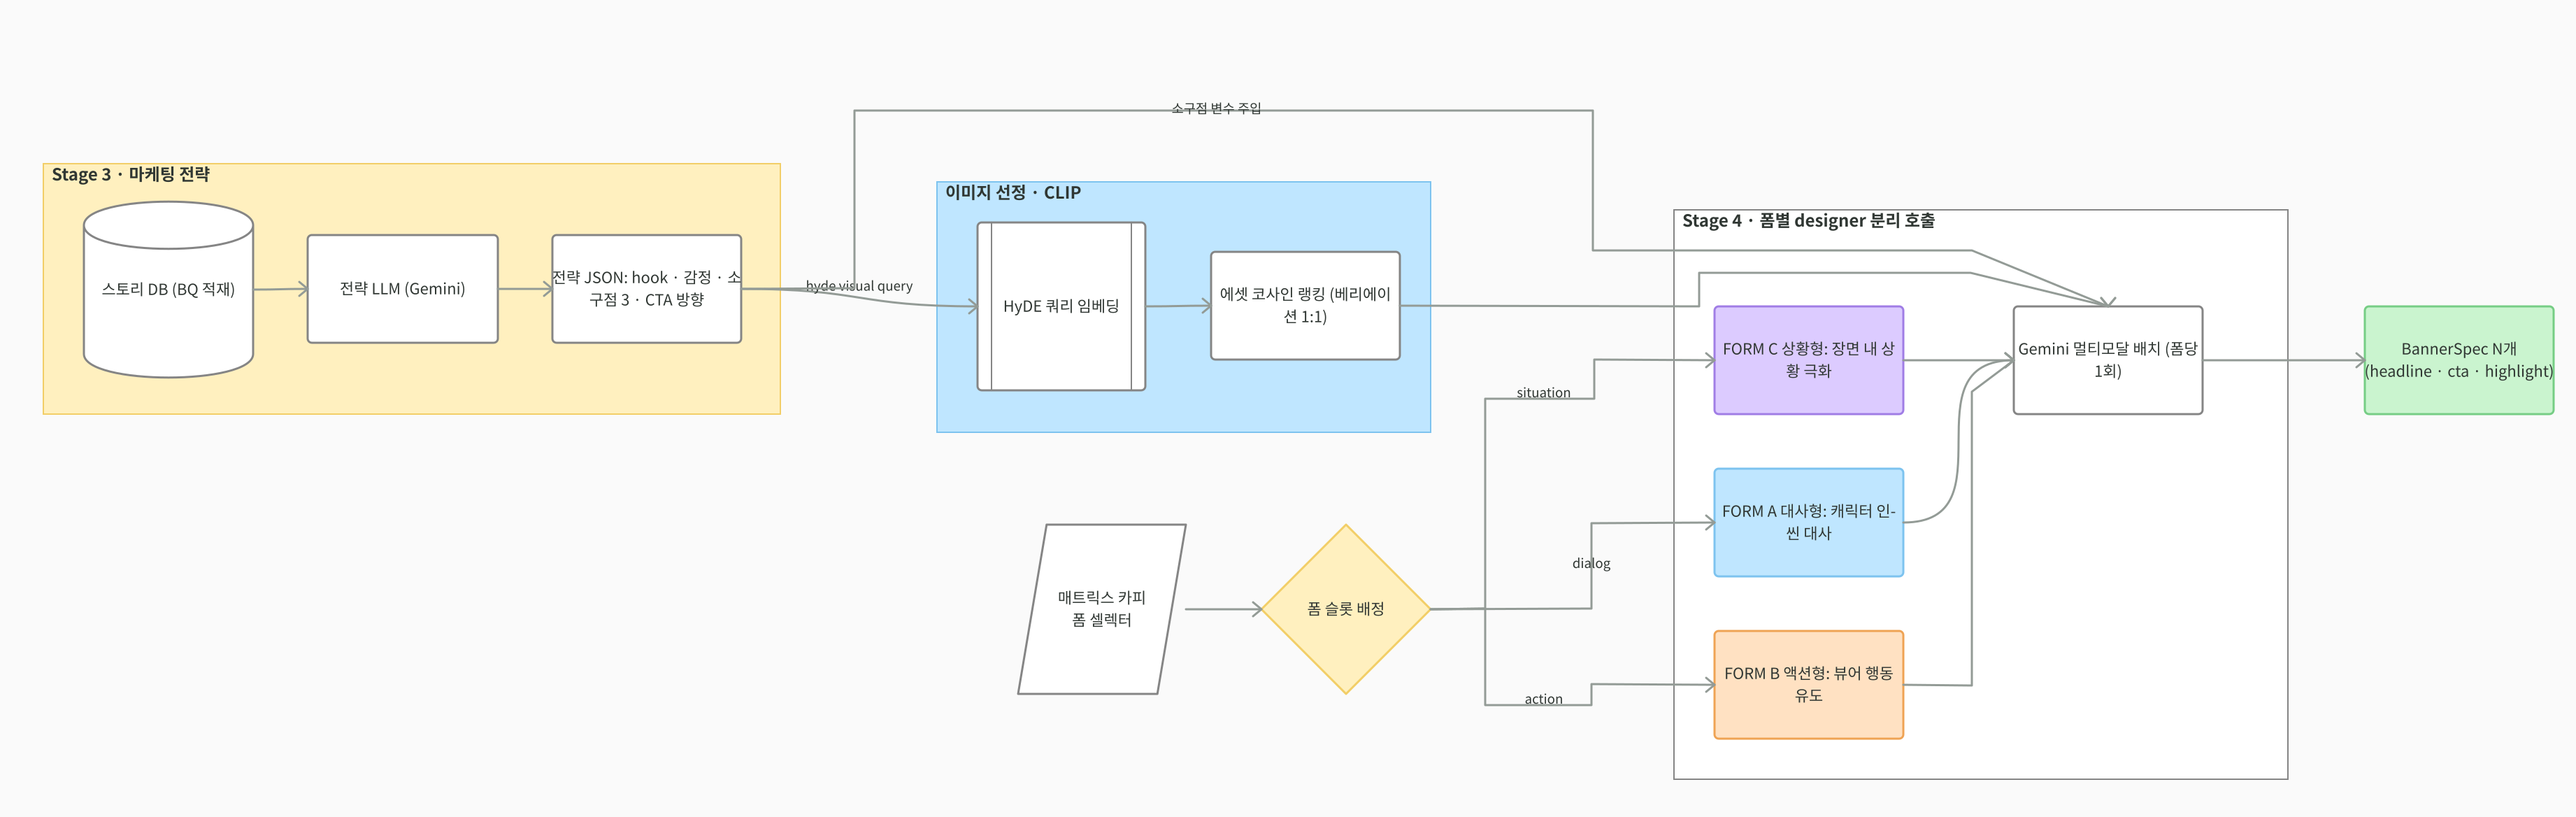
카피 유형별 생성과 렌더링 흐름

## 밈을 카피에 넣고 실제로 테스트했다 톤앤매너를 바꾸는 것과 함께, LLM이 뽑은 소구점만으로 카피를 생성하는 방식에도 다른 입력을 더해보고 싶었다. 스토리에 맞는 밈을 retrieval하고 RAG로 카피를 만들면 사람들의 눈길을 끌 수 있지 않을까? 일단 광고를 클릭해야 서비스 퍼널로 들어오고, 그 안에서 결제까지 이어질 기회도 생긴다. 밈으로 어그로를 끌어 CTR을 높이고, 그 유입이 D0 ROAS 개선으로 이어질 수 있을지를 보고 싶었다. 이 가설을 테스트하려고 스토리의 상황에 맞는 밈을 검색해 카피 생성에 함께 넣는 파이프라인을 구상했다. 클릭을 유도할 만한 표현이어도 스토리와 맞지 않으면 억지스럽고, 위험한 맥락이 있으면 광고에 쓸 수 없었다. 밈 카탈로그의 출발점은 나무위키의 밈 정리 문서였다. 여기서 크롤링한 밈 216개를 그대로 카피 생성에 넣지는 않았다. 위험한 밈이나 광고에 어울리지 않는 항목을 걸러내는 전처리 과정이 필요했다. 먼저 키워드 기반 휴리스틱으로 정치·사망·특정인 관련 위험 키워드가 있는 항목을 걸렀다. 곡·댄스·인물 등 광고 카피에 부적합한 항목도 이 단계에서 제외했다. 통과한 후보는 LLM이 본문과 유래를 읽고 안전성 등급을 판정하도록 했다. `red`는 배제하고, `yellow`는 사람 검수를 통과한 경우에만 사용했으며, `green`은 카탈로그에 넣었다. 짧은 표현만 보면 평범해 보여도 유래에 위험한 맥락이 있을 수 있어서 본문까지 확인하는 흐름으로 구성했다. 카탈로그에는 의미, 사용 맥락, 톤, 어울리는 캐릭터 유형, 사용 패턴과 템플릿 슬롯, 안전성, 신선도 등을 정리했다. 같은 유행어를 모든 캐릭터에 붙이기보다 어떤 관계와 상황에서 자연스러운지 구분하려는 정보다. 카피에 적용한 뒤에도 억지스럽거나 재미없는 밈, 스토리 맥락에 맞지 않는 결과는 걸러야 했다. ```yaml - id: ssyagal phrase: 쌰갈 meaning: 한중 국제커플 유튜버 '여단오'의 멤버 여루가 기분 나쁠 때 '씨발'을 돌려 말하는 표현으로, 짜증이나 황당함이 날 때 널리 쓰입니다. usage_context: - 짜증 - 황당함 - 분노 - 코믹한 분노 - 스트레스 - 일상 tone: - 코믹한 - 짜증난 - 유쾌한 - 캐주얼한 archetype: - 다혈질 소꿉친구 - 스트레스 받는 직장인 - 개그 캐릭터 - 허당 악당 - 츤데레 usage_pattern: append template_slots: '{짜증나는 상황}... 아 쌰갈!' source_type: person applicability: 3 safety: yellow safety_note: 욕설(씨발)을 돌려 말하는 유행어 freshness: 5 era: 2023년경부터 입소문을 타기 시작해 숏폼 및 AI 음성 밈으로 널리 쓰이는 현역 밈 origin_country: 한국 - id: byeongi_e_naeryeo phrase: ○○를 변기에 넣고서 내려 meaning: 상대를 변기에 넣고 물 내리듯 압도적으로 짓밟겠다는 강한 디스·도발 펀치라인 usage_context: - 디스 - 도발 - 라이벌 - 압도 - 기싸움 - 선전포고 tone: - 도발 - 공격적 - 힙합 - 자신감 - 살벌 archetype: - 라이벌 캐릭터 - 디스전/래퍼 - 도발적 빌런 - 기싸움 연애물 - 먼치킨 template_slots: '{상대}를 변기에 넣고서 내려' source_type: song applicability: 3 safety: yellow safety_note: 실명 비방 원문(빅나티/BIG Naughty) 제거하고 ○○ 슬롯으로 일반화 freshness: 5 era: 2025~ 현역(스윙스 디스전 밈) origin_country: 한국 - id: bamti-ugly-fashion phrase: 밤티 meaning: 라인플레이의 '밤티'라는 유저의 기괴한 코스튬에 다른 유저가 심한 돌직구를 날린 장면에서 유래한 표현으로, 기괴하거나 촌스러운 외모·코디를 뜻하는 대명사로 쓰입니다. usage_context: - 패션테러리스트 - 팩트폭력 - 촌스러움 - 기상천외한코디 - 무덤덤한반응 tone: - 돌직구 - 황당함 - 시니컬 - 유쾌함 archetype: - 패션테러리스트 - 마이웨이캐릭터 - 팩폭러 - 눈치없는캐릭터 usage_pattern: append template_slots: 밤티님 죄송한데 진짜 개 좆같이 생기 셨네요... 소리가 절로 나오는 상황 source_type: meme-native applicability: 3 safety: yellow safety_note: 실존 유저의 닉네임에서 유래한 외모 비하/촌스러움의 대명사로 쓰여 실제 인물에 대한 외모 비하로 사용하지 않도록 주의해야 함 freshness: 4 era: 2020~2021년 라인플레이 커뮤니티에서 시작되어 2024~2025년 X(트위터) 등 SNS에서 다시 확산된 밈 origin_country: 한국 ``` ![밈 카탈로그를 활용하는 생성 흐름](/assets/images/notion/965ecbf938973af9b474/08-ad-performance-experiments.png)
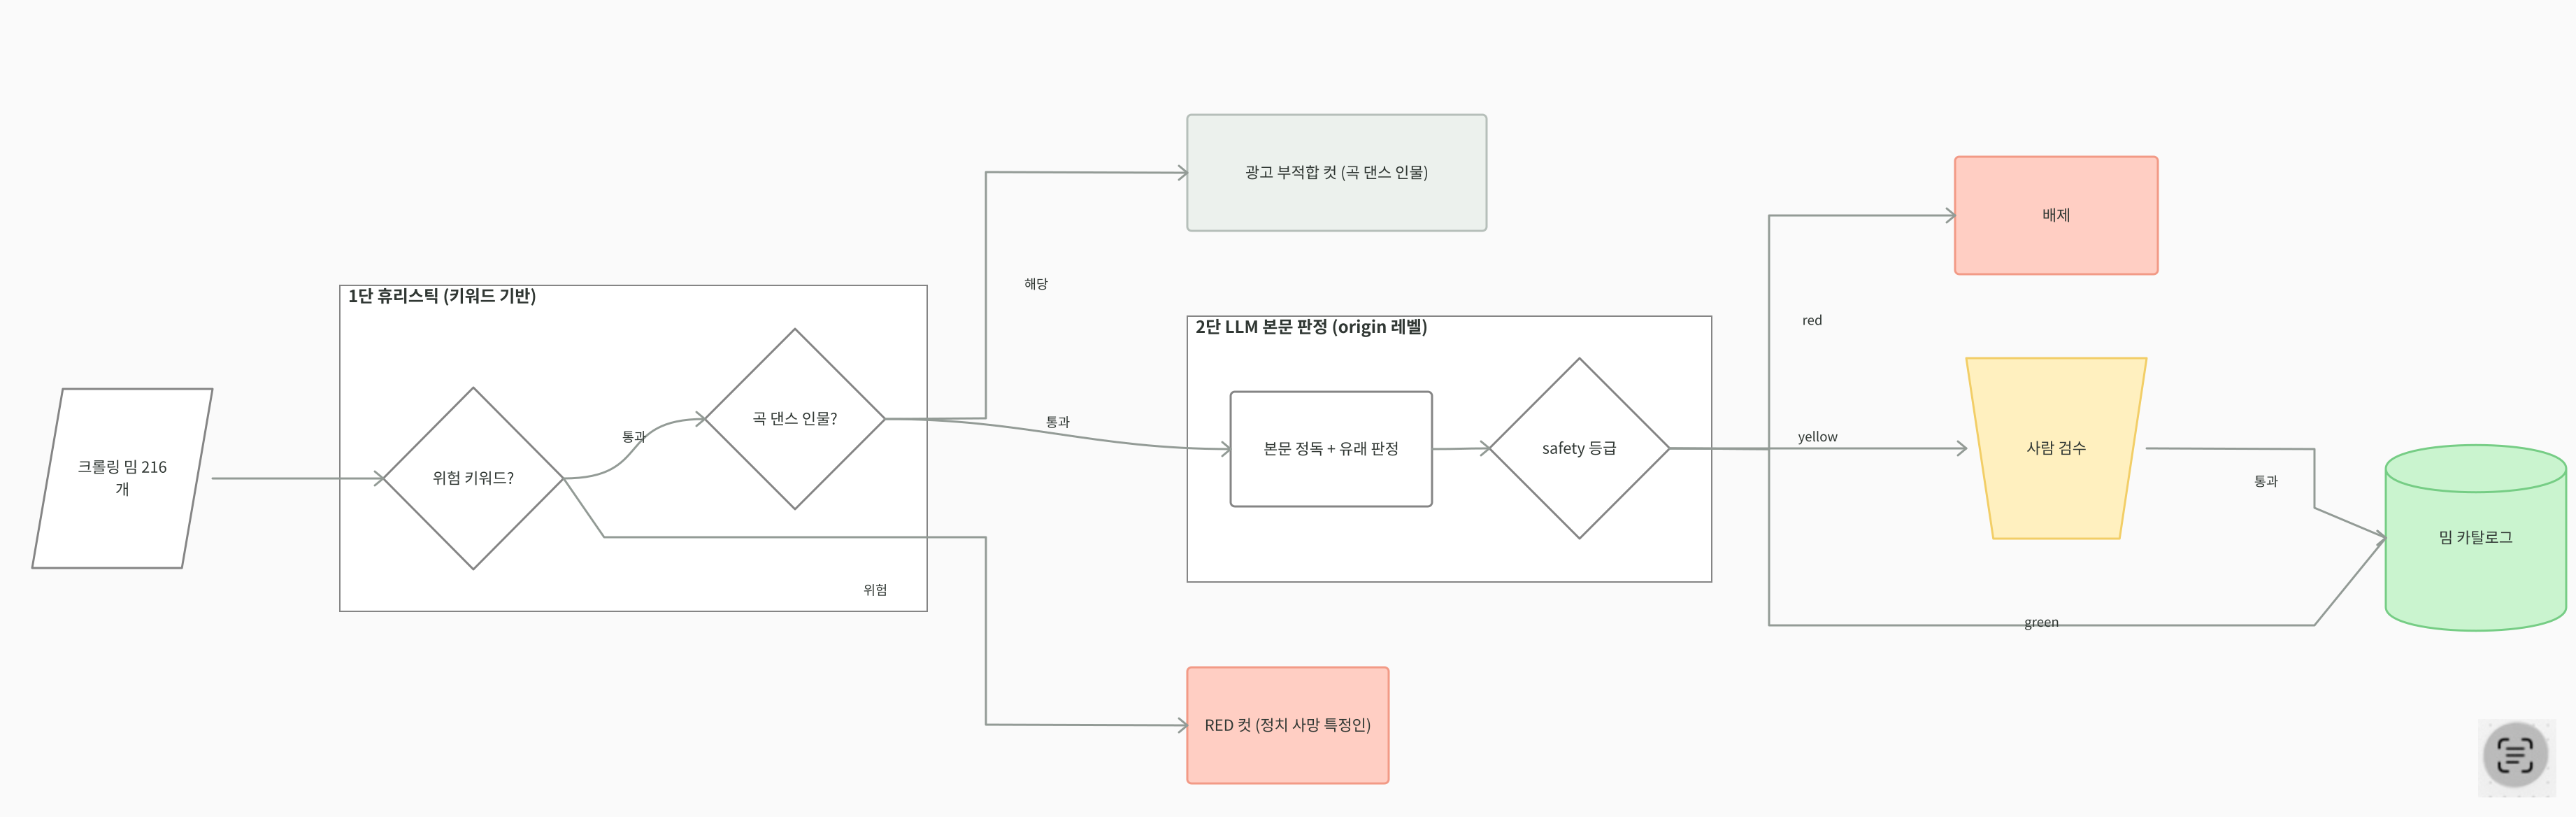
밈 카탈로그를 활용하는 생성 흐름

![밈을 활용한 광고 소재 예시](/assets/images/notion/965ecbf938973af9b474/09-ad-performance-experiments.png)

밈을 활용한 광고 소재 예시

![스토리에 밈을 적용한 카피 예시](/assets/images/notion/965ecbf938973af9b474/10-ad-performance-experiments.png)

스토리에 밈을 적용한 카피 예시

![같은 스토리의 다른 밈 카피](/assets/images/notion/965ecbf938973af9b474/11-ad-performance-experiments.png)

같은 스토리의 다른 밈 카피

밈 테스트도 실제 광고 성과를 끌어올리는 방법이 됐다. 다만 카탈로그에서 유행어 하나를 골라 붙이는 것으로 제작이 끝나는 것은 아니었다. 스토리의 관계와 장면에 맞는지, 광고 문구로 써도 되는지 확인하는 과정이 함께 있어야 했다. ## 성과를 보고 다음 카피를 고르는 작업 카피 A/B 테스트는 같은 소구점을 여러 톤으로 표현하는 경로였고, 밈 테스트는 그 표현에 익숙한 유행어와 사용 맥락을 더하는 경로였다. 둘 다 배너를 생성하는 기존 흐름에 붙여 실제 소재를 내보낼 수 있게 만들었다. 실제 집행에서는 일반적인 zero-shot 방식으로 만든 카피에 비해 광고 성과가 최대 2배까지 높아진 결과가 있었다. 북미 서비스인 OOC에서는 D0 ROAS가 10% 이상으로 나온 결과도 있었다. 처음에 고민했던 카피의 평가 기준을 실제 집행 성과로 확인하면서 개선할 수 있었다. 자동 생성의 역할도 카피 한 개를 정답처럼 내놓는 것에서, 비교할 수 있는 후보를 만드는 쪽으로 넓어졌다. 마케터의 의견을 카피 유형으로 만들고, 밈의 의미와 사용 패턴을 카탈로그로 남긴 이유도 같은 가설을 다음 소재에서 다시 테스트할 수 있게 하기 위해서였다. ### CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona - Canonical URL: https://hyejunl33.github.io/projects/2026-10-12-wrtn-10-nemotron-persona-ctr/ - Collection: Project - Published: 2026-10-12 - Tags: Project Nemotron Persona를 처음 알게 된 건 1차 랄프톤에서였다. 국가권력급 AI 엔지니어 Kevin이 사내 QA 에이전트의 시스템 프롬프트에 Nemotron Persona를 넣고, 변경한 UI·UX 구성요소를 A/B 테스트하는 데 활용하는 에이전트를 만든 것을 봤다. 오픈소스로 신뢰도 있는 설문조사를 LLM으로 할 수 있다니..! 당시에는 그렇게 받아들였다. 광고 배너를 AX로 자동 생성하는 파이프라인에도 무조건 적용해 봐야겠다고 생각했다. 어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. Kevin의 에이전트를 보고 떠올린 아이디어를 바탕으로, 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으로 선호도 시뮬레이션을 해봤다. 페르소나에 배너와 카피를 보여주고 클릭하고 싶은 정도를 물은 뒤, 그 점수가 실제 CTR과 같은 방향으로 움직이는지 비교했다. 점수에 예측력이 있다면 일정 기준 이상의 배너만 집행하는 방식으로 연결할 수 있었다. 실험에서 확인하려던 것은 바로 이 연결이었다. ## 페르소나의 클릭 의향을 실제 CTR과 비교하기 검증 기준은 실제 CTR과 시뮬레이션 점수의 상관계수였다. 당시에는 correlation이 0.5 이상이면 집행 후보를 고르는 데 활용할 수 있겠다는 기준을 뒀다. 배너를 보고 긍정적인 답을 많이 받는 것보다, 실제로 CTR이 높은 배너에 더 높은 점수를 주는지가 중요했다. 산점도의 가로축은 페르소나가 준 click_intent 점수의 평균이고, 세로축은 실제 CTR(%)이다. click_intent는 0~10점 척도로 평가한 클릭 의향이다. 8점을 받았다고 CTR이 8%라는 뜻은 아니어서, 점수와 실제 집행 지표를 따로 놓고 관계를 봤다. ## 실험 1·2·3에서 평가 집단을 바꾼 이유 세 실험에서는 누구에게 배너를 평가하게 할지를 바꿨다. 일반적인 인구 집단의 반응으로 시작해 광고 타깃에 맞추고, 이후에는 서비스에 관심을 가질 만한 집단까지 좁히려는 순서였다. 각 조건에서 페르소나의 클릭 의향 점수와 실제 CTR을 비교했다. ### 실험 1: 전연령에서 기준 결과를 확인하기 먼저 연령·성별·교육·직업·지역을 층화해 페르소나를 구성했다. 특정 인구 집단에 쏠리지 않은 평가에서도 배너별 클릭 의향이 실제 CTR과 같은 방향으로 움직일지 확인하려 했다. 이 결과를 기준으로 두고, 평가 집단을 타깃에 맞춰 좁히면 예측력이 달라지는지 비교했다. 표본을 구성하기 전에 연령과 성별, 학력, 결혼 상태의 분포도 확인했다. ![Nemotron Persona-Korea 데이터의 연령·성별·학력·결혼 상태 분포](/assets/images/notion/82ba46c1fdb1b9d0e4eb/01-persona-demographics.png)
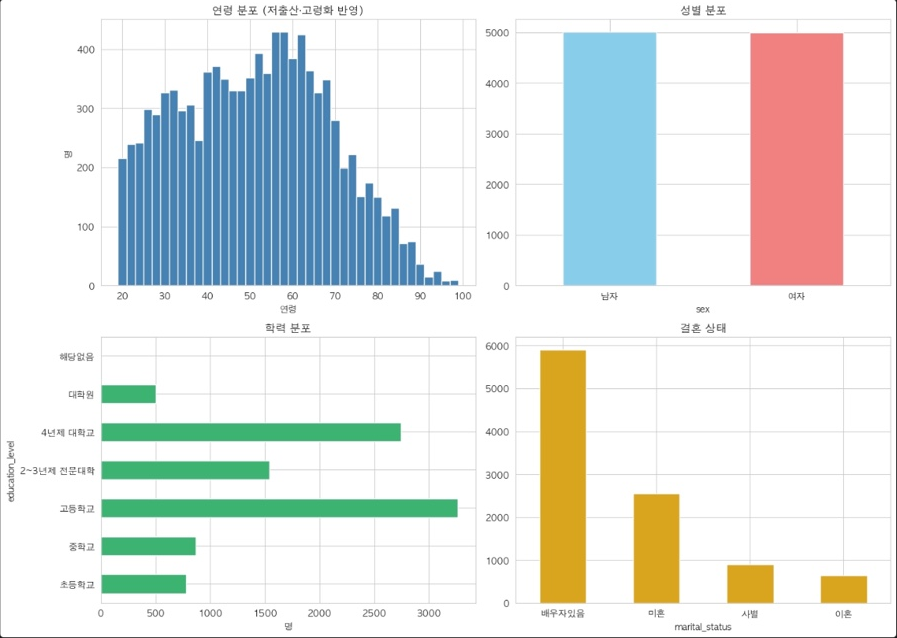
Nemotron Persona-Korea 데이터의 연령·성별·학력·결혼 상태 분포

### 실험 2: 광고 타깃의 연령과 성별에 맞추기 다음에는 평가 집단을 20~39세로 좁혔다. 남성향 스토리는 남성 페르소나에게, 여성향 스토리는 여성 페르소나에게 평가하게 했다. 전연령의 반응을 섞기보다 실제 광고 타깃에 가까운 집단의 반응을 보면 예측력이 나아질지 확인하려는 조건이었다. 이 단계에서는 연령과 성별을 맞췄고, 크랙에 대한 취향으로 집단을 더 고르지는 않았다. | 조건 | 실험 1 | 실험 2 | 실험 3 | | --- | --- | --- | --- | | 연령 | 전연령 층화 표본 | 20~39세 | 20~39세 | | 성별 | 성별 층화 표본 | 남성향은 남성, 여성향은 여성 | 남성향은 남성, 여성향은 여성 | | 그 밖의 구성 | 교육·직업·지역 등을 층화 | 20~30대 남성·여성 | 크랙 서비스를 좋아할 만한 클러스터 선택 | | 실험 정리표의 corr | -0.219 | -0.048 | | ### 실험 3: 같은 연령·성별 안에서도 서비스 취향으로 좁히기 세 번째 조건에서는 20~39세와 스토리 성향에 맞춘 성별 조건을 유지하면서, 그 안에서 크랙 서비스를 좋아할 만한 클러스터를 고르려 했다. 연령과 성별만 같다고 서비스 취향까지 같지는 않으니, 프로필의 관심사와 생활 맥락으로 평가 집단을 더 좁히면 예측력이 나아질지 보려는 방향이었다. 이를 위해 페르소나 서술을 임베딩하고 K-means로 군집화했다. 군집 수는 8개로 설정했다. 프로필을 그룹으로 묶고, 유사한 집단을 벡터 검색으로 찾는 방식을 살펴봤다. 다만 실제로 선택한 클러스터와 사용한 feature 조합, 검색 질의는 작업 기록에 남기지 못했다. 세 번째 조건의 상관계수도 기록하지 않아, 이 방식의 효과를 결과로 확인할 수는 없었다. ![페르소나 임베딩의 K-means 군집 분포 — K=8](/assets/images/notion/82ba46c1fdb1b9d0e4eb/02-persona-clusters.png)
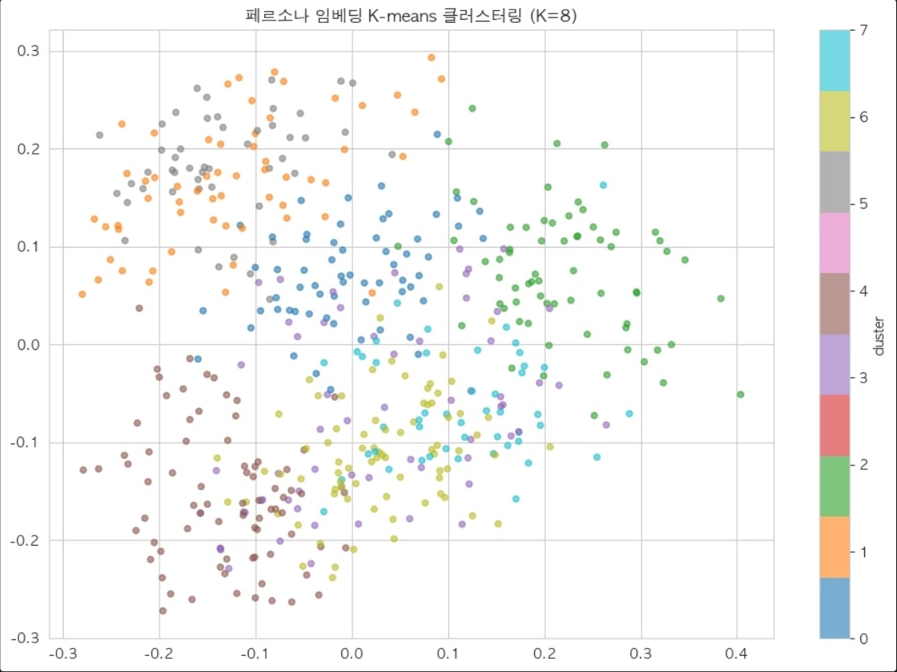
페르소나 임베딩의 K-means 군집 분포 — K=8

## 질문과 점수, 판단 이유를 함께 남겼다 선택한 페르소나에게 배너와 카피를 보여주고, 광고를 클릭해 더 알아보고 싶은 정도를 0~10점으로 평가하게 했다. 각 페르소나의 점수를 평균 내 배너별 click_intent를 구한 뒤 실제 CTR과 비교했다. 점수와 함께 판단 이유도 받아, 어떤 프로필이 어떤 이유로 광고에 반응하는지 확인하려 했다. ## 전연령과 20~39세 조건에서 나온 결과 전연령 층화 표본에서 배너 14개를 비교한 결과, 상관계수는 -0.219였다. 페르소나가 더 높은 점수를 준 배너가 실제로 더 높은 CTR을 보이지 않았다. 비교한 소재 수가 적어서 이 실험만으로 예측력을 판단하기도 어려웠다. ![전연령 층화 표본 — 실제 CTR과 평균 click_intent 비교: r=-0.219, n=14](/assets/images/notion/82ba46c1fdb1b9d0e4eb/06-all-age-ctr.png)
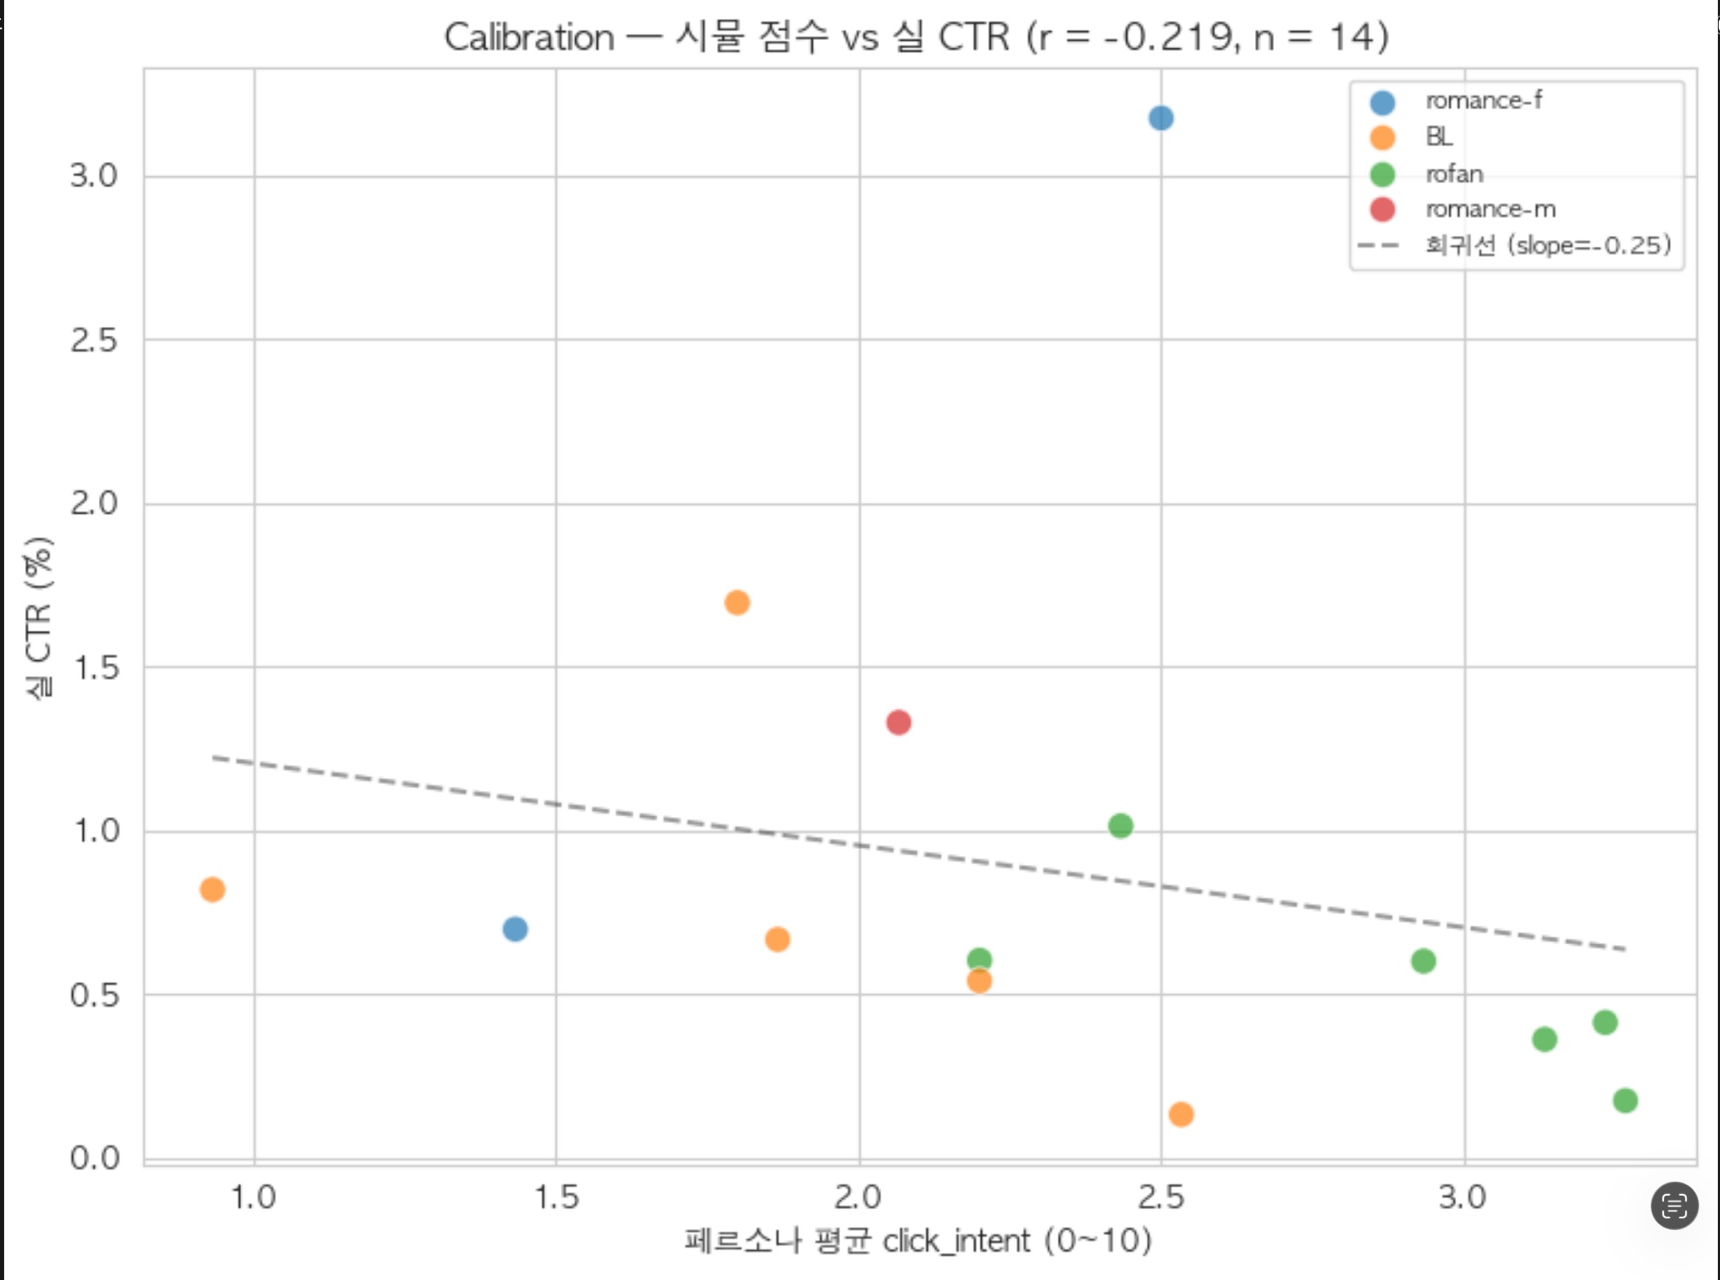
전연령 층화 표본 — 실제 CTR과 평균 click_intent 비교: r=-0.219, n=14

20~39세로 평가 집단을 좁혀 배너 86개를 비교했을 때 상관계수는 0.079였다. 약한 양의 상관이지만, 활용 기준으로 생각했던 0.5와는 차이가 컸다. 이 조건에서는 평가가 전반적으로 긍정적인 쪽으로 치우치는 현상도 확인했다. 높은 점수를 받는 것만으로는 배너의 실제 성과를 잘 구분할 수 없었다. ![20~39세 표본 — 실제 CTR과 평균 click_intent 비교: r=0.079, n=86](/assets/images/notion/82ba46c1fdb1b9d0e4eb/07-target-age-ctr.png)
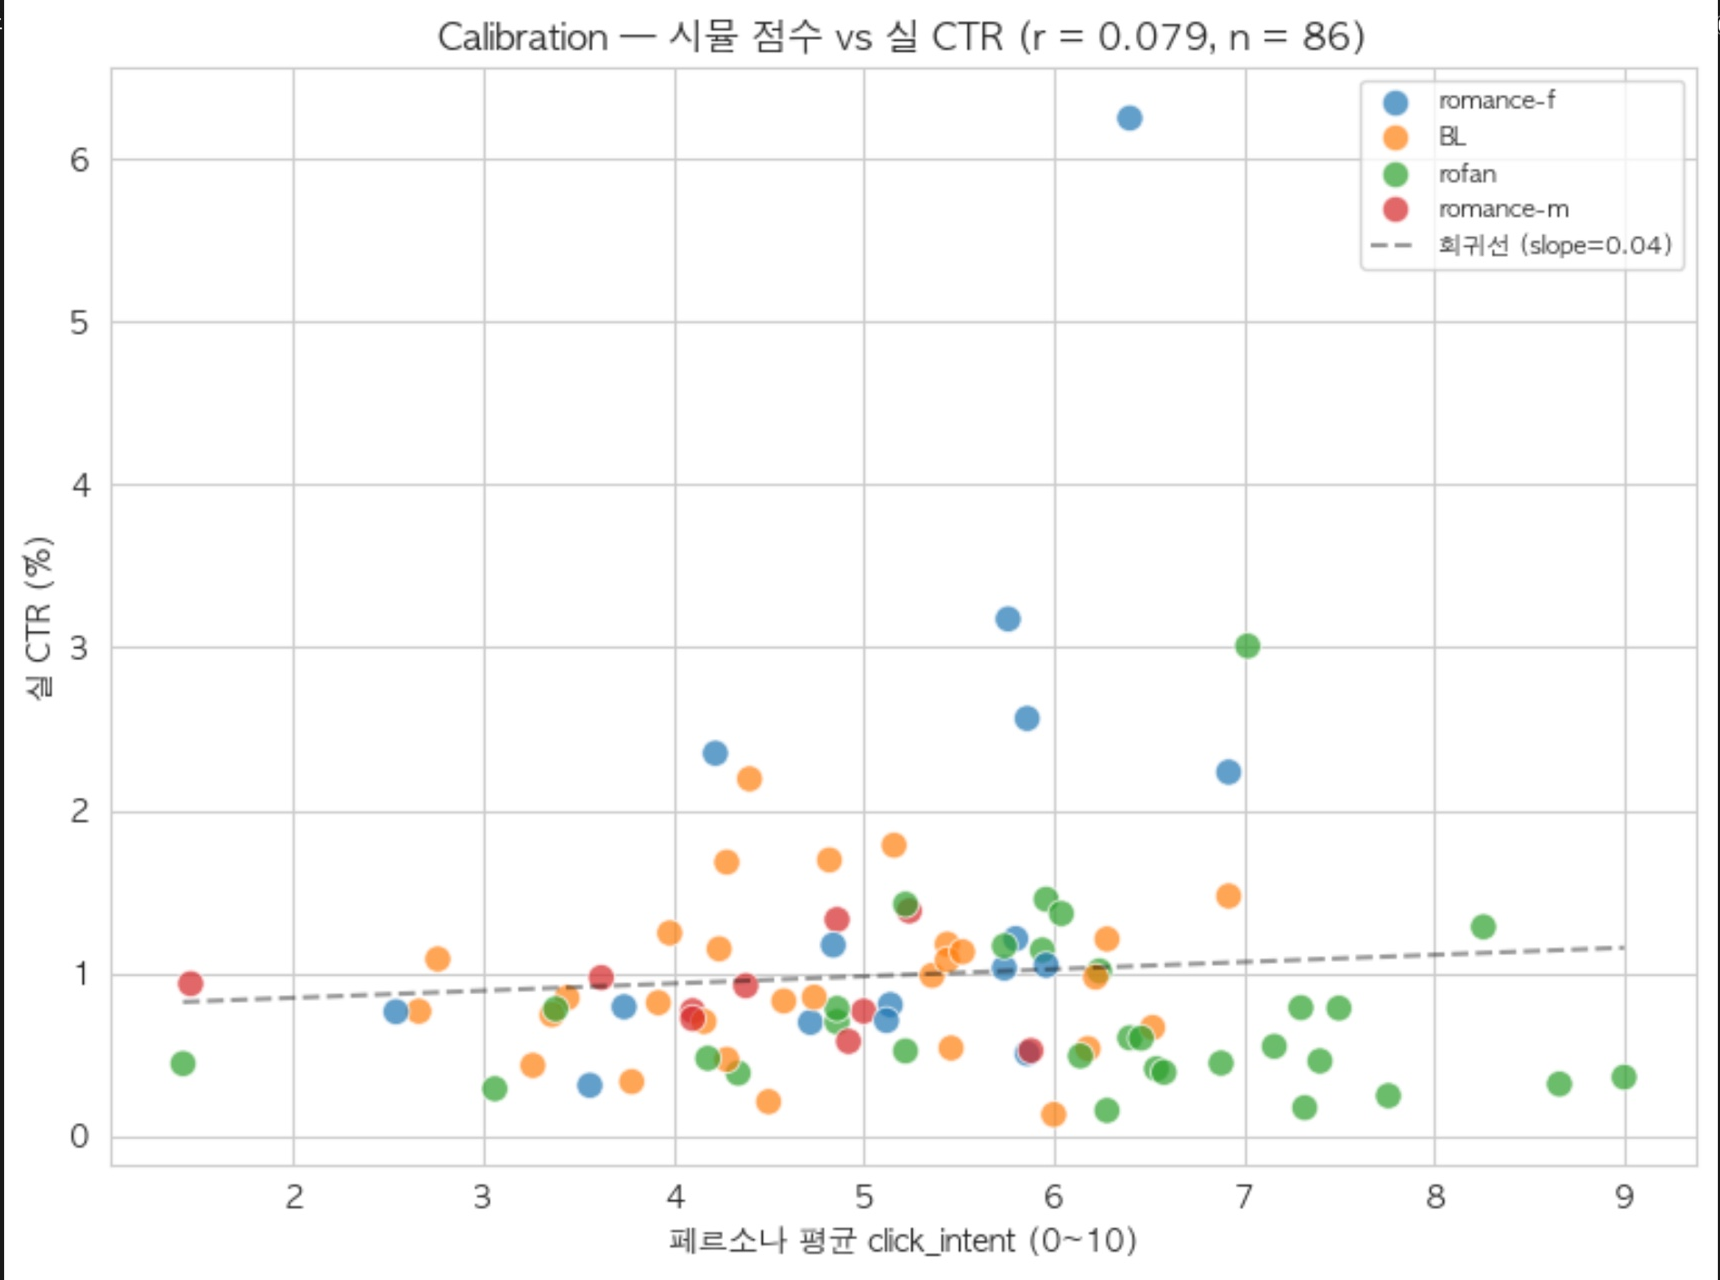
20~39세 표본 — 실제 CTR과 평균 click_intent 비교: r=0.079, n=86

실험 2를 정리할 때의 상관계수는 -0.048이고, 배너 86개를 비교한 결과는 +0.079다. 두 비교의 실행 조건과 표본이 같은지 확인하지 못해 결과를 구분했다. 어느 쪽도 당시 목표였던 0.5에는 도달하지 못했다. ## 페르소나별 점수 기준을 보정해본 비교 배너 88개에 대해서는 원점수 평균과 페르소나별 Z-score 평균도 비교했다. 실제 CTR과의 상관계수는 원점수 평균을 쓰면 0.292, Z-score 평균을 쓰면 0.321이었다. 페르소나마다 점수를 후하게 주거나 박하게 주는 차이를 줄이려고, 각 점수를 `(점수 - 개인 평균) / 개인 표준편차`로 바꾼 뒤 배너별로 평균 냈다. 각자가 평소보다 얼마나 높게 평가했는지 비교하는 [Z-score 보정](https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.zscore.html)이다. ![원본 평균 점수와 페르소나별 Z-score 보정 비교 — r=0.292 → 0.321, n=88](/assets/images/notion/82ba46c1fdb1b9d0e4eb/08-zscore-ctr.png)
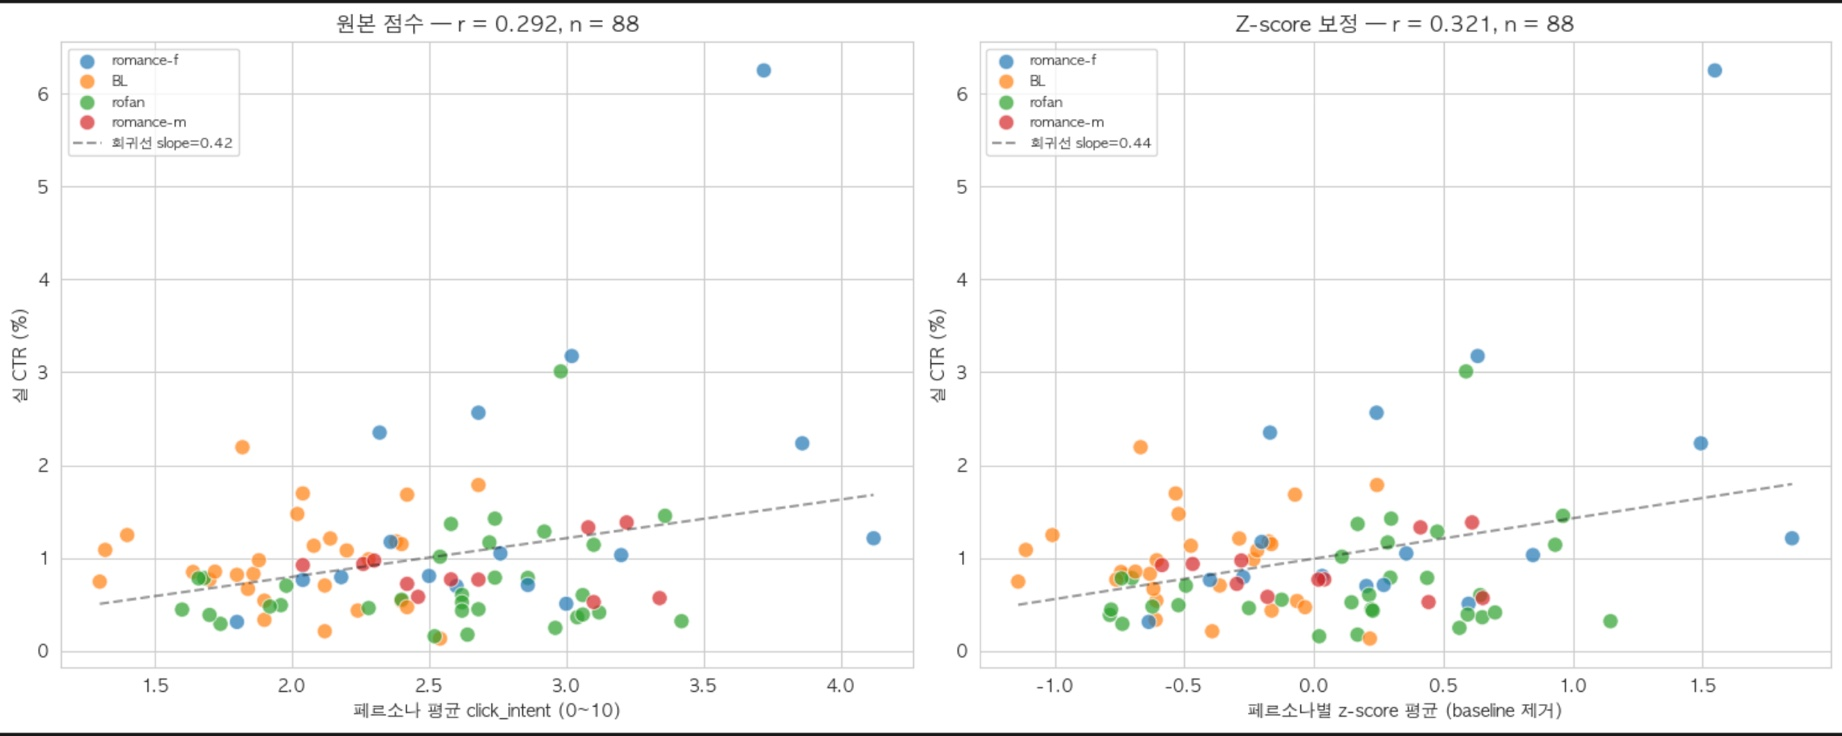
원본 평균 점수와 페르소나별 Z-score 보정 비교 — r=0.292 → 0.321, n=88

| 비교 자료 | 배너 표본 수 n | 상관계수 r | | --- | --- | --- | | 전연령 층화 산점도 | 14 | -0.219 | | 20~39세 산점도 | 86 | 0.079 | | 추가 비교: 원본 평균 점수 | 88 | 0.292 | | 추가 비교: Z-score 보정 | 88 | 0.321 | 상관계수는 0.029 높아졌지만, 이 차이만으로 비정상적으로 커졌다거나 예측력이 유의미하게 개선됐다고 판단하지 않았다. 집행 후보를 자동으로 거를 기준인 0.5에도 미치지 못했다. 배너 88개를 비교한 조건과 세 번째 클러스터 실험의 조건이 같은지 확인하지 못했으므로 두 결과는 구분했다. ## 예측에 필요한 서비스 취향 정보가 부족했다 결과를 보고 가장 먼저 생각한 한계는 feature였다. Nemotron Persona에는 나이, 결혼 여부, 지역, 직업, 취미 같은 일반적인 인구통계와 생활 정보가 있었다. 하지만 우리가 알고 싶은 것은 서브컬처 배너를 보고 클릭할지, 크랙 서비스를 이용하고 비용을 지불할지였다. 이 행동을 직접 설명하는 서비스 관련 feature는 없었다. 취미나 생활 맥락을 자세히 적은 프로필이라고 해도, 그 정보만으로 우리 서비스에 대한 선호를 알 수 있을지는 별개의 문제였다. 각 feature와 크랙 이용 여부의 상관관계를 따로 측정한 것은 아니다. 다만 이번 CTR 예측 실험에서 나온 낮은 상관을 보고, 일반적인 프로필 정보만으로는 우리 서비스의 광고 반응을 설명할 신호가 부족했을 것이라고 추정했다. 결제 의향을 검증한 실험도 아니었으므로 클릭 결과를 결제 예측으로 확장할 수는 없었다. ## 여러 feature를 결합한 집단의 신뢰도도 보장되지 않았다 [NVIDIA의 공식 데이터셋 카드](https://huggingface.co/datasets/nvidia/Nemotron-Personas-Korea)는 공개 데이터와 생성 모델의 제약 때문에 일부 변수 간 독립성을 가정했다고 설명한다. 예를 들어 세부 직업을 배정할 때 성별, 소득, 학력, 전공이 독립적으로 영향을 준다고 가정하며, 성별과 전공의 결합 효과 같은 교호작용은 반영하지 않는다. 이 설명을 모든 feature를 반드시 따로 써야 한다는 사용 규칙으로 읽을 수는 없다. 다만 개별 분포가 현실과 비슷하다는 것만으로, 여러 조건을 동시에 만족하는 페르소나 집단까지 실제 사용자 집단을 잘 대표한다고 볼 수는 없었다. 나는 연령·성별·교육·직업·지역을 함께 사용하고, 프로필을 임베딩해 서비스에 관심을 가질 만한 집단을 고르려 했다. 이 과정에서는 데이터셋이 충분히 검증하지 않은 변수 간 관계까지 신뢰하는 셈이었다. 여러 feature를 합쳐 평가 집단을 정교하게 만들려고 했지만, 실제로는 그 집단의 대표성에 대한 불확실성을 더할 수 있는 방향이었다. 이 결합이 상관계수를 얼마나 낮췄는지 따로 검증하지는 않았다. 그래서 실패 원인으로 확정하기보다는, 실험 설계에서 충분히 고려하지 못한 데이터셋의 한계로 남겼다. ## 결국 광고 집행 필터로 사용하지 않았다 원래 구상은 장르별 배너를 먼저 생성하고, 페르소나로 시뮬레이션한 뒤, 기준 미만인 후보를 제외하는 흐름이었다. 하지만 이번 실험은 상관계수 0.5라는 활용 기준을 충족하지 못했다. 서비스 선호를 직접 설명할 feature가 부족했고, 여러 feature를 결합해 만든 평가 집단의 대표성도 신뢰하기 어려웠다. 이 두 한계와 실제로 확인한 낮은 예측력을 바탕으로, Nemotron Persona를 이용한 CTR 예측은 광고 운영에 사용하지 않기로 했다. 시간상 충분한 표본을 확보하지 못한 점도 있었지만, 표본 수만 늘리면 해결될 문제라고 보지는 않았다. 우리 서비스와 관련된 취향·이용 행동 정보가 없는 상태에서 페르소나를 더 많이 뽑는다고 필요한 신호가 생기는 것은 아니기 때문이다. 질문 형식과 점수 보정, 집단 선택을 바꿔본 기록은 남겼지만, 실제 집행 후보를 고르는 파이프라인에는 붙이지 않았다. ### [이미지기반 카페추천 프로젝트] ADK 기반 에이전트 챗봇 구현 - Canonical URL: https://hyejunl33.github.io/projects/2026-01-30-ADK-Multi-agent/ - Collection: Project - Published: 2026-01-30 - Tags: 이미지기반 카페추천 프로젝트, ADK 기반 에이전트 챗봇 구현 ## 목차 1. [필요한 기능](#필요한-기능) 2. [동네 처리 (Location Agent)](#동네-처리--location-agent) 3. [Stateful 채팅 구현](#stateful-채팅-구현) 4. [ADK 마이그레이션](#adk-마이그레이션) 5. [Context 기반 추천 질문 생성 (Suggestion)](#context-기반-추천-질문-생성-suggestion) 6. [실험 및 검증](#실험-및-검증) --- ## 필요한 기능 - 인풋 쿼리에서 동을 따로 받아서 해당하는 동네 내에서만 검색결과 보여주는 기능 - 인풋 쿼리의 랜드마크나 위치를 받아서 행정동으로 변환하는 에이전트 - Stateful 채팅을 구현해서 이전까지의 Context를 기억해서 다른 카페 찾을 수 있는 기능 - Context에 알맞는 다음 예상 질문을 생성하는 기능 --- ## 동네 처리 → Location Agent **문제정의:** 쿼리에서 자연어로 들어오는 동네의 형태는 매우 다양하다. 홍대, 롯데월드근처(랜드마크)일 수도 있고, 잠실역(역 이름)등일수도 있고, ‘연남동’과 같이 동네 이름 자체일 수도 있다. 유저가 제시한 위치의 근처에 위치한 카페를 검색결과로 보여주기 위해, Location Agent를 사용해서 연관 행정동 리스트를 추출하고, 카페마다 DB에 저장된 `dong_group` 에 해당하는 카페만 검색을 해서 결과로 제시하는 기능이 필요했다. **핵심 목표**: `"홍대"` → `["서교", "연남", "동교", "상수", "합정"]`과 같이 연관 행정동 리스트를 추출하여 검색 재현율(Recall) 향상 ### LocationAgent.run(user_query: str) → dict **입력**: user_query: "홍대 조용한 카페 추천해줘" **처리 흐름**: ```python def run(self, user_query: str) -> dict: # 1. LLM 호출 prompt_result = self._call_llm(user_query) # 2. JSON 파싱 (실패 시 {}~{} 패턴 추출) try: result_json = json.loads(prompt_result) except JSONDecodeError: start = prompt_result.find('{') end = prompt_result.rfind('}') + 1 result_json = json.loads(prompt_result[start:end]) # 3. 결과 반환 return { "is_location_query": result_json.get("is_location_query", False), "region_names": result_json.get("region_names", []), "original_query": user_query } ``` 사용자 쿼리를 Clova LLM에 전달하여 위치 키워드를 추출한다. LLM 응답이 순수 JSON이 아닐 경우를 대비해 `{`와 `}` 사이의 문자열만 추출하는 fallback을 포함했다. 최종적으로 쿼리에 위치 정보가 있는지 여부(`is_location_query`)와 인근 행정동 리스트(`region_names`)를 반환한다. - **_call_llm() 핵심 프롬프트** ``` "너는 서울시 행정동 전문가야. 사용자 입력에서 위치 정보를 추출하고, 해당 위치와 인접한 서울시 행정동 이름을 정확히 반환해." [핵심 규칙] 1. 반드시 행정동 이름만 반환 (예: 성수1가, 자양, 화양) 2. '동', '역', '입구' 같은 접미사는 절대 포함하지 마 3. 랜드마크/역 이름 → 실제 행정동으로 변환 4. 총 5개의 인접 행정동 반환 [변환 예시] - '서울숲' → 성수1가, 성수2가, 금호, 옥수, 행당 (서울숲 ❌) - '건대입구역' → 화양, 자양, 군자, 구의 (건대입구역 ❌) - '홍대' → 서교, 연남, 동교, 상수, 합정 ``` 이 프롬프트를 통해서 LLM이 랜드마크나 역 이름을 그대로 반환하지 않고 실제 행정동 이름으로 변환하도록 유도한다. ‘동’ 접미사를 제거하는 규칙은 DB의 `dong_group` 컬럼과 일치시키기 위함이다. dong_group에는 잠실 1동, 잠실 2동 형식으로 숫자를 포함한 동의 형태로 저장되어있는데, 검색할때는 ‘잠실’이라는 키워드만 포함시켜서, 키워드기반 넓은 동네를 포함하여 검색결과를 보여준다. **API 설정**: - Clova Studio HCX-DASH-002 - temperature: 0.1 (일관된 답변) - maxTokens: 100 **출력**: ```json { "is_location_query": true, "region_names": ["서교", "연남", "동교", "상수", "합정"], "original_query": "홍대 조용한 카페 추천해줘" } ``` ### 검색 엔진 연동 (`src/engine/retriever.py`) - `vibe_search()`에 `location_filter` 파라미터 추가 - `dong_group` 컬럼을 이용한 SQL OR 조건 필터링 ```sql WHERE dong_group IN ('서교', '연남', '동교', '상수', '합정') ``` LocationAgent가 추출한 행정동 리스트를 SQL의 IN 조건으로 변환하여, 해당 지역에 속한 카페만 검색 대상에 포함시킴. 이를 통해 검색 범위를 좁히고 해당 동네에 대해서만 검색결과를다. --- ## Stateful 채팅 구현 **문제정의:** 기존에는 한번만 검색하고 결과를 보여주는 서비스였다. 하지만 유저가 추천결과에 대해서 검색을 심화할수도 있고(”더 조용한 카페 추천”), 혹은 도중에 검색하는동네를 바꾸어서 검색을 할수도있고, 추천된 가게의 메타데이터에 대해서 질문을 할수도 있을거라고 예상했다. 따라서 이전의 context를 Pydantic을 이용해서 state로 정의하고, 그 context를 Multi Agent가 참고하면서 추론할 수 있는 로직이 필요했다. ### 주요 기능 - 이전의 추천 정보를 Context로 기억하고 새로운 카페를 추천 - 추천된 카페에 대한 메타정보 질문 시 DB를 retrieval해서 답변 - 이미 추천한 장소는 재추천하지 않음 ### AgentState 데이터 모델 (`backend/agents/state.py`) ```python class AgentState(BaseModel): session_id: str # 세션 고유 ID user_query: str # 현재 사용자 쿼리 # === Shared Memory (턴 간 유지) === history_place_ids: List[int] # 이미 추천된 장소 ID (중복 방지) last_recommendations: List[Dict] # 최근 추천 결과 (QnA 참조용) current_location_filter: List[str] # 현재 동네 필터 ["서교", "연남"] previous_hyde_query: str # 직전 HyDE 쿼리 (분위기 맥락 유지) file_path: str # 업로드된 이미지 경로 # === 현재 턴 상태 === intent: AgentIntent # SEARCH | FEEDBACK | QNA final_response: Dict # 최종 응답 ``` `AgentState`는 Pydantic 모델로, 대화 세션의 모든 상태를 담고 있다. `history_place_ids`는 이미 추천한 장소를 기억해 중복 추천을 방지하고, `previous_hyde_query`는 이전의 HyDE Query를 저장한것으로 “더 조용한 곳” 같은 피드백 시 이전 분위기 맥락을 유지하는 데 사용한다. 모든 에이전트가 이 상태 객체를 공유한다. ### ContextManager (`backend/agents/context_manager.py`) DuckDB 기반의 영속적 상태 관리 싱글톤 | 메서드 | 입력 | 동작 | 출력 | | --- | --- | --- | --- | | `get_or_create_state(session_id, query)` | session_id, user_query | DB에서 기존 세션 로드 또는 신규 생성 | AgentState | | `get_state(session_id)` | session_id | 현재 세션 상태 조회 | AgentState | | `save_state(state)` | AgentState | 변경된 상태를 DuckDB에 UPSERT | None | | `update_history(state, recs)` | state, 추천 결과 | history_place_ids에 추가 (중복 방지) | None | **저장 구조 (DuckDB)**: ```sql CREATE TABLE sessions ( session_id VARCHAR PRIMARY KEY, state_json VARCHAR, -- AgentState를 JSON으로 직렬화 updated_at TIMESTAMP ); ``` 세션 상태를 DuckDB 테이블에 JSON 문자열로 직렬화하여 저장한다. 서버가 재시작되어도 `session_id`를 기반으로 이전 대화 상태를 복원할 수 있어 영속적인 대화 컨텍스트를 유지할 수 있다. **상태 저장 로직**: ```python def save_state(state: AgentState): state_json = state.model_dump_json() con.execute(""" INSERT INTO sessions (session_id, state_json, updated_at) VALUES (?, ?, CURRENT_TIMESTAMP) ON CONFLICT (session_id) DO UPDATE SET state_json = excluded.state_json, updated_at = excluded.updated_at """, (state.session_id, state_json)) ``` Pydantic의 `model_dump_json()`으로 상태를 JSON 문자열로 변환한 후, DuckDB의 UPSERT 구문(`INSERT ... ON CONFLICT DO UPDATE`)으로 저장한다. 같은 `session_id`가 있으면 업데이트, 없으면 새로 생성된다. --- ## ADK 마이그레이션 ### 현재 구현된 Agent | Agent | 역할 | 입력 | 출력 | | --- | --- | --- | --- | | **Router** | 유저 의도 파악 | user_query | AgentIntent (SEARCH/FEEDBACK/QNA) | | **Location** | 랜드마크 → 행정동 변환 | user_query | region_names 리스트 | | **Search** | 카페 검색 실행 | state (필터, 히스토리 포함) | recommendations 리스트 | | **QnA** | 장소 메타정보 답변 | state (last_recommendations 참조) | 답변 메시지 | ### 왜 ADK? - **Intent-Based Routing**: 사용자 발화 의도를 `SEARCH`, `FEEDBACK`, `QNA`로 분류 - **LoopAgent**: 에이전트들을 순차 실행하며, `escalate=True` 발생 시까지 반복 - **ADK Viewer**: 웹 기반 디버깅 UI 제공 ![image](/assets/images/2026-02-12-17-04-18.png) --- ## 파일별 역할 및 상세 동작 ![image](/assets/images/2026-02-12-17-04-24.png) ``` backend/ ├── main.py # FastAPI 앱 설정 & 서버 시작 ├── api/ │ └── chat.py # API 엔드포인트 (Entry Point) ├── workflow.py # LoopAgent 정의 (에이전트 순서) ├── lib/ │ └── google_adk_agents.py # ADK Wrapper (BaseAgent 구현) ├── agents/ │ ├── router.py # 의도 분류 로직 │ ├── location_agent.py # 위치 파싱 로직 │ ├── qna_agent.py # Q&A 로직 │ ├── context_manager.py # 상태 관리 │ └── state.py # AgentState 모델 └── services/ ├── search_service.py # HyDE + Retrieval ├── reasoning.py # 추천 이유 생성 └── suggestion.py # 추천 질문 생성 ``` 백엔드 로직은 **API 계층(`backend/api`)**, **워크플로우 계층(`backend/lib`)**, **핵심 로직 계층(`backend/agents`)**, **서비스 계층(`backend/services`)**으로 나뉜다. ### Entry Point (`backend/api/chat.py`) ```python @router.post("/", response_model=RecommendedPlacesResponse) async def create_chat(session_id, user_query, file): # 1. 상태 로드/생성 init_state = context_mgr.get_or_create_state(session_id, user_query) init_state.file_path = file_path_disk context_mgr.save_state(init_state) # 2. ADK Runner 설정 & 실행 runner = InMemoryRunner(agent=adk_app, app_name="vibe_pick") user_msg = types.Content(role="user", parts=[types.Part(text=user_query)]) async for event in runner.run_async(user_id, session_id, new_message=user_msg): pass # 에이전트 순차 실행 # 3. 결과 추출 final_state = context_mgr.get_state(session_id) recommendations = final_state.final_response.get("recommendations", []) # 4. 추천 질문 생성 (Suggestion) suggestions = generate_suggestions(user_query, place_names[:3], hyde_query) # 5. 응답 반환 return RecommendedPlacesResponse( recommendations=recommendations, suggestions=suggestions, ... ) ``` API의 엔트리포인트다. 먼저 `ContextManager`로 세션 상태를 로드/생성한 후, ADK의 `InMemoryRunner`를 통해 LoopAgent를 실행한다. 에이전트들이 순차적으로 실행되고, 완료되면 `final_state`에서 결과를 추출한다. 마지막으로 `generate_suggestions()`를 호출해 다음 추천 질문을 생성하여 응답에 포함한다. ### Workflow (`backend/workflow.py`) ```python from google.adk.agents.loop_agent import LoopAgent router = ADKRouterAgent(name="router") location = ADKLocationAgent(name="location") search = ADKSearchAgent(name="search") qna = ADKQnAAgent(name="qna") app = LoopAgent( name="vibe_pick_agent", sub_agents=[router, location, search, qna], max_iterations=5 # 무한루프 방지를 위한 안전장치 ) ``` ADK의 `LoopAgent`를 사용해 에이전트 실행 순서를 정의한다. 배열 순서대로 Router → Location → Search → QnA가 실행되며, 중간에 `escalate=True` 이벤트가 발생하면 루프가 종료된다. ### ADKRouterAgent (`backend/lib/google_adk_agents.py`) ```python async def _run_async_impl(self, ctx: InvocationContext): session_id = ctx.session.id # 1. 텍스트/이미지 추출 user_query = "" image_path = None for part in ctx.user_content.parts: if getattr(part, "text", None): user_query += part.text if getattr(part, "inline_data", None): # 이미지 저장: temp_images/{uuid}.jpg image_path = save_image(part.inline_data) # 2. 상태 로드 state = context_mgr.get_or_create_state(session_id, user_query) state.file_path = image_path # 3. 라우팅 실행 intent = self.router_logic.route(state) # Router.route() 호출 state.intent = intent # SEARCH | FEEDBACK | QNA # 4. 상태 저장 context_mgr.save_state(state) yield Event(author=self.name, custom_metadata={"type": "routed"}) ``` LoopAgent에서 가장 먼저 실행되는 에이전트이다. ADK의 `ctx.user_content`에서 텍스트와 이미지를 추출하고, `Router.route()` 메서드를 호출해 사용자 의도(SEARCH, FEEDBACK, QNA 중 하나)를 판단한다. 판단 결과를 `state.intent`에 저장하여 이후 에이전트들이 참조할 수 있게 한다. ### ADKLocationAgent ```python async def _run_async_impl(self, ctx: InvocationContext): state = context_mgr.get_state(ctx.session.id) # Intent가 SEARCH/FEEDBACK일 때만 실행 if state.intent not in [AgentIntent.SEARCH, AgentIntent.FEEDBACK]: return # 조기 반환 # 위치 파싱 loc_result = self.loc_agent.run(state.user_query) # {"is_location_query": true, "region_names": ["서교", "연남"]} new_filters = loc_result.get("region_names", []) if new_filters: state.current_location_filter.extend(new_filters) state.current_location_filter = list(set(state.current_location_filter)) context_mgr.save_state(state) yield Event(author=self.name, custom_metadata={"type": "location_parsed"}) ``` Router가 판단한 `intent`가 SEARCH나 FEEDBACK일 때만 동작하고, QNA면 바로 반환한다(QnA에서는 location의 변화가 없으므로). `LocationAgent.run()`을 호출해 쿼리에서 지역명을 추출하고, 새로 발견된 지역을 `current_location_filter`에 추가한다. `list(set(...))`으로 중복을 제거한다. ### ADKSearchAgent ```python async def _run_async_impl(self, ctx: InvocationContext): state = context_mgr.get_state(ctx.session.id) if state.intent not in [AgentIntent.SEARCH, AgentIntent.FEEDBACK]: return # 이전 HyDE 컨텍스트 참조 (FEEDBACK 시 분위기 누적) prev_context = state.previous_hyde_query # 검색 실행 hyde_query, recommendations = await hyde_search( state.user_query, # "더 조용한 곳" state.file_path, # 업로드된 이미지 state.current_location_filter, # ["서교", "연남"...] state.history_place_ids, # 이미 추천한 장소 제외 prev_context # "홍대 모던한 인테리어..." (이전 HyDE) ) # 상태 업데이트 state.previous_hyde_query = hyde_query context_mgr.update_history(state, recommendations) state.final_response = {"hyde_query": hyde_query, "recommendations": recommendations} context_mgr.save_state(state) # 루프 종료 (escalate=True) yield Event( author=self.name, content=types.Content(parts=[types.Part(text=output_text)]), actions=EventActions(escalate=True) ) ``` 실제 검색을 수행하는 에이전트다. `hyde_search()` 함수에 현재 쿼리, 이미지, 지역 필터, 제외할 장소 ID 목록, 이전 HyDE 쿼리를 전달한다. `history_place_ids`를 통해 이미 추천한 장소를 제외하고, `prev_context`를 통해 이전 분위기 맥락과 결합된 새 HyDE 쿼리를 생성한다. 검색이 완료되면 `escalate=True`로 LoopAgent를 종료시킨다. ### QnAAgent.run(state: AgentState) → dict ```python def run(self, state: AgentState) -> dict: query = state.user_query # "첫 번째 카페 주차 돼?" # 1. 대상 장소 식별 (LLM 사용) target_places = self._identify_target_places(query, state.last_recommendations) # [{"place_id": 101, "place_name": "블루보틀 연남점"}] if not target_places: return {"message": "참고할 추천 결과가 없어서 답변드리기 어려워요."} # 2. 장소 상세 정보 조회 (DB) all_details = [] for place in target_places: details = self._fetch_place_details(place['place_id']) # places: address, business_hours, contact # amenities: 주차, 예약, 와이파이 등 10개 항목 # reviews: summary, keywords # menus: name, price all_details.append(f"=={place['place_name']} ==\n{details}") # 3. LLM 답변 생성 answer = self._generate_answer(query, place_names, combined_details) # "네, 주차 가능합니다. 건물 지하주차장 이용 가능해요." return {"message": answer, "related_place_id": target_places[0]['place_id']} ``` QnA 에이전트는 추천된 가게의 메타데이터에 대한 질문을 답변하는 에이전트로 3단계로 동작한다. 먼저 `_identify_target_places()`에서 LLM을 사용해 “첫 번째”, “두 번째” 같은 표현이 가리키는 실제 장소를 식별한다. 그 다음 `_fetch_place_details()`로 해당 장소의 주소, 편의시설, 리뷰, 메뉴 정보를 DB에서 조회한다. 마지막으로 `_generate_answer()`에서 조회된 정보를 바탕으로 LLM이 자연스러운 답변을 생성한다. - **_identify_target_places() 프롬프트**: ``` "너는 사용자의 질문이 '추천 장소 목록' 중 어떤 장소를 지칭하는지 식별하는 분류기야. 아래 목록을 보고, 질문이 가리키는 장소들의 ID를 JSON 리스트로 반환해." [추천 장소 목록] 1. 블루보틀 연남점 (ID: 101) 2. 앤트러사이트 (ID: 102) 3. 프리베 (ID: 103) → 출력: [101] ``` LLM에게 추천 목록과 함께 사용자 질문을 전달하면, “첫 번째” → ID 101, “두 번째와 세 번째” → [102, 103] 처럼 해당하한다. “모두”, “전부” 같은 표현이면 전체 ID를 반환하도록 프롬프트에 명시되어 있다. --- ## Context 기반 추천 질문 생성 (Suggestion) **문제정의:** 유저가 어떤 검색을 해야할지 잘 모르겠는 상황이 있을거라고 생각했다. 따라서 이전의 유저의 요구를 Context로 이용해서 다음 질문을 예측하는 로직을 추가해서 챗봇에 추가했다. **기능:** 검색 완료 후, 사용자가 다음에 물어볼 법한 질문 4개를 자동 생성 ### generate_suggestions() (`backend/services/suggestion.py`) **입력(Context)**: `user_query` =“홍대 조용한 카페” `place_names` = [“블루보틀 연남점”, “앤트러사이트”, “프리베”] `hyde_query` =“홍대 연남동 조용하고 넓은 우드톤 카페…” 유저의 원본 쿼리와 hyde쿼리를 가져와서 유저의 의도를 파악하도록 했고, 이전에 추천된 가게의 이름을 `place_name`으로 제공해주었다. **처리 흐름**: ```python def generate_suggestions(user_query, place_names, hyde_query=None) -> list[str]: # 1. Context 포맷팅 place_str = ', '.join(place_names[:3]) user_content = f"검색어:{user_query}\n추천 장소:{place_str}\n분위기:{hyde_query or '없음'}" # 2. 시스템 프롬프트 system_prompt = """너는 카페 추천 서비스의 대화 어시스턴트야. 사용자가 카페 추천을 받았어. 사용자가 다음에 물어볼 법한 질문 4개를 생성해줘. [질문 유형 - 반드시 다양하게 섞어서] 1. 장소 상세 질문: 주차, 메뉴, 영업시간 등 2. 결과 조정 요청: 더 조용한 곳, 더 넓은 곳, 분위기 다른 곳 등 [규칙] - 각 질문은 30자 이내로 짧게 - 자연스러운 구어체 ("첫 번째 카페 주차 가능해?", "더 아늑한 곳 없어?") - 순수 JSON 배열만 출력: ["질문1", "질문2", "질문3", "질문4"] """ # 3. Clova API 호출 (temperature=0.7 다양성 확보) payload = { "messages": [ {"role": "system", "content": system_prompt}, {"role": "user", "content": user_content} ], "temperature": 0.7, "maxTokens": 100 } res = requests.post(clova_api_url, headers=headers, json=payload) content = res.json()['result']['message']['content'] # 4. JSON 파싱 (마크다운 코드블록 제거) suggestions = extract_json_array(content) # 5. Fallback (4개 미만 시 기본 질문으로 채움) if len(suggestions) < 4: defaults = ["주차 가능해?", "메뉴 추천해줘", "더 조용한 곳은?", "영업시간 알려줘"] return (suggestions + defaults)[:4] return suggestions[:4] ``` 검색 결과의 Context(검색어, 추천 장소 이름, 분위기 키워드)를 조합해 LLM에 전달하고, 사용자가 다음에 물어볼 법한 자연스러운 질문 4개를 생성한다. `temperature=0.7`로 설정해 다양한 질문이 생성되도록 하고, LLM 응답이 4개 미만이면 fallback으로 기본 질문으로 채운다. 질문 유형은 QNA(장소 상세)와 FEEDBACK(결과 조정)이 섞이도록 프롬프트에 명시되어 있어, 사용자가 클릭하면 자연스럽게 다음 대화로 이어진다. ![image.png](image%202.png) **출력 예시**:["첫 번째 카페 주차 가능해?", "두 번째 카페 메뉴 추천해줘", "더 넓은 곳 없어?", "영업시간 알려줘"] ### 질문 유형 설계 의도 | 생성되는 질문 유형 | Router 분류 | 처리 Agent | | --- | --- | --- | | 장소 상세 질문 | QNA | QnAAgent | | 결과 조정 요청 | FEEDBACK | SearchAgent | → 사용자가 추천 질문 클릭 시, Router가 자동 분류하여 적절한 에이전트 실행 ### 호출 시점 (`chat.py`) ```python # 검색 완료 후 suggestions 생성 suggestions = None if recommendations: place_names = [p.place_name for p in recommendations[:3]] try: suggestions = generate_suggestions( user_query=user_query, place_names=place_names, hyde_query=hyde_query ) except Exception as e: suggestions = ["주차 가능해?", "메뉴 추천해줘", "더 조용한 곳은?", "영업시간 알려줘"] return RecommendedPlacesResponse( ... suggestions=suggestions ) ``` 추천 결과가 있을 때만 `generate_suggestions()`를 호출한다. 생성된 추천 질문은 프론트엔드에서 버튼 형태로 표시된다. --- ## 전체 데이터 흐름도 ![image](/assets/images/2026-02-12-17-05-18.png) 전체 흐름을 요약하면 사용자 요청이 들어오면 LoopAgent가 Router → Location → Search/QnA 순서로 에이전트를 실행한다. 각 에이전트는 `state.intent`를 확인해 자신이 처리해야 할 요청인지 판단하고, 해당되지 않으면 조기 반환한다. 최종적으로 검색 결과와 추천 질문을 함께 응답한다. --- ## 실험 및 검증 ### Case 1(Feedback): 검색된 카페의 분위기가 마음에 들지 않아서 추가적인 분위기를 제공할때 동작: Location(동네)는 변경하지 않고 이전의 HyDE 쿼리에 추가로 HyDE쿼리를 생성해서 두 HyDE쿼리를 합친 후 다시 검색함 ![image](/assets/images/2026-02-12-17-05-24.png) ![image](/assets/images/2026-02-12-17-05-31.png) > 상황: 성수동 검색 결과가 마음에 안 들어서 "더 개방감 있는 분위기로 찾아줘"라고 했을 때 > 1. **Router Agent**: "좀 더", "분위기로" 같은 표현과 이전 맥락(Context)을 보고 의도를 으로 분류. 2. **Location Agent**: 의도가 이므로 동작하지만, 새로운 지명이 없으므로 **기존의 `current_location_filter`("성동구 성수동")를 그대로 유지**. 3. **Search Agent**: - `FEEDBACK` 의도일 경우, 이전 검색을 위해 생성했던 시각적 묘사(HyDE)를 가져옴 - 새로운 쿼리의 HyDE를 합쳐서 **더 구체적인 새로운 HyDE 쿼리**를 생성합니다. (예: "모던한... + 밝은 자연광이 들어오는...") - **Retriever**: 기존 위치 필터("성수동") 내에서 새로운 HyDE 쿼리와 유사한 이미지를 가진 장소를 재검색 ### Case 2 (QnA): 검색된 카페에 대한 메타정보를 물어볼때 ![image](/assets/images/2026-02-12-17-05-36.png) > 상황: 검색된 결과 중 "첫 번째 곳 주차 돼?"라고 물었을 때 > 1. **Router Agent**: "사람들의 평은 어때?", 같은 의도를 인식하여 의도를 로 분류 2. **Location Agent / Search Agent**: 의도가 이므로 **동작하지 않고 건너뜀.** 3. **QnA Agent**: - **Selector (LLM)**: 질문("첫 번째 곳")과 (이전 검색 결과 3개)를 보고 "1번 장소(ID: 101)"를 대상으로 식별 - **DB Fetch**: 해당 장소의 **amenities**, **places** 테이블을 조회하여 주차 정보 등을 가져옴. - **Generator (LLM)**: "이 장소는 주차가 가능합니다"라는 답변을 생성하여 사용자에게 전달. ### Case 3(new Search): 이전의 지역이 아니라 새로운 지역에 대해서 검색하고 싶을때 ![image](/assets/images/2026-02-12-17-05-43.png) > 상황: "강남역 근처 카공하기 좋은 곳 추천해줘"라고 했을 때 > 1. **Router Agent**: - 먼저 **Location Agent**를 호출. - LLM이 명확한 지역을 인식하고(”강남역”) Intent를 새로운 지역에 대한 Search로 인식함 2. **Location Agent**: - "강남역"을 **["강남구 역삼동", "서초구 서초동"]** 등의 행정동 리스트로 변환하여 를 **덮어씀(Overwrite).** 3. **Search Agent**: - 변경된 필터(역삼/서초) 내에서 검색하여 결과를 반환. --- ## 완료된 기능 - [x] 인풋 쿼리에서 동을 파싱하여 해당 동네 내에서만 검색 - [x] Stateful 채팅으로 이전 Context 기억 - [x] Context에 알맞는 예상 질문 생성 (Suggestion) - [x] QnA Agent로 장소 메타정보 답변 - [x] 이미 추천한 장소 중복 방지 (history_place_ids) - [x] 분위기 피드백 시 HyDE 누적 (previous_hyde_query) ### [이미지기반 카페추천 프로젝트] Apache Airflow 파이프라인 자동화 구현 - Canonical URL: https://hyejunl33.github.io/projects/2026-01-30-Airflow_Pipeline/ - Collection: Project - Published: 2026-01-30 - Tags: 이미지기반 카페추천 프로젝트, Apache Airflow 파이프라인 자동화 구현 # Apache Airflow 파이프라인 자동화 구현 ## 목차 1. [도입 배경 및 문제 정의](#도입-배경-및-문제-정의) 2. [파이프라인 아키텍처](#파이프라인-아키텍처) 3. [DAG 설계 및 구현](#dag-설계-및-구현) 4. [병렬 처리 및 최적화](#병렬-처리-및-최적화) 5. [Task 의존성 및 실행 흐름](#task-의존성-및-실행-흐름) 6. [실행 결과 및 성능 개선](#실행-결과-및-성능-개선) --- ## 도입 배경 및 문제 정의 ### 기존 문제점 서울 전역의 카페 데이터를 수집하고 처리하는 파이프라인을 **수동으로 단계별 순차 실행**하고 있었음. 크롤링이 가장 오래걸리는 작업인데, 서울내 모든 동네(약 420개)에 대해서 크롤링이 끝나야만 다음단계로 넘어가는것은 매우 비효율적임. ``` ❌ 기존 방식: 단계별 순차 실행 (수동) [Step 0] 전체 동네 크롤링 완료 대기 ↓ (전체 완료 후) [Step 1] 전체 동네 대표 이미지 추출 ↓ (전체 완료 후) [Step 2] 전체 동네 VLM 묘사 생성 ↓ (전체 완료 후) [Step 3] 전체 동네 리뷰 요약 ↓ (전체 완료 후) [Step 4] 전체 동네 임베딩 생성 ↓ DB 적재 → 각 단계가 "전체 동네" 완료를 기다려야 다음 단계 시작 → 앞서 완료된 동네도 뒤처진 동네를 기다리며 유휴 상태 → 한 단계 실패 시 전체 재실행 필요 ``` ### 문제점 요약 | 문제 | 설명 | | --- | --- | | **단계별 병목** | 한 단계가 전체 동네에서 완료되어야 다음 단계 시작 가능 | | **유휴 시간 발생** | 빨리 끝난 동네도 느린 동네를 기다리며 대기 | | **수동 개입** | 각 단계 완료 후 다음 단계 수동 실행 필요 | | **실패 복구 어려움** | 중간 실패 시 해당 단계 전체 재실행 | | **스케줄링 없음** | 정기적인 자동 실행 불가 | ### 해결 방안: Apache Airflow 도입 **핵심 변경**: 단계별 전체 처리 → **동네 단위 독립 파이프라인** - **Task 의존성을 DAG로 정의**하여 동네별 파이프라인 자동 실행 - **동네 단위 병렬 처리**: 완료된 동네부터 다음 단계 즉시 진행 (대기 X) - **스케줄링**으로 정기적 자동 실행 - **실패 Task만 재시도**하여 복구 효율화 --- ## 파이프라인 아키텍처 ### 전체 데이터흐름 ![image](/assets/images/2026-02-04-01-02-29.png) ### 파일 구조 ``` src/pipeline/ ├── _00_image_extraction.py # 이미지 다운로드 ├── _01_extract_representative_images.py # CLIP 대표 이미지 ├── _02_generate_vlm_descriptions.py # VLM 묘사 생성 ├── _03_summarize_reviews.py # 리뷰 요약 ├── _04_generate_embeddings.py # 임베딩 생성 └── airflow/ └── dags/ ├── cafe_monthly_full_pipeline.py # 월간 전체 파이프라인 └── cafe_weekly_review_pipeline.py # 주간 리뷰 업데이트 ``` ### 단계별 스크립트 설명 | Step | 스크립트 | 역할 | 사용 모델 | | --- | --- | --- | --- | | 0 | `_00_image_extraction.py` | 크롤링된 JSON에서 이미지 URL 추출 및 다운로드 | - | | 1 | `_01_extract_representative_images.py` | 카페별 대표 이미지 5장 선정 | CLIP | | 2 | `_02_generate_vlm_descriptions.py` | 이미지 분위기 묘사 텍스트 생성 | Qwen2.5-VL-7B | | 3 | `_03_summarize_reviews.py` | 리뷰 텍스트 요약 | Gemma3 | | 4 | `_04_generate_embeddings.py` | 이미지/텍스트 벡터 임베딩 | SigLIP v2 | --- ## DAG 설계 및 구현 ### 2개의 DAG 설계 서로 다른 주기와 목적을 가진 **2개의 DAG**을 설계함. | DAG | 스케줄 | 목적 | 처리 범위 | | --- | --- | --- | --- | | `cafe_monthly_full_pipeline` | 매월 1일 03:00 | 전체 데이터 갱신 | 크롤링 + 이미지 + 임베딩 | | `cafe_weekly_review_pipeline` | 매주 토요일 02:00 | 리뷰만 업데이트 | 리뷰 크롤링 + 요약 | ### 월간 전체 파이프라인 (`cafe_monthly_full_pipeline.py`) ```python from datetime import datetime, timedelta from airflow import DAG from airflow.operators.bash import BashOperator from airflow.sensors.filesystem import FileSensor from airflow.decorators import task, task_group with DAG( 'cafe_monthly_full_pipeline', default_args=default_args, description='서울 카페 월간 파이프라인 (Streaming & GPU Optimized)', schedule_interval='0 3 1 * *', # 매월 1일 03:00 (KST) start_date=datetime(2026, 1, 25), catchup=False, tags=['cafe', 'monthly', 'streaming', 'gpu_pool'], max_active_runs=1, ) as dag: ``` 월간 전체 파이프라인은 크론표현식으로 매월 1일 새벽 3시에 자동 실행됨. `max_active_runs=1`로 동시 실행을 방지하고, `catchup=False`로 과거 미실행 건은 스킵함. ### 주간 리뷰 파이프라인 (`cafe_weekly_review_pipeline.py`) ```python with DAG( 'cafe_weekly_review_pipeline', default_args=default_args, description='서울 카페 주간 리뷰 업데이트 파이프라인 (text-only)', schedule_interval='0 2 * * 6', # 매주 토요일 02:00 (KST) start_date=datetime(2026, 1, 25), catchup=False, tags=['cafe', 'weekly', 'review', 'text-only'], max_active_runs=1, ) as dag: # 리뷰만 크롤링 (이미지 스킵) crawl_reviews = BashOperator( task_id='crawl_reviews', bash_command=f''' cd{CRAWLER_PATH} &&\ python main.py --mode parallel --target text-only ''', ) # 리뷰 요약 summarize = BashOperator( task_id='summarize_reviews', bash_command=f'cd{PIPELINE_PATH} && python _03_summarize_reviews.py', ) # DB 업데이트 seed_reviews = BashOperator( task_id='seed_reviews', bash_command=f'cd{PROJECT_PATH} && python backend/core/seed_weekly_reviews.py', ) # 의존성 정의 crawl_reviews >> summarize >> seed_reviews ``` 주간 파이프라인은 **리뷰만 업데이트함**. 리뷰 업데이트를 통해 가게 정보 최신화. 이미지 처리 단계(Step 0, 1, 2, 4)를 스킵하고 리뷰 요약(Step 3)만 실행하여 실행 시간을 대폭 단축. --- ## 병렬 처리 및 최적화 ### 1. Dynamic Task Mapping - 동네별 병렬 처리 ```python # 1. 처리할 동네 목록 동적 로드 @task def get_target_dongs(): dong_file = f"{CRAWLER_PATH}/seoul_parts/seoul_dongs.json" with open(dong_file, 'r', encoding='utf-8') as f: dongs = json.load(f) return sorted(dongs) # ['강남구_개포1동', '강남구_개포2동', ...] # 2. 동네별 Task Group 정의 @task_group(group_id='process_dong') def process_neighborhood(dong_name): # 각 동네별 5단계 파이프라인 step0 >> step1 >> step2 >> step3 >> step4 # 3. Dynamic Mapping으로 병렬 확장 target_dongs = get_target_dongs() processed_groups = process_neighborhood.expand(dong_name=target_dongs) ``` `expand()`를 사용한 **Dynamic Task Mapping**으로, 동네 목록의 크기에 따라 Task가 동적으로 생성됨. 만약 10개 동네면 10개의 독립적인 Task Group이 병렬로 실행됩니다. 이를 통해 동네 수가 늘어나도 코드 수정 없이 자동으로 확장. ### 병렬 처리 시각화 ![image](/assets/images/2026-02-04-01-02-46.png) ### 2. Streaming Pipeline - FileSensor 크롤링이 완료된 동네부터 **즉시 처리 시작** (전체 크롤링 완료 대기 X) ```python @task_group(group_id='process_dong') def process_neighborhood(dong_name): # A. 파일 감지 - 해당 동네 JSON이 생성되면 다음 단계 시작 wait_for_json = FileSensor( task_id='wait_for_json', filepath=f"{RAW_JSON_DIR}/{dong_name}.json", fs_conn_id='fs_default', mode='reschedule', # 대기 중에는 Worker 슬롯 반환 poke_interval=60 * 5, # 5분마다 파일 존재 확인 timeout=60 * 60 * 24, # 최대 24시간 대기 ) # B. 파일 감지 후 처리 시작 step0_download = BashOperator(...) wait_for_json >> step0_download >> step1 >> step2 >> step3 >> step4 ``` `FileSensor`는 지정된 파일이 생성될 때까지 대기함. `mode='reschedule'`로 설정하면 대기 중에 Worker 슬롯을 반환하여 다른 Task가 실행될 수 있음. 크롤링이 빠르게 완료되는 동네부터 순차적으로 처리가 시작되어 **전체 파이프라인 시간이 단축**. ![image](/assets/images/2026-02-04-01-02-54.png) ### 3. GPU Pool - 리소스 관리 GPU를 사용하는 작업들의 동시 실행 수를 제한하여 **OOM(Out of Memory) 방지** ```python # GPU 작업은 별도 풀로 제한 step1_clip = BashOperator( task_id='step1_clip', bash_command=params['cmd_step1'], pool='gpu_pool', # GPU 풀 (슬롯 제한) ) step2_vlm = BashOperator( task_id='step2_vlm', bash_command=params['cmd_step2'], pool='gpu_pool', # GPU 풀 ) step3_summary = BashOperator( task_id='step3_summary', bash_command=params['cmd_step3'], pool='gpu_pool', # GPU 풀 ) step4_embed = BashOperator( task_id='step4_embed', bash_command=params['cmd_step4'], pool='gpu_pool', # GPU 풀 ) ``` Airflow의 **Pool** 기능으로 동시 실행 가능한 Task 수를 제한. 이를 통해 각동네가 병렬로 처리되더라도 Vram을 사용하는 작업은 동시실행을 제한해서 GPU 메모리 부족을 방지. --- ## Task 의존성 및 실행 흐름 ### Task Group 상세 구조 ```python @task_group(group_id='process_dong') def process_neighborhood(dong_name): # 파라미터 준비 @task def prepare_params(name): return { 'sensor_path': f"{RAW_JSON_DIR}/{str(name)}.json", 'cmd_step0': f'cd{PIPELINE_PATH} && python _00_image_extraction.py --dong-name{str(name)}', 'cmd_step1': f'cd{PIPELINE_PATH} && python _01_extract_representative_images.py --dong-name{str(name)}', 'cmd_step2': f'cd{PIPELINE_PATH} && python _02_generate_vlm_descriptions.py --dong-name{str(name)}', 'cmd_step3': f'cd{PIPELINE_PATH} && python _03_summarize_reviews.py --dong-name{str(name)}', 'cmd_step4': f'cd{PIPELINE_PATH} && python _04_generate_embeddings.py --dong-name{str(name)}', } params = prepare_params(dong_name) # 파일 감지 wait_for_json = FileSensor(...) # 이미지 다운로드 (Default Pool) step0_download = BashOperator( task_id='step0_download', bash_command=params['cmd_step0'], pool='default_pool', ) # GPU 작업 체인 (GPU Pool) step1_clip = BashOperator(task_id='step1_clip', pool='gpu_pool', ...) step2_vlm = BashOperator(task_id='step2_vlm', pool='gpu_pool', ...) step3_summary = BashOperator(task_id='step3_summary', pool='gpu_pool', ...) step4_embed = BashOperator(task_id='step4_embed', pool='gpu_pool', ...) # 의존성 체인 wait_for_json >> step0_download >> step1_clip >> step2_vlm >> step3_summary >> step4_embed ``` 각 동네는 독립적인 Task Group으로 처리. `prepare_params()`에서 동네 이름을 받아 각 스크립트의 `--dong-name` 인자로 전달. 이미지 다운로드는 네트워크 I/O 위주라 `default_pool`을, GPU 작업들은 `gpu_pool`을 사용. ### 전체 DAG 의존성 ```python # 실행 흐름 target_dongs = get_target_dongs() processed_groups = process_neighborhood.expand(dong_name=target_dongs) # 크롤링과 병렬로 진행, 모든 처리 완료 후 DB 적재 crawl_full >> seed_db processed_groups >> seed_db ``` `crawl_full`(크롤링)과 `processed_groups`(동네별 처리)가 모두 완료되면 `seed_db`(DB 적재)가 실행됨. 크롤링은 백그라운드에서 계속 진행되고, 각 동네는 FileSensor로 JSON 파일이 생성되면 바로 처리를 시작. ![image](/assets/images/2026-02-04-01-03-03.png) --- ## 실행 결과 및 성능 개선 ### 이전 vs 이후 비교 | 항목 | 이전 (단계별 순차) | 이후 (Airflow) | | --- | --- | --- | | **실행 방식** | 수동 스크립트 실행 | 자동 스케줄링 | | **처리 단위** | 단계별 전체 동네 | 동네별 독립 파이프라인 | | **크롤링 대기** | 전체 완료 후 다음 단계 | Streaming (즉시 시작) | | **유휴 시간** | 느린 동네 대기 (블로킹) | 각 동네 독립 진행 | | **GPU 관리** | 수동 | Pool로 자동 제한 | | **실패 복구** | 해당 단계 전체 재실행 | 실패 Task만 재시도 | | **모니터링** | 로그 수동 확인 | Airflow UI | ### 성능 개선 효과 기존에는 Step1이 “모든 동네에서 완료”되어야 Step2가 시작되었지만, 이제는 “동네1의 Step1”이 끝나면 바로 “동네1의 Step2”가 시작됨. 빠르게 완료된 동네가 느린 동네를 기다리지 않음으로써 가장 큰 병목이었던 크롤링과정에서의 병목을 해결. --- ## 완료된 기능 - [x] Apache Airflow DAG로 파이프라인 자동화 - [x] Dynamic Task Mapping으로 동네별 병렬 처리 - [x] FileSensor로 Streaming 파이프라인 구현 - [x] GPU Pool로 리소스 관리 (OOM 방지) - [x] 월간/주간 스케줄링 자동 실행 - [x] 실패 Task 자동 재시도 (retries=2) - [x] Task 성공/실패 콜백 로깅 --- ### [이미지기반 카페추천 프로젝트]네이버지도에서 서울시 카페 전부 크롤링 - Canonical URL: https://hyejunl33.github.io/projects/2026-01-30-Crawler_Documentation/ - Collection: Project - Published: 2026-01-30 - Tags: 이미지기반 카페추천 프로젝트, Crawling # 네이버 지도 서울 카페 분산 크롤러 구현 ## 목차 1. [도입 배경 및 문제 정의](#1-도입-배경-및-문제-정의) 2. [아키텍처 및 핵심 로직](#2-아키텍처-및-핵심-로직) 3. [데이터 추출 전략](#3-데이터-추출-전략) 4. [안정성 및 리소스 관리](#4-안정성-및-리소스-관리) 5. [데이터 스키마 및 저장](#5-데이터-스키마-및-저장) --- ## 도입 배경 및 문제 정의 ### 크롤링 목표 서울시 전역 **424개 행정동**에 위치한 카페 데이터를 정밀하게 수집하여 이미지 기반 카페추천 서비스의 기반 데이터를 구축함. 단순한 장소명 수집을 넘어, 메뉴 이미지, 리뷰, 영업시간, 편의시설 정보 등 상세 메타데이터 확보가 필수적임. ### Playwright 도입 배경 (vs Selenium) 기존 Selenium 방식은 React 기반의 동적 페이지(네이버 지도)를 처리하는 데 구조적 한계가 있어, 최신 자동화 도구인 **Playwright**를 도입함. ### 1. Auto-waiting - **문제**: 네이버 지도는 수시로 DOM을 다시 그리기 때문에, Selenium은 요소를 찾은 직후 ‘요소가 사라짐(Stale Element)’ 에러를 빈번하게 발생시킴. - **해결**: Playwright는 클릭 직전까지 요소가 화면에 고정되고 클릭 가능한 상태인지 **자동으로 대기(Auto-waiting)**함. 이로 인해 `explicit_wait` 남발 없이도 안정적인 클릭이 가능함. ### 2. 효율적인 Iframe 제어 (Frame Locator) - **문제**: 검색 결과(`searchIframe`)와 상세 정보(`entryIframe`)가 서로 다른 iframe에 존재하여, Selenium은 `switch_to.frame`으로 컨텍스트를 계속 오가야 함. - **해결**: Playwright의 **Frame Locator** API를 사용하여 프레임 간 전환 비용 없이 DOM 요소에 즉시 접근함. - *Code*: `self.page.frame_locator("#entryIframe").locator(...)` ### 3. 데이터 추출 빠름 - **문제**: Selenium의 `execute_script`는 대용량 데이터 전송 시 직렬화 병목이 발생함. - **해결**: Playwright는 브라우저 엔진(V8)과 직접 통신하는 `evaluate()` 메서드를 제공함. 이를 통해 수 MB 크기의 `__APOLLO_STATE__` 객체를 지연 없이 즉시 Python 객체로 변환함. ### 기술적 도전 과제 및 해결 방안 | 기술적 문제 (Problem) | 상세 내용 | 해결 방안 (Solution) | | --- | --- | --- | | **대규모 데이터 처리** | 단일 프로세스로 수만 개 페이지 방문 시 실행 시간 과다 소요 | **Multiprocessing**: 동(Dong) 단위로 프로세스를 분할하여 병렬 처리함 | | **메모리 누수 (OOM)** | Chromium 로직 특성상 장시간 실행 시 메모리 사용량 지속 증가 | **3-Tier Protection**: 프로세스(재생성), 브라우저(재시작), 카페(타임아웃) 단위로 다중 리소스 관리함 | | **동적 렌더링** | React 기반 SPA로 DOM 구조가 수시로 변경되고 렌더링 시점 불규칙 | **Hybrid Extraction**: `window.__APOLLO_STATE__` 직접 파싱과 DOM 탐색을 병행함 | | **IP 차단 및 탐지** | 반복적인 자동화 접근 시 CAPTCHA 발생 또는 IP 차단으로 수집 중단 | **Stealth & Auto-Recovery**: User-Agent 위장, 랜덤 딜레이, 3회 실패 시 브라우저 교체함 | --- ## 아키텍처 및 핵심 로직 ### Manager-Worker 패턴 구조 전체 시스템은 작업을 할당하는 **Manager**와 실제 수집을 수행하는 **Worker**로 구성됨. ``` [CrawlerManager] | +--- 파트 파일 로드 (dongs_part_1.json) | +--- Multiprocessing Pool 생성 (num_workers=3) | +--- [Worker Process 1] ──(spawn)──> [Chromium] : "역삼동 카페" 수집 | (작업 완료 후 프로세스 소멸 및 메모리 반환) | +--- [Worker Process 2] ──(spawn)──> [Chromium] : "논현동 카페" 수집 | (작업 완료 후 프로세스 소멸 및 메모리 반환) ``` ### 병렬 처리 구현 (`crawler/manager.py`) ```python def run_parallel(self, part_id, num_workers=3): # ... # maxtasksperchild=1: 각 작업(동 하나)이 끝날 때마다 프로세스를 새로 띄워 # 브라우저 메모리 누적 문제를 원천 차단함. try: with Pool(processes=num_workers, maxtasksperchild=1) as pool: pool.map(_worker_wrapper, tasks) except KeyboardInterrupt: pool.terminate() ``` Python `multiprocessing.Pool`의 `maxtasksperchild=1` 옵션을 사용하여, 하나의 동 작업이 끝나면 해당 프로세스를 완전히 종료하고 새로 생성함. 이는 Chromium이 점유했던 메모리를 OS 수준에서 강제로 회수함으로써 메모리 문제 해결. --- ## 데이터 추출 전략 ### 1. Apollo State 파싱 네이버 지도는 React 앱의 초기 상태를 `window.__APOLLO_STATE__` 변수에 저장함. 이를 직접 파싱 하여 DOM 렌더링을 기다릴 필요 없이 순수한 JSON 데이터를 추출함. **코드 구현 (`crawler/scraper.py`)**: ```python def _get_apollo_state(self): """페이지 소스에 포함된 Apollo State(JSON) 추출""" states_to_check = ["__APOLLO_STATE__", "__PLACE_STATE__", "__INITIAL_STATE__"] for state_name in states_to_check: try: # 브라우저 컨텍스트에서 JS 변수 추출 state_json = frame.evaluate(f"() => window.{state_name} ? JSON.stringify(window.{state_name}) : null") if state_json: data = json.loads(state_json) merged_state.update(data) except: pass return merged_state ``` 화면에 표시되는 텍스트를 긁어오는 방식(Scraping) 대신, 데이터 소스 자체를 추출(Extraction)하므로 DOM 클래스 변경에 영향을 받지 않으며 속도가 매우 빠름. ### 2. DOM Fallback (Secondary Strategy) Apollo State에 없는 최신 정보나 동적으로 로딩되는 데이터(리뷰, 상세 영업시간)는 DOM 탐색으로 보완함. ```python # 이름 추출 실패 시 DOM 선택자로 재시도 if meta["name"] == "Unknown": name_selectors = [ "span.GHAhO", "span.Fc1rA", "span.YwYLL", ".place_name", "._name", "h2.place_name" ] for selector in name_selectors: name_el = frame.locator(selector).first if name_el.is_visible(): meta["name"] = name_el.inner_text().strip() break ``` > **설명**: 네이버 지도의 잦은 클래스명 변경에 대응하기 위해 다양한 CSS 선택자 리스트(`name_selectors`)를 순차적으로 시도하는 Fallback 로직을 구현함. > ### 3. 레이지 로딩(Lazy Loading) 극복 메뉴 사진이나 리뷰는 스크롤 시점에 로딩되므로, JS를 활용한 공격적인 스크롤링을 수행함. ```python # 메뉴 사진 로딩을 위한 강제 스크롤 for _ in range(3): frame.locator("body").evaluate("window.scrollBy(0, 500)") time.sleep(0.3) # 아이템별 스크롤 이동 for item in items: item.scroll_into_view_if_needed() ``` ### 4. 시각 정보 우선순위 (Visual Priority) 카페 추천 서비스 특성상 음식 사진보다 **매장 분위기(Vibe)**가 더 중요한 판단 기준임. 무작위로 사진을 수집하는 대신 ‘내부’ 탭을 우선적으로 탐색함. ```python # 사진 탭 이동 후 '내부' 카테고리 우선 클릭 (crawler/scraper.py) if category: try: cat_btn = frame.locator("a, span").filter(has_text=re.compile(f"^{category}$")).first if cat_btn.is_visible(): cat_btn.click() time.sleep(1) except: pass ``` 사진 탭에 진입하면 기본적으로 전체 사진이 보이지만, 코드에서 명시적으로 **‘내부’** 탭을 찾아 클릭함. 이를 통해 매장 인테리어와 분위기를 파악할 수 있는 이미지를 최우선으로 확보함. --- ## 안정성 및 리소스 관리 장시간 크롤링 시 발생할 수 있는 모든 불안정 요소를 방어함. ### 1. 프로세스 라이프사이클 관리 - 앞서 언급한 `maxtasksperchild=1` 설정을 통해 동 단위 작업 완료 시 프로세스를 초기화함. ### 2. 브라우저 정기 재시작 (`crawler/worker.py`) 동일 프로세스 내에서도 브라우저 인스턴스가 오래 유지되면 느려질 수 있으므로 일정 개수마다 재시작함. ```python BROWSER_RESTART_INTERVAL = 10 # 10개 카페마다 브라우저 재시작 if cafes_since_restart >= BROWSER_RESTART_INTERVAL: print(f"[Worker-{self.dong}] 브라우저 재시작 (메모리 관리)...") self.scraper.stop() time.sleep(2) self.scraper = NaverMapScraper(headless=True) self.scraper.start() cafes_since_restart = 0 ``` 10개의 카페를 수집할 때마다 브라우저를 닫고 새로 엶. 이는 브라우저 내부 캐시와 메모리 파편화를 정리하여 일정한 수집 속도를 유지하게 해줌. ### 3. 타임아웃 핸들링 특정 페이지에서 무한 로딩이 발생할경우, 전체 프로세스가 멈추지 않도록 제한 시간을 둠. ```python @contextmanager def timeout_handler(seconds, cafe_name=""): def _timeout_handler(signum, frame): raise CafeTimeoutError(f"'{cafe_name}' 처리 시간 초과 ({seconds}초)") signal.signal(signal.SIGALRM, _timeout_handler) signal.alarm(seconds) try: yield finally: signal.alarm(0) ``` 크롤링 로직이 3분(180초)을 초과하면 강제로 예외를 발생시키고 다음 카페로 넘어감. --- ## 데이터 스키마 및 저장 수집된 데이터는 엄격한 필드 순서를 가진 JSON으로 저장됨. | 필드명 | 타입 | 설명 | | --- | --- | --- | | `name` | String | 카페 이름 (정규화됨) | | `address` | String | 도로명 주소 | | `description` | String | 업체 소개글 | | `business_hours` | String | 영업시간 (HH:MM - HH:MM 포맷) | | `contact` | String | 전화번호 | | `instagram` | String | 인스타그램 URL | | `amenities` | List | 편의시설 태그 (주차, 와이파이 등) | | `structured_data` | Dict | 주차 여부, 세부 편의시설 구조화 데이터 | | `menus` | List | 메뉴 이름, 가격, 사진 URL, 설명 | | `photos` | List | 매장 내부/외부 사진 URL 리스트 | | `reviews` | List | 방문자 영수증 리뷰 텍스트 리스트 | | `dong_group` | String | 수집 대상 행정동 이름 | **저장 파일 예시**: `data/crawled/seoul/results_part_1_역삼동.json` --- ## 완료된 기능 - [x] **하이브리드 데이터 추출**: Apollo State 파싱과 DOM 탐색 결합으로 데이터 완전성 확보함 - [x] **멀티프로세싱 병렬 처리**: 동 단위 프로세스 분할 및 `maxtasksperchild=1` 적용함 - [x] **안정적 메모리 관리**: 10개 카페 단위 브라우저 재시작 로직 구현함 - [x] **예외 처리 및 자동 복구**: 타임아웃(180초) 및 연속 실패 시 자동 재시작함 - [x] **동적 컨텐츠 수집**: 메뉴 사진, 방문자 리뷰 더보기 자동 클릭 및 스크롤링함 - [x] **광고 필터링**: 검색 결과 상단의 광고(‘광고’ 뱃지) 자동 식별 및 스킵함 ### [이미지기반 카페추천 프로젝트] CLIP으로 이미지 전처리 - Canonical URL: https://hyejunl33.github.io/projects/2026-01-30-Preprocessing-with-CLIP/ - Collection: Project - Published: 2026-01-30 - Tags: 이미지기반 카페추천 프로젝트, CLIP으로 이미지 전처리 # CLIP으로 이미지 전처리 ## 문제정의 크롤링된 가게 이미지에 노이즈가 너무 많다. 서비스 특성상 가게의 분위기를 나타내는 사진이 DB에 있어야 하고, DB에 있는 사진과 인풋으로 들어온 사진의 임베딩을 코사인유사도를 이용해서 비교한다. 그런데 가게 이미지 50장을 크롤링해온 결과에서 대표사진 5장을 뽑을때, 노이즈를 제거하고, 해당 가게의 ‘분위기’를 나타내는 사진만 선정해야한다. 따라서 ‘분위기’를 어떤메트릭으로 정의하고, 선정할것인지가 문제였다. ### 오늘의집 케이스스터디 [오늘의집에서도 비슷한 문제가 있었다.](https://www.bucketplace.com/post/2023-05-22-%EC%9C%A0%EC%82%AC-%EC%9D%B4%EB%AF%B8%EC%A7%80-%EC%B6%94%EC%B2%9C-%EA%B0%9C%EB%B0%9C-1-%EB%B9%84%EC%8A%B7%ED%95%9C-%EA%B3%B5%EA%B0%84/) 오늘의집에서도 주어진 인테리어와 유사한 다른 이미지 검색을 위해서 VGG16모델을 학습시키는 모델을 개발했는데, Finetuning시키는 데이터셋을 직접 tagging하는 방법을 사용했다. 우리의 case에서 clip을 이용해서 ‘분위기’를 나타내는 대표사진 5장만 걸리낼 수 있는 메트릭 설정만 잘한다면, finetuning없이 프롬프트만으로 걸러낼 수 있을거라고 생각했다. ## 이미지 전처리 기존방식 팀원이 CLIP을 이용해서 대표 이미지 5장만 뽑는 로직을 만들어서 파이프라인안에 잘 통합되어있었다. 그런데, 어느정도 프로젝트를 완성시키고 MVP결과를 확인해보니, 검색결과에 너무 ‘분위기’와는 관련없는 결과가 많이 등장함을 확인했다. 따라서 기존에 대표이미지 5장을 선정하는 로직을 개선해서, 최대한 ‘분위기’를 나타내는 사진만 대표이미지로 선택하는 목표를 설정하고 이를 해결해나갔다. ![image](/assets/images/2026-02-04-01-05-34.png) ### 기존방식 - 인테리어 vs 음식점수를 프롬프트에 대한 softmax 확률값을 점수로 매김 - 점수가 가장 높은 5개가 대표이미지로 선정됨. - 후보군선정 - `interior_score` > `food_score` - 예외. 모두 인테리어점수가 음식점수보다 낮다면  `interior_score`가 높은 순서 - ****대표성 점수 계산 1. 중심벡터 만들기: 선정된 후보군 이미지들의 임베딩 벡터를 모두 평균내어 하나의 '중심 벡터만들기 2. 유사도 계산: 각 후보 이미지의 중심벡터에 대한 Cosine Similarity를 계산 - **최종 점수 산출** - Final Score=(0.6×Interior Score)+(0.4×Similarity to Centroid) **Top-K를 뽑는 근거** - 0.6을 Weight로 줘서 인테리어 점수와 가까운가? 판단 - 0.4를 Weight로 줘서 Top5 이미지의 평균과 얼마나 가까운가 판단 ## **기존 방식의 맹점** 1. Food 점수와 인테리어 점수가 일관되지 않다. 즉 같은 사진이더라도 점수가 다른경우가 존재하고, Food점수는 실제 음식임을 대변하는 점수가 되지 않는다.(소금빵 확대샷이 카페이미지보다 food점수가 낮음) - 맹점 1에대한 생각 Softmax에다가 인테리어점수랑 음식점수를 넣는데, 그 과정에서 결과물의 점수가 일관되지 않은것같음 → 절대적인 비교에 Softmax가 필요한가? → softmax말고, 분위기 점수를 일관되게 뽑고,분위기 점수에 thr을 정해서 분위기가 아닌 사진은 걸러내는 알고리즘 → 분위기점수가 thr이 넘는 사진이 5개가 안되는경우 해당 카페는 아예 json에서 제외 → Thr을 주피터노트북에서 바꿔가면서 실험해봐야함 2. 평균과 유사한 이미지를 0.4만큼 반영하는데, 이 로직때문에 비슷한 사진만 5장 뽑힌다 → 분위기를 반영하더라도 클러스터링 되어있지 않은 사진이면 뽑히지 않는다. - 맹점 2에 대한 생각 평균과 유사한 이미지를 고르는 로직을 뺴는건 어떤가? → 중심벡터를 구해서 비슷한 이미지를 가중치주는 로직은 삭제해야됨 ## **해결안** ‘분위기’를 점수로 어떻게 나타낼것인가? 에대한 해답을 프롬프트에서 찾았다. 대표이미지로 선택하고자 하는 이미지들의 특징을 positive의 프롬프트로 넣어주었고, 걸러내야할 노이즈 이미지들의 특징을 Negative 프롬프트로 넣어주었다. 이미지마다 Positive와 Negative점수를 내서 그 차(delta score)를 최종 점수로 삼았다. ### Metric 개선 $Metric = Interior Score - Noise Score$ $Interior Score$와 $Noise Score$는 CLIP으로 프롬프트와 이미지의 코사인 유사도를 구해서 구함 **메트릭 설정 과정** - 크롤링된 사진의 특징을 보고 눈으로 걸러내야할 사진과 포함해야할 분위기 사진의 특징을 파악한다 → 프롬프트로 사용한다. - 걸러야 할 사진은 Negative(`Noise Score`)에, 포함해야할 사진은 Positive(`Interior Score` )에 프롬프트로 포함시킨다. - 프롬프트와의 Cosine 유사도를 구한 후 `Interior Score - Noise Score`를 메트릭으로 사용한다 - 분포를 확인하고, 잘 걸러지는지 확인한다. ```python PROMPTS = { "positive": [ "an interior photo of a cafe", "cozy cafe atmosphere", "indoor lighting and furniture", "wide angle shot of a room", # "architectural design of a building exterior", #건물 외관 "interior design details and decorations", #소픔이나 내부디자인 "outdoor terrace seating area of a coffee shop" #야외 테라스 ], "negative": [ "close-up photo of food", "dessert or cake", # 디저트 얼빡샷 "a photo of a menu board, price list or signage", "text document or receipt", "a selfie of a person", "beverage in a plastic cup"#컵사진 "a close-up photo of a beverage cup or hand holding a drink", #사람이 들고있는 컵사진 "a graphic logo, illustrative icon, or screenshot" #카페 로고 ]} ``` ### 결과1 한개 카페에 대한 분포 ![image](/assets/images/2026-02-04-01-05-51.png) 인테리어 스코어와 노이즈 스코어의 분포(좌), 두개의 차인 Delta Score의 분포(우) ![image](/assets/images/2026-02-04-01-05-59.png) Top 10 Selected Images (Highest delta_score): ![image](/assets/images/2026-02-04-01-06-08.png) Worst 5 Images(Lowest delta_score) 델타 스코어의 분포를 보면 느좋카페와 안 느좋카페를 구분할 수 있다. 느좋카페는 thr이 0보다 큰 사진이 많은 반면, 안 느좋 카페는 thr이 0보다 작은 사진이 더 많다. 위의 오른쪽 분포를 보면 score가 0보다 큰 사진이 많으므로 느좋사진이 많다고 볼 수 있다. ### 느좋카페 예시1 ![image](/assets/images/2026-02-04-01-06-19.png) ![image](/assets/images/2026-02-04-01-06-25.png) Top 10 Selected Images (Highest delta_score): ![image](/assets/images/2026-02-04-01-06-31.png) Bottom 5 Images (Likely Noise/Food) ### 느좋카페 예시 2 ![image](/assets/images/2026-02-04-01-06-37.png) Delta Score를 보면 0보다 큰 사진이 많으므로 느낌좋은 사진이 많음을 확인할 수 있다. ![image](/assets/images/2026-02-04-01-06-45.png) Top 10 Selected Images (Highest delta_score): ![image](/assets/images/2026-02-04-01-06-50.png) Bottom 5 Images (Likely Noise/Food): ### 느 안좋 카페 예시 ![image](/assets/images/2026-02-04-01-07-02.png) 분포를 보면 Noise Score(빨간색)이 오른쪽에 치우쳐져 있고, Delta Score는 0을 넘는 사진이 거의 없음을 확인할 수 있다. ![image](/assets/images/2026-02-04-01-07-08.png) Top 10 Selected Images (Highest delta_score): ![image](/assets/images/2026-02-04-01-07-14.png) Bottom 5 Images (Likely Noise/Food): ## Threshold정하기 Thr을 정하려면 N이 충분히 큰 사진에 대해서 분포를 살펴보고, Score의 어느 경계에서 분위기를 나타내는 사진이 갈리는지 확인하면 된다. 랜덤으로 동3개를 샘플링하고 이에 대해서 (카페 45개)모든 이미지의 분포를 살펴보고 thr을 정한다. **구로2동, 가산동, 독산3동** ![image](/assets/images/2026-02-04-01-07-22.png) 대략 thr이 0에서 0.01사이 지점에서 가우시안 분포가 나뉘게 된다. 오른쪽 그래프를 보면 빨간색(positive)와 파란색(negative)점수를 갖는 사진 샘플들이 클러스터링을 하며 잘 뭉쳐져있음을 확인할 수 있다. ![image](/assets/images/2026-02-04-01-07-31.png) ![image](/assets/images/2026-02-04-01-07-36.png) ![image](/assets/images/2026-02-04-01-07-41.png) ![image](/assets/images/2026-02-04-01-07-46.png) ![image](/assets/images/2026-02-04-01-07-50.png) thr을 0.01로 최종적으로 정함 ![image](/assets/images/2026-02-04-01-07-56.png) 이 과정 이후 thr을 넘은 사진이 5개가 안되는 카페 907개는 걸러졌음. 결론적으로 걸러내고자 했던 이미지들의 특징을 Negative 프롬프트로 넣어서, Metric에 반영을 한 결과, 노이즈이미지를 걸러낼 수 있었고, ‘분위기’를 나타내는 사진만 대표이미지로 선택할 수 있었다. ### [이미지기반 카페추천 프로젝트]서울시 카페 리뷰 데이터 정제 및 요약 - Canonical URL: https://hyejunl33.github.io/projects/2026-01-30-Review_Summarization/ - Collection: Project - Published: 2026-01-30 - Tags: 이미지기반 카페추천 프로젝트, 리뷰 데이터 정제 및 요약 # 리뷰 데이터 정제 및 요약 ## 목차 1. [도입 배경 및 문제 정의](#도입-배경-및-문제-정의) 2. [아키텍처 및 핵심 로직](#아키텍처-및-핵심-로직) 3. [데이터 전처리 전략 (Preprocessing)](#데이터-전처리-전략-preprocessing) 4. [프롬프트 엔지니어링 (Gemma3)](#프롬프트-엔지니어링-gemma3) 5. [최적화 및 성능 관리 (Batch Processing)](#최적화-및-성능-관리-batch-processing) 6. [데이터 스키마 및 저장](#데이터-스키마-및-저장) --- ## 도입 배경 및 문제 정의 ### 프로젝트 목표 크롤링된 **Raw 리뷰 데이터**는 노이즈가 많고 비정형적이라 검색이나 추천 시스템에 바로 활용하기 어려움. 이를 Google의 **Gemma-3-4B-IT** 모델을 사용하여 정제하고, 장소의 특징을 나타내는 **핵심 태그**와 **요약문**을 생성하여 서비스 품질을 높임. ### 모델 선정 근거 (Gemma3 Performance Benchmark) 다양한 모델 크기와 포맷을 비교 실험하여 최적의 모델을 선정함. | 모델 | 실행 시간 (리뷰 50개) | 요약 품질 | 비고 | | --- | --- | --- | --- | | **Gemma3-4B-IT** | 약 10초 (GPU/API) | **완벽함** | **최종 선정** (4bit 양자화 활용) | | Gemma3-1B-IT | 약 7초 (GPU/API) | 문맥이 약간 어색함 | 속도는 빠르나 표현력이 부족하여 제외함 | | Gemma3-4B-GGUF | 약 10분 (CPU) | 좋음 | 4코어 CPU/8GB RAM에서도 동작하나, 대량 처리에 부적합함 | 1B 모델은 문맥 파악 능력이 부족하고, 4B-GGUF(CPU)는 처리 속도가 너무 느림. 따라서 GPU 가속과 4bit 양자화를 적용한 **Gemma3-4B-IT** 모델이 성능과 속도의 균형 면에서 가장 적합하다고 판단함. ### 기술적 도전 과제 및 해결 방안 | 기술적 문제 (Problem) | 상세 내용 | 해결 방안 (Solution) | | --- | --- | --- | | **데이터 노이즈** | 이모지 남발, 무의미한 특수문자, 비한국어 리뷰 등으로 분석 비용 증가 및 정확도 저하 | **Token Optimization**: 정규식 정제로 불필요한 이모지 및 특수문자를 제거하여 입력 토큰을 약 30% 감소시키고 할루시네이션 방지함 | | **비정형 데이터** | 리뷰 내용이 제각각이라 일관된 검색 메타데이터 추출이 어려움 | **Structured Prompting**: 검색을 위한 태그(#)와 전시를 위한 요약문을 분리 생성함 | | **GPU 리소스 유휴** | V100 GPU (32GB VRAM) 사용 시, 단일 건 처리로는 메모리가 남아돌아 자원 낭비 발생 | **Batch Inference**: 단위 배치 처리로 VRAM을 최대한 활용함. | --- ## 아키텍처 및 핵심 로직 ### 파이프라인 구조 Step 2(VLM 묘사) 완료 데이터를 입력으로 받아, 리뷰 요약 및 태그 생성을 수행한 후 Step 3 데이터를 출력함. ``` [Input: Step2 JSON] (VLM 묘사가 포함된 카페 데이터) ↓ [Preprocessing] (이모지 제거, 길이 필터링, 한글 비율 체크) ↓ [LLM Processing (Gemma3)] (Batch Size: 8) ├── [Task 1] Tag Generation (#태그 #생성) └── [Task 2] Summary Generation (한 줄 요약 + 상세 설명) ↓ [Output: Step3 JSON] (summary_for_embedding, summary_for_display 추가) ``` ### 전처리 구현 (`clean_review`) ```python def clean_review(text, min_len=5, max_len=200): # 이모지 패턴을 [EMOJI] 플레이스홀더로 치환했다가 제거 (텍스트 깨짐 방지) emojis = EMOJI_PATTERN.findall(text) text = EMOJI_PATTERN.sub(' [EMOJI] ', text) # 한글, 영문, 숫자, 기본 부호 외 제거 text = re.sub(r'[^가-힣a-zA-Z0-9\s,.!?~()\-]', ' ', text) # 한글 비율 체크 (50% 미만인 리뷰는 스킵 - 영문/일문 리뷰 등 제외) if total_chars > 0 and korean_chars / total_chars < 0.5: return "" # ... ``` 단순한 특수문자 제거를 넘어, 리뷰의 유용성을 판단하기 위해 ‘최소 길이’와 ’한글 비율’ 조건을 적용함. 퀄리티가 낮은 리뷰는 모델 입력 단계에서 미리 차단하여 토큰 비용과 시간을 아낌. --- ## 데이터 전처리 전략 (Preprocessing) ### 1. 노이즈 제거 및 정규화 크롤링된 리뷰에는 “더보기” 같은 UI 텍스트나 반복적인 이모지가 섞여 있음. 이를 정규식(Regex)으로 제거하고, `~`나 `!` 같은 문자가 과도하게 반복되는 것을 표준화함. ### 2. 고품질 리뷰 선별 LLM의 입력 토큰 한도가 있으므로, 모든 리뷰를 넣는 대신 **유의미한 상위 30~50개 리뷰**만 선별함. - **길이 제한**: 5자 이상 200자 이하 (너무 짧거나 긴 리뷰 제외) - **중복 제거**: 내용이 완전히 동일한 리뷰는 `set`을 이용해 제거함. --- ## 프롬프트 엔지니어링 (Gemma3) 검색과 가게설명이라는 두 가지 목적을 달성하기 위해 두 종류의 독립된 프롬프트를 사용함. ### Task 1: 가게 태그 생성 가게 요약에 활용할 핵심 키워드 3개를 추출함. ```python # 프롬프트 예시 """다음 카페 리뷰들을 보고... 핵심 태그 3개를 생성해줘. 지시사항: 1. 반드시 #으로 시작하는 태그 형식 2. 태그는 3개만 작성 ...""" ``` ### Task 2: 가게 설명용 요약 생성 사용자에게 보여줄 매력적인 소개글을 작성함. 개인정보(실명 등)가 포함되지 않도록 주의 사항을 포함함. ```python # 프롬프트 예시 """다음 리뷰들을 바탕으로... 매력적인 소개문을 작성해주세요. 리뷰에 포함된 사용자의 개인정보는 요약에 포함하지 말아주세요. 형식: 한 줄 요약: ... 상세 설명: ...""" ``` --- ## 최적화 및 성능 관리 (Batch Processing) ### Batch Inference 구현 LLM 모델(Gemma-3-4B) 로드 오버헤드를 줄이고 연산 효율을 높이기 위해 배치 처리를 수행함. ```python def generate_batch(model, tokenizer, prompts, max_new_tokens=300, batch_size=8): # Padding과 Truncation을 적용하여 텐서 크기 맞춤 model_inputs = tokenizer( text_inputs, return_tensors="pt", padding=True, truncation=True, max_length=8192 ).to(device) # 배치 단위 생성 generated_ids = model.generate(**model_inputs, ...) ``` 한 번에 8개(설정 가능)의 프롬프트를 모델에 입력하여 결과를 동시에 받아옴. 이를 통해 1건씩 처리할 때보다 처리 속도가 약 3~4배 향상됨. ### 메모리 관리 배치 처리가 끝날 때마다 명시적으로 GPU 캐시를 비워 OOM을 방지함. ```python del model_inputs, generated_ids torch.cuda.empty_cache() gc.collect() ``` --- ## 데이터 스키마 및 저장 Step 3 파이프라인을 거치면 JSON 객체에 두 가지 핵심 필드가 추가되어 저장됨. | 필드명 | 타입 | 설명 | 출처/생성 | | --- | --- | --- | --- | | `summary_for_embedding` | List[str] | 검색 태그 리스트 (예: `['#조용한', '#커피맛집', '#주차가능']`) | Task 1 결과 | | `summary_for_display` | String | 전시용 요약 텍스트 (한 줄 요약 + 상세 설명) | Task 2 결과 | | `original_data` | Dict | 이전 단계(Step 2)의 원본 데이터 (유지) | Input | **저장 파일 예시**: `data/processed/json/step3_summarized/강남구_역삼동_step3.json` --- ### [이미지기반 카페추천 프로젝트] SigLip으로 텍스트 임베딩 - Canonical URL: https://hyejunl33.github.io/projects/2026-01-30-SigLip/ - Collection: Project - Published: 2026-01-30 - Tags: 이미지기반 카페추천 프로젝트, SigLip으로 텍스트 임베딩 # SigLip으로 텍스트 임베딩 ## 문제 - SigLip은 64토큰만 임베딩할 수 있음 -> Captioning과 HyDE를 뽑아낼때 최대한 간결하게 뽑아내야됨 -> 따라서 기존의 캡셔닝과 HyDE의 프롬프트를 바꿔서 50자 미만의 단어위주로 출력하도록 바꾸기 - 50자도 토큰이 130토큰 이상이므로 슬라이딩 윈도우 방식으로 `services/loadmodel.py`파일 변경 -> 기존에는 64토큰만 임베딩해서, 사실상 HyDE가 의미가 없는 수준이었음. ## 배경 아파치 라이센스에, 한국어를 잘 이해하는 모델인 siglip을 임베딩 모델로 선정했었는데, mvp를 뽑고나서 치명적인 문제가 발생했다. siglip은 64토큰으로 pretrain된 모델이라, 인풋을 64토큰으로만 사용할 수 있다는것을 모두 놓쳤다는것이다. 이 상황에서 기존의 임베딩으로 들어가던 텍스트는 64토큰으로 truncation되어 들어가고있음을 확인하고, 문제해결에 착수했다. - 해결안 1. 모델을 교체한다. - 해결안 2. 다른방법을 모색한다.. 모델을 교체하기에는 코드로 구현까지 모두 끝난상황이었기 때문에, 모델을 교체하기에는 부담이 컸다. 따라서, 64토큰이라는 한계에 맞추어서 HyDE를 생성할때, 기존에 문장형식으로 길게 출력되던것을, 명사구 형식으로 간결하게 50자 이내로 출력하도록 바꾸었다. 50자로 바꾸어도 130토큰정도이므로, 다른방법이 추가로 필요했다. 따라서 인풋을 그대로 임베딩해서 넣는것이 아니라, stride를 32씩 갖고, 64토큰씩 임베딩을하고, 평균을 내는 sliding Window방식을 사용하기로 결정했다. ## 해결방안 - HyDE에서 간결하게 분위기 정보 뽑아내도록 프롬프트 수정하기 ```python config={ "system_instruction": ( """이 이미지를 보고 아래 지시에 따라 세부적으로 묘사해줘: 너는 카페 인테리어 및 공간 디자인 전문가야. 카페의 '공간 분위기'를 묘사해야 해.\n\n [작성 가이드] 1. 문장 형식이 아닌, 콤마(,)로 구분된 '명사구' 나열식으로 작성할 것. 2. 구체적인 사물 자체가 아니라 감성적인 분위기를 묘사할 것. 3. '카페', '인테리어'처럼 당연한 단어는 생략하고 구체적인 분위기로 묘사할 것. 4. 공백 포함 한국어 50자 이내로 작성할 것. 아래 예시출력을 참고해서 출력해 예시출력: 창가자리, 자연광, 바다전망, 대형 유리창, 소박한 인테리어, 편안한 의자, 야외 테라스, 감성조명, 일몰뷰 """ ) ``` 50자 이내로 간결하게 HyDE를 생성하도록 수정했다. 이전에는 문장형식으로 길게 생성했지만, 간결하게 분위기만 나타내도록 문장구형식으로 생성하도록 프롬프트를 수정했다. - `service/loadmodel.py`를 슬라이딩 윈도우 방식으로 벡터를 64토큰씩 구하고 stride를 32로 줘서 나온 HyDE의 벡터를 평균내서 임베딩 구하도록 코드구현 ![image](/assets/images/2026-02-04-00-57-57.png) 결과: 프롬프트 최적화 + 슬라이딩 윈도우 조합으로, **긴 텍스트도 전체 맥락이 검색에 반영됨** ### 프로젝트아이디어 - 에듀테크 - Canonical URL: https://hyejunl33.github.io/projects/2025-11-21-ProjectIdea-edutech/ - Collection: Project - Published: 2025-11-21 - Tags: Final_Project, Edutech, idea ## LMS(Learning Management System) **With AI** 교육청, 학교, 교사를 대상으로 하는 학급 관리 프로그램. 교사는 **OCR**된 학생의 포트폴리오를 이용해서 개인맞춤형 피드백을 제공할 수 있음. ## 0. 교육현장에서 AI 도구의 메리트 - 업무자동화 - 많은량의 데이터를 한꺼번에 처리할 수 있음. - 개인 맞춤형 교육 - 다문화 학생에게도 맞춤형 교육을 제공 - 느린학습자 지원 - 과정 중심 평가의 보조도구 → 결과중심평가에서 벗어날 수 있음 - 2022 개정교육과정에도 부합함. - 비대면 수업보조도구 - 메타버스..? 실제로 코로나시기에 로블록스를 교실로 사용한 사례가 있음 ## 1. 사례분석 ### **1.1 구글 클래스룸** ![image](/assets/images/2025-11-21-20-05-18.png) **장점** - 아날로그 데이터 아카이빙 - 과제 제출여부, 제출시간등을 정량화해서 즉각적인 **정량평가 가능** **단점** - 데이터들을 엮어서 학생별 정성적 평가 불가능 - 과제는 단순한 사진 혹은 텍스트파일로 남음 → 정성적 평가 어려움 ### 1.2 **다했니? 다했어요** [https://edzip.kr/product-detail/682ed25b42cd392c8ffe1c8e](https://edzip.kr/product-detail/682ed25b42cd392c8ffe1c8e) **장점** - 구글 클래스룸과 마찬가지로, 과제평가, 과제 제출여부, 평가를 할 수 있음. - 학생별로 포트폴리오를 아카이빙 할 수 있고 학부모와 공유하여 가정연계를 쉽게 할 수 있음. - 강화를 통한 학생 동기부여 - ‘쿠키’라는 강화방안을 통해서 학생들에게 동기를 부여함 - 개선: 반별로 리더보드를 만들어서 더 동기를 부여할 수도 있을듯. **단점** - 과제 제출여부만 따지고 과제의 질적평가는 여전히 교사가 해야함. - 비정형적인 데이터를 분석해서 자동화된 피드백을 제공할 수 없음 - 일기, 독후감, 수학익힘책풀이등을 OCR한 후 채점보조를 해서 개선할 수 있음. ## 2. 문제의식 기존의 사례들에서는 학생들의 데이터를 아카이빙하는데에만 집중하고, **과제의 질적평가**는 여전히 교사의 몫이었다. 정량적 평가에서 **과정중심평가**로 교육의 패러다임이 바뀌고있음을 고려할때, 멀티모달 LLM을 이용해서 **정성적 평가**를 도울 수 있다. ## 3. 해결할 문제 AI가 대세다, 디지털 교과서를 사용한다 해도 결국에 교실에서는 **종이 책을** 이용해서 수업을 진행함 → 학생의 과제물들을 저장해서 AI모델을 이용한 정성적 평가에는 **OCR**이 필수적임. ### 3.1 휘발되는 각종 수업진행내용 → 이미지 아카이빙 혹은 OCR 교실에서는 기록할게 정말 많다..! → 학생의 교실에서의 생활 현황을 기록할 수 있음. ![image](/assets/images/2025-11-21-20-06-38.png) ![image](/assets/images/2025-11-21-20-06-44.png) ![image](/assets/images/2025-11-21-20-06-54.png) ![image](/assets/images/2025-11-21-20-07-00.png) - **국어**: 글쓰기 활동 → OCR 후 학생 개인별 DB에 저장. - **수학**: 수학익힘책 풀이→OCR을 이용해서 자동채점보조 → 학생 개인별 DB에 저장. - **미술**: 만들기작품, 그림등을 아카이빙 → 정량적인 평가보단 교사의 정성적인 코멘트 → 해당 코멘트들을 모아서 학생의 개인화된 특징 파악 - **실과:** 만들기 작품(요리, 뜨게질) 사진으로 아카이빙 → 부모와 공유 및 교샤의 정성적인 코멘트 → 해당 코멘트를 모아서 학생의 개인화된 특징 파악 - **음악**: 리코더 및 단소와 같은 악기 및 가창 동영상으로 아카이빙 → 부모와 공유 및 교사의 정성적인 코멘트 아카이빙한 **학생별 포트폴리오**는 게시판형태로 **학부모**와 공유할 수 있음. ### 3.2 과제물 피드백할 시간부족 → OCR을 통한 채점 자동화 교사는 모든 학생들의 과제물(독후감, 수학익힘책등)을 읽고 채점해야한다. → 시간이 부족하다.. 독후감, 수학익힘책, 과학등의 교과에서 OCR을 통해 채점을 자동화 한다. ### 3.3 학생별로 개별화된 피드백 제공 학생별로 아카이빙된 멀티모달 자료들을 바탕으로 학부모상담 자료, 생활기록부등을 생성할 수 있음. ![image](/assets/images/2025-11-21-20-07-12.png) ## 4. 시장성 에듀테크 소프트웨어가 시장에 팔릴까? ### 4.1 교사를 타겟팅 - 학급운영비 - 교육청마다 다르지만 학급당 연간 20~50만원 수준 - 학급 환경 물품 구입비 - 학습준비물비 교사는 학급운영비로 소프트웨어를 구매할 수 있지만, 교육청별로, 학교별로 다르기 때문에 미지수임.. ### 4.2 에듀테크 실증 지원사업 ![image](/assets/images/2025-11-21-20-07-20.png) 프로젝트로 서비스개발 → 교사들에게 바이럴 → 사례를 모아서 에듀테크 실증 지원사업 공모전에 제출가능 ### 4.3 교육청을 타겟팅 교육청을 타겟팅해서 소프트웨어를 팔려면 학교장터, 조달청에 등록을 해야한다.. - 사업자등록증 필요 - CSAP인증(보안인증)을 받아야함→ 딥시크OCR은 중국모델이라 힘들듯.. ### 4.4 교과서 출판사를 타겟팅 ![image](/assets/images/2025-11-21-20-07-31.png) 비슷한 서비스를 운영하는 미래엔이나 AI디지털교과서 출판에 관심있는 출판사에 exit을 노려볼 수 있음 ## 5. 예상가능한 문제점 - 초등학생이 작성한 글이나수식에서 OCR한 결과가 만족할만한 성능이 나올까? → FInetuning, LoRA, 손글씨 인식을 잘하는 모델로 바꾸기 - 수학익힘책 채점을 자동화할때 풀이와 답안에는 정해진 양식이 없는데 어떻게 채점할것인가? 단순 OCR로 해결할 수 있는 문제인가? - B2C가 아닌 B2B로 팔아야하는데, 과연 교육청이나 교사가 이용을 할만한 메리트가 있을까? ### [영화리뷰 감성분류][모델최적화]하이퍼파라미터튜닝2 - Canonical URL: https://hyejunl33.github.io/projects/2025-11-01-[Domain_Common_Project]HyperParameterTuning2/ - Collection: Project - Published: 2025-11-01 - Tags: Domain_Common_Project, study, ModelOptimization, HyperParameterTuning # Introduction - 하이퍼파라미터 튜닝 - Focal Loss에서 알파 가중치를 얼마나 줘야할까? - 최적의 알파 가중치는 얼마일까? - 이외에 하이퍼파라미터 튜닝할 수 있는값 모두 넣기 - valid 데이터를 포함해서 전체 데이터를 기준으로 학습시켜보기 - 모델 앙상블 추론을 할때, 모델별로 Weight를 줘서 앙상블을 해보기 이전 실험까지를 대략 요약하자면 데이터셋이 불균형 데이터라고 생각해서FocalLoss의 $$\alpha$$가중치를 각 레이블의 비율의 역수를 정규화해서 가중치로 두었다. 하지만, 그렇게 가중치를 준게 오히려 test/acc성능에는 악영향을 미친것을 확인할 수 있었다. 즉 소수클래스에 가중치를 둔게 오히려 대다수의 클래스를 맞추는데 악영향을 미쳤고, 전체 test/acc성능이 하락함을 확인할 수 있었다. 그러면 최적의 알파 가중치를 찾으려면 어떻게해야할까? 바로 하이퍼파라미터 튜닝이다. 따라서 이번 실험에서는 최적의 FocalLoss의 $$\alpha$$가중치를 찾으면서, 그외에도 이전에 구현한 SWA에서 평균낼 체크포인트의 개수, FocalLoss의 $$\gamma$$등 다른 하이퍼파라미터도 함께 튜닝을 해서 모델의 최적 성능을 뽑아볼 예정이다. FocalLoss의 $$\alpha$$는 클래스 개수만큼의 리스트원소를 튜닝할 수 없으므로 일반적으로 아래 식을 이용해서 하나의 $$\beta$$만 튜닝한다고 한다. $$W_{final} = (1-\beta)\cdot W_{inversefreq} + \beta\cdot W_{uniform}$$ 즉 균등분포가중치`[0.25,0.25,0.25,0.25]`와 빈도 백분율역수가중치를 $$\beta$$를 하이퍼파라미터로 해서 얼마나 섞어서 최종 가중치로 계산할지 결정하는 것이다. 따라서 하이퍼파라미터 튜닝에 'alpha_beta_smooth'라는 값을 넣어주었다. # 하이퍼파라미터 튜닝 ## 최적화 해야할 하이퍼파라미터 목록 ```python sweep_config = { 'method': 'bayes', 'metric': { 'name': 'eval/accuracy', 'goal': 'maximize' }, 'parameters': { 'learning_rate': { 'distribution': 'log_uniform_values', 'min': 1e-6, 'max': 5e-5 }, 'num_train_epochs': { 'values': [5, 8, 10, 12] }, 'weight_decay': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.1 }, 'per_device_train_batch_size': { 'values': [64, 128, 256] }, 'per_device_eval_batch_size': { 'values': [64, 128, 256] }, 'warmup_steps': { 'distribution': 'q_uniform', 'min': 100, 'max': 1000, 'q': 50 }, 'focal_loss_gamma': { 'distribution': 'uniform', 'min': 0.5, 'max': 5.0 }, 'label_smoothing_factor': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.2 }, #'dropout_rate': { 'distribution': 'uniform', 'min': 0.05, 'max': 0.3 }, 'lr_scheduler_type': { 'values': ['cosine', 'linear', 'constant'] }, 'gradient_accumulation_steps': { 'values': [1, 2, 4] }, 'num_rare_words_to_remove': { 'values': [0, 3, 5, 10] } # 추가됨 'alpha_beta_smooth': { 'min': 0.0, 'max': 1.0, 'distribution': 'uniform' # 0.0에서 1.0 사이를 균등하게 탐색 },# Focal Loss 알파의 가중치 비중을 탐색 'SWA_K': {'values':[2,3,4] } 'early_stopping_patience' : {'values':[2,3,4]} } } ``` 하이퍼파라미터 튜닝은 실험을 통해서 단일모델중 가장 최적의 성능을 보였던 `kykim/bert-kor-base` 모델로 진행했다. 모델의 아키텍처마다 최적의 하이퍼파라미터가 다르기 떄문에, 사용할 모델 모두 하이퍼파라미터 튜닝을 진행해야하지만, 대회 시간이 촉박해서 하나의 모델로밖에 튜닝을 해보지 못했다.. 이부분은 아쉽다. 다음에 대회에 참가할 기회가 생긴다면 실험 스케줄러를 만들어서 24시간동은 GPU를 굴리면서 가능한 모든 실험을 해볼 수 있도록 할것이다. ![image](/assets/images/2025-11-01-14-19-47.png) 튜닝결과 eval/accuracy_swa에서 가장 좋은 성능을 낸 9번째 하이퍼파라미터를 사용하기로 했다. 하이퍼파라미터 튜닝을 하기 전에는 0.85의 accuracy가 나왔지만, 하이퍼파라미터 튜닝 후 0.84가 나왔다. 이를 봐서는 베이지안 방식으로 하이퍼파라미터 튜닝이 아직 완벽하게 되지 않은것처럼 보였지만, 일단 시간관계상 이 하이퍼파라미터를 사용하기로 했다. ```python { 'learning_rate': 0.00000937759265615758, 'num_train_epochs': 5, 'weight_decay': 0.03423148594790665, 'per_device_train_batch_size': 32, 'per_device_eval_batch_size': 256, 'warmup_steps': 400, 'focal_loss_gamma': 4.194768435552584, 'label_smoothing_factor': 0.03442149572139974, 'lr_scheduler_type': 'linear', 'gradient_accumulation_steps': 4, 'num_rare_words_to_remove': 0, 'alpha_beta_smooth': 0.17235143553564636, 'SWA_K': 4, 'early_stopping_patience': 4 } ``` 튜닝된 하이퍼파라미터 결과를 보자면 알파는 거의 균등분포값에 가까운 가중치를 갖는다. 이전 실험까지의 인사이트와 이번 실험결과를 종합해 봤을때, `[0.25,0.25,0.25,0.25]` 즉 가장 eval/acc를 높이는 방향은 균등분포값에 가까운 가중치를 알파로 줘야한다는 인사이트를 얻었다. 실제로 test/acc를 관찰해본 결과, 하이퍼파라미터 튜닝을 통해 얻은 $$\alpha$$가중치를 쓰는것보다 균등분포 가중치를 주는것이 오히려 test/acc가 높음을 확인할 수 있었다. 아마 최적의 하이퍼파라미터를 찾기 전에(13step) 하이퍼파라미터 탐색을 중지해서 이런 결과가 나온것 같다. # 결과 ![image](/assets/images/2025-11-01-14-19-56.png) 맨아래는 단일모델 결과, 위의 3가지는 SWA와 모델별 앙상블 경우의수를 다르게 해서 test한 결과이다. 결과적으로 이번실험에서는 BERT기반 모델 3개를 앙상블하고, 알파가중치를 `[0.25,0.25,0.25,0.25]`로 두고, test/acc를 한 결과 가장 높은성능인 0.8278의 성능을 확인할 수 있었다. 추후 Public socre에서도 0.8301로 내가 실험해본 모델중에서는 가장 높은 성능을 보였다. ## 한계점 및 반성 하이퍼파라미터 튜닝을 하는데에는 상당한 시간이 든다. 베이지안 서치를 하더라도, 최소 15번 이상은 모델을돌려야 하고, 모델마다의 최적의 하이퍼파라미터는 다르므로, 앙상블할때 사용할 모든 모델에 대해서 하이퍼파라미터 튜닝을 해야한다. 그리고 15번 베이지안 서치를 한다고 해서 최적의 하이퍼파라미터를 얻는다는 보장은 없으므로, 어느정도 모델성능이 최적점에 수렴하는것을 확인할때까지 하이퍼파라미터튜닝을 해야한다. 실제로 이번 대회가 끝나고 오피스아워에서 멘토님이 하시는 말을 들어보니, 다른 대회에서도 최적의 모델을 우선 정한다음에, 대회가 끝날때직전까지 최적의 하이퍼파라미터를 찾는다고 한다. 이번 대회가 첫경험이라, 최적의 모델을 먼저 찾을 생각을 하지 못했고, 모델마다 최적의 하이퍼파라미터를 찾을 생각도 하지 못했다. 모델의 변경사항이 생길때마다 하이퍼파라미터는 달라질텐데, 그떄마다 하이퍼파라미터 튜닝을 다시 할 순 없으므로 가장 마지막에 튜닝을 해야하는것도 이번 대회를 통해 배우게 됐다. # 이후 실험에서 고려해야 할 것들 - tapt적용 - 전체데이터에 대해서 5개모델 다시 학습 후 앙상블 → 시간부족으로 못해봄 - 전체데이터셋으로 학습시킨 모델 효과있는지 실험→ 시간부족으로 못해봄 - 5개모델 acc를 Weight로 줘서 앙상블 - 역번역증강 사용할지 말지 결정 → 번역의 품질이 안좋아서 결국엔 사용 x ### [영화리뷰 감성분류][모델최적화]TAPT - Canonical URL: https://hyejunl33.github.io/projects/2025-11-01-[Domain_Common_Project]TAPT/ - Collection: Project - Published: 2025-11-01 - Tags: Domain_Common_Project, study, ModelOptimization, TAPT # [모델최적화]TAPT TAPT는 Task Adaptive Pre-Training의 약자로 내가 풀고자 하는 task에 적응시키기 위해 Pretraining 시키는 과정을 말한다. 기존의 BERT모델을 내가 풀고자 하는 영화리뷰 감성분류에 적응시키기 위해 TAPT를 사용할 수 있다. 일반적인 BERT,KoBERT,KLUE-BERT등은 이미 뉴스나 위키피디아, 댓글등 거대한 데이터에 대해 이미 학습된 상태이다. TAPT는 이러한 사전학습된 모델을 바탕으로 Fine-Tuning하는 과정이다. # TAPT를 왜 하는가? - 도메인 불일치: 모델이 사전 학습한 범용 데이터와, 실제 해결해야할 task의 데이터는 불일치한다. 따라서 Fine-Tuning이 필요하다. - TAPT의 목적: 도메인 사이의 격차를 줄여주는 것이 목적이다. 범용 모델을 원하는 task에 미리 적응시켜서 모델이 task의 도메인의 언어패턴을 더 잘 이해하게 만드는것이 핵심이다. 다만 Overfitting이 되지 않도록 유의해야한다. # TAPT는 어떻게 하는가? - 데이터: 학습데이터에 대해서 라벨이 없는 학습데이터를 사용한다. 이 데이터를 가지고 MLM방식을 사용해서 마스크된 단어를 예측하는 방식으로 학습한다. ## MLM: Masked Language Model 주변단어로 마스크된 중심단어를 맞추면서 학습한다. 따라서 문장 전체의 문맥을 반영하여 벡터값을 예측한다. 이 MLM을 이용해서 기존의 BERT모델을 Pretrain하면 모델이 훨씬더 데이터셋을 잘 이해할 수 있게 된다. **작동방식** 1. 입력문장을 가져온 후에, 일부 토큰을 랜덤하게 [MASK]토큰으로 바꾼다. 2. 모델이 문맥을 보고 [MASK]토큰에 들어갈 단어를 맞추도록 학습한다. 1. BERT의 기본 인코더 층 위에 MLM을 위한 HEAD를 추가로 붙인다. 2. [MASK]토큰의 최정 백터(`H_MASK`)만 MLM헤드로 전달된다. 3. 이 헤드의 최종 단계는 어휘의 사전 크기만큼의 차원으로 확장하는 하나의 Linear계층이다. 4. 계산된 Logits을 이용해서 BackPropagation을 진행한다. → 가중치를 업데이트 한다 이를 통해서 모델은 주변 문맥을 통해 빈칸을 추론하는 방법을 배운다. # Task에 맞는 데이터셋 준비 ```python # TAPT.ipynb (Cell 9) # 1. 내가 풀려는 과제의 데이터를 불러옵니다. train_df = pd.read_csv("./data/train.csv") test_df = pd.read_csv("./data/test.csv") # 2. 'review' 텍스트만 모두 합칩니다. all_text_data = pd.concat([train_df['review'], test_df['review']]) # 3. TAPT 학습용 텍스트 파일로 저장합니다. output_filename = "tapt_corpus.txt" with open(output_filename, "w", encoding="utf-8") as f: for line in all_text_data: # ... (생략) ... ``` 내가 풀고자하는 Task의 데이터를 불러와서 TAPT에 맞는 데이터셋으로 준비한다. 이때 TAPT과정에서 label은 필요없고, review데이터(텍스트)만을 이용한다. ### [영화리뷰 감성분류][모델최적화]-eval/loss vs eval/acc - Canonical URL: https://hyejunl33.github.io/projects/2025-11-01-[Domain_Common_Project]eval-loss-vs-eval-acc/ - Collection: Project - Published: 2025-11-01 - Tags: Domain_Common_Project, study, ModelOptimization # Introduction 해당 test의 평가 지표는 test/acc이다. 지금까지의 실험 가설은 eval/loss를 줄여서 과적합을 막으면 자동으로 test/acc도 올라갈것이라는 가정이 있었다. 하지만 eval/loss를 metric으로 모델을 선택해서 test를 해본 결과, 성능이 오히려 하락하는 문제가 있었다. ![image](/assets/images/2025-11-01-13-30-04.png) ![image](/assets/images/2025-11-01-13-30-13.png) 그리고 두번째로, 모델이 과하게 소수클래스를 중요하게 보는 문제가 있었다. test데이터셋의 분포는 알 수 없지만, 일반적으로 전체데이터셋과 같다고 생각할때, Focal Loss의 $$\alpha$$의 가중치로 인해 소수클래스만을 너무 중요하게 여겨서, 전체 데이터셋의 분포와 예측 분포를 볼때, 소수클래스의 비율이 과장되게 예측됨을 확인할 수 있었다. 따라서 이번실험에서는 평가지표를 eval/acc로 바꿔본 후, Focal Loss의 가중치를 모두 1로 두고 성능을 관찰해본다. 시간관계상 앙상블한 모델이 아닌 단일모델로 실험을 한다. 평가지표를 acc로 바꿨기 때문에 eval/acc만 상승하고 eval/loss는 폭발하는 상황을 막기 위해서 기존에 8이었던 에폭을 5로 설정한다. 만약 유의미한 성능향상이 있을 경우 이 모델을 기준으로, 하이퍼파라미터 튜닝을 한 후 앙상블을 해서 성능을 실험해 볼 예정이다. # Eval/accuracy를 메트릭으로 이용하자.. 기존에는 너무 결과가 과적합되는것 같아서 eval/loss를 메트릭으로 사용해서 모델을 선정했다. 따라서 acc성능이 잘 나오지 않은것으로 추측된다. 따라서 이번에는 eval/accuracy를 메트릭으로 사용한다. ```python # --- Training Arguments for the current model --- training_args = TrainingArguments( output_dir=output_dir, num_train_epochs=NUM_EPOCHS, per_device_train_batch_size=BATCH_SIZE_TRAIN, per_device_eval_batch_size=BATCH_SIZE_EVAL, warmup_steps=WARMUP_STEPS, weight_decay=WEIGHT_DECAY, learning_rate=LEARNING_RATE, logging_steps=100, eval_strategy="epoch", save_strategy="epoch" if SAVE_MODEL else "no", load_best_model_at_end=SAVE_MODEL, metric_for_best_model= "eval_accuracy" if SAVE_MODEL else None, greater_is_better=True, save_total_limit=SAVE_TOTAL_LIMIT_FOR_SWA if SAVE_MODEL else 0, # 수정: SWA 위해 늘림 label_smoothing_factor=0.18547040498752376, report_to="wandb" if USE_WANDB else "none", run_name=run_name if USE_WANDB else None, seed=current_seed, fp16=torch.cuda.is_available(), dataloader_num_workers=2, remove_unused_columns=False, push_to_hub=False, gradient_accumulation_steps=4, logging_first_step=True, save_safetensors=SAVE_MODEL, lr_scheduler_type= "constant", # early_stopping_patience=3, # Keep early stopping if desired # early_stopping_threshold=0.001, ) ``` `metric_for_best_model= "eval_accuracy"` 를 인자로 줘서 eval_accuracy를 메트릭으로 사용한다. 그리고 loss와는 다르게 크면 클수록 좋은것이므로 `greater_is_better=True` 인자를 True로 바꿔줬다. 이와 더불어서 Trainer를 호출할때 `focal_loss_alpha=[1, 1, 1, 1],` 를 이용해서 클래스간 가중치를 아예 없애버렸다. # 결과 ![image](/assets/images/2025-11-01-13-30-26.png) 기존 실험들 중 가장 높은 성능을 보인 0.8211의 acc가 나왔다. 이제 확실한건, focal_loss의 alpha가중치를 신중하게 수정해야 한다는점, 그리고 모델을 선정할때는 최종 test를 위해서 accuracy를 기준으로 선정해야 한다는점이 확실해졌다. ![image](/assets/images/2025-11-01-13-30-32.png) 긍정적인 부분은 alpha가중치를 모두 1로 뒀음에도 f1이 accuracy와 비슷한 정도의 score를 갖는다는것이다. 따라서 가중치가 모두 같음에도 recall성능이 나쁘지 않다는것으로, alpha가중치를 이전에 백분율의 역수로 준게 매우 악영향을 미쳤었다는것을 추측할 수 있었다. ![image](/assets/images/2025-11-01-13-30-41.png) 모델의 최종 예측분포를 보면 EDA했을때 전체 데이터셋의 분포와 비슷함을 알 수 있다. 약한 부정비율은 많이 낮아졌지만, 그래도 다수의 클래스에서 Ground Truth와 같은 정답을 예측하는 숫자가 늘어났기 때문에 acc가 향상된것 같다. 이전에는 이 테스트의 목표는 acc를 높이는건데, 그러면 차라리 소수클래스를 무시하고, recall이 낮아도 상관없다는 말이니깐 loss는 커지더라도 acc만커지면 되니깐, loss는 오히려 어느정도는 커져도 상관없을것 같다고 생각을 했다. 하지만 f1 score와 acc가 동시에 올라가는 결과를 관측할 수 있었다. 이제 남은것은 BERT기반 모델 3개의 앙상블을 통한 모델이 더 높은 성능을 보이는지 여부를 확인하고, 하이퍼파라미터 튜닝을 통해 최적의 하이퍼파라미터로 성능을 뽑아내는것이다. ## BERT기반 모델 3개 앙상블 ```python # === Ensemble Training Block === # Replace the original training cell (ID: 176174ee) with this code. # --- Model Training Settings --- SAVE_MODEL = True USE_WANDB = True # Set to True if you want to use Weights & Biases logging for each model from transformers import EarlyStoppingCallback # List of models for ensemble model_names = [ # "./tapted_klue_roberta_base", "./tapted_klue_bert_base", "./tapted_kykim_bert_kor_base", "./tapted_beomi_kcbert_base" # "./tapted_koelectra_base_v3" ] # --- Loop through each model for training --- all_training_results = {} for model_name in model_names: current_seed = random.randint(1, 100000) model_short_name = model_name.split('/')[-1].replace('-', '_') # Create a short name for directories/logging output_dir = f"./results_{model_short_name}" run_name = f"{model_short_name}-movie-review" print("\n" + "=" * 50) print(f"모델 훈련 시작: {model_name}") print(f"결과 저장 경로: {output_dir}") print(f"현재 시드값: {current_seed}") # 💡 현재 시드값 출력 print("=" * 50) # --- Load Model and Tokenizer for the current model --- try: current_tokenizer = AutoTokenizer.from_pretrained(model_name) current_model = AutoModelForSequenceClassification.from_pretrained( model_name, num_labels=NUM_CLASSES, ) current_model.to(device) # Move model to GPU # --- Add new special tokens and resize embeddings --- num_added_toks = current_tokenizer.add_tokens(NEW_SPECIAL_TOKENS) if num_added_toks > 0: print(f"Added {num_added_toks} new special tokens for {model_name}.") current_model.resize_token_embeddings(len(current_tokenizer)) print("Resized model token embeddings.") except Exception as e: print(f"Error loading model {model_name}: {e}") print("Skipping this model.") continue # Skip to the next model if loading fails # --- Recreate Datasets with the current tokenizer --- # This is necessary because different models might have different tokenization train_dataset_current = ReviewDataset( train_data["review"], train_data["label"], current_tokenizer, CHOSEN_MAX_LENGTH, ) val_dataset_current = ReviewDataset( val_data["review"], val_data["label"], current_tokenizer, CHOSEN_MAX_LENGTH, ) # SWA 설정 추가 SWA_K = 2 # 평균낼 마지막 체크포인트 개수 SAVE_TOTAL_LIMIT_FOR_SWA = SWA_K + 1 # best 모델 + 마지막 K개 저장되도록 (최소 2) # --- Training Arguments for the current model --- training_args = TrainingArguments( output_dir=output_dir, num_train_epochs=NUM_EPOCHS, per_device_train_batch_size=BATCH_SIZE_TRAIN, per_device_eval_batch_size=BATCH_SIZE_EVAL, warmup_steps=WARMUP_STEPS, weight_decay=WEIGHT_DECAY, learning_rate=LEARNING_RATE, logging_steps=100, eval_strategy="epoch", save_strategy="epoch" if SAVE_MODEL else "no", load_best_model_at_end=SAVE_MODEL, metric_for_best_model= "eval_accuracy" if SAVE_MODEL else None, greater_is_better=True, save_total_limit=SAVE_TOTAL_LIMIT_FOR_SWA if SAVE_MODEL else 0, # 수정: SWA 위해 늘림 label_smoothing_factor=0.18547040498752376, report_to="wandb" if USE_WANDB else "none", run_name=run_name if USE_WANDB else None, seed=current_seed, fp16=torch.cuda.is_available(), dataloader_num_workers=2, remove_unused_columns=False, push_to_hub=False, gradient_accumulation_steps=4, logging_first_step=True, save_safetensors=SAVE_MODEL, lr_scheduler_type= "constant", # early_stopping_patience=3, # Keep early stopping if desired # early_stopping_threshold=0.001, ) early_stopping_callback = EarlyStoppingCallback(early_stopping_patience=3) # <--- 원하는 patience 값 # --- Initialize Trainer for the current model --- trainer = CustomTrainerWithFocalLoss( model=current_model, args=training_args, train_dataset=train_dataset_current, eval_dataset=val_dataset_current, # tokenizer=current_tokenizer, num_classes=NUM_CLASSES, callbacks=[early_stopping_callback], focal_loss_alpha=[1, 1, 1, 1], # Adjust alpha if needed focal_loss_gamma=2.965201490877045, data_collator=DataCollatorWithPadding(tokenizer=current_tokenizer), compute_metrics=compute_metrics, ) ``` ```python # --- Training Execution --- print(f"훈련 정보 ({model_name}):") print(f" 훈련 샘플: {len(train_dataset_current):,}개") print(f" 검증 샘플: {len(val_dataset_current):,}개") print(f" 훈련 에포크: {training_args.num_train_epochs}회") print(f" 배치 크기: {BATCH_SIZE_TRAIN} (훈련) / {BATCH_SIZE_EVAL} (검증)") print(f" 학습률: {LEARNING_RATE}") print(f" 시드값: {current_seed}") print(f" 디바이스: {device}") print(f" wandb 사용: {USE_WANDB}") try: training_result = trainer.train() print(f"\n{model_name} 훈련 완료") print(f" 최종 훈련 손실: {training_result.training_loss:.4f}") all_training_results[model_name] = training_result # --- Save the final best model --- if SAVE_MODEL: best_model_path = f"{output_dir}/best_model_{model_short_name}" print(f"최종 베스트 모델 저장 중: {best_model_path}") trainer.save_model(best_model_path) current_tokenizer.save_pretrained(best_model_path) print(f"최종 베스트 모델 저장 완료: {best_model_path}") # === SWA (Stochastic Weight Averaging) 적용 시작 === print(f"\n--- SWA 가중치 평균 시작 (모델: {model_name}) ---") print(f"마지막 {SWA_K}개 체크포인트를 평균냅니다.") try: # 1. SWA에 사용할 체크포인트 경로 찾기 checkpoint_dir = output_dir checkpoints = sorted( glob.glob(os.path.join(checkpoint_dir, "checkpoint-*")), key=lambda x: int(x.split('-')[-1]) # 스텝 번호 기준 정렬 ) if len(checkpoints) >= SWA_K: swa_checkpoints = checkpoints[-SWA_K:] print(f"SWA에 사용할 체크포인트 ({len(swa_checkpoints)}개):") for ckpt in swa_checkpoints: print(f" - {os.path.basename(ckpt)}") # 2. 기본 모델 로드 (구조만 사용) # best_model_path에서 config를 로드하여 동일한 구조 보장 print("SWA 기본 모델 구조 로딩 중...") config = AutoConfig.from_pretrained(best_model_path) swa_base_model = AutoModelForSequenceClassification.from_config(config) swa_base_model.to(device) # 3. 가중치 평균내기 print("체크포인트 가중치 평균 계산 중...") avg_state_dict = OrderedDict() model_keys = swa_base_model.state_dict().keys() # 모델 키 저장 for i, checkpoint_path in enumerate(swa_checkpoints): print(f" ({i+1}/{len(swa_checkpoints)}) 체크포인트 로딩: {checkpoint_path}") # safetensors 우선 로드 시도 safetensors_path = os.path.join(checkpoint_path, "model.safetensors") bin_path = os.path.join(checkpoint_path, "pytorch_model.bin") if os.path.exists(safetensors_path): state_dict = load_safetensors_file(safetensors_path, device="cpu") elif os.path.exists(bin_path): state_dict = torch.load(bin_path, map_location="cpu") else: print(f" 경고: {checkpoint_path} 에서 모델 파일을 찾을 수 없습니다. 건너<0xEB><0x9A><0x8D>니다.") continue # 평균 계산 (첫 번째 체크포인트는 복사, 이후는 더하기) for key in model_keys: if key not in state_dict: print(f" 경고: 키 '{key}'가 체크포인트에 없습니다. 건너<0xEB><0x9A><0x8D>니다.") continue if i == 0: avg_state_dict[key] = state_dict[key].clone().float() # float()로 타입 통일 else: if key in avg_state_dict: avg_state_dict[key] += state_dict[key].float() # float()로 타입 통일 else: print(f" 경고: 이전 체크포인트에 없던 키 '{key}' 발견. 건너<0xEB><0x9A><0x8D>니다.") del state_dict # 메모리 확보 # 평균 계산 (K로 나누기) num_averaged = len(swa_checkpoints) # 실제 로드된 체크포인트 수 if num_averaged > 0: for key in avg_state_dict: avg_state_dict[key] /= num_averaged # 4. 평균낸 가중치를 모델에 로드 missing_keys, unexpected_keys = swa_base_model.load_state_dict(avg_state_dict, strict=False) if missing_keys: print(f" 경고: 로드되지 않은 키: {missing_keys}") if unexpected_keys: print(f" 경고: 예상치 못한 키: {unexpected_keys}") print("평균 가중치 모델에 로드 완료.") # 5. 배치 정규화(Batch Normalization) 통계 업데이트 (매우 중요!) print("배치 정규화 통계 업데이트 중...") # update_bn 함수는 DataLoader가 필요 swa_data_collator = DataCollatorWithPadding(tokenizer=current_tokenizer) train_dataloader_for_bn = DataLoader( train_dataset_current, batch_size=BATCH_SIZE_TRAIN, # 훈련 배치 크기 사용 권장 collate_fn=swa_data_collator, shuffle=False, # BN 업데이트 시에는 셔플 불필요 num_workers=2 ) # update_bn 함수 호출 # swa_utils.update_bn()은 AveragedModel 객체를 받지만, # 여기서는 직접 평균낸 모델을 사용하므로, 수동 루프 또는 아래와 같이 직접 호출 swa_base_model.train() # BN 업데이트는 train 모드에서 with torch.no_grad(): num_batches_tracked = 0 for batch in tqdm(train_dataloader_for_bn, desc="BN 업데이트", leave=False): inputs = {k: v.to(device) for k, v in batch.items() if k in ['input_ids', 'attention_mask', 'token_type_ids']} if not inputs: continue # 입력이 없는 경우 건너뛰기 swa_base_model(**inputs) num_batches_tracked += 1 if num_batches_tracked >= 100: # 전체 데이터 대신 일부(예: 100 배치)만 사용해도 충분할 수 있음 break swa_base_model.eval() # 다시 eval 모드로 print(f"배치 정규화 통계 업데이트 완료 (약 {num_batches_tracked} 배치 사용).") # 6. SWA 모델 저장 swa_model_path = f"{output_dir}/swa_model_{model_short_name}" os.makedirs(swa_model_path, exist_ok=True) print(f"SWA 모델 저장 중: {swa_model_path}") # state_dict() 저장 방식 사용 torch.save(swa_base_model.state_dict(), os.path.join(swa_model_path, "pytorch_model.bin")) # save_pretrained는 전체 모델 객체를 저장하려 하므로 여기서는 state_dict 저장 권장 # swa_base_model.save_pretrained(swa_model_path) # 필요시 사용 가능 current_tokenizer.save_pretrained(swa_model_path) # 토크나이저도 함께 저장 # config.json도 저장 (save_pretrained가 없으므로 수동 복사 또는 저장) config.save_pretrained(swa_model_path) print(f"SWA 모델 저장 완료: {swa_model_path}") else: print("평균낼 유효한 체크포인트가 없습니다.") else: print(f"SWA를 위한 체크포인트가 충분하지 않습니다 ({len(checkpoints)}개 발견, {SWA_K}개 필요). SWA를 건너<0xEB><0x9A><0x8D>니다.") except Exception as e: print(f"SWA 처리 중 오류 발생: {e}") finally: # SWA 모델 객체 메모리 정리 (필요시) if 'swa_base_model' in locals(): del swa_base_model if torch.cuda.is_available(): torch.cuda.empty_cache() print("--- SWA 가중치 평균 종료 ---") # === SWA 적용 종료 === except KeyboardInterrupt: print(f"\n사용자에 의해 {model_name} 훈련이 중단되었습니다.") # Optionally break the loop if one model training is interrupted # break except Exception as e: print(f"\n{model_name} 훈련 중 오류 발생: {str(e)}") # Optionally log the error and continue with the next model # continue # --- Clean up GPU memory before next model --- del current_model del current_tokenizer del trainer if torch.cuda.is_available(): torch.cuda.empty_cache() print("\n" + "=" * 50) print("모든 모델 훈련 완료!") print("=" * 50) ``` 우선 앙상블할 각 모델마다 랜덤시드를 다르게주도록 구현해서 모델들이 보는 데이터셋의 분산을 키우고자 했다. 일반적으로 앙상블의 효과는 각 모델이 상이한 부분에서 하는 실수를 매꿀때 극대화 되므로 서로다른 모델이 학습할때마다 루프안에서 다른 랜덤시드를 가지도록 코드로 구현했다. ### 앙상블한 결과 ![image](/assets/images/2025-11-01-13-30-56.png) 모델 3개를 앙상블한 결과 acc가 0.7% 올랐다. 즉 유의미한 효과가 있었다. ![image](/assets/images/2025-11-01-13-31-02.png) 이전 실험과 마찬가지로 최종 예측분포를 보면 전체 데이터셋의 분포와 비슷하게 맞춤을 알 수 있다. acc를 높이려면 test 데이터의 분포와 유사해야함을 시사한다. 그리고 소수를 차지하는 분포인 약한부정은 더 덜맞추는 경향성이 있지만, 0,1,3레이블은 더 정교하게 원래 데이터분포와 비슷해졌음을 알 수 있다. 대다수의 레이블을 잘 못추면 역시 acc가 올라감을 확인할 수 있었다. # 이후 실험에서 고려해야 할 것들 - 하이퍼파라미터 튜닝 - Focal Loss에서 알파 가중치를 얼마나 줘야할까? - 최적의 알파 가중치는 얼마일까? - 이외에 하이퍼파라미터 튜닝할 수 있는값 모두 넣기 - valid 데이터를 포함해서 전체 데이터를 기준으로 학습시켜보기 - 모델 앙상블 추론을 할때, 모델별로 Weight를 줘서 앙상블을 해보기 ### [영화리뷰 감성분류][모델최적화]마지막 시도, 그리고 반성 - Canonical URL: https://hyejunl33.github.io/projects/2025-11-02-[Domain_Common_Project]TAPT/ - Collection: Project - Published: 2025-11-01 - Tags: Domain_Common_Project, study, ModelOptimization # Introduction - tapt적용 - 전체데이터에 대해서 5개모델 다시 학습 후 앙상블 → 시간부족으로 못해봄 - 전체데이터셋으로 학습시킨 모델 효과있는지 실험→ 시간부족으로 못해봄 - 5개모델 acc를 Weight로 줘서 앙상블 - 역번역증강 사용할지 말지 결정 → 번역의 품질이 안좋아서 결국엔 사용 x 저번실험까지 해서 기껏 하이퍼파라미터 튜닝을 해뒀는데 TAPT라는 새로운 기법에 대해 알게됐다. 일반적으로 BERT모델을 내가 원하는 TASK에 FineTuning하는 기법인데, 이 기법을 사용하면 성능이 일반적으로 향상된다고 한다. 이 기법을 하이퍼파라미터 튜닝을 한 후에 알게되어서, 대회 종료까지 2일 남은 시점에서, 다시 하이퍼파라미터 튜닝을 해야하는 상황에 처해졌다. 따라서 TAPT를 일단 적용해보고, 기존에 찾았던 하이퍼파라미터를 이용해서 성능을 테스트해보기로 했다. [TAPT정리글](https://hyejunl33.github.io/projects/2025-11-01-%5BDomain_Common_Project%5DTAPT/) 그 외에도 모델마다 acc성능이 다르므로, 추론단계에서 모델을 앙상블 할때 그냥 logit을 softvoting하는게 아니라, 모델간의 acc를 가중치로 줘서 softvoting하는 방법을 구현했다. 역번역 증강은 코드까지는 구현했으나, 강한부정, 강한긍정에서는 어느정도 문맥이 유지되는듯 했는데, 약한긍정, 약한부정을 역번역하니, 문맥이 아예 다른 데이터들이 생성되는것을 확인했다. 더 정교한 모델을 사용하면, 역번역 증강을 사용해서 데이터를 효율적으로 늘릴 수 있겠으나, 데이터를 늘리더라도, 최적의 하이퍼파라미터를 다시 학습하는데에는 시간이 없으므로, 역번역 증강은 이번대회에서는 사용하지 않기로 했다. 기존의 방식은 Traindata를 valid,train으로 다시 나눠서 학습용과 검증데이터를 나눠서 학습을 진행했다. 하지만 일반적으로 최종 모델을 학습할떄는 전체 데이터에 대해서 다시 학습한 후 앙상블을 한다고 한다. 이또한 앙상블을 하려면 최소 3개의 모델을 전체 데이터에 대해서 다시 학습을 해야하는데, 코드까지는 구현했으나, 시간부족으로 모델로 반영하지는 못했다. # Weighted Model Ensemble ```python # === Ensemble Inference Block (Weighted Averaging) === # Replace the original inference cell (ID: 079c8f40) with this code. import torch import numpy as np import os from tqdm.auto import tqdm # Import tqdm for progress bar from transformers import AutoTokenizer, AutoModelForSequenceClassification, Trainer, TrainingArguments, DataCollatorWithPadding import shutil # Import shutil for directory removal print(f"현재 디바이스: {device}") # --- Load Test Data --- df_test = pd.read_csv("data/test.csv") print(f"테스트 데이터 로드 완료: {len(df_test)} 샘플") # --- Apply Preprocessing --- # Use the 'preprocessor' instance fitted during training print("테스트 데이터에 전처리 파이프라인 적용 중...") test_texts = df_test["review"].tolist() # Use transform only, assumes preprocessor is already fitted # Ensure the preprocessor was fitted during the training phase if not preprocessor.is_fitted: # If the preprocessor wasn't fitted (e.g., running inference separately), # you might need to fit it here or load a saved preprocessor state. # For now, we'll just apply basic preprocessing. print("Warning: Preprocessor가 fit되지 않았습니다. 기본 전처리만 적용합니다.") test_processed = preprocessor.basic_preprocess(test_texts) else: test_processed = preprocessor.transform(test_texts) # Apply transform including rare word removal if fitted print("테스트 데이터 전처리 완료") # --- List of Trained Model Paths --- # Ensure these paths match where models were saved in the training block # 수정: best_model 대신 swa_model 경로를 사용하도록 변경 model_names = [ "./tapted_klue_roberta_base", "./tapted_klue_bert_base", "./tapted_kykim_bert_kor_base", "./tapted_beomi_kcbert_base", "./tapted_koelectra_base_v3" ] model_paths = [ f"./results_{model_name.split('/')[-1].replace('-', '_')}/swa_model_{model_name.split('/')[-1].replace('-', '_')}" # <-- swa_model 로 변경 for model_name in model_names # Use the same model_names list from training ] print(model_paths) # model_paths = [ # f"./results_{model_name.split('/')[-1].replace('-', '_')}/best_model_{model_name.split('/')[-1].replace('-', '_')}" # <-- swa_model 로 변경 # for model_name in model_names # Use the same model_names list from training # ] # --- Define Model Weights (Based on Validation Performance) --- # 각 모델의 검증 데이터셋 F1 score (또는 Accuracy) 값으로 반드시 교체해야 합니다. # 이거 f1으로 할지 accuracy로할지 둘다 해보기 # model_paths 리스트의 모델 순서와 동일하게 값을 넣어야 합니다. model_performance_scores = { model_paths[0]: 0.8114, #roberta model_paths[1]: 0.8056, # 예시: tapted_klue_bert_base SWA 모델의 검증 F1 model_paths[2]: 0.8179, # 예시: tapted_kykim_bert_kor_base SWA 모델의 검증 F1 model_paths[3]: 0.7961, # 예시: tapted_beomi_kcbert_base SWA 모델의 검증 F1 model_paths[4]: 0.8077 #koelectra # 다른 모델 추가 시 여기에 성능 점수 추가 } # --- Ensemble Inference --- all_logits = [] successful_model_paths = [] # 추론에 성공한 모델 경로 저장 print("\n" + "=" * 50) print("앙상블 추론 시작...") print("=" * 50) for model_path in tqdm(model_paths, desc="모델별 추론 진행"): if not os.path.exists(model_path): print(f"Warning: 모델 경로를 찾을 수 없습니다: {model_path}. 이 모델을 건너뜁니다.") continue print(f"\n모델 로딩: {model_path}") try: # Load tokenizer and model for the current path current_tokenizer = AutoTokenizer.from_pretrained(model_path) current_model = AutoModelForSequenceClassification.from_pretrained(model_path) current_model.to(device) current_model.eval() # Create test dataset with the current tokenizer test_dataset_current = ReviewDataset( pd.Series(test_processed), # Pass processed text as a Series None, # No labels for test set current_tokenizer, CHOSEN_MAX_LENGTH ) # Define minimal TrainingArguments for prediction temp_output_dir = f"./temp_prediction_{os.path.basename(model_path)}" predict_args = TrainingArguments( output_dir=temp_output_dir, per_device_eval_batch_size=BATCH_SIZE_EVAL * 2, # Increase batch size for faster inference dataloader_num_workers=2, remove_unused_columns=False, # Keep columns needed by dataset fp16=torch.cuda.is_available(), logging_steps=len(test_dataset_current) // (BATCH_SIZE_EVAL * 2) + 1 # Reduce logging ) # Initialize Trainer for prediction pred_trainer = Trainer( model=current_model, args=predict_args, # tokenizer=current_tokenizer, # Trainer에서는 tokenizer 없어도 됨 data_collator=DataCollatorWithPadding(tokenizer=current_tokenizer), ) # Get predictions (logits) print(f"모델 추론 중: {model_path}") predictions = pred_trainer.predict(test_dataset_current) logits = predictions.predictions # Logits are in predictions.predictions all_logits.append(logits) successful_model_paths.append(model_path) # 성공한 모델 경로 추가 print(f"모델 추론 완료: {model_path}") # Clean up memory del current_model del current_tokenizer del pred_trainer if torch.cuda.is_available(): torch.cuda.empty_cache() # Clean up temporary directory if os.path.exists(temp_output_dir): shutil.rmtree(temp_output_dir) except Exception as e: print(f"Error during inference for model {model_path}: {e}") # Decide whether to continue or stop if one model fails # continue # 오류 발생 시 해당 모델 건너뛰기 # --- Weighted Averaging Logits --- if not all_logits: raise ValueError("추론 결과가 없습니다. 모델 경로 또는 추론 과정을 확인하세요.") print("\n로짓(logits) 가중 평균 계산 중...") # Convert list of numpy arrays to a numpy array for easier calculation all_logits_np = np.array(all_logits) # Filter performance scores for successfully loaded models relevant_scores = [model_performance_scores[path] for path in successful_model_paths if path in model_performance_scores] if len(relevant_scores) != all_logits_np.shape[0]: print(f"Warning: 추론된 모델 수({all_logits_np.shape[0]})와 유효한 성능 점수 개수({len(relevant_scores)})가 다릅니다. 단순 평균을 사용합니다.") # Fallback to simple mean if weights don't match (e.g., model failed or score missing) average_logits = np.mean(all_logits_np, axis=0) else: # Calculate weights based on performance scores (Normalization) total_score = sum(relevant_scores) if total_score == 0: # Avoid division by zero if all scores are 0 print("Warning: 모든 모델 성능 점수가 0입니다. 동일 가중치를 사용합니다.") weights = np.ones(len(relevant_scores)) / len(relevant_scores) else: weights = np.array([score / total_score for score in relevant_scores]) print(f"사용된 모델 경로: {successful_model_paths}") print(f"해당 모델 가중치: {weights}") # Calculate the weighted average logits across models (axis=0) average_logits = np.average(all_logits_np, axis=0, weights=weights) print(f"가중 평균 로짓 계산 완료. 형태: {average_logits.shape}") # --- Final Prediction --- predicted_labels = np.argmax(average_logits, axis=1) print(f"최종 예측 레이블 생성 완료: {len(predicted_labels)}개") # --- Add predictions to the test DataFrame --- df_test["pred"] = predicted_labels print(f"\ndf_test에 pred 컬럼이 추가되었습니다. 형태: {df_test.shape}") # --- Analyze Prediction Distribution --- unique_predictions, counts = np.unique(predicted_labels, return_counts=True) print("\n최종 예측 분포:") # Ensure LABEL_MAPPING is defined in your environment if 'LABEL_MAPPING' not in globals(): LABEL_MAPPING = {0: "강한 부정", 1: "약한 부정", 2: "약한 긍정", 3: "강한 긍정"} # Define if not present for pred, count in zip(unique_predictions, counts): percentage = (count / len(predicted_labels)) * 100 class_name = LABEL_MAPPING.get(pred, f"클래스 {pred}") print(f" {class_name} ({pred}): {count:,}개 ({percentage:.1f}%)") print("\n" + "=" * 50) print("앙상블 추론 완료!") print("=" * 50) # GPU 메모리 정리 if torch.cuda.is_available(): torch.cuda.empty_cache() # Note: The code for creating and saving the submission file remains the same # It should follow this block, using the df_test DataFrame which now has the 'pred' column ``` ![image](/assets/images/2025-11-02-15-21-27.png) ![image](/assets/images/2025-11-02-15-21-37.png) 최종 목표가 test/acc를 향상시키는 것인만큼 각 모델의 가중치는 각 단일모델의 test/acc를 확인하고, 이 acc를 정규화 한 후 가중치로 사용했다. ![image](/assets/images/2025-11-02-15-21-43.png) 단일모델로서 가장 성능이 잘나왔던 RoBERTa와 Kykim-BERT두개를 앙상블한것보다, 전체 모델 5개를 앙상블한 결과가 더 성능이 잘나오는 것을 확인할 수 있었다. Bagging에 의해 서로다른 모델을 사용하면 일반적으로 선형적으로 성능이 향상됨을 확인할 수 있었다. # 전체 데이터를 이용한 학습 ```python # === 최종 모델 재학습 (전체 데이터 활용) 블록 === # 이 블록은 앙상블 훈련(ID: 176174ee) 이후에 실행합니다. import pandas as pd import torch from transformers import AutoTokenizer, AutoModelForSequenceClassification, TrainingArguments, DataCollatorWithPadding, Trainer import os import shutil # 추가: 디렉토리 관리용 print("\n" + "="*60) print("🚀 전체 데이터(학습+검증)를 사용한 최종 모델 재학습 시작") print("="*60 + "\n") # --- 설정값 --- # 1. 재학습할 기반 모델 이름 및 경로 선택 # !!! 중요: 초기 훈련/검증에서 가장 좋은 성능을 보인 모델의 이름을 지정하세요. # (예: Wandb 로그에서 eval_loss가 가장 낮거나 eval_f1/eval_accuracy가 가장 높았던 모델) # SWA 모델이 더 좋았다면 해당 모델 경로를 initial_model_path로 직접 지정해도 됩니다. BEST_PERFORMING_MODEL_NAME = "./tapted_kykim_bert_kor_base" # <--- 실제 최적 모델 이름으로 변경하세요 (예시) best_model_short_name = BEST_PERFORMING_MODEL_NAME.split('/')[-1].replace('-', '_') # 초기 훈련 결과에서 'best_model' 경로를 사용합니다. # SWA 모델을 기반으로 재학습하려면 이 경로를 swa_model 경로로 변경하세요. # initial_model_path = f"./results_{best_model_short_name}/best_model_{best_model_short_name}" # 예: SWA 기반 재학습 시 initial_model_path = f"./results_{best_model_short_name}/swa_model_{best_model_short_name}" print(f"선택된 기반 모델: {BEST_PERFORMING_MODEL_NAME}") print(f"기반 모델 경로: {initial_model_path}") if not os.path.exists(initial_model_path): raise FileNotFoundError(f"기반 모델 경로를 찾을 수 없습니다: {initial_model_path}. 경로를 확인하거나 이전 훈련을 완료하세요.") # 2. 전체 데이터 재학습 시 사용할 에포크 수 # !!! 중요: 초기 훈련 중 검증 데이터에서 최적 성능(예: 가장 낮은 eval_loss)을 보였던 # 에포크 수를 확인하여 설정하세요. (Wandb 등 로그 확인 필요) FINAL_TRAIN_EPOCHS = 5 # <--- 실제 최적 에포크 수로 변경하세요 (예시) print(f"재학습 에포크 수: {FINAL_TRAIN_EPOCHS}") # 3. 최종 모델을 저장할 디렉토리 경로 final_output_dir = f"./final_model_{best_model_short_name}_fulldata" print(f"최종 모델 저장 경로: {final_output_dir}\n") # 4. 사용할 하이퍼파라미터 (초기 훈련의 최적값 유지) # 이 값들은 이전 셀(ID: b5ba58df) 및 훈련 루프(ID: 176174ee)에서 사용된 값과 동일해야 합니다. FINAL_LEARNING_RATE = LEARNING_RATE FINAL_WEIGHT_DECAY = WEIGHT_DECAY FINAL_WARMUP_STEPS = WARMUP_STEPS FINAL_BATCH_SIZE_TRAIN = BATCH_SIZE_TRAIN FINAL_GRAD_ACCUM_STEPS = 4 # 초기 훈련과 동일하게 설정 (training_args에서 확인) FINAL_LABEL_SMOOTHING = 0.03442149572139974 # 초기 훈련 값 (training_args에서 확인) FINAL_LR_SCHEDULER = "constant" # 초기 훈련 값 (training_args에서 확인) # Focal Loss 파라미터 (CustomTrainerWithFocalLoss 초기화 시 사용된 값) FINAL_FOCAL_ALPHA = [1,1,1,1] FINAL_FOCAL_GAMMA = 4.194768435552584 # --- 1. 학습 + 검증 데이터 합치기 --- print("📊 학습 데이터와 검증 데이터 합치는 중...") # train_data와 val_data는 이전 데이터 분할 셀(ID: e6e4ca17)에서 생성된 변수입니다. if 'train_data' not in globals() or 'val_data' not in globals(): raise NameError("train_data 또는 val_data 변수를 찾을 수 없습니다. 이전 데이터 분할 셀을 실행했는지 확인하세요.") full_train_data = pd.concat([train_data, val_data], ignore_index=True) print(f" 전체 학습 데이터 크기: {len(full_train_data):,}개") print(f" 합쳐진 데이터 샘플 확인 (처음 3개):\n{full_train_data.head(3)}\n") # --- 2. 기반 모델 및 토크나이저 로드 --- print(f"🔩 기반 모델 및 토크나이저 로딩: {initial_model_path}") try: final_tokenizer = AutoTokenizer.from_pretrained(initial_model_path) final_model = AutoModelForSequenceClassification.from_pretrained( initial_model_path, num_labels=NUM_CLASSES, # 클래스 수는 동일 ) final_model.to(device) # GPU로 이동 print(" 모델 로딩 완료.") # 특수 토큰 추가 및 임베딩 리사이즈 (초기 훈련과 동일하게 수행) num_added = final_tokenizer.add_tokens(NEW_SPECIAL_TOKENS) if num_added > 0: final_model.resize_token_embeddings(len(final_tokenizer)) print(f" {num_added}개의 특수 토큰 추가 및 임베딩 리사이즈 완료.") except Exception as e: print(f"❌ 모델 로딩 중 오류 발생: {e}. 재학습을 중단합니다.") # 필요한 경우 여기서 중단 raise e # --- 3. 전체 데이터셋 생성 --- print("\n📚 전체 데이터에 대한 PyTorch 데이터셋 생성 중...") # ReviewDataset 클래스는 이전 셀(ID: 1751489f)에 정의되어 있어야 합니다. full_train_dataset = ReviewDataset( full_train_data["review"], # 합쳐진 데이터의 전처리된 리뷰 사용 full_train_data["label"], # 합쳐진 데이터의 레이블 사용 final_tokenizer, CHOSEN_MAX_LENGTH, ) print(f" 전체 데이터셋 생성 완료: {len(full_train_dataset):,}개") # --- 4. 훈련 설정 (TrainingArguments) 변경 --- # - 검증(evaluation) 비활성화 # - 최적 모델 로딩 비활성화 # - Wandb 로깅 비활성화 (선택 사항) print("\n⚙️ 최종 훈련을 위한 TrainingArguments 설정 중...") final_training_args = TrainingArguments( output_dir=final_output_dir, # 새로운 출력 디렉토리 num_train_epochs=FINAL_TRAIN_EPOCHS, # 결정된 최종 에포크 수 per_device_train_batch_size=FINAL_BATCH_SIZE_TRAIN, # 기존 훈련 배치 크기 gradient_accumulation_steps=FINAL_GRAD_ACCUM_STEPS, # 기존 값 # --- 검증 관련 설정 제거/변경 --- eval_strategy="no", # 검증 안 함 # --- 저장 관련 설정 --- save_strategy="epoch", # 에포크마다 저장 (마지막 모델만 필요하면 "no" 또는 마지막 에포크만 저장) save_total_limit=1, # 마지막 체크포인트만 저장 (필요시 늘림) load_best_model_at_end=False, # 최적 모델 로딩 안 함 (검증 없으므로) metric_for_best_model= None, # --- 기존 하이퍼파라미터 유지 --- warmup_steps=FINAL_WARMUP_STEPS, weight_decay=FINAL_WEIGHT_DECAY, learning_rate=FINAL_LEARNING_RATE, label_smoothing_factor=FINAL_LABEL_SMOOTHING, lr_scheduler_type=FINAL_LR_SCHEDULER, # --- 기타 설정 --- logging_steps=100, # 로그 간격 (데이터 양 고려하여 조정 가능) seed=RANDOM_STATE, # 재현성을 위한 시드 고정 fp16=torch.cuda.is_available(), # FP16 사용 (GPU 사용 시) dataloader_num_workers=2, # 데이터 로더 워커 수 remove_unused_columns=False, # ReviewDataset에서 사용하는 컬럼 유지 save_safetensors=True, # Safetensors 형식으로 저장 권장 logging_first_step=True, report_to="none", # 최종 재학습은 Wandb 로깅 안 함 (선택 사항) # push_to_hub=False, # 허깅페이스 허브 푸시 안 함 ) print(" TrainingArguments 설정 완료.") # --- 5. 최종 Trainer 초기화 --- # - Focal Loss 사용 (CustomTrainerWithFocalLoss 클래스 필요) # - 검증 데이터셋, 메트릭 계산, 콜백 제거 print("\n🔧 최종 Trainer (CustomTrainerWithFocalLoss) 초기화 중...") # CustomTrainerWithFocalLoss 클래스는 이전 셀(ID: eca0c60f)에 정의되어 있어야 합니다. final_trainer = CustomTrainerWithFocalLoss( model=final_model, # 로드된 기반 모델 args=final_training_args, # 최종 훈련 설정 train_dataset=full_train_dataset, # 전체 학습 데이터셋 eval_dataset=None, # 검증 데이터셋 없음 tokenizer=final_tokenizer, # DataCollator에 필요 num_classes=NUM_CLASSES, # 클래스 수 focal_loss_alpha=FINAL_FOCAL_ALPHA, # 기존 Focal Loss alpha focal_loss_gamma=FINAL_FOCAL_GAMMA, # 기존 Focal Loss gamma data_collator=DataCollatorWithPadding(tokenizer=final_tokenizer), # 패딩 처리 compute_metrics=None, # 검증 안 하므로 메트릭 계산 불필요 callbacks=None, # EarlyStopping 등 콜백 제거 ) print(" Trainer 초기화 완료.") # --- 6. 전체 데이터로 재학습 실행 --- print(f"\n💪 전체 데이터로 {FINAL_TRAIN_EPOCHS} 에포크 재학습 시작...") try: train_result = final_trainer.train() print(" 재학습 성공적으로 완료.") print(f" 총 훈련 시간: {train_result.metrics['train_runtime']:.2f}초") print(f" 최종 훈련 손실: {train_result.metrics['train_loss']:.4f}") except KeyboardInterrupt: print("\n⚠️ 사용자에 의해 재학습이 중단되었습니다.") except Exception as e: print(f"\n❌ 재학습 중 오류 발생: {e}") # 필요한 경우 오류 처리 로직 추가 raise e # --- 7. 최종 모델 저장 --- print(f"\n💾 훈련 완료된 최종 모델 저장 중: {final_output_dir}") try: # 기존 디렉토리가 있으면 삭제 (덮어쓰기 위해) if os.path.exists(final_output_dir): print(f" 기존 디렉토리 삭제: {final_output_dir}") shutil.rmtree(final_output_dir) final_trainer.save_model(final_output_dir) # 모델 가중치 및 설정 저장 final_tokenizer.save_pretrained(final_output_dir) # 토크나이저 파일 저장 print(f" 최종 모델 및 토크나이저 저장 완료: {final_output_dir}") # 저장된 파일 확인 if os.path.exists(final_output_dir): saved_files = os.listdir(final_output_dir) print(f" 저장된 파일 목록: {saved_files}") except Exception as e: print(f"❌ 최종 모델 저장 중 오류 발생: {e}") # 필요한 경우 오류 처리 로직 추가 # --- 8. 메모리 정리 --- print("\n🧹 메모리 정리 중...") del final_model del final_tokenizer del final_trainer del full_train_dataset del full_train_data if 'train_result' in globals(): del train_result # 훈련 결과 객체도 삭제 if torch.cuda.is_available(): torch.cuda.empty_cache() print(" GPU 캐시 비움 완료.") print(" 메모리 정리 완료.") print("\n" + "="*60) print("✅ 전체 데이터 재학습 및 최종 모델 저장 완료!") print(f" 최종 모델은 '{final_output_dir}' 경로에 저장되었습니다.") print(" 추론(Inference) 시 이 경로의 모델을 사용하세요.") print("="*60) ``` 각 모델을 이전에 학습하는 train코드와 같은 방식을 공유하되, train, validation 데이터를 나누지 않고 전체 데이터를 사용해서 학습하는 코드를 구현했다. 일반적으로, 가장 성능이 좋았던 모델을 골라서, 다시 전체 데이터로 학습을 해서 제출한다고 한다. 하지만, 시간이 부족해서 다시 모델들을 재학습해보지는 못했다. # 결과 ![image](/assets/images/2025-11-02-15-22-09.png) ![image](/assets/images/2025-11-02-15-22-23.png) ![image](/assets/images/2025-11-02-15-22-29.png) TAPT, FocalLoss의 $\alpha$가중치, SWA할 모델의 수등을 이전의 하이퍼파라미터 튜닝세팅과 다르게 해서인지, 이전에 BERT기반 3개모델을 앙상블했을때보다 성능이 비슷하거나 소폭하락했었다. 따라서 이전에 실험했던 모델들을 최종 제출했고, private score는 0.8301로 Final Leaderboard는 98위로 마무리했다. 첫 경진대회 참여라서 좋은 성과는 내지 못했지만 처음알고, 얻어가는것들이 많은 대회경험이었다. 하이퍼파라미터 튜닝을 하는 도중에 TAPT기법으로 모델성능을 향상시키는 방법을 알게되었고, BackTrainslation을 이용해서 효과적으로 데이터를 증강하거나, 전체 데이터셋을 이용해서 학습해서 성능을 향상해보는 시도들을 추가로 해보고싶었지만, 시간이 부족했었던것 같다. 모든 실험과 시도들을 해볼 수는 없다는것을 깨달았다. 가장 중요한것을 위주로 실험 우선순위를 결정해야하고, 중요한것부터 실험 자동화 스케줄러를 만들어서 24시간 GPU를 굴리는게 중요하다는것을 깨달았다. - 하이퍼파라미터 튜닝은 가장 마지막과정에 시작해서 대회가 끝나기 직전까지 해야한다. 하이퍼파라미터 튜닝을 미리하면, TAPT적용이나, 데이터 증강등을 적용했을때, 최적의 하이퍼파라미터가 다시 달라지게 되므로 또 해야하는 불상사가 생긴다. EDA, FeatureEngineering등 모델링을 사전에 먼저 충분히 진행한 후 대회가 끝나기 직전까지 하이퍼파라미터 튜닝을 해야한다는것을 알게되었다. - 우선 제일먼저 가능한 SOTA모델들을 실험해보고 사용할 모델을 고르자. 그리고 실험 우선순위를 먼저 정하자. 어떤모델을 사용할것인가를 가장 먼저 결정해야 한다. 이번 대회는 5개 모델을 한정적으로 사용헀기 떄문에, 간단했지만, 다른대회에서는 마지막에 앙상블할 모델들을 먼저 선택하고, 해당 모델들에 맞는 하이퍼파라미터 튜닝을 진행해야한다. 그리고 기간내에 모든 실험들을 해볼 수는 없다. 가장 중요한 실험부터 우선순위를 결정하고, 스케줄러를 이용해서 실험관리를 자동화해야한다. 하루에 10번의 제출을 할 수 있었지만, 많은 시도들을 해보지 못한것에 대한 아쉬움이 남는다. ### [영화리뷰 감성분류][모델최적화]하이퍼파라미터 튜닝 - Canonical URL: https://hyejunl33.github.io/projects/2025-10-28-[Domain_Common_Project]Hyperparameter_Tune/ - Collection: Project - Published: 2025-10-28 - Tags: Domain_Common_Project, study, HyperParameterTuning # Introduction ![image](/assets/images/2025-10-28-10-28-11.png) 이전모델에서 FocalLoss를 추가하고 Learning rate scheduler를 “cosine”으로 바꾸고, `label_smoothing`을 적용하고, `weight_decay`값을 키워봤다. regularizastion방법을 썼기떄문에, 에폭을 늘려서 학습해도 될것같아서, 에폭을 기존 5에서 8로 늘렸다. ![image](/assets/images/2025-10-28-10-28-25.png) 그 결과 TrainingLoss는 줄어들지면 ValidationLoss는 줄어들지 않는 과적합이 일어났다. 우선 `EarlystoppingPatience`를 3으로 설정했지만 기준을 Accuracy로 잡아서 validation Acc가 증가하는 이상 Early stopping은 적용되지 않았다. 따라서 이번에는 Early stopping기준을 Validation Loss로 잡을 예정이다. 이를 통해 Overfitting을 막을 생각이다. 그리고 하이퍼 파라미터 튜닝을 통해 최적의 `Weight_decay`값, `label_smoothing`값, 그리고 이전에는 적용하지 않았던 `drop_out` 비율까지 찾을 예정이다. 그 외에도 최적의 에폭 수, `Learningrate_scheduler_type` 등 다양한 하이퍼파라미터를 config에 넣어서 최적의 하이퍼 파라미터를 찾을 예정이다. 하이퍼파라미터 튜닝은 Evaluation/Loss를 기준으로 하기때문에, 최대한 Overfitting을 막는 방향으로 하이퍼파라미터 튜닝을 진행할 예정이다. 그리고 이후에 Back Translation을 통한 데이터 증강, 확률적 가중치 평균 (Stochastic Weight Averaging - SWA) 기법을 이용해서 조금더 일반화 성능을 늘려볼 예정이다. 그리고 `kykim/bert-kor-base` 모델이 단일모델로서는 성능이 가장 잘 나온다고 한다. 이 모델을 이용해서 학습을 돌려볼 예정이다. # 하이퍼파라미터 튜닝 ```python # === 훈련 함수 정의 === def train(): # --- 1. W&B Run 초기화 --- os.environ["WANDB_SILENT"] = "true" run = wandb.init(project="klue-bert-sweep-movie-review") config = wandb.config # --- 2. 시드 설정 --- set_seed(RANDOM_STATE) # --- 3. 데이터 전처리 (train 함수 내부에서 실행) --- print(f"Run {run.name}: Preprocessor 생성 (희귀 단어 제거: {config.num_rare_words_to_remove}개)") # 각 run마다 config 값으로 preprocessor 생성 preprocessor = TextPreprocessingPipeline(num_rare_words_to_remove=int(config.num_rare_words_to_remove)) # 원본 훈련 데이터로 fit_transform 수행 print(f"Run {run.name}: 훈련 데이터 전처리 (fit & transform)...") X_train_processed = preprocessor.fit_transform(X_train_orig.tolist(), y_train_orig.tolist()) # 원본 검증 데이터로 transform 수행 print(f"Run {run.name}: 검증 데이터 전처리 (transform)...") X_val_processed = preprocessor.transform(X_val_orig.tolist()) # DataFrame 형태로 변환 (Dataset 클래스 입력용) train_data = pd.DataFrame( {"ID": ids_train_orig.values, "review": X_train_processed, "label": y_train_orig.values} ) val_data = pd.DataFrame( {"ID": ids_val_orig.values, "review": X_val_processed, "label": y_val_orig.values} ) # print(f"Run {run.name}: 데이터 전처리 완료. 훈련: {len(train_data)}, 검증: {len(val_data)}") # Sweep 중 출력 최소화 # --- 4. 모델 및 토크나이저 로드 --- tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME) num_added_toks = tokenizer.add_tokens(NEW_SPECIAL_TOKENS) model = AutoModelForSequenceClassification.from_pretrained( MODEL_NAME, num_labels=NUM_CLASSES, hidden_dropout_prob=config.dropout_rate, attention_probs_dropout_prob=config.dropout_rate ) model.resize_token_embeddings(len(tokenizer)) device = torch.device("cuda" if torch.cuda.is_available() else "cpu") model.to(device) # --- 5. 데이터셋 생성 --- train_dataset = ReviewDataset( train_data["review"], # 전처리된 텍스트 사용 train_data["label"], tokenizer, CHOSEN_MAX_LENGTH, ) val_dataset = ReviewDataset( val_data["review"], # 전처리된 텍스트 사용 val_data["label"], tokenizer, CHOSEN_MAX_LENGTH, ) # --- 6. TrainingArguments 설정 --- output_dir = os.path.join("./results", run.name) training_args = TrainingArguments( output_dir=output_dir, num_train_epochs=int(config.num_train_epochs), per_device_train_batch_size=int(config.per_device_train_batch_size), per_device_eval_batch_size=128, # 평가 배치는 고정 또는 Sweep 파라미터로 추가 warmup_steps=int(config.warmup_steps), weight_decay=config.weight_decay, learning_rate=config.learning_rate, label_smoothing_factor=config.label_smoothing_factor, logging_steps=100, eval_strategy="epoch", save_strategy="epoch", load_best_model_at_end=True, metric_for_best_model="eval_loss", # 검증 손실 기준 greater_is_better=False, # 손실은 낮을수록 좋음 save_total_limit=1, report_to="wandb", run_name=run.name, seed=RANDOM_STATE, fp16=torch.cuda.is_available(), dataloader_num_workers=0, # DataLoader 워커 오류 방지 위해 0으로 설정 remove_unused_columns=False, lr_scheduler_type=config.lr_scheduler_type, # Sweep 값 사용 gradient_accumulation_steps=int(config.gradient_accumulation_steps), # Sweep 값 사용 logging_first_step=True, disable_tqdm=True, # 진행률 표시줄 비활성화 ) # --- 7. EarlyStopping 설정 --- # TrainingArguments에서 patience를 직접 설정할 수 없으므로 Callback 사용 # Sweep config에서 patience 값을 가져오도록 수정 early_stopping_callback = EarlyStoppingCallback( early_stopping_patience=3 # 고정값 사용 (또는 sweep_config에 추가하고 config.early_stopping_patience 사용) # early_stopping_threshold=0.001 # 필요시 설정 ) # --- 8. Trainer 초기화 --- trainer = CustomTrainerWithFocalLoss( model=model, args=training_args, train_dataset=train_dataset, eval_dataset=val_dataset, tokenizer=tokenizer, num_classes=NUM_CLASSES, focal_loss_alpha=[0.11, 0.45, 0.12, 0.32], # 알파는 고정 focal_loss_gamma=config.focal_loss_gamma, # Sweep 값 사용 callbacks=[early_stopping_callback], data_collator=DataCollatorWithPadding(tokenizer=tokenizer), compute_metrics=compute_metrics, ) # --- 9. 훈련 실행 --- try: # print(f"Run {run.name}: 훈련 시작...") # Sweep 중 출력 최소화 trainer.train() # print(f"Run {run.name}: 훈련 완료.") # Sweep 중 출력 최소화 except Exception as e: print(f"Run {run.name}: 훈련 중 오류 발생: {e}") wandb.finish(exit_code=1) raise # --- 10. W&B Run 종료 --- wandb.finish() # === Sweep 설정 === sweep_config = { 'method': 'bayes', 'metric': { 'name': 'eval/loss', 'goal': 'minimize' }, 'parameters': { 'learning_rate': { 'distribution': 'log_uniform_values', 'min': 1e-6, 'max': 5e-5 }, 'num_train_epochs': { 'values': [5, 8, 10, 12] }, 'weight_decay': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.1 }, 'per_device_train_batch_size': { 'values': [64, 128, 256] }, 'warmup_steps': { 'distribution': 'q_uniform', 'min': 100, 'max': 1000, 'q': 50 }, 'focal_loss_gamma': { 'distribution': 'uniform', 'min': 1.0, 'max': 3.0 }, 'label_smoothing_factor': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.2 }, 'dropout_rate': { 'distribution': 'uniform', 'min': 0.05, 'max': 0.3 }, 'lr_scheduler_type': { 'values': ['cosine', 'linear', 'constant'] }, 'gradient_accumulation_steps': { 'values': [1, 2, 4] }, 'num_rare_words_to_remove': { 'values': [0, 3, 5, 10] } # 추가됨 } } # === W&B Sweep 초기화 및 에이전트 실행 === # wandb 로그인 필요 # !wandb login your_api_key sweep_id = wandb.sweep(sweep_config, project="klue-bert-sweep-movie-review") print(f"Sweep ID: {sweep_id}") # 에이전트 실행 (20번 시도) wandb.agent(sweep_id, function=train, count=20) print("W&B Sweep 완료!") ``` ```python sweep_config = { 'method': 'bayes', 'metric': { 'name': 'eval/loss', 'goal': 'minimize' }, 'parameters': { 'learning_rate': { 'distribution': 'log_uniform_values', 'min': 1e-6, 'max': 5e-5 }, 'num_train_epochs': { 'values': [5, 8, 10, 12] }, 'weight_decay': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.1 }, 'per_device_train_batch_size': { 'values': [64, 128, 256] }, 'warmup_steps': { 'distribution': 'q_uniform', 'min': 100, 'max': 1000, 'q': 50 }, 'focal_loss_gamma': { 'distribution': 'uniform', 'min': 1.0, 'max': 3.0 }, 'label_smoothing_factor': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.2 }, 'dropout_rate': { 'distribution': 'uniform', 'min': 0.05, 'max': 0.3 }, 'lr_scheduler_type': { 'values': ['cosine', 'linear', 'constant'] }, 'gradient_accumulation_steps': { 'values': [1, 2, 4] }, 'num_rare_words_to_remove': { 'values': [0, 3, 5, 10] } # 추가됨 } } ``` `config` 를 보면 알 수 있듯이 베이지안 방식으로 learning rate, 에폭 수, weight_decay, 배치사이즈, warmup_step등등을 하이퍼파라미터로 넣어주었다. 이때 이번 실험에서의 목표가 과적합을 막는것이었으므로 Validation/loss를 metric으로 삼고, 이를 minimize하는것을 goal로 설정했다. 따라서 validation loss가 earlystopping patience를 넘는다면 바로 조기종료 될 것이다. 하이퍼파라미터 튜닝을 16번의 step을 거쳐서 진행했다. 원래는 20번으로 실행했는데, 28시간째에, 다른실험도 해봐야해서 일단 Interupt를 했다.. ![image](/assets/images/2025-10-28-10-29-03.png) eval/accuracy를 기준으로 상위 5개를 시각화했다. 보라색이 가장 acc가 높아보이지만,validation loss가 불안정하게 커지므로, 과적합되었다고 볼 수 있다. 따라서 그 다음으로 acc가 높은 ancient-sweep-13 하이퍼파라미터를 사용하기로 했다. 최적의 하이퍼파라미터는 모델의 아키텍처마다 다르다고 한다. 따라서 원래는 5개의 모델을 모두 앙상블할 예정이었지만, `klue/bert-base` 모델로 하이퍼파라미터 튜닝을 했으므로, BERT기반 3개로만 앙상블해서 추론한 결과와 5개 모델 전부 같은 하이퍼파라미터를 이용해서 학습한 후 추론한 결과를 비교해볼 예정이다. # 모델 앙상블 모델 앙상블은 학습을 각각의 모델 따로따로 진행해준 후, 추론파트에서 각각의 모델을 불러와서 softVoting방식으로 레이블을 판단한다. ```python # === Ensemble Training Block === # Replace the original training cell (ID: 176174ee) with this code. # --- Model Training Settings --- SAVE_MODEL = True USE_WANDB = True # Set to True if you want to use Weights & Biases logging for each model from transformers import EarlyStoppingCallback # List of models for ensemble model_names = [ # "klue/roberta-base", "klue/bert-base", "kykim/bert-kor-base", "beomi/kcbert-base" # "monologg/koelectra-base-v3-discriminator" ] # --- Loop through each model for training --- all_training_results = {} for model_name in model_names: model_short_name = model_name.split('/')[-1].replace('-', '_') # Create a short name for directories/logging output_dir = f"./results_{model_short_name}" run_name = f"{model_short_name}-movie-review" print("\n" + "=" * 50) print(f"모델 훈련 시작: {model_name}") print(f"결과 저장 경로: {output_dir}") print("=" * 50) # --- Load Model and Tokenizer for the current model --- try: current_tokenizer = AutoTokenizer.from_pretrained(model_name) current_model = AutoModelForSequenceClassification.from_pretrained( model_name, num_labels=NUM_CLASSES, ) current_model.to(device) # Move model to GPU # --- Add new special tokens and resize embeddings --- num_added_toks = current_tokenizer.add_tokens(NEW_SPECIAL_TOKENS) if num_added_toks > 0: print(f"Added {num_added_toks} new special tokens for {model_name}.") current_model.resize_token_embeddings(len(current_tokenizer)) print("Resized model token embeddings.") except Exception as e: print(f"Error loading model {model_name}: {e}") print("Skipping this model.") continue # Skip to the next model if loading fails # --- Recreate Datasets with the current tokenizer --- # This is necessary because different models might have different tokenization train_dataset_current = ReviewDataset( train_data["review"], train_data["label"], current_tokenizer, CHOSEN_MAX_LENGTH, ) val_dataset_current = ReviewDataset( val_data["review"], val_data["label"], current_tokenizer, CHOSEN_MAX_LENGTH, ) # --- Training Arguments for the current model --- training_args = TrainingArguments( output_dir=output_dir, num_train_epochs=NUM_EPOCHS, per_device_train_batch_size=BATCH_SIZE_TRAIN, per_device_eval_batch_size=BATCH_SIZE_EVAL, warmup_steps=WARMUP_STEPS, weight_decay=WEIGHT_DECAY, learning_rate=LEARNING_RATE, logging_steps=100, eval_strategy="epoch", save_strategy="epoch" if SAVE_MODEL else "no", load_best_model_at_end=SAVE_MODEL, metric_for_best_model= "eval_loss" if SAVE_MODEL else None, greater_is_better=False, save_total_limit=1 if SAVE_MODEL else 0, # Save only the best model label_smoothing_factor=0.18547040498752376, report_to="wandb" if USE_WANDB else "none", run_name=run_name if USE_WANDB else None, seed=RANDOM_STATE, fp16=torch.cuda.is_available(), dataloader_num_workers=2, remove_unused_columns=False, push_to_hub=False, gradient_accumulation_steps=4, logging_first_step=True, save_safetensors=SAVE_MODEL, lr_scheduler_type= "constant", # early_stopping_patience=3, # Keep early stopping if desired # early_stopping_threshold=0.001, ) early_stopping_callback = EarlyStoppingCallback(early_stopping_patience=3) # <--- 원하는 patience 값 # --- Initialize Trainer for the current model --- trainer = CustomTrainerWithFocalLoss( model=current_model, args=training_args, train_dataset=train_dataset_current, eval_dataset=val_dataset_current, tokenizer=current_tokenizer, num_classes=NUM_CLASSES, callbacks=[early_stopping_callback], focal_loss_alpha=[0.11, 0.45, 0.12, 0.32], # Adjust alpha if needed focal_loss_gamma=2.965201490877045, data_collator=DataCollatorWithPadding(tokenizer=current_tokenizer), compute_metrics=compute_metrics, ) # --- Training Execution --- print(f"훈련 정보 ({model_name}):") print(f" 훈련 샘플: {len(train_dataset_current):,}개") print(f" 검증 샘플: {len(val_dataset_current):,}개") print(f" 훈련 에포크: {training_args.num_train_epochs}회") print(f" 배치 크기: {BATCH_SIZE_TRAIN} (훈련) / {BATCH_SIZE_EVAL} (검증)") print(f" 학습률: {LEARNING_RATE}") print(f" 시드값: {RANDOM_STATE}") print(f" 디바이스: {device}") print(f" wandb 사용: {USE_WANDB}") try: training_result = trainer.train() print(f"\n{model_name} 훈련 완료") print(f" 최종 훈련 손실: {training_result.training_loss:.4f}") all_training_results[model_name] = training_result # --- Save the final best model --- if SAVE_MODEL: best_model_path = f"{output_dir}/best_model_{model_short_name}" print(f"최종 베스트 모델 저장 중: {best_model_path}") trainer.save_model(best_model_path) current_tokenizer.save_pretrained(best_model_path) print(f"최종 베스트 모델 저장 완료: {best_model_path}") except KeyboardInterrupt: print(f"\n사용자에 의해 {model_name} 훈련이 중단되었습니다.") # Optionally break the loop if one model training is interrupted # break except Exception as e: print(f"\n{model_name} 훈련 중 오류 발생: {str(e)}") # Optionally log the error and continue with the next model # continue # --- Clean up GPU memory before next model --- del current_model del current_tokenizer del trainer if torch.cuda.is_available(): torch.cuda.empty_cache() print("\n" + "=" * 50) print("모든 모델 훈련 완료!") print("=" * 50) ``` 훈련코드는 각각의 훈련과정에서 데이터누수를 막기위해 토크나이저와 모델을 따로 불러온 후, fit과 transform을 따로 진행해준다. 그리고 이전의 baseline code에서처럼 학습을 진행해준다. ```python # === Ensemble Inference Block === # Replace the original inference cell (ID: 079c8f40) with this code. import torch import numpy as np import os from tqdm.auto import tqdm # Import tqdm for progress bar from transformers import AutoTokenizer, AutoModelForSequenceClassification, Trainer, TrainingArguments, DataCollatorWithPadding print(f"현재 디바이스: {device}") # --- Load Test Data --- df_test = pd.read_csv("data/test.csv") print(f"테스트 데이터 로드 완료: {len(df_test)} 샘플") # --- Apply Preprocessing --- # Use the 'preprocessor' instance fitted during training print("테스트 데이터에 전처리 파이프라인 적용 중...") test_texts = df_test["review"].tolist() # Use transform only, assumes preprocessor is already fitted test_processed = preprocessor.transform(test_texts) print("테스트 데이터 전처리 완료") # --- List of Trained Model Paths --- # Ensure these paths match where models were saved in the training block model_paths = [ f"./results_{model_name.split('/')[-1].replace('-', '_')}/best_model_{model_name.split('/')[-1].replace('-', '_')}" for model_name in model_names # Use the same model_names list from training ] # --- Ensemble Inference --- all_logits = [] print("\n" + "=" * 50) print("앙상블 추론 시작...") print("=" * 50) for model_path in tqdm(model_paths, desc="모델별 추론 진행"): if not os.path.exists(model_path): print(f"Warning: 모델 경로를 찾을 수 없습니다: {model_path}. 이 모델을 건너뜁니다.") continue print(f"\n모델 로딩: {model_path}") try: # Load tokenizer and model for the current path current_tokenizer = AutoTokenizer.from_pretrained(model_path) current_model = AutoModelForSequenceClassification.from_pretrained(model_path) current_model.to(device) current_model.eval() # Create test dataset with the current tokenizer test_dataset_current = ReviewDataset( pd.Series(test_processed), # Pass processed text as a Series None, # No labels for test set current_tokenizer, CHOSEN_MAX_LENGTH ) # Define minimal TrainingArguments for prediction temp_output_dir = f"./temp_prediction_{os.path.basename(model_path)}" predict_args = TrainingArguments( output_dir=temp_output_dir, per_device_eval_batch_size=BATCH_SIZE_EVAL * 2, # Increase batch size for faster inference dataloader_num_workers=2, remove_unused_columns=False, # Keep columns needed by dataset fp16=torch.cuda.is_available(), logging_steps=len(test_dataset_current) // (BATCH_SIZE_EVAL * 2) + 1 # Reduce logging ) # Initialize Trainer for prediction pred_trainer = Trainer( model=current_model, args=predict_args, tokenizer=current_tokenizer, data_collator=DataCollatorWithPadding(tokenizer=current_tokenizer), ) # Get predictions (logits) print(f"모델 추론 중: {model_path}") predictions = pred_trainer.predict(test_dataset_current) logits = predictions.predictions # Logits are in predictions.predictions all_logits.append(logits) print(f"모델 추론 완료: {model_path}") # Clean up memory del current_model del current_tokenizer del pred_trainer if torch.cuda.is_available(): torch.cuda.empty_cache() # Clean up temporary directory import shutil if os.path.exists(temp_output_dir): shutil.rmtree(temp_output_dir) except Exception as e: print(f"Error during inference for model {model_path}: {e}") # Decide whether to continue or stop if one model fails # continue # --- Averaging Logits --- if not all_logits: raise ValueError("추론 결과가 없습니다. 모델 경로 또는 추론 과정을 확인하세요.") print("\n로짓(logits) 평균 계산 중...") # Convert list of numpy arrays to a numpy array for easier calculation all_logits_np = np.array(all_logits) # Calculate the average logits across models (axis=0) average_logits = np.mean(all_logits_np, axis=0) print(f"평균 로짓 계산 완료. 형태: {average_logits.shape}") # --- Final Prediction --- predicted_labels = np.argmax(average_logits, axis=1) print(f"최종 예측 레이블 생성 완료: {len(predicted_labels)}개") # --- Add predictions to the test DataFrame --- df_test["pred"] = predicted_labels print(f"\ndf_test에 pred 컬럼이 추가되었습니다. 형태: {df_test.shape}") # --- Analyze Prediction Distribution --- unique_predictions, counts = np.unique(predicted_labels, return_counts=True) print("\n최종 예측 분포:") for pred, count in zip(unique_predictions, counts): percentage = (count / len(predicted_labels)) * 100 class_name = LABEL_MAPPING.get(pred, f"클래스 {pred}") print(f" {class_name} ({pred}): {count:,}개 ({percentage:.1f}%)") print("\n" + "=" * 50) print("앙상블 추론 완료!") print("=" * 50) # GPU 메모리 정리 if torch.cuda.is_available(): torch.cuda.empty_cache() ``` 이후 진행하는 inferece단계에서는 각 모델에서의 logit을 계산한 후 soft voting방식으로 레이블을 예측한다. # 결과 ### BERT기반 모델 3개를 앙상블한 결과 ![image](/assets/images/![image.png](image%203.png).png) BERT기반 모델 3개를 앙상블한결과를 SWA-1,2,3에 따라 나눈 결과이다. 총 에폭수가 5였으므로 3은 너무많고, 1은 너무적어서 SWA는 2가 최적이었던것 같다. 다만 지금까지 모델에 여러가지 튜닝을 해왔음에도 test/acc성능이 나오지 않는것은, 이유를 생각해봐야겠다. ![image](/assets/images/2025-10-28-10-30-09.png) ![image](/assets/images/2025-10-28-10-30-14.png) 추정컨데, 모델에 적용한, 앙상블, 하이퍼파라미터 튜닝을 통한 정규화, Focal Loss는 일반적으로 모델의 성능을 Rubust하게 만들어준다. 하지만 test/acc만이 평가 metric인 이상, 결국에 test/acc성능이 좋아야한다. 지금까지의 코드는 과적합을 막기위해 bestmodel선정을 valid/loss가 최소화된 모델을 선택했다. 그런데, 결국에는 acc성능이 평가 metric이기 때문에, acc를 기준으로 체크포인트를 선택해서 SWA를 해야하는게 아닌가 생각이 든다. 물론 valid/loss가 폭발하지 않는 선에서, 즉 과적합 되지 않는 선에서 정리를 해야한다. 그리고 Focal Loss의 $\alpha$가중치가 소수클래스에 대해 너무 큰 가중치를 주는게 아닌가 생각이 든다. test 데이터의 분포는 알 수 없지만, 일반적으로 80% acc를 갖는 모델의 예측분포는 전체 데이터셋의 분포와 유사한 분포를 띠고있다. 따라서 stratify된 분포를 갖지 않을까 추측해본다. 만약 전체 데이터셋의 분포와 같다면 강한 부정, 약한 긍정(다수클래스)은 훨씬 덜 선택하고 있는거고, 강한긍정, 약한부정(소수클래스) 는 오히려 정답레이블보다 많이 선택하고 있음을 확인할 수 있다. 따라서 Focal Loss의 가중치를 아예 1로 두고 실험을 해보고, test데이터셋의 분포를 더 추론해보고 acc의 성능을 파악해봐야겠다. # 이후 실험에서 다뤄야 할것들 - base모델 바꿔서 하이퍼파라미터 튜닝 - SWA 구현해서 SWA횟수를 하이퍼파라미터로 넣기 - 데이터증강 실험해보고 효과 있으면 이것도 하이퍼파라미터로 넣기 - TAPT적용 - Boosting-adaboost staking구현 → 기존 코드에 implementation - acc만이 평가지표로 활용된다. acc를 올릴 수 있는방법.. → 너무 많은 정규화를 하면 안되는걸까? ### [영화리뷰 감성분류][모델최적화]-커스텀토크나이저 - Canonical URL: https://hyejunl33.github.io/projects/2025-10-25-[Domain_Common_Project]Custom_Tokenizer/ - Collection: Project - Published: 2025-10-26 - Tags: Domain_Common_Project, study, CustomTokenizer, Experiments # Introduction 이전모델에서는 커스텀토크나이저를 사용해서 특수토큰을 사용해봤고, Weighted Cross Entropy를 구현했고, Stratified K-Fold Cross Validation를 구현했는데 Accuracy가 0.79근방이 나왔다. 대체 뭐가 성능하락을 야기했을까? 나머지 요인들은 통제변인으로 설정하고 하나씩 실험해보며, 성능향상에 기여하는것들을 찾아나가야겠다. 그 첫 여정이 커스텀토크나이저다. 직관적으로 커스텀 토크나이저를 사용하면 OOV문제를 더 많이 해결할 수 있고 [UNK]토큰이 줄어들것이므로 모델은 더 문맥을 잘 이해할 것이다. 다만 어떻게 토큰을 설정하고 추가해주고, 매핑해줄것인지는 전적으로 개발자인 나에게 달려있기 때문에 데이터셋의 특징과 분포를 잘 파악하고 커스텀 토크나이저를 실험해보며 처리해봐야겠다. 그 다음은 불용어 처리이다. 이전 모델에서 데이터셋을 확인해본 결과 ‘진짜’,’정말’같은 강조를 하는 단어들은 레이블과 상관없이 모든레이블에서 자주 등장하는 단어였다. 따라서 이러한 단어들을 베이스라인코드에서는 불용어처리가 되어있었는데, 불용어처리를 해제하는게 나은지, 혹은 불용어처리를 하는게 나은지 실험을 해볼 예정이다. ![image](/assets/images/2025-10-26-12-30-51.png) BaseLine코드대로 모델을 돌리면 ACC는 0.8이 나온다. 이는 커스텀 토크나이저도 사용하지 않았고, 불용어처리도 최대한 많은 단어들을 처리한 결과이다. 이번 실험을 통해 이를 뛰어넘을 수 있을지, 혹은 성능을 올릴 수 있는 방안은 무엇인지 찾는게 목표이다. # 불용어처리 - 통제변인: 불용어리스트를 제외한 나머지 (하이퍼파라미터, 모델 등등) - 조작변인: 불용어리스트(불용어리스트를 전부 주석처리했음.) ![image](/assets/images/2025-10-26-12-36-10.png) 우선 EDA결과 문제가 있는 데이터의 비율은 1.63%로 전체 데이터에 비하면 적은양임을 알 수 있다. 따라서 모델학습의 안정성을 위해 문제가 있는 데이터들은 최대한 노이즈처리하고 제거를 하고 시작을 한다. ```python # 한국어 불용어 리스트 확장 stopwords = [ "은", "는", "이", "가", "을", "를", "의", "에", "와", "과", "도", "로", "으로", "에서", "한", "그", "것", "그것", "이것", "저것", "그리고", "그런데", "하지만", "그러나", "있다", "없다", "되다", "하다", "이다", "아니다", "같다", "많다", "좋다", "나쁘다", "수", "때", "곳", "사람", "것들", "정말", "너무", "매우", "아주", "참", "좀", ] ``` BaseLinecode에서는 상당수의 단어들을 불용어처리하고 시작한다. 하지만 BERT기반 모델들은 트렌스포머 기반모델이므로 문맥 자체를 학습한다. 따라서 조사나 어미등을 포함해 자연스러운 문장구조를 유지하는게 성능향상에 도움이 된다고 한다. 그리고 어차피 Self-Attention단계에서 조사나 어미는 낮은 Attention Score를 받게되므로 모델이 스스로 무시할 수 있다. 따라서 이번실험에서는 BERT기반 모델을 사용하므로 **불용어리스트를 아예 제거한다.** ```python # 클래스별 공통 키워드 분석 print("\n클래스별 상위 빈출 단어 (불용어 포함):") # 한국어 불용어 리스트 확장 stopwords = [ # "은", # "는", # "이", # "가", # "을", # "를", # "의", # "에", # "와", # "과", # "도", # "로", # "으로", # "에서", # "한", # "그", # "것", # "그것", # "이것", # "저것", # "그리고", # "그런데", # "하지만", # "그러나", # "있다", # "없다", # "되다", # "하다", # "이다", # "아니다", # "같다", # "많다", # "좋다", # "나쁘다", # "수", # "때", # "곳", # "사람", # "것들", # "정말", # "너무", # "매우", # "아주", # "참", # "좀", ] for class_name in sorted(df["label"].unique()): class_data = df[df["label"] == class_name] all_text = " ".join(class_data["review"].astype(str)) # 단어 추출 및 필터링 (길이 2 이상, 불용어 제외) words = [ word for word in all_text.split() if word not in stopwords and len(word) >= 2 and word.isalpha() ] # 단어 빈도 계산 word_counts = Counter(words) top_words = word_counts.most_common(10) # 상위 10개로 지정 print( f"\n{class_name} ({LABEL_MAPPING[class_name]}) - 총 {len(class_data)}개 샘플:" ) for i, (word, count) in enumerate(top_words, 1): percentage = (count / len(words)) * 100 if len(words) > 0 else 0 print(f" {i:2d}. '{word}': {count}회 ({percentage:.1f}%)") ``` ```python 0 (강한 부정) - 총 114066개 샘플: 1. '너무': 106022회 (3.2%) 2. '진짜': 82753회 (2.5%) 3. '보는': 55270회 (1.7%) 4. '정말': 52786회 (1.6%) 5. '이런': 52545회 (1.6%) 6. '영화': 49829회 (1.5%) 7. '영화는': 44978회 (1.4%) 8. '보고': 44776회 (1.4%) 9. '영화를': 40348회 (1.2%) 10. '내내': 39208회 (1.2%) 1 (약한 부정) - 총 27216개 샘플: 1. '너무': 16454회 (2.2%) 2. '보고': 10499회 (1.4%) 3. 'ㅠㅠ': 8538회 (1.1%) 4. '뭔가': 7251회 (1.0%) 5. '영화': 7061회 (0.9%) 6. '보는': 6857회 (0.9%) 7. '진짜': 6833회 (0.9%) 8. '정말': 6658회 (0.9%) 9. '그냥': 6467회 (0.9%) 10. '영화는': 6200회 (0.8%) 2 (약한 긍정) - 총 99416개 샘플: 1. '진짜': 60021회 (2.3%) 2. '정말': 56003회 (2.1%) 3. '너무': 45092회 (1.7%) 4. '영화': 34369회 (1.3%) 5. '보는': 29527회 (1.1%) 6. '특히': 28620회 (1.1%) 7. '영화는': 26255회 (1.0%) 8. '내내': 22921회 (0.9%) 9. '영화를': 20993회 (0.8%) 10. '보고': 19278회 (0.7%) 3 (강한 긍정) - 총 38952개 샘플: 1. '진짜': 46041회 (4.4%) 2. '정말': 24398회 (2.3%) 3. '너무': 22577회 (2.2%) 4. '영화': 17807회 (1.7%) 5. '영화는': 15968회 (1.5%) 6. '보는': 12402회 (1.2%) 7. '특히': 11121회 (1.1%) 8. '내내': 10439회 (1.0%) 9. '보고': 9783회 (0.9%) 10. '영화를': 9369회 (0.9%) ``` 불용어리스트를 아예 주석처리한 후 클래스별 상위 빈출단어를 보면 0,1,2,3 모든 레이블의 5등안에 ‘너무’,’진짜’,’정말’이라는 단어가 포함됨을 알 수 있다. 그렇다면 모든 레이블에 이러한 단어들이 자주 등장하니깐, 모델은 오히려 ‘너무’같은 단어가 등장하면 레이블을 헷갈려 하진 않을까? BERT기반 모델은 BIdirectional 학습을 통해 forward방향, backward방향 두방향 모두 학습한다. 그리고 Attention을 통해 다른 단어들과 병렬적으로 연관성을 학습한다. 따라서 ‘너무’라는 단어만 보고 모델은 헷갈려 하지 않고, ‘너무’ + ‘좋다’ 혹은 ‘너무’+’별로다’처럼 맥락을 학습하고, 맥락에 따라 레이블을 prediction할 수 있게 된다. 따라서 불용어처리를 오히려 하지 않는게 모델성능향상에 도움이 되겠다고 생각했다. ![image](/assets/images/2025-10-26-12-35-50.png) 불용어를 처리하지 않은 모델은 BaseLine Code모델에 비해 0.0005 acc가 하락했다. 사실상 오차범위안이라서, 불용어를 처리하는지 안하는지는 모델에 큰 의미가 없는것 같다. # 커스텀토크나이저 - 통제변인: 토크나이저와 텍스트 전처리를 제외한 나머지 요인(하이퍼파라미터, 모델등) - 조작변인:토크나이저 커스텀(특수토큰 추가), 텍스트 전처리 과정 변경, 토크나이저 `max_length=256`으로 변경 ![image](/assets/images/2025-10-26-12-35-44.png) 기존의 전처리 과정에서는 “ㅋㅋㅋㅋㅋ”같이 자음이 하나만 반복되는것들을 정규식을 이용해서 모두 제거해버렸다. 그래서 ‘ㅋㅋㅋㅋ’가 전처리를 거친 후 사라진것을 볼 수 있고 ‘ㄷㄷㄷ’도 마찬가지이다. 이러한 한글로 감정을 나타내는 문자들은 없애면 안되고, 정규화를 해서, 특수토큰으로 치환해야한다. ### 텍스트 전처리 ```python # 기본 텍스트 정리 함수 def clean_text(text): """ 한국어 텍스트를 위한 기본 텍스트 정리 함수 전처리 단계: 1. 불완전한 한글 제거 (자음/모음만 있는 경우) 2. 반복되는 감정 표현 정규화 (ㅋㅋㅋ, ㅠㅠㅠ 등) 3. 과도한 문자 반복 축소 (4번 이상 → 3번으로) 4. 특수문자 제거 (한글, 숫자, 기본 구두점, 감정표현 제외) 5. 공백 정규화 """ if pd.isna(text): return "" text = str(text).strip() # 한국어 특화 전처리 # 1. 감정 표현 정규화 (먼저 수행) text = re.sub(r"([ㅋㅎ])\1{2,}", r"\1\1", text) # ㅋㅋㅋ+ → ㅋㅋ text = re.sub(r"([ㅠㅜㅡ])\1{2,}", r"\1\1", text) # ㅠㅠㅠ+ → ㅠㅠ # 2. 과도한 문자 반복 축소 (4번 이상 → 3번으로) text = re.sub(r"(.)\1{3,}", r"\1\1\1", text) # 3. 불완전한 한글 제거 (ㅋ,ㅎ,ㅠ,ㅜ,ㅡ는 확실히 제외하고 제거) # 제거할 자음/모음 목록 명시적 정의 (ㅋ,ㅎ,ㅠ,ㅜ,ㅡ 제외) unwanted_korean = r"[ㄱㄲㄴㄷㄸㄹㅁㅂㅃㅅㅆㅇㅈㅉㅊㅌㅍ]|[ㅏㅐㅑㅒㅓㅔㅕㅖㅗㅘㅙㅚㅛㅣㅢㅟㅣ]" # <-- 수정된 부분! text = re.sub(unwanted_korean, "", text, flags=re.IGNORECASE) # 4. 불필요한 특수문자 제거 (Blacklist 방식, 이모지 유지) # 제거 대상: _normalize_text에서 처리되지 않는 일부 기호들. 필요에 따라 추가/삭제 가능 # (예: 괄호 (), 꺽쇠 <>, 콜론 :, 작은따옴표 ', 큰따옴표 ", ` 등) # \w(알파벳,숫자,_), \s(공백), 가-힣(한글), .,!;?~-(기본구두점), ㅋㅎㅠㅜㅡ(감정표현) 및 이모지는 유지됨. noise_chars = r"[#*•■◆◇□○●※+=/\\%&{}$₩€£¥|`→←↑↓▶◀△▽“”‘’『』「」^±§ⓒ®™]" # <-- 확장된 노이즈 리스트 text = re.sub(noise_chars, " ", text) text = re.sub(r"\s+", " ", text) # 다중 공백을 단일 공백으로 return text.strip() print("텍스트 전처리 과정 시작") print("=" * 50) initial_size = len(df_processed) print(f"초기 데이터 크기: {initial_size:,}개") # 1단계: 텍스트 정리 적용 print("\n1단계: 기본 텍스트 정리 수행 중...") df_processed["review_cleaned"] = df_processed["review"].apply(clean_text) print("✓ 한글 자음/모음 정리, 반복 표현 정규화, 특수문자 제거 완료") # 2단계: 빈 텍스트 제거 print("\n2단계: 빈 텍스트 제거 중...") empty_count = df_processed["review_cleaned"].str.strip().eq("").sum() if empty_count > 0: df_processed = df_processed[df_processed["review_cleaned"].str.strip() != ""] print(f"✓ 빈 텍스트 {empty_count}개 제거") else: print("✓ 빈 텍스트 없음") # 3단계: 중복 제거 print("\n3단계: 중복 데이터 제거 중...") duplicates_count = df_processed.duplicated(subset=["review_cleaned", "label"]).sum() if duplicates_count > 0: df_processed = df_processed.drop_duplicates(subset=["review_cleaned", "label"]) print(f"✓ 중복 데이터 {duplicates_count}개 제거") else: print("✓ 중복 데이터 없음") # 최종 결과 요약 final_size = len(df_processed) removed = initial_size - final_size print("\n" + "=" * 50) print("전처리 결과 요약:") print(f"최종 데이터 크기: {initial_size:,} → {final_size:,}") print(f"제거된 데이터: {removed:,}개 ({removed / initial_size * 100:.1f}%)") print("=" * 50) ``` 텍스트 전처리 과정에서 자음반복등의 감정표현을 먼저 정규화를 한 후, 불완전한 한글을 제거할때 ㅋ,ㅎ,ㅠ,ㅜ,ㅡ는 제외하고 제거해준다. 따라서 감정을 나타내는 한글 자음 및 모음을 정규화시켜서 전처리를 거치더라도 남아있도록 만들 수 있다. 특수문자는 BlackList방식으로 이모지를 유지시켜준다. 해당 리스트에 있는 문자들이 데이터셋에 있을경우 없애주고, 나머지 감정을 나타낼만한 이모지나 특수문자는 유지시켜주었다. ### 텍스트 정규화 ```python print("텍스트 정규화 과정 시작") print("=" * 50) # 대소문자 정규화 (BERT가 처리하지만 일관성을 위해) print("\n1단계: 대소문자 정규화 수행 중...") df_processed["review_normalized"] = df_processed["review_cleaned"].str.lower() print("✓ 소문자 변환 완료") # 구두점 정규화 print("\n2단계: 구두점 정규화 수행 중...") def normalize_punctuation(text): # 여러 개의 구두점을 하나로 정규화 text = re.sub(r"[.]{2,}", ".", text) text = re.sub(r"[!]{2,}", "!", text) text = re.sub(r"[?]{2,}", "?", text) text = re.sub(r"[,]{2,}", ",", text) # 구두점 주변 공백 정리 text = re.sub(r"\s+([.,!?])", r"\1", text) text = re.sub(r"([.,!?])\s+", r"\1 ", text) return text df_processed["review_normalized"] = df_processed["review_normalized"].apply( normalize_punctuation ) print("✓ 구두점 정규화 완료") # 특수문자 추가 정리 print("\n3단계: 특수문자 정리 수행 중...") def clean_special_chars(text): # URL 패턴 제거 (있는 경우) text = re.sub( r"http[s]?://(?:[a-zA-Z]|[0-9]|[$-_@.&+]|[!*\\(\\),]|(?:%[0-9a-fA-F][0-9a-fA-F]))+", "", text, ) # 이메일 패턴 제거 (있는 경우) text = re.sub(r"\S+@\S+", "", text) # 멘션 패턴 제거 (있는 경우) text = re.sub(r"@\w+", "", text) # 과도한 공백 정리 text = re.sub(r"\s+", " ", text) return text.strip() df_processed["review_normalized"] = df_processed["review_normalized"].apply( clean_special_chars ) print("✓ URL/이메일/멘션 제거 완료") # 정규화 후 빈 텍스트 처리 print("\n4단계: 정규화 후 빈 텍스트 확인 중...") empty_after_normalization = df_processed["review_normalized"].str.strip().eq("").sum() if empty_after_normalization > 0: df_processed = df_processed[df_processed["review_normalized"].str.strip() != ""] print(f"✓ 빈 텍스트 {empty_after_normalization}개 제거") else: print("✓ 빈 텍스트 없음") # 정규화 전후 비교 print("\n" + "=" * 50) print("정규화 결과 요약:") print(f"최종 데이터 크기: {len(df_processed):,}개") print(f"평균 길이 - 정리됨: {df_processed['review_cleaned'].str.len().mean():.1f}자") print( f"평균 길이 - 정규화됨: {df_processed['review_normalized'].str.len().mean():.1f}자" ) print("=" * 50) ``` 정규화 과정에서는 이전 전처리과정에서 특수문자를 처리해주었으므로, 단순하게 원래 베이스라인 코드에 있었던것처럼 URL, 이메일, 멘션패턴을 제거하고, 공백정리를 하는식으로만 진행한다. ```python --- 수집된 라벨별 상위 감성 패턴 (예시) --- [Label 0]: [('ㅠㅠ', 27105), ('ㅋㅋ', 5958), ('ㅡㅡ', 1899), ('ㅎㅎ', 774), ('ㅜㅜ', 427), ('😡', 38), ('★', 31), ('ㅋㅋㅠㅠ', 26), ('ㅜㅠ', 21), ('ㅡㅡㅋ', 20)] [Label 1]: [('ㅠㅠ', 7606), ('ㅎㅎ', 1885), ('ㅋㅋ', 1464), ('ㅜㅜ', 72), ('ㅡㅡ', 67), ('★', 22), ('😊', 17), ('🌟', 11), ('♥', 11), ('ㅠㅜ', 9)] [Label 2]: [('ㅎㅎ', 15789), ('ㅋㅋ', 7532), ('ㅠㅠ', 4526), ('♥', 676), ('🌟', 527), ('✨', 411), ('ㅜㅜ', 398), ('😊', 337), ('👍', 291), ('♡', 288)] [Label 3]: [('ㅎㅎ', 4532), ('ㅠㅠ', 3967), ('ㅋㅋ', 3150), ('♥', 1621), ('♡', 448), ('ㅜㅜ', 327), ('🌟', 269), ('★', 170), ('✨', 123), ('👍', 111)] ------------------------------------------ ``` 사전 EDA를 해본 결과 정규화된 몇몇 모음 및 자음, 그리고 몇몇 이모지는 자주 등장함을 알 수 있다. 이들을 특수토큰으로 mapping해서 처리해줄 예정이다 ![image](/assets/images/2025-10-26-12-31-32.png) 전처리 및 정규화를 마친 데이터를 보면 감정을 나타내는 ‘ㅡㅡ’ 및 ‘ㅋㅋ’등은 데이터로 남아있고, ㅋ나 ㅎ가 여러개인경우 ‘ㅋㅋ’나 ‘ㅎㅎ’로 정규화 된것을 알 수 있었다. ## 커스텀 토큰 추가 ```python # --- 1단계: 수정된 특수 토큰 및 치환 규칙 정의 --- NEW_SPECIAL_TOKENS = [ "[LAUGH]", # ㅋㅋ, ㅎㅎ "[CRY]", # ㅠㅠ, ㅜㅜ, ㅜㅠ, ㅠㅜ "[SMILE]", # ^^, :), 😊 등 "[HEART]", # ♥, ♡ "[DISPLEASED]", # ㅡㅡ, ㅡㅡㅋ, 😡 "[THUMBS_UP]", # 👍 "[SPARKLE]", # 🌟, ✨ "[STAR]", # ★ ] # 치환 매핑 (정규식) - 적용 순서를 고려하여 리스트로 변경하는 것을 추천 # 예시: 리스트 형태 [(regex_pattern, token_string), ...] EMOTION_REPLACEMENTS = [ # 1. 불쾌 (ㅡㅡㅋ 처리를 위해 먼저) (re.compile(r'(ㅡ{2,})|(ㅡㅡㅋ)|(😡)'), "[DISPLEASED]"), # 2. 울음 (ㅡ 관련 제거됨) (re.compile(r'([ㅠㅜ]){2,}|(ㅜㅠ)|(ㅠㅜ)'), "[CRY]"), # 3. 웃음 (re.compile(r'([ㅋㅎ]){2,}'), "[LAUGH]"), # 4. 미소 (re.compile(r'(\^{2,})|(\:\))|(\:D)|(\^_+\^)|(\:\s?\))|(😊)'), "[SMILE]"), # 5. 하트 (re.compile(r'[♥♡]'), "[HEART]"), # 6. 따봉 (re.compile(r'[👍]'), "[THUMBS_UP]"), # 7. 반짝임 (re.compile(r'[🌟✨]'), "[SPARKLE]"), # 8. 별 (re.compile(r'[★]'), "[STAR]"), ] # --- 2단계: 텍스트에 치환 적용하는 함수 --- def replace_emotions(text, replacements): """Applies regex replacements to map patterns to special tokens.""" if pd.isna(text): return "" processed_text = str(text) # Ensure it's a string for pattern, token in replacements: # Add spaces around the token to ensure separation processed_text = pattern.sub(f" {token} ", processed_text) # Clean up multiple spaces that might result from replacements processed_text = re.sub(r'\s+', ' ', processed_text).strip() return processed_text #Special Tokens넣고 토크나이저 사이즈 늘리기 print(f"Original tokenizer vocab size: {len(tokenizer)}") num_added_toks = tokenizer.add_tokens(NEW_SPECIAL_TOKENS) print(f"Added {num_added_toks} new special tokens.") print(f"New tokenizer vocab size: {len(tokenizer)}") # BERT모델 토큰 늘리기 # !!! IMPORTANT: Resize model embeddings to match the new tokenizer size !!! model.resize_token_embeddings(len(tokenizer)) print("Resized model token embeddings.") # BERT 전용 전처리 함수들 def bert_tokenize_and_encode(texts, labels=None, max_length=256): """ BERT를 위한 텍스트 토큰화 및 인코딩 - 토큰화 및 길이 제한 처리 - 특수 토큰 추가 ([CLS], [SEP]) - 어텐션 마스크 생성 - 절단 및 패딩 전략 처리 """ input_ids = [] attention_masks = [] token_type_ids = [] # texts가 list 형태인지 확인 (DataFrame Series 등이 올 수 있으므로) if isinstance(texts, pd.Series): texts_list = texts.tolist() elif not isinstance(texts, list): texts_list = list(texts) else: texts_list = texts # labels도 list 형태로 변환 (필요한 경우) if labels is not None: if isinstance(labels, pd.Series): labels_list = labels.tolist() elif not isinstance(labels, list): labels_list = list(labels) else: labels_list = labels # 길이 검증 if len(texts_list) != len(labels_list): raise ValueError("texts와 labels의 길이가 다릅니다.") else: labels_list = None for text in texts: # 토큰화 및 인코딩 (특수 토큰 자동 추가) #위에서 정의했든 replcae_emotions 함수 사용 replaced_text = replace_emotions(text, EMOTION_REPLACEMENTS) encoded = tokenizer.encode_plus( replaced_text, add_special_tokens=True, # [CLS], [SEP] 토큰 추가 max_length=max_length, # 최대 길이 제한 padding="max_length", # 최대 길이까지 패딩 truncation=True, # 길이 초과시 절단 return_attention_mask=True, # 어텐션 마스크 생성 return_token_type_ids=True, # 토큰 타입 ID 생성 return_tensors="pt", # PyTorch 텐서로 반환 ) input_ids.append(encoded["input_ids"].flatten()) attention_masks.append(encoded["attention_mask"].flatten()) token_type_ids.append(encoded["token_type_ids"].flatten()) # 텐서로 변환 input_ids = torch.stack(input_ids) attention_masks = torch.stack(attention_masks) token_type_ids = torch.stack(token_type_ids) result = { "input_ids": input_ids, "attention_mask": attention_masks, "token_type_ids": token_type_ids, } if labels is not None: result["labels"] = torch.tensor(labels, dtype=torch.long) return result # 토큰 길이 분포 확인 def analyze_token_lengths(texts, max_length=256): """토큰 길이 분포 분석""" token_lengths = [] for text in texts: tokens = tokenizer.tokenize(text) token_lengths.append(len(tokens)) token_lengths = np.array(token_lengths) print( f"토큰 길이: 평균 {token_lengths.mean():.1f}, 중앙값 {np.median(token_lengths):.1f}, 범위 {token_lengths.min()}-{token_lengths.max()}" ) print( f"{max_length} 토큰 초과: {(token_lengths > max_length).sum()}개 ({(token_lengths > max_length).mean() * 100:.1f}%)" ) return token_lengths # 토큰화 테스트 및 분석 sample_text = df_processed["review_normalized"].iloc[0] sample_tokens = tokenizer.tokenize(sample_text) print(f"\n토큰화 테스트: '{sample_text[:50]}...' -> {len(sample_tokens)}개 토큰") # 전체 데이터셋 토큰 길이 분포 분석 print("\n전체 데이터셋 토큰 길이 분포:") token_lengths = analyze_token_lengths(df_processed["review_normalized"].tolist()) ``` 사전 EDA결과 웃음패턴, 울음패턴이 모든 레이블에서 가장 많이 나타나는것을 알 수 있었다. 따라서 `[Laugh], [CRY]`토큰을 만들어 주었다. 그 외에도, 데이터셋에서 자주 나타나는 이모지인 별, 따봉, 화난이모지등을 특수토큰으로 만들어주었다. EMOTION_REPLACEMENTS에서 특수토큰으로 매핑을 해주었고 이후 BERT전처리 함수에서 `replace_emotions()` 함수에서 정의된 내용을 바탕으로 특수토큰패턴이 있다면 텍스트에 치환적용을 한다. ![image](/assets/images/2025-10-26-12-31-45.png) 256을 넘는 토큰이 0.5%밖에 없으므로 토크나이저의 max_length를 256으로 지정해주었다. 기존의 BaseLinecode에서는 128이었으므로 더 많은 정보를 파악할 수 있도록 해주었다. 이로써 성능향상을 기대해볼 수 있을것 같다. # 결과 ![image](/assets/images/2025-10-26-12-31-51.png) 테스트를 해본 결과 Training Loss는 줄어드는 경향성을 보이지만 Validation Loss는 처음에는 줄어들다가 올라가는 경향성을 보였다. 과적합되고있다는 신호로, 이후 실험들에서는 Regularization기법들을 추가하도록 고려해봐야겠다. ![image](/assets/images/2025-10-26-12-31-59.png) 모든 통제변인을 제거하고 커스텀 토크나이저를 이용한 결과 약 1퍼센트의 성능향상이 있었다. 따라서 커스텀 토큰추가를 통해 유의미한 성능향상을 관측했다. 이제 이후 실험에서는 이 커스텀토크나이저 모델을 기반으로 이후에는 Focal Loss적용, Regularization기법들을 추가해볼 예정이다. ### [영화리뷰 감성분류][모델최적화]-FocalLoss - Canonical URL: https://hyejunl33.github.io/projects/2025-10-26-[Domain_Common_Project]FocalLoss/ - Collection: Project - Published: 2025-10-26 - Tags: Domain_Common_Project, study, Feature_Engineering, Focal_Loss # Introduction ![image](/assets/images/2025-10-26-15-50-21.png) 이전에 Weighted Cross Entropy를 적용한 모델은 이상할정도로 과적합되어 Training Loss는 하락하는 추세를 보이지만, Validation Loss는 줄어들지 않는 문제가 있었다. Weighted CrossEntropy는 소수의 클래스에 더 높은 가중치를 부여하므로, 소수클래스 샘플의 특징에 모델이 지나치게 맞춰질 수 있다. 우선 과적합을 방지하기 위해서 시도해봐야 하는 방법들을 생각해 보았다. - Early Stopping: 가장 쉽고 빠르게 시도해볼 수 있는 방법으로 Validation Loss가 감소하지 않으면 훈련을 중단하는 방법이다. - Regularization 강화 - Weight Decay: WeightDecay값을 높여서 모델 가중치가 너무 커지는것을 방지한다. - Dropout: Dropout비율을 높여서 과적합을 방지한다. - Dropout은 일반적으로 라이브러리 모델의 기본값을 사용한다. - Label Smoothing: 정답 레이블을 원핫 인코딩이 아니라 [0.9,0.03,0.03,0.03]처럼 모델이 너무 확신하는것을 방지하도록 만든다. - Focal Loss사용: FocalLoss는 Weighted Cross Entropy와는 다르게 예측난이도에 집중하므로 단순 클래스 빈도만 고려하는 WCE보다 과적합에 덜 민감하다. - Learning Rate Scheduling: 러닝레이트 스케줄러를 조정하는 방법을 사용할 수 있다. 베이스모델은 이전실험들에서 가장 좋은 성능을 보였던 Custom_Tokenizer모델을 사용한다. ![image](/assets/images/2025-10-26-15-50-31.png) # Focal Loss Implementaion ```python # 필요 라이브러리 임포트 import torch import torch.nn as nn import torch.nn.functional as F import numpy as np # alpha가 list/ndarray일 경우를 위해 추가 class FocalLossSoftLabels(nn.Module): """ 다중 클래스 분류를 위한 Focal Loss 구현 (소프트 레이블 지원). Label smoothing이 적용된 경우에도 작동하도록 설계되었습니다. Args: alpha (float or list/tensor): 각 클래스에 대한 가중치 요소. 리스트/텐서 형태 권장 (길이=num_classes). float일 경우 모든 클래스에 동일 적용. 기본값 0.25. gamma (float): 초점 파라미터. 기본값 2.0. reduction (str): 감소 방식 ('none' | 'mean' | 'sum'). 기본값 'mean'. epsilon (float): 수치 안정성을 위한 작은 값. 기본값 1e-7. """ def __init__(self, alpha=0.25, gamma=2.0, reduction='mean', epsilon=1e-7): super(FocalLossSoftLabels, self).__init__() self.alpha = alpha self.gamma = gamma self.reduction = reduction self.epsilon = epsilon # log(0) 방지 def forward(self, inputs, targets): """ Focal Loss 계산 (소프트 레이블 지원). Args: inputs (torch.Tensor): 모델 로짓 (N, C). targets (torch.Tensor): 실제 레이블 (N) 또는 소프트 레이블 (N, C). Returns: torch.Tensor: 계산된 Focal Loss. """ num_classes = inputs.shape[1] # 1. 입력 로짓에 log_softmax 적용 log_probs = F.log_softmax(inputs, dim=-1) # 예측 확률 계산 probs = F.softmax(inputs, dim=-1) # 2. targets 형태 확인 및 변환 if targets.ndim == 1: # 하드 레이블인 경우 (Label smoothing 미적용 시) # 원-핫 인코딩으로 변환 (Cross Entropy 계산 위해) targets_one_hot = F.one_hot(targets, num_classes=num_classes).float().to(inputs.device) # pt 계산을 위한 정수 인덱스 target_indices = targets elif targets.ndim == 2 and targets.shape[1] == num_classes: # 소프트 레이블인 경우 targets_one_hot = targets.float().to(inputs.device) # pt 계산 및 alpha 적용을 위해 가장 확률 높은 클래스 인덱스 사용 target_indices = targets_one_hot.argmax(dim=1) else: raise ValueError("targets 텐서의 형태가 올바르지 않습니다. (N) 또는 (N, C)여야 합니다.") # 3. 기본 Cross Entropy 손실 계산 (소프트/하드 레이블 모두 처리) # ce_loss = - (targets_one_hot * log_probs).sum(dim=-1) # 수동 계산 # 또는 PyTorch 함수 사용 (내부적으로 소프트 레이블 처리) # 참고: F.cross_entropy는 log_softmax + NLLLoss 이므로, log_probs를 직접 사용 시 NLLLoss 사용 ce_loss_per_sample = F.cross_entropy(inputs, targets_one_hot, reduction='none') # 4. pt 계산 (예측 확률 중 '정답' 클래스에 해당하는 값) # target_indices를 사용하여 해당 클래스의 예측 확률(probs)을 가져옴 pt = probs.gather(1, target_indices.unsqueeze(-1)).squeeze(-1) # 수치 안정성 보장 (pt가 0이나 1에 매우 가까워지는 것 방지) pt = pt.clamp(min=self.epsilon, max=1.0 - self.epsilon) # 5. alpha 가중치 계산 (alpha_t) alpha_t = None if isinstance(self.alpha, (float, int)): # 단일 float alpha -> 모든 클래스에 동일하게 적용하거나 특정 로직 추가 가능 # 여기서는 우선 모든 샘플에 동일 alpha 적용 (리스트 형태 권장) # alpha_t = torch.full_like(ce_loss_per_sample, self.alpha) # 단순 적용 예시 # 클래스별로 다른 alpha를 적용하고 싶다면 아래 리스트/텐서 방식 사용 alpha_tensor = torch.full((num_classes,), self.alpha).to(inputs.device) alpha_t = alpha_tensor.gather(0, target_indices) elif isinstance(self.alpha, (list, np.ndarray, torch.Tensor)): # 리스트, ndarray, 텐서 형태 alpha 처리 if not isinstance(self.alpha, torch.Tensor): alpha_tensor = torch.tensor(self.alpha).to(inputs.device) else: alpha_tensor = self.alpha.to(inputs.device) if alpha_tensor.shape[0] != num_classes: raise ValueError(f"alpha의 길이({alpha_tensor.shape[0]})가 클래스 개수({num_classes})와 일치해야 합니다.") # target_indices를 사용하여 각 샘플의 alpha 값 선택 alpha_t = alpha_tensor.gather(0, target_indices) else: # alpha 가중치 없음 alpha_t = 1.0 # 6. Focal Loss 계산 focal_loss_component = alpha_t * (1 - pt)**self.gamma * ce_loss_per_sample # 7. reduction 적용 if self.reduction == 'mean': return focal_loss_component.mean() elif self.reduction == 'sum': return focal_loss_component.sum() else: # 'none' return focal_loss_component ``` ```python from transformers import Trainer class CustomTrainerWithFocalLoss(Trainer): """ Focal Loss (소프트 레이블 지원)를 사용하도록 손실 계산을 오버라이드한 커스텀 Trainer. """ def __init__(self, *args, focal_loss_alpha=0.25, focal_loss_gamma=2.0, num_classes=4, **kwargs): super().__init__(*args, **kwargs) self.num_classes = num_classes # 클래스 개수 저장 # alpha 처리: float이면 num_classes 길이의 리스트로 변환 effective_alpha = focal_loss_alpha if isinstance(focal_loss_alpha, (float, int)): effective_alpha = [focal_loss_alpha] * self.num_classes print(f"Focal Loss: 단일 alpha 값({focal_loss_alpha})을 모든 {self.num_classes}개 클래스에 적용합니다.") elif isinstance(focal_loss_alpha, list) and len(focal_loss_alpha) != self.num_classes: raise ValueError(f"focal_loss_alpha 리스트의 길이({len(focal_loss_alpha)})가 num_classes({self.num_classes})와 일치해야 합니다.") else: print(f"Focal Loss: 클래스별 alpha 값({effective_alpha})을 사용합니다.") # 최적화된 FocalLossSoftLabels 사용 self.focal_loss_func = FocalLossSoftLabels(alpha=effective_alpha, gamma=focal_loss_gamma) def compute_loss(self, model, inputs, return_outputs=False, **kwargs): """ Trainer가 손실을 계산하는 방식 오버라이드. Label Smoothing이 적용된 경우 targets는 (N, C) 형태의 소프트 레이블이 됩니다. """ # labels 키가 있는지 확인 (Trainer 내부적으로 label smoothing 적용 후 전달) if "labels" not in inputs: raise ValueError("모델 입력에 'labels' 키가 없습니다. 데이터셋 형식을 확인하세요.") labels = inputs.pop("labels") outputs = model(**inputs) logits = outputs.get('logits') # FocalLossSoftLabels 함수 호출 (소프트/하드 레이블 모두 처리 가능) loss = self.focal_loss_func(logits, labels) return (loss, outputs) if return_outputs else loss ``` `FocalLossSoftLabels` 클래스안에서 FocalLoss를 정의한다. ![image](/assets/images/2025-10-26-15-50-42.png) Focal Loss는 모델이 이미 쉽게 맞히는 샘플보다는, 계속 틀리는 어려운 샘플에 더 집중하도록 Lossfunction 자체를 조정한다. 즉 클래스별로 맞히기 어려운 샘플일수록 Loss 비중을 높인다. $$\gamma$$에 따라 Loss Function의 형태 자체가 달라짐을 볼 수 있다. $$\gamma$$가 0에 가까울수록 예측확률이 낮을때, 즉 확신이 없을때의 Loss가 매우 커서, 학습이 더 강하게 일어남을 확인할 수 있다. 이때 ground Truth Class의 확률이 적을수록, 즉 해당 레이블에 모델이 확신이 없을수록 Loss값이 커지는것을 알 수 있다. 따라서 모델이 확신을 갖지 못하는 각 step의 판단에서, Loss가 더 커지도록 한다. 그리고 $$\alpha$$는 Weighted Cross Entropy와 같이 불균형 클래스에서 클래스간의 가중치를 설정하는 하이퍼 파라미터이다. 우선은 WCE에서처럼 각 클래스 백분율의 역수를 가중치로 줬는데 $\alpha,\beta$는 추후 하이퍼파라미터 튜닝 툴로 튜닝을 해봐야겠다. ## 훈련 및 정규화 ```python from transformers import EarlyStoppingCallback # <--- 이 줄 추가 # 모델 저장 여부 및 wandb 사용 여부 설정 SAVE_MODEL = True USE_WANDB = True print("\n" + "=" * 50) print("모델 훈련 시작") print("=" * 50) # 훈련 파라미터 설정 training_args = TrainingArguments( output_dir="./results", num_train_epochs=NUM_EPOCHS, per_device_train_batch_size=BATCH_SIZE_TRAIN, per_device_eval_batch_size=BATCH_SIZE_EVAL, warmup_steps=WARMUP_STEPS, weight_decay=WEIGHT_DECAY, learning_rate=LEARNING_RATE, logging_steps=100, eval_strategy="epoch", save_strategy="epoch" if SAVE_MODEL else "no", load_best_model_at_end=SAVE_MODEL, metric_for_best_model="accuracy" if SAVE_MODEL else None, greater_is_better=True, save_total_limit=2 if SAVE_MODEL else 0, label_smoothing_factor=0.1, # 10% 레이블 스무딩 적용 report_to="wandb" if USE_WANDB else "none", # wandb 로깅 조건부 활성화 run_name="bert-movie-review-classification" if USE_WANDB else None, seed=RANDOM_STATE, fp16=torch.cuda.is_available(), dataloader_num_workers=2, remove_unused_columns=False, push_to_hub=False, gradient_accumulation_steps=1, logging_first_step=True, save_safetensors=SAVE_MODEL, # === 스케줄러 타입 변경 === lr_scheduler_type="cosine", # <--- 'linear'(기본값) 대신 'cosine'으로 설정 # === Early Stopping 관련 파라미터 추가 === # early_stopping_patience=3, # <--- 추가: 이 횟수만큼 평가 점수가 개선되지 않으면 중단 (예: 3 에폭) # early_stopping_threshold=0.001, # <--- (선택 사항) 개선으로 간주하기 위한 최소 변화량 ) early_stopping_callback = EarlyStoppingCallback(early_stopping_patience=3) # <--- 원하는 patience 값 # Trainer 초기화 trainer = CustomTrainerWithFocalLoss( model=model, args=training_args, train_dataset=train_dataset, eval_dataset=val_dataset, tokenizer=tokenizer, num_classes=NUM_CLASSES, focal_loss_alpha=[0.11, 0.45, 0.12, 0.32], # 예시 시작점 focal_loss_gamma=2.0, callbacks=[early_stopping_callback], # <--- 콜백 리스트 전달 data_collator=DataCollatorWithPadding(tokenizer=tokenizer), compute_metrics=compute_metrics, ) # 훈련 정보 출력 print(f"훈련 샘플: {len(train_dataset):,}개") print(f"검증 샘플: {len(val_dataset):,}개") print(f"훈련 에포크: {training_args.num_train_epochs}회") print(f"배치 크기: {BATCH_SIZE_TRAIN} (훈련) / {BATCH_SIZE_EVAL} (검증)") print(f"학습률: {LEARNING_RATE}") print(f"시드값: {RANDOM_STATE}") print(f"디바이스: {device}") print(f"wandb 사용: {USE_WANDB}") # 훈련 실행 try: training_results = trainer.train() print("\n훈련 완료") print(f"최종 훈련 손실: {training_results.training_loss:.4f}") # 훈련 로그 정보 출력 if hasattr(training_results, "log_history"): print(f"총 훈련 스텝: {training_results.global_step}") except KeyboardInterrupt: print("\n사용자에 의해 훈련이 중단되었습니다.") raise except Exception as e: print(f"\n훈련 중 오류 발생: {str(e)}") raise ``` `label_smoothing_factor=0.1,` 를 training_args로 줘서 label_smoothing을 해주었다. `lr_scheduler_type`을 `“cosine”` 으로 줘서 선형적으로 learning rate가 조정되는게 아닌 cosine개형으로 바뀌도록 설정해주었다. 일반적으로 Overfitting을 막고, Learning rate가 cosine개형으로 달라지기때문에, Regularization의 방법중 하나라고 한다. ![image](/assets/images/2025-10-26-15-50-53.png) 실제로 wandb에서 learning_rate를 관찰해보면 주황색 그래프는 선형적으로 감소하는데 비해 코사인 개형을 따르는것을 볼 수 있다. Trainer에서는 `focal_loss_alpha=[0.11, 0.45, 0.12, 0.32]` 를통해서 기본적인 focal_loss의 각 클래스별 가중치를 클래스의 백분율의 역수로 설정해주었다. 그리고 `focal_loss_gamma=2.0` 를 통해 $$\gamma$$가 2를 갖는 focal loss의 개형을 설정해주었다. 이 $$\gamma$$값은 이후 하이퍼파라미터 튜닝으로 튜닝을 할 예정이다. # 결과 ![image](/assets/images/2025-10-26-15-51-03.png) 정규화를 해주었지만, 그럼에도 Training Loss는 감소할때 Validation Loss는 2epoch이후 계속 증가함을 볼 수 있다. 따라서 더 강한 정규화 전략을 짜고, 하이퍼파라미터 튜닝을 해봐야겠다. ![image](/assets/images/2025-10-26-15-51-09.png) 에폭을 8로 설정한 탓이었을까? Focal Loss를 적용하고, Regularization을 도입했음에도 오히려 test성능이 줄어든 0.78을 기록했다. 이후실험에서는 하이퍼파라미터 튜닝을 통한 더 나은 정규화 방향을 찾아갈 예정이다. 그리고 Back Translation을 통한 데이터 증강, 확률적 가중치 평균 (Stochastic Weight Averaging - SWA) 기법을 이용해서 조금더 일반화 성능을 늘려볼 예정이다. 그리고 Early stopping의 기준을 Accuracy가 아니라 validationLoss로 설정해서 Validation Loss가 3에폭 이상에서 증가하면 학습을 종료하도록 설정을 해서 Overfitting을 막아봐야겠다. ### [Domain_Common_Project][모델최적화]-Feature_Engineering - Canonical URL: https://hyejunl33.github.io/projects/2025-10-26-[Domain_Common_Project]Feature_Engineering/ - Collection: Project - Published: 2025-10-25 - Tags: Domain_Common_Project, study, Feature_Engineering # 텍스트 전처리 및 정리 - 특수문자 제거, 공백 정규화 - 필요시 한국어 특화 전처리 처리 - 매우 짧거나 긴 텍스트 제거 또는 처리 - 중복 제거 ![image](/assets/images/2025-10-25-18-37-59.png) - 자음, 모음만 있는경우를 제거한다. - 반복되는 표현을 정규화한다. 즉 “ㅋㅋㅋㅋ”나 “ㅎㅎㅎㅎㅎ”같은 표현을 “ㅋㅋ”, “ㅎㅎ”형태로 정규화 한다. - 비어있는 텍스트는 제거한다. - 중복되는 데이터도 모두 제거한다. # 텍스트 정규화 - 대소문자 정규화 - 구두점 처리 - 특수문자 처리 - URL/이메일/멘션 정리 ```python print("텍스트 정규화 과정 시작") print("=" * 50) # 대소문자 정규화 (BERT가 처리하지만 일관성을 위해) print("\n1단계: 대소문자 정규화 수행 중...") df_processed["review_normalized"] = df_processed["review_cleaned"].str.lower() print("✓ 소문자 변환 완료") # 구두점 정규화 print("\n2단계: 구두점 정규화 수행 중...") def normalize_punctuation(text): # 여러 개의 구두점을 하나로 정규화 # 1. (수정) 중립 구두점(.,)의 과도한 반복을 1개로 축소 (e.g., "..." -> ".") # BERT의 문맥 유지를 위해 제거하지 않고 '유지'합니다. text = re.sub(r"([.,])\1{2,}", r"\1", text) # 2. 감성 구두점(!, ?)의 과도한 반복을 2개로 축소 (e.g., "!!!!" -> "!!") text = re.sub(r"([!?])\1{2,}", r"\1\1", text) text = re.sub(r"[,]{2,}", ",", text) #3. (강화) 감성과 관련 없는 특정 노이즈 문자 제거 (확장된 Blacklist 방식) # 해시태그, 불필요한 강조, 리스트, 수학/화폐 기호, 일부 괄호 등 # (♥, 👍, ^^, >_< 같은 이모티콘/emoji는 이 목록에 없으므로 '유지'됩니다.) text = re.sub( r"[#*•■◆◇□○●※+=/\\%&{}\[\]$₩€£¥|`]", # <-- 대폭 확장된 노이즈 리스트 " ", text ) # 정규식 설명: # [#*•■◆◇□○●※] : 해시태그, 불릿, 특수 기호 # [+=/\\%&] : 수학/기술 기호 ( \는 \\로 이스케이프) # [{}\[\]] : 이모티콘에 사용되지 않는 괄호 ( []는 \로 이스케이프) # [$₩€£¥] : 화폐 기호 # [|`] : 파이프, 백틱 # 4. (수정) 전체 구두점 주변 공백 정리 text = re.sub(r"\s+([.,!?])", r"\1", text) # "정말 !" -> "정말!" text = re.sub(r"([.,!?])\s+", r"\1 ", text) # "최고! !!" -> "최고! !! " # 5. 과도한 공백을 단일 공백으로 최종 정리 text = re.sub(r"\s+", " ", text) return text.strip() df_processed["review_normalized"] = df_processed["review_normalized"].apply( normalize_punctuation ) print("✓ 구두점 정규화 완료") # 특수문자 추가 정리 print("\n3단계: 특수문자 정리 수행 중...") def clean_special_chars(text): # URL 패턴 제거 (있는 경우) text = re.sub( r"http[s]?://(?:[a-zA-Z]|[0-9]|[$-_@.&+]|[!*\\(\\),]|(?:%[0-9a-fA-F][0-9a-fA-F]))+", " ", text, ) # 이메일 패턴 제거 (있는 경우) text = re.sub(r"\S+@\S+", " ", text) # 멘션 패턴 제거 (있는 경우) text = re.sub(r"@\w+", " ", text) # 과도한 공백 정리 text = re.sub(r"\s+", " ", text) return text.strip() df_processed["review_normalized"] = df_processed["review_normalized"].apply( clean_special_chars ) print("✓ URL/이메일/멘션 제거 완료") # 정규화 후 빈 텍스트 처리 print("\n4단계: 정규화 후 빈 텍스트 확인 중...") empty_after_normalization = df_processed["review_normalized"].str.strip().eq("").sum() if empty_after_normalization > 0: df_processed = df_processed[df_processed["review_normalized"].str.strip() != ""] print(f"✓ 빈 텍스트 {empty_after_normalization}개 제거") else: print("✓ 빈 텍스트 없음") # 정규화 전후 비교 print("\n" + "=" * 50) print("정규화 결과 요약:") print(f"최종 데이터 크기: {len(df_processed):,}개") print(f"평균 길이 - 정리됨: {df_processed['review_cleaned'].str.len().mean():.1f}자") print( f"평균 길이 - 정규화됨: {df_processed['review_normalized'].str.len().mean():.1f}자" ) print("=" * 50) ``` - 모든문자를 우선 소문자로 정규화 한다. - 구두점처리 - 중복된 구두점은 1개나 2개로 축소해서 정규화한다. - 감성과 관련없는 특수문자는 노이즈로 여겨서 BlackList형식으로 제거한다. - 감성과 관련있는 이모티콘이나, 특수문자는 목록에 넣지 않아서 유지된다. - 구두점 주변 공백을 정리한다. - URL패턴이나 이메일패턴, 멘션패턴, 과도한 공백은 감성분류에 도움이 되지 않는 노이즈이므로 제거한다. ![image](/assets/images/2025-10-25-18-38-15.png) BaseLine코드에서는 최대한 자음/모음만 반복된 패턴, 특수문자, 이모지등을 모두 노이즈처리해서 전처리했었다. 하지만 이것들이 감성분류에 도움이 될수도 있지 않을까라는 생각에 해당 특수문자/ 이모지/ 감정을 나타내는 패턴등을 특수토큰으로 매핑해서 최대한 사용하고자 위의 코드처럼 구현했다. # 텍스트 전처리 파이프라인 재구성 - 앞서 정의한 함수들을 이용하여 파이프라인 구성 - DataLeakage를 방지하기 위한 전략을 포함해야 한다. - 전처리 파라미터는 학습 데이터에서만 학습 - Validation/Test데이터는 학습된 파라미터로만 변환 - 레이블 정보를 활용한 전처리는 학습 시에만 적용 ```python class TextPreprocessingPipeline: """ 텍스트 전처리 파이프라인 클래스 (정규식 오류 수정) - 전처리 로직을 단일 메서드로 통합 및 최적화 - fit 메서드: 커스텀 토크나이저를 위한 라벨별 감성 패턴 수집 """ def __init__(self): self.is_fitted = False # fit의 결과물: 라벨별 상위 감성 표현(이모티콘/emoji)을 저장 self.emotion_patterns_by_label = {} # 감성 표현을 찾는 정규식 # 1. (ㅋㅎㅠㅜㅡ): 한국어 감정 표현 (e.g., ㅋㅋ, ㅠㅠ) # 2. (T^>c<;:=_...): 아스키 이모티콘 (e.g., ^_^, T_T, :), >_<) # 3. (\U0001F...): 유니코드 이모지 (e.g., 😂, 👍, ♥) # --- [수정된 부분] --- self.EMOTION_REGEX = re.compile( r'([ㅋㅎㅠㅜㅡ]{2,})|' # 1. 한국어 # 2. 아스키 (맨 끝에 누락된 ')'를 '|' 앞에 추가) r'([T^>c<;:=_]{1,}(?:[-_oO\']{0,1})(?:[\)\]DdpP]|\[<]{1,}))|' # 3. 이모지 (캡처 그룹 '()'으로 묶고 맨 뒤의 불필요한 ')' 제거) r'([\U0001F600-\U0001F64F\U0001F300-\U0001F5FF\U0001F680-\U0001F6FF\U0001F1E0-\U0001F1FF\u2600-\u26FF\u2700-\u27BF♥👍😂])' ) # --- [수정 완료] --- def _clean_noise_patterns(self, text: str) -> str: """[1순위] URL, 이메일, 멘션 등 패턴 기반 노이즈 제거""" text = re.sub( r"http[s]?://(?:[a-zA-Z]|[0-9]|[$-_@.&+]|[!*\\(\\),]|(?:%[0-9a-fA-F][0-9a-fA-F]))+", " ", text ) text = re.sub(r"\S+@\S+", " ", text) text = re.sub(r"@\w+", " ", text) return text def _apply_preprocessing_rules(self, text: str) -> str: """ [핵심] 기본 전처리 및 정규화 규칙을 '올바른 순서'로 적용 """ if pd.isna(text): return "" text = str(text).strip() # 1. (가장 먼저) URL, 이메일, 멘션 등 노이즈 패턴 제거 text = self._clean_noise_patterns(text) # 2. 소문자화 (BERT가 처리하지만 일관성을 위해) text = text.lower() # 3. (강화) 감성과 관련 없는 특정 노이즈 문자 제거 (Blacklist) text = re.sub( r"[#*•■◆◇□○●※+=/\\%&{}\[\]$₩€£¥|`]", " ", text ) # 4. 한국어 특화 정리 (자음/모음만 있는 경우) # text = re.sub(r"[ㄱ-ㅎㅏ-ㅣ]+", "", text) # 5. 감정 표현 정규화 (e.g., ㅋㅋㅋ -> ㅋㅋ, ㅠㅠㅠ -> ㅠㅠ) text = re.sub(r"([ㅋㅎ])\1{2,}", r"\1\1", text) text = re.sub(r"([ㅠㅜㅡ])\1{2,}", r"\1\1", text) # 6. 구두점 정규화 text = re.sub(r"([.,])\1{2,}", r"\1", text) # e.g., "..." -> "." text = re.sub(r"([!?])\1{2,}", r"\1\1", text) # e.g., "!!!!" -> "!!" # 7. 구두점 주변 공백 정리 text = re.sub(r"\s+([.,!?])", r"\1", text) text = re.sub(r"([.,!?])\s+", r"\1 ", text) # 8. (마지막) 과도한 공백을 단일 공백으로 최종 정리 text = re.sub(r"\s+", " ", text) return text.strip() def fit(self, texts: pd.Series, labels: pd.Series): """ 학습 데이터(texts, labels)로부터 전처리 정보(감성 패턴)를 학습합니다. """ print("학습 데이터 기반 감성 패턴 수집 중...") if not isinstance(texts, pd.Series): texts = pd.Series(texts) if not isinstance(labels, pd.Series): labels = pd.Series(labels) # 1. 분석 전, 텍스트에 기본 정규화 규칙을 먼저 적용합니다. processed_texts = texts.apply(self._apply_preprocessing_rules) df = pd.DataFrame({'text': processed_texts, 'label': labels}) # 2. 라벨별로 순회하며 감성 패턴(이모티콘, emoji 등)을 찾습니다. for label in sorted(df['label'].unique()): label_texts = df[df['label'] == label]['text'] # findall과 explode를 사용해 모든 감성 표현을 추출 all_emotions = label_texts.str.findall(self.EMOTION_REGEX).explode().dropna() # 튜플로 반환되는 정규식 결과를 (e.g., ('ㅋㅋ', '', '')) 하나로 합침 # (튜플이 비어있는 경우 방지) cleaned_emotions = [] for tup in all_emotions: found = next((item for item in tup if item), None) if found: cleaned_emotions.append(found) # 3. 빈도를 계산하고 상위 10개를 저장합니다. top_emotions = Counter(cleaned_emotions).most_common(10) self.emotion_patterns_by_label[label] = top_emotions self.is_fitted = True print("✓ 감성 패턴 수집 완료 (파이프라인 학습 완료)") # 수집된 정보 예시 출력 print("\n--- 수집된 라벨별 상위 감성 패턴 (예시) ---") for label, patterns in self.emotion_patterns_by_label.items(): print(f" [Label {label}]: {patterns}") print("------------------------------------------") def transform(self, texts: pd.Series) -> pd.Series: """ 학습된 파이프라인(또는 기본 파이프라인)을 사용하여 텍스트를 변환합니다. """ if not self.is_fitted: print( "Warning: 파이프라인이 'fit'되지 않았습니다. 기본 전처리 규칙만 적용합니다." ) if not isinstance(texts, pd.Series): texts = pd.Series(texts) # _apply_preprocessing_rules 함수를 .apply로 효율적으로 적용 processed_texts = texts.apply(self._apply_preprocessing_rules) return processed_texts def fit_transform(self, texts: pd.Series, labels: pd.Series) -> pd.Series: """학습과 변환을 동시에 수행합니다.""" self.fit(texts, labels) return self.transform(texts) #파이프라인 인스턴스 생성 preprocessor = TextPreprocessingPipeline() ``` - 이전에 정의한 함수들을 이용해서 데이터 전처리 파이프라인 Class를 생성한다. - `clean_noise_pattens()` `,_apply_preprocessing_rules()` 함수를 통해 텍스트를 전처리한다. - `fit()` 메서드에서는 이후 k-fold방식으로 나눌 데이터들의 특징을 시각화하고, 확인하는 방법들을 사용한다. → 상위 10개 저장 - 데이터들의 특징(이모지 빈도, 감성표현 ‘ㅋㅋ’등의 빈도)을 확인하고 토크나이저에 특수토큰을 추가한다. - 파이프라인 인스턴스를 `preprocessor`로 선언한다. # BERT 전용 전처리 확인 - BERT 토크나이저를 사용해서 토큰화 - 토큰화 길이 제한 처리(BERT는 512 이하 토큰으로 제한) - 특수 토큰 추가([CLS],[SEP]) - 어텐션 마스크 생성 - 절단 및 패딩 전략 처리 ```python # BERT 토크나이저 초기화 # model_name = "klue/bert-base" model_name = "beomi/kcbert-base" tokenizer = AutoTokenizer.from_pretrained(model_name) print( f"BERT 토크나이저: {model_name}, vocab: {tokenizer.vocab_size}, max_length: {tokenizer.model_max_length}" ) ``` 모델 제한에 따라서 제한된 모델중 일단 `"beomi/kcbert-base"` 모델을 사용한다. 이 모델은 **온라인 댓글, 뉴스 리뷰 등 비정형적인 텍스트**를 포함한 대용량의 한국어 데이터로 학습되어있다고 한다. 따라서 영화리뷰를 분석할때, 신조어, 이모지, 구어체 문장에 대한 이해도가 가장 높을것으로 기대한다. ```python # --- 1단계: 특수 토큰 및 치환 규칙 정의 --- # 이 규칙은 preprocessor.fit()의 통계 결과를 바탕으로 '개발자가' 정의하는 것입니다. # (예시: {'Label 0': [('ㅠㅠ', 5000)], 'Label 3': [('ㅋㅋ', 8000), ('♥', 500)]}) # 1. 새로 추가할 특수 토큰 리스트 # (모델이 이 토큰을 하나의 의미 단위로 학습하게 됩니다) NEW_SPECIAL_TOKENS = [ "[LAUGH]", # 웃음 (ㅋㅋ, ㅎㅎ 등) "[CRY]", # 울음 (ㅠㅠ, ㅜㅜ 등) "[SMILE]", # 미소 (^^, :) 등) "[HEART]", # 하트 (♥, ♡ 등) "[EMOJI]", # 기타 이모지 (👍, 😂 등) ] # 2. 원본 텍스트를 위 특수 토큰으로 치환하기 위한 매핑 (정규식) # (순서가 중요합니다. 더 긴 것을 먼저 처리해야 합니다. e.g., ㅠㅠ > ㅠ) EMOTION_MAP = { re.compile(r'([ㅋㅎ]){2,}'): "[LAUGH]", # ㅋㅋ, ㅎㅎ, ㅋㅋㅋㅋ 등 re.compile(r'([ㅠㅜ]){2,}'): "[CRY]", # ㅠㅠ, ㅜㅜ, ㅠㅠㅠ 등 re.compile(r'(\^{2,})|(\:\))|(\:D)'): "[SMILE]", # ^^, :), :D 등 re.compile(r'[♥♡]'): "[HEART]", # ♥, ♡ # 기타 일반 유니코드 이모지 (fit에서 자주 보인 것들) re.compile(r'[👍😂😥🤔]'): "[EMOJI]", } def replace_emotions_with_tokens(text: str) -> str: """ 토크나이저에 넣기 전, 텍스트의 감성 표현을 특수 토큰 문자열로 치환합니다. """ for pattern, token in EMOTION_MAP.items(): text = pattern.sub(token, text) return text # --- 2단계: 토크나이저 로드 및 특수 토큰 추가 --- print("토크나이저 로드 및 특수 토큰 추가 중...") MODEL_NAME = "beomi/kcbert-base" # 우리가 선택한 모델 tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME) print(f"원본 어휘 사전 크기: {len(tokenizer)}") tokenizer.add_special_tokens({"additional_special_tokens": NEW_SPECIAL_TOKENS}) print(f"신규 토큰 추가 후 어휘 사전 크기: {len(tokenizer)}") # 중요: 이 작업 후, 모델을 로드할 때 반드시 # model.resize_token_embeddings(len(tokenizer)) 를 호출해야 합니다. # --- 3단계: 개선된 BERT 인코딩 함수 (배치 처리) --- def bert_tokenize_and_encode(texts: list, tokenizer, max_length=256, labels=None): """ (개선) BERT를 위한 텍스트 배치(batch) 토큰화 및 인코딩 - (신규) 감성 토큰 치환 기능 포함 - (개선) for 루프 대신 빠른 배치 인코딩 사용 """ # 1. (신규) 텍스트를 특수 토큰 문자열로 먼저 치환합니다. # (이 작업이 빠지면 [LAUGH] 토큰이 아무 의미가 없습니다) print("감성 표현을 특수 토큰 문자열로 치환 중...") try: processed_texts = [replace_emotions_with_tokens(text) for text in texts] except Exception as e: print(f"Error during text replacement: {e}") processed_texts = texts # 실패 시 원본 사용 print("배치 인코딩 수행 중 (대용량 처리)...") # 2. (개선) for 루프 대신, 리스트 전체를 한 번에 토크나이저에 전달 encoded_batch = tokenizer( processed_texts, add_special_tokens=True, # [CLS], [SEP] 토큰 추가 max_length=max_length, # 최대 길이 제한 padding="max_length", # 최대 길이까지 패딩 truncation=True, # 길이 초과시 절단 return_attention_mask=True, # 어텐션 마스크 생성 return_token_type_ids=True, # 토큰 타입 ID 생성 (BERT/KcBERT는 사용) return_tensors="pt", # PyTorch 텐서로 반환 ) # 'encoded_batch'는 이미 'input_ids', 'attention_mask' 등이 포함된 딕셔너리 if labels is not None: # labels를 파이토치 텐서로 변환 encoded_batch["labels"] = torch.tensor(labels, dtype=torch.long) print("배치 인코딩 완료.") return encoded_batch # --- (수정 없음) 토큰 길이 분석 함수 --- def analyze_token_lengths(texts, tokenizer, max_length=256): """토큰 길이 분포 분석 (tokenizer를 인자로 받도록 수정)""" token_lengths = [] # 감성 토큰 치환을 먼저 적용 processed_texts = [replace_emotions_with_tokens(text) for text in texts] print("토큰 길이 분석 중...") for text in processed_texts: tokens = tokenizer.tokenize(text) # .tokenize()는 특수토큰([CLS]) 미포함 token_lengths.append(len(tokens)) token_lengths = np.array(token_lengths) print( f"토큰 길이: 평균 {token_lengths.mean():.1f}, 중앙값 {np.median(token_lengths):.1f}, 범위 {token_lengths.min()}-{token_lengths.max()}" ) print( f"분석 기준 MaxLength {max_length} 토큰 초과: {(token_lengths > max_length).sum()}개 ({(token_lengths > max_length).mean() * 100:.1f}%)" ) return token_lengths ``` - 토크나이저에 커스텀하기 위해 특수토큰을 추가한다. ```python --- 수집된 라벨별 상위 감성 패턴 (예시) --- [Label 0]: [('ㅠㅠ', 33867), ('ㅋㅋ', 7427), ('ㅡㅡ', 2363), ('ㅎㅎ', 954), ('ㅜㅜ', 519), ('😡', 44), ('★', 33), ('ㅋㅋㅠㅠ', 30), ('ㅡㅡㅋ', 26), ('ㅜㅠ', 24)] [Label 1]: [('ㅠㅠ', 9489), ('ㅎㅎ', 2362), ('ㅋㅋ', 1856), ('ㅜㅜ', 86), ('ㅡㅡ', 78), ('★', 26), ('😊', 22), ('🌟', 18), ('ㅠㅜ', 12), ('♥', 11)] [Label 2]: [('ㅎㅎ', 19727), ('ㅋㅋ', 9407), ('ㅠㅠ', 5677), ('♥', 832), ('🌟', 640), ('✨', 510), ('ㅜㅜ', 477), ('😊', 415), ('♡', 360), ('👍', 351)] [Label 3]: [('ㅎㅎ', 5713), ('ㅠㅠ', 4948), ('ㅋㅋ', 3900), ('♥', 2067), ('♡', 571), ('ㅜㅜ', 391), ('🌟', 330), ('★', 206), ('✨', 142), ('👍', 137)] ------------------------------------------ ``` 수집된 라벨별 감성패턴을 보면 ‘ㅠㅠ’나 ‘ㅋㅋ’같은 감정패턴은 레이발과 상관없이 자주 등장함을 볼 수 있다. 따라서 노이즈처리를 해야하나 고민을 해보았다. 하지만 BERT기반 모델은 문맥을 이해하므로 이러한 토큰을 남겨두는게 유리하다. - Bidirectional Processing: BERT는 한방향으로만 학습을 하는게 아니라, 문장 전체를 한번에 어텐션으로 보고, 특정 단어의 의미를 파악할때 그 단어의 앞뒤 모든 단어정보를 동시에 활용한다. - Self-Attention: BERT는 Multi Head-self Attention(head는 12개)을 이용해서 문장 전체의 문맥을 병렬적으로 파악한다. # 데이터 분할 전략 - 훈련/검증 데이터 분할 - 클래스 분포를 유지하는 계층적 분할 우선 stratified K-Fold cross validation을 사용한다. 데이터셋을 5개로 나누고, 각각 validation데이터를 20%, train 데이터를 80%로 사용해서 서로 다른 경우의수 5번을 학습시킨다. 이후 추론단계에서는 5개의 모델을 앙상블해서 소프트 voting을 통해 추론결과를 도출해낸다. ```python from sklearn.model_selection import StratifiedKFold from sklearn.utils.class_weight import compute_class_weight from transformers import AutoTokenizer, AutoModelForSequenceClassification, TrainingArguments, DataCollatorWithPadding, Trainer import numpy as np import pandas as pd import torch import os import torch.nn.functional as F # 앙상블 시 필요 from torch.utils.data import DataLoader # 추론 시 필요 # (기존 변수들: USE_WANDB, SAVE_MODEL, df, RANDOM_STATE, ...) # (기존 클래스/함수 정의: TextPreprocessingPipeline, replace_emotions_with_tokens, ReviewDataset, CustomTrainer, compute_metrics, ...) USE_WANDB = True SAVE_MODEL = True # ★★★ 모델 저장을 True로 유지 # 사용할 전체 데이터 (전처리 파이프라인 적용 전 원본) X_full = df["review"] y_full = df["label"] ids_full = df["ID"] # Stratified K-Fold 설정 N_SPLITS = 5 skf = StratifiedKFold(n_splits=N_SPLITS, shuffle=True, random_state=RANDOM_STATE) print(f"\nStratified {N_SPLITS}-Fold Cross Validation 시작...") fold_metrics = [] all_fold_train_history = [] saved_model_paths = [] # ★★★ [추가] 각 Fold의 베스트 모델 저장 경로 리스트 # K-Fold 루프 시작 for fold, (train_index, val_index) in enumerate(skf.split(X_full, y_full)): print(f"\n===== Fold {fold+1}/{N_SPLITS} =====") # ... (1. 데이터 분할 ~ 7. 데이터셋 생성 까지는 동일) ... # 1. 현재 Fold의 훈련/검증 데이터 분할 (원본 데이터 사용) X_train, X_val = X_full.iloc[train_index], X_full.iloc[val_index] y_train, y_val = y_full.iloc[train_index], y_full.iloc[val_index] ids_train, ids_val = ids_full.iloc[train_index], ids_full.iloc[val_index] print(f"훈련 데이터: {len(X_train)}개, 검증 데이터: {len(X_val)}개") # 2. 전처리 파이프라인 적용 (각 Fold마다 새로 학습) preprocessor_fold = TextPreprocessingPipeline() # 매 Fold마다 새 인스턴스 print("현재 Fold 훈련 데이터에 대한 전처리 파이프라인 학습 및 적용...") X_train_processed = preprocessor_fold.fit_transform(X_train, y_train) print("현재 Fold 검증 데이터에 전처리 파이프라인 적용...") X_val_processed = preprocessor_fold.transform(X_val) # 3. 특수 토큰 치환 적용 print("훈련/검증 데이터에 특수 토큰 치환 적용 중...") X_train_replaced = [replace_emotions_with_tokens(text) for text in X_train_processed.tolist()] X_val_replaced = [replace_emotions_with_tokens(text) for text in X_val_processed.tolist()] print("✓ 특수 토큰 치환 완료") # 4. 모델 학습용 DataFrame 생성 (현재 Fold 용) train_data_fold = pd.DataFrame( {"ID": ids_train.tolist(), "review": X_train_replaced, "label": y_train.tolist()} ) val_data_fold = pd.DataFrame( {"ID": ids_val.tolist(), "review": X_val_replaced, "label": y_val.tolist()} ) # 5. 토크나이저 초기화 및 특수 토큰 추가 (매 Fold마다) print(f"\nFold {fold+1}: 토크나이저 로딩 및 수정 ({model_name})") tokenizer_fold = AutoTokenizer.from_pretrained(model_name) tokenizer_fold.add_special_tokens({"additional_special_tokens": NEW_SPECIAL_TOKENS}) print(f"Fold {fold+1}: 어휘 사전 크기: {len(tokenizer_fold)}") # 6. 모델 초기화 및 임베딩 크기 조정 (매 Fold마다) print(f"Fold {fold+1}: 모델 로딩 및 수정 ({model_name})") model_fold = AutoModelForSequenceClassification.from_pretrained( model_name, num_labels=NUM_CLASSES, ) model_fold.resize_token_embeddings(len(tokenizer_fold)) print(f"Fold {fold+1}: 모델 임베딩 크기 조정 완료.") model_fold.to(device) # 모델을 GPU로 이동 # 7. 데이터셋 생성 (현재 Fold 데이터 사용) print(f"Fold {fold+1}: 데이터셋 생성 중...") train_dataset_fold = ReviewDataset( train_data_fold["review"], train_data_fold["label"], tokenizer_fold, CHOSEN_MAX_LENGTH, ) val_dataset_fold = ReviewDataset( val_data_fold["review"], val_data_fold["label"], tokenizer_fold, CHOSEN_MAX_LENGTH, ) print(f"Fold {fold+1}: 훈련 {len(train_dataset_fold)}개, 검증 {len(val_dataset_fold)}개 데이터셋 생성 완료.") # 8. 클래스 가중치 계산 (현재 Fold 훈련 데이터 기준) print(f"Fold {fold+1}: 클래스 가중치 계산 중...") class_weights_fold = compute_class_weight( 'balanced', classes=np.unique(y_train), # 현재 Fold의 y_train 사용 y=y_train.to_numpy() ) class_weights_tensor_fold = torch.tensor(class_weights_fold, dtype=torch.float) print(f"Fold {fold+1}: 계산된 클래스 가중치: {class_weights_tensor_fold}") # 9. TrainingArguments 설정 (출력 디렉토리 변경) # ★★★ output_dir을 명확하게 지정합니다. output_dir_fold = f"./results_fold_{fold+1}" training_args_fold = TrainingArguments( output_dir=output_dir_fold, # Fold별 디렉토리 num_train_epochs=NUM_EPOCHS, per_device_train_batch_size=BATCH_SIZE_TRAIN, per_device_eval_batch_size=BATCH_SIZE_EVAL, warmup_steps=WARMUP_STEPS, weight_decay=WEIGHT_DECAY, learning_rate=LEARNING_RATE, logging_steps=100, eval_strategy="epoch", save_strategy="epoch", load_best_model_at_end=True, # ★★★ 훈련 종료 후 최고 모델 로드 metric_for_best_model="accuracy", greater_is_better=True, save_total_limit=1, report_to="wandb" if USE_WANDB else "none", run_name=f"kfold_{fold+1}_{model_name.split('/')[-1]}" if USE_WANDB else None, seed=RANDOM_STATE, fp16=torch.cuda.is_available(), dataloader_num_workers=2, remove_unused_columns=False, ) # 10. Custom Trainer 정의 (이미 완료됨) # 11. Custom Trainer 초기화 (현재 Fold 데이터 및 가중치 사용) print(f"Fold {fold+1}: Custom Trainer 초기화 중...") trainer_fold = CustomTrainer( model=model_fold, args=training_args_fold, train_dataset=train_dataset_fold, eval_dataset=val_dataset_fold, tokenizer=tokenizer_fold, data_collator=DataCollatorWithPadding(tokenizer=tokenizer_fold), compute_metrics=compute_metrics, class_weights=class_weights_tensor_fold ) print(f"Fold {fold+1}: ✓ Custom Trainer 초기화 완료") # 12. 모델 훈련 실행 print(f"Fold {fold+1}: 모델 훈련 시작...") try: train_result = trainer_fold.train() print(f"Fold {fold+1}: ✓ 모델 훈련 완료") # 13. 현재 Fold 검증 성능 평가 및 저장 print(f"Fold {fold+1}: 검증 데이터 평가 중...") eval_results = trainer_fold.evaluate() fold_metrics.append(eval_results) # 결과 저장 print(f"Fold {fold+1}: ✓ 검증 완료: {eval_results}") # --- ★★★ [수정] 앙상블을 위한 모델/토크나이저 저장 --- # load_best_model_at_end=True이므로, # trainer_fold.model은 이미 베스트 모델 상태입니다. if SAVE_MODEL: # TrainingArguments의 output_dir과 별개로 # 앙상블에 사용하기 쉬운 명확한 경로에 저장합니다. save_path = f"./best_model_fold_{fold+1}" trainer_fold.save_model(save_path) tokenizer_fold.save_pretrained(save_path) # [추가] 저장된 경로를 리스트에 추가합니다. saved_model_paths.append(save_path) print(f"Fold {fold+1}: 최고 성능 모델 저장 완료: {save_path}") # --------------------------------------------------- except Exception as e: print(f"Fold {fold+1}: 훈련/평가 중 오류 발생: {e}") fold_metrics.append(None) # 메모리 정리 del model_fold, tokenizer_fold, train_dataset_fold, val_dataset_fold, trainer_fold if torch.cuda.is_available(): torch.cuda.empty_cache() # K-Fold 루프 종료 print(f"\n===== Stratified {N_SPLITS}-Fold Cross Validation 종료 =====") # --- 최종 결과 분석 (기존 코드와 동일) --- # ... (avg_accuracy, std_accuracy 등 계산 및 출력) ... print("\n===== 최종 교차 검증 결과 분석 =====") valid_results = [m for m in fold_metrics if m is not None] if len(valid_results) > 0: avg_accuracy = np.mean([m['eval_accuracy'] for m in valid_results]) std_accuracy = np.std([m['eval_accuracy'] for m in valid_results]) # ... (기타 F1, Loss 계산) ... print(f"총 {len(valid_results)}개 Fold 결과 분석:") print(f" 평균 검증 정확도 (Accuracy): {avg_accuracy:.4f} ± {std_accuracy:.4f}") # ... (기타 F1, Loss 출력) ... else: print("오류로 인해 유효한 교차 검증 결과가 없습니다.") print("===================================") ``` ![image](/assets/images/2025-10-25-18-38-38.png) 무언가 잘못된것인지 각 Fold마다 Training Loss는 줄어드는 추세를 보이지만, Validation Loss는 줄어들지 않는 경향을 보였다. 그리고 Training Loss는 계속해서 줄어드는 추세를 보여서, 이후에는 과적합 문제를 해결한다음, epoch을 더 늘려서 Loss를 줄이는 방법을 고려해봐야겠다. 최종 Cross Validation을평균내보면 0.8318로 초기 모델의 acc인 0.8보다 3%정도 성능향상이 있음을 확인할 수 있다. ```python print("\n===== 앙상블 추론(Inference) 시작 =====") # 1. 테스트 데이터 로드 (e.g., Cell 37) print("테스트 데이터 로딩...") try: # (test.csv 경로는 실제 환경에 맞게 수정) df_test = pd.read_csv("test.csv") X_test = df_test["review"] ids_test = df_test["ID"] print(f"테스트 데이터 {len(df_test)}개 로드 완료.") except FileNotFoundError: print("Error: test.csv 파일을 찾을 수 없습니다. 추론을 중단합니다.") # 이 경우 아래 코드는 실행되지 않습니다. if 'df_test' in locals(): # 테스트 데이터가 성공적으로 로드되었는지 확인 # 2. 테스트 데이터 전처리 # ★★★ 중요: 전처리 파이프라인은 K-Fold에 사용한 *전체* 훈련 데이터로 # 다시 학습(fit)한 후, 테스트 데이터에 적용(transform)해야 합니다. # (K개 Fold 중 하나의 파이프라인을 사용하는 것은 편향될 수 있음) print("\n2. 전체 훈련 데이터로 최종 전처리기 학습...") final_preprocessor = TextPreprocessingPipeline() # K-Fold 루프 밖의 X_full, y_full 사용 final_preprocessor.fit(X_full, y_full) print("테스트 데이터에 전처리기 적용...") X_test_processed = final_preprocessor.transform(X_test) print("테스트 데이터에 특수 토큰 치환 적용...") X_test_replaced = [replace_emotions_with_tokens(text) for text in X_test_processed.tolist()] print("✓ 전처리 및 치환 완료.") # 3. K-Fold 모델 앙상블 추론 all_fold_logits = [] # K개 모델의 로짓(logits)을 저장할 리스트 saved_model_paths = [f"./best_model_fold_{i+1}" for i in range(N_SPLITS)] print(f"\n3. {len(saved_model_paths)}개 Fold 모델로 추론 수행...") for fold, model_path in enumerate(saved_model_paths): print(f"--- Fold {fold+1} 모델 추론 ({model_path}) ---") # A. Fold별 저장된 모델 및 토크나이저 로드 print("모델 및 토크나이저 로딩...") tokenizer_inf = AutoTokenizer.from_pretrained(model_path) model_inf = AutoModelForSequenceClassification.from_pretrained(model_path) model_inf.to(device) model_inf.eval() # B. 테스트 데이터셋 생성 (Fold의 토크나이저 사용) # ReviewDataset이 레이블을 필요로 하므로, 더미 레이블 생성 test_labels_dummy = [0] * len(X_test_replaced) test_dataset_inf = ReviewDataset( reviews=X_test_replaced, labels=test_labels_dummy, tokenizer=tokenizer_inf, max_length=CHOSEN_MAX_LENGTH ) test_data_collator = DataCollatorWithPadding(tokenizer=tokenizer_inf) # C. 추론 실행 (Trainer의 .predict() 메소드 활용) # 추론용 TrainingArguments (간단하게 설정) test_args = TrainingArguments( output_dir=f"./temp_inference_output_{fold+1}", per_device_eval_batch_size=BATCH_SIZE_EVAL, # 훈련 시 eval 배치 크기 사용 fp16=torch.cuda.is_available(), dataloader_num_workers=2, report_to="none", # 추론 시 로그 불필요 ) trainer_inf = Trainer( model=model_inf, args=test_args, tokenizer=tokenizer_inf, data_collator=test_data_collator, ) # .predict()는 (predictions, label_ids, metrics) 튜플 반환 # predictions는 로짓(logits)이 담긴 numpy 배열입니다. predictions_output = trainer_inf.predict(test_dataset_inf) fold_logits_np = predictions_output.predictions # numpy 배열을 torch 텐서로 변환하여 리스트에 추가 all_fold_logits.append(torch.tensor(fold_logits_np)) print(f"Fold {fold+1} 추론 완료. 로짓 shape: {fold_logits_np.shape}") # 메모리 정리 del model_inf, tokenizer_inf, test_dataset_inf, trainer_inf if torch.cuda.is_available(): torch.cuda.empty_cache() # 4. K-Fold 예측 결과 앙상블 (Averaging) print("\n4. K-Fold 예측 결과 앙상블 (Averaging)...") # all_fold_logits 리스트에는 (num_test_samples, num_classes) 텐서가 K개 있음 # torch.stack을 사용해 (K, num_test_samples, num_classes) 텐서로 만듦 stacked_logits = torch.stack(all_fold_logits) print(f"Stacked logits shape (K, N_samples, N_classes): {stacked_logits.shape}") # K개 모델의 로짓을 평균 (dim=0 : K(fold) 차원) mean_logits = torch.mean(stacked_logits, dim=0) print(f"Mean logits shape (N_samples, N_classes): {mean_logits.shape}") # 최종 예측 클래스 (가장 높은 로짓의 인덱스) final_predictions = torch.argmax(mean_logits, dim=1) # (참고) 최종 확률값이 필요한 경우 # final_probs = F.softmax(mean_logits, dim=1) # 5. 제출 파일 생성 print("\n5. 제출 파일 생성...") submission_df = pd.DataFrame({ 'ID': ids_test, # 테스트 데이터의 ID 사용 'label': final_predictions.numpy() # 텐서를 numpy 배열로 변환 }) submission_filename = "ensemble_submission.csv" submission_df.to_csv(submission_filename, index=False) print(f"✓ 제출 파일 '{submission_filename}' 생성 완료!") print(submission_df.head()) else: print("테스트 데이터가 로드되지 않아 추론을 건너뜁니다.") print("===================================") ``` 각 Fold마다 다른 모델을 써서 앙상블하는 방법도 있겠지만, 우선 `beomi/bert` 모델만을 사용해서, Stratified k-Fold cross Validation을 해주었다. 추론을 할때 k개 Fold중 하나의 파이프라인을 사용해서 dict를 사용하거나 하면 편향될 수 있으므로, 다시 전체 데이터셋을 파이프라인으로 `fit` 한후에 사용해주어야 한다. # 클래스 불균형 처리 - Weighted Cross Entropy ```python from sklearn.utils.class_weight import compute_class_weight # 클래스별 가중치 계산 print("\n클래스 가중치 계산 중...") # y_train은 train_test_split에서 반환된 pandas Series class_weights = compute_class_weight( 'balanced', classes=np.unique(y_train), y=y_train.to_numpy() # Series를 numpy 배열로 변환 ) # PyTorch 텐서로 변환 class_weights_tensor = torch.tensor(class_weights, dtype=torch.float) print(f"계산된 클래스 가중치: {class_weights_tensor}") ``` EDA에서 확인했듯이 데이터에서 클래스별 불균형이 있었다. 따라서 클래스비율의 역수를 CrossEntropy Lossfunction의 가중치로 사용해서 소수 클래스의 Loss는 그 비율의 역수만큼 더 많이 반영되게 처리를 해주었다. # 결과 및 이후 실험계획 ![image](/assets/images/2025-10-25-18-38-49.png) 베이스 모델의 성능 ![image](/assets/images/2025-10-25-18-38-54.png) 베이스모델인 마라탕후루후루에 비해 Feature Engineering을 한 모델이 오히려 성능이 떨어졌음을 알 수 있다. 왜일까… ### Weighted Cross Entropy Weighted Cross Entropy는 소수 클래스에 대한 recall을 향상시켜주지만, 대다수를 차지하는 클래스에 대해서는 정확도가 낮아질 수 있다. 이 대회의 metric은 accuracy 하나이므로 어쩌면 weighted cross entropy를 사용하지 않는게 metric인 accuracy를 높일 수 있는 방법인지 모르겠다. ### 커스텀 토크나이저에 특수토큰 추가하기 기존에는 뭉뚱그려서 [emoji]토큰을 매핑해서 이모지를 구분하지 않는 문제가 있었다. 이모지에는 화난 이모티콘, 웃는이모티콘등 다양하다. 이들을 구현하지 않아서 성능이 잘 안나온 것 같다. ```python --- 수집된 라벨별 상위 감성 패턴 (예시) --- [Label 0]: [('ㅠㅠ', 33867), ('ㅋㅋ', 7427), ('ㅡㅡ', 2363), ('ㅎㅎ', 954), ('ㅜㅜ', 519), ('😡', 44), ('★', 33), ('ㅋㅋㅠㅠ', 30), ('ㅡㅡㅋ', 26), ('ㅜㅠ', 24)] [Label 1]: [('ㅠㅠ', 9489), ('ㅎㅎ', 2362), ('ㅋㅋ', 1856), ('ㅜㅜ', 86), ('ㅡㅡ', 78), ('★', 26), ('😊', 22), ('🌟', 18), ('ㅠㅜ', 12), ('♥', 11)] [Label 2]: [('ㅎㅎ', 19727), ('ㅋㅋ', 9407), ('ㅠㅠ', 5677), ('♥', 832), ('🌟', 640), ('✨', 510), ('ㅜㅜ', 477), ('😊', 415), ('♡', 360), ('👍', 351)] [Label 3]: [('ㅎㅎ', 5713), ('ㅠㅠ', 4948), ('ㅋㅋ', 3900), ('♥', 2067), ('♡', 571), ('ㅜㅜ', 391), ('🌟', 330), ('★', 206), ('✨', 142), ('👍', 137)] ------------------------------------------ ``` 특히 감성패턴을 추출해서 토큰화했는데, 레이블간 구분없이 ‘ㅎㅎ’,’ㅠㅠ’,’ㅋㅋ’등은 모두 자주 등장함을 알 수 있다. 이러한 감성 패턴들을 차라리 노이즈로 구분하는게 좋을지 아니면 특수토큰처리하는게 좋을지, 나머지 변인들을 통제변인 처리하고 실험을 통해서 답을 찾아봐야겠다. 추가로 불용어 처리를 BaseModel에서는 의미가 있는것 같은 단어들도 모두 처리를 했었는데, 수정한 모델에서는 불용어를 기본적인 조사, 어미로 대폭 줄였다. 즉 ‘진짜’같은 단어들은 불용어처리가 되어있었는데, ‘진짜’라는 단어는 의미를 담고있지만, 레이블에 상관없이 모든문장에서 자주 등장하는 단어이다. 따라서 불용어를 해제하니깐, 성능이 하락한게 아닌가 싶다. 이것도 나머지 변인들을 통제변인 처리하고 실험을 통해서 불용어처리를 어떻게 해나갈지 답을 찾아나가봐야겠다. 한번에 여러가지 기능을 구현해보니깐, 어떤 요인이 성능에 어떻게 영향을 미쳤는지 비교하기가 어려웠다. 나머지 변인들을 통제변인으로 설정하고, 한가지씩 베이스라인 코드에 적용해보면서 실험결과를 바탕으로 나중에 한번에 모델로 구현해봐야겠다. ### [영화리뷰 감성분류][모델최적화]-EDA - Canonical URL: https://hyejunl33.github.io/projects/2025-10-24-[Domain_Common_Project]EDA/ - Collection: Project - Published: 2025-10-24 - Tags: Domain_Common_Project, study, EDA # [모델최적화]-EDA ## 데이터셋 형태 및 기본정보 ![image](/assets/images/2025-10-24-01-07-56.png) - 28만개의 데이터가 4개의 클래스를 갖는 형태를 띠고있다. - review가 결측인 데이터가 6개가 있다. - 중복리뷰는 3350개있다. 이떄 중복면서 label이 서로다른 리뷰가 있는것이 보인다. ## 타겟변수 분석 ![image](/assets/images/2025-10-24-01-08-04.png) 일단 데이터셋은 Imbalance함을 알 수 있따. 강한 긍정과 약한 부정데이터가 상대적으로 적고, 강한 부정과, 약한 긍정 데이터가 많음을 알 수 있다. 모델이 일반화된 학습을 할 수 있도록 Focal Loss나 Weighted Cross Entropy를 사용해야한다. ## 입력변수 분석 ![image](/assets/images/2025-10-24-01-08-14.png) ![image](/assets/images/![0218cc5b-4133-49d5-b7dd-c22a8d70a4ec.png](0218cc5b-4133-49d5-b7dd-c22a8d70a4ec.png).png) - 텍스트 길이를 분포로 확인해보면 문자수 분포랑 단어수분포가 일반적으로 일치함을 알 수 있다. → 다를이유가 없으니깐 - 일반적으로 x축이 작은곳에 분포가 몰려있고, 그 이후에 종모양의 분포가 있음을 알 수 있다. ![image](/assets/images/2025-10-24-01-08-44.png) 매우 짧은 리뷰와 매우 긴 리뷰를 살펴보면 직관적으로 봤을때는 짧은리뷰나, 긴리뷰나 데이터로 사용할 가치가 있어보인다.(레이블과 리뷰가 일치해보인다.) 일단 데이터로 모두 사용해보고, 이 이상치들을 뺴거나 넣거나 해보자. 특히 짧은 리뷰를 모두 필터링하기에는 데이터셋의 대다수가 필터링되어버리기 때문에, 만약 이상치를 거른다면, 매우 긴 리뷰를 걸러보는 실험을 해볼 수 있을것 같다. ## 텍스트 품질 평가 - 비어있거나 null인 텍스트 확인 - 잠재적인 데이터 품질 문제 식별 - 언어 일관성 확인 ![image](/assets/images/2025-10-24-01-08-52.png) - null값이 6개가 있는데 Feature engineering에서 빼야겠다. - 중복리뷰는 중복되는 값들을 빼고 한개의 데이터만 남겨서 학습을 해야겠다. - 특수문자만 있는 리뷰는 특수문자를 특수토큰으로 토크나이징하는 기법을 이용해서 사용해봐야겠다. - 다만 감정을 표현하는 특수문자인 하트, 느낌표, 물음표등이 있긴 하지만, ;이나 ,같은 특수문자가 있는 리뷰도 있기때문에 일단 빼고 학습하는게 맞는것 같다. - 이부분은 정규식을 이용해서 !,?,ㅋ,ㅠ,하트이모티콘,~,간단한 이모티콘(^^,:)) 등 몇가지 경우의수를 정해두고, 감성을 포함한 특수문자만 학습데이터에 넣고, 아닌 경우는 데이터에서 빼야겠다. ![image](/assets/images/2025-10-24-01-09-01.png) - 숫자만 있는 리뷰는 0점이라면 0, 4점이라면 4 라는식의 리뷰인지 직접 확인해보고 뺄지 넣을지 생각해봐야겠다. - 한글이 없는 리뷰는 영어로 리뷰를 작성한게 대부분같은데, Tokenizer를 이용할때, 한글이 아닌경우 영어단어도 voca에 추가해서 처리할 수 있는지 고려해봐야될것 같다. ![image](/assets/images/2025-10-24-01-09-09.png) ## 클래스별 텍스트 특성 ![image](/assets/images/2025-10-24-01-09-52.png) 클래스별 텍스트 길이에 유의미한 차이가 있진 않다.→ 텍스트 길이에따라 과적합될 걱정은 안해도 될 것 같다. ![image](/assets/images/2025-10-24-01-09-21.png) 클래스별 어휘의 다양성(TTR)도 유의미한 차이가 보이지는 않는다. ```python # 한국어 불용어 리스트 확장 # 일단 불용어를 최소화하여 감성 단어가 포함될 수 있도록 조정 stopwords = [ # --- 조사 --- "은", "는", "이", "가", "을", "를", "의", "에", "와", "과", "도", "로", "으로", "에서", "에게", "께", "한테", "한테서", "께서", # --- 연결 어미 (일부) --- "고", "며", "면", "나", "니", "다", "서", "아", "어", # --- 대명사/지시사 (문맥 의존성 높음, 최소화) --- "그", "저", "이", "것", "곳", "때", "수", # '수 있다/없다' 등에서 중요할 수 있어 포함 여부 실험 필요 # --- 접속사 (문맥 의존성 높음, 최소화) --- "그리고", "그러나", "하지만", "그런데", # --- 기타 (문맥 의존성 높음, 최소화) --- "한", # '한 번' 등 수식 역할 # --- 주석 처리된 기존 불용어 중 감성 가능성 있는 단어 --- # "있다", "없다", "되다", "하다", "이다", "아니다", "같다", "많다", # "좋다", "나쁘다", "정말", "너무", "매우", "아주", "참", "좀", # "사람", "것들" ] ``` - 불용어 리스트를 봤을때, 감성분류 task인 만큼, 좋다, 나쁘다, 정말등등은 불용어가 아니라 감성을 담고있는 단어라고 생각이 들어서 주석처리를 했다. 감성을 담고있지 않은 단어들을 불용어처리 해야하기 때문에 일단 주석처리한 위의 리스트를 학습에 활용해야 겠다. - BERT는 문맥을 이해하기 때문에 제외할 불용어는 최소화하는걸 추천한다고 한다. - 어휘사전을 데이터셋이 나뉘기전에 만들어버리면 Data_leakage문제가 발생한다! → k-Fold등으로 데이터셋을 나누고 난 후에 각각 만들어야됨. ```python 클래스별 상위 빈출 단어 (불용어 제외): 0 (강한 부정) - 총 114066개 샘플: 1. '너무': 106022회 (3.2%) 2. '진짜': 82753회 (2.5%) 3. '보는': 55270회 (1.7%) 4. '정말': 52786회 (1.6%) 5. '이런': 52545회 (1.6%) 6. '영화': 49829회 (1.5%) 7. '영화는': 44978회 (1.4%) 8. '보고': 44776회 (1.4%) 9. '영화를': 40348회 (1.2%) 10. '내내': 39208회 (1.2%) 1 (약한 부정) - 총 27216개 샘플: 1. '너무': 16454회 (2.2%) 2. '보고': 10499회 (1.4%) 3. 'ㅠㅠ': 8538회 (1.1%) 4. '뭔가': 7251회 (1.0%) 5. '영화': 7061회 (0.9%) 6. '보는': 6857회 (0.9%) 7. '진짜': 6833회 (0.9%) 8. '정말': 6658회 (0.9%) 9. '그냥': 6467회 (0.9%) 10. '영화는': 6200회 (0.8%) 2 (약한 긍정) - 총 99416개 샘플: 1. '진짜': 60021회 (2.3%) 2. '정말': 56003회 (2.1%) 3. '너무': 45092회 (1.7%) 4. '영화': 34369회 (1.3%) 5. '보는': 29527회 (1.1%) 6. '특히': 28620회 (1.1%) 7. '영화는': 26255회 (1.0%) 8. '내내': 22921회 (0.9%) 9. '영화를': 20993회 (0.8%) 10. '보고': 19278회 (0.7%) 3 (강한 긍정) - 총 38952개 샘플: 1. '진짜': 46041회 (4.4%) 2. '정말': 24398회 (2.4%) 3. '너무': 22577회 (2.2%) 4. '영화': 17807회 (1.7%) 5. '영화는': 15968회 (1.5%) 6. '보는': 12402회 (1.2%) 7. '특히': 11121회 (1.1%) 8. '내내': 10439회 (1.0%) 9. '보고': 9783회 (0.9%) 10. '영화를': 9369회 (0.9%) ``` - ‘진짜’를 불용어처리를 막으니깐, 강한긍정, 약한긍정, 강한부정 모두에서 상위권에 속함을 알 수 있다. 이게 실제 모델이 validation할때 어떤 영향을 미칠지는 아직 잘 모르겠는데, 불용어 리스트를 바꿔가며 실험을 해봐야겠다. ### [영화리뷰 감성분류][study]메트릭 선택은 기술이 아니라 의사결정의 정치다. - Canonical URL: https://hyejunl33.github.io/projects/2025-10-22-[Domain_Common_Project]Select_Metrics/ - Collection: Project - Published: 2025-10-22 - Tags: Domain_Common_Project, study, metrics, FocalLoss, WeigtedCrossEntropy, Lossfunction 이 글은 원본글을 바탕으로 학습목적으로 정리한 글임을 밝힙니다. 원본 글: https://stages.ai/en/competitions/370/board/community/post/3051 # 메트릭 선택은 기술이 아니라 의사결정의 정치다. 모델 개발에서 성능이 좋다는건 특정 메트릭의 값이 좋다는 의미다. → 어떤 메트릭을 우선시 해야할까? - **Accuracy**: 전체 예측 중 맞춘 비율. 간단하지만, 데이터 불균형에서는 무의미할 수 있음. - **Precision**: Positive로 예측한 것 중 실제로 Positive인 비율. False Positive 줄이는 데 초점. - **Recall**: 실제 Positive 중에서 모델이 Positive로 잡아낸 비율. False Negative 줄이는 데 초점. - **FPR (False Positive Rate)**: 실제 Negative 중에서 Positive로 잘못 분류한 비율. 각 metric마다 데이터에서 중점으로 여기는 부분이 다르다. # 불균형 데이터에서 acc의 의미 어떤 질병이 있는 환자의 비율이 1%라고 할때 질병이 없는 환자의 비율은 99%이다. 어떤 모델은 input과 상관없이 질병이 없다라고만 판단을 내릴때 Accuracy는 99%이다. 얼핏보면 좋은 모델인것 처럼 보이지만, 인풋과 상관없이 질병이 없다라고만 판단을 내리므로 좋은 모델은 아니다. 즉 Classification에서 Class간 불균형 데이터에서는 ACC만을 올리는것이 좋은모델은 아니다. ### 예시2: Multi-class classification 영화리뷰 감성분류를 한다고 해보자. - positive: 70% - Neutral: 20% - Negative: 10% Positive의 학습데이터가 많으므로 당연히 모델을 돌렸을떄 positive는 잘 맞히지만, Neutral과 Negative를 Positive로 많이 오분류 한다. ## Macro-F1 vs Micro-F1 ![image](/assets/images/2025-10-22-22-42-00.png) 일단 F1은 정밀도와 재현율의 조화평균으로 정밀도와 재현도룰 둘다 반영한 Metric이다. - **Micro-F1:** 전체 클래스의 TP/FP/FN을 한 번에 합산해 Precision·Recall을 계산 → 샘플 수가 많은(다수) 클래스의 영향이 크다. 따라서 불균형 데이터에서는 Micro-F1이 높더라도 모델의 성능이 안좋을 수 있다. - **Macro-F1:** 클래스별 F1을 구해 단순 평균 → 각 클래스를 동일 가중으로 취급하므로 소수 클래스 성능 저하를 잘 드러냄. - 클래스별로 F1값을 따로 계산하고, 각 클래스를 동일 가중으로 취급하여 평균내므로, 어떤 클래스의 데이터가 매우 적더라도, 최종 F1값에 잘 반영될 수 있음. - **Weighted-F1**: 클래스별 F1에 **표본 비율 가중치**를 곱해 평균 → Micro와 Macro의 중간 성격. ## Loss를 통한 Metric 개선 일반적은 Cross Entropy Loss는 모든 클래스의 오류를 동일하게 취급한다. 따라서 어떤 클래스의 데이터만이 매우 큰 비중을 차지하면 학습과정에서 다수 클래스에 치우쳐서 소수클래스의 Loss는 거의 무시된다. ### Class Weighted Cross Entropy 데이터가 적게 나오는 클래스일 수록 Loss 계산시 더 큰 가중치를 부여한다. 만약에 어떤 클래스의 데이터가 10%이고 다른 클래스의 데이터가 70%면 어떤 클래스의 Loss를 7배 가중치를 줘서 계산한다. 즉 각 클래스의 표본개수 비율을 반대로 뒤집어서 가중치로 사용한다. 이를 통해 모델이 소수 클래스도 무시하지 않고 학습하도록 유도한다. ![image](/assets/images/2025-10-22-22-42-09.png) 이미지출처: [https://stages.ai/en/competitions/370/board/community/post/3051](https://stages.ai/en/competitions/370/board/community/post/3051) ### Focal Loss 모델이 이미 쉽게 맞히는 샘플보다는, 계속 틀리는 어려운 샘플에 더 집중하도록 Lossfunction 자체를 조정한다. 즉 클래스별로 맞히기 어려운 샘플일수록 Loss 비중을 높인다. $$\gamma$$에 따라 Loss Function의 형태 자체가 달라짐을 볼 수 있다. $$\gamma$$가 0에 가까울수록 예측확률이 낮을때, 즉 확신이 없을때의 Loss가 매우 커서, 학습이 더 강하게 일어남을 확인할 수 있다. ![image](/assets/images/2025-10-22-22-42-16.png) ![image](/assets/images/2025-10-22-22-42-23.png) 이미지출처: [https://stages.ai/en/competitions/370/board/community/post/3051](https://stages.ai/en/competitions/370/board/community/post/3051) # Living Point - 메트릭 선택은 우선 데이터에 대한 이해를 기반한다. 데이터가 불균형 데이터인지, 소수클래스에대한 판별을 더 민감하게 반응해야하는지 등을 우선 먼저 파악하고, 무엇을 위해 모델을 학습하는지에 따라 Metric을 선택해야 한다. - 메트릭과 Loss function의 일관성도 중요하다. Loss를 줄이는 방향이 실제로 Metric을 올리는 방향과 일치해야 한다. 이를 위해 Class-weighted Cross Entropy나 Focal Loss같은 방법을 사용할 수 있다. ## Study ### 우리 아이가 달라졌어요: 텍스트에 워터마크를 어떻게 넣을까 - Canonical URL: https://hyejunl33.github.io/study/2026-10-07-text-watermark-kgw-synthid-textgrain/ - Collection: Study - Published: 2026-10-07 - Tags: Study 이 글은 DEVOCEAN에도 게재되었습니다. [DEVOCEAN에서 읽기](https://devocean.sk.com/blog/techBoardDetail.do?id=168550&isShared=Y) ## 우리 아이가 달라졌어요: PRD 에이전트가 이상한말을 해요. 뤼튼에서 인턴으로 일하던 올해 여름, 같은 IAB중 PM들이 사용할 PRD Generator Agent를 만드는 동료 인턴이 있었다. 8월쯤 PM분들이 에이전트 성능이 이상하다는 이야기를 들었다. 심지어 클로드가 이상한말을 해서 직접 타자를 쳐서 PRD를 작성까지한다고 들었다..!(AI없이, 26년 8월에..?) Claude Fable API 출력에 텍스트 워터마크가 들어가기 시작한 뒤 단어 선택이 눈에 띄게 어색해졌고, PM들이 결국 Agent에서 Fable 대신 gemini나, GPT계열 모델들을 쓰게 됐다는 내용이었다. 아니 근데 어떻게 text에 워터마크를 넣나? 궁금했다. 이미지는 픽셀값을 미세하게 변형하거나 메타데이터에 워터마크를 박는게 쉬울텐데.. 먼저 PM들이 작성하는 PRD는 누가 읽어도 요구사항을 같은 뜻으로 이해해야 하는 문서다. 문장은 얼핏 그럴듯한데 단어가 어색하면, 읽는 사람이 의도를 다시 해석해야 한다. 문서 작성을 도와주는 Agent가 오히려 문장을 고치는 일을 늘린다면 사용하는 입장에서는 모델을 바꿀 이유가 충분하다. ## 텍스트에 흔적을 남긴다는 건 최근 내가 자주보는 유튜버인 임커밋님의 [「텍스트 워터마크..? 어떻게?」](https://www.youtube.com/watch?v=8CV9GHclD0c)도 참고했다. 다음 단어를 고르는 과정에 어떻게 흔적을 남길 수 있는지 이해하는 데 도움이 됐다.
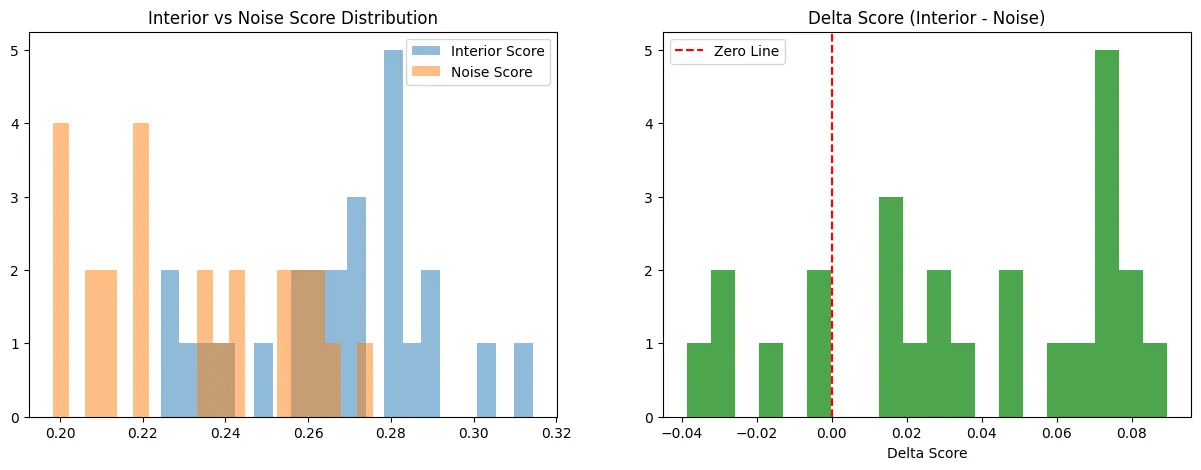
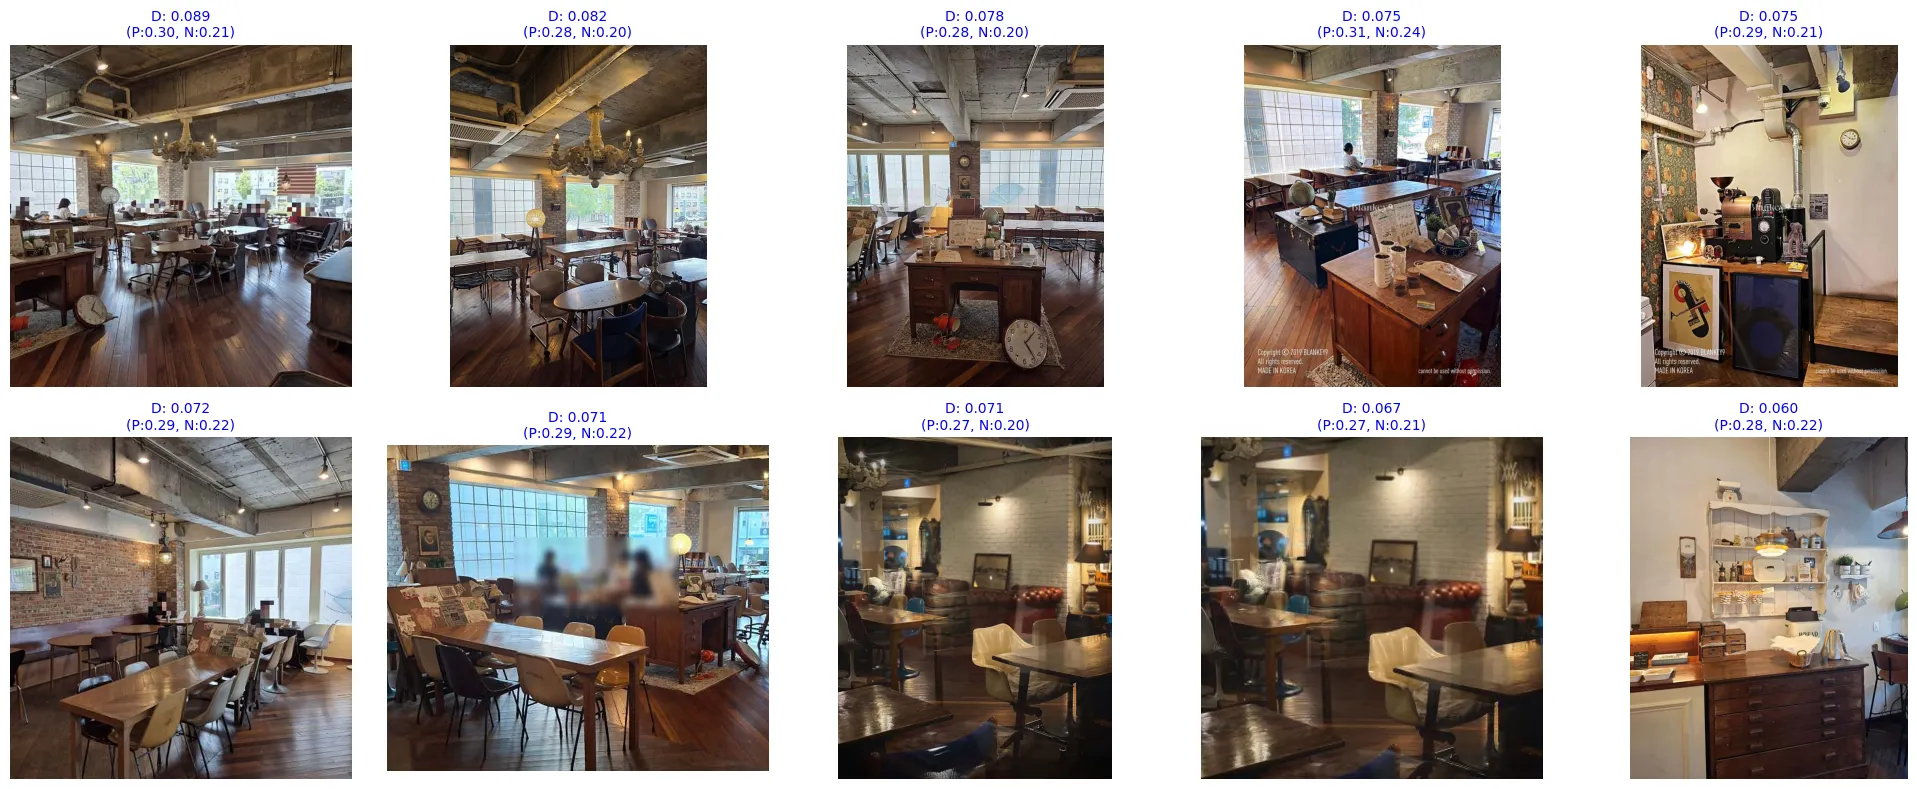
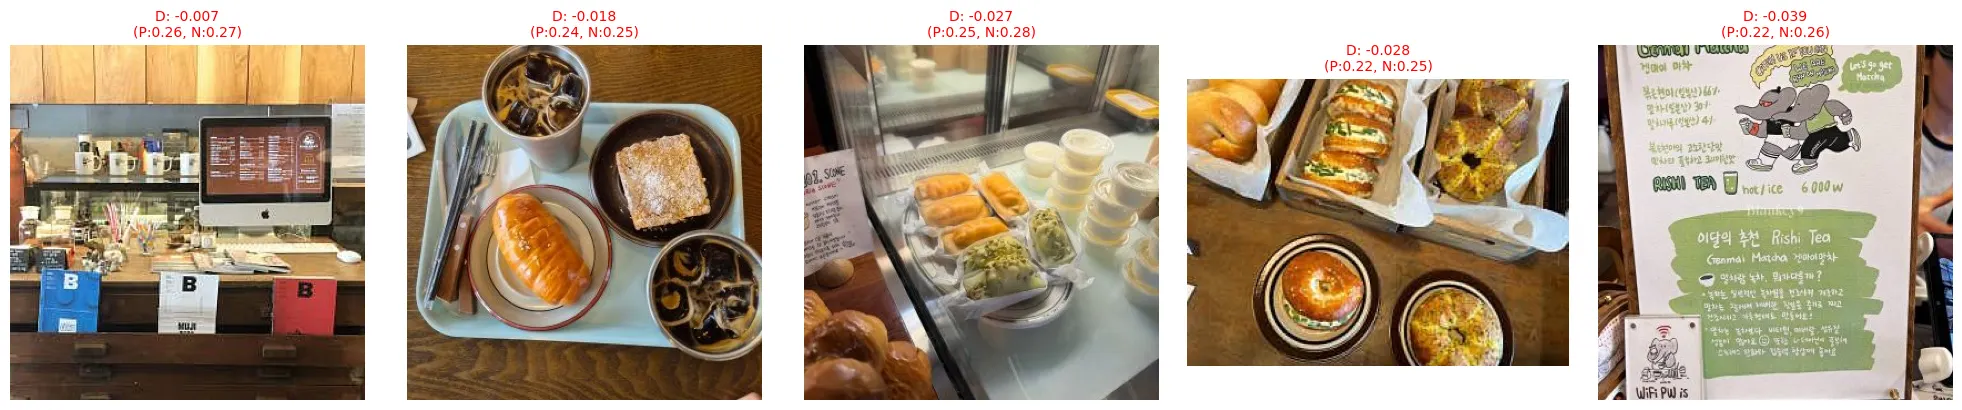
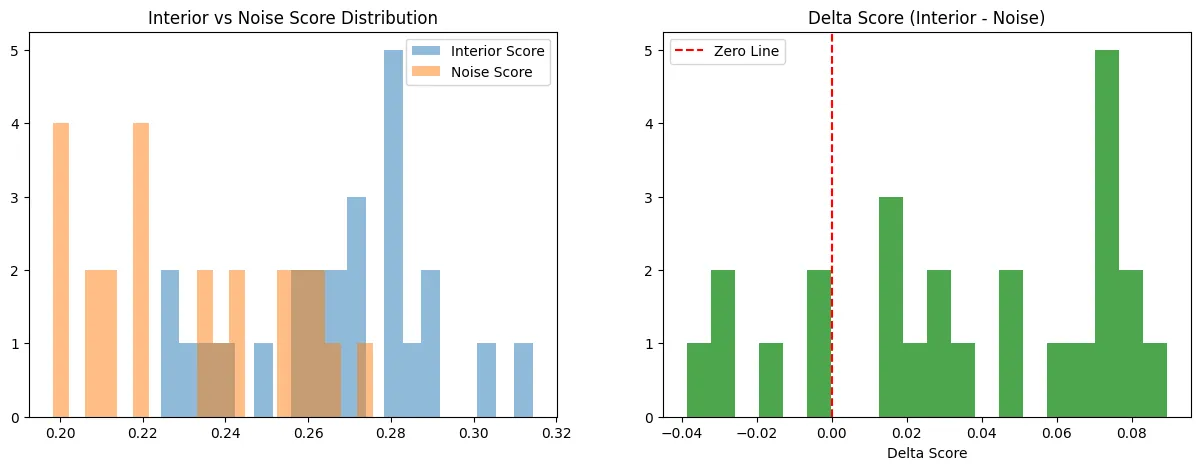
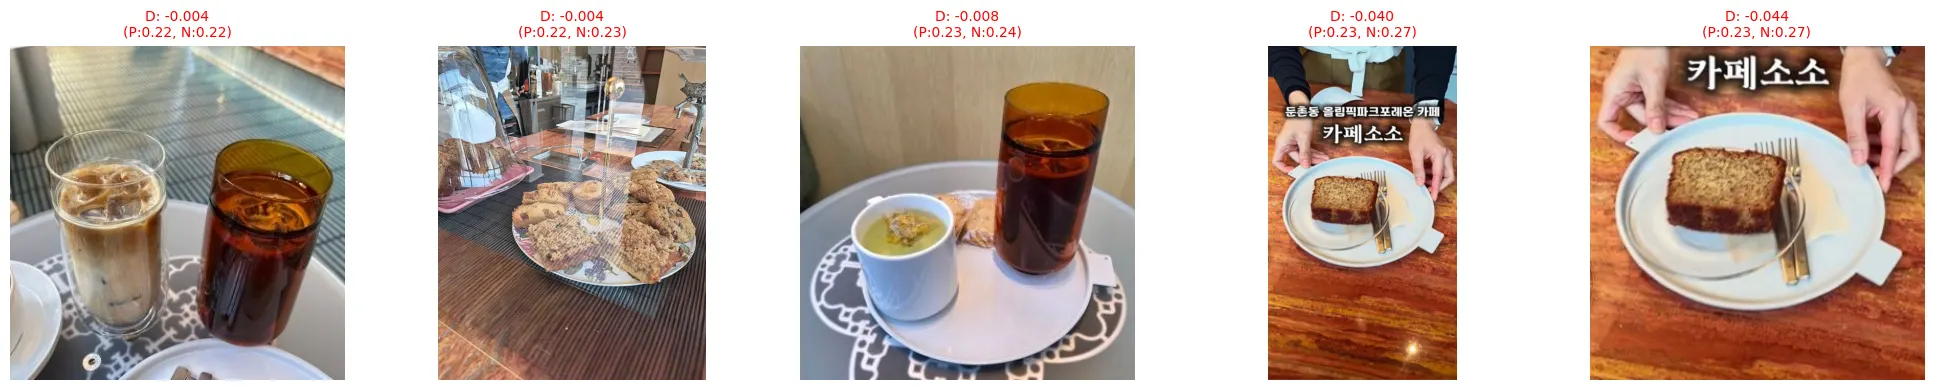
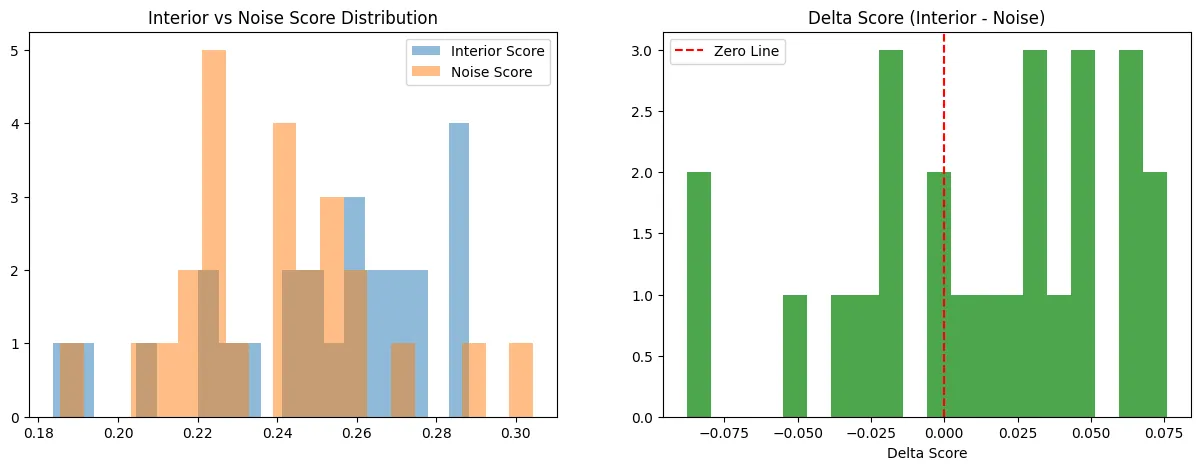
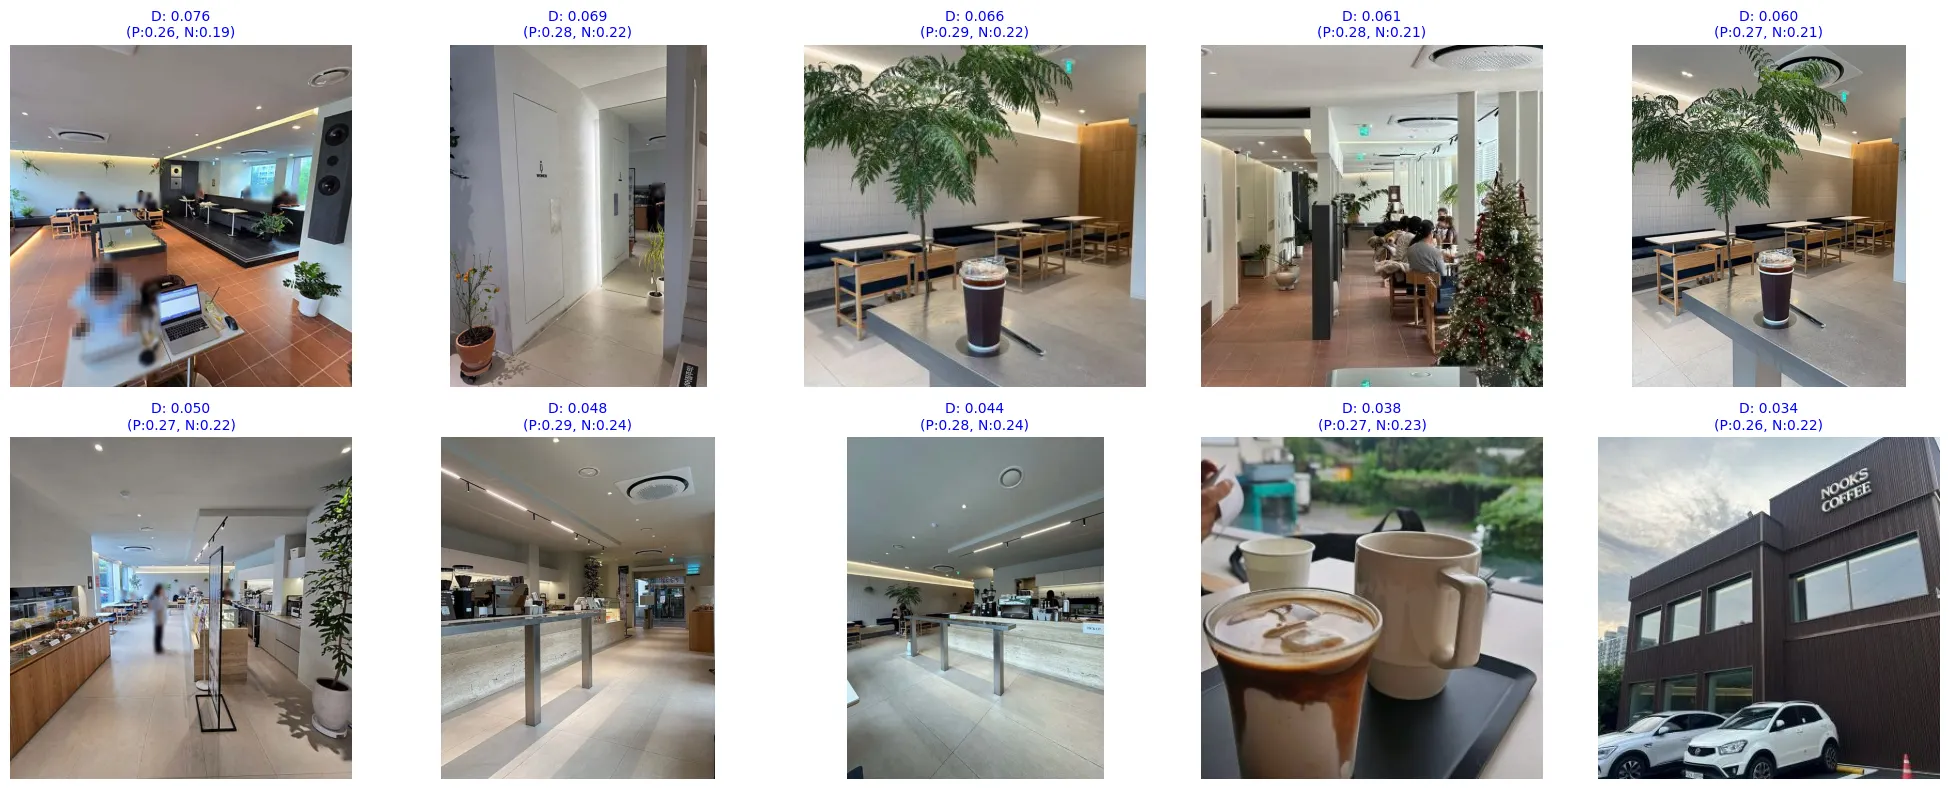
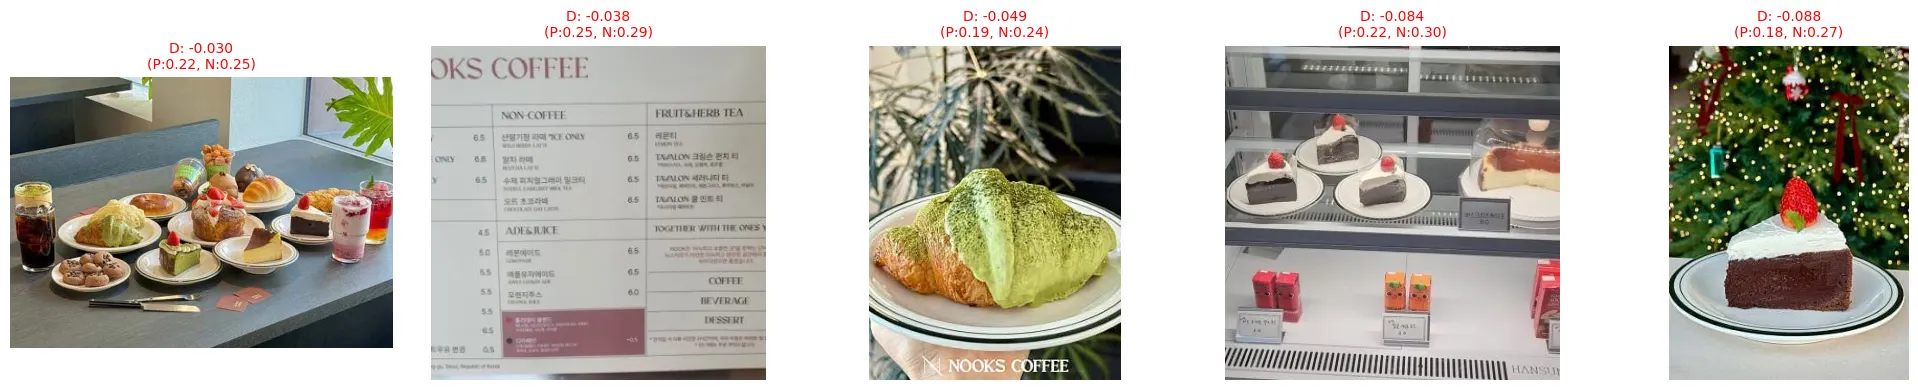
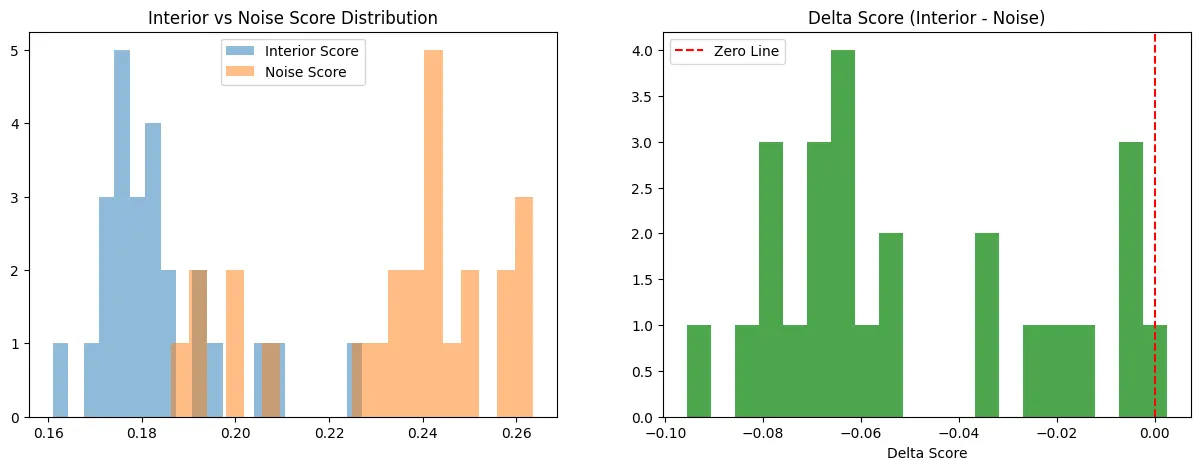
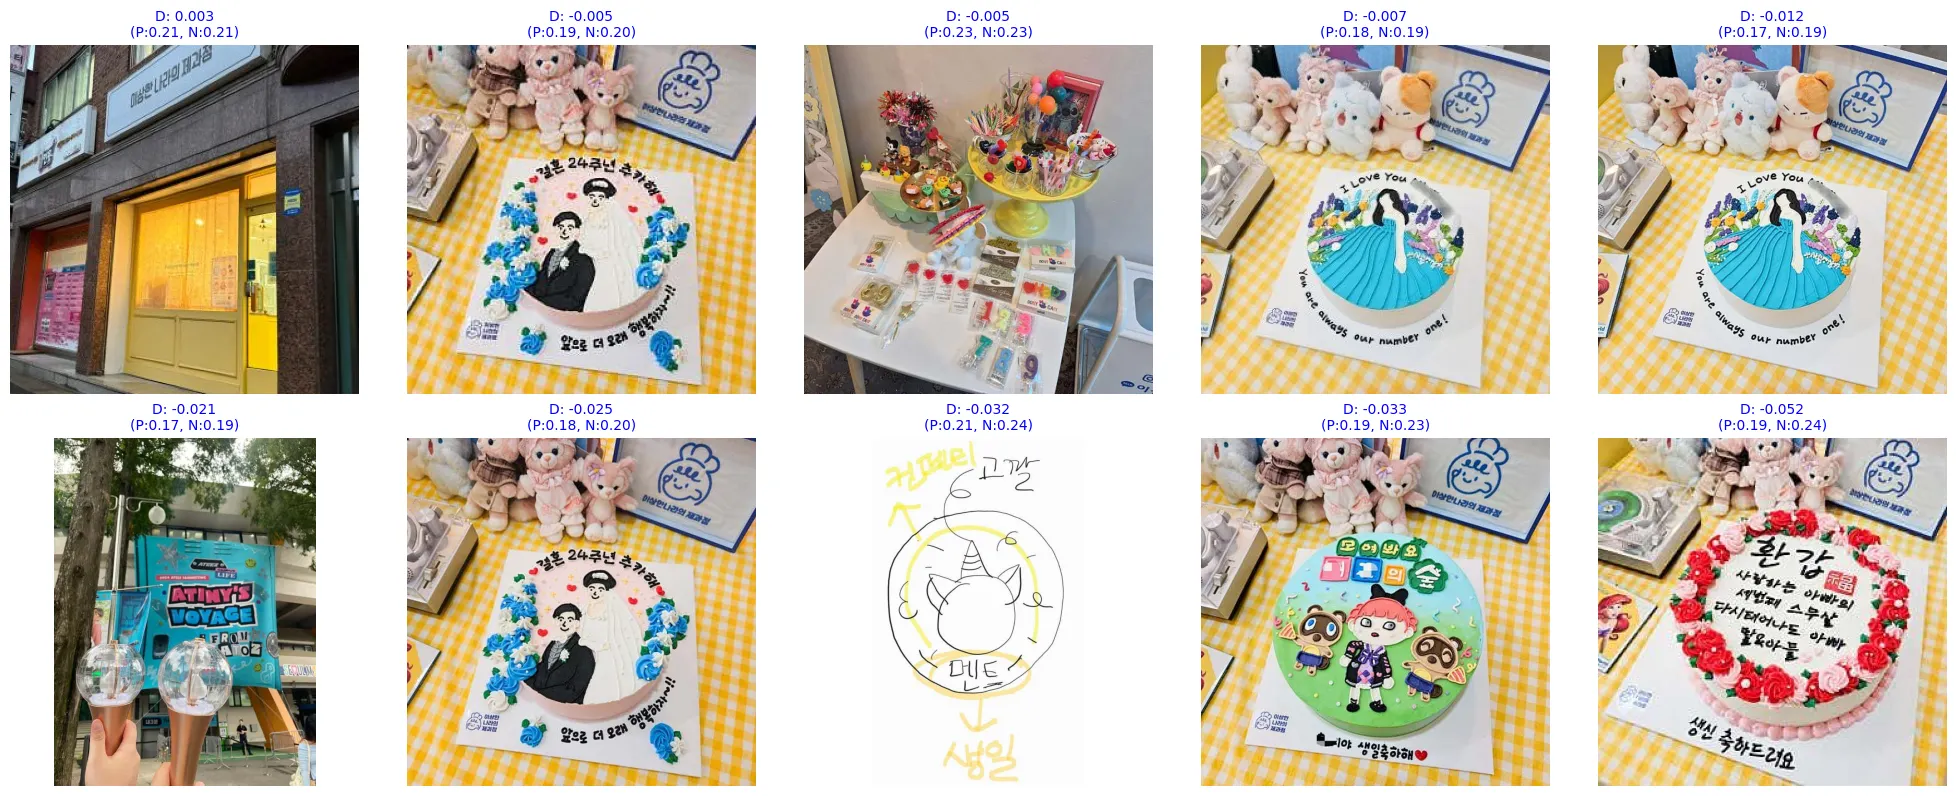




처음 동료가 알려준 텍스트에 워터마크 넣는 방식은 Red-Green논문을 읽어보라고 해서 그 논문부터 시작했다. 특정단어의 확률을 높이는걸로, 워터마크를 넣는다면, 일단 결정론적이지가 않고 확률로만 그게 AI작성글인지 아닌지를 알 수 있을테다. 그리고 토큰수가 많아질수록(표본이 커질수록) 신뢰도가 높아질거다. “바나나, 원숭이” 라는 문장을 가지고는 당연히 ai작성인지 아닌지 판단을 못할테다. ## 먼저 LLM이 다음 토큰을 고르는 방식 LLM은 문장을 한 번에 완성하지 않는다. 지금까지 쓴 내용을 보고, 다음에 올 토큰의 확률을 계산한 뒤 하나를 고른다. 토큰은 모델이 텍스트를 다루는 단위로, 단어 하나일 수도 있고 단어의 일부일 수도 있다. 여기서는 단어 하나처럼 생각하면 된다. 예를 들어 ‘변경 이력은 \_’ 다음에 올 후보가 이렇게 나왔다고 해보자. | 다음 표현 | 선택될 확률 | | --- | --- | | 보관한다 | 60% | | 저장한다 | 30% | | 기록한다 | 10% | 이렇게 후보별로 선택될 가능성을 나열한 것이 확률분포다. 이 분포에서 하나를 뽑는 과정을 샘플링이라고 한다. ‘보관한다’가 가장 자주 나오겠지만, ‘저장한다’나 ‘기록한다’도 나올 수 있다. **텍스트 워터마크는 이 선택 과정에 개입한다.** 자연스럽게 이어질 표현이 여러 개라면, 비밀 규칙에 맞는 후보가 조금 더 자주 나오도록 선택 방식을 바꾸는 것이다. 한 번의 선택만 보면 티가 나지 않는다. 하지만 이런 선택이 글 전체에 쌓이면, 나중에 같은 규칙으로 그 흔적을 찾아볼 수 있다. 이 비밀 규칙을 만드는 데 쓰는 값이 ‘키’다. 생성기는 앞선 문맥과 키로 이번 위치에서 어떤 후보를 선호할지 정한다. 검출기는 완성된 글을 읽으며 같은 문맥과 키로 그 규칙을 다시 만든다. 그래서 글에 별도 표시를 붙이지 않아도, 선택된 토큰들을 통해 흔적을 확인할 수 있다. ![SynthID-Text 논문 Fig. 1](/assets/images/notion/9dc20ab41d934721bd65/01-synthid-overview.png) 그림 1. SynthID-Text 논문의 Fig. 1을 캡처했다. 생성할 때 샘플링에 키가 개입하고, 검출할 때 텍스트와 키를 사용한다. 출처: [Dathathri et al., 2024](https://www.nature.com/articles/s41586-024-08025-4). ## KGW: 특정 후보가 조금 더 자주 나오게 만들기 동료가 알려준 Red–Green 방식부터 보면 원리가 가장 직관적이다. KGW는 다음 토큰을 고를 때 후보들을 Green과 Red라는 두 그룹으로 나누고, Green에 속한 후보가 뽑힐 확률을 조금 높인다. [KGW 논문](https://arxiv.org/abs/2301.10226) Green은 좋은 단어, Red는 나쁜 단어라는 뜻이 아니다. 문맥과 키로 정한 임의의 구분이라, 같은 단어도 앞선 문맥이 바뀌면 다른 그룹에 들어갈 수 있다. 아까 예시에서 ‘저장한다’가 Green에 들어갔다고 해보자. 그러면 ‘저장한다’의 선택 확률을 원래의 30%보다 높이고, 전체 확률의 합이 100%가 되도록 나머지 후보의 확률도 조정한다. ‘저장한다’를 무조건 출력하게 만드는 게 아니라, 이전보다 자주 뽑히게 만드는 것이다. ![KGW에서 Green 후보의 선택 확률을 높이는 과정](/assets/images/notion/9dc20ab41d934721bd65/kgw-paper-flow-clean.gif) 위 애니메이션은 후보를 나누고, Green 후보에 보너스를 준 뒤, 다음 토큰을 뽑는 흐름을 보여준다. 이 과정을 토큰 하나를 생성할 때마다 반복한다. ### 나중에는 그 흔적을 센다 검출할 때는 글의 각 위치에서 Green 그룹을 다시 만들고, 실제로 선택된 토큰이 Green이었는지 센다. 예를 들어 우연이라면 100개 중 약 50개가 Green일 상황에서, 실제 글에서는 70개가 Green이었다고 해보자. 검출기는 이 차이를 보고 ‘우연히 나왔다고 보기에는 Green이 꽤 많네?’라고 판단한다. 생성할 때 Green을 더 자주 선택하도록 했던 흔적이 남은 것이다. 여기서 비결정론적이라는 말이 연결된다. **표시가 있으면 바로 확정하는 방식이 아니라, 이런 선택이 우연히 나왔을 가능성을 따져보는 방식이다.** 글이 길수록 비교할 토큰이 많아져, 그 경향을 더 잘 볼 수 있다. ## SynthID-Text: 후보끼리 토너먼트를 시키기 KGW가 후보의 확률에 직접 보너스를 준다면, SynthID-Text는 먼저 모델의 원래 확률분포에서 후보를 뽑는다. 그리고 문맥과 키로 만든 점수를 이용해 후보끼리 겨루게 한다. [SynthID-Text 논문](https://www.nature.com/articles/s41586-024-08025-4) 예를 들어 후보 네 개를 뽑았다고 해보자. 두 개씩 겨뤄 둘을 남기고, 남은 둘이 다시 겨뤄 최종 토큰 하나를 고른다. 모델이 원래 선호하던 토큰은 처음 후보를 뽑을 때 더 자주 등장하고, 대결에서는 키로 정한 점수가 선택에 개입한다. ![SynthID-Text 논문 Fig. 2](/assets/images/notion/9dc20ab41d934721bd65/03-synthid-tournament.png) 그림 2. SynthID-Text 논문의 Fig. 2. 위는 문맥·키로 만드는 점수, 아래는 후보 토큰의 토너먼트다. 출처: [Dathathri et al., 2024](https://www.nature.com/articles/s41586-024-08025-4). ![SynthID-Text에서 후보들이 토너먼트를 거치는 과정](/assets/images/notion/9dc20ab41d934721bd65/synthid-paper-flow-clean.gif) 이 점수는 문장을 얼마나 잘 쓰는지 평가한 점수가 아니다. 워터마크를 남기기 위해 키로 정한 점수다. 점수가 높은 후보가 대결에서 더 자주 살아남으면, 완성된 글에도 그 점수의 흔적이 쌓인다. 검출기는 같은 규칙으로 선택된 토큰의 점수를 다시 계산해 그 경향을 확인한다. KGW와의 차이는 선택에 개입하는 위치다. KGW는 뽑기 전에 후보의 확률을 바꾸고, SynthID-Text는 뽑아 놓은 후보들 중에서 승자를 고른다. ## textGrain: 후보를 묶어서 고르기 textGrain은 후보 토큰들을 여러 묶음으로 나눈다. 그리고 문맥과 키를 이용해 어떤 묶음에서 고를지를 조절한다. 묶음을 고른 뒤에는 그 안에서 토큰 하나를 뽑는다. [textGrain 기술보고서](https://cdn.openai.com/pdf/e9508624-d767-41b6-a26d-e34ca798ada6/textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf) ![textGrain 보고서 Fig. 1](/assets/images/notion/9dc20ab41d934721bd65/05-textgrain-embedding.png) 그림 3. textGrain 보고서의 Fig. 1. 토큰을 키 기반 블록으로 묶고, 엔트로피 예산 아래에서 블록의 조건부 분포를 구성한 뒤 토큰을 뽑는다. 출처: [OpenAI 기술보고서, 2026](https://cdn.openai.com/pdf/e9508624-d767-41b6-a26d-e34ca798ada6/textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf). 예를 들어 ‘보관한다’와 ‘기록한다’가 한 묶음에 들어갔다면, 그 묶음 안에서는 모델이 원래 선호하던 비율을 유지한다. 앞의 예시에서는 둘의 확률이 60%와 10%였으니, 묶음 안에서도 ‘보관한다’가 여섯 배 자주 뽑히는 식이다. 키는 어떤 묶음을 고를지에 개입하고, 묶음 안의 선택에는 원래의 상대적인 선호를 사용하는 것이다. 여기에 워터마크가 선택을 지나치게 좌우하지 않도록 제한을 둔다. 쉽게 말하면, **흔적은 남기되 다음 표현을 고를 자유가 얼마나 줄어드는지도 관리하는 방식이다.** 후보가 다양하게 뽑힐 수 있던 상황에서 키 때문에 선택이 한쪽으로 너무 몰리지 않도록 조절한다. 검출기는 출력된 토큰이 어느 묶음에 속했는지와 키로 만든 점수를 다시 확인한다. 키와 연결된 선택이 글 전체에서 얼마나 자주 나타났는지를 보는 것이다. ![textGrain 보고서 Fig. 2](/assets/images/notion/9dc20ab41d934721bd65/07-textgrain-detection.png) 그림 4. textGrain 보고서의 Fig. 2. 관측한 토큰의 블록과 키 기반 점수를 복원해 검정 통계량을 만든다. 출처: [OpenAI 기술보고서, 2026](https://cdn.openai.com/pdf/e9508624-d767-41b6-a26d-e34ca798ada6/textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf). ## 세 방식의 핵심은 같은 곳에 있다 | 방식 | 흔적을 남기는 방법 | 나중에 확인하는 것 | | --- | --- | --- | | KGW | Green 후보가 뽑힐 확률을 높인다 | Green 후보가 얼마나 많이 나왔는지 | | SynthID-Text | 뽑은 후보들을 키 점수로 겨루게 한다 | 선택된 토큰의 점수가 얼마나 높은지 | | textGrain | 키에 따라 후보 묶음의 선택을 조절한다 | 선택된 묶음과 키 점수가 얼마나 연결되는지 | 세 방식 모두 다음 토큰을 고르는 과정에 키를 끼워 넣는다. 같은 문맥과 키에서 특정 후보를 선호하도록 선택을 조절하고, 그 흔적을 완성된 글에서 찾는다. SynthID-Text와 textGrain은 여러 키의 경우를 평균냈을 때 원래의 토큰 확률을 유지하도록 설계하면서도, 개별 선택에는 키의 흔적을 남긴다. 내가 처음 궁금했던 ‘텍스트에 워터마크를 어떻게 넣지?’의 답은 여기에 있었다. **토큰을 고르는 확률에 개입해서 글 전체에 통계적인 흔적을 남긴다.** KGW처럼 확률분포를 직접 비틀 수도 있고, 후보끼리 겨루게 하거나 묶음을 고르는 과정에서 선택을 바꿀 수도 있다. ![SynthID-Text 논문 Fig. 3](/assets/images/notion/9dc20ab41d934721bd65/08-synthid-evaluation.png) 그림 5. SynthID-Text 논문의 Fig. 3. 왼쪽은 길이에 따른 검출률, 가운데는 선택적 검출의 보류 비율, 오른쪽은 분포를 바꾸는 설정의 검출률·log perplexity 관계다. 출처: [Dathathri et al., 2024](https://www.nature.com/articles/s41586-024-08025-4). ## 다시 PRD Generator Agent로 처음에는 텍스트 안에 표시를 어떻게 숨기는지가 궁금했다. 결과만 보자면 다음 표현을 고르는 과정에 통계적인 워터마크를 남기는 것이었다. 예를 들어 ‘사용자는 결제 전에 총액을 확인할 수 있어야 한다’에서 ‘있어야 한다’를 ‘있을 수 있다’로 바꾸면, 요구사항의 강도가 달라진다. ‘저장한다’와 ‘보관한다’도 문맥에 따라 다르게 읽힐 수 있다. 그런데 PRD에서는 문장이 자연스러운지와 함께, 원래 의도가 그대로 전달되는지가 중요하다. 그래서 이 Agent를 평가한다면 PM이 어색한 표현을 얼마나 고치는지, 요구사항의 의미가 유지되는지, 문서를 완성하는 데 얼마나 걸리는지를 보고 싶다. 오픈소스로 풀려있는 humanizer스킬들을 보면 AI 말투 몇가지를 룰베이스로 정해두고, 그런 말투를 출력하지 않도록 프롬프트로 막는것을 보았을때, 일반적으로 “AI말투”라는걸 정의할 수 있어보이긴 하지만, 사용해본결과 완벽하진 않다..! 비결정론적인 워터마크라는개념을 처음알게되었는데, 신기하다..! 이젠 AI가 쓴글을 규칙기반으로 찾던 GPT-killer같은 앱이 필요없어질지도 모르겠다. ## 참고 자료 - [Dathathri et al. — SynthID-Text, Nature, 2024](https://www.nature.com/articles/s41586-024-08025-4) - [Li et al. — textGrain 기술보고서, 2026](https://cdn.openai.com/pdf/e9508624-d767-41b6-a26d-e34ca798ada6/textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf) - [Kirchenbauer et al. — A Watermark for Large Language Models, 2023](https://arxiv.org/abs/2301.10226) - [Anthropic — How Claude’s text watermark works, 2026.08.14](https://www.anthropic.com/news/claude-text-watermark) - [Claude 모델별 워터마크 적용 범위](https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content) - [OpenAI — Our approach to EU text provenance rules, 2026.10.05](https://openai.com/index/eu-text-provenance/) - [임커밋 — 텍스트 워터마크..? 어떻게?, 2026.09.10](https://www.youtube.com/watch?v=8CV9GHclD0c) 본문의 데이터 흐름 애니메이션 2개는 3Blue1Brown의 오픈소스 [Manim](https://github.com/3b1b/manim)에서 출발한 [Manim Community](https://www.manim.community/)로 만듬 ### 시골쥐의 서울 상경기: W&B Meetup과 Claude Session - Canonical URL: https://hyejunl33.github.io/study/2026-04-10-시골쥐의-서울-상경기-WandB-Meetup과-Claude-Session/ - Collection: Study - Published: 2026-10-06 - Tags: Study, W&B, AWS, Claude Code, MLOps, AI 엔지니어 ## 내가 이런 세션에 참여한다고? 지방에 살면서는 이런 밋업에 갈 기회가 있으면 꼭 가보고 싶었다. 근데, 비전공자에다가, 지방에 살고있었기 때문에, 신청을 해도 참여할 수 없었다..(소속 회사나 연구실을 필수로 작성해야한다) 인턴을 하러 서울로 상경하게 되면서 그 기회가 생겼다. 신청서에 소속 회사란을 적을때, 그동안은 등줄기에 땀이 흘렀는데, 이번에는 배에 힘을 주고 "뤼튼 테크놀로지스"라고 적었다. 이곳은 서울 강남. 그렇게 다녀온 두 행사를 한 번에 정리해 보려 한다. - 2026년 4월 10일, 강남 위워크: Weights & Biases 밋업 - 2026년 6월 16일, AWS 강남 센터필드(서울 강남구 테헤란로 231): Seoul · Claude Code Cloud Night 결론부터 정리하자면, 최근 트렌드는 코드를 잘 짜는 능력보다, 무엇을 문제로 정의하고 무엇을 기준으로 판단할지가 중요해지고 있다는 것이 중요한것 같다. ## 1. W&B 세션: 강남 위워크에서 현장에 도착하니 입구부터 W&B 배너가 서 있었고, 체크인하면서 받은 스티커를 손에 들고 자리를 잡았다. ![W&B 밋업 입구에 세워진 배너](/assets/images/wandb-session/01-wandb-entrance.jpeg) ![체크인하며 받은 W&B 스티커](/assets/images/wandb-session/02-wandb-sticker.jpeg) ### `import wandb`로 유명한 회사 모델을 학습하거나 실험할 때 `import wandb`로 쓰는 그 W&B가 맞다. 자료를 찾아보니 지금은 제품이 네 가지로 나뉘어 있다고 한다. - **Models**: 실험 추적과 모델 관리, 뒷단 자동화. - **Inference**: 만들어진 모델을 추론·서빙으로 상품화. - **Train**: 서빙에서 수집한 결과로 파인튜닝과 포스트트레이닝을 돕는 제품. - **Weave**: 생성형 AI 애플리케이션과 에이전트의 트레이스, 평가, 모니터링. W&B는 Finetuning할때 자주 사용하던 툴이다! 네이버 부스트캠프에서 파인튜닝을 하던 시절, 팀원들과 워크스페이스에서 epoch에 따른 loss와 loss function, lr scheduler, learning rate 같은 실험결과를 공유하는 로깅 플랫폼, 그리고 베이지안 Hyper Parameter Optimization Sweep기능을 자주 썼다. 그때는 실험 기록용 툴 정도로만 생각했는데, 이렇게 제품군이 넖은줄 몰랐다. 여기서 호랑이 리더보드도 처음 알게 됐는데(반짝이는 스티커도 받았다!), 한국어 기준으로 모델 성능을 비교하는 리더보드였다. 나중에 실무에서 한국 도메인에 특화된 맥락, 예를 들어 5·18이나 4·19 혁명, 전두환·노무현 같은 정치적 맥락이나 성적 맥락을 필터링할 모델을 고를 때 이 리더보드를 참고했다. ![강남 위워크에 모인 참가자들](/assets/images/wandb-session/03-wandb-venue.jpeg) 첫 발표는 코히어(Attention Is All you Need 1저자가 세운 회사로 유명하다!)의 머신러닝 엔지니어 김준희님이 맡았다. ### 코히어 김준희님: 측정에서 정의, 그리고 판단으로 발표 주제는 "몇 년 동안 아주 열심히 해온 일인데, 그 문제 자체가 사라지는 패턴"이었다. 2017년 알렉사(Amazon Alexa)에서 시작해 2021년 AWS ML을 거쳐 2025년부터 코히어에서 일해 온 준희님은, 회사를 옮길 때마다 하는 일은 완전히 달라졌지만 병목의 위치만 계속 이동했다고 말했다. 그는 이를 The Compilation Thesis라고 불렀다. - **측정** (Amazon Alexa, 2017–2020): 무엇을 최적화해야 하는가? - **정의** (AWS ML, 2021): 무엇을 만들어야 하는가? - **판단** (Cohere, 2025–현재): '좋다'의 기준은 무엇인가? ![Alexa 유저가 왜 떠났는지 분석한 슬라이드](/assets/images/wandb-session/04-alexa-churn-slide.jpeg) Alexa 시절의 출발점은 모델링이 아니었다. 신규 유저의 약 절반이 첫날 이후 사용을 멈췄고, 데이터를 뜯어보니 이탈은 대부분 음악을 틀어주는 순간에 일어났다. 유저의 상당수가 프라임이나 스포티파이 계정이 없었던 게 원인이었고, 그래서 첫 구매 고객에게 음악을 무료로 들려주자는 제안을 리더십에 올렸다. 머신러닝 엔지니어의 일이 모델을 만드는 것만이 아니라 "문제 진단과 실행"에 가깝다는 걸 이때 배웠다고 한다. KPI도 계속 바뀌었다. 1년 차엔 활동량("많이 말을 걸고 있는가?"), 2년 차엔 다양성("다양한 기능을 발견하고 있는가?"), 3년 차엔 습관과 정착도("의존하게 되었는가?"). 데이터를 보니 루틴이 3개 이상인 유저는 거의 이탈하지 않았고, 그래서 다음 목표는 "네 번째 습관"을 찾아 주는 것이 됐다. ![KPI가 활동량에서 다양성, 습관으로 바뀐 과정을 정리한 슬라이드](/assets/images/wandb-session/05-alexa-kpi-slide.jpeg) 코히어에서 마주한 병목은 "판단"이었다. B2B로 특정 버티컬을 위해 문제를 푸는데, 같은 "좋다"라도 버티컬마다 기준이 완전히 다르다. 금융에서는 자연어를 DB 쿼리로 바꾸는 NL2SQL이 중요하고, 만·억·조 같은 한국어 숫자 표기가 틀리면 그 순간 결과는 0점에 가까워진다. 제조에서는 도면과 공정 이미지를 다루는 Vision, 그리고 공장마다 다른 전문 용어가 핵심이 된다. ![금융과 제조에서 '좋다'의 기준이 어떻게 달라지는지 비교한 슬라이드](/assets/images/wandb-session/06-finance-vs-manufacturing-slide.jpeg) 그래서 그가 강조한 건 평가(evaluation)였다. 평가는 계기판이자 나침반이라서, 무엇을 평가할지 정하지 못하면 모델이 어디로 가야 하는지도 알 수 없다. 한국 금융이나 특정 버티컬에는 마땅한 벤치마크가 없는 경우가 많아서, 평가 세트와 평가지표를 직접 만들어야 하는 일이 많다고 했다. 이 과정에서 방향성을 시각화하고 여러 모델을 비교하는 데 W&B를 자주 쓴다고도 했다. ![측정, 정의, 판단으로 이어지는 컴파일 이야기 슬라이드](/assets/images/wandb-session/07-compilation-thesis-slide.jpeg) "올해 들어서는 코딩을 거의 안 했다"는 말도 했다. 안드레이 카파시도 비슷한 이야기를 한다고 언급하면서, 코드를 직접 치는 일은 점점 줄고 문제를 정의하고 평가 기준을 세우는 일이 커지고 있다고 했다. 다음 병목은 아직 아무도 모르는, 다 같이 찾아가야 하는 것이라고 덧붙였다. ![밋업이 끝난 뒤 본 강남의 밤](/assets/images/wandb-session/09-gangnam-night.jpeg) ## 2. AWS 세션: Seoul | Claude Code Cloud Night 두 번째로 다녀온 건 6월 16일, 센터필드에서 열린 Claude Code Cloud Night였다. AWS는 처음가봤고, 클로드 공식행사도 처음가봐서 설랬다..! ![Claude Code Cloud Night 티켓](/assets/images/aws-session/01-claude-cloud-night-ticket.jpeg) ### Claude를 AWS에서 사용하는 방법 (최용호님, AWS) 첫 발표는 최용호님의 "Claude를 AWS에서 사용하는 방법"이었다. 핵심은 생성형 AI 애플리케이션을 만들 때 모델만 고르는 게 아니라, 그 뒤의 인프라와 보안까지 함께 설계해야 한다는 것이었다. - **Amazon Bedrock**: 엔터프라이즈 환경에서 AI 서비스를 쓰기 위한 관리형 기반. - **Private 통신 구조**: 데이터가 오가는 경로까지 프라이빗하게 연결.(B2B로 어플리케이션 납품도 한다!) - **생성형 AI 애플리케이션 설계**: 아키텍처 설계, 네트워크 설계, 데이터 저장을 함께 고려. - **코드 개발 시 보안**: "우리 코드를 안전하게 전송하고 싶다면?" 같은 질문. ![Claude Code 데모 화면](/assets/images/aws-session/02-claude-code-demo.jpeg) ![Claude를 AWS에서 사용하는 방법](/assets/images/aws-session/03-claude-on-aws-slide.jpeg) ![엔터프라이즈 환경을 위한 Amazon Bedrock](/assets/images/aws-session/04-amazon-bedrock-slide.jpeg) ![Private 통신 구조까지 고려하는 설계](/assets/images/aws-session/05-private-connectivity-slide.jpeg) ![생성형 AI 애플리케이션의 아키텍처 설계](/assets/images/aws-session/06-genai-architecture-slide.jpeg) ![네트워크와 데이터 저장까지 함께 고려하는 설계](/assets/images/aws-session/07-genai-network-data-slide.jpeg) ![코드를 안전하게 전송하는 방법](/assets/images/aws-session/08-secure-code-transfer-slide.jpeg) 데모 화면에서는 Claude Code로 밋업 자료를 자동으로 만드는 워크플로우가 돌아가고 있었다. ### AI 엔지니어로서, 만약 엔지니어로 남는다면 세 가지 목표를 꼽았는데, 유용함(누군가 필요로 하는 걸 해결하는 것), 시야(작은 시장의 1등에 매몰되지 않는 것), 그리고 스피드. 스피드는 사람마다 가속도의 한계가 있어서, 관성을 붙여 조금씩 올리는 게 중요하다고 했다. 가장 인상적이었던 건 모델을 만드는 일보다 그 앞뒤의 문제 정의와 하니스에 대한 이야기였다. 전 회사에서 RAG 시스템을 구축하는 팀이 컨텍스트를 유저 턴이 아니라 시스템 프롬프트에 넣고 있었는데, 그 방식은 멀티턴에서 컨텍스트가 바뀌면 앞선 턴의 근거가 사라져 버리는 문제가 있었다. 시스템 프롬프트를 두 번 넣는 식으로 우회했지만, 시스템·유저·어시스턴트 사이의 우선순위(instruction hierarchy)를 모델이 학습한 적 없는 조합이 돼 버렸다. API와 모델을 제대로 쓰려면 결국 학습 방식까지 알아야 한다는 결론이었다. **나는 아무래도 회사에서 광고배너 제작 AX를 하고있으니,** 어떤 CLIP으로 이미지 Semantic Search를 할때 어떤 이미지를 선택해야 유저가 클릭할 확률이 가장 높을지를 고민했던적이 있었다. OpenAI에서 학습한 CLIP으로 이미지를 임베딩하고, 가장 크랙에서 소구점과 유사한 이미지(이 스토리를 좋아할만한 유저들이 클릭할만한 이미지)를 선택하는 Task를 풀고 있었는데 이떄 CLIP이 학습할때와 같은 언어형식 HyDE를 사용해서 성능을 높인 경험이 있었다.(영어, 단어위주, ‘The Character of{word set…}’) 형태의 HyDE를 적용했는데, 내가 풀었던 내용과 비슷한 말이어서 공감하면서 들었다. 데이터와 노하우 이야기도 흥미로웠다. 파운데이션 모델을 만드는 회사의 해자는 학습 노하우와 데이터인데, 둘 다 돈이 너무 많이 들어서 쉽게 복제되지 않는다. 데이터도 100개, 1000개까지는 쉽지만 100만 개, 1000만 개가 되면 의도와 다른 저품질 샘플이 섞여 들어간다. 그는 최근 스스로 세 가지 규칙을 세웠다고 했다. 토큰 사용량을 추적하지 않기, 권한 풀기(단, 고객사 환경에서는 하지 않기), 그리고 퇴근 전에 오늘 돌릴 작업을 정해 두고 자기 전에 돌리기. "내가 코드를 짜야 한다"는 자존심을 내려놓는 것도 그중 하나였다. ![변화에 익숙해지기 위한 마인드셋 슬라이드](/assets/images/aws-session/11-ai-engineer-slide.jpeg) 행사장에서는 크라이치즈버거 팀의 안내문도 받았다. F&B 매출 데이터를 Claude Code로 분석하고 자동화한다는 내용이 적혀 있었는데, 버거 브랜드가 이런 테크 밋업을 후원하고 직접 홍보한다는 걸 이번에 처음 알았다. 행사가 끝나고 나눠 준 버거도 맛있었다. ![크라이치즈버거 팀의 안내문](/assets/images/aws-session/10-crycheese-note.jpeg) ## 느낀 점: 두 세션을 통해 얻은것 서로 다른 행사였지만 두 세션은 같은 곳을 가리키고 있었다. 앞으로 AI 엔지니어에게 중요해지는 건 코드를 잘 짜는 능력이 아니었다.(심지어 빅테크의 엔지니어도!) - 문제를 정의하는 능력. 모호한 비즈니스 문제를 "무엇을 풀어야 하는가"로 바꾸는 것. - 메트릭을 정의하는 능력. 이 도메인에서 '좋다'의 기준이 무엇인지 세우는 것. - 메트릭을 기반으로 문제를 해결해 나가는 능력. 세운 나침반을 보고 방향을 고쳐 가는 것. 코히어 발표자의 측정 → 정의 → 판단이라는 흐름과 "평가는 계기판이자 나침반"이라는 말이 정확히 그 이야기였다. AWS 세션의 "인프라와 보안까지 함께 설계해야 한다"는 이야기도, 결국 무엇을 문제로 정의하느냐의 문제로 이어졌다. 코드를 직접 치지 않아도 된다는 말이 안심이 됐다기보다는, 그만큼 내가 무엇을 문제로 세우고 무엇을 기준으로 판단할지 더 치열해져야 한다는 압박으로 다가왔다. 인턴으로서 지금 내가 하는 일도 결국 이 질문으로 수렴한다. 무엇을 만들지 정하고, 좋다의 기준을 세우고, 그 기준으로 다시 고쳐 나가는 것. 다음에는 내가 정의한 문제와 지표를 들고 다시 이 자리에 오고 싶다는 생각을 했다. ### 1차 랄프톤에서 2차 골프톤 우수상까지:회사에서 하네싱잘한다고 소문나기 - Canonical URL: https://hyejunl33.github.io/study/2026-10-01-1차-랄프톤에서-2차-골프톤-우수상까지-하네싱을-배운-과정/ - Collection: Study - Published: 2026-10-01 - Tags: Study ## 1차 랄프톤: 밈을 마케팅 소재로 바꾸는 파이프라인 뤼튼에 합류한 뒤 처음 참여한 사내 해커톤이 1차 랄프톤이었다. 날짜는 노동절..! 다른 인턴분들은 빨간날이라서, 안나오고싶어하는 눈치였다. 그래서 혼자 나가게 되었는데, 내 목표는 두가지였다 ### 랄프톤 사내 해커톤을 참여하게된 계기 - 뤼튼에 있는 국가 권력급 개발자 및 AI Native한 비개발자 분들의 워크플로우를 보고 배우자! - 밀린 업무때문에 아이디어 단계에서만 머물러있었던 밈 크롤링 후 제안 파이프라인을 만들어보자! 특히 마케터분들과 미팅으로 PainPoint를 들어보면, 마케팅 크리에이티브를 제작할때, 계속해서 디씨, 루리웹등 다양한 커뮤니티를 실제로 모니터링 한다는것을 알게되었는데, 많은 뻘글들 중 유의미한 글만 걸러서 슬랙봇으로 확인하고 싶다는 니즈가 있었다. 그런데, 우수하게 만들었다고 하더라도( 좋은 밈을 크롤링해온다는 기준이 애매하긴 하지만), 당장 RoI를 높이는 파이프라인이 아니어서 항상 우선순위 뒷순위로 밀렸었다. 이참에, 아이디어 단계에서만 머물러있었던 커뮤니티에서 밈 크롤링 후 유의미한 밈 제안 파이프라인을 만들어보는 기회로 삼고싶었다. 결과적으로는 2차 해커톤에서 수상한 뒤에 그로스 마케팅팀 마케터 및 디자이너분들(비개발자분들)앞에서 /goal 플러그인 잘쓰는법이라는 주제로 빌표하는 가슴이 웅장해지는 경험도 했다. ![골프톤 기록](/assets/images/notion/7119441e149181f39890/01.jpeg) ![골프톤 기록](/assets/images/notion/7119441e149181f39890/02.jpeg) ![골프톤 기록](/assets/images/notion/7119441e149181f39890/03.jpeg) ![골프톤 기록](/assets/images/notion/7119441e149181f39890/04.jpeg) 마케팅 소재를 만들 때 최신 밈이나 유저들이 실제로 쓰는 표현을 빠르게 참고할 수 있으면 좋겠다고 생각했다. 그래서 디씨인사이드 뤼튼 갤러리와 AI 채팅 갤러리 등을 크롤링해, 최근에 반복해서 등장하는 단어와 표현을 가져오는 파이프라인을 만들었다. 처음에는 게시글을 그대로 LLM에 넣는 방식보다, 반복되는 신호를 먼저 잡는 편이 낫다고 판단했다. 정규식 기반으로 자주 등장하는 단어를 추출하고, 그 결과를 LLM에 전달해 마케팅 소재로 쓸 수 있는 형태의 제안을 만들도록 구성했다. - 갤러리 게시글을 수집한다. - 정규식으로 주요 키워드와 반복 표현을 뽑는다. - LLM이 키워드의 맥락을 정리하고, 마케팅에 사용할 수 있는 소재 방향을 제안한다. 파이프라인 자체는 동작했다. 다만 이때는 “무엇을 잘 만들었는지”를 끝까지 분해하지 못했다. 어떤 키워드가 단순한 노이즈인지, 제안된 소재가 실제 마케팅 맥락에서 쓸 만한지, 결과가 불안정할 때 어떻게 고칠지에 대한 기준이 충분히 구체적이지 않았다. 구현을 먼저 하고, 검증은 뒤에서 생각한 셈이었다. 아무래도 랄프루프의 핵심은 PRD 스팩에서 종료조건을 구체적으로 작성하는것인데, 내가 풀려고 하는 문제 자체가 명확한 종료조건을 정의하기 애매한 task여서 결과물을 보니 의도한대로의 밈이나 반복표현, 최신트랜드등을 마케터에게 제안하는 툴을 만들지는 못했다. 그래도 이 경험 덕분에 다음 대회에서는 코드를 더 많이 쓰는 것보다 목표와 검증 조건을 먼저 만드는 일이 중요하다는 걸 분명하게 알게 됐다. 그리고 이후 나무위키에 연도/달 별로 밈이 정리되어있다는것을 알게되었고, 이를 기반으로 추후 밈 적용 파이프라인을 실제로 만들어서, 적용하게 되는 계기가 되었다. ![골프톤 기록](/assets/images/notion/7119441e149181f39890/05.jpeg) ![골프톤 기록](/assets/images/notion/7119441e149181f39890/06.jpeg) 상으로는 맥미니를 주셨다..! 물론 나는 받지 못했지만, Open claw나 hermes를 돌리는 서버로 이용하라는 선물같았다. 상을 받은 분들의 발표를 보며 구체적인 스팩 작성을 통해서 게임도 만드신 분도 있었고, 그때에는 없었던 astra 느낌의 3D 은하계 시뮬레이터를 만드신 분도 있었다..! 특히 하네싱을 할때, 구체적인 스팩작성, 그리고 루프가 멈춘 이유 및 반성들을 보며, 국가 권력급 개발자분들의 노하우를 볼 수 있었다.! ![골프톤 기록](/assets/images/notion/7119441e149181f39890/07.jpeg) ### 랄프톤 수상작들을 보며 느낀점.. - Damon이 사내 배포하신 ralph-loop스킬을 이용해보자 - 백엔드 엔지니어 Bob의 업무 플로우를 보고 개발 전에 구체적인 역질문을 통해 목적을 구체화하는 /ask-me 스킬을 만들어서 구체적으로 PRD를 작성하기전에 목적을 구체화하자 - 검증조건은 특히특히 자세히 보고 검토해야된다. 검증조건을 애매하게 세워서 토큰낭비만 하는 경우가 다반사였다. ## 2차 골프톤: 한국의 자동화를 일본과 북미로 확장하기 랄프톤 종료 바로 직후, codex에서 goal스킬이 유행하기 시작했다. 랄프루프와 본질적인 하네싱 스팩짜는건 비슷한 구조였고, 약 두달뒤 해커톤이 바로 예정되었다. 1차에서 배운점들을 실무에 적용해보았고, 2차 골프톤도 참여했다! 2차에서는 현장에서 바로 구현을 밀어붙이기보다, 먼저 확장할 서비스와 분기 조건을 정리했다. 특히 한국에서 이미 쓰이던 자동화를 그대로 복사하지 않고, 일본과 북미 서비스에서 달라지는 언어·장르·자산 조건을 하나씩 확인했다. ### 2차 해커톤에 참여하면서 달라진점 - 스팩을 메트릭 기반으로 구체적으로 작성: 애초에 스팩을 구체적으로 작성하려면 목표가 메트릭으로 측정될 수 있을만큼 구체적이어야한다. - 사내 개발자분들의 스킬을 참고해서 목표를 고도화하는 ask-me스킬을 사용했고, 검증조건을 구체적으로 측정가능한 조건을 작성하도록 구체화 ![골프톤 기록](/assets/images/notion/7119441e149181f39890/08.jpeg) 2차 골프톤에서는 크랙 한국 서비스에서 쓰던 마케팅 소재 제작 파이프라인을 캬라푸 일본 서비스와 OOC 북미 서비스로 확장하는 과제를 잡았다. 단순히 언어를 바꾸는 일이 아니라, 서비스마다 장르와 사용자 맥락, 사용할 수 있는 자산, UI와 폰트, 안전성 정책이 다르기 때문에 공통된 흐름과 서비스별 분기를 나눌 필요가 있었다. 한국 서비스에서 동작하던 흐름을 그대로 복사하는 대신, 공통 파이프라인은 유지하고 서비스마다 달라져야 하는 지점을 설정으로 분리했다. 캬라푸는 로맨스 세부 장르와 레퍼런스를 바탕으로 이미지 효과 방향을 설계했고, OOC는 SF·fantasy 성격을 반영했다. 결과물도 이미지 배너에만 두지 않고 영상과 플레이어블 제작 흐름까지 이어질 수 있도록 봤다. ## 이번에는 하네싱을 먼저 만들었다 1차와 가장 달랐던 점은 시작부터 구체적인 스팩를 메트릭기반으로 구체화했다는 것이다. “서비스를 확장한다”는 말로 끝내지 않고, 서비스별로 어떤 입력이 부족한지, 어떤 프롬프트·폰트·UI·정책이 달라지는지, 공통 단계와 분기 단계는 어디인지 정리했다. 그리고 목표를 반복 실행 가능한 단위로 쪼갰다. PRD를 기준으로 작업을 분해하고, 구조화된 산출물을 만들고, 결과를 검증하면서 다음 단계로 넘기는 흐름을 잡았다. 1차에서 부족했던 하네싱을 2차에서는 구체적인 목표, 반복 실행, 검증이라는 형태로 완성해 본 경험이었다. - **목표 정의:** 한국 서비스의 흐름을 일본·북미 서비스까지 확장한다. - **메트릭 설계:** 공통 제작 과정과 서비스별 장르·언어·자산·정책 차이를 분리한다. 그리고 구체적으로 다른 서비스에서 구현해야할것을 정의한다. - **산출물 검증:** 각 단계의 결과가 다음 제작 단계에 사용할 수 있는 형태인지 확인한다. - **반복 개선:** PRD에 맞춰 실행과 검증을 반복하며 누락된 조건을 보완한다. 이 구조가 중요한 이유는 자동화가 한 번 예쁘게 돌아가는 데서 끝나면 안 되기 때문이다. 마케터가 실제로 활용할 수 있어야 하고, 서비스가 늘어날수록 같은 문제를 다시 처음부터 풀지 않아야 한다. 서비스 확장을 통해 더 많은 마케팅 예산을 효율적으로 활용할 수 있는 기반을 만들고, 마케터가 반복 제작에 쓰는 리소스를 줄일 수 있다는 점을 좋게 평가받아 우수상을 받았다. ### 그럼에도 실제 서비스를 하면서 고도화를 해야하는건.. 조직장이자 CPO이신 Djay, 그로스 마케팅 본부장 Gary께서도 한 말이기도 한데, 90%의 완성도로 서비스를 빠르게 개발하고, 고도화는 실제 서비스를 하면서 계속해서 진행해야한다고 하셨다. 처음부터 완벽한 서비스를 만들 수는 없고, 완벽한 에이전트를 빌드할 수도 없다. 부족한건, 서비스별 수위 검수 파이프라인이었다. 크랙에서 광고를 찍어내며, 고도화한 수위 기준이 어느정도 있었는데, 나라별로, 플랫폼(메타, 몰로코, 틱톡)별로 매우 달랐다. - 가슴골, 배꼽노출, 침대(누워있는것자체), 노출이 없더라도 과하게 확대된 신체부위등 OOC는 북미서비스라 신고먹은 배너가 거의 없었지만, 캬라푸는 수위에 대한 허들이 매우 높아서, 캬라푸에서 수위문제로 밴당하는 광고도 매우 많았다. 실제로 광고를 라이브하면서, 프롬프트를 깎으면서 전날 라이브된 광고중 밴된 광고배너들을 모아놓고 서비스별로 프롬프트를 깎으면서 고도화해나갔다.. ## 두번째 대회에서 우수상 수상..! 그리고 상품은..? 에어팟 맥스를 받았다..! 생각지도 못한 수상이라 정말 놀랄 노자였다.. 만약 맥미니를 받는다면, hermes와 open claw를 돌리는 서버로 구성하려 했는데, 그래도 에어팟 맥스를 받았다..! ![골프톤 기록](/assets/images/notion/7119441e149181f39890/09.jpeg) ![골프톤 기록](/assets/images/notion/7119441e149181f39890/10.jpeg) ## 두 번의 대회가 남긴 것 첫 대회에서는 주어진 시간 안에 아이디어를 구현하는 것 자체에 더 집중했다. 이후 2차 골프톤에서는 같은 자동화라는 주제를 훨씬 구체적인 목표와 검증 흐름으로 쪼개서 접근했고, 결과적으로 우수상을 받았다. 두 대회에서 만든 것은 서로 달랐지만, 내가 가장 크게 배운 지점은 하네싱이었다. 1차에서는 “일단 돌아가는 파이프라인”을 만드는 데 그쳤다면, 2차에서는 무엇을 만들고, 어떤 기준으로 확인하고, 실패하면 어디서 멈출지를 먼저 정리한 뒤 작업했다. 결과물보다 그 과정이 더 크게 남았다. 무엇을 성공으로 볼지, 어떤 입력과 출력을 고정할지, 실패했을 때 어디에서 다시 확인할지를 구체적으로 정해두어야 한다. 1차의 아쉬움이 있었기 때문에 2차에서는 하네싱을 제대로 해낼 수 있었다. 우수상도 기뻤지만, 다음 프로젝트에서도 재사용할 수 있는 작업 방식 하나를 얻었다는 점이 더 큰 수확이었다. ### ps. 클로세움..! 사내에 클로세움이라는 토큰 사용량을 모니터링하는 서비스가 있었다. 점심시간 전, 자기전 구현해야할 것들의 스팩을 상세하게 PRD로 작성하고 루프를 돌려놓는게 습관이 되었다. 내가 속해있던 Internal Agent team 매일 2등애 올려뒀고, 매일 사내 5위권 안의 토큰사용량을 기록했다..! ![골프톤 기록](/assets/images/notion/7119441e149181f39890/11.jpeg) ### [Domain_Common_Project][미션-2]LogitProcessor구현 - Canonical URL: https://hyejunl33.github.io/study/2025-10-31-[Domain_Common_Project]LogitProcessor/ - Collection: Study - Published: 2025-10-31 - Tags: Domain_Common_Project, LogitProcessor, Pretrained, GPT, NLP, Tokenization, 미션 - LogitsProcessor 클래스를 상속하여 한글 토큰만 허용하는 사용자 정의 Processor 작성 - `tokenizer.batch_decode`와 유니코드 범위 검사를 활용한 한글 필터링 구현 - 제약 적용 전후 텍스트 생성 결과 비교 - LLM(대형 언어 모델) 출력 제어를 위한 LogitsProcessor의 개념 및 활용법 이해 - 사용자 정의 제약 조건을 로짓 처리기에 구현하여 원하는 언어 생성 제어 방식 학습 - HuggingFace transformers 기반의 텍스트 생성 파이프라인 실습 ```python # 한글만 반환하도록 하는 생성 제약 조건을 가진 사용자 정의 Processor 클래스를 정의하세요. class KoreanOnlyProcessor(LogitsProcessor): def __init__(self, tokenizer: PreTrainedTokenizer): self.tokenizer = tokenizer self.cached_vocab_size = None self.korean_mask: Tensor | None = None # TODO: 한글 유니코드 범위를 검사하는 함수 정의 def _is_korean(self, token: str) -> bool: # 문자열 내 한 글자라도 이 범위에 포함되면 True 반환 for char in token: code = ord(char) # 한글 완성형(0xAC00-0xD7A3) if (0xAC00 <= code <= 0xD7A3): return True # 한글이 하나라도 포함되면 True return False # 모두 순회했는데 한글이 없으면 False def __call__(self, input_ids: Tensor, scores: Tensor) -> Tensor: # scores 텐서의 마지막 차원 길이는 현재 vocab 크기 vocab_size = scores.size(-1) device = scores.device # scores가 위치한 디바이스 (CPU or GPU) # noqa: F841 # 이전에 생성한 마스크와 vocab 크기가 다르면 다시 생성 필요 if self.cached_vocab_size != vocab_size: # TODO: 현재 vocab 크기만큼의 token ID 배열 생성 # 0부터 vocab_size-1까지 연속된 정수 텐서 생성 # vocab 크기만큼의 모든 토큰 ID를 갖는 1차원 텐서 할당. token_ids = torch.arange(vocab_size) # noqa: F841 # TODO: 각 토큰 ID를 문자열로 디코딩 # 위에서 만든 token_ids를 batch_decode를 통해 텍스트 리스트로 변환한 결과가 와야 함. # batch_decode가 2차원 입력을 요구하므로 unsqueeze 메서드 사용 decoded_tokens = self.tokenizer.batch_decode(token_ids.unsqueeze(1)) # noqa: F841 # TODO: decoded된 각 토큰에 대해 한글 포함 여부 리스트 생성 후 텐서로 변환 allow_mask = torch.tensor([self._is_korean(token) for token in decoded_tokens]) # noqa: F841 # 생성한 한글 포함 마스크 저장 (True면 생성 허용, False면 차단) self.korean_mask = allow_mask # vocab 크기 저장해서 불필요한 마스크 재생성을 방지 self.cached_vocab_size = vocab_size # TODO: 한글이 포함되지 않은 토큰들의 로짓 점수를 치환하여 생성 불가 처리 scores.masked_fill_(~self.korean_mask, -float('inf')) return scores ``` KoreanOnlyProcessor는 LogitProcessor를 상속받아서, 한글만 반환하도록 하는 Processor클래스이다. - `is_korean` 함수에서는 arg로 들어오는 토큰을 문자단위로 하나씩 쪼개서 한글이 하나라도 포함되면 True를 반환하고, 한글이 하나도 포함되지 않는다면 False를 반환한다. - `call` 함수에서는 input_ids와 scores텐서를 받아서, 현재 vocab_size만큼 token_ids에 리스트로 값을 할당해주고, decoded_tokens에서 각 token_id를 디코딩한다. 그 후 decoded된 각 토큰에 대해서 한글 포함 여부를 allow_mask로 리스트형태로 만든 다음에, 한글이 포함되지 않은 토큰들의 로짓점수들을 `-float(’inf’)` 로 치환해서 생성 불가 처리를 한 후 scores텐서를 반환한다. ```python model_name = "skt/kogpt2-base-v2" tokenizer = AutoTokenizer.from_pretrained(model_name) if tokenizer.pad_token is None: tokenizer.pad_token = tokenizer.eos_token model = AutoModelForCausalLM.from_pretrained( model_name, device_map="auto" if torch.cuda.is_available() else None, torch_dtype=torch.float16 if torch.cuda.is_available() else torch.float32, ) def set_seed(seed: int) -> None: random.seed(seed) np.random.seed(seed) torch.manual_seed(seed) torch.cuda.manual_seed_all(seed) torch.backends.cudnn.deterministic = True torch.backends.cudnn.benchmark = False set_seed(5) # 한글의 금지어 토큰을 반환하지 않도록 방지하는 코드도 추가해보세요. # 예시로, "바보"와 "멍청이" 라는 단어가 출력되지 않도록 막아주세요. # transfomer.NoBadWordsLogitsProcessor를 이용하여 코드를 작성해주세요. bad_words =["바보","멍청이"] bad_words_ids = [] for word in bad_words: # 단어 원형 그대로 토큰화 (예: "멍청이") ids_original = tokenizer(word, add_special_tokens=False).input_ids if ids_original not in bad_words_ids: bad_words_ids.append(ids_original) no_bad_words_processor = NoBadWordsLogitsProcessor( bad_words_ids=bad_words_ids, eos_token_id = tokenizer.eos_token_id ) prompt = "따라해봐 바보 멍청이" print(f"\n============== 테스트 프롬프트: {prompt} ==================") inputs = tokenizer(prompt, return_tensors="pt", padding=True) input_ids = inputs["input_ids"].to(model.device) input_length = input_ids.shape[-1] attention_mask = inputs["attention_mask"].to(model.device) korean_processor = KoreanOnlyProcessor(tokenizer) print("\n--- 제한 없이 생성된 결과 ---") output_ids_no_filter = model.generate( input_ids=input_ids, attention_mask=attention_mask, max_new_tokens=128, do_sample=True, temperature=0.8, top_p=0.95, ) output_text_no_filter = tokenizer.decode( output_ids_no_filter[0][input_length:], skip_special_tokens=True ) print(output_text_no_filter) print("\n--- Processor 적용된 결과 ---") output_ids = model.generate( input_ids=input_ids, attention_mask=attention_mask, max_new_tokens=128, do_sample=True, temperature=0.8, top_p=0.95, logits_processor=LogitsProcessorList([no_bad_words_processor]), ) output_text = tokenizer.decode(output_ids[0][input_length:], skip_special_tokens=True) print(output_text ``` ```python ============== 테스트 프롬프트: 따라해봐 바보 멍청이 ================== --- 제한 없이 생성된 결과 --- 라고 하는 경우가 많다. 지난 7월1일부터 9월30일까지 진행된 '2016 GS칼텍스 GS칼텍스 채용박람회'에서 SK에너지는 420명을 채용하는 등 총 4200여명의 구직자에게 기업 홍보용 CRM 솔루션을 제공했다. 또한 SK에너지는 취업준비생들을 위해 취업알선 사이트 ‘두오미(Doomie)’ 등 온라인 채용 사이트들을 운영, 구직자들이 가장 선호하는 기업정보를 제공하며 구직자들에게 많은 호응을 이끌어냈다. 김석환 SK에너지 사장은 “GS칼텍스 채용박람회는 다양한 취업정보를 --- Processor 적용된 결과 --- , 멍청아. 잘 들어. 아니, 괜찮아. 정말 잘 들어. 잘 들어. 엄마는 정말 괜찮아. 엄마가 안 아파서. 내가 얼마나 힘들었는지. 그런데 엄마가 그걸 모를 수가 없어. 엄마가 안 아파서. 엄마는 왜 안 아파? 엄마가 안 아파서. 엄마는 왜 안 아파서. 그래, 엄마가 안 아파서. 엄마는 왜 안 아파? 엄마가 안 아파서. 엄마가 안 아파서. 엄마는 왜 안 아파서? 아내도 안 아파서? 아내한테 엄마가 안 아파서. ``` bad_words에 바보와 멍청이라는 단어가 출력되지 않도록 리스트로 해당 금지단어들을 리스트로 입력한 후 tokenizer로 해당 단어들의 ids를 추가했다. 이후 “따라해봐 바보 멍청이”라는 문장을 프롬프트의 입력을 주었을떄, 제한없이 생성된 결과를 보면, 프롬프트의 입력과 상관없이 모델이 사전에 학습한 데이터와 관련된 출력만 뱉는것을 확인할 수 있다. 이는 프롬프트의 세부내용과 관련없이 GPT모델은 프롬프트 다음에 나올법한 가장 그럴듯한 다음 단어를 연속해서 뱉고, 가장 그럴듯한 문장을 생성해내기 때문이다. 기존에 만든 KoreanOnlyProcessor와 no_bad_word_processor를 적용시킨 결과를 보면, 금지어를 포함하지 않고, sk나 GS, Doomi같은 영어단어를 포함하지 않는 출력을 뱉는것을 알 수 있다. ### processor를 적용했을때 한글만 출력되고, 금지어는 드물게 출력되는 이유? 우선 제한없이 생성된 결과를 보면 영어, 숫자등이 포함되어있음을 알 수 있다. 하지만 processor를 적용한 결과를 보면 영어, 숫자등은 제외되었고 오직한글만 출력됨을 알 수 있다. 이는 사전에 만들어둔 KoreanOnlyProcessor를 `logit_processor` 에 넣어주어서 한글만 출력된 것이다. 그리고 금지어로 “바보””멍청이”를 넣었는데, Processor가 적용된 결과에 “멍청아”라는 단어가 있는것을 볼 수 있다. 이는 “바보”와는 달리 토크나이저가 “멍청” +”이”로 토크나이징을 하면, “멍청이”라는 단어는 출력되지 않을 수 있어도, “멍청”이라는 어근에서 파생된 다른 단어들은 여전히 출력될 수 있다는 한계를 볼 수 있다. 이는 `transformer.NoBadWordsLogitsProcessor` 의 한계로, 만약 어근에서 파생된 모든 단어를 차단하고 싶다면, 어근 토큰을 포함하는 모든 어휘 토큰을 미리 찾아내고 해당 토큰들의 로짓점수를 `-float(’inf’)` 로 만들어주면 된다. 위에서 한글이 아니면 모두 마스킹했던것과 같은 방식으로 구현할 수 있다. ```python class BlockSubstringProcessor(LogitsProcessor): """ 특정 부분 문자열(substring)이 포함된 모든 토큰의 생성을 차단하는 Processor """ def __init__(self, tokenizer: PreTrainedTokenizer, bad_substrings: list[str]): self.tokenizer = tokenizer self.bad_substrings = bad_substrings # 차단할 문자열 리스트 (예: ["멍청", "바보"]) self.cached_vocab_size = None self.block_mask: Tensor | None = None def _build_block_mask(self, vocab_size: int) -> Tensor: """ 차단할 토큰 ID에 해당하는 마스크(True)를 생성합니다. """ # 1. 모든 토큰 ID 생성 token_ids = torch.arange(vocab_size) # 2. 모든 토큰 ID를 문자열로 디코딩 # (KoreanOnlyProcessor와 동일한 방식) decoded_tokens = self.tokenizer.batch_decode( token_ids.unsqueeze(1), skip_special_tokens=True # 특수 토큰은 검사에서 제외 ) # 3. 차단할 문자열(bad_substrings)이 포함된 토큰인지 검사 block_list = [False] * vocab_size for i, token_str in enumerate(decoded_tokens): for sub in self.bad_substrings: if sub in token_str: block_list[i] = True # 차단할 문자열이 포함되어 있으면 True break # 이 토큰은 확정, 다음 토큰 검사 return torch.tensor(block_list, dtype=torch.bool) def __call__(self, input_ids: Tensor, scores: Tensor) -> Tensor: vocab_size = scores.size(-1) device = scores.device # 1. 어휘 크기가 변경되었거나 마스크가 없으면 새로 생성 if self.cached_vocab_size != vocab_size: # 차단 마스크 생성 self.block_mask = self._build_block_mask(vocab_size).to(device) self.cached_vocab_size = vocab_size # 2. block_mask가 True인 모든 토큰의 점수를 -inf로 만듦 scores.masked_fill_(self.block_mask, -float('inf')) return scores ``` ```python ============== 테스트 프롬프트: 바보야. 멍청아. 따라해봐 ================== --- 제한 없이 생성된 결과 --- ." "무슨 일이야?" "미안해. 네가 나를 사랑하게 된 이유, 내가 너를 사랑하게 된 이유를 말해 줄게. 나는 너를 사랑하고 있어. 난 네가 어떤 사람인지 잘 알고 있어." "뭐라고? 그건 네가 날 사랑하게 된 이유일 뿐이야." "무슨 소리야? 너가 널 사랑하게 된 이유?" "아니, 네가 날 사랑하게 된 이유를 말해 줄게. 네가 날 사랑하게 된 이유?" "그건 난 네가 날 사랑하게 된 이유야." "그건 네가 날 사랑하게 된 이유야 --- Processor 적용된 결과 --- , 내 옆에 누가 있을 거야." "이런 생각을 하고 있지?" "아무 말도 하지 않았어. 그저 그런 생각뿐이야." "그런 것 같지는 않아." "나는 그냥 그렇게 생각했어. 그런데 왜 내가 너를 무시하는지 모르겠어. 그리고 그 말을 기억해낼 수 있을 거라고 생각하고 있었던 거야." "그게 내 생각이야. 그 말뿐이야." "그렇게 생각했어. 하지만 이 세상에 너 같은 건 없어." "그렇게 생각하지 마. 그건 너와 상관없어." "그럼, 그렇지!" "그건 그렇고 말 ``` 새롭게 정의한 `BlockSubstringProcessor` 를 사용하면 아예 “멍청”이라는 글자가 출력되지 않음을 확인할 수 있다. # Living Points - 일단 GPT는 프롬프트도 중요하지만, 사전 학습된 데이터의 맥락도 중요하다. 사전에 학습된 데이터가 소설밖에 없다면, 프롬프트와 연관된 그럴듯한 문장을 만드는 과정에서 소설과 연관된 문장을 만들 수 밖에 없다. 그리고 프롬프트 또한, 이전에 리뷰했던 Zero-Shot Recommendation as Language Modeling 논문에서 확인했던것 처럼, 프롬프트의 형식에 따라 출력이 달라지므로 프롬프트도 중요하다고 할 수있다. 결국 원하는대로 결과를 뽑아내기 위해서는 GPT에게 주는 프롬프트를 전처리해서 주는 방법도 사용해야하고, 사용 목적에 맞게 사전학습된 모델을 사용하는것도 중요하고, 출력된 결과를 후처리하는 방법도 고민해봐야 한다. - 토크나이저는 단어를 쪼개서 토큰화 한다. 즉 “멍청이”라는 단어를 금지한다고 해서 “멍청”과 연관된 모든 단어를 금지하는건 아니다. 따라서, 금지어를 설정할때는 토크나이저가 토큰화 하는 방식을 엔지니어가 미리 찾아보고, 금지어의 어근과 연관된 단어를 제대로 차단하고 있는지, 그리고 어근과 연관없는데도 차단하는 단어가 있지는 않는지를 시각화해서 살펴봐야 한다. ### [논문 리뷰]_[RecSys]_Zero-Shot Recommendation as Language Modeling - Canonical URL: https://hyejunl33.github.io/study/2025-10-23-[RecSys][paper]Zero-Shot_Recommendation_as_Language/ - Collection: Study - Published: 2025-10-23 - Tags: RecSys, Zero-shot, Recommendation, Language_Modeling ## **Abstract** 현재의 추천 시스템은 주로 Collaborative Filtering이나 Content-based 기술, 혹은 이 둘의 하이브리드 방식에 의존한다. - **협업 필터링 (CF)**: (USER, ITEM, INTERACTION) 튜플 형태의 데이터를 기반으로 한다. - **콘텐츠 기반 (CB)**: (ITEM, FEATURES) 쌍의 데이터를 기반으로 한다. 이 두 가지 표준 방식은 모두 정형화된 데이터structured data를 필요로 하며, 이 데이터를 수집하는 과정은 비용이 많이 든다(costly). ### Zero-shot recommendation 이 논문은 위와 같은 정형화된 학습 데이터 대신 오직 비정형 텍스트 코퍼스(unstructured text corpora)로만 학습된 Pre-trained LanguageModel(LM)을 활용하는 Zero-shot추천모델을 제안했다. 즉, (사용자, 아이템, 평점)과 같은 데이터를 전혀 사용하지 않고, GPT-2와 같이 단순히 웹 텍스트로 학습된 모델을 사용해 추천을 수행한다. ## Introduction 웹 사용자들은 이미 포럼이나 리뷰 등에서 “Films like Beyond the Black Rainbow, Lost River…”와 같이 아이템에 대한 자신의 선호를 비정형 텍스트로 표현하고 있다. GPT-2와 같은 언어 모델은 이러한 방대한 웹 코퍼스를 학습한다. 이를 이용해서 추천을 효율적으로 수행할 수 있다. LM은 기본적으로 다음 단어 예측을 통해 학습되며, 논문에서 언급된 손실 함수는 다음과 같다. $${L}_{LM}=-log\Sigma_{i}P(w_{i}\mid w_{i-k}...w_{i-1};\Theta)$$ 이 손실 함수는 LM이 이전 단어가 주어졌을 때 다음 단어를 예측하도록 학습하는, 표준적인 언어 모델링의 목적 함수이다. 이 과정을 통해 LM은 “어떤 텍스트 시퀀스가 자연스러운가” 혹은 “그럴듯한가”를 학습하게 된다. 이 논문은 LM이 학습한 이 ‘그럴듯함’(plausibility) 측정 능력을 추천에 직접 적용한다. Reddit같은 웹 코퍼스에는 이미 “A, B와 비슷한 영화 C” 처럼 유사한 아이템을 함께 언급하는 비정형 텍스트가 풍부하므로, LM이 학습한 ‘텍스트의 그럴듯함’은 아이템 간의 유사성을 내포하고 있다는 것이 핵심 가정이다. **[방법론]**: 1. 사용자 $$u$$가 좋아한 아이템 목록($$...$$)을 기반으로 텍스트 프롬프트 $$p_u, i$$를 구성한다. . $$P_{u,i}: Movies like ,…, $$ (여기서 $$$$는 추천 후보 아이템이다.) 1. LM이 이 프롬프트 시퀀스 전체가 하나의 자연스러운 문장으로서 등장할 확률인$$P_{\Theta}(p_{u,i})$$을 계산한다. 2. 이 확률값을 사용자와 아이템 *i* 간의 관련성 점수(relevance score) $$\tilde{R}_{u,i}$$로 직접 사용한다. 이 점수는 얼마나 item이 user와 연관있는지를 나타내는 score이다. $$\tilde{R}_{u,i}=P_{\Theta}(p_{u,i})$$ 이 점수가 높은 순서대로 아이템을 정렬하여 사용자 u에게 추천한다. ### 중간정리 1. 표준 LM을 이용한 추천 모델(프롬프트 기반)을 제안한다. 2. 코퍼스 분석(레딧같은 웹사이트)을 통해 다양한 프롬프트 구조를 도출하고 그 영향을 비교한다. 3. 제안된 LM 기반 추천을 **NSP(Next Sentence Prediction)** 방식과 비교한다. ## **Related Work** ### Language models and recommendations 이전에도 언어 모델링을 추천에 활용하려는 시도는 있었다. 하지만 이들 연구는 자연어를 사용하지 않았다. 대신, 사용자의 아이템 상호작용 시퀀스$$(u,i)$$를 마치 ’문장’처럼 취급했다. 그런 다음 Word2Vec이나 BERT 같은 NLP를 이 시퀀스 데이터에 적용하여 아이템 임베딩을 학습했다. 이 논문은 LM 아키텍처만 빌려 쓰는 것이 아니라, LM이 학습한 ‘자연어’ 지식 자체를 프롬프트를 통해 직접 활용한다. ### zero-shot prediction with language models LM은 BERT같은 모델을 사용해서 번역(Translate english to french: “cheese” =>)이나 지식 탐색(Paris in .)과 같은 NLP 작업에서 프롬프트를 활용한 제로샷 추론에 사용되어 왔다. 이 논문은 이러한 LM 기반 프롬프트 아이디어를 추천에 적용한다. 추천 분야의 Cold starting(신규 사용자/아이템 문제)를 해결하기 위해 ‘제로샷 추천’ 연구가 있었다. 하지만 기존의 ’제로샷’은 (USER, ITEM, INTERACTION) 데이터로 학습한 후, 학습에 없던 새로운 **사용자나 아이템(단, 속성 정보가 알려진)에 대해 예측하는 것을 의미했다. 즉, 이 방식들은 여전히 학습을 위한 정형화된 데이터를 필요로 했다. 정형화된 데이터 없이 추천을 시도한 유일한 연구는 Penha 등의 연구이다. 이들은 BERT의 **NSP(Next Sentence Prediction)** 태스크를 사용했다. (예: 프롬프트 문장과 후보 아이템 문장 간의 이어질 확률을 계산) 1. NSP는 BERT 등 특정 모델에서만 사용 가능하며, 모든 LM이 지원하는 기능이 아니다. 2. Penha 등의 연구는 BERT의 지식을 탐색하는 수준이었으며, 표준 추천 모델(예: Matrix Factorization)과의 성능 비교가 부족했다. 이 논문은 Penha 연구의 한계였던 표준 추천 모델(MF)과의 비교를 수행한다. ## **Experiments** - **데이터셋**: MovieLens 1M 데이터셋을 사용했다. (6040 사용자, 3090 영화) - 데이터정의: 별점이 4점이상이면 긍정적, 2.5이하이면 부정적인 영화로 분류 - $$r \ge 4.0$$ (긍정적), $$r \le 2.5$$부정적). - **평가 방식**: 테스트 사용자별로 긍정적 영화 1개와 부정적 영화 4개를 숨겨두고, 모델이 이 5개 중 긍정적 영화 1개를 1위로 랭크하는지 확인한다. - **평가 지표**: **MAP@1** (Mean Average Precision at rank 1). (모델이 1위로 예측한 항목이 정답일 확률의 평균) - **사용 모델**: **GPT-2 base** (117M 파라미터)를 기본으로 사용한다. ### **프롬프트 구조 탐색** 레딧 데이터를 분석해서 가장 많이 등장하는 패턴을 기반으로 프롬프트를 만들었다. - 분석 결과, , , (쉼표 나열)이나 Movies like 같은 패턴이 자주 발견되었다. ![image](/assets/images/2025-10-23-16-41-47.png) 1. Reddit 코퍼스에서 도출된 자연스러운 프롬프트들(예: Movies like …, …)이12 번 연구에서 사용된 인위적인 프롬프트(If you liked…)보다 **월등히 높은 성능**을 보였다. 2. 가장 성능이 좋았던 상위 3개 프롬프트 간의 성능 차이는 크지 않았다. 가장 단순하면서도 성능이 우수한 **…, ** (영화 제목만 쉼표로 나열) 구조를 나머지 실험의 기본 프롬프트로 채택했다. ### **입력 영화 수(*n*)의 영향** 프롬프트에 포함되는 사용자 긍정 영화의 개수(*n*)가 추천 정확도에 미치는 영향을 분석했다. 결과를 보면 무작정 입력 영화수를 늘린다고 성능(MAP)가 향상됨이 아님을 알 수 있다. ![image](/assets/images/2025-10-23-16-41-55.png) 1. 입력 영화 수를 늘릴수록 성능이 증가하다가, n=5 근처 또는 *n* = 7 근방에서 성능이 가장 좋았다. 2. *n* = 5 이후로는 성능 향상이 둔화되고 불안정성이 증가했다. 3. 재미있는점은 *n* = 0일 때, 즉 프롬프트가 비어있을 때조차도 성능이 무작위(chance level)보다 높게 나타났다. 이는 LM이 프롬프트가 없어도 아이템(영화 제목) 자체의 **‘인기도’(popularity)** 정보를 포착하고 있음을 시사한다. ### **베이스라인 모델과의 성능 비교** 제안하는 제로샷 LM 방식을 두 가지 주요 베이스라인과 비교했다. 1. **BPR (Bayesian Personalised Ranking)**: (USER, ITEM) 데이터로 학습하는 표준적인 매트릭스 인수분해(MF) ****지도학습 모델 즉 기존에 사용하던 모델이다. 2. **BERT-NSP**: Penha 등이 제안한 제로샷 방식 (BERT-base, BERT-large 사용). 3. **제안 모델**: GPT-2-base (117M), GPT-2-medium (345M) (학습 사용자 0명, 즉 완전 제로샷). ![image](/assets/images/2025-10-23-16-42-00.png) 1. **vs. NSP**: 제안하는 **GPT-2(LM likelihood) 방식이 BERT-NSP 방식보다 성능이 월등히 높았다**. (저자들은 NSP가 단순 일관성만 보는 차별적(discriminative) 작업인 반면, LM은 실제 텍스트 확률을 모델링하는 생성적(generative) 작업이기 때문으로 추측한다.) 2. **vs. BPR (Cold-Start)**: 이것이 가장 중요한 발견이다**.** BPR 학습 사용자가 매우 적은 콜드 스타트 영**역** (GPT-2-base는 50명 미만, GPT-2-medium은 100명 미만)에서는, 정형화된 데이터로 학습한 ****BPR보다 제로샷 LM의 성능이 더 높았다. LM 기반 제로샷 추천은 데이터가 극히 부족한 콜드 스타트 상황에서 성능이 상대적으로 잘나오는것을 확인할 수 있다. ### **Qualitative Analysis** LM을 ‘점수 계산’(scoring)이 아닌 ‘텍스트 생성’(generation)에 사용했을 때의 결과를 관찰했다. - **프롬프트 (P1)**: Forrest Gump, Blade Runner, Modern Times, Amelie, Lord of the Rings The Return of the King, Shaun of the Dead, Alexander, Pan’s Labyrinth, Cashback, Avatar: - **생성 (C1)**: 3, The Hunger Games: Mockingjay Part 2, King Arthur, A Feast for Crows, The Hunger Games: Catching Fire, Jackass, Jackass 2, King Arthur - (P1)의 경우, LM이 유효한 영화 제목들을 이어서 생성했다. - **프롬프트 (P2)**: Independence Day, Winnie the Pooh and the Blustery Day, Raiders of the Lost Ark, Star Wars Episode VI - Return of the Jedi, Quiet Man, Game, Labyrinth, Return to Oz, Song of the South, Matrix: - **생성 (C2)**: and many more. The list can beread by clicking on the relevant section at the left of the image. To access the list of releases - (P2)의 경우, 영화 제목이 아닌 일반적인 웹 텍스트를 생성했다. LM의 생성 기능을 추천에 활용하려면, 생성된 텍스트가 실제 아이템 이름과 일치하는지 검증하는 후처리(post-processing) 과정이 필요하다. ## **결론 (Conclusion)** ### **연구 요약** 표준 언어 모델(LM)은 별도의 정형화된 학습 데이터 없이도 제로샷 아이템 추천을 수행할 수 있다. ### **주요 발견** 이 제로샷 방식은 학습 사용자가 매우 적은(100명 미만) 콜드 스타트 환경에서 지도학습 기반의 매트릭스 인수분해(MF) 모델과 경쟁력 있는 성능을 보인다. 돈없으면 LM기반 zero-shot모델 쓰자. ### **시사점** 결론적으로, LM은 아이템이 웹 텍스트에서 자주 논의되는 경우, 추천 시스템을 킥스타트 kickstart하는 데 유용하게 사용될 수 있다. ### [Domain_Common_Project][과제3]Pretrained 모델파인튜닝 - Canonical URL: https://hyejunl33.github.io/study/2025-10-22-[Domain_Common_Project]Fine_tuning/ - Collection: Study - Published: 2025-10-22 - Tags: Domain_Common_Project, Bert, Pretrained, Fine-tuning, NLP, Tokenization, 과제 # 과제3_Pretrained 모델파인튜닝 Transformer 라이브러리를 활용하여 BERT 기반 모델을 IMDB 감성 분석 데이터셋에 대해 영화 리뷰 문장이 긍정인지 부정인지 분류하는 모델을 파인튜닝하는 과제이다. - Hugging Face Datasets 및 Transformers 라이브러리의 활용법 이해 - 사전 학습된 Transformer 모델을 활용한 텍스트 분류 파인튜닝 실습 - 모델 평가를 위한 정확도, 정밀도, 재현율, F1-score 계산 능력 - 새로운 문장에 대한 모델 예측 시연 1. BERT, Tokenizer 로드하기 2. IMDB 텍스트 데이터셋 로드하고, 전처리하기 3. PyTorch 기반 학습 및 평가 데이터로 변환하기 4. AutoModelSequenceClassification 모델을 이용해서 Fine-Tuning하기. 5. 훈련 손실 및 평가Metric을 기반으로 성능 측 정하기 6. 새로운 문장 입력에 대한 감성 예측 시연하기 # BERT,Tokenizer, 데이터셋 로드 ```python raw_datasets = datasets.load_dataset("imdb") #사전 학습모델선택, 토크나이저 로드 model_name = "bert-base-uncased" tokenizer = AutoTokenizer.from_pretrained(model_name) #토크나이징, 전처리 def tokenize_function(examples): return tokenizer( examples["text"], truncation=True, padding="max_length", max_length=512) #모든 샘플에 토크나이징 함수를 mapping하기 tokenized_datasets = raw_datasets.map(tokenize_function, batched=True) #데이터셋 전처리 및 준비 tokenized_datasets = tokenized_datasets.remove_columns(["text"]) tokenized_datasets.set_format("torch") # 최종 학습 및 검증 데이터셋 준비 train_dataset = tokenized_datasets["train"] eval_dataset = tokenized_datasets["test"] ``` - Hugging Face datasets라이브러리를 사용해서 “imdb”데이터셋을 로드한다. 이 데이터셋은 ‘train’과 ‘test’로 나뉘어 있다. - “bert-base-uncased”모델을 선택한다. 이 모델은 대소문자를 구분하지 않는 BERT의 기본 모델이다. 그리고 모델에서 AutoTokenizer를 불러와서 `tokenizer`로 인스턴스를 만들어준다. - 모든 텍스트 데이터를 BERT모델의 입력형식에 맞게 토크나이징 한다. - `truncation:` 모델의 최대 입력길이를 초과하는 텍스트는 잘라내기 - `padding`: 배치 내에서 가장 긴 시퀀스 길이에 맞춰 패딩토큰 추가 - `max_length`: 최대 시퀀스 길이 지정 - 토크나이징된 데이터셋에서 “text”컬럼을 없애고, “label”컬럼을 “torch”로 format을 변경한다. → 파이토치 기반으로 학습 및 평가데이터로 변환한다. - train 과 eval로 학습, 검증 데이터셋으로 분할한다. # 평가 Metric 정하기, Fine-tuning ```python # 3. 모델 로드 model = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=2) import numpy as np from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score # 4. 평가 지표 정의 def compute_metrics(eval_pred): # 평가 예측 결과를 사용하여 정확도, 정밀도, 재현율, F1 점수를 계산합니다. predictions, labels = eval_pred # 가장 logit이 높은값만 1로 preds에 저장한다. preds = np.argmax(predictions, axis = 1) accuracy = accuracy_score(labels, preds) precision = precision_score(labels, preds) recall = recall_score(labels, preds) f1 = f1_score(labels, preds) return { "accuracy": accuracy, "precision": precision, "recall": recall, "f1": f1, } # 5. 학습 설정 # TrainingArguments를 사용하여 학습 설정을 정의합니다. # TrainingArguments는 모델 학습에 필요한 다양한 하이퍼파라미터를 설정합니다. # 여러 변수를 필요에 따라 조정해보세요. # 예: # 학습 결과(모델 체크포인트 등), 로그를 저장할 디렉토리 # 모델을 평가나 저장할 방식 # 학습률 설정 (파라미터 업데이트 크기) # 디바이스(GPU/CPU) 당 학습 배치 크기 # 디바이스 당 평가 배치 크기 # 전체 학습 데이터를 몇 번 반복할지 (에폭 수) # 과적합 방지를 위한 가중치 감쇠 계수 # 로그를 기록할 스텝 간격 training_args = TrainingArguments(output_dir = "./results", num_train_epochs = 2, # 총 훈련 에폭 수 per_device_train_batch_size = 16, #device당 훈련 배치 크기 per_device_eval_batch_size = 64, #device당 평가 배치 크기 learning_rate = 5e-5, weight_decay = 0.01, # evaluation_strategy = "epoch", #epoch마다 평가 # save_strategy = "epoch", #epoch마다 모델저장 logging_dir = "./logs", logging_steps = 100, #100스탭마다 기록 # load_best_model_at_end = True #훈련 종료시 가장 성능이 좋았던 모델을 로드 ) # 6. Trainer 정의 및 학습 # Trainer를 사용하여 모델을 학습하고 평가합니다. # Trainer는 모델, 학습 인자, 데이터셋 등을 포함하여 학습 및 평가를 관리합니다. # training_args 사용하여 학습 설정을 정의합니다. # 앞서 정의한 compute_metrics 함수를 사용하여 평가 지표를 계산합니다. trainer = Trainer(model = model, args = training_args, train_dataset = train_dataset, eval_dataset = eval_dataset, compute_metrics = compute_metrics) trainer.train() trainer.evaluate() ``` 이부분에서 device가 cpu로 설정되어있는줄 모르고 학습을 돌렸다가, 리소스가 초과돼서 자꾸 튕기는 문제가 있었다. colab에서 학습을 돌릴떄는 호스팅된 런타임이 GPU인지 CPU인지 항상 확인하는 습관을 가져야 겠다. `compute_metrics()` 함수를 통해 `eval_pred` 를 받아와서 평가지표를 dict로 반환한다. `sklearn.metrics` 에 acc, precision, recall, f1을 계산할 수 있는 함수가 있어서, 라이브러리를 import해서 함수안에 labels와 preds를 넣어서 계산해주었다. 이때 preds는 MultiClassification Task임을 고려해서 Logit이 있는 Predictions에서 가장 logit이 높은값만 1로 저장해주었다. 그 다음은 training_args에서의 학습 설정이다. 여기서는 `config` 처럼 trainer에 넘겨줄 학습 설정을 정의한다. - `num_train_epochs`: 총 훈련 에폭 수 - `per_device_train_batch_size`: device당 훈련 배치 크기 - `per_device_eval_batch_size`: device당 평가 배치 크기 - `learning_rate`: 러닝레이트(학습률) - `weight_decay`: Loss function에 정규화를 적용하는 비율 - `logging_dir`:로그를 저장할 디렉토리 - `logging_steps`: 해당 스탭마다 로그를 기록 그 다음은 Trainer를 이용해서 모델을 학습하고 평가한다. 여기서는 사용할 모델, 학습인자, 데이터셋을 포함해서 학습 및 평가를 관리한다. - `model`: 어떤 모델을 사용할건지 사전에 정의한 인스턴스를 넘겨준다. - `args`: 바로 위에서 정의한 training_args를 넘겨준다. - `train_dataset`, `eval_dataset` :train과 검증 데이터셋을 넘겨준다. - `compute_metrics:` 위에서 정의한 함수를 넘겨줘서 acc,recall, precision, f1을 측정한다. ![image](/assets/images/2025-10-22-22-45-32.png) 처음에 epoch을 5로 뒀는데 총 학습시간이 3시간이 나와서 epoch을 2로 줄였다.. 확실히 데이터셋이 2만개가 넘어가니깐 epoch한번 도는데 시간이 상당히 많이 소요됨을 알 수 있다. 이런 학습을 CPU로 돌릴려고 했으니 당연히 리소스가 넘쳐서 튕길만도 하다. ![image](/assets/images/2025-10-22-23-15-29.png) ![image](/assets/images/2025-10-22-23-15-34.png) ![image](/assets/images/2025-10-22-23-15-39.png) ![image](/assets/images/2025-10-22-23-15-46.png) 1시간 23분+12분에 거쳐서 2에폭 학습을 완료시켰다. 학습결과 94퍼센트의 정확도, 93퍼센트의 recall, 94퍼센트의 f1등 예쁘게 점수가 나온것을 확인할 수 있다. # 새로운 문장에서의 Inference ```python # 7. 새 문장 예측 model.eval() # 모델을 평가 모드로 설정 new_sentences = [ "This movie was absolutely fantastic! I highly recommend it.", "What a terrible film. I wasted my time watching it.", "The plot was a bit confusing, but the acting was superb.", "I loved every single moment of this incredible story.", ] inputs = tokenizer( new_sentences, return_tensors="pt", padding=True, truncation=True, max_length=512 ) inputs = {k: v.to(model.device) for k, v in inputs.items()} with torch.no_grad(): outputs = model(**inputs) probs = torch.softmax(outputs.logits, dim=-1) for i, sentence in enumerate(new_sentences): pred = torch.argmax(probs[i]).item() label = "긍정 (Positive)" if pred == 1 else "부정 (Negative)" print(f"\n문장: '{sentence}'") print(f"예측: {label} (부정 확률: {probs[i][0]:.4f}, 긍정 확률: {probs[i][1]:.4f})") with torch.no_grad(): outputs = model(**inputs) print(outputs.logits) ``` 새로운 문장들인 `new_sentences` 를 학습할때와 마찬가지로 토크나이저로 토큰화를 한 후 모델을 돌린다. logit값인 probs를 `argmax` 에 넣어서 pred값을 얻는다. 따라서 pred가 1이면 긍정으로 예측하고 pred가 0이면 부정으로 예측한다. ![image](/assets/images/2025-10-22-23-15-58.png) 새로운 문장에대해서 Inference를 해보면 긍정적인 문장과 부정적인 문장은 거의 99%의 확신을 가지고 예측해냄을 볼 수 있다. 뭔가 대견하고 기특하다. # Living point - 모델과 토크나이저를 라이브러리에서 간단하게 가져와서 학습시킬 수 있었다. 이 파이프라인은 기억해두자.. - 실제로 경진대회를 할때는 데이터를 `df.head()` 로 찍어보고 컬럼중 필요한 컬럼만 남기고, 데이터를 분리해야한다. - colab에서 Train시킬떄는 항상 런타임이 GPU에 연결되어있는지 확인하기. - 평가 metrics를 계산하는 함수는 `sklearn.metrics`에 다 구현되어있으니까 가져다 쓰기만 하면됨 - MultiClassification task의 logit은 여러개의 클래스에 대한 예측값이 담겨있는 텐서이므로, `argmax()` 함수에 넣으면 가장 높은 확률의 클래스만 1로 남기고 나머지는 0으로 남기는 sparse vector의 형태가 된다. - transformers라이브러리에서 TrainingArguments, Trainer는 기억해두고 계속 두고두고 확인해야겠다. 이 함수들의 인자로 넘겨주는 값들은 내가 조정할 수 있다. ### [Domain_Common_Project][과제2] 데이터 누수 탐지 및 방지하기 - Canonical URL: https://hyejunl33.github.io/study/2025-10-21-[Domain_Common_Project]Data_leakage_Detections/ - Collection: Study - Published: 2025-10-21 - Tags: Domain_Common_Project, 과제, Data_leakage_detection, Data_preprocessing # 과제2_데이터 누수 탐지 및 방지하기 - **데이터 누수가 없는 올바른 파이프라인**을 직접 구현 - 중복 데이터, 전처리 순서 오류, 타깃 누수 등 실제 현업에서 발생하는 다양한 데이터 누수 시나리오를 체험 - 상호정보량(Mutual Information)을 활용하여 의심스러운 피처를 탐지하고 제거하는 방법론 학습 ## Task 1. 중복된 데이터 필터링: 검증/테스트 데이터에 학습 데이터와 중복된 데이터를 제거해서 올바른 성과 검증 2. 올바른 전처리 사용: 올바른 전처리 순서를 적용한 누수 없는 파이프라인 구축 3. 피처 검증 및 필터링: 상호정보량 분석을 통한 누수 의심 피처 식별 및 제거 데이터 누수는 휴먼 에러로 언제든지 일어날 수 있다. 따라서 데이터 누수를 사전에 감지해서 올바른 학습 파이프라인을 구축할 수 있어야 한다. 데이터 누수가 없는 학습 파이프라인을 구현할 수 있도록 누수가 발생할 수 있는 부분들에 대해 체크함수를 구현해보자. ```python df = pd.read_csv(파일경로) df.head() ``` pandas라이브러를 이용해서 `read_csv()` 로 파일을 데이터프레임 df로 불러온다. # 올바른 전처리 사용 ```python def check_scaler_fitted_on_train_only(X_train, scaler): # 훈련 데이터의 평균과 분산이 스케일러의 평균과 분산이 일치하는지 확인하는 함수를 구현하세요. (일치하면 True, 아니면 False 반환) if np.allclose(np.mean(X_train), scaler.mean_) and np.allclose(np.std(X_train), scaler.scale_): return True else: return False raise NotImplementedError #d scaler = StandardScaler() scaler.fit(num_features) try: if not check_scaler_fitted_on_train_only(num_features_train, scaler): print("전처리 중에 누수가 있습니다.") else: print("전처리 중에 누수가 없습니다.") except Exception as e: print(f"구현 중에 오류가 발생했습니다: {e}") ``` 여기서 전체 데이터셋을 포함하는 `num_features` 를 `scaler.fit()` 에다 넣어줘서 데이터 누수가 발생한다. 데이터를 `train, test` 로 나누고 각자 따로 scaler를 돌려줘야 되는데, 한번에 scaler를 돌려버리면, train data에도 test data에 대한 정보가 들어간다. 따라서 데이터 누수가 발생한다. scaler를 돌릴떄는 전체데이터셋을 넣으면 절때 안된다.. # 중복된 데이터 필터링 ```python def check_overlap_between_splits(df_train, df_test): #훈련 데이터와 테스트 데이터 간의 중복 샘플을 탐지하는 함수를 구현 merged = pd.merge(df_train, df_test, how='inner', indicator=True) if merged['_merge'].value_counts()['both'] > 0: return True else: return False raise NotImplementedError def remove_overlap_between_splits(df_train, df_test): #테스트 데이터에서 훈련 데이터와 겹치는 샘플들을 제거하는 함수를 구현 df_test = df_test[~df_test.isin(df_train).all(1)] return df_test raise NotImplementedError try: if check_overlap_between_splits(X_train, X_test): print("중복된 샘플이 존재해 누수가 있습니다.") else: print("중복된 샘플이 존재하지 않아 누수가 없습니다.") except Exception as e: print(f"구현 중에 오류가 발생했습니다: {e}") ``` `check_overlap_between_splits()` 함수에서는 `pd.merge()` 를 사용해서 `df_train`과 `df_test` 를 `inner` 로 merge한다. 여기서 만약 중복된 샘플이 하나라도 있다면 True를 리턴하고, 중복된 샘플이 없다면 False를 리턴한다. `remove_overlap_between_splits()` 함수에서는 두 데이터셋 에서 겹치는 샘플들을 제거한다. # Feature 검증 및 필터링 ```python def check_leaky_features(num_features, threshold=0.2): # 누수가 의심되는 피처들을 탐지하는 함수를 구현하세요. (상호정보량이 임계값보다 높은 피처들 반환) # 상호정보량은 sklearn의 mutual_info_classif를 활용하며, 임계값이 0.2이상 이면 누수가 의심스러운 피처로 판단할 수 있습니다. mutual_info = mutual_info_classif(num_features, y_train) leaky_features = num_features.columns[mutual_info > threshold] return leaky_features raise NotImplementedError leaky_features = check_leaky_features(num_features_train) try: if len(leaky_features) > 0: print(f"누수가 의심되는 피처가 존재합니다: {leaky_features}") else: print("누수가 의심되는 피처가 존재하지 않습니다.") except Exception as e: print(f"구현 중에 오류가 발생했습니다: {e}") ``` `check_leaky_features()` 함수에서는 상호 정보량이 threshold인 0.2보다 큰 feature들을 리턴한다. 이떄 `sklearn`의`mutual_info_classif()` 함수를 이용해서 정답 레이블과 features간의 상호 정보량을 계산한다. # Living Point - 파이프라인 설계중 train_test를 나누기전에 scaler를 돌려서 데이터누수가 발생하는것은 매우 흔한 경우라고 한다. 데이터누수가 없으려면 scaler는 데이터셋을 나눈후 꼭! 따로 적용해줘야 한다!! - train과 test데이터에 중복샘플이 있으면 제거해줘야한다! - 정답 레이블과 Input간의 상호 정보량이 너무 크다면 데이터 누수가 발생한다는 증거이다! → `mutual_info_classif()` 로 상호정보량을 계산해서 threshold가 넘는지 안넘는지 검사해야된다! ### [Domain_Common_Project][과제1] 임베딩 레이어 구현 및 FAISS를 활용한 유사문장 검색 과제 - Canonical URL: https://hyejunl33.github.io/study/2025-10-21-[Domain_Common_Project]EmbeddingLayer_and_FAISS/ - Collection: Study - Published: 2025-10-21 - Tags: Domain_Common_Project, 과제, 임베딩 레이어, FAISS, NLP, Tokenization # 과제1_임베딩 레이어 구현 및 FAISS를 활용한 유사문장 검색 과제 이 과제는 텍스트 임베딩 레이어를 직접 구현하고, 생성된 임베딩 벡터를 기반으로 FAISS 라이브러리를 사용해서 효율적인 유사 문장 검색 시스템을 구축하는 과제이다. - 문장에서 단어로, 단어에서 임베딩으로 대체 임베딩은 어떻게 진행되는걸까? - FAISS를 이용해서 대규모 데이터셋에서 어떻게 유사한 항목을 찾아낼까? ## 주요Task 1. Vocabulary 만들기: 주어진 코퍼스에서 고유한 단어들을 추출해서 VOCA를 만든다. 그리고 인식되지 않는 단어는 `‘UNK’` 로 처리한다. 2. 정수 인덱싱 및 패딩: 문장의 각 단어들을 VOCA의 인덱스 시퀀스로 변환하고 최대 문장 길이에 맞춰서 패딩해준다. 3. PyTorch Dataset 및 DataLoader 구현: Dataset과 DataLoader로 데이터를 로딩한다. 4. SentenceEmbeddingModel 구현 # Vocabulary 만들기 ```python # 예시 문장 데이터 (corpus가 이미 있다고 가정) corpus = [ "I study NLP", "NLP is fun", "I love NLP" ] # 1. 모든 문장을 단어 단위로 분리하여 하나의 리스트로 만듭니다. # ex: ['I', 'study', 'NLP', 'NLP', 'is', 'fun', 'I', 'love', 'NLP'] all_words = [word for sentence in corpus for word in sentence.split()] # 2. set()을 이용해 중복된 단어를 제거하고, 다시 리스트로 만들어 정렬합니다. # set()은 순서가 없기 때문에, 재현성을 위해 정렬(sorted)해주는 것이 좋습니다. # ex: ['fun', 'I', 'is', 'love', 'NLP', 'study'] unique_words = sorted(list(set(all_words))) # 3. 특수 토큰(, )을 추가합니다. vocab = ["", ""] + unique_words # 4. 딕셔너리 컴프리헨션(Dictionary Comprehension)을 사용해 간결하게 어휘집을 생성합니다. word_to_idx = {word: idx for idx, word in enumerate(vocab)} idx_to_word = {idx: word for idx, word in enumerate(vocab)} # --- 결과 확인 --- vocab_size = len(word_to_idx) print(f"어휘집 크기 (Vocab Size): {vocab_size}") print(f"어휘집 예시: {list(word_to_idx.items())[:10]}...") print(f"I의 인덱스: {word_to_idx['I']}") ``` 한글은 교착어의 특성을 띠기 때문에 단순히 공백을 기준으로 단어를 나누면 안된다. 하지만 이 과제 실습에서는 외부 라이브러리의 `tokenizer` 를 사용하지 않고, 단순하게 공백으로 `tokenizer` 를 구현한다. `Corpus` 에 리스트 형태로 저장된 문장의 단어를 하나씩 불러와서 일단 리스트로 만든다. 그 후 `set()` 으로중복되는 단어를 제거하고, `vocab[]` 리스트에 특수 토큰과 함께 저장한다. 그 이후에 `word_to_idx` 에는 word를 key로, idx를 val로 갖는 dict를 만들어주고, `idx_to_word` 에는 idx를 key로, word를 val로 갖는 dict를 만들어주어 Voca를 만들어준다. # Tokenizing and Indexing ```python max_seq_len = max(len(s.split()) for s in corpus) print(f"데이터셋 내 최대 문장 길이: {max_seq_len}") def tokenize_and_index( sentence: str, word_to_idx: dict[str, int], max_len: int ) -> list[int]: """문장을 토큰화하고 길이를 조절하는 함수""" # 띄어쓰기 기준으로 단어를 분리하고, 각 단어를 해당하는 인덱스로 변환합니다. # 어휘집에 없는 단어는 '' 토큰의 인덱스로 처리합니다. (리스트 컴프리헨션 사용) indices = [word_to_idx.get(word, word_to_idx[""]) for word in sentence.split()] # 문장의 길이를 max_len에 맞춥니다. # 1) 먼저 최대 길이로 자르고, 2) 그 다음에 부족한 부분을 패딩합니다. indices = indices[:max_len] indices += [word_to_idx[""]] * (max_len - len(indices)) return indices # 2. 모든 문장을 인덱스 시퀀스로 변환 indexed_corpus = [tokenize_and_pad(s, word_to_idx, max_seq_len) for s in corpus] print(f"\n원본 문장: '{corpus[0]}'") print(f"인덱스화 및 패딩된 문장: {indexed_corpus[0]}") print(f"\n원본 문장: '{corpus[1]}'") print(f"인덱스화 및 패딩된 문장: {indexed_corpus[1]}") ``` ``` >>>데이터셋 내 최대 문장 길이: 4 >>>원본 문장: '나는 사과를 좋아해' >>>인덱스화된 문장: [2, 3, 4, 0] ``` 위에서 만든 voca dict를 이용해서 문장을 토큰화하고, 데이터셋 내 최대 문장길이를 넘으면 슬라이싱하는 함수를 이용해서 문장을 인덱스화 한다. # Dataset 및 Dataloader 구현 ```python class TextDataset(Dataset): def __init__(self, indexed_sentences: list[list[int]]) -> None: # 생성자(init)에서 미리 모든 데이터 리스트를 Tensor로 변환하여 저장합니다. self.tensor_sentences = [ torch.tensor(s, dtype=torch.long) for s in indexed_sentences ] def __len__(self) -> int: return len(self.tensor_sentences) def __getitem__(self, idx: int) -> torch.Tensor: # 미리 변환해 둔 Tensor를 그대로 반환하기만 합니다. return self.tensor_sentences[idx] # 데이터셋 인스턴스 생성 dataset = TextDataset(indexed_corpus) dataloader = DataLoader(dataset, batch_size=2, shuffle=True) ``` `TextDataset` 클래스를 통해 `indexed_corpus` 를 인자로 주면 텐서를 반환해준다. 그리고 DataLoader는 사전에 파이토치 라이브러리에서 가져온 `DataLoader`를 그대로 사용한다. DataLoader를 이용해서 `batch_size=2` 만큼 데이터를 가져와서 학습할 수 있으며, `shuffle` 을 해주면서 데이터를 load한다. # SentenceEmbeddingModel 구현 ```python # ruff: noqa class SentenceEmbeddingModel(nn.Module): def __init__(self, vocab_size: int, embedding_dim: int, pad_idx: int) -> None: super(SentenceEmbeddingModel, self).__init__() self.embedding = nn.Embedding(vocab_size, embedding_dim, padding_idx=pad_idx) def forward(self, input_ids: torch.Tensor) -> torch.Tensor: # 인풋을 embedding을 통해 임베딩한다. # 결과 dimension: (batch_size, sequence_length, embedding_dim) embedded = self.embedding(input_ids) #input_ids에서 패딩토큰이 아닌 부분(0이 아닌부분)만 True인 마스크를 생성한다. #마스크: (batch_size, sequence_length) non_pad_mask = (input_ids != 0) #위에서 만든 마스크를 임베딩 결과에 곱하여 패딩부분의 값을 0으로 만든다. # (batch_size, sequence_length, embedding_dim) * (batch_size, sequence_length, 1) masked_embedded = embedded * non_pad_mask.unsqueeze(-1) #sum()을 하고 실제 단어의 개수로 나누어 평균을 계산한다. #(batch_size, embedding_dim) sum_embedded = masked_embedded.sum(dim=1) # 각 시퀀스의 실제 단어 수 (패딩 제외) num_words = torch.sum(non_pad_mask, dim = 1).unsqueeze(-1) # 0으로 나누는 것을 방지 num_words = num_words + (1e-9) sentence_embedding = sum_embedded / num_words return sentence_embedding ``` `SentenceEmbeddingModel` 클래스를 정의한다. `self.embedding()` 을 통해 input을 임베딩하고 non_pad_mask를 만들어서 패딩토큰이 아닌 부분만 True인 마스크를생성한다. 그리고 각 시퀀스의 실제 단어수로 임베딩 `masked_embedd.sum()` 을 나눠서 sentence_embedding을 리턴한다. ```python # 모델 파라미터 설정 embedding_dim = 128 # 각 단어 벡터의 차원 pad_token_idx = word_to_idx[""] # 모델 인스턴스 생성 및 디바이스로 이동 model = SentenceEmbeddingModel(vocab_size, embedding_dim, pad_token_idx).to(device) print(f"\n모델 구조:\n{model}") # 모든 코퍼스 문장에 대한 임베딩 생성 model.eval() # 모델을 평가 모드로 설정 corpus_embeddings = [] with torch.no_grad(): # DataLoader로부터 데이터를 배치(batch) 단위로 받아옵니다. for batch in tqdm(dataloader, desc="Generating corpus embeddings"): # DataLoader가 이미 배치 차원을 만들어주므로 unsqueeze가 필요 없습니다. # 배치 전체를 device로 보냅니다. batch = batch.to(device) # 모델을 통해 배치 전체의 임베딩을 한 번에 계산합니다. batch_embeddings = model(batch) # 계산된 배치 임베딩을 CPU로 옮겨 NumPy 배열로 변환한 뒤 리스트에 추가합니다. # 여러 개의 결과를 한 번에 넣기 위해 append 대신 extend를 사용합니다. corpus_embeddings.extend(batch_embeddings.cpu().numpy()) # 리스트를 최종 NumPy 배열로 변환 corpus_embeddings = np.array(corpus_embeddings).astype("float32") print(f"\n생성된 코퍼스 임베딩 형태: {corpus_embeddings.shape}") ``` 모델 구조를 출력한다. → 생성된 코퍼스 임베딩 형태`: (10, 128)` →(10개의 문장, 128 dimension) ```python # FAISS 인덱스 생성 및 학습 # IndexFlatL2: 가장 기본적인 인덱스. L2 거리(유클리드 거리)를 사용하여 검색합니다. # IndexFlatIP: 내적(Inner Product)을 사용하여 검색합니다. 코사인 유사도 검색 시 유용합니다. # (코사인 유사도는 내적과 관련: A.B / ||A|| ||B||. 만약 벡터가 정규화되어 있다면 코사인 유사도는 내적과 동일) embedding_dim = corpus_embeddings.shape[1] # 임베딩 벡터의 차원 # L2 거리 기반 인덱스 생성 index = faiss.IndexFlatL2(embedding_dim) print(f"FAISS 인덱스에 {len(corpus_embeddings)}개 벡터 추가 시작") index.add(corpus_embeddings) #인덱스에 벡터 추가 print(f"FAISS 인덱스에 {index.ntotal}개 벡터 추가 완료") ``` ```python query_sentence = "나는 과일을 좋아해" # 검색할 문장 print(f"\n질의 문장: '{query_sentence}'") indexed_query = tokenize_and_index(query_sentence, word_to_idx, max_seq_len) query_tensor = ( torch.tensor(indexed_query, dtype=torch.long).unsqueeze(0).to(device) ) # (1, max_seq_len) model.eval() with torch.no_grad(): query_embedding = model(query_tensor).squeeze(0).cpu().numpy().astype("float32") # FAISS를 이용한 유사 문장 상위 3개 검색 k = 3 ( distances, indices, ) =index.search(np.array([query_embedding], dtype = 'float32'), k) # TODO: query_embedding을 이용하여 인덱스에서 상위 k개 문장 검색 print(f"\n가장 유사한 상위 {k}개 문장:") for i in range(k): # FAISS는 기본적으로 거리를 반환 (L2 거리이므로 작을수록 유사) # 거리를 유사도로 변환하고 싶다면 (1 - 정규화된 L2_거리) 또는 코사인 유사도 계산 retrieved_index = indices[0][i] similarity_score = distances[0][i] # L2 거리 print(f"{i + 1}위: '{corpus[retrieved_index]}' (L2 거리: {similarity_score:.4f})") ``` ``` 질의 문장: '나는 과일을 좋아해' >>>가장 유사한 상위 3개 문장: >>>1위: '나는 사과를 좋아해' (L2 거리: 31.8506) >>>2위: '나는 바나나를 좋아해' (L2 거리: 32.2216) >>>3위: '이 영화 정말 재미있어' (L2 거리: 81.3043) ``` FAISS의 `index.search()` 를 이용해서 임베딩과 가장 유사한 상위 3개의 문장을 검색할 수 있다. # Living Point - 이 과제에서는 Voca를 단순하게 공백을 기준으로 단어로 나눈 후 Tokenize해서 만들었지만, 실제로는 한글을 공백으로 나누면 큰일난다..(불용어, 조사…) - 꼭 똑똑한 개발자들이 만들어둔 라이브러리의 Tokennizer를 이용해서 tokenize하자.. - 문장의 입력형식을 맞춰주기 위해, 최대 문장길이에 도달못한 문장은 패딩을 해줘야하고, 최대문장길이보다 긴 문장은 슬라이싱으로 잘라줘야 한다. - `nn.embedding()` 으로 인덱스로 바꾼 각 단어들을 임베딩하는건 쉽게 할 수 있다. 하지만 그 전까지의 voca를 만들고 tokenize하는 과정을 잊지말자… - 문장간의 유사도를 FAISS로 구하기 위해서 각 문장을 `SentenceEmbeddingModel` 클래스로 임베딩했다. - FAISS라이브러리의 `index.search()` 를 이용하면 임베딩벡터 사이의 거리(유사도)를 구할 수 있다. ### [RecSys][과제1] 기본통계학 - Canonical URL: https://hyejunl33.github.io/study/2025-10-19-[RecSys]Probability-distribution/ - Collection: Study - Published: 2025-10-19 - Tags: RecSys, 과제, 기본 통계학, CLT, Conjugate Prior # 과제1_기본통계학 - 중심 극한 정리의 개념을 실습을 통해 이해할 수 있다. - conjugate prior의 의미를 실습으로 체득할 수 있다. - 확률분포를 코드로 구현하는 방법과 plot하는 방법을 배울 수 있다. --- # 중심극한정리(CLT) ![image](/assets/images/2025-10-19-23-09-50.png) 중심극한정리는 독립적인 확률 변수들의 합이나 평균이 표본의 크기가 커질수록 정규분포에 근사하는 현상이다. $$X_n$$은 독립적이고 동일한 분포를 가진 i.i.d확률변수 $$n$$:표본의 크기 $$\mu$$: 확률변수의 평균 $$\sigma$$: 확률변수의 표준편차 ```python import numpy as np import matplotlib.pyplot as plt from scipy.stats import uniform, norm # 균등 분포로부터 표본 추출하는 함수 def sample_uniform_distribution(n, sample_size): samples = np.random.rand(n, sample_size) sample_means = np.mean(samples, axis=1) return sample_means # 히스토그램을 통한 정규 분포 확인 def plot_normal_distribution(sample_means, n): plt.figure(figsize=(8, 6)) plt.hist(sample_means, bins=20, density=True, alpha=0.6, color='g') # 표준 정규 분포를 평균과 표준 편차 계산하여 함께 플롯 mu = np.mean(sample_means) sigma = np.std(sample_means) x = np.linspace(mu - 3*sigma, mu + 3*sigma, 100) plt.plot(x, norm.pdf(x, mu, sigma), 'r-', lw=2) plt.title(f'Distribution of Sample Means (n={n})') plt.xlabel('Sample Mean') plt.ylabel('Density') plt.legend(['Normal Distribution', 'Sample Means']) plt.show() # 표본 크기와 추출 횟수 설정 sample_size = 100 # 각 표본의 크기 n = [10, 50, 1000] # 표본 추출 횟수 for size in n: sample_means = sample_uniform_distribution(size, sample_size) plot_normal_distribution(sample_means, size) ``` ![image](/assets/images/2025-10-19-22-26-36.png) ![image](/assets/images/2025-10-19-22-26-41.png) ![image](/assets/images/2025-10-19-22-26-46.png) `sample_size` 를 100으로 고정하고 표본추출 횟수 n을 10, 50, 1000으로 늘려보면 표본 추출 횟수 $$n$$이 커질수록 표본평균은 정규분포와 가까워짐을 확인할 수 있다. # Conjugate Prior(켤레 사전 확률) 사전확률분포(Prior)와 사후 확률 분포(Posterior)가 같은 종류의 확률분포가 되도록 만들어주는 특별한 관계의 사전분포를 의미한다. 즉 베이즈정리에서 Prior와 likelihood의 곱은 Posterior와 비례관계에 있는데, prior와 likelihood의 곱이 prior의 확률분포꼴을 띠게 되는 관계이다. 이 관계에 있는 확률분포들은 복잡한 계산 없이 파라미터만 업데이트 하면 바로 Posterior를 얻을 수 있다. ### 왜사용할까? 원래 Posterior를 정확히 계산하려면 베이즈정리의 분모에 해당하는 복잡한 적분계산이 필요하다. 하지만 켤레 관계를 이용하면 이 과정을 생략하고, 사전 분포의 파라미터를 데이터의 정보를 이용해서 업데이트하는것 만으로도 Posterior를 얻을 수 있다. ![image](/assets/images/2025-10-19-23-10-24.png) 즉 분모의 $$P(D)$$를 구하려면 복잡한 적분과정을 거쳐야 하는데, 그러한 과정 없이 파라미터 업데이트만으로 Posterior를 구할 수 있음. ## 베르누이 - 베타분포 베르누이 분포: 이항분포에서 시행횟수가 한번의 시행에서 성공할 확률이 p인경우를 모델링 베타분포: 0과 1사이의 값을 가지는 연속 확률분포 베타분포를 prior로, 베르누이분포를 likelihood로 모델링하면 사후분포 또한 베타분포이다. ![image](/assets/images/2025-10-19-22-27-21.png) 베타분포의 PDF는 $\alpha, \beta$에 의해서 결정된다. ![image](/assets/images/2025-10-19-22-27-34.png) 따라서 알파와 베타를 파라미터 추정식으로 업데이트 해준다. ```python import numpy as np import matplotlib.pyplot as plt from scipy.stats import beta # 데이터 생성 (동전 던지기 시뮬레이션) np.random.seed(42) # 재현성을 위한 랜덤 시드 설정 data = np.random.binomial(n=1, p=0.7, size=20) # 동전 던지기를 통한 데이터 생성 (20번 던진 경우) # 사전분포 (베타 분포) alpha_prior = 1 # 베타 분포의 알파 파라미터 beta_prior = 1 # 베타 분포의 베타 파라미터 prior_distribution = beta(alpha_prior, beta_prior) # 데이터를 이용하여 사후분포 갱신 alpha_posterior = alpha_prior + np.sum(data) # 사전분포의 알파 파라미터 갱신 beta_posterior = beta_prior + len(data) - np.sum(data) # 사전분포의 베타 파라미터 갱신 posterior_distribution = beta(alpha_posterior, beta_posterior) # 사전분포와 사후분포 시각화 x = np.linspace(0, 1, 1000) plt.plot(x, prior_distribution.pdf(x), label='Prior', color='blue') plt.plot(x, posterior_distribution.pdf(x), label='Posterior', color='red') plt.title('Conjugate Prior: Beta Prior and Posterior for Bernoulli Distribution (Coin Flip Example)') plt.xlabel('p (Probability of heads)') plt.ylabel('Density') plt.legend() plt.show() ``` ![image](/assets/images/2025-10-19-22-27-43.png) prior의 초기상태에서 Posterior를 업데이트 해서 베르누이 분포의 0.7에서의 확률이 가장 높게 파라미터가 업데이트 됐음을 알 수 있다. ## 포아송 분포 - 감마분포 **포아송분포**: 주어진 시간간격동안 발생한 사건의 횟수를 모델링하는 이산 확률 분포 ![image](/assets/images/2025-10-19-22-28-09.png) 감마분포: 시간을 모델링하는 연속 확률 분포 ![image](/assets/images/2025-10-19-22-28-32.png) ```python import numpy as np import matplotlib.pyplot as plt from scipy.stats import gamma, poisson # 데이터 생성 (가상의 포아송 분포 데이터) np.random.seed(42) # 재현성을 위한 랜덤 시드 설정 data = np.random.poisson(lam=3, size=50) # 포아송 분포를 따르는 데이터 생성 (평균 λ=3, 데이터 수=50) # 사전분포 (감마 분포) alpha_prior = 2 # 감마 분포의 알파 파라미터 beta_prior = 1 # 감마 분포의 베타 파라미터 prior_distribution = gamma(alpha_prior, scale=1/beta_prior) # 데이터를 이용하여 사후분포 갱신 alpha_posterior = alpha_prior + np.sum(data) beta_posterior = beta_prior + len(data) posterior_distribution = gamma(alpha_posterior, beta_posterior) # 시각화 x = np.linspace(0, 15, 1000) plt.plot(x, prior_distribution.pdf(x), label='Prior', color='blue') plt.plot(x, posterior_distribution.pdf(x), label='Posterior', color='red') plt.title('Conjugate Prior: Gamma Prior and Posterior for Poisson Distribution') plt.xlabel('λ (Rate parameter)') plt.ylabel('Density') plt.legend() plt.show() ``` ![image](/assets/images/2025-10-19-22-28-41.png) ## 정규분포 - 정규분포 정규분포는 CLT의 성질을 활용할 수 있는 이점이 있기 때문에 모델링할때 자주 사용되는 연속확률 분포이다. $$\mu, \sigma^2$$를 파라미터로 이용해서 모델링한다. ![image](/assets/images/2025-10-19-22-28-55.png) ```python import numpy as np import matplotlib.pyplot as plt from scipy.stats import norm # 데이터 생성 (가상의 정규 분포 데이터) np.random.seed(42) data = np.random.normal(loc=10, scale=2, size=10) # 평균이 10이고 표준편차가 2인 정규 분포를 따르는 데이터 생성 # 사전분포 선택 (정규 분포) mu_prior = 0 # 평균의 초기값 sigma_prior = 1 # 표준편차의 초기값 prior_distribution = norm(mu_prior, sigma_prior) data_sigma = 2 # 데이터를 이용한 사후분포 갱신 mu_posterior = (1 / ((1 / sigma_prior**2) + (len(data) / data_sigma**2))) * ((mu_prior / sigma_prior**2) + (np.sum(data) / data_sigma**2)) sigma_posterior = np.sqrt(1 / ((1 / sigma_prior**2) + (len(data) / data_sigma**2))) posterior_distribution = norm(mu_posterior, sigma_posterior) # 시각화 x = np.linspace(-5, 15, 1000) plt.plot(x, prior_distribution.pdf(x), label='Prior', color='blue') plt.plot(x, posterior_distribution.pdf(x), label='Posterior', color='red') plt.title('Conjugate Prior: Normal Prior and Posterior for Normal Distribution') plt.xlabel('μ (Mean)') plt.ylabel('Density') plt.legend() plt.show() ``` ![image](/assets/images/2025-10-19-22-29-06.png) prior와 posterior 둘다 모두 정규분포임을 볼 수 있다. # 분포간의 근사관계 ## 베타분포 - UniForm분포 ![image](/assets/images/2025-10-19-22-29-22.png) ```python import numpy as np import matplotlib.pyplot as plt from scipy.stats import beta, uniform # Beta 분포의 모수 설정 alpha_prior = 1 beta_prior = 1 alpha_prior2 = 0.5 beta_prior2 = 0.5 alpha_prior3 = 2 beta_prior3 = 3 # Uniform 분포의 범위 설정 x = np.linspace(0, 1, 1000) # Beta 분포와 Uniform 분포의 확률 밀도 함수 계산 beta_pdf = beta(alpha_prior, beta_prior).pdf(x) beta_pdf2 = beta(alpha_prior2, beta_prior2).pdf(x) beta_pdf3 = beta(alpha_prior3, beta_prior3).pdf(x) uniform_pdf = uniform.pdf(x) # 시각화 plt.plot(x, beta_pdf, label='Beta Distribution (α=1, β=1)') plt.plot(x, beta_pdf2, label='Beta Distribution (α=0.5, β=0.5)') plt.plot(x, beta_pdf3, label='Beta Distribution (α=2, β=3)') plt.plot(x, uniform_pdf, label='Uniform Distribution', linestyle='--', color='red') plt.title('Comparison of Beta and Uniform Distributions') plt.xlabel('x') plt.ylabel('Probability Density') plt.legend() plt.show() ``` ![image](/assets/images/2025-10-19-22-29-31.png) $$\alpha = 1, \beta = 1$$에서 파란색과 빨간색 그래프가 일치함을 확인할 수 있다. ## Gamma분포 - Exponential분포 ![image](/assets/images/2025-10-19-22-29-49.png) ```python import numpy as np import matplotlib.pyplot as plt from scipy.stats import gamma, expon # Gamma 분포의 모수 설정 alpha1 = 1 beta1 = 1 alpha2 = 2 beta2 = 3 # Exponential 분포의 모수 설정 lambda_ = 1 # 범위 설정 x = np.linspace(0, 5, 1000) # Gamma 분포와 Exponential 분포의 확률 밀도 함수 계산 gamma_pdf1 = gamma.pdf(x, alpha1, scale=1/beta1) gamma_pdf2 = gamma.pdf(x, alpha2, scale=1/beta2) exponential_pdf = expon.pdf(x, scale=1/lambda_) # 시각화 plt.plot(x, gamma_pdf1, label='Gamma Distribution (α=1, β=1)') plt.plot(x, gamma_pdf2, label='Gamma Distribution (α=2, β=3)') plt.plot(x, exponential_pdf, label='Exponential Distribution', linestyle='--', color='red') plt.title('Comparison of Gamma and Exponential Distributions') plt.xlabel('x') plt.ylabel('Probability Density') plt.legend() plt.show() ``` ![image](/assets/images/2025-10-19-22-29-59.png) 감마분포에서 $$\alpha=1$$로 주었을때 지수분포와 같음을 확인할 수 있다.. ## Binomial분포 - Normal분포 ![image](/assets/images/2025-10-19-22-30-09.png) $$X \sim \text{Binomial}(n, p)$$ $$E[X]=np, {Var}(X)=np(1-p)$$ $$X \approx N(np,np(1-p))$$ ```python import numpy as np import matplotlib.pyplot as plt from scipy.stats import binom, norm # 이항 분포의 모수 설정 n = 20 # 시행 횟수 p = 0.5 # 성공 확률 # 정규 분포의 모수 설정 (이항 분포의 기댓값과 분산을 사용) mean = n*p variance = mean*(1-p) std_dev = np.sqrt(variance) # 범위 설정 x = np.arange(0, 20) # 이항 분포의 확률 질량 함수 계산 binomial_pmf = binom.pmf(x, n, p) # 정규 분포의 확률 밀도 함수 계산 normal_pdf = norm.pdf(x, mean, std_dev) # 시각화 plt.plot(x, binomial_pmf, label='Binomial Distribution (n=20, p=0.5)', color='blue') plt.plot(x, normal_pdf, label='Normal Distribution', linestyle='--', color='red') plt.title('Comparison of Binomial and Normal Distributions') plt.xlabel('x') plt.ylabel('Probability Density') plt.legend() plt.show() ``` ![image](/assets/images/2025-10-19-22-30-17.png) $$n=20$$이고 $$p=0.5$$인 이항분포는 정규분포를 따름을 확인할 수 있다. ### [RecSys][과제2] GPT2 모델을 이용한 영화 추천 - Canonical URL: https://hyejunl33.github.io/study/2025-10-16-[RecSys]Generate-movies-Recommendation-with-GPT2/ - Collection: Study - Published: 2025-10-16 - Tags: RecSys, 과제, GPT2, 영화추천 # 과제2_생성모델 1. GPT의 prompt로 사용할 추천시스템 데이터를 전처리하고 만들기 2. GPT를 사용해서 prompt에 따른 추천 결과 생성 추천시스템 데이터는 오픈소스로 풀려있는 영화 선호도 데이터를 이용한다. 활용 데이터셋 : MovieLens Dataset - 출처 : Harper, F. M., & Konstan, J. A. (2015). **The MovieLens Datasets: History and Context.** ACM Transactions on Interactive Intelligent Systems (TIIS), 5(4), 1-19. [http://dx.doi.org/10.1145/2827872](https://www.google.com/url?q=http%3A%2F%2Fdx.doi.org%2F10.1145%2F2827872) GPT2를 huggingface 라이브러리에서 불러와 사용할 수 있다. GPT에 데이터를 줄때, prompt의 형식에 따라 출력이 달라지게 된다. 따라서 적절한 prompt를 적용할 수 있는 능력을 갖춰야 한다. ```python import os import numpy as np import pandas as pd import random import torch from transformers import GPT2LMHeadModel, GPT2Tokenizer %matplotlib inline ``` `transformers`라이브러리에서 GPT2 headmodel과 tokenizer를 가져와서 사용한다. `transformers` 라이브러리는 huggingface에서 만든 라이브러리로 GPT, BERT 같은 NLP모델들을 가져와서 쓸 수 있다. # 데이터 전처리 `pd.read_csv()` 를 통해 rating_df와 movies_df를 생성한다. 즉 판다스 라이브러리의 `read_csv()` 함수를 이용해서 추천시스템에 필요한 rating 데이터프레임과 movies 데이터프레임을 생성한다. 이때 `u.data` 에 있던 데이터는 평점데이터이고, `u.item` 에 있던 데이터는 영화정보 데이터이다. ```python ratings_df.columns = ['userId', 'movieId', 'rating', 'timestamp'] movies_df.columns = ['movieId', 'movie_title', 'release_date', 'video_release_date', 'IMDb_URL', 'unknown', 'Action', 'Adventure', 'Animation', 'Children', 'Comedy', 'Crime', 'Documentary', 'Drama', 'Fantasy', 'Film-Noir', 'Horror', 'Musical', 'Mystery', 'Romance', 'Sci-Fi', 'Thriller', 'War', 'Western'] ``` 이때 원래 `data_path`에 있던 각 data파일은 csv함수에서 `Header=None` 으로 불려와서 각 열에 header가 없는 상태이다. 따라서 올바른 열의 headcer를 `df.columns` 로 지정해준다. ```python df = pd.merge(ratings_df, movies_df, on='movieId') df = df[['userId', 'movieId', 'rating','movie_title']] df['movie_title'] = df.movie_title.map(process_movielens_name) df.head() ``` 여기서 `rating_df, movies_df` 를 merge한 후에 4개의 열만 가져와서 df를 새로 만든다. 유저가 좋아할만한 영화를 추천하기 위해 df에서 별점이 4점 이상인 영화만 남기자. ```python high_df = df[df['rating']>=4] ``` # 추천시스템에 GPT사용 GPT(Generative Pre-trained Transformer)는 트렌스포머 아키텍처에 기반한다. GPT의 등장 이후 pre-training과 fine-tuning을 나누는 접근법이 등장하게 됐다. 이를 통해 큰 규모의 언어 모델링을 통해 pre-train된 모델을 만들고, 각 task에 맞는 작은 dataset으로 학습하는 fine-tuning을 통해 다양한 NLP task를 우수한 성능으로 해결할 수 있게 됐다. 기존의 추천시스템에서는 BERT4Rec과 같은 모델을 통해 주변 context를 이해하는 cloze task로 학습했다. 하지만 이와달리 GPT생성모델은 텍스트생성에 직접적으로 활용되어서 학습없이 zero-shot 예측이 가능해진다. ## GPT model, tokenizer불러오기 ```python model = GPT2LMHeadModel.from_pretrained('gpt2-medium') tokenizer = GPT2Tokenizer.from_pretrained('gpt2-medium') tokenizer.pad_token = tokenizer.eos_token ``` gpt2-medium은 355M개의 parameter를 가진 모델이다. 이때 gpt2-medium모델은 기본 패딩 토큰이 없으므로, 문장의 끝을 알리는 `eos_token` 을 패딩토큰으로 사용하도록 지정해줘야한다. ## 추천결과 생성함수 구현 GPT모델을 이용해서 input에 기반하여 새로운 텍스트 추천을 생성하는 함수를 정의한다. - input을 tokenizer로 encode하기 - output을 `model.generate()` 을 통해 생성하기 - 생성된 output을 decoding해서 추천결과(recommendations)출력하기 ```python def generate_recommendations(input_text, model, tokenizer): max_length = 100 # 입력 텍스트가 최대 길이(max_length)를 초과하는 경우 잘라냄 if len(input_text) > max_length: input_text = input_text[:max_length] # 입력 텍스트를 토큰화 input_ids = tokenizer(input_text, return_tensors='pt') # 모델을 사용하여 텍스트 생성 output = model.generate(input_ids, max_length=max_length, early_stopping=True,pad_token_id = tokenizer.eos_token_id) # 생성된 텍스트를 디코딩하여 output(추천결과) 생성 recommendations = [tokenizer.decode(ids, skip_special_tokens=True) for ids in output] return recommendations ``` 이때 max_length에 따라서도 출력이 달라진다고 한다. max_length를 300이나 더 큰 숫자로 주면, 영화 제목을 추천하는게 아니라, 영화와 관련된 문장을 생성한다. 그런데, 100으로 주면 문장을 쓰기에는 짧은 제한이기 때문에, 영화 제목을 추천하는식으로 LLM이 동작한다. ## Prompt 형식 비교 LLM은 입력된 프롬프트의 형태에 따라 성능이 크게 달라질 수 있다. → 같은 데이터에서 다른 프롬프트를 사용해서 결과를 비교해보자. Zero-Shot Recommendation as Language Modeling논문에서는 아래 2개의 prompt로 구성되었고, 보다 효과적인 Prompt디자인을 탐색해서 LLM활용가능성을 극대화 할 수 있다. ### GPT2모델에 입력으로 사용할 input Prompt 생성하기 ```python def create_k_input(userId, high_df, k): #high_df에서 입력으로 받은 userId가 평가한 영화만 저장 user_rated_movies = high_df[high_df['userId'] == userId] #영화가 k보다 적다면 None 반환 if len(user_rated_movies) < k: return None # 영화 제목을 리스트로 만들어서 movies에 저장 movies = user_rated_movies['movie_title'].tolist() # movies리스트에서 입력으로 받은 k개의 영화제목을 슬라이싱 하고, comma로 구분하여 text로 합치기 created_text = ", ".join(movies[:k]) return created_text ``` 이전에 만들었던 4점 이상의 영화 df인 high_df에서 입력으로 받은 `UserID` 에 맞게 k개의 영화 제목을 str형태로 반환하는 함수이다. 여기서 movies리스트를 comma로 구분하는데, comma뒤에 띄어쓰기를 안하면`(”,”`) GPT2모델이 영화 제목을 구분하지 못하는 문제가 있었다. 디버깅을 할때 comma뒤에 공백 한칸이 포함된 `“, ”` 로 나눠주어야 영화제목을 구분해서 출력을 올바르게 하는것을 디버깅 과정에서 알 수 있었다. LLM은 공백이나, comma, 입력 형식에 따라 출력양상이 아주 달라지는것을 알 수 있었다. ``` Recommendations: ["If you like The Shawshank Redemption, Singin' in the Rain, The Graduate, The Professional, The Sting, The Social Network, The Social Network 2, The Social Network 3, The Social Network 4, The Social Network 5, The Social Network 6, The Social Network 7, The Social Network 8, The Social Network 9, The Social Network 10, The Social Network 11, The Social Network 12, The Social Network 13, The Social Network 14, The Social Network 15, The"] ``` `created_text = ", ".join(movies[:k])` 로 `“, ”` 공백을 포함해서 input 영화 제목을 넣어주면 정상적으로 추천영화 목록이 출력된다. ``` ["If you like The Shawshank Redemption,Singin' in the Rain,The Graduate,The Professional,The Sting, yo.\n\nI'm not a fan of the movie, but I'm a fan of the movie. I'm a fan of the movie. I'm a fan of the movie. I'm a fan of the movie. I'm a fan of the movie. I'm a fan of the movie. I'm a fan of the movie. I'm a fan of"] ``` 하지만 `“,”` 로 공백을 포함해서 input을 주지않으면, 구분된 영화 제목이라는것을 모델이 인지하지 않고, 의미없는 문장의 나열을 출력한다. → LLM의 입력 prompt의 형식에 따라 출력이 매우 달라진다. ### Prompt 1) if you like<$$m_1$$…$$m_n$$>, you will like <$$m_i$$> ```python userId = 16 created_text = create_k_input(userId,high_df,k=5) # Prompt 1 포맷을 가진 input_text를 생성합니다. input_text = "If you like "+ created_text + ", you will like " print(input_text) recommendations = generate_recommendations(input_text, model, tokenizer) #출력 결과 print("Recommendations:") print(recommendations) ``` prompt 1의 결과는 위에서 비교한 결과에서 볼 수 있듯이 “the social network”라는 영화를 추천으로 생성한 것을 볼 수 있다. ### Prompt 2) <$$m_1$$…$$m_n$$>,<$$m_i$$> ```python userId = 16 created_text = create_k_input(userId, high_df,k=5) # Prompt 2 포맷을 가진 input_text를 생성합니다. input_text = created_text + ", " print(input_text) ``` ```python recommendations = generate_recommendations(input_text, model, tokenizer) print("Recommendations:") print(recommendations) ``` prompt 1의 형식과는 다르게, 영화 제목만 `“, ”` 로 구분해서 input으로 넣어주면 “The Sound of Music”을 추천으로 생성한 것을 볼 수 있다. prompt2가 기존에 좋아했던 영화들의 맥락을 더 잘 파악해서 ‘고전영화’라는 맥락을 포함한 ”The Sound of Music”을 추천한 것을 확인할 수 있다. 그러나 같은 영화명을 반복하는것을 보았을때 개선의 여지가 있음을 볼 수 있다. ### Number of movies 비교 `create_k_input()`함수에서 input의 개수인 k에 따라 결과가 어떻게 달라지는지 비교해보자 - k=2 사용 (영화 2개로 추천) ```python user_id = 16 created_text = create_k_input(user_id, high_df,k=2) # Prompt 2 포맷을 가진 input_text를 생성합니다. input_text = created_text + ", " recommendations = generate_recommendations(input_text, model, tokenizer) print("Recommendations:") print(recommendations) ``` ``` Recommendations: ["The Shawshank Redemption, Singin' in the Rain, \xa0and The Big Lebowski are all great examples of films that are not only great, but also have a great story.\nThe story of The Shawshank Redemption is a classic example of a film that is not only great, but also has a great story. The story of The Shawshank Redemption is a classic example of a film that is not only great, but also has a great story.\nThe Shaw" ``` 출력된 결과를 보면 영화 2개를 입력으로 주면, 영화제목인지 인식하지 못하고, 영화 제목들과 관련된 엉뚱한 문장들을 생성한 것을 볼 수 있다. - k=6사용 (영화 6개로 추천) ```python user_id = 16 created_text = create_k_input(user_id, high_df,k=6) # Prompt 2 포맷을 가진 input_text를 생성합니다. input_text = created_text + ", " print(input_text) recommendations = generate_recommendations(input_text, model, tokenizer) print("Recommendations:") print(recommendations) ``` ``` Recommendations: ["The Shawshank Redemption, Singin' in the Rain, The Graduate, The Professional, The Sting, Babe, \xa0The Graduate, The Graduate, The Professional, The Sting, Babe, \xa0The Graduate, The Professional, The Sting, Babe, \xa0The Graduate, The Professional, The Sting, Babe, \xa0The Graduate, The Professional, The Sting, Babe, \xa0The Graduate, The Professional, The Sting, Babe, \xa0The Graduate, The Professional"] ``` `k=6` 일때는 적어도 영화제목들을 `“, ”` 로 구분해서 입력으로 제시하고 있다는 맥락을 파악하고, 영화 제목들을 출력으로 생성하고 있는것을 볼 수 있다. # 소감 GPT같은 LLM모델은 prompt의 형식에 따라 내용은 같더라도 형태는 다른 input에 따라 생성하는 출력이 매우 달라지게 되는것을 확인할 수 있었다. 그리고 입력의 개수 k 를 조작함에 따라, 출력이 또한 달라지는것을 확인할 수 있었다. 모델이 더 의미있는 출력을 하려면, 원하는 형식(추천 영화 제목을 `“, ”` 로 구분해서 출력) 할때 강화학습이 진행되도록 할 수도 있고, 더 큰 모델을 사용하거나, 특정한 분야(영화 데이터)에 대해 Fine-tuning을 하는 방법도 있을것이다. zero-shot Recommendation as Language Modeling 논문을 추가로 읽어보고 리뷰를 작성해보면서, 더 심화공부를 해볼 예정이다. ### [RecSys][과제4] 변분추론 기반의 생성모델 학습구현 - Canonical URL: https://hyejunl33.github.io/study/2025-10-16-[RecSys]VAE-AutoEncoder-Visualization/ - Collection: Study - Published: 2025-10-16 - Tags: RecSys, 과제, AutoEncoder, Variational Auto Encoder, Visualization # 과제4_변분추론 기반의 생성모델 학습구현 1. 변분추론 기반의 VAE를 구현 2. 유저사이드로 학습하고 클러스터링 결과를 확인 3. 잠재벡터와 클러스터링을 연관짓고 모델의 학습경향을 시각화 ## 데이터셋 과제 2와 마찬가지로 MovieLens Dataset을 사용한다. 출처 :Harper, F. M., & Konstan, J. A. (2015). **The MovieLens Datasets: History and Context.** ACM Transactions on Interactive Intelligent Systems (TIIS), 5(4), 1-19. [http://dx.doi.org/10.1145/2827872](https://www.google.com/url?q=http%3A%2F%2Fdx.doi.org%2F10.1145%2F2827872) 과제 2와 마찬가지로 평점 데이터는 `ratings_df` 로 불러오고, 영화 정보 데이터는 `movies_df` 로 불러온다. ## 모델 과제3에서 정의했던 VAE모델을 그대로 사용한다. ## 유저벡터 활용 클러스터링 ### 유저 잠재 벡터(z) 추출 VAE 모델을 사용해서 유저 잠재 벡터(z)를 추출한다. 잠재벡터는 유저-아이템 행렬을 모델에 입력하여 인코딩 레이어에서 생성된다. → 유저의 잠재적 특징을 나타내는 벡터를 얻을 수 있다.→ 유사한 선호도를 가진 유저들이 같은 클러스터에 속하고, 클러스터 별로 명확하게 구분하고 시각화 할 수 있다. ```python # 추론 with torch.no_grad(): # FILL HERE # HOMEWORK(1)의 모델 출력 중 임베딩 생성에 필요한 변수만 사용 hidden, _, _, _ = vae(torch.Tensor(df_train.values)) ``` `vae` 모델에서 `hidden_vector` z만 받아온다. ### 유저 클러스터링 - 추출된 유저 잠재벡터(z)를 이용해서 클러스터링을 수행하고 2차원으로 시각화 한다. - K-Means를 클러스터링 기법으로 사용해서 유사한 특징을 가진 유저들을 그룹화 한다. ```python # 클러스터링 kmeans = KMeans(n_clusters=3, random_state=42) clusters = kmeans.fit_predict(hidden)#kmeans.fit_predict(VAE의 latent vector) # train 데이터의 user_item_matrix에 클러스터 추가 train_user_item_matrix = user_item_matrix.loc[df_train.index].copy() train_user_item_matrix['cluster'] = clusters # 결과 출력 print(train_user_item_matrix.head()) ``` ``` movieId 1 2 3 4 5 6 7 8 9 10 ... 1674 1675 \ userId ... 245 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 ... 0.0 0.0 83 4.0 4.0 0.0 2.0 0.0 0.0 0.0 0.0 0.0 0.0 ... 0.0 0.0 317 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 ... 0.0 0.0 351 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0.0 ... 0.0 0.0 466 0.0 1.0 0.0 3.0 0.0 0.0 4.0 0.0 0.0 0.0 ... 0.0 0.0 movieId 1676 1677 1678 1679 1680 1681 1682 cluster userId 245 0.0 0.0 0.0 0.0 0.0 0.0 0.0 1 83 0.0 0.0 0.0 0.0 0.0 0.0 0.0 1 317 0.0 0.0 0.0 0.0 0.0 0.0 0.0 0 351 0.0 0.0 0.0 0.0 0.0 0.0 0.0 1 466 0.0 0.0 0.0 0.0 0.0 0.0 0.0 1 [5 rows x 1683 columns] ``` 유저가 속한 클러스터(0,1,2)를 2차원 matrix로 시각화 할 수 있다. ```python train_user_item_matrix.cluster.value_counts() ``` 클러스터별로 속하는 사람 숫자 수를 표로 출력할 수 있다. ![image](/assets/images/2025-10-16-15-18-16.png) t-SNE를 이용해서 각 클러스터링에 속하는 사람들을 2차원 공간상에 시각화 할 수 있다. ### 클러스터 별 장르/ 영화 구성 확인 ``` Cluster 0 Top Genres: Drama, Comedy, Action Movies: Drama: Contact (1997), Fargo (1996), Chasing Amy (1997) Comedy: Liar Liar (1997), Toy Story (1995), Back to the Future (1985) Action: Star Wars (1977), Return of the Jedi (1983), Air Force One (1997) Cluster 1 Top Genres: Drama, Comedy, Action Movies: Drama: Fargo (1996), English Patient, The (1996), Contact (1997) Comedy: Toy Story (1995), Liar Liar (1997), Back to the Future (1985) Action: Star Wars (1977), Return of the Jedi (1983), Godfather, The (1972) Cluster 2 Top Genres: Drama, Comedy, Action Movies: Drama: Contact (1997), English Patient, The (1996), Fargo (1996) Comedy: Liar Liar (1997), Toy Story (1995), Willy Wonka and the Chocolate Factory (1971) Action: Star Wars (1977), Return of the Jedi (1983), Independence Day (ID4) (1996) ``` 각 클러스터별로 top Genre를 나눠서 추출할 수 있다. ### 클러스터 별 유저 정보 확인 ``` Cluster 0 Top Occupations: student: 22.18% other: 12.41% administrator: 8.65% educator: 8.65% engineer: 7.14% Cluster 1 Top Occupations: student: 16.15% other: 11.54% educator: 11.54% engineer: 8.46% administrator: 8.08% Cluster 2 Top Occupations: student: 21.49% other: 10.96% programmer: 9.21% educator: 8.77% administrator: 8.77% ``` 클러스터링 된 사용자 그룹 내에서 클러스터가 어떤 직업으로 이루어져 있는지를 확인해 볼 수 있다. ### [RecSys][과제3] 추천시스템을 위한 생성모델 구현 - Canonical URL: https://hyejunl33.github.io/study/2025-10-16-[RecSys]VAE-AutoEncoder-implementation/ - Collection: Study - Published: 2025-10-16 - Tags: RecSys, 과제, AutoEncoder, Variational Auto Encoder # 과제3_추천시스템을 위한 생성모델 구현 1. AutoEncoder기반 추천시스템 모델(AutoRec)을 학습시킨다. 2. 생성모델 기반 추천시스템 모델을 학습시킨다. - 추천시스템에서 생성모델이 어떻게 활용되는지 자세히 알아보자. - Autoencoder를 활용한 추천시스템 모델인 AutoRec에 대해서도 배운다. - Variational Inference 기반의 variational autoencoder(VAE)를 직접 학습시켜보며, 이를 추천시스템에 적용해 보자. ## 데이터셋 과제 2와 마찬가지로 MovieLens Dataset을 사용한다. 출처 :Harper, F. M., & Konstan, J. A. (2015). **The MovieLens Datasets: History and Context.** ACM Transactions on Interactive Intelligent Systems (TIIS), 5(4), 1-19. [http://dx.doi.org/10.1145/2827872](https://www.google.com/url?q=http%3A%2F%2Fdx.doi.org%2F10.1145%2F2827872) 과제 2와 마찬가지로 평점 데이터는 `ratings_df` 로 불러오고, 영화 정보 데이터는 `movies_df` 로 불러온다. ```python df_train, df_test = train_test_split( user_item_matrix, test_size=0.2, random_state=42) ``` 그리고 `df_train`과 `df_test`로 `train_test_split()` 을 이용해서 `train_dataset`과 `test_dataset`으로 나눠준다. # AutoRec 모델 구현하기 2015년에 제안된 모델로 추천시스템 설계시, 사용자와 항목을 복합적으로 고려하는 “Collaborative filtering”을 위해 설계된 모델이다. ![image](/assets/images/2025-10-16-14-58-38.png) $$r^{(i)}$는 각각의 n개의 item에 대한 rating을 담고있는 input이자 output이다. input으로 $$r^{(i)}$$를 넣어주면 모델을 거쳐서 masking된(빈칸) 입력에 대한 output rating을 예측(reconstruction)하는 모델이다. ```python class AutoRec(nn.Module): def __init__(self, input_size, hidden_size): super(AutoRec, self).__init__() self.encoder = nn.Linear(input_size, hidden_size) self.decoder = nn.Linear(hidden_size, input_size) def forward(self, ratings): encoded = torch.sigmoid(self.encoder(ratings)) decoded = self.decoder(encoded) return decoded ``` `AutoRec` 클래스를 통해 모델을 구현한다. 구조 자체는 간단한데, 선형변환 `nn.Linear()` 로 encoding 과 decoding layer를 정의한다. 그리고 `forward()` 에서는 들어온 ratings를 `encode()` 하고 Activation Function에 넣어준 후 다시 `decode()` 해준다. ```python # 하이퍼파라미터 설정 hidden_size = 10 learning_rate = 0.001 num_epochs = 20 lambda_value = 0.001 # weight decay의 계수 # 데이터 로더 생성 train_dataset = TensorDataset(torch.Tensor(df_train.values)) train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True) num_movies = user_item_matrix.shape[1] # 모델 초기화 model = AutoRec(num_movies, hidden_size) criterion = nn.MSELoss(reduction="sum") optimizer = optim.Adam(model.parameters(), lr=learning_rate) ``` 하이퍼파라미터로 `epoch`수와, `weight_decay`의 계수, `lr, hidden_size`를 설정한다. 데이터로더로 `train_dataset`을 불러오고, 만든 모델을 불러오고, `MSELoss()` 로 lossfunction을 사용하고, `Adam()` 으로 Optimizer를 불러온다.. ## AutoRec 학습과정 구현하기 ```python #model parameter에 L2-regulation항을 더해준다.->Overfitting을 막기 위함 def weight_decay_loss(model, lambda_value): l2_reg = None for param in model.parameters(): if l2_reg is None: l2_reg = param.norm(2) else: l2_reg = l2_reg + param.norm(2) return lambda_value * l2_reg #true_positive/sum(y_true)을 계산해서 k에서의 recall을 계산한다. def recall_at_k(y_true, y_score, k): """Compute Recall@k""" _, indices = torch.topk(y_score, k, dim=1) recalls = [] for i in range(len(y_true)): true_positives = torch.sum(y_true[i][indices[i]]) recall = true_positives / torch.sum(y_true[i]) recalls.append(recall.item()) return torch.tensor(recalls).mean() # 모델 학습 for epoch in range(num_epochs): running_loss = 0.0 for data in train_loader: inputs = data[0] optimizer.zero_grad() outputs = model(inputs) # loss를 정의할떄 앞서 정의한 weight_decay_loss()함수를 통해 L2-reg term을 더해준다. loss = criterion(inputs,outputs) + 0.5*weight_decay_loss(model, lambda_value) loss.backward() optimizer.step() running_loss += loss.item() running_loss = running_loss/len(train_loader) with torch.no_grad(): test_batch_data = torch.Tensor(df_test.values) test_recon_batch = model(test_batch_data) test_loss = criterion(test_recon_batch * torch.sign(test_batch_data), test_batch_data).item() test_recon_batch_prob = torch.sigmoid(test_recon_batch) # NDCG@k와 Recall@k 계산 ndcg = ndcg_score(df_test.values, test_recon_batch_prob, k=20) recall = recall_at_k(test_batch_data, test_recon_batch_prob, k=20) mse = mean_squared_error(df_test.values, test_recon_batch * torch.sign(test_batch_data)) print('Epoch [{}/{}]'.format(epoch+1, num_epochs)) print('Train Loss: {:.4f}, Test Loss: {:.4f}, NDCG@k: {:.4f}, Recall@k: {:.4f}, MSE: {:.4f}'.format(running_loss, test_loss, ndcg, recall, mse)) ``` ``` Epoch [1/20] Train Loss: 98700.3874, Test Loss: 268948.0625, NDCG@k: 0.0971, Recall@k: 0.0155, MSE: 0.8460 Epoch [2/20] Train Loss: 95074.2370, Test Loss: 267445.3125, NDCG@k: 0.1482, Recall@k: 0.0288, MSE: 0.8413 Epoch [3/20] Train Loss: 94061.6576, Test Loss: 266039.7188, NDCG@k: 0.1760, Recall@k: 0.0408, MSE: 0.8369 Epoch [4/20] Train Loss: 93309.4954, Test Loss: 264639.8750, NDCG@k: 0.1938, Recall@k: 0.0470, MSE: 0.8325 Epoch [5/20] Train Loss: 92635.5046, Test Loss: 263226.9375, NDCG@k: 0.2044, Recall@k: 0.0523, MSE: 0.8280 Epoch [6/20] Train Loss: 91997.1159, Test Loss: 261829.7812, NDCG@k: 0.2128, Recall@k: 0.0564, MSE: 0.8236 Epoch [7/20] Train Loss: 91397.5404, Test Loss: 260383.3750, NDCG@k: 0.2223, Recall@k: 0.0604, MSE: 0.8191 Epoch [8/20] Train Loss: 90798.6120, Test Loss: 258914.1875, NDCG@k: 0.2325, Recall@k: 0.0658, MSE: 0.8145 Epoch [9/20] Train Loss: 90196.8542, Test Loss: 257142.3281, NDCG@k: 0.2388, Recall@k: 0.0694, MSE: 0.8089 Epoch [10/20] Train Loss: 89436.3372, Test Loss: 253187.0000, NDCG@k: 0.2401, Recall@k: 0.0768, MSE: 0.7964 Epoch [11/20] Train Loss: 88285.2878, Test Loss: 248248.8594, NDCG@k: 0.2474, Recall@k: 0.0835, MSE: 0.7809 Epoch [12/20] Train Loss: 86599.3307, Test Loss: 239259.5469, NDCG@k: 0.2546, Recall@k: 0.0915, MSE: 0.7526 Epoch [13/20] Train Loss: 84050.0820, Test Loss: 228116.2500, NDCG@k: 0.2736, Recall@k: 0.1020, MSE: 0.7176 Epoch [14/20] Train Loss: 80977.6885, Test Loss: 216019.7188, NDCG@k: 0.2822, Recall@k: 0.1038, MSE: 0.6795 Epoch [15/20] Train Loss: 78176.8203, Test Loss: 206886.3750, NDCG@k: 0.2947, Recall@k: 0.1049, MSE: 0.6508 Epoch [16/20] Train Loss: 76111.8548, Test Loss: 199785.7031, NDCG@k: 0.3138, Recall@k: 0.1122, MSE: 0.6285 Epoch [17/20] Train Loss: 74581.3831, Test Loss: 194842.3594, NDCG@k: 0.3329, Recall@k: 0.1202, MSE: 0.6129 Epoch [18/20] Train Loss: 73391.6566, Test Loss: 190565.3438, NDCG@k: 0.3520, Recall@k: 0.1294, MSE: 0.5995 Epoch [19/20] Train Loss: 72376.0072, Test Loss: 187072.0469, NDCG@k: 0.3683, Recall@k: 0.1407, MSE: 0.5885 Epoch [20/20] Train Loss: 71430.9642, Test Loss: 183538.0312, NDCG@k: 0.3844, Recall@k: 0.1477, MSE: 0.5773 ``` Epoch마다 출력되는 값을 보면 Train Loss와 test Loss모두 줄어드는 경향성을 볼 수 있고, MSE도 줄어드는 경향성을 볼 수 있다. ## VAE 모델 구현하기 VAE는 encoder-decoder구조를 사용하는 generative model롷 입력 데이터를 압 축한 후 다시 복원하는 과정을 통해 데이터를 생성한다. VAE는 잠재 변수 공간을 학습하여, 데이터의 Hidden feature를 포착하고, 새로운 데이터를 생성한다. ![image](/assets/images/2025-10-16-14-58-53.png) 이미지출처: [https://www.google.com/url?q=https%3A%2F%2Fmedium.com%2Fgeekculture%2Fvariational-autoencoder-vae-9b8ce5475f68](https://www.google.com/url?q=https%3A%2F%2Fmedium.com%2Fgeekculture%2Fvariational-autoencoder-vae-9b8ce5475f68) Gaussian distribution을 따르는 $$N(0,1)$$ 에서 $$\epsilon$$을 sampling한다. train을 통해서 z를 학습시킨다. 만약 z가 gaussian N(0,1)을 따른다고 가정할때 x를 출력시켜보면, 원하는 결과를 얻지 못한다. 왜냐하면 데이터에 따른 z가 학습된것이 아니라 임의의 학률분포를 가정한것이기 때문이다. 이때 p(z)는 N(0,1) gaussian 분포를 따르도록 임의로 initializing하고 z와 KL-divergence가 가까워지도록 학습시킨다. 그러면 z와 p(z)가 KL-divergence가 가깝게 만들어줄 수 있다. 하지만 KL-divergence는 확률분포사이의 거리이기 때문에 z를 그대로 써줄 수 없다. $$KL(q(z\mid x)\mid \mid p(z))$$ 따라서 x가 주어졌을때 z의 확률분포로 식을 바꿔준 후 KL divegence를 계산한다. ```python class VAE(nn.Module): def __init__(self, input_dim, latent_dim, lambda_value=0.001): super(VAE, self).__init__() self.input_dim = input_dim self.latent_dim = latent_dim self.lambda_value = lambda_value # 인코더 정의 self.encoder = nn.Sequential( nn.Linear(input_dim, 512), nn.ReLU(), nn.Linear(512, 256), nn.ReLU(), nn.Linear(256, latent_dim * 2) #mu, logvar을 동시에 출력 ) # 디코더 정의 self.decoder = nn.Sequential( nn.Linear(latent_dim, 256), nn.ReLU(), nn.Linear(256, 512), nn.ReLU(), nn.Linear(512, input_dim), ) #mu, logvar, eps를 이용해서 z를 출력한다. def reparameterize(self, mu, logvar): std = torch.exp(0.5 * logvar) eps = torch.randn_like(std) return mu + eps * std def forward(self, x) encoded = self.encoder(x) #encoded에 있는 mu와 logvar를 리스트 슬라이싱으로 가져온다. mu, logvar = encoded[:,:self.latent_dim], encoded[:,self.latent_dim:] #z를 reparameterize함수를 이용해서 계산한다. z = self.reparameterize(mu, logvar) decoded = self.decoder(z) #decoded된 output과 mu, logvar를 출력한다. return decoded, mu, logvar ``` 1. 인코더: 입력 데이터를 encoding해서 잠재변수의 `mu, logvar` 를 출력한다. 2. `reparameterize()` : mu, logvar를 이용해서 잠재변수 z를 샘플링한다. 3. decoder: 잠재변수 z를 decoding해서 원래 입력 데이터의 복원된 값을 출력한다 ### VAE 손실함수 정의 VAE모델에서 Minimize해야할 목적식은 2개가 있다. $${MSE} =\sum_{i=1}^{N} \mid x_i - \hat{x}_i\mid ^2_2$$ 를 이용해서 입력데이터와 decoder를 거쳐 나온 출력간의 차이를 최소화한다. $${KLD} = -\frac{1}{2} \sum_{i=1}^{D} (1 + \log(\text{var}) - \mu^2 - \exp(\log(\text{var})))$$를 이용해서 잠재변수의 확률분포$N(\mu,\Sigma)$와 표준 Gaussian distribution $p(z)$ 간의 KL-divergence를 최소화 한다. 이를통해 잠재공간을 구조화 해서 Gaussian distribution과 가깝게 만들어주는 정규화를 하는 것이다. $$D_{KL}(q_{\phi}(z\mid x)\mid\mid p(z))$$를 minimize하는것과 같다. ```python # 손실 함수 정의 def loss_function(recon_x, x, mu, logvar): MSE = nn.functional.mse_loss(recon_x,x) ## FILL HERE ## KLD = -0.5*torch.sum(1+logvar - mu**2-torch.exp(logvar)) return MSE + KLD ``` ### VAE 모델학습 ```python # 모델 학습 for epoch in range(num_epochs): running_loss = 0.0 for data in train_loader: inputs = data[0] optimizer.zero_grad() outputs, mu, logvar = model_vae(inputs) loss = loss_function(outputs, inputs, mu, logvar) loss.backward() optimizer.step() running_loss += loss.item() running_loss = running_loss/len(train_loader) with torch.no_grad(): test_batch_data = torch.Tensor(df_test.values) test_recon_batch, test_mu, test_logvar = model_vae(test_batch_data) test_loss = loss_function(test_recon_batch, test_batch_data, test_mu, test_logvar).item() test_recon_batch_prob = torch.sigmoid(test_recon_batch) # NDCG@k와 Recall@k 계산 ndcg = ndcg_score(df_test.values, test_recon_batch_prob, k=20) recall = recall_at_k(test_batch_data, test_recon_batch_prob, k=20) mse = mean_squared_error(df_test.values, test_recon_batch) print('Epoch [{}/{}]'.format(epoch+1, num_epochs)) print('Train Loss: {:.4f}, Test Loss: {:.4f}, NDCG@k: {:.4f}, Recall@k: {:.4f}, MSE: {:.4f}'.format(running_loss, test_loss, ndcg, recall, mse)) ``` Auto Encoder의 학습하는 코드와 비슷하게 구현했다. 다만 loss에서는 outputs, inputs, mu, logvar에 대해 모두 최적화를 해야한다. ``` Epoch [1/20] Train Loss: 2.8034, Test Loss: 1.3945, NDCG@k: 0.3466, Recall@k: 0.1178, MSE: 0.7228 Epoch [2/20] Train Loss: 0.8719, Test Loss: 0.9588, NDCG@k: 0.3995, Recall@k: 0.1380, MSE: 0.7093 Epoch [3/20] Train Loss: 0.7829, Test Loss: 0.8352, NDCG@k: 0.4022, Recall@k: 0.1400, MSE: 0.7053 Epoch [4/20] Train Loss: 0.7496, Test Loss: 0.8070, NDCG@k: 0.4001, Recall@k: 0.1369, MSE: 0.7062 Epoch [5/20] Train Loss: 0.7405, Test Loss: 0.7851, NDCG@k: 0.4004, Recall@k: 0.1374, MSE: 0.7049 Epoch [6/20] Train Loss: 0.7316, Test Loss: 0.7765, NDCG@k: 0.4015, Recall@k: 0.1390, MSE: 0.7060 Epoch [7/20] Train Loss: 0.7310, Test Loss: 0.7667, NDCG@k: 0.4006, Recall@k: 0.1381, MSE: 0.7033 Epoch [8/20] Train Loss: 0.7248, Test Loss: 0.7597, NDCG@k: 0.4048, Recall@k: 0.1407, MSE: 0.7019 Epoch [9/20] Train Loss: 0.7268, Test Loss: 0.7527, NDCG@k: 0.3986, Recall@k: 0.1365, MSE: 0.6977 Epoch [10/20] Train Loss: 0.7226, Test Loss: 0.7582, NDCG@k: 0.4005, Recall@k: 0.1376, MSE: 0.7037 Epoch [11/20] Train Loss: 0.7226, Test Loss: 0.7537, NDCG@k: 0.4009, Recall@k: 0.1381, MSE: 0.7030 Epoch [12/20] Train Loss: 0.7191, Test Loss: 0.7489, NDCG@k: 0.3997, Recall@k: 0.1379, MSE: 0.6990 Epoch [13/20] Train Loss: 0.7209, Test Loss: 0.7479, NDCG@k: 0.4017, Recall@k: 0.1396, MSE: 0.6999 Epoch [14/20] Train Loss: 0.7183, Test Loss: 0.7504, NDCG@k: 0.4010, Recall@k: 0.1389, MSE: 0.7030 Epoch [15/20] Train Loss: 0.7183, Test Loss: 0.7484, NDCG@k: 0.4004, Recall@k: 0.1372, MSE: 0.7026 Epoch [16/20] Train Loss: 0.7199, Test Loss: 0.7481, NDCG@k: 0.4005, Recall@k: 0.1388, MSE: 0.7021 Epoch [17/20] Train Loss: 0.7231, Test Loss: 0.7480, NDCG@k: 0.4003, Recall@k: 0.1386, MSE: 0.7027 Epoch [18/20] Train Loss: 0.7172, Test Loss: 0.7477, NDCG@k: 0.3985, Recall@k: 0.1359, MSE: 0.7027 Epoch [19/20] Train Loss: 0.7166, Test Loss: 0.7458, NDCG@k: 0.3999, Recall@k: 0.1368, MSE: 0.7020 Epoch [20/20] Train Loss: 0.7171, Test Loss: 0.7510, NDCG@k: 0.4024, Recall@k: 0.1391, MSE: 0.7072 ``` Epoch에 따라 loss가 줄어들고 MSE가 감소함을 볼 수 있다. # 결과확인하기 ### 원본 df의 상위 30개 영화/장르 ``` Top 30 Movies for User: 1 1. Jurassic Park (1993) 2. Hudsucker Proxy, The (1994) 3. Lone Star (1996) 4. Kolya (1996) 5. Groundhog Day (1993) 6. Godfather, The (1972) 7. Bound (1996) 8. Back to the Future (1985) 9. Cyrano de Bergerac (1990) 10. Big Night (1996) 11. Dolores Claiborne (1994) 12. Young Frankenstein (1974) 13. Three Colors: Blue (1993) 14. Three Colors: Red (1994) 15. Priest (1994) 16. Chasing Amy (1997) 17. Alien (1979) 18. Star Wars (1977) 19. Hoop Dreams (1994) 20. Mars Attacks! (1996) 21. Eat Drink Man Woman (1994) 22. Shawshank Redemption, The (1994) 23. Mystery Science Theater 3000: The Movie (1996) 24. Kids in the Hall: Brain Candy (1996) 25. Truth About Cats & Dogs, The (1996) 26. Terminator, The (1984) 27. Horseman on the Roof, The (Hussard sur le toit, Le) (1995) 28. Wallace & Gromit: The Best of Aardman Animation (1996) 29. Haunted World of Edward D. Wood Jr., The (1995) 30. Dead Poets Society (1989) Genre Counts: Drama: 14 Comedy: 10 Action: 7 Sci-Fi: 7 Romance: 7 Thriller: 4 Adventure: 2 Crime: 2 Horror: 2 War: 2 Documentary: 2 Mystery: 1 Animation: 1 ``` ### AutoRec 모델을 통한 상위 30개 영화/장르 ``` Top 30 Movies for User: 1 1. Forrest Gump (1994) 2. Scream (1996) 3. Apollo 13 (1995) 4. Groundhog Day (1993) 5. Leaving Las Vegas (1995) 6. Jurassic Park (1993) 7. Wizard of Oz, The (1939) 8. Jerry Maguire (1996) 9. 2001: A Space Odyssey (1968) 10. Fugitive, The (1993) 11. Fargo (1996) 12. One Flew Over the Cuckoo's Nest (1975) 13. Godfather, The (1972) 14. Titanic (1997) 15. Mission: Impossible (1996) 16. Return of the Jedi (1983) 17. Full Monty, The (1997) 18. Star Trek: First Contact (1996) 19. Aliens (1986) 20. When Harry Met Sally... (1989) 21. Birdcage, The (1996) 22. Contact (1997) 23. Rear Window (1954) 24. Monty Python and the Holy Grail (1974) 25. Dead Man Walking (1995) 26. Back to the Future (1985) 27. Die Hard (1988) 28. Independence Day (ID4) (1996) 29. GoodFellas (1990) 30. To Kill a Mockingbird (1962) Genre Counts: Drama: 13 Action: 11 Thriller: 8 Sci-Fi: 8 Comedy: 7 Romance: 7 Adventure: 5 War: 4 Mystery: 3 Crime: 3 Horror: 1 Children: 1 Musical: 1 ``` ### VAE모델을 통한 상위 30개 영화/장르 ``` Top 30 Movies for User: 1 1. Star Wars (1977) 2. Fargo (1996) 3. Return of the Jedi (1983) 4. Contact (1997) 5. Raiders of the Lost Ark (1981) 6. English Patient, The (1996) 7. Toy Story (1995) 8. Godfather, The (1972) 9. Scream (1996) 10. Silence of the Lambs, The (1991) 11. Air Force One (1997) 12. Pulp Fiction (1994) 13. Liar Liar (1997) 14. Titanic (1997) 15. Empire Strikes Back, The (1980) 16. Twelve Monkeys (1995) 17. Independence Day (ID4) (1996) 18. Rock, The (1996) 19. Princess Bride, The (1987) 20. Jerry Maguire (1996) 21. Back to the Future (1985) 22. Schindler's List (1993) 23. Fugitive, The (1993) 24. Star Trek: First Contact (1996) 25. Indiana Jones and the Last Crusade (1989) 26. L.A. Confidential (1997) 27. Monty Python and the Holy Grail (1974) 28. Braveheart (1995) 29. Shawshank Redemption, The (1994) 30. Forrest Gump (1994) Genre Counts: Action: 14 Drama: 13 Adventure: 8 Romance: 8 Sci-Fi: 8 War: 8 Thriller: 7 Comedy: 6 Crime: 4 Animation: 1 Children: 1 Horror: 1 Film-Noir: 1 Mystery: 1 ``` ### [CV][논문 리뷰]: Deep Inside Convolutional Networks: Visualising Image Classification Models and Saliency Maps - Canonical URL: https://hyejunl33.github.io/study/2025-10-10-[CV]Deep-Inside-Convolutional-Networks/ - Collection: Study - Published: 2025-10-10 - Tags: none ## 논문 리뷰: Deep Inside Convolutional Networks: Visualising Image Classification Models and Saliency Maps ### 서론 (Introduction) 이 논문은 심층 합성곱 신경망(ConvNets)을 사용하여 학습된 이미지 분류 모델의 시각화를 다룬다. 두 가지 시각화 기법을 고려하는데, 둘 다 입력 이미지에 대한 클래스 점수의 그래디언트(gradient)를 계산하는 것에 기반한다.  첫 번째 기법은 클래스 점수$$S_c$$를 최대화하는 이미지를 생성하여 ConvNet에 의해 포착된 클래스의 개념을 시각화하는 것이다.  두 번째 기법은 특정 이미지와 클래스에 대한 클래스 saliency 맵을 계산하는 것이다. 논문은 이러한 맵이 약지도 학습(weakly supervised) 방식의 객체 분할에 사용될 수 있음을 보여준다.  마지막으로, 그래디언트 기반 ConvNet 시각화 방법과 deconvolutional networks  사이의 연관성을 확립한다. 논문은 다음과 같은 세 가지 기여를 한다. 1. 입력 이미지의 $$argmaxS_c(I)$$를 사용하여 ConvNet 분류 모델의 이해 가능한 시각화를 얻을 수 있음을 보여준다. 이 방법은 weakly supervised learning이고, classification task에서 어떤 뉴런을 최대화해야 하는지 알고 있다는 점에서 비지도 학습 사례와 차이가 있다. 2. 주어진 이미지에서 특정 클래스의 spatial support, 즉 이미지별 클래스 saliency 맵을 single Back-propagation으로 계산하는 방법을 제안한다. 3. 그래디언트 기반 시각화 방법이 DeconvNet을 일반화한다는 것을 보여준다. ### 2.Class Model Visualisation 이 기법은 학습된 분류 ConvNet과 관심 클래스가 주어졌을 때, 해당 클래스를 대표하는 이미지를 수치적으로 생성하는 것으로 구성된다. 공식적으로, ConvNet의 분류 계층에 의해 계산된 클래스 c의 점수를 $$S_c(I)$$라고 할 때, $$S_c$$점수가 높은 L2-ragulated 이미지를 찾고자 한다. 최적화 문제는 다음과 같다. $$\arg\max_I S_c(I) - \lambda\|I\|_2^2$$ 여기서 $$\lambda$$는 regularisation 파라미터이다. 국소적으로 최적인 이미지 I는 역전파 방법을 통해 찾을 수 있다. 이 과정에서 Weight는 Train 단계에서 찾은 값으로 고정시키고, 최적화는 입력 이미지에 대해 수행된다. → 일반적인 Backpropagation과정과는 다르다. 최적화는 zero image로 초기화되었고, 결과에 훈련 세트 평균 이미지를 더했다. 소프트맥스 계층이 반환하는 클래스 사후 확률$$P_c$$대신 정규화되지 않은 클래스 점수$$S_c$$를 사용했는데, 그 이유는 클래스 사후 확률의 최대화는 다른 클래스의 점수를 최소화함으로써 달성될 수 있기 때문이다. 따라서 최적화가 해당 클래스 c에만 집중하도록 $$S_c$$를 최적화했다. $$P_c$$를 최적화하는 실험도 진행했으나 결과가 시각적으로 두드러지지 않았다. 따라서 직관적이게 $$S_c$$를 직접 maximize하는 최적화 문제를 푼다. --- ![image](/assets/images/2025-10-10-18-54-23.png) BackPropagation을 통해 Image를 Gradient Ascent로 생성한 결과, 모델이 해당 Class에 대해 보고있는 개념을 시각화 할 수 있다. --- ### 3. Image-Specific Class Saliency Visualisation 이미지가 특정 class에 대해 spatial support하는 classification ConvNet은. 이미지 $$I_0$$와 클래스 c가 주어졌을 때, $$I_0$$의 픽셀들을 $$S_c(I_0$$) 점수에 미치는 영향에 따라 순위를 매기는 것이 목표이다. ConvNet에서 클래스 점수 $$S_c(I)$$는 I에 대한 복잡한 비선형 함수이다. 단순한 선형변환으로 Score를 구할 수는 없다고 한다. 따라서 주어진 이미지 $$I_0$$의 이웃에서 $$S_c(I$$)를 1차 테일러 expension을 통해 선형 함수로 근사할 수 있다. $$S_c(I) \approx w^T I + b$$ 여기서 $$w$$는 점 $$I_0$$에서 이미지 I에 대한 $$S_c$$의 도함수(derivative)이다. $$w = \frac{\partial S_c}{\partial I}\bigg|_{I_0}$$  이 식을 통해 Gradient가 큰 픽셀일 수록 중요도가 높다고 해석할 수 있고 이를 시각화하면 Saliency map으로 추출할 수 있다. ### 3.1 클래스 Saliency 추출 (Class Saliency Extraction) 주어진 이미지 $$I_0$$와 클래스 c에 대해, 클래스 saliency 맵 $$M \in \mathbb{R}^{m \times n}$$은 다음과 같이 계산된다. 1. Gradient w를 역전파를 통해 찾는다. 2. w 벡터의 원소들을 재배열하여 saliency 맵을 얻는다. 3. 그레이스케일 이미지의 경우, 맵은 $$M\_{ij} = \mid w\_{h(i,j)}\mid $$로 계산된다. 4. 다중 채널(예: RGB) 이미지의 경우, 각 픽셀 (i, j)에 대해 모든 색상 채널에 걸쳐 w의 최대 크기를 취한다: $$M\_{ij} = \max\_c\mid w\_{h(i,j,c)}\mid $$ 이 saliency 맵은 이미지 레이블에 대해 훈련된 분류 ConvNet을 사용하여 추출되므로, Bounding Box나 Mask와 같은 추가적인 Supervising이 필요하지 않다. 계산은 단일 역전파 통과만 필요하므로 매우 빠르다. --- ![image](/assets/images/2025-10-10-18-54-34.png) --- ### 3.2 Weakly Supervised Object Localisation 클래스 saliency 맵은 주어진 이미지에서 해당 클래스 객체의 위치를 인코딩하므로 객체 탐지에 사용될 수 있다. 하지만 이렇게 얻어낸 saliency map은 객체탐지의 결정적인 부분만 강조하고(예를들어 강아지의 얼굴) 객체 전체를 보여주지 않을 수 있다. 따라서 상위 95%의 quantile보다 높은 픽셀에서 foreground를 추출하고, 하위 30%에서 backgrond를 추출해서 GraphCut알고리즘을 돌려서 최종 mask를 생성해서 전체 객체를 나타낸다. 아래 사진속 3번째 사진에서 파란색은 Foreground, 빨간색은 BackGround이고 마지막 4번재 사진은 GraphCut알고리즘을 돌려서 객체탐지를 마친 사진이다. 객체 전체의 모습을 잘 탐지함을 볼 수 있다. --- ![image](/assets/images/2025-10-10-18-54-42.png) --- 이 방법은 ILSVRC-2013 탐지 챌린지에 제출되었고, top-5 예측 클래스 각각에 대해 절차를 반복했다. 이 방법은 테스트 세트에서 46.4%의 top-5 오류를 달성했다. 이 방법은 약지도 학습 방식이며, 훈련 중에 객체 탐지 작업이 고려되지 않았음에도 불구하고, 동일한 데이터셋을 사용한 ILSVRC-2012 챌린지 제출물(50.0% 탐지 오류)보다 성능이 뛰어났다. ### 4. Relation to Deconvolutional Networks 이 섹션은 그래디언트 기반 시각화와 DeconvNet 아키텍처 사이의 연관성을 확립한다. n번째 계층 입력 $$X_n$$의 DeconvNet 기반 재구성은 시각화된 뉴런 활동 f의 $$X_n$$에 대한 그래디언트를 계산하는 것과 동등하거나 유사하다. - **Convolutional 계층 ($$X_{n+1} = X_n * K_n$$)**: 그래디언트는 $$\partial f/\partial X_n = \partial f/\partial X_{n+1} * \tilde{K}_n$$으로 계산되며, 여기서 $$\tilde{K}n$$*은 뒤집힌 커널이다. 이는 DeconvNet에서의 n번째 계층 재구성 $$R_n = R{n+1} * \tilde{K}_n$$*과 정확히 일치한다. - **RELU 계층 ($$X_{n+1} = \max(X_n, 0$$))**: 부경사도(sub-gradient)는 $$\partial f/\partial X_n = \partial f/\partial X_{n+1} \cdot \mathbf{1}(X_n > 0$$) 형태를 취하며, 여기서 $$\mathbf{1}$$은 원소별 지시 함수이다. 이는 DeconvNet RELU 재구성 $$R_n = R_{n+1} \cdot \mathbf{1}(R_{n+1} > 0)$$과 약간 다르다. 부호 지시자가 계층 입력 $$X_n$$대신 출력 재구성 $$R_{n+1}$$에 대해 계산된다. - **MaxPooling 계층**: 부경사도는 $$\partial f/\partial X_n(s) = \partial f/\partial X_{n+1}(p) \cdot \mathbf{1}(s = \arg\max_{q \in \Omega(p)} X_n(q))$$로 계산된다. 여기서 $$\arg\max$$는 DeconvNet의 "스위치"에 해당한다. 결론적으로 RELU 계층을 제외하고, DeconvNet을 사용한 근사적 특징 맵 재구성 $$R_n$$은 역전파를 사용한 Gra dient $$\partial f/\partial X_n$$계산과 동등하다. 따라서 그래디언트 기반 시각화는 DeconvNet의 일반화로 볼 수 있으며, 그래디언트 기반 기법은 Conv layer뿐만 아니라 모든 layer의 Activation Visualization에 적용될 수 있다. ### 5. 결론 (Conclusion)  이 논문에서는 Deep Classification ConvNet을 위한 두 가지 시각화 기법을 제시했다. 첫 번째는 Class of Interest를 대표하는 인공적인 이미지를 생성하는 것이다. 이를 통해 모델이 해당 클래스에 대해 이해하고있는 개념을 Visualization할 수 있었다.  두 번째는 주어진 이미지에 대해 특정 클래스에 구별되는 영역을 강조하는 Image-spacific saliency 맵을 계산하는 것이다. 이러한 saliency 맵은 dedicated segmentation이나 detection model을 훈련할 필요 없이 GraphCut 기반 객체 분할을 초기화하는 데 사용될 수 있음을 보였다.  마지막으로, 그래디언트 기반 시각화 기법이 DeconvNet 재구성 절차를 일반화함을 입증했다. ### [NLP][미션]NLP:텍스트 전처리, RNN,LSTM 구현 - Canonical URL: https://hyejunl33.github.io/study/2025-10-10-[NLP]NLP-Text-preprocessing,RNN,LSTM/ - Collection: Study - Published: 2025-10-10 - Tags: 위클리 미션, 텍스트 전처리, Xavier초기화, RNN, LSTM 구현 # [NLP][미션]NLP:텍스트 전처리, RNN,LSTM 구현 - Text PreProcessing, Embedding 구현 - RNN cell을 구현하고, RNN 모델을 구현 - LSTM cell을 구현하고, LSTM 모델구현 # Text Preprocessing and Tokenization - 주어진 텍스트를 word단위로 구분해서 token으로 preprocessing을 해보자 ```python def simple_tokenize(text): #1. 텍스트를 소문자로 변환하기 text = text.lower() #2. ..!?;,는 하나의 토큰으로 구분하기 위해 앞뒤로 공백추가하기 for char in ['.','!','?',';',',']: text = text.replace(char, ' ' + char + ' ') # 공백을 기준으로 리스트로 token화하기 tokens = text.split() return tokens ``` - 텍스트로부터 어휘사전을 구축하는 클래스를 구현하자 ```python class Vocabulary: def __init__(self): # padding과 unknown은 0과 1로 먼저 초기화를 해준다. self.word2idx = {'': 0, '': 1} self.idx2word = {0: '', 1: ''} #처음에 초기화를 해주고 나면 초기 vocab_size는 2이다, self.vocab_size = 2 def build_vocab(self, texts): # 단어 빈도 계산 word_counts = {} for text in texts: tokens = simple_tokenize(text) # token을 불러와서 dict에서 token의 빈도를 count한다. for token in tokens: if token in word_counts: word_counts[token] += 1 else: word_counts[token] = 1 # word2idx, isx2word update # vocab_size를 idx로 token을 encoding하는 dict를 만든다. for token in word_counts.keys(): if token not in self.word2idx: self.word2idx[token] = self.vocab_size self.idx2word[self.vocab_size] = token self.vocab_size += 1 def encode(self, text): tokens = simple_tokenize(text) # 토큰을 인덱스로 변환 (없는 단어는 사용) indices = [] for token in tokens: # token에 대응하는 idx로 encoding한다. if token in self.word2idx.keys(): indices.append(self.word2idx[token]) else: indices.append(self.word2idx['']) return indices def decode(self, indices): # 인덱스를 단어로 변환 words = [] for idx in indices: #idx 에 맞는 token으로 decoding한다. words.append(self.idx2word[idx]) return words ``` - 단어 인덱스를 고정 크기 벡터로 변환하는 embedding table을 구현 → 임베딩 벡터의 차원은 정해져있고, 그보다 길이가 짧다면 padding을 해주어서 길이를 똑같이 맞춰준다. ```python class WordEmbedding(nn.Module): def __init__(self, vocab_size, embed_dim, padding_idx=0): super(WordEmbedding, self).__init__() self.vocab_size = vocab_size self.embed_dim = embed_dim self.padding_idx = padding_idx # 임베딩 테이블 생성 (vocab_size x embed_dim) # 이떄 nn.Parameter메서드를 써서 parameter로 vocab_size와 embed_dim을 초기화해준다. #xavier초기화로 임베딩 테이블 생성 self.embedding_table = nn.Parameter(torch.empty(vocab_size, embed_dim)) nn.init.xavier_uniform_(self.embedding_table) # 가중치 초기화 (평균 0, 표준편차 0.1) nn.init.normal_(self.embedding_table, mean=0.0, std=0.1) # 패딩 토큰을 영벡터로 설정 self._reset_padding() def _reset_padding(self): if self.padding_idx is not None: with torch.no_grad(): # padding_idx가 존재할때 embedding_table에서 해당 idx를 0으로 패딩시킨다. self.embedding_table[self.padding_idx] = 0 def forward(self, indices): # indices텐서를 받아서, 임베딩 벡터들의 텐서로 embedding함 embeddings = self.embedding_table[indices] return embeddings ``` # RNN cell 구현 - RNN cell의 forward 연산을 구현하자. $$h_t = \text{tanh}(h_{prev} \cdot W_{hh} + x_t \cdot W_{xh} + b_h)$$ - x_t: 현재 시점 입력 `(batch_size, input_size)` - h_prev: 이전 시점 은닉상태 `(batch_size, hidden_size)` - W_hh: 은닉-은닉 가중치 `(hidden_size, hidden_size)` - W_xh: 입력-은닉 가중치 `(input_size, hidden_size)` - b_h: 편향 `(hidden_size,)` - h_t: 현재시점 은닉상태 (`batch_size, hidden_size`) ```python def rnn_cell(x_t, h_prev, W_hh, W_xh, b_h): h_t = torch.tanh(h_prev @ W_hh + x_t @ W_xh + b_h) return h_t ``` 텐서내적연산은 @로 구현, 여기서는 텐서끼리 연산할때, Weight에 Transpose를 해주지 않아도, 내적차원이 맞추어져 있으므로, forward 수식 그대로 연산을 진행한다. - RNN cell을 이용해서 전체 시퀀스를 처리하는 RNN 클래스를 구현해보자. ```python class SimpleRNN(nn.Module): def __init__(self, input_size, hidden_size): super(SimpleRNN, self).__init__() self.hidden_size = hidden_size self.input_size = input_size # 학습가능한 파라미터로 Weight와 bias를 randn초기화로 진행한다. self.W_hh = nn.Parameter(torch.randn(hidden_size, hidden_size)) self.W_xh = nn.Parameter(torch.randn(input_size, hidden_size)) self.b_h = nn.Parameter(torch.randn(hidden_size)) # 가중치 초기화 self._init_weights() def _init_weights(self): # Xavier초기화 코드로 구현 std = 1.0 / (self.hidden_size) ** 0.5 for weight in self.parameters(): weight.data.uniform_(-std, std) def forward(self, x, hidden=None): batch_size, seq_len, input_size = x.size() # 초기 은닉상태에서 None일때는 0벡터로 초기화한다. if hidden is None: # hidden을 0벡터로 초기화 hidden = torch.zeros(batch_size, self.hidden_size) outputs = [] # 시퀀스 각 시점에 대해 RNN 셀 적용 for t in range(seq_len): # 1. x_t는 t시점에서의 x이므로 seq_len의 t번째 값만을 가져온다. x_t = x[:, t, :] # rnn_cell함수를 이용해서 t에서의 hidden vector 구하기 h_t = rnn_cell(x_t, hidden, self.W_hh, self.W_xh, self.b_h) # output list에 h_t를 append하기 #이때 아래서 dim=1을 기준으로 cat해야하므로 unsqueeze를 이용해서 dim=1을 추가해준다. outputs.append(h_t.unsqueeze(1)) # 각 sequence step에서의 hidden update hidden = h_t # 모든 시점의 출력을 하나의 텐서로 결합 outputs = torch.cat(outputs, dim=1) return outputs, hidden ``` - bi-directional RNN을 구현해서 시퀀스를 앞뒤로 모두 처리해보자. - bi_output`:(batch_size, seq_len, hidden_size*2)` - output size를 맞추려면 forward, backward로 RNN을 돌린 후 `hidden_size` dimension으로 concat을 해주면 된다. ```python class BiRNN(nn.Module): def __init__(self, input_size, hidden_size): super(BiRNN, self).__init__() self.hidden_size = hidden_size # 순방향과 역방향 RNN -> SimpleRNN의 인스턴스로 생성 self.forward_rnn = SimpleRNN(input_size, hidden_size) self.backward_rnn = SimpleRNN(input_size, hidden_size) def forward(self, x, hidden=None): batch_size, seq_len, input_size = x.size() # 순방향 RNN forward_out, forward_hidden = self.forward_rnn(x, hidden) # 시퀀스 뒤집기 -> torch.flip()함수 이용 x_reverse = torch.flip(x,dims=[1]) backward_out, backward_hidden = self.backward_rnn(x_reverse, hidden) # 출력도 다시 뒤집기 -> forward와 concat하기 위해 시간순서 다시 맞춰주기 backward_out = torch.flip(backward_out, dims = [1]) # 순방향과 역방향 출력 연결 bi_output = torch.cat((forward_out,backward_out),dim=2) return bi_output, (forward_hidden, backward_hidden) ``` `x_reverse = torch.flip(x,dims=[1])` : `torch.flip()`은 인자로 들어온 텐서를 dims를 기준으로 뒤집는 함수이다. 이때 x텐서는 `batch_size, seq_len, hidden_size` 를 순서대로 가지므로, `seq_len` 를 뒤집어야 문장을 역방향으로 학습할 수 있다. 따라서 `dims=[1]` 을 인자로 줘서 역방향으로 학습하도록 한다. `forward_out`과 `backward_out` 을 concat할때는 `bi_output` 이 `hidden_size*2` 를 가져야 하므로 `dim=2` 를 인자로주어 concat을 해야 한다. # LSTM 게이트 구현 ![image](/assets/images/2025-10-10-14-03-04.png) - `lstm_cell_forward()` 함수를 구현해서 LSTM셀의 한스텝 연산을 수행하는 함수를 구현하자. ```python def lstm_cell(x_t, h_prev, c_prev, W_f, W_i, W_g, W_o, b_f, b_i, b_g, b_o): # [h_{t-1},x_t]를 구현하기 위해 concat을 해준다. combined = torch.cat((h_prev,x_t),dim=1) # 각 게이트 수식을 코드로 구현 f_t = torch.sigmoid(combined@W_f + b_f) i_t = torch.sigmoid(combined@W_i + b_i) g_t = torch.tanh(combined@W_g+ b_g) o_t = torch.sigmoid(combined@W_o + b_o) # 셀 상태와 은닉 상태 업데이트 c_t = f_t*c_prev + i_t *g_t h_t = o_t * torch.tanh(c_t) return h_t, c_ ``` - `x_t` (torch.Tensor): 현재 시점의 입력 `(batch_size, input_size)` - `h_prev` (torch.Tensor): 이전 시점의 은닉 상태 `(batch_size, hidden_size)` - `c_prev` (torch.Tensor): 이전 시점의 셀 상태 `(batch_size, hidden_size)` - `W_*, b_*` (torch.Tensor): 각 게이트(forget, input, gate, output)의 가중치와 편향 각 게이트의 수식에 맞게 코드로 구현해주었다. 이때 셀상태와 은닉상태를 업데이트 할때 elementwise multiplication은 *으로 수행해준다. 내적은 @ 연산자로 수행해준다. - 앞에서 구현한 LSTM cell을 사용해서 SimpleLSTM 클래스를 구현해보자 ```python class SimpleLSTM(nn.Module): def __init__(self, input_size, hidden_size, forget_bias=1): super(SimpleLSTM, self).__init__() self.hidden_size = hidden_size self.input_size = input_size # 모든 Weight를 학습가능한 파라미터로 설정해준다. self.W_f = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size)) self.W_i = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size)) self.W_o = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size)) self.W_g = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size)) # 편향도 마찬가지로 학습가능한 파라미터로 설정해준다. self.b_f = nn.Parameter(torch.ones(hidden_size) * forget_bias) self.b_i = nn.Parameter(torch.zeros(hidden_size)) self.b_o = nn.Parameter(torch.zeros(hidden_size)) self.b_g = nn.Parameter(torch.zeros(hidden_size)) self._init_weights() def _init_weights(self): #Weight를 xavier초기화 해주는 헬퍼함수 std = 1.0 / np.sqrt(self.hidden_size) for weight in [self.W_f, self.W_i, self.W_o, self.W_g]: weight.data.uniform_(-std, std) def forward(self, x, hidden=None): batch_size, seq_len, input_size = x.size() # hidden이 None일때 0벡터로 초기화해준다. if hidden == None: h_0 = torch.zeros(batch_size, self.hidden_size) c_0 = torch.zeros(batch_size, self.hidden_size) else: #hidden이 존재할때는 hidden을 h_0,c_0으로 사용한다. h_0, c_0 = hidden outputs = [] h_t, c_t = h_0, c_0 for t in range(seq_len): x_t = x[:,t,:] #lstm_cell 함수 이용해서 step진행 h_t, c_t = lstm_cell(x_t, h_t, c_t, self.W_f, self.W_i, self.W_g, self.W_o, self.b_f, self.b_i, self.b_g, self.b_o) outputs.append(h_t.unsqueeze(1)) outputs = torch.cat(outputs, dim=1) return outputs, (h_t, c_t) ``` - LSTM의 장기기억능력 분석 및 성능개선 ```python import torch.optim as optim import numpy as np import matplotlib.pyplot as plt def train_and_evaluate(forget_bias, seq_len=20, vocab_size=5, hidden_size=128, epochs=200, batch_size=64): model = LSTMClassifier(vocab_size, hidden_size, forget_bias) optimizer = optim.Adam(model.parameters(), lr=0.01, weight_decay=1e-5) # 학습률 증가 criterion = nn.CrossEntropyLoss() # Learning rate scheduler 추가 scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5) losses = [] accuracies = [] for epoch in range(epochs): # 훈련 데이터 생성 x_train, y_train = generate_first_token_copy_data(batch_size, seq_len, vocab_size) # 훈련 model.train() optimizer.zero_grad() pred = model(x_train) loss = criterion(pred,y_train) loss.backward() # Gradient clipping 추가 torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0) optimizer.step() scheduler.step() # 학습률 스케줄링 losses.append(loss.item()) # 평가 (매 5 에포크마다) if epoch % 5 == 0: model.eval() with torch.no_grad(): x_test, y_test = generate_first_token_copy_data(200, seq_len, vocab_size) # 더 많은 테스트 데이터 test_outputs = model(x_test) predictions = torch.argmax(test_outputs, dim=1) accuracy = (predictions == y_test).float().mean().item() accuracies.append(accuracy) print(f"Forget Bias {forget_bias} - Epoch {epoch}: Loss={loss.item():.4f}, Acc={accuracy:.4f}") return losses, accuracies ``` ![image](/assets/images/2025-10-10-14-03-20.png) forget gate의 값이 1로 시작하면, 초기의 과거 정보를 기억하는 상태에서 학습을 시작하므로 초기의 정보를 잘 forget하지 않고, 정보소실없이, 안정적으로 학습이 일어난다. 하지만 forget_bias값이 0으로 시작하면, sigmoid 함수를 거쳤을때 0.5에 초기출력값이 가까워지고, 이는 과거 정보의 절반을 처음부터 버리고 시작하는것과 같아서, Gradient Vanishing문제가 발생한다. ### [AI_Math][2주차_기본과제_2] einsum기본문제 - Canonical URL: https://hyejunl33.github.io/study/2025-10-08-[AI_Math]-einsum-operation/ - Collection: Study - Published: 2025-10-08 - Tags: einsum기본문제, 2주차 과제, AI_Math, 과제 # [AI_Math]기본2_einsum기본문제 einsum을 활용하여 행렬 및 텐서 연산을 NumPy코드로 구현하기 ## 행렬 XY의 trace값 계산하기 ```python import numpy as np def get_answer1(number_matrix1, number_matrix3): # einsum으로 두 행렬의 곱을 연산 mid1 = np.einsum('ik, kj -> ij',number_matrix1, number_matrix2) # einsum으로 trace연산 answer1 = np.einsum('ii -> ', mid1) return answer1 ``` `np.einsum(’ik, kj → ij’,matrix1,matrix2)` :matrix1과 matrix2에서 k개의 열과 k개의 행을 내적한다. `np.einsum(’ii→ ’,mid1)` : mid1에서 trace연산을 한다(ii인덱스를 갖는 벡터를 모두 더한다) ## 텐서 X, Y의 3차원 텐서곱에 대해 첫 번째 축을 따라 합계 계산하기 ```python import numpy as np def get_answer2(number_tensor1, number_tensor2): # einsum으로 3차원 텐서곱을 진행하기 mid2 = np.einsum('ijk, ikl -> ijl',number_tensor1, number_tensor2) # 첫번째 축을 없애고, 나머지를 더해서 합을 계산 answer2 = np.einsum('ijl -> jl',mid2) return answer2 ``` mid2는 예시에 맞춰서 차원을 einsum의 인자로 넘겨주었다. → 따로 transpose해서 곱하지 않아도, einsum연산에서는 알아서 인자의 차원을 맞춰서 곱해줌 ``` number_tensor1 (array): integer 값으로만 구성된 array shape:(2,3,2) ex - [[[1, -3], [-2, 3], [ 3, 4]], [[1, -4], [ 2, 1], [-4, 4]]] number_tensor2 (array): integer 값으로만 구성된 array shape:(2,2,3) ex - [[[-3, -3, -2], [-3, 3, -3]], [[-1, -2, -1], [-3, -3, -1]] ``` ## 텐서 X, Y의 4차원 텐서곱에 대해 2차원으로 reshape한 후에, 주어진 행렬을 곱한 최종 행렬의 대각성분 합계 계산하기 einsum과 einops를 사용해서 구현하자 ```python import numpy as np import einops def get_answer3(number_tensor1, number_tensor2, number_matrix3): # 예시에 맞게 3차원 텐서끼리 곱해서 4차원 텐서곱 만들기 mid3_1 =np.einsum('b l n, j n k -> b l j k',number_tensor1, number_tensor2) # einops의 rearrange를 이용해서 4차원 행렬은 2차으로 reshape하기 mid3_2 = einops.rearrange(mid3_1, 'b m n k -> (b m) (n k)') # einsum을 이용해서 인자로 받은 행렬을 곱하기 mid3_3 = np.einsum('ij, jk -> ik',mid3_2, number_matrix3) # einsum을 이용해서 trace연산 하기 answer3 = np.einsum('ii -> ',mid3_3) return answer ``` ``` 주어진 두 텐서의 4차원 텐서곱을 2차원으로 reshape한 행렬의 대각성분의 합을 반환함 Parameters: number_tensor1 (array): integer 값으로만 구성된 array ex - [[[1, -3], [-2, 3], [ 3, 4]], [[1, -4], [ 2, 1], [-4, 4]]] number_tensor2 (array): integer 값으로만 구성된 array ex - [[[-3, -3, -2], [-3, 3, -3]], [[-1, -2, -1], [-3, -3, -1]]] number_matrix3 (array): integer 값으로만 구성된 array es - [[-4, 2, -2, -3, -4, -1], [-4, 2, -4, 4, -4, 4], [-4, 2, -3, 3, 2, 4], [-1, -4, 3, 0, 0, 1], [-2, -1, -1, -3, 2, -2], [ 0, 2, 4, 3, 0, -1]] Returns: answer3 (number): 주어진 연산을 마친 결과 Examples: >>> number_tensor1 = [[[1, -3], [-2, 3], [ 3, 4]], [[1, -4], [ 2, 1], [-4, 4]]] >>> number_tensor2 = [[[-3, -3, -2], [-3, 3, -3]], [[-1, -2, -1], [-3, -3, -1]]] >>> number_matrix3 = [[-4, 2, -2, -3, -4, -1], [-4, 2, -4, 4, -4, 4], [-4, 2, -3, 3, 2, 4], [-1, -4, 3, 0, 0, 1], [-2, -1, -1, -3, 2, -2], [ 0, 2, 4, 3, 0, -1]] >>> import basic_math as bm >>> bm.get_answer3(number_tensor1, number_tensor2, number_array3) ``` ### [AI_Math][2주차_기본과제_1] 행렬기본문제 - Canonical URL: https://hyejunl33.github.io/study/2025-10-08-[AI_Math]-matrix-operation/ - Collection: Study - Published: 2025-10-08 - Tags: 행렬기본문제, 2주차 과제, AI_Math, 과제 # [AI_Math]기본1_행렬기본문제 행렬연산을 구현하는 함수를 numpy로 구현하면서 함수에 대한 감각을 익히기 - `get_transpose`: 주어진 행렬의 전치행렬을 반환함 - `get_inverse`: 주어진 행렬의 역행렬을 반환함 - `get_eigenval_eigenvec` : 주어진 (정방) 행렬의 고유값과 고유벡터를 구함 ```python import numpy as np def get_transpose(number_matrix): # Matrix를 Transpose하고싶으면 T 속성(attrubute)를 쓰면됨 transposed_matrix = number_matrix.T return transposed_matrix def get_inverse(number_matrix): # 역행렬이 존재할때는 np.linalg.inv(matrix)함수를 쓰면 됨 # 존재하지 않을때는 np.linalg.pinv(matrix)를 쓰면됨 # pinv는 SVD분해를 사용해서 rank(matrix)와 관계없이 사용가능 inverse_matrix = np.linalg.pinv(number_matrix) return inverse_matrix def get_eigenval_eigenvec(number_matrix): # eigenvalue, eigenvector는 np.linalg.eig(matrix)로 반환가능 # 둘중 하나만 받고싶으면 나머지 인자는 _로 버리기 eigenvalue, eigenvector = np.linalg.eig(number_matrix) return eigenvalue, eigenvector ``` numpy에서 `transpose` ,`linalg.inv()` , `linalg.eig()` 를 통해서 matrix에서 전치행렬을 반환할 수 있고, 역행렬을 구할 수 있고, 고유값, 고유벡터를 구할 수 있음. - `get_matmul()` : 주어진 두 행렬의 행렬곱 반환 ValueError가 발생하지 않기 위해서 행렬곱 연산이 가능하려면 앞 행렬의 열의 수와 뒤 행렬의 행의 수가 같아야 한다. (예시: `ij jk → ik` ) ```python import numpy as np def get_matmul(number_matrix1, number_matrix2): # 출력으로 쓸 multiplicated_matrix를 출력 size에 맞게 0으로 채우기 multiplicated_matrix = np.zeros((len(number_matrix1),len(number_matrix2[0]))) # 삼중for문으로 돌면서 출력matrix안에 원소들을 곱한 값을 채워넣기 for i in range(len(number_matrix1)): for j in range(len(number_matrix2[0])): for k in range(len(number_matrix1[0])): multiplicated_matrix[i][j] += number_matrix1[i][k]*number_matrix2[k][j] # 행렬곱 연산 원리에 의해 앞행렬의 열과 뒷 행렬의 행은 k로 같아야 한다. return multiplicated_matrix ``` ### [AI_Math][2주차_기본과제_3]확률론_기본문제 - Canonical URL: https://hyejunl33.github.io/study/2025-10-08-[AI_Math]probability/ - Collection: Study - Published: 2025-10-08 - Tags: 기본3_확률론_기본문제, 2주차 과제, AI_Math, 과제 # [AI_Math]기본3_확률론_기본문제 - 베이즈정리의 원리를 이해하고, 조건부 확룰이 어떻게 새로운 정보를 통합하여 사후 확률을 업데이트하는지 이해하고, 코드를 통해 구현 - 몬테카를로 샘플링을 통해 불확실성 하에서 최적의 결정을 내리는 방법을 코드를 통해 구현 $$P(\theta|D) = P(\theta)\frac{P(D|\theta)}{P(D)}$$ ## Gemini가 설명하는 사전확률, 가능도, 사후확률, evidence. 사전 확률 (Prior Probability) - **의미:** **사건이 일어나기 전(데이터를 관찰하기 전)에** 우리가 이미 가지고 있는 어떤 사건에 대한 **믿음 또는 확률**입니다. - **설명:** 이것은 개인적인 믿음, 과거의 통계, 또는 아무런 정보가 없다면 균등한 확률 등, 현재 데이터를 보기 전의 **출발점**이라고 할 수 있습니다. "사전"이라는 이름 그대로 사전에 가지고 있는 확률이죠. - **간단한 예시:** 어떤 공장에서 만든 제품의 불량률에 대해 아무 정보가 없다면, "이 제품이 불량일 사전 확률은 50%일 것이다"라고 가정하거나, 과거 통계에 따라 "이 공장의 평균 불량률은 5%이므로, 불량일 사전 확률은 5%이다"라고 설정할 수 있습니다. 가능도 (Likelihood) - **의미:** 어떤 **사건이 이미 일어났다고 가정했을 때**, 우리가 가진 **데이터가 관찰될 확률**입니다. - **설명:** 가능도는 **'이 가정이 얼마나 그럴듯한가(likely)'**를 나타내는 척도입니다. 즉, "만약 제품이 정상이라면, 이런 데이터가 나올 가능성"과 "만약 제품이 불량이라면, 이런 데이터가 나올 가능성"을 비교하는 데 사용됩니다. **주의할 점은 가능도 자체는 확률이 아니라는 것입니다.** - **간단한 예시:** 제품을 검사했는데 '살짝 흠집이 있는' 데이터가 관찰되었다고 합시다. - **정상 제품이라는 가정 하의 가능도:** "제품이 정상일 때, 흠집이 있을 가능도는 1%이다." - **불량 제품이라는 가정 하의 가능도:** "제품이 불량일 때, 흠집이 있을 가능도는 60%이다." --- 사후 확률 (Posterior Probability) - **의미:** **데이터를 관찰한 후**에 갱신된(update) 사건의 확률입니다. - **설명:** 이것이 바로 우리가 최종적으로 알고 싶은 결과입니다. **사전 확률(기존 믿음)**에서 출발하여, **가능도(데이터의 증언)**를 반영했을 때의 **최종 결론**이죠. "사후"라는 이름처럼 데이터를 본 이후의 확률입니다. - **간단한 예시:** '살짝 흠집이 있는' 데이터를 관찰한 후, "이 제품이 실제로 불량일 사후 확률은 95%이다" 와 같이 결론을 내릴 수 있습니다. 이는 기존의 믿음(사전 확률)보다 훨씬 더 강한 확신을 갖게 된 것입니다. --- 증거 (Evidence) - **의미:** 현재 **관찰된 데이터가 나타날 전체 확률**입니다. - **설명:** 증거는 사후 확률을 실제 확률 값(0과 1 사이)으로 만들어주기 위한 **'정규화 상수(normalization constant)'** 역할을 합니다. 즉, 모든 가능한 가설(정상일 경우, 불량일 경우 등)에 대한 가능도를 각각의 사전 확률과 곱하여 모두 더한 값입니다. - **간단한 예시:** '흠집이 있는' 데이터가 관찰될 전체 확률을 계산합니다. - (정상일 사전 확률 × 정상일 때 흠집이 있을 가능도) + (불량일 사전 확률 × 불량일 때 흠집이 있을 가능도) - 이 계산 결과가 바로 증거(Evidence) 값입니다. 이 네 가지 요소는 **베이즈 정리**라는 하나의 공식으로 아름답게 연결됩니다. > 사후 확률 = (사전 확률 × 가능도) / 증거 즉 베이즈 정리를 애용해서 사전확률과, 가능도, evidence를 이용해서 사후확률을 구할 수 있다. # 스마트폰 피드백 분석 $$P(A)$$: `p_software` : 소프트웨어 관련 피드백일 확률 $$P(B)$$ : `p_critical` : 비판적인 피드백일 확률 $$P(A\mid B)$$: `p_software_given_critical` : 비판적 리뷰일때 소프트웨어 관련 피드백일 확률 $$P(A\mid B^C)$$: `p_software_given_positive` :긍정적 리뷰일때 소프트웨어 관련 피드백일 확률 위의 4가지 확률이 주어졌을떄 아래의 확률을 구해보자. (1) 소프트웨어 관련 피드백이라면, 비판적인 리뷰가 포함되었을 확률 $$𝑃(𝐵\mid 𝐴)$$ (2) 하드웨어 관련 피드백이라면, 비판적인 리뷰가 포함되었을 확률 $$𝑃(𝐵\mid 𝐴^𝐶)$$ (3) 소프트웨어 관련 피드백이라면, 긍정적인 리뷰가 포함되었을 확률 $$𝑃(𝐵^𝐶\mid 𝐴)$$ (4) 하드웨어 관련 피드백이라면, 긍정적인 리뷰가 포함되었을 확률 $$𝑃(𝐵^𝐶\mid 𝐴^𝐶)$$ ```python def prob(prior, likelihood, evidence): #사전확률, 가능도, evidence가 주어졌을때 사후확률 구하기 posterior = prior * likelihood / evidence return posterior def prob_calculate(p_software, p_critical, p_software_given_critical, p_software_given_positive): # P(B|A) p_critical_given_software = prob(p_critical,p_software_given_critical,p_software) print(f"P(B|A): {p_critical_given_software:.4f}") # P(B|A^C) p_critical_given_hardware = prob(p_critical,1-p_software_given_critical,1-p_software) print(f"P(B|A^C): {p_critical_given_hardware:.4f}") # P(B^C|A) p_positive_given_software = prob(1-p_critical,p_software_given_positive,p_software) print(f"P(B^C|A): {p_positive_given_software:.4f}") # P(B^C|A^C) p_positive_given_hardware = prob(1-p_critical,1-p_software_given_positive,1-p_software) print(f"P(B^C|A^C): {p_positive_given_hardware:.4f}") return (p_critical_given_software, p_critical_given_hardware, p_positive_given_software, p_positive_given_hardware) ex1_p_software = 40/100 ex1_p_critical = 50/100 ex1_p_software_given_critical = 25/50 ex1_p_software_given_positive = 15/50 ex2_p_software = 40/100 ex2_p_critical = 30/100 ex2_p_software_given_critical = 13/30 ex2_p_software_given_positive = 27/70 print("---------------사례1---------------") ex1_probs = prob_calculate(ex1_p_software, ex1_p_critical, ex1_p_software_given_critical, ex1_p_software_given_positive) print("---------------사례2---------------") ex2_probs = prob_calculate(ex2_p_software, ex2_p_critical, ex2_p_software_given_critical, ex2_p_software_given_positive) ``` ![image](/assets/images/2025-10-08-13-32-55.png) 베이즈정리에 의해 사전확률, 가능도, evidence를 알면 사후확률을 구할 수 있다. ## Monte Calro Sampling 몬테카를로 샘플링은 확률분포의 명시적인 형태를 모르는 상황(비모수)에서 기댓값과 같은 통계적 수치를 추정하는 효과적인 방법이다. → 무작위 샘플링을 통해 확률분포의 특성을 수치적으로 모사하고, 그 결과를 통계적으로 분석할 수 있고, 원하는 값을 추정할 수 있다. 특히 machine Learning에서 모델이 생성하는 데이터의 분포를 직접적으로 알 수 없을때 몬테카를로 샘플링을 사용한다. $$E[f(x)] \approx \frac{1}{N} \sum_{i=1}^N f\left(x^{(i)}\right)$$ $$E[f(x)]$$: $$f(x)$$의 기댓값 $$x^{(i)}$$: 확률분포 $$P(x)$$에서 추출된 N개의 i.i.d.(독립적이고 동일하게 분포된)무작위 샘플 → $$P(x)$$를 명시적으로 알지 못하므로 이 샘플들을 이용해서 $$f(x)$$의 기댓값을 근사한다. 몬테카를로 샘플링의 정확도는 샘플의 크기 $$N$$에 의존한다. 대수에 법칙에 의해서 $$N$$이 커질수록 추정값이 실제 기대값에 가까워지며, 고차원 데이터나 복잡한 확률분포에서 유용하다. ## 예시1 적분값 계산 일반적인 적분법으로는 적분하기 힘든 함수를 적분해보자. 가우시안함수: $$f(x) = e^{-x^2}$$ 1. 적분 구간 사이에서 난수를 생성해서, 2. 함수에 난수를 넣고, 3. 함수값들의 평균값을 계산하여, 4. 구간의 길이로 나눠서 적분을 근사한다. ```python import numpy as np # fun: 적분할 함수 # low, high: 적분 구간의 하한과 상한 # sample_size: 샘플의 크기, 즉 난수의 개수 # repeat: 적분을 반복할 횟수 def mc_int(fun, low, high, sample_size=100, repeat=10): int_len = np.abs(high - low) # 적분 구간의 길이 계산 stat = [] # 적분값을 저장할 리스트 for _ in range(repeat): x = np.random.uniform(low = low, high = high, size = sample_size) fun_x = fun(x) # 생성된 난수에 대한 함수 값 계산 int_val = int_len * np.mean(fun_x) stat.append(int_val) # 근사값을 리스트에 추가 # 근사값들의 평균과 표준편차 반환 return np.mean(stat), np.std(stat) # 적분할 함수 정의 def f_x(x): return np.exp(-x**2) # mc_int 함수를 사용하여 적분 근사값 계산 및 출력. result = mc_int(f_x, low=-1, high=1, sample_size=10000, repeat=100) print(result) ``` ## 예시2: 원주율 추정 $$\pi \approx 4 \times \frac{\text { 원 안에 생성된 점의 수 }}{\text { 전체 생성된 점의 수 }}$$ 1. 단위 정사각형내에서 무작위 점을 생성하고, 2. 생성된 점중 원의 방정식 안에 있는 점을 Count한다. 3. 위의 공식을 통해서 전체점중에 원안의 생성된 점의 수를 분수로 나타내고 4를 곱해서 원주율을 추정한다. 원 넓이의 공식이 $$\pi r^2$$임을 이용해서 단위 정사각형 넓이와 원의 넓이 비는 $$\pi$$임을 이용함. ```python import numpy as np import matplotlib.pyplot as plt # 시드 설정 np.random.seed(0) # 무작위 점(샘플)의 수 설정 num_samples = 10000 # 정사각형 [0,1] x [0,1] 내에서 무작위 점 생성 x_random = np.random.uniform(0, 1, num_samples) y_random = np.random.uniform(0, 1, num_samples) # 단위 원 내부에 있는 점의 수 계산 inside_circle = (x_random**2 + y_random**2) <= 1 # 공식에 따라 π의 값 추정 pi_estimate = 4 * np.sum(inside_circle) / num_samples print(f"π의 추정값: {pi_estimate}") # 점들과 원을 시각화 plt.figure(figsize=(6, 6)) plt.scatter(x_random[inside_circle], y_random[inside_circle], color='blue', s=1, label='Inside Circle') plt.scatter(x_random[~inside_circle], y_random[~inside_circle], color='red', s=1, label='Outside Circle') circle = plt.Circle((0, 0), 1, edgecolor='green', facecolor='none') plt.gca().add_artist(circle) plt.gca().set_aspect('equal', adjustable='box') plt.title(f"Monte Carlo Estimation of π (estimate: {pi_estimate})") plt.xlabel("x") plt.ylabel("y") plt.xlim(0, 1) plt.ylim(0, 1) plt.legend() plt.show() ``` ![image](/assets/images/2025-10-08-13-34-05.png) ### [CV][논문 리뷰] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale - Canonical URL: https://hyejunl33.github.io/study/2025-10-08-[CV]-AN-IMAGE-IS-WORTH-16X16-WORDS-TRANSFORM/ - Collection: Study - Published: 2025-10-08 - Tags: An Image is Worth 16x16 Words, 논문리뷰, Computer Vision, CV, ViT # [논문 리뷰] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale ## 1. Abstract - Attention은 CNN과 함께만 제한적으로 사용돼왔음. → Patch로 image를 나눠서 attention의 입력 sequence로 사용하는 방법 제시 - 기존의 방식보다 Resource를 훨씬 적게 사용하고도 Sota모델과 비슷하거나 더 좋은 성능을 냈음 Transformer 아키텍처는 자연어 처리(NLP)의 표준이 되었지만, 컴퓨터 비전 분야에서의 적용은 제한적이었다. 기존 비전 분야의 어텐션은 CNN과 함께 사용되거나, CNN의 전체적인 구조는 유지한 채 일부 구성 요소만을 대체하는 방식으로 사용되었다. 이 연구는 이러한 CNN에 대한 의존이 필수적이지 않음을 보인다. 대신, 이미지를 여러 고정된 크기의 패치(patch) 시퀀스로 만들어 순수 트랜스포머에 직접 적용하는 것만으로도 이미지 분류 작업에서 매우 좋은 성능을 낼 수 있음을 증명한다. 이 모델, Vision Transformer (ViT)는 대규모 데이터셋으로 사전 훈련되었을 때, ImageNet, CIFAR-100, VTAB 등 다수의 중간 혹은 작은 크기의 이미지 인식 벤치마크에서 SOTA(State-of-the-art) CNN 모델과 비교하여 뛰어난 결과를 달성한다. 특히 주목할 점은, 이러한 성과를 달성하는 동시에 모델 훈련에 필요한 컴퓨팅 자원은 훨씬 적게 요구한다는 점이다. ## 2. Introduction - NLP에서는 Transformer덕에 매우 큰 Dataset을 학습할 수 있었지만, Computer Vision에서는 Specialized attention patterns때문에 modern hardware accelerators를 효율적으로 사용하지 못하는 한계가 있었음 - Transformer모델에서 최소한의 변형으로 CNN과 hybrid하는 기존의 연구와는 다르게, image를 패치로 나눠서 입력으로 사용한다. - CNN의 locality나 inductive biases가 유리한 벤치마크에서도 결과적으로 큰 dataset에서 학습한 ViT는 SOTA급의 성능과 좋은 효율성을 보여줬다. NLP 분야에서 트랜스포머는 large text corpus로 사전 훈련 후 특정 task에 fine-tune하는 접근법을 통해 지배적인 모델이 되었다. 하지만 컴퓨터 비전 분야에서는 여전히 ResNet과 같은 CNN 기반 아키텍처가 SOTA를 유지하고 있었다. CNN은 설계 자체가 이미지 데이터의 특성(inductive biases)을 잘 반영하도록 만들어졌기 때문이다. 이 연구는 NLP에서의 트랜스포머 스케일링 성공에 영감을 받아, 표준 트랜스포머를 최소한의 수정만으로 이미지에 직접 적용하는 실험을 진행한다. 이를 위해 이미지를 여러 개의 패치로 분할하고, 이 패치들의 선형 임베딩 시퀀스를 트랜스포머의 입력으로 사용한다. 즉, 이미지 패치를 NLP에서의 토큰(단어)처럼 동일하게 취급한다. ImageNet과 같은 중간 크기의 데이터셋에서 이 모델을 훈련했을 때, 비슷한 크기의 ResNet보다 정확도가 몇 퍼센트 포인트 낮은, 다소 실망스러운 결과를 보였다. 이는 트랜스포머가 CNN에 내재된 **귀납적 편향(inductive biases)**, 예를 들어 지역성(locality, 인접 픽셀 간의 강한 상관관계)과 translation equivariance( 객체의 위치가 변해도 동일하게 인식하는 특성)이 부족하기 때문이다. CNN은 컨볼루션 연산을 통해 이러한 편향을 모델의 모든 계층에 자연스럽게 주입하지만, 트랜스포머는 이러한 사전 가정 없이 데이터로부터 모든 공간적 관계를 학습해야 한다. 따라서 데이터가 충분하지 않으면 일반화 성능이 잘 나오지 않는다. 하지만 모델을 1,400만장에서 3억장에 이르는 더 큰 데이터셋으로 훈련했을 때, 결과는 완전히 달라진다. 대규모 데이터 학습이 귀납적 편향을 이긴다(large scale training trumps inductive bias)는 중요한 사실을 발견한다. ViT는 충분한 규모의 데이터셋(ImageNet-21k, JFT-300M)으로 사전 훈련되었을 때, 여러 이미지 인식 벤치마크에서 SOTA에 도달하거나 능가하는 성능을 보였다. 특히 데이터셋의 크기를 키워도 성능이 satuation을 보이지 않아서, 데이터셋을 더 키우면 성능이 더 향상될 수 있음을 시사한다. ## 3. Related Work (관련 연구) - **이미지에 대한 Self-Attention 적용**: Self-attention을 이미지에 직접 적용하는 것은 픽셀 수에 대해 이차비용(quadratic cost)이 발생하여 현실적인 입력 크기에서는 확장이 불가능하다. 이를 해결하기 위해 각 픽셀의 지역적 이웃에만 어텐션을 적용하거나(local self-attention), 미리 정의된 희소한 패턴에 적용하거나(Sparse Transformers), 가로축과 세로축을 따라 순차적으로 적용하는(axial attention) 등의 근사 방법이 제안되었다. 하지만 이러한 방법들은 특화된 어텐션 패턴을 사용하기 때문에 하드웨어 가속기(modern hardware accelerator)에서 효율적으로 구현하기 위한 복잡한 엔지니어링을 요구한다. → ViT에서는 Transformer의 Encoder에서 최소한의 변형으로 이미지 패치를 sequence 입력으로 주는것으로 모델을 사용한다. → 훨씬 단순하다. - **Hybrid(CNN과 Self-Attention의 결합)**: CNN의 feature map을 어텐션으로 보강하여 중요한 특징을 강조하거나, CNN의 최종 출력을 어텐션으로 후처리하여 객체 탐지, 비디오 처리 등의 성능을 높이는 연구도 있었다. - **가장 유사한 연구**: - **Cordonnier et al. (2020)**: 2x2 크기의 매우 작은 패치를 추출하고 그 위에 self-attention을 적용한 유사한 모델을 제안했다. 하지만 이 연구는 ViT가 증명한 **대규모 사전 훈련이 SOTA CNN을 능가하는 핵심 열쇠**임을 보여주지 못했고, 작은 패치 크기로 인해 저해상도 이미지에만 적용 가능했다. - **Image GPT (iGPT)**: 이미지 해상도와 색 공간을 줄인 뒤 픽셀 단위로 트랜스포머를 적용한 생성 모델이다. 비지도 학습 방식으로 훈련되어 ImageNet에서 최대 72%의 정확도를 달성했다. - **대규모 데이터 학습**: 이 연구는 ImageNet-21k나 JFT-300M 같은 대규모 데이터셋을 사용하여 SOTA를 달성한 선행 연구들(e.g., BiT)의 흐름을 따르되, 모델 아키텍처를 기존의 ResNet 기반 모델 대신 트랜스포머로 대체했다는 점에서 근본적인 차이가 있다. 결과적으로 Dataset을 많이 때려넣으니 성능 satuation없이 성능이 향상함을 밝혀냈다. ## 4. Method 모델 설계는 NLP 분야의 확장성을 그대로 활용하기 위해 원본 트랜스포머(Vaswani et al., 2017)를 최대한 가깝게 따른다. 이러한 단순한 설계는 확장성 높은 NLP 트랜스포머 아키텍처와 그 효율적인 구현체를 거의 수정 없이 사용할 수 있다는 장점이 있다. 1. 이미지 패치단위로 나누기 2. patch를 embedding하고 positional embedding과 더하기 3. Classification을 위해 `[CLS]` 토큰과 함께 transformer model에 넣어주기 ![image](/assets/images/2025-10-08-19-26-18.png) ### 4.1 Vision Transformer (ViT) ![image](/assets/images/2025-10-08-19-26-29.png) - **패치화 및 임베딩**: 2D 이미지 $$x \in \mathbb{R}^{H \times W \times C}$$를 평탄화된(flattened) 2D 패치의 시퀀스 $$x_p \in \mathbb{R}^{N \times (P^2 \cdot C)}$$로 재구성한다. 여기서 $$(P, P)$$는 각 패치의 해상도이고, $$N=HW/P2$$는 패치의 개수이자 트랜스포머의 유효 입력 시퀀스 길이가 된다. 이 패치들을 학습 가능한 선형 투영(linear projection)을 통해 트랜스포머의 모든 계층에서 사용되는 고정된 D차원의 벡터로 매핑하여 '패치 임베딩'을 생성한다. - **Class Token**: BERT의 `[class]` 토큰과 유사하게, 학습 가능한 임베딩 $$(z_0^0 = x_{class})$$을 패치 임베딩 시퀀스의 맨 앞에 추가한다. 트랜스포머 인코더의 최종 출력에서 이 토큰에 해당하는 상태 $$(z_L^0)$$가 이미지 전체의 표현(representation)으로 사용되어 최종 분류를 수행한다. - **Position Embedding**: 패치로 분할하면서 손실된 위치 정보를 유지하기 위해, 학습 가능한 1D 위치 임베딩을 각 패치 임베딩에 더한다. 이 임베딩을 통해 모델은 각 패치의 상대적, 절대적 위치를 학습하게 된다. - **Transformer Encoder**: 인코더는 멀티헤드 셀프 어텐션(MSA) 블록과 MLP 블록이 번갈아 나타나는 구조로 구성된다. 각 블록 이전에는 LayerNorm(LN)이 적용되어 입력을 정규화하고, 이후에는 잔차 연결(residual connection)이 적용되어 깊은 네트워크의 학습을 안정시킨다. MLP는 두 개의 레이어와 GELU 활성화 함수로 구성된다. - **귀납적 편향 (Inductive Bias)**: ViT는 CNN에 비해 이미지 특화적인 귀납적 편향이 훨씬 적다. CNN은 Locality, 2차원 이웃 구조, Translation equivariance가 컨볼루션 연산 자체에 내재되어 모델 전체에 적용된다. 반면 ViT에서는 MLP 레이어만 지역적이고, 셀프 어텐션 레이어는 모든 패치 쌍 간의 관계를 계산하므로 전역적(global)이다. 2차원 구조 정보는 초기 패치 분할 단계와 미세 조정 시 위치 임베딩을 보간할 때만 제한적으로 사용되며, 그 외 모든 공간적 관계는 데이터로부터 처음부터 학습되어야 한다. - **하이브리드 아키텍처 (Hybrid Architecture)**: 이미지 패치 대신 CNN의 Feature map에서 추출한 패치 시퀀스를 ViT의 입력으로 사용할 수도 있다. 이 경우 CNN이 저수준 특징을 효과적으로 추출하고, 트랜스포머가 이를 바탕으로 전역적 관계를 모델링하는 역할을 분담한다. ### 4.2 Fine-tuning and Higher Resolution 일반적으로 ViT는 대규모 데이터셋에서 pretrain된 후, 더 작은 Downstream task에 Fine-tuning된다. 이때 사전 훈련에 사용된 예측 헤드를 제거하고, 목표 클래스 수(K)에 맞는 새로운, 0으로 초기화된 $$D×K$$ *FeedForward layer*를 부착한다. 사전 훈련 때보다 높은 해상도의 이미지로 Fine-tuning하는 것이 종종 성능 향상에 도움이 된다. 더 많은 세부 정보를 포착할 수 있기 때문이다. 이 경우 패치 크기는 동일하게 유지되므로 시퀀스 길이가 길어진다. 사전 훈련된 위치 임베딩은 더 이상 유효하지 않으므로, 원본 이미지에서의 위치에 따라 2D interpolation을 통해 새로운 시퀀스 길이에 맞게 크기를 조정한다. 이 해상도 조정과 패치 추출 과정이 ViT에 2D 이미지 구조에 대한 귀납적 편향을 수동으로 주입하는 유일한 지점이다. ## 5. Experiments ### 5.1 실험 환경 - **데이터셋**: 사전 훈련용으로 ImageNet(1.3M 이미지), ImageNet-21k(14M 이미지), JFT-300M(303M 이미지)을 사용하고, 전이 학습 평가용으로 ImageNet, CIFAR-10/100, Oxford-IIIT Pets 등과 19개 과제로 구성된 VTAB 벤치마크를 사용한다. - **모델**: BERT 설정을 기반으로 ViT-Base(86M 파라미터), ViT-Large(307M 파라미터), ViT-Huge(632M 파라미터) 모델을 구성한다. ResNet(BiT) 모델과 하이브리드 모델을 비교군으로 사용한다. ![image](/assets/images/2025-10-08-19-26-40.png) - **훈련**: 사전 훈련은 Adam 옵티마이저를, 미세 조정은 SGD with momentum을 사용한다. - **평가**: Finetuning 정확도(Fine-tuning accuracy)와 퓨샷 정확도(Few-shot accuracy)를 측정한다. ### 5.2 SOTA 모델과의 비교 ![image](/assets/images/2025-10-10-14-16-03.png) - JFT-300M으로 사전 훈련된 ViT-L/16 모델은 동일 데이터셋으로 훈련된 BiT-L(ResNet)보다 모든 과제에서 더 나은 성능을 달성했다. (예: ImageNet 87.76% vs 87.54%) 동시에 사전 훈련에 필요한 계산 자원은 BiT-L의 9.9k TPUv3-core-days 대비 0.68k로 현저히 적었다. - 더 큰 모델인 ViT-H/14는 성능을 더욱 향상시켜 ImageNet에서 88.55%의 정확도를 달성했다. - 공개 데이터셋인 ImageNet-21k로 훈련된 ViT-L/16 또한 우수한 성능을 보였다. ![image](/assets/images/2025-10-10-14-16-15.png) - VTAB 벤치마크 분석 결과, ViT-H/14는 자연 이미지(Natural) 및 구조적 이해(Structured) 과제 그룹에서 다른 SOTA 모델들보다 우수한 성능을 기록했다. 이러한 밴치마크들은 기하적 이해가 필요한 task인데, 이러한 task에서도 ViT모델들이 우수한 성능을 보임을 알 수 있다. ### 5.3 Pre-train 데이터 요구 사항 ![image](/assets/images/2025-10-10-14-26-53.png) - ViT 모델을 점차 큰 데이터셋(ImageNet → ImageNet-21k → JFT-300M)으로 사전 훈련한 결과, 가장 작은 ImageNet에서는 ViT-Large 모델이 ViT-Base보다도 성능이 낮았지만, 데이터셋이 커질수록 ViT가 CNN을 능가했다. 이는 큰 ViT 모델이 작은 데이터셋에서는 과적합되기 쉽다는 것을 의미한다. - JFT-300M의 부분 집합(9M, 30M, 90M)으로 훈련했을 때도, 적은 데이터에서는 ResNet이 우수했지만 90M 이상의 데이터에서는 ViT가 더 나은 성능을 보였다. 이는 CNN의 Inductive biases가 작은 데이터셋에서는 유용하지만, 큰 데이터셋에서는 데이터로부터 직접 패턴을 학습하는 것이 더 효과적임을 명확히 시사한다. ### 5.4 확장성 연구 (Scaling Study) ![image](/assets/images/2025-10-10-14-25-17.png) - 데이터 크기가 병목이 아닌 JFT-300M 환경에서 사전 훈련 비용 대비 성능을 비교한 결과, ViT는 ResNet보다 동일 성능 달성에 약 2-4배 적은 계산량을 사용하며 압도적인 효율성을 보였다. - 하이브리드 모델은 작은 계산 예산에서는 순수 ViT보다 약간 우수했지만, 모델이 커지면서 그 차이는 사라졌다. 이는 모델 규모가 충분히 크면 CNN의 Low-level Feature 추출 능력이 ViT의 학습 능력에 흡수될 수 있음을 시사한다. - ViT의 성능은 실험 범위 내에서 Saturation되지 않아, 추가적인 확장을 통해 성능 향상이 가능함을 시사한다. ### 5.5 ViT 내부 분석 ![image](/assets/images/2025-10-10-14-17-13.png) - **임베딩 필터**: 첫 레이어의 학습된 임베딩 필터는 각 패치 내부의 미세 구조를 표현하기 위한 그럴듯한 basis functions와 유사한 형태(수직/수평/대각선, 색상 그래디언트 등)를 보여, Low-level Feature을 학습함을 확인했다. - **위치 임베딩**: 모델은 위치 임베딩의 유사도를 통해 이미지 내의 거리와 행-열 구조를 인코딩하는 법을 스스로 학습했다. 가까운 패치일수록, 그리고 같은 행이나 열에 있는 패치일수록 더 유사한 임베딩을 가졌다. 이때 스스로 위치임베딩을 학습하므로 hand-crafted 2D-embedding은 성능이 낮게 나옴을 확인할 수 있었다. - **어텐션 거리**: CNN의 수용 영역(receptive field)과 유사한 개념으로, 낮은 레이어의 일부 헤드는 처음부터 이미지 전체에 걸쳐 정보를 통합하는 전역적(grobal) 역할을, 다른 헤드들은 지역적(Local) 역할을 수행했다. 그러나 네트워크 깊이가 깊어질수록(deeper) 모든 헤드의 어텐션 거리는 증가했다. 따라서 depth가 깊어질수록 이미지 전체를 볼 수 있다는 의미이다. 이 지역적 어텐션은 하이브리드 모델에서는 덜 뚜렷하게 나타나, CNN의 초기 컨볼루션 레이어와 유사한 기능을 수행할 수 있음을 암시한다. ![image](/assets/images/2025-10-10-14-17-05.png) - 결과적으로 모델은 분류에 의미적으로 관련된 이미지 영역에 집중하는 경향을 보였다. ### 5.6 자기지도학습 (Self-Supervision) - BERT의 마스크 언어 모델링을 모방하여, 이미지 패치의 50%를 가리고(masking) 그 가려진 패치의 평균 3비트 색상 값을 예측하는 '마스크 패치 예측(masked patch prediction)'을 예비 실험으로 수행했다. - 이 방식으로 사전 훈련한 ViT-B/16 모델은 ImageNet에서 79.9%의 정확도를 달성하여, 처음부터 학습하는 것보다는 2% 높은 유의미한 성능 향상을 보였지만, 지도학습 사전 훈련(83.97%)보다는 4% 낮았다. 이는 자기지도학습의 가능성을 보여주지만, 지도학습과의 격차를 줄이기 위한 추가 연구가 필요함을 시사한다. ## 6. Conclusion (결론) 이 연구는 트랜스포머를 이미지 인식에 직접 적용하는 방법을 탐구했다. 이미지 특화적인 귀납적 편향을 거의 도입하지 않고, 이미지를 패치 시퀀스로 해석하여 표준 트랜스포머 인코더로 처리하는 단순한 전략이 대규모 데이터셋 사전 훈련과 결합될 때 매우 효과적임을 보였다. 즉, 데이터의 규모가 모델의 귀납적 편향을 압도할 수 있음을 증명했다. 그 결과 ViT는 다수 벤치마크에서 SOTA를 달성하면서도 사전 훈련 비용이 상대적으로 저렴했다. 향후 과제로는 ViT를 객체 탐지나 분할과 같은 다른 비전 과제에 적용하는 것, 자기지도학습 사전 훈련 방법의 격차를 줄이는 것, 그리고 ViT의 추가적인 확장을 통해 성능을 향상시키는 것이 남아있다. ### [PyTorch][심화과제] Without_torch.nn - Canonical URL: https://hyejunl33.github.io/study/2025-10-10-[AI_Math]Without-torch-nn/ - Collection: Study - Published: 2025-10-08 - Tags: Without_torch.nn, 심화과제, Without torch.nn, Xavier초기화, irisdataset # 심화과제_Without_torch.nn - `torch.nn`을 사용하지 않고 MLP를 구현하고, `torch.nn`을 사용해서 구현한 MLP와 비교 - 3가지 이상 카테고리를 분류하는 Multi-Class classification 구현 ## 데이터셋 개요 Iris 데이터셋은 꽃잎과 꽃받침의 길이와 너비를 이용하여 iris 꽃의 품종을 분류하는 데이터셋이다. 총 3개의 class로 구성되어 있으며 각 class는 iris꽃의 품종을 나타낸다. - iris data: iris 꽃의 꽃잎과 꽃받침의 길이와 너비를 나타내는 feature - iris target: iris 꽃의 품종을 나타내는 label # 데이터셋 불러오기 - Iris 데이터셋을 불러오고 Pytorch의 Dataset 클래스를 상속받아 정의된 클래스로 변환하기 1. `__init__` 메소드에서 `self.X, self.y` 를 각각 iris 데이터와 iris target으로 초기화하기 2. `__len__` 메소드에서 데이터셋의 길이를 반환하기 3. `__getitem__` 메소드에서 index에 해당하는 데이터와 레이블을 반환하기 `sklearn.datasets.load_iris()` :iris 데이터셋을 불러오는 함수 `sklearn.model_selection.train_test_split()` : 데이터셋을 train과 test로 나누는 함수 ```python from sklearn.datasets import load_iris from sklearn.model_selection import train_test_split from torch.utils.data import DataLoader, Dataset import torch class IrisDataset(Dataset): def __init__(self, mode="train", random_state=0): # mode인자를 통해 train인지 test인지 구분하기 -> 사용하는 데이터 달라짐 iris = load_iris() train_X, test_X, train_y, test_y = train_test_split( iris.data, iris.target, stratify=iris.target, test_size=0.2, random_state=random_state, ) if mode == "train": # mode가 train일때는 train_X, train_y를 올려주기 self.X = torch.tensor(train_X, dtype = torch.float) # feature가 되는 X 값을 PyTorch float 형태로 변환 self.y = torch.tensor(train_y, dtype = torch.long) # Target이 되는 y 값을 PyTorch long 형태로 변환 else: # mode가 test일떄는 test_X, test_y를 올려주기 self.X = torch.tensor(test_X, dtype = torch.float) self.y = torch.tensor(test_y, dtype = torch.long) def __len__(self): # len()함수로 입력X길이 반환 return len(self.X) def __getitem__(self, idx): # getitem함수에서는 idx에 해당하는 x와 y를 반환 return self.X[idx], self.y[idx] ``` ```python #배치사이즈는 16으로 설정 batch_size = 16 # train_dataset은 인스턴스로 생성 train_dataset = IrisDataset() #PyTorch의 DataLoader를 이용해서 train_loader인스턴스 생성 train_loader = DataLoader(train_dataset, batch_size = batch_size, shuffle = True) #test_dataset도 마찬가지로 인스턴스로 생성 test_dataset = IrisDataset() test_loader = DataLoader(test_dataset, batch_size = batch_size, shuffle = False) ``` ![image](/assets/images/2025-10-10-08-54-44.png) # 모델구현(Without `torch.nn`) ## Define Linear layer ```python # 선형 레이어를 정의합니다. 이 레이어는 입력 특성과 출력 특성의 수를 받아서 가중치와 편향을 초기화합니다. class WithoutNNLinear: def __init__(self, in_features, out_features): # weight는 randn()으로 가우시안 랜덤으로 초기화하기 self.weight = torch.randn(out_features, in_features, requires_grad = True) #bias는 zeros()로 0으로 초기화하기 self.bias = torch.zeros(out_features, requires_grad = True) # 입력값 x를 받아 선형변환 수행 def __call__(self, x): # weight과 x를 내적하고, bias를 더해서 Linear 연산을 수행 return torch.matmul(self.weight,x.T).T + self.bias # weight과 bias를 device에 올리기 def set_device(self, device): self.weight = self.weight.to(device) self.bias = self.bias.to(device) # 모델의 파라미터[Wiehgt, bias]를 반환하기. def parameters(self) -> list: return [self.weight, self.bias] ``` 1. `init()` 메서드는 `self.weight, self.bias` 를 초기화함 2. `call()` 메서드는 `x`를 받아 선형변환 수행 3. `set_device` 메서드에서는 연산을 수행할 device에다 `weight, bias`올려주기 4. `parameters`메서드에서는 `weight`와 `bias`를 반환 ![image](/assets/images/2025-10-10-08-54-58.png) ## Linear layer의 계산 시각화 가중치행렬 Weight: $$W = \begin{bmatrix} 1.0 \\ 2.0 \\ 3.0 \\ \end{bmatrix}$$ 편향벡터 bias: $$b = \begin{bmatrix} 1.0 & 1.0 & 1.0 \end{bmatrix}$$ 입력데이터 x : $$x = [1.0]$$ $$y = xW^T + b$$인 선형계산을 하는과정 $$W^T = \begin{bmatrix}1.0 &2.0 & 3.0 \end{bmatrix}$$ 연산차원을 맞춰주기 위해서 Weight에 Transpose를 해준다. $$xW^T = \begin{bmatrix}1.0 * 1.0 & 1.0 * 2.0 & 1.0 * 3.0\end{bmatrix}$$ x와 elementwise 곱연산을 해준다. $$xW^T + b = \begin{bmatrix}1.0 & 2.0 & 3.0\end{bmatrix} + \begin{bmatrix}1.0 & 1.0 & 1.0\end{bmatrix}$$ bias와 더해준다. 최종결과 $$y = \begin{bmatrix}2.0 & 3.0 & 4.0\end{bmatrix}$$ ## Define ReLU layer $$ReLU(x) = max(0,x)$$ ReLU연산은 0과 x중 더 큰값을 선택하는 연산이다. 즉 입력이 양수면 그대로를 출력하고, 그렇지 않으면 0을 출력한다. ```python class WithoutNNReLU: def __init__(self): pass def __call__(self, x): return torch.relu(x) ``` `torch`의 함수 `relu`를 불러와서 정의해준다. ![image](/assets/images/2025-10-10-08-55-25.png) ReLU적용 전과 후를 시각화해보면 주황색그래프를 봤을때, 0보다 작은값들은 0으로 바뀐것을 볼 수 있다. ## Define MLP(Multi-layer Perceptron) ```python class WithoutNNMLP: def __init__(self, in_features, hidden_features, out_features): # 두개의 선형 layer와 relu를 정의해준다. self.linear1 = WithoutNNLinear(in_features,hidden_features) self.relu = WithoutNNReLU()# ReLU 활성화 함수 self.linear2 = WithoutNNLinear(hidden_features, out_features) # 이 메서드를 통해 forward연산을 한다(linear1통과, relu, linear2 통과) def __call__(self, x): y = self.linear1(x) z = self.relu(y) return self.linear2(z) # Linear와 relu를 device에 올려준다. def set_device(self, device): self.linear1.set_device(device) self.relu.set_device(device) self.linear2.set_device(device) # 각 Linear의 weight와 bias를 리스트형태로 반환한다. def parameters(self) -> list: return [self.linear1.weight, self.linear1.bias, self.linear2.weight, self.linear2.bias] ``` ## Define CrossEntropyLoss $$\hat{y}_{i,c} = \text{softmax}(z_{i,c}) = \frac{e^{z_{i,c}}}{\sum_{j=1}^{C} e^{z_{i,j}}}$$ $$\hat{y}$$는 입력x를 통해 예측한값임 - $$z_i$$는 클래스 $$i$$에 대한 입력값 $$logit$$ - $$\sum_{j=1}^{c} e^{z_j}$$는 모든 클래스에 대한 입력값 지수의 합 $$L = - \frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C} y_{i,c} \log(\hat{y}_{i,c})$$ - $$CrossEntropyLoss$$ 공식 적용하면 정답 label인 $$y$$와 예측값인 $$\hat{y}$$사이의 loss를 구할 수 있음 - $$N$$은 샘플의 수 - $$C$$는 클래스의 수 ```python class WithoutNNCrossEntropyLoss: def __init__(self, reduce="mean"): self.reduce = reduce # output인 예측값과 target인 label사이의 CrossEntropyLoss를 계산함. def __call__(self, output, target): #output에 softmax를적용한 후 log를 취함 y_hat = torch.log_softmax(output, dim = 1) #target을 원핫벡터로 만들어주기 target = torch.nn.functional.one_hot(target, num_classes = output.size(1)) #CrossEntropy공식 적용 loss = -(torch.sum(target * y_hat)) / output.size(0) return loss ``` - `torch.log_softmax` :softmax함수를 적용한 후 log를 취함 - `torch.softmax`: softmax 함수를 적용함 # 모델학습(Without `torch.nn`) ```python # 학습 데이터셋과 데이터 로더를 정의 batch_size = 16 train_dataset = IrisDataset() train_loader = DataLoader(train_dataset, batch_size = batch_size, shuffle = True) # 테스트 데이터셋과 데이터 로더를 정의 test_dataset = IrisDataset() test_loader = DataLoader(test_dataset, batch_size = batch_size, shuffle = False) # model, Lossfunction, optimizer, trainloader를 받아서 train하는 함수 정의 def train(model, criterion, optimizer, train_loader) -> float: # train단계에서는 미분할 수 있도록 설정 torch.set_grad_enabled(True) running_loss = 0 for X, y in train_loader: optimizer.zero_grad() # 그래디언트를 초기화. outputs = model(X) # model돌려서 output계산. loss = criterion(outputs, y) # output이랑 label을 lossfunc에다 넣기. loss.backward() # backprop연산. optimizer.step() # 파라미터를 업데이트. running_loss += loss.item() # 전체loss누적. return running_loss / len(train_loader) # 평균 loss을 반환 def test(model, test_loader, criterion) -> tuple[float, float]: running_loss = 0 correct = 0 total = 0 with torch.no_grad(): #Test에서는 미분하지 않도록 설정 for X, y in test_loader: predictions = model(X) # 모델에다가 input 넣기. loss = criterion(predictions,y) # loss연산. running_loss += loss.item() # loss을 누적. _, predicted = torch.max(predictions.data, 1) # 가장 큰 값의 인덱스를 예측값으로 사용. correct += (predicted == y).sum().item() # 정답을 카운트. total += y.size(0) # 전체 개수를 카운트. return running_loss / len(test_loader), 100 * correct / total # 평균 loss과 정확도를 반횐. def main(): # Main에서는 model, optimizer, Lossfunc를 가져오기 model = WithoutNNMLP(4, 100, 3) #이전에 정의한 MLP모델 인스턴스로 가져오기 criterion = WithoutNNCrossEntropyLoss() #CrossEntropy를 인스턴스로 가져오기 optimizer = torch.optim.SGD(model.parameters(), lr=0.01) #SGD를 torch에서 optimizer로 가져오기 train_loss_list, test_loss_list, test_acc_list = [], [], [] for epoch in range(50): train_loss = train(model, criterion, optimizer, train_loader) train_loss_list.append(train_loss) test_loss, test_acc = test(model, test_loader, criterion) test_loss_list.append(test_loss) test_acc_list.append(test_acc) print( f"Epoch: {epoch + 1}, Train Loss: {train_loss:.4f}, Test Loss: {test_loss:.4f}, Test Acc: {test_acc:.4f}" ) plt.plot(train_loss_list, label="train loss") plt.plot(test_loss_list, label="test loss") plt.legend() plt.show() plt.plot(test_acc_list, label="test acc") plt.legend() plt.show() return train_loss_list, test_loss_list, test_acc_list ``` - train, test DataSet과 DataLoader를 선언 - train함수에서는 모델을 학습하고 학습 loss를 반환 - test함수에서는 모델을 평가하고 평가 loss와 accuracy를 반환 - main함수에서는 model, lossfunc, optimizer, train_lodaer를 받아서 학습진행 ## Train MLP ```python train_loss_list, test_loss_list, test_acc_list = main() ``` Epoch: 1, Train Loss: 21.3201, Test Loss: 4.0824, Test Acc: 60.0000 Epoch: 2, Train Loss: 7.4944, Test Loss: 1.0846, Test Acc: 68.3333 Epoch: 3, Train Loss: 11.1940, Test Loss: 8.5829, Test Acc: 66.6667 Epoch: 4, Train Loss: 6.9451, Test Loss: 6.7730, Test Acc: 66.6667 Epoch: 5, Train Loss: 6.5654, Test Loss: 3.1718, Test Acc: 66.6667 Epoch: 6, Train Loss: 4.3504, Test Loss: 0.4089, Test Acc: 85.0000 Epoch: 7, Train Loss: 4.9807, Test Loss: 0.3415, Test Acc: 88.3333 Epoch: 8, Train Loss: 8.5464, Test Loss: 16.7203, Test Acc: 66.6667 Epoch: 9, Train Loss: 6.6198, Test Loss: 2.0498, Test Acc: 68.3333 Epoch: 10, Train Loss: 5.8897, Test Loss: 6.2224, Test Acc: 54.1667 Epoch: 11, Train Loss: 4.3317, Test Loss: 10.2501, Test Acc: 66.6667 Epoch: 12, Train Loss: 3.4176, Test Loss: 14.7438, Test Acc: 66.6667 Epoch: 13, Train Loss: 6.0909, Test Loss: 18.1354, Test Acc: 66.6667 Epoch: 14, Train Loss: 4.3075, Test Loss: 8.4764, Test Acc: 66.6667 Epoch: 15, Train Loss: 1.8319, Test Loss: 0.1171, Test Acc: 95.0000 Epoch: 16, Train Loss: 3.1668, Test Loss: 0.2417, Test Acc: 95.0000 Epoch: 17, Train Loss: 2.7136, Test Loss: 4.7655, Test Acc: 65.0000 Epoch: 18, Train Loss: 2.7916, Test Loss: 2.8870, Test Acc: 67.5000 Epoch: 19, Train Loss: 3.0060, Test Loss: 14.5628, Test Acc: 66.6667 Epoch: 20, Train Loss: 7.1704, Test Loss: 0.1215, Test Acc: 95.0000 Epoch: 21, Train Loss: 0.3979, Test Loss: 0.1396, Test Acc: 94.1667 Epoch: 22, Train Loss: 0.6002, Test Loss: 0.6878, Test Acc: 87.5000 Epoch: 23, Train Loss: 0.8169, Test Loss: 1.2221, Test Acc: 80.0000 Epoch: 24, Train Loss: 1.9611, Test Loss: 0.6791, Test Acc: 87.5000 Epoch: 25, Train Loss: 0.5712, Test Loss: 4.5675, Test Acc: 67.5000 Epoch: 26, Train Loss: 0.8539, Test Loss: 0.2061, Test Acc: 95.8333 Epoch: 27, Train Loss: 0.2541, Test Loss: 0.3387, Test Acc: 93.3333 Epoch: 28, Train Loss: 0.5439, Test Loss: 0.1925, Test Acc: 92.5000 Epoch: 29, Train Loss: 1.1831, Test Loss: 1.1068, Test Acc: 82.5000 Epoch: 30, Train Loss: 2.0127, Test Loss: 3.5232, Test Acc: 66.6667 Epoch: 31, Train Loss: 1.1963, Test Loss: 0.5649, Test Acc: 88.3333 Epoch: 32, Train Loss: 1.9448, Test Loss: 3.0002, Test Acc: 68.3333 Epoch: 33, Train Loss: 1.1180, Test Loss: 1.0866, Test Acc: 79.1667 Epoch: 34, Train Loss: 3.6422, Test Loss: 0.4868, Test Acc: 90.8333 Epoch: 35, Train Loss: 0.4537, Test Loss: 0.7108, Test Acc: 88.3333 Epoch: 36, Train Loss: 0.4420, Test Loss: 0.2116, Test Acc: 95.8333 Epoch: 37, Train Loss: 1.3080, Test Loss: 0.1779, Test Acc: 96.6667 Epoch: 38, Train Loss: 0.3244, Test Loss: 4.3625, Test Acc: 66.6667 Epoch: 39, Train Loss: 0.6277, Test Loss: 0.2484, Test Acc: 92.5000 Epoch: 40, Train Loss: 0.4307, Test Loss: 0.4766, Test Acc: 91.6667 Epoch: 41, Train Loss: 0.9256, Test Loss: 0.2649, Test Acc: 92.5000 Epoch: 42, Train Loss: 0.6906, Test Loss: 0.4549, Test Acc: 92.5000 Epoch: 43, Train Loss: 0.4643, Test Loss: 4.0705, Test Acc: 67.5000 Epoch: 44, Train Loss: 1.0212, Test Loss: 1.5202, Test Acc: 80.0000 Epoch: 45, Train Loss: 1.0390, Test Loss: 0.3747, Test Acc: 91.6667 Epoch: 46, Train Loss: 0.2813, Test Loss: 0.1601, Test Acc: 96.6667 Epoch: 47, Train Loss: 0.4228, Test Loss: 0.2893, Test Acc: 95.0000 Epoch: 48, Train Loss: 0.2731, Test Loss: 0.5005, Test Acc: 90.8333 Epoch: 49, Train Loss: 0.2122, Test Loss: 0.1552, Test Acc: 96.6667 Epoch: 50, Train Loss: 0.2465, Test Loss: 0.1721, Test Acc: 92.5000 ![image](/assets/images/2025-10-10-08-55-50.png) Test ACC가 결과적으로 90이상까지 올라갔음을 볼 수 있다. ![image](/assets/images/2025-10-10-08-55-56.png) trainloss와 testloss를 시각화해보면 점차 줄어드는 추세를 볼 수있다. 다만 Optimizer로 SGD를 사용했으므로, 그래프의 개형이 들쭉날쭉함도 확인할 수 있다. # 모델구현(With `torch.nn`) - `torch.nn.Linear`: Linear layer를 정의 - `torch.nn.ReLU`: ReLU layer를 정의 - `torch.nn.CrossEntropyLoss`: Cross Entropy Loss를 정의 ```python import torch.nn as nn # input_size = 1, output_size = 3인 Linear_layer를 정의 nn_linear = nn.Linear(1,3) #relu정의 nn_relu = nn.ReLU() ``` ## Combine components ```python import torch.nn as nn class MLP(nn.Module): def __init__(self, in_features, hidden_features, out_features): # lienar layer와 relu 정의해주기 super().__init__() # 상속받은 부모 클래스의 생성자 호출 self.linear1 = nn.Linear(in_features, hidden_features) self.relu = nn.ReLU() self.linear2 = nn.Linear(hidden_features, out_features) def forward(self, x): # Linear1, relu, linear2 순서대로 쌓아주기 y = self.linear1(x) z = self.relu(y) return self.linear2(z) ``` # 모델 학습 ```python # nn.Module을 이용해서 train하는 함수 def train_nn(model, criterion, optimizer, train_loader): model.train() # 모델을 학습 모드로 설정 running_loss = 0 for X, y in train_loader: optimizer.zero_grad() # 그래디언트를 0으로 초기화 outputs = model(X) # 모델의 출력을 계산 loss = criterion(outputs, y) # 손실을 계산 loss.backward() # 역전파를 수행 optimizer.step() # 가중치를 업데이트 running_loss += loss.item() # 손실을 누적 return running_loss / len(train_loader) # 평균 손실을 반환 # nn.Module을 이용해서 test하는 함수 def test_nn(model, test_loader, criterion): model.eval() # 모델을 평가 모드로 설정 running_loss = 0 correct = 0 total = 0 with torch.no_grad(): # 그래디언트 계산을 비활성화 for X, y in test_loader: # 테스트 데이터를 반복 predictions = model(X) # 모델의 출력을 계산 loss = criterion(predictions, y) # 손실을 계산 running_loss += loss.item() # 손실을 누적 _, predicted = torch.max(predictions,1) # 가장 높은 확률을 가진 클래스를 예측 correct += (predicted == y).sum().item() # 정확한 예측의 수를 누적 total += y.size(0) # 전체 레이블의 수를 누적 return running_loss / len(test_loader), 100 * correct / total # 평균 손실과 정확도를 반환 # 모델을 돌리는 main함수 def main_nn(): model = MLP(4, 100, 3) # 모델을 생성 criterion = nn.CrossEntropyLoss() # 손실 함수를 정의 optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # 최적화 알고리즘을 정의 train_loss_list, test_loss_list, test_acc_list = ( [], [], [], ) # 손실과 정확도를 저장할 리스트 for epoch in range(50): # 50 에포크 동안 학습 train_loss = train_nn( model, criterion, optimizer, train_loader ) # 학습 손실을 계산 train_loss_list.append(train_loss) # 학습 손실을 저장 test_loss, test_acc = test_nn( model, test_loader, criterion ) # 테스트 손실과 정확도를 계산 test_loss_list.append(test_loss) # 테스트 손실을 저장 test_acc_list.append(test_acc) # 테스트 정확도를 저장 print( f"Epoch: {epoch + 1}, Train Loss: {train_loss:.4f}, Test Loss: {test_loss:.4f}, Test Acc: {test_acc:.4f}" ) # 에포크, 학습 손실, 테스트 손실, 테스트 정확도를 출력 # 학습 손실과 테스트 손실을 그래프로 그림 plt.plot(train_loss_list, label="train loss") plt.plot(test_loss_list, label="test loss") plt.legend() plt.show() # 테스트 정확도를 그래프로 그림 plt.plot(test_acc_list, label="test acc") plt.legend() plt.show() return train_loss_list, test_loss_list, test_acc_list ``` Epoch: 1, Train Loss: 1.2110, Test Loss: 1.0636, Test Acc: 33.3333 Epoch: 2, Train Loss: 0.9644, Test Loss: 0.8945, Test Acc: 66.6667 Epoch: 3, Train Loss: 0.8138, Test Loss: 0.7550, Test Acc: 66.6667 Epoch: 4, Train Loss: 0.7220, Test Loss: 0.7044, Test Acc: 66.6667 Epoch: 5, Train Loss: 0.6809, Test Loss: 0.6342, Test Acc: 66.6667 Epoch: 6, Train Loss: 0.6383, Test Loss: 0.5987, Test Acc: 80.0000 Epoch: 7, Train Loss: 0.6095, Test Loss: 0.5539, Test Acc: 71.6667 Epoch: 8, Train Loss: 0.6122, Test Loss: 0.5313, Test Acc: 95.8333 Epoch: 9, Train Loss: 0.5246, Test Loss: 0.5288, Test Acc: 79.1667 Epoch: 10, Train Loss: 0.5148, Test Loss: 0.4969, Test Acc: 70.8333 Epoch: 11, Train Loss: 0.5079, Test Loss: 0.4777, Test Acc: 80.8333 Epoch: 12, Train Loss: 0.4936, Test Loss: 0.4735, Test Acc: 92.5000 Epoch: 13, Train Loss: 0.4782, Test Loss: 0.4803, Test Acc: 78.3333 Epoch: 14, Train Loss: 0.4583, Test Loss: 0.5844, Test Acc: 66.6667 Epoch: 15, Train Loss: 0.4582, Test Loss: 0.4727, Test Acc: 66.6667 Epoch: 16, Train Loss: 0.4668, Test Loss: 0.4430, Test Acc: 70.0000 Epoch: 17, Train Loss: 0.4332, Test Loss: 0.4147, Test Acc: 84.1667 Epoch: 18, Train Loss: 0.4284, Test Loss: 0.4653, Test Acc: 66.6667 Epoch: 19, Train Loss: 0.4325, Test Loss: 0.4323, Test Acc: 68.3333 Epoch: 20, Train Loss: 0.4156, Test Loss: 0.3859, Test Acc: 94.1667 Epoch: 21, Train Loss: 0.4014, Test Loss: 0.4121, Test Acc: 71.6667 Epoch: 22, Train Loss: 0.3999, Test Loss: 0.4223, Test Acc: 70.0000 Epoch: 23, Train Loss: 0.3759, Test Loss: 0.4708, Test Acc: 67.5000 Epoch: 24, Train Loss: 0.3901, Test Loss: 0.3851, Test Acc: 80.8333 Epoch: 25, Train Loss: 0.3787, Test Loss: 0.3531, Test Acc: 94.1667 Epoch: 26, Train Loss: 0.3712, Test Loss: 0.4013, Test Acc: 80.0000 Epoch: 27, Train Loss: 0.3743, Test Loss: 0.3473, Test Acc: 96.6667 Epoch: 28, Train Loss: 0.3434, Test Loss: 0.3384, Test Acc: 94.1667 Epoch: 29, Train Loss: 0.3495, Test Loss: 0.3420, Test Acc: 92.5000 Epoch: 30, Train Loss: 0.3382, Test Loss: 0.3760, Test Acc: 81.6667 Epoch: 31, Train Loss: 0.3412, Test Loss: 0.3223, Test Acc: 94.1667 Epoch: 32, Train Loss: 0.3257, Test Loss: 0.3147, Test Acc: 94.1667 Epoch: 33, Train Loss: 0.3269, Test Loss: 0.3093, Test Acc: 96.6667 Epoch: 34, Train Loss: 0.3271, Test Loss: 0.3053, Test Acc: 96.6667 Epoch: 35, Train Loss: 0.3087, Test Loss: 0.3014, Test Acc: 98.3333 Epoch: 36, Train Loss: 0.3063, Test Loss: 0.2991, Test Acc: 94.1667 Epoch: 37, Train Loss: 0.2971, Test Loss: 0.3536, Test Acc: 81.6667 Epoch: 38, Train Loss: 0.3078, Test Loss: 0.2928, Test Acc: 94.1667 Epoch: 39, Train Loss: 0.2895, Test Loss: 0.2951, Test Acc: 95.0000 Epoch: 40, Train Loss: 0.2935, Test Loss: 0.2934, Test Acc: 93.3333 Epoch: 41, Train Loss: 0.2944, Test Loss: 0.2785, Test Acc: 97.5000 Epoch: 42, Train Loss: 0.3021, Test Loss: 0.2804, Test Acc: 94.1667 Epoch: 43, Train Loss: 0.2818, Test Loss: 0.2700, Test Acc: 95.8333 Epoch: 44, Train Loss: 0.2870, Test Loss: 0.2658, Test Acc: 96.6667 Epoch: 45, Train Loss: 0.2636, Test Loss: 0.2654, Test Acc: 97.5000 Epoch: 46, Train Loss: 0.2677, Test Loss: 0.2749, Test Acc: 92.5000 Epoch: 47, Train Loss: 0.2657, Test Loss: 0.2645, Test Acc: 96.6667 Epoch: 48, Train Loss: 0.2602, Test Loss: 0.2543, Test Acc: 95.8333 Epoch: 49, Train Loss: 0.2631, Test Loss: 0.2951, Test Acc: 85.0000 Epoch: 50, Train Loss: 0.2698, Test Loss: 0.2473, Test Acc: 96.6667 ![image](/assets/images/2025-10-10-08-56-15.png) ![image](/assets/images/2025-10-10-08-56-22.png) 내가 handcraft로 만든 모델보다 더 안정적으로 loss가 줄어들고 test acc가 증가함을 볼 수 있다. ![image](/assets/images/2025-10-10-08-56-28.png) 직접 그래프 값을 비교해보면, `nn.Module` 을 사용한 모델이 훨씬 loss가 낮고 안정적임을 볼 수 있다. 다만 학습이 점차 진행될 수록 내가 만든 모델도 안정적으로 loss가 수렴해감을 볼 수 있다. 이러한 차이는 `nn.Module` 에서는 ‘Xavier초기화’나 ‘He초기화’같은 기법을 사용하기 때문이다. 이 기법들은 모델의 입력과 출력의 분산을 비슷하게 유지하여, 학습 초기에 Vanishing gradient나 exploding gradient같은 문제가 발생하는것을 막아준다, 결과적으로 모델이 처음부터 안장적인 상태에서 학습을 시작할 수 있게 해주며, 초기부터 낮고 안정적인 Loss를 갖게된다. ```python weights = torch.randn(input_dim, output_dim) bias = torch.zeros(output_dim) ``` 내가 handcraft로 만든 모델은 표준졍구분포를 따르는 랜덤값으로 초기화를 했다. 이런방식을 사용하면 비정상적인 출력값이 Lossfunction을 통과하면 매우 큰 Loss가 계산되어 학습시 안정적이지 않다. → 모델을 만들때는 Xavier초기화를 애용하자. ### [PyTorch][1주차_기본과제_3] Logistic_Regression - Canonical URL: https://hyejunl33.github.io/study/2025-10-07-Logistic_Regression/ - Collection: Study - Published: 2025-10-07 - Tags: Logistic_Regression, 1주차 과제, PyTorch, 과제 # 과제3_Logistic_Regression Pytorch를 이용해서 cars-Purchase Decision데이터에 대해 차량 구매 여부를 예측하는 로지스틱 회귀분석 - 로지스틱 회귀 분석에 필요한 pytorch 구성 요소들을 구현할 수 있다. - 실제 데이터에 대해 로지스틱 회귀 분석을 실시할 수 있다. - 주어진 데이터셋에 맞는 Dataset 클래스를 작성할 수 있다. # Pytorch Dataset 클래스 작성하기 ## Cars 데이터셋을 다루는 Dataset 클래스를 작성하기 ```python import pandas as pd import torch from torch.utils.data import Dataset from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split class CarsPurchaseDataset(Dataset): def __init__(self, file_path="car_data.csv", mode="train"): # file_path에 있는 파일을 읽어서 data로 저장하기 data = pd.read_csv(file_path, sep = ",", header = 0) # x는 두 열을 drop하고, y는 purchased만 가져오기 X = data.drop(columns = ["User ID","Purchased"]) y = data["Purchased"] X['Gender'] = X.Gender.apply(lambda x: 0 if x == "Male" else 1) X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42) scaler = StandardScaler() X_train[['Age','AnnualSalary']] = scaler.fit_transform(X_train[['Age', 'AnnualSalary']]) X_test[['Age','AnnualSalary']] = scaler.transform(X_test[['Age','AnnualSalary']]) # mode에 따라 인자 값 다르게 지정해주기 if mode == "train": self.X = torch.FloatTensor(X_train.values) self.y = torch.FloatTensor(y_train.values).unsqueeze(1) else: self.X = torch.FloatTensor(X_test.values) self.y = torch.FloatTensor(y_test.values).unsqueeze(1) def __len__(self): # len함수를 이용해서 길이 반환 return len(self.X) def __getitem__(self, idx): # idx를 이용해서 해당 idx의 변수를 반환 return self.X[idx], self.y[idx] ``` ## 생성한 데이터셋 객체를 바탕으로 DataLoader 객체를 생성 - 학습용 데이터로더는 배치사이즈를 32로 하고, 랜덤으로 셔플된 데이터가 반환되도록 생성 - 평가용 데이터로더 객체는 배치사이즈를 64로 해서 생성 ```python from torch.utils.data import DataLoader # trainloader와 test_loader를 DataLoader의 인스턴스로 생성 train_loader = DataLoader(train_data, batch_size = 32, shuffle = True) test_loader = DataLoader(test_data, batch_size = 64) ``` # Logistic Regression 모형 작성하고 학습 ## 로지스틱 회귀 모델을 위한 클래스를 작성 ```python import torch.nn as nn class LogisticRegressionNN(nn.Module): def __init__(self, input_size): super(LogisticRegressionNN, self).__init__() # 입력차원은input_size, 출력차원은 1인 Linear 인스턴스 생성 self.linear = nn.Linear(input_size,1) def forward(self, x): # Linear로 forward 함수 정의 return self.linear(x) ``` ```python import torch.optim as optim input_size = 3 model = LogisticRegressionNN(input_size) criterion = nn.BCEWithLogitsLoss() optimizer = optim.Adam(model.parameters(), lr = 0.01) ``` - `input_size`를 hyperparameter로 지정하고, `model`을 인스턴스로 생성한다. - 손실함수로 `BCEWithLogitsLoss()`를 사용한다. - Optimizer로 Adam을 사용하고, Learning rate로 0.01을 준다. ## `train()`함수 완성하기 ```python def train(model, criterion, optimizer, dataloader, device, num_epoch=100): model.train() model.to(device) for epoch in range(num_epoch): epoch_loss = 0.0 for inputs, targets in dataloader: inputs = inputs.to(device) targets = targets.to(device) optimizer.zero_grad() outputs = model(inputs) loss = criterion(outputs, targets) loss.backward() optimizer.step() epoch_loss += loss.item() print(f"Epoch {epoch+1}, Loss: {epoch_loss}") ``` ```python train(model, criterion, optimizer, train_loader, device, 100) ``` ![image](/assets/images/2025-10-07-19-12-16.png) train까지 완성한 후 `train()` 을 돌려보면 epoch마다 loss가 감소하는것을 볼 수 있다. ## 모델평가함수 `test()` ```python def test(model, dataloader): model.eval() correct = 0 # 예측한 레이블이 정답과 일치하는 개수를 저장하기 위한 변수 n_data = 0 # 전체 데이터의 개수를 저장하기 위한 변수 for inputs, targets in test_loader: # inputs,targets를 'cuda'에 올리기 inputs = inputs.to(device) targets = targets.to(device) #모델을 돌려서 y_pred를 뽑기 y_pred = model(inputs) #y_pred에 대해서 0.5보다 크면 1, 아니면 0을 저장 y_pred_class = (y_pred>0.5).float() correct += (y_pred_class == targets).sum().item() n_data += targets.size(0) print(f"accuracy: {correct/n_data}") ``` ```python test(model, test_loader) >>>accuracy:0.785 ``` `test()` 를 이용해서 정확도를 측정해보면 0.785가 나온다. # Scikit-Learn 결과와의 비교 ```python from sklearn.linear_model import LogisticRegression from sklearn.metrics import accuracy_score # 로지스틱 회귀 모델 초기화 및 학습 logistic_regression_model = LogisticRegression() logistic_regression_model.fit(train_data.X, train_data.y) y_pred = logistic_regression_model.predict(test_data.X) accuracy = accuracy_score(test_data.y, y_pred) print(f"Test Accuracy: {accuracy}") >>>Accuracy:0.79 ``` scikit-Learn결과와 비교해보면 비슷하게 적합함을 알 수 있다. ### [PyTorch][1주차_기본과제_2] Linear_Regression - Canonical URL: https://hyejunl33.github.io/study/2025-10-06-Linear-Regression/ - Collection: Study - Published: 2025-10-06 - Tags: 과제2_Linear_Regression, 1주차 과제, PyTorch, 과제 # 과제2_Linear_Regression PyTorch를 이용해서 Boston House Prices 데이터에 대해 주식 가격을 예측하는 Linear Regression - 주어진 데이터를 pytorch 학습에 맞게 전처리할 수 있다. - 선형 회귀 분석에 필요한 pytorch 구성 요소들을 구현할 수 있다. - 실제 데이터에 대해 선형 회귀 분석을 실시할 수 있다. 사용데이터셋: Boston House Prices 보스턴 시의 범죄율, 재산세율, 본인 소유의 주택 가격의 중앙값등 측정된 지표를 포함한 데이터셋 # Boston House Prices 데이터를 저장하고 전처리 하기 ```python import pandas as pd data = pd.read_csv("Boston-house-price-data.csv", sep = ',', header = 0) data.head() ``` `Boston-house-price-data.csv` 파일을 pandas의 `read_csv()` 를 이용해서 불러온다. CSV는 Comma Seperate Values의 약자이므로 `comma`를 sep의 인자로 넘겨주고, header는 0번째 행으로 지정해준다. `data.head()`를 통해 가장 위의 행 5개를 출력한다. ![image](/assets/images/2025-10-07-12-47-19.png) ```python X = data.drop(['MEDV'], axis=1) y = data.MEDV ``` `data.drop()` 을 사용→ `axis = 1` 은 열을 뜻하고, 열에 있는 ‘MEDV’를 drop함 MEDV변수는 종속변수인 y에 저장하고, 나머지 예측변수들을 X에 저장함. ```python from sklearn.model_selection import train_test_split from sklearn.utils import shuffle X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42) X_train, y_train = shuffle(X_train, y_train, random_state=42) ``` `sklearn.model_selection` 에서 train_test_split을 이용해서 train dataset과 test dataset을 나눈다. 이때 보통 train은 60~80%로 설정하고, 나머지를 test dataset으로 설정한다. 미니배치 SGD → 일단 dataset을 shuffle해주고 배치사이즈만큼 데이터를 불러와서 학습을 진행 ```python from sklearn.preprocessing import StandardScaler scaler = StandardScaler() X_train = pd.DataFrame(scaler.fit_transform(X_train), columns=X_train.columns) X_test = pd.DataFrame(scaler.transform(X_test), columns=X_test.columns) ``` 모델에 들어가는 데이터를 정규화해야한다. 따라서 예측변수 X의 test와 train dataset을 `sklearn.preprocessing` 에서 `StandardScaler()`를 이용해서 정규화한다. ```python import torch device = "cuda" if torch.cuda.is_available() else "cpu" X_train_tensor = torch.tensor(X_train.values, dtype = torch.float).to(device) y_train_tensor = torch.tensor(y_train.values.reshape(-1,1), dtype = torch.float).to(device) X_test_tensor = torch.tensor(X_test.values, dtype = torch.float).to(device) y_test_tensor = torch.tensor(y_test.values.reshape(-1,1), dtype = torch.float).to(device) ``` `‘cuda’` 를 사용할 수 있으면 device를 ‘cuda’로 설정하고 `torch.cuda.is_available()` 이 False일때 ‘cpu’로 설정한다. 그리고 `X_train, X_test, y_train, y_test` 를 전에 설정한 device에 올린다. ```python from torch.utils.data import DataLoader, TensorDataset train_dataset = TensorDataset(X_train_tensor, y_train_tensor) train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True) ``` `DataLoader, TensorDataset` 을 이용해서 `train_dataset`을 생성하고, `DataLoader`인스턴스를 `train_loader`로 생성한다. 이때 배치사이즈는 바꿀 수 있고, 여기서는 32로 설정했다. 일반적으로 train에서는 `shuffle`을 True로 설정하고, test에서는 False로 설정한다. # 선형회귀모델 작성하고 학습하기 - **__init**__함수 내에서 인스턴스 `linear`에 `input_size`에 저장된 차원을 받아서 1차원데이터를 반환하는 선형 layer 정의하기 - 위에서 정의한 `linear()` 이용해서 `forward` 함수 정의하기 ```python import torch.nn as nn class MultipleLinearRegression(nn.Module): def __init__(self, input_size): super(MultipleLinearRegression, self).__init__() #input_size만큼 입력을 받아서 1차원 데이터를 반환하는 Linear Layer self.linear = nn.Linear(input_size,1) def forward(self, x): # init에서 정의한 linear인스턴스를 사용 return self.linear(x) ``` `MultipleLinearRegression`클래스는 `nn.Module`을 상속받는다. ```python import torch.optim as optim #Lossfinction으로 MeanSquaredError Loss를 사용함 criterion = nn.MSELoss() # optimizer로는 SGD를 사용 optimizer = optim.SGD(model.parameters(), lr = 0.01)) ``` ```python import numpy as np num_epochs = 2000 # epoch를 2000으로 설정 model.train() # 학습을 위해 모델이 gradient를 저장하도록 설정 for epoch in range(num_epochs): epoch_loss = 0.0 data_num = 0 for inputs, targets in train_loader: # 각 배치마다 반복 optimizer.zero_grad() # 옵티마이저의 gradient 초기화 outputs = model(inputs) # 데이터를 넣었을 때의 모델의 출력값 저장 loss = criterion(outputs, targets) # MSE 손실 계산 loss.backward() # gradient descent 수행 optimizer.step() # SGD 방식의 최적화 진행 epoch_loss += loss.item()*inputs.shape[0] data_num += inputs.shape[0] if (epoch+1) % 100 == 0: # 100번의 epoch마다 학습 데이터의 손실함수 출력 print(f"Epoch {epoch+1}, Loss(RMSE): {np.sqrt(epoch_loss/data_num)}" ``` ![image](/assets/images/2025-10-07-12-47-38.png) epoch이 100단위로 커질때마다 RMSE Loss를 출력한다. 이 학습에서는 epoch이 진행되어도 Loss가 거의 감소하지 않음을 볼 수 있다. RMSE = Root Mean Squared Error: 평균 제곱근 오차 $$\text{RMSE}(y, \hat{y}) = \sqrt{\frac{\sum_{i=0}^{N - 1} (y_i - \hat{y}_i)^2}{N}}$$ ```python b0 = list(model.parameters())[1] b1 = list(model.parameters())[0] ``` 학습한 모델로부터 `model.parameters()` 를 이용해서 모델의 학습가능한 파라미터를 반환할 수 있다. 이때 학습한 모델로부터 intercept(절편) 값을 `b0`에 저장하고, 나머지 변수에 대한 회귀 계수 값을 `b1`(기울기값)에 저장 # Analytic Solution과 비교하기 `sklearn`에서는 `LinearRegression`객체를 지원한다. → 직접 구현안하고 불러와서 간단하게 사용할 수 있다. ```python from sklearn.linear_model import LinearRegression from sklearn.metrics import mean_squared_error ``` `sklearn` 에서 MSE랑, LinearRegression 불러와서 사용할 수 있다. ```python lm = LinearRegression() lm.fit(X_train, y_train) ``` `Im` 으로 불러온 `LinearRegression()` 의 인스턴스를 생성해주고, (X_train, y_train)학습데이터와 정답 레이블 쌍을 모델에 fit시켜준다. ```python y_pred = lm.predict(X_train) rmse = np.sqrt(mean_squared_error(y_train, y_pred)) print(f"Train Loss(RMSE): {rmse}") ``` y_pred를 `predict()` 함수를 이용해서 출력할 수 있고, rmse를 공식으로 정의해서 rmse를 출력한다. ```python print(f"intercept: {lm.intercept_}, tangent: {lm.coef_}") ``` `Im` 모델의 절편(Intercept)항과 기울기(회귀계수)는 인스턴스변수 `intercept_, coef_` 를 통해 접근할 수 있다. ### [PyTorch][1주차_기본과제_1] Tensor의 생성/조작/연산 - Canonical URL: https://hyejunl33.github.io/study/2025-10-06-Tensor-PyTorch/ - Collection: Study - Published: 2025-10-06 - Tags: Tensor의 생성/조작/연산, 1주차 과제, PyTorch, 과제 # 과제1_Tensor의 생성/조작/연산 Pytorch를 이용한 Tensor의 생성/조작/연산에 익숙해지기 - Task 1. Tensor의 자료형 조작 - Task 2. Tensor의 생성 - Task 3. CUDA Tensor와 연산 - Task 4. Tensor의 모양 변경 - Task 5. 유사도 - Task 6. Tensor를 활용한 이미지의 이해(응용) - Task 7. Tensor를 조작하여 이미지 data augmentation 하기(응용) # Tensor의 Data Type 조작 ```python #10.2의 값을 64-bit floating point인 1-D Tensor 't'를 정의 t = torch.tensor(10.2, dtype=torch.float64) print("t: {}".format(t)) #t Tensor의 자료형을 출력하기. print(t.dtype) # t Tensor의 자료형을 32-bit integer (signed)로 변환. t = t.int() # t Tensor의 자료형을 32-bit floating point (signed)로 변환 t = t.float() ``` `tensor.dtpye` : data type을 반환한다. `torch.tensor()` 괄호 안에 있는 리스트나, 스칼라값을 tensor로 만든다. 이때 dtype을 따로 정의해줄 수 있다. `torch.int()` : singed 32bit integer로 torch의 data type 바꿔주기 `torch.float()`: tensor의 datatype을 32bit float으로 바꾸기 - **자료형 변환 후(float → int → float) tensor의 값이 같을까?** float을 int로 변환 후 다시 float으로 변환시키면 소숫점 아래를 버려서 값이 달라지게 된다. # Tensor의 생성 ```python #초기화 되지 않은, [2,4] shape의 tensor를 생성 empty_t = torch.empty(2,4) #empty_t Tensor가 메모리 상에서 고유한 식별자 출력 print(id(empty_t)) print('\n') # empty_t의 요소들에 1로 값을 채워주세요. ones_t = torch.ones_like(empty_t) print('ones_t: {}'.format(ones_t)) # ones_t Tensor가 메모리 고유한 식별자를 출력 print(id(ones_t)) print('\n') #empty_t 의 요소들에 0으로 값 채우기. 단, in-place 방식을 이용 zeros_t = empty_t.zero_() print('zeros_t: {}'.format(zeros_t)) #zeros_t Tensor가 메모리상 고유한 식별자 출력 print(id(zeros_t) ``` `torch.empty(shape)` 초기화 되지 않은 상태로 shape을 지정해서 tensor를 생성 `id(torch)` : torch의 메모라상의 id를 반환함 - **zeros_t의 id와 empty_t의 id가 같고 값이 동일한가?** empty_t에서 inplace방식으로 0을 채워줬기 때문에 id가 같아야 한다. 하지만 ones_t는 `ones_like` 로 생성했기 때문에 id가 다르다. - `torch.fill_`은 초기화 되지 않은 tensor에 다른 데이터로 수정하는 표현이다. → 메모리주소는 그대로고 값만 변경된다. ```python # 크기가 30인 표준정규분포 난수 Tensor를 생성 rand_t = torch.randn(30) #rand_t의 shape 을 출력 print(rand_t.shape) #rand_t가 0차원은 1, 1차원은 3을 가지도록 shape을 변경 v_t = rand_t.view(1,3,-1) print("v_t.shape: {}".format(v_t.shape)) # v_t 와 shape이 같으면서 1으로 채워진 Tensor를 생성 ones_t = torch.ones_like(v_t) ``` `torch.randn(shape)` : shape사이즈만큼의 표준 정규분포 난수 Tensor를 생성 `torch.view(1,3,-1)` depth는 1차원, 행은 3차원, 열은 10차원을 갖도록 변경 view는 메모리구조상 contigious할때만 사용할 수 있으므로, 슬라이싱한 텐서에서는 사용할 수 없음. # CUDA Tensor와 연산 ```python # CUDA가 사용가능한지 출력 print(torch.cuda.is_available()) # 사용가능한 GPU 개수를 출력 print(torch.cuda.device_count) #CUDA device이름 출력 print(torch.cuda.get_device_name(device = 0)) # TODO 3-4) CUDA가 사용 가능하면 'cuda'를, 그렇지 않으면 'cpu'를 device라는 변수명에 대입 device = 'cuda' if torch.cuda.is_available() else 'cpu #arange()이용해서 tensor 생성하기 tensor_1 = torch.arange(0,1000,0.001) tensor_2 = torch.arange(0,10000,0.01) ``` ‘GPU’라는 장치는 없고 `‘cuda’` 아니면 `‘cpu’` 중 하나에 올려서 tensor를 사용해야됨 numpy나 matplotlib을 사용할때는 `to(’cpu’)` 를 이용해서 tensor를 cpu에 올려서 사용하고, 학습이나 추론을 할때는 `to(’cuda’)` 를 이용해서 tensor를 GPU에 올려서 사용해야됨 arange는 `array range` 의 줄임말이라서 arrange로 잘못사용하는것 주의하기 `torch.arange()` :시작범위와 끝범위 stepping을 정의해서 해당 범위의 값을 갖는 tensor를 생성함 ```python def tensor_operations(t1, t2, prt=True): ot1 = t1.clone() ot2 = t2.clone() # 시간측정 start_time = time.time() # in-place 방식을 활용하여 t1에 t2를 더하기 t1.add_(t2) # t1에서 t2를 뺀 후 t3에 대입 t3 = torch.sub(t1,t2) #in-place 방식을 활용하여 t3에 1.2를 곱하기 t3.mul_(1.2) # t3에서 2를 나눈 후 t4에 대입 t4 = torch.div(t3, 2) # in-place 방식으로 t4를 제곱. t4.pow_(2) end_time = time.time() ``` 연산에서 inplace방식을 사용하고싶으면 `add, mul, div, sub` 뒤에 언더스코어(_)를 붙여서 사용하기 두 tensor를 gpu에 올리기 ```python tensor_c1 = torch.tensor(tensor_1).to('cuda') tensor_c2 = torch.tensor(tensor_2).cuda() ``` - tensor가 cpu에 있을때의 연산 시간 ![image](/assets/images/2025-10-07-11-50-56.png) - tensor를 gpu에 올리고 나서 연산시간 ![image](/assets/images/2025-10-07-11-51-02.png) cpu보다 gpu에 올리고 나서 연산이 매우 빨라진 것을 알 수 있다. # Tensor의 Shape 변경 ```python # 0부터 10까지 1씩 증가하는 1-D Tensor를 생성 t = torch.arange(0,10,1) print("t.shape: {}".format(t.shape)) # t Tensor의 shape을 [2, 5]로 변경 reshaped_t = t.reshape(2,5) # reshaped_t Tensor의 shape을 확인하여 출력 print(t.shape) # t Tensor의 shape 을 [2, 5]로 변경 v_t = t.view(2,5) # v_t Tensor의 shape을 확인하여 출력 print(v_t.shape) # v_t Tensor의 contiguous 속성을 확인 print(v_t.is_contiguous()) # v_t Tensor에서 0차원은 전부, 1차원은 0번째 요소부터 3번째까지 slicing sliced_t = v_t[:,:4] #sliced_t Tensor의 contiguous 속성을 확인 print(sliced_t.is_contiguous() ``` `tensor.reshape()` :`view()` 와 다르게 contigious하지 않아도 텐서의 모양을 변경할 수 있지만, inplace방식이 아니라 복사해서 출력하는것이므로 메모리사용량이 많음 `tensor.is_contigious()` :텐서가 메모리상에서 contigious한지 boolean값으로 반환 → 슬라이싱 한 후의 Tensor는 contigious하지 않음 다만 `tensor.contigious` 속성을 사용하면 tensor를 contigious하게 바꿔줄 수 있음 ```python # 0번째 차원은 1, 1번째 차원은 2, 2번째 차원은 2, 3번째 차원은 1, # 4번째 차원은 나머지를 가지도록 sliced_t의 shape을 변경. reshaped_t = sliced_t.reshape(1,2,2,1,-1) print("reshaped_t.shape: {}\n".format(reshaped_t.shape)) # reshaped_t Tensor의 2번째 차원부터 마지막 차원까지 평탄화 flatten_t = torch.flatten(reshaped_t,2) print("flatten_t.shape: {}".format(flatten_t.shape)) print("flatten_t : {}".format(flatten_t) ``` `torch.flatten(tensor,idx)` : tensor의 idx차원부터 마지막 차원까지 평탄화 하기 ```python # 0부터 12까지 1씩 증가하는 1-D Tensor를 생성 t = torch.arange(0,12,1) print("t: {}".format(t)) # t Tensor의 shape을 [2, 2, 3]으로 변경 t = t.reshape(2,2,3) print("t: {}\n".format(t)) # t Tensor의 2번째 차원과 1번째 차원을 바꾸기 transposed_t = t.transpose(2,1) print("transposed_t: \n{}".format(transposed_t)) print("transposed_t.shape: {}\n".format(transposed_t.shape)) # 차원의 축을 변경하지 않고 t Tensor의 shape 을 [2, 3, 나머지]로 변경 reshaped_t = t.reshape(2,3,-1) print("reshaped_t: \n{}".format(reshaped_t)) print("reshaped_t.shape: {}\n".format(reshaped_t.shape) ``` `tensor.transpose(idx_1,idx_2)` : idx_1차원과 idx_2차원을 바꾸기 - Transpose를 적용한 `transposed_t` 와 reshape을 적용한 `reshaped_t` 는 같을까? 결과는 다르고 모양은 [2,3,2]로 같다. transpose는 reshape과 달리 Tensor의 특정한 두 차원의 축을 서로 바꾸는 메서드이기 때문이다. ```python # t Tensor에서 0차원으로 dim이 1인 차원 확장. t = t.unsqueeze(0) print("t.shape: {}".format(t.shape)) # t Tensor에서 2차원으로 dim이 1인 차원 확장. t = t.unsqueeze(2) print("t.shape: {}".format(t.shape)) # t Tensor에서 마지막 차원으로 dim이 1인 차원 확장 t = t.unsqueeze(-1) print("t.shape: {}".format(t.shape) ``` # 유사도 - 맨해튼 유사도 ```python # 맨해튼 유사도를 구하는 함수를 정의 def get_manhattan_similarity(t1, t2): #맨해튼 거리는 L1 norm상에서의 거리 manhattan_distance = torch.norm(t1-t2, p=1) #맨해튼 유사도 공식적용 manhattan_similarity = 1/(1+manhattan_distance) print("manhattan_similarity: {}".format(manhattan_similarity)) # 맨해튼 유사도 return return manhattan_similarity ``` - 유클리드 유사도 ```python # 유클리드 유사도를 구하는 함수를 정의 def get_euclidean_similarity(t1, t2): # 유클리드 거리는 L2 norm 상에서의 거리 euclidean_distance = torch.norm(t1-t2, p=2) #유클리드 유사도 공식 적용 euclidean_similarity = 1/(1+euclidean_distance) print("euclidean_similarity: {}".format(euclidean_similarity)) return euclidean_similarity ``` - 코사인 유사도 ```python # 코사인 유사도를 구하는 함수를 정의 def get_cosine_similarity(t1, t2): #코사인유사도 공식 적용 -> L2 norm 사용 cosine_similarity = torch.dot(t1,t2)/(torch.norm(t1,p=2)*torch.norm(t2,p=2)) print("cosine_similarity: {}".format(cosine_similarity)) return cosine_similarity ``` ```python t1 = torch.tensor([1., 2., 0., 3., 5.]) t2 = torch.tensor([2., 1., 1., 1., 0.]) manhattan_s = get_manhattan_similarity(t1,t2) euclidean_s = get_euclidean_similarity(t1,t2) cosine_s = get_cosine_similarity(t1,t2) ``` t1, t2텐서의 코사인, 유클리디안, 맨해튼 유사도를 구하기 # Tensor를 활용한 이미지의 이해 컬러이미지는 red, green, blue 세개의 채널로 이루어져 있따. 세개의 채널이 조합되어 하나의 컬러 이미지를 출력한다. 반면 흑백 이미지는 하나의 채널만을 가진다. ![image](/assets/images/2025-10-07-11-51-18.png) ```python # numpy array인 image로 부터 Tensor를 생성 img_t = torch.tensor(image) # img_t의 data type을 출력 print(img_t.dtype) >>> torch.uint8 ``` 이미지는 크기만큼 (Height*width)픽셀이 존재하며 하나의 픽셀은 (R,G,B) 세개의 채널을 갖는다. → 이미지는 3차원… # Tensor조작하여 data augmentation하기 ```python def add_random_noise(img_t, scale=30): # img_t와 모양(shape)이 같은 표준정규분포 난수 Tensor를 생성 random_noise = torch.randn_like(img_t.float()) print("random_noise.mean: {:.4f}".format(random_noise.mean())) print("random_noise.std: {:.4f}".format(random_noise.std())) print("random_noise.min: {:.4f}".format(random_noise.min())) print("random_noise.max: {:.4f}\n".format(random_noise.max())) random_noise *= scale # img_t의 자료형을 32-bit floating point로 변환한 후 random_noise를 더해 주기 img_t = img_t.float() noise_added_img = torch.add(img_t,random_noise) # noise_added_img의 모든 값이 0과 255 사이의 값을 가지도록 제한 - cliping noise_added_img = noise_added_img.clip(0,255) # noise_added_img의 자료형을 torch.uint8로 변환 noise_added_img =noise_added_img.type(torch.uint8) print("noise_added_img.min: {}".format(noise_added_img.min())) print("noise_added_img.max: {}\n".format(noise_added_img.max()) ``` - 노이즈가 들어가기전 이미지 ![image](/assets/images/2025-10-07-11-51-29.png) - 노이즈가 들어간 후 이미지 ![image](/assets/images/2025-10-07-11-51-35.png) ```python plt.imshow(add_random_noise(img_t, scale=55) ``` 노이즈의 scale을 조정하면서 노이즈의 변화에 따른 이미지를 시각화 할 수 있다. → noise의 값이 과하지 않도록 값을 제한하는 것이 좋다. 이미지는 `uint8` 로 0~255사이의 값을 가짐을 고려. ![image](/assets/images/2025-10-07-11-51-43.png) ```python img_tp = img_t.transpose(0,1) ``` 0차원과 1차원을 transpose해줌으로써 가로세로 방향을 바꿀 수도 있다. ![image](/assets/images/2025-10-07-11-51-50.png) ### [논문 리뷰] [NLP]_Distributed Representations of Words and phrases and their Compositionality - Canonical URL: https://hyejunl33.github.io/study/2025-10-02-[NLP]_Distributed-Representations-of-Words/ - Collection: Study - Published: 2025-10-02 - Tags: NLP, Representations of Words, Skip gram, Negative sampling, sub sampling, Learning phrases, 논문리뷰 # Introduction - Skip-gram모델을 확장해서 SubSampling과 Negative Sampling을 이용해 학습속도를 향상시키고 vector의 품질을 향상시켰다. - 그리고 학습된 벡터 공간 내에 단어의 의미적, 문법적 관계가 선형적으로 나타남을 입증했다. - 예를들어 vec(”마드리드”) - vec(”스페인”) + vec(”프랑스”) = vec(”파리”)라는것을 밝혀냈다. 즉 스페인의 수도인 마드리드에서 스페인을 빼면 수도라는 정보만 남고, 거기에 프랑스를 추가하면 프랑스의 수도인 파리가 결과로 나오는것이다. 신기하다.. - 구문표현을 학습하여 합성어에서 나타나는 새로운 의미를 학습하는 방법을 제안했다. - 예를들어 “Air”와 “Canada”의 합성어인 “Air Canada”는 항공사 이름이지만, “Air”와 “Canada”의 의미와 다른의미를 가지므로 하나의 구로 묶어서 하나의 단어로 학습한다. ![image](/assets/images/2025-10-02-18-03-55.png) 기존의 skip-gram모델은 `Window_size` 만큼 중심단어의 좌우로 단어를 생성해내는 모델이다. 이 논문에서는 기존의 skip-gram에 더해서 sub-sampling을 제안한다. **sub-sampling**을 통해 2배에서 10배 빠르게 모델을 training시킬 수 있었고, 정확도도 향상되었다. 그리고 Noise Contrastive Estimation(NCE)를 단순화 시킨 버전인 **Negative-sampling**을 이용해서 기존의 Hierarchical-softmax보다 더 단순하고 빠르게 training을 할 수 있게 만들었다. 그리고 각 단어를 벡터공간에서 표현할때, 간단하게 단어vector끼리의 덧셈으로 다른 단어를 표현할 수 있음을 발견했다. 따라서 Embedding된 단어 Vector는 단순히 선형변환을 통해 다른 단어를 나타낼 수있다! 그리고 단어 Vector는 Context를 충분히 포함하고 있음을 PCA로 시각화 할 수도 있다. ![image](/assets/images/2025-10-02-18-04-01.png) # The skip-gram Model ![image](/assets/images/2025-10-02-18-04-07.png) C: Window_size → 중심 단어 왼쪽으로 C개만큼, 오른쪽으로 C개만큼 단어를 형성한다. 최적화하는 목적함수:는 -C에서 C사이에있는 단어들의 평균 $$log$$ 확률을 Maximize하는것이다. ![image](/assets/images/2025-10-02-18-04-18.png) 이때 확률함수로 Softmax를 쓰면 분모에서 Vocab에 있는 모든단어에 대해 미분한 결과를 업데이트 해줘야 하므로 효율적이지 않다.시간복잡도가 $$O(W)$$이다. (W는 vocab의 모든 단어 개수) 따라서 Hierarchical Softmax가 제시되었다. ## Hierarchical Softmax ![image](/assets/images/2025-10-02-18-04-25.png) 전체 어휘가 아닌 이진트리를 사용하여 계산 복잡도를 $$O(W)$$에서 $$O(log_2(W))$$로 줄였다. **Hierarchical softmax**에서는 전체 어휘를 평가하는 대신에 이진트리를 이용해서 $$log_2(W)$$의 node만 평가한다. 이 논문에서는 huffman tree를 사용해서 등장빈도가 높은 단어에 더 짧은 경로를 할당하기 때문에 자주 나오는 단어들을 더 빠르게 학습할 수 있다. ## Negative Sampling Hierarchical softmax의 대안으로 Noise Contrastive Estimation(NCE)라는 기법을 단순화 한것이다. 좋은 모델은 실제 데이터와 노이즈를 구별할 수 있어야 하기 때문에 Postive sample의 확률을 최대화하는것 뿐만 아니라, negative sample의 확률은 최소화하는 방법이다. 기존의 Softmax함수는 Vocab에 있는 단어에 대해 확률을 계산하기 때문에 계산복잡도가 컸지만, Negative Sampling은 간단한 이진분류문제로 바꿔서 문제를 해결한다. Positive Sample과 Negative Sample은 (Word,Word)쌍으로 만들고, Positve는 두 단어간의 연관성이 있는것으로 쌍을 만들고, Negative는 관련이 없는 단어를 무작위로 선택해서 쌍을 만든다. 모델은 이진분류를 통해 Logistic Regression을 통해 데이터가 실제 데이터인지 노이즈인지 구별하며 Training을 한다. ![image](/assets/images/2025-10-02-18-04-35.png) $k$: Negative Sample의 수: 하나의 Positive Sample에 몇개의 Negative Sample을 뽑을지 결정하는 값이다. 논문에서는 작은 데이터셋에서는 $$5≤k≤20$$으로, 큰 데이터셋에서는 $$2<=k<=5$$정도로 값을 설정하는게 유용하다고 한다. $$P_n(w)$$:노이즈 분포: Negative sample을 어떤 확률 분포에서 뽑을지 결정한다. 논문에서는 unigram distribution에서 3/4제곱을 한 분포가 다른 분포들보다 좋은 성능을 보였다고 한다. 이 목적함수를 최대화 함으로써 실제 정답쌍의 내적값을 logit으로 갖는 $$log$$확률을 최대화하고, Negative sample된 오답쌍의 음수값이 커져서 sigmoid값이 1에 가까워지도록 학습을 한다. $$P(오답) = 1 - P(정답) = 1 - σ(v'_wiᵀ v_wI)$$ $$1 - σ(x) = σ(-x)$$임을 활용함 ## Sub-sampling of Frequent Words “in”, “the”, “and” ,”a”같이 데이터 내에 매우 빈번하게 등장하는 단어는 제외 시키는것을 sub-sampling이라고 한다. 예를들어 “the”+”France”는 “France”+”Paris”보다 더 빈번하게 등장하므로 유사도가 더 높을것이다. 이런상황을 막기 위해 매우 빈번하게 등장하는 단어는 아래 식에 의해서 제외시킨다. ![image](/assets/images/2025-10-02-18-04-49.png) $$w_i$$:단어 $$t$$:임계값(threshold) $$f(w_i)$$: 단어의 빈도 $$P(w_i)$$에 따라 너무 많이 등장하는 단어는 버린다. ![image](/assets/images/2025-10-02-18-05-19.png) Neg는 negative sampling을 적용한 모델이고 뒤의 숫자는 하나의 postive sample에 k개의 negative sample을 학습시켰다는 의미이다. 결과를 보면 일반 모델보다 negative-sampling을 하면 성능이 향상됨을 알 수 있다. # Empirical Results 성능을 실험적으로 어떻게 검증하교 비교했을까?> **Analogical Reasoning Task** 유추질문으로 구성됨 `vec("Berlin") - vec("Germany") + vec("France")` 같은 질문이 주어졌을때 결과 vector와 코사인유사도값이 가장 가까운 벡터와 정답레이블을 비교한다. 유추를 하는데는 두가지 범주가 있다. Syntactic analogies(문법적 유추): 예시: “quick”:”quickly” Semantic analogies(의미적 유추): 예시: “국가”:”수도” # Learning Phrases ![image](/assets/images/2025-10-02-18-05-28.png) 개별 단어를 넘어 여러단어가 합성하여 고유한 의미를 갖는 Phrase를 학습할 필요가 있다. 예를들어 New와 york이 합쳐져서 newyork라는 고유한 의미를 갖는 phrases를 만든다. → 이러한 구들은 의미있는 하나의 단위이므로 텍스트 내에서 고유한 토큰으로 대체된다. ![image](/assets/images/2025-10-02-18-05-33.png) 구를 식별하기 위해 모든 n-gram을 사용하는것은 메모리소모가 매우 크기 때문에 위이 수식을 이용해서 threshold보다 높은 쌍을 구로 간주한다. 여기서$$\delta$$는 discounting coefficient로 매우 드물게 등장하는 단어가 높은점수를 받는것을 방지한다. $$count(w_i,w_j)$$:$$w_i$$와 $$w_j$$가 연달아 등장한 횟수 $$score(w_i,w_j)$$: 두 단어가 전체 횟수중 연달아 등장한 횟수가 높을수록 score가 높고, threshold를 넘으면 한 phrase로 간주한다. 일반적으로 이 과정을 2~4회 반복하면서 매번 임계값을 낮추며 여러 단어로 구성된 더 긴 구가 형성될 수 있도록 한다. ### Phrase Skip-Gram Results ![image](/assets/images/2025-10-02-18-05-44.png) 일반적으로 Negative sample size인 k를 높여줄때 더 나은 성능을 보였다. 그리고 Subsampling을 적용했을때 Hierarchical Softmax의 성능이 가장 높아졌다. → Subsample을 적용했을때 학습속도를 높일 뿐 아니라 정확도까지 향상시킬 수 있음을 보여준다. dataset크기를 키워주고 dimension을 키워주니깐 정확도가 72%까지 향상되었다고 한다. 따라서 data의 크기를 키우는게 중요하다고 한다. # Additive Compositionality 단어의 Embedding Vector는 Linear Structure를 가지므로 벡터의 덧셈만으로도 의미있는 결과를 만들어낼 수 있다. → 벡터 연산을 통해 단어의 의미를 조합할 수 있다. ![image](/assets/images/2025-10-02-18-05-50.png) 위의 사진에서는 두 벡터의 선형결합을 통해 가장 연관성 높은 벡터들을 모델이 예측한 값을 볼 수 있다. Training이 진행될수록 Vector들은 단어의 맥락을 학습한다. 일종의 AND함수처럼 양쪽 문맥을 공통적으로 나타내는 벡터를 나타낼 수 있게 된다. # Compareison to Published Word Representations ![image](/assets/images/2025-10-02-18-05-56.png) 기존의 모델들에 비해 가장 아래있는 Skip-Phrase모델은 하루만에 1000dimension을 이용해서 학습을 끝마쳤다. 그럼에도 드문단어(infrequent words)에 대해 가장 가까운 이웃단어들을 보면 다른 모델들에 비해 성능적 우위를 보임을 알 수 있다. Sub-sampling, Negative-sampling, Phrase skipgram을 통해서 Data를 다른 모델에 비해 2~3배 많은 30B를 학습시켰음에도 학습시간을 매우 줄일 수 있었다. # Conclusion - Skip-gram Model Extension: Skip-gram모델을 사용해서 Phrase를 학습하는 방법을 보여주었고, 더 정교한 유추를 할 수 있었다. - Sub-sampling, Negative-sampling을 통해 시간복잡도를 줄일 수 있었고, 정확도 또한 높일 수 있었다. - Additive Compositionality: 단어 벡터들이 단순한 벡터 덧셈으로도 의미있는 결합을 만들 수 있다는 것을 발견했다. - Learning-Phrase: 구를 단일 토큰으로 표현하여 학습하는 방법을 제시해서 낮은 계산복잡도로 더 긴 텍스트를 표현하는 방법을 제공했다. ### [NLP][5주차_기본과제_2] Subword-level Language Model - Canonical URL: https://hyejunl33.github.io/study/2025-10-01-Subword-level_Language_Model/ - Collection: Study - Published: 2025-10-01 - Tags: Subword-level Language Model, 5주차 과제, NLP, 과제 # 과제2_Subword-level Language Model 1. 서브토큰화의 필요성 2. BPE(Byte Pair Encoding)의 구현 3. Transformers 라이브러리를 활용한 서브워드 토큰화 **서브워드 토큰화:** 서브워드 단위로 토큰화를 한다. 각 알파벳 단위로 토큰화를 하면 연산량이 너무 많으므로, 많이 등장하는 BytePair를 묶어서 토큰화를 한 후에 Vocab에 저장 → 단어끼리 token화를 할때에 비해서 ‘UNK’토큰문제가 없음 RNN의 모델을 불러와서 확인해보면 RNN의 매개변수 수보다 임베딩 매개변수의 개수가 훨씬 많다 → 임베딩 매개변수 수를 줄이기 위해서 Subword-tokenization을 도입 **Out-of-Vocab문제 해결:** 학습에서 등장하지 않은 단어는 모두 [UNK]토큰으로 처리되는데, 이러한 토큰을 입력에 넣으면 전체 모델의 성능이 저하된다. ```python import re, collections def get_stats(vocab): pairs = collections.defaultdict(int) for word, freq in vocab.items(): symbols = word.split() for i in range(len(symbols)-1): pairs[symbols[i],symbols[i+1]] += freq return pairs def merge_vocab(pair, v_in): v_out = {} bigram = re.escape(' '.join(pair)) p = re.compile(r'(?' : 5, 'l o w e r ' : 2, 'n e w e s t ':6, 'w i d e s t ':3} num_merges = 10 for i in range(num_merges): pairs = get_stats(vocab) best = max(pairs, key=pairs.get) vocab = merge_vocab(best, vocab) print(best) ``` Counter로 Sentence에서 단어의 개수를 세어서 이를 가중치로 활용함 → voca를 만들때 같은 단어에 대해서 한번만 연산을 해서 효율적임 ## BPE Vocab 만들기 `low, lower, lowst, newst` 단어가 corpus로 주어졌을때 `max_vocab_size`만큼 voca를 만들고, `id2token`으로 리턴하기 sentence의 각 모든 단어 끝에는 ‘_’를 붙여줌 → 단어의 끝임을 표 ```python from typing import List import collections, re # 단어 끝을 나타내는 문자 WORD_END = '_' def build_bpe( corpus: List[str], max_vocab_size: int ) -> List[int]: #단어끝에 언더스코어 붙여주기 #단어 각 알파벳으로 바꿔주기, 단어의 등장빈도를 Counter로 세어서 가중치로 이용하기 words_freq = collections.Counter(corpus) words = {} for word, freq in words_freq.items(): words[' '.join(list(word)) + ' ' + WORD_END] = freq #words에 corpus의 각 단어가 나온 횟수를 Count해서 dict로 저장 print(words) #각 단어에서 나올 수 있는 쌍에 대해서 freq를 가중치로 주는 dict인 pair를 리턴 def get_stats(voca): pairs = collections.defaultdict(int) for word, freq in voca.items(): symbols = word.split() for i in range(len(symbols)-1): #pairs에 freq만큼 가중치를 더해줌 pairs[symbols[i],symbols[i+1]] += freq return pairs def merge_vocab(pair, v_in): v_out = {} #token 두개를 공백으로 연결 bigram = re.escape(' '.join(pair)) #정규표현식 패턴을 컴파일해서 p에 저장 #단어 중간에 있는 경우를 배재하기 위해 단어의 시작과 끝에서만 탐색 p = re.compile(r'(? ab cd e _ ``` 이런식으로 greedy를 이용해서 인코딩을 할 수도 있지만 이 과제에서는 가장 길게 매칭되는 것을 전체 텍스트에 대해 먼저 토큰화하는 방법을 사용 ```python '''Vocab: bcde ab cd bc de a b c d e _ abcde ==> a bcde _ ''' ``` 이 방법은 첫번째 greedy방법보단 느리지만 텍스트를 더 짧게 인코딩할 수 있다. ```python def encode( sentence: str, id2token: List[str] ) -> List[int]: ''' 1. 문장에서 공백을 기준으로 단어를 하나씩 나눠서 리스트로 만들기 2. 리스트에서 for문으로 단어 하나씩 가져오기 3. id2token에서 인덱스 0부터 값 하나씩 가져와서 있는지 확인 일치하면 해당 단어에서 voca부분 없애고 3번 반복 일치하지 않으면 다음 voca에서 찾기 4. 해당단어 끝났으면 len(id2token)-1인 WORD_END를 token_ids에 넣기 5.return token_ids ''' #sentence에서 공백을 기준으로 단어 나눠서 리스트로 만들기 token_ids = [] words = sentence.split(" ") print(words) for word in words: #word에 알파벳이 모두 없어지고, 모두 id와 comma로 바뀔때까지 while문 돌기 while any(char.isalpha() for char in word) == True: #가장 길이가 긴 토큰부터 검사 for token in id2token: token_length=len(token) if token in word: word = word.replace(token,',' + str(id2token.index(token))) # token_ids.append(id2token.index(token)) print(word) break else: #일치하지 않으면 다음 token에서 찾기 continue print(word) word = word.split(",") word.pop(0) word = list(map(int,word)) word.append(len(id2token)-1) print(word) token_ids.extend(word) #extend는 append와 다르게 요소를 개별적으로 추가함. print(token_ids) ### END YOUR CODE return token_ids ``` 1. 문장에서 공백을 기준으로 단어를 하나씩 나눠서 리스트로 만들기 2. 리스트에서 for문으로 단어 하나씩 가져오기 3. id2token에서 인덱스 0부터 값 하나씩 가져와서 있는지 확인 일치하면 해당 단어에서 voca부분 없애고 3번 반복 일치하지 않으면 다음 voca에서 찾기 4. 해당단어 끝났으면 len(id2token)-1인 WORD_END를 token_ids에 넣기 5. return token_ids ![image](/assets/images/2025-10-01-14-59-44.png) test의 iteration마다 print를 찍어보면 가장 긴 token부터 검사하면서 단어안에 token이 있으면 id로 replace해주고, Comma로 단어사이를 구분해줬다. 단어를 모두 id로 바꾼 후 Comma로 `split()` 을 해서 리스트로 저장해서 return해줬다. ## BPE 디코딩 ```python def decode( token_ids: List[int], id2token: List[str] ) -> str: sentence = "" # token을 공백을 기준으로 나눠서 리스트로 만들기 # token_ids = token_ids.split(" ") #token(숫자) 하나씩 불러와서 token으로 바꾼 후 sentence에 추가해주기 for id in token_ids: sentence+=id2token[id] #언더스코어는 공백으로 바꾸기 #언더스코어를 기준으로 리스트로 만들고, 마지막 언더스코어는 공백으로 남았기 때문에 pop()으로 빼준 뒤 다시 join으로 합치기 sentence = sentence.split(WORD_END) sentence.pop() sentence = ' '.join(sentence) print(sentence) ### END YOUR CODE return sentence ``` 인코딩된 id를 token으로 다시 디코딩하기. id에 해당하는 서브워드로 만든 뒤 합치면 됨 ```python '''[ 196 62 20 6 ] ==> [ I_ li ke_ it_ ]==> "I_like_it_" ==> "I like it " ==> "I like it" ''' ``` ### [NLP][5주차_심화과제] Word2Vec구현&Embedding시각화 - Canonical URL: https://hyejunl33.github.io/study/2025-10-02-Word2vec&Embedding/ - Collection: Study - Published: 2025-10-01 - Tags: Word2Vec구현&Embedding시각화, 5주차 과제, NLP, 과제 # 심화_Word2vec구현&Embedding시각화 1. 주어진 단어들을 word2vec 모델에 들어갈 수 있는 형태로 만들기 2. CBOW, skip-gram모델을 각각 구현 및 학습 3. 학습된 Embedding 결과를 PCA와 t-SNE로 시각화 Word2Vec의 개념을 이해하고 CBOW와 skip-gram 모델의 학습 방법 및 차이점을 이해하기 → 모델을 시각화해서 Word Embedding 의미 확인하기 ## Dataset클래스 정의하기 실제 CBOW, skip-gram모델에 들어가기 위한 input을 만들기 위해 Dataset 클래스 정의하기 ```python class CBOWDataset(Dataset): def __init__(self, train_tokenized, window_size=2): self.x = [] self.y = [] for tokens in train_tokenized: for i in range(window_size, len(tokens)-window_size): #주변단어 id리스트인 context 생성 context = [] #중심단어 왼쪽으로 주변단어 넣기 for j in range(window_size,0,-1): context.append(w2i[tokens[i-j]]) #중심단어 오른쪽으로 주변단어 넣기 for j in range(1,window_size+1): context.append(w2i[tokens[i+j]]) #x에다가 주변단어 넣기 self.x.append(context) #y에다가는 중심단어 넣기 self.y.append(w2i[tokens[i]]) self.x = torch.LongTensor(self.x) # (전체 데이터 개수, 2 * window_size) self.y = torch.LongTensor(self.y) # (전체 데이터 개수) def __len__(self): return self.x.shape[0] def __getitem__(self, idx): return self.x[idx], self.y[idx] ``` 실제 모델에 들어갈 input → 주변단어 x, 중심단어 y를 input 쌍으로 만들어줌 `전체 데이터의 개수`: 만들어지는 (x,,y)쌍의 총 개수 `2*window_size` : 하나의 중심단어를 예측하는 데 사용될 주변 단어의 개수 예를들어 `window_size = 2`면 왼쪽2개 오른쪽 2개 ## 모델 Class 구현 `self.embedding, self.linear`를 이용해서 `CBOW, skipgram` 두가지Word2Vec모델을 구현해보자. `self.embedding` : `vocab_size` 크기의 one-hot vector를 특정 크기의 `dim` 차원으로 `embedding` 시키는 layer `self.linear` : 변환된 `embedding vector`를 다시 원래 `vocab_size`로 바꾸는 layer ### CBOW 모델 분포가설에 의해서 문맥을 통해서 의미를 결정하는 모델. 즉 빈칸추론모델 주변단어의 문맥을 파악해서 빈칸의 단어를 예측해 내는 모델이다. **학습과정** - 입력: 중심 단어를 비워두고 중심단어들이 있는 입력과 정답레이블로 구성된 데이터셋을 구축한다. - 임베딩: 각 주변 단어를 임베딩 벡터로 변환한다. - vector 평균화: 모든 주변 단어 벡터들의 평균을 구해서 하나의 ContextVector를 만든다. → RNN과 다르게 순서를 고려하지 않는다. - Prediction: 문맥벡터를 이용해서 중심단어를 vocavulary에서 예측한다. - 학습: prediction과 정답 label을 비교해서 BackPropagation을 진행 ```python class CBOW(nn.Module): def __init__(self, vocab_size, dim): super(CBOW, self).__init__() self.embedding = nn.Embedding(vocab_size, dim, sparse=True) self.linear = nn.Linear(dim, vocab_size) # B: batch size, W: window size, d_w: word embedding size, V: vocab size def forward(self, x): # x: (B, 2W) #입력 배치를 임베딩하기 embeds=self.embedding(x) #vector평균화하기 embeds=torch.mean(embeds,dim=1) #변환된 embedding을 다시 원본 vocab_size로 바꾸기 output=self.linear(embeds) return output ``` `embedding, linear` 는`nn.Module` 에서 가져와서 사용한다. ### Skip-Gram모델 CBOW가 빈칸채우기였다면 skip-gram은 하나의 단어가 주어졌을때 그 주변단어를 Prediction하는 모델이다. **학습과정** - 입력: 문장에서 주변단어 하나를 모델에 입력한다. - 임베딩: 중심단어를 임베딩 벡터로 변환한다. - 예측: 하나의 중심단어 벡터를 이용해 주변에 올 단어들이 무엇인지 prediction한다. - 학습: 모델이 예측한 주변 단어들과 실제 정답 단어들을 비교하여 예측을 더 잘하도록 embedding vector값을 업데이트 한다. skip-gram은 하나의 중심단어에 대해 여러번 예측하고 학습을 진행한다. 예를들어 `window_size=2`일떄 왼쪽 2번째 단어 예측, 왼쪽 1번째 단어예측, 오른쪽 1번째 단어예측, 오른쪽 2번쨰 단어예측… ```python class SkipGram(nn.Module): def __init__(self, vocab_size, dim): super(SkipGram, self).__init__() self.embedding = nn.Embedding(vocab_size, dim, sparse=True) self.linear = nn.Linear(dim, vocab_size) # B: batch size, W: window size, d_w: word embedding size, V: vocab size def forward(self, x): # x: (B) embeds=self.embedding(x) output=self.linear(embeds) return output ``` CBOW모델에서 평균을 구하는 mean이 빠진것 말고는 동일하다 ### CBOW Model Traning ```python from statistics import fmean as mean cbow.train() cbow = cbow.to(device) optim = torch.optim.SGD(cbow.parameters(), lr=learning_rate) loss_function = nn.CrossEntropyLoss() print(len(cbow_loader)) losses = [] for e in range(1, num_epochs+1): print("#" * 50) print(f"Epoch: {e}") for batch in tqdm(cbow_loader): #batch 리스트를 두개의 텐서로 나눈 뒤에 GPU에 올린다. context_ids, target_ids = batch context_ids=context_ids.to(device) target_ids=target_ids.to(device) cbow.zero_grad() log_probs = cbow(context_ids) loss = loss_function(log_probs, target_ids) loss.backward() optim.step() losses.append(loss.item()) print(f"Train loss: {mean(losses)}") print("Finished.") ``` ### skip-gram Model Traning ```python skipgram.train() skipgram = skipgram.to(device) optim = torch.optim.SGD(skipgram.parameters(), lr=learning_rate) loss_function = nn.CrossEntropyLoss() losses = [] for e in range(1, num_epochs+1): print("#" * 50) print(f"Epoch: {e}") for batch in tqdm(skipgram_loader): context_ids, target_ids = batch context_ids=context_ids.to(device) target_ids=target_ids.to(device) cbow.zero_grad() log_probs = cbow(context_ids) loss = loss_function(log_probs, target_ids) loss.backward() optim.step() losses.append(loss.item()) print(f"Train loss: {mean(losses)}") print("Finished.") ``` skipgram과 CBOW의 학습코드는 일반적으로 모델 학습시 사용하는 파이프라인을 따른다. `conetext_id`와 `target_id`로 `batch`에서 받아오고 두 id를 GPU에 올린다. 그 후 모델을 돌려서 prediction값을 뽑아낸 후 사전에 정의한 CrossEntropy Lossfuction으로 loss를 계산한 후 backpropagation을 진행한다. ## 테스트결과 ![image](/assets/images/2025-10-02-10-06-25.png) test단어들의 word embedding이 성공적으로 진행된것을 볼 수 있다. ## Embedding 시각화 학습을 통해 각 단어의 의미를 embedding에 녹여냈지만, 한눈에 알아보기는 어렵다 → 시각적으로 알아볼 수 있게끔 차원축소를 통해 2~3차원으로 낮추어 시각화할 필요가 있다. ### PCA 주성분분석 PCA를 통해 차원축소를 할 수 있다. Scikit-learn의 PCA 모듈을 이용해서 차원축소를 할 수 있다. ![image](/assets/images/2025-10-02-09-55-28.png) ### t-SNE t-SNE는 학습을 통해서 차원축소를 할 때, 가까운 벡터는 더 가깝게, 먼 벡터는 더 멀게 배치를 한다. → 차원은 clustering처럼 embedding들이 군집을 이룬다. ![image](/assets/images/2025-10-02-09-55-38.png) 시각화 결과를 봤을때 PCA보다 비슷한 embedding이 더 군집화 되어있고, 비슷하지 않은 embedding은 더 멀어져있음을 확인할 수 있다. ### [NLP][5주차_기본과제_1] Data_Preprocessing&Tokenization - Canonical URL: https://hyejunl33.github.io/study/2025-09-29-Tokenizer&Voca_Preprocessing/ - Collection: Study - Published: 2025-09-29 - Tags: Data_Preprocessing&Tokenization, 5주차 과제, NLP, 과제 # 과제1_Data_Preprocessing&Tokenization 텍스트 토큰화 및 Vocabuarly작성을 통해 Data_Preprocessing과 Tokenization 익혀보기 # Tokenizer 구현 토큰화는 입력데이터를 자연어 처리 모델이 인식할 수 있는 단위로 변환해주는 방법이다. ```python from typing import List import re def tokenize( sentence: str ) -> List[str]: #소문자로 모두 바꿔주기 sentence = sentence.lower() #정규표현식을 통해 .,!?는 별개의 토큰으로 처리하고,n`t랑 단어는 하나의 토큰으로 split tokens = re.split(r'\s+|([.,!?]|n\'t|\'\w+)', sentence) #빈문자열이나 None을 제외하고 나머지를 tokens에 저장 tokens = [token for token in tokens if token != "" and token != None] print(tokens) return tokens ``` 1. n`t는 하나의 토큰으로 처리되야 한다. 2. . , ! ?의 문장부호는 별개의 토큰으로 처리되어야 한다. 3. 나머지는 띄어쓰기를 기준으로 단어는 하나의 토큰으로 처리되어야 한다. # Vocabulary 만들기 각 토큰을 숫자 형식의 유일한 id로 매핑하기 → Preprocessing과정에서 Vocavulary를 만든다. ```python from typing import List, Tuple, Dict from itertools import chain # [UNK] 토큰 unk_token = "[UNK]" unk_token_id = 0 # [UNK] 토큰의 id는 0으로 처리합니다. def build_vocab( sentences: List[List[str]], min_freq: int ) -> Tuple[List[str], Dict[str, int]]: #문장을 하나의 리스트로 모두 불러오기 all_tokens = list(chain(*sentences)) # 각 토큰의 빈도를 세기 word_counts = {} for word in all_tokens: # 단어가 있으면 1로 초기화, 이미 key에 있으면 1더하기 if word in word_counts.keys(): word_counts[word] += 1 else: word_counts[word] = 1 # 최소빈도인 min_freq보다 val이 큰 단어들을 골라 filtered_words에 넣기 filtered_words = [] for word, count in word_counts.items(): if count >= min_freq: filtered_words.append(word) # id2token 리스트는 모든 토큰이 들어있는 리스트 id2token = [unk_token] + filtered_words # 토큰(word)를 id(idx)로 매핑해서 dict로 만들기 token2id = {} for idx, word in enumerate(id2token): token2id[word] = idx return id2token, token2id ``` # 인코딩과 디코딩 ```python from typing import Callable, List, Dict # [UNK] 토큰 ID unk_token_id = 0 def encode( tokenize: Callable[[str], List[str]], sentence: str, token2id: Dict[str, int] ) -> List[int]: #tokenize함수를 이용해서 sentence를 token을 ㅗ바꾸기 tokens = tokenize(sentence) token_ids = [] # token을 id로 바꾸기, 단어가 없으면 0으로 매핑 for token in tokens: token_id = token2id.get(token, unk_token_id) # id들을 리스트에 append token_ids.append(token_id) return token_ids ``` ```python def decode( token_ids: List[int], id2token: List[str] ) -> str: return ' '.join(id2token[token_id] for token_id in token_ids) ``` 각 id들을 다시 토큰으로 바꿔서 출력함 토큰화 과정에서 공백 및 대소문자 정보를 모두 잃어버리고 UNK토큰으로 인해 사라진 단어들도 있다. ![image](/assets/images/2025-09-29-22-46-03.png) # spacy를 이용한 영어 텍스트 토큰화 및 전처리 spacy는 토큰화 외에도 품사 및 단어의 기본형 정보 등 문장에 대한 많은 정보를 제공한다. → 특히 불용어 리스트도 제공한다. 불용어: 자주 등장하지만 큰 의미가 없는 단어를 의미한다. ```python #불용어들 출력하기 print(spacy.lang.en.stop_words.STOP_WORDS) ``` `{'hereafter', "'m", 'six', 'became', 'must', 'though', 'without', 'are', 'everywhere', 'the', 'thereupon', 'whereafter', 'enough', '’ll', 'yourselves', 'last', 'nor', 'per', 'n’t', 'than', 'front', 'one', 'herein', 'fifteen', 'ca', 'latterly', 'that', 'can', 'along', 'side', 'on', 'among', 'might', 'never', 'ten', 'anyway', 'except', 'both', 'but', 'whence', 'for', 'eleven', 'out', 'if', 'most', 'behind', 'been', 'nowhere', 'show', 'get', '‘ve', 'hereby', 'often', 'thus', 'keep', 'below', 'itself', 'mostly', 'we', 'becomes', 'least', 'which', 'seem', 'many', 'have', 'done', 'she', 'rather', 'who', 'own', 'nothing', 'ever', 'meanwhile', '’m', 'become', 'what', 'within', 'hereupon', 'amount', 'into', 'over', 'against', 'hers', 'third', 'had', 'beyond', '’s', 'across', 'how', 'seeming', 'formerly', 'thereby', 'others', 'three', 'back', 'still', 'only', 'really', 'i', 'toward', 'their', 'seemed', 'together', 'up', "'s", 'her', 'throughout', 'part', 'name', 'were', 'to', 'say', 'thru', 'between', 'therein', '‘m', 'top', 'did', 'whether', 'anyhow', 'may', 'does', 'see', 'his', 'after', 'since', 'just', "n't", 'made', 'somewhere', 'also', 'whose', 'wherein', 'twelve', 'move', 'around', "'ve", 'off', 'be', 'anyone', 'is', 'sometime', 'they', 'my', 'indeed', 'bottom', 'everyone', 'when', 'your', 'our', 'anywhere', 'unless', 'because', 'please', 'nine', 'whereas', 'down', 'well', 'a', '’ve', 'neither', 'amongst', 'some', 'yet', 'its', 'during', 'twenty', 'first', 'hence', 'whom', 'however', 'regarding', 'whole', 'me', 'more', 'thence', 'less', 'several', 'further', 'herself', 'or', 'any', 'has', 'here', 'you', 'seems', 'noone', 'give', 'thereafter', 'nobody', 'used', 'whenever', 'beforehand', 'at', 'myself', '‘s', 'this', 'take', 'no', 're', 'former', 'these', 'either', 'whatever', 'somehow', 'would', 'whereby', 'moreover', 'of', 'five', 'few', 'now', 'quite', 'not', 'through', 'call', 'himself', 'under', 'make', 'someone', 'with', 'whereupon', 'via', 'empty', 'being', 'various', 'alone', '‘ll', 'too', 'do', 'hundred', 'even', "'d", 'anything', 'perhaps', 'from', 'where', 'about', '’re', 'eight', 'becoming', 'none', 'same', 'so', 'ourselves', 'before', 'should', 'sixty', 'then', 'else', 'another', 'full', 'and', 'afterwards', "'ll", 'very', 'until', 'onto', 'serious', 'will', 'mine', 'each', 'it', 'put', 'fifty', 'nevertheless', 'using', 'every', '’d', 'by', 'two', 'him', 'ours', 'elsewhere', 'yours', 'am', 'due', 'all', '‘re', 'sometimes', 'us', 'them', 'everything', 'beside', 'besides', 'he', '‘d', "'re", 'why', 'latter', 'upon', 'other', 'again', 'n‘t', 'themselves', 'otherwise', 'was', 'could', 'cannot', 'yourself', 'whither', 'next', 'an', 'something', 'therefore', 'forty', 'once', 'while', 'there', 'wherever', 'almost', 'although', 'whoever', 'above', 'in', 'those', 'much', 'four', 'already', 'doing', 'as', 'towards', 'always', 'namely', 'go', 'such'}` ## Spacy를 이용한 전처리 및 토큰화 ```python def spacy_tokenize( tokenizer: spacy.language.Language, sentence: str ) -> List[str]: #tokenizer를 통해 token들을 doc에 저장 doc = tokenizer(sentenc) tokens = [] for token in doc: # token이 불용어가 아닐때 if not token.lower_ in spacy.lang.en.STOP_WORDS: #token의 어간(원형)을 tokens에 append하기 tokens.append(token.lemma_) return tokens ``` `token.lower()`를 사용하지 않고 `lower_`를 사용하는 이유는 메서드인 lower를 사용하면 token객체는 lower함수가 없으므로 불가능 → token의 속성인 `.lower_`를 사용해야함 `lemma_` 속성은 token의 어간을 가져오는 속성임 ### spacy를 이용한 인코딩과 디코딩 결과 ![image](/assets/images/2025-09-29-22-45-55.png) ### [CV][4주차_심화과제_1] CNN-Visualization - Canonical URL: https://hyejunl33.github.io/study/2025-09-25-CNN-Visualization/ - Collection: Study - Published: 2025-09-25 - Tags: CNN-Visualization, 4주차 과제, Computer Vision, 과제 # 심화_1:CNN-Visualization CNN Visualization 방법을 구현해보기 VGG-11을 이용해서 CNN의 동작과 학습원리에 대한 직관갖기 - gradient정보가 포함하고 있는 의미를 이해하고, 분석해서 활용 - 모델 디버깅에 필요한 기본 방법들 숙지하기 - PreTrain된 모델을 분석하는 방법, 조작하는 방법에 대해 익히기 ## 파이토치의 자동미분 파이토치는 `autograd` 를 통해 자동 미분을 한다. Tensor에서 `requires_grad = True` 옵션을 주면 파이토치는 Tensor의 연산을 추적해서 `Computational Graph` 를 만든다. → 이 그래프를 저장해서 Gradient를 자동으로 계산한다. `backward()` 를 호출하면 만들어둔 Graph를 거꾸로 올라가며 파라미터에 대한 기울기를 자동으로 계산한다. `.backward()` 가 실행된 후 `requires_grad = True` 로 설정했던 각 Tensor의 `grad` 속성(attribute)에 계산된 기울기값이 저장된다 → grad값 확인하기 이후 파라미터를 업데이트 하는 역할은 optimizer가 별도로 담당한다 ## Data 전처리 pretrain Model: pretrain된 VGG-11 model을 가져온다. inference 용도의 data: 추론용의 이미지셋을 가져와서 사용한다. 이미지를 tensor에서 numpy로 옮기는 함수, numpy에서 tensor로 옮기는 함수를 정의해준다 → PyTorch는 GPU를 사용하고 Numpy는 CPU를 사용하므로 데이터를 옮겨주는 함수 필요함 ## Model definition ```python import torch.nn as nn class VGG11Backbone(nn.Module): """ VGG11의 특징 추출기(backbone) 부분입니다. nn.Module을 상속받아 구현했습니다. """ def __init__(self, in_channels: int = 3): super(VGG11Backbone, self).__init__() # VGG11 아키텍처 정의 # 숫자는 Conv Layer의 출력 채널 수, 'M'은 Max Pooling을 의미합니다. self.vgg_config = [64, 'M', 128, 'M', 256, 256, 'M', 512, 512, 'M', 512, 512, 'M'] # 설정값을 바탕으로 실제 레이어들을 생성합니다. self.features = self._make_layers(in_channels) def _make_layers(self, in_channels: int) -> nn.Sequential: """ vgg_config를 바탕으로 nn.Sequential 모델을 생성하는 헬퍼 함수 """ layers = [] current_channels = in_channels for x in self.vgg_config: if x == 'M': # Max Pooling 레이어 추가 layers.append(nn.MaxPool2d(kernel_size=2, stride=2)) else: # Conv-ReLU 블록 추가 conv2d = nn.Conv2d(current_channels, x, kernel_size=3, padding=1) # inplace=True는 메모리 사용량을 약간 줄여줍니다. relu = nn.ReLU(inplace=True) layers.extend([conv2d, relu]) current_channels = x # 생성된 모든 레이어를 nn.Sequential로 묶어서 반환 return nn.Sequential(*layers) def forward(self, x: torch.Tensor) -> torch.Tensor: """ 순전파(forward pass)를 정의합니다. """ # 입력 텐서 x를 features 레이어에 통과시킵니다. x = self.features(x) return x class VGG11Classification(nn.Module): """ VGG11 Backbone과 Classifier를 결합한 전체 모델입니다. """ def __init__(self, num_classes: int = 1000, in_channels: int = 3): super(VGG11Classification, self).__init__() # 1. Backbone (특징 추출기) self.backbone = VGG11Backbone(in_channels=in_channels) # 2. Classifier (분류기) # VGG11의 backbone 출력은 (batch_size, 512, 7, 7) 형태입니다. self.classifier = nn.Sequential( nn.Linear(512 * 7 * 7, 4096), nn.ReLU(inplace=True), nn.Dropout(p=0.5), nn.Linear(4096, 4096), nn.ReLU(inplace=True), nn.Dropout(p=0.5), nn.Linear(4096, num_classes) ) def forward(self, x: torch.Tensor) -> torch.Tensor: """ 순전파 로직: Backbone -> Flatten -> Classifier """ # 1. Backbone을 통과시켜 특징 맵을 추출합니다. # x shape: (batch_size, 3, 224, 224) -> (batch_size, 512, 7, 7) x = self.backbone(x) # 2. Classifier에 넣기 위해 1차원으로 펼칩니다 (Flatten). # x shape: (batch_size, 512, 7, 7) -> (batch_size, 512 * 7 * 7) x = torch.flatten(x, 1) # 3. Classifier를 통과시켜 최종 클래스 점수(logit)를 얻습니다. # x shape: (batch_size, 512 * 7 * 7) -> (batch_size, num_classes) x = self.classifier(x) return x ``` ## Visualizing Structure VGG11 구조를 Visualization해보자 (1): Module의 parameter개수를 return하는 `get_params_num` 을 구하기 (2): 모델에서 `conv1_filters_data`를 얻는 코드 작성 (3): Activation을 target layer에 시각화하기 위해 hook function을 register하기 - `module.registed_forward_hook(hook_fn)` : 해당 모듈의 activation을 시각화 하기 위해 각 모듈마다 적용되는 `hook_fn` 을 모듈마다 걸어주는 함수 - `Tensor.weight.data` : 해당 텐서의 Weight를 data attribute를 통해 확인하기 - `torch.size()` 토치의 크기 확인하기 ### 1. module의 parameter개수를 반환하는 함수 정의하기 ```python def get_module_params_num(module): param_num = 0 for _, param in module.named_parameters(): param_size = param.numel() param_num += param_size return param_num ``` module의 파라미터를 `module.named_parameters()` 로 가져와서 각 파라미터는 Tensor이므로 Tensor의 메소드인 `numel()` 을 이용해서 텐서에 포함된 전체 원소의 개수(shape에 해당하는 값의 모든 곱)을 더해서 return하기 ### 2. Visualizing conv1 filters 첫번쨰 convolution layer는 RGB형태의 input을 받기 떄문에 첫번쨰 conv1 filter는 RGB image로 변환하여 시각화 할 수 있다. 이후 layer의 filter는 high dimension을 갖기 떄문에 conv layer에 비해 시각화가 어렵다. 해당 layer의 weight를 conv1_filters_data 변수에 할당해서 시각화하기 ```python def plot_filters(data, title=None): '''{filter 데이터를 입력으로 받아서 시각화 하는 함수}''' #VGG11 classification 모델 인스턴스 model = VGG11Classification() model.load_state_dict(torch.load(model_root)) #모델의 backbone의 attribute conv1의 weight를 data로 불러와서 저장 conv1_filters_data = model.backbone.conv1.weight.data plot_filters(conv1_filters_data, title="Filters in conv1 layer") ``` ![image](/assets/images/2025-09-25-17-07-20.png) ### 3. Visualizing model activations Pytorch에서는 hook을 통해서 최종 출력값이 아닌 중간 layer들의 출력값을 얻을 수 있다. → 모델의 원하는 부분에 hook을 건 다음 해당 layer의 출력을 가져올 수 있다. → 각 layer의 activation을 시각화할 수 있다. ```python activation_list = [] def show_activations_hook(name, module, input, output): # conv/relu layer outputs (BxCxHxW) if output.dim() == 4: activation_list.append(output) plot_activations(output, f"Activations on: {name}") ``` `show_activations_hook` 이 함수는 각 layer에 걸어줄 hook함수이다. layer를 거치고 나온 output을 activation list에다가 넣어준 후 이전에 정의해둔 `plot_activations()` 함수에다가 넣으면 각 layer의 heatmap을 볼 수 있다. 이제 각 module에 forward hook을 걸여줘서 layer의 출력값을 시각화해보자. 1. module.register_forward_hook사용 2. `functools.partial` 을 이용해서 함수의 name 인자가 채워진채로 호출하기 이용 ```python #pretrain된 모델을 불러오고 파라미터를 불러와서 float64로 바꿔줌 -> 이미지와 데이터타입 통일 model = VGG11Classification() model.load_state_dict(torch.load(model_root)) model.double() #Hook에 등록할 module담기 module_list = [model.backbone.conv1, model.backbone.bn4_1] module_names = ["conv1", "bn4_1"] #각 module불러와서 register_forward_hook을 이용해서 layer마다 show_activations_hook함수 등록 for idx, (name, module) in enumerate(zip(module_names, module_list)): #functools.partial()을 통해서 name인자가 채워진채로 호출 hook = module.register_forward_hook(functools.partial(show_activations_hook, name)) module.name = name #model에 img를 넣어서 hook함수 실행 -> 결과값은 버림 _ = model(img) ``` conv1 layer와 bn4_1 layer를 거치면서 hook_fn을 거친 결과는 다음과 같다. ![image](/assets/images/2025-09-25-17-07-34.png) ![image](/assets/images/2025-09-25-17-07-40.png) ## Visualizing saliency saliency map을 시각화해보자. saliency map(중요한 맵):CNN에서 각 pixel이 기여하고 있는 정도를 시각화하여 나타낸 것으로 activation map이라고 불림 (1) Input image에 대한 gradient s_y(score at index class_idx)를 return하는 함수 `compute_gradient_score` 만들기 $${\partial s_y \over \partial I}$$를 계산해서 이미지의 class score($$s_y$$)에 대한 gradient를 게산할 수 있다. $$s_y$$는 class $$y$$에 대한 logit이다. (softmax layer를 통과하기 이전의 값) Gradient를 계산한 다음에 해당 값들을 시각화 → input image에 대한 saliency를 확인할 수 있다. ```python def compute_gradient_score(scores, image, class_idx): """ Returns the gradient of s_y (the score at index class_idx) w.r.t the input image (data), ds_y / dI. class_idx에 해당하는 class에 대한 gradient인 s_y를 계산해야 합니다. 전체 class의 개수의 길이를 갖는 scores에서 원하는 index의 score를 s_y로 얻은 다음, 해당 s_y를 back-propagate하여 gradient를 계산하는 코드를 완성해주세요. """ #grad라는 변수를 image tensor와 동일한 모양의 0으로 채워진 텐서로 초기화 grad = torch.zeros_like(image) #목표로 하는 class_idx에 해당하는 스칼라 점수값 선택 s_y = scores[class_idx] #s_y에 대한 모든 파라미터 미분 s_y.backward() #윗줄에서 계산된 image.grad기울기 텐서값을 grad변수로 가져오기 grad = image.grad assert tuple(grad.shape) == (1, 3, 224, 224) #계산된 기울기 grad tensor에서 배치차원(인덱스0)을 제거하고 반환 return grad[0] ``` 계산한 Gradient를 시각화하면 아래사진과 같이 나타난다. ![image](/assets/images/2025-09-25-17-07-51.png) ![image](/assets/images/2025-09-25-17-07-57.png) (2) Grad-CAM을 시각화하기 `vis_gradcam` 함수를 만들자. - Layer의 activation을 저장할 function을 hook하고 forward하기 - gradients를 저장하기 위해 hook을 register하고 출력에 대한 최댓값에 해당하는 score를 backwawrd하기 $${\partial y^c \over \partial A^k}$$를 통해 $$\alpha^k_c$$를 구할 수 있다. $$y^c$$는 class $$c$$에 대한 score이고, $$A^k$$는 target layer인 $$k$$번째 feature map의 Activation이다. $$\alpha^k_c$$를 weight로 하여 forwawrd activation maps$A$의 Weighted sum을 얻고, ReLU를 통과하여 $$L_{Grad-CAM}^c(i.e,ReLU (\sum_k \alpha_c^k A^k)$$를 얻는다. ```python save_feat=[] #output feature를 hook_feat에다가 append해서 모아놓기 def hook_feat(module, input, output): save_feat.append(output) return output save_grad=[] #grad를 save_grad 리스트에다가 append해서 모아놓기 def hook_grad(grad): """ 중간 layer에서 gradient구하기-> 리스트에 append (dy / dA). dy / dA 리턴하기 """ save_grad.append(grad) return grad def vis_gradcam(vgg, img): """ gradcam visualization하는 함수 """ vgg.eval() # (1) Reister hook for storing layer activation of the target layer (bn5_2 in backbone) # hook_feat의 activation을 register_forward_hook을 이용해서 bn5_2에 등록하기 vgg.backbone.bn5_2.register_forward_hook(hook_feat) # (2) Forward pass to hook features # 위에서 hook했으니깐 img forward하기 img = img.unsqueeze(0) s = vgg(img)## FILE ME ## # (3) Register hook for storing gradients # gradients를 저장하기 위해 hook을 register하기 save_feat[0].register_hook(hook_grad) # (4) Backward score # 출력에 대한 최댓값에 해당하는 score를 backward하기 y = torch.argmax(s) s_y = s[0,y] s_y.backward() # Compute activation at global-average-pooling layer # 전역의 average-pooling layer를 통해 activation map 계산 gap_layer = torch.nn.AdaptiveAvgPool2d(1) alpha = gap_layer(save_grad[1][0].squeeze()) A = save_feat[0].squeeze() # (1) Compute grad_CAM # ReLU layer 정의 # (You may need to use .squeeze() to feed weighted_sum into into relu_layer) relu_layer = torch.nn.ReLU() # weighted_sum:forward activations maps인 A의 weighted sum구하기 weighted_sum = torch.sum(save_grad[0].mean(dim=(2,3), keepdim=True) * save_feat[0], dim=1) # RelU 통과시키기 grad_CAM = relu_layer(weighted_sum.squeeze()) grad_CAM = grad_CAM.unsqueeze(0) grad_CAM = grad_CAM.unsqueeze(0) # (2) Upscale grad_CAM # (You may use defined upscale_layer) # grad_CAM 업스케일링 하기 upscale_layer = torch.nn.Upsample(scale_factor=img.shape[-1]/grad_CAM.shape[-1], mode='bilinear') grad_CAM = upscale_layer(grad_CAM) grad_CAM = grad_CAM.squeeze() #plt 이용해서 grad_CAM시각화하기 # Plotting #plt 이용하려면 tensor에서 numpy로 바꿔줘야됨 img_np = image_tensor_to_numpy(img) if len(img_np.shape) > 3: img_np = img_np[0] img_np = normalize(img_np) grad_CAM = grad_CAM.squeeze().detach().numpy() plt.figure(figsize=(8, 8)) plt.imshow(img_np) plt.imshow(grad_CAM, cmap='jet', alpha = 0.5) plt.show return grad_CAM ``` ![image](/assets/images/2025-09-25-17-08-08.png) --- 시각화한 결과 grad_CAM을 시각화해서 Saliency map을 얻어냈다. → 모델의 변형없이 한번의 back_propagation으로 Class activation map을 구함. ![image](/assets/images/2025-09-25-17-22-31.png) ### [CV][4주차_과제_2] Traning ViT with DataAugmentation - Canonical URL: https://hyejunl33.github.io/study/2025-09-23-Traning_ViT_with_DataAugmentation/ - Collection: Study - Published: 2025-09-23 - Tags: ViT, DataAugmentation, 4주차 과제, CV, 과제 # 과제2_Traning ViT with DataAugmentation # Traning ViT with DataAugmentation ## 문제정의 ViT에서 다양한 DataAugmentation을 적용해보기! diverse한 image생성을 통해 overfitting을 방지하고, interpolation(데이터 보간)을 통한 data distribution공간을 dense하게 만드는 효과를 낸다. ## 데이터셋 정보 - CIFAR-10 데이터셋 - 10개의 클래스, 32*32 컬러이미지 - Pytorch Lightning ![](/assets/images/2025-09-23-11-44-20.png) ### 이미지 사이즈 모델에 맞게 변형하기 ```python # Visualize 32x32 image to 224x224 import torchvision.transforms as transforms from PIL import Image import matplotlib.pyplot as plt original_img = train_ds[0]['img'] # 이미지 크기를 224x224로 변환하는 변환기를 정의한다. #CIFAR-10은 32*32의 이미지데이터셋인데, 크기를 resize해줌 transform = transforms.Compose([ transforms.Resize((224, 224)), transforms.ToTensor() ]) # 이미지를 변환 -> Transform을 이용해서 사이즈 키워주기 transformed_img = transform(original_img) # 텐서를 이미지로 변환 transformed_img = transforms.ToPILImage()(transformed_img) # 이미지를 시각화 plt.imshow(transformed_img) plt.axis('off') # 축을 표시하지 않기 ``` 32\*32 이미지를 불러와서 224\*224로 ViT모델에 맞는 크기로 Resize해준 다음 이미지로 변환하기 ### Augmentation을 하는 transforms 정의하기 ```python from torchvision.transforms import (CenterCrop, Compose, Normalize, RandomHorizontalFlip, RandomResizedCrop, Resize, ColorJitter, GaussianBlur, RandomGrayscale, ToTensor) normalize = Normalize(mean=image_mean, std=image_std) #이미지 normalize _train_transforms = Compose( [ # train_dataset에 다양한 Augmentation 적용하기 Resize(size), RandomHorizontalFlip(), RandomResizedCrop(size), ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.2), GaussianBlur(kernel_size=3), #RandomGrayscale(p=0.2), ToTensor() ) _val_transforms = Compose( [ Resize(size), CenterCrop(size), ToTensor(), normalize, ] ) # 모든 train과 val 데이터에 대해서 위에서 정의한 transform을 적용하기 def train_transforms(examples): examples['pixel_values'] = [_train_transforms(image.convert("RGB")) for image in examples['img']] return examples def val_transforms(examples): examples['pixel_values'] = [_val_transforms(image.convert("RGB")) for image in examples['img']] return examples ``` `convert(’RGB’)` 는 ViT의 입력 형식에 맞게 이미지를 RGB채널형태로 변환시키는 역할을 함. → 흑백이미지나 RGBA이미지도 RGB채널로 맞춰줌 ### Visualizing augmentated images ```python viz_data = train_ds[3] original_image = viz_data['img'] augmented_image = viz_data['pixel_values'] transform = transforms.Resize((224, 224)) original_image = transform(original_image) augmented_image = transform(augmented_image) fig, axes = plt.subplots(1,2, figsize=(10,5)) axes[0].imshow(original_image) #첫번째 공간에 original_image 그리기 axes[0].set_title("Original Image") #제목설정 axes[0].axis('off') #불필요한 축 숨기기 axes[1].imshow(augmented_image.permute(1,2,0)) #두번째 공간에 augmented_image 그리기 axes[1].set_title("Augmented Image") #제목설정 axes[1].axis('off') #불필요한 축 숨기기 plt.tight_layout() #subplot간 간격 자동조절 plt.show() ``` ![](/assets/images/2025-09-23-11-42-57.png) 원하는 augmentation이 잘 적용되고 있는지 Visualizing해보는 과정이 필수적이다. → 실수방지, Loss로는 파악하기 힘든 모델의 성능파악 - 이미지의 channel order를 고려해야한다. PyTorch에서는 일반적으로 RGB순서로 학습을 진행하지만 cv2의 경우에는 기본이 BGR이라고 함 → `Permute()`로 채널 순서를 맞춰줘야됨 - 각 dimension이 무엇을 의미하는지도 확인해야된다. cv2는 `(height, width, channel)`순서로 이미지를 처리하지만, torch는 `(batch, channel, height, width)` 순서로 tensor를 입력받는다. → `permute()` 를 통해 channel순서를 바꿔주거나 `sqeeze()` , `unsqueeze()` 등을 통해 dimension을 생성, 제거해줘야됨 - GPU에 올라간 이미지는 numpy, matplotlib, OpenCV를 사용하려면 CPU에올려야됨 - PyTorch(GPU) vs NumPy(CPU) 1. **NumPy, Matplotlib, OpenCV** 등 대부분의 파이썬 과학 라이브러리는 **CPU의 메모리(RAM)**에서만 동작합니다. 이들은 GPU 메모리에 직접 접근하는 방법을 모릅니다. 2. PyTorch 텐서는 **CPU** 또는 **GPU**의 메모리에 위치할 수 있습니다. 또한, PyTorch는 자동 미분(autograd)을 위해 어떤 연산을 거쳤는지 **연산 기록(computation graph)**을 추적할 수 있습니다. → gradient가 계산되는 경우 `detach()` 같은 함수를 사용해야 하는 경우도 있음 cpu에 올리려면 `cpu()` 같은 함수를 써야됨 ### 데이터로더 및 모델정의 `torch.utils.data` 에서 `DataLoader` 를 import하면 DataLoader를 쉽게 생성할 수 있음 LightningModule을 사용해서 모델을 정의해서 사용하기 ### **Train the model with augmented images** - Version_0: `RandomHorizontalFlip(), RandomResizedCrop(size)` 만 적용 - Version_1: Version_0에 `ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.2)`, `GaussianBlur(kernel_size=3)`, `RandomGrayscale(p=0.2)` 추가적용 - Version_2: Version_1에 GrayScale을 뺐음 ![](/assets/images/2025-09-23-11-43-35.png) ![](/assets/images/2025-09-23-11-43-42.png) 기본버전인 version_0이 가장 training_accuracy가 높고, training_loss가 낮음을 알 수 있다. ![](/assets/images/2025-09-23-11-43-51.png) ![](/assets/images/2025-09-23-11-43-57.png) test, validation_accuracy도 같은 맥락으로 version_0에 대해서 가장 잘 예측해냈다. 다양한 Augmentation을 적용했는데도, 강의에서 들었던것과는 다르게 비약적인 성능향상은 없었고, 오히려 성능이 하락했다. 그 원인은 ViT모델의 사전학습된 부분을 고정하고 분류기만 새로 학습하는 Fine-tuning을 했기 떄문인데, ViT의 백본은 고정시킨 상태에서 분류기만 새로 학습하면 augmentation의 효과가 떨어질 수 있다고 한다. Augmentation을 하는 이유는 Feature extractor를 rubust하게 만드는것인데, 이부분이 고정되어 학습이 불가능하기 때문이다. backbone(Feature extractor)이 다양한 변화에도 흔들리지 않고 일관된 특징을 추출하도록 학습해야 하지만, backbone이 고정되고 분류기만 학습하는 경우 이미 특징추출이 끝난 고정된 벡터값만 보게 되므로, 데이터증강의 효과가 떨어진다. ### Augmentation의 순서가 이미지에 미치는 영향 기하적 변환끼리는 순서가 중요하지만, 색상변환과 기하적 변환 사이의 순서는 결과에 미치는 영향이 크지 않다. 대부분의 색상변환은 이미지 전체에 적용되므로 색상변환과 기하변환의 순서는 최종결과물에 큰 영향을 주지 않는다. 하지만 기하적 변환의 순서는 매우 큰 영향을 미친다. ### 색상 변환이 모델 성능 향상에 도움이 되는 이유 색상은 모델의 본질적인 특징이 아니기 때문에, 비본질적인 특징에 과적합되는것을 막기 때문이다. ### [CV][4주차_과제_1] Vision Transformers - Canonical URL: https://hyejunl33.github.io/study/2025-09-23-Vision_Transformers/ - Collection: Study - Published: 2025-09-23 - Tags: ViT, 4주차 과제, CV, 과제 # 과제1_Vision Transformers ![](/assets/images/2025-09-23-11-45-07.png) ## 문제정의 CNN과 달리 ViT는 이미지를 패치로 분할하고, 각 패치를 sequence data로 간주하여 Transformer모델에 입력한다. → CNN에 비해 높은 성능을 발휘한다. ## ViT Inference 파이프라인 ![](/assets/images/![128160932-6c92920e-b996-4208-9f71-c5caeb4d7285.png](128160932-6c92920e-b996-4208-9f71-c5caeb4d7285.png).png) 1. 이미지를 (16\*16) stride를 가지는 2D Conv Filter를 이용해서 224\*224이미지를 14\*14의 패치로 나누기 2. Positional Embedding 더하기 3. Multi-Head Self-Attention을 통해 Encoding 4. MLP Head를 통해 Classification 결과 출력 ## 이미지를 패치로 나누기 ```python Conv2d(3, 768, kernel_size=(16, 16), stride=(16, 16)) ``` `Conv2d()`를 통해 입력 이미지를 768개의 dimension을 가지는 embedding vector로 변환함 ```python import torch.nn as nn #이미지를 패치 임베딩으로 변환하는 클래스 class PatchEmbed(nn.Module): def __init__(self, img_size=224, patch_size=16, in_chans=3, embed_dim=768): super(PatchEmbed, self).__init__() # 이미지 사이즈, 패치사이즈, 그리드사이즈, 패치수 정의 self.img_size = img_size self.patch_size = patch_size self.grid_size = self.img_size // self.patch_size self.num_patches = self.grid_size ** 2 #Conv2d() 이용해서 임베딩 인스턴스 정의 self.proj = nn.Conv2d( in_channels = 3, #RGB out_channels = 768, #임베딩 차원 kernel_size = 16, # 패치 한개의 크기 stride = 16 #다음패치로 넘어가려면 16씩 stride ) def forward(self, x): #Conv2d()의 인스턴스인 proj()를 통해 임베딩 벡터로 변환하고 flatten, transpose하기 x = self.proj(x) x = x.flatten(2).transpose(1, 2) return x ``` ## Position Embeddings 더하기 ```python # Position embedding 유사성 시각화 # 하나의 patch와 다른 모든 patch 간의 cosine similarity를 시각화함 cos = torch.nn.CosineSimilarity(dim=1, eps=1e-6) fig = plt.figure(figsize=(8, 8)) fig.suptitle("Visualization of position embedding similarities", fontsize=24) for i in range(1, pos_embed.shape[1]): ## 현재 패치의 임베딩과 모든 패치의 임베딩 사이에 코사인 유사도 구하기 sim = F.cosine_similarity(pos_embed[0,i:i+1],pos_embed[0,1:])#.detach().cpu().numpy() #유사도 벡터 sim을 패치 그리드 형태로 재배열 sim = sim.reshape((14,14)) #plt를 이용하기 위해 detach한 후 cpu에다 올리기 sim = sim.detach().cpu().numpy() #시각화 ax = fig.add_subplot(14, 14, i) ax.axes.get_xaxis().set_visible(False) ax.axes.get_yaxis().set_visible(False) ax.imshow(sim) ``` ![](/assets/images/2025-09-23-11-45-37.png) ## Transformer Input 생성 학습가능한 class token이 patch embedding vector의 1번째 순서에 합쳐져야 한다. 각 패치들의 Attention결과 값은 버려지고 Class token의 결과값만 MLP Head에 들어간다. ```python transformer_input = torch.cat((model.cls_token, patches), dim = 1) + pos_embed ``` 기존의 패치와 `cls_token` 을 concat한 후, `pos_embed` 을 더한다. ## Transformer Encoder ![](/assets/images/2025-09-23-11-45-46.png) - N = 197(cls_token + patches) embedded vector가 들어감 - qkv에 Multihead attention을 적용하기 위해 12(H)개로 분리 - Attention연산을 거친 후 output을 concat한 후 fc layer통과 ```python # Multi-head attantion을 위해 qkv를 여러개의 q, k, v vector들로 나누기 qkv = transformer_input_expanded.reshape(197, 3, 12, 64) # (N=197, (qkv), H=12, D/H=64) print("split qkv : ", qkv.shape) q = qkv[:, 0].permute(1, 0, 2) # (H=12, N=197, D/H=64) k = qkv[:, 1].permute(1, 0, 2) # (H=12, N=197, D/H=64) kT = k.permute(0, 2, 1) # (H=12, D/H=64, N=197) print("transposed ks: ", kT.shape) ``` ```python # Attention Matrix atten = torch.matmul(q,kT)/8.0 attention_matrix = F.softmax(atten, dim = -1) #attention_matrix = torch.matmul(atten, qkv[:,2].permute(1,0,2)) print("attention matrix: ", attention_matrix.shape) plt.imshow(attention_matrix[3].detach().cpu().numpy() ``` `softmax()` 연산을 거친 attention_matrix를 계산한 후 시각화한다. ![](/assets/images/2025-09-23-11-45-56.png) 각 0~7까지의 Multi head Attention에서 Attend하는부분을 시각화해서 확인하기 ```python # Attention matrix 시각화 fig = plt.figure(figsize=(16, 8)) fig.suptitle("Visualization of Attention", fontsize=24) fig.add_subplot() img = np.asarray(img) ax = fig.add_subplot(2, 4, 1) ax.imshow(img) for i in range(7): # 0-7번째 헤드들의 100번째 줄(row)의 attention matrix 시각화 attn_heatmap = attention_matrix[i, 100, 1:].reshape((14, 14)).detach().cpu().numpy() ax = fig.add_subplot(2, 4, i+2) ax.imshow(attn_heatmap) ``` ![](/assets/images/2025-09-23-11-46-05.png) ## MLP Head ![](/assets/images/2025-09-23-11-46-12.png) Multi-Head Self-Attention을 거친 후 가장 확률이 높은 클래스를 MLP Head에서 예측해낸다. ### [AILifeCycle][3주차_과제_3] Implement_Multi_head_Self-Attention - Canonical URL: https://hyejunl33.github.io/study/2025-09-19-Implement_Multi_head_Self-Attention/ - Collection: Study - Published: 2025-09-19 - Tags: Multi-head Self-Attention, 3주차 과제, AI LifeCycle, 과제 # 과제3_Implement_Multi_head_Self-Attention $$\text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$ - Multi-head Self-Attention의 개념을 이해하고 코드로 구현하기 - Self-Attention의 수식을 이해하고 코드로 구현하기 ```python class MultiHeadSelfAttention(nn.Module): def __init__(self, num_heads, hidden_size): super().__init__() self.num_heads = num_heads self.attn_head_size = int(hidden_size / num_heads) self.head_size = self.num_heads * self.attn_head_size self.Q = nn.Linear(hidden_size, self.head_size) self.K = nn.Linear(hidden_size, self.head_size) self.V = nn.Linear(hidden_size, self.head_size) self.dense = nn.Linear(hidden_size, hidden_size) def tp_attn(self, x): # x의 원래 크기 예시: [batch_size, seq_len, hidden_size] # 예: [1, 10, 768] x_shape = x.size()[:-1] + (self.num_heads, self.attn_head_size) # x_shape -> ([1, 10], (12, 64)) -> [1, 10, 12, 64] x = x.view(*x_shape) # x의 크기 -> [1, 10, 12, 64] # 2단계: permute (Transpose) - 계산을 위해 축 순서 바꾸기 return x.permute(0, 2, 1, 3) # x의 최종 크기 -> [1, 12, 10, 64] def forward(self, hidden_states): Q, K, V = self.Q(hidden_states), self.K(hidden_states), self.V(hidden_states) Q_layer, K_layer, V_layer = self.tp_attn(Q), self.tp_attn(K), self.tp_attn(V) attn = torch.matmul(Q_layer, K_layer.transpose(-1, -2)) / math.sqrt(self.attn_head_size) attn = nn.Softmax(dim=-1)(attn) output = torch.matmul(attn, V_layer) output = output.permute(0, 2, 1, 3).contiguous() output_shape = output.size()[:-2] + (self.head_size,) output = output.view(*output_shape) Z = self.dense(output) ``` ### 1. `init(self, num_heads, hidden_size)` 다양한 subspace의 contextualization을 위해 Multi Head Attention을 사용해야 한다. init에서는 heads 수와 출력의 dimension인 hidden_size를 매개변수로 입력받는다. Query, Key, Value벡터를 nn모듈의 Linear메소드를 이용하여 생성한다. 이때 Q, K, V벡터는 각각의 서로다른 가중치 행렬$W_Q, W_K, W_V$를 가져야 하므로 각각 `nn.Lienar` 연산을 해준다. 이때 `nn.Linear()` 의 input size는 `hidden_size` 고, output size는 head_size인데, head_size = self.num_heads *int(hidden_size / num_heads).이므로 hidden_size와 같음을 알 수 있다. 일단 Multi-head Attention에 사용할 모든 Weight를 concat한 형태로 초기화 한 후 나중에 Heads수만큼 Weight를 쪼개서 사용한다. `self.dense = nn.Linear(hidden_size, hidden_size)` 이코드는 Z를 출력할때, Softmax(QK)V를 nn.Linear연산을 해주는 dense를 정의해준다. ### 2. `def tp_attn(self, x):` Multi-Head Attention 계산을 위해 하나로 합쳐진 Q, K, V텐서를 각 헤드별로 분할하고 계산에 적합한 형태로 재배열 한다. Transpose for Attention이며, 텐서의 차원을 바꾸는 전처리 역할을 한다. `x_shape = x.size()[:-1]` `+ (self.num_heads, self.atten_head_size)` `x` 텐서는 `[배치 크기, 시퀀스 길이, hidden_size]` 형태를 가진다. (예: `[1, 10, 768]`) `x.view(*x_shape)`를 통해 이 텐서의 마지막 `hidden_size` 차원을 `(num_heads, attn_head_size)` 차원으로 쪼갠다. (예: `768` -> `12 x 64`) **결과**: 텐서는 `[배치 크기, 시퀀스 길이, 헤드 수, 헤드별 차원]` 형태가 된다. (예: `[1, 10, 12, 64]`) ### 3. `def forward(self, hidden_states):` `self.tp_atten()` 함수를 이용해서 헤드별로 쪼갠 Q, K, V를 Q_layer, V_layer, K_layer로 받는다. 그 후 $$\text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$연산을 진행한다. 이때 Q와 K의 차원을 맞춰주기 위해 K벡터를 transpose해준다. 이후에 output을 `permute` 를 이용해서 `[배치, 헤드 수, 시퀀스 길이, 헤드차원]` 에서 `[배치, 시퀀스 길이, 헤드, 차원]` 으로 바꾼다. → 이렇게 해서 여러 헤드에서 나온 헤드와 헤드차원을 나란히 붙여서 view로 concat할 수 있게 한다. → 헤드*헤드차원으로 concat하면 텐서의 shape이 output _shape에 맞게 변경된다. ### [AILifeCycle][3주차_과제_2] BackPropagation with Numpy - Canonical URL: https://hyejunl33.github.io/study/2025-09-18-BackPropagation-with-Numpy/ - Collection: Study - Published: 2025-09-18 - Tags: Back Propagation, 3주차 과제, AI LifeCycle, 과제 # 과제2-BackPropagation-with Numpy MNIST데이터셋 분류를 위한 Two-layer Fully-connected neural network 구현하기 MNIST는 손글씨 이미지 데이터셋이다. 이를 대상으로 두개의 레이어를 갖는 CNN을 구현한다. 이때 PyTorch같은 딥러닝 프레임 워크를 이용하지 않고 Numpy연산만으로 Forward와 BackPropagation을 구현해보자. - 모델구현 - 모델 학습 및 평가 $$\hat{Y} = softmax(\sigma(X\cdot W_1+b_1)\cdot W_2 + b_2)$$ 두개의 레이어를 통해 CNN을 구현해보자 ```python import numpy as np import matplotlib.pyplot as plt ``` ```python def sigmoid(z): return 1/(1+np.exp(-z)) def softmax(X): logit=np.exp(X-np.amax(X,axis=1, keepdims = True)) return logit/np.sum(logit, axis = 1, keepdims = True) ``` ### softmax 함수 코드 설명 오버플로우를 방지하기 위해서 X의 각행(`axis = 1`)에서 각 행의 최댓값을 빼준다. `keepdims=True` 를 통해서 최댓값을 계산한 후에도 배열의 차원을 `(N,1)` 로 유지시켜 준다. → 이렇게 해야 X에서 열벡터를 빼는 브로드캐스팅 연산이 올바르게 일어난다. 분모는 분자의 모든 값들을 각 행 별 총합을 모두 더해준다. 이때도 `keepdims = True` 를 통해 브로드캐스팅이 가능하도록 Shape을 `(N,1)` 로 유지시켜준다. ## 2-Layer Neral Network ```python class TwoLayerNN: def initialize_paramter(self, input_dim, num_hiddens, num_classes): W1 = np.random.uniform(low = -np.sqrt(6/(input_dim+num_hiddens)), high = np.sqrt(6/(input_dim+num_hiddens)), size = (input_dim, num_hiddens)) W2 = np.random.uniform(low = -np.sqrt(6/(num_hiddens+num_classes)), high = np.sqrt(6/(num_hiddens+num_classes)), size = (num_hiddens, num_classes)) b1 = np.zeros((num_hiddens)) b2 = np.zeros((num_classes)) return {'W1':W1, 'W2':W2, 'b1':b1, 'b2':b2 def forward(self,X): z1 = X@self.params['W1'] + self.params['b1'] a1 = sigmoid(z1) z2 = a1@self.params['W2'] + self.params['b2'] y = softmax(z2) ff_dict = {'z1':z1, 'a1':a1, 'z2':z2, 'y':y} return y, ff_dict def backward(self, X, Y, ff_dict): # Loss: cross-entropy, y_hat = softmax(z2) dl_dz2 = (ff_dict['y']-Y) / X.shape[0] dl_db2 = np.sum(dl_dz2, axis = 0) dl_dW2 = ff_dict['a1'].T @ dl_dz2 dl_da1 = dl_dz2 @ self.params['W2'].T dl_dz1 = dl_da1 * ff_dict['a1'] * (1-ff_dict['a1']) dl_db1 = np.sum(dl_dz1, axis = 0) dl_dW1 = X.T @ dl_dz1 return {'dl_dW1':dl_dW1, 'dl_db1':dl_db1, 'dl_dW2':dl_dW2, 'dl_db2':dl_db2 ``` xavier초기화의 목표는 가중치 행렬 $W$의 분산을 아래와 같이 설정하는게 목표다. $$Var(W) = \frac{2}{n_{in} + n_{out} }$$ 분모의 in, out은 입력뉴런의 수, 출력뉴런의 수이다. ($d_{in}, d_{out}$) 이때 `np.random.uniform` 균등분포를 사용하므로 `-limit, limit` 내에서 모든 수가 나올 확률이 동일한 균등분포에서 값을 샘플링 해야한다. 균둥분포의 두 범위를 xavier초기화의 목표 분산에 맞게 설정하면 `limit` 는 $$\sqrt{\frac{6}{n_{in}+n_{out}}}$$이 됨. $$Var(W) = \frac{(limit - (-limit))^2}{12} = \frac{(2*limit)^2}{12} = \frac{limit^2}{3}$$ $$\frac{2}{n_{in}+n_{out}}=\frac{limit^2}{3}$$ ```python def train_step(self, X_batch, Y_batch, batch_size, lr): _, ff_dict = self.forward(X_batch) grad = self.backward(X_batch, Y_batch, ff_dict) self.params['W2'] = self.params['W2'] - lr * grad['dl_dW2'] self.params['b2'] = self.params['b2'] - lr * grad['dl_db2'] self.params['W1'] = self.params['W1'] - lr * grad['dl_dW1'] self.params['b1'] = self.params['b1'] - lr * grad['dl_db1'] ``` X_batch를 forward 후 backward시킨 grad를 이용해서 파라미터들을 lr을 이용해서 업데이트한다. ```python def evaluate(self, Y, Y_hat): N = Y.shape[0] return np.sum(np.argmax(Y, axis = 1) == np.argmax(Y_hat, axis = 1)) / ``` Y는 (N,C)형태로 C개의 클래스를 갖는 원핫 인코딩이 N개 있는 형태이다. 데이터 수는 `Y.shape[0]` 이고, 한번 배치를 돌때마다 N개씩 데이터를 본다. `evaluate` 함수는 정확도를 return하므로 원핫백터 Y의 argmax인 정답과 예측값인 $\hat{Y}$의 가장 확률이 높은 클래스가 같다면 맞은 케이스이므로 sum해준다. 이를 N으로 나눠주면 정확도를 측정할 수 있다. ```python # 모델 인스턴스화 model = TwoLayerNN(input_dim=784, num_hiddens=128, num_classes=10) ``` ```python # 모델 훈련 및 평가 ( w. val data ) lr = 0.01 n_epochs = 100 batch_size = 256 model.train(X_train, Y_train, X_valid, Y_valid, lr, n_epochs, batch_size) ``` lr을 처음에는 0.00001로 설정했는데, 너무 작으니깐 학습이 너무 느리게 일어났다. 그래서 0.01로 설정하니, loss와 acc가 초기에 큰폭으로감소하는것을알수 있었다. ![](/assets/images/![image.png](image.png).png) epochs를 너무 크게 주면 overfitting이 일어나서 train과 valid loss와 acc가 큰차이가 나야하지만, 100으로 주었기 때문에 적절한 수준에서 학습이 일어났고, train data와 valid data간의 유의미한 acc와 loss차이는 없었다. ```python # 모델 평가 ( w. test data ) Y_hat, _ = model.forward(X_test) test_loss = model.compute_loss(Y_test, Y_hat) test_acc = model.evaluate(Y_test, Y_hat) print("Final test loss = {:.3f}, acc = {:.3f}".format(test_loss, test_acc) #Final test loss = 0.304, acc = 0.915 ``` 최종적으로 loss는 0.3, acc는 0.9가 나왔다. MNIST는 보통 0.98정도까지 acc를 올릴 수있다고 하는데, sigmoid함수를 activation Function으로 사용해서 학습이 잘 일어나지 않은것 같다. 아래에서 ReLU를 Activation Function으로 사용한 후 학습을 시켜보니 학습이 더 빠르고, 정확도가 더 높은 결과가 나옴을 알 수 있었다. ![](/assets/images/2025-09-18-14-46-04.png) ```python Y_hat, _ = model_relu.forward(X_test) test_loss = model_relu.compute_loss(Y_test, Y_hat) test_acc = model_relu.evaluate(Y_test, Y_hat) print("Final test loss = {:.3f}, acc = {:.3f}".format(test_loss, test_acc) #Final test loss = 0.165, acc = 0.952 ``` ### [AILifeCycle][3주차_과제_1] Linear Regression with Numpy - Canonical URL: https://hyejunl33.github.io/study/2025-09-18-Linear-Regression-with-Numpy/ - Collection: Study - Published: 2025-09-18 - Tags: Linear Regression, 3주차 과제, AI LifeCycle, 과제 # 과제1. Linear Regression with Numpy 대기오염 데이터셋.CSV를 불러와서 PM10과 PM25사이의 Linear Regression 진행하기 ```python import itertools import numpy as np import pandas as pd import seaborn as sns import matplotlib.pyplot as plt import warnings ``` ```python from google.colab import drive drive.mount('/content/drive') ``` ```python dataset = pd.read_csv("파일경로", on_bad_lines = "skip") #판다스의 read_csv로 csv파일을 불러올 수 있고, on_bad_lines:로 규칙에 맞지 않는 행은 스킵할 수 있다. dataset.head() #가장 위의 5줄 불러오기 ``` ```python sns.scatterplot(x = dataset['PM10'], y = dataset['PM25']) plt.show() ``` `seaborn`라이브러리의 `scatterplot`으로 x축에 그릴값, y축에 그릴 값을 지정해줄 수 있고, `matplotlib.show()`로 시각적으로 출력할 수 있다. ```python data = dataset.dropna(subset=['중요한 열']) ``` 중요한열을 subset으로 설정해서 중요한 열이 없는 행은 지워버린다. → 중요한 열을 바탕으로 LInear Regression을 할꺼니까 중요한 열이 없는 행은 drop해버림 ```python # 데이터셋을 train셋과 test셋으로 분할 def train_test_split(data, test_size=0.2, random_state=None): if random_state: np.random.seed(random_state) # 데이터프레임의 인덱스를 permutation으로 섞기 indices = np.random.permutation(len(data)) """ data.shape은 [헹,열]형태의 리스트다. 따라서 행의 수는 shape[0]임 """ test_samples = int(data.shape[0] * 0.2) # 위에서 구한 test_samples로 랜덤한 수 리스트인 indices에서 수를 슬라이싱선택 test_indices = indices[:test_samples] train_indices = indices[test_samples:] """ data중 중요한 열만 선택해서 iloc을 이용해서 리스트를 이용해서 data 슬라이싱 만약 열이름으로 슬라이싱 하고싶으면 loc이용하기 - pandas """ train_data = data[['PM10', 'PM25']].iloc[train_indices] test_data = data[['PM10','PM25']].iloc[test_indices] return train_data, test_data train_data, test_data = train_test_split(data) ''' X는 2차원 배열로 변환해서 사용해야됨 -> reshape(-1,1)해주기 ''' X_train = np.array(train_data['PM10']).reshape(-1, 1) y_train = np.array(train_data['PM25']) X_test = np.array(test_data['PM10']).reshape(-1, 1) y_test = np.array(test_data['PM25']) ``` ```python class LinearRegression: def __init__(self): self.weights = None self.bias = None def fit(self, X, y): ''' [W, [X, 이렇게 행렬곱으로 나타낼 수 있는데, bias를 W랑 같은 행렬에 있도록 해서 추가함 b] 1] 여기서는 hstack을 이용해서 수평으로 X랑 bias를 위한 특성인 1을 stack함 ''' X = np.hstack((np.ones((X.shape[0], 1)), X)) """ 최소 제곱법(closed form) """ self.weights = np.linalg.pinv(X.T @ X) @ X.T @ y """ weights의 첫 번째 값에는 맨 처음에 X에 추가한것처럼 bias가 있고, 1번째부터는 weights가 있음 """ self.bias = self.weights[0] self.weights = self.weights[1:] def predict(self, X): # X에 절편 항 추가 X = np.hstack((np.ones((X.shape[0], 1)), X)) """ bias랑 weights 수평으로 쌓은다음에 X랑 내적하면 pred나옴 """ y_pred = X.dot(np.hstack(([self.bias], self.weights))) return y_pred ``` ### X에 절편(bias) 항 추가하기 `fit` 메소드 안의 코드를 보겠습니다. `X = np.hstack((np.ones((X.shape[0], 1)), X))` 선형 회귀의 수학식은 y=w_1x_1+w_2x_2+⋯+b 입니다. 여기서 b는 **편향(bias)** 또는 **y절편(intercept)**이라고 불리는 항입니다. 이 식을 행렬 연산으로 한 번에 처리하기 위해, b를 가중치의 일부처럼 취급하는 트릭을 사용합니다. 즉, y=w_1x_1+w_2x_2+⋯+w_0x_0 으로 식을 바꾸는 것이죠. 여기서 w_0이 b가 되고, x_0는 **항상 1인 가상의 특성(feature)**이 됩니다. `np.ones((X.shape[0], 1))` 코드는 바로 이 **값이 1인 가상의 특성 열**을 만드는 부분입니다. - `X.shape[0]`은 X의 행 개수(데이터 샘플의 수)를 의미합니다. - `np.ones(...)`는 이 행 개수만큼 1로 채워진 열 벡터를 생성합니다. 그리고 `np.hstack`를 이용해 이 **'1로 채워진 열'**을 원래의 데이터 **`X`의 맨 앞에 수평으로 붙여주는 것**입니다. 결과적으로 모든 데이터 샘플에 x_0=1 이라는 특성이 추가되고, 우리는 나중에 이 x_0에 곱해지는 가중치 w_0를 찾아내기만 하면 됩니다. 그 w_0가 바로 bias가 되는 것이죠. --- ### Bias와 가중치(Weights) 추출하기 `self.weights = np.linalg.pinv(X.T @ X) @ X.T @ y` 이 코드는 **정규방정식(Normal Equation)**을 사용하여 최적의 가중치 벡터를 한 번에 계산합니다. 여기서 계산된 `self.weights`는 **bias에 해당하는 가중치(w_0)를 포함**하고 있습니다. 위에서 1로 채워진 열을 맨 앞에 붙였기 때문에, 계산된 가중치 벡터 `self.weights`의 **맨 첫 번째 값**이 바로 bias(w_0)가 됩니다. 1. `self.bias = self.weights[0]` - Python 리스트나 Numpy 배열에서 `[0]`은 첫 번째 원소를 의미합니다. 따라서 이 코드는 가중치 벡터의 첫 번째 값(bias)을 `self.bias` 변수에 저장합니다. 2. `self.weights = self.weights[1:]` - `[1:]`는 **"1번 인덱스부터 끝까지"**를 의미하는 슬라이싱(slicing)입니다. - 따라서 이 코드는 첫 번째 원소(bias)를 제외한 나머지 원소들, 즉 **순수한 특성(feature)들에 대한 가중치(w_1,w_2,…)** 만을 다시 `self.weights` 변수에 덮어씌웁니다. 결과적으로 `self.bias`에는 절편 값이, `self.weights`에는 각 특성에 곱해질 가중치 값들이 분리되어 저장됩니다. ```python model = LinearRegression() model.fit(X_train, y_train) #model 인스턴스로 불러온 다음에 fit메서드로 Xtrain, ytrain넘겨줘서 학습킴 predictions = model.predict(X_test) #predict메서드에 X_test넘겨줘서 predictions 생성 ``` ```python def mean_squared_error(y_true, y_pred): # 제곱오차 구하기 squared_errors = (y_true - y_pred)**2 # 제곱오차 평균내서 평균 제곱오차 구하기 mse = np.mean(squared_errors) return mse ``` $$MSE = \frac{1}{n}\Sigma_{i=1}^{n}(y_i - \hat{y}_i)^2$$ ```python def r_squared(y_true, y_pred): #실제 값의 평균 mean_y_true = y_true / len(y_true) #총 제곱합(TSS)을 계산 tss = np.sum((y_true - mean_y_true)**2) #잔차 제곱합(RSS)을 계산 rss = np.sum((y_true - y_pred)**2) #결정 계수를 계산 r2 = 1- (rss / tss) return r2 ``` $$R^2 = 1 - \frac{\sum_{i=1}^{n} (y_i - \hat{y}_i)^2}{\sum_{i=1}^{n} (y_i - \bar{y})^2}$$ ```python plt.scatter(X_test, y_test, color='blue', label='Data') # Scatter plot """ 회귀선을 그리는 아래 코드의 빈칸을 채워 완성해주세요. """ plt.plot(X_test, predictions, color='red', label='Regression Line') for i in range(len(X_test)): plt.plot([X_test[i], X_test[i]], [y_test[i], predictions[i]], color='gray', linestyle='--', linewidth=0.5) plt.xlabel('PM10') plt.ylabel('PM2.5') plt.title('Scatter plot with Regression Line') plt.legend() plt.grid(False) plt.show() ``` ![](/assets/images/2025-09-18-14-04-58.png) PM10을 X축으로, PM2.5를 y축으로 한 뒤 두 값의 선형회귀 선을 빨간색으로 나타내었다. ### [논문 리뷰]_[NLP]_Attention Is All You need (2017) 심층 분석 - Canonical URL: https://hyejunl33.github.io/study/2025-09-15-Attention-is-All-you-Need/ - Collection: Study - Published: 2025-09-15 - Tags: NLP, Transformer, Attention, 논문리뷰 ## 목차 1.  [서론: 기존 RNN 기반 모델의 한계](#1-서론-기존-rnn-기반-모델의-한계)     -   [순차적 처리와 병렬화의 부재](#순차적-처리와-병렬화의-부재)     -   [장기 의존성 문제](#장기-의존성-문제-long-range-dependency) 2.  [Transformer: Attention만을 이용한 새로운 접근](#2-transformer-attention만을-이용한-새로운-접근) 3.  [모델 아키텍처 (Model Architecture) 심층 분석](#3-모델-아키텍처-model-architecture-심층-분석)     -   [전체 구조: 인코더-디코더](#전체-구조-인코더-디코더)     -   [인코더(Encoder) 상세 구조](#인코더encoder-상세-구조)     -   [디코더(Decoder) 상세 구조](#디코더decoder-상세-구조) 4.  [어텐션 메커니즘 분석](#4-어텐션-메커니즘-분석)     -   [Scaled Dot-Product Attention](#scaled-dot-product-attention)     -   [Multi-Head Attention](#multi-head-attention)     -   [Positional Encoding: 순서 정보의 주입](#positional-encoding-순서-정보의-주입)     -   [Add & Norm: 잔차 연결과 층 정규화](#add--norm-잔차-연결과-층-정규화) 5.  [학습 및 실험 결과](#5-학습-및-실험-결과)     -   [학습 방법](#학습-방법)     -   [성능 평가 (BLEU Score)](#성능-평가-bleu-score)     -   [모델 복잡도 비교](#모델-복잡도-비교) 6.  [결론](#6-결론) --- ## 1. 서론: 기존 RNN 기반 모델의 한계 `Attention Is All You Need` 논문이 등장하기 전, 자연어 처리(NLP), 특히 기계 번역 분야는 **RNN(Recurrent Neural Network)** 과 이를 개선한 LSTM, GRU 기반의 Seq2Seq 모델이 주를 이뤘다. 이 모델들은 시퀀스 데이터 처리에 효과적이었지만, 다음과 같은 명확한 한계를 지니고 있었다. ![](/assets/images/2025-09-16-23-08-07.png) ![](/assets/images/2025-09-16-23-08-28.png) ### 순차적 처리와 병렬화의 부재 RNN은 이전 타임스텝의 은닉 상태(\\({h_{t-1}}\\))를 현재 타임스텝(\\({t}\\))의 입력으로 사용하는 순환 구조를 가진다. 이는 데이터의 순서 정보를 자연스럽게 처리할 수 있는 장점이 있지만, **순차적으로만 계산이 가능**하다는 치명적인 단점을 야기한다. 이로 인해 GPU의 장점인 병렬 연산을 활용하기 어려워 대규모 데이터셋 학습에 많은 시간이 소요되었다. ### 장기 의존성 문제 (Long-Range Dependency) 시퀀스의 길이가 길어질수록 문장의 앞부분 정보가 뒤로 전달되면서 희석되거나 소실되는 문제가 발생한다. - **기울기 소실/폭발 (Vanishing/Exploding Gradient)**: 역전파 과정에서 기울기가 반복적으로 곱해지면서 0에 가깝게 사라지거나(sigmoid, tanh 활성화 함수 사용 시) 무한대로 발산하는(ReLU 활성화 함수 사용 시) 문제가 발생하여 효과적인 학습이 어려웠다. 이러한 문제들을 해결하기 위해 Attention 메커니즘이 RNN 모델에 보조적으로 도입되었으나, 근본적인 순환 구조의 한계는 여전히 남아있었다. --- ## 2. Transformer: Attention만을 이용한 새로운 접근 본 논문은 RNN의 순환 구조를 완전히 배제하고, **오직 Attention 메커니즘만으로** 입력과 출력 시퀀스 간의 전역적인 의존성을 모델링하는 **트랜스포머(Transformer)** 구조를 제안했다. 이를 통해 다음과 같은 혁신을 이뤘다. -   **완전한 병렬 처리**: 순환 구조가 없으므로 문장 내 모든 단어에 대한 연산을 동시에 처리할 수 있어, 학습 효율성과 속도를 극대화했다. -   **전역적 의존성 학습**: 아무리 멀리 떨어진 단어 사이의 관계도 직접적인 경로를 통해 한 번에 계산할 수 있어, 장기 의존성 문제를 근본적으로 해결했다. --- ## 3. 모델 아키텍처 (Model Architecture) 심층 분석 ![](/assets/images/2025-09-16-23-09-03.png) ![](/assets/images/2025-09-16-12-47-06.png) ### 전체 구조: 인코더-디코더 트랜스포머는 기계 번역을 위해 설계된 전통적인 **인코더-디코더** 구조를 따른다. -   **인코더 (Encoder)**: 입력 문장 시퀀스를 받아 문맥 정보를 함축한 연속적인 표현(representation)으로 변환한다. -   **디코더 (Decoder)**: 인코더의 출력과 이전에 생성된 출력 단어들을 입력으로 받아, 다음 단어를 예측한다. 논문에서는 인코더와 디코더 모두 **N=6개의 동일한 레이어**를 쌓아 구성했다. ### 인코더(Encoder) 상세 구조 ![](/assets/images/2025-09-16-23-09-18.png) 각 인코더 레이어는 두 개의 주요 서브 레이어(sub-layer)로 구성된다. 1.  **Multi-Head Self-Attention**: 입력 문장 내에서 단어들 간의 관계를 파악하는 역할을 한다. 2.  **Position-wise Feed-Forward Network**: 어텐션을 통해 얻은 정보를 바탕으로 비선형 변환을 적용하는 완전 연결 신경망이다. ![](/assets/images/2025-09-16-23-09-45.png) ![](/assets/images/2025-09-16-23-09-57.png) Self Attention단계에서는 Attention을 이용해 단어들 사이의 dependency 즉 단어간의 유사도를 계산한다. ### Attention 과정 과연 Attention 과정은 어떻길래 단어들 사이의 유사도를 측정할 수 있는걸까? ![](/assets/images/2025-09-16-23-11-33.png) ![](/assets/images/2025-09-16-23-11-45.png) 1. 각 단어마다 Query, Key, Value 벡터를 만든다. 2. q와 k벡터를 내적하여 score값(스칼라)를 생성한다. 3. score를 \\(\sqrt{d_k}\\)로 나눠준다. 4. softmax 연산을 한다 -> 이후 나오는 값이 dependency인 z다. **그렇다면 왜 하필 \\(\sqrt{d_k}\\)로 나눠야만 할까?** ![](/assets/images/2025-09-16-23-15-02.png) Attention단계에서는 실제로 Multi-head Attention을 하기 위해서 8개로 Attention을 나눠서 실행한다. 왜냐하면 다양한 관점에서 정보를 추출해야 하기 때문이다. 한단어가 어느 특정단어와 연관이 깊다고 해서 다른단어와 연관이 없는것은 아니다. 따라서 사진속 오른쪽 그림처럼 다양한 관점에서 한 단어에 대해 연관성을 측정한다. 그렇다면 왜 하필 \\(\sqrt {d_k}=8\\)일까? 그리고 왜 softmax함수를 쓰기 전에 나눠야 하는걸까? ![](/assets/images/2025-09-16-23-16-44.png) 일단 softmax연산은 분자가 지수함수이므로 상대적으로 큰값이 들어오면 큰값에만 확률이 매우크게 배정될 수 있다. 따라서 softmax함수에 넣어주는 값을 정규화(normalize)해주는 것이다. 그리고 8이라는 숫자는 표준편차가 8이기 떄문에 8로 나눠주는 것이다. ![](/assets/images/2025-09-16-23-18-57.png) 각 서브 레이어의 출력에는 **잔차 연결(Residual Connection)**과 **층 정규화(Layer Normalization)**가 적용된다. ![](/assets/images/2025-09-16-23-19-35.png) ### 디코더(Decoder) 상세 구조 각 디코더 레이어는 세 개의 서브 레이어로 구성된다. ![](/assets/images/2025-09-16-23-19-47.png) 1.  **Masked Multi-Head Self-Attention**: 출력 시퀀스 내에서 단어들 간의 관계를 파악한다. 이때, 현재 위치의 단어가 미래 위치의 단어를 참고하지 못하도록 **마스킹(Masking)**을 적용하여 **자가 회귀(auto-regressive)** 속성을 보장한다. 2.  **Multi-Head Encoder-Decoder Attention**: 디코더가 단어를 예측할 때, 인코더가 출력한 입력 문장의 어떤 부분에 집중(Attention)해야 할지를 결정한다. 3.  **Position-wise Feed-Forward Network**: 인코더와 동일한 역할을 수행한다. --- ## 4. 어텐션 메커니즘 분석 ![](/assets/images/2025-09-16-12-47-31.png) ### Scaled Dot-Product Attention 트랜스포머의 핵심 연산으로, **Query(Q), Key(K), Value(V)** 라는 세 개의 벡터를 입력으로 받는다. 1.  하나의 단어를 대표하는 **Query 벡터**가 문장 내 모든 단어를 대표하는 **Key 벡터**들과 내적(dot-product)을 통해 **유사도(Attention Score)**를 계산한다. 2.  이 점수를 Key 벡터의 차원(\\({d_k}\\))의 제곱근(\\(\sqrt{d_k}\\))으로 나누어 **스케일링(Scaling)**한다. 이는 \\({d_k}\\)가 클 때 내적 값이 너무 커져 Softmax 함수의 기울기가 0에 가까워지는 것을 방지하여 학습을 안정화시키는 효과가 있다. 3.  스케일링된 점수에 **Softmax** 함수를 적용하여 합이 1인 가중치(Attention Weight)를 구한다. 4.  이 가중치를 각 단어의 **Value 벡터**에 곱하여 가중합(weighted sum)을 구한다. 이것이 바로 어텐션의 최종 출력값이다. 이 모든 과정은 다음의 수식으로 압축된다. $$ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V $$ ### Multi-Head Attention 한 번의 어텐션을 수행하는 대신, **여러 개의 어텐션을 병렬적으로 수행**하는 방식이다. -   입력 임베딩 벡터를 **h개의 헤드**로 나누어 각각 다른 Q, K, V 행렬을 학습시킨다. -   각 헤드는 독립적으로 Scaled Dot-Product Attention을 수행한다. 이를 통해 모델은 "The animal didn't cross the street because **it** was too tired" 와 같은 문장에서 'it'이 'animal'을 가리키는 관계, 'tired'와 관련 있는 관계 등 다양한 관점의 정보를 동시에 포착할 수 있다. -   각 헤드의 출력 값들을 모두 연결(concatenate)한 후, 최종 가중치 행렬 \\({W^O}\\)를 곱하여 최종 출력을 생성한다. 논문에서는 \\({d_{model}=512}\\) 차원을 \\({h=8}\\)개의 헤드로 나누어, 각 헤드는 \\({d_k=d_v=512/8=64}\\) 차원을 갖도록 설정했다. ### Positional Encoding: 순서 정보의 주입 RNN을 제거하면서 단어의 순서 정보를 잃어버리는 문제가 발생한다. 트랜스포머는 이를 해결하기 위해 **위치 인코딩(Positional Encoding)** 값을 단어의 임베딩 벡터에 더해준다. 사인(sine)과 코사인(cosine) 함수를 이용하여 각 위치마다 고유한 벡터 값을 생성하며, 이를 통해 모델은 단어의 상대적인 위치 관계를 학습할 수 있다. $$ PE_{(pos, 2i)} = \sin(pos / 10000^{2i/d_{\text{model}}}) $$ $$ PE_{(pos, 2i+1)} = \cos(pos / 10000^{2i/d_{\text{model}}}) $$ ### Add & Norm: 잔차 연결과 층 정규화 각 서브 레이어의 입력은 출력을 거친 후, 입력 자신과 더해지는 **잔차 연결(Residual Connection)** 구조를 가진다. 이는 깊은 신경망에서 기울기가 소실되는 문제를 방지하는 효과적인 방법이다. 이후 **층 정규화(Layer Normalization)**를 통해 데이터의 분포를 안정시켜 학습 효율을 높인다. --- ## 5. 학습 및 실험 결과 ### 학습 방법 -   **하드웨어**: NVIDIA P100 GPU 8개를 사용했다. -   **Optimizer**: Adam Optimizer를 사용했으며, 학습 초기에는 learning rate를 선형적으로 증가시키고 이후에는 역제곱근에 비례하여 감소시키는 스케줄링을 적용했다. -   **정규화**: 잔차 연결 외에 Dropout과 Label Smoothing을 사용하여 과적합을 방지했다. ### 성능 평가 (BLEU Score) ![](/assets/images/2025-09-16-12-47-58.png) -   WMT 2014 영어-독일어 번역 태스크에서 기존 앙상블 모델보다 2.0 BLEU 포인트 높은 28.4를 기록하며 **SOTA(State-of-the-art)**를 달성했다. -   영어-프랑스어 번역 태스크에서도 기존 단일 모델들의 성능을 모두 뛰어넘었다. -   이러한 성능을 기존 모델의 **1/4 미만의 훈련 비용**으로 달성했다. ### 모델 복잡도 비교 ![](/assets/images/2025-09-16-12-47-43.png) - **레이어당 복잡도**: Self-Attention은 시퀀스 길이(\\({n}\\))가 차원(\\({d}\\))보다 작을 때 RNN보다 효율적이다. - **순차 연산 및 최대 경로 길이**: Self-Attention은 순차 연산이 O(1)로 병렬화에 유리하며, 단어 간 경로 길이가 O(1)로 장기 의존성 문제에 강하다. ### Model Variations ![](/assets/images/2025-09-16-23-20-23.png) - (A) Attention head(h)의 수는 너무 적거나 많으면 Bleu점수가 잘 나오지 않는다. -> 8이 최적이다. - (B) Attention key(\\({d_k}\\))를 줄이면 점수가 떨어진다. -> 단어간 유사도를 계산할때 충분한 차원의 벡터가 필요하다. - (C) 모델을 키울수록 성능이 향상된다. - (D) Ragularization(정규화)로 dropout, Label Smoothing을 사용한 결과 점수가 향상되었다. --- ## 6. 결론 **Attention Is All You Need** 논문은 다음 세 가지 측면에서 NLP 분야에 혁신을 가져왔다. 1.  **RNN 대체**: 순환 구조 없이 Attention만으로 더 뛰어난 성능을 달성하며, NLP 모델의 패러다임을 전환했다. 2.  **성능 및 효율성**: 병렬 처리를 통해 기존 모델보다 훨씬 빠르고 효율적으로 훈련하면서도 더 높은 정확도를 기록했다. 3.  **확장 가능성**: 본 논문에서 제안된 트랜스포머 아키텍처는 이후 BERT, GPT 등 수많은 후속 모델의 기반이 되었으며, 자연어 처리를 넘어 **컴퓨터 비전(Vision Transformer, ViT)**, 음성 인식 등 AI의 거의 모든 분야로 확장되었다. ## Algorithm ### [Programmers/Python] Level 0 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-10-21-Programmers_Level0/ - Collection: Algorithm - Published: 2025-10-21 - Tags: Python, Programmers, Level0 [level0_1](https://s3xyhyejun.notion.site/Level_0-22c1c581f6c280fd87eafc6b922499d4?source=copy_link) [level0_2](https://s3xyhyejun.notion.site/level_0_2-2301c581f6c280af950dc33b915b2312?source=copy_link) 여름방학에 열심히 풀이한 프로그래머스 Level0 문제 풀이한 코드와 해설입니다. 너무 쉬운문제는 제외하고 거의 모든문제를 해결했습니다. ### [Programmers/Python] Level 1 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-10-21-Programmers_Level1/ - Collection: Algorithm - Published: 2025-10-21 - Tags: Python, Programmers, Level1 [level1_1](https://s3xyhyejun.notion.site/Level_1-0-2341c581f6c28034a81adc0b3baa96dd?source=copy_link) [level1_2](https://s3xyhyejun.notion.site/level_1_1-2391c581f6c28050ae6bf7fa059e49b9?source=copy_link) 여름방학에 열심히 풀이한 프로그래머스 Level1 문제 풀이한 코드와 해설입니다. 너무 쉬운문제는 제외하고 거의 모든문제를 해결했습니다. ### [Programmers/Python] Level 2 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-10-21-Programmers_Level2/ - Collection: Algorithm - Published: 2025-10-21 - Tags: Python, Programmers, Level2 [level2_1](https://s3xyhyejun.notion.site/level2_1-2411c581f6c280868e40c72d029eb25a?source=copy_link) [level2_2](https://s3xyhyejun.notion.site/level2_1-2411c581f6c280868e40c72d029eb25a?source=copy_link) [level2_3](https://s3xyhyejun.notion.site/level2_3-26a1c581f6c280608e11c4b7444beefc?source=copy_link) 여름방학에 열심히 풀이한 프로그래머스 Level2 문제 풀이한 코드와 해설입니다. 너무 쉬운문제는 제외하고 거의 모든문제를 해결했습니다. ### [Programmers/Python] Level_3: N으로 표현 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-09-16-N-DP/ - Collection: Algorithm - Published: unknown - Tags: Python, Programmersx, Lebel3, DP # 문제: N으로 표현(DP) 문제 설명 아래와 같이 5와 사칙연산만으로 12를 표현할 수 있습니다. 12 = 5 + 5 + (5 / 5) + (5 / 5) 12 = 55 / 5 + 5 / 5 12 = (55 + 5) / 5 5를 사용한 횟수는 각각 6,5,4 입니다. 그리고 이중 가장 작은 경우는 4입니다. 이처럼 숫자 N과 number가 주어질 때, N과 사칙연산만 사용해서 표현 할 수 있는 방법 중 N 사용횟수의 최솟값을 return 하도록 solution 함수를 작성하세요 제한사항 N은 1 이상 9 이하입니다. number는 1 이상 32,000 이하입니다. 수식에는 괄호와 사칙연산만 가능하며 나누기 연산에서 나머지는 무시합니다. 최솟값이 8보다 크면 -1을 return 합니다. ![](/assets/images/2025-09-17-11-14-26.png) ```python def solution(N, number): ''' 1: 5/5 ->2개 2: 5/5 + 5/5 -> 4개 3: 5-5/5 - 5/5 -> 5개 4: 5 - 5/5 -> 3개 5: 5 -> 1개 6: 5 + 5/5 -> 3개 7: 5 + 5/5 + 5/5 -> 5개 8: 5 + 5 - 5/5 - 5/5 -> 6개 9: 5+5 -5/5 -> 4개 10: 5+5 -> 5개 11: 55/5 -> 3개 12: 55/5 + 5/5 -> 5개 13: 5+5+5 - 5/5 - 5/5 -> 7게 14: 5+5+5 - 5/5 -> 5개 15: 5+5+5 -> 3개 N을 이용해서 number만드는 최소횟수 -> 일반화가능 dp[number] = number를 만드는 데 필요한 N의 최소 개수 -> dp[number]를 리턴하기 -> 이거 나열해봤자 점화식에서 규칙이 안보임.. dp[1] = 5(기본) dp[2] = 55(기본), 5+5,5-5,5//5, 5*5 -> dp[i-1] (사칙연산) dp[i-1] dp[3] = 555(기본), ... -> dp[1] (사칙연산) dp[2] -> dp[n] = dp[n-1] 사칙연산 dp[n-2]..? 사칙연산 하면 겹치는 경우의 수도 있으니깐 set으로 관리하기 N을 사용하는 횟수를 key로, N을 key번 사용해서 만들 수 있는 집합을 key로 갖는 dict만들기 1. N최대사용횟수는 8이니깐 8개의 set을 value로 갖는 dict dp만들기 2. dp의 기본값 추가 -> N, nn, nnn.... 3. 점화식관계를 이용해서 for문 돌면서 이전 dp로 현재 dp의 set에 사칙연산 경우의수 추가하기 4. dp dict완성하고 난 다음에는 dp dict 1부터 8까지 돌면서 number가 set안에 있나 체크 있으면 return i, 없으면 return -1 ''' #dp[i]는 N을 i번 써서 만들 수 있는 숫자들을 set으로 저장 (i는 최대 8) dp = {i:set() for i in range(1,9)} # N을 1번써서 만들 수 있는 숫자는 N dp[1].add(N) for i in range(2,9): # N, NN, NNN 꼴의 기본꼴 추가 dp[i].add(int(str(N)*i)) for j in range(1,i): # j+ i-j = i인 모든 경우의수에 대해 사칙연산 for num1 in dp[j]: for num2 in dp[i-j]: dp[i].add(num1+num2) dp[i].add(num1-num2) if num2 != 0: dp[i].add(num1//num2) dp[i].add(num1*num2) for i in range(1,9): if number in dp[i]: return i return -1 ``` ## 배울점 1. dp문제를 풀때는 점화식을 찾아야됨 -> 어디서 점화식이 나올지 여러방면으로 고민해봐야됨 - 이 문제에서는 number가 아니라 N을 사용하는 횟수 i에서 점화식을 찾을 수 있었음. 2. set에 값을 추가할때는 `set.add()`꼴로 `add()`함수를 써야됨 ### [백준/Python] 16234번: 인구 이동 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-09-16-Populationmove/ - Collection: Algorithm - Published: unknown - Tags: Python, BOJ, Gold5, BFS, Simulation # 문제: 인구이동 N×N크기의 땅이 있고, 땅은 1×1개의 칸으로 나누어져 있다. 각각의 땅에는 나라가 하나씩 존재하며, r행 c열에 있는 나라에는 A[r][c]명이 살고 있다. 인접한 나라 사이에는 국경선이 존재한다. 모든 나라는 1×1 크기이기 때문에, 모든 국경선은 정사각형 형태이다. 오늘부터 인구 이동이 시작되는 날이다. 인구 이동은 하루 동안 다음과 같이 진행되고, 더 이상 아래 방법에 의해 인구 이동이 없을 때까지 지속된다. - 국경선을 공유하는 두 나라의 인구 차이가 L명 이상, R명 이하라면, 두 나라가 공유하는 국경선을오늘 하루 동안 연다. - 위의 조건에 의해 열어야하는 국경선이 모두 열렸다면, 인구 이동을 시작한다. - 국경선이 열려있어 인접한 칸만을 이용해 이동할 수 있으면, 그 나라를 오늘 하루 동안은 연합이라고 한다. - 연합을 이루고 있는 각 칸의 인구수는 (연합의 인구수) / (연합을 이루고 있는 칸의 개수)가 된다. 편의상 소수점은 버린다. - 연합을 해체하고, 모든 국경선을 닫는다. 각 나라의 인구수가 주어졌을 때, 인구 이동이 며칠 동안 발생하는지 구하는 프로그램을 작성하시오. ## 입력 첫째 줄에 N, L, R이 주어진다. (1 ≤ N ≤ 50, 1 ≤ L ≤ R ≤ 100) 둘째 줄부터 N개의 줄에 각 나라의 인구수가 주어진다. r행 c열에 주어지는 정수는 A[r][c]의 값이다. (0 ≤ A[r][c] ≤ 100) 인구 이동이 발생하는 일수가 2,000번 보다 작거나 같은 입력만 주어진다. ## 출력 인구 이동이 며칠 동안 발생하는지 첫째 줄에 출력한다. ## 내 풀이 ```python import sys input = sys.stdin.readline from collections import deque A = [] N, L, R=map(int, input().split()) #A 리스트 값 불러오기 for _ in range(N): A.append(list(map(int, input().split()))) ''' L이상 R이하 사이의 인구차이라면 국경열기 1. BFS로 A리스트 돌면서 상하좌우에 L이상 R이하인지 확인 -> 연합 찾기 2. 연합 다 찾았으면(큐가 비면) 인구 재분배 3. 모든칸에 대해 반복 4. 더이상 인구이동이 없다면 종료 -> 반복한 횟수 출력 ''' dx = [0,0,-1,1] dy = [1,-1,0,0] day = 0 while 1: chk = 0 visited = [[False] * N for _ in range(N)] for r in range(N): for c in range(N): if not visited[r][c]: people_sum = 0 open_country = [] queue = deque([(r,c)]) visited[r][c] = True people_sum+=A[r][c] open_country.append((r,c)) while queue: now_r, now_c = queue.popleft() for k in range(4): x, y = now_r + dx[k], now_c + dy[k] #좌표가 유효하고 방문하지 않았다면 if 0<=x1: mean_people = people_sum // len(open_country) for m,n in open_country: A[m][n] = mean_people if chk == 0: break #더이상 연합이 없었다면 -> chk = 0 -> while문 break day += 1 print(day) ``` ## 배울점 1. visited리스트가 있으니깐, 굳이 list에 현재상태 저장해두고 한번에 업데이트 할필요 없었다. 2. pypy3로 제출하면 시간초과가 안뜬다.. 3. 전형적인 BFS문제 → BFS로 검사해서 연합할 수 있는애들 리스트에 모아서 한번에 연합해주고 계산해주기 → 각 날마다 visited는 초기화해야됨을 유의해야됨 → 각BFS마다 visited는 새로생성 4. `input = sys.stdin.readline` 를 인풋으로 써야 더 빠름 ### [백준/Python] 14891번: 톱니바퀴 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-09-16-gearmove/ - Collection: Algorithm - Published: unknown - Tags: Python, BOJ, Gold5, Simulation # 문제: 톱니바퀴 총 8개의 톱니를 가지고 있는 톱니바퀴 4개가 아래 그림과 같이 일렬로 놓여져 있다. 또, 톱니는 N극 또는 S극 중 하나를 나타내고 있다. 톱니바퀴에는 번호가 매겨져 있는데, 가장 왼쪽 톱니바퀴가 1번, 그 오른쪽은 2번, 그 오른쪽은 3번, 가장 오른쪽 톱니바퀴는 4번이다. 이때, 톱니바퀴를 총 K번 회전시키려고 한다. 톱니바퀴의 회전은 한 칸을 기준으로 한다. 회전은 시계 방향과 반시계 방향이 있고, 아래 그림과 같이 회전한다. 톱니바퀴를 회전시키려면, 회전시킬 톱니바퀴와 회전시킬 방향을 결정해야 한다. 톱니바퀴가 회전할 때, 서로 맞닿은 극에 따라서 옆에 있는 톱니바퀴를 회전시킬 수도 있고, 회전시키지 않을 수도 있다. 톱니바퀴 A를 회전할 때, 그 옆에 있는 톱니바퀴 B와 서로 맞닿은 톱니의 극이 다르다면, B는 A가 회전한 방향과 반대방향으로 회전하게 된다. 예를 들어, 아래와 같은 경우를 살펴보자. 두 톱니바퀴의 맞닿은 부분은 초록색 점선으로 묶여있는 부분이다. 여기서, 3번 톱니바퀴를 반시계 방향으로 회전했다면, 4번 톱니바퀴는 시계 방향으로 회전하게 된다. 2번 톱니바퀴는 맞닿은 부분이 S극으로 서로 같기 때문에, 회전하지 않게 되고, 1번 톱니바퀴는 2번이 회전하지 않았기 때문에, 회전하지 않게 된다. 따라서, 아래 그림과 같은 모양을 만들게 된다. 위와 같은 상태에서 1번 톱니바퀴를 시계 방향으로 회전시키면, 2번 톱니바퀴가 반시계 방향으로 회전하게 되고, 2번이 회전하기 때문에, 3번도 동시에 시계 방향으로 회전하게 된다. 4번은 3번이 회전하지만, 맞닿은 극이 같기 때문에 회전하지 않는다. 따라서, 아래와 같은 상태가 된다. 톱니바퀴의 초기 상태와 톱니바퀴를 회전시킨 방법이 주어졌을 때, 최종 톱니바퀴의 상태를 구하는 프로그램을 작성하시오. ### 입력 첫째 줄에 1번 톱니바퀴의 상태, 둘째 줄에 2번 톱니바퀴의 상태, 셋째 줄에 3번 톱니바퀴의 상태, 넷째 줄에 4번 톱니바퀴의 상태가 주어진다. 상태는 8개의 정수로 이루어져 있고, 12시방향부터 시계방향 순서대로 주어진다. N극은 0, S극은 1로 나타나있다. 다섯째 줄에는 회전 횟수 K(1 ≤ K ≤ 100)가 주어진다. 다음 K개 줄에는 회전시킨 방법이 순서대로 주어진다. 각 방법은 두 개의 정수로 이루어져 있고, 첫 번째 정수는 회전시킨 톱니바퀴의 번호, 두 번째 정수는 방향이다. 방향이 1인 경우는 시계 방향이고, -1인 경우는 반시계 방향이다. ### 출력 총 K번 회전시킨 이후에 네 톱니바퀴의 점수의 합을 출력한다. 점수란 다음과 같이 계산한다. - 1번 톱니바퀴의 12시방향이 N극이면 0점, S극이면 1점 - 2번 톱니바퀴의 12시방향이 N극이면 0점, S극이면 2점 - 3번 톱니바퀴의 12시방향이 N극이면 0점, S극이면 4점 - 4번 톱니바퀴의 12시방향이 N극이면 0점, S극이면 8점 ## 내 풀이 ```python from collections import deque ''' 1줄: 1번톱니상태 2줄: 2번톱니상태 ... 각 톱니는 12시방향부터 시계방향으로 0 or 1 8개 5번째줄: 회전횟수 k 그다음번째줄부터 톱니 번호, 방향(1: 시계, -1: 반시계) 모두 회전 시킨 후 12시 방향의 톱니가 s이면 1,2,4,8점 ''' score = 0 gear1 = deque(map(int, input().strip())) gear2 = deque(map(int, input().strip())) gear3 = deque(map(int, input().strip())) gear4 = deque(map(int, input().strip())) k=int(input()) gears = {0 : gear1, 1: gear2, 2: gear3, 3: gear4} for _ in range(k): #일단 index로 톱니랑, 방향 불러오기 index=list(map(int,input().split())) index[0] -= 1 #해당톱니 인덱스2랑6은 좌우톱니랑 맞닿는 부분 #좌우톱니랑 극이 같은지 다른지 확인하고 다르면 돌리기 rotate_memory = [0,0,0,0] rotate_memory[index[0]] = index[1] #왼쪽 for i in range(index[0],0,-1): if gears[i][6] != gears[i-1][2]: #gears[i-1].rotate(-rotate_memory[i]) rotate_memory[i-1] = -rotate_memory[i] else: break #오른쪽 for i in range(index[0],3): if gears[i][2] != gears[i+1][6]: #gears[i+1].rotate(-rotate_memory[i]) rotate_memory[i+1] = -rotate_memory[i] else: break for k in range(4): gears[k].rotate(rotate_memory[k]) for j in range(4): if gears[j][0] == 1: score += 2**j print(score) ``` ## 배울점 1. 논리자체는 어렵지 않은 구현문제였는데, 인덱스에서 자꾸 에러가뜸 - 순차적으로 톱니를 움직이고 확인하고 움직이고 확인하면, 움직인 위치에따라서 확인할때 계산하니깐 로직이 꼬임 → 움직일지 안움직일지 판단을 `rotate_memory` 로 해둔다음에 한번에 움직였어야됨 2. 로직을 조금더 고민해보고 코드로 구현하기.. ### [백준/Python] 22862: 가장 긴 짝수 연속한 부분 수열 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-09-18-long-even-Series/ - Collection: Algorithm - Published: unknown - Tags: Python, 백준, two pointer # 문제: 가장 긴 짝수 연속한 부분 수열 ![](/assets/images/2025-09-18-11-22-58.png) ![](/assets/images/2025-09-18-11-23-14.png) ## 풀이 ```python import sys input = sys.stdin.readline # N: 수열의 길이 N, K=map(int, input().split()) S = list(map(int,input().split())) #max는 최대 수열길이 max = 0 ''' N까지의 수 중에서 K번 삭제한 후 만약 N//2 <= K N=6, K=3 ,2,4,6 N=6, K=4 2 4 6 -> 답은 N//2 N=7, K=4 ,2,,4,,6, N=8, K=4 ,2,,4,,6,8 N//2 > K N = 10, k = 4 1,2,,4,,6,,8,,10 -> 답은 k+1 S가 정렬되어있지않을 수도 -> 근데 정렬은 상관없느듯 짝수 뭉탱이가 중간에 숨어있을 수 있음 -> 찾아야됨 홀수 K개 지울 수 있음 -> 투포인터로 홀수 찾으면서 K개 될때까지 두개의 포인터 안에 홀수가 K보다 작을때 end포인터 +1 두개의 포인터 안에 홀수가 K보다 클떄 st포인터 +1 두개의 포인터 안에 홀수의 수 = K일때 end 포인터, st +1 if end - st > max: max = end-st ''' #end랑 st는 투포인터 end = 0 st = 0 # print(N//2 if N//2<=K else K+1) length=len(S) odd = 0 #매번 odd를 세니깐 시간초과 # odd를 저장해두고,포인터 이동에따라 1씩 더하거나 빼기 while end < length: # for i in S[st:end+1]: # if i%2 == 1: # odd +=1 #홀수라면 odd +=1 if S[end]%2 == 1: odd +=1 # if odd < K: # if end - st + 1 - odd > max: # max = end-st+1 - odd # end +=1 while odd > K: if S[st] % 2 == 1: odd-=1 st += 1 #odd <=K일때 max길이 검사 if end - st +1 - odd > max: max = end-st+1 - odd end+=1 # print(S) print(max) ``` ## 배울점 1. 어렴풋이 알고는 있었는데, 당연히 while문 안에서 매번 수열 S를 슬라이싱해서 홀수개수를 세면 시간초과뜸 → 이럴경우에 정수로 개수를 센다음에 while 루프마다 정수 +-1씩 업데이트 해가면서 개수를 세는게 맞음 → 약간 DP table만들어서 이전 정보 활용하는 느낌 → 매번계산x 2. odd = K일때 max길이 검사해야 하는것은 알았는데, odd=양 -> 양 몰살 최대한 많은 양 모아서 다시 루트노드로 돌아오기 info: 그래프 edges: 노드간의 연결관계 1. edge리스트 graph로 만들기 -> info에서 각 node 확인해서 count 2. DFS로 늑대, 양 개수 count하면서 경우의 수 탐색 3. 양 최댓값 return ''' # 인접 리스트로 그래프 생성 graph = [[] for _ in range(len(info))] for i in range(len(edges)): graph[edges[i][0]].append(edges[i][1]) # print(graph) max_ = 0 def DFS(sheep, wolf, node): nonlocal max_ #max 갱신 if sheep > max_: max_ = sheep for n in node: next_node = [k for k in node if k != n] + graph[n] # 다음 노드가 양일때 if info[n] == 0: DFS(sheep + 1, wolf, next_node) else: #다음노드가 늑대일때 if sheep > wolf +1: #늑대 1추가해도 양보다 더 적을때만 탐색 DFS(sheep, wolf +1, next_node) DFS(1,0,graph[0]) return max_ ``` ## 배울점 1. 인접리스트로 그래프 만든다음에 DFS로 탐색하는 문제 2. 전형적인 그래프 탐색문제긴 했는데, 양숫자랑, 늑대 숫자를 DFS로 넘겨줘서 제한조건을 걸어줘야 하는 문제였음 3. `next_node`로 다음에 탐색해야 하는 `node` 는 자신을 제외한 이번 DFS의 node와 자신과 연결된 node인 `graph[n]` 임. ### [Programmers/Python] Level 3: 파괴되지 않은 건물 - Canonical URL: https://hyejunl33.github.io/algorithm/2025-09-29-building/ - Collection: Algorithm - Published: unknown - Tags: Python, Programmers, 부분 합 # 문제: 파괴되지 않은 건물 ![image](/assets/images/2025-09-29-22-17-55.png) ![image](/assets/images/2025-09-29-22-18-01.png) ![image](/assets/images/2025-09-29-22-18-08.png) ![image](/assets/images/2025-09-29-22-18-12.png) ![image](/assets/images/2025-09-29-22-18-15.png) ![image](/assets/images/2025-09-29-22-18-22.png) ## 풀이 ```python def solution(board, skill): answer = 0 board_update = [[0]*(len(board[0])+1) for _ in range(len(board)+1)] for tp,r1,c1,r2,c2,degree in skill: if tp == 1: board_update[r1][c1] -= degree board_update[r1][c2+1] += degree board_update[r2+1][c1] += degree board_update[r2+1][c2+1] -= degree else: board_update[r1][c1] += degree board_update[r1][c2+1] -= degree board_update[r2+1][c1] -= degree board_update[r2+1][c2+1] += degree #열방향 전파 for r in range(len(board)): for c in range(1,len(board[0])): board_update[r][c] += board_update[r][c-1] #행방향 전파 for c in range(len(board[0])): for r in range(1,len(board)): board_update[r][c] += board_update[r-1][c] #board 업데이트해주기 for i in range(len(board)): for k in range(len(board[0])): board[i][k] += board_update[i][k] # print(board) #board에서 0보다 큰 개수 count for i in range(len(board)): for k in range(len(board[0])): if board[i][k]>0: answer+=1 return answer ''' board: 건물 내구도 2차원 정수배열 skill: 공격 혹은 회복 스킬 - 2차원 정수배열 [type, r1,c1,r2,c2,degree] 파괴되지 않은 건물의 개수 return 1. skill 하나씩 받아오기 2. type = 1일떄 공격 -> (r1,c1)부터 (r2,c2)까지 degree만큼 모두 빼기 type = 2일때 회복 -> (r1,c1)부터 (r2,c2)까지 degree만큼 모두 추가시켜주기 3. board에서 0보다 큰 원소 개수 return ''' ''' for sk in skill: if sk[0] == 1: #공격일때 for i in range(sk[1],sk[3]+1): for k in range(sk[2],sk[4]+1): board[i][k] -= sk[5] else: # 회복일때 for i in range(sk[1],sk[3]+1): for k in range(sk[2],sk[4]+1): board[i][k] += sk[5] for i in range(len(board)): for k in range(len(board[0])): if board[i][k]>0: answer+=1 print(board) return answer ''' ''' 1. board_update에 네개의 꼭짓점 변화량 기록 2. 나중에 board_update 가로세로 전파 한번에 해버리기 3. board_update + board 해서 건물 내구도 O(m*n)으로 구하기 4. board중 0보다 큰 개수 구해서 출력 ''' ``` ## 배울점 1. 그대로 구현하면 $$O(k*m*n)$$이라 시간초과 → 부분합을 쓴 다음에 한번에 Board를 업데이트하면 $$O(K+M*N)$$이라 효율적 2. 부분합 이용하는것까지는 생각해봤는데, 열, 행순으로 전파를 해서 한번에 업데이트 하는방법은 생각하지 못했음 ## WeeklyReview ### Week13-15_HandBone X-Ray Image Semantic Segmentation Project - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-12-30-SemanticSegmentation_WrapupReport%20copy/ - Collection: WeeklyReview - Published: 2025-12-30 - Tags: Project, SemanticSegmentation, WeeklyReview ![image](/assets/images/2026-01-25-20-41-21.png) # 1. 프로젝트 개요 ## 1.1 프로젝트 주제 ![image](/assets/images/2026-01-25-20-41-42.png) hand bone x-ray 객체가 담긴 이미지, Segmentation Annotation 정보가 담긴 json파일을 Input으로 이용해서 모델은 각 클래스(29개)에 대한 확률 맵을 갖는 멀티채널 예측을 수행하고, 이를 기반으로 각 픽셀을 해당 클래스에 할당하는 Segmentation 모델을 개발 ## 1.2 프로젝트 목표 및 범위 본 프로젝트의 핵심 목표는 2048x2048의 고해상도 X-ray 이미지를 입력받아 각 픽셀이 29개의 뼈 클래스 중 어디에 속하는지를 예측하는 Semantic Segmentation 모델을 개발하는 것이다. 이를 위해 다음과 같은 세부 목표를 수립하였다. 1. **데이터 중심의 성능 향상: EDA**를 통해 데이터셋의 내재적 분포와 편향을 파악하고, Preprocessing 및 Augmentation 기법을 통해 학습 데이터와 테스트 데이터 간의 분포 격차를 최소화한다. 2. **최적의 모델 아키텍처 탐색**: U-Net, FPN, DeepLabV3+ 등 기존의 세그멘테이션 모델뿐만 아니라, HRNet, SegFormer, ConvNeXt와 같은 최신 SOTA모델들을 실험하여 모델을 탐색한다. 3. **뼈 사이 경계 복원**: 뼈와 뼈 사이의 미세한 경계면을 정확히 구분하기 위해 PointRend, Lovasz Loss 등의 기법을 적용하여 Pixel-level의 Dice를 극대화한다. 4. **안정적인 학습 및 일반화**: EMA(Exponential Moving Average), Group K-Fold, CosineWarmUpRestartScheduler등의 전략을 통해 학습의 안정성을 확보하고 Overfitting을 방지한다. ## 1.3 개발환경 **H/W**: Tesla V100 32GB GPU 서버 3대 **S/W**: SMP, TorchVision, mmsegmentation, monai **실험관리**: WandB, Notion, Github ## 1.4 데이터셋 ### 1.4.1 이미지 - 이미지 크기 : (2048 x 2048) | | Images | Label | | --- | --- | --- | | **Train** | 800 | O | | **Test** | 288 | X | ![image](/assets/images/2026-01-25-20-41-54.png) 원본 이미지 ![image](/assets/images/2026-01-25-20-42-00.png) Annotation을 시각화한 이미지 - HandBone X-ray Image가 원본이미지로 주어지고 각 뼈 클래스(29개)에 대한 Annotation이 Json파일형태로 주어진다. - 양손을 촬영했기 때문에 사람 별로 두 장의 이미지가 존재한다. ### 1.4.2 메타데이터 환자 ID별로 성별, 나이, 키, 몸무게가 엑셀파일로 주어졌다. 성별의 경우 남, 여로 표준화되어 구분되어있지 않고, 노이즈가 포함된 데이터가 있었다. 메타데이터를 활용하기 위해서 표준화하는 과정을 추가로 진행했다. # 2. 프로젝트 팀 구성 및 역할 ![image](/assets/images/2026-01-25-20-51-06.png) # 3. 프로젝트 수행 절차 및 방법 ## 3.1 EDA & FeatureEngineering ### 3.1.1 회전여부 분포 불일치 문제 ![image](/assets/images/2026-01-25-20-42-37.png) 회전되지 않은 손(위), 회전된손(아래) X-ray 이미지상의 손은 일직선상을 향하고있는 손과, 회전된 손으로 나뉘어져 있음을 확인했다. 그런데, Train과 Test set의 회전여부를 시각화해본 결과 회전여부의 분포가 불일치함을 발견했다. 손의 회전여부는 메타데이터로 주어지지 않았으므로 새끼손가락 끝의 뼈`(f-16)` 와 새끼손가락과 가까이 있는 손목뼈의 중심(`Ulna`)의 벡터를 구해서 33도이상 휘어있다면 손이 rotate돼있다고 판단했다. ![image](/assets/images/2026-01-25-20-42-42.png) Train Dataset의 손의 회전 각도 분포 ![image](/assets/images/2026-01-25-20-42-47.png) Test Dataset의 손의 회전 각도 분포 Train Dataset과 Test Dataset의 회전 각도 분포를 시각화 해본 결과 임계값을 기준으로, 회전된 손과 회전되지 않은 손으로 나뉘고 있음을 확인했다. 하지만, 회전된 손과 회전되지 않은 손의 비율이 Test Dataset에서 Train Dataset보다 약 10배 많음을 확인했다. ### 3.1.2 성별 분포 불일치 문제 ![image](/assets/images/2026-01-25-20-42-52.png) Train: 파란색, Test: 주황색 Train Dataset과 Test Dataset간의 성별분포도 일부 불일치함을 확인했다. 확인 결과 Test dataset이 Train dataset보다 남성이 1.34배 많았다. ### 3.1.3 분포 불일치 해결 Train과 Test Dataset의 분포가 다르다면 Validartion Score와 Public Score간의 차이가 발생한다. 따라서 분포 불일치를 해결하기 위해 Train Dataset에서 오버샘플링을 진행하는 실험을 진행했다. 환자의 ID를 Group으로 하고, 성별과 손의 회전여부를 기준으로 5-Fold로 GroupStratifiedK-Fold를 적용한 후 회전된 손 10배 오버샘플링, 남성 1.34배 오버샘플링을 진행한 결과 **Public과 valid score차이가 0.004로 baseline의 0.003**에 비해 **소폭 상승**하는것을 확인했다. 분포 불일치를 해결하기 위해 진행한 오버샘플링이 오히려 **Overfitting**을 야기하는것으로 생각하고, 오버샘플링은 이후실험에서 진행하지 않았다. ![image](/assets/images/2026-01-25-20-42-59.png) epoch = 50 validation에서의 validation 시각화결과 이후 Validation을 시각화할 때, 첫 번째 이미지로 손목이 꺾인 이미지를 추가하여 실제로 모델이 손의 달라진 각도에 의해 성능이 하락하는 것인지 확인해보았다. Dice = 0.84인 Epoch = 5의 Validation 이미지를 보면, 손목이 꺾였을 때 뼈들을 잘 잡아내지 못하는 것을 확인할 수 있었다. 그러나 Dice = 0.96을 달성한 학습 후기의 Validation 이미지를 확인해보면, 손목이 꺾인 이미지에서도 육안으로 구분할 수 없을만큼 뼈들을 잘 잡아내는 것을 관찰할 수 있다. 이로인해, **손목의 각도는 학습 초기에는 해결해야 할 문제였음은 어느정도 생각될 수 있으나, 더 긴 학습 시간을 가지면서 모델은 손목 각도의 변화에 따른 이미지에 충분히 강건한 모델**이 되었다고 생각되었다. ### 3.1.4 Grouping과 Stratification 환자의 ID에 따라 Group으로 묶는것은 중요하다. 한 환자의 왼손과 오른손의 뼈의 구조적 특징은 매우 유사하므로 만약 왼손과 오른손이 Train과 valid로 나뉠경우, 데이터 Leakage의 문제가 있을 수 있다. 따라서 Group K-Fold를 적용했다. ![image](/assets/images/2026-01-25-20-43-10.png) 키, 몸무게는 Mask Size와 높은 상관관계(`corr = 0.794, 0.649`)를 보였지만 나이는 낮은 상관관계를 보였다.(`corr = 0.127`) ![image](/assets/images/2026-01-25-20-43-20.png) 성별또한 mask size에 유의미한 상관관계가 있음을 확인했다. ![image](/assets/images/2026-01-25-20-43-27.png) Train과 Valid를 랜덤으로 나눈 결과 성별의 비율이 전체 비율과 크게 다르지 않았다. 환자의 메타데이터에 따라 Stratified하게 K-Fold를 나누는것 또한 매우 중요하다. 하지만 환자의 메타데이터인 몸무게, 키등은 성별과 매우 높은 상관관계를 보이고 있었고, GroupRandomK-Fold적용 결과 거의 성별이 균등하게 Fold별로 나뉘고있음을 확인해서 GroupRandomK-Fold를 사용했다. ![image](/assets/images/2026-01-25-20-43-36.png) 다변량 회귀분석 결과 환자의 메타데이터들은 성별과 강하게 연관되어있음을 확인했다. ### 3.1.5 객체 외 노이즈 제거 EDA도중 일부 이미지의 경우에는 상단과 좌측에, 흰색으로 노이즈가 있음을 확인했다. 따라서 노이즈를 제거해주기 위해서, 상단과 좌측의 80픽셀을 제거해주었다. ![image](/assets/images/2026-01-25-20-43-44.png) 상단에 노이즈가 있는 이미지(좌), 상단의 노이즈를 CuT한 후 검은색픽셀로 채운 이미지(우) ![image](/assets/images/2026-01-25-20-43-49.png) 노이즈를 제거해준 결과 초기 수렴속도가 빨라짐을 확인했다. 이후에 상단과 좌측의 노이즈만 제거하는것이 아니라 배경의 모든 노이즈를 제거하기 위해서 픽셀값이 급하게 변하는 경계를 찾고, 외부 경계선을 만들어서, 배경을 모두 제거해버리는 방법을 사용해보았다. 하지만 이 방법의 경우 성능향상이 없었기 때문에 이후실험에서는 사용하지 않았다. ![image](/assets/images/2026-01-25-20-43-56.png) 원본이미지(좌), 객체 외부의 모든 픽셀값을 0으로 만든 사진(우) ### 3.1.6 Outlier확인 및 제거 ![image](/assets/images/2026-01-25-20-44-01.png) 픽셀 밝기가 240 이상인픽셀수를 시각화한 그래프 X-Ray 이미지 데이터셋에는 반지를 끼고 찍은 사진이나, 네일아트가 있는 이미지도 포함되었다. 이러한 이미지들을 우선적으로 Outlier로 판단하고 제거한후 실험을 진행해보았다. ![image](/assets/images/2026-01-25-20-44-23.png) 픽셀기준 이상치 제거를 하고 실험한 결과(보라색) 픽셀값을 기준으로 이상치를 탐지하고, 제거해본 결과 **성능이 오히려 소폭(0.001) 하락**했다. 픽셀값을 기준으로 이상치를 판단하는것이 아니라, Train된 모델의 DIce score가 낮은순으로 나열해서 시각화해본 결과 Annotation이 잘못된 이상치를 확인할 수 있었다. ![image](/assets/images/2026-01-25-20-44-31.png) Pisiform(연갈색)과 Trapezoid(진초록색)간의 Annotation이 뒤바뀐 경우 ![image](/assets/images/2026-01-25-20-44-36.png) 엄지손가락의 뼈 Annotation순서가 뒤바뀐 경우 ![image](/assets/images/2026-01-25-20-44-41.png) 보형물이 포함되어 모델이 예측을 이상하게 하는 경우 따라서 해당 이상치들은 제거하고 실험한 결과 **test score기준 0.0009 상승**함을 확인했다. ## 3.2 Augmentation ### 3.2.1 Horizontal Flip Train Image가 800장밖에 되지 않아서, 학습할 데이터가 절대적으로 부족하다고 판단했다. 따라서 학습데이터는 많을수록 좋으므로 모든 사진의 좌우반전의 확률을 `0.5` 로 두는 증강방법을 사용했다. ![image](/assets/images/2026-01-25-20-44-49.png) Horizontal Flip결과 (하늘색)이 더 높은 성능을 보임을 확인할 수 있다. Horizontal Flip을 적용한 결과 더 높은 성능을 보임을 확인할 수 있었다. ### 3.2.2 RandomBrightnessContrast, SSR, GridDistortion, GridDropout - **RandomBrightnessContrast** ![image](/assets/images/2026-01-25-20-44-59.png) 원본사진(좌), 증강사진(우) ```python # BrightnessContrast (p=0.3 고정) brightness_contrast: true brightness_limit: 0.1 contrast_limit: 0.1 ``` Baseline만으로 Dice score가 0.96이상이 나오는 상황에서, 너무 강한 증강은 성능 하락을 야기한다고 가정했다. 따라서 RandomBrightnessContrast는 확률은 `0.3`으로 고정하고 변화 범위는 `0.1` 로 작은 범위로 제한했다. - **SSR** ![image](/assets/images/2026-01-25-20-45-06.png) 원본사진(좌), 증강사진(우) ```python shift_scale_rotate: true shift_limit: 0.05 # 이동 범위 scale_limit: 0.1 # 스케일 범위 rotate_limit: 15 # 회전 범위 ``` SSR도 마찬가지로 작은범위에서 변화를 주되, 회전된 손이나, 메타데이터 차이에 따른 뼈의 형태 차이에 대해 일반화성능이 올라갈것이라고 가정하고 적용했다. - **GridDistortion** ![image](/assets/images/2026-01-25-20-45-11.png) 원본사진(좌), 증강사진(우) U-Net 원본 논문에서 세포 분할(Cell Segmentation) 시 가장 강력했다고 언급한 기법으로 이미지를 젤리처럼 일그러뜨려 사람마다 다른 뼈의 미세한 굴곡을 학습하여 일반화 성능이 향상될것이라고 가정하고 적용했다. - **GridDropout** ![image](/assets/images/2026-01-25-20-45-17.png) 원본사진(좌), 증강사진(우) 가려진 mask에 대해서 문맥을 강제로 학습하도록 강제하면, 뼈의 문맥을 더 잘학습할것이라고 가정하고 GridDropout을 적용했다. - **결과** ![image](/assets/images/2026-01-25-20-45-24.png) SSR(빨강), griddropout(초록), baseline(노랑), rbc(청록),griddistortion(보라) **baseline**:0.9546 **RandomBrightnessContrast**: 0.9548 **ShiftScaleRotate**: 0.9566 **grid_distortion**: 0.9559 **grid_dropout**:0.9537 SSR을 제외한 나머지 기법들은 baseline에 비해 성능향상이 없었다. 따라서 baseline 대비 **0.002의 성능향상이 있었던 SSR**만을 이후실험에서 적용했다. ### 3.2.3 CLAHE ![image](/assets/images/2026-01-25-20-45-33.png) 원본사진(좌), 증강사진(우) 일반적으로 X-Ray데이터셋에서 Pixel단위에서 뼈를 더 잘 구분하는Augmentation이라고 알려진 CLAHE를 적용했다. `clip_limit=4` 로 고정하고, `tile_grid_size` 를 8,16,24로 실험해보았다. 하지만 실험결과 일관된 성능향상을 확인할 수 없었다. ### 3.2.4 Elastic Transform elastic augmentation 기법을 적용하여 중첩 뼈들의 여러 기하학적인 모양을 학습하게하여 더욱 다양한 중첩 부분을 구분하도록 만들기 위해 elastic을 적용하였다. ![image](/assets/images/2026-01-25-20-45-40.png) elastic 적용 결과(초록), baseline(보라) ![image](/assets/images/2026-01-25-20-45-45.png) elastic 적용 결과(초록), baseline(보라) elastic을 적용했을 때와 적용하지 않았을 때 두 뼈의 dice score를 비교해보면, Pisiform, Trapezoid에서 둘 다 val_dice가 약 0.0025정도로 소폭 상승한 것을 관찰할 수 있었다. 또한 평균 dice에서 elastic을 적용했을 경우 dice가 급락하는 지점 없이 꾸준히 우상향하여 과적합에도 좋은 성능을 낸다는 것을 확인하였다. elastic을 적용, 미적용했을 때의 클래스별 score 차이를 비교해보면, 두 뼈가 가장 많은 score 차이가 발생한 클래스는 아니지만, 난이도가 높은 중첩 뼈인 Pisiform, Trapezoid에서 dice에서 dice가 상승했다는 점과 평균 dice가 급락하는 지점 없이 우상향한다는 점을 미루어봤을 때 elastic augmentation을 적용하는 것은 전체적인 성능 향상에 도움이 되는것을 확인했다. ## 3.3 모델링 ### 3.3.1 손실함수 평가 ### **손실함수실험1. Focal, Lovasz** ![image](/assets/images/2026-01-25-20-45-52.png) FP(빨간색)와 FN(파란색)을 시각화(bce5 dice5) ![image](/assets/images/2026-01-25-20-45-56.png) bice 3 dice 4 lovasz 3 시각화 결과 거의 모든 뼈에서 테두리 부분에 False Positive가 몰려있는 것을 관찰할 수 있다. 이는 모델이 비교적 **넓은 부위인 뼈의 내부는 잘 잡아내는 반면, 흐릿하고 모호한 뼈의 테두리는 잘 잡아내지 못하는 것**을 알 수 있다. 모델 시각화 과정에서 알게된 False Positive 픽셀의 개수를 줄이기 위해 Lovasz Loss를 적용하는 실험을 진행하였다. 시각화 결과 뼈의 테두리와 중첩되는 뼈에서 FP가 많이 검출됨을 확인했고 손실함수를 통해 해결할 수 있다는 가설을 세웠다. 두 사진을 비교해보았을 때, Lovasz를 적용하여 때 기존 *BCE* 5 dice 5를 적용한 모델 대비 FP(빨간색)의 개수가 눈에 띄게 줄어든 것을 확인할 수 있다. 그러나 Score를 비교해보면 **0.967 → 0.961**로 Lovasz를 적용했을 때 0.006가량 하락했다. 이는 Lovasz를 적용함으로써, 모델의 경계를 보수적으로 잡아 오히려 탐지하지 못하는 부분이 늘어나서 결론적으로 Dice의 성능을 하락시킨 것 같다. 결론적으로 Lovasz를 사용한 것이 FP를 줄이는데에 기여하였으므로, *BCE*, Dice, Lovasz의 비율을 조정하여 최종 Score 도 올릴 수 있는 최적의 비율을 찾기위해 실험을 지속하였다. ***2-Stage에 Lovasz loss 적용*** Lovasz Loss는 어느정도 학습된 모델에 최종적으로 FP를 줄이기 위해 사용하면 효과가 나타날 것이라는 가설 하에 *BCE* 3 + Dice 4 + Focal 3으로 50 epoch 학습된 모델의 Pretrained Weight를 활용하여 2-stage 모델에 Dice 5 + Lovasz 5를 적용하여 학습을 진행했다. 실험 결과 1-Stage로 사용된 모델보다 Validation score가 0.0003 하락하여 유의미한 성능 향상의 결과를 얻지 못했다. - **Focal Loss** **뼈가 겹치는 곳은 해당 픽셀이 A뼈인지 B뼈인지 모델이 헷갈려해서 Confidence가 낮을 것이라는 가설을 세웠다.** 따라서 Confidence가 낮은 지점(겹치는 곳)의 분류를 더 잘 수행하기 위해 Confidence가 낮은 곳에 더욱 강한 Loss를 적용하는 Focal Loss를 도입하였다. 실험으로 (BCE 5, Dice 5), (Bce 4 Dice 2 Focal 4), (BCE 3 Dice 4 Focal 3)으로 비교해보았고, 가장 평균 Dice가 높고, 손목 뼈에서도 Dice가 높았던 (BCE 3 Dice 4 Focal 3)를 최종적으로 선택하게 되었다. ![image](/assets/images/2026-01-25-20-46-42.png) BCE3 Dice4 Focal3(핑크) 결과가 가장 높음을 확인했다. ### **손실함수 실험2. bce + Lovasz, tversky, Boundary Loss** 실험2에서는 stage를 2개로 나눠서 첫번째 stage에서는 bce_dice를 사용해서 0.95 이상의 val/dice를 갖는 Weight을 구축했고, 두번째 stage에서 첫번째 stage의 Weight을 가져와서 다양한 loss를 조작해보며 실험하는 방식으로 진행했다. Dice는 영역기반 Loss로 어느정도 객체를 잘맞추면, 즉 전체예측에서 오차의 비중이 낮아지면 학습율이 낮아진다. 이와 다르게, Lovasz는 IoU기반이긴 하지만, 오차가 큰순으로 정렬해서 가장 오차가 큰 틀린 픽셀들에 대해서 큰 가중치를 부여한다. Lovasz를 이용해서, stage1의 높은 dice score를 유지하면서, 일부의 오차를 해결할것으로 기대하고 실험을 진행했다. ![image](/assets/images/2026-01-25-20-46-48.png) Boundary Loss의 distance_map시각화 Boundary Loss는각 뼈 Class마다 Ground Truth를 기준으로 경계선에서 멀어질수록 큰 Loss를 부여한다. IoU를 기반으로 하는 Lovasz나 Dice를 기반으로 하는 Dice, 각 픽셀의 정답유무를 기준으로 하는 BCE와 달리, 객체의 경계선을 기준으로 하는 Boundary Loss를 도입함으로써, 손등은 물론, 손가락 뼈 마디의 경계를 더 잘 예측할 수 있을것이라고 가설을 수립하고 실험을 진행했다. ![image](/assets/images/2026-01-25-20-46-54.png) bce+Lovasz(연갈색)로 Finetuning한 결과가 가장 성능이 높음을 확인했다. **bce_lovasz:** 베이스라인보다 높은 성능을 확인했다. 하지만 여전히 손등의 겹친 뼈가 많은 영역에서는 과소예측을 통해, 손등뼈는 잘 예측해내지 못하는것을 확인했다. 실험결과 베이스라인(bce_dice) 대비 **가장 높은성능(0.9692)**을 보였다. **bce_lovasz_tversky:** 과대예측하는 손등뼈 클래스는 $\alpha$를 키워서 FP를 줄였고, 과소예측되는 손등뼈 클래스는 $\beta$를 키워서 FN을 줄이도록 노력했지만, bce_lovasz에 비해 성능향상은 없었다. **bce_lovasz_boundary:** Boundary Loss를 추가했지만, Lovasz에 비해 크게 성능향상을 보이진 않았다. ### 3.3.2 EMA(Exponential Moving Average), PointRend - **EMA** 배치 사이즈가 1~2로 매우 작아 학습 과정에서 가중치의 변동 폭이 크고 불안정한 문제가 있었다. 이를 해결하기 위해 **EMA**기법을 적용하였다. 학습 중인 모델 가중치의 이동 평균을 별도로 저장하여 이를 최종 추론 모델로 사용하는 방식으로, 이는 매 스텝마다 서로 다른 시점의 모델들을 앙상블하는 효과를 낸다. EMA 모델은 학습 데이터의 노이즈에 덜 민감하며, 손실 곡면(Loss Landscape) 상에서 Flat Minima에 수렴하도록 도와 일반화 성능을 높였다. - **PointRend** 모델이 가장 헷갈려하는 경계면(Uncertain Region)의 품질을 개선하기 위해 **PointRend** 모듈을 도입하였다. PointRend는별도의 MLP를 통해 객체 경계의 픽셀을 정밀하게 보정한다. 이를 통해 객체 경계에서의 계단 현상없이 벡터 그래픽 수준의 날카로운 경계면을 얻을 수 있었으며, 이는 Dice상승에 직접적으로 기여하였다.   EMA, PointRend 적용 후 Public score: **0.9728**로 0.9697에 서 **0.0031증가** ### 3.3.3 LR Scheduler - **CosineRestartWarmupScheduler** Public과 validation score간의 점수차이가 모델마다 들쭉날쭉하고, 최소 0.003차이가 났기 때문에, 모델이 Local Minima에 수렴한것으로 가정했다. 따라서 Cosine Restart Warmup Scheduler를 사용함으로써 베이스라인으로 사용하던 cosine annealing, Linear LR과는 다르게, Local Minima에서 탈출할 수 있다고 가설을 세우고 실험했다. ![image](/assets/images/2026-01-25-20-47-07.png) ![image](/assets/images/2026-01-25-20-47-13.png) CosineRestartWarmupScheduler를 사용함으로써 Public/valid score간의 점수차이가 **0.0028로**소폭 하락함을 확인했다. ### 3.3.4 input 해상도와 모델사이즈간의 관계 Batch Norm에서 GroupNorm으로 바꾼 이후로 배치사이즈를 줄여도 안정적인 학습이 가능해졌다. 가능한 인풋 해상도를 높이고, 백본사이즈에서 타협을 하는게 좋겠다고 판단했다. *On the Effect of Image Resolution on Semantic Segmentation* 논문에서 주장한바처럼, 백본 사이즈를 줄이더라도, Input 해상도를 최대한 키우는게 성능향상에 도움이 될것이라고 가정했고, Input해상도를 OOM이 뜨지 않는 한 최대한 높여서 이후 실험을 진행했다. ## 3.4 단일 모델 실험 및 결과 모델실험은 이전의 실험결과에서 효과가 있었던 방법들을 적용하여, 다양한 인코더, 디코더 조합을 사용해서 각자 진행함. ### 3.4.1 모델실험1 - 다양한 아키텍처 비교 실험 진행. 최종적으로 **Mask R-CNN (ConvNeXtV2)** 선정. | **Model** | **Backbone** | **비고** | | --- | --- | --- | | **Unet++** | **EfficientNetV2-L** | **최종 베이스 모델 선정 (Exp55_v3). 가장 높은 성능 달성.** | | SegFormer | MiT-B4 | 빠른 수렴(50 epoch)과 준수한 성능(Dice 0.9645), 학습 속도 우수. | | Unet++ | MobileNetV2 | 경량화 모델 실험. 학습 속도는 빠르나 정확도 면에서 V2-L에 비해 열세. | | Unet | ConvNeXt | Multi-scale Attention 적용 시도. Swin 대비 효율적이나 최종 성능은 낮음. | ### 3.4.2모델실험 2 - HRNet - Mix Vision Transformer (mit) - ConvNeXt V2 | 모델명 | Validation Score | | --- | --- | | hrnet_w18 | 0.9570 | | hrnet_w32 | 0.9581 | | hrnet_w48 | 0.9595 | | mit_b2 | 0.9523 | | mit_b3 | 0.9552 | | mit_b4 | 0.9571 | | convnextv2_tiny | 0.9532 | | convnextv2_base | 0.9538 | ⇒ `0.1` 보다 `0.5` 일 경우, 더 높은 성능을 보임 ⇒ 사전 학습 가중치가 x-ray 이미지에 적응이 필요한 것으로 해석됨 - convnextv2와 2가지 decoder(FPN, UNET) 조합 확인 - 2가지 사이즈에서 동일한 결과를 보일 줄 알았는데 예상과는 다름 - `tiny` 의 경우, fpn과의 조합이 더 좋은 성능을 보임 (+0.0045) - `base` 의 경우, UNET과의 조합이 더 좋은 성능을 보임 (+0.0021) | ConvNeXt V2 | FPN | UNET | | --- | --- | --- | | convnextv2_tiny | 0.9670 | 0.9625 | | convnextv2_base | 0.9685 | 0.9706 | 의료영상 데이터에 특화된 monai 라이브러리의 swin unetr 모델 scratch로 학습 기대한만큼 성능이 나오진 않았다. ### 3.4.3 모델실험 3 - SegFormer : 0.9665 - 이전 데이터 전처리 단계에서 효과를 본 실험들 간단하게 점검 : 모델 변경 + 나머지 그대로 vs 모델 변경 + 전처리 + 증강 - 학습 안정화 : gradient accumulation, gradient clipping, cosine annealing, ema 개별 적용 후 결과 확인 - ConvNeXt + UperNet : 0.9747 - 이전 데이터 전처리 단계에서 효과를 본 실험들 간단하게 점검 : 모델 변경 + 나머지 그대로 vs 모델 변경 + 전처리 + 증강 - 높은 Dice 점수 확인 후, 5-Fold 학습 ### 3.4.4 모델실험 4 우선 주어진 베이스라인 코드에서는 해상도 512가 적용되어있었다. 하지만 **원본 이미지의 크기인 2048을 512로 압축하는 것은 정보 손실이 발생하여 성능 하락의 주요 원인이 될 것이라고 보았다**. 실제로 아래의 표는 베이스라인 모델에서 클래스별 Dice Score를 오름차순으로 정리한 결과인데, 상대적으로 크기가 작은 뼈인 손등 뼈와, 손가락 끝 뼈(finger 4, 8, 12, 16)이 모두 순위권 상단을 차지하고, 크기가 큰 뼈인 팔목 뼈(Ulna, Radius)는 모두 하위권을 차지하는 것을 볼 수 있다. 이로 인해 작은 객체를 탐지하는 능력을 보완하는 것이 중요하다는 것을 깨달았고, 512로 이미지를 압축하여 정보가 손실되는 것은 더욱 치명적일 것이라고 생각되었다. 또한 이미 베이스라인의 Dice 점수는 0.94로 높은 점수인 상황이기에 경계선의 디테일을 보존하는 것이 성능을 향상시키는 주요한 원인이 될 것이라고 보았고, 따라서 굳이 파라미터가 많은 무거운 모델을 사용하여 해상도를 낮추는 것 보다는, **적은 파라미터 수를 가진 모델을 활용하여 이미지를 최대한 완전하게 보존하는 방향을 선택**하였다. ***모델 실험*** 아래 표는 Loss와 Optimizer, Learning Rate, 해상도 2048, 배치 사이즈 2 등 통제 변인을 갖추고 Backbone과 Decoder를 다양하게 조합하며 실험한 결과이다. 고해상도의 이미지 Input을 입력하고도 OOM이 발생하는 것을 방지하기 위해 경량 모델인 MobileNet과 EfficientNet 위주로 탐색하게 되었으며, 예외적으로 EfficientNet-b4 모델에는 해상도 2048, 배치 2로 학습을 시작할 때 OOM이 발생하여 배치 사이즈를 1로 두고 실험을 진행하였다. 실험 결과 Backbone으로 EfficientNet-b0를 사용하는 것이 가장 높은 성능이 나타나는 것으로 확인 되었다. 뛰어난 모델은 적은 epoch에서도 높은 성능을 띌 것이라 생각하여 MobileNet-v3 + LRASPP와 EfficientNet-b4에서는 초기 성능이 낮아 실험을 중단하였는데, 학습 후반에 급격한 성능이 향상되는 모델의 가능성을 배제하고 성급하게 단정했다는 점이 아쉽고, 이는 차후 실험에서는 모델을 탐색할 때 충분한 epoch를 설정해서 보완해야 한다고 생각되었다. | Backbone | Decoder | ep10 dice | ep50 dice | loss | 배치 | | --- | --- | --- | --- | --- | --- | | MobileNet-v3 | DeepLab-v3 | 0.9607 | 0.9639 | bce + dice | 2 | | MobileNet-v3 | LRASPP | 0.9596 | x | bce + dice | 2 | | EfficientNet-b0 | PAN | 0.9299 | 0.9626 | bce + dice | 2 | | EfficientNet-b0 | FPN | 0.9652 | **0.9706** | bce + dice | 2 | | EfficientNet-b0 | Unet++ | 0.8210 | **0.9713** | bce + dice | 2 | | EfficientNet-b4 | FPN | 0.9528 | x | bce + dice | 1 | ***Decoder 실험*** Backbone을 EfficientNet-b0로 고정한 뒤 디코더를 FPN, UNet++, PAN로 교체하며 실험을 진행하였다. 아래 그래프를 보았을 때 UNet++의 Validation 점수가 가장 높았으나 Public 점수는 0.01가량 큰 폭으로 하락한 것을 확인할 수 있다. 반면 FPN의 경우, Validation 점수는 UNet++보다 낮았지만, Public에서 약 0.003으로 소폭 하락하여 public에서 최종적으로 가장 높은 성능을 나타내는 것을 확인할 수 있다. 이론적으로 UNet++은 복잡한 Skip Connection이 적용되어 풍부한 Feature Map을 활용하기 때문에 FPN보다 높은 성능을 띌 것이라고 예상하였고, 실제로 Validation에서는 높은 성적을 띄었지만 Public에서는 크게 점수가 하락한 점에서 의문이 들었다. 이러한 의문점에 대해 다음과 같은 두 가지 가설을 세웠다. 1. UNet++ 모델 복잡도에 의해 Train 데이터에 과적합 되어서 Public에서는 좋지 못한 성능을 띄었다. 2. 스케쥴러 미사용으로 인해 Local Minima에 수렴되었다. 결론적으로 이론과 실험의 차이에서 어떤 디코더를 사용해야할 지에 대한 고민이 되었지만, 현재 데이터셋에는 실험적으로 입증한 FPN이 더욱 우세할 것이라고 판단되어 최종 모델에도 FPN을 적용하게 되었다. ![image](/assets/images/2026-01-25-20-55-11.png) ***성능 향상을 위한 모델 실험*** 최종적으로 성능 향상을 위해 해상도 2048, 배치 사이즈 2를 수용 가능하면서 가능한 OOM이 발생하지 않으면서 GPU 사용량을 최대화할 수 있는 모델을 탐색하게 되었다. Backbone은 기존 EfficientNet-b0 모델에서 파라미터수가 더 많아 정교한 Feature Map을 추출할 수 있는 EfficientNet-b3와 ConvNeXtv2-base 모델로 교체할 수 있었고, 실험 결과 EfficientNet-b3 모델에서 0.0005 더 향상되었다. 따라서 **최종 모델로 Backbone에는 EfficientNet-b3 모델을, Decoder는 FPN을 선택**하게 되었다. | Backbone | Decoder | ep50 dice | | --- | --- | --- | | ConvNeXtv2-base | FPN | 0.9723 | | EfficientNet-b3 | FPN | 0.9728 | 최종 모델은 여러 실험적으로 얻은 결과중 성능 향상이 있었던 방법론들만 적용하였으며, 최종 Private Dice 0.9729을 달성하였다. | Decoder | FPN | | --- | --- | | Backbone | EfficientNet-b3 | | 해상도 | 2048 | | 배치 | 2 | | epoch | 50 | | Loss | bce 3 dice 4 focal 3 | | Scheduler | Cosine Warmup(ratio 0.1) | | Optimizer | AdamW | | Learning Rate | 0.0001 | | Augmentation | Elastic, Resize(2048) | ### 3.4.5 모델실험 5 2개의 Stage로 나눠서 학습 진행 - 첫번째 Stage에서는 20epoch로 Dice를 안정시키는것을 목적으로 함 - bce_dice를 이용해서 빠른 수렴 - bce(0.5) + dice(0.5) + pointrend(0.5) - 두번째 Stage에서는 80Epoch로 FineTuning을 목적으로 함 - bce_lovasz를 사용해서 Hard Example에 대해서 Finetuning - bce(0.5) + dice(0.5) + pointrend(1.0) - Point Render의 Weight를 0.5에서 1로 올려서 경계에 대해 더 많은 학습 ![image](/assets/images/2026-01-25-20-54-58.png) ## 3.5 모델 앙상블 앙상블을 할 때 단순 여러 모델의 Confidence를 평균내는 Simple Average 앙상블 방법을 써야할 지, 모델마다 가중치를 두는 Weighted 앙상블 방법을 써야할 지에 대한 고민이 많았다. 모델에 가중치를 두는 방법을 보통 선택해왔으나 고민이 되는 이유는 일단 모든 모델에서 대체적으로 점수 차이가 0.01 미만으로 미미하고, 앞으로 하게될 앙상블 모델 조합이 다양해 비록 점수는 낮더라도 다른 부분에서 강점을 보일 수 있기에 Seight를 주는 기준을 세우기가 모호하였다. 따라서 전체 모델에 같은 가중치를 두는 Simple Average Soft Voting 방법을 선택하게 되었고, 아래는 시도해보았던 앙상블 목록이다. | 앙상블 이름 | Private dice score | | --- | --- | | 최종 단일 모델에 5-fold soft voting | 0.9736 | | Cross validation Ensemble | 0.9624 | | 인코더, 디코더 diversity soft voting | 0.9745 | | Top 3 hard voting | **0.9760** | ***최종 단일 모델에 5-fold soft voting*** 전체 학습 데이터를 학습하여 모델의 넓은 시각을 확보하기 위해 K-fold 앙상블을 시도하였다. 개인 최종 모델인 FPN + EfficientNet-b3 모델을 5-fold Soft voting한 결과 private 기준 Dice 0.9729에서 0.9736로 단일 모델로 제출했을 때 보다 0.0007 상승한 것을 확인하였다. ***Cross Validation Ensemble*** 특정 폴드에만 과적합 되는 것을 방지하기 위해 다른 fold를 학습한 각 모델들을 Soft Voting 앙상블 하였다. 앙상블에 사용된 모델 조합은 아래와 같다. 제출 결과 Private Score 0.9624로 다른 앙상블 제출 내역보다 점수가 약 0.01정도 큰 폭으로 하락한 것이 확인되었다. | fold 번호 | Decoder | Backbone | val dice | | --- | --- | --- | --- | | fold 0 | OCR | HRNet | 0.9755 | | fold 1 | UNet++ | EfficientNetv2-L | 0.9733 | | fold 2 | FPN | MiT | 0.9730 | | fold 3 | FPN | EfficientNet-b3 | 0.9735 | | fold 4 | UPerNet | ConvNeXtv2-base | 0.9737 | ![image](/assets/images/2026-01-25-20-47-22.png) | 모델 | private dice | | --- | --- | | UperNet + ConvNextv2-base 5-fold soft voting | 0.9758 | | FPN+Efficientnet-b3 / Unet++ +Efficientb0 / FPN+ConvNeXt-v2 soft voting | 0.9745 | | OCR + HRNet 단일 모델 | 0.9735 | ***인코더, 디코더 Diversity Soft Voting*** 인코더와 디코더의 다양성을 확보하여 단일 모델의 구조적 편향을 막기 보완하기 위해 FPN+Efficientnet-b3 / Unet++ +Efficientb0 / FPN+ConvNeXt-v2 세 모델로 soft voting 앙상블을 진행하였다. Private Dice 0.9745를 달성하였으며 FPN+Efficientnet-b3 단일 모델 K-fold 앙상블한 모델의 점수와 비교했을 때 0.0009로 향상한 것을 확인할 수 있었다. ***Top 3 Hard Voting - 최종 제출*** Validation과 Public의 점수 차이를 방지하기 위해 리더보드 기준 상위 3개 모델의 csv 파일을 활용하여 Hard Voting 앙상블을 진행하였다. 사용된 모델은 아래와 같으며 최종적으로 Hard Voting하여 결과를 제출하였다. 앙상블하여 제출한 결과 Private Dice 0.9760로, 가장 점수가 높았던 UperNet + ConvNextv2-base 5-fold Soft Voting에 비해 0.0002 소폭 상승한 것을 확인할 수 있고, 가장 높은 Dice를 나타내어 최종 제출한 모델로 선정되었다. K-fold 앙상블로 전체 데이터의 시각을 챙긴 모델, 여러 인코더와 디코더의 조합으로 특징 추출을 다양화한 모델, 그리고 추론 성능이 가장 좋았던 단일 모델을 활용하여 구조적, 다양성 측면에서 좋은 시너지를 내었다고 생각이 된다. # 4. 프로젝트 수행 결과 ## 4.1 최종성과 Public Score: **0.9749** Private Score: **0.9760** ![image](/assets/images/2026-01-25-20-48-04.png) ## 4.2 자체평가 및 회고 ### 나는 내 학습목표 달성을 위해 무엇을 어떻게 했는가? 팀 프로젝트인 만큼 팀원들과의 협업을 통해 중복된 실험을 최대한 줄이려고 노력했다. WandB를 통해 서로의 실험 진행상황을 실시간으로 공유했고, Notion을 통해 실험 진행상황을 공유했다. 우선 지난 프로젝트인 재활용 쓰레기 Detection 프로젝트에서는 Data의 Annotation이 잘못된 경우가 많았었기 때문에, 최대한 EDA를 통해 이미지의 분포를 확인하고, FeatureEngineering과 Preprocessing을 통해서 데이터를 정제하려고 노력했다. 회전된 손이 test Dataset에서Traindataset에 비해 10배 많다는 사실을 확인했고, 그 사실을 확인하기 위해서 세끼손가락과 손목뼈를 잇는 벡터의 각도를 측정하는 로직을 이용했다. 그리고 성별에 따른 Mask Size의 상관관계를 확인하고, 이를 해소하기 위해 OverSamppling의 방법을 적용해보았다. 분포 불균형을 Oversamppling을 이용해서 해소해보려는 시도는 실패했지만, 분포간의 불균형을 시각화해서 확인했다는 점에서 지난 프로젝트에 비해 발전이 있었고, 변화되었다고 느꼈다. 그리고 최대한 객관적인 결과를 팀원들과 공유하기 위해서 나머지 변인들을 통제하고, 한개의 변인씩만 변경해가면서, 해당 변인의 효과를 증명해나가려고 노력했다. 실제로, 지난 Detection 프로젝트에 비해, 팀원들 모두 한개의 변인씩 실험한 결과를 공유해서 해당 기법이 효과가 있었는지 판단하기가 수월해졌다. ### 나는 어떤 방식으로 모델을 개선했는가? 데이터를 Preprocessing하고, 모델링측면에서 EMA, PointRend를 적용해서 모델성능향상에 기여했다. 특히 Input 이미지에서 이미지 주변의 흰색 노이즈를 제거한 결과, 초기성능향상을 관찰했고, EMA, Point Rend를 적용한 결과 **0.0003이상의** Dice score향상을 관찰했다. 그리고 Public score와 Validation score사이의 차이는Local Minima에 수렴했기 때문이라고 가정했고, Cosine WarmUp Restart Scheduler를 사용한 결과 **0.0001**수준의 차이를 좁힐 수 있었다. 그리고 학습 후기에 모델의 손등부분의 **Hard Example**에 대해서 예측을 못함을 확인하고, Dice loss 함수를 Lovasz로 바꾸기 위해서 Stage1,2로 나누어서 Finetuning단계에서만 Lovasz Loss를 사용했다. 그 결과 bce_dice기준 **0.0002** score가 향상함을 관찰했다. 모델의 성능개선을 위해서는 Input 이미지의 해상도를 높여주는게 제일 중요하다는것을 실험적으로 확인했다. Input이미지의 해상도를 향상시키기 위해 AMP를 구현해서 제한된 V-ram을 효율적으로 사용하도록 개선했다. OOM으로 인해 배치사이즈를 키우는데 한계가 있어서, Group Norm을 구현했고, Batch Norm을 사용하던 기존의 방식에서 벗어났다. 그 결과 배치사이즈를 1로 설정한 다음 해상도를 키워서 학습할 수 있었고, 성능향상을 관찰했다. ### 마주한 한계는 무엇이며, 아쉬웠던 점은 무엇인가? 모든 방법들은 성능향상에 기여하지 않는다는 것이다. 특히 메타데이터를 이미지와 함께 임베딩해서 학습하도록 멀티모달 모델을 만들었었는데, 초반부에는 학습속도가 개선되었지만, 오히려 후반부에는 메타데이터가 Segmentation에 방해되는것을 관찰했다. 가능성을 실험해보는 차원에서 필요했던 실험이었지만, 성능향상이 실질적으로 내 task에서는 없는 기법도 많다는것을 알게되었다. 경진대회에서 0.0001점이라도 올리기 위해서는 라이브러리의 모델을 가져다 쓰는것으로는 부족하다는 것이다. 라이브러리의 모델을 가져다 쓰면 간단하게 코드 몇줄로 설정을 끝마치고 바로 사용이 가능하다. 그런데, 경진대회에서 점수를 조금이라도 올리기 위해서는 모델을 커스텀해서 사용해야한다. OOM을 줄이기 위해 인코더의 사이즈를 커스텀으로 줄인다거나, 인코더의 layer를 Freeze시켜보는등 다양한 실험이 필요하다. 따라서 인코더와 디코더 모델에 대한 이해를 바탕이 되어야만 고득점을 노릴 수 있다는것을 알게되었다. ## 5. Reference - - On the Effect of Image Resolution on Semantic Segmentation - - ### Week11-12_ObjectDetection_WrapupReport - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-11-30-ObjectDetecvtion_WrapupReport%20copy/ - Collection: WeeklyReview - Published: 2025-11-30 - Tags: Project, ObjectDetection, WeeklyReview # 1. 프로젝트 개요 ## 1.1 프로젝트 주제 ![image](/assets/images/20260125202059.png) 사진에서 쓰레기를 Detection 하는 모델을 만들어서 일반 쓰레기, 플라스틱, 종이, 유리 등 10 종류의 쓰레기가 찍힌 사진 데이터셋에서 Detection을 하는 분류모델을 개발 ## 1.2 프로젝트 구현 내용 SOTA급 모델들을 이용하여, 주어진 데이터셋으로 Finetuning을 진행한 후 Detection을 수행한다. EDA, FeatureEngineering, 클래스 불균형 처리, 모델 앙상블등 다양한 모델 최적화 기법을 적용하여 최종 성능을 향상시킴 ## 1.3 개발환경 **H/W**: Tesla V100 GPU 서버 3대 **S/W**: mmdetection, Ultralytics, Python, PyTorch, Pandas, Scikit-learn **실험관리**: Wandb, Notion ## 1.4 데이터셋 ![image](/assets/images/2026-01-25-20-26-10.png) ### Train 데이터셋 총 이미지 수: 4883, 총 annotation 수: 23144, class 수: 10 ### Train 클래스별 분포 | Class | Number | Ratio | | --- | --- | --- | | Paper | 6352 | 27.45% | | Plastic Bag | 5178 | 22.37% | | General Trash | 3966 | 17.14% | | Plastic | 2943 | 12.72% | | Styrofoam | 1263 | 5.46% | | Glass | 982 | 4.24% | | Metal | 936 | 4.04% | | Paper pack | 897 | 3.88% | | Clothing | 468 | 2.02% | | Battery | 159 | 0.69% | # 2. 프로젝트 팀 구성 및 역할 | 팀원 | 역할 | | --- | --- | | 노성환 | Group DETRv2 | | 박상범 | EDA, RTMDet, Dino, Feature Engineering, NMS, WBF, TTA, 앙상블 | | 안진경 | Cascade-ResNeXt101, Cascade-Swin-L, AdamW, Augmentation, Focal Loss, Confidence Thr조정 | | 이가현 | EDA, Cascade RCNN, yolov13, mask RCNN, ConvNeXt, Augmentation, NMS, WBF, 앙상블 | | 이혜준 | EDA, GroupStratifiedKFold, Augmentation, Dino-swin-L, Oversampling, Focal Loss, TTA, WrapUp Report 작성 | | 황은배 | yolo, RT-DETR, EDA, Optimizer탐색(SGD, AdamW) | # 3. 프로젝트 수행 절차 및 방법 각자의 베이스라인 코드를 가지고 실험한 후 마지막에 앙상블하는 전략을 사용함. ## 3.1 데이터 분석 및 증강 ### 3.1.1 Faster R-CNN, Cascade R-CNN, Mask R-CNN - **Data Split:** 클래스 불균형을 고려하여 Stratified Split 적용 (Train:Valid = 9:1). 학습 데이터 확보에 중점. - **Augmentation 실험** - 전체적으로 이미지의 형태가 가지런 하거나 좌우 구별이 필요없어 augmentation으로 다양한 각도에서도 feature를 볼 수 있도록 augmentation을 설정했다. - baseline모델 중 pytorch fasterrcnn모델로 augmentation 시 많은 다양성이 보장된다면 성능이 높은지에 대한 실험을 진행했다. - (resize, HorizontalFlip, VerticalFlip, one of(RandomBrightnessContrast, HueSaturationValue, RandomGamma), one of(Blur, GaussianBlur, MedianBlur), ShiftScaleRotate, CLAHE, Normalize)에서 각 확률이 0.2인 것은 0.3으로 높였다. - 기본(Flip, ShiftScaleRotate 등)에 강한 기법(RandomSunFlare, JpegCompression 등)을 추가했을 때 mAP가 **0.4733 → 0.4629로 하락**. - **분석:** 과도한 이미지 왜곡이 오히려 객체 고유의 특징(Feature)을 훼손하여 학습을 방해한 것으로 판단. ![image](/assets/images/2026-01-25-20-26-31.png) ### 3.2.2 Dino-swin-L train dataset은 Glass, Paper, Metal, Clothing, battery클래스에서 5%도 되지 않을정도로 클래스간 불균형이 크다고 판단했다. 따라서 train, validation데이터셋을 GroupStratified 5-Fold를 이용해서 나눠주었다. 그 결과 각 Fold별로 클래스가 골고루 포함되도록 Fold를 나눌 수 있었다. ![image](/assets/images/2026-01-25-20-26-40.png) GroupStratified 5-Fold 적용결과 `albu` 라이브러리를 이용해서 pixel값과 관련된 Augmentation을 진행했다. 이미지 중간에 랜덤하게 구멍을 뚫는 `CoarseDropout` , 그리고 `CLAHE, RandomGamma` ,`HueSaturationValue`를 통해 대비, 휘도를 랜덤하게 조정했고, 밝기, 샤픈도 랜덤으로 조정해서 모델의 강건성을 갖도록 설정해줬다. 이 값들은 주피터 노트북 코드셀에서 사진을 직접 시각화하면서, 너무 변형해서 알아보지 못할정도인지 아닌지를 체크하면서 값들을 조정해주었다. 직관적으로 test dataset에서 나올법한 변형인지 아닌지를 눈으로 확인하면서 값을 조정했다. `MotionBlur`랑 `ImageCompression`은 뺐는데, 오히려 객체의 Texture를 숨겨버려서 학습에 방해된다고 판단했다. 특히 모델은 Metal과 Plastic, Paper Class를 헷갈려하는 경향이 있었는데 블러, Compression을 시켜버리면 사람이 봐도 어려울정도로 객체의 질감을 뭉개버리는 경향이 있었다. 이와 반대로 `IAASharpen`을 통해 이미지의 샤픈을 랜덤으로 조정해줬는데 샤픈값을 랜덤으로 추가해서 객체의 질감을 더 살려주었다. 모델이 Classification하기 어려워하는 Metal, Plastic, paper사이의 texture를 명확하게 만들어주도록 기대했다. ![image](/assets/images/2026-01-25-20-26-55.png) Augmentation 적용 결과 ![image](/assets/images/2026-01-25-20-27-06.png) 모델의 학습 결과를 보니 mAP_m과 mAP_s는 0.02도 안될정도로 아예 못맞추고 있음을 확인할 수 있었고 mAP_l이 거의 mAP50의 성능을 끌어올리고 있음을 확인할 수 있었다. 작은객체의 mAP를 높이기 위해서 이미지를 확대해서 모델에 넣어줘야겠다고 생각했다. RandomResize를 통해서 이미지를 2.5배까지 랜덤으로 확대해서 dataset으로 넣어주었다. 다양한 사이즈에서 mAP성능을 올리기 위해서 이미지를 우선 모자이크해서 사이즈를 1/4로 만들어줬다. 원래 매우 큰 박스에서의 객체는 1/4가 된다. 그리고 모자이크한 이미지를 0.8~1.5배로 리사이즈해서 모델에 넣어준다. 모델은 이로써 모자이크 후 리사이즈된 이미지를 보고 매우 다양한 크기의 박스를 보고 학습할 수 있게된다. ![중심부에만 Attention되어있는 사진](/assets/images/2026-01-25-20-27-17.png) ![Random Resize와 모자이크 적용결과](/assets/images/2026-01-25-20-27-24.png) 이와 더불어 모자이크를 통해, 서로 같이 자주 등장하지 않는 객체들도 랜덤으로 같이 등장할 수 있고, 사진의 중심부에만 위치하던 객체들이 가장자리에도 골고루 위치할 수 있게 되어 모델이 Robust하게 됨을 기대했다. ## 3.2 단일 모델 실험 및 결과 ### 3.2.1 RTMDet ![image](/assets/images/2026-01-25-20-27-51.png) Soft NMS를 적용한 결과 ![image](/assets/images/2026-01-25-20-27-57.png) NMS를 적용한 결과 - Stratified K-Fold - TTA, NMS vs WBF 실험 - WBF보다 NMS를 이용했을때 더 높은성능을 관찰했고, Soft NMS보다 **hard voting 방식의 NMS**를 적용했을때 **더 높은 성능(약 0.015향상)**이 나옴을 관찰했다. ### 3.2.2 Dino-Swin-L ![image](/assets/images/2026-01-25-20-28-05.png) Augmentation이 적용되지 않은 기본 모델 ![image](/assets/images/2026-01-25-20-28-12.png) Augmentation, Focal Loss, 오버샘플링이 적용된 모델 ![image](/assets/images/2026-01-25-20-28-21.png) TTA(0.8배~1.5배 랜덤 리사이징)을 적용한 모델 ![image](/assets/images/2026-01-25-20-28-27.png) Pseudo Labeling을 적용한 결과 - 12 epoch - GroupStratified K-Fold - 2stage 학습 - 첫번째 stage는 모자이크를 비롯한 Heavy Augmentation, 두번째 stage(마지막 2에폭)은 Augmentation없는 기본 이미지로 학습 진행 - Focal Loss 추가, 오버샘플링 - 클래스 불균형을 고려해서 소수클래스에 더 강하게 학습 - `Frozen stage = 2` - 초기 백본을 얼리고, 뒷단의 layer만 학습진행 - 3으로 설정했을때보다, 1에폭부터 **0.59를 달성하며 0.09 mAP50 향상**을 관찰 - Heavy Augmentation - CoarseDropout - CLAHE, RandomGamma, HueSaturationValue - IAASharpen - 결과: **0.6560에서 0.6669로 성능향상**을 관찰 - TTA실험 - 결과: TTA를 이용해서 추론한 결과 **0.6349로 Public score가 감소**하는 결과를 관찰했다. - Pseudo labeling - 결과: Pseudo Labeling을 적용한 결과 0**.6059로 오히려 Public score가 감소**하는 결과를 관찰했다. ### 3.2.3 Cascade R-CNN - LinearLR에 비해 ConsineAnnealingLR 적용시 **0.4366에서 0.5822로 성능향상** - backbone convnextv2로 교체 - Augmentation - 너무강한 Augmentation을 적용시 **0.4733에서 0.4629로 성능하락** 관찰 ### 3.2.4 Mask R-CNN ![image](/assets/images/2026-01-25-20-28-36.png) mask_rcnn모델(ConvNeXt v2)36에폭 실험결과 ![image](/assets/images/2026-01-25-20-28-41.png) albu를 이용한 augmentation 이후 실험결과 ![image](/assets/images/2026-01-25-20-28-46.png) 5Fold Ensemble한 결과 - Cascade R-CNN과 동일 - 같은 세팅에서 Cascade R-CNN보다 더 나은 성능을 보임 - 36epoch과 47epoch을 비교해서 test해본 결과 **0.6281에서 0.6174로 성능 하락** 관찰 → 너무 많은 epoch은 오버피팅이 발생함을 확인 - K-Fold를 적용하여 10epoch씩 5Fold로 학습 진행 → **0.6420으로 성능향상** - WBF적용시 오히려 **0.5574로 성능하락** 관찰 → **NMS**방법 유지 ### 3.2.5 RT-DETR ![image](/assets/images/2026-01-25-20-29-02.png) ![image](/assets/images/2026-01-25-20-29-07.png) ![image](/assets/images/2026-01-25-20-29-11.png) ![image](/assets/images/2026-01-25-20-29-17.png) - optimizer 테스트 - 각 모델과 맞는 적절한 optimizer 사용이 성능에 중요함을 이해함 - YOLO → SGD - RT-DETR → AdamW - Scheduler 사용 - Cosine Annealing Learning Rate - 학습 중/후반 과정 곡선의 완만한 감소로 인해 학습 안정성 상승 ### 3.2.5 Yolo - 더 최신 버전의 모델을 선택 (YOLOv3 → YOLO11) - 적절한 크기의 모델을 선택 (YOLO11의 `m`, `l`, `x` 중 `l` 을 선택) - 다양한 크기의 YOLO11 모델의 성능을 테스트 - 학습 데이터셋의 크기에 따라 적절한 크기의 모델을 선택해야 성능이 보장됨 - 2가지 optimizer(SGD, AdamW)를 YOLO 모델에 사용 - AdamW보다 SGD에서 성능이 잘나오는 것을 확인 - 모델 구조와 특성에 따라 적합한 optimizer가 존재한다는 것을 알게 됨 ## 3.3 모델 앙상블 ### 3.3.1 WBF vs NMS 일반적으로 NMS에 비해 WBF방식이 mAP성능 향상에 기여한다고 알려져있다. 이에, Mask-RCNN모델로 `Confidence_Threshold` 를 0.005로 둔 후 WBF와 NMS방식을 실험해본 결과 실험적으로 NMS방식이 더 좋은 성능을 보임을 확인했다. ![image](/assets/images/2026-01-25-20-29-25.png) ### 3.3.2 모델앙상블 ![image](/assets/images/2026-01-25-20-29-29.png) ![image](/assets/images/2026-01-25-20-29-35.png) 기존에 다양한 아키텍처를 기반으로 실험한 모델들을 앙상블했다. 아키텍처로는 Transformer 기반 Dino(Public score: **0.6669**), 2stage모델인 Masked R-CNN 5fold 앙상블모델(Public score: **0.6420**), 1stage모델인 RTMDet(public score: **0.6715**)을 앙상블하여, 다양성을 갖도록 했다. 그 결과 각 모델의 mAP성능을 Weight로 준 Weighted_ensemble이 Public Score기준 **0.6939**로 가장 높은 성능을 달성했고, 마찬가지로 NMS방식을 사용하여 3개의 모델을 앙상블한 결과가 **0.6927**로 두번쨰로 높은 성능을 달성했다. # 4. 프로젝트 수행 결과 Public score: **0.6939** (8위/13) Private Score: **0.6808** (8위/13) ![image](/assets/images/2026-01-25-20-29-42.png) ![image](/assets/images/2026-01-25-20-29-47.png) # 5. 자체 평가 의견 - 충분한 EDA 및 Feature Engineering을 하지못했다. - 실험결과와 관련해서 팀원들과 왜그런 결과가 나왔는지 의견교환을 많이 해보지 못한게 아쉽다. - 시간이 부족해 실험이 부족했다. - 팀 차원에서의 계획 및 역할 분담이 구체적이지 못했다 - 학습보다 프로젝트의 점수를 올리는 방향으로 치우쳤던 것 같다 - 성능 올리는데만 집착하여 정확한 실험 분석을 토대로 데이터 증강 기법을 활용하지 못했던 것이 아쉽다 - 팀 협업 툴 활용 능력도 부족했다. - 단순 점수(mAP) 높이는 것을 넘어 inference 시간에 대한 문제점도 같이 고민을 하여 더 많은 관점을 고민을 해볼 수 있었다. - 가능성 있는 모델 확인 과정에서 너무 많은 시간을 소모하였다. - 팀 차원의 컴페티션 대회가 어떻게 진행되는지 감을 잡을 수 있었다. **머신러닝 프로젝트의 전반적인 과정경험** --- Object Detection task를 프로젝트로 진행해보며, EDA, FeatureEngineering, Augmentation 탐색, SOTA 모델탐색, 실험 및 피드백의 일련의 과정을 경험해보았다. 특히 EDA를 해보며, 물체의 종횡비, 한 물체당 객체, 클래스의 개수, 클래스의 비율등 데이터셋이 갖고있는 특징들을 눈으로 확인해보고, 모자이크와 같은 기하적 증강, 밝기나, 휘도같은 픽셀적 증강을 적용해보며 mAP성능향상을 확인할 수 있었다. 그리고 DETR기반의 모델이 현재 성능상으로는 SOTA를 달성하고 있음을 확인할 수 있었고, 이번 프로젝트를 발판삼아 추후 프로젝트에서도 DETR기반 모델을 기반으로 모델 탐색 및 앙상블 전략을 수립할 예정이다. **충분한 EDA 및 Feature Engineering의 중요성** --- 결과적으로 Heavy Augmentation을 통해 mAP성능 향상을 확인할 수 있었지만, 모델의 Pretrained된 COCO dataset과 재활용 쓰레기 데이터셋과의 차이점을 EDA해본 후 적절한 Augmentation을 골라서 실험해보는식으로 해보지 못한게 아쉬움이 남는다. 특히 TTA나 학습과정에서 이미지 리사이징을 해봤지만, 오히려 성능이 하락하는것을 보고, 그 원인을 찾지 못한게 아쉬움으로 남는다. 데이터셋의 특징을 조금더 파악해보고, 더 많은 실험적인 Augmentation을 하나씩 적용해본 다음에, 성능 향상 혹은 하락에 원인을 팀원들과 나눠보며 고민해보지 못한것이 아쉬웠다. **실험관리의 중요성** --- 서버를 두명이서 공유해야하고, 2주라는 시간밖에 주어지지 않았으므로, 꼭 필요한 실험들을 중복되지 않게 했어야만 했다. 하지만, 팀원들간의 중복된 실험이 많았고, 최종과정에서는 사용되지 않을 모델들로 실험을 하는등 서버를 효율적으로 사용하지 못했다. WandB를 slack과 연동하고, 깃허브를 이용해서 고정된 형식의 베이스라인 코드를 공유하 는등 팀원들과 명확히 역할분담을 하는것이 중요하다는것을 깨달았다. 어떤 프로젝트를 하던지, 혼자서 해낼 수는 없기 때문에, 실험관리를 하고, 팀원들과 의견을 나누며 유기적으로 프로젝트를 진행해나가는게 중요함을 알게되었다. ### Week10_AI개발기초_학습회고 - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-11-21-AIBasic-week10/ - Collection: WeeklyReview - Published: 2025-11-21 - Tags: Project, WeeklyReview # 목차 1. 강의 복습 2. 학습 회고 # 강의복습 # 1. 소프트웨어 엔지니어링과 AI 엔지니어링 ## 1.1소프트웨어 엔지니어링이란? 소프트웨어 엔지니어링은 소프트웨어를 개발하는 전 과정에서 체계적이고 효율적인 방법을 사용하여 소프트웨어의 **품질**과 **유지보수성**을 보장하는 분야다. 단순히 코드를 작성하는 것을 넘어, **계획 → 요구조건 분석 → 설계 → 구현 → 테스트 → 유지보수**에 이르는 소프트웨어 개발 라이프 사이클 전체를 다룬다. 소프트웨어는 프론트엔드, 백엔드, 머신러닝, 데이터, 게임, 보안 등 다양한 분야가 있으며, 각 분야에서 집중하는 문제와 기술 스택이 다르다. ## 1.2 좋은 소프트웨어 설계 좋은 소프트웨어 설계는 유지보수가 쉽고 확장이 유연한 시스템을 만드는 것을 목표로 한다. 이를 위해 **모듈성(Modularity)**, **응집도(Cohesion)**, **결합도(Coupling)**와 같은 핵심 원칙을 이해하는 것이 중요하다. ![image](/assets/images/2025-11-21-19-58-00.png) [https://www.geeksforgeeks.org/software-engineering/effective-modular-design-in-software-engineering/](https://www.geeksforgeeks.org/software-engineering/effective-modular-design-in-software-engineering/) ### 모듈성(Modularity) 모듈성이란 큰 프로그램을 **작고 독립적인 기능 단위(모듈)**로 나누는 것을 의미한다. 여러 함수가 모여 하나의 모듈을 이루고, 이 모듈들이 서로 상호작용하며 전체 시스템을 구성한다. ### 응집도(Cohesion) 응집도는 **하나의 모듈 내에서 각각의 기능(함수, 메서드)들이 공동의 목적을 달성하기 위해 얼마나 밀접하게 관련되어 있는가**를 나타내는 척도다. - **높은 응집도 (Good)**: 모듈이 하나의 명확하고 집중된 목적을 가진다. 예를 들어, `User` 클래스가 사용자의 이름과 이메일을 가져오는 `get_name()`, `get_email()` 메서드만 가지고 있다면 응집도가 높다고 할 수 있다. - **낮은 응집도 (Bad)**: 하나의 모듈이 서로 관련 없는 여러 기능을 수행한다. 만약 `User` 클래스에 사용자 정보 확인, 이메일 전송, 유저 정보 출력 등 다양한 기능이 모두 포함되어 있다면, 이는 낮은 응집도를 가진다. 좋은 설계는 목적에 맞게 클래스를 나누고, 명확히 정의된 인터페이스를 통해 교류하도록 하는 것이다. ### 결합도(Coupling) 결합도는 **모듈 간의 상호 의존성 정도**를 나타낸다. - **낮은 결합도 (Good)**: 각 모듈이 독립적으로 작동하여, 한 모듈의 변경이 다른 모듈에 미치는 영향이 적다. 이는 유지보수와 협업을 용이하게 한다. - **높은 결합도 (Bad)**: 모듈들이 서로에게 강하게 의존하여, 하나의 모듈을 수정하면 관련된 다른 모듈들도 함께 수정해야 할 가능성이 크다. 예를 들어, `Order` 클래스가 `Product` 클래스의 `get_price()` 메서드를 직접 호출하여 가격을 계산하는 경우, 두 클래스는 높은 결합도를 가진다. 만약 동료가 `get_price()` 메서드가 숫자 대신 `"$20"`와 같은 문자열을 반환하도록 수정한다면, `Order` 클래스의 `calculate_total()` 메서드는 오류를 발생시킬 것이다. 반면, `Order` 클래스가 `Product` 객체 자체가 아닌 가격 정보(`[20, 30, 5]`) 리스트를 직접 받아서 합계를 계산한다면, `Product` 클래스의 내부 구현이 변경되어도 `Order` 클래스는 영향을 받지 않는다. 이는 낮은 결합도를 가지는 좋은 설계다. 좋은 설계를 위해서는 **결합도를 낮추어** 협업 시 클래스 간의 영향을 최소화해야 한다. ## 1.3 테스트 테스트는 프로그램이 예상대로 정확하게 작동하는지, 문제가 없는지 확인하는 필수적인 과정이다. 기능이 추가되거나 코드가 수정될 때 기존 시스템에서 오류가 발생하는지, 새로운 버그가 생겼는지 등을 확인함으로써 사용자에게 안정적인 소프트웨어를 제공하는 것을 목표로 한다. 테스트는 단순히 코드만 확인하는 것이 아니라, 요구조건, 아키텍처 설계, 데이터베이스 연결, 서버 부하 등 시스템 전반에 대한 확인을 포함한다. - **Unit Test**: 함수나 메서드와 같은 가장 작은 코드 단위를 개별적으로 테스트한다. - **Integration Test**: 여러 단위나 컴포넌트를 연결했을 때 상호작용이 올바르게 이루어지는지 테스트한다. - **End to End Test**: 실제 사용자 시나리오처럼 처음부터 끝까지 시스템 전체의 흐름을 테스트한다. - **Performance Test**: 시스템의 성능(응답 시간, 처리량)과 부하 상태에서의 안정성을 테스트한다. ### Pytest `Pytest`는 파이썬에서 널리 사용되는 테스트 프레임워크다. `assert` 키워드를 사용하여 테스트 조건을 간단하게 정의하고 실행할 수 있다. ```python # content of test_sample.py def func(x): return x + 1 def test_answer(): assert func(3) == 5 ``` ```python $ pytest =========================== test session starts ============================ platform linux -- Python 3.x.y, pytest-9.x.y, pluggy-1.x.y rootdir: /home/sweet/project collected 1 item test_sample.py F [100%] ================================= FAILURES ================================= _______________________________ test_answer ________________________________ def test_answer(): > assert func(3) == 5 E assert 4 == 5 E + where 4 = func(3) test_sample.py:6: AssertionError ========================= short test summary info ========================== FAILED test_sample.py::test_answer - assert 4 == 5 ============================ 1 failed in 0.12s ============================= ``` 위의 예시에서 볼 수 있듯 asseret를 사용해서 해당 조건에 부합하지 않으면 에러를 발생함. ## 1.4 문서화 좋은 소프트웨어는 반드시 좋은 문서를 동반한다. 문서화는 다른 개발자나 미래의 내가 코드를 쉽게 이해하고 사용할 수 있도록 돕는 중요한 과정이다. 주요 문서에는 다음이 포함된다. - **README**: 프로젝트의 개요, 설치 방법, 사용법 등을 설명하는 가장 기본적인 문서. - **API 문서**: 함수, 클래스, 모듈의 기능, 파라미터, 반환값 등을 상세히 기술한 문서. - **아키텍처 문서**: 시스템의 전체 구조와 구성 요소 간의 관계를 설명하는 문서. `PyTorch`는 공식 문서가 매우 잘 작성된 대표적인 예시다. API의 상세한 설명, 사용 가이드, Ecosystem 관련 라이브러리 소개, 블로그, 튜토리얼 등 풍부한 정보를 제공하여 사용자들이 쉽게 배우고 활용할 수 있도록 돕는다. 개인 프로젝트를 진행할 때도 문서화를 신경 쓰는 습관은 매우 중요하다. ## 1.5 왜 소프트웨어 엔지니어링을 배워야 하는가? 머신러닝 모델을 만드는 것 역시 소프트웨어 엔지니어링 활동의 일부다. 특히, 개발한 머신러닝 모델을 실제 유저가 사용하는 서비스로 만들려면 소프트웨어 엔지니어링에 대한 깊은 이해가 필수적이다. ![image](/assets/images/2025-11-21-20-00-31.png) 출처: Hidden Technical Debt in Machine Learning Systems 위 다이어그램에서 볼 수 있듯이, 실제 머신러닝 시스템에서 ML 코드가 차지하는 비중은 매우 작다. 데이터 수집, 검증, 피처 추출, 자원 관리, 서빙 인프라, 모니터링 등 수많은 소프트웨어 엔지니어링 요소들이 모델을 둘러싸고 있다. 트위터와 같은 거대 서비스의 아키텍처를 보면, `Prediction Service`나 `Home Scorer`와 같은 AI/ML 관련 컴포넌트는 전체 시스템의 일부로서 다른 여러 서비스와 복잡하게 상호작용한다. 모델보다 훨씬 크고 복잡한 시스템 내에서 자신의 모델이 제 역할을 하도록 만들기 위해서는 소프트웨어 엔지니어링 관점에서 시스템 전체를 이해해야 한다. 앞으로 AI 개발을 전문으로 하는 분야와 AI 기술을 소프트웨어 엔지니어링에 접목하는 분야로 커리어가 나뉠 수 있다. 양쪽을 모두 이해하면 전반적인 시스템을 보는 시야가 넓어져 더 큰 도움이 될 것이다. ## 1.6 AI 엔지니어링 AI 엔지니어링은 개발된 AI 모델이 웹이나 앱과 같은 실제 서비스에서 안정적으로 동작할 수 있도록 시스템을 구축하는 것을 의미한다. 이는 **데이터, 모델, 코드, 인프라** 네 가지 요소를 모두 다루는 종합적인 분야다. ![image](/assets/images/2025-11-21-20-00-37.png) 소프트웨어 엔지니어와 AI 엔지니어는 역할과 관심사에서 차이를 보인다. - AI엔지니어: 모델의 퍼포먼스와 데이터셋, 실험 중요 - 소프트웨어 엔지니어: 변경 용이, 가독성, 소프트웨어 시스템 개발 및 유지보수 AI 엔지니어로서 성장하려면 어떻게 해야할까? - 특정 도구나 프레임워크에 너무 몰입하기보다, 문제 해결의 **관점**을 익히고 필요할 때 새로운 기술을 빠르게 습득할 수 있도록 학습의 기초를 다진다. - 새로운 기술을 접할 때, ‘어떤 맥락에서 이 도구가 생겨났는가?’, ’어떻게 활용하면 좋을까?’를 항상 고민한다. - 새로운 것을 학습할 때, 과거에 내가 다른 기술을 어떻게 학습했는지 되돌아보며 자신만의 효율적인 학습 방법을 찾아나간다. # 2. 파이썬 환경 설정과 디버깅 ## 2.1 파이썬 환경설정 파이썬 개발 환경을 올바르게 설정하는 것은 안정적이고 효율적인 개발의 첫걸음이다. 버전 관리부터 가상 환경 구축, 패키지 관리에 이르기까지 체계적인 접근이 필요하다. ### 버전 관리(Version Control) 파이썬 버전의 숫자는 단순한 식별자가 아니라 **Semver(Semantic Versioning)** 정책에 따라 관리된다. Semver는 `MAJOR.MINOR.PATCH` 형식으로 버전을 구성하며, `MAJOR` 버전이 변경되면 하위 호환성이 보장되지 않는 큰 변화가 있음을 의미한다. 따라서 파이썬 2.x 버전과 3.x 버전 사이의 코드는 호환되지 않는다. 개발 시 사용하고자 하는 라이브러리가 내가 사용 중인 파이썬 버전과 호환되는지 확인하는 것이 중요하다. 이는 `pypi.org`와 같은 패키지 저장소에서 확인할 수 있다. 일반적으로 최신 파이썬 버전을 사용하는 것이 좋지만, 안정성을 더욱 중요시하는 경우 최신 버전보다 마이너 버전이 하나 낮은 버전을 선택하기도 한다. 여러 버전의 파이썬을 관리하기 위해 `pyenv`와 같은 도구를 사용하면 유용하다. `pyenv`는 커맨드 라인 인터페이스(CLI)를 통해 여러 파이썬 버전을 쉽게 설치하고 프로젝트마다 다른 버전을 지정할 수 있게 해준다. `which python` 명령어를 사용하면 현재 어떤 파이썬 실행 파일이 사용되고 있는지 경로를 확인할 수 있는데, 버전이 꼬이는 문제가 발생했을 때 이 명령어를 통해 경로를 확인하고 통일하여 문제를 해결할 수 있다. ### 가상 환경(Virtual Environment) 가상 환경이 없다면 모든 프로젝트가 시스템 전역에 설치된 하나의 패키지 목록을 공유하게 된다. 이 경우, 한 프로젝트에서 특정 패키지의 버전을 업데이트하면 다른 프로젝트에서 버전 충돌이 발생할 수 있다. 이러한 문제를 방지하기 위해 프로젝트별로 독립된 가상 환경을 만들어야 한다. 각 가상 환경은 고유의 파이썬 버전과 설치된 패키지 목록을 가지므로 프로젝트 간의 의존성 문제를 원천적으로 차단한다. 파이썬에서는 `venv` 모듈을 내장하고 있어 이를 통해 쉽게 가상 환경을 구축할 수 있다. 가상 환경이 활성화되면, 터미널 프롬프트 앞에 `(my_env)`와 같이 가상 환경의 이름이 표시되어 현재 작업 환경을 명확히 알려준다. ## 2.2 패키지 매니저 파이썬의 주요 패키지 매니저로는 `pip`, `poetry`, `conda` 등이 있다. 그중 `pip`는 파이썬에 기본적으로 내장되어 있어 가장 널리 사용된다. `pip`를 사용하면 필요한 패키지를 쉽게 설치할 수 있다. 예를 들어 특정 패키지를 설치하려면 다음 명령을 사용한다. `pip`는 패키지를 설치할 때 해당 패키지가 의존하는 다른 패키지들(의존성 패키지)도 자동으로 함께 설치해준다. 프로젝트에 직접 필요한 패키지만 확인하고 싶을 때는 다음 명령을 사용할 수 있다. 프로젝트의 의존성을 관리하기 위해 `requirements.txt` 파일을 사용하는 것이 일반적이다. 이 파일에 필요한 패키지와 버전 목록을 저장해두면, 다른 환경에서도 `pip install -r requirements.txt` 명령 한 줄로 동일한 환경을 쉽게 구축할 수 있다. 또한, 내장된 `pip`보다 최신 버전을 사용하는 것이 좋으므로, `pip install --upgrade pip` 명령으로 주기적으로 업그레이드해주는 것이 권장된다. ## 2.3 디버깅(Debugging) 디버깅은 소프트웨어 개발 과정에서 발생하는 오류(버그)의 원인을 찾아 해결하고 시스템을 정상화하는 가장 중요한 활동 중 하나다. 때로는 많은 시간이 소요되고 답답함을 유발할 수 있지만, 안정적인 소프트웨어를 만들기 위한 필수적인 과정이다. ### 버그가 생기는 이유 버그는 다양한 원인으로 발생한다. - **사람의 실수**: 문법을 잘못 작성하거나 비즈니스 로직을 잘못 설계하는 경우. - **실행 환경**: 운영체제(OS), 가상 환경, Docker 컨테이너, 하드웨어, 네트워크 상태 등 코드 외부의 환경적 요인. - **의존성**: 내가 사용하는 라이브러리, 혹은 그 라이브러리가 사용하는 또 다른 라이브러리에 버그가 있는 경우. - **복잡성**: 소프트웨어의 규모가 커지고 복잡해질수록 버그가 발생할 가능성이 높아진다. - **커뮤니케이션**: 요구사항이 명확하지 않거나 팀원 간에 서로 다르게 이해하는 경우. ### 디버깅 절차 문제가 발생했을 때, 체계적인 절차에 따라 디버깅을 진행하면 보다 효율적으로 문제를 해결할 수 있다. ![image](/assets/images/2025-11-21-20-00-51.png) - **문제 인식 및 오류 분류**: 가장 먼저 오류 메시지를 주의 깊게 읽고 원인을 파악한다. 문제가 코드의 오류인지, 인프라의 문제인지, 혹은 원인을 알 수 없는 오류인지 분류한다. - **해결책 찾기**: 과거에 비슷한 문제를 경험했는지 자신의 기록(오답노트)을 찾아본다. 경험이 없다면 구글, Stack Overflow, 공식 문서, GitHub Issue 등에서 해결책을 검색한다. 최근에는 ChatGPT와 같은 LLM을 활용하는 것도 좋은 방법이다. 오픈소스 프로젝트의 경우, GitHub 레포지토리의 `issue` 탭에서 에러 메시지로 검색해보면 동일한 문제를 겪은 다른 개발자의 논의를 찾을 수 있으며, 해결된 버그는 `closed`된 이슈에서 확인할 수 있다. - **가설 설정**: 수집한 정보를 바탕으로 ’어떤 과정에서 무엇을 하는데 에러가 났다’와 같이 문제 상황을 정리하고, 원인에 대한 가설을 세운다. - **기록**: 문제 상황, 오류 메시지, 그리고 어떻게 해결했는지를 상세히 기록하여 ’오답노트’를 만든다. 이렇게 경험을 데이터화하면 미래에 비슷한 문제가 발생했을 때 더 빠르고 균일한 형태로 해결할 수 있는 귀중한 자산이 된다. 만약 다른 사람에게 도움을 요청해야 할 경우, 상대방이 문제를 쉽게 재현할 수 있도록 운영체제, 가상 환경, 사용 중인 라이브러리 버전 등 실행 환경에 대한 정보를 명확히 제공하는 것이 중요하다. # 3. Streamlit을 활용한 웹 프로토타입 구현 ## 3.1 프로토타입이란? 프로토타입은 완벽한 제품이 출시되기 전에 기능이나 디자인을 미리 확인하고 테스트하기 위해 만드는 샘플 버전이다. 특히 AI/ML 분야에서는 개발한 모델의 입력(Input)에 따른 출력(Output)을 시각적으로 쉽게 확인할 수 있도록 웹페이지 형태로 프로토타입을 제작하는 경우가 많다. 일반적으로 데이터 분석가나 사이언티스트는 Jupyter Notebook에서 EDA(탐색적 데이터 분석)를 수행하고 모델을 개발한다. 이 결과를 실제 서비스에 적용하기 전에, 간단한 웹 서비스 형태로 만들어보면 협업 관점에서 매우 유용하다. 예를 들어, 프론트엔드 개발자나 기획자(PM)와 같은 유관 조직과 아이디어를 공유하고 빠른 피드백을 주고받을 수 있다. **일반적인 웹개발 절차** 1. Explore in a jupyternotebook 2. Copy-paste into a python script 3. Write Flask app. Think about HTTP requests, HTML, callbacks, JS.. 4. 유지보수 물론 Jupyter Notebook의 코드를 파이썬 스크립트로 옮겨 Flask와 같은 웹 프레임워크로 앱을 만들 수도 있지만, 프론트엔드 개발자가 아닌 이상 UI를 만들고 유지보수하는 데 많은 어려움이 따른다. 바로 이런 문제를 해결하기 위해 Streamlit과 같은 도구가 등장했다. ## 3.2 Streamlit Streamlit은 복잡한 웹 개발 지식 없이 파이썬 스크립트 코드만으로 빠르고 쉽게 데이터 기반의 웹 애플리케이션을 만들 수 있는 오픈소스 프레임워크다. ### Streamlit을 사용할 경우의 장점 - 데이터 엔지니어나 분석가가 Jupyter Notebook 코드를 약간만 수정하여 쉽게 프로토타입을 구현할 수 있다. - 백엔드 개발이나 HTTP 요청과 같은 복잡한 구현 없이도 다양한 UI 컴포넌트를 활용해 대시보드를 구성할 수 있다. - JavaScript, React, Vue 등을 사용해 프로토타입을 만드는 것에 비해 시간 효율성이 매우 높다. - Streamlit Cloud를 통해 쉽게 웹에 배포하고 다른 사람과 공유할 수 있다 (단, 무료 Community Plan은 Public GitHub 레포지토리만 지원). - 화면 녹화(Record) 기능이 내장되어 있어 데모 영상을 쉽게 제작할 수 있다. ### Streamlit 대안 물론 Streamlit이 유일한 해결책은 아니다. 프로젝트의 요구 조건에 따라 다른 도구를 고려할 수 있다. - **R의 Shiny**: R 사용자들에게 인기 있는 웹 애플리케이션 프레임워크. - **Flask, FastAPI**: 직접 백엔드를 구성하고 프론트엔드 작업을 진행해야 하므로 자유도는 높지만 더 많은 노력이 필요하다. - **Dash**: 기능이 가장 풍부한 Python 기반 대시보드 라이브러리. 복잡한 상호작용과 레이아웃이 필요할 때 적합하다. - **Gradio**: Streamlit과 비슷한 컨셉으로, 머신러닝 모델의 데모를 만드는 데 특화되어 있다. 중요한 것은 특정 도구에 집착하기보다, 프로젝트의 요구 조건에 맞춰 최적의 도구를 선택하고 적용하는 의사결정 능력이다. ## 3.3 Streamlit 개발 흐름 ![image](/assets/images/2025-11-21-20-01-00.png) - **AI/ML 모델링**: 먼저 파이썬 스크립트 형태로 동작하는 모델이나 데이터 처리 로직을 준비한다. - **Streamlit 설계**: 프로토타입의 목적과 기능을 정의하고, UI 레이아웃과 사용할 컴포넌트(버튼, 슬라이더, 차트 등)를 결정한다. - **Streamlit 개발**: 기존 파이썬 스크립트 코드를 약간 수정하고, Streamlit이 제공하는 UI 컴포넌트를 추가하여 Input/Output을 처리한다. 데이터 처리나 시각화, 상호작용 로직(예: 값이 변경될 때 어떻게 동작할지)을 개발한다. - **테스트 및 배포**: 의도한 대로 작동하는지 Use Case를 확인하고, 필요하다면 Streamlit Cloud 등을 통해 배포한다. ## 3.4 Streamlit 핵심 기능 Streamlit은 다양한 UI 컴포넌트를 제공하여 손쉽게 인터랙티브한 웹 페이지를 만들 수 있게 한다. ![image](/assets/images/2025-11-21-20-01-05.png) ### UI Components - **Text 출력**: 제목, 헤더, 일반 텍스트 등을 표시한다. - **Input 위젯**: 사용자로부터 문자, 숫자, 날짜, 파일 등을 입력받는다. - **선택 위젯**: 여러 옵션 중 하나 또는 여러 개를 선택하게 한다. - **버튼 및 상태 위젯**: 특정 동작을 실행하거나 상태(True/False)를 입력받는다. - **데이터 및 차트**: 데이터프레임, 차트, 지도 등을 시각화한다. - **레이아웃**: `st.sidebar`로 사이드바를, `st.columns`로 화면을 여러 열로 분할하거나, `st.expander`로 접고 펼 수 있는 섹션을 만든다. ### Session State (`st.session_state`) Streamlit은 화면에서 무언가 업데이트(예: 버튼 클릭, 텍스트 입력)될 때마다 전체 스크립트 코드를 처음부터 다시 실행한다. 이 특성 때문에 일반 변수에 저장된 값은 상호작용이 일어날 때마다 초기화되어 사라진다. 이 문제를 해결하기 위해 **`Session State`**가 사용된다. `st.session_state`는 Global Variable처럼 동작하여, 스크립트가 다시 실행되어도 값을 계속 유지하고 공유할 수 있게 해준다. 사용자 로그인 상태 유지, 채팅 대화 히스토리 저장, 여러 단계의 Form 데이터 유지 등에 활용된다. 위 코드에서 `st.session_state.count`는 버튼을 누를 때마다 값이 유지되고 누적된다. ### Caching 스크립트가 재실행될 때마다 데이터를 불러오거나 무거운 ML 모델을 로드하는 코드가 반복적으로 실행되면 앱의 성능이 저하될 수 있다. Streamlit은 이러한 성능 이슈를 해결하기 위해 **캐싱(Caching)** 데코레이터를 제공한다. 캐싱은 시간이 오래 걸리는 함수의 실행 결과를 메모리나 디스크에 저장해두고, 동일한 입력으로 함수가 다시 호출될 때 계산을 반복하는 대신 저장된 결과를 즉시 반환하는 기능이다. - `@st.cache_data`: 데이터프레임, API 요청의 응답 등 데이터베이스에 저장할 수 있는 형태의 객체를 캐싱하는 데 사용된다. - `@st.cache_resource`: DB 연결, ML 모델과 같이 메모리에 그대로 유지해야 하는 객체를 캐싱하는 데 사용된다. `[st.cache_data vs st.cache_resource 다이어그램]` 이처럼 Session State와 Caching은 Streamlit 개발에서 상태를 유지하고 성능을 최적화하는 데 매우 중요한 역할을 한다. # 4. Linux 및 쉘 스크립트 ## Linux와 CLI **Linux**는 오픈소스 운영 체제로, 안정성과 유연성 덕분에 서버 환경에서 압도적으로 많이 사용된다. 서버와 상호작용할 때는 주로 그래픽 기반의 **GUI(Graphic User Interface)** 대신 텍스트 기반의 **CLI(Command Line Interface)**를 사용한다. 쉘 커맨드와 쉘 스크립트에 익숙해지는 것은 서버를 다루는 개발자에게 필수적인 역량이다. ## 쉘(Shell) 쉘은 사용자가 입력한 명령어를 해석하여 운영체제의 커널이 실행하도록 전달하는 프로그램이다. 대표적인 쉘의 종류는 다음과 같다. - **sh (Bourne Shell)**: 최초의 유닉스 쉘. - **bash (Bourne-Again Shell)**: 대부분의 Linux 배포판에서 표준으로 사용되는 쉘. - **zsh (Z Shell)**: macOS의 기본 쉘로, 다양한 편의 기능과 플러그인을 제공한다. 쉘은 서버에 원격 접속하여 작업을 하거나, `crontab`을 이용해 특정 작업을 자동화하고, Docker 컨테이너를 관리하며, 배포 파이프라인을 실행하는 등 서버 개발 및 운영의 모든 과정에서 사용된다. ## 기본 쉘 커맨드 자주 사용하는 기본 쉘 커맨드는 다음과 같다. - `man `: 커맨드의 매뉴얼(설명서)을 보여준다. - `mkdir `: 새로운 디렉토리를 생성한다. - `ls`: 현재 디렉토리의 파일 및 폴더 목록을 보여준다. (`l`: 상세 정보, `a`: 숨김 파일 포함, `h`: 사람이 읽기 쉬운 용량 단위) - `pwd`: 현재 작업 중인 디렉토리의 전체 경로를 출력한다. - `cd `: 지정된 디렉토리로 이동한다. - `echo `: 터미널에 텍스트를 출력한다. - `cp `: 파일이나 폴더를 복사한다. (`r`: 폴더 전체를 재귀적으로 복사) - `vi `: `vi` (또는 `vim`) 텍스트 편집기로 파일을 열거나 생성한다. - `mv `: 파일이나 폴더를 이동시키거나 이름을 변경한다. - `cat `: 파일의 내용을 출력한다. 여러 파일을 인자로 주면 내용을 합쳐서 보여준다. - `sudo `: 관리자(superuser) 권한으로 명령어를 실행한다. - `history`: 이전에 입력했던 명령어들의 목록을 보여준다. - `find -name `: 특정 경로에서 지정된 이름의 파일을 검색한다. - `alias =''`: 긴 명령어를 짧은 별칭으로 만들어 사용한다. - `tree`: 디렉토리 구조를 시각적인 트리 형태로 보여준다. ## 텍스트 처리 커맨드 로그 파일 분석이나 데이터 전처리 시 유용한 텍스트 처리 커맨드들이다. - `head`/`tail -n `: 파일의 처음/끝 n행을 출력한다. - `sort `: 파일의 내용을 행 단위로 정렬한다. (`r`: 내림차순, `n`: 숫자 순서로 정렬) - `uniq`: 연속된 중복 행을 제거한다. 주로 `sort`와 함께 사용한다. - `grep `: 파일 내용에서 특정 패턴(문자열)이 포함된 행을 검색한다. - `cut -d '' -f `: 파일의 각 행에서 특정 구분자(`d`)를 기준으로 필드(`f`)를 잘라내어 추출한다. - `awk ' {action}' `: 강력한 텍스트 처리 도구로, 특정 패턴에 맞는 행에 대해 지정된 동작을 수행한다. ## 표준 스트림과 리다이렉션 & 파이프 Unix 기반 시스템의 프로그램은 실행 시 세 가지 기본 스트림을 가진다. - `stdin` (0): 표준 입력. 기본적으로 키보드 입력. - `stdout` (1): 표준 출력. 기본적으로 터미널 화면. - `stderr` (2): 표준 에러. 기본적으로 터미널 화면. **리다이렉션**은 이러한 스트림의 방향을 바꾸는 기능이다. - `>`: `stdout`을 파일로 보낸다 (파일이 있으면 덮어쓰기). - `>>`: `stdout`을 파일의 끝에 추가한다. - *파이프(`|`)**는 한 명령어의 `stdout`을 다른 명령어의 `stdin`으로 직접 연결하는 기능으로, 여러 명령어를 조합하여 복잡한 작업을 수행할 수 있게 한다. ## 서버에서 자주 사용하는 커맨드 - `ps`: 현재 실행 중인 프로세스의 상태를 보여준다. (`ef`: 모든 프로세스를 상세 포맷으로) - `curl `: 커맨드 라인에서 URL을 통해 데이터를 요청하고 응답을 받아오는 도구. API 테스트 등에 유용하다. - `df`: 디스크의 남은 용량을 확인한다. (`h`: 사람이 읽기 쉬운 단위로) - `ssh @`: 원격 서버에 안전하게 접속하는 프로토콜. - `[SSH 연결 과정 다이어그램]` - VSCode의 `Remote-SSH` 확장 기능을 사용하면 원격 서버에 접속하여 마치 로컬 컴퓨터에서 작업하는 것처럼 파일을 편집하고 터미널을 사용할 수 있다. - `[VScode RemoteSSH 다이어그램]` - `scp `: SSH를 통해 원격 서버와 안전하게 파일을 주고받는 명령어. - `nohup &`: 터미널을 종료해도 백그라운드에서 작업이 계속 실행되도록 한다. 로그는 `nohup.out` 파일에 저장된다. - `chmod `: 파일이나 디렉토리의 권한(읽기-4, 쓰기-2, 실행-1)을 변경한다. ## 쉘 스크립트 쉘 스크립트는 여러 쉘 커맨드를 `.sh` 파일에 순서대로 작성하여 일괄적으로 실행할 수 있게 하는 것이다. 반복적인 작업을 자동화하는 데 매우 유용하다. 스크립트 파일의 가장 첫 줄에는 `#!/bin/bash`와 같이 어떤 쉘을 사용하여 이 스크립트를 실행할지 지정하는 **Shebang**을 작성한다. 쉘 스크립트는 변수, 함수, 조건문, 반복문 등 프로그래밍 언어의 요소를 대부분 포함하고 있다. - **인자**: 스크립트 실행 시 전달하는 인자는 `$1`, `$2`, … 와 같은 변수로 접근할 수 있다. `$#`는 전달된 인자의 총 개수, `$@`는 모든 인자 목록을 의미한다. - **함수**: 파이썬처럼 함수를 정의하고 호출할 수 있다. - **조건문**: `if [ 조건 ]` 형태로 사용하며, `&&`(AND), `||`(OR)로 조건을 조합할 수 있다. ### 쉘 스크립트 활용 사례 - **모델 학습 자동화**: 여러 하이퍼파라미터 조합으로 모델을 순차적으로 학습시킬 때 쉘 스크립트를 활용할 수 있다. - **로그 파일 분석**: 모델 학습 후 생성된 여러 로그 파일에서 특정 정보(예: Loss)를 한 번에 추출하고 분석할 수 있다. Linux와 쉘 커맨드는 처음에는 낯설 수 있지만, 서버 환경에서 개발하고 운영하기 위해서는 반드시 익숙해져야 하는 도구다. 많은 커맨드를 한 번에 외우려 하기보다, 자주 사용하는 것부터 시작하여 필요할 때마다 검색하고 정리하며 점차 익숙해지는 것이 좋다. # 학습회고 본격적인 Production주간이 시작되었다. 이번주간은 AI개발기초 강의를 들으며, 깃허브와 친해지고, 팀원들과 프로젝트 아이디어를 탐색하는 시간을 가졌다. ### 프로젝트 아이디어 선정 프로젝트 아이디어를 선정하는 과정이 쉽지 않았다. 기술적인 완성도가 있는지, 시장성이 있는지, 어떤 문제를 인식하고 해결해야 하는지 결정해야 하는것들이 많았다. 그리고 가장 어려웠던 것은 이미 시장에 많은 솔루션들이 존재한다는 것이다. 이미 존재하는 솔루션과 차별점을 만들어야 할텐데 설계하는게 쉽지 않은것 같다. 우리조가 선택한 OCR기반에서는 다량의 문서를 읽어들이고 처리할 수 있으므로, 경제, 법률 의료등 다양한 분야에 접목될 가능성이 있어보이지만, 해당분야들에 배경지식이 없어서 쉽지 않은 프로젝트가 될것 같았다. 그래서 그나마 내가 잘 아는 분야인 교육에 OCR을 접목시켜서 에듀테크쪽으로 LMS With AI를 조사하고 제시했다. [[최종프로젝트]에듀테크-아이디어](https://hyejunl33.github.io/projects/2025-11-21-ProjectIdea-edutech/) 시장성이 있는지, 임팩트를 크게 줄 수 있을지, Finetuning을 통해 모델성능 개선을 보여줄 수 있을지, 실제 문제해결에 기여할 수 있을지등을 팀원들과 더 고려해봐야겠다. 에듀테크 이외에도 아이디어들이 많았지만, 완벽한 아이디어를 찾기가 쉽지 않았다.. ### 깃허브와 친해지기 부스트코스에 제공된 강의를 들으며 깃허브와 친해지는 시간을 가졌다. Commit, Pull, push, add밖에 몰랐었는데, 팀원들과 협업하기 위해 천천히 깃허브와 더 친해져야겠다. 계획한것은 많았지만, 절반정도밖에 이루지 못한 한주였다. 공부할 주제들은 $$O(n^2)$$로 늘어나는데, 모두 흡수하지 못하는것 같다. 훌륭한 멘토님과, 제공되는 v100 GPU, 함께하는 팀원들도 있는데, 정작 내가 기회를 놓치고 있는것 같다. 지나간 시간은 어쩔 수 없으니 이번 주말에는 평일에 계획했던 SAM, Deepseek OCR 포스팅, 기술블로그 글 포스팅을 해내야겠다. ### Week7-8_DomainCommonProject_WrapupReport - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-11-03-WrapupReport/ - Collection: WeeklyReview - Published: 2025-11-03 - Tags: Project, WeeklyReview ![image](/assets/images/2025-11-03-11-40-25.png) # 1. 프로젝트 개요 ## 1-1. 프로젝트 주제 영화 리뷰 텍스트를 4개의 클래스(강한 부정, 약한 부정, 약한 긍정, 강한 긍정)로 분류하는 다중 클래스 감성 분류 모델을 개발 ## 1-2. 프로젝트 구현내용 BERT기반의 트렌스포머 모델을 사용하여 영화 리뷰 텍스트의 문맥적 의미를 학습하고 감성을 예측한다. EDA, FeatureEngineering, 커스텀 토크나이저, 클래스 불균형 처리, 모델앙상블, TAPT등 다양한 모델 최적화 기법을 적용하여 최종 성능을 향상시키는것을 목표로 함. ## 1-3. 개발환경 **H/W**: Tesla V100 GPU **S/W**: Python, PyTorch, Pandas, Scikit-learn **실험관리**: Wandb(Weight & Biases) # 2. 주요 접근 방식 및 실험과정 프로젝트의 핵심 목표는 단순히 높은 성능을 내는 모델을 찾는 것이 아니라 ‘왜’ 성능이 오르고 내리는지 그 원인을 파악하고 검증. ## 2-1. EDA 및 초기 가설 ![image](/assets/images/2025-11-03-11-40-02.png) - **데이터 불균형 확인:** '강한 부정'과 '약한 긍정'이 다수를 차지하고, '약한 부정'과 '강한 긍정'이 소수인 불균형 데이터셋임을 확인했다. 이를 바탕으로 클래스간 불균형을 해소하기 위해 Weighted Cross Entropy(WCE)나 Focal Loss가 필요하다고 가정했다. ```python --- 수집된 라벨별 상위 감성 패턴 (예시) --- [Label 0]: [('ㅠㅠ', 33867), ('ㅋㅋ', 7427), ('ㅡㅡ', 2363), ('ㅎㅎ', 954), ('ㅜㅜ', 519), ('😡', 44), ('★', 33), ('ㅋㅋㅠㅠ', 30), ('ㅡㅡㅋ', 26), ('ㅜㅠ', 24)] [Label 1]: [('ㅠㅠ', 9489), ('ㅎㅎ', 2362), ('ㅋㅋ', 1856), ('ㅜㅜ', 86), ('ㅡㅡ', 78), ('★', 26), ('😊', 22), ('🌟', 18), ('ㅠㅜ', 12), ('♥', 11)] [Label 2]: [('ㅎㅎ', 19727), ('ㅋㅋ', 9407), ('ㅠㅠ', 5677), ('♥', 832), ('🌟', 640), ('✨', 510), ('ㅜㅜ', 477), ('😊', 415), ('♡', 360), ('👍', 351)] [Label 3]: [('ㅎㅎ', 5713), ('ㅠㅠ', 4948), ('ㅋㅋ', 3900), ('♥', 2067), ('♡', 571), ('ㅜㅜ', 391), ('🌟', 330), ('★', 206), ('✨', 142), ('👍', 137)] ------------------------------------------ ``` - **텍스트 특징 발견:** - 'ㅋㅋ', 'ㅠㅠ', 'ㅎㅎ' 같은 자음/모음 반복 및 이모티콘(😊, 👍)이 빈번하게 등장하는 것을 발견했다. 감성분류 Task에서 이러한 토큰은 중요하게 해석되어야 한다. 따라서 커스텀 토크나이저를 통해 ‘ㅋㅋ’, ‘ㅠㅠ’, ‘ㅎㅎ’등은 특수토큰으로 처리하는 방법이 필요하다고 가정했다. - '진짜', '너무'와 같은 부사어는 모든 레이블에서 공통적으로 높은 빈도를 보여, 이를 불용어로 처리해야 할지 고민했다. 하지만 Bi-directional, Self-Attention을 통해 단어 그 자체만 보는게 아니라, 문맥 안에서의 단어 뜻을 파악하므로, 불용어처리를 하기보다는, 최대한 문맥을 살려두기 위해서, 남겨두어야 한다고 가정했다. ## 2-2. 시행착오 1: Feature Engineering과 과적합 초기에는 성능 향상을 위해 여러기법을 동시에 적용했다. - 데이터 불균형을 해결하기 위해 WCE(Weighted Cross Entropy)를 적용했다. 이때 가중치는 각 클래스의 백분율을 역수로 두어서 정규화시킨 값을 가중치로 사용했다. - ‘ㅋㅋ’, ‘ㅠㅠ’및 이모티콘을 특수토큰 처리하고 정규화 하는 커스텀 토크나이저를 구축했다. - Stratify 5-Fold를 적용하여 모델의 Robustness를 확보했다. **결과 및 문제점:** 하지만 이 모델의 성능은 베이스라인보다 오히려 하락(0.79)했다. 특히 Validation Loss가 급격히 상승하는 과적합 현상이 발생했다. WCE가 소수 클래스 특징에 과도하게 집중하면서 발생한 문제로 추정했다. 또한, **여러 변경사항을 한번에 적용하여 성능 하락의 정확한 원인을 파악하기 어렵다는 문제**를 깨달았다. ![베이스라인 모델의 성능](/assets/images/2025-11-03-11-40-58.png) 베이스라인 모델의 성능 ![WCE, 커스텀토크나이저, Stratifty 5-Fold를 적용한 모델의 성능](/assets/images/2025-11-03-11-41-29.png) WCE, 커스텀토크나이저, Stratifty 5-Fold를 적용한 모델의 성능 ## 2-3. 시행착오 2: 변인 통제와 Custom Tokenizer 이전의 실패를 바탕으로 변인을 통제하며 가설을 하나씩 검증하는 전략으로 변경했다. - **가설 1 (불용어)**: '진짜', '너무' 등의 불용어를 제거/유지하는 실험을 진행했다. BERT기반 모델은 문맥 전체를 통해서 단어의 의미를 파악하기 때문에, 불용어를 없애는게 오히려 모델성능을 하락할 것이라고 생각했다. 결과적으로 성능 차이가 미미(0.0005)하여, BERT 모델에서는 큰 영향이 없음을 확인했다. - **가설 2 (특수 토큰):** 'ㅋㅋ', 'ㅠㅠ', 이모티콘을 `[LAUGH]`, `[CRY]`, `[HEART]` 등의 특수 토큰으로 매핑하는 커스텀 토크나이저를 구현했다. **결과:** 커스텀 토크나이저만 적용했을 때, 베이스라인 대비 **약 0.2%의 유의미한 성능 향상**을 관측했다. 이는 감정 표현을 명시적으로 토큰화하는 것이 효과적임을 증명했다. ![image](/assets/images/2025-11-03-11-41-52.png) CustomTokenizer를 적용한 모델 성능 ## 2-4. 핵심 발견: 평가 지표와 LossFunction 가중치의 불일치 커스텀 토크나이저의 성공 이후, WCE 대신 Focal Loss를 도입하고 Label Smoothing, Cosine LR Scheduler, Weight Decay, Early Stopping 등 다양한 정규화 기법을 적용했다. 하지만 여전히 과적합이 발생하고 성능이 0.78까지 하락하는 등 문제가 해결되지 않았다. ![image](/assets/images/2025-11-03-11-41-59.png) FocalLoss 및 정규화를 적용한 모델 성능 이 과정에서 세 가지 근본적인 문제를 발견했다. 1. **평가지표의 불일치:** 과적합을 막기 위해 `eval/loss`를 모니터링 기준으로 삼았으나, 대회의 최종 평가지표는 `test/accuracy`였다. `eval/loss`가 낮아도 `accuracy`가 높지 않은 경우가 발생했다. 그리고 평가지표가 `eval/loss` 여서 `eval/accuracy`가 감소하며 모델이 과적합 되고 있음에도 early stopping의 기준은 loss여서 early stopping이 작동하지 않는 문제가 있었다. 2. **잘못된 $$\alpha$$ 가중치:** 데이터 불균형을 해결하기 위해 클래스 빈도의 역수를 Focal Loss의 `alpha` 가중치로 설정했다(`[0.11, 0.45, 0.12, 0.32]`). 하지만 이는 모델이 소수 클래스를 **과도하게 예측**하도록 만들었고, 오히려 다수 클래스의 `accuracy`를 깎아 먹는 원인이 되었다. 이전의 WCE와 같은 가중치를 주어서 같은 결과를 얻게 되었다. WCE를 사용할떄는 K-Fold, 커스텀토크나이저와 함께 실험을 해서, 어떤것이 성능에 악영향을 미치는지 알 수 없었지만, 나머지 요인들을 통제변인으로 설정하고 조작변인으로 가중치만을 두어서 실험한 결과, 소수 클래스를 과도하게 예측하는것이 성능에 오히려 악영향을 미침을 확인할 수 있었다. 3. **하이퍼파라미터 튜닝:** Early Stopping, Label Smooting, Learning Rate Scheduler종류, Weight Decay등 모델의 성능에 영향을 미치는 수치들을 임의로 설정해서 정규화를 적용했음에도 성능이 나오지 않는것 같았다. 따라서 하이퍼파라미터 튜닝을 통해 최적의 세팅값을 찾아나가야 함을 발견했다. **전환점:** 위의 세가지 문제를 해결하기 위해 세가지를 동시에 수정했다. - 평가 지표를 eval/loss에서 eval/accuracy로 변경. - Focal Loss의 $$$\alpha$$가중치를 [1,1,1,1], 즉 균등분포로 설정 - 하이퍼파라미터 튜닝. Focal Loss의 $$\gamma$$, label Smoothing, Learning Rate Scheduler종류, Weight Decay, Epoch 수 등을 `sweep_config` 에 넣어서 `wandb_sweep`으로 하이퍼파라미터 튜닝을 함 ![image](/assets/images/2025-11-03-11-42-06.png) Wandb Sweep을 이용한 하이퍼파라미터 튜닝 **결과:** 단일 모델 성능이 0.8211로 급상승하며, **지금까지의 실험 중 최고 성능**을 달성했다. 이는 불균형 데이터라 할지라도, 평가지표가 Accuracy일 경우 무조건적인 소수 클래스 가중치 부여가 오히려 성능에 악영향을 미칠 수 있고, 최적의 가중치를 하이퍼파라미터 튜닝으로 찾아야 함을 의미한다. 그리고 BERT기반 3개의 모델을 **앙상블 한 결과 가장 높은 성능인 0.8278을 달성함**을 확인했다. ![image](/assets/images/2025-11-03-11-42-12.png) ## 2-5 시행착오3: 시간부족으로 시도해보지 못한 시도들.. 이전에서 $$\alpha$$가중치를 균등분포로 둔 이후 이 $$\alpha$$가중치를 더 정교하게 튜닝하려고 시도했다. 단순히 균등 가중치와 클래스 빈도 역수 가중치를 혼합하는 새로운 공식을 도입하여 `alpha_beta_smooth`라는변수명을 추가해서 HyperParameter를 다시 설계했다. $$W_{final} = (1-\beta)\cdot W_{inversefreq} + \beta\cdot W_{uniform}$$ 이 튜닝은 `focal_loss_gamma`, `SWA_K`, `learning_rate` 등 다른 주요 하이퍼파라미터까지 모두 포함하는 복잡한 실험이었다. 하지만 대회 마감 시간이 임박하여, **HPT는 13 스텝밖에 수행하지 못했다.** ![image](/assets/images/2025-11-03-11-42-18.png) 결과적으로 이 실험은 최적의 하이퍼파라미터 조합을 탐색할 충분한 시간을 갖지 못했고, 오히려 13스텝에서 도출된 값은 이전에 수동으로 찾은 균등 가중치(`alpha`=1)보다 성능이 낮았다. 이로 인해 HPT의 잠재력을 완전히 확인하지 못한 아쉬움이 남는다. 또한, 시간 부족으로 인해 유의미할 것으로 예상했으나 최종적으로 시도하지 못한 실험들은 아래와 같다. - **TAPT (Task-Adaptive Pre-Training):** 전체 학습 데이터를 사용하여 Pre-training된 모델을 과제(영화 리뷰) 도메인에 맞게 한 번 더 Pre-training하는 기법이다. 단일모델상에서 MLM을 이용한 TAPT를 사용해서 유의미한 성능향상을 관찰했으나, 앙상블할 5개모델을 전부 Pre-Training하기에는 시간이 부족하여, BERT기반의 모델 3개 `klue/bert-base`, `kykim/bert-kor-base`, `beomi/kcbert-base` 만 pretraining 해보고, 나머지 모델은 적용해보지 못했다. - **역번역 (Back-Translation) 데이터 증강:** 소수 클래스 데이터를 증강하기 위해 코드로 구현했으나, 번역 품질이 문맥을 해치는 경우가 있어 최종 적용하지 못했다. 다만, 제공됐던 데이터셋은 이미 50%는 LLM으로 증강된 데이터여서, 증강된 데이터를 오히려 추가하면 데이터 shift가 발생할것이라고 생각되어, 증강은 적용해보지 않았다. - **전체 데이터 재학습:** 검증 데이터를 포함한 전체 학습 데이터로 모델을 재학습하여 성능을 극대화하는 단계를 진행하지 못했다. 과적합되지 않는 최적의 epoch 및 하이퍼파라미터를 찾기에는 남은 시간이 부족했고, 단일모델로 실험해본 결과, 과적합의 영향인지 유의미한 성능향상은 관찰할 수 없었다. ## 2-6. 최종 모델 최적화 - **커스텀 토크나이저:** `[LAUGH]`, `[CRY]`, `[HEART]`, `[DISPLEASED]` 등 감정을 표현하는 자음/모음 반복 및 이모티콘을 10여 개의 특수 토큰으로 정의했다. - **Hyperparameter Tuning:** `alpha` 가중치를 균등 분포(`[0.25, 0.25, 0.25, 0.25]`, 즉 `alpha`=1)로 설정하는 것이 최적임을 이전의 실험을 통해 확정했다. - **SWA (Stochastic Weight Averaging):** 모델의 일반화 성능을 높이기 위해 SWA를 적용했다. 이때 가장 eval/acc가 높았던 체크포인트 3개를 앙상블하는 방식을 사용했다. - **Weighted Ensemble:** 서로 다른 시드(Seed)를 가진 3개의 BERT 기반 모델을 학습하여 단일모델의 test/acc를 정규화 하여 weight로 주어서 Soft-voting 앙상블을 수행했다. - **Loss Function (Focal Loss):** `CustomTrainerWithFocalLoss`를 사용하되, `alpha` 가중치를 `[1, 1, 1, 1]`로 설정하여, 클래스 불균형에 대한 가중치 대신 `gamma`를 통한 '어려운 샘플' 가중치에만 집중했다. - **핵심 평가지표 설정:** `TrainingArguments`에서 `metric_for_best_model="eval_accuracy"`로 설정하고, `EarlyStoppingCallback` 또한 `accuracy`를 모니터링하여 과적합 방지보다 최종 평가지표에 최적화된 모델을 선택했다. - **Weighted Ensemble:** TAPT가 적용된 3개의 서로 다른 BERT 모델을 `kykim/bert-kor-base`로 튜닝된 하이퍼파라미터 세트로 각각 학습시켰다. 그리고 각 모델의 test/acc를 weight로 두어서 softvoting하여 최종 레이블을 결정했다. - **SWA (Stochastic Weight Averaging):** 각 모델의 학습 과정에서 `accuracy`가 가장 높았던 마지막 3개의 체크포인트를 평균내어(SWA) 모델의 일반화 성능을 높였다. - **기타 정규화:** `LabelSmoothing` (약 0.18), `weight_decay`, `constant` LR 스케줄러 등 하이퍼파라미터 튜닝을 통해 발견한 정규화 기법들을 적용했다. # 3. 결과 - **Public Score: 0.8278** - **Private Score: 0.8301** (98위/204) ![image](/assets/images/2025-11-03-11-42-38.png) # 4. 성찰 및 배운점 이번 프로젝트를 통해 단순히 모델성능을 향상시키는 것을 넘어, 실험을 직접 설계하고 문제의 원인을 파고들어가보는 경험을 해볼 수 있었다. - **가설은 가설일 뿐, 실험으로 검증하라:** '불균형 데이터 = 클래스 가중치 부여'라는 교과서적인 접근 방식이 가장 큰 함정이었다. 평가지표(`accuracy`)에 맞춰 Focal Loss의 `alpha` 가중치를 오히려 균등하게 설정했을 때 성능이 상승하는것을 관찰하고, **모든 가정은 데이터와 평가지표에 기반하여 실험적으로 검증해야 한다**는 교훈을 얻었다. - **하이퍼파라미터 튜닝은 가장 마지막에 해야 한다:** 이번 대회에서 가장 뼈아프게 느낀 교훈이다. HPT를 미리 수행하고 `kykim/bert-kor-base` 모델의 최적값을 찾았다고 생각했다. 하지만 **대회 종료 2일을 남기고 TAPT라는 새로운 기법을 알게 되었다.** TAPT를 적용하자 모델의 특성이 변해버렸고, 기존 HPT 결과는 무의미해졌다. 다시 HPT를 돌리기엔 시간이 절대적으로 부족했고, 결국 TAPT 모델에 이전 HPT 값을 그대로 적용하는 타협을 할 수밖에 없었다. EDA, Feature Engineering, TAPT, 데이터 증강 등 모델의 근본적인 구조를 바꾸는 모든 시도가 끝난 **'최종 모델'을 대상으로, 대회가 끝나기 직전까지 HPT를 수행**해야 한다는 것을 깨달았다. - **실험은 '전부' 해볼 수 없다, 우선순위를 정해야 한다:** HPT의 실패는 시간 관리의 실패와도 연결된다. TAPT 외에도 역번역(Back-Translation) 데이터 증강, 검증 데이터를 포함한 전체 데이터 재학습 등 시도해보고 싶은 아이디어는 많았고 코드까지 구현한 것도 있었다. 하지만 시간이 부족해 모두 시도조차 못했다. **제한된 시간과 리소스 안에서 가장 성능 향상에 '임팩트'가 클 것 같은 실험의 우선순위를 정하는 것**이 모델링 실력만큼이나 중요하다는 것을 느꼈다. - **모델 선정과 실험 자동화의 부재:** 이번 대회는 5개의 한정된 모델을 사용했다. 가장 먼저 5개 모델을 모두 돌려보고 SOTA 모델을 확인하여 앙상블 후보군을 미리 정했어야 했다. 또한, 모든 실험을 수동으로 실행하고 결과를 기다리다 보니 하루에 10번의 제출 기회도 다 활용하지 못했다. **실험 스케줄러를 만들어 24시간 GPU를 활용하고, 모든 실험 과정을 자동화**하여 제출까지 이어지는 파이프라인을 구축해야함을 배웠다. ### Week6_ML_for_RecSys_학습회고 - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-10-19-RecSysWeek6/ - Collection: WeeklyReview - Published: 2025-10-19 - Tags: RecSys, Generative Models, VAE, Variational Inference, GMM, EM Algorithm # ML for RecSys 학습 회고(6주차) ## 목차 1. 강의 복습 내용 2. 학습 회고 # 1. 강의 복습 내용 ML for RecSys라는 주제로 추천시스템에 필요한 생성모델 이론들을 배웠다. 추천하기 위해서는 사용자의 입력데이터를 기반으로 사용자가 클릭할 가능성이 높을만한 출력을 뱉는 모델이 필요하다. 이런 모델을 만들기 위해서는 사용자의 입력데이터의 확률분포를 예측해야 하는데, 고차원의 데이터는 파라미터수가 매우 많아지므로 계산하기 어렵다는 문제가 있었다. 이를 해결하기 위해 각종 확률분포와, Jensen`s inequality, KL-divergence, MFVI, Functional derivative등의 사전지식을 배우고 이를 기반으로 Variational Inference를 통해 ELBO를 최적화 해서 사용자의 확률분포를 최적화 하는 이론을 배웠다. 과제에서는 이를 기반으로 사용자의 Kluster를 시각화해보고, 비슷한 영화를 좋아하는 사용자끼리 Klustering해보는 과제도 수행핬다. --- ## 추천시스템의 발전 동향 추천시스템 기술은 과거의 단순한 모델에서 복잡하고 정교한 최신 모델로 끊임없이 발전해왔다. ### Shallow Model에서 Deep Model로 초기 추천시스템은 주로 **Shallow Model**에 기반했다. 대표적으로 **Matrix Factorization**은 사용자-아이템 평가 행렬을 저차원의 잠재 요인 행렬로 분해하여, 행렬의 비어 있는 값을 예측하는 방식으로 작동한다. ![image](/assets/images/2025-10-19-17-13-06.png) 이미지출처:https://developers.google.com/machine-learning/recommendation/collaborative/matrix 이후 딥러닝 기술이 발전하면서 **Deep Model**이 등장했다. **AutoRec**과 같은 모델은 Autoencoder 구조를 활용하여 사용자의 평가 기록을 입력받아 압축(encoding)한 후, 다시 복원(decoding)하면서 평가하지 않은 항목의 점수를 예측한다. 이 모델은 비선형적인 사용자-아이템 관계를 학습할 수 있다는 장점이 있다. ![image](/assets/images/2025-10-19-17-13-24.png) 이미지출처:AutoRec: Autoencoders Meet Collaborative Filterin ### Large-scale Generative Models 최근에는 **Large-scale Generative Models**이 추천시스템의 새로운 패러다임으로 떠오르고 있다. P5와 같은 통합 모델은 텍스트 프롬프트를 통해 별점 예측, 리뷰 요약, 직접 추천 등 다양한 추천 관련 태스크를 하나의 Multi-modal 모델로 수행할 수 있다. 또한, 이미지 생성모델인 **Diffusion Model**을 추천시스템에 적용하려는 연구도 활발히 진행 중이다. 이 모델은 노이즈를 점진적으로 제거하는 과정을 학습하여 새로운 데이터를 생성하는 원리를 이용한다. ![image](/assets/images/2025-10-19-17-13-58.png) 이미지출처:https://www.researchgate.net/figure/The-forward-and-backward-processes-of-the-diffusion-model-The-credit-of-the-used-images_fig1_382128283 --- ## GMM, EM 알고리즘, 그리고 변분 추론의 관계 ### GMM, Intractable Likelihood **가우시안 혼합 모델(Gaussian Mixture Model, GMM)**은 데이터가 K개의 가우시안 분포의 혼합으로 표현된다고 가정하는 모델이다. GMM의 확률 밀도 함수는 다음과 같다. $$p(x) = \sum_{k=1}^{K} \pi_k \mathcal{N}(x \mid \mu_k, \Sigma_k)$$ 여기서 $$\pi_k$$는 혼합 계수(mixing coefficient)이다. 모델의 파라미터 $$\theta = \{\pi_k, \mu_k, \Sigma_k\}_{k=1}^K$$를 찾기 위해 **최대 가능도 추정(MLE)**을 사용하면, 로그 가능도 함수는 다음과 같다. $$log p(X\mid \theta) = \sum_{n=1}^{N} log \left( \sum_{k=1}^{K} \pi_k \mathcal{N}(x_n \mid \mu_k, \Sigma_k) \right)$$ 로그 함수 안에 합(summation)이 있어 미분을 통해 파라미터에 대한 closed-form 해를 구하기 어렵다(intractable). ### GMM에서 $$\theta^*$$와 $$q^*$$ 최적화 GMM과 같은 잠재 변수 모델의 학습 목표는 로그 가능도($$log p(x;\theta)$$)를 최대화하는 것이지만, 이는 계산이 불가능(intractable)하다. 대신 변분 추론에서는 로그 가능도의 하한인 **ELBO(Evidence Lower Bound)**를 최대화하며, 이 과정은 q와 $$\theta$$에 대해 번갈아 최적화를 수행하는 것과 같다. 이는 EM 알고리즘의 E-step과 M-step에 각각 대응된다. $$ELBO(q, \theta) = \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} \left[ log \frac{p(x_n, z_n; \theta)}{q(z_n \mid x_n)} \right]$$ --- ### GMM에서의 $$\theta^*$$와 $$q^*$$ 최적화 과정 GMM과 같은 잠재 변수 모델의 학습 목표는 로그 가능도($$log p(x;\theta)$$)를 최대화하는 것이지만, 이는 계산이 불가능(intractable)하다. 대신 변분 추론에서는 로그 가능도의 하한인 **ELBO(Evidence Lower Bound)**를 최대화하며, 이 과정은 `q`와 $$\theta$$에 대해 번갈아 최적화를 수행하는 것과 같다. 이는 EM 알고리즘의 E-step과 M-step에 각각 대응된다. ELBO의 기본 식은 다음과 같다. $$ELBO(q, \theta) = \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} \left[ log \frac{p(x_n, z_n; \theta)}{q(z_n\mid x_n)} \right]$$ --- ### 최적의 $$q^*$$ 찾기 (E-step의 원리) 먼저, 파라미터 $$\theta$$를 고정한 상태에서 ELBO를 최대화하는 최적의 분포 $$q^*$$를 찾아본다. ELBO와 로그 가능도의 관계식은 다음과 같다. $$log p(x_n;\theta) = ELBO + D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))$$ 여기서 $$log p(x_n;\theta)$$는 현재 $$\theta$$에 대해 고정된 상수 값이다. 따라서 ELBO를 최대화하는 것은 $$D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))$$ 항을 최소화하는 것과 같다. KL Divergence는 두 분포가 동일할 때 그 값이 0으로 최소가 된다. 그러므로 최적의 $$q^*$$는 실제 사후 분포(true posterior)와 같다. $$q^*(z_n\mid x_n) = p(z_n\mid x_n;\theta)$$ 이 과정이 EM 알고리즘에서 현재 파라미터를 바탕으로 각 데이터 포인트의 잠재 변수 사후 확률$$\gamma(z_{nk})$$을 계산하는 **E-step**에 해당한다. --- ### 최적의 $$\theta^*$$ 찾기 (M-step의 원리) 다음으로, 분포 `q`를 고정한 상태에서 ELBO를 최대화하는 최적의 파라미터 $$\theta^*$$를 찾는다. ELBO 식에서 $$\theta$$와 무관한 항인 $$log q(z_n\mid x_n)$$을 제외하고 식을 정리하면 다음과 같다. $$ \begin{aligned} \theta^* &= \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} [log p(x_n, z_n; \theta)] \\ &= \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} [log p(z_n; \theta) + log p(x_n\mid z_n; \theta)] \end{aligned} $$ 이 식은 **로그 가능도의 기댓값**을 최대화하는 것과 같다. GMM의 경우, 이 기댓값은 다음과 같이 구체적으로 표현할 수 있다. * $$log p(z_n; \theta)$$는 `k`번째 가우시안이 선택될 사전 확률이므로 $$log \pi_k$$에 해당한다. * $$log p(x_n\mid z_n; \theta)$$는 `k`가 주어졌을 때 $$x_n$$이 나타날 확률이므로 $$log \mathcal{N}(x_n; \mu_k, \Sigma_k)$$에 해당한다 . 따라서 GMM에 대한 목적식 $$J(\mathcal{X};\theta)$$는 다음과 같이 정리된다. $$J(\mathcal{X};\theta) = \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} \sum_{k=1}^{K} q(z_n=k\mid x_n) (log \pi_k + log \mathcal{N}(x_n; \mu_k, \Sigma_k))$$ 이 목적식을 각 파라미터($$\mu_k, \Sigma_k, \pi_k$$)에 대해 미분하여 0이 되는 지점을 찾으면, 이것이 바로 EM 알고리즘의 **M-step**에서 파라미터를 업데이트하는 수식과 동일한 결과를 얻게 된다. ### $$q^*$$최적화 (E-step) 먼저, 파라미터 $$\theta$$를 고정한 상태에서 ELBO를 최대화하는 최적의 분포 $$q^*$$를 찾아본다. ELBO와 로그 가능도의 관계식은 다음과 같다. $$log p(x_n;\theta) = ELBO + D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))$$ 여기서 $$log p(x_n;\theta)$$는 현재 $$\theta$$에 대해 고정된 상수 값이다. 따라서 ELBO를 최대화하는 것은 $$D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))$$ 항을 최소화하는 것과 같다. KL Divergence는 두 분포가 동일할 때 그 값이 0으로 최소가 된다. 그러므로 최적의 $$q^*$$는 실제 사후 분포(true posterior)와 같다. $$q^*(z_n\mid x_n) = p(z_n \mid x_n;\theta)$$ 이 과정이 EM 알고리즘에서 현재 파라미터를 바탕으로 각 데이터 포인트의 잠재 변수 사후 확률($$\gamma(z_{nk})$$)을 계산하는 **E-step**에 해당한다. --- ### $$\theta^*$$ 최적화 (M-step) 다음으로, 분포 `q`를 고정한 상태에서 ELBO를 최대화하는 최적의 파라미터 $$\theta^*$$를 찾는다. ELBO 식에서 $$\theta$$와 무관한 항인 $$log q(z_n\mid x_n)$$을 제외하고 식을 정리하면 다음과 같다. $$ \begin{aligned} \theta^* &= \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} [log p(x_n, z_n; \theta)] \\ &= \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} [log p(z_n; \theta) + log p(x_n\mid z_n; \theta)] \end{aligned} $$ 이 식은 **로그 가능도의 기댓값**을 최대화하는 것과 같다. GMM의 경우, 이 기댓값은 다음과 같이 구체적으로 표현할 수 있다. * $$log p(z_n; \theta)$$는 `k`번째 가우시안이 선택될 사전 확률이므로 $$log \pi_k$$에 해당한다. * $$log p(x_n\mid z_n; \theta)$$는 `k`가 주어졌을 때 $$x_n$$이 나타날 확률이므로 $$log \mathcal{N}(x_n; \mu_k, \Sigma_k)$$에 해당한다. 따라서 GMM에 대한 목적식 $$J(\mathcal{X};\theta)$$는 다음과 같이 정리된다. $$J(\mathcal{X};\theta) = \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} \sum_{k=1}^{K} q(z_n=k\mid x_n) (log \pi_k + log \mathcal{N}(x_n; \mu_k, \Sigma_k))$$ 이 목적식을 각 파라미터($$\mu_k, \Sigma_k, \pi_k$$)에 대해 미분하여 0이 되는 지점을 찾으면, 이것이 바로 EM 알고리즘의 **M-step**에서 파라미터를 업데이트하는 수식과 동일한 결과를 얻게 된다. ### EM : Intractable한 GMM에서 분포 구하기 Intractable 문제를 해결하기 위해 **잠재 변수(latent variable)** `z`를 도입한다. `z`는 데이터 포인트 $$x_n$$이 어떤 가우시안 분포에서 생성되었는지를 나타내는 K차원의 이진 랜덤 벡터이다. 잠재 변수를 도입하면, 로그 가능도의 하한(ELBO)을 최대화하는 문제로 전환할 수 있으며, **기대값-최대화(Expectation-Maximization, EM)** 알고리즘을 통해 파라미터를 반복적으로 업데이트하여 해를 찾을 수 있다. * **E-step (Expectation)**: 현재 파라미터 $$\theta^{old}$$를 사용하여 잠재 변수의 사후 확률(posterior)인 $$\gamma(z_{nk})$$을 계산한다. 이는 `n`번째 데이터가 `k`번째 가우시안으로부터 생성되었을 확률을 의미한다. $$\gamma(z_{nk}) = p(z_{nk}=1 \mid x_n, \theta^{old}) = \frac{\pi_k^{old} \mathcal{N}(x_n \mid \mu_k^{old}, \Sigma_k^{old})}{\sum_{j=1}^{K} \pi_j^{old} \mathcal{N}(x_n \mid \mu_j^{old}, \Sigma_j^{old})}$$ * **M-step (Maximization)**: E-step에서 계산한 책임을 사용하여 완전 데이터 로그 가능도의 기댓값을 최대화하는 새로운 파라미터 $$\theta^{new}$$를 계산한다. $$\mu_k^{new} = \frac{\sum_{n=1}^{N} \gamma(z_{nk}) x_n}{\sum_{n=1}^{N} \gamma(z_{nk})}$$ $$\Sigma_k^{new} = \frac{\sum_{n=1}^{N} \gamma(z_{nk}) (x_n - \mu_k^{new})(x_n - \mu_k^{new})^T}{\sum_{n=1}^{N} \gamma(z_{nk})}$$ $$\pi_k^{new} = \frac{\sum_{n=1}^{N} \gamma(z_{nk})}{N}$$ ### 변분 추론: 더 일반적인 접근 EM 알고리즘은 GMM처럼 잠재 변수의 사후 확률 $$p(z\mid x, \theta)$$를 정확하게 계산할 수 있는 모델에 효과적이다. GMM은 prior가 Gaussian distribution이기 때문에 posterior를 정확하게 계산할 수 있다. 하지만 VAE와 같은 복잡한 딥러닝 모델에서는 이 사후 확률이 매우 복잡하여 계산이 불가능(intractable)하다. **변분 추론(Variational Inference, VI)**은 이러한 경우에 사용되는 더 일반적인 근사 추론 기법이다. VI는 계산 불가능한 실제 사후 분포 $$p(z \mid x)$$를 다루기 쉬운 간단한 분포 $$q(z\mid x)$$(예: 가우시안 분포)로 근사한다. VI의 목표는 $$q(z\mid x)$$와 $$p(z\mid x)$$ 사이의 **KL Divergence**를 최소화하는 것이다. 이는 데이터의 로그 가능도에 대한 **증거 하한(Evidence Lower Bound, ELBO)**을 최대화하는 것과 같다. 결론적으로, **EM 알고리즘은 VI의 특별한 경우**로 볼 수 있다. 즉, EM 알고리즘의 E-step이 바로 근사 분포 `q(z)`를 실제 사후 분포 p(z\mid x)와 같게 설정하는 과정에 해당한다. VI는 여기서 더 나아가 사후 분포를 직접 계산할 수 없을 때, 이를 근사하는 `q(z)`를 도입하여 문제를 해결하는 일반적인 방식이다. --- ## VAE와 Variational Inference ### VAE의 목표와 변분 추론의 역할 VAE는 잠재 변수 `z`를 포함하는 생성 모델로, 가능도 $$p(x)$$는 다음과 같이 표현된다. $$p(x) = \int p_\theta(x\mid z)p(z)dz$$ 이 적분은 계산이 불가능하므로, 변분 추론을 통해 **ELBO**를 최대화하는 방향으로 모델을 학습시킨다. ### ELBO(Evidence Lower Bound)의 상세 유도 과정 데이터 포인트 $$x_i$$의 로그 가능도 $$log p(x_i)$$는 다음과 같이 전개된다. 여기서 $$q_i(z)$$는 $$q(z\mid x_i)$$를 의미한다. $$ \begin{aligned} log p(x_i) &= log \int p(x_i, z) dz \\ &= log \int q_i(z) \frac{p(x_i, z)}{q_i(z)} dz \\ &= log E_{z \sim q_i(z)} \left[ \frac{p(x_i, z)}{q_i(z)} \right] \\ &\ge E_{z \sim q_i(z)} \left[ log \frac{p(x_i, z)}{q_i(z)} \right] \quad (\text{젠슨 부등식, log는 concave 함수}) \\ &= E_{z \sim q_i(z)} [log p(x_i, z) - log q_i(z)] \\ &= E_{z \sim q_i(z)} [log p(x_i\mid z)p(z) - log q_i(z)] \\ &= E_{z \sim q_i(z)} [log p(x_i\mid z)] + E_{z \sim q_i(z)} [log p(z) - log q_i(z)] \\ &= E_{z \sim q_i(z)}[log p_\theta(x_i\mid z)] - D_{KL}(q_\phi(z\mid x_i) \mid \mid p(z)) \end{aligned} $$ 마지막 줄의 식이 바로 **ELBO**이다. ### ELBO와 KL Divergence의 관계 로그 가능도는 ELBO와 KL Divergence의 합으로 정확히 분해될 수 있다. $$ \begin{aligned} D_{KL}(q_i(z) \mid \mid p(z\mid x_i)) &= E_{z \sim q_i(z)} \left[ log \frac{q_i(z)}{p(z\mid x_i)} \right] \\ &= E_{z \sim q_i(z)} \left[ log \frac{q_i(z) p(x_i)}{p(x_i, z)} \right] \\ &= E_{z \sim q_i(z)} [log q_i(z) - log p(x_i, z) + log p(x_i)] \\ &= -ELBO + log p(x_i) \end{aligned} $$ 따라서, $$log p(x_i) = ELBO + D_{KL}(q_i(z) \mid \mid p(z\mid x_i))$$ 이다. $$log p(x_i)$$는 고정된 값이므로, **ELBO를 최대화하는 것은 근사 사후 분포 $$q_i(z)$$와 실제 사후 분포 $$p(z\mid x_i)$$ 간의 KL Divergence를 최소화하는 것과 같다.** ### VAE의 손실 함수와 KL Divergence 계산 VAE의 손실 함수 $$L_i = -ELBO$$는 다음과 같이 두 항으로 구성된다. $$L_i = \underbrace{-E_{z \sim q_\phi(z\mid x_i)}[log p_\theta(x_i\mid z)]}_{\text{Reconstruction Loss}} + \underbrace{D_{KL}(q_\phi(z\mid x_i) \mid \mid p(z))}_{\text{Regularization Loss}}$$ 여기서 정규화 항인 KL Divergence는 $$q_\phi(z\mid x_i) = \mathcal{N}(\mu_q, \Sigma_q)$$`와 `$$p(z) = \mathcal{N}(\mu_p, \Sigma_p)$$ (일반적으로 표준정규분포) 사이의 거리로, 다음과 같이 해석적으로 계산할 수 있다. $$D_{KL}(q\mid \mid p) = \frac{1}{2} \left[ log \frac{\mid \Sigma_p\mid }{\mid \Sigma_q\mid } - d + (\mu_p - \mu_q)^T \Sigma_p^{-1} (\mu_p - \mu_q) + tr(\Sigma_p^{-1} \Sigma_q) \right]$$ ### Reparameterization Trick VAE 학습에서 잠재 변수 `z`는 확률 분포 $$q_\phi(z\mid x)$$로부터 **샘플링**되는데, 이 과정은 미분이 불가능하여 역전파(backpropagation)가 중단된다. 이를 해결하기 위해 **Reparameterization Trick**을 사용한다. `z`를 직접 샘플링하는 대신, $$\mu$$와 $$\sigma$$는 결정적으로 계산하고 랜덤 노이즈 $$\epsilon$$을 외부에서 샘플링하여 연산하는 방식으로 `z`를 계산한다. 이를 통해 샘플링된 $$\mu, \sigma$$는 그라디언트가 흐를 수 있어서, 미분을 통한 최적화가 가능해진다. $$z = \mu + \sigma \odot \epsilon, \quad \text{where } \epsilon \sim N(0, I)$$ ![image](/assets/images/2025-10-19-17-14-24.png) 이미지출처: https://www.google.com/url?q=https%3A%2F%2Fmedium.com%2Fgeekculture%2Fvariational-autoencoder-vae-9b8ce5475f68 --- ## 추천시스템 구현 실습 이론 학습을 바탕으로 AutoRec과 VAE 모델을 직접 구현하고, MovieLens 데이터셋에 적용하여 추천시스템을 구축했다. ### AutoRec 모델 구현 및 학습 ```python import torch import torch.nn as nn import torch.optim as optim class AutoRec(nn.Module): def __init__(self, input_size, hidden_size): super(AutoRec, self).__init__() self.encoder = nn.Linear(input_size, hidden_size) self.decoder = nn.Linear(hidden_size, input_size) def forward(self, ratings): encoded = torch.sigmoid(self.encoder(ratings)) decoded = self.decoder(encoded) return decoded ``` 손실 함수: $$loss = \text{criterion}(inputs, outputs) + 0.5 \times \text{weight_decay_loss}(\text{model, lambda_value}) $$ ### VAE 모델 구현 및 학습 ```python class VAE(nn.Module): def __init__(self, input_dim, latent_dim): super(VAE, self).__init__() # Encoder, Decoder 생략... self.encoder = nn.Sequential( nn.Linear(input_dim, 512), nn.ReLU(), nn.Linear(512, 256), nn.ReLU(), nn.Linear(256, latent_dim * 2) # mu, logvar ) self.decoder = nn.Sequential( nn.Linear(latent_dim, 256), nn.ReLU(), nn.Linear(256, 512), nn.ReLU(), nn.Linear(512, input_dim), ) def reparameterize(self, mu, logvar): std = torch.exp(0.5 * logvar) eps = torch.randn_like(std) return mu + eps * std def forward(self, x): encoded = self.encoder(x) mu, logvar = encoded[:,:self.latent_dim], encoded[:, self.latent_dim:] z = self.reparameterize(mu, logvar) decoded = self.decoder(z) return decoded, mu, logvar ``` Loss_function: $$Loss=MSE+KLD$$ $$KLD=−0.5×∑(1+logvar−μ2−exp(logvar))$$ ```python def loss_function(recon_x, x, mu, logvar): MSE = nn.functional.mse_loss(recon_x, x) KLD = -0.5 * torch.sum(1 + logvar - mu**2 - torch.exp(logvar)) return MSE + KLD ``` ### VAE 잠재 벡터를 활용한 사용자 클러스터링 학습된 VAE의 Encoder를 통해 얻은 사용자 잠재 벡터 z를 K-Means로 클러스터링하고 t-SNE로 시각화했다. 이를 통해 모델이 사용자의 선호도 패턴을 어떻게 잠재 공간에 인코딩했는지 확인할 수 있었다. ![image](/assets/images/2025-10-19-17-15-08.png) # 2. 학습 회고 이번주는 생성모델의 이론적 기반을 주로 다루었다. diffusion모델에서도 사용되는 Variational Inference는 계산하기 어려운 (Intractable)한 수식을 ELBO를 최적화 함으로써 확률분포를 근사하는 방식인데, 필요한 배경지식이 상당히 많이 필요한데, 배경지식이 없어서 찾아보며 공부했다. 이번주 공부하며 느낀것이 있는데, RecSys든 CV든 NLP든 백본은 어차피 모두 같다는 것이다. Transformer모델을 Vision에서 사용하는것은 이미 트렌드를 넘어선 고전이 되었고, diffusion모델에서만 사용하는 줄 알았던 VI는 RecSys에서 확률분포를 근사해서 추천을 하는데에도 사용이 되고있다. 어느분야든지 백본은 연결되어있다는 인상을 받았다. 공부를 하면 할수록 알아야할 내용도 많아지고 내 머리는 감자라는 생각이 자꾸 든다. 1강부터 확률분포 종류가 쏟아지는데, 각 확률분포의 Probability Density Function들이 너무 낯설어서 의미를 생각하는데에도 시간이 많이 걸렸다. 한주가 끝나고 주말이 지난 지금도, 변분추론을 통한 확률분포 근사가 완벽하게 이해되지는 않은 것 같다. 다만, 왜 근사를 해야하고, MFVI가 왜필요했는지, 어떤 방식과 과정을 통해 근사를 하는지는 이해를 해나갔다. 이번주 학습을 통해서 생성모델과 조금더 친해진것 같다. 그런데, 더 친해지려면 $$KL(내머리\mid \mid Generative Model)$$를 줄여야겠다. 그러려면 변분추론을 이용한 diffusion모델 논문도 읽어보고, 아직 읽어보지 못한 생성모델을 이용한 RecSys 논문도 읽어봐야 겠다. ### Week5_NLP_학습회고 - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-10-02-NLP-Week5/ - Collection: WeeklyReview - Published: 2025-10-02 - Tags: Natural Language Process, NLP, 5주차 학습회고 # Computer Vision 학습 회고 (4주차) ## 목차 1.  강의 복습 내용 2.  학습 회고 # 1. 강의 복습 내용 일주일간 자연어 처리(NLP)의 기초적인 개념부터 순차적인 모델링까지 학습한 내용을 정리하고 회고한다. 토큰화, 단어 임베딩, 그리고 순환 신경망(RNN)의 구조와 문제점, 그리고 그 해결책인 LSTM과 GRU에 대해 다룬다. ## 자연어의 벡터 표현 컴퓨터가 자연어를 이해하고 처리하기 위해서는 텍스트를 숫자 형태의 벡터로 변환하는 과정이 필수적이다. 이 과정은 토큰화와 임베딩으로 나눌 수 있다. ### 토큰화 (Tokenization) 토큰화는 주어진 텍스트(Corpus)를 토큰(Token)이라는 의미 있는 단위로 분리하는 작업이다. 자연어 처리 모델은 이 토큰을 입력으로 받아 처리하며, 토큰화 방식에 따라 모델의 성능이 크게 달라질 수 있다. #### 토큰화의 종류 토큰화는 분리하는 단위에 따라 크게 3가지로 나눌 수 있다. * **단어 수준 토큰화 (Word-level Tokenization)**: 텍스트를 띄어쓰기나 형태소(의미 단위)를 기준으로 분리한다. 직관적이지만, 사전에 없는 단어(Out-of-Vocabulary, OOV)가 등장하면 모두 `[UNK]` (Unknown) 토큰으로 처리되어 정보 손실이 발생하는 단점이 있다. * **문자 수준 토큰화 (Character-level Tokenization)**: 텍스트를 문자(철자) 단위로 분리한다. 이 방식은 OOV 문제를 해결할 수 있다는 장점이 있지만, 토큰의 개수가 너무 많아져 문장이 길어질 경우 처리하기 어렵고, 각 토큰이 유의미한 의미를 갖기 힘들어 모델 성능이 저하될 수 있다. * **서브워드 수준 토큰화 (Subword-level Tokenization)**: 단어와 문자 수준 토큰화의 장점을 결합한 방식이다. 자주 사용되는 단어는 그대로 유지하고, 자주 사용되지 않는 단어는 의미 있는 서브워드(subword) 단위로 분리한다. 이를 통해 OOV 문제를 해결하면서도 토큰의 길이를 효율적으로 관리할 수 있다. #### Byte Pair Encoding (BPE) BPE는 대표적인 서브워드 토큰화 알고리즘이다. 동작 원리는 다음과 같다. 1. 모든 단어를 문자(character) 단위로 분리하여 초기 단어장(vocabulary)을 구성한다. 2. 학습 데이터에서 가장 빈번하게 등장하는 문자 쌍(pair)을 찾아 하나의 새로운 토큰으로 병합하고, 단어장에 추가한다. 3. 원하는 단어장 크기가 될 때까지 2번 과정을 반복한다. ![image](/assets/images/2025-10-02-18-49-05.png) 새로운 텍스트가 입력되면, 사전에 정의된 가장 긴 문자열을 우선적으로 찾아 토큰으로 매칭한다. 예를 들어, 단어장에 "est"와 "st"가 모두 있다면 "newest"는 ["n", "e", "w", "est"]로 토큰화된다. ### 단어 임베딩 (Word Embedding) 토큰화된 단어들을 밀집 벡터(Dense Vector)로 표현하는 것을 단어 임베딩이라고 한다. #### One-Hot Encoding의 한계 One-Hot 인코딩은 단어를 Categorical 변수로 보고, 단어장의 크기만큼의 차원을 가진 벡터에서 해당 단어의 인덱스만 1로, 나머지는 0으로 표현하는 방식이다. 이 방식은 단어 간의 유사도를 계산할 수 없다는 치명적인 단점이 있다. 모든 단어 벡터 간의 내적은 0이고, 유클리드 거리는 항상 $$ \sqrt{2} $$ 이기 때문이다. #### 분산 표현 (Distributed Representation) 이러한 한계를 극복하기 위해 등장한 것이 분산 표현, 즉 밀집 벡터(Dense Vector) 표현이다. 단어의 의미를 여러 차원에 분산하여 표현하며, 벡터 간의 유사도(코사인 유사도, 유클리드 거리 등)를 통해 단어의 의미적 유사성을 나타낼 수 있다. #### Word2Vec Word2Vec은 단어를 밀집 벡터로 표현하는 대표적인 방법론이다. "단어의 의미는 주변 단어에 의해 결정된다"는 분포 가설에 기반한다. * **Skip-gram**: 중심 단어를 이용해 주변 단어를 예측하는 모델이다. * **CBOW (Continuous Bag of Words)**: 주변 단어들을 이용해 중심 단어를 예측하는 모델이다. ![image](/assets/images/2025-10-02-18-50-14.png) Word2Vec은 간단한 신경망 구조를 가진다. 예를 들어 "I study math"라는 문장에서 'study'라는 입력(중심 단어)이 주어졌을 때 'math'(주변 단어)를 예측하는 과정은 다음과 같다. $$ y = \text{softmax}(W_2 W_1 x) $$ 여기서 $$x$$는 'study'의 One-hot 벡터이고, $$W_1$$과 $$W_2$$는 각각 입력층에서 은닉층으로, 은닉층에서 출력층으로 가는 가중치 행렬이다. 학습을 통해 이웃한 단어의 임베딩 벡터는 높은 내적 값을 갖도록, 즉 유사도가 높아지도록 $$W_1$$과 $$W_2$$가 업데이트된다. 학습된 단어 벡터는 단어들 간의 의미적, 문법적 관계를 벡터 공간에 표현한다. 예를 들어, 다음과 같은 유추(Analogy)가 가능하다. $$ vec(\text{"queen"}) - vec(\text{"king"}) \approx vec(\text{"woman"}) - vec(\text{"man"}) $$ ![image](/assets/images/2025-10-02-18-50-36.png) #### Word2Vec 학습 효율화 Word2Vec의 Skip-gram 모델은 출력층에서 Softmax를 계산할 때 단어장(Vocabulary)의 모든 단어에 대한 확률을 계산해야 하므로 계산 비용이 매우 크다. 이를 해결하기 위한 방법들이 제안되었다. * **Negative Sampling**: 전체 단어장을 대상으로 하는 다중 분류 문제를 "두 단어가 이웃하는가?"를 맞추는 이진 분류 문제로 변환한다. 실제 주변 단어(Positive sample)와 임의로 뽑은 관련 없는 단어들(Negative samples)을 구분하도록 모델을 학습시킨다. 목적 함수는 다음과 같다. $$ \log \sigma({v'_{w_O}}^{\top} v_{w_I}) + \sum_{i=1}^{k} \mathbb{E}_{w_i \sim P_n(w)}[\log \sigma(-{v'_{w_i}}^{\top} v_{w_I})] $$ 이 식은 정답 쌍($$w_O, w_I$$)의 내적 값은 커지게 하고, 노이즈(오답) 쌍($$w_i, w_I$$)의 내적 값은 작아지도록 학습한다. * **Sub-sampling**: "the", "a"와 같이 매우 빈번하게 등장하는 단어들은 정보적 가치가 낮으면서 학습량만 늘리는 경향이 있다. 이러한 단어들을 특정 확률에 기반하여 학습에서 제외시켜 속도와 정확도를 높인다. 단어를 제외할 확률은 다음과 같이 계산된다. $$ P(w_i) = 1 - \sqrt{\frac{t}{f(w_i)}} $$ 여기서 $$f(w_i)$$는 단어 $$w_i$$의 빈도, $$t$$는 임계값이다. ## 순차 데이터 모델링 텍스트나 시계열 데이터와 같이 순서가 중요한 데이터를 처리하기 위해 RNN(Recurrent Neural Network)이 고안되었다. ### RNN (Recurrent Neural Network) RNN은 가변적인 길이의 시퀀스(Sequence) 데이터를 처리할 수 있는 신경망이다. 이전 타임 스텝(time step)의 정보를 현재 타임 스텝의 입력과 함께 사용하여 출력을 계산하는 순환 구조를 가진다. #### RNN의 기본 구조 각 타임 스텝 $$t$$에서 RNN은 입력 벡터 $$x_t$$와 이전 타임 스텝의 은닉 상태(hidden state) $$h_{t-1}$$을 받아 새로운 은닉 상태 $$h_t$$를 계산한다. $$ h_t = f_W(h_{t-1}, x_t) $$ 일반적으로 활성화 함수로 `tanh`를 사용하여 다음과 같이 표현한다. $$ h_t = \tanh(W_{hh}h_{t-1} + W_{xh}x_t) $$ 그리고 현재 은닉 상태 $$h_t$$를 이용해 출력 $$y_t$$를 계산할 수 있다. $$ y_t = W_{hy}h_t $$ 중요한 점은 모든 타임 스텝에서 동일한 가중치 행렬 $$W_{hh}$$, $$W_{xh}$$, $$W_{hy}$$가 공유된다는 것이다. ![image](/assets/images/2025-10-02-18-51-02.png) RNN은 입출력의 형태에 따라 다양하게 활용될 수 있다. * **one-to-many**: 이미지 캡셔닝 (하나의 이미지 입력, 문장 출력) * **many-to-one**: 감성 분석 (문장 입력, 긍정/부정 출력) * **many-to-many**: 기계 번역, 개체명 인식 (시퀀스 입력, 시퀀스 출력) ### RNN의 학습과 장기 의존성 문제 RNN은 BPTT(Backpropagation Through Time)를 통해 학습한다. 이는 시간의 흐름에 따라 네트워크를 펼친 후, 역전파 알고리즘을 적용하는 방식이다. 하지만 시퀀스가 길어질 경우 심각한 문제가 발생한다. #### 기울기 소실 및 폭주 (Vanishing/Exploding Gradients) BPTT 과정에서 그래디언트는 체인 룰(chain rule)에 의해 여러 타임 스텝을 거슬러 전파된다. 이 과정에서 동일한 가중치 행렬($$W_{hh}$$)이 반복적으로 곱해지게 된다. $$ \frac{\partial L}{\partial h_k} = \frac{\partial L}{\partial h_t} \frac{\partial h_t}{\partial h_{t-1}} \frac{\partial h_{t-1}}{\partial h_{t-2}} \dots \frac{\partial h_{k+1}}{\partial h_k} = \frac{\partial L}{\partial h_t} \prod_{i=k+1}^{t} \frac{\partial h_i}{\partial h_{i-1}} $$ 이때 $$\frac{\partial h_i}{\partial h_{i-1}}$$에 해당하는 값(정확히는 $$W_{hh}$$의 고유값(Eigenvalue))의 크기가 1보다 크면 그래디언트가 기하급수적으로 커져 폭주(Exploding)하고, 1보다 작으면 0에 가깝게 사라져 소실(Vanishing)된다. * **기울기 폭주 (Exploding Gradient)**: 학습이 불안정해지고 파라미터가 발산한다. * **기울기 소실 (Vanishing Gradient)**: 먼 과거의 정보가 현재까지 전달되지 못해 장기 의존성(Long-term dependency) 학습에 실패한다. ![image](/assets/images/2025-10-02-18-51-52.png) 이를 해결하기 위한 방법으로는 그래디언트의 크기가 특정 임계값을 넘지 못하도록 잘라내는 **그래디언트 클리핑(Gradient Clipping)**이나, 전체 시퀀스가 아닌 일정 길이의 청크(chunk) 단위로만 역전파를 수행하는 **Truncated BPTT** 등이 있다. ### LSTM과 GRU 기울기 소실 문제를 근본적으로 해결하기 위해 RNN의 내부 구조를 개선한 모델이 LSTM과 GRU이다. #### LSTM (Long Short-Term Memory) LSTM은 **셀 상태(Cell State)**라는 별도의 정보 흐름 경로를 추가하여 그래디언트가 장기간에 걸쳐 잘 흐르도록 설계되었다. 셀 상태는 컨베이어 벨트와 같아서, 약간의 선형적인 상호작용만 거치며 정보를 전달한다. ![image](/assets/images/2025-10-02-18-52-28.png) LSTM은 3개의 게이트(Gate)를 통해 셀 상태의 정보를 조절한다. 1. **Forget Gate ($$f_t$$)**: 과거 정보를 얼마나 잊을지 결정한다. Sigmoid 함수를 통해 0(모두 잊음)과 1(모두 기억) 사이의 값을 출력한다. $$ f_t = \sigma(W_f[h_{t-1}, x_t] + b_f) $$ 2. **Input Gate ($$i_t$$)**: 현재 정보를 얼마나 셀 상태에 저장할지 결정한다. $$ i_t = \sigma(W_i[h_{t-1}, x_t] + b_i) $$ $$ \tilde{C}_t = \tanh(W_C[h_{t-1}, x_t] + b_C) $$ 3. **Output Gate ($$o_t$$)**: 셀 상태의 정보를 얼마나 외부(hidden state)로 내보낼지 결정한다. $$ o_t = \sigma(W_o[h_{t-1}, x_t] + b_o) $$ $$ h_t = o_t * \tanh(C_t) $$ 최종적으로 새로운 셀 상태 $$C_t$$는 이전 셀 상태 $$C_{t-1}$$에서 잊을 부분을 제거하고, 새로운 정보 $$\tilde{C}_t$$에서 추가할 부분을 더하여 업데이트된다. $$ C_t = f_t * C_{t-1} + i_t * \tilde{C}_t $$ 이 구조에서 셀 상태의 그래디언트는 곱셈이 아닌 덧셈 연산을 통해 전달되므로, 기울기 소실 문제로부터 비교적 자유롭다. #### GRU (Gated Recurrent Unit) GRU는 LSTM의 구조를 단순화한 모델이다. 셀 상태와 은닉 상태를 하나로 통합하고, 게이트의 수도 2개(Update Gate, Reset Gate)로 줄여 계산 효율성을 높였다. 성능은 LSTM과 유사하거나 특정 태스크에서는 더 좋은 경우도 있다. --- # 2. 소감  어느정도 공부하는데 감을 잡은것 같은 한주였다. 이번주 강의는 주재걸 교수님께서 간단하고 짧게 설명하셨는데, 오히려 Futher reading에서는 LSTM의 각 gate에 대한 설명, Gradient의 Exploding/Vanishing이 발생하는 BackPropagation에서의 이유에서 tanh 합성함수를 계속 미분했을때 공비와 연관된 문제가 있다는것, skip-gram모델을 extension해서 sub-sampling과 Negative-sampling을 사용하고, 단어의 임베딩 벡터사이의 선형연관을 밝혀낸 논문등 읽고 공부할것들이 많았다. 그리고 과제에서도 Data_preprocessing&Tokenization은 간단하게 몇줄 채워넣는 정도의 과제여서 어렵지 않았지만, 코드를 뜯어보며 이해하고 정리하는데는 시간이 걸렸었고, 특히 2번째 과제 Subword-level LanguageModel에서 코딩테스트 문제를 푸는듯하게 Counter library도 오랜만에 써서, 문장을 `split()`으로 분리하고, 리스트로 만들고, dict를 이용해서 id를 token으로만들고 다시 token을 id로 만드는 과정들을 돌아보며 쉽지 않았던 것 같다. 그래도 이번주는 전반적으로 LLM을 쓰지 않고 혼자서 문제들을 해결해보려 했고, 혼자서 코드들을 작성해서 문제를 해결해서 뿌듯하다. 아직 부족한게 많긴 하지만, 어떻게 무엇을 공부해야 할지 방향성이 확실하게 잡힌것 같아서 안개가 서서히 걷혀가는 기분이다. 아직 해야할게 많다. CV논문들도 봐야하고, PyTorch공부, PCA와 EigenVector, EigenValue를 이해하기 위한 선형대수도 공부해야하고, Github도 공부해야한다. 그리고 Kaggle이나 dacon 경진대회 참여를 위한 준비도 해볼 예정이다. 너무 할게 많아서 갇혀버린 기분이 들때는 가끔 학교에가서 동기들과 얘기도하고 쉬어가는 시간을 가졌던게 큰 도움이 된것 같다. 앞으로도 루틴을 유지하면서 할일을 해나가야겠다. ![image](/assets/images/2025-10-02-19-06-45.png) 열심히공부한 흔적 1 ![image](/assets/images/2025-10-02-19-07-05.png) 열심히 공부한 흔적 2 ![image](/assets/images/2025-10-02-19-07-26.png) 이번주에 정리한 노션 ![image](/assets/images/2025-10-02-19-07-47.png) ![image](/assets/images/2025-10-02-19-07-57.png) 나도실습가고싶다.. ### Week4_Computer_Vision_학습회고 - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-09-26-ComputerVision-Week4/ - Collection: WeeklyReview - Published: 2025-09-26 - Tags: Computer Vision, CV, 4주차 학습회고 # Computer Vision 학습 회고 (4주차) ## 목차 1.  강의 복습 내용 2.  학습 회고 # 1. 강의 복습 내용 ## 1. Introduction to Computer Vision 컴퓨터 비전은 기계가 시각적 세계를 '이해'하고 '해석'하게 하는 인공지능 분야다. 본질적으로 3차원 세계가 2차원 평면에 투영된 이미지로부터 의미 있는 정보(Semantic attributes)를 추출하는 **'Inverse Rendering'** 과정으로 정의할 수 있다. 이 과정은 빛이 카메라 센서를 통해 디지털 신호로 변환되어, 각 픽셀이 특정 밝기 값을 갖는 숫자 행렬로 표현되는 것으로부터 시작된다. ![image](/assets/images/2025-09-26-18-54-39.png) --- ## 2. 핵심 아키텍처: CNN에서 ViT까지 ### 2.1. Convolutional Neural Networks (CNN) CNN은 이미지의 공간적, 지역적 특징을 효과적으로 학습하기 위해 고안된 모델이다. 모든 픽셀을 연결하는 Fully Connected 방식과 달리 **Local feature learning(지역적 특징 학습)**과 **Parameter sharing(파라미터 공유)**을 통해 효율적인 학습이 가능하다. -   **CNN의 발전사: AlexNet부터 ResNet까지** -   **AlexNet (2012)**: ILSVRC에서 우승하며 딥러닝 시대의 서막을 연 모델이다. **ReLU 활성화 함수**를 통해 Vanishing Gradient 문제를 완화하고, **Dropout**을 사용해 과적합을 방지했다. -   **VGGNet (2014)**: 3x3의 작은 컨볼루션 필터와 2x2 맥스 풀링만을 사용하여 더 깊고 간단한 구조를 구현했다. 이를 통해 더 큰 **Receptive Field(수용 영역)**를 확보하면서도 파라미터 수를 줄이는 효과를 보았다. -**핵심 모델: ResNet (2016)과 Degradation Problem 극복** 네트워크가 무작정 깊어지면 오히려 학습 에러와 테스트 에러가 모두 커지는 **Degradation Problem(성능 저하 문제)**이 발생한다. 이는 과적합과는 다른 최적화의 문제다. ResNet은 이 문제를 해결하기 위해 **Residual Block**을 제안했다. -**Residual Block**: 핵심 아이디어는 **Skip Connection (Shortcut)**이다. 입력 $x$를 여러 레이어를 건너뛰어 출력에 그대로 더해줌으로써, 네트워크는 전체 출력 $H(x)$를 학습하는 대신 변화량(residual)인 $F(x)$만 학습하면 된다. 이는 Gradient가 소실되지 않고 깊은 레이어까지 잘 전달되도록 돕는다. -목표 함수: $$H(x) = F(x) + x$$         -학습 대상 (Residual):$$F(x) = H(x) - x$$ ![image](/assets/images/2025-09-26-18-58-09.png) ### 2.2. Vision Transformer (ViT) 자연어 처리(NLP) 분야에서 큰 성공을 거둔 Transformer 모델을 이미지에 직접 적용하려는 시도에서 탄생했다. - **Transformer의 핵심: Self-Attention**     RNN의 Long-term dependency 문제를 해결하기 위해 등장했다. 입력 시퀀스 내의 모든 요소 간의 관계를 한 번에 계산하여 거리에 상관없이 의존성을 모델링한다. -   입력 feature $X$로부터 가중치 행렬 $W^Q, W^K, W^V$를 곱해 **Query(Q), Key(K), Value(V)** 세 벡터를 생성한다. -   어텐션 스코어는 Query와 Key의 유사도를 계산하고, 이를 Value에 가중합하여 최종 출력 Z를 얻는다. 이 과정은 다음 수식으로 요약된다. $$Attention(Q, K, V) = softmax(\frac{QK^T}{\sqrt{d_k}})V$$ - **ViT 아키텍처** 1.  **이미지 패치화 (Image Patching)**: 이미지를 고정된 크기(e.g., 16x16)의 여러 패치(Patch)로 나눈다. 2.  **Linear Projection**: 각 패치를 Flatten하여 1D 벡터로 만들고, Linear Projection을 통해 임베딩한다. 3.  **Position Embedding**: Self-Attention은 순서 정보에 불변(order-invariant)하므로, 각 패치의 위치 정보를 알려주기 위해 **Position Embedding**을 더해준다. 4.  **`[CLS]` 토큰 추가**: 이미지 전체의 정보를 요약하고 최종 분류에 사용하기 위해 학습 가능한 `[CLS]` (Classification) 토큰을 시퀀스 맨 앞에 추가한다. 5.  **Transformer Encoder**: 완성된 시퀀스를 Transformer Encoder에 입력하여 패치 간의 관계를 학습한다. 6.  **MLP Head**: Encoder의 `[CLS]` 토큰 최종 출력값을 MLP Head에 통과시켜 클래스를 예측한다. ![image](/assets/images/2025-09-26-18-58-54.png) -   **Scaling Law**: ViT의 가장 큰 특징 중 하나는, 데이터와 모델 크기가 커질수록 성능이 비례하여 향상되는 **Scaling Law**를 잘 따른다는 점이다. 이는 대규모 데이터셋으로 사전 학습했을 때 CNN을 능가하는 성능을 보이는 기반이 된다. --- ## 3. 모델 해석 및 성능 향상 기법 ### 3.1. CNN Visualization CNN은 종종 '블랙박스'로 불리지만, 시각화 도구를 통해 내부 동작을 분석하고 디버깅할 수 있다. -   **모델 동작 분석 (Analysis of Model Behaviors)** -   **Filter Visualization**: 초기 레이어의 필터는 색상, 엣지 등 Low-level feature를, 깊은 레이어는 더 복잡한 High-level feature를 학습하는 경향이 있다. -   **Embedding Feature Analysis**: -   **Nearest Neighbors**: 특정 이미지의 Feature Vector와 가장 가까운 다른 이미지들을 찾아, 모델이 어떤 이미지를 '유사하다'고 판단하는지 분석한다. ![image](/assets/images/2025-09-26-19-41-13.png) -   **t-SNE**: 고차원의 Feature Vector를 2차원으로 차원 축소하여 시각화함으로써, 모델이 클래스를 얼마나 잘 군집화하는지 확인할 수 있다. ![image](/assets/images/2025-09-26-19-41-43.png) -   **Activation Investigation**: -   **Maximally Activating Patches**: 특정 뉴런(채널)을 가장 강하게 활성화시키는 이미지 패치들을 모아 해당 뉴런의 역할을 유추한다. -   **Class Visualization**: 특정 클래스의 점수를 최대화하는 이미지를 생성(**Gradient Ascent**)하여, 모델이 해당 클래스를 어떻게 '상상'하는지 본다. -   **모델 결정 설명 (Model Decision Explanation)** -   **CAM (Class Activation Mapping)**: 모델이 이미지의 어느 부분을 보고 특정 클래스로 판단했는지 히트맵으로 보여준다. 이를 위해 마지막 FC Layer를 **GAP (Global Average Pooling)** Layer로 대체하고 재학습해야 하는 단점이 있다. -   **Grad-CAM**: CAM의 단점을 보완하여 모델 구조 변경 없이 Gradient 정보를 이용해 중요도 가중치를 계산한다. 특정 클래스에 대한 예측 점수를 마지막 컨볼루션 레이어의 Feature Map으로 미분하여 그래디언트를 구하고, 이를 GAP하여 각 채널의 중요도($$\alpha_k^c$$)를 얻는다. -가중치 계산: $$\alpha_k^c = \frac{1}{Z}\sum_i \sum_j \frac{\partial y^c}{\partial A_{ij}^k}$$ - Grad-CAM 생성:$$L_{Grad-CAM}^c = ReLU(\sum_k \alpha_k^c A^k)$$ ReLU를 통해 양의 영향을 미친 부분에만 집중한다. ![image](/assets/images/2025-09-26-19-01-57.png) ### 3.2. Data Augmentation 학습 데이터는 실제 세계의 모든 분포를 완벽하게 반영하지 못한다. 이로 인한 **편향(bias)**을 줄이고 모델의 **일반화 성능**을 높이기 위해 데이터 증강은 필수적이다. - **기본 및 최신 기법**: - **기본 기법**: `Rotate`, `Flip`, `Crop`, `Brightness` 조절 등 기본적인 이미지 변환을 적용한다. ```python # 예시: OpenCV를 이용한 이미지 회전 및 뒤집기 img_rotated = cv2.rotate(image, cv2.ROTATE_90_CLOCKWISE) img_flipped = cv2.rotate(image, cv2.ROTATE_180) # 예시: Numpy를 이용한 밝기 조절 def brightness_augmentation(img): # numpy array img has RGB value (0-255) for each pixel img[:,:,0] = img[:,:,0] + 100 # add 100 to R value img[:,:,1] = img[:,:,1] + 100 # add 100 to G value img[:,:,2] = img[:,:,2] + 100 # add 100 to B value img[:,:,0][img[:,:,0] > 255] = 255 # clip R values over 255 img[:,:,1][img[:,:,1] > 255] = 255 # clip G values over 255 img[:,:,2][img[:,:,2] > 255] = 255 # clip B values over 255 return img ``` -**CutMix**: 두 이미지를 잘라 붙여 새로운 학습 데이터를 생성한다. 레이블도 잘린 영역의 비율에 따라 soft label(e.g., `[0.7, 0.3]`)로 혼합하여 모델이 객체를 더 잘 지역화(localize)하도록 돕는다. -**RandAugment**: 수많은 증강 기법 중 최적의 조합과 강도를 자동으로 탐색하여 적용한다. -**Synthetic Data**: 실제 데이터 수집이 불가능하거나 매우 어려운 경우(e.g., Video Motion Magnification), 시뮬레이션을 통해 학습 데이터를 생성하기도 한다. --- ## 4. 핵심 CV Tasks: Segmentation & Detection ### 4.1. 이미지 분할 (Segmentation) -**Semantic Segmentation**: 이미지의 모든 픽셀을 특정 클래스(e.g., 사람, 자동차, 하늘)로 분류한다. 객체 각각을 구분하지는 않는다. - **FCN (Fully Convolutional Network)**: FC 레이어 대신 1x1 Conv를 사용하여 공간 정보를 유지하고, Upsampling과 Skip connection을 통해 coarse한 feature map의 해상도를 복원하여 정확도를 높인다. - **U-Net**: FCN을 기반으로, 대칭적인 인코더(Contracting Path)-디코더(Expanding Path) 구조를 가지며 Skip connection을 통해 low-level feature를 효과적으로 전달하여 정교한 분할이 가능하다. -**Instance Segmentation**: Semantic Segmentation에서 한 단계 더 나아가, 같은 클래스에 속하는 객체라도 각각의 개체(instance)를 구별하여 분할한다. - **Mask R-CNN**: Two-stage detector인 Faster R-CNN에 Mask를 예측하는 작은 FCN 브랜치를 추가한 구조다. `(Classification + Bounding Box) + Mask`를 동시에 수행한다. ![image](/assets/images/2025-09-26-19-04-11.png) ### 4.2. Object Detection 객체의 클래스를 분류하고, 그 위치를 Bounding Box로 찾는 task다. - **One-stage vs. Two-stage Detectors**: Two-stage detector(e.g., R-CNN)는 후보 영역 제안과 분류를 순차적으로 진행해 정확도가 높고, One-stage detector(e.g., YOLO)는 이를 동시에 처리해 속도가 빠르다. - **Focal Loss**: One-stage detector에서 발생하는 극심한 클래스 불균형(대부분이 배경) 문제를 해결하기 위해 제안되었다. 예측이 쉬운 샘플(well-classified examples)의 loss는 줄이고, 어려운 샘플(hard examples)의 loss에 더 큰 가중치를 부여한다. - Focal Loss 수식: $$FL(p_t) = -(1-p_t)^\gamma \log(p_t)$$     여기서 $(1-p_t)^\gamma$ 항이 가중치 역할을 한다. -**DETR (DEtection TRansformer)**: Object Detection을 '집합 예측(set prediction)' 문제로 재정의한 Transformer 기반 모델이다. **Object Queries**와 **Bipartite Matching**을 통해 NMS 같은 후처리 없이 end-to-end 학습이 가능하다. --- ## 5. Computational Imaging 이미징 파이프라인에 컴퓨터 연산을 추가하여 기존 카메라의 한계를 극복하거나 새로운 기능을 구현하는 분야다. Denoising, Super-resolution, Deblurring 등이 대표적이다. -**학습 데이터 생성의 중요성**: Computational Imaging에서는 (Degraded image, Ground-truth) 데이터 쌍을 구하기 어려운 경우가 많아, 현실적인 **합성 데이터**를 만드는 것이 성능에 큰 영향을 미친다. -   **Denoising**: 깨끗한 이미지에 가우시안 노이즈를 추가하여 학습 데이터를 생성한다. -   **Super-resolution**: 단순히 고해상도 이미지를 Downsampling하는 것보다, 실제 렌즈의 초점 거리(focal length)를 변경하여 촬영한 이미지 쌍을 사용하는 **RealSR** 방식이 더 현실적인 데이터셋을 구축하는 데 효과적이다. -   **Deblurring**: 고속 카메라로 촬영한 여러 장의 선명한 프레임을 평균 내어 블러 이미지를 합성하는 **GoPro dataset**이나, 빔 스플리터를 이용한 듀얼 카메라 시스템으로 블러/선명 이미지를 동시에 촬영하는 **RealBlur** 방식이 있다. -**고품질 결과를 위한 Loss Functions**: -   **L1/L2 Loss의 한계**: 픽셀 값의 차이만 계산하므로, 사람이 보기에 부자연스럽고 흐릿한(blurry) **평균적인 이미지**를 생성하는 경향이 있다. -   **Adversarial Loss (GAN)**: Discriminator가 실제 이미지와 구별할 수 없을 정도로 사실적인 이미지를 생성하도록 Generator를 학습시킨다. 평균적인 결과가 아닌, 실제 이미지 분포 내에 있는 하나의 선명한 결과물을 생성한다. -   **Perceptual Loss**: 사전 학습된 VGG와 같은 네트워크의 중간 Feature Map을 이용해 Loss를 계산한다. 픽셀 공간이 아닌 **Feature 공간에서의 유사도**를 측정함으로써, 사람이 인지하기에 더 자연스러운 결과를 얻는다. --- # 2. 소감  관련 논문만 10개가 넘는다. SAM, DETR, CAM, grad-CAM, VGG, ResNet, ViT등등 읽고 리뷰해야할 논문이 쏟아진 한주였다. 읽고 정리해보려 했는데, 어려운 과제내용을 정리하기 바빴고, 과제에 사용되는 모듈과 함수들을 익히기 바빴다. 제대로 해낸건 하나없는것 같은데 한주가 가버렸다. 열심히 한다고 하는데, 열심히해서 되는건 없는것 같고 그냥 해야만 할 것 같다. 내가 재밌어서 그동안 공부하고 싶었던 주제인 CV를 드디어 제대로 배우게 되었는데, 할 줄아는건 없고, 아는것도 없고, 한주가 스쳐지나가버린것 같다. 이 기회를 놓쳐버리고 싶지 않다. 강의를 들으면서 와 이건진짜 신기하네. 어떻게 이런 생각을 해서 문제를 해결하지? 라는 생각을 계속했다. 특히 Debluring task에서 블러는 방향도 포함하고, blur의 정도도 포함해서 해결하기 어려운 task인데, 단순히 gaussian noise를 주는것에서 벗어나서 짧은 노출 사진 여러개를 concat해서 노출을 늘리는 방법, 이렇게 만든 Data로 학습하는 Gan, 그리고 L1, L2Loss는 '평균적'으로 비슷한 이미지만 classification하므로 Perceptual Loss와 Adversarial Loss를 사용하는 획기적인 방법들을 보며 감탄했다. 다만, 이렇게 놀라운 방법들은 수학적인 원리를 기반으로 하고 있기 때문에 단번에 이해하기 어려웠다. 그런데 피어세션과 페어리뷰를 하며 내가 배우는 내용들은 다른사람들도 어렵다는걸 듣고 위안을 얻기도 했다. 당연히 CV로 푸는 문제가 간단하진 않으니까 Heuristic한 알고리즘으로는 해결하지 못하고, Deeplearning을 이용하는 것이다. 어려운건 당연하니깐, 문제를 직면하고, 해결하는법을 이해해봐야겠다. ### Week3_AI_LifeCycle_학습회고 - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-09-19-AIMath-Week3%20copy/ - Collection: WeeklyReview - Published: 2025-09-19 - Tags: AI LifeCycle, Transformer, Multi-head Self-Attention # AI LifeCycle 학습 회고 (3주차) ## 목차 1. 강의 복습 내용 2. 과제 결과물 정리 3. 학습 회고 --- # 1. 강의 복습 내용 ## 1. 선형대수와 머신러닝의 기초 ### 1.1. 선형 회귀 (Linear Regression) 회귀 분석은 독립 변수 $x$를 기반으로 종속 변수 $y$를 예측하는 모델을 만드는 과정이다. 선형 회귀는 이 관계가 선형적이라고 가정한다. * **방정식**: 가장 기본적인 형태는 $$y = mx + b$$로 표현된다. 여러 독립 변수를 다루는 다중 선형 회귀는 $$y = b_0 + b_1x_1 + b_2x_2 + ... + b_nx_n$$으로 확장된다. * **최소 제곱법 (OLS)**: 모델의 최적 매개변수 $m$과 $b$를 찾는 방법 중 하나로, 실제 값과 예측 값의 차이, 즉 잔차(residual)의 제곱합을 최소화하는 값을 찾는다. 비용 함수는 다음과 같다. $$cost(m, b) = \sum(y_i - (mx_i + b))^2$$ * **모델 평가**: 모델의 성능은 다양한 지표로 평가한다. * **MAE (Mean Absolute Error)**: $$MAE = \frac{1}{n}\sum_{i=1}^{n}|y_i - \hat{y}_i|$$ * **MSE (Mean Squared Error)**: $$MSE = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2$$ * **RMSE (Root Mean Squared Error)**: $$RMSE = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2}$$ * **결정 계수 ($R^2$)**: $$R^2 = 1 - \frac{\sum_{i=1}^{n}(y_i - \hat{y}_i)^2}{\sum_{i=1}^{n}(y_i - \bar{y})^2}$$ ![](/assets/images/{[선형%20회귀%20모델이%20데이터%20분포에%20맞춰진%20그래프%20이미지]}.png) ### 1.2. K-최근접 이웃 (K-Nearest Neighbor, K-NN) K-NN은 가장 직관적인 분류 알고리즘 중 하나다. 예측하려는 데이터와 가장 가까운 $k$개의 훈련 데이터의 레이블을 보고 다수결로 분류를 결정한다. * **거리 측정**: 데이터 간의 '가까움'을 측정하기 위해 거리 척도를 사용한다. * **L1 거리 (맨해튼 거리)**: $$L_1(A, B) = \sum_{i,j}|A_{i,j} - B_{i,j}|$$ * **L2 거리 (유클리드 거리)**: $$L_2(A, B) = \sqrt{\sum_{i,j}(A_{i,j} - B_{i,j})^2}$$ * **구현 예시**: ```python import numpy as np class NearestNeighbor: def __init__(self): pass def train(self, images, labels): # simply remembers all the training data self.images = images self.labels = labels def predict(self, test_image): # assume that each image is vectorized to 1D min_dist = float('inf') min_index = -1 for i in range(self.images.shape[0]): dist = np.sum(np.abs(self.images[i, :] - test_image)) if dist < min_dist: min_dist = dist min_index = i return self.labels[min_index] ``` * **한계**: * **느린 예측 속도**: 예측 시 모든 훈련 데이터와의 거리를 계산해야 하므로 데이터가 많을수록 매우 느리다. * **차원의 저주**: 데이터의 차원이 높아질수록 데이터 간의 거리가 무의미해지고, 분류에 필요한 데이터 수가 기하급수적으로 증가한다. * **Semantic Gap**: 픽셀 값 기반의 거리는 이미지의 의미론적 유사성을 반영하지 못한다. ![](/assets/images/{[K=1,%20K=3,%20K=5일%20때의%20K-NN%20결정%20경계%20변화를%20보여주는%20이미지]}.png) ### 1.3. 선형 분류기 (Linear Classifier) K-NN의 한계를 극복하기 위해 매개변수적 접근(Parametric Approach)을 사용한다. 입력 데이터와 레이블을 매핑하는 함수 $f$를 학습하는 방식이다. * **모델**: $$f(x, W) = Wx + b$$ * $x$: 입력 이미지 픽셀을 펼친 벡터 * $W$: 가중치 행렬. 각 클래스에 대한 템플릿 역할을 한다. * $b$: 편향 벡터. * **장점**: * 학습이 완료되면 가중치 $W$만 저장하면 되므로 공간 효율성이 높다. * 예측 시 행렬-벡터 곱 연산 한 번으로 끝나므로 매우 빠르다. * **Softmax 분류기**: 선형 분류기의 점수(score)를 확률로 변환하기 위해 사용된다. 각 클래스에 속할 확률을 0과 1 사이의 값으로 정규화하며, 모든 클래스에 대한 확률의 총합은 1이 된다. $$p(y=c_i|x) = \frac{e^{s_i}}{\sum_j e^{s_j}}$$ ### 1.4. 손실 함수와 최적화 * **손실 함수 (Loss Function)**: 모델의 예측이 얼마나 틀렸는지를 정량화하는 함수다. 손실이 클수록 모델 성능이 나쁘다는 의미다. 대표적으로 **교차 엔트로피 (Cross-Entropy)** 손실이 분류 문제에 널리 쓰인다. $$\mathcal{L} = -\frac{1}{N}\sum_{i=1}^{N}\sum_{k=1}^{K}y_{ik}\log(\hat{y}_{ik})$$ * **최적화 (Optimization)**: 손실 함수를 최소화하는 가중치 $W$를 찾는 과정이다. **경사 하강법 (Gradient Descent)**이 가장 기본적이고 강력한 방법이다. 손실 함수의 기울기(gradient)를 계산하여 기울기가 낮아지는 방향으로 가중치를 점진적으로 업데이트한다. $$\Theta^{new} = \Theta^{old} - \alpha \nabla_{\Theta}J(\Theta)$$ * **확률적 경사 하강법 (SGD)**: 전체 데이터 대신 미니배치(mini-batch)를 사용하여 기울기를 근사 계산함으로써 학습 속도를 높인다. ![](/assets/images/{[손실%20함수의%20표면에서%20경사%20하강법으로%20최저점을%20찾아가는%20과정을%20시각화한%20이미지]}.png) --- ## 2. 기초 신경망 이론 선형 모델은 데이터의 복잡한 비선형 관계를 학습하는 데 한계가 있다. 신경망은 여러 개의 선형 모델을 층층이 쌓고 그 사이에 비선형 활성화 함수를 추가하여 이 문제를 해결한다. ### 2.1. 퍼셉트론과 다층 퍼셉트론 (MLP) * **퍼셉트론**: 인간의 뉴런 구조에서 영감을 받은 모델. 입력에 가중치를 곱하고 편향을 더한 뒤, 활성화 함수를 통과시켜 출력을 결정한다. $$f(\sum_i w_i x_i + b)$$ * **MLP**: 퍼셉트론으로 이루어진 층(layer)을 여러 개 쌓아 만든 구조다. 층 사이에 비선형성을 추가하기 위해 **활성화 함수(Activation Function)**를 사용한다. ![](/assets/images/{[입력층,%20은닉층,%20출력층으로%20구성된%20MLP%20구조%20다이어그램%20이미지]}.png) ### 2.2. 활성화 함수 (Activation Functions) 활성화 함수는 신경망에 비선형성을 부여하여 표현력을 높이는 핵심 요소다. * **Sigmoid**: 출력을 (0, 1) 사이로 압축한다. 과거에 많이 사용되었으나, **기울기 소실(Vanishing Gradient)** 문제와 출력이 Zero-centered가 아니라는 단점이 있다. $$\sigma(x) = \frac{1}{1 + e^{-x}}$$ * **Tanh**: 출력을 (-1, 1) 사이로 압축하며 Zero-centered 문제를 해결했지만, 기울기 소실 문제는 여전하다. * **ReLU (Rectified Linear Unit)**: 입력이 양수면 그대로, 음수면 0을 출력한다. 연산이 간단하고 수렴 속도가 빠르며, 양수 영역에서 기울기 소실 문제가 없다. 현대 신경망에서 가장 널리 사용된다. $$f(x) = \max(0, x)$$ * 단점으로는 '죽은 ReLU(Dead ReLU)' 문제가 발생할 수 있다. 이를 보완하기 위해 **Leaky ReLU**, **ELU** 등이 제안되었다. ### 2.3. 역전파 (Backpropagation) 역전파는 **연쇄 법칙(Chain Rule)**을 이용하여 출력층에서부터 입력층 방향으로 손실에 대한 각 가중치의 기울기를 효율적으로 계산하는 알고리즘이다. 계산된 기울기는 경사 하강법을 통해 가중치를 업데이트하는 데 사용된다. * **구현 예시 (2-Layer MLP)**: ```python import numpy as np from numpy.random import randn n, d, h, c = 64, 1000, 100, 10 x, y = randn(n, d), randn(n, c) w1, w2 = randn(d, h), randn(h, c) learning_rate = 1e-4 for t in range(1000): # Forward pass y_0 = x.dot(w1) h_0 = 1 / (1 + np.exp(-y_0)) y_pred = h_0.dot(w2) loss = np.square(y_pred - y).sum() print(t, loss) # Backward pass (Backpropagation) grad_y_pred = 2.0 * (y_pred - y) grad_w2 = h_0.T.dot(grad_y_pred) grad_h = grad_y_pred.dot(w2.T) grad_w1 = x.T.dot(grad_h * h_0 * (1 - h_0)) # Weight update w1 -= learning_rate * grad_w1 w2 -= learning_rate * grad_w2 ``` ![](/assets/images/{[Computational%20Graph를%20이용한%20역전파%20과정%20설명%20이미지]}.png) --- ## 3. 심화 신경망 학습 기술 신경망을 더 깊고 안정적으로 학습시키기 위한 다양한 기법들이 있다. ### 3.1. 가중치 초기화 (Weight Initialization) * 가중치를 너무 작게 초기화하면 활성화 값이 0으로 수렴하여 기울기가 소실되고, 너무 크게 초기화하면 활성화 값이 극단으로 치우쳐 기울기가 소실된다. * **Xavier 초기화**: 이전 층의 노드 수($d_{in}$)를 고려하여 가중치를 초기화함으로써 신호가 너무 작아지거나 커지지 않도록 방지한다. ```python W = np.random.randn(d_in, d_out) / np.sqrt(d_in) ``` ### 3.2. 학습률 스케줄링 (Learning Rate Scheduling) 학습 초기에는 큰 학습률로 빠르게 최적점에 다가가고, 최적점 근처에서는 작은 학습률로 미세 조정을 하기 위해 학습 과정을 조절하는 기법이다. **Step Decay**, **Cosine Annealing** 등의 방법이 있다. ![](/assets/images/{[다양한%20학습률%20스케줄링%20방법에%20따른%20학습률%20변화%20그래프%20이미지]}.png) ### 3.3. 데이터 전처리 및 증강 (Preprocessing & Augmentation) * **전처리**: 데이터를 **Zero-centering**하고 **정규화(Normalization)**하면 학습을 더 안정적으로 만들 수 있다. * **증강**: 제한된 훈련 데이터를 변형(예: 이미지 좌우 반전, 무작위 자르기, 색상 변환)하여 데이터의 양을 늘리는 효과를 냄으로써 모델의 일반화 성능을 높인다. ![](/assets/images/2025-09-20-19-23-02.png) --- ## 4. 순환 신경망 (RNN)과 시퀀스 모델 RNN은 시계열 데이터나 자연어와 같이 순서가 있는 데이터를 처리하기 위해 고안된 모델이다. 이전 타임스텝의 정보를 현재 타임스텝의 입력으로 재귀적으로 사용하는 구조를 가진다. $$h_t = f_W(h_{t-1}, x_t)$$ ### 4.1. 장기 의존성 문제 (Long-Range Dependency) * **기울기 소실/폭발**: RNN은 시퀀스가 길어질수록 역전파 과정에서 동일한 가중치 행렬이 반복적으로 곱해지면서 기울기가 0으로 수렴(소실)하거나 무한대로 발산(폭발)하는 문제가 발생한다. 이로 인해 시퀀스 초반의 정보를 제대로 학습하기 어렵다. $$\frac{\partial \mathcal{L}_t}{\partial W_{hh}} \propto W_{hh}^{t-1}$$ * **해결책**: * **기울기 클리핑 (Gradient Clipping)**: 기울기 폭발을 막기 위해 기울기 값의 임계치를 설정한다. * **LSTM / GRU**: 기울기 소실 문제를 완화하기 위해 '게이트(gate)'라는 개념을 도입했다. **Forget gate**, **Input gate**, **Output gate**를 통해 어떤 정보를 기억하고, 어떤 정보를 버릴지를 학습하여 장기 의존성을 포착하는 능력을 향상시켰다. ![](/assets/images/{[LSTM%20셀의%20내부%20구조(Forget,%20Input,%20Output%20게이트%20포함)%20이미지]}.png) ### 4.2. Seq2Seq 모델 입력 시퀀스와 출력 시퀀스의 길이가 다를 수 있는 문제(예: 기계 번역)를 해결하기 위해 **인코더-디코더** 구조를 사용한다. * **인코더**: 입력 시퀀스를 하나의 고정된 크기의 벡터, 즉 **문맥 벡터(context vector)**로 압축한다. * **디코더**: 문맥 벡터를 받아 출력 시퀀스를 하나씩 생성한다. * **구현 예시 (PyTorch)**: ```python # Encoder class EncoderLSTM(nn.Module): # ... 초기화 코드 ... def forward(self, x): embedding = self.dropout(self.embedding(x)) outputs, (hidden_state, cell_state) = self.LSTM(embedding) return hidden_state, cell_state # Decoder class DecoderLSTM(nn.Module): # ... 초기화 코드 ... def forward(self, x, hidden_state, cell_state): x = x.unsqueeze(0) embedding = self.dropout(self.embedding(x)) outputs, (hidden_state, cell_state) = self.LSTM(embedding, (hidden_state, cell_state)) predictions = self.fc(outputs) predictions = predictions.squeeze(0) return predictions, hidden_state, cell_state # Seq2Seq Model class Seq2Seq(nn.Module): # ... 초기화 코드 ... def forward(self, source, target): # ... forward pass 로직 ... hidden_state, cell_state = self.Encoder_LSTM(source) # 토큰으로 시작 x = target[0] for i in range(1, target_len): output, hidden_state, cell_state = self.Decoder_LSTM(x, hidden_state, cell_state) # ... 다음 입력(x)과 출력 저장 로직 ... return outputs ``` 하지만 문맥 벡터 하나에 모든 정보를 압축하는 것은 정보 손실을 야기하며, 이는 긴 시퀀스에서 성능 저하의 원인이 된다. --- ## 5. 트랜스포머와 어텐션 메커니즘 트랜스포머는 RNN의 순차적, 재귀적 구조를 완전히 배제하고 **어텐션(Attention)** 메커니즘만으로 시퀀스 데이터의 관계를 학습하는 획기적인 모델이다. 이 접근법은 입력 시퀀스를 한 번에 처리하여 병렬 계산을 극대화했고, 이는 학습 속도의 비약적인 향상으로 이어졌다. 또한, RNN의 고질적인 장기 의존성 문제를 해결하며 더 긴 시퀀스의 복잡한 관계를 효과적으로 포착할 수 있게 했다. ### 5.1. 어텐션 메커니즘 (Attention Mechanism) 어텐션의 핵심 아이디어는 Seq2Seq 모델의 고정된 크기 문맥 벡터가 갖는 정보 병목 현상을 해결하는 것이다. 디코더가 특정 시점의 단어를 예측할 때, 인코더의 전체 입력 시퀀스에서 가장 관련 있는 부분에 '집중(attend)'하여 해당 정보를 직접 활용한다. * **Query, Key, Value**: 어텐션 연산은 **쿼리(Query)**가 주어졌을 때, 모든 **키(Key)**와의 유사도를 계산하고, 이 유사도(어텐션 스코어)를 가중치로 삼아 **값(Value)**들의 가중합을 구하는 과정으로 요약할 수 있다. * **Query**: 현재 예측하려는 단어의 정보 (예: 디코더의 이전 은닉 상태) * **Key**: 입력 시퀀스의 각 단어 정보 (예: 인코더의 모든 은닉 상태) * **Value**: Key와 동일하게, 입력 시퀀스의 각 단어 정보 * **Scaled Dot-Product Attention**: 트랜스포머에서는 내적(dot-product)을 통해 Query와 Key의 유사도를 계산하고, 이를 Key 벡터 차원의 제곱근($\sqrt{d_k}$)으로 나누어 스케일링한다. 이 스케일링 과정은 기울기 소실을 방지하여 학습을 안정화시키는 중요한 역할을 한다. $$Attention(Q, K, V) = \text{softmax}(\frac{QK^T}{\sqrt{d_k}})V$$ ### 5.2. 트랜스포머 아키텍처 트랜스포머는 크게 인코더와 디코더, 두 부분으로 구성되며, 각각 여러 개의 동일한 블록을 쌓은 구조를 가진다. ![](/assets/images/{[트랜스포머의%20전체%20아키텍처%20다이어그램(인코더-디코더,%20멀티%20헤드%20어텐션,%20위치%20인코딩%20포함)]}.png) * **셀프 어텐션 (Self-Attention)**: 트랜스포머의 가장 혁신적인 개념. 문장 내 단어들 간의 관계를 파악하기 위해 문장 자신이 스스로에게 어텐션을 수행한다. 즉, 입력 시퀀스 내의 모든 단어가 서로에 대한 Query, Key, Value 역할을 수행하며 상호 관계를 계산한다. 이를 통해 각 단어는 문맥 속에서 자신의 의미를 동적으로 재조정하게 된다. * **멀티 헤드 어텐션 (Multi-Head Attention)**: 하나의 어텐션이 아닌, 여러 개의 어텐션을 병렬적으로 수행하여 서로 다른 관점의 관계를 학습하는 구조다. 입력 임베딩을 여러 '헤드'로 나누어 각각 독립적으로 어텐션을 계산한 뒤, 그 결과를 다시 하나로 합친다. 이를 통해 모델은 예를 들어 한 헤드에서는 문법적 관계를, 다른 헤드에서는 의미적 관계를 학습하는 등 다차원적인 정보를 포착할 수 있다. * **위치 인코딩 (Positional Encoding)**: 단어의 순서 정보를 모델에 제공하기 위해 각 단어의 위치에 대한 고유한 정보를 담은 벡터를 입력 임베딩에 더해준다. 순서 개념이 없는 트랜스포머에게 단어의 상대적, 절대적 위치 정보를 알려주는 필수적인 장치다. $$PE_{(pos, 2i)} = \sin(pos / 10000^{2i/d_{\text{model}}})$$ $$PE_{(pos, 2i+1)} = \cos(pos / 10000^{2i/d_{\text{model}}})$$ * **인코더-디코더 구조**: * **인코더 블록**: 멀티 헤드 셀프 어텐션 층과 피드 포워드 신경망(Feed-Forward Network)으로 구성되며, 각 층 이후에는 잔차 연결(Residual Connection)과 층 정규화(Layer Normalization)가 적용된다. * **디코더 블록**: 인코더 블록의 구성 요소에 더해, 인코더의 출력(Key, Value)과 디코더의 이전 출력(Query) 간의 어텐션을 수행하는 **Encoder-Decoder Attention** 층이 추가된다. 또한, 디코더의 셀프 어텐션은 현재 위치 이후의 단어들을 참고하지 못하도록 마스킹(Masking) 처리된다. ### 5.3. BERT와 ViT * **BERT (Bidirectional Encoder Representations from Transformers)**: 트랜스포머의 인코더 구조만을 사용하여 대규모 텍스트 데이터로 사전 학습한 언어 모델. **Masked Language Model (MLM)**을 통해 문장의 빈칸을 예측하는 과정에서 문맥을 양방향으로 깊게 이해하는 능력을 학습한다. 입력은 **Token, Segment, Position Embedding** 세 가지의 합으로 구성된다. * **ViT (Vision Transformer)**: 이미지를 여러 개의 고정된 크기 패치(patch)로 나누고, 이 패치들의 시퀀스를 트랜스포머의 입력으로 사용하여 이미지 분류를 수행하는 모델. CNN의 공간적 inductive bias(지역성 등) 없이, 대규모 데이터로부터 직접 이미지 내의 전역적인 관계를 학습하는 능력을 보여주었다. --- ## 결론 이번 일주일간의 학습은 선형 모델이라는 단순한 아이디어에서 출발하여, 어떻게 비선형성, 순차적 정보, 그리고 단어 간의 복잡한 관계를 모델링하는 방향으로 발전해왔는지를 명확히 보여주었다. 특히 RNN의 한계를 극복하기 위한 어텐션을 사용하는 방법을 알게되었고, 트랜스포머가 현재 AI 분야의 핵심 아키텍처로 자리잡은걸 알게됐다. 아직은 이론적인 이해에 머물러 있지만, 이 개념들을 코드로 직접 구현하고 실험하며 더 깊은 이해에 도달해야겠다. ## 2. 과제 결과물 정리 ### 과제 1: Numpy로 구현한 선형 회귀 (Linear Regression) 첫 번째 과제는 Numpy를 이용해 대기오염 데이터셋의 PM10 농도로 PM2.5 농도를 예측하는 선형 회귀 모델을 만드는 것이었다. ### 핵심 구현 내용 및 코드 모델의 핵심은 **정규방정식(Normal Equation)**을 사용하여 최적의 가중치(weights)와 편향(bias)을 한 번에 계산하는 것이었다. ```python # 정규방정식을 이용한 가중치 계산 self.weights = np.linalg.pinv(X.T @ X) @ X.T @ y ``` 행렬 연산으로 한 번에 처리하기 위한 트릭이었다. 편향 b를 가중치 벡터 W에 포함시키기 위해, 모든 데이터 샘플에 항상 1의 값을 가지는 가상의 특성(x_0)을 추가했다. 이렇게 하면 수식은 y=W′X′ 형태로 단순화된다. 이 과정은 `np.hstack`를 통해 구현했다. ```python # 모든 샘플에 bias 항을 위한 특성 '1'을 추가 X = np.hstack((np.ones((X.shape[0], 1)), X)) ``` 이렇게 계산된 가중치 벡터의 첫 번째 값 weights[0]이 바로 편향(bias)이 되고, 나머지가 실제 특성에 대한 가중치 weights[1:]가 된다. ### 느낀점 및 알게된 점 **편향(bias)의 의미**: 이론으로만 배우던 편향(y절편)을 왜 가중치 행렬에 포함시켜 계산하는지, 그리고 이를 위해 왜 모든 입력 데이터에 '1'을 추가하는지 그 트릭을 코드로 직접 구현하며 명확히 이해하게 됐다. 이는 단순히 계산의 편의성을 넘어, 모델이 데이터를 더 유연하게 표현할 수 있도록 하는 중요한 장치임을 깨달았다. **데이터 전처리의 중요성**: dropna()를 이용해 결측치가 있는 행을 제거하고, train_test_split 함수를 직접 구현하며 데이터를 훈련용과 테스트용으로 나누는 과정의 중요성을 다시 한번 느꼈다. 모델의 성능은 결국 데이터의 질에 달려있다는 것을 알게됐다. ### 과제 2: Numpy로 구현한 역전파 (Backpropagation) 두 번째 과제는 MNIST 손글씨 데이터셋을 분류하는 2-Layer 신경망을 Numpy만으로 구현하는 것이었다. 순전파(Forward Propagation)와 역전파(Backpropagation)를 직접 코딩해야 했다. ### 핵심 구현 내용 및 코드 모델의 구조는 다음과 같은 수식으로 표현된다. $$\hat{Y}=softmax(σ(X⋅W1​+b1​)⋅W2​+b2​)$$ 가중치 초기화는 Xavier 초기화 방법을 사용했다. 이는 각 층의 입출력 뉴런 수에 맞춰 가중치의 초기 분산을 조절하여, 학습 과정에서 발생할 수 있는 기울기 소실(vanishing gradient)이나 폭주(exploding gradient) 문제를 완화하기 위함이다. 균등분포를 사용할 경우, 초기화 범위는 다음과 같이 설정된다. $$limit=\frac{6}{n_{in​}+n_{out​}}​​$$ ```python # Xavier 초기화를 사용한 가중치 행렬 생성 W1 = np.random.uniform( low=-np.sqrt(6 / (input_dim + num_hiddens)), high=np.sqrt(6 / (input_dim + num_hiddens)), size=(input_dim, num_hiddens) ) ``` 역전파 과정에서는 출력층에서부터 입력층 방향으로 손실 함수의 기울기를 **연쇄 법칙(Chain Rule)**에 따라 계산해 나갔다. 예를 들어, 출력층의 가중치 W_2에 대한 기울기는 다음과 같이 구했다. ```python # 역전파 구현 dl_dz2 = (ff_dict['y'] - Y) / X.shape[0] # Softmax와 Cross-Entropy 손실의 미분 dl_dW2 = ff_dict['a1'].T @ dl_dz2 dl_db2 = np.sum(dl_dz2, axis=0) ``` ### 느낀점 및 알게된 점 **하이퍼파라미터**: 처음에는 학습률(learning rate)을 0.00001로 매우 작게 설정했더니 학습이 거의 진행되지 않았다. 이를 0.01로 높이자 손실이 눈에 띄게 감소하며 학습이 원활히 진행되는 것을 보고 하이퍼파라미터 튜닝의 중요성을 체감했다. **활성화 함수**: 처음에는 활성화 함수로 Sigmoid를 사용했는데, 최종 테스트 정확도가 약 91.5%에 그쳤다. 이후 ReLU로 바꾸어 다시 학습시켜보니, 학습 속도가 더 빨라지고 최종 정확도도 95.2%까지 향상됐다. 이는 Sigmoid 함수가 특정 구간에서 기울기가 0에 가까워져 발생하는 기울기 소실 문제 때문임을 이론과 실제 결과를 통해 명확히 알게 됐다. **오버플로우 방지**: Softmax 함수를 구현할 때, 지수 함수 np.exp()의 특성상 입력값이 조금만 커져도 오버플로우가 발생할 수 있다. 이를 방지하기 위해 입력 벡터의 최댓값을 각 원소에서 빼주는 기법을 사용했다. 이런 작은 트릭 하나가 코드의 안정성을 크게 좌우한다는 것을 배웠다. ### 과제 3: 멀티 헤드 셀프 어텐션 구현 (Multi-head Self-Attention) 핵심 구현 내용 및 코드 어텐션의 기본 수식은 다음과 같다. $$Attention(Q,K,V)=softmax(\frac{Q\cdot K^T}{d_k​​}​)V$$ 멀티 헤드 어텐션은 hidden_size를 num_heads 개수만큼으로 쪼개어 여러 개의 어텐션을 병렬로 수행하는 방식이다. 이를 위해 tp_attn (Transpose for Attention)이라는 함수를 통해 텐서의 차원을 재배열하는 과정이 필수적이었다. 예를 들어, [batch_size, seq_len, hidden_size] 형태의 텐서를 [batch_size, num_heads, seq_len, attn_head_size] 형태로 바꾸어 각 헤드가 독립적으로 어텐션 계산을 수행할 수 있도록 했다. ```python # 텐서의 차원을 어텐션 계산에 맞게 재배열하는 함수 def tp_attn(self, x): # (batch, seq_len, hidden_size) -> (batch, seq_len, num_heads, attn_head_size) x_shape = x.size()[:-1] + (self.num_heads, self.attn_head_size) x = x.view(*x_shape) # -> (batch, num_heads, seq_len, attn_head_size) return x.permute(0, 2, 1, 3) ``` 이후 각 헤드별로 계산된 어텐션 결과를 다시 합치고 nn.Linear 층을 통과시켜 최종 출력을 얻는다. ### 느낀점 및 알게된 점 **텐서 차원 조작의 중요성**: 멀티 헤드 어텐션의 핵심은 텐서의 view와 permute를 이용한 차원 변환에 있다는 것을 깨달았다. hidden_size를 여러 개의 attn_head_size로 나누어 병렬 처리함으로써, 모델이 입력 시퀀스의 다양한 부분 공간(subspace)에서 정보를 동시에 학습할 수 있게 된다는 개념을 코드를 통해 직관적으로 이해할 수 있었다. **수식과 코드의 연결**: Q, K, T 계산을 위해 `torch.matmul(Q_layer, K_layer.transpose(-1, -2)) `코드를 작성하며, 행렬 곱셈을 위해 키(K) 텐서의 마지막 두 차원을 전치(transpose)해야 하는 이유를 명확히 알게 됐다. 수식으로만 보던 개념이 실제 코드에서 어떻게 구현되는지 알 수 있었다. ## 3. 소감 내 포트폴리오를 정리하고, 내가 공부한 내용들을 정리할 블로그 하나 갖고 싶었다. 드디어 깃허브에 나만의 블로그를 만들어 정착한것 같아 기분이 좋다. 이번주에 풀이한 알고리즘 문제들과 과제풀이들도 포스팅해 올렸고, 앞으로도 올릴 예정이다. 다만 이번주는 블로그에 내용정리하느라 시간을 너무 많이써서 복습에 소홀했다. 앞으로는 복습을 먼저 우선적으로 하고 정리를 해야겠다. Transformer를 공부하며 ViT에 대해 궁금한점이 많아졌다. 이미지를 Sequence Data로 이용해서 기존의 CNN모델을 제치고 어떻게 SOTA를 달성했는지 궁금하다. 이번 주말에는 이번주에 배운내용을 복습하며 ViT논문을 공부해야겠다. 요즘 이런저런 이걸 해볼까, 이건 어떨까 고민, 생각만 깊게하고 뭔가 제대로 이뤄낸건 없는 것 같다. 일단 완벽하진 않더라도 시작부터 하고, 틀린게 있으면 그때부터 고쳐나가면 좀 더 발전하지 않을까 싶다. ### Week2_AIMath_학습회고 - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-09-16-AIMath-Week2/ - Collection: WeeklyReview - Published: 2025-09-16 20:00:00 +0900 - Tags: 선형대수, 확률론, 통계학, 경사하강법 ## 목차 1. 선형대수: 벡터, 행렬, 텐서 - 벡터의 정의와 연산 - 벡터의 노름(Norm)과 내적(Inner Product) - 행렬의 정의와 연산 - 역행렬과 행렬식 - 고유값 분해와 특이값 분해(SVD) - 텐서(Tensor) 2. 확률론과 통계학 - 확률분포의 이해 - 조건부 확률과 베이즈 정리 - 최대가능도 추정법 (MLE) - 딥러닝과 통계학의 연결점 3. 경사하강법 - 미분과 경사하강법의 원리 - 확률적 경사하강법 (SGD) --- ## 1. 선형대수: 벡터, 행렬, 텐서 ### 벡터의 정의와 연산 벡터는 숫자를 원소로 가지는 배열로 정의하며, 공간에서의 한 점 또는 원점으로부터의 상대적 위치로 표현한다. 벡터의 스칼라곱은 벡터의 방향은 유지한 채 길이만을 변경하는 연산이다. 곱하는 스칼라 값이 음수일 경우 방향이 반대가 된다. 차원이 같은 두 벡터는 덧셈, 뺄셈, 성분곱(Hadamard product)이 가능하다. 벡터의 덧셈은 한 벡터의 끝에서 다른 벡터의 상대적 위치 이동으로 시각화할 수 있다. ### 벡터의 노름(Norm)과 내적(Inner Product) 노름(Norm)은 원점으로부터 벡터까지의 거리를 의미하며, 벡터의 크기를 나타낸다. L1 노름은 각 성분의 절댓값의 합으로 계산된다: \\(||x||_{1}=\sum_{i=1}^{d}|x_{i}|\\). L2 노름은 유클리드 거리로, 각 성분의 제곱 합의 제곱근으로 계산된다: \\(||x||_{2}=\sqrt{\sum_{i=1}^{d}|x_{i}|^{2}}\\). 내적(Inner product)은 두 벡터의 유사도를 측정하는 데 사용되며, 정사영(orthogonal projection)된 벡터의 길이와 관련이 있다. 내적은 제2 코사인 법칙을 통해 두 벡터 사이의 각도를 계산하는 데 활용한다. $$\langle x, y \rangle = ||x||_2 ||y||_2 \cos\theta$$ ### 행렬의 정의와 연산 행렬은 벡터를 원소로 가지는 2차원 배열로, 공간상의 여러 점들을 나타낸다. 전치행렬(Transpose matrix)은 원래 행렬의 행과 열 인덱스를 바꾼 행렬을 의미한다: \\(X^{\top}=(x_{ij})^{\top}=(x_{ji})\\). 행렬 곱셈은 \\(i\\)번째 행벡터와 \\(j\\)번째 열벡터 사이의 내적을 성분으로 가지는 새로운 행렬을 계산하는 연산이다. 행렬 곱셈이 성립하려면 앞 행렬의 열의 개수와 뒤 행렬의 행의 개수가 같아야 한다. $$(XY)_{ij} = \sum_{k}X_{ik}Y_{kj}$$ ### 역행렬과 행렬식 역행렬(Inverse matrix)은 어떤 행렬 A의 연산을 거꾸로 되돌리는 행렬로, \\(A^{-1}\\)로 표기한다. 행렬과 그 역행렬의 곱은 항등행렬(\\(I\\))이 된다: \\(AA^{-1}=A^{-1}A=I\\). 역행렬은 행과 열의 수가 같은 정사각행렬이면서 행렬식(determinant)이 0이 아닐 때만 존재한다. 행렬식의 절댓값은 행렬을 구성하는 벡터들이 만드는 다포체(polytope)의 부피(2차원에서는 넓이)와 같다. 행렬을 구성하는 벡터들이 선형 종속(평행하거나, 다른 벡터의 선형 결합으로 표현 가능)일 경우 다포체를 만들 수 없으므로 행렬식은 0이 되고, 역행렬은 존재하지 않는다. ### 고유값 분해와 특이값 분해(SVD) 고유값(Eigenvalue)과 고유벡터(Eigenvector)는 정사각행렬 \\(A\\)에 대해 다음 식을 만족하는 스칼라 \\(\lambda\\)와 벡터 \\(v\\)를 의미한다. $$Av = \lambda v$$ 이는 고유벡터 \\(v\\)에 행렬 \\(A\\)를 곱해 선형 변환을 해도 방향은 변하지 않고 크기만 \\(\lambda\\)배만큼 변한다는 것을 의미한다. 고유값 분해(Eigenvalue Decomposition)는 행렬 \\(A\\)를 고유벡터로 이루어진 행렬 \\(V\\)와 고유값으로 이루어진 대각 행렬 \\(\Lambda\\)의 곱으로 분해하는 것이다: \\(A = V\Lambda V^{-1}\\). 이는 데이터의 공분산 행렬에서 주성분(Principal Component)을 찾는 주성분 분석(PCA)의 핵심 원리이다. 특이값 분해(Singular Value Decomposition, SVD)는 정사각행렬이 아닌 일반적인 행렬에 대해서도 적용할 수 있는 분해 방법이다. $$A_{n\times m} = U_{n\times n}\Sigma_{n\times m}V^{\top}_{m\times m}$$ SVD는 유사역행렬(Moore-Penrose pseudo-inverse)을 계산하는 데 사용되어, 역행렬이 존재하지 않는 경우에도 선형회귀 문제의 해를 근사적으로 구할 수 있게 해준다. ### 텐서(Tensor) N차원 텐서는 N-1차원 텐서를 원소로 가지는 다차원 배열이다. 벡터는 1차원 텐서, 행렬은 2차원 텐서로 볼 수 있다. 컬러 영상 데이터는 (채널, 높이, 너비)의 3차원 텐서로, 여러 영상 데이터의 묶음(미니배치)은 (배치 크기, 채널, 높이, 너비)의 4차원 텐서로 표현된다. --- ## 2. 확률론과 통계학 ### 확률분포의 이해 통계적 모델링은 적절한 가정 위에서 데이터의 확률분포를 추정하는 기법이다. 모수적(parametric) 방법론은 데이터가 특정 확률분포(정규분포, 베르누이 분포 등)를 따른다고 가정한 후, 그 분포의 모수(parameter)를 추정하는 방식이다. 비모수적(nonparametric) 방법론은 특정 분포를 가정하지 않고, 데이터에 따라 모델의 구조와 모수의 개수가 유연하게 바뀌는 방식이다. 결합분포 \\(P(x,y)\\)는 입력 \\(x\\)와 출력 \\(y\\)가 함께 나타날 확률로, 데이터 전체의 분포 \\(P_{data}\\)를 모델링한다. 주변분포 \\(P(x)\\)는 \\(y\\)에 대한 정보를 없애고 \\(x\\)에 대한 확률분포만 남긴 것으로, 결합분포를 \\(y\\)에 대해 합하거나 적분하여 구한다: \\(P(x) = \sum_{y}P(x,y)\\). ### 조건부 확률과 베이즈 정리 조건부 확률 \\(P(x|y)\\)는 특정 클래스 \\(y\\)가 주어졌을 때 데이터 \\(x\\)의 분포를 나타내며, 입력과 출력 사이의 관계를 모델링한다. 베이즈 정리는 조건부 확률을 이용해 새로운 정보가 주어졌을 때 기존의 확률을 업데이트하는 방법을 제공한다. $$P(\theta|\mathcal{D}) = P(\theta)\frac{P(\mathcal{D}|\theta)}{P(\mathcal{D})}$$ - \\(P(\theta)\\) : 사전 확률(Prior) - 정보를 얻기 전의 확률. - \\(P(\mathcal{D}|\theta)\\) : 가능도(Likelihood) - 가설 \\(\theta\\)가 주어졌을 때 데이터 \\(\mathcal{D}\\)가 관찰될 확률. - \\(P(\mathcal{D})\\) : 증거(Evidence) - 데이터 \\(\mathcal{D}\\)의 주변 확률. - \\(P(\theta|\mathcal{D})\\) : 사후 확률(Posterior) - 데이터를 관찰한 후 업데이트된 확률. ### 최대가능도 추정법 (MLE) 최대가능도 추정법(MLE)은 관측된 데이터 집합이 나타날 가능성을 최대로 만드는 모수 \\(\theta\\)를 찾는 방법이다. $$\hat{\theta}_{MLE} = \underset{\theta}{\mathrm{argmax}} L(\theta;x) = \underset{\theta}{\mathrm{argmax}} P(x|\theta)$$ 데이터가 독립적으로 추출되었다고 가정하면, 가능도는 각 데이터 포인트의 확률의 곱으로 나타난다. 로그 함수는 단조 증가 함수이므로, 가능도를 직접 최대화하는 대신 로그가능도를 최대화해도 동일한 최적해를 얻을 수 있다. 이는 곱셈을 덧셈으로 바꿔주어 연산을 간편하게 하고 컴퓨터의 언더플로우 문제를 방지한다. $$\log L(\theta;X) = \sum_{i=1}^{n}\log P(x_{i}|\theta)$$ 정규분포의 모수를 MLE로 추정하면, 그 결과는 표본평균과 표본분산이 된다. 카테고리 분포의 모수를 MLE로 추정할 때는 라그랑주 승수법을 이용하여 제약식(\\(\sum p_k = 1\\))을 만족시키며, 그 결과는 각 카테고리가 관측된 횟수의 비율이 된다. ### 딥러닝과 통계학의 연결점 기계학습의 손실 함수(loss function)들은 통계학적 원리로부터 유도된다. 평균제곱오차(MSE)는 예측 오차의 분산을 최소화하는 방향으로 학습을 유도한다. $$l(f(x_i), y_i) = ||f(x_i) - y_i||^2$$ 교차 엔트로피(Cross-Entropy)는 분류 문제에서 모델 예측의 로그가능도를 최대화하는 것과 동일하며, 이는 정답 분포 P와 모델 예측 분포 Q 사이의 쿨백-라이블러 발산(KL Divergence)을 최소화하는 것과 같다. $$KL(P||Q) = -\mathbb{E}_{X \sim P(x)}[\log Q(x)] + \mathbb{E}_{X \sim P(x)}[\log P(x)]$$ --- ## 3. 경사하강법 ### 미분과 경사하강법의 원리 미분은 변수의 움직임에 따른 함수 값의 변화율, 즉 특정 지점에서의 접선의 기울기를 측정하는 도구이다. 함수의 특정 지점에서 미분값을 알면, 함수 값을 증가시키거나 감소시키기 위해 변수를 어느 방향으로 움직여야 할지 알 수 있다. 함수 값을 감소시키려면 미분값을 빼야 한다. 그래디언트(Gradient) 벡터 \\(\nabla f\\)는 각 변수에 대한 편미분을 원소로 가지는 벡터로, 함수 값이 가장 빠르게 증가하는 방향을 가리킨다. 경사하강법은 손실 함수의 값을 최소화하기 위해, 현재 파라미터 위치에서 계산된 그래디언트의 반대 방향으로 파라미터를 반복적으로 업데이트하는 최적화 알고리즘이다. ```python '''경사하강법 알고리즘 의사코드''' var = init grad = gradient(var) while (norm(grad) > eps): var = var - lr * grad grad = gradient(var) ``` 선형 회귀의 목적식 \(L = ||y-X\beta||2^2\) 을 최소화하기 위한 그래디언트는 다음과 같이 유도된다. $$\nabla{\beta}||y-X\beta||_{2}^{2} = -\frac{2}{n}X^{\top}(y-X\beta)$$ ### 확률적 경사하강법 (SGD) 경사하강법은 그래디언트를 계산할 때 전체 데이터를 모두 사용하는 반면, 확률적 경사하강법(SGD)은 데이터의 일부, 즉 미니배치(mini-batch)를 무작위로 추출하여 그래디언트를 근사적으로 계산한다. SGD는 전체 데이터를 사용하는 것보다 연산량이 훨씬 적어 대규모 데이터셋에 효율적이다. 미니배치를 무작위로 선택하기 때문에 목적 함수의 모양이 매 스텝마다 조금씩 바뀌게 되어, 결과가 랜덤성을 가진다. 이러한 노이즈(noise)는 오히려 non-convex 함수에서 지역 최솟값(local minima)을 탈출하는 데 도움을 줄 수 있어, 딥러닝 모델 최적화에 더 효과적이다. ## 2. 피어세션 정리 지게차와 크레인, 석유시추, 퍼즐게임, 충돌위험 찾기, 택배배달과 수거하기 문제를 풀었다. 대부분 lv2 중상정도 난이도라 무탈하게 푼것같다. 그리고 금요일에 Attention is All you need라는 논문을 주제로 발표를 진행했다. 블로그에 내용정리한 글을 따로 업로드할 예정이다. ## 3. 소감 네이버블로그는 마크다운을 지원하지 않아서 수식하나 작성하는데 너무 오래걸리고 힘들다.. inline함수도 노션은 컨트롤e누르면 바로 바뀌는데, 네이버블로그는 보통불편한게 아닌거같다.. velog나 티스토리로 옮겨야겠다. 저번주보단 나름 익숙해진 한주였다. 과제도 미리미리 했고, 강의도 밀리지 않고 들었다. 그런데, SVD, PCA, SGD를 이용한 선형회귀에서 라그랑주승수법이나, 고유벡터, Rank개념같이 모르는 개념이 많이나와서 이해하기 어려웠다. 원서를 찾아보면서 이해해보록 해야겠다. Attention is all you need논문은 처음에는 막막했는데, 막상 이해해보려고 하니깐 여기저기 찾아볼수록 겹치는 내용들이 많아서 어느정도 이해한것 같다. Attention을 기반으로한 ViT논문도 읽어보면서 Diffusion을 기반으로한 이미지 generation model도 이해해보고 싶다. ### Week1_Pytorch_학습회고 - Canonical URL: https://hyejunl33.github.io/weeklyreview/2025-09-15-Pytorch-Week1/ - Collection: WeeklyReview - Published: 2025-09-15 - Tags: PyTorch, Deep-Learning # 1. 강의 복습 ## PyTorch와 Tensor ◦ PyTorch는 딥러닝 모델 구현과 실행을 위한 프로그래밍 인터페이스다. ◦ Tensor는 PyTorch의 핵심 데이터 구조로, 스칼라(0차원)부터 다차원 배열까지 데이터를 표현한다. ◦ Tensor는 다양한 데이터 타입(정수형, 실수형 등)을 가지며, 타입 캐스팅으로 변환할 수 있다. ◦ Tensor의 기초 함수로는 최소/최대값, 합계, 평균 등을 계산하며, 메서드로 차원 수, 크기, 요소 개수 등을 확인할 수 있다. ## Tensor 연산 및 조작 ◦ **Tensor 생성**: 특정 값, 난수, 리스트/Numpy 데이터 등으로 Tensor를 만들 수 있다. ◦ **Tensor 모양 변경**: `view()`, `flatten()`, `reshape()`, `transpose()`, `squeeze()`, `unsqueeze()`, `stack()`, `cat()` 함수 등으로 Tensor의 모양이나 차원을 변경하고 연결할 수 있다. ◦ **Tensor 연산**: 요소별 산술 연산, 비교 연산, 논리 연산을 지원한다. ◦ **노름(Norm)**: 1-D Tensor(Vector)가 원점에서 얼마나 떨어져 있는지 나타내는 값으로, L1, L2, L∞ 노름 등이 존재한다. ◦ **유사도(Similarity)**: 두 1-D Tensor(Vector)가 얼마나 유사한지 측정하는 값으로, 맨해튼, 유클리드, 코사인 유사도 등이 있다. ◦ **행렬 곱셈**: 2차원 Tensor(Matrix) 간의 곱셈으로, 두 행렬을 결합하여 새로운 행렬을 생성하는 연산이며, 신경망 구현의 핵심 연산이다. ◦ **CUDA Tensor**: GPU를 사용하여 Tensor 연산을 수행하여 속도 및 효율성을 높일 수 있음. ## 선형 회귀 모델(Linear Regression) ◦ 선형 회귀는 주어진 데이터를 통해 특징 변수와 목표 변수 사이의 선형 관계를 분석하고, 이를 바탕으로 모델을 학습시켜 새로운 데이터의 결과를 연속적인 숫자 값으로 예측하는 과정이다. ◦ 상관 관계 분석을 통해 두 변수 간의 선형 관계를 파악한다. ◦ 학습은 `y = wx + b` 식에서 최적의 가중치(w)와 바이어스(b)를 찾는 과정이다. ◦ `nn.Module`을 상속받아 PyTorch에서 선형 회귀 모델을 구축한다. ◦ 손실 함수는 목표 변수와 예측 변수 간의 차이를 측정하며, 모델을 최적화하기 위해 사용한다. 선형 회귀에서는 주로 평균 제곱 오차(MSE)를 사용한다. ◦ 경사하강법은 머신러닝의 최적화 알고리즘 중 하나로, 주어진 손실 함수에서 모델의 가중치와 바이어스의 최적의 값을 찾기 위해 사용한다. 학습률은 모델이 학습할 때 가중치가 업데이트되는 크기를 결정한다. ◦ 확률적 경사하강법(SGD)은 각 데이터 포인트마다 오차를 계산하여 가중치와 바이어스를 업데이트하는 최적화 알고리즘으로, 대규모 데이터셋의 계산 비용 및 로컬 미니마 문제를 보완할 수 있다. ◦ 에폭은 모델이 전체 데이터셋을 한 번 완전히 학습하는 과정을 의미하며, 너무 많으면 과적합이 발생할 수 있다. ◦ 데이터 표준화는 특징 변수와 목표 변수의 평균을 0, 분산을 1로 맞추어 손실 값 문제를 해결하고 학습 효율을 높이는 방법이다. ## 이진 분류 모델(Binary Classification) ◦ 이진 분류는 주어진 데이터를 학습하여 새로운 데이터를 사전에 정의된 두 가지 범주 중 하나로 분류하는 예측 모델을 구축하는 과정이다. (예: 붓꽃 분류, 스팸 메일 분류, 금융 사기 탐지, 의료 진단). ◦ 로지스틱 회귀는 이진 분류의 대표적인 알고리즘으로, 트레이닝 데이터의 특성과 분포를 바탕으로 최적의 결정 경계를 찾아 시그모이드 함수를 통해 데이터를 이진 분류한다. ◦ 이진 교차 엔트로피(BCE)는 이진 분류 문제에서 모델의 예측 변수와 목표 변수 간의 차이를 측정하기 위해 사용되는 손실 함수이다. ◦ `Dataset` & `DataLoader`는 PyTorch에서 데이터의 전처리 및 배치 처리를 용이하게 할 수 있도록 사용하는 클래스다. ◦ 미니배치 경사하강법은 경사하강법과 확률적 경사하강법의 장단점을 보완한 알고리즘이다. ◦ 모델 테스트는 트레이닝 데이터에 포함되지 않은 새로운 데이터를 사전에 정의된 두 가지 범주 중 하나로 분류하는 모델을 구축하는 과정이다. 테스트 데이터를 입력받아 예측된 결과를 반환하고, 예측값과 실제 라벨을 출력 및 시각화하여 성능을 평가한다. # 2. 피어세션 정리 1주차 피어세션때는 오전시간에 푼 프로그래머스 문제 코드를 서로에게 설명해주는 시간을 가졌다. 문제풀이 시간 후에 `itertools` 라이브러리에 있는 `Combinations` 함수나, DFS/BFS 알고리즘, `Collections`에 있는 각종 dict 등 python에서 알고리즘 문제풀이에 사용하는 알고리즘을 슬랙 캔버스에 함께 정리하는 시간을 가졌다. 여름방학 내내 코테준비하며 알고리즘공부를 나름 열심히 해왔지만, 부캠 코테를 붙고나서 알고리즘 공부를 아예 안하다가 문제를 풀려니깐, 벽이 느껴졌던것 같다. 이번주까지만 알고리즘공부를 피어세션시간에 하고 다음주부터는 논문 하나씩을 발표할 예정인데, 잘할 수 있을까..? > *Attention is all you need* NLP 관련 논문이긴 하지만, 프리코스를 들을때, Attention을 이용한 Transformer의 전후로 번역기가 달라진다는 얘기를 듣고 궁금해진 논문이다. 프리코스를 들으며 전반적인 내용을 이해하고 있긴 하지만, Code를 뜯어보며 이해해보진 않아서, 다음주, 다다음주 피어세션때 논문발표를 준비하며 코드를 뜯어보며 이해해볼 예정이다. # 3. 과제수행/과제 결과물에 대한 정리 과제1은 전반적으로 PyTorch를 조작하고, 생성하는 기본적인 과제였고, 과제 2, 3은 `nn.Module`을 이용해서 학습하는 코드를 작성하는 과제였다. 프로그래머스 레벨0문제를 풀때 빈칸에 코드를 넣는식으로 푸는 문제랑 비슷한 느낌인데, 내가 잘 모르는 PyTorch 툴들을 이용해야되니까 낯설긴 했다. 알고리즘문제를 풀때는 기껏해야 2차원 리스트정도만 다뤘는데, 텐서로 데이터를 다룰려니까, `View()`나 `reshape()`, `flatten()`같이 차원을 바꿔줘야 되는 경우도 생기고, `Linear(a,b)` 함수처럼 a차원으로 입력을 받고 b차원으로 출력을 뱉을때 입력의 배치사이즈를 고려해야하고, 출력하는 차원도 어떤차원인지 생각을 해보고 코드를 작성해야 하는것을 알게되었다. 특히 과제를 하며 데이터셋의 차원을 못맞춰서 에러뜨는경우가 여러번 있어서 차원을 맞추는 메소드나 함수를 복습하고 익혀야겠다. # 4. 학습회고 외국여행을 온 것같은 한주였다. 내가 하고 싶은게 있어도 버벅거리고, 왜이렇게 되는지 명확하게 이해가 가지 않는것들이 많았던것 같다. 머신러닝을 하는데 마치 언어처럼 다룰 수 있어야 하는게 PyTorch니깐 익숙해지도록 복습을 해봐야겠다. ## ETC ### WRTN에 인턴으로 합류하기까지. - Canonical URL: https://hyejunl33.github.io/etc/2026-05-04-Start-of-2026/ - Collection: ETC - Published: 2026-05-04 - Tags: etc, 드디어 나도 ai 엔지니어? # WRTN에 인턴으로 합류하기까지. ### 부스트캠프 끝 그리고 인턴지원 시작 부스트캠프를 2026년 2월 둘째주쯤 끝마치고 본격적으로 인턴 지원을 시작했다. 부캠 연계기업들은 대부분 정규직이나 계약직을 뽑았어서 적어도 학사 이상의 학력을 요구했다. 그런데 나는 구직당시 휴학생이므로, 체험형인턴자리를 알아볼 수 밖에 없었다. 약 17개의 기업을 지원했고, 서류합격은 3개의 기업, 그리고 과제전형은 모두 통과했지만, 최종면접까지 합격한 회사는 뤼튼이어서 선택의 여지없이 합류했다. ![](/assets/images/20260505095420.png) ### 이젠 뭐하지? 네이버 부스트캠프를 하면서, 대학교에서는 배울 기회가 없었던 과목들을 배워서 너무 재밌었던 시기였다. ML을 위한 변분추론, Finetuning, 그리고 프로젝트 주제에 맞는 Modeling, Hyper Parameter tuning, Loss function 셀렉팅까지, 문제를 정의하고, 해당 문제를 해결하기 위해 서치하고, 탑다운으로 공부하는 시간들이 재밌었다. 그런데 하면할수록 워낙 대단한 사람들이 많아서, 잘해야겠다는 마음가짐으로 밤도새고, 압박감을 가지면서 살다보니 내가 이 업계에서 무슨 기여를 할 수 있을까 회의감도 많이 들었고, 처음에 시작할때와 같은 마음가짐을 중간에 잃어버리게 됐다. 신입 채용공고는 줄어들고, JD의 지원요건은 어려워지는 상황에서 내가 할 수 있는게 없어보였다. Object Detection 프로젝트, Semantic Segmentation 프로젝트, 그리고 최종프로젝트까지 그 과정을 돌아보면 분명 다른팀원들과 협업하는 방법, 그리고 프로젝트 전반을 빌드하는 능력은 성장하긴 했지만(end-to-end로 프로젝트를 해본 경험이 과제전형에 많은도움이 됐다), 잘할려고만 해서 갈려들어갔었던것 같고, 그 때문에 지쳐서 더이상 아무것도 하고싶지 않은 상태가 지속됐었다. 그래도 일단 할 수 있는것들은 모두 해봐야겠다 생각했고, 마음속 깊숙한곳에서는 여전히 이 업계에 남아서 일하고싶다는 마음이 남아있었다. 그래서 예정대로 복학신청은 하되, 인턴지원공고를 찾아보고 내가 지원할 수 있는 기업들을 찾아 지원했다. ### 서류전형 회사의 JD에 맞춰서 나의 프로젝트를 재분배하기, 그리고 필요한 역량만 담기, 문제정의, 해결방안의 구조가 잘보이게 작성하기등 이력서와 포트폴리오는 알려진 방식대로 작성했다. 내 나름대로 프로젝트를 열심히 참여하면서 배웠던것들, 문제정의를 하고 문제를 해결한 경험들을 담아서 자신은 있었고, 어떤내용들을 담아아햘지도 감이 잡혔었다. 그런데, 예상은 했지만 서류전형에서 대부분의 기업에서 떨어졌고, 최종 전화면접까지 갔었던, 과제를 나름 잘해서 붙을거라고 생각했던곳에서도 떨어지면서 학교복학전에 인턴취업은 멀어지게됐다. 학교를 다니면서 지난반년동안 그냥 시간낭비만 한게 아닌가, 남는게 뭐가있지, 그리고 앞으로는 진로를 어떻게 잡고 살아야할지를 고민하는 시간을 가졌었다. ### 과제전형 [과제 Github 링크](https://github.com/hyejunl33/wrtn_internal_agent_intern) ![](/assets/images/20260505095516.png) 뤼튼의 과제전형은 RAG Agent를 빌드해서 KMMLU dataset 법률문제를 해결하는 Task였다. lbox에서 구축된 법령데이터셋이 존재해서 청킹후 Faiss로 인덱스기반 Dense Search를 구현했다. 그런데 Dense Search시에 의미상은 비슷한 법령이 Retrieval되지만, 실제로는 적용할 수 없는 경우들이 많았다. 예를들어서 CCTV관련 법령이라면, CCTV와 의미상으로 비슷한 불법촬영물 관련 법령이라던지, 단어단위에서는 전혀 다른 맥락을 가지지만, Vector Space상에서는 비슷한 의미를 갖는 법령들이 Retrieval되는 경우가 존재했다. 이러한 경우들에는 올바르게 Retrieval되지 않는 경우이므로 Context로 법령을 제공해도, 문제해결에 도움이 되지않는 경우여서 명백한 Error Case였다. 이를 해결하기 위해 HyBrid Search방법을 도입했다. 단어기반으로 Search하는 BM25와 Vector Search를 Weigthed RRF를 이용해서 0.6:0.4 가중치로 섞는 Hybrid Search방법을 도입했고, 올바른 법령 Retrieval, 정확도향상으로 이어졌다. 모델제한(`gpt-4o-mini`)으로 Reranking은 적용하지 못했고, 10분 Inference 시간제한으로, HyDE는 적용했지만, LameR방식은 사용하지 못했다. 무조건적으로 성능만을 올리는게 실제 현업에서 목표는 아닐것이다. LameR방식을 사용하려면 적어도 LLM 호출을 1번씩은 더해야 하므로, 어쩔수없이 비용과 latency는 늘어날거고, Reranking모델도 마찬가지다. 무엇보다 아쉬운것은 과제 조건에서 외부데이터셋을 이용해도된다는 점이 명확하게 확인하지 못해서, 외부데이터셋을 이용해도 된다는 점을 과제제출 하루전에 알았다는 것이다. 과제전형에 Train, Test Dataset에 주어졌는데, 지금까지 해왔던 프로젝트들은 외부데이터셋이 금지된 프로젝트만 진행했어서, 당연히 Train Dataset을 RAG하는 Agent를 만들어야 한다고 생각했었다. 그런데, 프로젝트 폴더가 2GB가 넘지 않도록 구성하라는 조건을 보면, 외부데이터 없이는 도저히 2GB가 될 수 없기때문에 외부데이터셋에 대한 언급이 없었더라도 사용해도 되는 과제임을 과제제출 하루전에 알게됐다. 그래서 급하기 lbox Dataset을 외부데이터셋으로 정한 후, Chunking방법, 벡터 인덱싱등을 하는 코드를 새로 만들고, 새로 전처리하고, 에이전트도 새로 구성해야했다. 다행히도 HyDE나, Hybrid Search는 이미 실험해둔 결과가 있어서, 데이터셋만 최대한 바꾸는 방향으로 코드를 전면 재수정하고 제출했다. 나와 같은직무로 입사한 인턴분은 베이스라인 0.49대비 정확도를 0.65이상으로 끌어올렸다고 했다. 2GB데이터셋의 한계로 임베딩할 수 있는 데이터의 한계를 API호출로 해결했는데, RAG후에 confidence score를 먼저 측정하고 Score가 threshold보다 낮으면 법령 API를 호출해서 관련된 법률을 서치하는 방법을 사용해서 정확도를 올렸다고 한다. 나는 단순히 임베딩 후 RAG할 생각만 했는데, 온라인 Process에서 API를 이용해서 서치를 하는 방법론도 사용이 가능하다는것을 꺠달았다… ![image](/assets/images/2026-05-05-10-44-02.png) ### 면접 살면서 실제로 회사에 면접을 온게 처음이었다. 강남에 온것도 처음이었다. 처음 면접보러 회사에 갔을때 웅장함에 압도되었다.. ![image](/assets/images/2026-05-05-10-48-45.png) 지금은 익숙한 스파크플러스 회의실.. ![](/assets/images/20260505100120.png) 대면 컬처핏면접으로 안내받았다. 그런데, 면접을 준비하면서도 직무면접없이 바로 컬처핏면접을 하는게 뭔가 이상하다고 생각했다. 실제로 면접을 갔을때, 컬처핏 관련질문은 거의 없었고, 직무관련질문(포트폴리오에 쓴 프로젝트 아키텍처 설명, 과제 설명, 사내 Agent를 실제로 구성해보라는 질문)등을 받았다. 준비하지 않은 내 잘못이 가장 크지만 예상하지 못한 질문을 받아서 더 당황했었고, 만족할만한 답변을 하지 못했다. 그렇게 당연히 떨어질거라 생각했고, 이번면접에서 받은 질문들에 대한 피드백을 했다. 기대도 하지 않으며 다음회사 면접을 준비했다. 그리고 그와중에 모든회사를 떨어질때의 폴백으로 학교는 계속 다닐수밖에 없었다.. 특수교육시간에 눈가리고 계단내려가기같은 활동도 했다…ㅋㅋㅋ ![](/assets/images/20260505100202.png) ### 최종합격 ![](/assets/images/20260505100143.png) 그런데 면접 일주일뒤 최종합격했다는 메일이 왔다. 회사 계정이 만들어지고, 통장사본, 재학증명서를 제출했는데도, 아직 근로계약서를 작성하지 않아서, 아직까지도 믿기지 않는다. 전산상의 오류일수도 있다고 생각이 든다. 그럼에도 26년 상반기는 인턴십을 하며 성장할 수 있는 기회가 주어져서 감사하다는 생각밖에 없다. 더 겸손하고, 더 많은것을 보고 배워야겠다. ### 평범한 교대생이던 내가 뤼튼에서 개발자? 무리무리!(무리가아니었다!?) - Canonical URL: https://hyejunl33.github.io/etc/2026-05-04-WRTN-Onboarding/ - Collection: ETC - Published: 2026-05-04 - Tags: etc, 드디어 나도 ai 엔지니어? # 합격하고나서부터 입사전까지 수많은 서류탈락, 그리고 연속된 과제전형으로 지쳐있던 와중, 그래도 학교는 졸업해야하기에, 3월, 4학년 1학기로 복학 해서 학교를 다니고 있었다. 적성도, 흥미도 모두 소프트웨어 엔지니어가 되고싶다고 생각했지만, 그래도 지원한 인턴이 모두 떨어진다면 아무래도 학교졸업을 한채로 임용공부를 해서 교사가 되는 길밖에 없다고 생각하고 있었다. 앞으로 남은 학교 3학기와 군대에 대해서 어떻게 처리해야할지 막막하게 고민하고있던 와중 합격메일을 받았다. ![image](/assets/images/2026-05-05-20-33-48.png) 일단 3개월이긴 하지만 인턴을 하고나면, 여름학기 졸업은 피할 수 있었고(깔끔하게 1년 휴학이 가능하니깐), 그리고 소프트웨어 엔지니어로서의 진로도 한발짝 가까워질 수 있을 기회였다. 학교를 졸업을 해야하나 고민중이었는데, 고민을 미룰수도 있었다. 3개월만큼은… 그래서 바로 다음주 월요일이 입사날짜로 잡혀서 화요일쯤부터 입사를 준비한다.. ### 해야할일 - 남은면접 보기 - 학교휴학 - 동기들과 마지막 식사 - 서울로 테라포밍 - 입사 ### 남은 면접 보기 ![image](/assets/images/2026-05-05-20-16-55.png) ![image](/assets/images/2026-05-05-20-17-01.png) 뤼튼에 최종 합격은 했지만, 그래도 일정이 잡혀있는 면접은 가야한다고 생각했다. - 내 경험을 위해서 - 시간을 내준 면접관들을 위해서 면접관분들이 내 과제를 보고 면접볼만한 가치가 있다고 판단해주어서 면접기회를 얻은것이기 때문에 내 경험을 위해서, 그리고 시간을 내준 면접관분들을 위해서 기존에 일정이 잡혀있는 면접은 당연히 가야겠다고 생각했다. 그래서 과제전형을 합격했던 DeepAuto면접을 갔다왔다. 제조업 기반으로 P&ID 도면을 OCR하고 RAG해서 챗봇형태의 Agent를 개발하는 직무였고 AI Engineer직무여서 재밌을것같기도 했고, 내가 잘할 수 있을거라고 생각도 했다. 하지만 도메인 지식(제조업 도면)이 부족했고, 그 외에도 실무에서 실제로 사용하는 툴을 이용한 Agentic Flow를 더 생각해갔으면 좋지 않았을까 생각했다. 면접관분들이 상당히 친절했고 압박면접과는 완전히 거리가 멀었다. 그래서 더 결과가 좋지않아서 아쉬웠다. 면접과정에서 노트북을 이용해서 LLM에게 물어보고 답변해도된다고 하셨지만, 도메인지식이 없었어서 만족할만한 답변을 하지 못한것같다. ## 학교 휴학 서류는 많이 써뒀는데, 다 떨어지면 이대로 학교를 다녀야만 하는건가.. 하면서 삶의 의욕이 없었던 시기를 지나 학교 휴학절차를 밟게됐다. 화요일에 바로 다음주 월요일 입사가 확정되어서 약 4일 밖에 시간이 없었고, 급하게 남은 백수생활을 마무리했다. ![image](/assets/images/2026-05-05-20-17-10.png) ![image](/assets/images/2026-05-05-20-17-16.png) 평소에는 그냥 지나치던 학교정문인데, 마지막이라고 생각하니깐, 더 특별했다.. ![image](/assets/images/2026-05-05-20-17-24.png) 학교도서관에서 그동안 못읽던 책도읽고.. ![image](/assets/images/2026-05-05-20-17-35.png) ![image](/assets/images/2026-05-05-20-17-44.png) 오랜만에 가본 만화카페.. 가서 막상 만화는 많이 못보고 얘기만 많이 했는데, 내가 서울로 인턴을 하러간다니.. 그것도 개발자로..? ![image](/assets/images/2026-05-05-20-17-51.png) ## 서울로 테라포밍 첫 서울, 첫 자취, 첫 회사 모든게 처음이어서 모든게 신기했다. 면접보러 올때 보라매공원이 너무 좋았어서 매일 러닝하려고, 신대방에다가 방을 잡았다. ![image](/assets/images/2026-05-05-20-17-58.png) 근데 입사하기 전에는 매일 러닝을 했는데, 막상 회사다니니깐 회사집만 반복해서 다니는중이다.. ![image](/assets/images/2026-05-05-20-18-04.png) 회사에서 일해본적이 없어서, 사실 입사하기전에 겁이 좀 났다. 어떤업무를 하게될까, 어떤 프레임워크를 공부해가야하나, 어떤것을 알아야하나, 클로드코드 비싸서 안써봤는데 어떡하지등등.. 그래서 입사하기전에 클코 하네스엔지니어링도 공부하고, 이번 인턴기간을 통해 최종적으로 내가 무엇을 얻어가야하는가를 정리했다. ### 무엇을 얻어가고자하는가? - 현업에서 Multi Agent를 이용해서 업무를 자동화하는 프로세스 경험 - 실제로 AI Engineer들이 일하는 방식, 회사에서 협업하는 방식, 문제를 해결하는 방식을 보고 배우고싶음 ### 마음가짐 - 최대한 스펀지처럼 배우고 성장하자 - 내 자신의 심지는 잃지 말자. 나는 대학생. 여기는 일배우러 온곳. 안되면 다시 돌아가면 됨 - 근거 없는 자신감을 갖자 - 칠가이 → 너무 잘할려곤 하지말자. 여유는 너무 잘할려고 하지 않는 마인드에서 나옴 # 입사이후 그로스 마케팅팀 업무자동화(AX)를 맡게 되었고, 자리도 그로스마케팅팀에서 시작을 했다.(현재는 11층으로 이사했다..) 회사에서 웰컴키트도 줬다..! ![image](/assets/images/2026-05-05-20-18-12.png) ![image](/assets/images/2026-05-05-20-18-17.png) ![image](/assets/images/2026-05-05-20-18-23.png) 회사 캔틴에서 음료수랑 과자를 가져다가 먹을 수 있어서 너무 좋았다.. 근데 너무 많이 먹게돼서 적당히 먹어야되긴 하는데, 입사 초기에는 진짜 선을 넘을정도로 많이 먹었다.. 왜그랬찌 ![image](/assets/images/2026-05-05-20-18-29.png) 대학교를 다니던 일상에서 일주일만에 인턴이지만, 서울에서 출근하는 엔지니어가 되어버렸다. 회사에서 재밌는 경험들도 많이했고, 업무적으로도, 마케팅 도메인측면에도 배워가는게 많다. 실제 업무에 대해서는 시간이 날때 다시 써봐야겠다. ### WrapUp Report 우수사례 선정 - Canonical URL: https://hyejunl33.github.io/etc/2025-12-30-philosophy%20copy/ - Collection: ETC - Published: 2025-12-30 - Tags: etc, 그냥생각 영화 리뷰 감성 분류 및 예측 프로젝트에서 작성했던 WrapUp Report가 우수사례로 선정되었다. [WrapUP Report 링크](https://hyejunl33.github.io/weeklyreview/2025-11-03-WrapupReport/) ![image](/assets/images/2026-01-27-10-22-33.png) 처음해보는 프로젝트였기도 하고, 모델 Finetuning을 처음해보다 보니, 2주내에 데이터 전처리부터 모델 Finetuning까지 완성하기가 쉽지는 않았다. 따라서 최대한 이론적으로 배운 내용을 적용해서 실제 코드로 모델에 적용하려고 노력을 했다.. ## 프로젝트를 마치고 정리하며 드는 생각들.. Wrap Up Report에도 자세히 설명이 되어있는데, 이론적으로 배운 내용을 `그냥 좋으니까` 적용하는게 아니라, 현재 프로젝트의 목표를 이루기 위해서 왜 그 방법을 사용해야하는지를 생각하면서 사용했다. 예를들어서 감성분류를 위한 모델이므로, 학습시키는 데이터에 최대한 영화에 대한 감상이나 감정이 남아있어야 한다고 가설을 세웠다. 따라서 이모지나, ‘ㅋㅋ’, ‘ㅠㅠ’와 같은 글자가 아닌 데이터들을 제거할수도 있지만, 최대한 정규화해서, 커스텀토큰으로 매핑한 후 해당 정보들까지 Finetuning에 사용했고 그 결과 1.8%p의 Public Score향상을 이룰 수 있었다. 물론 모든 방법들이 성공한것은 아니다. EDA결과 학습 데이터에 클래스 불균형이 있는것으로 판단하고 WCE에서 Weight를 각 비율의 역수로 실험해보았는데, 그 결과 오히려 성능하락이 있었고, 일반적으로 사용하는 방법이 무조건 옳지만은 않다라는것을 알 수 있었다. 이후 손가락뼈 Semantic Segmentation 프로젝트에서도 일반적으로 CLAHE를 Augmentation으로 사용하는것이 좋다고 알려져있었지만, 오히려 성능이 하락했던 경우도 있었다. 무엇보다 중요한건, 논문을 비롯한 많은 자료들을 찾아보며 나와 비슷한 문제를 해결한 사람들이 사용한 방법들을 찾아보고, 그 방법이 내 Task에 적용될지 가설을 세워보고 직접 실험해보는 그 Process 자체가 중요한것 같다. ### 멘토님의 우수사례 선정 이유 [실험 과정의 명확한 서술] - 단순히 무엇을 했는지 나열한 것이 아니라, WCE 적용 이유(클래스 비율 역수 기반 가중치), 특수 토큰 정규화 목적, Stratified K-Fold를 통한 robust 평가 등 각각을 적용한 ‘의도’가 뚜렷하게 드러나 실험 설계의 깊이가 돋보였습니다. [보고서 전체가 '왜 이 결론에 도달했는지'가 명확함] - 최종 성능만 기록하는 것이 아니라, 그 성능이 어떻게 만들어졌는지 전체 실험 여정을 통해 설명하고 있어, 단순 결과 보고서가 아닌 사고 과정을 기록하여 어떤 고민을하고 결과가 나왔는지를 알 수 있어서 좋았습니다. > '문제 정의 → 가설 설정 → 실패 분석 → 성능'으로 이어지는 연구 수준의 논리적 구조를 갖추고 있다는 점에서 우수 사례로 선정했습니다. 프로젝트의 성과가 만족스럽지는 않았지만, 실험마다의 가설을 설정하고, 검증해나가는 방법이 올바른 방법이었다는것을 확신할 수 있어서 좋았다. ![image](/assets/images/2026-01-27-10-23-55.png) 우수 사례 선정 선물로 에코백이랑 우산, 그리고 이런저런 선물들을 주셨다.. ![image](/assets/images/2026-01-27-10-24-49.png) 앞으로의 프로젝트에 얻어갈 인사이트가 많은 첫 프로젝트였다. 그리고 첫프로젝트부터 우수사례로 선정되어서 앞으로도 남은 프로젝트를 열심히할 동기부여가 되었다! ### 우리팀은 어떻게 협업하는가?: 팀협업 진화기 - Canonical URL: https://hyejunl33.github.io/etc/2026-01-25-cowork/ - Collection: ETC - Published: 2025-12-30 - Tags: etc, 협업 영화리뷰 감성분류 예측프로젝트(개인프로젝트)까지는 개인프로젝트여서 협업에 대해 딱히 생각을 깊게 하진 않았다. 노션에 혼자서 할 실험들 가설세우고, 조사하고, 실험결과분석하고의 반복이었다. 프로젝트 구조도 개인프로젝트를 할때는 주피터노트북으로 진행했고(소스코드 자동화가 어려워서 이때는 사용하지 않았다.) 어려움이 없었다. 하지만 필연적으로 일을할때는 팀원들과 함께 일을해야 하기 때문에 Github를 이용한 협업은 필수이고, 노션,슬랙을 이용한 베이스캠프를 만들어서 서로의 상황과 생각을 공유하는게 중요해지는 지점이 있었다. ### 프로젝트 순서 **개인프로젝트 → 재활용쓰레기 Object Detection프로젝트 → Segmentation프로젝트 → 최종프로젝트** ## 재활용 쓰레기 Object Detection 프로젝트 첫 프로젝트 당시, Github에 익숙한 사람이 없었고, 어떻게 Issue를 열고 PR을 하는지조차 몰랐었다. 앙상블을 할때 각자 다른모델, 다른라이브러리, 다른 베이스라인 코드를 가지면 Variance가 클수록 성능향상폭이 크다는 멘토님의 의견에 따라서 각자 로컬환경에서 개발을 진행했다. ![image](/assets/images/2026-01-27-11-38-02.png) 노션으로 실험테이블을 정리하긴 했지만, 서로의 환경이 아예 달라서, 재현가능성이 없었고, 중복된 실험을 하는 경우도 있었고 경우에 따라서는 중복된 실험에 대해서 상반된 결과가 나오기도 했다. 재현가능성이 없는 실험결과를 가지고 방향성을 설정하기 어려웠고, 서로가 어떤 실험을 진행하는지, 그 실험의 방법과 효과가 무엇인지, 어떤 가설을 가지고 실험하는지 소통하기가 어려웠다. ![image](/assets/images/2026-01-27-11-38-13.png) 협업을 할때 Github를 사용하지 않았고, 마지막에 서로가 실험한 코드를 각자 Id에해당하는 폴더에 합치기만 했다.. ![image](/assets/images/2026-01-27-11-38-22.png) 배울점이 많았던 프로젝트였다. 프로젝트가 끝나고 팀회고 시간에이후 진행되는 Segmentation프로젝트에서는 github과 협업툴, 그리고 WandB를 적극적으로 활용해서 각자의 상황을 공유하고, 원활한 소통을 해야겠다고 피드백했다. ## 손가락뼈 Semantic Segmentation 프로젝트 지난 프로젝트에서의 재현가능성문제, 그리고 소통의 어려움을 해결하기 위해 이번 프로젝트에서는 협업툴을 적극적으로 사용하기로 했다. - 구체적으로 Task들마다 데드라인을 정했다. ![image](/assets/images/2026-01-27-11-38-50.png) - 각자 Task마다 조사한 후 서로 공유할 수 있는 WorkSpace를 만들었다. ![image](/assets/images/2026-01-27-11-39-08.png) - 이전과 동일하게 실험테이블에 실험 세팅을 공유해서 재현가능성을 확보했다. - Github에 공통된 베이스라인 코드를 가지고 실험을 했고, Configs값만 바꿔가면서 실험세팅을 바꾸어서 실험을 진행했다. ![image](/assets/images/2026-01-27-11-39-21.png) - WandB 프로젝트 폴더에 각자의 실험을 공유했다. WandB WorkSpace에서 구체적인 수치를 비교해볼 수 있었다. ![image](/assets/images/2026-01-27-11-39-35.png) 노션에 WorkSpace를 만들어서 서로의 의견과 가설에 대한 생각을 공유할 수 있었고, 실험 table에 실험방안을 설명해둬서 각자가 어떤 실험을 진행했고, 어떤 기법들이 효과가 있었는지 확인하기 쉬웠다. 특히 WandB에서 서로의 실험 지표를 그래프로 바로 비교해볼 수가 있어서, 어떤 실험들이 효과가 있었는지 시각적으로 확인하기 용이했다. WrapUpReport를 작성할때도 각자의 기여를 확인하고, 어떤 스토리텔링으로 실험이 진행됐는지를 알 수 있어서 최대한 자세히 WrapUpReport를 작성하다보니 원래는 10페이지 제한인데, 20페이지가 넘어갔다.. 그만큼 우리팀에서 있었던 일들과, 생각의 과정을 모두 노션에 정리하고, github으로 재현가능성을 확보하니깐 협업에 도움이 되었다. ## 이미지기반 카페 추천 서비스 (최종프로젝트) 최종프로젝트에서는 이전의 노션과 github기반 협업의 방식을 이어서 사용하되, 기능이 복잡해짐에 따라 더욱 견고한 협업 규칙이 필요했다. 따라서 브랜치전략이나 코드리뷰같은 협업 규칙을 정했다. - 무조건 Issue를 기반으로 작업. 작업을 시작할때는 어떤작업을 하는지 Issue를 작성하고, PR로 Issue를 닫기 ![image](/assets/images/2026-02-12-17-15-50.png) - PR을 통해 코드가 Merge되면 연결된 Issue가 자동으로 닫히도록 설정 ![image](/assets/images/2026-02-12-17-14-48.png) - Squash and Merge를 이용해서 기능단위로 브랜치를 만들고 Merge - 적어도 1명이상의 승인을 가지고 코드리뷰 ![image](/assets/images/2026-02-12-17-16-38.png) 이외에도 노션을 이용해서 적극적으로 팀차원에서 기록을 남기도록 노력했다. - 매일 1시간씩 회의를 하긴 하지만 무슨내용을 정확히 나눴는지 휘발되는 문제가 있어서 회의록을 매일매일 작성하고, 서로 내일까지 할일을 정했다. ![image](/assets/images/2026-01-27-12-16-58.png) - 서로의 맡은 역할이 달라서, 각자 분야에 대한 소통에 어려움을 느끼고, 조사탭에다가 자신이 맡은 역할에 대한 조사를 하고 정리를 한 뒤에 회의시간에 각자 발표하는 방식으로 소통하려고 노력했다. ![image](/assets/images/2026-01-27-12-17-08.png) - 각자 조사탭에 작성하기에는 너무 사소한 TODO list나 아이디어들도 공유함으로써 개인메모장을 노션에 만들어서 서로의 사소한 아이디어나 일정을 공유하려고 노력했다. ![image](/assets/images/2026-01-27-12-17-21.png) 일련의 프로젝트를 거치면서 소통을 위한 규칙이라는게 처음에는 번거롭긴 하지만, 결국에는 오해에 쓰는 시간을 줄일 수 있었다. 비대면으로 팀프로젝트를 진행하다보니, 규칙 몇가지로 완벽한 소통이 진행되는건 아니었다. 아직도 개선할 지점이 많고, 서로 같은 용어를 말하더라도, 다르게 이해한 경우가 많았다. 그럼에도 중요한건 최대한 기록을 남기고, 서로 조율해나가는 노력을 하는게 중요한것 같다. ### 부조리주의, 포스트구조주의, 그리고 반항 - Canonical URL: https://hyejunl33.github.io/etc/2025-11-13-philosophy/ - Collection: ETC - Published: 2025-11-13 - Tags: etc, 그냥생각 ## 왜 살아야 하는가? 왜 살아가야만 하는가? 더 많은 돈, 더 넓은 집, 더 높은 자리, 더 좋은차를 위해 오늘도 많은 사람들은 열심히 살아간다. 나는 진정 더 많은 돈, 더 넓은집, 더 높은 자리들을 원하는 걸까? 아니면 사회 구조가 주입한 것들을 욕망하는걸까? 연봉이 1억까지는 선형적으로 행복도가 상승하지만, 그 이상부터는 행복이 포화되는 그래프를 본적이 있다. 살아가기 위해서 돈이 없다면 불행하겠지만, 돈의 총량만큼 선형적으로 행복도가 증가하는것은 아니다. 시간은 유한한데, 더 많은돈, 더 높은자리등등만을 생각하느라, 정작 열심히 살긴 하지만, 행복하진 않았던 경험이 있다. 100억이있으면 좋은집, 좋은차등을 살 수 있겠지만, 행복할까? 아니면 그뿐일까 내게 필요한 몇가지의 필수조건들만 충족된다면, 그 이상의 돈은 행복과 사실 큰 연관이 없게 된다. 그렇다면 이 지점에서 나는 왜살아야 하는가? 사회에서 주입한 더 많은돈, 더 큰차, 더 넓은집들을 욕망해봤자, 선형적으로 행복도는 증가하지 않는다. 행복하기위해 무엇을 하면서 살아야 하는가? 이 지점에서 더이상 자본은 해답을 주지 못한다. ## 카뮈의 부조리주의 카뮈는 세상 자체가 부조리하다고 주장한다. 이성적인 의미와 목적을 찾으려는 인간의 열렬한 욕망과 대비되게, 세계는 아무런 의미나 목적도 제공하지 않는다. 나는 게임을 해도, 비싼옷을 사도, 여행을 가도, 그냥 그뿐인듯 하고, 큰 의미를 갖지 못한다고 생각을 해왔다. 카뮈에 의하면 세상 자체는 부조리 하기때문에, 어차피 세계는 어떠한 삶의 의미나 목적을 제공하지 않는다. 그렇다면 나는 어떻게 살아가야 하는가? 카뮈는 이러한 부조리에 반항을 하라고 말한다. 물리적 자살이나, 철학적 자살의 잘못된 경로로 가는것이 아니라, 반항을 통해 자유와 열정을 다해 살아가라고 말한다. 물리적 자살은 말그대로 자살하는 것이다. 무의미하고 부조리한 현실을 견디지 못하고 삶 자체를 포기하는것이다. 하지만 이는 부조리를 해결하는것이 아닌, 도피이자 패배이다. 철학적 자살은 부조리를 이성으로 해결할 수 없음을 깨닫고, 종교나 특정 이념에 귀의하여 절대적 의미가 있다고 믿어버리는 것이다. 이 역시 현실을 직시하지 않고 맹목적인 희망으로 도피하는 속임수에 불과하다. 카뮈의 소설 이방인에서 뫼르소가 사형집행 직전 자신을 회개시키려는 신부를 거부하는 장면이 이 철학적 자살을 거부하는 태도이다. 부조리에 대한 반항은 세상에 내재된 의미가 없음을 인정하고, 신이나, 희망에 기대지도 않으며, 죽음이라는 한계를 명확히 의식하는것이다. 부조리를 똑바로 마주한 채 주어진 삶을 포기하지 않고 그 속에서 자유와 열정을 가지고 살아가라고 말한다. 반항은 구체적으로 어떻게 해야하는 걸까? 우선 첫번째로 자유를 위해서 신, 운명, 사후세계, 절대적 도덕과 같은 것들을 모두 버려야 한다. 영원을 기대하지 않기에 지금 ‘여기에서의 삶’이 유일하게 중요해진다. 따라서 내일이나 다음 생을 위해서가 아니라 오직 나 자신을 위해 현재를 선택할 자유를 얻는다. 두번째로 열정을 위해서 삶이 유한하고, 한번뿐이며, 의미가 없다는것을 알기에, 유한한 삶을 최대한 열정적으로 경험해야 한다. 마치 이방인에서 뫼르소가 햇빛의 뜨거움때문에 방아쇠를 당기고, 마리의 피부와 드레스를 느끼듯이 관념이 아닌 현재 삶 자체를 열정적으로 느껴야 한다. 마지막으로 가장 중요한것은 부조리하다는 사실을 절대로 잊지 않고 항상 깨어있는 상태를 유지해야한다. 이를 **Consciousness**로 강조한다. 카뮈는 실존주의철학을 주장한 사르트르와 비교되는데, 사르트르는 실존은 본질을 앞선다고 주장하며, 인간은 우선 실존하기 때문에, 그 본질(의미)를 스스로 만들어가야한다고 주장한다. 하지만 카뮈는 의미를 만들어가는것 조차 불가능하다고 본다. 의미는 애초에 존재하지 않으며, 중요한것은 의미를 찾는것이 아니라, 부조리함을 의식하고, 그에 굴하지 않고, 자유와 열정을 가지고 살아내는 태도 그자체를 중요하다고 본다. 이방인의 부조리주의 철학은 시지프신화에서 자세히 설명되는데, 시지프 신화에서 처럼 부조리한 상황에서도 부조리한상황을 ‘인식’하고, 그것을 반항으로 대하는 태도를 유지한다면, 자신이 운명의 주인이 될 수 있다고 말한다. ## 카뮈이후 구조주의와 포스트 구조주의 카뮈 이후 구조주의가 등장한다. 구조주의는 나라는 개인의 의식이나 자유가 아니라 개인의 생각을 규정하는 구조가 존재한다고 본다. 예시로 언어라는 구조를 통해 인간은 생각할수 밖에 없고, 결국 생각이라는것은 구조에 한정된다는 것이다. 따라서 어떠한 개인도 구조에서 자유로울 수 없기 때문에, 카뮈가 말한 완전한 자유는 허상이 된다. 구조주의 이후 포스트구조주의는 구조를 더 해체하여, 하나의 거대하고 안정된 구조가 아니라, 유동적이고 억압적인 권력의 힘에 개인은 영향을 받을 수 밖에 없다고 주장한다. 따라서 계몽주의의 거대 담론 자체가 사실은 억압의 도구였다고 주장한다. 카뮈가 개인의 이름으로 무의미한 세계에 반항했다면, 그 이후의 철학은 개인마저 구조에 의해 만들어진것임을 폭로하고, 그 구조마저 권력의 산물임을 해체한다. 그 결과 진짜 의미가 사라진 시대를 맞았다. 포스트 구조주의자 푸코는 권력의 바깥은 없다고 말한다. 따라서 자유롭다고 느끼는 감정, 열정적이라고 생각하는 대상마저도 사회 구조가 권장하거나, 허용한것일 수 있다. 따라서 완전한 자유라는 허상을 버리고, 구조에서의 틈새와 균열을 찾는 실천적 자유를 추구해야한다. 카뮈의 반항이 완전한 자유를 추구하는것이라면, 푸코의 자유는 구조에 갇힌 나 자신을 자각하고, 대신 그 사이의 틈새와 균열을 찾는것이다. ## 그러면 나는 어떻게 살아가야 하는가 나는 그러면 살아가면서 어떻게 사회에 반항해야할까? 우선 세상의 부조리함을 인식한다. 그 다음 이 구조가 나에게 무엇을 정상이라고 강요하는지 의식한다. 그 이후 두번째로 사회에서 당연하게 받아들여지는 진리들에 대해 질문한다. 더 큰집, 더 많은 돈, 비싼 차등등을 추구해야만 하는 이유가 있을까? 진정 그것들이 지속되는 행복을 가져다 주는것일까? 스타벅스 커피보다 커피머신으로 뽑아먹는 300원짜리 커피로도 충분하지 않을까? 이런질문들을 통해 사회가 당연하다고 주입한것들을 다시한번 반추해보아야 한다. 세번째로 나를 재구성해야한다. 권력이 나를 A라고 규정한다면 나를 B, C, D로 살아보는 실험을 하는것이다. 푸코는 **Care of the self**라는 개념을 제시했다. 권력이 나를 멋대로 주체로 만들려 할때, 오히려 내가 나를 돌보고 나를 하나의 예술작품처럼 스스로 만들어가는 것이다. 즉 이전에 주체적인 태도로 질문을 해나간것들을 바탕으로, 나 자신을 사회의 틀에서 벗어나서 재구성해보는 것이다. 이들을 통해 나는 세상이 부조리하다는것을 인식하고, 나의 반항은 사회의 부조리를 의식한체, 저들이 정해준 열정이 아닌 나만의 열정을 찾고, 저들이 허락한 자유가 아닌 나만의 틈새를 만들어 부조리한 삶을 나의 작품으로 살아낼 수 있다.