성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는 작업이다.
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는 작업이다.
발굴 이후의 제작은 기존 서브카피·롱폼·모션 파이프라인을 그대로 사용했다. 새로 만든 것은 그 앞에서 어떤 스토리를 가져올지 정하는 검색 경로였다.
앵글과 실제 소재를 따로 저장했다
입력은 다른 팀원이 만든 에이전트에서 JSON 형태로 받은 광고 성과 분석과 인사이트였다. 여기에는 앵글 제목과 요약, 추천 크리에이티브 브리프, AI 분석 근거와 확신도, 뒷받침 소재 수, 위닝 형식과 매체가 들어 있었다. 이 분석 결과를 다음 스토리 검색의 입력으로 활용했고, 앵글을 뒷받침하는 배너와 원본 스토리는 별도 목록으로 남겼다.
selection_id    앵글 고유 id
title           위닝 앵글 제목
summary         요약
recommended_brief   추천 크리에이티브 브리프 (가설 시드)
ai_rationale    왜 이겼는지에 대한 분석 근거
category        genre_theme | copy_angle
confidence      확신도
support_count   이 앵글을 뒷받침한 소재 수
media_type      image | video    ← 위닝 형식
platform        meta | tiktok   ← 위닝 매체
folder_name     Drive 폴더명
creative_name   소재 이름
material_type   img | vid
genre           파싱된 장르
form            sub | tag | longform | motion
story_id        딥링크에서 뽑은 원본 스토리 (없으면 데이터 오류)
‘어떤 관계나 장면이 잘됐다’는 분석 문장과 실제 광고 파일이 연결돼 있어야 했다. 원본 스토리는 소재의 딥링크에서 식별했다. 이후 새 후보를 만들 때도 어떤 앵글과 검색축에서 왔는지 남겨서, 결과를 다시 확인할 수 있게 했다.
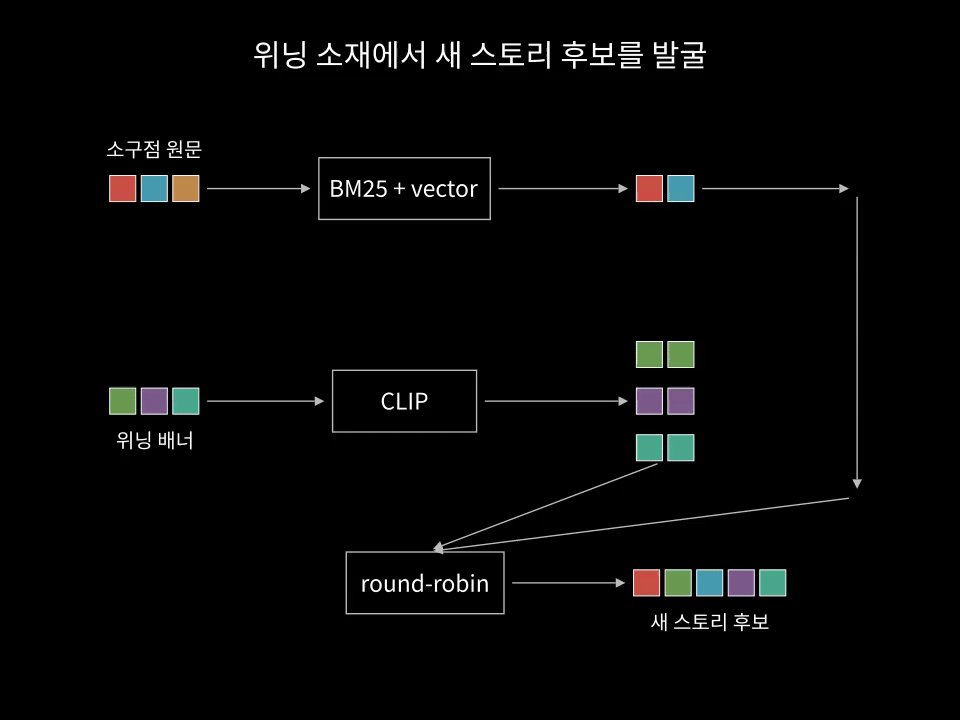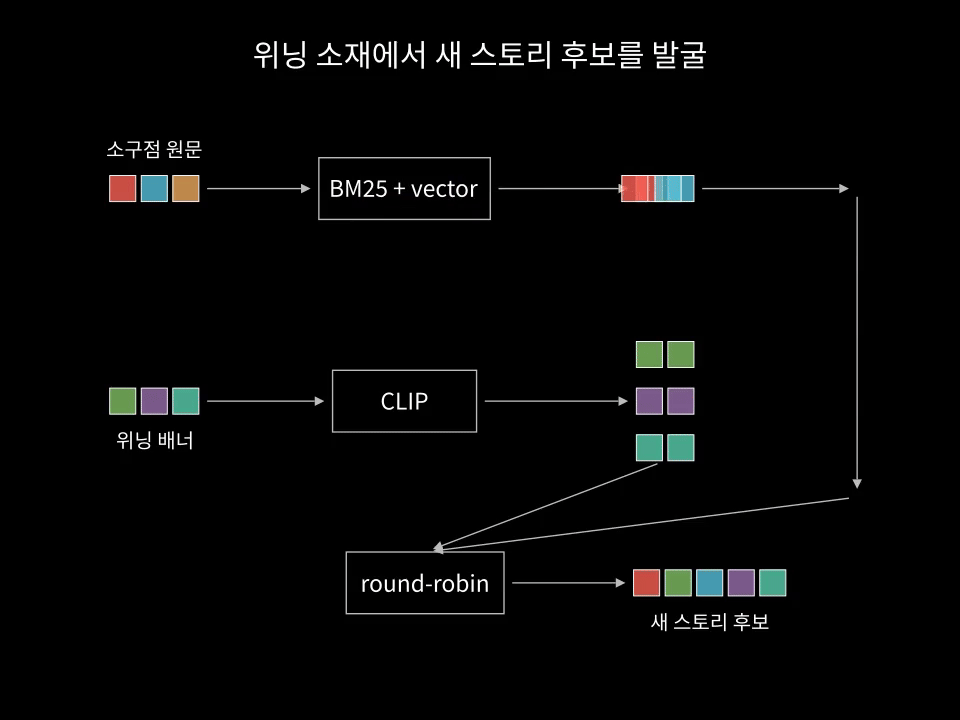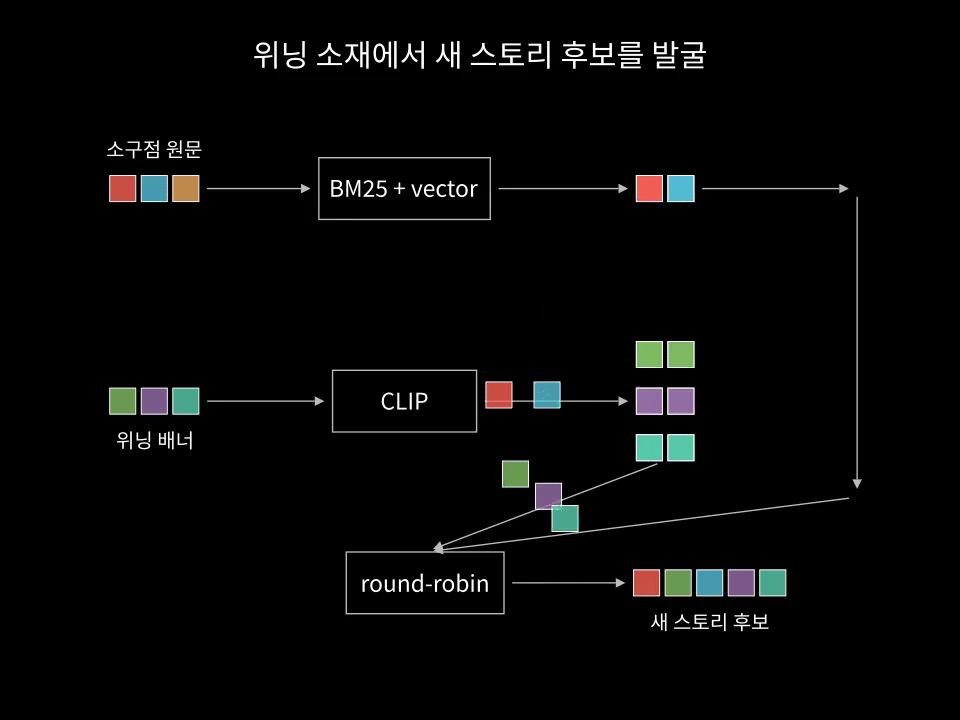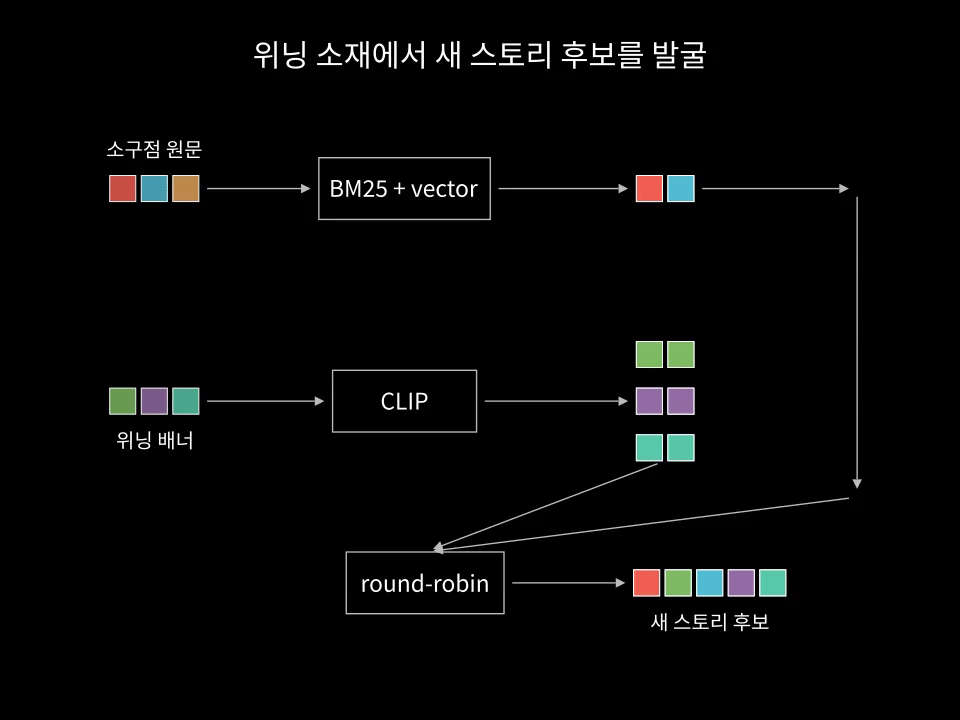
텍스트축·이미지축의 후보를 순환 선택하는 흐름

위닝 앵글에서 스토리를 발굴하고 제작하는 흐름
텍스트축은 실제 위닝 스토리의 소구점으로
처음처럼 LLM에게 가상의 소구점을 새로 만들게 하기보다, 위닝 앵글을 뒷받침한 실제 스토리의 감정·훅·소구점 원문을 검색어로 썼다. 그 문장은 검색 코퍼스가 임베딩한 원문이기도 했다. 검색을 위해 번역하거나 다시 해석하면서 뜻이 흔들리는 것을 줄일 수 있었다.
어휘 검색인 BM25와 의미 기반 벡터 검색을 순위 융합으로 합쳤다. 같은 키워드를 공유하는 후보와 표현은 달라도 의미가 비슷한 후보를 함께 찾으려는 방식이었다. 한쪽 검색이 실패해도 다른 쪽 결과를 반환하도록 했다.
위닝 스토리가 연결돼 있지 않을 때만 LLM이 가상 소구점을 만드는 기존 경로로 돌아갔다. 실제 원문이 있는데도 다시 만들어 쓰는 것과, 입력이 없어서 대체하는 경우를 나눴다.
이미지축에서는 배너마다 따로 검색했다
이미지축은 위닝 배너 그림 자체를 CLIP으로 인코딩하고, 스토리의 프로필 이미지에서 이웃을 찾았다. 여기서 여러 배너의 결과를 어떻게 합칠지가 문제였다.
실측 사례에서 배너 일곱 장이 있는 앵글의 상위 열 후보 중 일곱 개가 한 배너에서 나왔다. 인물 크롭이 큰 배너가 순위를 독식하는 현상이 있었다. 광고 배너와 캐릭터 일러스트는 종류가 달라 절대 코사인 점수도 낮게 나왔기 때문에, 다른 배너의 점수를 같은 기준으로 비교하기 어려웠다.
그래서 배너마다 후보를 따로 찾고 돌아가며 채웠다. 각 배너 내부의 순위를 사용하고, 하나의 배너가 전체 후보를 가져가지 않도록 했다. 여러 이미지의 평균 벡터도 쓰지 않았다. 서로 다른 그림체와 구도를 평균내면 어느 쪽도 제대로 나타내지 않는 중간점이 될 수 있어서였다.
이 선택은 다양성을 확보하기 위한 운영 규칙이었다. 서로 다른 배너의 점수를 섞어서 하나의 높은 숫자를 고르는 것이 이 작업의 목적과 맞는지부터 다시 봐야 했다.
검색 결과를 그날의 생성 목록으로
앵글들을 돌아가며 목표 개수만큼 새로운 스토리를 발굴했다. 개별 앵글 검색이 실패하면 그 앵글만 건너뛰고 전체 작업은 계속했다. 후보가 모자라면 목표 미만인 채로 끝냈다. 개수를 맞추려고 관련성이 낮은 후보를 억지로 넣지는 않았다.
발굴은 크론으로 미리 돌리고, 아침에 통합 생성 화면을 열면 사용할 세트가 준비돼 있게 했다. 운영자는 일괄 생성을 실행하고 결과를 확인할 수 있다.
선택된 스토리는 기존 제작 흐름에 들어간다. 다만 디자이너 프롬프트에는 위닝 카피의 헤드라인·서브·CTA와 그 톤을 예시로 넣었다. 결과물은 위닝 경로의 폴더로 올리고 소재 메타데이터에 어느 검색축에서 발굴했는지 기록했다.
실제 집행에서 확인한 성과
위닝 앵글에는 ‘왜 성과가 났는가’에 대한 해석이 들어 있다. 실제 소재를 근거로 한 분석이지만, 그것을 새로운 스토리에 적용했을 때 같은 성과가 난다고 확정할 수는 없다. 검색은 그 가설과 비슷한 후보를 찾아주는 단계다.
실제 집행에서는 차이가 나타났다. 서비스별로 차이는 있었지만, 위닝앵글을 기반으로 만든 광고 배너는 그리드서치 방식으로 만든 배너보다 약 두 배의 성과를 냈다. OOC에서는 핵심 지표로 봤던 D0 ROAS가 10% 이상으로 유지되는 결과도 나왔다.
이 작업에서는 모델이 새 기획을 계속 만드는 것보다, 운영팀이 이미 확인한 광고와 원본 스토리를 다음 제작에 연결하는 데 집중했다. 텍스트축과 이미지축을 분리하고, 후보가 어디서 왔는지 남긴 이유도 이후 집행 결과를 다시 읽기 위해서였다. 이후에도 어떤 앵글과 검색축이 유효한지는 새 광고의 집행 결과와 함께 계속 확인해야 한다.
본문의 데이터 흐름 애니메이션은 3Blue1Brown의 오픈소스 Manim에서 출발한 Manim Community로 만들었다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
한국에서 만든 광고 파이프라인을 북미·일본으로 확장하기
광고 소재 제작 파이프라인은 크랙에서 먼저 만들었다. 이후 북미 OOC와 일본 캬라푸로 확장했다. 이미 돌아가는 생성 흐름이 있으니 언어만 바꾸면 될 것 같지만, 실제로는 입력 데이터와 UI, 폰트, 디자인 레퍼런스가 달랐다.