CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으로 선호도 시뮬레이션을 해봤다.
Nemotron Persona를 처음 알게 된 건 1차 랄프톤에서였다. 국가권력급 AI 엔지니어 Kevin이 사내 QA 에이전트의 시스템 프롬프트에 Nemotron Persona를 넣고, 변경한 UI·UX 구성요소를 A/B 테스트하는 데 활용하는 에이전트를 만든 것을 봤다.
오픈소스로 신뢰도 있는 설문조사를 LLM으로 할 수 있다니..! 당시에는 그렇게 받아들였다. 광고 배너를 AX로 자동 생성하는 파이프라인에도 무조건 적용해 봐야겠다고 생각했다.
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. Kevin의 에이전트를 보고 떠올린 아이디어를 바탕으로, 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으로 선호도 시뮬레이션을 해봤다.
페르소나에 배너와 카피를 보여주고 클릭하고 싶은 정도를 물은 뒤, 그 점수가 실제 CTR과 같은 방향으로 움직이는지 비교했다. 점수에 예측력이 있다면 일정 기준 이상의 배너만 집행하는 방식으로 연결할 수 있었다. 실험에서 확인하려던 것은 바로 이 연결이었다.
페르소나의 클릭 의향을 실제 CTR과 비교하기
검증 기준은 실제 CTR과 시뮬레이션 점수의 상관계수였다. 당시에는 correlation이 0.5 이상이면 집행 후보를 고르는 데 활용할 수 있겠다는 기준을 뒀다. 배너를 보고 긍정적인 답을 많이 받는 것보다, 실제로 CTR이 높은 배너에 더 높은 점수를 주는지가 중요했다.
산점도의 가로축은 페르소나가 준 click_intent 점수의 평균이고, 세로축은 실제 CTR(%)이다. click_intent는 0~10점 척도로 평가한 클릭 의향이다. 8점을 받았다고 CTR이 8%라는 뜻은 아니어서, 점수와 실제 집행 지표를 따로 놓고 관계를 봤다.
실험 1·2·3에서 평가 집단을 바꾼 이유
세 실험에서는 누구에게 배너를 평가하게 할지를 바꿨다. 일반적인 인구 집단의 반응으로 시작해 광고 타깃에 맞추고, 이후에는 서비스에 관심을 가질 만한 집단까지 좁히려는 순서였다. 각 조건에서 페르소나의 클릭 의향 점수와 실제 CTR을 비교했다.
실험 1: 전연령에서 기준 결과를 확인하기
먼저 연령·성별·교육·직업·지역을 층화해 페르소나를 구성했다. 특정 인구 집단에 쏠리지 않은 평가에서도 배너별 클릭 의향이 실제 CTR과 같은 방향으로 움직일지 확인하려 했다. 이 결과를 기준으로 두고, 평가 집단을 타깃에 맞춰 좁히면 예측력이 달라지는지 비교했다. 표본을 구성하기 전에 연령과 성별, 학력, 결혼 상태의 분포도 확인했다.
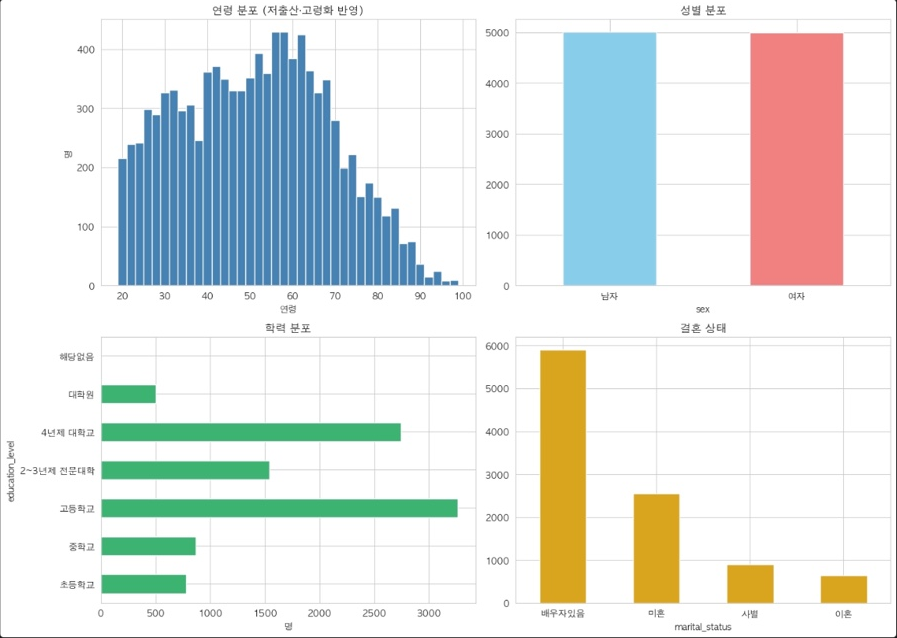
Nemotron Persona-Korea 데이터의 연령·성별·학력·결혼 상태 분포
실험 2: 광고 타깃의 연령과 성별에 맞추기
다음에는 평가 집단을 20~39세로 좁혔다. 남성향 스토리는 남성 페르소나에게, 여성향 스토리는 여성 페르소나에게 평가하게 했다. 전연령의 반응을 섞기보다 실제 광고 타깃에 가까운 집단의 반응을 보면 예측력이 나아질지 확인하려는 조건이었다. 이 단계에서는 연령과 성별을 맞췄고, 크랙에 대한 취향으로 집단을 더 고르지는 않았다.
| 조건 | 실험 1 | 실험 2 | 실험 3 |
|---|---|---|---|
| 연령 | 전연령 층화 표본 | 20~39세 | 20~39세 |
| 성별 | 성별 층화 표본 | 남성향은 남성, 여성향은 여성 | 남성향은 남성, 여성향은 여성 |
| 그 밖의 구성 | 교육·직업·지역 등을 층화 | 20~30대 남성·여성 | 크랙 서비스를 좋아할 만한 클러스터 선택 |
| 실험 정리표의 corr | -0.219 | -0.048 |
실험 3: 같은 연령·성별 안에서도 서비스 취향으로 좁히기
세 번째 조건에서는 20~39세와 스토리 성향에 맞춘 성별 조건을 유지하면서, 그 안에서 크랙 서비스를 좋아할 만한 클러스터를 고르려 했다. 연령과 성별만 같다고 서비스 취향까지 같지는 않으니, 프로필의 관심사와 생활 맥락으로 평가 집단을 더 좁히면 예측력이 나아질지 보려는 방향이었다.
이를 위해 페르소나 서술을 임베딩하고 K-means로 군집화했다. 군집 수는 8개로 설정했다. 프로필을 그룹으로 묶고, 유사한 집단을 벡터 검색으로 찾는 방식을 살펴봤다. 다만 실제로 선택한 클러스터와 사용한 feature 조합, 검색 질의는 작업 기록에 남기지 못했다. 세 번째 조건의 상관계수도 기록하지 않아, 이 방식의 효과를 결과로 확인할 수는 없었다.
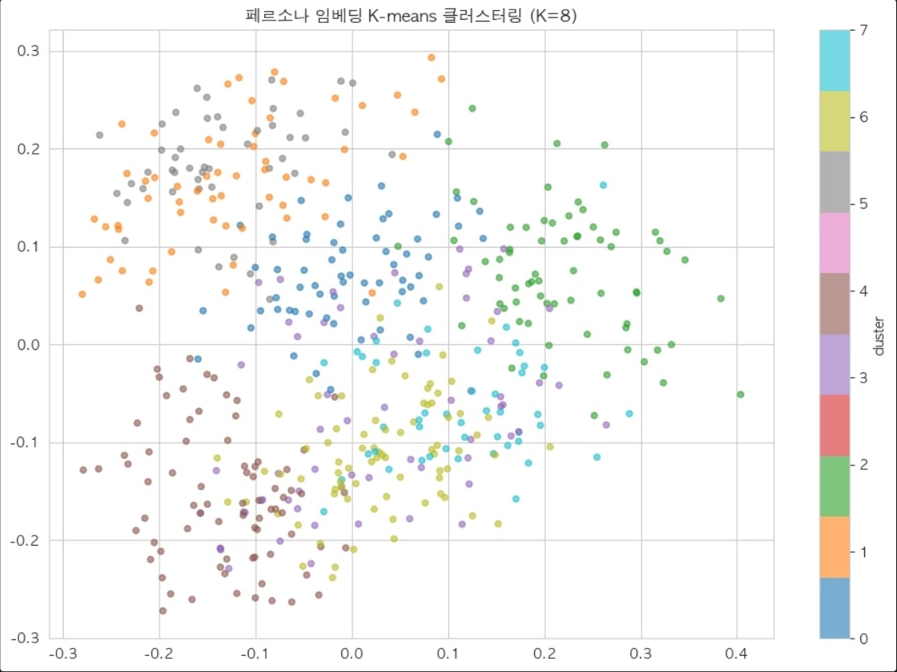
페르소나 임베딩의 K-means 군집 분포 — K=8
질문과 점수, 판단 이유를 함께 남겼다
선택한 페르소나에게 배너와 카피를 보여주고, 광고를 클릭해 더 알아보고 싶은 정도를 0~10점으로 평가하게 했다. 각 페르소나의 점수를 평균 내 배너별 click_intent를 구한 뒤 실제 CTR과 비교했다. 점수와 함께 판단 이유도 받아, 어떤 프로필이 어떤 이유로 광고에 반응하는지 확인하려 했다.
전연령과 20~39세 조건에서 나온 결과
전연령 층화 표본에서 배너 14개를 비교한 결과, 상관계수는 -0.219였다. 페르소나가 더 높은 점수를 준 배너가 실제로 더 높은 CTR을 보이지 않았다. 비교한 소재 수가 적어서 이 실험만으로 예측력을 판단하기도 어려웠다.
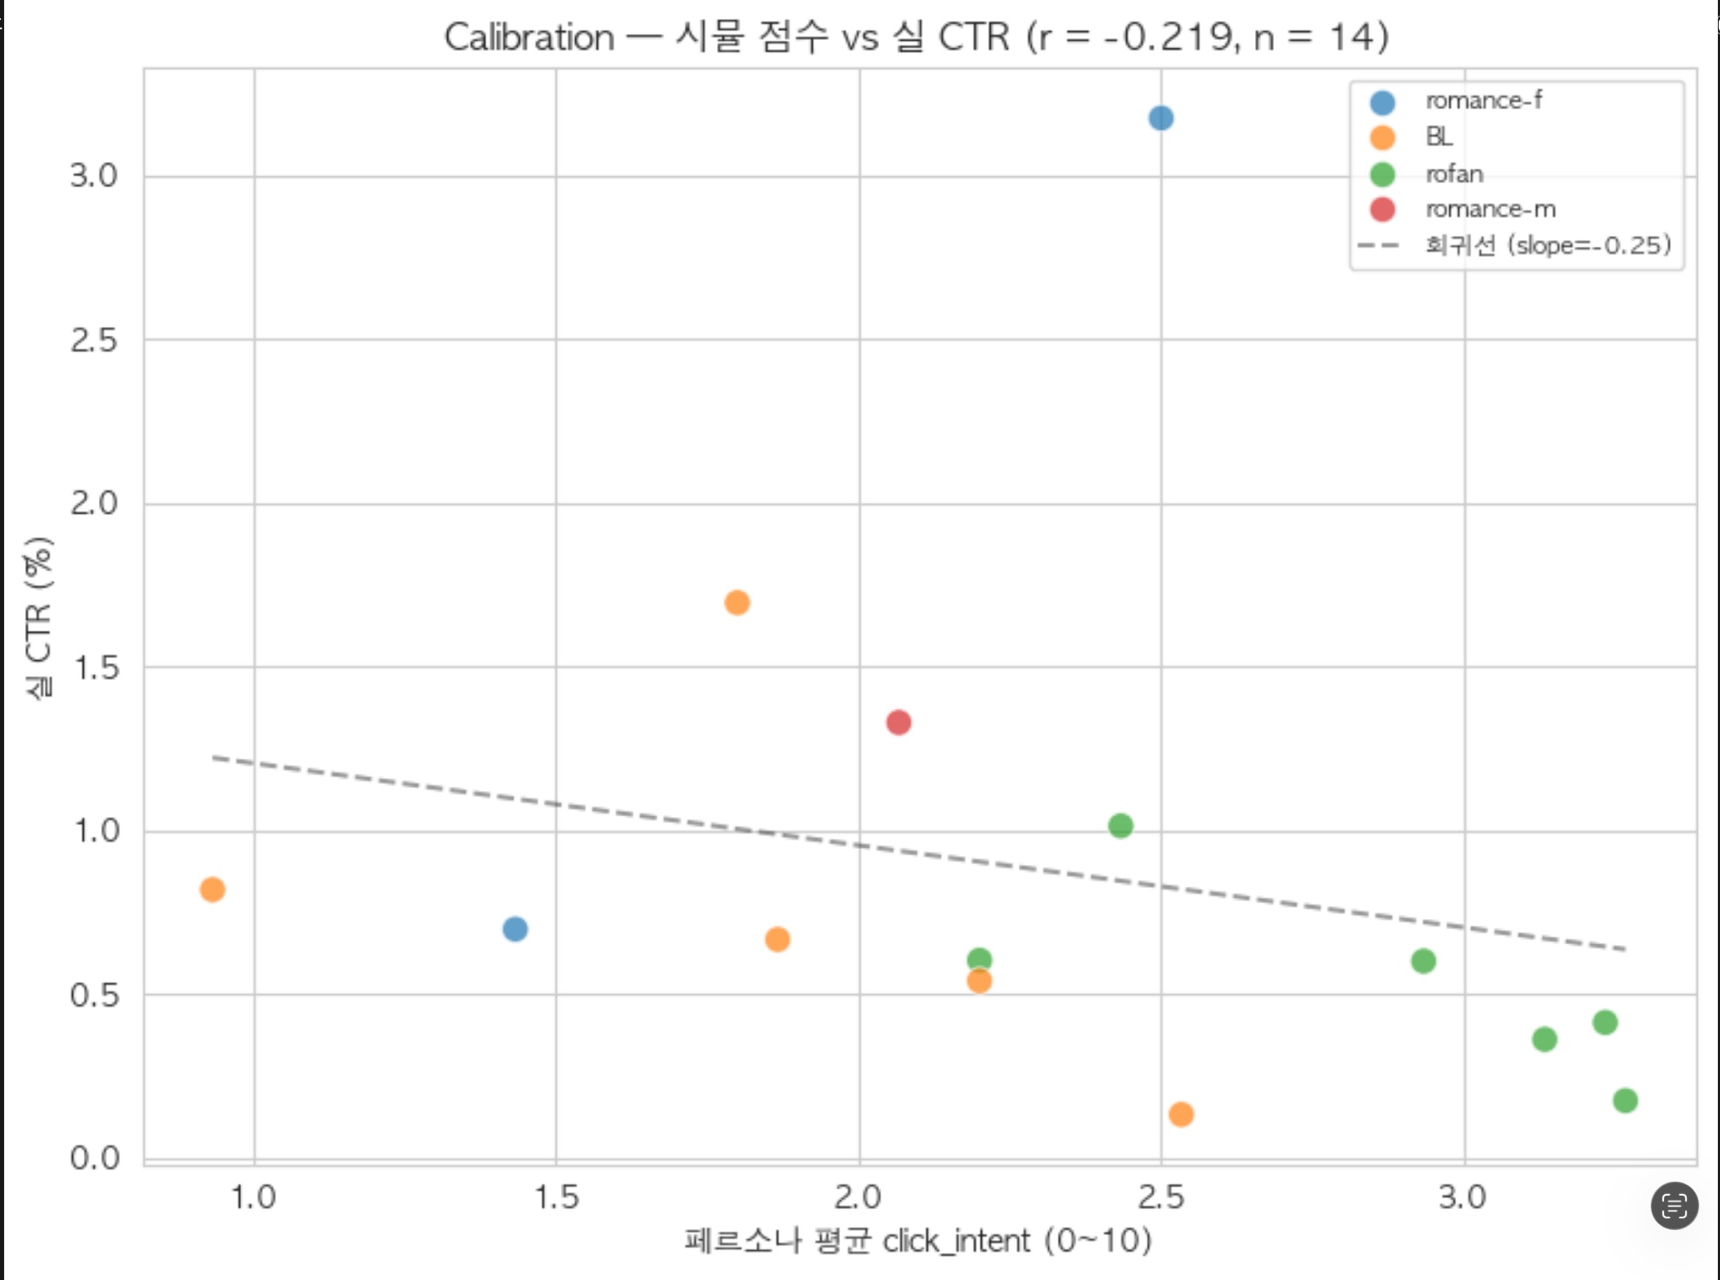
전연령 층화 표본 — 실제 CTR과 평균 click_intent 비교: r=-0.219, n=14
20~39세로 평가 집단을 좁혀 배너 86개를 비교했을 때 상관계수는 0.079였다. 약한 양의 상관이지만, 활용 기준으로 생각했던 0.5와는 차이가 컸다. 이 조건에서는 평가가 전반적으로 긍정적인 쪽으로 치우치는 현상도 확인했다. 높은 점수를 받는 것만으로는 배너의 실제 성과를 잘 구분할 수 없었다.
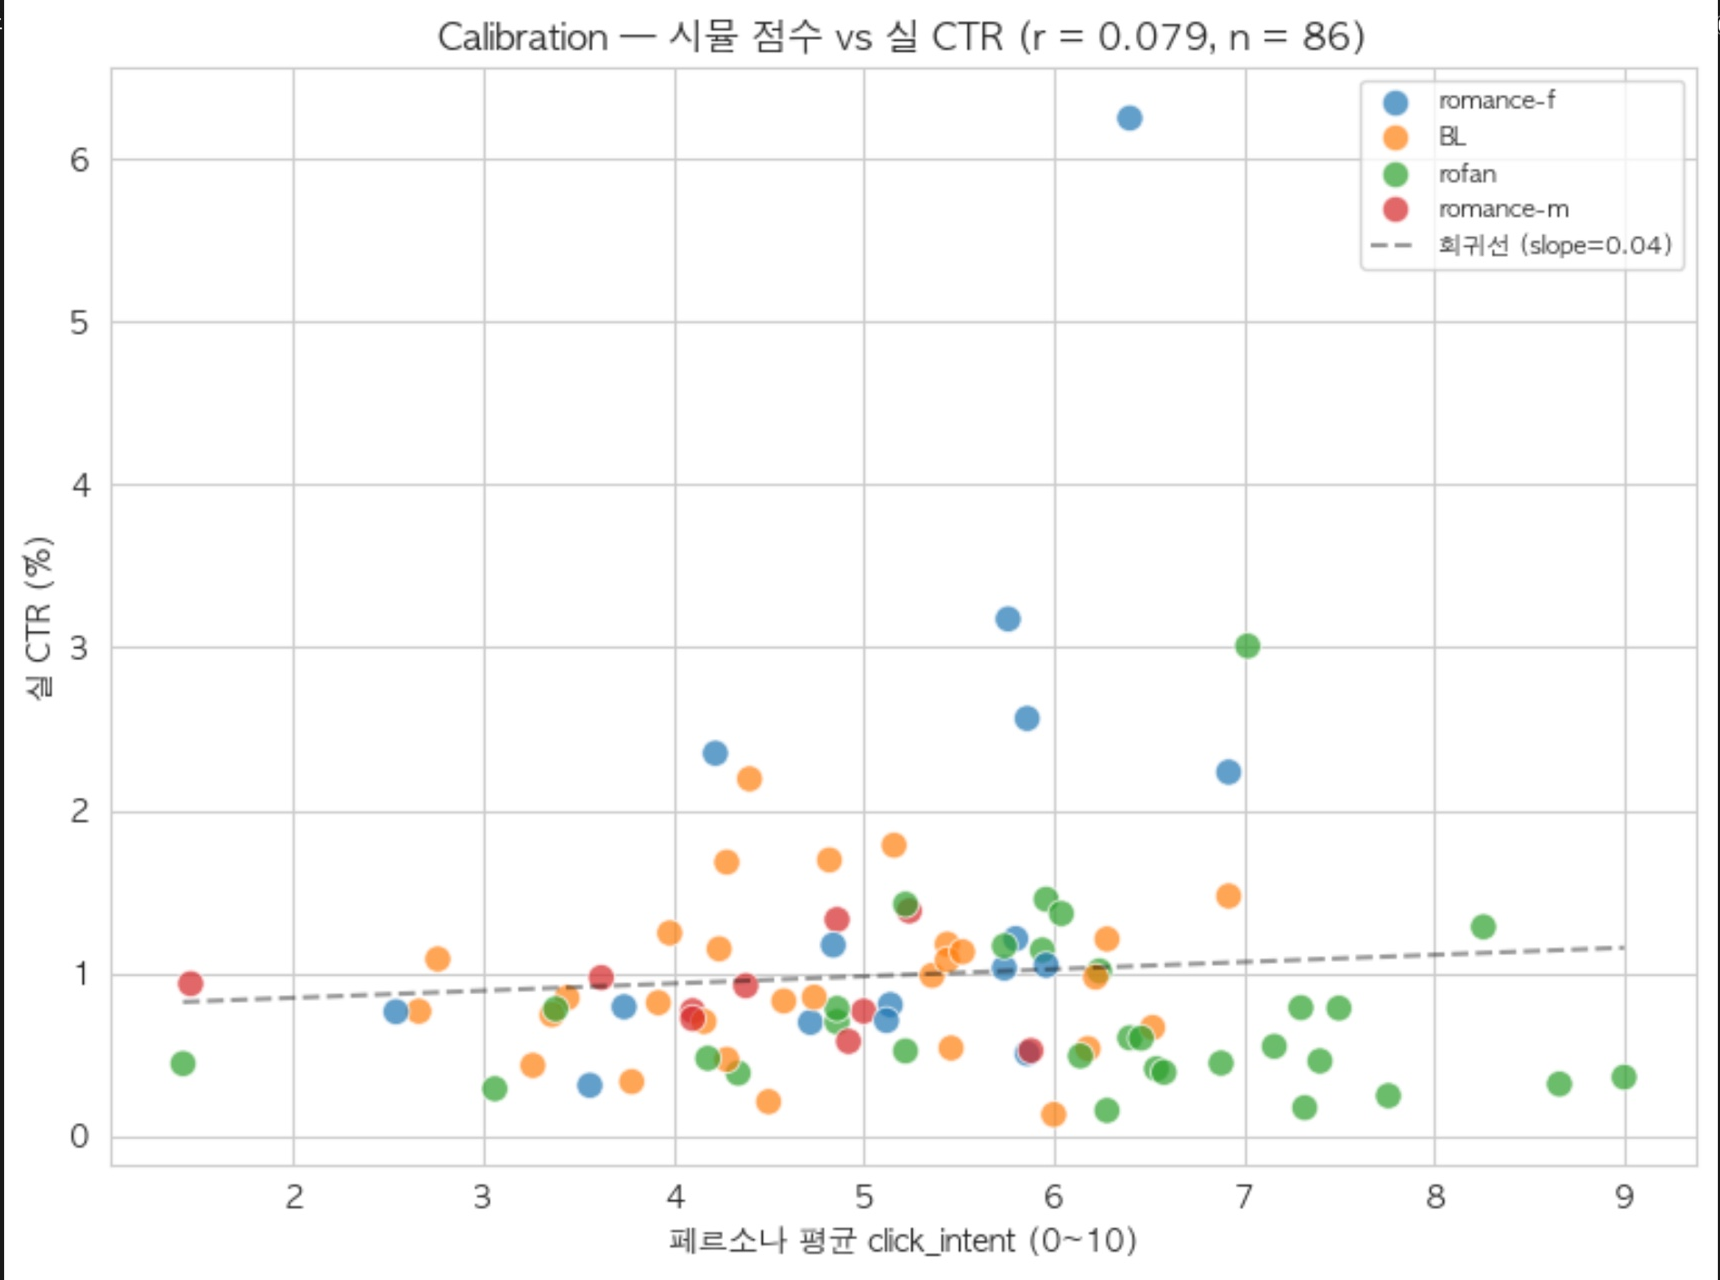
20~39세 표본 — 실제 CTR과 평균 click_intent 비교: r=0.079, n=86
실험 2를 정리할 때의 상관계수는 -0.048이고, 배너 86개를 비교한 결과는 +0.079다. 두 비교의 실행 조건과 표본이 같은지 확인하지 못해 결과를 구분했다. 어느 쪽도 당시 목표였던 0.5에는 도달하지 못했다.
페르소나별 점수 기준을 보정해본 비교
배너 88개에 대해서는 원점수 평균과 페르소나별 Z-score 평균도 비교했다. 실제 CTR과의 상관계수는 원점수 평균을 쓰면 0.292, Z-score 평균을 쓰면 0.321이었다.
페르소나마다 점수를 후하게 주거나 박하게 주는 차이를 줄이려고, 각 점수를 (점수 - 개인 평균) / 개인 표준편차로 바꾼 뒤 배너별로 평균 냈다. 각자가 평소보다 얼마나 높게 평가했는지 비교하는 Z-score 보정이다.
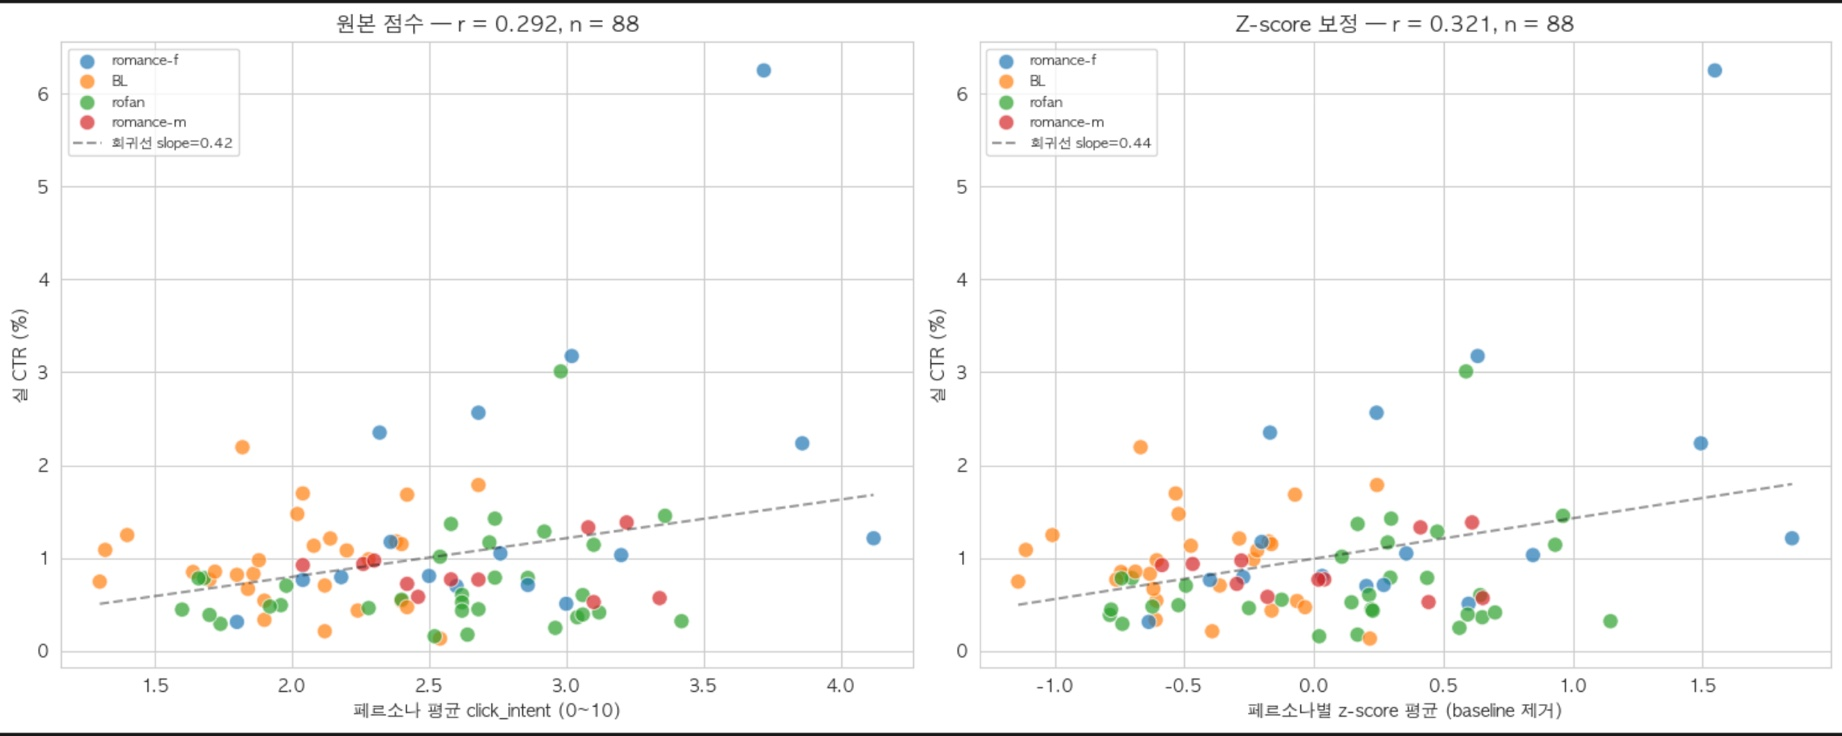
원본 평균 점수와 페르소나별 Z-score 보정 비교 — r=0.292 → 0.321, n=88
| 비교 자료 | 배너 표본 수 n | 상관계수 r |
|---|---|---|
| 전연령 층화 산점도 | 14 | -0.219 |
| 20~39세 산점도 | 86 | 0.079 |
| 추가 비교: 원본 평균 점수 | 88 | 0.292 |
| 추가 비교: Z-score 보정 | 88 | 0.321 |
상관계수는 0.029 높아졌지만, 이 차이만으로 비정상적으로 커졌다거나 예측력이 유의미하게 개선됐다고 판단하지 않았다. 집행 후보를 자동으로 거를 기준인 0.5에도 미치지 못했다. 배너 88개를 비교한 조건과 세 번째 클러스터 실험의 조건이 같은지 확인하지 못했으므로 두 결과는 구분했다.
예측에 필요한 서비스 취향 정보가 부족했다
결과를 보고 가장 먼저 생각한 한계는 feature였다. Nemotron Persona에는 나이, 결혼 여부, 지역, 직업, 취미 같은 일반적인 인구통계와 생활 정보가 있었다. 하지만 우리가 알고 싶은 것은 서브컬처 배너를 보고 클릭할지, 크랙 서비스를 이용하고 비용을 지불할지였다. 이 행동을 직접 설명하는 서비스 관련 feature는 없었다.
취미나 생활 맥락을 자세히 적은 프로필이라고 해도, 그 정보만으로 우리 서비스에 대한 선호를 알 수 있을지는 별개의 문제였다. 각 feature와 크랙 이용 여부의 상관관계를 따로 측정한 것은 아니다. 다만 이번 CTR 예측 실험에서 나온 낮은 상관을 보고, 일반적인 프로필 정보만으로는 우리 서비스의 광고 반응을 설명할 신호가 부족했을 것이라고 추정했다. 결제 의향을 검증한 실험도 아니었으므로 클릭 결과를 결제 예측으로 확장할 수는 없었다.
여러 feature를 결합한 집단의 신뢰도도 보장되지 않았다
NVIDIA의 공식 데이터셋 카드는 공개 데이터와 생성 모델의 제약 때문에 일부 변수 간 독립성을 가정했다고 설명한다. 예를 들어 세부 직업을 배정할 때 성별, 소득, 학력, 전공이 독립적으로 영향을 준다고 가정하며, 성별과 전공의 결합 효과 같은 교호작용은 반영하지 않는다.
이 설명을 모든 feature를 반드시 따로 써야 한다는 사용 규칙으로 읽을 수는 없다. 다만 개별 분포가 현실과 비슷하다는 것만으로, 여러 조건을 동시에 만족하는 페르소나 집단까지 실제 사용자 집단을 잘 대표한다고 볼 수는 없었다. 나는 연령·성별·교육·직업·지역을 함께 사용하고, 프로필을 임베딩해 서비스에 관심을 가질 만한 집단을 고르려 했다. 이 과정에서는 데이터셋이 충분히 검증하지 않은 변수 간 관계까지 신뢰하는 셈이었다.
여러 feature를 합쳐 평가 집단을 정교하게 만들려고 했지만, 실제로는 그 집단의 대표성에 대한 불확실성을 더할 수 있는 방향이었다. 이 결합이 상관계수를 얼마나 낮췄는지 따로 검증하지는 않았다. 그래서 실패 원인으로 확정하기보다는, 실험 설계에서 충분히 고려하지 못한 데이터셋의 한계로 남겼다.
결국 광고 집행 필터로 사용하지 않았다
원래 구상은 장르별 배너를 먼저 생성하고, 페르소나로 시뮬레이션한 뒤, 기준 미만인 후보를 제외하는 흐름이었다. 하지만 이번 실험은 상관계수 0.5라는 활용 기준을 충족하지 못했다. 서비스 선호를 직접 설명할 feature가 부족했고, 여러 feature를 결합해 만든 평가 집단의 대표성도 신뢰하기 어려웠다. 이 두 한계와 실제로 확인한 낮은 예측력을 바탕으로, Nemotron Persona를 이용한 CTR 예측은 광고 운영에 사용하지 않기로 했다.
시간상 충분한 표본을 확보하지 못한 점도 있었지만, 표본 수만 늘리면 해결될 문제라고 보지는 않았다. 우리 서비스와 관련된 취향·이용 행동 정보가 없는 상태에서 페르소나를 더 많이 뽑는다고 필요한 신호가 생기는 것은 아니기 때문이다. 질문 형식과 점수 보정, 집단 선택을 바꿔본 기록은 남겼지만, 실제 집행 후보를 고르는 파이프라인에는 붙이지 않았다.
Continue exploring
더 읽어보기
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...
한국에서 만든 광고 파이프라인을 북미·일본으로 확장하기
광고 소재 제작 파이프라인은 크랙에서 먼저 만들었다. 이후 북미 OOC와 일본 캬라푸로 확장했다. 이미 돌아가는 생성 흐름이 있으니 언어만 바꾸면 될 것 같지만, 실제로는 입력 데이터와 UI, 폰트, 디자인 레퍼런스가 달랐다.