[영화리뷰 감성분류][모델최적화]하이퍼파라미터튜닝2
[모델최적화]하이퍼파라미터튜닝2
Introduction
- 하이퍼파라미터 튜닝
- Focal Loss에서 알파 가중치를 얼마나 줘야할까?
- 최적의 알파 가중치는 얼마일까?
- 이외에 하이퍼파라미터 튜닝할 수 있는값 모두 넣기
- Focal Loss에서 알파 가중치를 얼마나 줘야할까?
- valid 데이터를 포함해서 전체 데이터를 기준으로 학습시켜보기
- 모델 앙상블 추론을 할때, 모델별로 Weight를 줘서 앙상블을 해보기
이전 실험까지를 대략 요약하자면 데이터셋이 불균형 데이터라고 생각해서FocalLoss의 \(\alpha\)가중치를 각 레이블의 비율의 역수를 정규화해서 가중치로 두었다. 하지만, 그렇게 가중치를 준게 오히려 test/acc성능에는 악영향을 미친것을 확인할 수 있었다. 즉 소수클래스에 가중치를 둔게 오히려 대다수의 클래스를 맞추는데 악영향을 미쳤고, 전체 test/acc성능이 하락함을 확인할 수 있었다. 그러면 최적의 알파 가중치를 찾으려면 어떻게해야할까? 바로 하이퍼파라미터 튜닝이다. 따라서 이번 실험에서는 최적의 FocalLoss의 \(\alpha\)가중치를 찾으면서, 그외에도 이전에 구현한 SWA에서 평균낼 체크포인트의 개수, FocalLoss의 \(\gamma\)등 다른 하이퍼파라미터도 함께 튜닝을 해서 모델의 최적 성능을 뽑아볼 예정이다.
FocalLoss의 \(\alpha\)는 클래스 개수만큼의 리스트원소를 튜닝할 수 없으므로 일반적으로 아래 식을 이용해서 하나의 \(\beta\)만 튜닝한다고 한다.
\[W_{final} = (1-\beta)\cdot W_{inversefreq} + \beta\cdot W_{uniform}\]즉 균등분포가중치[0.25,0.25,0.25,0.25]와 빈도 백분율역수가중치를 \(\beta\)를 하이퍼파라미터로 해서 얼마나 섞어서 최종 가중치로 계산할지 결정하는 것이다. 따라서 하이퍼파라미터 튜닝에 ‘alpha_beta_smooth’라는 값을 넣어주었다.
하이퍼파라미터 튜닝
최적화 해야할 하이퍼파라미터 목록
sweep_config = {
    'method': 'bayes',
    'metric': { 'name': 'eval/accuracy', 'goal': 'maximize' },
    'parameters': {
        'learning_rate': { 'distribution': 'log_uniform_values', 'min': 1e-6, 'max': 5e-5 },
        'num_train_epochs': { 'values': [5, 8, 10, 12] },
        'weight_decay': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.1 },
        'per_device_train_batch_size': { 'values': [64, 128, 256] },
        'per_device_eval_batch_size': { 'values': [64, 128, 256] },
        'warmup_steps': { 'distribution': 'q_uniform', 'min': 100, 'max': 1000, 'q': 50 },
        'focal_loss_gamma': { 'distribution': 'uniform', 'min': 0.5, 'max': 5.0 },
        'label_smoothing_factor': { 'distribution': 'uniform', 'min': 0.0, 'max': 0.2 },
        #'dropout_rate': { 'distribution': 'uniform', 'min': 0.05, 'max': 0.3 },
        'lr_scheduler_type': { 'values': ['cosine', 'linear', 'constant'] },
        'gradient_accumulation_steps': { 'values': [1, 2, 4] },
        'num_rare_words_to_remove': { 'values': [0, 3, 5, 10] } # 추가됨
        'alpha_beta_smooth': {
            'min': 0.0,
            'max': 1.0,
            'distribution': 'uniform' # 0.0에서 1.0 사이를 균등하게 탐색
        },# Focal Loss 알파의 가중치 비중을 탐색
        'SWA_K': {'values':[2,3,4]
        }
        'early_stopping_patience' : {'values':[2,3,4]}
    }
}
하이퍼파라미터 튜닝은 실험을 통해서 단일모델중 가장 최적의 성능을 보였던 kykim/bert-kor-base 모델로 진행했다. 모델의 아키텍처마다 최적의 하이퍼파라미터가 다르기 떄문에, 사용할 모델 모두 하이퍼파라미터 튜닝을 진행해야하지만, 대회 시간이 촉박해서 하나의 모델로밖에 튜닝을 해보지 못했다.. 이부분은 아쉽다. 다음에 대회에 참가할 기회가 생긴다면 실험 스케줄러를 만들어서 24시간동은 GPU를 굴리면서 가능한 모든 실험을 해볼 수 있도록 할것이다.
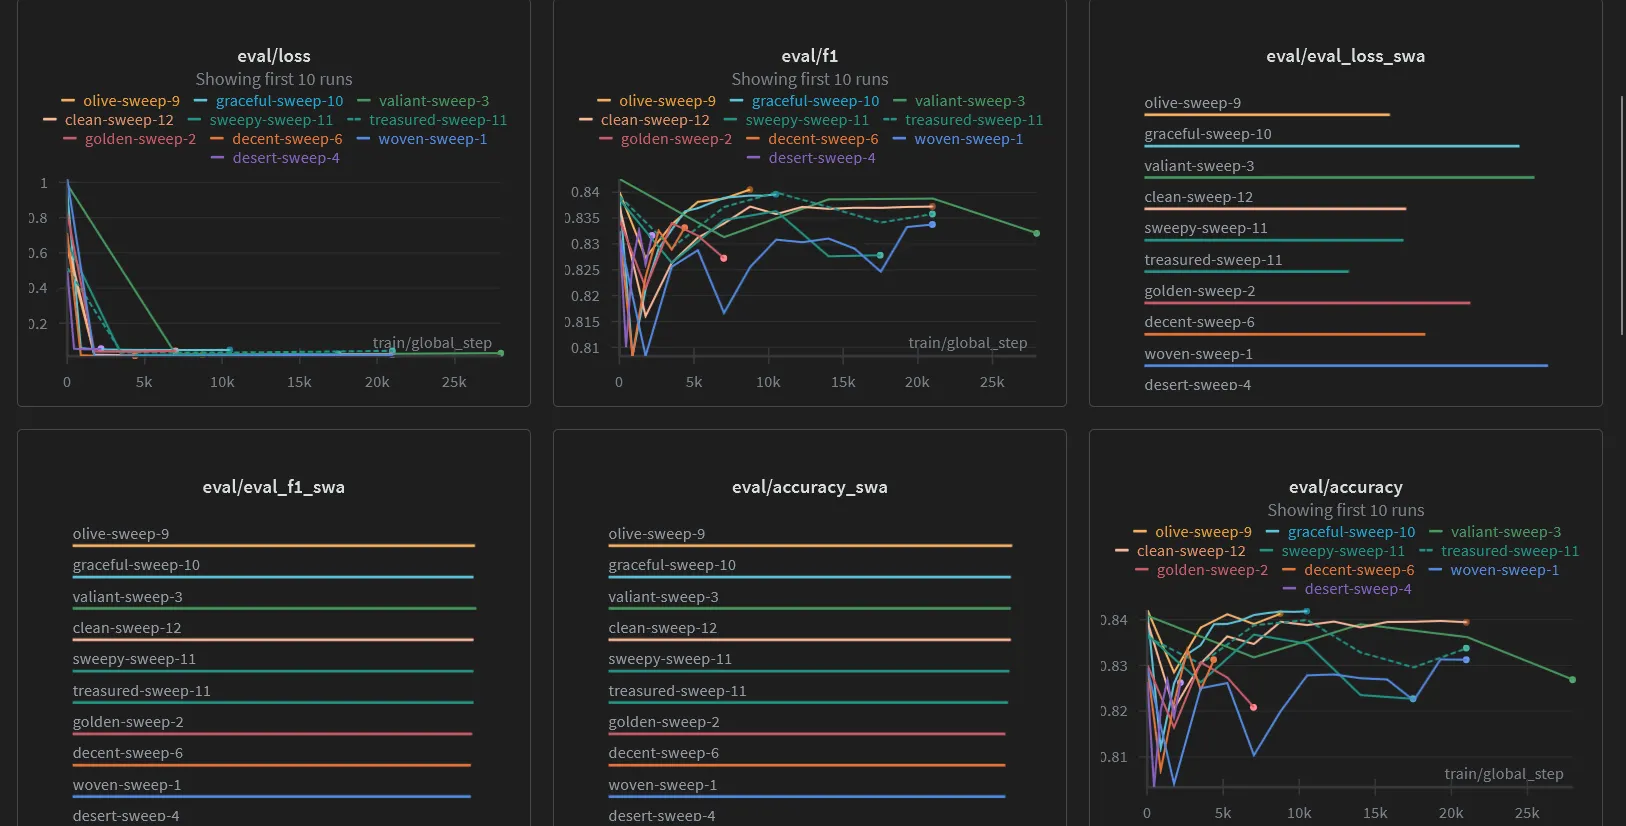
튜닝결과 eval/accuracy_swa에서 가장 좋은 성능을 낸 9번째 하이퍼파라미터를 사용하기로 했다. 하이퍼파라미터 튜닝을 하기 전에는 0.85의 accuracy가 나왔지만, 하이퍼파라미터 튜닝 후 0.84가 나왔다. 이를 봐서는 베이지안 방식으로 하이퍼파라미터 튜닝이 아직 완벽하게 되지 않은것처럼 보였지만, 일단 시간관계상 이 하이퍼파라미터를 사용하기로 했다.
{
    'learning_rate': 0.00000937759265615758,
    'num_train_epochs': 5,
    'weight_decay': 0.03423148594790665,
    'per_device_train_batch_size': 32,
    'per_device_eval_batch_size': 256,
    'warmup_steps': 400,
    'focal_loss_gamma': 4.194768435552584,
    'label_smoothing_factor': 0.03442149572139974,
    'lr_scheduler_type': 'linear',
    'gradient_accumulation_steps': 4,
    'num_rare_words_to_remove': 0,
    'alpha_beta_smooth': 0.17235143553564636,
    'SWA_K': 4,
    'early_stopping_patience': 4
}
튜닝된 하이퍼파라미터 결과를 보자면 알파는 거의 균등분포값에 가까운 가중치를 갖는다. 이전 실험까지의 인사이트와 이번 실험결과를 종합해 봤을때, [0.25,0.25,0.25,0.25] 즉 가장 eval/acc를 높이는 방향은 균등분포값에 가까운 가중치를 알파로 줘야한다는 인사이트를 얻었다. 실제로 test/acc를 관찰해본 결과, 하이퍼파라미터 튜닝을 통해 얻은 \(\alpha\)가중치를 쓰는것보다 균등분포 가중치를 주는것이 오히려 test/acc가 높음을 확인할 수 있었다. 아마 최적의 하이퍼파라미터를 찾기 전에(13step) 하이퍼파라미터 탐색을 중지해서 이런 결과가 나온것 같다.
결과
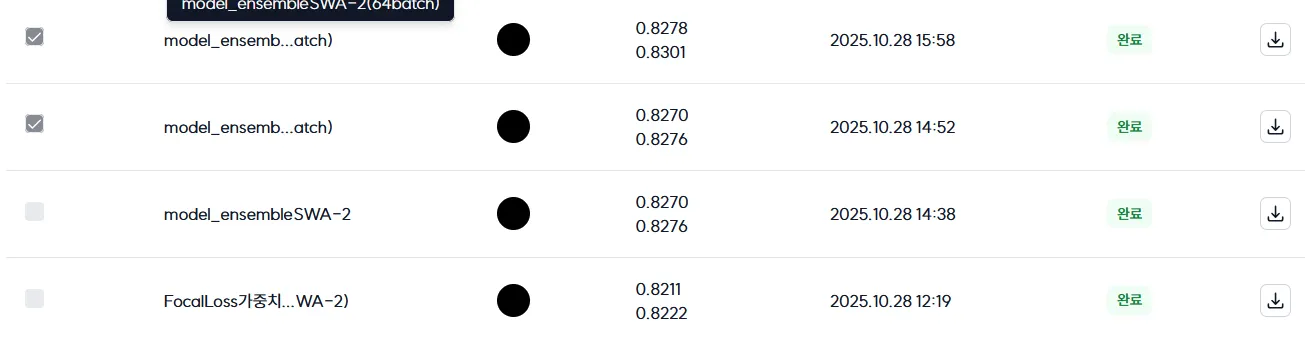
맨아래는 단일모델 결과, 위의 3가지는 SWA와 모델별 앙상블 경우의수를 다르게 해서 test한 결과이다. 결과적으로 이번실험에서는 BERT기반 모델 3개를 앙상블하고, 알파가중치를 [0.25,0.25,0.25,0.25]로 두고, test/acc를 한 결과 가장 높은성능인 0.8278의 성능을 확인할 수 있었다. 추후 Public socre에서도 0.8301로 내가 실험해본 모델중에서는 가장 높은 성능을 보였다.
한계점 및 반성
하이퍼파라미터 튜닝을 하는데에는 상당한 시간이 든다. 베이지안 서치를 하더라도, 최소 15번 이상은 모델을돌려야 하고, 모델마다의 최적의 하이퍼파라미터는 다르므로, 앙상블할때 사용할 모든 모델에 대해서 하이퍼파라미터 튜닝을 해야한다. 그리고 15번 베이지안 서치를 한다고 해서 최적의 하이퍼파라미터를 얻는다는 보장은 없으므로, 어느정도 모델성능이 최적점에 수렴하는것을 확인할때까지 하이퍼파라미터튜닝을 해야한다. 실제로 이번 대회가 끝나고 오피스아워에서 멘토님이 하시는 말을 들어보니, 다른 대회에서도 최적의 모델을 우선 정한다음에, 대회가 끝날때직전까지 최적의 하이퍼파라미터를 찾는다고 한다. 이번 대회가 첫경험이라, 최적의 모델을 먼저 찾을 생각을 하지 못했고, 모델마다 최적의 하이퍼파라미터를 찾을 생각도 하지 못했다. 모델의 변경사항이 생길때마다 하이퍼파라미터는 달라질텐데, 그떄마다 하이퍼파라미터 튜닝을 다시 할 순 없으므로 가장 마지막에 튜닝을 해야하는것도 이번 대회를 통해 배우게 됐다.
이후 실험에서 고려해야 할 것들
- tapt적용
- 전체데이터에 대해서 5개모델 다시 학습 후 앙상블 → 시간부족으로 못해봄
- 전체데이터셋으로 학습시킨 모델 효과있는지 실험→ 시간부족으로 못해봄
- 5개모델 acc를 Weight로 줘서 앙상블
- 역번역증강 사용할지 말지 결정 → 번역의 품질이 안좋아서 결국엔 사용 x
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...