[이미지기반 카페추천 프로젝트] Apache Airflow 파이프라인 자동화 구현
Apache Airflow 파이프라인 자동화 구현
Apache Airflow 파이프라인 자동화 구현
목차
도입 배경 및 문제 정의
기존 문제점
서울 전역의 카페 데이터를 수집하고 처리하는 파이프라인을 수동으로 단계별 순차 실행하고 있었음.
크롤링이 가장 오래걸리는 작업인데, 서울내 모든 동네(약 420개)에 대해서 크롤링이 끝나야만 다음단계로 넘어가는것은 매우 비효율적임.
❌ 기존 방식: 단계별 순차 실행 (수동)

[Step 0] 전체 동네 크롤링 완료 대기
              ↓ (전체 완료 후)
[Step 1] 전체 동네 대표 이미지 추출
              ↓ (전체 완료 후)
[Step 2] 전체 동네 VLM 묘사 생성
              ↓ (전체 완료 후)
[Step 3] 전체 동네 리뷰 요약
              ↓ (전체 완료 후)
[Step 4] 전체 동네 임베딩 생성
              ↓
         DB 적재

→ 각 단계가 "전체 동네" 완료를 기다려야 다음 단계 시작
→ 앞서 완료된 동네도 뒤처진 동네를 기다리며 유휴 상태
→ 한 단계 실패 시 전체 재실행 필요
문제점 요약
| 문제 | 설명 |
|---|---|
| 단계별 병목 | 한 단계가 전체 동네에서 완료되어야 다음 단계 시작 가능 |
| 유휴 시간 발생 | 빨리 끝난 동네도 느린 동네를 기다리며 대기 |
| 수동 개입 | 각 단계 완료 후 다음 단계 수동 실행 필요 |
| 실패 복구 어려움 | 중간 실패 시 해당 단계 전체 재실행 |
| 스케줄링 없음 | 정기적인 자동 실행 불가 |
해결 방안: Apache Airflow 도입
핵심 변경: 단계별 전체 처리 → 동네 단위 독립 파이프라인
- Task 의존성을 DAG로 정의하여 동네별 파이프라인 자동 실행
- 동네 단위 병렬 처리: 완료된 동네부터 다음 단계 즉시 진행 (대기 X)
- 스케줄링으로 정기적 자동 실행
- 실패 Task만 재시도하여 복구 효율화
파이프라인 아키텍처
전체 데이터흐름
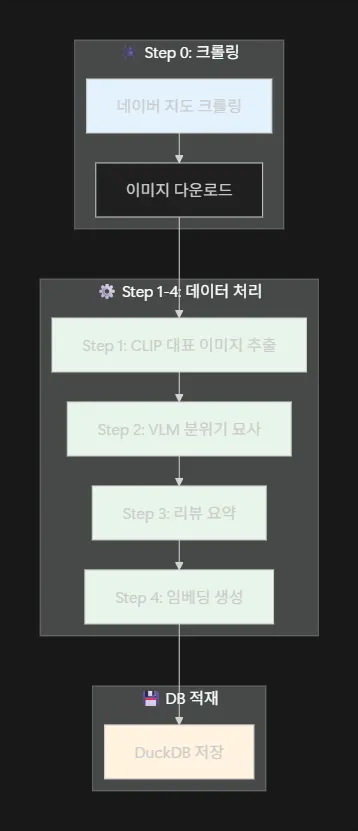
파일 구조
src/pipeline/
├── _00_image_extraction.py           # 이미지 다운로드
├── _01_extract_representative_images.py  # CLIP 대표 이미지
├── _02_generate_vlm_descriptions.py  # VLM 묘사 생성
├── _03_summarize_reviews.py          # 리뷰 요약
├── _04_generate_embeddings.py        # 임베딩 생성
└── airflow/
    └── dags/
        ├── cafe_monthly_full_pipeline.py    # 월간 전체 파이프라인
        └── cafe_weekly_review_pipeline.py   # 주간 리뷰 업데이트
단계별 스크립트 설명
| Step | 스크립트 | 역할 | 사용 모델 |
|---|---|---|---|
| 0 | _00_image_extraction.py |
크롤링된 JSON에서 이미지 URL 추출 및 다운로드 | - |
| 1 | _01_extract_representative_images.py |
카페별 대표 이미지 5장 선정 | CLIP |
| 2 | _02_generate_vlm_descriptions.py |
이미지 분위기 묘사 텍스트 생성 | Qwen2.5-VL-7B |
| 3 | _03_summarize_reviews.py |
리뷰 텍스트 요약 | Gemma3 |
| 4 | _04_generate_embeddings.py |
이미지/텍스트 벡터 임베딩 | SigLIP v2 |
DAG 설계 및 구현
2개의 DAG 설계
서로 다른 주기와 목적을 가진 2개의 DAG을 설계함.
| DAG | 스케줄 | 목적 | 처리 범위 |
|---|---|---|---|
cafe_monthly_full_pipeline |
매월 1일 03:00 | 전체 데이터 갱신 | 크롤링 + 이미지 + 임베딩 |
cafe_weekly_review_pipeline |
매주 토요일 02:00 | 리뷰만 업데이트 | 리뷰 크롤링 + 요약 |
월간 전체 파이프라인 (cafe_monthly_full_pipeline.py)
from datetime import datetime, timedelta
from airflow import DAG
from airflow.operators.bash import BashOperator
from airflow.sensors.filesystem import FileSensor
from airflow.decorators import task, task_group

with DAG(
    'cafe_monthly_full_pipeline',
    default_args=default_args,
    description='서울 카페 월간 파이프라인 (Streaming & GPU Optimized)',
    schedule_interval='0 3 1 * *',  # 매월 1일 03:00 (KST)
    start_date=datetime(2026, 1, 25),
    catchup=False,
    tags=['cafe', 'monthly', 'streaming', 'gpu_pool'],
    max_active_runs=1,
) as dag:
월간 전체 파이프라인은 크론표현식으로 매월 1일 새벽 3시에 자동 실행됨.
max_active_runs=1로 동시 실행을 방지하고, catchup=False로 과거 미실행 건은 스킵함.
주간 리뷰 파이프라인 (cafe_weekly_review_pipeline.py)
with DAG(
    'cafe_weekly_review_pipeline',
    default_args=default_args,
    description='서울 카페 주간 리뷰 업데이트 파이프라인 (text-only)',
    schedule_interval='0 2 * * 6',  # 매주 토요일 02:00 (KST)
    start_date=datetime(2026, 1, 25),
    catchup=False,
    tags=['cafe', 'weekly', 'review', 'text-only'],
    max_active_runs=1,
) as dag:

    # 리뷰만 크롤링 (이미지 스킵)
    crawl_reviews = BashOperator(
        task_id='crawl_reviews',
        bash_command=f'''
            cd{CRAWLER_PATH} &&\
            python main.py --mode parallel --target text-only
        ''',
    )

    # 리뷰 요약
    summarize = BashOperator(
        task_id='summarize_reviews',
        bash_command=f'cd{PIPELINE_PATH} && python _03_summarize_reviews.py',
    )

    # DB 업데이트
    seed_reviews = BashOperator(
        task_id='seed_reviews',
        bash_command=f'cd{PROJECT_PATH} && python backend/core/seed_weekly_reviews.py',
    )

    # 의존성 정의
    crawl_reviews >> summarize >> seed_reviews
주간 파이프라인은 리뷰만 업데이트함. 리뷰 업데이트를 통해 가게 정보 최신화.
이미지 처리 단계(Step 0, 1, 2, 4)를 스킵하고 리뷰 요약(Step 3)만 실행하여 실행 시간을 대폭 단축.
병렬 처리 및 최적화
1. Dynamic Task Mapping - 동네별 병렬 처리
# 1. 처리할 동네 목록 동적 로드
@task
def get_target_dongs():
    dong_file = f"{CRAWLER_PATH}/seoul_parts/seoul_dongs.json"
    with open(dong_file, 'r', encoding='utf-8') as f:
        dongs = json.load(f)
    return sorted(dongs)  # ['강남구_개포1동', '강남구_개포2동', ...]

# 2. 동네별 Task Group 정의
@task_group(group_id='process_dong')
def process_neighborhood(dong_name):
    # 각 동네별 5단계 파이프라인
    step0 >> step1 >> step2 >> step3 >> step4

# 3. Dynamic Mapping으로 병렬 확장
target_dongs = get_target_dongs()
processed_groups = process_neighborhood.expand(dong_name=target_dongs)
expand()를 사용한 Dynamic Task Mapping으로, 동네 목록의 크기에 따라 Task가 동적으로 생성됨.
만약 10개 동네면 10개의 독립적인 Task Group이 병렬로 실행됩니다. 이를 통해 동네 수가 늘어나도 코드 수정 없이 자동으로 확장.
병렬 처리 시각화
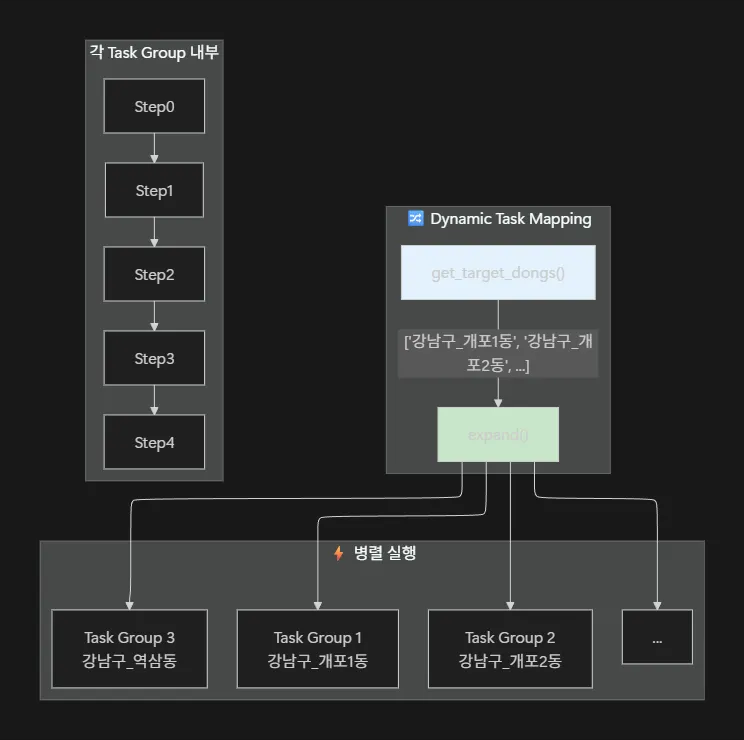
2. Streaming Pipeline - FileSensor
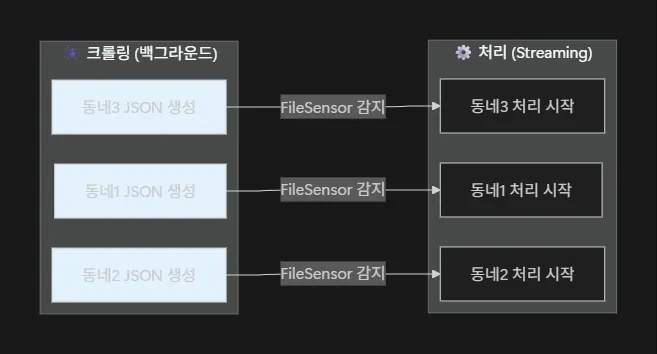
크롤링이 완료된 동네부터 즉시 처리 시작 (전체 크롤링 완료 대기 X)
@task_group(group_id='process_dong')
def process_neighborhood(dong_name):

    # A. 파일 감지 - 해당 동네 JSON이 생성되면 다음 단계 시작
    wait_for_json = FileSensor(
        task_id='wait_for_json',
        filepath=f"{RAW_JSON_DIR}/{dong_name}.json",
        fs_conn_id='fs_default',
        mode='reschedule',        # 대기 중에는 Worker 슬롯 반환
        poke_interval=60 * 5,     # 5분마다 파일 존재 확인
        timeout=60 * 60 * 24,     # 최대 24시간 대기
    )

    # B. 파일 감지 후 처리 시작
    step0_download = BashOperator(...)

    wait_for_json >> step0_download >> step1 >> step2 >> step3 >> step4
FileSensor는 지정된 파일이 생성될 때까지 대기함. mode='reschedule'로 설정하면 대기 중에 Worker 슬롯을 반환하여 다른 Task가 실행될 수 있음.
크롤링이 빠르게 완료되는 동네부터 순차적으로 처리가 시작되어 전체 파이프라인 시간이 단축.
3. GPU Pool - 리소스 관리
GPU를 사용하는 작업들의 동시 실행 수를 제한하여 OOM(Out of Memory) 방지
# GPU 작업은 별도 풀로 제한
step1_clip = BashOperator(
    task_id='step1_clip',
    bash_command=params['cmd_step1'],
    pool='gpu_pool',  # GPU 풀 (슬롯 제한)
)

step2_vlm = BashOperator(
    task_id='step2_vlm',
    bash_command=params['cmd_step2'],
    pool='gpu_pool',  # GPU 풀
)

step3_summary = BashOperator(
    task_id='step3_summary',
    bash_command=params['cmd_step3'],
    pool='gpu_pool',  # GPU 풀
)

step4_embed = BashOperator(
    task_id='step4_embed',
    bash_command=params['cmd_step4'],
    pool='gpu_pool',  # GPU 풀
)
Airflow의 Pool 기능으로 동시 실행 가능한 Task 수를 제한. 이를 통해 각동네가 병렬로 처리되더라도 Vram을 사용하는 작업은 동시실행을 제한해서 GPU 메모리 부족을 방지.
Task 의존성 및 실행 흐름
Task Group 상세 구조
@task_group(group_id='process_dong')
def process_neighborhood(dong_name):

    # 파라미터 준비
    @task
    def prepare_params(name):
        return {
            'sensor_path': f"{RAW_JSON_DIR}/{str(name)}.json",
            'cmd_step0': f'cd{PIPELINE_PATH} && python _00_image_extraction.py --dong-name{str(name)}',
            'cmd_step1': f'cd{PIPELINE_PATH} && python _01_extract_representative_images.py --dong-name{str(name)}',
            'cmd_step2': f'cd{PIPELINE_PATH} && python _02_generate_vlm_descriptions.py --dong-name{str(name)}',
            'cmd_step3': f'cd{PIPELINE_PATH} && python _03_summarize_reviews.py --dong-name{str(name)}',
            'cmd_step4': f'cd{PIPELINE_PATH} && python _04_generate_embeddings.py --dong-name{str(name)}',
        }

    params = prepare_params(dong_name)

    # 파일 감지
    wait_for_json = FileSensor(...)

    # 이미지 다운로드 (Default Pool)
    step0_download = BashOperator(
        task_id='step0_download',
        bash_command=params['cmd_step0'],
        pool='default_pool',
    )

    # GPU 작업 체인 (GPU Pool)
    step1_clip = BashOperator(task_id='step1_clip', pool='gpu_pool', ...)
    step2_vlm = BashOperator(task_id='step2_vlm', pool='gpu_pool', ...)
    step3_summary = BashOperator(task_id='step3_summary', pool='gpu_pool', ...)
    step4_embed = BashOperator(task_id='step4_embed', pool='gpu_pool', ...)

    # 의존성 체인
    wait_for_json >> step0_download >> step1_clip >> step2_vlm >> step3_summary >> step4_embed
각 동네는 독립적인 Task Group으로 처리. prepare_params()에서 동네 이름을 받아 각 스크립트의 --dong-name 인자로 전달.
이미지 다운로드는 네트워크 I/O 위주라 default_pool을, GPU 작업들은 gpu_pool을 사용.
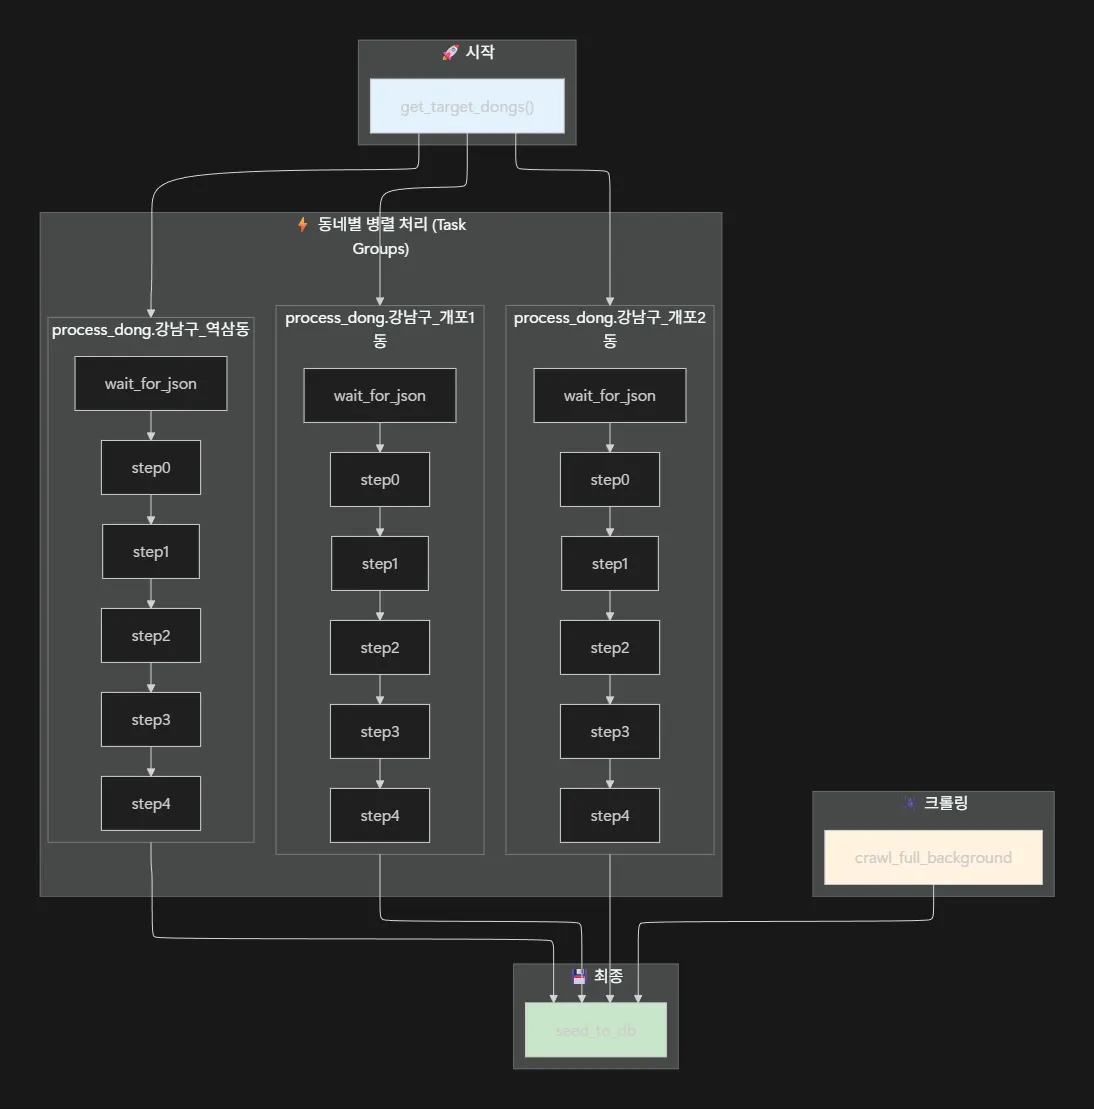
전체 DAG 의존성
# 실행 흐름
target_dongs = get_target_dongs()
processed_groups = process_neighborhood.expand(dong_name=target_dongs)

# 크롤링과 병렬로 진행, 모든 처리 완료 후 DB 적재
crawl_full >> seed_db
processed_groups >> seed_db
crawl_full(크롤링)과 processed_groups(동네별 처리)가 모두 완료되면 seed_db(DB 적재)가 실행됨.
크롤링은 백그라운드에서 계속 진행되고, 각 동네는 FileSensor로 JSON 파일이 생성되면 바로 처리를 시작.
실행 결과 및 성능 개선
이전 vs 이후 비교
| 항목 | 이전 (단계별 순차) | 이후 (Airflow) |
|---|---|---|
| 실행 방식 | 수동 스크립트 실행 | 자동 스케줄링 |
| 처리 단위 | 단계별 전체 동네 | 동네별 독립 파이프라인 |
| 크롤링 대기 | 전체 완료 후 다음 단계 | Streaming (즉시 시작) |
| 유휴 시간 | 느린 동네 대기 (블로킹) | 각 동네 독립 진행 |
| GPU 관리 | 수동 | Pool로 자동 제한 |
| 실패 복구 | 해당 단계 전체 재실행 | 실패 Task만 재시도 |
| 모니터링 | 로그 수동 확인 | Airflow UI |
성능 개선 효과
기존에는 Step1이 “모든 동네에서 완료”되어야 Step2가 시작되었지만, 이제는 “동네1의 Step1”이 끝나면 바로 “동네1의 Step2”가 시작됨.
빠르게 완료된 동네가 느린 동네를 기다리지 않음으로써 가장 큰 병목이었던 크롤링과정에서의 병목을 해결.
완료된 기능
- Apache Airflow DAG로 파이프라인 자동화
- Dynamic Task Mapping으로 동네별 병렬 처리
- FileSensor로 Streaming 파이프라인 구현
- GPU Pool로 리소스 관리 (OOM 방지)
- 월간/주간 스케줄링 자동 실행
- 실패 Task 자동 재시도 (retries=2)
- Task 성공/실패 콜백 로깅
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...