IP침해차단 파이프라인 만들기
광고에 쓸 스토리 이미지에서 확인해야 하는 IP는 애니메이션에 한정되지 않았다. 애니메이션처럼 정해진 도메인의 IP는 WD-Tagger로 태깅한 뒤 걸러낼 수 있었고, ops팀도 이미 이 방식으로 자동 태깅과 필터링을 하고 있었다.
광고에 쓸 스토리 이미지에서 확인해야 하는 IP는 애니메이션에 한정되지 않았다. 애니메이션처럼 정해진 도메인의 IP는 WD-Tagger로 태깅한 뒤 걸러낼 수 있었고, ops팀도 이미 이 방식으로 자동 태깅과 필터링을 하고 있었다. 우리가 더 확인해야 했던 것은 영화, 버튜버, 삼국지나 콜오브듀티 같은 게임의 에셋 IP까지 포함한 범위였다. 태거가 아는 캐릭터만 확인해서는 이 범위를 다루기 어려워 이미지 역검색을 사용했다.
스토리의 2차창작 여부는 서비스 데이터에 필드로 있었다. 처음에는 그 값이 false인 스토리만 광고로 만들었다. 그런데 운영하면서 해당 필드가 false인 작품에 알려진 버튜버 IP가 들어 있는 사례가 생겼다. 신고가 들어온 콘텐츠를 사람이 처리하는 흐름만으로는 광고 생성 앞에서 모든 후보를 확인하기 어려웠다. 이미지의 IP를 찾는 모듈을 따로 만들었고, 그 과정에서 ‘웹에 같은 그림이 있다’는 것과 ‘알려진 IP를 사용했다’는 것이 다르다는 문제를 만나게 됐다.
역검색과 이미지 거리로 시작했다
처음에는 이미지 역검색 결과와 원본 이미지의 유사도를 사용했다. 실제 문제가 있었던 다섯 스토리의 이미지 쌍을 잘 찾는 임베딩 모델을 비교했고, CCIP가 해당 사례에서 높은 유사도를 보여 채택했다.
거리 지표는 (1 - cosine similarity) / 2였다. 값이 작을수록 비슷한 이미지다. 랜덤으로 뽑은 1,000개 스토리의 프로필 이미지에서 점수 분포를 보고, 이미지 쌍을 직접 확인해 0.055를 초기 후보 기준으로 정했다.
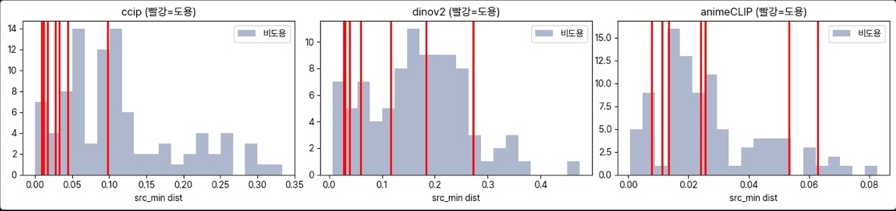
IP 이미지 쌍의 임베딩 모델 비교
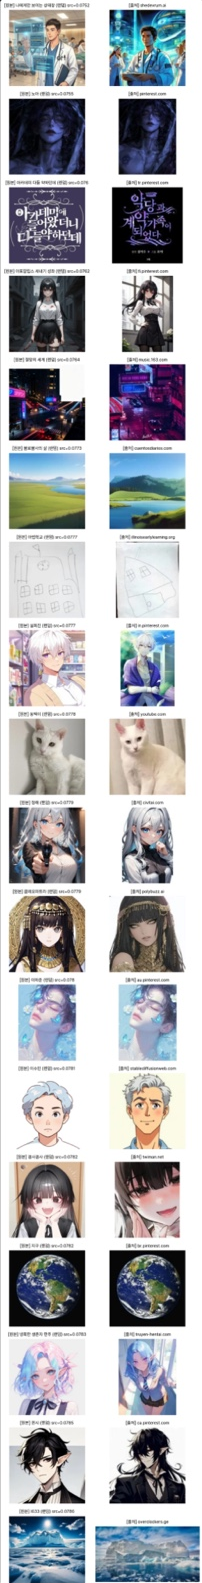
거리 기준을 정하기 위해 확인한 이미지 쌍
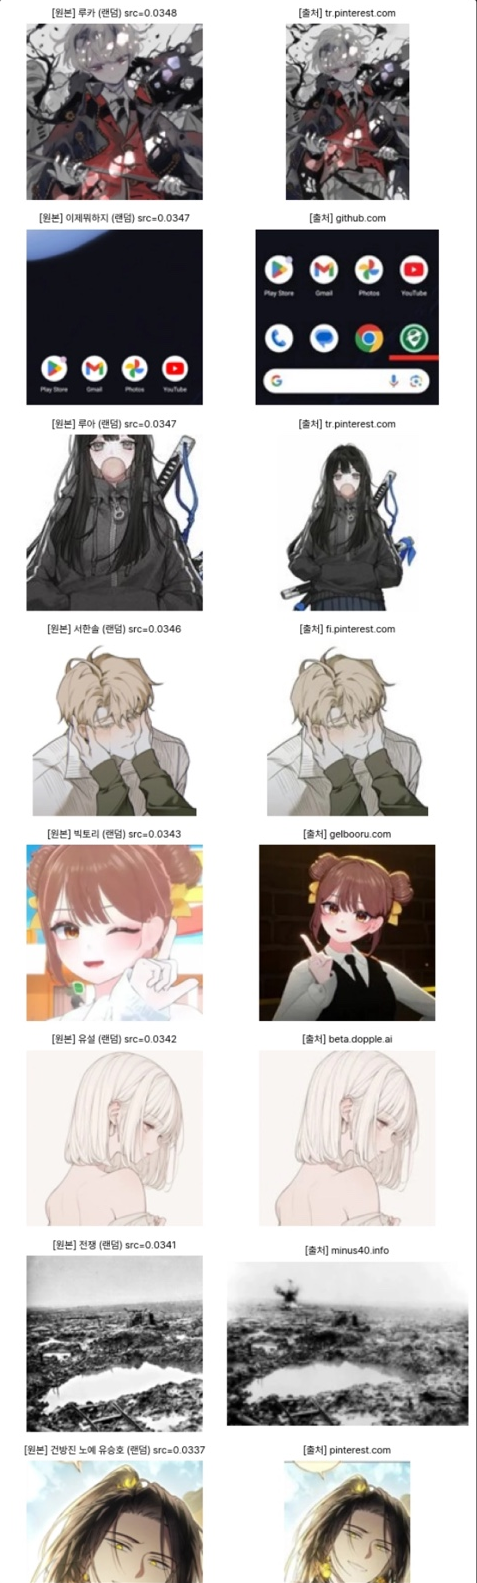
이미지 쌍의 유사도와 오류 사례
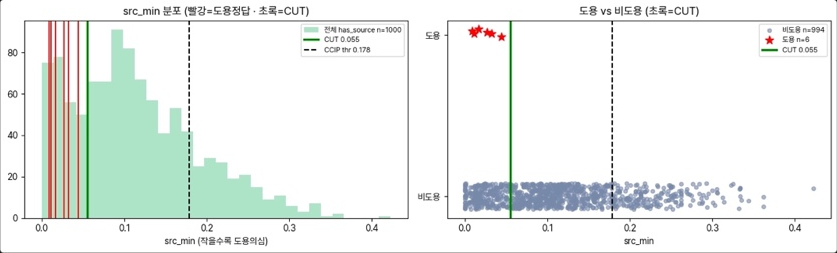
이미지 거리 분포와 후보 임계값
이 방식은 같은 이미지를 찾는 데는 쓸 수 있었지만, 다른 사이트에 그 이미지가 있다는 이유만으로 차단하면 문제가 있었다. 같은 제작자가 여러 캐릭터챗 서비스에 올릴 수도 있고, 누군가 핀터레스트에 재게시했을 수도 있다. 검색 결과만으로 어느 쪽이 원본인지 알 수 없는 경우도 있었다.
광고 제작에서는 애매한 경우까지 보수적으로 막는 선택을 할 수 있었지만, Ops 검수에도 이 기준을 그대로 적용하면 너무 많이 차단됐다. 랜덤 1,000건에서 약 20%가 검열되는 문제가 있어서 기준을 바꿀 필요가 있었다.
검색 결과가 가리키는 엔티티를 보게 했다
사례를 알려진 버튜버·게임·애니 캐릭터·실존인물이 있는 경우, 다른 서비스나 이미지 모음 사이트에 등장하지만 권리 관계가 불명확한 경우, 검수된 오리지널이나 제작자 자체 이미지인 경우로 나눠 봤다.
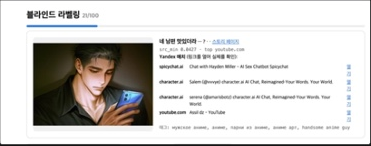
다른 사이트에 등장한 이미지 사례
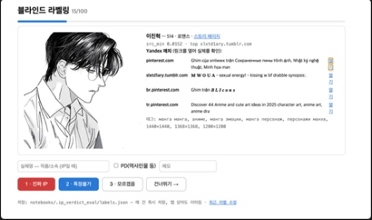
재게시와 IP 식별을 구분해야 하는 사례
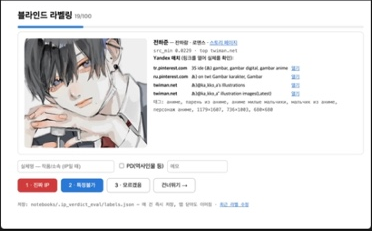
동일 이미지가 검색되는 또 다른 사례
검색 결과를 그대로 차단 판정으로 쓰는 대신, 검색이 제공한 맥락을 LLM이 읽는 단계를 추가했다. 원본과 매치 이미지 쌍, 도메인, 페이지 제목과 URL, 역검색 태그를 함께 넣었다. 스토리 제목과 요약, 프롬프트, 태그도 판정 맥락으로 활용했다.
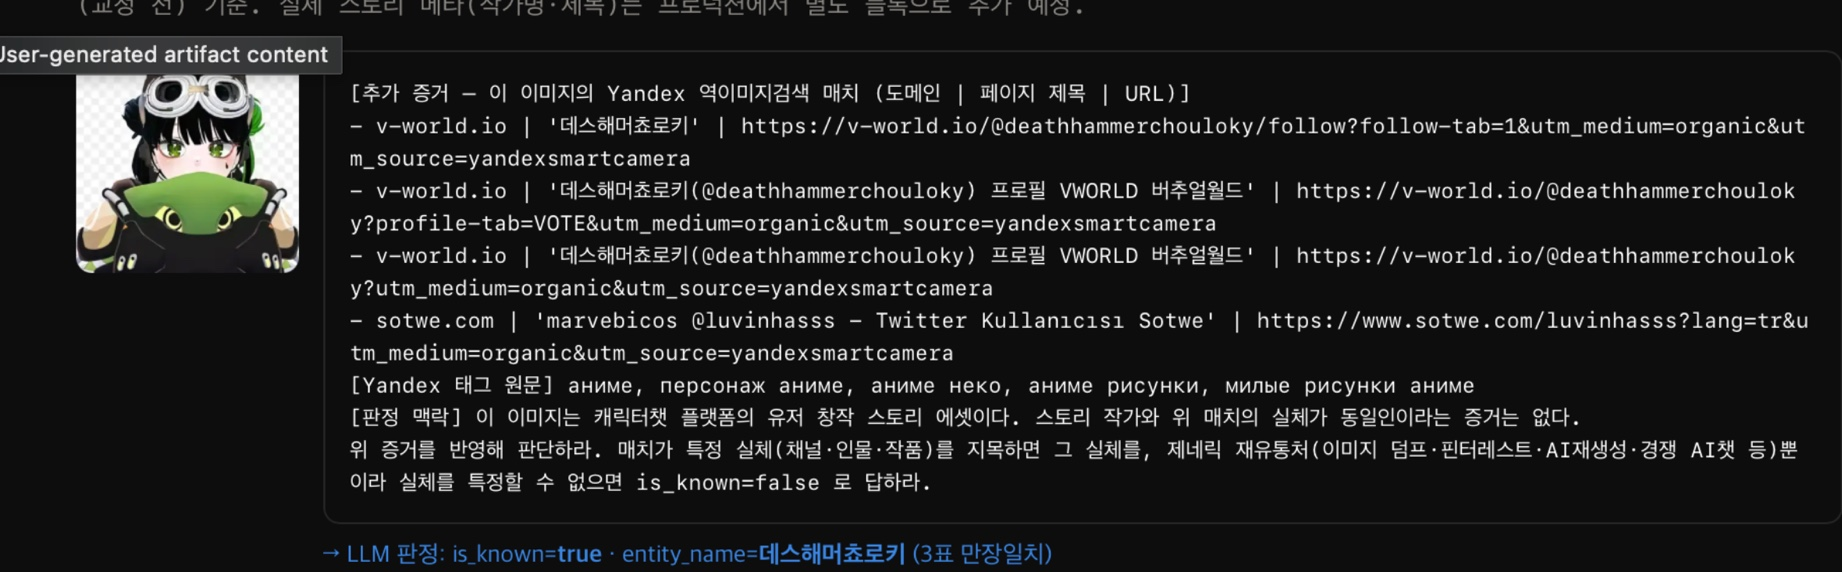
이미지와 검색 결과 맥락을 함께 넣은 판정 입력
LLM에는 알려진 실체인지, 엔티티 이름과 소속 작품은 무엇인지, 어떤 유형인지, 어느 도메인의 증거가 결정적이었는지를 구조화해서 받았다. 이름을 이미지에서만 맞히게 했을 때 놓쳤던 한국 버튜버나 게임 캐릭터도, 관련 페이지 제목과 태그가 함께 있으면 식별할 수 있었다.
class Verdict(BaseModel):
    is_known: bool = False             # 핵심 판정 — 증거가 실존 실체를 지목하는지 여부
    entity_name: Optional[str] = None  # 지목한 실체명 (예: "흥선대원군 (이하응)")
    franchise: Optional[str] = None    # 소속 작품/그룹/회사 (예: "블루 아카이브")
    entity_type: str = "unknown"       # 실체 유형 (실존인물/게임캐릭터/버튜버 등)
    confidence: float = 0.0            # 모델 자체 확신도 0~1
    key_evidence_domain: Optional[str] = None  # 결정적 근거가 된 매치 도메인
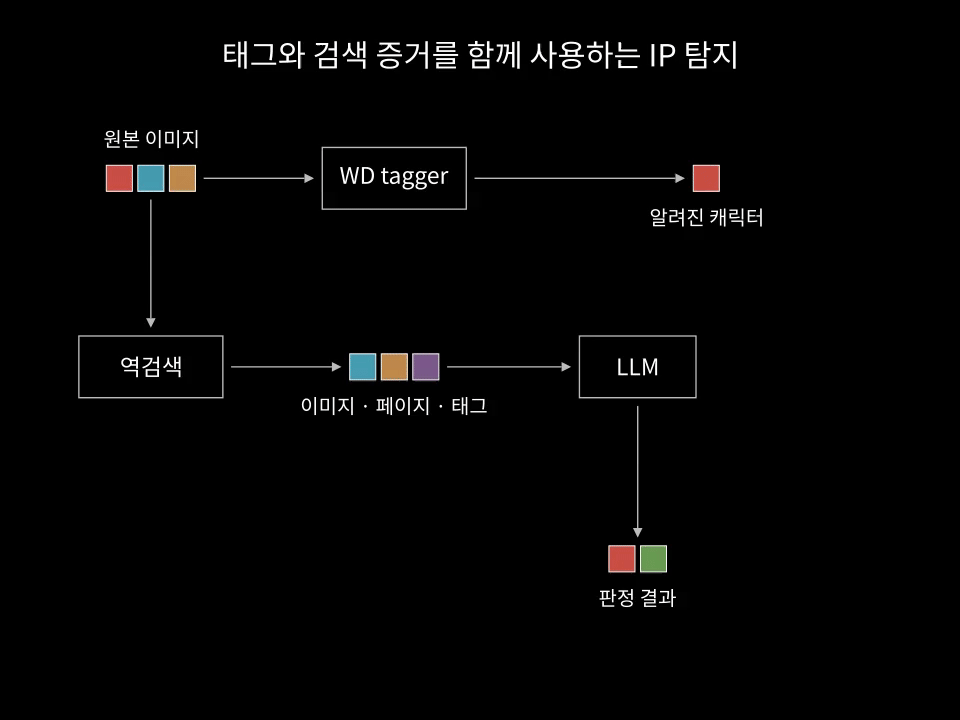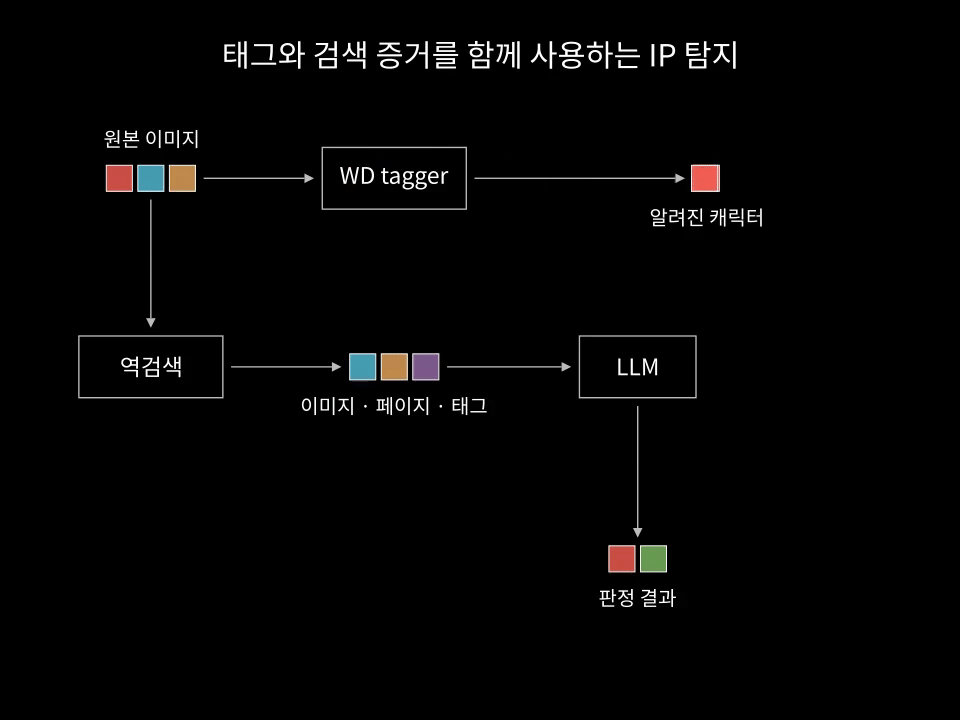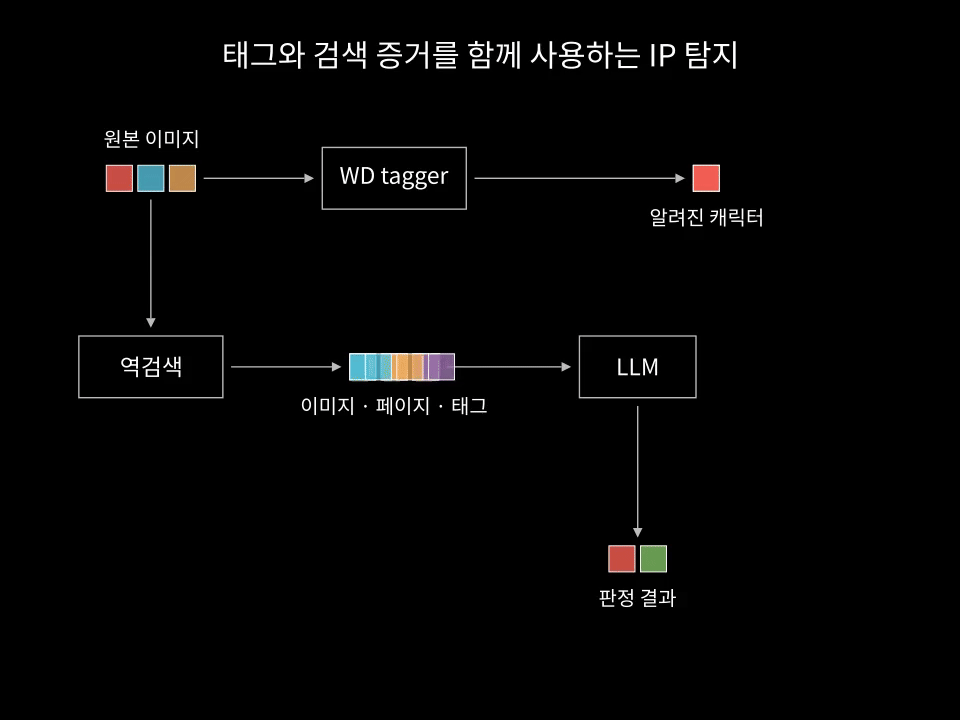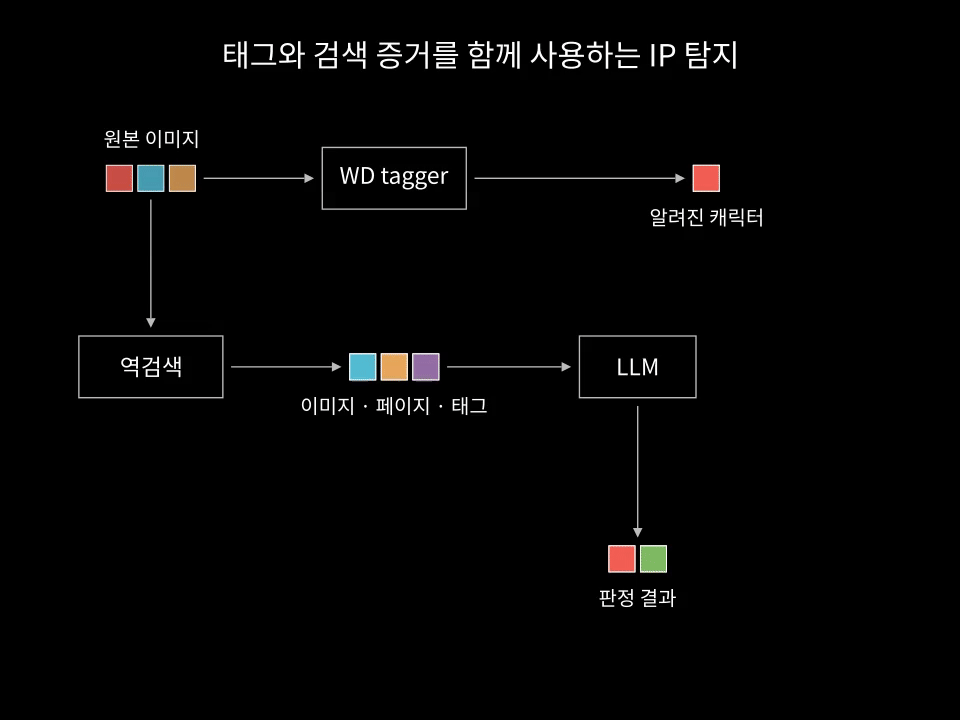
WD tagger와 역검색 증거 기반 LLM 판정의 데이터 흐름
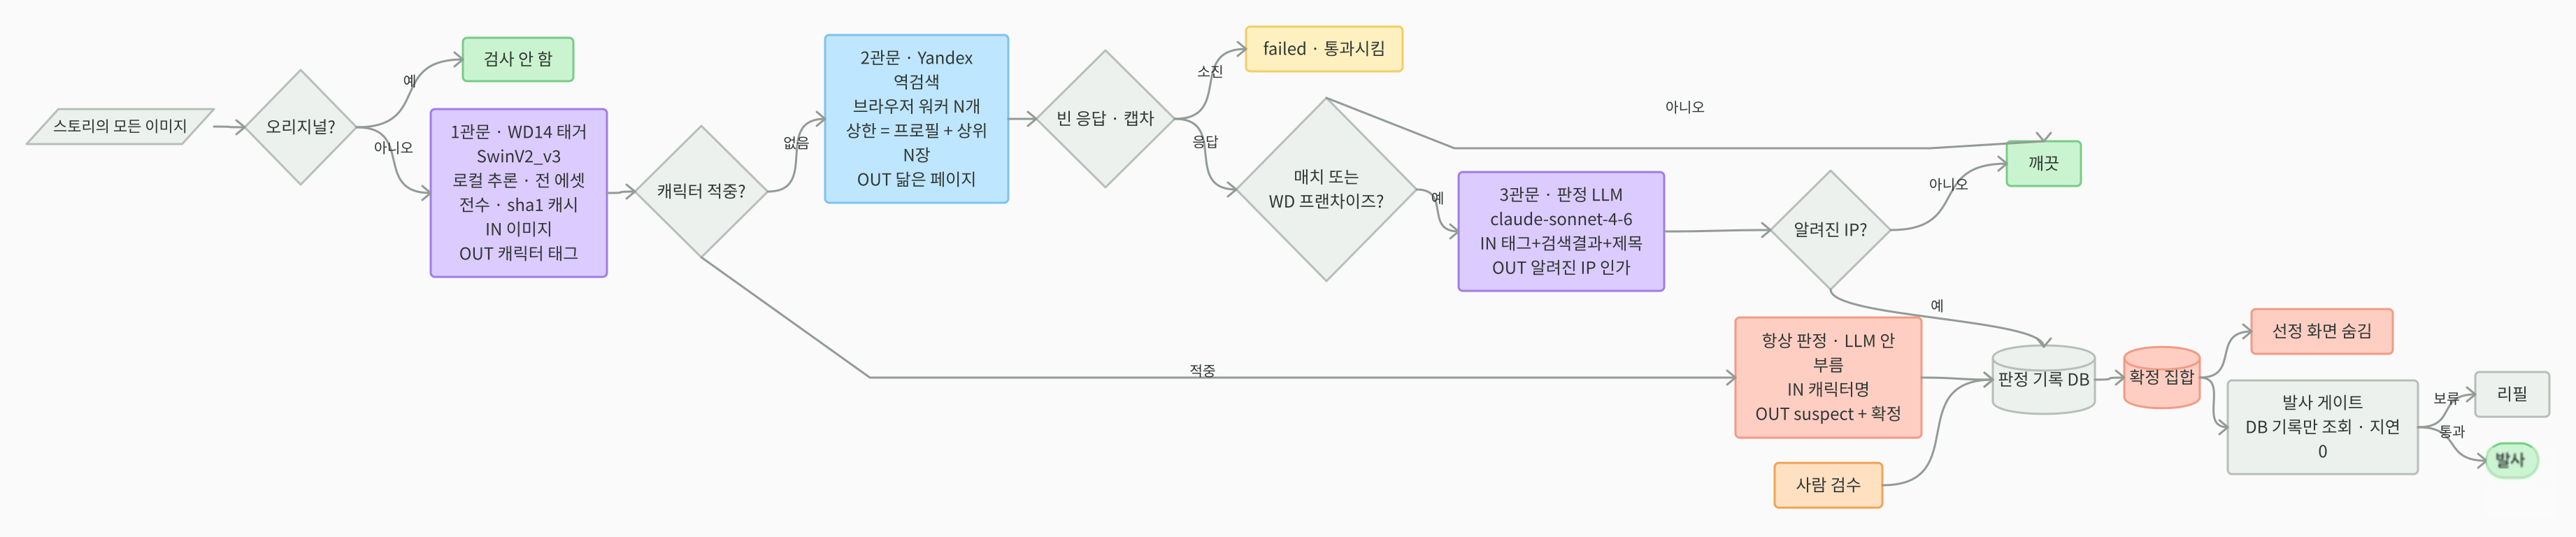
태거와 역검색을 결합한 IP 탐지 흐름
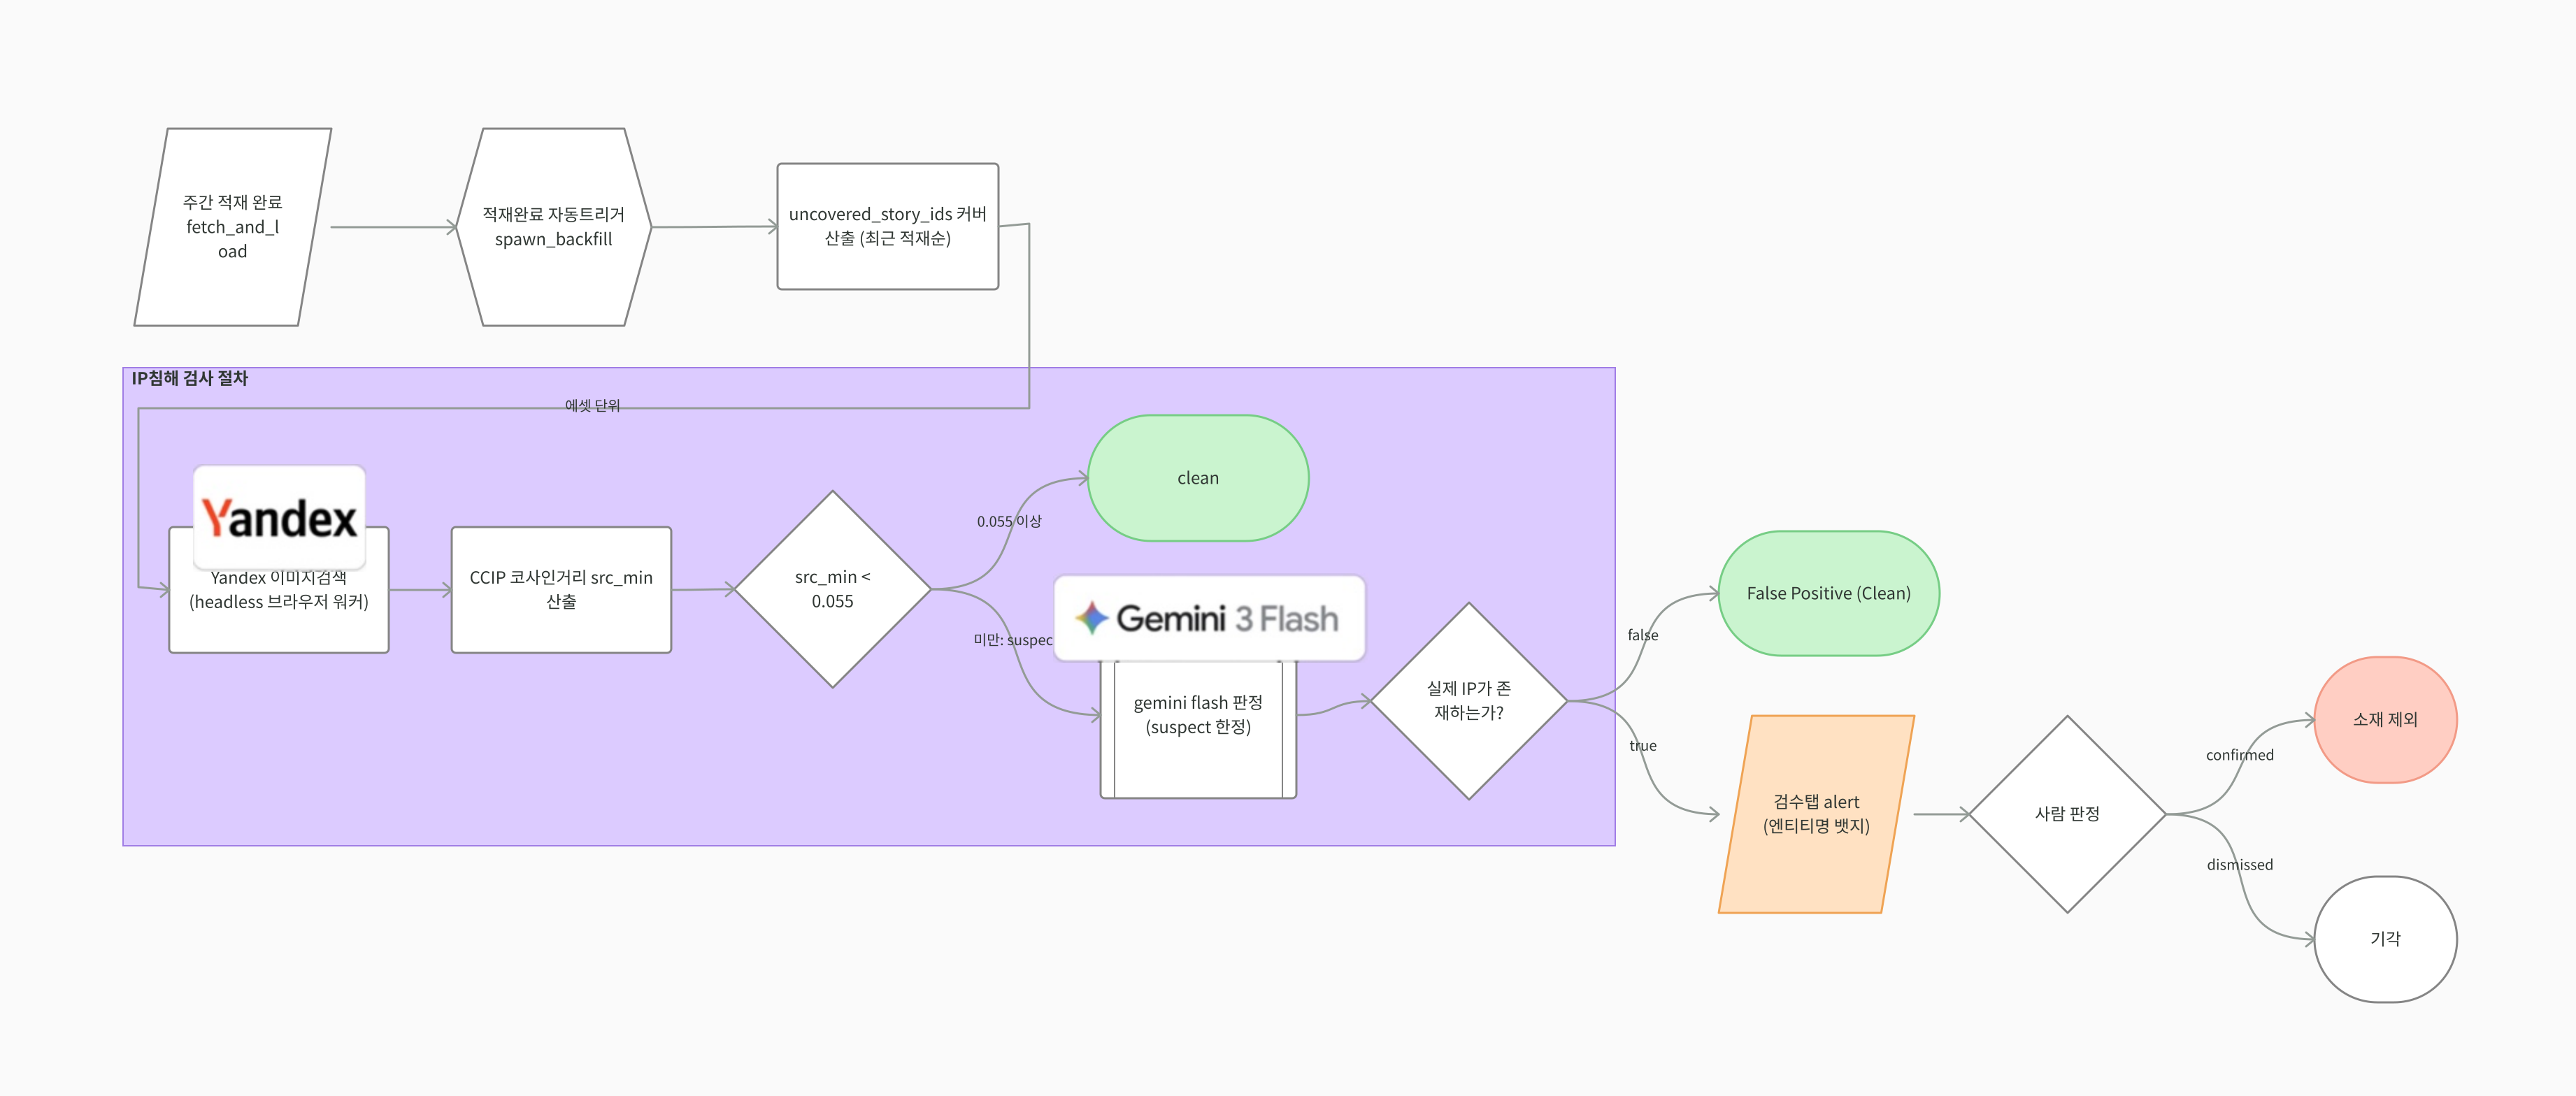
역검색 증거를 LLM 판정으로 연결하는 흐름
핵심은 웹상 존재 여부보다 검색 증거가 특정 IP나 인물을 가리키는지를 보는 것이었다. 다만 이 출력만으로 실제 권리 관계를 확정할 수 있는 것은 아니다. 우리가 만든 것은 광고·검수 흐름에서 확인할 후보를 가르는 판정 시스템이었다.
수동 라벨링으로 바뀐 결과를 확인했다
100건을 수동으로 라벨링해 진짜 문제 사례와 오탐을 구분했다. LLM 레이어를 추가한 평가에서는 문제 사례를 놓치지 않으면서 오탐이 줄었다.
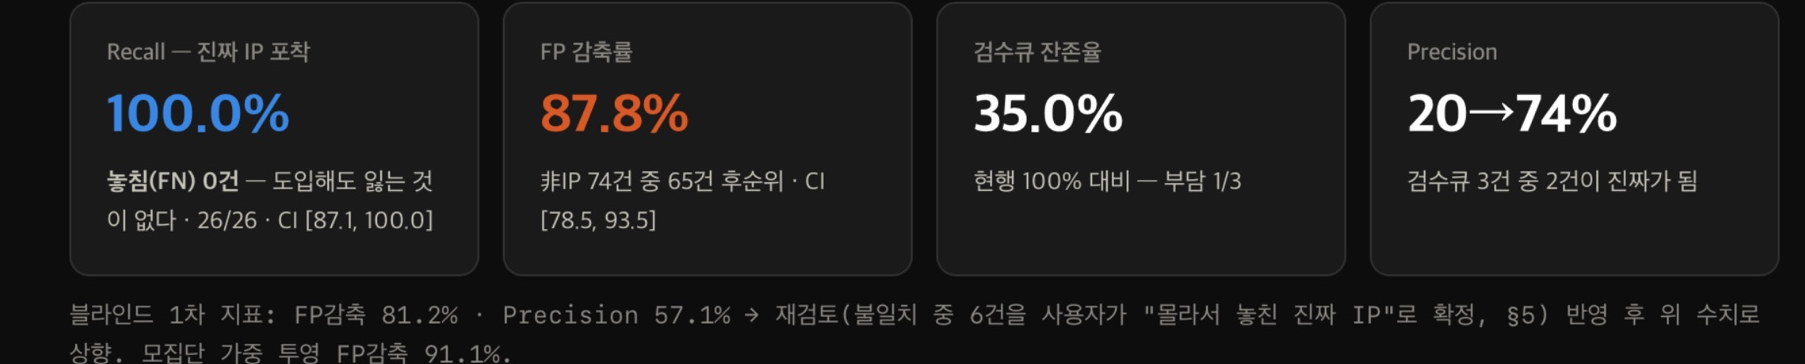
IP 판정 평가의 최종 지표
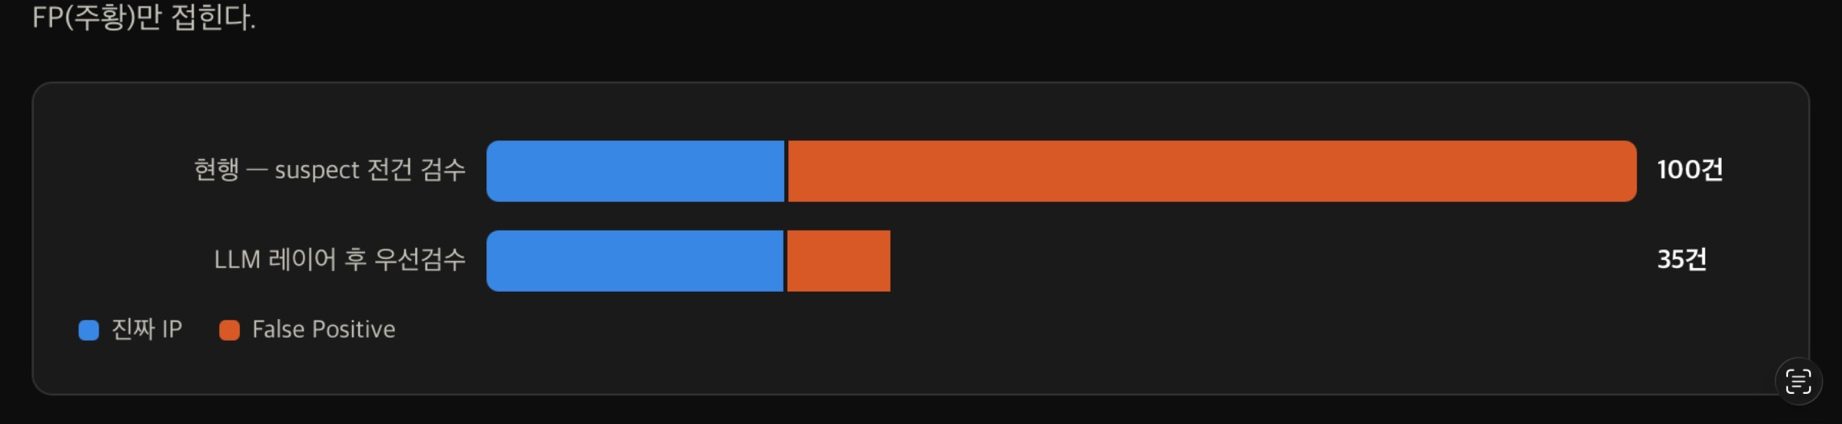
판정 전후의 검수 후보 비교
실험 대시보드에는 recall 100%, FP 감소율 87.8%, precision 20% → 74%가 기록돼 있다. 표의 최종 수치는 불일치 사례를 재검토한 뒤 반영한 결과다. 알려진 문제 26건을 모두 남겼고, 비IP 74건 중 65건을 후순위로 돌려 검수 큐 잔존율은 35%가 됐다. precision은 전체 정확도가 아니라, 검수 큐에 남긴 후보 중 실제 문제 사례가 차지하는 비율이다.
여기서 recall 100%는 해당 평가 표본에서 FN이 없었다는 뜻이다. 이미지에도 26/26의 신뢰구간이 함께 표시돼 있다. 서비스의 모든 IP를 놓치지 않는다는 의미로 확대할 수는 없다. 초기 1,000건 EDA와 이후 라벨링 평가도 서로 다른 목적의 표본이었다.
단일 호출과 세 번 호출하는 앙상블도 비교했다. 120건에서 개선된 것은 한 건이어서, 그 실험에서는 호출을 세 배로 늘릴 만큼 큰 차이가 아니었다. JSON 파싱 오류가 나면 재시도하는 대체 경로는 남기고, 앙상블까지 사용할 필요는 없다고 판단했다.
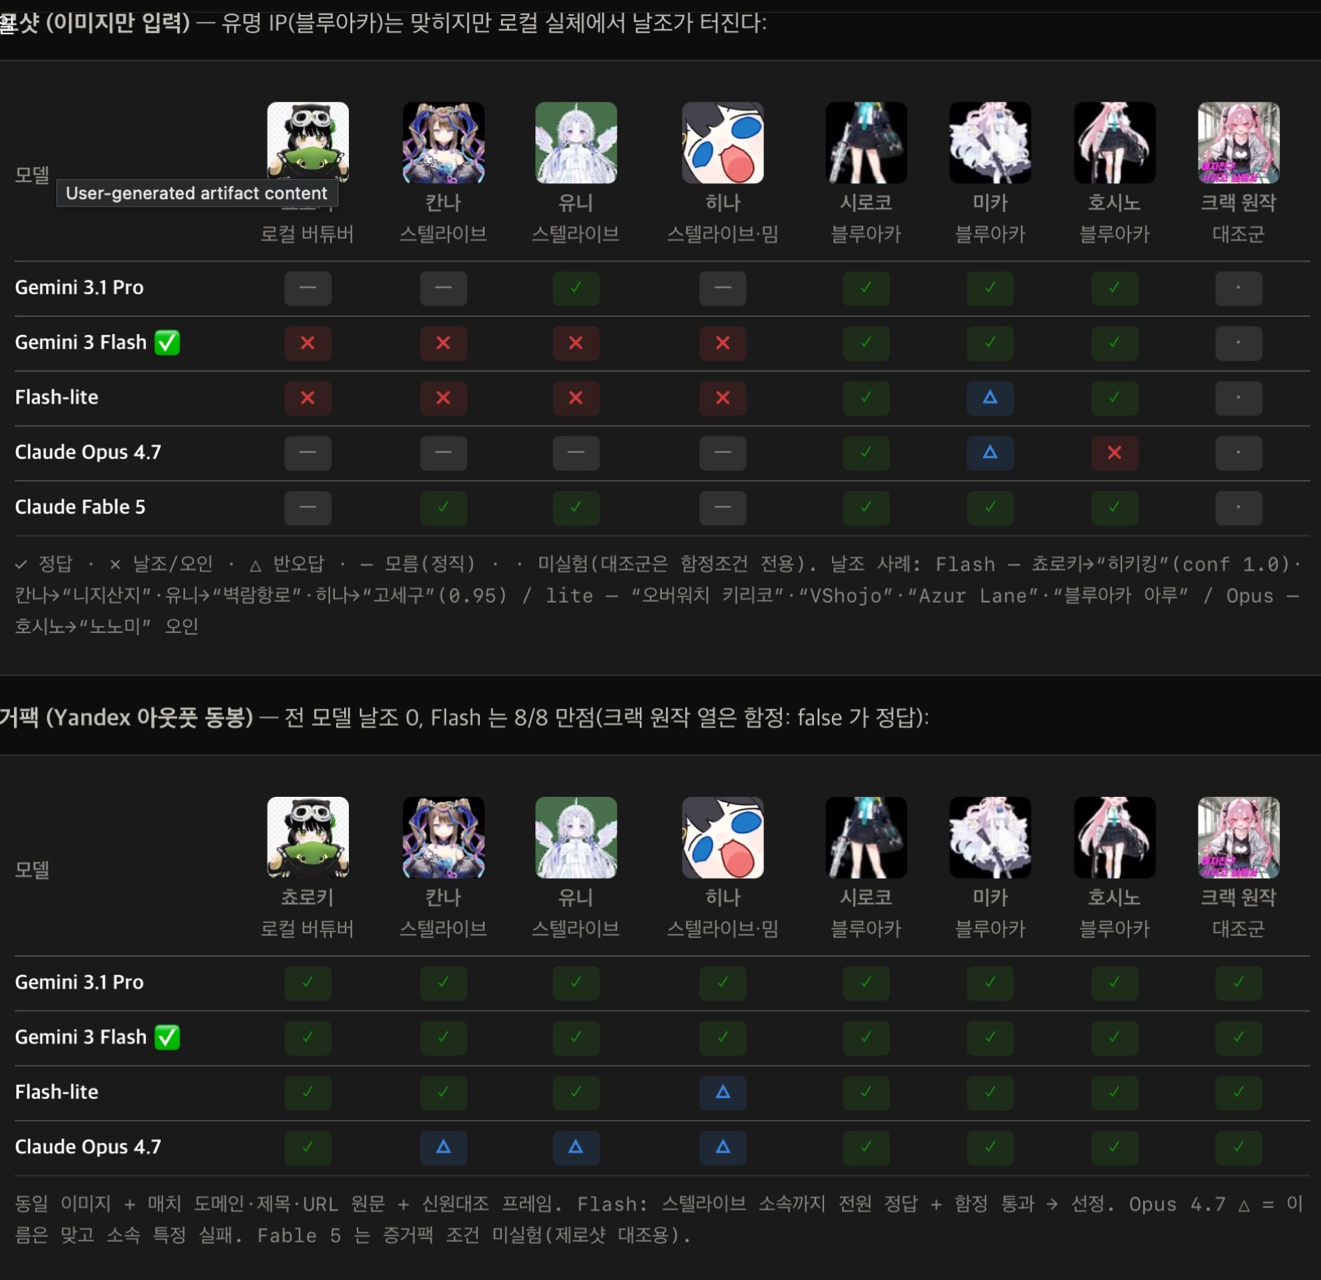
증거 기반 IP 판정 모델 비교
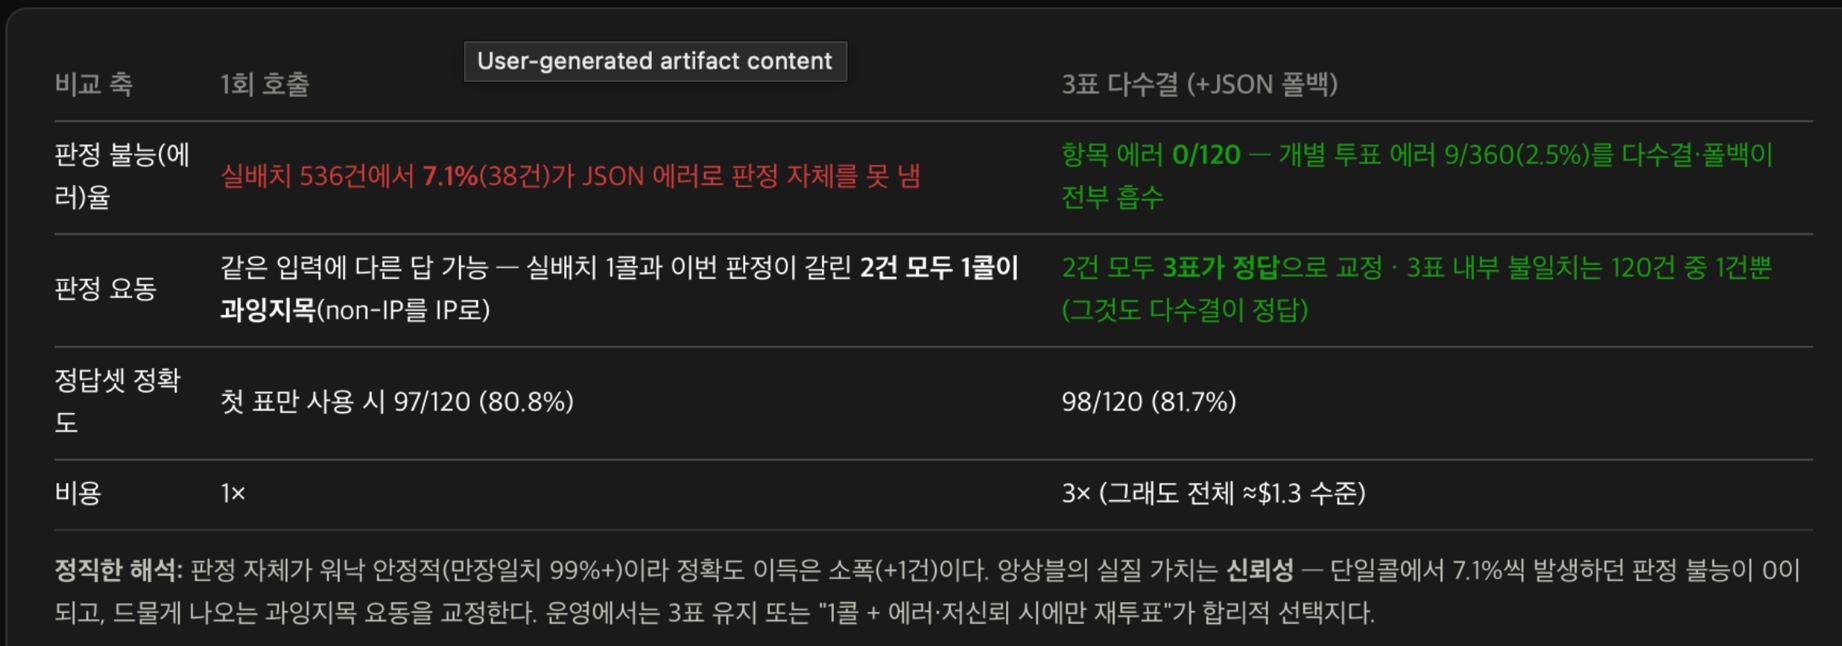
단일 호출과 세 번 호출한 앙상블 비교
웹에 없는 변형 이미지는 또 다른 문제였다
반대로 역검색 결과가 없는데도 유명 IP인 그림이 있었다. 생성 모델로 변형한 이미지는 웹에 똑같은 원본이 없어서 검색에 걸리지 않을 수 있다. 블루아카이브와 귀멸의 칼날 캐릭터 사례에서 이 문제가 드러났다.
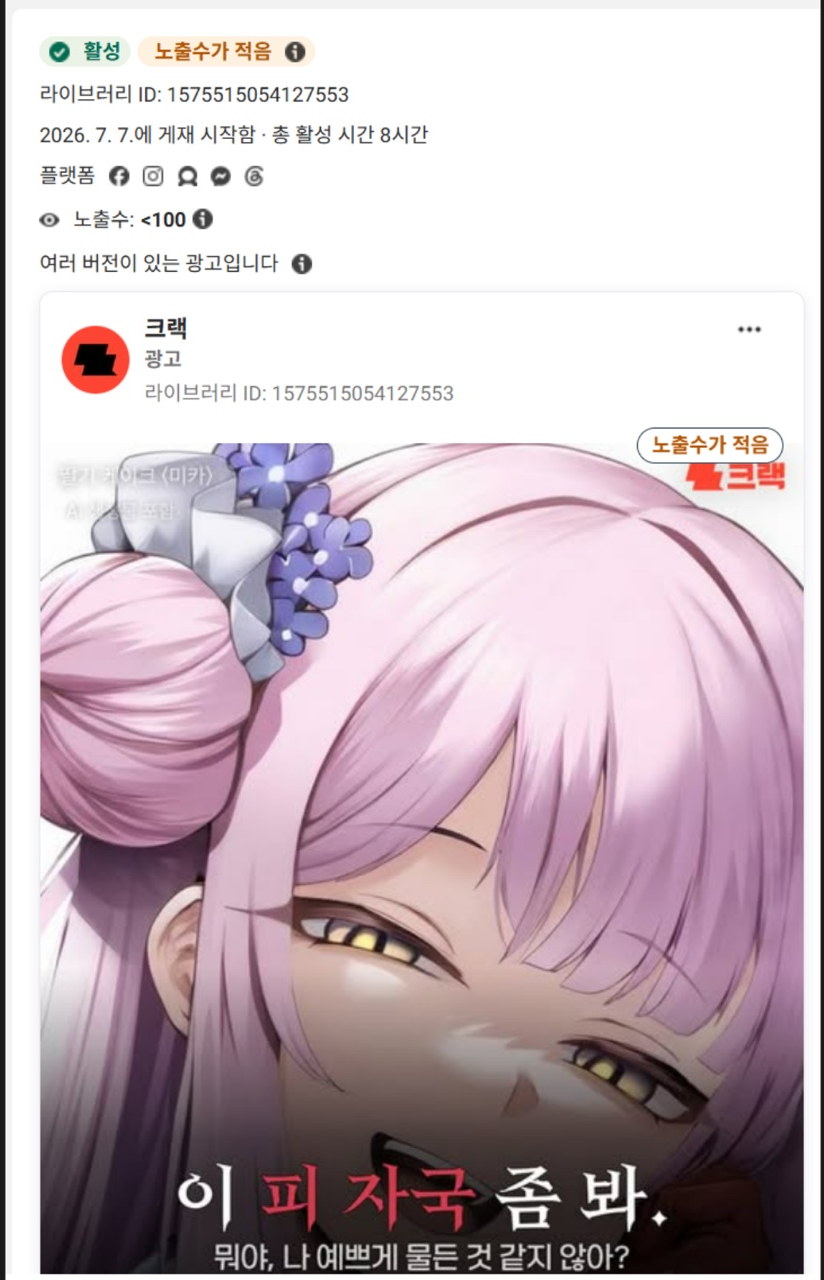
변형 이미지에서 확인한 블루아카이브 사례
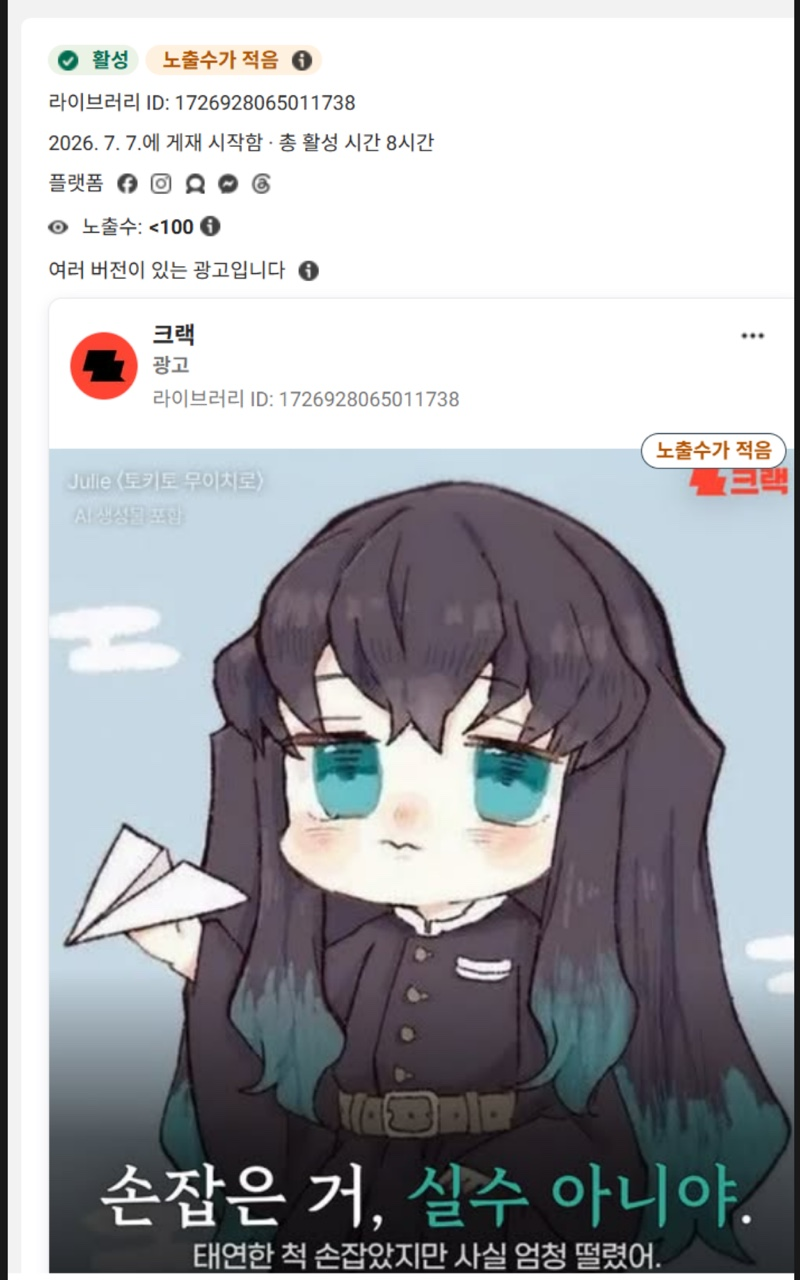
변형 이미지에서 확인한 귀멸의 칼날 사례
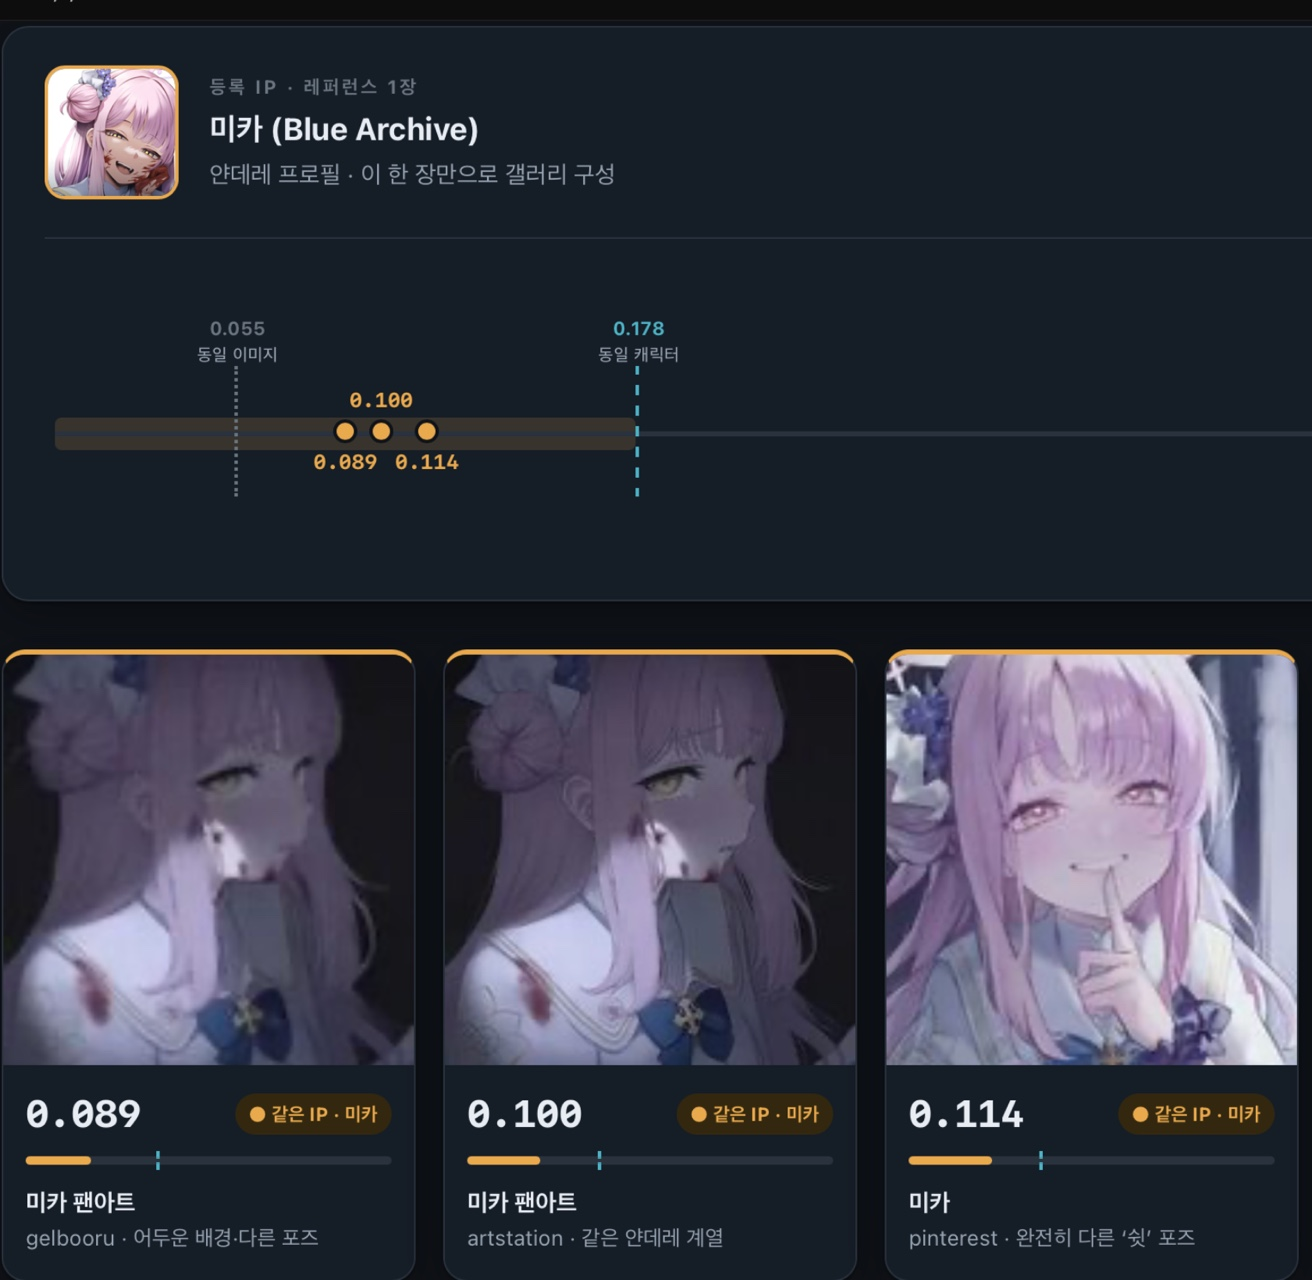
웹 역검색에서 확인한 후보 이미지
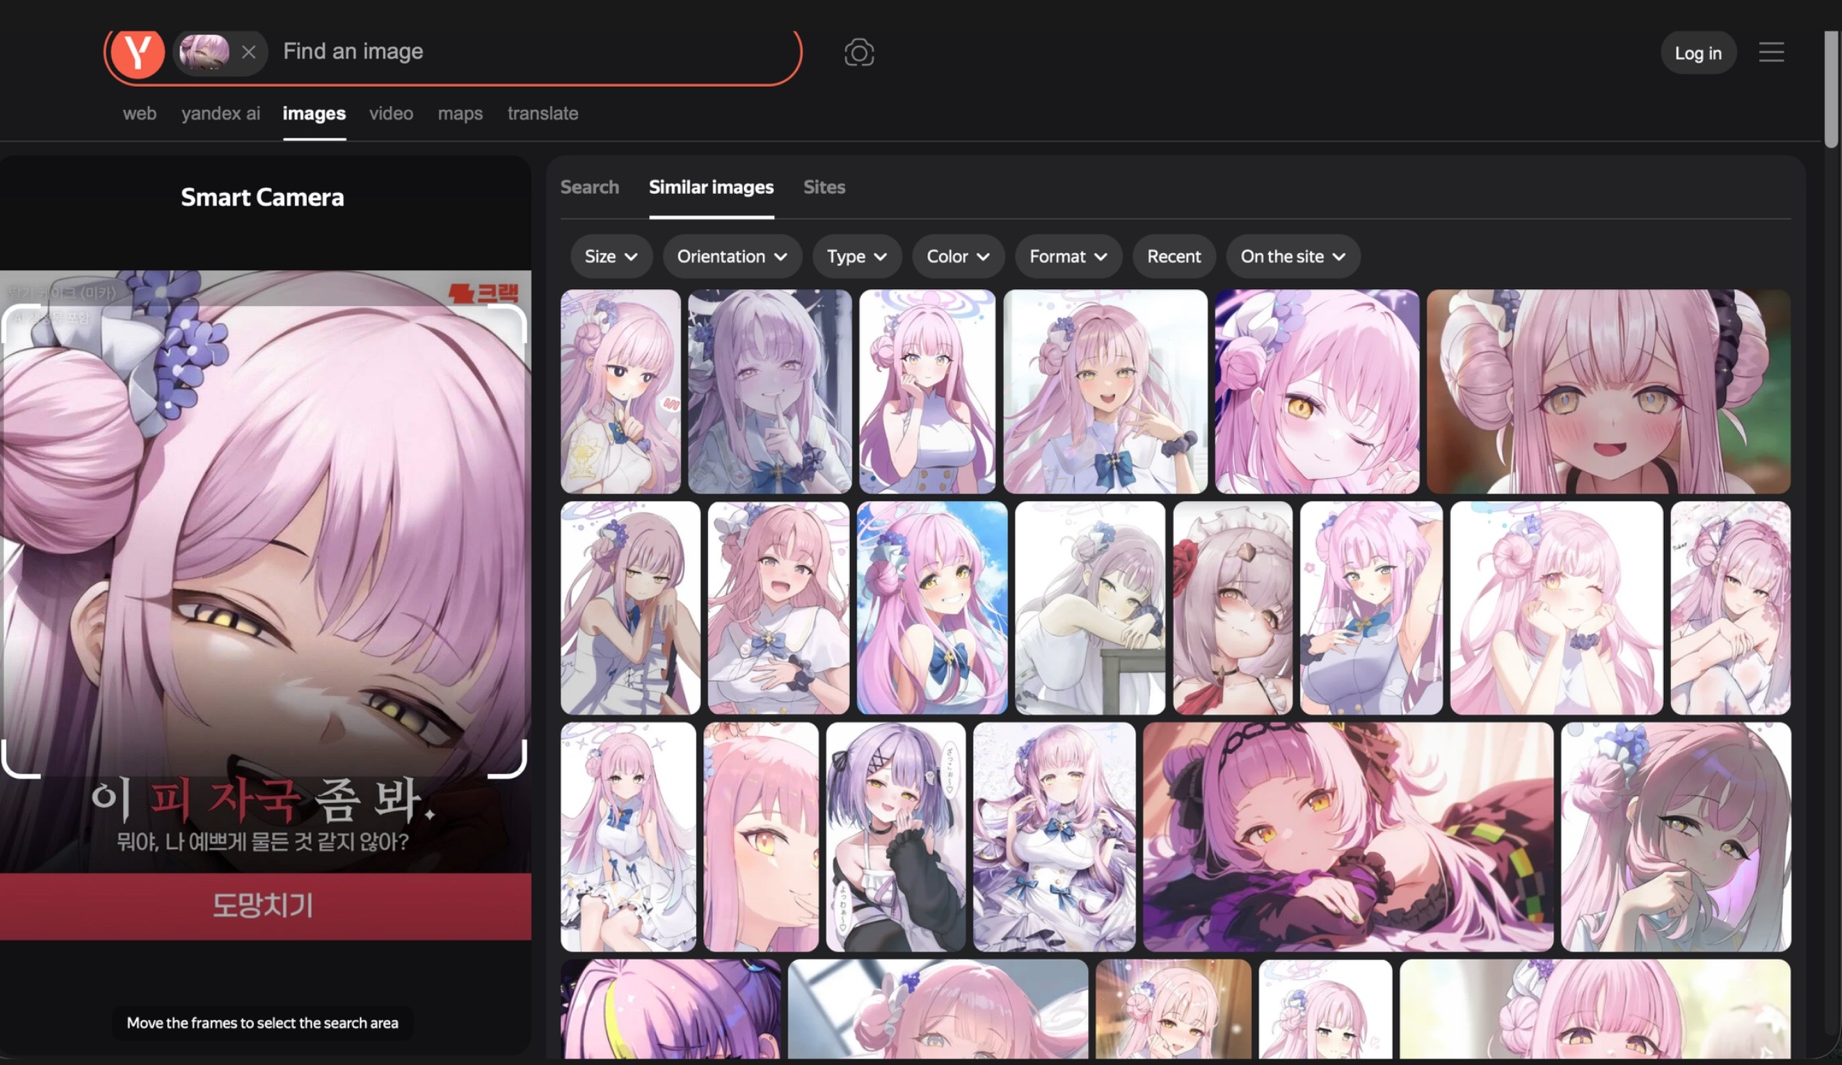
변형 이미지의 유사 후보 검색 결과
기존의 0.055 거리 기준은 완전히 같지 않은 이미지를 후보에서 빼는 데도 영향을 줬다. 그래서 후보 기준을 0.1로 넓혔다. 더 많은 후보가 들어와도 뒤의 LLM이 검색 태그와 맥락을 확인하도록 했다.
역검색을 보완하기 위해 파이프라인 앞단에도 WD-Tagger를 연결했다. Danbooru 어휘를 기반으로 유명 애니·게임 캐릭터를 식별하는 경로다. 역검색이 0건이었던 원피스 합성 포스터에서 태거는 roronoa_zoro를 높은 점수로 잡았다. 문제가 있었던 두 스토리도 유명 IP여서 태거로 걸러낼 수 있었다.
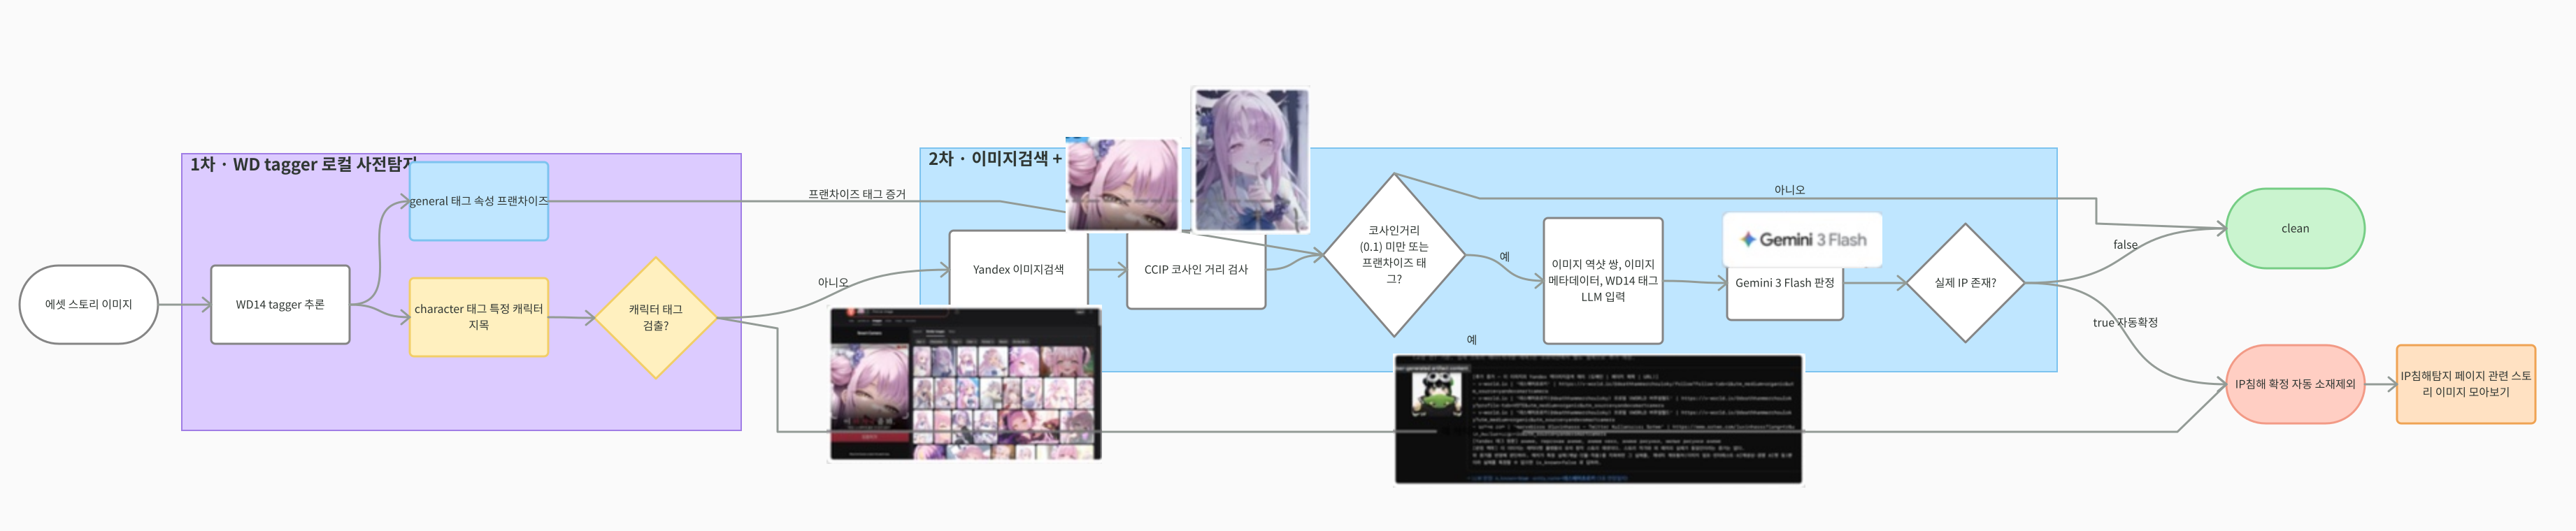
WD tagger를 추가한 IP 탐지 흐름
태거만으로 끝낼 수도 없었다. 일본 애니·게임에 강한 반면 한국 버튜버는 어휘 커버리지에 없어서 못 잡는 사례가 있었다. 태거와 역검색+LLM은 서로 다른 실패를 보완했다. 이미 서비스에서 검수한 오리지널 스토리는 이 검사에서 별도로 제외했다.
처음에는 이미지가 같은지를 잘 찾으면 문제가 해결될 거라고 봤다. 실제로는 같은 이미지가 있어도 판정을 보류해야 하는 경우와, 같은 이미지가 없어도 알려진 캐릭터인 경우가 함께 있었다. 운영 사례가 생길 때마다 그 차이를 분리하고, 어느 단계가 그 증거를 다룰 수 있는지 다시 설계했다.
본문의 데이터 흐름 애니메이션은 3Blue1Brown의 오픈소스 Manim에서 출발한 Manim Community로 만들었다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...