[논문 리뷰] [NLP]_Distributed Representations of Words and phrases and their Compositionality
[NLP]_Distributed Representations of Words and phrases and their Compositionality
Introduction
- Skip-gram모델을 확장해서 SubSampling과 Negative Sampling을 이용해 학습속도를 향상시키고 vector의 품질을 향상시켰다.
- 그리고 학습된 벡터 공간 내에 단어의 의미적, 문법적 관계가 선형적으로 나타남을 입증했다.
-
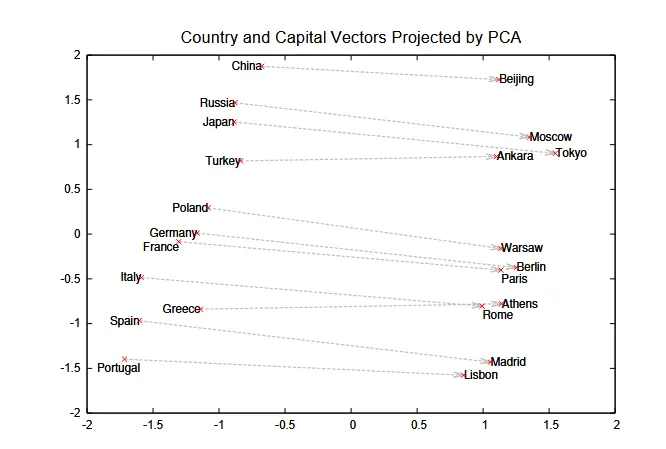
예를들어 vec(”마드리드”) - vec(”스페인”) + vec(”프랑스”) = vec(”파리”)라는것을 밝혀냈다.
즉 스페인의 수도인 마드리드에서 스페인을 빼면 수도라는 정보만 남고, 거기에 프랑스를 추가하면 프랑스의 수도인 파리가 결과로 나오는것이다. 신기하다..
- 구문표현을 학습하여 합성어에서 나타나는 새로운 의미를 학습하는 방법을 제안했다.
- 예를들어 “Air”와 “Canada”의 합성어인 “Air Canada”는 항공사 이름이지만, “Air”와 “Canada”의 의미와 다른의미를 가지므로 하나의 구로 묶어서 하나의 단어로 학습한다.
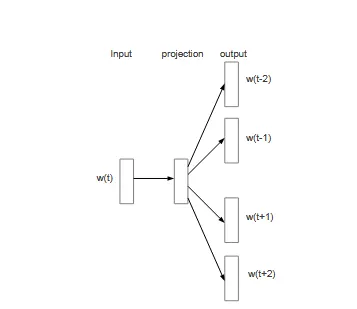
기존의 skip-gram모델은 Window_size 만큼 중심단어의 좌우로 단어를 생성해내는 모델이다.
이 논문에서는 기존의 skip-gram에 더해서 sub-sampling을 제안한다. sub-sampling을 통해 2배에서 10배 빠르게 모델을 training시킬 수 있었고, 정확도도 향상되었다. 그리고 Noise Contrastive Estimation(NCE)를 단순화 시킨 버전인 Negative-sampling을 이용해서 기존의 Hierarchical-softmax보다 더 단순하고 빠르게 training을 할 수 있게 만들었다.
그리고 각 단어를 벡터공간에서 표현할때, 간단하게 단어vector끼리의 덧셈으로 다른 단어를 표현할 수 있음을 발견했다. 따라서 Embedding된 단어 Vector는 단순히 선형변환을 통해 다른 단어를 나타낼 수있다! 그리고 단어 Vector는 Context를 충분히 포함하고 있음을 PCA로 시각화 할 수도 있다.
The skip-gram Model
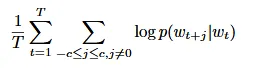
C: Window_size → 중심 단어 왼쪽으로 C개만큼, 오른쪽으로 C개만큼 단어를 형성한다.
최적화하는 목적함수:는 -C에서 C사이에있는 단어들의 평균 \(log\) 확률을 Maximize하는것이다.
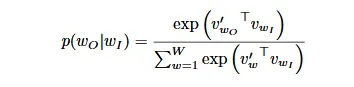
이때 확률함수로 Softmax를 쓰면 분모에서 Vocab에 있는 모든단어에 대해 미분한 결과를 업데이트 해줘야 하므로 효율적이지 않다.시간복잡도가 \(O(W)\)이다. (W는 vocab의 모든 단어 개수)
따라서 Hierarchical Softmax가 제시되었다.
Hierarchical Softmax
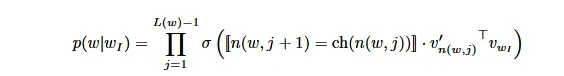
전체 어휘가 아닌 이진트리를 사용하여 계산 복잡도를 \(O(W)\)에서 \(O(log_2(W))\)로 줄였다.
Hierarchical softmax에서는 전체 어휘를 평가하는 대신에 이진트리를 이용해서 \(log_2(W)\)의 node만 평가한다.
이 논문에서는 huffman tree를 사용해서 등장빈도가 높은 단어에 더 짧은 경로를 할당하기 때문에 자주 나오는 단어들을 더 빠르게 학습할 수 있다.
Negative Sampling
Hierarchical softmax의 대안으로 Noise Contrastive Estimation(NCE)라는 기법을 단순화 한것이다.
좋은 모델은 실제 데이터와 노이즈를 구별할 수 있어야 하기 때문에 Postive sample의 확률을 최대화하는것 뿐만 아니라, negative sample의 확률은 최소화하는 방법이다.
기존의 Softmax함수는 Vocab에 있는 단어에 대해 확률을 계산하기 때문에 계산복잡도가 컸지만, Negative Sampling은 간단한 이진분류문제로 바꿔서 문제를 해결한다.
Positive Sample과 Negative Sample은 (Word,Word)쌍으로 만들고, Positve는 두 단어간의 연관성이 있는것으로 쌍을 만들고, Negative는 관련이 없는 단어를 무작위로 선택해서 쌍을 만든다.
모델은 이진분류를 통해 Logistic Regression을 통해 데이터가 실제 데이터인지 노이즈인지 구별하며 Training을 한다.
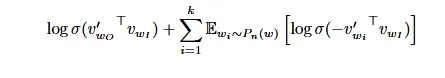
$k$: Negative Sample의 수: 하나의 Positive Sample에 몇개의 Negative Sample을 뽑을지 결정하는 값이다. 논문에서는 작은 데이터셋에서는 \(5≤k≤20\)으로, 큰 데이터셋에서는 \(2<=k<=5\)정도로 값을 설정하는게 유용하다고 한다.
\(P_n(w)\):노이즈 분포: Negative sample을 어떤 확률 분포에서 뽑을지 결정한다. 논문에서는 unigram distribution에서 3/4제곱을 한 분포가 다른 분포들보다 좋은 성능을 보였다고 한다.
이 목적함수를 최대화 함으로써 실제 정답쌍의 내적값을 logit으로 갖는 \(log\)확률을 최대화하고, Negative sample된 오답쌍의 음수값이 커져서 sigmoid값이 1에 가까워지도록 학습을 한다.
\[P(오답) = 1 - P(정답) = 1 - σ(v'_wiᵀ v_wI)\]\(1 - σ(x) = σ(-x)\)임을 활용함
Sub-sampling of Frequent Words
“in”, “the”, “and” ,”a”같이 데이터 내에 매우 빈번하게 등장하는 단어는 제외 시키는것을 sub-sampling이라고 한다. 예를들어 “the”+”France”는 “France”+”Paris”보다 더 빈번하게 등장하므로 유사도가 더 높을것이다. 이런상황을 막기 위해 매우 빈번하게 등장하는 단어는 아래 식에 의해서 제외시킨다.
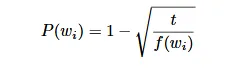
\(w_i\):단어
\(t\):임계값(threshold)
\(f(w_i)\): 단어의 빈도
\(P(w_i)\)에 따라 너무 많이 등장하는 단어는 버린다.
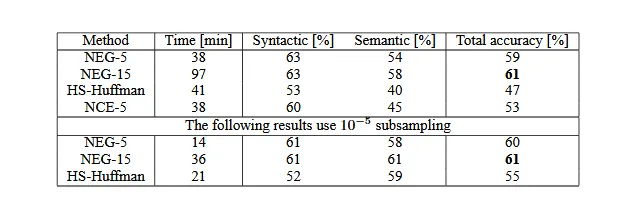
Neg는 negative sampling을 적용한 모델이고 뒤의 숫자는 하나의 postive sample에 k개의 negative sample을 학습시켰다는 의미이다.
결과를 보면 일반 모델보다 negative-sampling을 하면 성능이 향상됨을 알 수 있다.
Empirical Results
성능을 실험적으로 어떻게 검증하교 비교했을까?>
Analogical Reasoning Task
유추질문으로 구성됨
vec("Berlin") - vec("Germany") + vec("France") 같은 질문이 주어졌을때 결과 vector와 코사인유사도값이 가장 가까운 벡터와 정답레이블을 비교한다.
유추를 하는데는 두가지 범주가 있다.
Syntactic analogies(문법적 유추): 예시: “quick”:”quickly”
Semantic analogies(의미적 유추): 예시: “국가”:”수도”
Learning Phrases
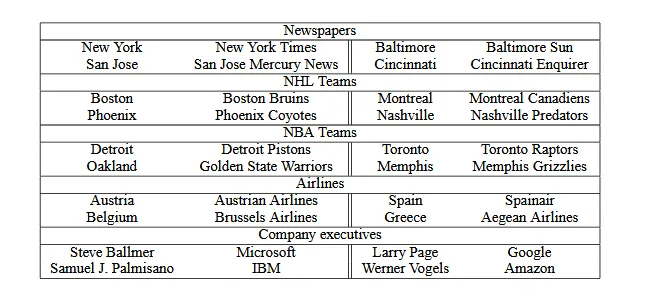
개별 단어를 넘어 여러단어가 합성하여 고유한 의미를 갖는 Phrase를 학습할 필요가 있다.
예를들어 New와 york이 합쳐져서 newyork라는 고유한 의미를 갖는 phrases를 만든다. → 이러한 구들은 의미있는 하나의 단위이므로 텍스트 내에서 고유한 토큰으로 대체된다.
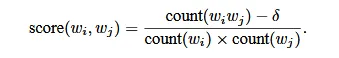
구를 식별하기 위해 모든 n-gram을 사용하는것은 메모리소모가 매우 크기 때문에 위이 수식을 이용해서 threshold보다 높은 쌍을 구로 간주한다.
여기서\(\delta\)는 discounting coefficient로 매우 드물게 등장하는 단어가 높은점수를 받는것을 방지한다.
\(count(w_i,w_j)\):\(w_i\)와 \(w_j\)가 연달아 등장한 횟수
\(score(w_i,w_j)\): 두 단어가 전체 횟수중 연달아 등장한 횟수가 높을수록 score가 높고, threshold를 넘으면 한 phrase로 간주한다.
일반적으로 이 과정을 2~4회 반복하면서 매번 임계값을 낮추며 여러 단어로 구성된 더 긴 구가 형성될 수 있도록 한다.
Phrase Skip-Gram Results
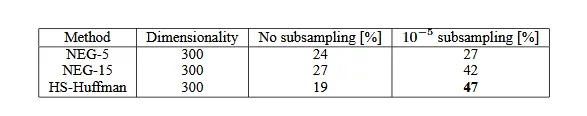
일반적으로 Negative sample size인 k를 높여줄때 더 나은 성능을 보였다. 그리고 Subsampling을 적용했을때 Hierarchical Softmax의 성능이 가장 높아졌다. → Subsample을 적용했을때 학습속도를 높일 뿐 아니라 정확도까지 향상시킬 수 있음을 보여준다.
dataset크기를 키워주고 dimension을 키워주니깐 정확도가 72%까지 향상되었다고 한다. 따라서 data의 크기를 키우는게 중요하다고 한다.
Additive Compositionality
단어의 Embedding Vector는 Linear Structure를 가지므로 벡터의 덧셈만으로도 의미있는 결과를 만들어낼 수 있다.
→ 벡터 연산을 통해 단어의 의미를 조합할 수 있다.
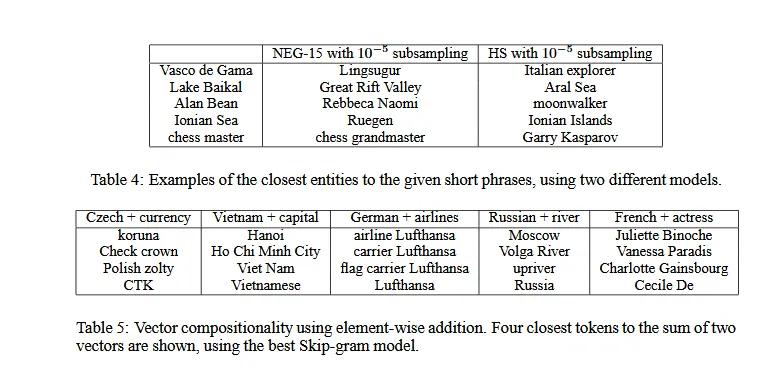
위의 사진에서는 두 벡터의 선형결합을 통해 가장 연관성 높은 벡터들을 모델이 예측한 값을 볼 수 있다.
Training이 진행될수록 Vector들은 단어의 맥락을 학습한다.
일종의 AND함수처럼 양쪽 문맥을 공통적으로 나타내는 벡터를 나타낼 수 있게 된다.
Compareison to Published Word Representations
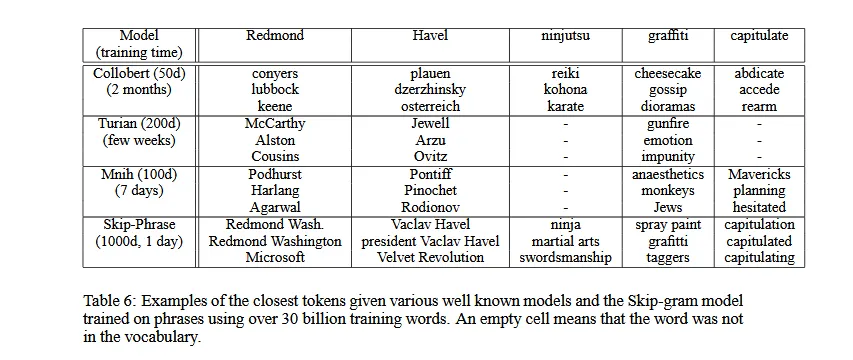
기존의 모델들에 비해 가장 아래있는 Skip-Phrase모델은 하루만에 1000dimension을 이용해서 학습을 끝마쳤다. 그럼에도 드문단어(infrequent words)에 대해 가장 가까운 이웃단어들을 보면 다른 모델들에 비해 성능적 우위를 보임을 알 수 있다.
Sub-sampling, Negative-sampling, Phrase skipgram을 통해서 Data를 다른 모델에 비해 2~3배 많은 30B를 학습시켰음에도 학습시간을 매우 줄일 수 있었다.
Conclusion
- Skip-gram Model Extension: Skip-gram모델을 사용해서 Phrase를 학습하는 방법을 보여주었고, 더 정교한 유추를 할 수 있었다.
- Sub-sampling, Negative-sampling을 통해 시간복잡도를 줄일 수 있었고, 정확도 또한 높일 수 있었다.
- Additive Compositionality: 단어 벡터들이 단순한 벡터 덧셈으로도 의미있는 결합을 만들 수 있다는 것을 발견했다.
- Learning-Phrase: 구를 단일 토큰으로 표현하여 학습하는 방법을 제시해서 낮은 계산복잡도로 더 긴 텍스트를 표현하는 방법을 제공했다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...