[영화리뷰 감성분류][study]메트릭 선택은 기술이 아니라 의사결정의 정치다.
[Domain_Common_Project][study] 메트릭 선택은 기술이 아니라 의사결정의 정치다.
이 글은 원본글을 바탕으로 학습목적으로 정리한 글임을 밝힙니다. 원본 글: https://stages.ai/en/competitions/370/board/community/post/3051
메트릭 선택은 기술이 아니라 의사결정의 정치다.
모델 개발에서 성능이 좋다는건 특정 메트릭의 값이 좋다는 의미다. → 어떤 메트릭을 우선시 해야할까?
- Accuracy: 전체 예측 중 맞춘 비율. 간단하지만, 데이터 불균형에서는 무의미할 수 있음.
- Precision: Positive로 예측한 것 중 실제로 Positive인 비율. False Positive 줄이는 데 초점.
- Recall: 실제 Positive 중에서 모델이 Positive로 잡아낸 비율. False Negative 줄이는 데 초점.
- FPR (False Positive Rate): 실제 Negative 중에서 Positive로 잘못 분류한 비율.
각 metric마다 데이터에서 중점으로 여기는 부분이 다르다.
불균형 데이터에서 acc의 의미
어떤 질병이 있는 환자의 비율이 1%라고 할때 질병이 없는 환자의 비율은 99%이다. 어떤 모델은 input과 상관없이 질병이 없다라고만 판단을 내릴때 Accuracy는 99%이다. 얼핏보면 좋은 모델인것 처럼 보이지만, 인풋과 상관없이 질병이 없다라고만 판단을 내리므로 좋은 모델은 아니다.
즉 Classification에서 Class간 불균형 데이터에서는 ACC만을 올리는것이 좋은모델은 아니다.
예시2: Multi-class classification
영화리뷰 감성분류를 한다고 해보자.
- positive: 70%
- Neutral: 20%
- Negative: 10%
Positive의 학습데이터가 많으므로 당연히 모델을 돌렸을떄 positive는 잘 맞히지만, Neutral과 Negative를 Positive로 많이 오분류 한다.
Macro-F1 vs Micro-F1
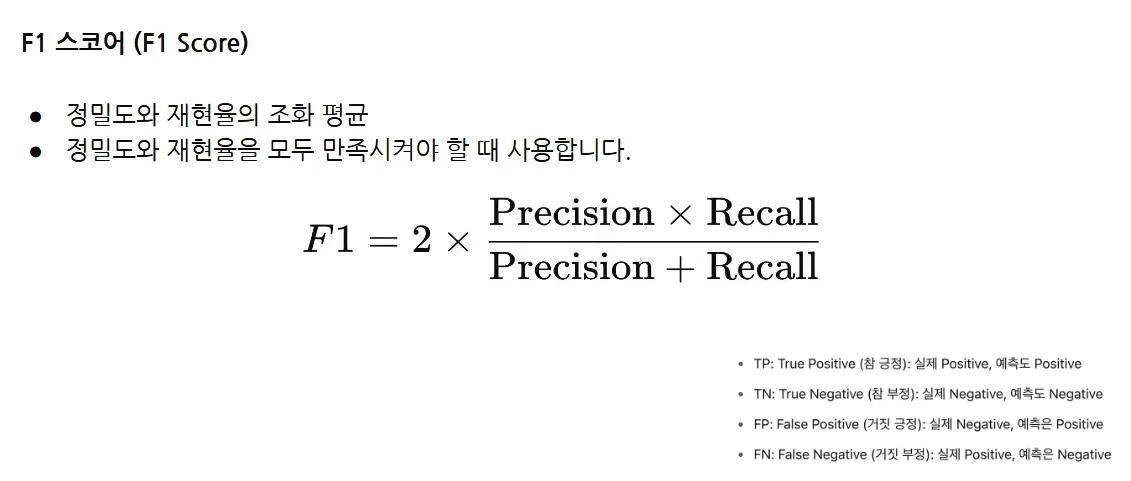
일단 F1은 정밀도와 재현율의 조화평균으로 정밀도와 재현도룰 둘다 반영한 Metric이다.
- Micro-F1: 전체 클래스의 TP/FP/FN을 한 번에 합산해 Precision·Recall을 계산 → 샘플 수가 많은(다수) 클래스의 영향이 크다. 따라서 불균형 데이터에서는 Micro-F1이 높더라도 모델의 성능이 안좋을 수 있다.
- Macro-F1: 클래스별 F1을 구해 단순 평균 → 각 클래스를 동일 가중으로 취급하므로 소수 클래스 성능 저하를 잘 드러냄.
- 클래스별로 F1값을 따로 계산하고, 각 클래스를 동일 가중으로 취급하여 평균내므로, 어떤 클래스의 데이터가 매우 적더라도, 최종 F1값에 잘 반영될 수 있음.
- Weighted-F1: 클래스별 F1에 표본 비율 가중치를 곱해 평균 → Micro와 Macro의 중간 성격.
Loss를 통한 Metric 개선
일반적은 Cross Entropy Loss는 모든 클래스의 오류를 동일하게 취급한다. 따라서 어떤 클래스의 데이터만이 매우 큰 비중을 차지하면 학습과정에서 다수 클래스에 치우쳐서 소수클래스의 Loss는 거의 무시된다.
Class Weighted Cross Entropy
데이터가 적게 나오는 클래스일 수록 Loss 계산시 더 큰 가중치를 부여한다.
만약에 어떤 클래스의 데이터가 10%이고 다른 클래스의 데이터가 70%면 어떤 클래스의 Loss를 7배 가중치를 줘서 계산한다.
즉 각 클래스의 표본개수 비율을 반대로 뒤집어서 가중치로 사용한다. 이를 통해 모델이 소수 클래스도 무시하지 않고 학습하도록 유도한다.
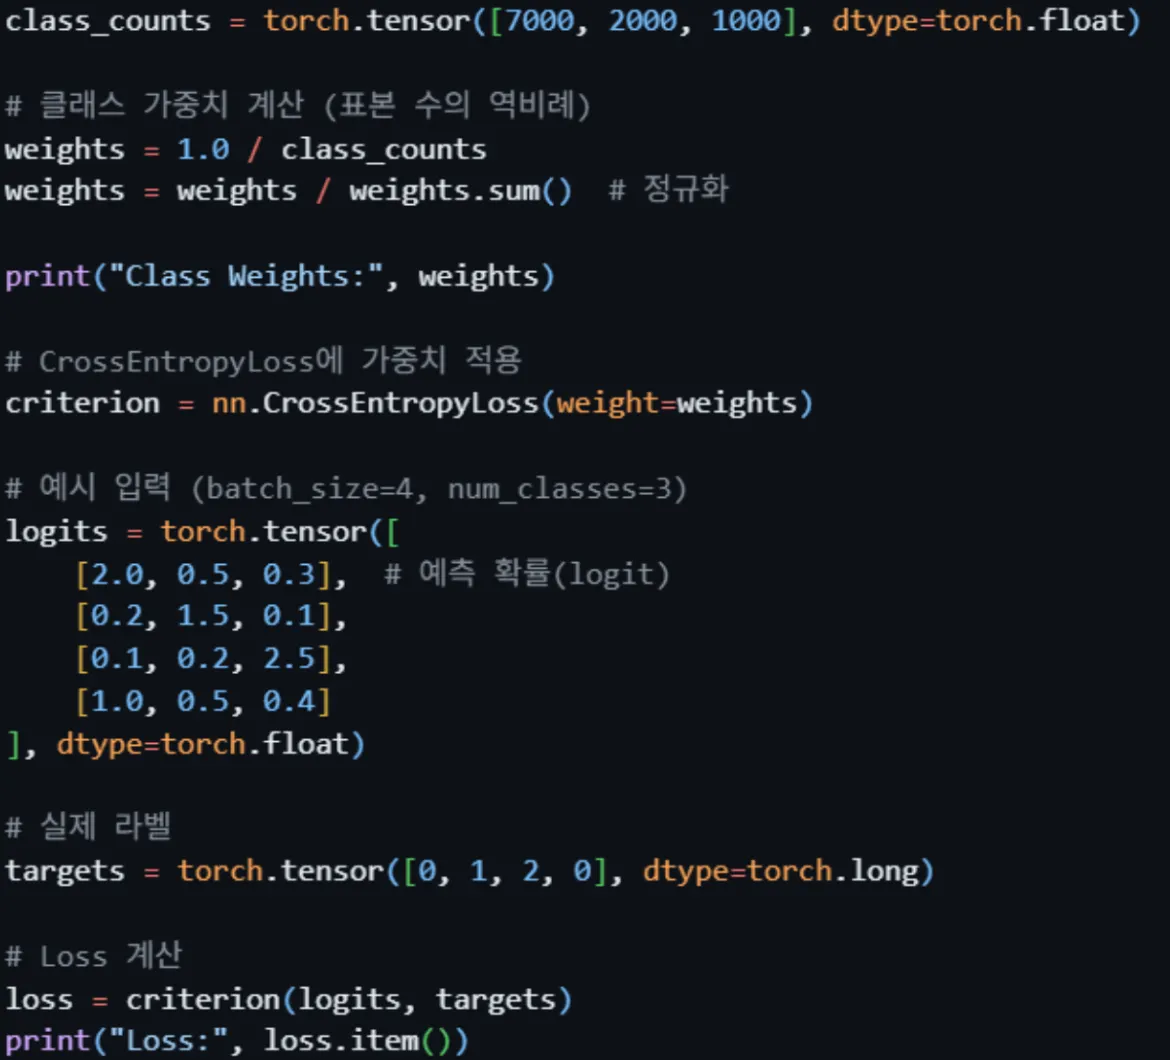
이미지출처: https://stages.ai/en/competitions/370/board/community/post/3051
Focal Loss
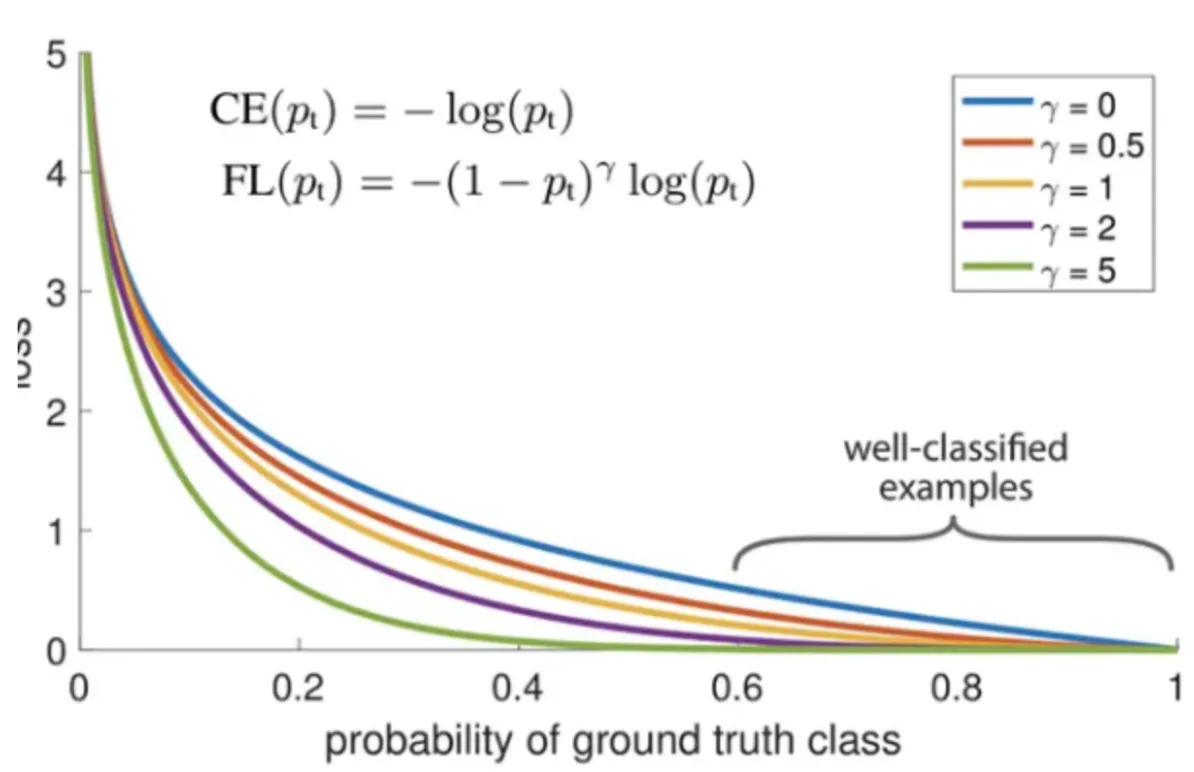
모델이 이미 쉽게 맞히는 샘플보다는, 계속 틀리는 어려운 샘플에 더 집중하도록 Lossfunction 자체를 조정한다.
즉 클래스별로 맞히기 어려운 샘플일수록 Loss 비중을 높인다.
\(\gamma\)에 따라 Loss Function의 형태 자체가 달라짐을 볼 수 있다. \(\gamma\)가 0에 가까울수록 예측확률이 낮을때, 즉 확신이 없을때의 Loss가 매우 커서, 학습이 더 강하게 일어남을 확인할 수 있다.
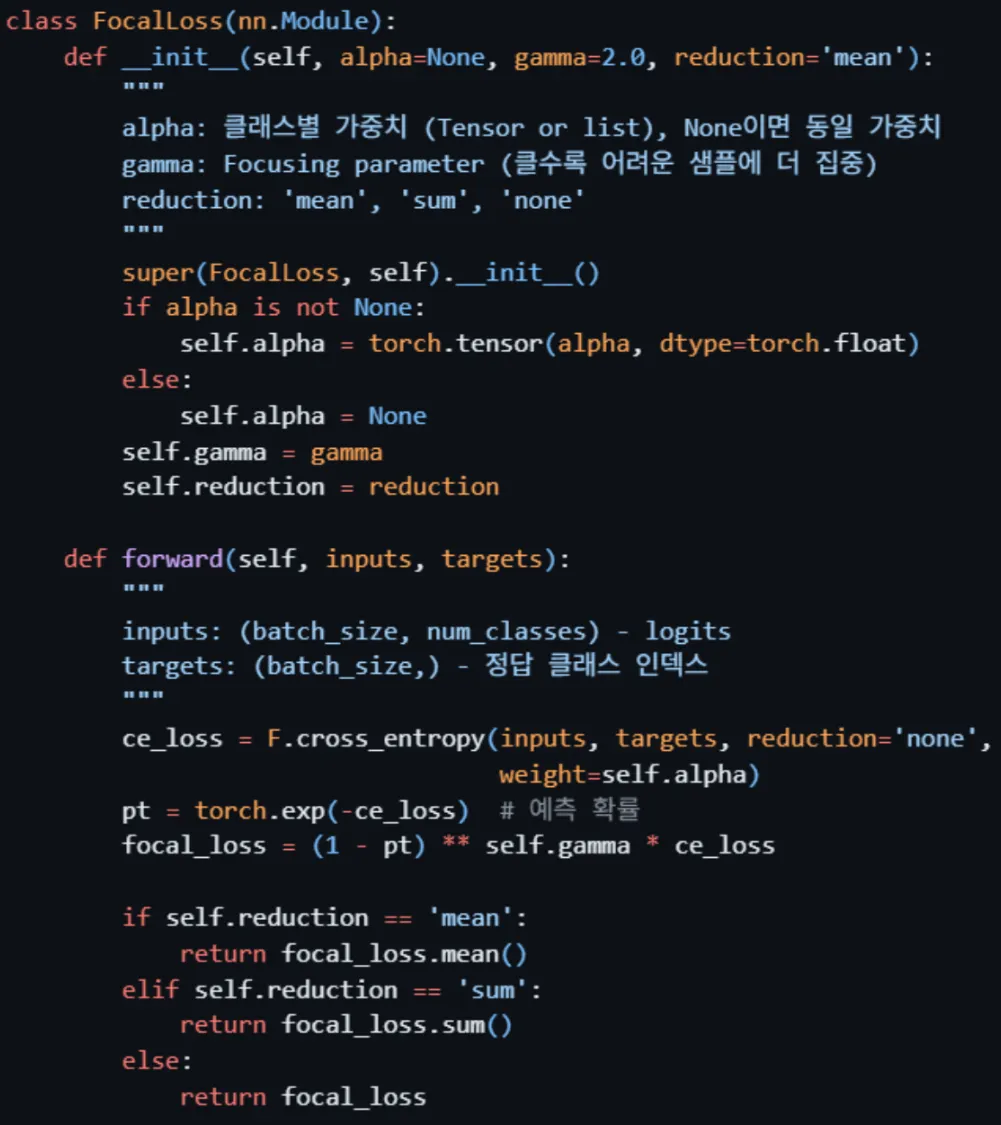
이미지출처: https://stages.ai/en/competitions/370/board/community/post/3051
Living Point
- 메트릭 선택은 우선 데이터에 대한 이해를 기반한다. 데이터가 불균형 데이터인지, 소수클래스에대한 판별을 더 민감하게 반응해야하는지 등을 우선 먼저 파악하고, 무엇을 위해 모델을 학습하는지에 따라 Metric을 선택해야 한다.
- 메트릭과 Loss function의 일관성도 중요하다. Loss를 줄이는 방향이 실제로 Metric을 올리는 방향과 일치해야 한다. 이를 위해 Class-weighted Cross Entropy나 Focal Loss같은 방법을 사용할 수 있다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...