[영화리뷰 감성분류][모델최적화]-EDA
[Domain_Common_Project][모델최적화]-EDA.
[모델최적화]-EDA
데이터셋 형태 및 기본정보
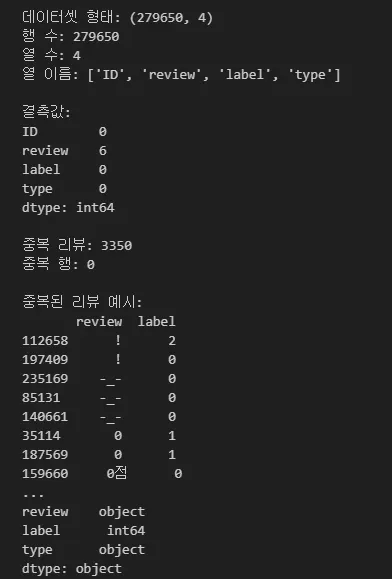
- 28만개의 데이터가 4개의 클래스를 갖는 형태를 띠고있다.
- review가 결측인 데이터가 6개가 있다.
- 중복리뷰는 3350개있다. 이떄 중복면서 label이 서로다른 리뷰가 있는것이 보인다.
타겟변수 분석
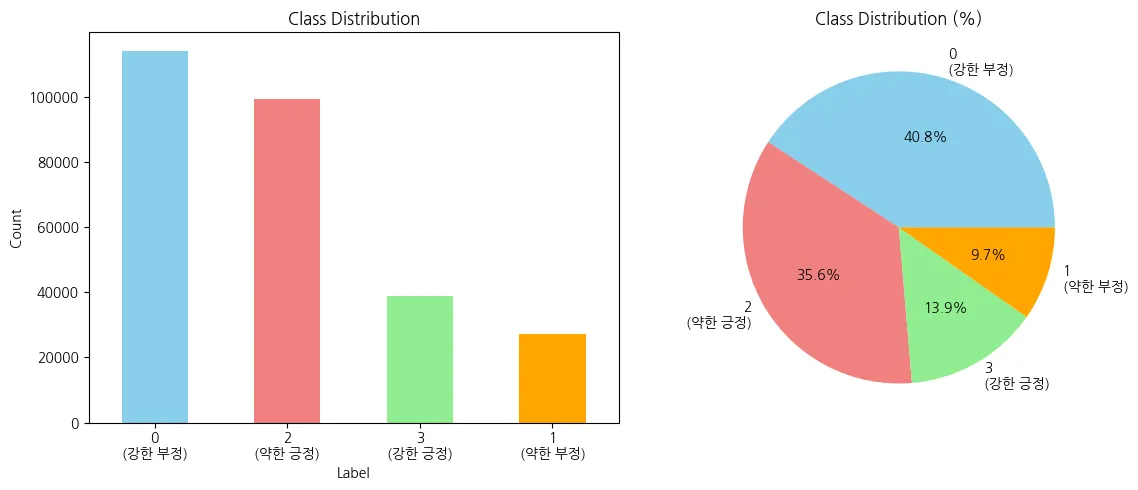
일단 데이터셋은 Imbalance함을 알 수 있따. 강한 긍정과 약한 부정데이터가 상대적으로 적고, 강한 부정과, 약한 긍정 데이터가 많음을 알 수 있다. 모델이 일반화된 학습을 할 수 있도록 Focal Loss나 Weighted Cross Entropy를 사용해야한다.
입력변수 분석
.png)
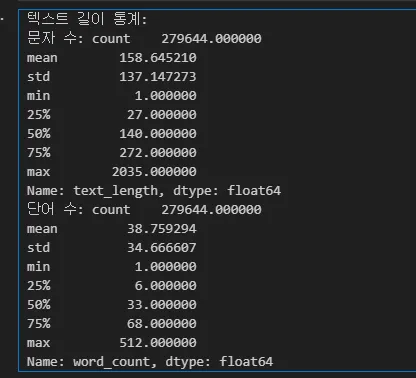
- 텍스트 길이를 분포로 확인해보면 문자수 분포랑 단어수분포가 일반적으로 일치함을 알 수 있다. → 다를이유가 없으니깐
- 일반적으로 x축이 작은곳에 분포가 몰려있고, 그 이후에 종모양의 분포가 있음을 알 수 있다.
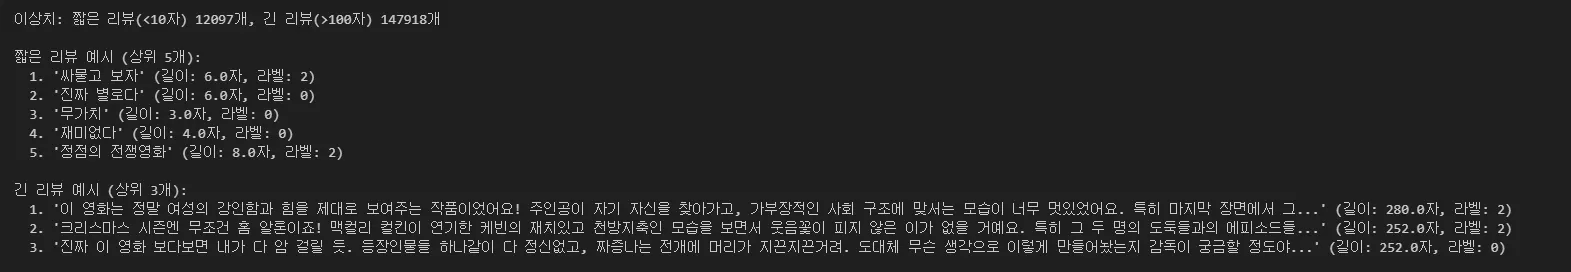
매우 짧은 리뷰와 매우 긴 리뷰를 살펴보면 직관적으로 봤을때는 짧은리뷰나, 긴리뷰나 데이터로 사용할 가치가 있어보인다.(레이블과 리뷰가 일치해보인다.) 일단 데이터로 모두 사용해보고, 이 이상치들을 뺴거나 넣거나 해보자. 특히 짧은 리뷰를 모두 필터링하기에는 데이터셋의 대다수가 필터링되어버리기 때문에, 만약 이상치를 거른다면, 매우 긴 리뷰를 걸러보는 실험을 해볼 수 있을것 같다.
텍스트 품질 평가
- 비어있거나 null인 텍스트 확인
- 잠재적인 데이터 품질 문제 식별
- 언어 일관성 확인
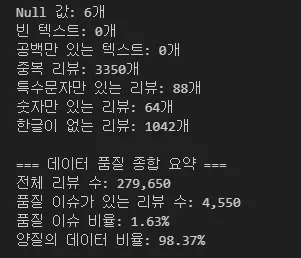
- null값이 6개가 있는데 Feature engineering에서 빼야겠다.
- 중복리뷰는 중복되는 값들을 빼고 한개의 데이터만 남겨서 학습을 해야겠다.
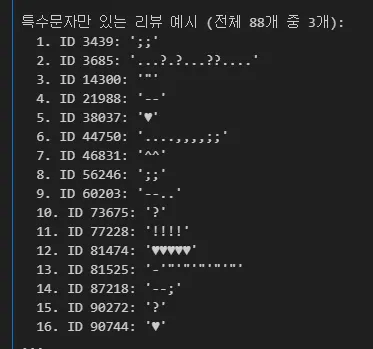
- 특수문자만 있는 리뷰는 특수문자를 특수토큰으로 토크나이징하는 기법을 이용해서 사용해봐야겠다.
- 다만 감정을 표현하는 특수문자인 하트, 느낌표, 물음표등이 있긴 하지만, ;이나 ,같은 특수문자가 있는 리뷰도 있기때문에 일단 빼고 학습하는게 맞는것 같다.
- 이부분은 정규식을 이용해서 !,?,ㅋ,ㅠ,하트이모티콘,~,간단한 이모티콘(^^,:)) 등 몇가지 경우의수를 정해두고, 감성을 포함한 특수문자만 학습데이터에 넣고, 아닌 경우는 데이터에서 빼야겠다.
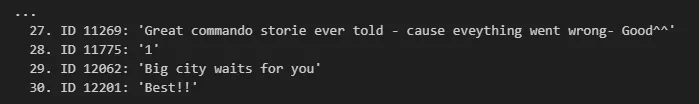
- 숫자만 있는 리뷰는 0점이라면 0, 4점이라면 4 라는식의 리뷰인지 직접 확인해보고 뺄지 넣을지 생각해봐야겠다.
- 한글이 없는 리뷰는 영어로 리뷰를 작성한게 대부분같은데, Tokenizer를 이용할때, 한글이 아닌경우 영어단어도 voca에 추가해서 처리할 수 있는지 고려해봐야될것 같다.
클래스별 텍스트 특성
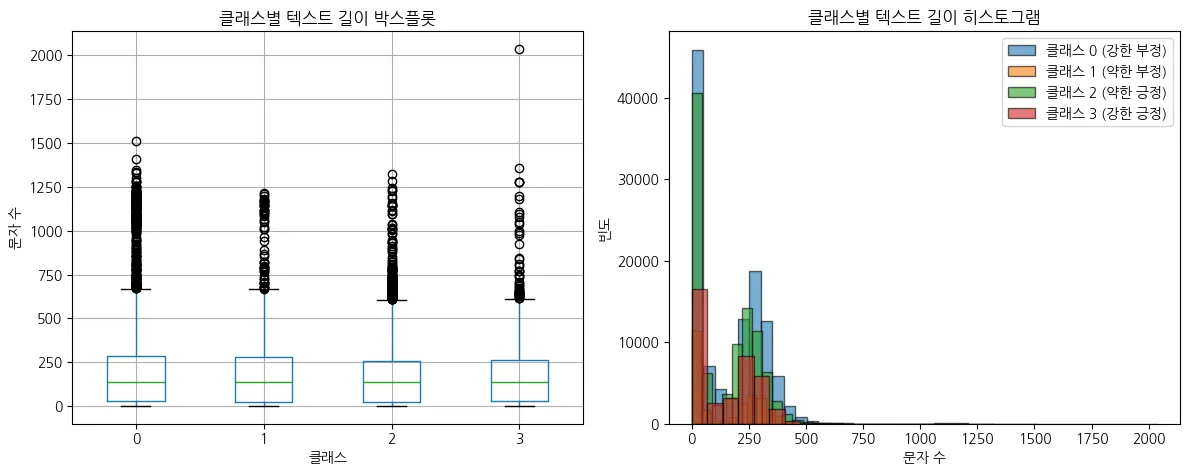
클래스별 텍스트 길이에 유의미한 차이가 있진 않다.→ 텍스트 길이에따라 과적합될 걱정은 안해도 될 것 같다.
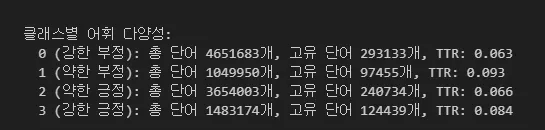
클래스별 어휘의 다양성(TTR)도 유의미한 차이가 보이지는 않는다.
# 한국어 불용어 리스트 확장
# 일단 불용어를 최소화하여 감성 단어가 포함될 수 있도록 조정
stopwords = [
    # --- 조사 ---
    "은", "는", "이", "가", "을", "를", "의", "에", "와", "과", "도",
    "로", "으로", "에서", "에게", "께", "한테", "한테서", "께서",
    # --- 연결 어미 (일부) ---
    "고", "며", "면", "나", "니", "다", "서", "아", "어",
    # --- 대명사/지시사 (문맥 의존성 높음, 최소화) ---
    "그", "저", "이", "것", "곳", "때", "수", # '수 있다/없다' 등에서 중요할 수 있어 포함 여부 실험 필요
    # --- 접속사 (문맥 의존성 높음, 최소화) ---
    "그리고", "그러나", "하지만", "그런데",
    # --- 기타 (문맥 의존성 높음, 최소화) ---
    "한", # '한 번' 등 수식 역할
    # --- 주석 처리된 기존 불용어 중 감성 가능성 있는 단어 ---
    # "있다", "없다", "되다", "하다", "이다", "아니다", "같다", "많다",
    # "좋다", "나쁘다", "정말", "너무", "매우", "아주", "참", "좀",
    # "사람", "것들"
]
- 불용어 리스트를 봤을때, 감성분류 task인 만큼, 좋다, 나쁘다, 정말등등은 불용어가 아니라 감성을 담고있는 단어라고 생각이 들어서 주석처리를 했다. 감성을 담고있지 않은 단어들을 불용어처리 해야하기 때문에 일단 주석처리한 위의 리스트를 학습에 활용해야 겠다.
- BERT는 문맥을 이해하기 때문에 제외할 불용어는 최소화하는걸 추천한다고 한다.
- 어휘사전을 데이터셋이 나뉘기전에 만들어버리면 Data_leakage문제가 발생한다! → k-Fold등으로 데이터셋을 나누고 난 후에 각각 만들어야됨.
클래스별 상위 빈출 단어 (불용어 제외):

0 (강한 부정) - 총 114066개 샘플:
   1. '너무': 106022회 (3.2%)
   2. '진짜': 82753회 (2.5%)
   3. '보는': 55270회 (1.7%)
   4. '정말': 52786회 (1.6%)
   5. '이런': 52545회 (1.6%)
   6. '영화': 49829회 (1.5%)
   7. '영화는': 44978회 (1.4%)
   8. '보고': 44776회 (1.4%)
   9. '영화를': 40348회 (1.2%)
  10. '내내': 39208회 (1.2%)

1 (약한 부정) - 총 27216개 샘플:
   1. '너무': 16454회 (2.2%)
   2. '보고': 10499회 (1.4%)
   3. 'ㅠㅠ': 8538회 (1.1%)
   4. '뭔가': 7251회 (1.0%)
   5. '영화': 7061회 (0.9%)
   6. '보는': 6857회 (0.9%)
   7. '진짜': 6833회 (0.9%)
   8. '정말': 6658회 (0.9%)
   9. '그냥': 6467회 (0.9%)
  10. '영화는': 6200회 (0.8%)

2 (약한 긍정) - 총 99416개 샘플:
   1. '진짜': 60021회 (2.3%)
   2. '정말': 56003회 (2.1%)
   3. '너무': 45092회 (1.7%)
   4. '영화': 34369회 (1.3%)
   5. '보는': 29527회 (1.1%)
   6. '특히': 28620회 (1.1%)
   7. '영화는': 26255회 (1.0%)
   8. '내내': 22921회 (0.9%)
   9. '영화를': 20993회 (0.8%)
  10. '보고': 19278회 (0.7%)

3 (강한 긍정) - 총 38952개 샘플:
   1. '진짜': 46041회 (4.4%)
   2. '정말': 24398회 (2.4%)
   3. '너무': 22577회 (2.2%)
   4. '영화': 17807회 (1.7%)
   5. '영화는': 15968회 (1.5%)
   6. '보는': 12402회 (1.2%)
   7. '특히': 11121회 (1.1%)
   8. '내내': 10439회 (1.0%)
   9. '보고': 9783회 (0.9%)
  10. '영화를': 9369회 (0.9%)
- ‘진짜’를 불용어처리를 막으니깐, 강한긍정, 약한긍정, 강한부정 모두에서 상위권에 속함을 알 수 있다. 이게 실제 모델이 validation할때 어떤 영향을 미칠지는 아직 잘 모르겠는데, 불용어 리스트를 바꿔가며 실험을 해봐야겠다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...