[Domain_Common_Project][모델최적화]-Feature_Engineering
[모델최적화]-Feature_Engineering.
텍스트 전처리 및 정리
- 특수문자 제거, 공백 정규화
- 필요시 한국어 특화 전처리 처리
- 매우 짧거나 긴 텍스트 제거 또는 처리
- 중복 제거
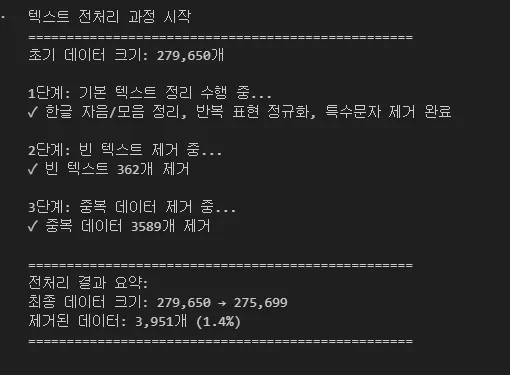
- 자음, 모음만 있는경우를 제거한다.
- 반복되는 표현을 정규화한다. 즉 “ㅋㅋㅋㅋ”나 “ㅎㅎㅎㅎㅎ”같은 표현을 “ㅋㅋ”, “ㅎㅎ”형태로 정규화 한다.
- 비어있는 텍스트는 제거한다.
- 중복되는 데이터도 모두 제거한다.
텍스트 정규화
- 대소문자 정규화
- 구두점 처리
- 특수문자 처리
- URL/이메일/멘션 정리
print("텍스트 정규화 과정 시작")
print("=" * 50)

# 대소문자 정규화 (BERT가 처리하지만 일관성을 위해)
print("\n1단계: 대소문자 정규화 수행 중...")
df_processed["review_normalized"] = df_processed["review_cleaned"].str.lower()
print("✓ 소문자 변환 완료")

# 구두점 정규화
print("\n2단계: 구두점 정규화 수행 중...")

def normalize_punctuation(text):
    # 여러 개의 구두점을 하나로 정규화
    # 1. (수정) 중립 구두점(.,)의 과도한 반복을 1개로 축소 (e.g., "..." -> ".")
    #    BERT의 문맥 유지를 위해 제거하지 않고 '유지'합니다.
    text = re.sub(r"([.,])\1{2,}", r"\1", text)
    # 2. 감성 구두점(!, ?)의 과도한 반복을 2개로 축소 (e.g., "!!!!" -> "!!")
    text = re.sub(r"([!?])\1{2,}", r"\1\1", text)
    text = re.sub(r"[,]{2,}", ",", text)

    #3. (강화) 감성과 관련 없는 특정 노이즈 문자 제거 (확장된 Blacklist 방식)
    #    해시태그, 불필요한 강조, 리스트, 수학/화폐 기호, 일부 괄호 등
    #    (♥, 👍, ^^, >_< 같은 이모티콘/emoji는 이 목록에 없으므로 '유지'됩니다.)
    text = re.sub(
        r"[#*•■◆◇□○●※+=/\\%&{}\[\]$₩€£¥|`]",  # <-- 대폭 확장된 노이즈 리스트
        " ",
        text
    )
    # 정규식 설명:
    # [#*•■◆◇□○●※] : 해시태그, 불릿, 특수 기호
    # [+=/\\%&]       : 수학/기술 기호 ( \는 \\로 이스케이프)
    # [{}\[\]]         : 이모티콘에 사용되지 않는 괄호 ( []는 \로 이스케이프)
    # [$₩€£¥]          : 화폐 기호
    # [|`]             : 파이프, 백틱

    # 4. (수정) 전체 구두점 주변 공백 정리
    text = re.sub(r"\s+([.,!?])", r"\1", text)  # "정말 !" -> "정말!"
    text = re.sub(r"([.,!?])\s+", r"\1 ", text) # "최고! !!" -> "최고! !! "

    # 5. 과도한 공백을 단일 공백으로 최종 정리
    text = re.sub(r"\s+", " ", text)

    return text.strip()

df_processed["review_normalized"] = df_processed["review_normalized"].apply(
    normalize_punctuation
)
print("✓ 구두점 정규화 완료")

# 특수문자 추가 정리
print("\n3단계: 특수문자 정리 수행 중...")

def clean_special_chars(text):
    # URL 패턴 제거 (있는 경우)
    text = re.sub(
        r"http[s]?://(?:[a-zA-Z]|[0-9]|[$-_@.&+]|[!*\\(\\),]|(?:%[0-9a-fA-F][0-9a-fA-F]))+",
        " ",
        text,
    )

    # 이메일 패턴 제거 (있는 경우)
    text = re.sub(r"\S+@\S+", " ", text)

    # 멘션 패턴 제거 (있는 경우)
    text = re.sub(r"@\w+", " ", text)

    # 과도한 공백 정리
    text = re.sub(r"\s+", " ", text)

    return text.strip()

df_processed["review_normalized"] = df_processed["review_normalized"].apply(
    clean_special_chars
)
print("✓ URL/이메일/멘션 제거 완료")

# 정규화 후 빈 텍스트 처리
print("\n4단계: 정규화 후 빈 텍스트 확인 중...")
empty_after_normalization = df_processed["review_normalized"].str.strip().eq("").sum()
if empty_after_normalization > 0:
    df_processed = df_processed[df_processed["review_normalized"].str.strip() != ""]
    print(f"✓ 빈 텍스트 {empty_after_normalization}개 제거")
else:
    print("✓ 빈 텍스트 없음")

# 정규화 전후 비교
print("\n" + "=" * 50)
print("정규화 결과 요약:")
print(f"최종 데이터 크기: {len(df_processed):,}개")
print(f"평균 길이 - 정리됨: {df_processed['review_cleaned'].str.len().mean():.1f}자")
print(
    f"평균 길이 - 정규화됨: {df_processed['review_normalized'].str.len().mean():.1f}자"
)
print("=" * 50)
- 모든문자를 우선 소문자로 정규화 한다.
- 구두점처리
- 중복된 구두점은 1개나 2개로 축소해서 정규화한다.
- 감성과 관련없는 특수문자는 노이즈로 여겨서 BlackList형식으로 제거한다.
- 감성과 관련있는 이모티콘이나, 특수문자는 목록에 넣지 않아서 유지된다.
-
구두점 주변 공백을 정리한다.
- URL패턴이나 이메일패턴, 멘션패턴, 과도한 공백은 감성분류에 도움이 되지 않는 노이즈이므로 제거한다.
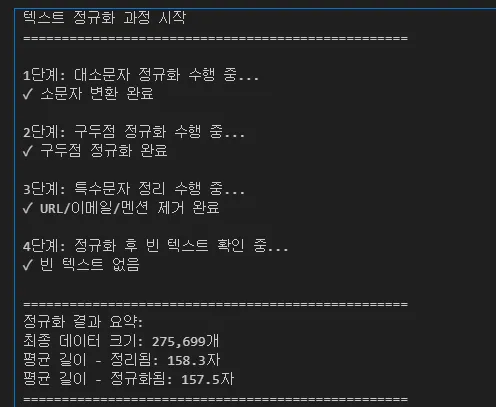
BaseLine코드에서는 최대한 자음/모음만 반복된 패턴, 특수문자, 이모지등을 모두 노이즈처리해서 전처리했었다. 하지만 이것들이 감성분류에 도움이 될수도 있지 않을까라는 생각에 해당 특수문자/ 이모지/ 감정을 나타내는 패턴등을 특수토큰으로 매핑해서 최대한 사용하고자 위의 코드처럼 구현했다.
텍스트 전처리 파이프라인 재구성
- 앞서 정의한 함수들을 이용하여 파이프라인 구성
- DataLeakage를 방지하기 위한 전략을 포함해야 한다.
- 전처리 파라미터는 학습 데이터에서만 학습
- Validation/Test데이터는 학습된 파라미터로만 변환
- 레이블 정보를 활용한 전처리는 학습 시에만 적용
class TextPreprocessingPipeline:
    """
    텍스트 전처리 파이프라인 클래스 (정규식 오류 수정)
    - 전처리 로직을 단일 메서드로 통합 및 최적화
    - fit 메서드: 커스텀 토크나이저를 위한 라벨별 감성 패턴 수집
    """

    def __init__(self):
        self.is_fitted = False
        # fit의 결과물: 라벨별 상위 감성 표현(이모티콘/emoji)을 저장
        self.emotion_patterns_by_label = {}

        # 감성 표현을 찾는 정규식
        # 1. (ㅋㅎㅠㅜㅡ): 한국어 감정 표현 (e.g., ㅋㅋ, ㅠㅠ)
        # 2. (T^>c<;:=_...): 아스키 이모티콘 (e.g., ^_^, T_T, :), >_<)
        # 3. (\U0001F...): 유니코드 이모지 (e.g., 😂, 👍, ♥)

        # --- [수정된 부분] ---
        self.EMOTION_REGEX = re.compile(
            r'([ㅋㅎㅠㅜㅡ]{2,})|'  # 1. 한국어

            # 2. 아스키 (맨 끝에 누락된 ')'를 '|' 앞에 추가)
            r'([T^>c<;:=_]{1,}(?:[-_oO\']{0,1})(?:[\)\]DdpP]|\[<]{1,}))|'

            # 3. 이모지 (캡처 그룹 '()'으로 묶고 맨 뒤의 불필요한 ')' 제거)
            r'([\U0001F600-\U0001F64F\U0001F300-\U0001F5FF\U0001F680-\U0001F6FF\U0001F1E0-\U0001F1FF\u2600-\u26FF\u2700-\u27BF♥👍😂])'
        )
        # --- [수정 완료] ---

    def _clean_noise_patterns(self, text: str) -> str:
        """[1순위] URL, 이메일, 멘션 등 패턴 기반 노이즈 제거"""
        text = re.sub(
            r"http[s]?://(?:[a-zA-Z]|[0-9]|[$-_@.&+]|[!*\\(\\),]|(?:%[0-9a-fA-F][0-9a-fA-F]))+",
            " ", text
        )
        text = re.sub(r"\S+@\S+", " ", text)
        text = re.sub(r"@\w+", " ", text)
        return text


    def _apply_preprocessing_rules(self, text: str) -> str:
        """
        [핵심] 기본 전처리 및 정규화 규칙을 '올바른 순서'로 적용
        """
        if pd.isna(text):
            return ""

        text = str(text).strip()

        # 1. (가장 먼저) URL, 이메일, 멘션 등 노이즈 패턴 제거
        text = self._clean_noise_patterns(text)

        # 2. 소문자화 (BERT가 처리하지만 일관성을 위해)
        text = text.lower()

        # 3. (강화) 감성과 관련 없는 특정 노이즈 문자 제거 (Blacklist)
        text = re.sub(
            r"[#*•■◆◇□○●※+=/\\%&{}\[\]$₩€£¥|`]", " ", text
        )

        # 4. 한국어 특화 정리 (자음/모음만 있는 경우)
        # text = re.sub(r"[ㄱ-ㅎㅏ-ㅣ]+", "", text)

        # 5. 감정 표현 정규화 (e.g., ㅋㅋㅋ -> ㅋㅋ, ㅠㅠㅠ -> ㅠㅠ)
        text = re.sub(r"([ㅋㅎ])\1{2,}", r"\1\1", text)
        text = re.sub(r"([ㅠㅜㅡ])\1{2,}", r"\1\1", text)

        # 6. 구두점 정규화
        text = re.sub(r"([.,])\1{2,}", r"\1", text)     # e.g., "..." -> "."
        text = re.sub(r"([!?])\1{2,}", r"\1\1", text)  # e.g., "!!!!" -> "!!"

        # 7. 구두점 주변 공백 정리
        text = re.sub(r"\s+([.,!?])", r"\1", text)
        text = re.sub(r"([.,!?])\s+", r"\1 ", text)

        # 8. (마지막) 과도한 공백을 단일 공백으로 최종 정리
        text = re.sub(r"\s+", " ", text)

        return text.strip()

    def fit(self, texts: pd.Series, labels: pd.Series):
        """
        학습 데이터(texts, labels)로부터 전처리 정보(감성 패턴)를 학습합니다.
        """
        print("학습 데이터 기반 감성 패턴 수집 중...")

        if not isinstance(texts, pd.Series):
            texts = pd.Series(texts)
        if not isinstance(labels, pd.Series):
            labels = pd.Series(labels)

        # 1. 분석 전, 텍스트에 기본 정규화 규칙을 먼저 적용합니다.
        processed_texts = texts.apply(self._apply_preprocessing_rules)

        df = pd.DataFrame({'text': processed_texts, 'label': labels})

        # 2. 라벨별로 순회하며 감성 패턴(이모티콘, emoji 등)을 찾습니다.
        for label in sorted(df['label'].unique()):
            label_texts = df[df['label'] == label]['text']

            # findall과 explode를 사용해 모든 감성 표현을 추출
            all_emotions = label_texts.str.findall(self.EMOTION_REGEX).explode().dropna()

            # 튜플로 반환되는 정규식 결과를 (e.g., ('ㅋㅋ', '', '')) 하나로 합침
            # (튜플이 비어있는 경우 방지)
            cleaned_emotions = []
            for tup in all_emotions:
                found = next((item for item in tup if item), None)
                if found:
                    cleaned_emotions.append(found)

            # 3. 빈도를 계산하고 상위 10개를 저장합니다.
            top_emotions = Counter(cleaned_emotions).most_common(10)
            self.emotion_patterns_by_label[label] = top_emotions

        self.is_fitted = True
        print("✓ 감성 패턴 수집 완료 (파이프라인 학습 완료)")

        # 수집된 정보 예시 출력
        print("\n--- 수집된 라벨별 상위 감성 패턴 (예시) ---")
        for label, patterns in self.emotion_patterns_by_label.items():
            print(f"  [Label {label}]: {patterns}")
        print("------------------------------------------")

    def transform(self, texts: pd.Series) -> pd.Series:
        """
        학습된 파이프라인(또는 기본 파이프라인)을 사용하여 텍스트를 변환합니다.
        """
        if not self.is_fitted:
            print(
                "Warning: 파이프라인이 'fit'되지 않았습니다. 기본 전처리 규칙만 적용합니다."
            )

        if not isinstance(texts, pd.Series):
            texts = pd.Series(texts)

        # _apply_preprocessing_rules 함수를 .apply로 효율적으로 적용
        processed_texts = texts.apply(self._apply_preprocessing_rules)

        return processed_texts

    def fit_transform(self, texts: pd.Series, labels: pd.Series) -> pd.Series:
        """학습과 변환을 동시에 수행합니다."""
        self.fit(texts, labels)
        return self.transform(texts)

#파이프라인 인스턴스 생성
preprocessor = TextPreprocessingPipeline()
- 이전에 정의한 함수들을 이용해서 데이터 전처리 파이프라인 Class를 생성한다.
clean_noise_pattens(),_apply_preprocessing_rules()함수를 통해 텍스트를 전처리한다.
fit()메서드에서는 이후 k-fold방식으로 나눌 데이터들의 특징을 시각화하고, 확인하는 방법들을 사용한다. → 상위 10개 저장- 데이터들의 특징(이모지 빈도, 감성표현 ‘ㅋㅋ’등의 빈도)을 확인하고 토크나이저에 특수토큰을 추가한다.
- 파이프라인 인스턴스를
preprocessor로 선언한다.
BERT 전용 전처리 확인
- BERT 토크나이저를 사용해서 토큰화
- 토큰화 길이 제한 처리(BERT는 512 이하 토큰으로 제한)
- 특수 토큰 추가([CLS],[SEP])
- 어텐션 마스크 생성
- 절단 및 패딩 전략 처리
# BERT 토크나이저 초기화
# model_name = "klue/bert-base"
model_name = "beomi/kcbert-base"
tokenizer = AutoTokenizer.from_pretrained(model_name)

print(
    f"BERT 토크나이저: {model_name}, vocab: {tokenizer.vocab_size}, max_length: {tokenizer.model_max_length}"
)
모델 제한에 따라서 제한된 모델중 일단 "beomi/kcbert-base" 모델을 사용한다. 이 모델은 온라인 댓글, 뉴스 리뷰 등 비정형적인 텍스트를 포함한 대용량의 한국어 데이터로 학습되어있다고 한다. 따라서 영화리뷰를 분석할때, 신조어, 이모지, 구어체 문장에 대한 이해도가 가장 높을것으로 기대한다.
# --- 1단계: 특수 토큰 및 치환 규칙 정의 ---
# 이 규칙은 preprocessor.fit()의 통계 결과를 바탕으로 '개발자가' 정의하는 것입니다.
# (예시: {'Label 0': [('ㅠㅠ', 5000)], 'Label 3': [('ㅋㅋ', 8000), ('♥', 500)]})

# 1. 새로 추가할 특수 토큰 리스트
# (모델이 이 토큰을 하나의 의미 단위로 학습하게 됩니다)
NEW_SPECIAL_TOKENS = [
    "[LAUGH]",  # 웃음 (ㅋㅋ, ㅎㅎ 등)
    "[CRY]",    # 울음 (ㅠㅠ, ㅜㅜ 등)
    "[SMILE]",  # 미소 (^^, :) 등)
    "[HEART]",  # 하트 (♥, ♡ 등)
    "[EMOJI]",  # 기타 이모지 (👍, 😂 등)
]

# 2. 원본 텍스트를 위 특수 토큰으로 치환하기 위한 매핑 (정규식)
# (순서가 중요합니다. 더 긴 것을 먼저 처리해야 합니다. e.g., ㅠㅠ > ㅠ)
EMOTION_MAP = {
    re.compile(r'([ㅋㅎ]){2,}'): "[LAUGH]",  # ㅋㅋ, ㅎㅎ, ㅋㅋㅋㅋ 등
    re.compile(r'([ㅠㅜ]){2,}'): "[CRY]",    # ㅠㅠ, ㅜㅜ, ㅠㅠㅠ 등
    re.compile(r'(\^{2,})|(\:\))|(\:D)'): "[SMILE]", # ^^, :), :D 등
    re.compile(r'[♥♡]'): "[HEART]",        # ♥, ♡
    # 기타 일반 유니코드 이모지 (fit에서 자주 보인 것들)
    re.compile(r'[👍😂😥🤔]'): "[EMOJI]",
}

def replace_emotions_with_tokens(text: str) -> str:
    """
    토크나이저에 넣기 전, 텍스트의 감성 표현을 특수 토큰 문자열로 치환합니다.
    """
    for pattern, token in EMOTION_MAP.items():
        text = pattern.sub(token, text)
    return text

# --- 2단계: 토크나이저 로드 및 특수 토큰 추가 ---

print("토크나이저 로드 및 특수 토큰 추가 중...")
MODEL_NAME = "beomi/kcbert-base"  # 우리가 선택한 모델
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

print(f"원본 어휘 사전 크기: {len(tokenizer)}")
tokenizer.add_special_tokens({"additional_special_tokens": NEW_SPECIAL_TOKENS})
print(f"신규 토큰 추가 후 어휘 사전 크기: {len(tokenizer)}")

# 중요: 이 작업 후, 모델을 로드할 때 반드시
# model.resize_token_embeddings(len(tokenizer)) 를 호출해야 합니다.

# --- 3단계: 개선된 BERT 인코딩 함수 (배치 처리) ---

def bert_tokenize_and_encode(texts: list, tokenizer, max_length=256, labels=None):
    """
    (개선) BERT를 위한 텍스트 배치(batch) 토큰화 및 인코딩
    - (신규) 감성 토큰 치환 기능 포함
    - (개선) for 루프 대신 빠른 배치 인코딩 사용
    """

    # 1. (신규) 텍스트를 특수 토큰 문자열로 먼저 치환합니다.
    # (이 작업이 빠지면 [LAUGH] 토큰이 아무 의미가 없습니다)
    print("감성 표현을 특수 토큰 문자열로 치환 중...")
    try:
        processed_texts = [replace_emotions_with_tokens(text) for text in texts]
    except Exception as e:
        print(f"Error during text replacement: {e}")
        processed_texts = texts # 실패 시 원본 사용

    print("배치 인코딩 수행 중 (대용량 처리)...")
    # 2. (개선) for 루프 대신, 리스트 전체를 한 번에 토크나이저에 전달
    encoded_batch = tokenizer(
        processed_texts,
        add_special_tokens=True,      # [CLS], [SEP] 토큰 추가
        max_length=max_length,        # 최대 길이 제한
        padding="max_length",         # 최대 길이까지 패딩
        truncation=True,              # 길이 초과시 절단
        return_attention_mask=True,   # 어텐션 마스크 생성
        return_token_type_ids=True,   # 토큰 타입 ID 생성 (BERT/KcBERT는 사용)
        return_tensors="pt",          # PyTorch 텐서로 반환
    )

    # 'encoded_batch'는 이미 'input_ids', 'attention_mask' 등이 포함된 딕셔너리

    if labels is not None:
        # labels를 파이토치 텐서로 변환
        encoded_batch["labels"] = torch.tensor(labels, dtype=torch.long)

    print("배치 인코딩 완료.")
    return encoded_batch

# --- (수정 없음) 토큰 길이 분석 함수 ---
def analyze_token_lengths(texts, tokenizer, max_length=256):
    """토큰 길이 분포 분석 (tokenizer를 인자로 받도록 수정)"""
    token_lengths = []

    # 감성 토큰 치환을 먼저 적용
    processed_texts = [replace_emotions_with_tokens(text) for text in texts]

    print("토큰 길이 분석 중...")
    for text in processed_texts:
        tokens = tokenizer.tokenize(text) # .tokenize()는 특수토큰([CLS]) 미포함
        token_lengths.append(len(tokens))

    token_lengths = np.array(token_lengths)

    print(
        f"토큰 길이: 평균 {token_lengths.mean():.1f}, 중앙값 {np.median(token_lengths):.1f}, 범위 {token_lengths.min()}-{token_lengths.max()}"
    )
    print(
        f"분석 기준 MaxLength {max_length} 토큰 초과: {(token_lengths > max_length).sum()}개 ({(token_lengths > max_length).mean() * 100:.1f}%)"
    )
    return token_lengths
- 토크나이저에 커스텀하기 위해 특수토큰을 추가한다.
--- 수집된 라벨별 상위 감성 패턴 (예시) ---
  [Label 0]: [('ㅠㅠ', 33867), ('ㅋㅋ', 7427), ('ㅡㅡ', 2363), ('ㅎㅎ', 954), ('ㅜㅜ', 519), ('😡', 44), ('★', 33), ('ㅋㅋㅠㅠ', 30), ('ㅡㅡㅋ', 26), ('ㅜㅠ', 24)]
  [Label 1]: [('ㅠㅠ', 9489), ('ㅎㅎ', 2362), ('ㅋㅋ', 1856), ('ㅜㅜ', 86), ('ㅡㅡ', 78), ('★', 26), ('😊', 22), ('🌟', 18), ('ㅠㅜ', 12), ('♥', 11)]
  [Label 2]: [('ㅎㅎ', 19727), ('ㅋㅋ', 9407), ('ㅠㅠ', 5677), ('♥', 832), ('🌟', 640), ('✨', 510), ('ㅜㅜ', 477), ('😊', 415), ('♡', 360), ('👍', 351)]
  [Label 3]: [('ㅎㅎ', 5713), ('ㅠㅠ', 4948), ('ㅋㅋ', 3900), ('♥', 2067), ('♡', 571), ('ㅜㅜ', 391), ('🌟', 330), ('★', 206), ('✨', 142), ('👍', 137)]
------------------------------------------
수집된 라벨별 감성패턴을 보면 ‘ㅠㅠ’나 ‘ㅋㅋ’같은 감정패턴은 레이발과 상관없이 자주 등장함을 볼 수 있다. 따라서 노이즈처리를 해야하나 고민을 해보았다.
하지만 BERT기반 모델은 문맥을 이해하므로 이러한 토큰을 남겨두는게 유리하다.
- Bidirectional Processing: BERT는 한방향으로만 학습을 하는게 아니라, 문장 전체를 한번에 어텐션으로 보고, 특정 단어의 의미를 파악할때 그 단어의 앞뒤 모든 단어정보를 동시에 활용한다.
- Self-Attention: BERT는 Multi Head-self Attention(head는 12개)을 이용해서 문장 전체의 문맥을 병렬적으로 파악한다.
데이터 분할 전략
- 훈련/검증 데이터 분할
- 클래스 분포를 유지하는 계층적 분할
우선 stratified K-Fold cross validation을 사용한다. 데이터셋을 5개로 나누고, 각각 validation데이터를 20%, train 데이터를 80%로 사용해서 서로 다른 경우의수 5번을 학습시킨다. 이후 추론단계에서는 5개의 모델을 앙상블해서 소프트 voting을 통해 추론결과를 도출해낸다.
from sklearn.model_selection import StratifiedKFold
from sklearn.utils.class_weight import compute_class_weight
from transformers import AutoTokenizer, AutoModelForSequenceClassification, TrainingArguments, DataCollatorWithPadding, Trainer
import numpy as np
import pandas as pd
import torch
import os
import torch.nn.functional as F # 앙상블 시 필요
from torch.utils.data import DataLoader # 추론 시 필요

# (기존 변수들: USE_WANDB, SAVE_MODEL, df, RANDOM_STATE, ...)
# (기존 클래스/함수 정의: TextPreprocessingPipeline, replace_emotions_with_tokens, ReviewDataset, CustomTrainer, compute_metrics, ...)

USE_WANDB = True
SAVE_MODEL = True # ★★★ 모델 저장을 True로 유지

# 사용할 전체 데이터 (전처리 파이프라인 적용 전 원본)
X_full = df["review"]
y_full = df["label"]
ids_full = df["ID"]

# Stratified K-Fold 설정
N_SPLITS = 5
skf = StratifiedKFold(n_splits=N_SPLITS, shuffle=True, random_state=RANDOM_STATE)

print(f"\nStratified {N_SPLITS}-Fold Cross Validation 시작...")

fold_metrics = []
all_fold_train_history = []
saved_model_paths = [] # ★★★ [추가] 각 Fold의 베스트 모델 저장 경로 리스트

# K-Fold 루프 시작
for fold, (train_index, val_index) in enumerate(skf.split(X_full, y_full)):
    print(f"\n===== Fold {fold+1}/{N_SPLITS} =====")

    # ... (1. 데이터 분할 ~ 7. 데이터셋 생성 까지는 동일) ...

    # 1. 현재 Fold의 훈련/검증 데이터 분할 (원본 데이터 사용)
    X_train, X_val = X_full.iloc[train_index], X_full.iloc[val_index]
    y_train, y_val = y_full.iloc[train_index], y_full.iloc[val_index]
    ids_train, ids_val = ids_full.iloc[train_index], ids_full.iloc[val_index]
    print(f"훈련 데이터: {len(X_train)}개, 검증 데이터: {len(X_val)}개")

    # 2. 전처리 파이프라인 적용 (각 Fold마다 새로 학습)
    preprocessor_fold = TextPreprocessingPipeline() # 매 Fold마다 새 인스턴스
    print("현재 Fold 훈련 데이터에 대한 전처리 파이프라인 학습 및 적용...")
    X_train_processed = preprocessor_fold.fit_transform(X_train, y_train)
    print("현재 Fold 검증 데이터에 전처리 파이프라인 적용...")
    X_val_processed = preprocessor_fold.transform(X_val)

    # 3. 특수 토큰 치환 적용
    print("훈련/검증 데이터에 특수 토큰 치환 적용 중...")
    X_train_replaced = [replace_emotions_with_tokens(text) for text in X_train_processed.tolist()]
    X_val_replaced = [replace_emotions_with_tokens(text) for text in X_val_processed.tolist()]
    print("✓ 특수 토큰 치환 완료")

    # 4. 모델 학습용 DataFrame 생성 (현재 Fold 용)
    train_data_fold = pd.DataFrame(
        {"ID": ids_train.tolist(), "review": X_train_replaced, "label": y_train.tolist()}
    )
    val_data_fold = pd.DataFrame(
        {"ID": ids_val.tolist(), "review": X_val_replaced, "label": y_val.tolist()}
    )

    # 5. 토크나이저 초기화 및 특수 토큰 추가 (매 Fold마다)
    print(f"\nFold {fold+1}: 토크나이저 로딩 및 수정 ({model_name})")
    tokenizer_fold = AutoTokenizer.from_pretrained(model_name)
    tokenizer_fold.add_special_tokens({"additional_special_tokens": NEW_SPECIAL_TOKENS})
    print(f"Fold {fold+1}: 어휘 사전 크기: {len(tokenizer_fold)}")

    # 6. 모델 초기화 및 임베딩 크기 조정 (매 Fold마다)
    print(f"Fold {fold+1}: 모델 로딩 및 수정 ({model_name})")
    model_fold = AutoModelForSequenceClassification.from_pretrained(
        model_name,
        num_labels=NUM_CLASSES,
    )
    model_fold.resize_token_embeddings(len(tokenizer_fold))
    print(f"Fold {fold+1}: 모델 임베딩 크기 조정 완료.")
    model_fold.to(device) # 모델을 GPU로 이동

    # 7. 데이터셋 생성 (현재 Fold 데이터 사용)
    print(f"Fold {fold+1}: 데이터셋 생성 중...")
    train_dataset_fold = ReviewDataset(
        train_data_fold["review"],
        train_data_fold["label"],
        tokenizer_fold,
        CHOSEN_MAX_LENGTH,
    )
    val_dataset_fold = ReviewDataset(
        val_data_fold["review"],
        val_data_fold["label"],
        tokenizer_fold,
        CHOSEN_MAX_LENGTH,
    )
    print(f"Fold {fold+1}: 훈련 {len(train_dataset_fold)}개, 검증 {len(val_dataset_fold)}개 데이터셋 생성 완료.")

    # 8. 클래스 가중치 계산 (현재 Fold 훈련 데이터 기준)
    print(f"Fold {fold+1}: 클래스 가중치 계산 중...")
    class_weights_fold = compute_class_weight(
        'balanced',
        classes=np.unique(y_train), # 현재 Fold의 y_train 사용
        y=y_train.to_numpy()
    )
    class_weights_tensor_fold = torch.tensor(class_weights_fold, dtype=torch.float)
    print(f"Fold {fold+1}: 계산된 클래스 가중치: {class_weights_tensor_fold}")

    # 9. TrainingArguments 설정 (출력 디렉토리 변경)
    # ★★★ output_dir을 명확하게 지정합니다.
    output_dir_fold = f"./results_fold_{fold+1}"

    training_args_fold = TrainingArguments(
        output_dir=output_dir_fold, # Fold별 디렉토리
        num_train_epochs=NUM_EPOCHS,
        per_device_train_batch_size=BATCH_SIZE_TRAIN,
        per_device_eval_batch_size=BATCH_SIZE_EVAL,
        warmup_steps=WARMUP_STEPS,
        weight_decay=WEIGHT_DECAY,
        learning_rate=LEARNING_RATE,
        logging_steps=100,
        eval_strategy="epoch",
        save_strategy="epoch",
        load_best_model_at_end=True, # ★★★ 훈련 종료 후 최고 모델 로드
        metric_for_best_model="accuracy",
        greater_is_better=True,
        save_total_limit=1,
        report_to="wandb" if USE_WANDB else "none",
        run_name=f"kfold_{fold+1}_{model_name.split('/')[-1]}" if USE_WANDB else None,
        seed=RANDOM_STATE,
        fp16=torch.cuda.is_available(),
        dataloader_num_workers=2,
        remove_unused_columns=False,
    )

    # 10. Custom Trainer 정의 (이미 완료됨)

    # 11. Custom Trainer 초기화 (현재 Fold 데이터 및 가중치 사용)
    print(f"Fold {fold+1}: Custom Trainer 초기화 중...")
    trainer_fold = CustomTrainer(
        model=model_fold,
        args=training_args_fold,
        train_dataset=train_dataset_fold,
        eval_dataset=val_dataset_fold,
        tokenizer=tokenizer_fold,
        data_collator=DataCollatorWithPadding(tokenizer=tokenizer_fold),
        compute_metrics=compute_metrics,
        class_weights=class_weights_tensor_fold
    )
    print(f"Fold {fold+1}: ✓ Custom Trainer 초기화 완료")

    # 12. 모델 훈련 실행
    print(f"Fold {fold+1}: 모델 훈련 시작...")
    try:
        train_result = trainer_fold.train()
        print(f"Fold {fold+1}: ✓ 모델 훈련 완료")

        # 13. 현재 Fold 검증 성능 평가 및 저장
        print(f"Fold {fold+1}: 검증 데이터 평가 중...")
        eval_results = trainer_fold.evaluate()
        fold_metrics.append(eval_results) # 결과 저장
        print(f"Fold {fold+1}: ✓ 검증 완료: {eval_results}")

        # --- ★★★ [수정] 앙상블을 위한 모델/토크나이저 저장 ---
        # load_best_model_at_end=True이므로,
        # trainer_fold.model은 이미 베스트 모델 상태입니다.
        if SAVE_MODEL:
            # TrainingArguments의 output_dir과 별개로
            # 앙상블에 사용하기 쉬운 명확한 경로에 저장합니다.
            save_path = f"./best_model_fold_{fold+1}"
            trainer_fold.save_model(save_path)
            tokenizer_fold.save_pretrained(save_path)

            # [추가] 저장된 경로를 리스트에 추가합니다.
            saved_model_paths.append(save_path)
            print(f"Fold {fold+1}: 최고 성능 모델 저장 완료: {save_path}")
        # ---------------------------------------------------

    except Exception as e:
        print(f"Fold {fold+1}: 훈련/평가 중 오류 발생: {e}")
        fold_metrics.append(None)

    # 메모리 정리
    del model_fold, tokenizer_fold, train_dataset_fold, val_dataset_fold, trainer_fold
    if torch.cuda.is_available():
        torch.cuda.empty_cache()

# K-Fold 루프 종료
print(f"\n===== Stratified {N_SPLITS}-Fold Cross Validation 종료 =====")

# --- 최종 결과 분석 (기존 코드와 동일) ---
# ... (avg_accuracy, std_accuracy 등 계산 및 출력) ...
print("\n===== 최종 교차 검증 결과 분석 =====")
valid_results = [m for m in fold_metrics if m is not None]
if len(valid_results) > 0:
    avg_accuracy = np.mean([m['eval_accuracy'] for m in valid_results])
    std_accuracy = np.std([m['eval_accuracy'] for m in valid_results])
    # ... (기타 F1, Loss 계산) ...
    print(f"총 {len(valid_results)}개 Fold 결과 분석:")
    print(f"  평균 검증 정확도 (Accuracy): {avg_accuracy:.4f} ± {std_accuracy:.4f}")
    # ... (기타 F1, Loss 출력) ...
else:
    print("오류로 인해 유효한 교차 검증 결과가 없습니다.")
print("===================================")
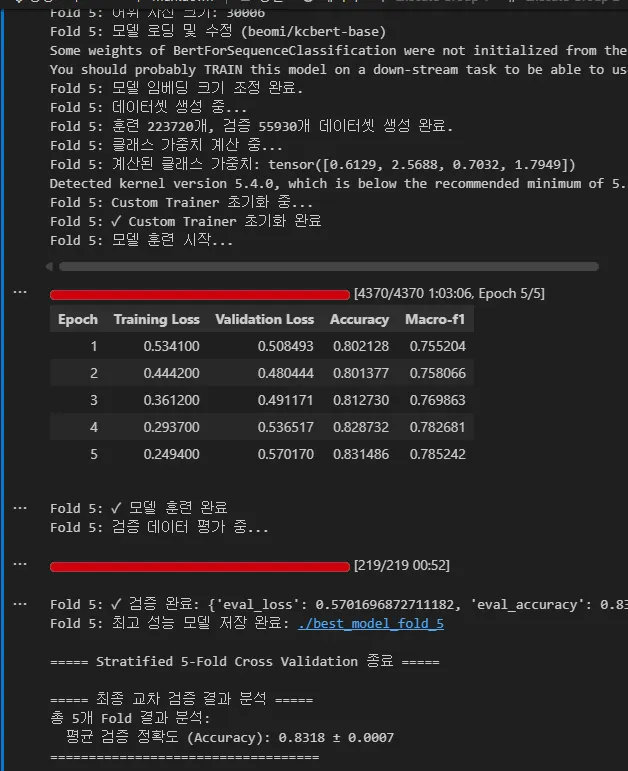
무언가 잘못된것인지 각 Fold마다 Training Loss는 줄어드는 추세를 보이지만, Validation Loss는 줄어들지 않는 경향을 보였다. 그리고 Training Loss는 계속해서 줄어드는 추세를 보여서, 이후에는 과적합 문제를 해결한다음, epoch을 더 늘려서 Loss를 줄이는 방법을 고려해봐야겠다.
최종 Cross Validation을평균내보면 0.8318로 초기 모델의 acc인 0.8보다 3%정도 성능향상이 있음을 확인할 수 있다.
print("\n===== 앙상블 추론(Inference) 시작 =====")

# 1. 테스트 데이터 로드 (e.g., Cell 37)
print("테스트 데이터 로딩...")
try:
    # (test.csv 경로는 실제 환경에 맞게 수정)
    df_test = pd.read_csv("test.csv")
    X_test = df_test["review"]
    ids_test = df_test["ID"]
    print(f"테스트 데이터 {len(df_test)}개 로드 완료.")
except FileNotFoundError:
    print("Error: test.csv 파일을 찾을 수 없습니다. 추론을 중단합니다.")
    # 이 경우 아래 코드는 실행되지 않습니다.

if 'df_test' in locals(): # 테스트 데이터가 성공적으로 로드되었는지 확인

    # 2. 테스트 데이터 전처리
    # ★★★ 중요: 전처리 파이프라인은 K-Fold에 사용한 *전체* 훈련 데이터로
    # 다시 학습(fit)한 후, 테스트 데이터에 적용(transform)해야 합니다.
    # (K개 Fold 중 하나의 파이프라인을 사용하는 것은 편향될 수 있음)

    print("\n2. 전체 훈련 데이터로 최종 전처리기 학습...")
    final_preprocessor = TextPreprocessingPipeline()
    # K-Fold 루프 밖의 X_full, y_full 사용
    final_preprocessor.fit(X_full, y_full)

    print("테스트 데이터에 전처리기 적용...")
    X_test_processed = final_preprocessor.transform(X_test)

    print("테스트 데이터에 특수 토큰 치환 적용...")
    X_test_replaced = [replace_emotions_with_tokens(text) for text in X_test_processed.tolist()]
    print("✓ 전처리 및 치환 완료.")

    # 3. K-Fold 모델 앙상블 추론
    all_fold_logits = [] # K개 모델의 로짓(logits)을 저장할 리스트
    saved_model_paths = [f"./best_model_fold_{i+1}" for i in range(N_SPLITS)]
    print(f"\n3. {len(saved_model_paths)}개 Fold 모델로 추론 수행...")

    for fold, model_path in enumerate(saved_model_paths):
        print(f"--- Fold {fold+1} 모델 추론 ({model_path}) ---")

        # A. Fold별 저장된 모델 및 토크나이저 로드
        print("모델 및 토크나이저 로딩...")
        tokenizer_inf = AutoTokenizer.from_pretrained(model_path)
        model_inf = AutoModelForSequenceClassification.from_pretrained(model_path)
        model_inf.to(device)
        model_inf.eval()

        # B. 테스트 데이터셋 생성 (Fold의 토크나이저 사용)
        # ReviewDataset이 레이블을 필요로 하므로, 더미 레이블 생성
        test_labels_dummy = [0] * len(X_test_replaced)

        test_dataset_inf = ReviewDataset(
            reviews=X_test_replaced,
            labels=test_labels_dummy,
            tokenizer=tokenizer_inf,
            max_length=CHOSEN_MAX_LENGTH
        )

        test_data_collator = DataCollatorWithPadding(tokenizer=tokenizer_inf)

        # C. 추론 실행 (Trainer의 .predict() 메소드 활용)
        # 추론용 TrainingArguments (간단하게 설정)
        test_args = TrainingArguments(
            output_dir=f"./temp_inference_output_{fold+1}",
            per_device_eval_batch_size=BATCH_SIZE_EVAL, # 훈련 시 eval 배치 크기 사용
            fp16=torch.cuda.is_available(),
            dataloader_num_workers=2,
            report_to="none", # 추론 시 로그 불필요
        )

        trainer_inf = Trainer(
            model=model_inf,
            args=test_args,
            tokenizer=tokenizer_inf,
            data_collator=test_data_collator,
        )

        # .predict()는 (predictions, label_ids, metrics) 튜플 반환
        # predictions는 로짓(logits)이 담긴 numpy 배열입니다.
        predictions_output = trainer_inf.predict(test_dataset_inf)
        fold_logits_np = predictions_output.predictions

        # numpy 배열을 torch 텐서로 변환하여 리스트에 추가
        all_fold_logits.append(torch.tensor(fold_logits_np))
        print(f"Fold {fold+1} 추론 완료. 로짓 shape: {fold_logits_np.shape}")

        # 메모리 정리
        del model_inf, tokenizer_inf, test_dataset_inf, trainer_inf
        if torch.cuda.is_available():
            torch.cuda.empty_cache()

    # 4. K-Fold 예측 결과 앙상블 (Averaging)
    print("\n4. K-Fold 예측 결과 앙상블 (Averaging)...")

    # all_fold_logits 리스트에는 (num_test_samples, num_classes) 텐서가 K개 있음
    # torch.stack을 사용해 (K, num_test_samples, num_classes) 텐서로 만듦
    stacked_logits = torch.stack(all_fold_logits)
    print(f"Stacked logits shape (K, N_samples, N_classes): {stacked_logits.shape}")

    # K개 모델의 로짓을 평균 (dim=0 : K(fold) 차원)
    mean_logits = torch.mean(stacked_logits, dim=0)
    print(f"Mean logits shape (N_samples, N_classes): {mean_logits.shape}")

    # 최종 예측 클래스 (가장 높은 로짓의 인덱스)
    final_predictions = torch.argmax(mean_logits, dim=1)

    # (참고) 최종 확률값이 필요한 경우
    # final_probs = F.softmax(mean_logits, dim=1)

    # 5. 제출 파일 생성
    print("\n5. 제출 파일 생성...")
    submission_df = pd.DataFrame({
        'ID': ids_test, # 테스트 데이터의 ID 사용
        'label': final_predictions.numpy() # 텐서를 numpy 배열로 변환
    })

    submission_filename = "ensemble_submission.csv"
    submission_df.to_csv(submission_filename, index=False)
    print(f"✓ 제출 파일 '{submission_filename}' 생성 완료!")
    print(submission_df.head())

else:
    print("테스트 데이터가 로드되지 않아 추론을 건너뜁니다.")

print("===================================")
각 Fold마다 다른 모델을 써서 앙상블하는 방법도 있겠지만, 우선 beomi/bert 모델만을 사용해서, Stratified k-Fold cross Validation을 해주었다.
추론을 할때 k개 Fold중 하나의 파이프라인을 사용해서 dict를 사용하거나 하면 편향될 수 있으므로, 다시 전체 데이터셋을 파이프라인으로 fit 한후에 사용해주어야 한다.
클래스 불균형 처리
- Weighted Cross Entropy
from sklearn.utils.class_weight import compute_class_weight
# 클래스별 가중치 계산
print("\n클래스 가중치 계산 중...")
# y_train은 train_test_split에서 반환된 pandas Series
class_weights = compute_class_weight(
    'balanced',
    classes=np.unique(y_train),
    y=y_train.to_numpy() # Series를 numpy 배열로 변환
)

# PyTorch 텐서로 변환
class_weights_tensor = torch.tensor(class_weights, dtype=torch.float)

print(f"계산된 클래스 가중치: {class_weights_tensor}")
EDA에서 확인했듯이 데이터에서 클래스별 불균형이 있었다. 따라서 클래스비율의 역수를 CrossEntropy Lossfunction의 가중치로 사용해서 소수 클래스의 Loss는 그 비율의 역수만큼 더 많이 반영되게 처리를 해주었다.
결과 및 이후 실험계획

베이스 모델의 성능
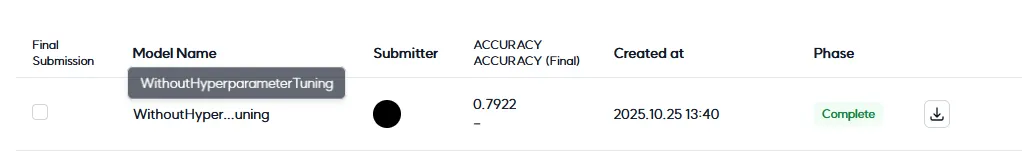
베이스모델인 마라탕후루후루에 비해 Feature Engineering을 한 모델이 오히려 성능이 떨어졌음을 알 수 있다. 왜일까…
Weighted Cross Entropy
Weighted Cross Entropy는 소수 클래스에 대한 recall을 향상시켜주지만, 대다수를 차지하는 클래스에 대해서는 정확도가 낮아질 수 있다. 이 대회의 metric은 accuracy 하나이므로 어쩌면 weighted cross entropy를 사용하지 않는게 metric인 accuracy를 높일 수 있는 방법인지 모르겠다.
커스텀 토크나이저에 특수토큰 추가하기
기존에는 뭉뚱그려서 [emoji]토큰을 매핑해서 이모지를 구분하지 않는 문제가 있었다. 이모지에는 화난 이모티콘, 웃는이모티콘등 다양하다. 이들을 구현하지 않아서 성능이 잘 안나온 것 같다.
--- 수집된 라벨별 상위 감성 패턴 (예시) ---
  [Label 0]: [('ㅠㅠ', 33867), ('ㅋㅋ', 7427), ('ㅡㅡ', 2363), ('ㅎㅎ', 954), ('ㅜㅜ', 519), ('😡', 44), ('★', 33), ('ㅋㅋㅠㅠ', 30), ('ㅡㅡㅋ', 26), ('ㅜㅠ', 24)]
  [Label 1]: [('ㅠㅠ', 9489), ('ㅎㅎ', 2362), ('ㅋㅋ', 1856), ('ㅜㅜ', 86), ('ㅡㅡ', 78), ('★', 26), ('😊', 22), ('🌟', 18), ('ㅠㅜ', 12), ('♥', 11)]
  [Label 2]: [('ㅎㅎ', 19727), ('ㅋㅋ', 9407), ('ㅠㅠ', 5677), ('♥', 832), ('🌟', 640), ('✨', 510), ('ㅜㅜ', 477), ('😊', 415), ('♡', 360), ('👍', 351)]
  [Label 3]: [('ㅎㅎ', 5713), ('ㅠㅠ', 4948), ('ㅋㅋ', 3900), ('♥', 2067), ('♡', 571), ('ㅜㅜ', 391), ('🌟', 330), ('★', 206), ('✨', 142), ('👍', 137)]
------------------------------------------
특히 감성패턴을 추출해서 토큰화했는데, 레이블간 구분없이 ‘ㅎㅎ’,’ㅠㅠ’,’ㅋㅋ’등은 모두 자주 등장함을 알 수 있다. 이러한 감성 패턴들을 차라리 노이즈로 구분하는게 좋을지 아니면 특수토큰처리하는게 좋을지, 나머지 변인들을 통제변인 처리하고 실험을 통해서 답을 찾아봐야겠다.
추가로 불용어 처리를 BaseModel에서는 의미가 있는것 같은 단어들도 모두 처리를 했었는데, 수정한 모델에서는 불용어를 기본적인 조사, 어미로 대폭 줄였다. 즉 ‘진짜’같은 단어들은 불용어처리가 되어있었는데, ‘진짜’라는 단어는 의미를 담고있지만, 레이블에 상관없이 모든문장에서 자주 등장하는 단어이다. 따라서 불용어를 해제하니깐, 성능이 하락한게 아닌가 싶다. 이것도 나머지 변인들을 통제변인 처리하고 실험을 통해서 불용어처리를 어떻게 해나갈지 답을 찾아나가봐야겠다.
한번에 여러가지 기능을 구현해보니깐, 어떤 요인이 성능에 어떻게 영향을 미쳤는지 비교하기가 어려웠다. 나머지 변인들을 통제변인으로 설정하고, 한가지씩 베이스라인 코드에 적용해보면서 실험결과를 바탕으로 나중에 한번에 모델로 구현해봐야겠다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...