[영화리뷰 감성분류][모델최적화]-커스텀토크나이저
[모델최적화]-커스텀토크나이저
Introduction
이전모델에서는 커스텀토크나이저를 사용해서 특수토큰을 사용해봤고, Weighted Cross Entropy를 구현했고, Stratified K-Fold Cross Validation를 구현했는데 Accuracy가 0.79근방이 나왔다. 대체 뭐가 성능하락을 야기했을까? 나머지 요인들은 통제변인으로 설정하고 하나씩 실험해보며, 성능향상에 기여하는것들을 찾아나가야겠다.
그 첫 여정이 커스텀토크나이저다. 직관적으로 커스텀 토크나이저를 사용하면 OOV문제를 더 많이 해결할 수 있고 [UNK]토큰이 줄어들것이므로 모델은 더 문맥을 잘 이해할 것이다. 다만 어떻게 토큰을 설정하고 추가해주고, 매핑해줄것인지는 전적으로 개발자인 나에게 달려있기 때문에 데이터셋의 특징과 분포를 잘 파악하고 커스텀 토크나이저를 실험해보며 처리해봐야겠다.
그 다음은 불용어 처리이다. 이전 모델에서 데이터셋을 확인해본 결과 ‘진짜’,’정말’같은 강조를 하는 단어들은 레이블과 상관없이 모든레이블에서 자주 등장하는 단어였다. 따라서 이러한 단어들을 베이스라인코드에서는 불용어처리가 되어있었는데, 불용어처리를 해제하는게 나은지, 혹은 불용어처리를 하는게 나은지 실험을 해볼 예정이다.
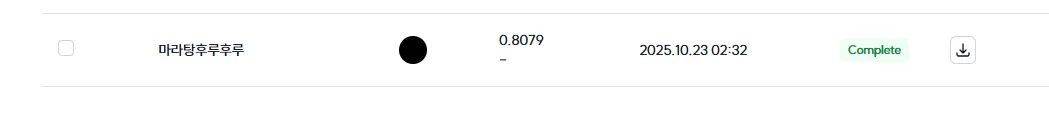
BaseLine코드대로 모델을 돌리면 ACC는 0.8이 나온다. 이는 커스텀 토크나이저도 사용하지 않았고, 불용어처리도 최대한 많은 단어들을 처리한 결과이다. 이번 실험을 통해 이를 뛰어넘을 수 있을지, 혹은 성능을 올릴 수 있는 방안은 무엇인지 찾는게 목표이다.
불용어처리
- 통제변인: 불용어리스트를 제외한 나머지 (하이퍼파라미터, 모델 등등)
- 조작변인: 불용어리스트(불용어리스트를 전부 주석처리했음.)
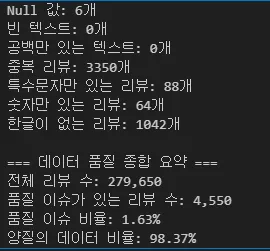
우선 EDA결과 문제가 있는 데이터의 비율은 1.63%로 전체 데이터에 비하면 적은양임을 알 수 있다. 따라서 모델학습의 안정성을 위해 문제가 있는 데이터들은 최대한 노이즈처리하고 제거를 하고 시작을 한다.
# 한국어 불용어 리스트 확장
stopwords = [
    "은",
    "는",
    "이",
    "가",
    "을",
    "를",
    "의",
    "에",
    "와",
    "과",
    "도",
    "로",
    "으로",
    "에서",
    "한",
    "그",
    "것",
    "그것",
    "이것",
    "저것",
    "그리고",
    "그런데",
    "하지만",
    "그러나",
    "있다",
    "없다",
    "되다",
    "하다",
    "이다",
    "아니다",
    "같다",
    "많다",
    "좋다",
    "나쁘다",
    "수",
    "때",
    "곳",
    "사람",
    "것들",
    "정말",
    "너무",
    "매우",
    "아주",
    "참",
    "좀",
]
BaseLinecode에서는 상당수의 단어들을 불용어처리하고 시작한다. 하지만 BERT기반 모델들은 트렌스포머 기반모델이므로 문맥 자체를 학습한다. 따라서 조사나 어미등을 포함해 자연스러운 문장구조를 유지하는게 성능향상에 도움이 된다고 한다. 그리고 어차피 Self-Attention단계에서 조사나 어미는 낮은 Attention Score를 받게되므로 모델이 스스로 무시할 수 있다. 따라서 이번실험에서는 BERT기반 모델을 사용하므로 불용어리스트를 아예 제거한다.
# 클래스별 공통 키워드 분석
print("\n클래스별 상위 빈출 단어 (불용어 포함):")

# 한국어 불용어 리스트 확장
stopwords = [
    # "은",
    # "는",
    # "이",
    # "가",
    # "을",
    # "를",
    # "의",
    # "에",
    # "와",
    # "과",
    # "도",
    # "로",
    # "으로",
    # "에서",
    # "한",
    # "그",
    # "것",
    # "그것",
    # "이것",
    # "저것",
    # "그리고",
    # "그런데",
    # "하지만",
    # "그러나",
    # "있다",
    # "없다",
    # "되다",
    # "하다",
    # "이다",
    # "아니다",
    # "같다",
    # "많다",
    # "좋다",
    # "나쁘다",
    # "수",
    # "때",
    # "곳",
    # "사람",
    # "것들",
    # "정말",
    # "너무",
    # "매우",
    # "아주",
    # "참",
    # "좀",
]

for class_name in sorted(df["label"].unique()):
    class_data = df[df["label"] == class_name]
    all_text = " ".join(class_data["review"].astype(str))

    # 단어 추출 및 필터링 (길이 2 이상, 불용어 제외)
    words = [
        word
        for word in all_text.split()
        if word not in stopwords and len(word) >= 2 and word.isalpha()
    ]

    # 단어 빈도 계산
    word_counts = Counter(words)
    top_words = word_counts.most_common(10)  # 상위 10개로 지정

    print(
        f"\n{class_name} ({LABEL_MAPPING[class_name]}) - 총 {len(class_data)}개 샘플:"
    )
    for i, (word, count) in enumerate(top_words, 1):
        percentage = (count / len(words)) * 100 if len(words) > 0 else 0
        print(f"  {i:2d}. '{word}': {count}회 ({percentage:.1f}%)")
0 (강한 부정) - 총 114066개 샘플:
   1. '너무': 106022회 (3.2%)
   2. '진짜': 82753회 (2.5%)
   3. '보는': 55270회 (1.7%)
   4. '정말': 52786회 (1.6%)
   5. '이런': 52545회 (1.6%)
   6. '영화': 49829회 (1.5%)
   7. '영화는': 44978회 (1.4%)
   8. '보고': 44776회 (1.4%)
   9. '영화를': 40348회 (1.2%)
  10. '내내': 39208회 (1.2%)

1 (약한 부정) - 총 27216개 샘플:
   1. '너무': 16454회 (2.2%)
   2. '보고': 10499회 (1.4%)
   3. 'ㅠㅠ': 8538회 (1.1%)
   4. '뭔가': 7251회 (1.0%)
   5. '영화': 7061회 (0.9%)
   6. '보는': 6857회 (0.9%)
   7. '진짜': 6833회 (0.9%)
   8. '정말': 6658회 (0.9%)
   9. '그냥': 6467회 (0.9%)
  10. '영화는': 6200회 (0.8%)

2 (약한 긍정) - 총 99416개 샘플:
   1. '진짜': 60021회 (2.3%)
   2. '정말': 56003회 (2.1%)
   3. '너무': 45092회 (1.7%)
   4. '영화': 34369회 (1.3%)
   5. '보는': 29527회 (1.1%)
   6. '특히': 28620회 (1.1%)
   7. '영화는': 26255회 (1.0%)
   8. '내내': 22921회 (0.9%)
   9. '영화를': 20993회 (0.8%)
  10. '보고': 19278회 (0.7%)

3 (강한 긍정) - 총 38952개 샘플:
   1. '진짜': 46041회 (4.4%)
   2. '정말': 24398회 (2.3%)
   3. '너무': 22577회 (2.2%)
   4. '영화': 17807회 (1.7%)
   5. '영화는': 15968회 (1.5%)
   6. '보는': 12402회 (1.2%)
   7. '특히': 11121회 (1.1%)
   8. '내내': 10439회 (1.0%)
   9. '보고': 9783회 (0.9%)
  10. '영화를': 9369회 (0.9%)
불용어리스트를 아예 주석처리한 후 클래스별 상위 빈출단어를 보면 0,1,2,3 모든 레이블의 5등안에 ‘너무’,’진짜’,’정말’이라는 단어가 포함됨을 알 수 있다. 그렇다면 모든 레이블에 이러한 단어들이 자주 등장하니깐, 모델은 오히려 ‘너무’같은 단어가 등장하면 레이블을 헷갈려 하진 않을까?
BERT기반 모델은 BIdirectional 학습을 통해 forward방향, backward방향 두방향 모두 학습한다. 그리고 Attention을 통해 다른 단어들과 병렬적으로 연관성을 학습한다. 따라서 ‘너무’라는 단어만 보고 모델은 헷갈려 하지 않고, ‘너무’ + ‘좋다’ 혹은 ‘너무’+’별로다’처럼 맥락을 학습하고, 맥락에 따라 레이블을 prediction할 수 있게 된다. 따라서 불용어처리를 오히려 하지 않는게 모델성능향상에 도움이 되겠다고 생각했다.
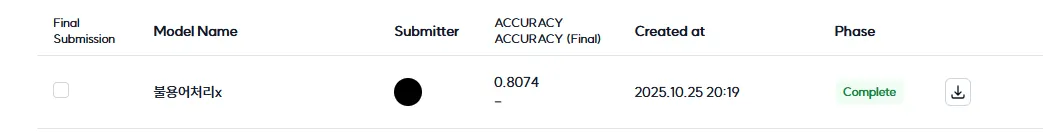
불용어를 처리하지 않은 모델은 BaseLine Code모델에 비해 0.0005 acc가 하락했다. 사실상 오차범위안이라서, 불용어를 처리하는지 안하는지는 모델에 큰 의미가 없는것 같다.
커스텀토크나이저
- 통제변인: 토크나이저와 텍스트 전처리를 제외한 나머지 요인(하이퍼파라미터, 모델등)
- 조작변인:토크나이저 커스텀(특수토큰 추가), 텍스트 전처리 과정 변경, 토크나이저
max_length=256으로 변경
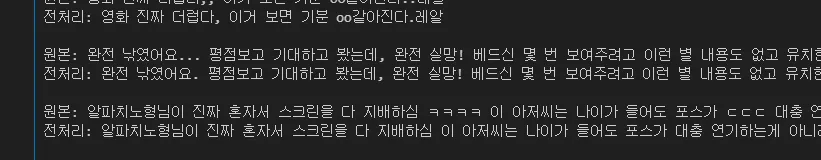
기존의 전처리 과정에서는 “ㅋㅋㅋㅋㅋ”같이 자음이 하나만 반복되는것들을 정규식을 이용해서 모두 제거해버렸다. 그래서 ‘ㅋㅋㅋㅋ’가 전처리를 거친 후 사라진것을 볼 수 있고 ‘ㄷㄷㄷ’도 마찬가지이다. 이러한 한글로 감정을 나타내는 문자들은 없애면 안되고, 정규화를 해서, 특수토큰으로 치환해야한다.
텍스트 전처리
# 기본 텍스트 정리 함수
def clean_text(text):
    """
    한국어 텍스트를 위한 기본 텍스트 정리 함수

    전처리 단계:
    1. 불완전한 한글 제거 (자음/모음만 있는 경우)
    2. 반복되는 감정 표현 정규화 (ㅋㅋㅋ, ㅠㅠㅠ 등)
    3. 과도한 문자 반복 축소 (4번 이상 → 3번으로)
    4. 특수문자 제거 (한글, 숫자, 기본 구두점, 감정표현 제외)
    5. 공백 정규화
    """
    if pd.isna(text):
        return ""

    text = str(text).strip()

    # 한국어 특화 전처리
    # 1. 감정 표현 정규화 (먼저 수행)
    text = re.sub(r"([ㅋㅎ])\1{2,}", r"\1\1", text)  # ㅋㅋㅋ+ → ㅋㅋ
    text = re.sub(r"([ㅠㅜㅡ])\1{2,}", r"\1\1", text)  # ㅠㅠㅠ+ → ㅠㅠ
    # 2. 과도한 문자 반복 축소 (4번 이상 → 3번으로)
    text = re.sub(r"(.)\1{3,}", r"\1\1\1", text)

#   3. 불완전한 한글 제거 (ㅋ,ㅎ,ㅠ,ㅜ,ㅡ는 확실히 제외하고 제거)
    # 제거할 자음/모음 목록 명시적 정의 (ㅋ,ㅎ,ㅠ,ㅜ,ㅡ 제외)
    unwanted_korean = r"[ㄱㄲㄴㄷㄸㄹㅁㅂㅃㅅㅆㅇㅈㅉㅊㅌㅍ]|[ㅏㅐㅑㅒㅓㅔㅕㅖㅗㅘㅙㅚㅛㅣㅢㅟㅣ]" # <-- 수정된 부분!
    text = re.sub(unwanted_korean, "", text, flags=re.IGNORECASE)

    # 4. 불필요한 특수문자 제거 (Blacklist 방식, 이모지 유지)
        #    제거 대상: _normalize_text에서 처리되지 않는 일부 기호들. 필요에 따라 추가/삭제 가능
        #    (예: 괄호 (), 꺽쇠 <>, 콜론 :, 작은따옴표 ', 큰따옴표 ", ` 등)
        #    \w(알파벳,숫자,_), \s(공백), 가-힣(한글), .,!;?~-(기본구두점), ㅋㅎㅠㅜㅡ(감정표현) 및 이모지는 유지됨.
    noise_chars = r"[#*•■◆◇□○●※+=/\\%&{}$₩€£¥|`→←↑↓▶◀△▽“”‘’『』「」^±§ⓒ®™]" # <-- 확장된 노이즈 리스트
    text = re.sub(noise_chars, " ", text)
    text = re.sub(r"\s+", " ", text)  # 다중 공백을 단일 공백으로

    return text.strip()

print("텍스트 전처리 과정 시작")
print("=" * 50)
initial_size = len(df_processed)
print(f"초기 데이터 크기: {initial_size:,}개")

# 1단계: 텍스트 정리 적용
print("\n1단계: 기본 텍스트 정리 수행 중...")
df_processed["review_cleaned"] = df_processed["review"].apply(clean_text)
print("✓ 한글 자음/모음 정리, 반복 표현 정규화, 특수문자 제거 완료")

# 2단계: 빈 텍스트 제거
print("\n2단계: 빈 텍스트 제거 중...")
empty_count = df_processed["review_cleaned"].str.strip().eq("").sum()
if empty_count > 0:
    df_processed = df_processed[df_processed["review_cleaned"].str.strip() != ""]
    print(f"✓ 빈 텍스트 {empty_count}개 제거")
else:
    print("✓ 빈 텍스트 없음")

# 3단계: 중복 제거
print("\n3단계: 중복 데이터 제거 중...")
duplicates_count = df_processed.duplicated(subset=["review_cleaned", "label"]).sum()
if duplicates_count > 0:
    df_processed = df_processed.drop_duplicates(subset=["review_cleaned", "label"])
    print(f"✓ 중복 데이터 {duplicates_count}개 제거")
else:
    print("✓ 중복 데이터 없음")

# 최종 결과 요약
final_size = len(df_processed)
removed = initial_size - final_size
print("\n" + "=" * 50)
print("전처리 결과 요약:")
print(f"최종 데이터 크기: {initial_size:,} → {final_size:,}")
print(f"제거된 데이터: {removed:,}개 ({removed / initial_size * 100:.1f}%)")
print("=" * 50)
텍스트 전처리 과정에서 자음반복등의 감정표현을 먼저 정규화를 한 후, 불완전한 한글을 제거할때 ㅋ,ㅎ,ㅠ,ㅜ,ㅡ는 제외하고 제거해준다. 따라서 감정을 나타내는 한글 자음 및 모음을 정규화시켜서 전처리를 거치더라도 남아있도록 만들 수 있다.
특수문자는 BlackList방식으로 이모지를 유지시켜준다. 해당 리스트에 있는 문자들이 데이터셋에 있을경우 없애주고, 나머지 감정을 나타낼만한 이모지나 특수문자는 유지시켜주었다.
텍스트 정규화
print("텍스트 정규화 과정 시작")
print("=" * 50)

# 대소문자 정규화 (BERT가 처리하지만 일관성을 위해)
print("\n1단계: 대소문자 정규화 수행 중...")
df_processed["review_normalized"] = df_processed["review_cleaned"].str.lower()
print("✓ 소문자 변환 완료")

# 구두점 정규화
print("\n2단계: 구두점 정규화 수행 중...")

def normalize_punctuation(text):
    # 여러 개의 구두점을 하나로 정규화
    text = re.sub(r"[.]{2,}", ".", text)
    text = re.sub(r"[!]{2,}", "!", text)
    text = re.sub(r"[?]{2,}", "?", text)
    text = re.sub(r"[,]{2,}", ",", text)

    # 구두점 주변 공백 정리
    text = re.sub(r"\s+([.,!?])", r"\1", text)
    text = re.sub(r"([.,!?])\s+", r"\1 ", text)

    return text

df_processed["review_normalized"] = df_processed["review_normalized"].apply(
    normalize_punctuation
)
print("✓ 구두점 정규화 완료")

# 특수문자 추가 정리
print("\n3단계: 특수문자 정리 수행 중...")

def clean_special_chars(text):
    # URL 패턴 제거 (있는 경우)
    text = re.sub(
        r"http[s]?://(?:[a-zA-Z]|[0-9]|[$-_@.&+]|[!*\\(\\),]|(?:%[0-9a-fA-F][0-9a-fA-F]))+",
        "",
        text,
    )

    # 이메일 패턴 제거 (있는 경우)
    text = re.sub(r"\S+@\S+", "", text)

    # 멘션 패턴 제거 (있는 경우)
    text = re.sub(r"@\w+", "", text)

    # 과도한 공백 정리
    text = re.sub(r"\s+", " ", text)

    return text.strip()

df_processed["review_normalized"] = df_processed["review_normalized"].apply(
    clean_special_chars
)
print("✓ URL/이메일/멘션 제거 완료")

# 정규화 후 빈 텍스트 처리
print("\n4단계: 정규화 후 빈 텍스트 확인 중...")
empty_after_normalization = df_processed["review_normalized"].str.strip().eq("").sum()
if empty_after_normalization > 0:
    df_processed = df_processed[df_processed["review_normalized"].str.strip() != ""]
    print(f"✓ 빈 텍스트 {empty_after_normalization}개 제거")
else:
    print("✓ 빈 텍스트 없음")

# 정규화 전후 비교
print("\n" + "=" * 50)
print("정규화 결과 요약:")
print(f"최종 데이터 크기: {len(df_processed):,}개")
print(f"평균 길이 - 정리됨: {df_processed['review_cleaned'].str.len().mean():.1f}자")
print(
    f"평균 길이 - 정규화됨: {df_processed['review_normalized'].str.len().mean():.1f}자"
)
print("=" * 50)
정규화 과정에서는 이전 전처리과정에서 특수문자를 처리해주었으므로, 단순하게 원래 베이스라인 코드에 있었던것처럼 URL, 이메일, 멘션패턴을 제거하고, 공백정리를 하는식으로만 진행한다.
--- 수집된 라벨별 상위 감성 패턴 (예시) ---
  [Label 0]: [('ㅠㅠ', 27105), ('ㅋㅋ', 5958), ('ㅡㅡ', 1899), ('ㅎㅎ', 774), ('ㅜㅜ', 427), ('😡', 38), ('★', 31), ('ㅋㅋㅠㅠ', 26), ('ㅜㅠ', 21), ('ㅡㅡㅋ', 20)]
  [Label 1]: [('ㅠㅠ', 7606), ('ㅎㅎ', 1885), ('ㅋㅋ', 1464), ('ㅜㅜ', 72), ('ㅡㅡ', 67), ('★', 22), ('😊', 17), ('🌟', 11), ('♥', 11), ('ㅠㅜ', 9)]
  [Label 2]: [('ㅎㅎ', 15789), ('ㅋㅋ', 7532), ('ㅠㅠ', 4526), ('♥', 676), ('🌟', 527), ('✨', 411), ('ㅜㅜ', 398), ('😊', 337), ('👍', 291), ('♡', 288)]
  [Label 3]: [('ㅎㅎ', 4532), ('ㅠㅠ', 3967), ('ㅋㅋ', 3150), ('♥', 1621), ('♡', 448), ('ㅜㅜ', 327), ('🌟', 269), ('★', 170), ('✨', 123), ('👍', 111)]
------------------------------------------
사전 EDA를 해본 결과 정규화된 몇몇 모음 및 자음, 그리고 몇몇 이모지는 자주 등장함을 알 수 있다. 이들을 특수토큰으로 mapping해서 처리해줄 예정이다
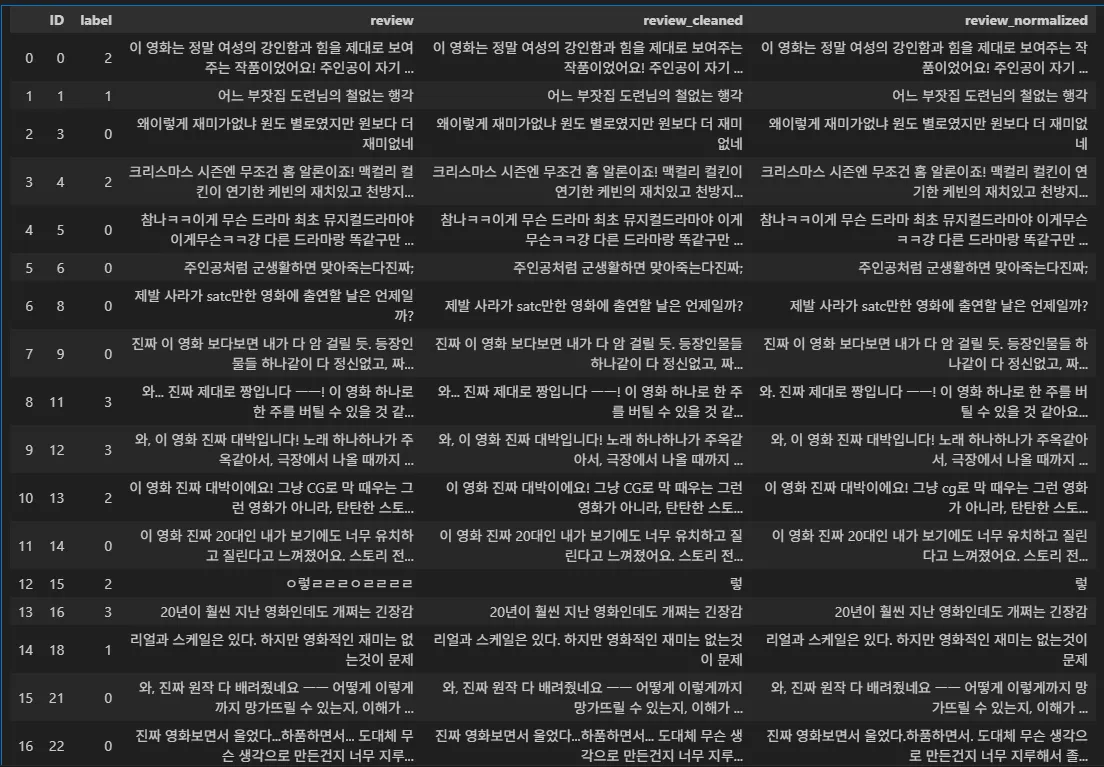
전처리 및 정규화를 마친 데이터를 보면 감정을 나타내는 ‘ㅡㅡ’ 및 ‘ㅋㅋ’등은 데이터로 남아있고, ㅋ나 ㅎ가 여러개인경우 ‘ㅋㅋ’나 ‘ㅎㅎ’로 정규화 된것을 알 수 있었다.
커스텀 토큰 추가
# --- 1단계: 수정된 특수 토큰 및 치환 규칙 정의 ---
NEW_SPECIAL_TOKENS = [
    "[LAUGH]",      # ㅋㅋ, ㅎㅎ
    "[CRY]",        # ㅠㅠ, ㅜㅜ, ㅜㅠ, ㅠㅜ
    "[SMILE]",      # ^^, :), 😊 등
    "[HEART]",      # ♥, ♡
    "[DISPLEASED]", # ㅡㅡ, ㅡㅡㅋ, 😡
    "[THUMBS_UP]",  # 👍
    "[SPARKLE]",    # 🌟, ✨
    "[STAR]",       # ★
]

# 치환 매핑 (정규식) - 적용 순서를 고려하여 리스트로 변경하는 것을 추천
# 예시: 리스트 형태 [(regex_pattern, token_string), ...]
EMOTION_REPLACEMENTS = [
    # 1. 불쾌 (ㅡㅡㅋ 처리를 위해 먼저)
    (re.compile(r'(ㅡ{2,})|(ㅡㅡㅋ)|(😡)'), "[DISPLEASED]"),
    # 2. 울음 (ㅡ 관련 제거됨)
    (re.compile(r'([ㅠㅜ]){2,}|(ㅜㅠ)|(ㅠㅜ)'), "[CRY]"),
    # 3. 웃음
    (re.compile(r'([ㅋㅎ]){2,}'), "[LAUGH]"),
    # 4. 미소
    (re.compile(r'(\^{2,})|(\:\))|(\:D)|(\^_+\^)|(\:\s?\))|(😊)'), "[SMILE]"),
    # 5. 하트
    (re.compile(r'[♥♡]'), "[HEART]"),
    # 6. 따봉
    (re.compile(r'[👍]'), "[THUMBS_UP]"),
    # 7. 반짝임
    (re.compile(r'[🌟✨]'), "[SPARKLE]"),
    # 8. 별
    (re.compile(r'[★]'), "[STAR]"),
]

# --- 2단계: 텍스트에 치환 적용하는 함수 ---
def replace_emotions(text, replacements):
    """Applies regex replacements to map patterns to special tokens."""
    if pd.isna(text):
        return ""
    processed_text = str(text) # Ensure it's a string
    for pattern, token in replacements:
        # Add spaces around the token to ensure separation
        processed_text = pattern.sub(f" {token} ", processed_text)
    # Clean up multiple spaces that might result from replacements
    processed_text = re.sub(r'\s+', ' ', processed_text).strip()
    return processed_text

#Special Tokens넣고 토크나이저 사이즈 늘리기
print(f"Original tokenizer vocab size: {len(tokenizer)}")
num_added_toks = tokenizer.add_tokens(NEW_SPECIAL_TOKENS)
print(f"Added {num_added_toks} new special tokens.")
print(f"New tokenizer vocab size: {len(tokenizer)}")

# BERT모델 토큰 늘리기
# !!! IMPORTANT: Resize model embeddings to match the new tokenizer size !!!
model.resize_token_embeddings(len(tokenizer))
print("Resized model token embeddings.")

# BERT 전용 전처리 함수들
def bert_tokenize_and_encode(texts, labels=None, max_length=256):
    """
    BERT를 위한 텍스트 토큰화 및 인코딩
    - 토큰화 및 길이 제한 처리
    - 특수 토큰 추가 ([CLS], [SEP])
    - 어텐션 마스크 생성
    - 절단 및 패딩 전략 처리
    """
    input_ids = []
    attention_masks = []
    token_type_ids = []

    # texts가 list 형태인지 확인 (DataFrame Series 등이 올 수 있으므로)
    if isinstance(texts, pd.Series):
        texts_list = texts.tolist()
    elif not isinstance(texts, list):
        texts_list = list(texts)
    else:
        texts_list = texts

    # labels도 list 형태로 변환 (필요한 경우)
    if labels is not None:
        if isinstance(labels, pd.Series):
            labels_list = labels.tolist()
        elif not isinstance(labels, list):
            labels_list = list(labels)
        else:
            labels_list = labels
        # 길이 검증
        if len(texts_list) != len(labels_list):
             raise ValueError("texts와 labels의 길이가 다릅니다.")
    else:
        labels_list = None

    for text in texts:
        # 토큰화 및 인코딩 (특수 토큰 자동 추가)
        #위에서 정의했든 replcae_emotions 함수 사용
        replaced_text = replace_emotions(text, EMOTION_REPLACEMENTS)
        encoded = tokenizer.encode_plus(
            replaced_text,
            add_special_tokens=True,  # [CLS], [SEP] 토큰 추가
            max_length=max_length,  # 최대 길이 제한
            padding="max_length",  # 최대 길이까지 패딩
            truncation=True,  # 길이 초과시 절단
            return_attention_mask=True,  # 어텐션 마스크 생성
            return_token_type_ids=True,  # 토큰 타입 ID 생성
            return_tensors="pt",  # PyTorch 텐서로 반환
        )

        input_ids.append(encoded["input_ids"].flatten())
        attention_masks.append(encoded["attention_mask"].flatten())
        token_type_ids.append(encoded["token_type_ids"].flatten())

    # 텐서로 변환
    input_ids = torch.stack(input_ids)
    attention_masks = torch.stack(attention_masks)
    token_type_ids = torch.stack(token_type_ids)

    result = {
        "input_ids": input_ids,
        "attention_mask": attention_masks,
        "token_type_ids": token_type_ids,
    }

    if labels is not None:
        result["labels"] = torch.tensor(labels, dtype=torch.long)

    return result

# 토큰 길이 분포 확인
def analyze_token_lengths(texts, max_length=256):
    """토큰 길이 분포 분석"""
    token_lengths = []

    for text in texts:
        tokens = tokenizer.tokenize(text)
        token_lengths.append(len(tokens))

    token_lengths = np.array(token_lengths)

    print(
        f"토큰 길이: 평균 {token_lengths.mean():.1f}, 중앙값 {np.median(token_lengths):.1f}, 범위 {token_lengths.min()}-{token_lengths.max()}"
    )
    print(
        f"{max_length} 토큰 초과: {(token_lengths > max_length).sum()}개 ({(token_lengths > max_length).mean() * 100:.1f}%)"
    )

    return token_lengths

# 토큰화 테스트 및 분석
sample_text = df_processed["review_normalized"].iloc[0]
sample_tokens = tokenizer.tokenize(sample_text)
print(f"\n토큰화 테스트: '{sample_text[:50]}...' -> {len(sample_tokens)}개 토큰")

# 전체 데이터셋 토큰 길이 분포 분석
print("\n전체 데이터셋 토큰 길이 분포:")
token_lengths = analyze_token_lengths(df_processed["review_normalized"].tolist())
사전 EDA결과 웃음패턴, 울음패턴이 모든 레이블에서 가장 많이 나타나는것을 알 수 있었다. 따라서 [Laugh], [CRY]토큰을 만들어 주었다. 그 외에도, 데이터셋에서 자주 나타나는 이모지인 별, 따봉, 화난이모지등을 특수토큰으로 만들어주었다.
EMOTION_REPLACEMENTS에서 특수토큰으로 매핑을 해주었고 이후 BERT전처리 함수에서 replace_emotions() 함수에서 정의된 내용을 바탕으로 특수토큰패턴이 있다면 텍스트에 치환적용을 한다.
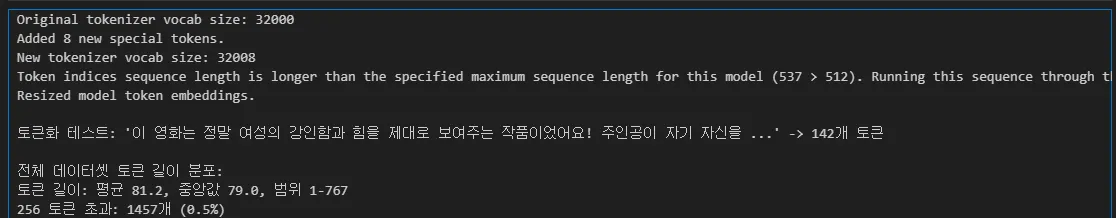
256을 넘는 토큰이 0.5%밖에 없으므로 토크나이저의 max_length를 256으로 지정해주었다. 기존의 BaseLinecode에서는 128이었으므로 더 많은 정보를 파악할 수 있도록 해주었다. 이로써 성능향상을 기대해볼 수 있을것 같다.
결과
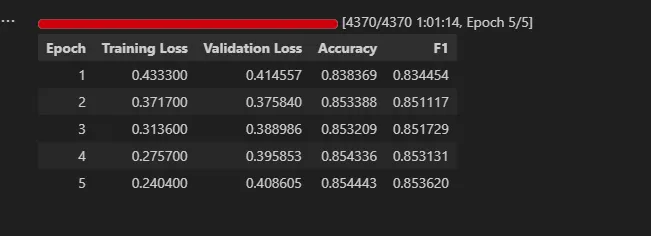
테스트를 해본 결과 Training Loss는 줄어드는 경향성을 보이지만 Validation Loss는 처음에는 줄어들다가 올라가는 경향성을 보였다. 과적합되고있다는 신호로, 이후 실험들에서는 Regularization기법들을 추가하도록 고려해봐야겠다.
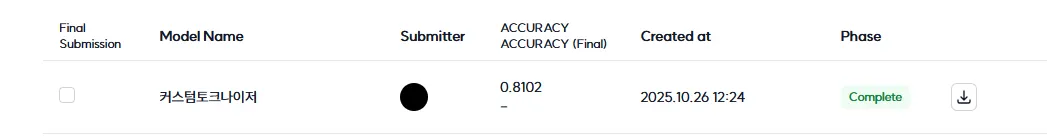
모든 통제변인을 제거하고 커스텀 토크나이저를 이용한 결과 약 1퍼센트의 성능향상이 있었다. 따라서 커스텀 토큰추가를 통해 유의미한 성능향상을 관측했다.
이제 이후 실험에서는 이 커스텀토크나이저 모델을 기반으로 이후에는 Focal Loss적용, Regularization기법들을 추가해볼 예정이다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...