[영화리뷰 감성분류][모델최적화]-FocalLoss
[모델최적화]-FocalLoss
Introduction
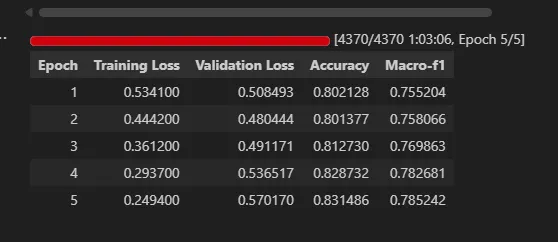
이전에 Weighted Cross Entropy를 적용한 모델은 이상할정도로 과적합되어 Training Loss는 하락하는 추세를 보이지만, Validation Loss는 줄어들지 않는 문제가 있었다.
Weighted CrossEntropy는 소수의 클래스에 더 높은 가중치를 부여하므로, 소수클래스 샘플의 특징에 모델이 지나치게 맞춰질 수 있다. 우선 과적합을 방지하기 위해서 시도해봐야 하는 방법들을 생각해 보았다.
- Early Stopping: 가장 쉽고 빠르게 시도해볼 수 있는 방법으로 Validation Loss가 감소하지 않으면 훈련을 중단하는 방법이다.
- Regularization 강화
- Weight Decay: WeightDecay값을 높여서 모델 가중치가 너무 커지는것을 방지한다.
- Dropout: Dropout비율을 높여서 과적합을 방지한다.
- Dropout은 일반적으로 라이브러리 모델의 기본값을 사용한다.
- Label Smoothing: 정답 레이블을 원핫 인코딩이 아니라 [0.9,0.03,0.03,0.03]처럼 모델이 너무 확신하는것을 방지하도록 만든다.
- Focal Loss사용: FocalLoss는 Weighted Cross Entropy와는 다르게 예측난이도에 집중하므로 단순 클래스 빈도만 고려하는 WCE보다 과적합에 덜 민감하다.
- Learning Rate Scheduling: 러닝레이트 스케줄러를 조정하는 방법을 사용할 수 있다.
베이스모델은 이전실험들에서 가장 좋은 성능을 보였던 Custom_Tokenizer모델을 사용한다.
Focal Loss Implementaion
# 필요 라이브러리 임포트
import torch
import torch.nn as nn
import torch.nn.functional as F
import numpy as np # alpha가 list/ndarray일 경우를 위해 추가

class FocalLossSoftLabels(nn.Module):
    """
    다중 클래스 분류를 위한 Focal Loss 구현 (소프트 레이블 지원).
    Label smoothing이 적용된 경우에도 작동하도록 설계되었습니다.

    Args:
        alpha (float or list/tensor): 각 클래스에 대한 가중치 요소.
                                       리스트/텐서 형태 권장 (길이=num_classes).
                                       float일 경우 모든 클래스에 동일 적용. 기본값 0.25.
        gamma (float): 초점 파라미터. 기본값 2.0.
        reduction (str): 감소 방식 ('none' | 'mean' | 'sum'). 기본값 'mean'.
        epsilon (float): 수치 안정성을 위한 작은 값. 기본값 1e-7.
    """
    def __init__(self, alpha=0.25, gamma=2.0, reduction='mean', epsilon=1e-7):
        super(FocalLossSoftLabels, self).__init__()
        self.alpha = alpha
        self.gamma = gamma
        self.reduction = reduction
        self.epsilon = epsilon # log(0) 방지

    def forward(self, inputs, targets):
        """
        Focal Loss 계산 (소프트 레이블 지원).

        Args:
            inputs (torch.Tensor): 모델 로짓 (N, C).
            targets (torch.Tensor): 실제 레이블 (N) 또는 소프트 레이블 (N, C).

        Returns:
            torch.Tensor: 계산된 Focal Loss.
        """
        num_classes = inputs.shape[1]

        # 1. 입력 로짓에 log_softmax 적용
        log_probs = F.log_softmax(inputs, dim=-1)
        # 예측 확률 계산
        probs = F.softmax(inputs, dim=-1)

        # 2. targets 형태 확인 및 변환
        if targets.ndim == 1: # 하드 레이블인 경우 (Label smoothing 미적용 시)
            # 원-핫 인코딩으로 변환 (Cross Entropy 계산 위해)
            targets_one_hot = F.one_hot(targets, num_classes=num_classes).float().to(inputs.device)
            # pt 계산을 위한 정수 인덱스
            target_indices = targets
        elif targets.ndim == 2 and targets.shape[1] == num_classes: # 소프트 레이블인 경우
            targets_one_hot = targets.float().to(inputs.device)
            # pt 계산 및 alpha 적용을 위해 가장 확률 높은 클래스 인덱스 사용
            target_indices = targets_one_hot.argmax(dim=1)
        else:
            raise ValueError("targets 텐서의 형태가 올바르지 않습니다. (N) 또는 (N, C)여야 합니다.")

        # 3. 기본 Cross Entropy 손실 계산 (소프트/하드 레이블 모두 처리)
        # ce_loss = - (targets_one_hot * log_probs).sum(dim=-1) # 수동 계산
        # 또는 PyTorch 함수 사용 (내부적으로 소프트 레이블 처리)
        # 참고: F.cross_entropy는 log_softmax + NLLLoss 이므로, log_probs를 직접 사용 시 NLLLoss 사용
        ce_loss_per_sample = F.cross_entropy(inputs, targets_one_hot, reduction='none')

        # 4. pt 계산 (예측 확률 중 '정답' 클래스에 해당하는 값)
        # target_indices를 사용하여 해당 클래스의 예측 확률(probs)을 가져옴
        pt = probs.gather(1, target_indices.unsqueeze(-1)).squeeze(-1)
        # 수치 안정성 보장 (pt가 0이나 1에 매우 가까워지는 것 방지)
        pt = pt.clamp(min=self.epsilon, max=1.0 - self.epsilon)

        # 5. alpha 가중치 계산 (alpha_t)
        alpha_t = None
        if isinstance(self.alpha, (float, int)):
            # 단일 float alpha -> 모든 클래스에 동일하게 적용하거나 특정 로직 추가 가능
            # 여기서는 우선 모든 샘플에 동일 alpha 적용 (리스트 형태 권장)
            # alpha_t = torch.full_like(ce_loss_per_sample, self.alpha) # 단순 적용 예시
            # 클래스별로 다른 alpha를 적용하고 싶다면 아래 리스트/텐서 방식 사용
             alpha_tensor = torch.full((num_classes,), self.alpha).to(inputs.device)
             alpha_t = alpha_tensor.gather(0, target_indices)

        elif isinstance(self.alpha, (list, np.ndarray, torch.Tensor)):
            # 리스트, ndarray, 텐서 형태 alpha 처리
            if not isinstance(self.alpha, torch.Tensor):
                alpha_tensor = torch.tensor(self.alpha).to(inputs.device)
            else:
                alpha_tensor = self.alpha.to(inputs.device)

            if alpha_tensor.shape[0] != num_classes:
                 raise ValueError(f"alpha의 길이({alpha_tensor.shape[0]})가 클래스 개수({num_classes})와 일치해야 합니다.")
            # target_indices를 사용하여 각 샘플의 alpha 값 선택
            alpha_t = alpha_tensor.gather(0, target_indices)

        else: # alpha 가중치 없음
            alpha_t = 1.0

        # 6. Focal Loss 계산
        focal_loss_component = alpha_t * (1 - pt)**self.gamma * ce_loss_per_sample

        # 7. reduction 적용
        if self.reduction == 'mean':
            return focal_loss_component.mean()
        elif self.reduction == 'sum':
            return focal_loss_component.sum()
        else: # 'none'
            return focal_loss_component
from transformers import Trainer

class CustomTrainerWithFocalLoss(Trainer):
    """
    Focal Loss (소프트 레이블 지원)를 사용하도록 손실 계산을 오버라이드한 커스텀 Trainer.
    """
    def __init__(self, *args, focal_loss_alpha=0.25, focal_loss_gamma=2.0, num_classes=4, **kwargs):
        super().__init__(*args, **kwargs)
        self.num_classes = num_classes # 클래스 개수 저장

        # alpha 처리: float이면 num_classes 길이의 리스트로 변환
        effective_alpha = focal_loss_alpha
        if isinstance(focal_loss_alpha, (float, int)):
            effective_alpha = [focal_loss_alpha] * self.num_classes
            print(f"Focal Loss: 단일 alpha 값({focal_loss_alpha})을 모든 {self.num_classes}개 클래스에 적용합니다.")
        elif isinstance(focal_loss_alpha, list) and len(focal_loss_alpha) != self.num_classes:
             raise ValueError(f"focal_loss_alpha 리스트의 길이({len(focal_loss_alpha)})가 num_classes({self.num_classes})와 일치해야 합니다.")
        else:
             print(f"Focal Loss: 클래스별 alpha 값({effective_alpha})을 사용합니다.")

        # 최적화된 FocalLossSoftLabels 사용
        self.focal_loss_func = FocalLossSoftLabels(alpha=effective_alpha, gamma=focal_loss_gamma)

    def compute_loss(self, model, inputs, return_outputs=False, **kwargs):
        """
        Trainer가 손실을 계산하는 방식 오버라이드.
        Label Smoothing이 적용된 경우 targets는 (N, C) 형태의 소프트 레이블이 됩니다.
        """
        # labels 키가 있는지 확인 (Trainer 내부적으로 label smoothing 적용 후 전달)
        if "labels" not in inputs:
             raise ValueError("모델 입력에 'labels' 키가 없습니다. 데이터셋 형식을 확인하세요.")

        labels = inputs.pop("labels")
        outputs = model(**inputs)
        logits = outputs.get('logits')

        # FocalLossSoftLabels 함수 호출 (소프트/하드 레이블 모두 처리 가능)
        loss = self.focal_loss_func(logits, labels)

        return (loss, outputs) if return_outputs else loss
FocalLossSoftLabels 클래스안에서 FocalLoss를 정의한다.
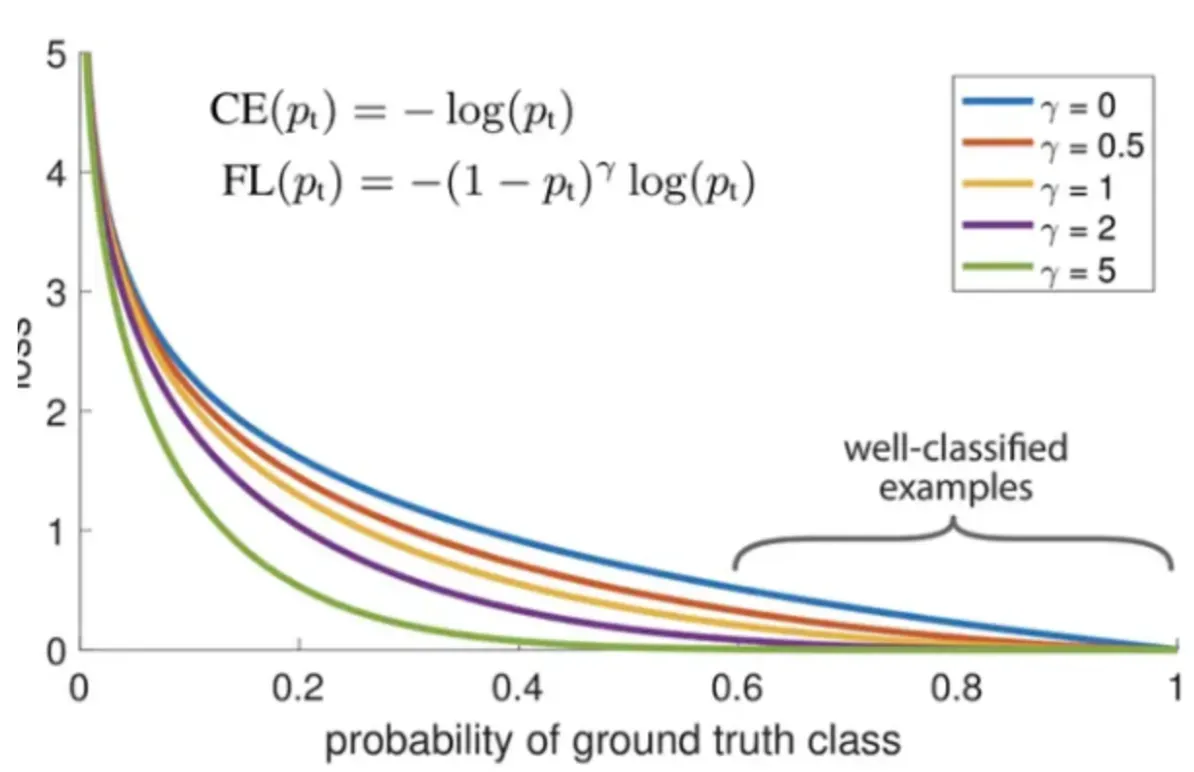
Focal Loss는 모델이 이미 쉽게 맞히는 샘플보다는, 계속 틀리는 어려운 샘플에 더 집중하도록 Lossfunction 자체를 조정한다. 즉 클래스별로 맞히기 어려운 샘플일수록 Loss 비중을 높인다.
\(\gamma\)에 따라 Loss Function의 형태 자체가 달라짐을 볼 수 있다. \(\gamma\)가 0에 가까울수록 예측확률이 낮을때, 즉 확신이 없을때의 Loss가 매우 커서, 학습이 더 강하게 일어남을 확인할 수 있다.
이때 ground Truth Class의 확률이 적을수록, 즉 해당 레이블에 모델이 확신이 없을수록 Loss값이 커지는것을 알 수 있다. 따라서 모델이 확신을 갖지 못하는 각 step의 판단에서, Loss가 더 커지도록 한다.
그리고 \(\alpha\)는 Weighted Cross Entropy와 같이 불균형 클래스에서 클래스간의 가중치를 설정하는 하이퍼 파라미터이다. 우선은 WCE에서처럼 각 클래스 백분율의 역수를 가중치로 줬는데 $\alpha,\beta$는 추후 하이퍼파라미터 튜닝 툴로 튜닝을 해봐야겠다.
훈련 및 정규화
from transformers import EarlyStoppingCallback # <--- 이 줄 추가

# 모델 저장 여부 및 wandb 사용 여부 설정
SAVE_MODEL = True
USE_WANDB = True

print("\n" + "=" * 50)
print("모델 훈련 시작")
print("=" * 50)

# 훈련 파라미터 설정
training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=NUM_EPOCHS,
    per_device_train_batch_size=BATCH_SIZE_TRAIN,
    per_device_eval_batch_size=BATCH_SIZE_EVAL,
    warmup_steps=WARMUP_STEPS,
    weight_decay=WEIGHT_DECAY,
    learning_rate=LEARNING_RATE,
    logging_steps=100,
    eval_strategy="epoch",
    save_strategy="epoch" if SAVE_MODEL else "no",
    load_best_model_at_end=SAVE_MODEL,
    metric_for_best_model="accuracy" if SAVE_MODEL else None,
    greater_is_better=True,
    save_total_limit=2 if SAVE_MODEL else 0,
    label_smoothing_factor=0.1, # 10% 레이블 스무딩 적용
    report_to="wandb" if USE_WANDB else "none",  # wandb 로깅 조건부 활성화
    run_name="bert-movie-review-classification" if USE_WANDB else None,
    seed=RANDOM_STATE,
    fp16=torch.cuda.is_available(),
    dataloader_num_workers=2,
    remove_unused_columns=False,
    push_to_hub=False,
    gradient_accumulation_steps=1,
    logging_first_step=True,
    save_safetensors=SAVE_MODEL,
    # === 스케줄러 타입 변경 ===
    lr_scheduler_type="cosine", # <--- 'linear'(기본값) 대신 'cosine'으로 설정
    # === Early Stopping 관련 파라미터 추가 ===
    # early_stopping_patience=3,      # <--- 추가: 이 횟수만큼 평가 점수가 개선되지 않으면 중단 (예: 3 에폭)
    # early_stopping_threshold=0.001, # <--- (선택 사항) 개선으로 간주하기 위한 최소 변화량

)
early_stopping_callback = EarlyStoppingCallback(early_stopping_patience=3) # <--- 원하는 patience 값
# Trainer 초기화
trainer = CustomTrainerWithFocalLoss(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=val_dataset,
    tokenizer=tokenizer,
    num_classes=NUM_CLASSES,
    focal_loss_alpha=[0.11, 0.45, 0.12, 0.32], # 예시 시작점
    focal_loss_gamma=2.0,
    callbacks=[early_stopping_callback], # <--- 콜백 리스트 전달
    data_collator=DataCollatorWithPadding(tokenizer=tokenizer),
    compute_metrics=compute_metrics,
)

# 훈련 정보 출력
print(f"훈련 샘플: {len(train_dataset):,}개")
print(f"검증 샘플: {len(val_dataset):,}개")
print(f"훈련 에포크: {training_args.num_train_epochs}회")
print(f"배치 크기: {BATCH_SIZE_TRAIN} (훈련) / {BATCH_SIZE_EVAL} (검증)")
print(f"학습률: {LEARNING_RATE}")
print(f"시드값: {RANDOM_STATE}")
print(f"디바이스: {device}")
print(f"wandb 사용: {USE_WANDB}")

# 훈련 실행
try:
    training_results = trainer.train()
    print("\n훈련 완료")
    print(f"최종 훈련 손실: {training_results.training_loss:.4f}")

    # 훈련 로그 정보 출력
    if hasattr(training_results, "log_history"):
        print(f"총 훈련 스텝: {training_results.global_step}")

except KeyboardInterrupt:
    print("\n사용자에 의해 훈련이 중단되었습니다.")
    raise
except Exception as e:
    print(f"\n훈련 중 오류 발생: {str(e)}")
    raise
label_smoothing_factor=0.1, 를 training_args로 줘서 label_smoothing을 해주었다.
lr_scheduler_type을 “cosine” 으로 줘서 선형적으로 learning rate가 조정되는게 아닌 cosine개형으로 바뀌도록 설정해주었다. 일반적으로 Overfitting을 막고, Learning rate가 cosine개형으로 달라지기때문에, Regularization의 방법중 하나라고 한다.
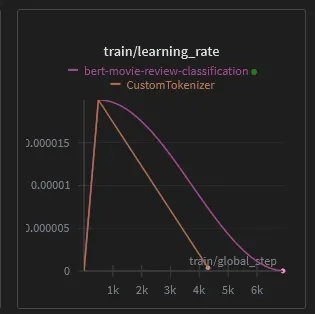
실제로 wandb에서 learning_rate를 관찰해보면 주황색 그래프는 선형적으로 감소하는데 비해 코사인 개형을 따르는것을 볼 수 있다.
Trainer에서는 focal_loss_alpha=[0.11, 0.45, 0.12, 0.32] 를통해서 기본적인 focal_loss의 각 클래스별 가중치를 클래스의 백분율의 역수로 설정해주었다. 그리고 focal_loss_gamma=2.0 를 통해 \(\gamma\)가 2를 갖는 focal loss의 개형을 설정해주었다. 이 \(\gamma\)값은 이후 하이퍼파라미터 튜닝으로 튜닝을 할 예정이다.
결과
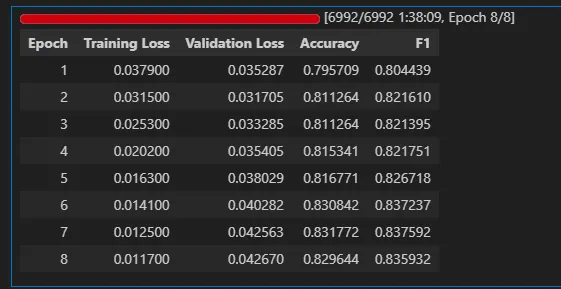
정규화를 해주었지만, 그럼에도 Training Loss는 감소할때 Validation Loss는 2epoch이후 계속 증가함을 볼 수 있다. 따라서 더 강한 정규화 전략을 짜고, 하이퍼파라미터 튜닝을 해봐야겠다.
 에폭을 8로 설정한 탓이었을까? Focal Loss를 적용하고, Regularization을 도입했음에도 오히려 test성능이 줄어든 0.78을 기록했다.
이후실험에서는 하이퍼파라미터 튜닝을 통한 더 나은 정규화 방향을 찾아갈 예정이다. 그리고 Back Translation을 통한 데이터 증강, 확률적 가중치 평균 (Stochastic Weight Averaging - SWA) 기법을 이용해서 조금더 일반화 성능을 늘려볼 예정이다. 그리고 Early stopping의 기준을 Accuracy가 아니라 validationLoss로 설정해서 Validation Loss가 3에폭 이상에서 증가하면 학습을 종료하도록 설정을 해서 Overfitting을 막아봐야겠다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...