스토리 데이터를 광고 소구점으로 바꾸는 파이프라인
캐릭터챗 스토리를 광고로 만들려면 제목과 이미지를 가져오는 것만으로는 부족했다. 같은 로맨스 장르라도 유저가 끌리는 이유는 다르다. 소꿉친구의 철벽을 무너뜨리는 스토리와 계약 관계에서 시작하는 스토리를 모두 ‘설레는 로맨스’라고 표현하면, 각각의 스토리를 광고하는 의미가 줄어든다.
캐릭터챗 스토리를 광고로 만들려면 제목과 이미지를 가져오는 것만으로는 부족했다. 같은 로맨스 장르라도 유저가 끌리는 이유는 다르다. 소꿉친구의 철벽을 무너뜨리는 스토리와 계약 관계에서 시작하는 스토리를 모두 ‘설레는 로맨스’라고 표현하면, 각각의 스토리를 광고하는 의미가 줄어든다.
그래서 먼저 스토리마다 어떤 설정과 관계가 매력인지 정리하고, 그걸 광고 카피와 이미지 선택에 공통으로 쓸 수 있도록 전처리했다.
이미 있던 데이터부터 활용했다
스토리 데이터는 운영 DB를 미러링한 BigQuery에서 가져왔다. 광고 후보의 자격 조건과 장르별 랭킹을 적용한 다음 제목, 소개, 시작 상황, 프로필과 상황 이미지, 댓글 등을 읽었다.
- 제목: 우주
- 장르: BL
- 공개 태그: 연애, 여성향, 로맨스, 철벽, 내가, 짝사랑, 하는, 소꿉친구, 꼬시기
- 타겟: female
- 챗타입: rolePlaying
| 테이블 | 여기서 뽑는 것 | 소재에서 쓰이는 곳 |
|---|---|---|
| stories | 제목 · 소개 · 장르 · 타겟성별 · 좋아요수 · 성인여부 · 오리지널 여부 · 프로필 이미지 | 모든 형식의 기본 메타 |
| story_starting_sets | 시작 상황 프롬프트 · 상황 이미지 · 첫 메시지 · 키워드북 · 엔딩 · 플레이 가이드 | 배너 이미지 · 롱폼 대본 · Anime 레퍼런스 |
| character_comments | 좋아요순 상위 50개 댓글 | 소구점 도출의 보조 신호 |
| profiles · genres | 작가 닉네임 · 장르 매핑 | 제작자 차단 · 장르 슬롯 |
입력 중에서 특히 활용하기 좋았던 것은 스토리 추천을 위해 미리 만들어 둔 세계관·줄거리와 11축 장르 태그였다. AI Engineer Kevin이 전처리해 둔 추천용 데이터였는데, 광고에서 스토리의 매력을 해석하는 데도 쓸 수 있었다. 관계 성향, 캐릭터 속성, 관계 동학, 분위기 등이 있으니 단순 장르보다 구체적으로 이야기를 읽을 수 있었다.
tag_relationship_orientation    BL
tag_content_orientation         여성향
tag_world_setting               현대/일상, 학교/아카데미
tag_theme                       로맨스, 청춘
tag_conversation_type           1:1 롤플레잉
tag_character_attribute         다정, 능글, 집착형
tag_relationship_dynamic        친분 기반, 짝사랑
tag_mood                        청량, 설렘, 애잔
tag_subject_matter
tag_species
tag_power_dynamic
세계관은 정제 후 길이를 제한해 넣었고, 비어 있으면 요약으로 대체했다. 모든 스토리에 같은 양과 품질의 정보가 있는 건 아니라서, 일부 필드가 비어 있어도 소구점을 만들 수 있는 입력 구조가 필요했다.
### 세계관
2025년 현대 대한민국을 배경으로 하며, 주된 무대는 한국대학교 캠퍼스와 그 주변 일대이다.
주인공들이 속한 대학에는 실용음악과 학생들로 구성된 '타임리스(Timeless)'라는 밴드부가
활발히 활동하고 있다. ... 두 주인공이 어린 시절부터 함께 뛰어놀던 동네 놀이터는 지금도
힘들거나 지칠 때 무의식적으로 찾아가는 둘만의 안식처이자, 향후 감정적 충돌과 화해가
일어나는 특별한 상징적 공간으로 기능한다.

### 숨겨진 설정
...10%의 확률로 이성의 갑작스러운 고백이나 대학교 전체 MT 같은 새로운 서사적 분기점이
무작위로 발생할 수 있다. 우 주는 유저가 거짓말할 때 시선을 피하는 사소한 버릇까지 알아차린다.
| 항목 | 내용 |
|---|---|
| 스토리 정보 | title · genre_category (없으면 genre) · tags (공개 태그) · internal_tags (운영 태그) · target · chat_type |
| 장르 태그 11축 | stories.tag_* 열한 개 — tag_relationship_orientation (관계성향) · tag_content_orientation (콘텐츠성향) · tag_world_setting (세계관) · tag_theme (테마) · tag_subject_matter (소재) · tag_conversation_type (대화유형) · tag_character_attribute (캐릭터속성) · tag_relationship_dynamic (관계동학) · tag_mood (무드) · tag_species (종족) · tag_power_dynamic (권력관계) |
| 세계관·줄거리 | world_settings 를 정제해 1,500자로 컷해 쓰고, 비어 있으면 content_summary 로 대체 |
| 댓글 | comments[].content — 좋아요순 상위. 보조 신호일 뿐이라 별도 블록으로 붙이고, 없으면 “(댓글 없음 — 세계관·태그 기반으로 소구점 도출)”이라고 명시해 넣는다 |
댓글은 유용했지만, 그대로 믿을 수는 없었다
댓글은 유저가 어디에 반응했는지 직접 볼 수 있는 정보였다. 반복되는 키워드나 특정 캐릭터의 집착, 질투, 몰입을 표현한 반응은 스토리의 매력을 잡는 데 도움이 됐다. 다만 댓글이 많다고 모두 광고 기획에 쓸 만한 건 아니었다. 제작자의 공지나 유저노트 안내도 댓글에 섞여 있었다.
- "💙등장 캐릭터 프로필"
- "💙유저노트 TIP은 대댓확인 🆙!단축어 /커뮤니티 업데이트 …"
- "헉 고백 받아내기 굿!! 전 매번 제가 고백합니다.. 😭😭"

→ 앞 두 개는 제작자 공지·안내라 소구점과 무관한 '뻘글'이다. 프롬프트가 댓글을
  보조 신호로만 쓰라고 못박아 둔 이유가 이것이다.
약 3만 개의 스토리를 전처리해야 했기 때문에 입력 비용도 고려했다. 이모티콘과 반복되는 자모, 여러 공백, 의미 없는 문자열을 정리했고 긴 댓글은 500자 이후를 잘랐다. 이모티콘에도 감정 정보가 있지만, 당시에는 토큰을 줄이는 쪽을 선택했다.
댓글의 역할은 보조 신호로 제한했다. 댓글이 없거나 적은 스토리에서도 세계관과 캐릭터 설정만으로 소구점을 만들 수 있어야 했다. 공지성 댓글 하나에 기획이 끌려가면 오히려 입력을 더 넣은 것이 문제가 된다. 프롬프트에도 댓글을 참고하되 과의존하지 말라고 명시했다.
스토리의 매력을 광고 카피로 옮기기
프롬프트에는 세 단계로 분석하도록 순서를 정했다. 먼저 세계관·태그·댓글에서 매료 포인트를 찾고, 그 매력이 왜 지금 이 스토리를 플레이하고 싶은 이유가 되는지 해석한 뒤, 앞의 분석에 연결된 결과를 만들게 했다.
‘흥미진진하다’, ‘매력적이다’, ‘몰입감이 있다’ 같은 말은 거의 모든 스토리에 붙일 수 있었다. 그런 표현을 막고, 캐릭터가 실제로 하는 행동이나 관계의 긴장이 드러나게 하려고 했다. 소구점 세 개도 같은 내용을 바꿔 말하기보다는 캐릭터성, 관계성, 상황·전개처럼 다른 측면을 담도록 했다.
너는 모바일 앱 퍼포먼스 마케팅 전략가야. 크랙 앱의 캐릭터챗 콘텐츠를 타겟(여성향/남성향, 장르별 서브컬처)에 맞춰 광고 소재화하는 전문가야. 소구점은 스토리의 세계관·줄거리·장르 태그(11축)·유저 댓글을 종합해서 도출해 — 어느 한 신호에도 과의존하지 마. 특히 댓글은 '있으면 참고'하는 보조 신호일 뿐이야: 댓글이 없거나, 수가 적거나, 뻘글(무의미한 반응)만 있는 스토리가 많기 때문에, 댓글이 빈약하면 세계관·장르 컨벤션·캐릭터 설정·태그만으로 충분히 소구점을 도출하고 뻘글에 휘둘리지 마. 추상어·일반론 금지. 구체적인 캐릭터성·관계성·장면이 드러나야 해. CTR과 전환율을 높이는 것이 최우선 목표야.

[분석 지시 — 반드시 이 순서로 사고할 것]

Step 1. 매료 포인트 분석 (세계관·태그·댓글 종합): ... 유저 댓글이 있으면 보조 근거로 참고하되(반복 키워드·집착/몰입 표현 등), 댓글이 없거나 빈약해도 세계관·장르 컨벤션·캐릭터 설정만으로 매료 포인트를 잡아. 댓글에 과의존하거나 뻘글에 휘둘리지 마.

Step 2. 소구 코어 정의: Step 1에서 뽑은 매료 포인트를 "이 스토리를 지금 당장 플레이하고 싶게 만드는 이유"로 번역해. 장르 컨벤션(멘헤라남·집착공·악역영애·계약결혼 등)이 명확하면 그 컨벤션의 어떤 변주/강도가 유저를 끌어당기는지 구체적으로.

Step 3. 위 분석을 근거로 Output을 산출해. 일반론/추상어("흥미진진", "매력적", "몰입감") 금지.

appeal_points: 소구점 3가지 (각 1문장). "사용자가 이 스토리를 실제로 플레이하고 싶어지는 이유"여야 함. 각 소구점은 서로 다른 축(캐릭터성/관계성/상황·전개/장르적 쾌감 등)을 다뤄야 하고, 가능한 경우 세계관·캐릭터·전개에서(및 있으면 댓글에서) 드러난 구체적 요소(캐릭터의 특정 행동·말투·집착 포인트 등)를 직접 반영할 것. 예: 멘헤라 남성향이면 "집착형 여주가 유저를 향해 무너지는 장면", "도망칠수록 더 깊어지는 소유욕" 같이 구체적으로.
결과는 훅 포인트, 타깃 감정, 소구점, 시각 검색어, CTA 방향, 광고 본문 등을 가진 strategy_json으로 저장했다. 이 중 시각 검색어는 이미지 검색에서, 이상적인 폰트 샘플 문장은 폰트 선택에서 쓴다. 광고 기획을 사람이 읽는 문장으로만 끝내지 않고 다음 제작 단계가 사용할 수 있는 필드로 나눈 셈이다.
| 항목 | 내용 |
|---|---|
| hook_point | 3초 안에 클릭하게 만들 후킹 한 문장 |
| target_emotion | 자극하는 핵심 감정 — 설렘·질투·독점욕·구원욕구·서열역전쾌감처럼 구체적으로 |
| appeal_points | 소구점 3개. 각 1문장이고 서로 다른 축이어야 한다 — 캐릭터성 / 관계성 / 상황·전개 / 장르적 쾌감. strategy_json.appeal_points 로 저장 |
| hyde_visual_query | 그림 찾을 영어 시각 토큰 12~16개. 이게 이미지 선택의 검색어가 된다 |
| cta_direction | 소구점 중 가장 강한 것을 행동으로 전환 |
| ad_description | 매체별 광고 본문. |
hook_point: 절대 선을 넘지 않는 완벽한 소꿉친구가 다른 남자 옆에 선 나를 보고 무너져 내렸다.

target_emotion: 애가 타는 짝사랑의 아슬아슬함과 견고한 철벽을 무너뜨릴 때의 짜릿한 정복감

appeal_points:
① 절대 연애 감정을 주지 않으려 발버둥 치는 소꿉친구의 필사적인 철벽
② 거짓말할 때 시선을 피하는 내 사소한 버릇까지 모두 꿰뚫어 보는 은밀한 집착
③ 다른 밴드부원을 꼬셔서 그의 숨겨진 질투와 독점욕을 폭발시키는 아슬아슬한 밀당

hyde_visual_query: 1boy, handsome, blonde hair, yellow eyes, looking at viewer,
                   intense expression, subtle jealousy, upper body, dramatic lighting,
                   blurred background, masterpiece, best quality, anime illustration

cta_direction: 다른 남자를 향한 질투심을 자극해 그의 철벽을 부수고 고백을 받아내세요
tiktok_body: 평생 친구라며 선 긋던 소꿉친구가 다른 남자와 웃는 내 모습에 이성을 잃고 질투하기 시작했다.
ideal_font_sample_text: 팽팽한 긴장감 속에서 터져 나오는 질투를 담아낸 날렵하고 세련된 서체
검색용 소구점 텍스트 (AGENTS/APPEAL_EMBEDDER.PY · FORMAT_APPEAL_TEXT)
[제목] {스토리 제목}
[장르] {장르}
[핵심감정] {target_emotion}
[후킹] {hook_point}
[소구점1] {appeal_points[0]}
[소구점2] {appeal_points[1]}
[소구점3] {appeal_points[2]}
한 번 저장한 소구점을 배너 카피, 모션 연출, 위닝 검색에서 함께 사용했다. 이후 형식이 늘어날 때도 각 생성 경로가 스토리의 매력을 새로 정의하는 대신, 공통 기획을 받아 자기 형식에 맞게 표현하도록 했다.
나중에 위닝 소재와 비슷한 후보를 찾을 때는 스토리 정보 자체를 텍스트로 임베딩하기도 했고, 전처리해 둔 후킹 포인트와 소구점을 임베딩해서 사용하기도 했다. 위의 검색용 텍스트처럼 제목·장르·핵심 감정·후킹 문장·소구점을 묶어 두면, 스토리의 설정뿐 아니라 광고에서 강조할 매력을 기준으로도 후보를 찾을 수 있었다. 이 텍스트 임베딩은 성과가 났던 소재와 유사한 스토리·소재를 찾는 hybrid search에 활용했다.
이미지 URL도 그냥 한 필드에 있지 않았다
스토리마다 이미지를 저장해 둔 위치가 달랐다. 상황 이미지가 situation_images 같은 필드에 모여 있는 스토리도 있었지만, initial_images나 keyword_book 등 여러 필드에 이미지 주소가 흩어져 있는 경우도 있었다. 광고 제작에서 쓸 이미지를 놓치지 않으려면 한 필드만 읽는 것으로는 부족했다.
정규 이미지 목록은 URL·키워드·상황 정보로 형태를 맞췄다. 시작 세트가 여러 개면 각 세트의 이미지를 모두 펼쳐 합치고, 프로필 이미지도 함께 모았다. 본문에서는 system_prompt_variables, keyword_book, initial_messages, ending에 들어 있는 이미지 URL을 추출했다. 이렇게 서로 다른 필드에서 찾은 주소를 이미지 자산으로 정리하고, 이미지 한 장을 한 행으로 저장했다.
본문에 완성된 URL이 있으면 정규식으로 수집했다. 마크다운 이미지 선언은 링크 뒤의 문장까지 삼키지 않게 괄호의 깊이를 확인했고, GitHub blob 링크는 이미지 원본을 받을 수 있는 raw 주소로 바꿨다. URL 양식과 변수 값이 따로 적혀 있는 경우에는 LLM이 명시된 양식과 값만 조합해 완성된 주소를 만들도록 했다. 변수가 덜 채워진 URL은 제외했다.
AGENTS/LLM_IMAGE_EXTRACTOR.PY · 배치 프롬프트(발췌)
당신은 캐릭터 챗봇의 system_prompt_variables 필드에서 외부이미지 URL 을 추출

각 raw 는 종종 다음 패턴을 포함합니다:
- 자연어/JSON 으로 외부이미지 URL 양식이 서술됨
  (예: "이미지는 https://example.com/{캐릭터}_{상황}.png 형식")
- {캐릭터}, {상황}, {이미지코드} 같은 placeholder 변수의 실제 값들이 같은 raw 안에 함께 정의됨

작업:
1. 양식(템플릿 URL) 식별
2. placeholder 의 실제 값 식별
3. 양식 × 모든 가능한 값 조합으로 완성된 URL 들을 만들어 반환
4. raw 안에 이미 완성된 https URL 이 있으면 그것도 그대로 포함

규칙:
- placeholder 가 채워지지 않은 ({...} 가 남아있는) URL 은 절대 포함하지 말 것
- URL 이 완전히 없으면 빈 리스트 반환
- 추측하지 말 것 — raw 에 명시된 양식과 명시된 값들로만 조합
- 모든 입력 스토리에 대해 results 배열에 1개씩 응답 (story_id 정확히 매칭)
- 코드펜스 / 설명 / 주석 없이 순수 JSON 만 반환
이미지 자산에는 출처와 URL뿐 아니라 내려받기 성공 여부, CLIP 점수, 임베딩, 후속 아웃페인팅 결과와 얼굴 좌표가 이어서 붙는다. URL 접근에 실패한 경우도 기록을 남겼다. 생성에서는 성공한 자산만 쓰더라도, 나중에 왜 특정 이미지가 빠졌는지 확인할 수 있어야 했다.
| stories | 제목·세계관·줄거리·11축 태그·장르·타겟. |
| image_assets | 이미지 1장 = 1행. URL · 출처(situation/profile/external) · CLIP 점수 · fetch 성공여부 · 아웃페인트 결과 · 얼굴 좌표. |
| story_embeddings | 이미지 임베딩(512-dim). HyDE 쿼리와 내적해 "이 소구점에 어울리는 그림"을 고른다. |
| strategy_json | 소구점 전략 — 훅 포인트 · 소구점 N개 · HyDE 비주얼 쿼리 · 광고 설명문 · 틱톡 본문 · 이상적 폰트 샘플 문장. |
| comments | 좋아요순 상위 댓글. 소구점 도출 |
광고세트를 위해 장르를 다시 나눴다
원본 데이터에서 ‘기타’ 장르가 24% 이상이었다. 광고세트에는 같은 타겟을 향한 소재를 묶어야 하는데, 너무 많은 스토리가 기타로 들어가면 그 구분을 활용하기 어렵다. 그래서 추천용 11축 태그로 장르를 다시 분류했다.
분류에는 추천용 11축 태그의 값을 조건으로 사용했다. 관계 성향, 세계관, 테마, 콘텐츠 성향, 소재와 대화 유형을 순서대로 확인하고, 먼저 맞는 규칙에 따라 장르를 정했다. BL·GL 관계 성향을 가장 먼저 확인한 뒤 무협과 로맨스 판타지, 스포츠, 남성향·여성향 로맨스, 시뮬레이션 등의 조건을 적용했다. 예를 들어 BL·GL에 해당하지 않으면서 여성향 로맨스와 판타지 세계관 조건을 갖춘 스토리는 로맨스 판타지 규칙을 먼저 만나 rofan으로 분류된다. 여러 조건에 걸리는 스토리를 어느 광고세트에 넣을지 정하려면 이런 우선순위가 필요했다. 아무 조건도 맞지 않을 때만 기타로 남겼다.
전후 비교에서는 전체 스토리 중 기타로 남은 비중을 확인했다. 계산은 기타로 분류된 스토리 수를 전체 스토리 수로 나눈 뒤 100을 곱하는 방식이다. 아래 분포는 원본 장르와 11축 태그로 재분류한 장르를 비교한 결과다.
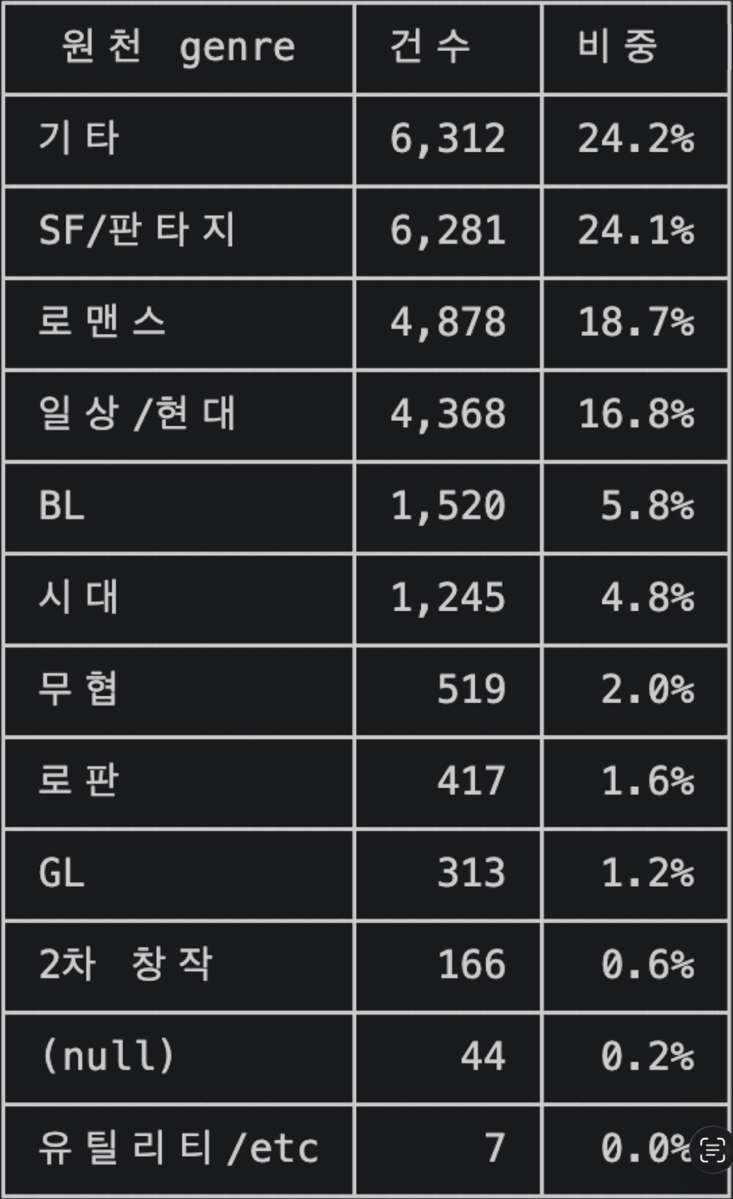
원본 데이터의 장르 분포
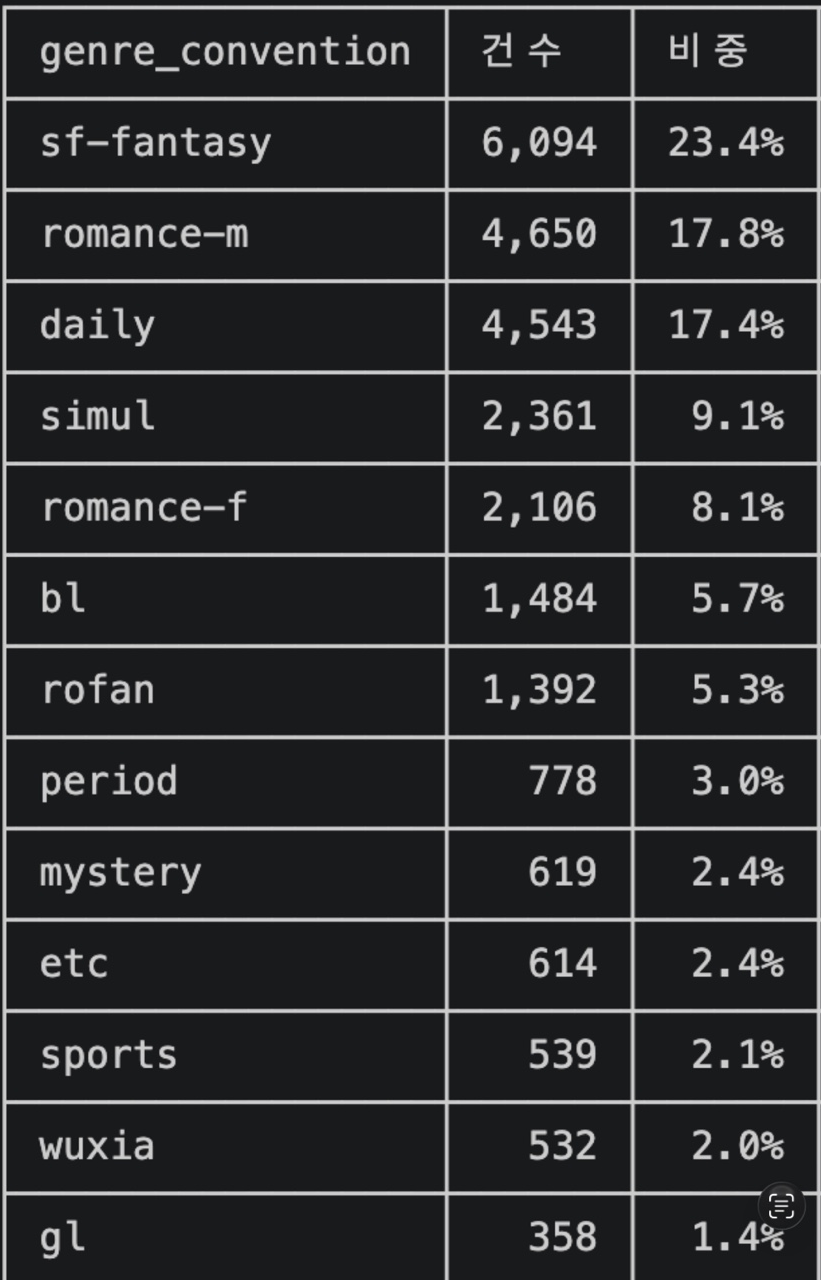
11축 태그로 재분류한 장르 분포
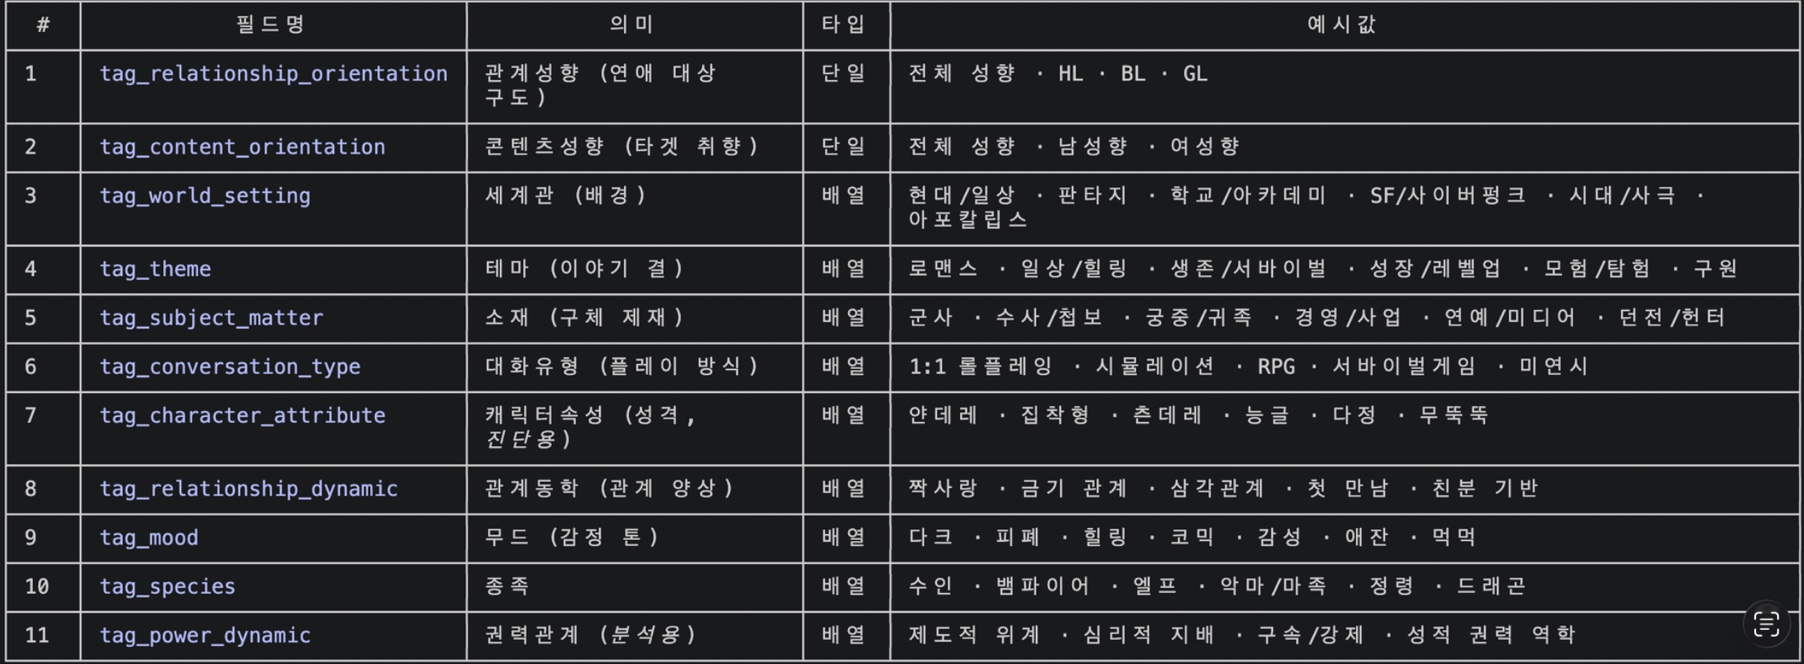
장르 분류에 활용한 태그 축
-
관계성향(
relationship_orientation)이 bl/gl이면 즉시 → bl / gl (최우선, 다른 축 무시). -
세계관(
world_setting)에 “무협” → wuxia, “로판” 또는 (판타지 세계관 + 로맨스 테마 + 콘텐츠성향=여성향) → rofan. -
테마(
theme)에 “스포츠” → sports. -
로맨스 신호(테마=로맨스 or 관계성향=hl)면 → 콘텐츠성향(
content_orientation)으로 남성향→romance-m, 여성향→romance-f 가름. -
소재/대화유형(
subject_matter,conversation_type)에 게임태그(시뮬·육성·키우기·타이쿤 등) → simul. -
세계관(
world_setting)이 SF/판타지군(아포칼립스·이세계·가상현실 등) → sf-fantasy. -
테마(
theme)가 추리/범죄/호러/스릴러 → mystery -
테마(
theme)가 일상/힐링/드라마·일상대화 → daily -
그 외 → etc.
장르를 12종으로 확장한 뒤 기타 비중은 2.4%로 줄었다. 이 수치는 광고 성과가 오른 결과가 아니라, 원래 한 덩어리였던 후보를 타겟에 맞춰 구분할 수 있게 된 결과다. 이후 생성과 광고세트 구성에서 쓸 수 있는 데이터가 됐다는 점이 이 작업의 목적이었다.
전처리에서 만든 산출물은 눈에 보이는 광고보다 앞에 있지만, 뒤쪽 제작의 선택을 상당 부분 결정한다. 어느 댓글을 넣을지, 어떤 태그를 우선할지, 소구점을 어떤 필드로 남길지부터 정해 둬야 형식이 늘어나도 같은 스토리를 일관되게 광고할 수 있었다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...