소구점에 맞는 이미지를 찾고 배너로 렌더링하기
광고에 쓸 소구점을 만들고 나면 그 문장에 맞는 그림을 골라야 했다. 캐릭터챗에는 같은 캐릭터의 이미지가 여러 장 들어 있는데, 표정이나 구도가 조금씩 다르다. 어느 이미지든 캐릭터는 같지만, 질투를 강조하는 카피와 다정함을 강조하는 카피에 어울리는 장면은 같지 않을 수 있다.
광고에 쓸 소구점을 만들고 나면 그 문장에 맞는 그림을 골라야 했다. 캐릭터챗에는 같은 캐릭터의 이미지가 여러 장 들어 있는데, 표정이나 구도가 조금씩 다르다. 어느 이미지든 캐릭터는 같지만, 질투를 강조하는 카피와 다정함을 강조하는 카피에 어울리는 장면은 같지 않을 수 있다.
그림을 고른 뒤에도 매체별 규격으로 바꾸고, 얼굴이 잘리지 않게 배치하고, 폰트와 카피를 얹는 과정이 남았다. 이 글에서는 이미지 후보를 정리하는 단계부터 실제 배너 파일로 렌더링하는 단계까지 이어서 정리한다.
배너에 못 쓰는 이미지부터 걸러냈다
수집한 이미지를 모두 검색 후보에 넣지는 않았다. 글자가 들어간 캡처, 실사, 풍경이나 도표, 캐릭터가 없는 이미지 등은 배너의 입력으로 적합하지 않았다. NSFW처럼 정해진 항목만 막는 필터로는 광고에서 쓸 만한 이미지를 충분히 구분하기 어려웠다.
CLIP 계열 모델로 긍정·부정 프롬프트와의 유사도를 계산했다. 긍정 쪽에는 애니메이션 인물, 얼굴과 상반신, 감정적인 표정 등을 두고, 부정 쪽에는 자막·워터마크·말풍선, 노출, 풍경·UI, 실사·비인간 객체 등을 넣었다.
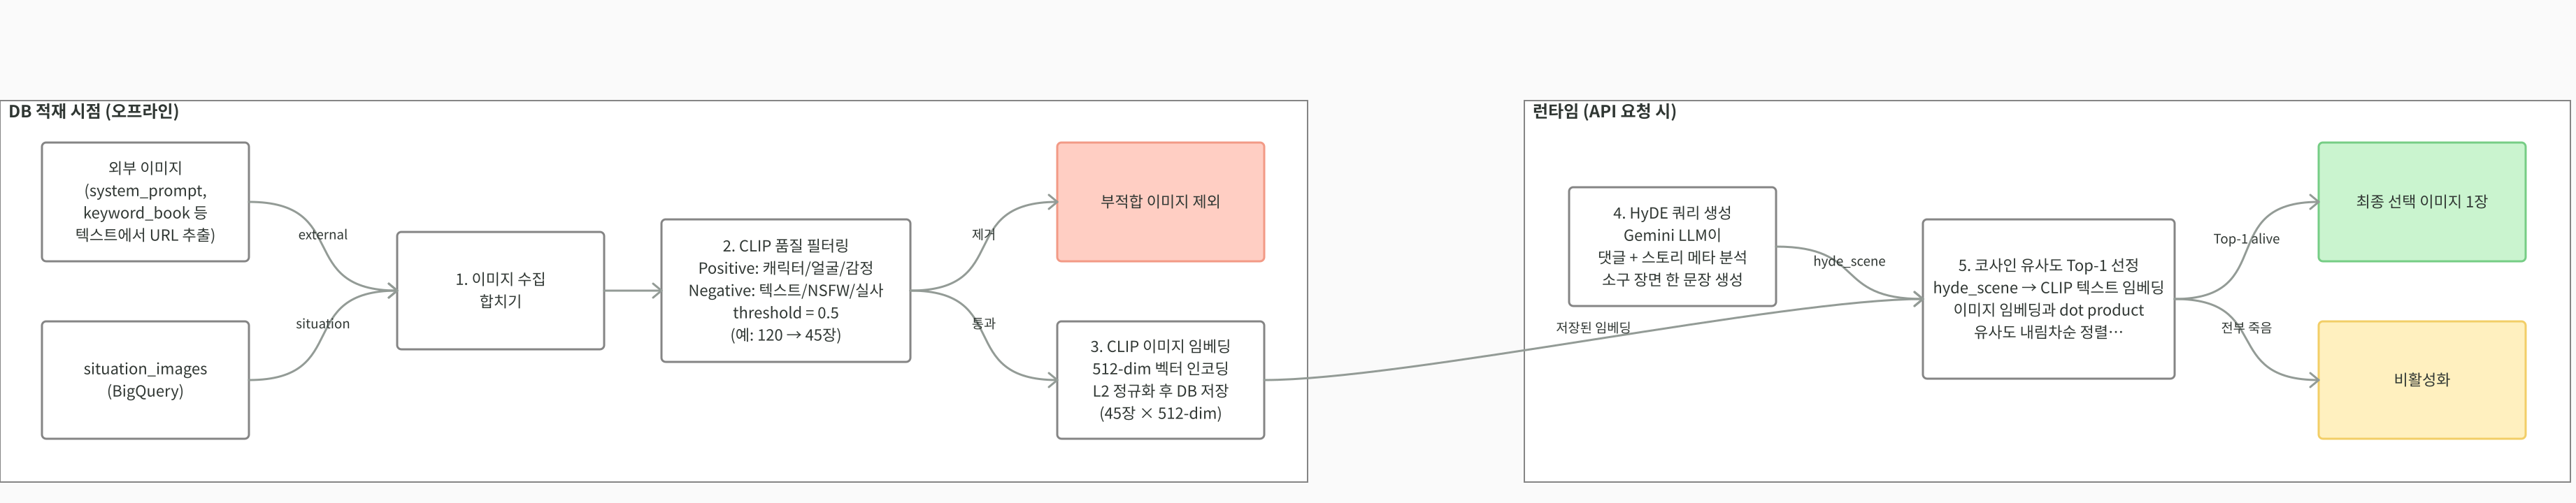
CLIP 기반 이미지 필터링 흐름
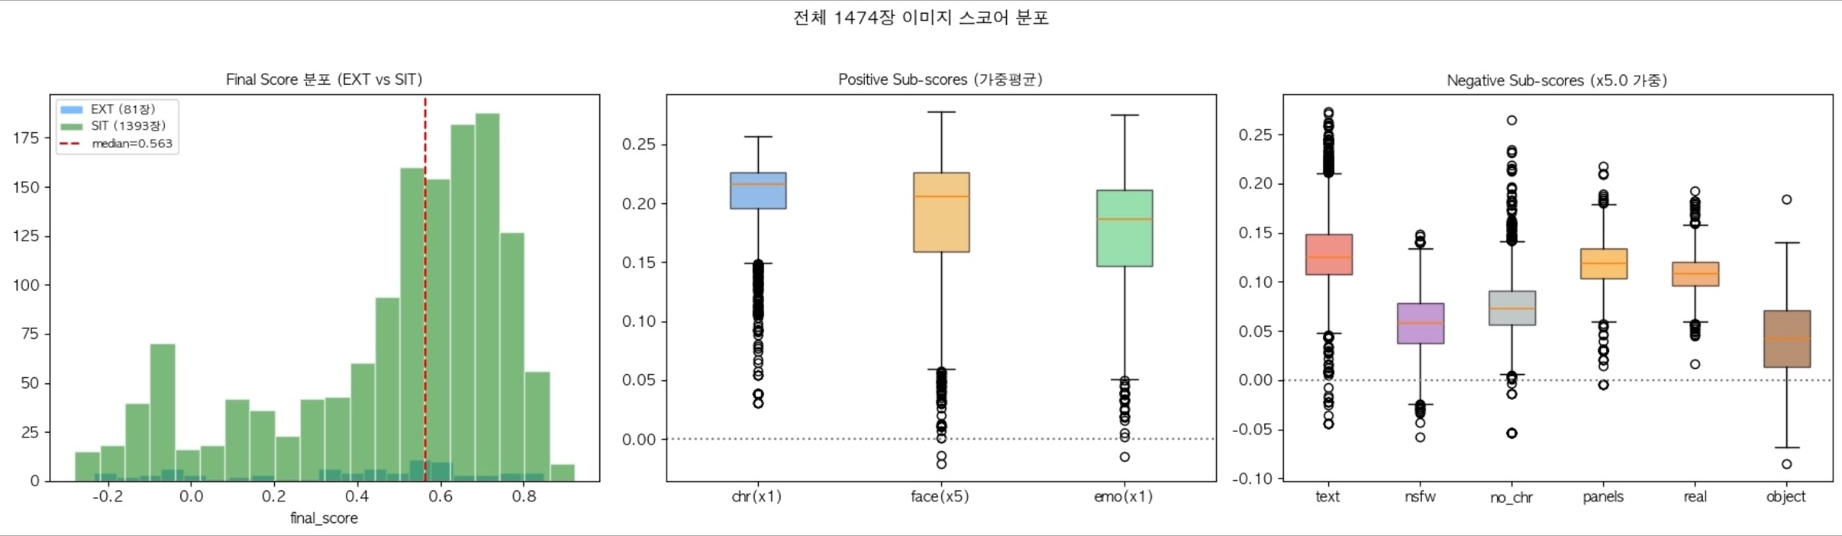
이미지 점수 분포와 속성별 비교
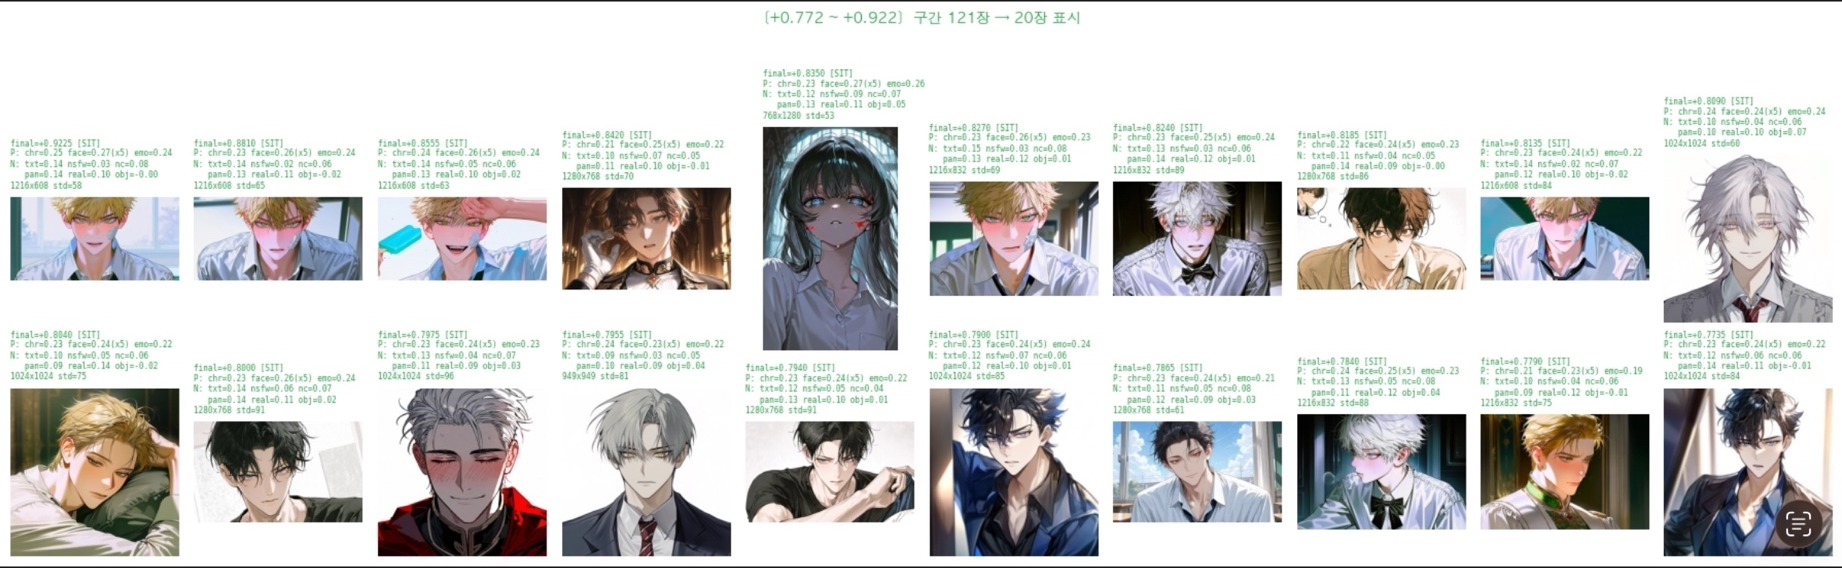
필터링 점수별 이미지 사례
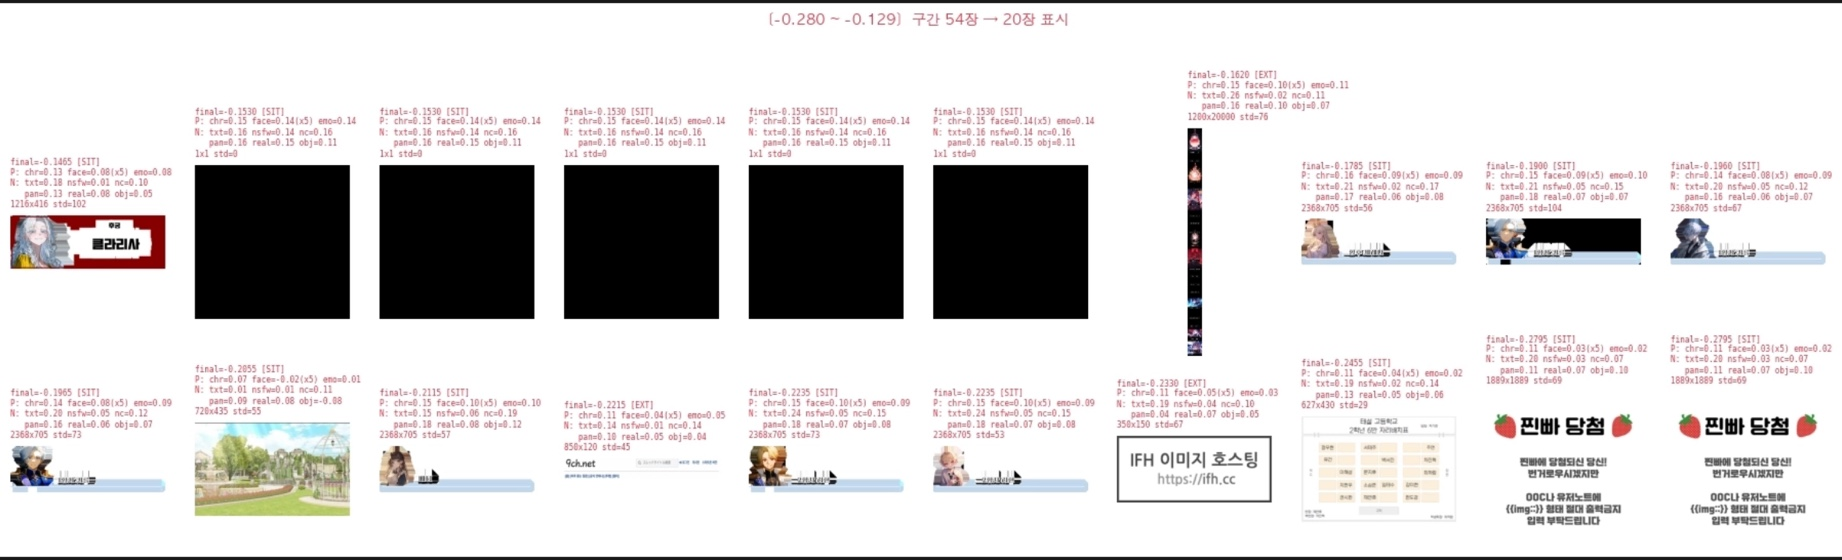
광고 후보에서 제외한 이미지 사례
POSITIVE_PROMPTS = {
    'p_character': "anime human character, illustrated person, human figure",
    'p_face': "anime character face, human upper body portrait, clear face",
    'p_emotion': "dramatic emotional expression, intense human gaze, expressive face",
}

POS_WEIGHT = 5.0  # Positive 전체 가중치 (final score)

# Negative 프롬프트 — 전체 x5 가중치
NEGATIVE_PROMPTS = {
    'n_text': (
        "subtitled anime screenshot, image with Korean text, "
        "dialogue text bar, caption overlay, watermark, speech bubble, "
        "white text on black bar, colored subtitle"
    ),
    'n_nsfw': "nude, explicit, nsfw, undressed, sexually suggestive content",
    'n_no_char': "landscape, scenery, map, diagram, screenshot, UI, no human character",
    'n_panels': "manga panels, comic strip layout, multiple frames, panel borders",
    'n_real': (
        "real photograph, real person, real animal, photo portrait, "
        "live action, 3D render, photorealistic"
    ),
    'n_object': (
        "cute mascot, chibi animal, cartoon penguin, cartoon creature, "
        "food illustration, small icon, item sprite, object illustration, "
        "illustrated animal, non-human cartoon creature"
    ),
}

NEG_WEIGHT = 5.0  # Negative 전체 가중치 (final score)
초기 실험의 점수는 5 × positiveScoreMean - 5 × NegativeScoreMean 형태였다. 두 항에 같은 가중치를 곱하면 순위 자체가 달라지는 것은 아니다. 점수의 크기와 임계값의 관계를 함께 봐야 한다. 뒤의 제작 흐름에는 단색 이미지와 흡연에 대한 별도 페널티도 들어갔다.
이미지 필터링 실험에서는 0.5를 기준으로 보수적으로 후보를 남겼다. 한편 전체 전처리 기록에는 양수 점수만 통과시키는 0 기준도 있다. 이 두 설정을 같은 실험 결과로 섞지는 않으려고 한다. 아래는 이미지 필터링과 선정 단계에서 남긴 자료다.
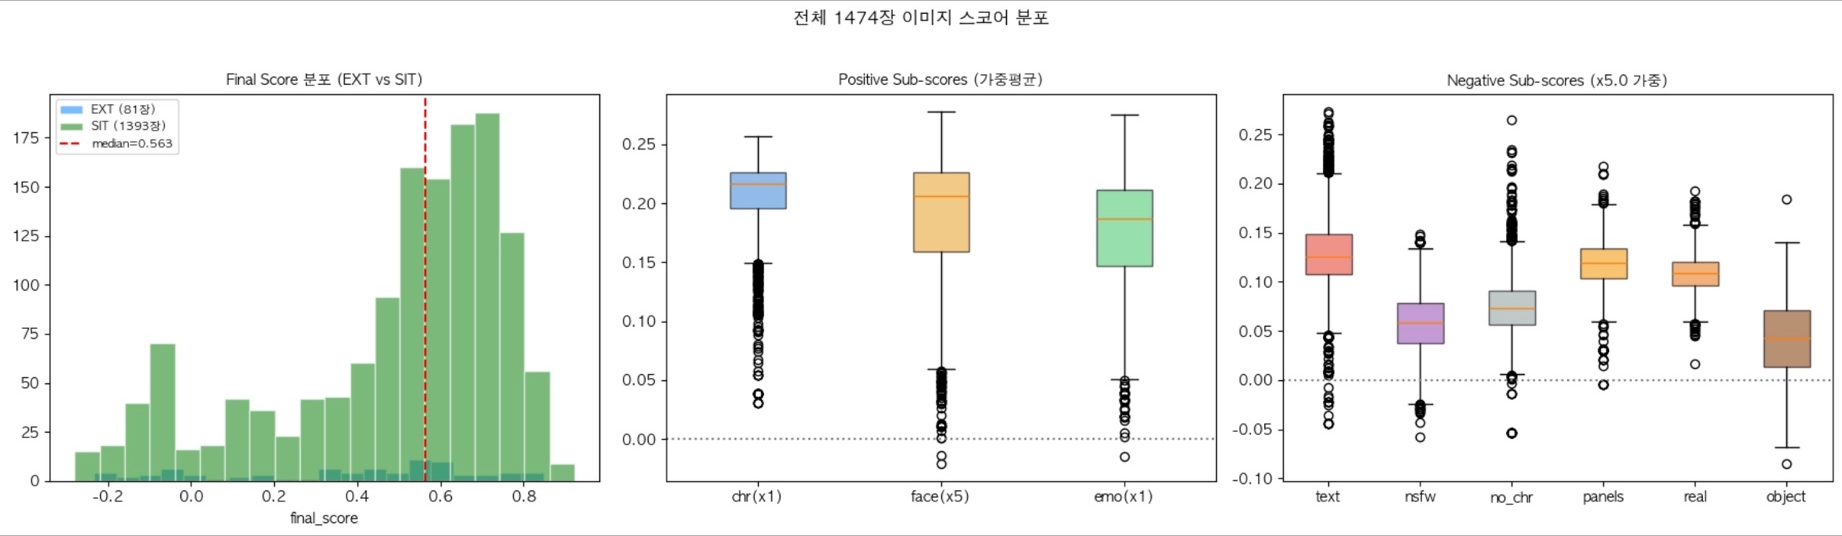
이미지 필터링 점수 분포
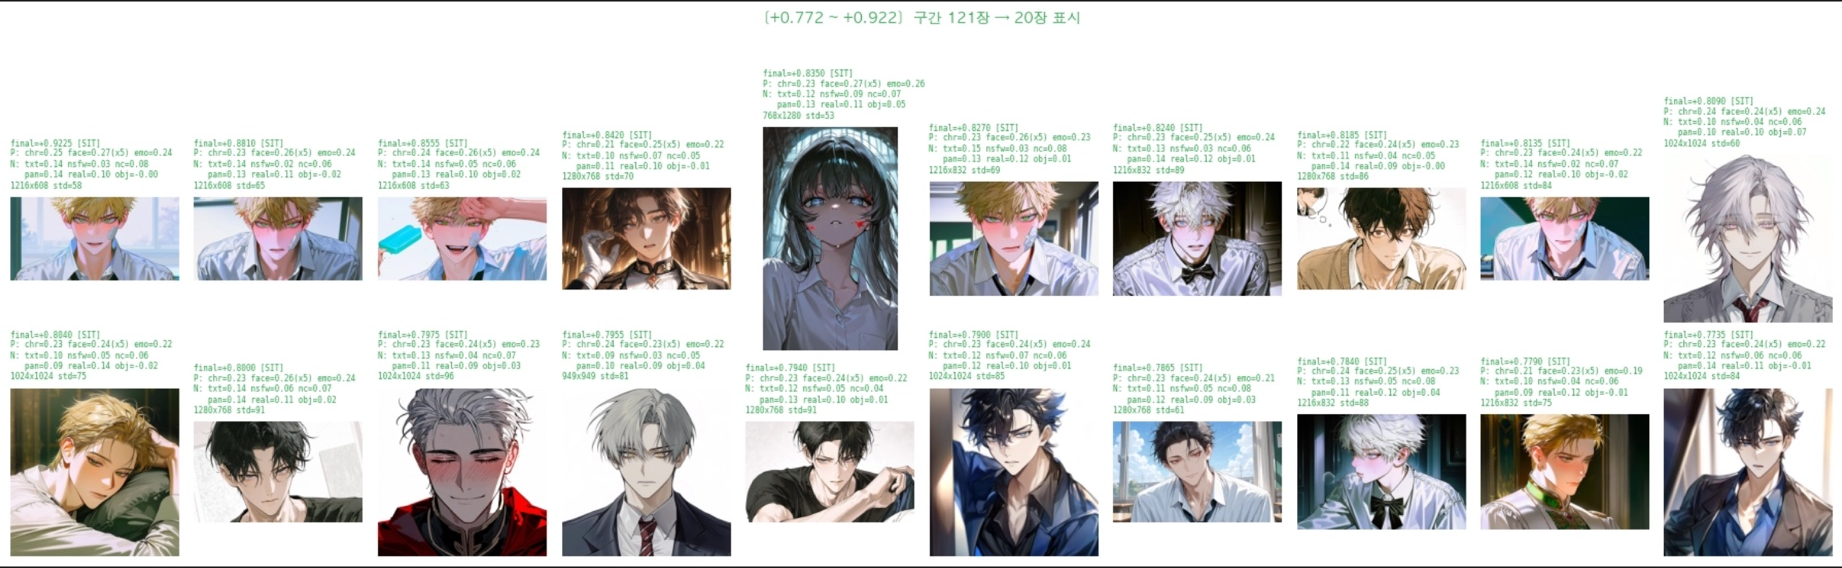
이미지 필터링에서 확인한 후보와 제외 사례
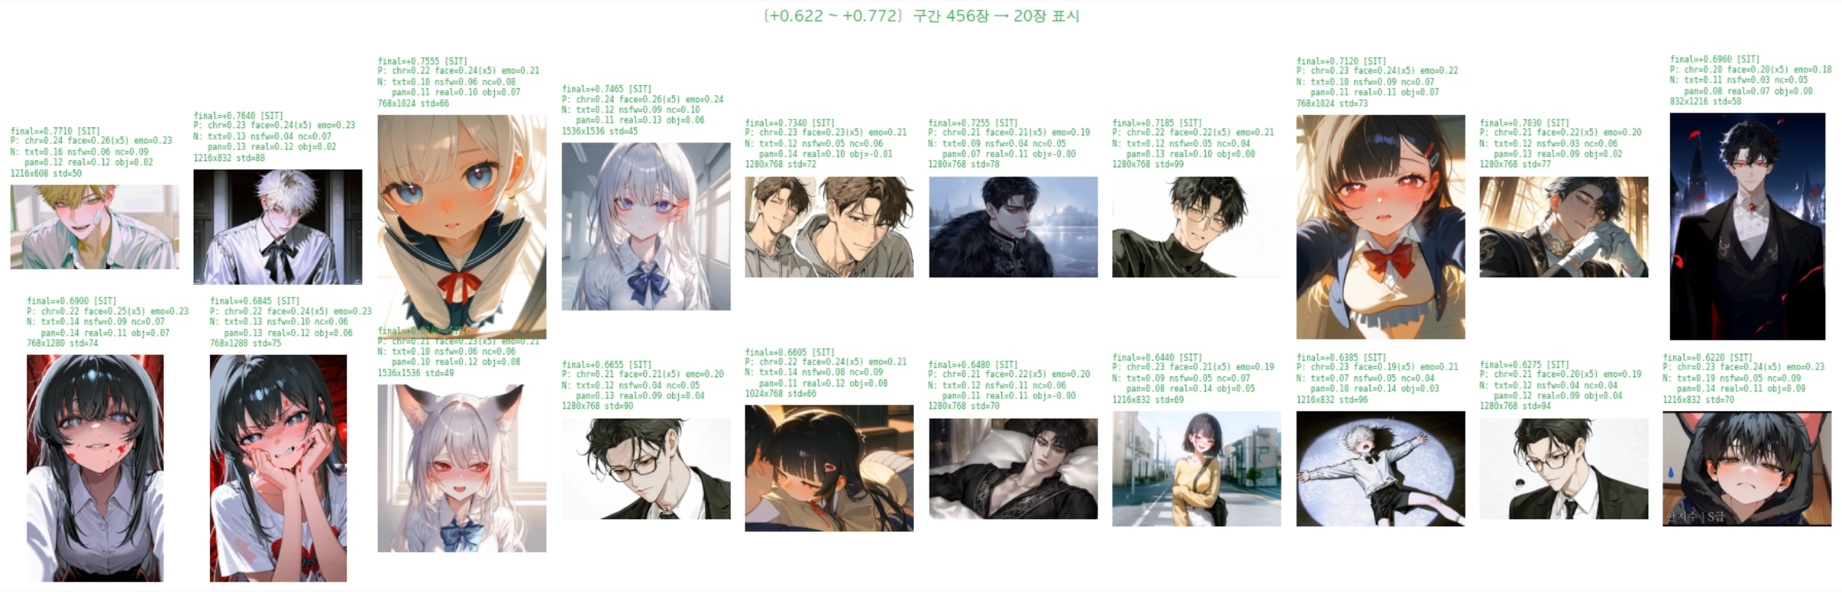
이미지 필터링에서 확인한 후보와 제외 사례
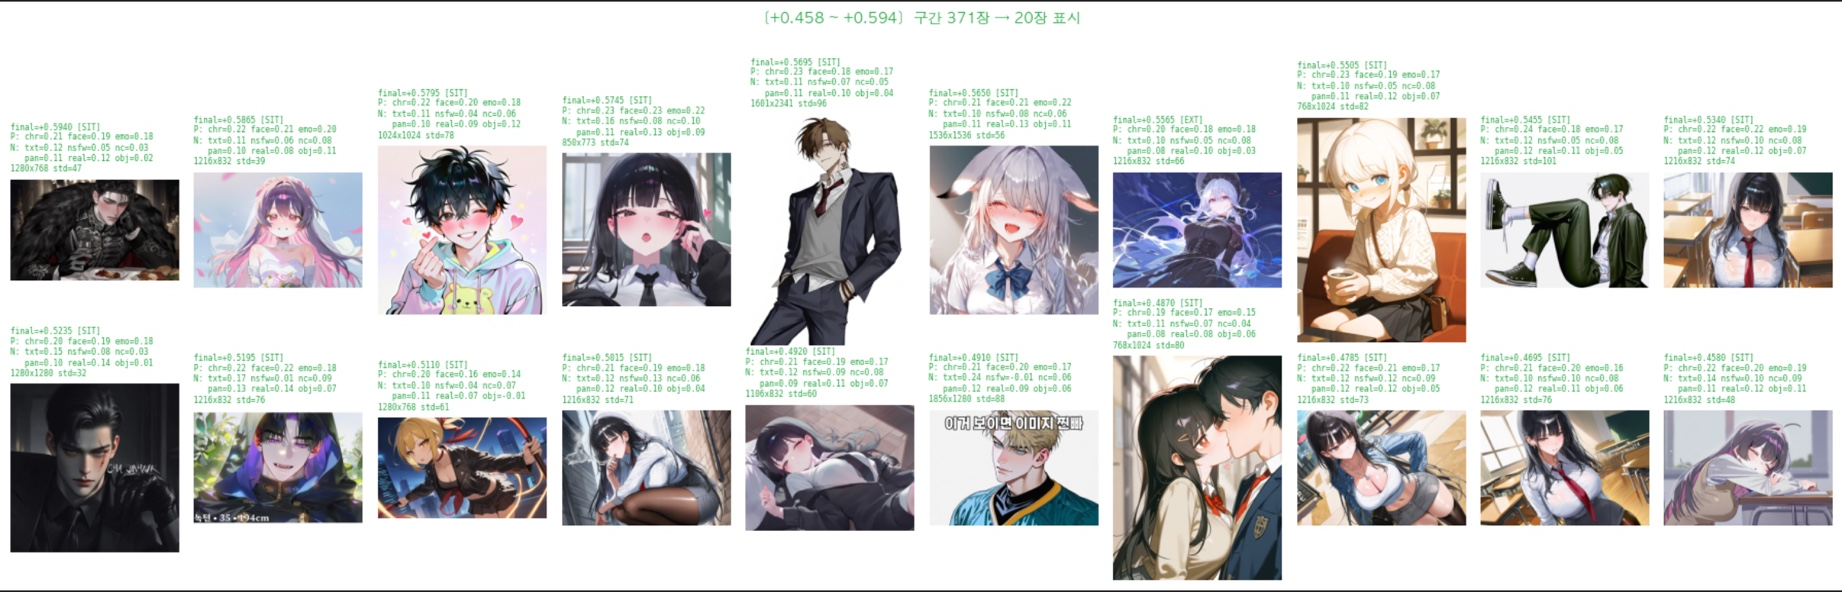
이미지 필터링에서 확인한 후보와 제외 사례
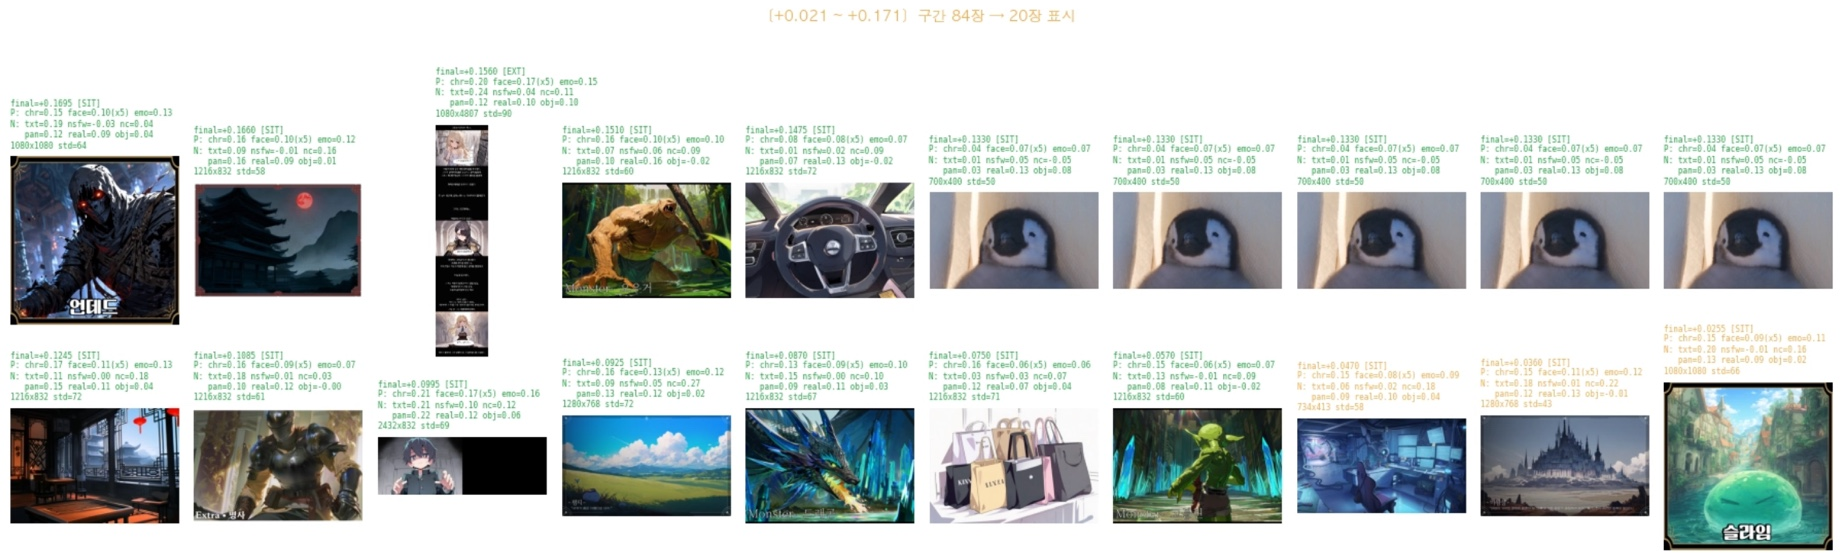
이미지 필터링에서 확인한 후보와 제외 사례
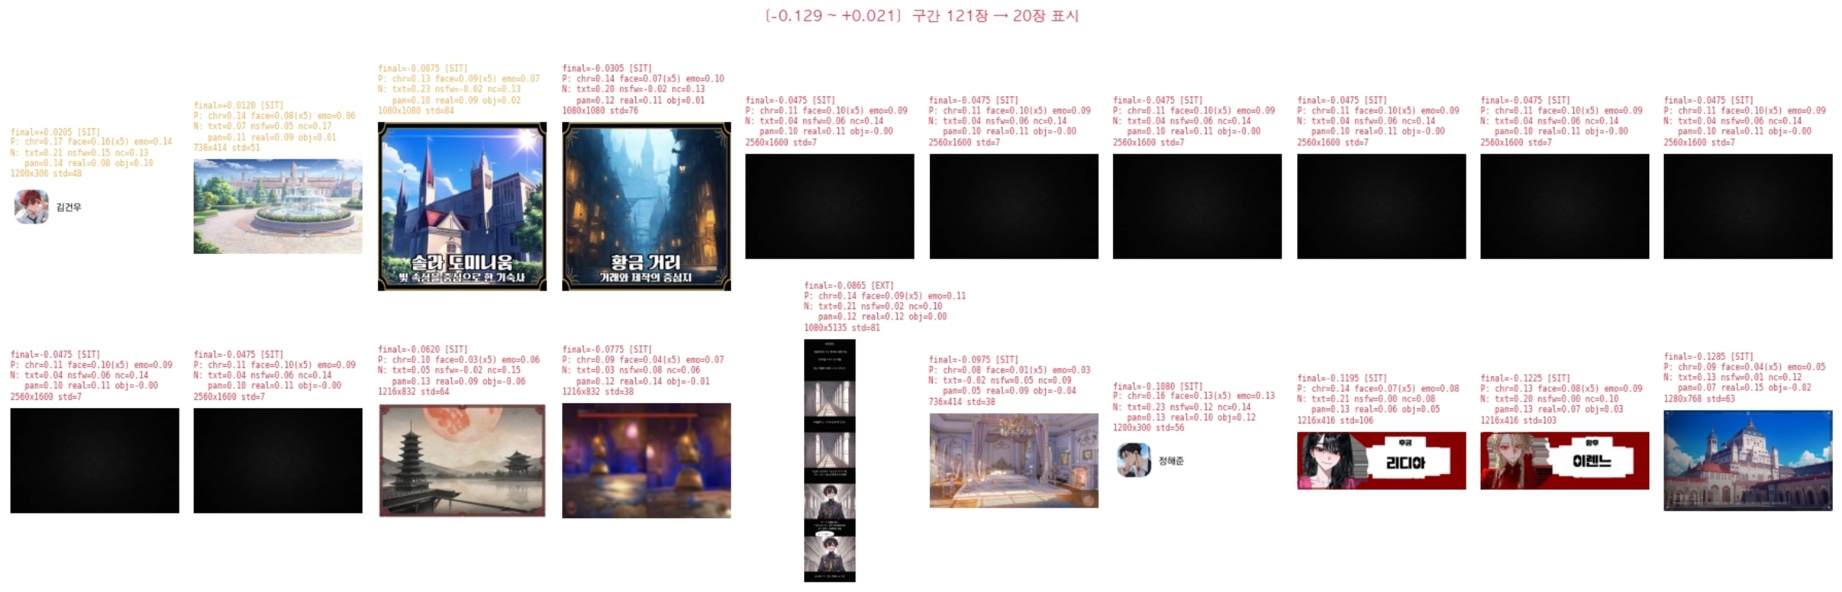
이미지 필터링에서 확인한 후보와 제외 사례
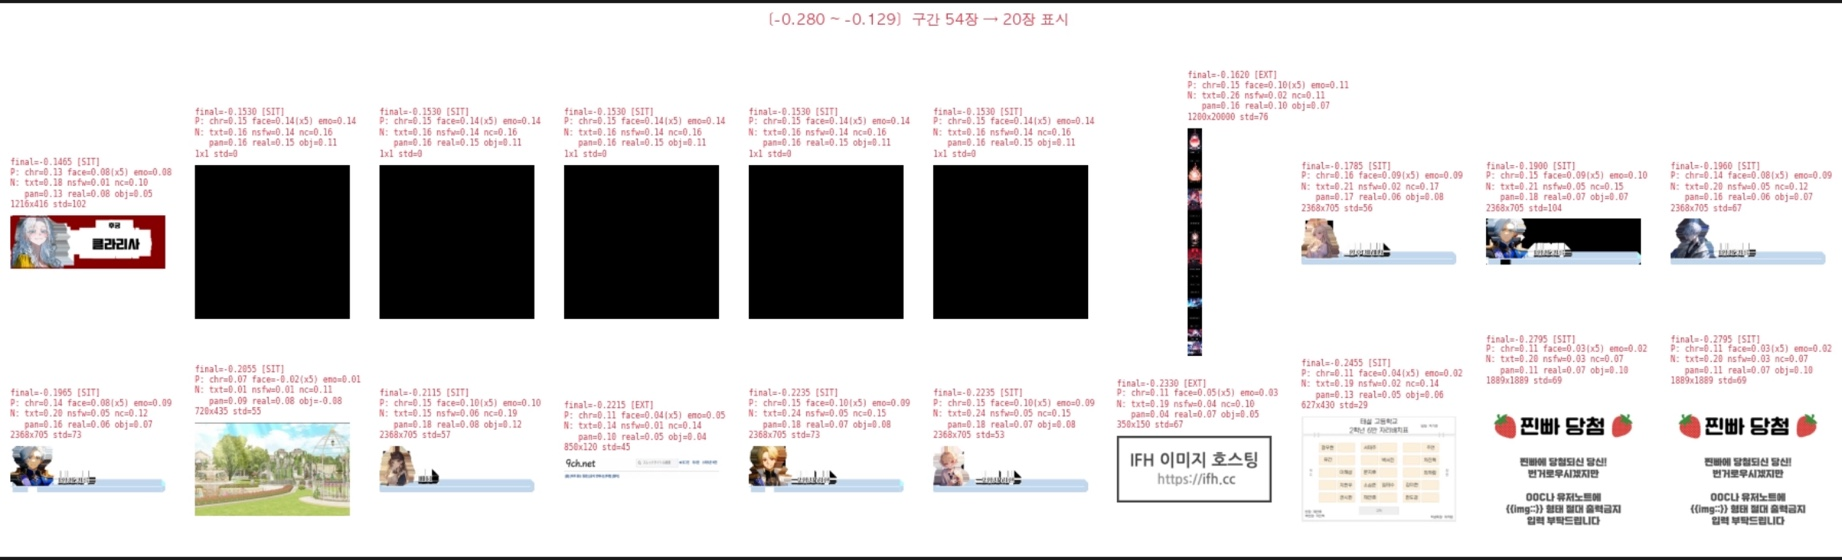
이미지 필터링에서 확인한 후보와 제외 사례
자동화에서는 잘못 남긴 이미지가 그대로 제작까지 갈 수 있어서, 쓸 수 있는 그림이 일부 빠지는 비용도 감수했다. 다만 모델 점수를 낮게 받았다는 사실만으로 그 이미지가 실제 광고에 부적합하다고 확정할 수는 없다. 필터가 무엇을 놓치고 무엇을 과하게 막는지 사례를 같이 확인해야 했다.
임베딩에는 xlm-roberta-base-ViT-B-32를 사용했다. 처음에는 한국 서비스인 크랙에서 개발했지만, 북미 OOC와 일본 캬라푸로 확장할 계획이 있었다. 처음부터 다국어 텍스트 인코더를 고려한 이유다. 이미지를 내려받지 못한 경우는 fetch_status='failed'로 남기고 생성 조회에서는 성공한 자산만 사용했다.
소구점을 그대로 검색하면 잘 맞지 않았다
소구점은 사람의 감정이나 관계를 설명하는 문장이다. ‘은밀한 집착’ 같은 표현을 이미지 검색에 바로 넣으면 눈에 보이는 장면으로 대응하기 어렵다. 이런 추상적인 쿼리를 썼을 때 이미지들과의 코사인 유사도가 낮고, 상위 후보들 사이의 점수 차이도 작았다.
그래서 HyDE 시각 쿼리를 영어 단어 형태로 바꿨다. 머리색, 눈 색, 구도, 표정, 조명처럼 그림에서 확인할 수 있는 특징을 토큰으로 만들었다. 전처리의 소구점 JSON에 이 쿼리를 저장하고, 제작 단계에서는 이미지 벡터와 비교해 후보를 고른다.
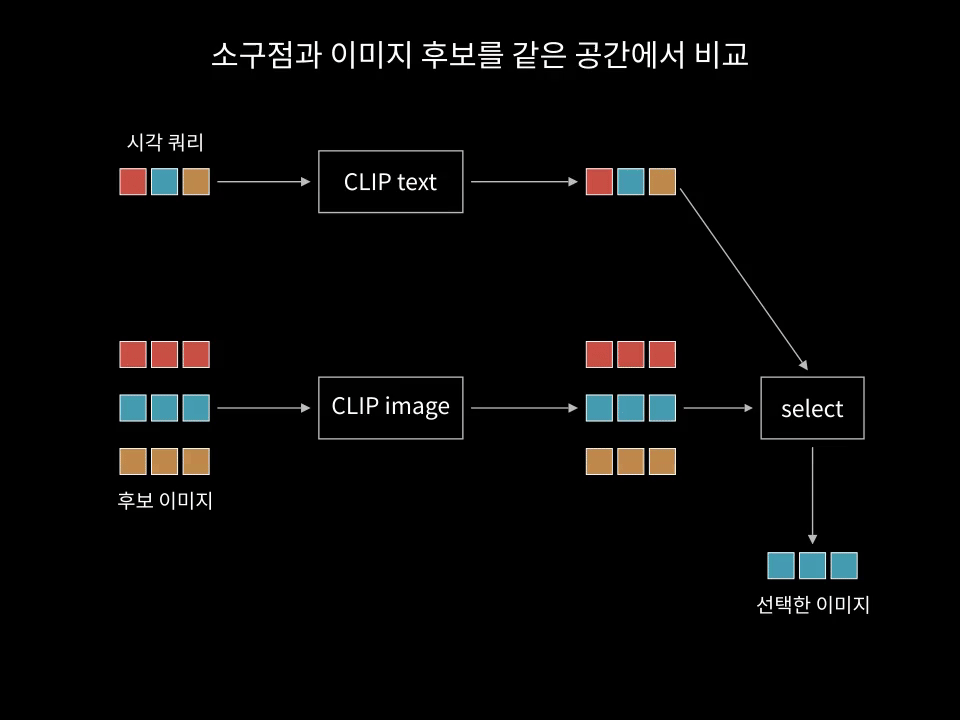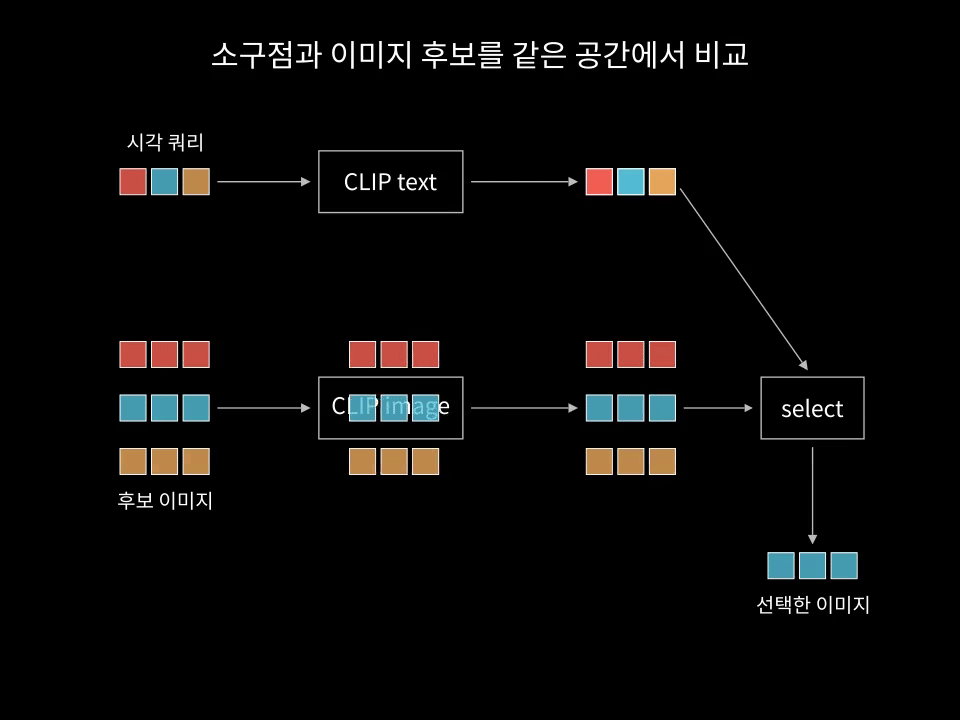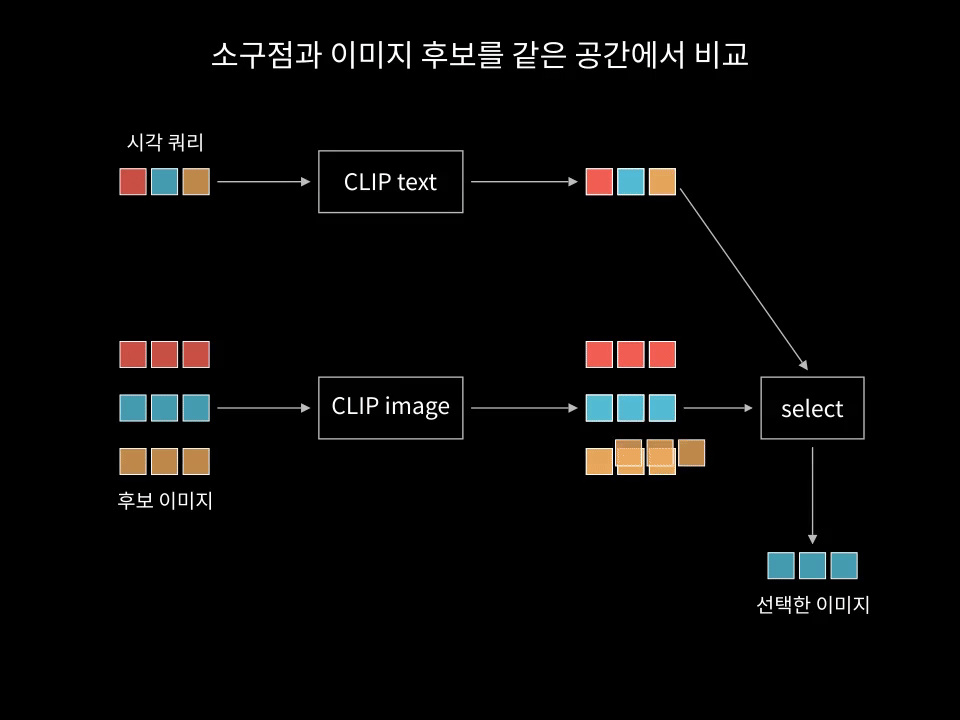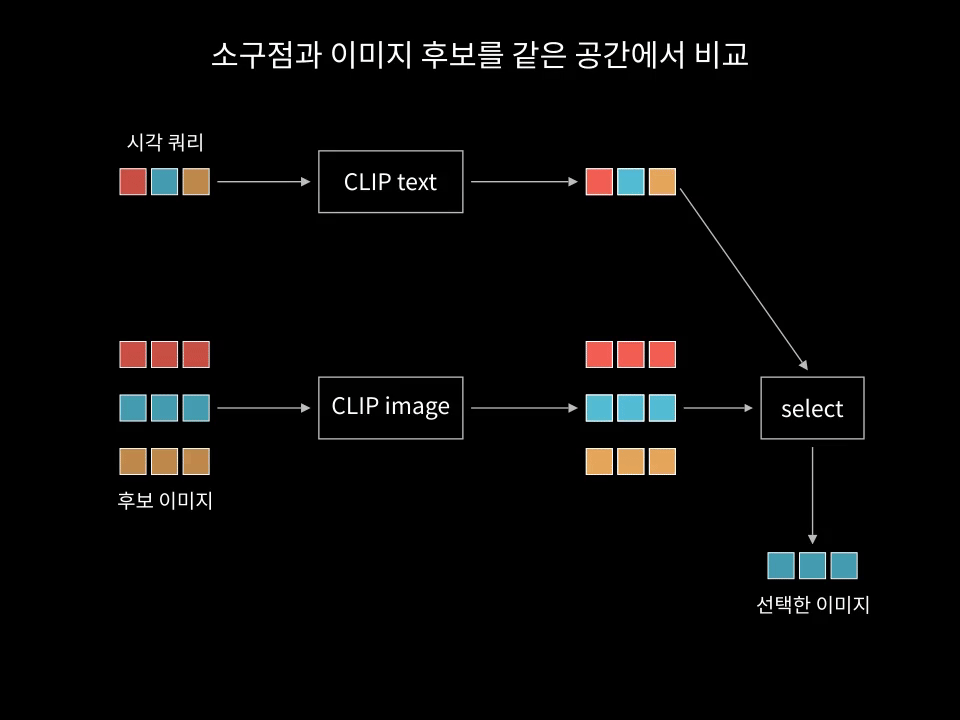
시각 쿼리와 이미지 후보를 CLIP 공간에서 비교해 선택하는 흐름
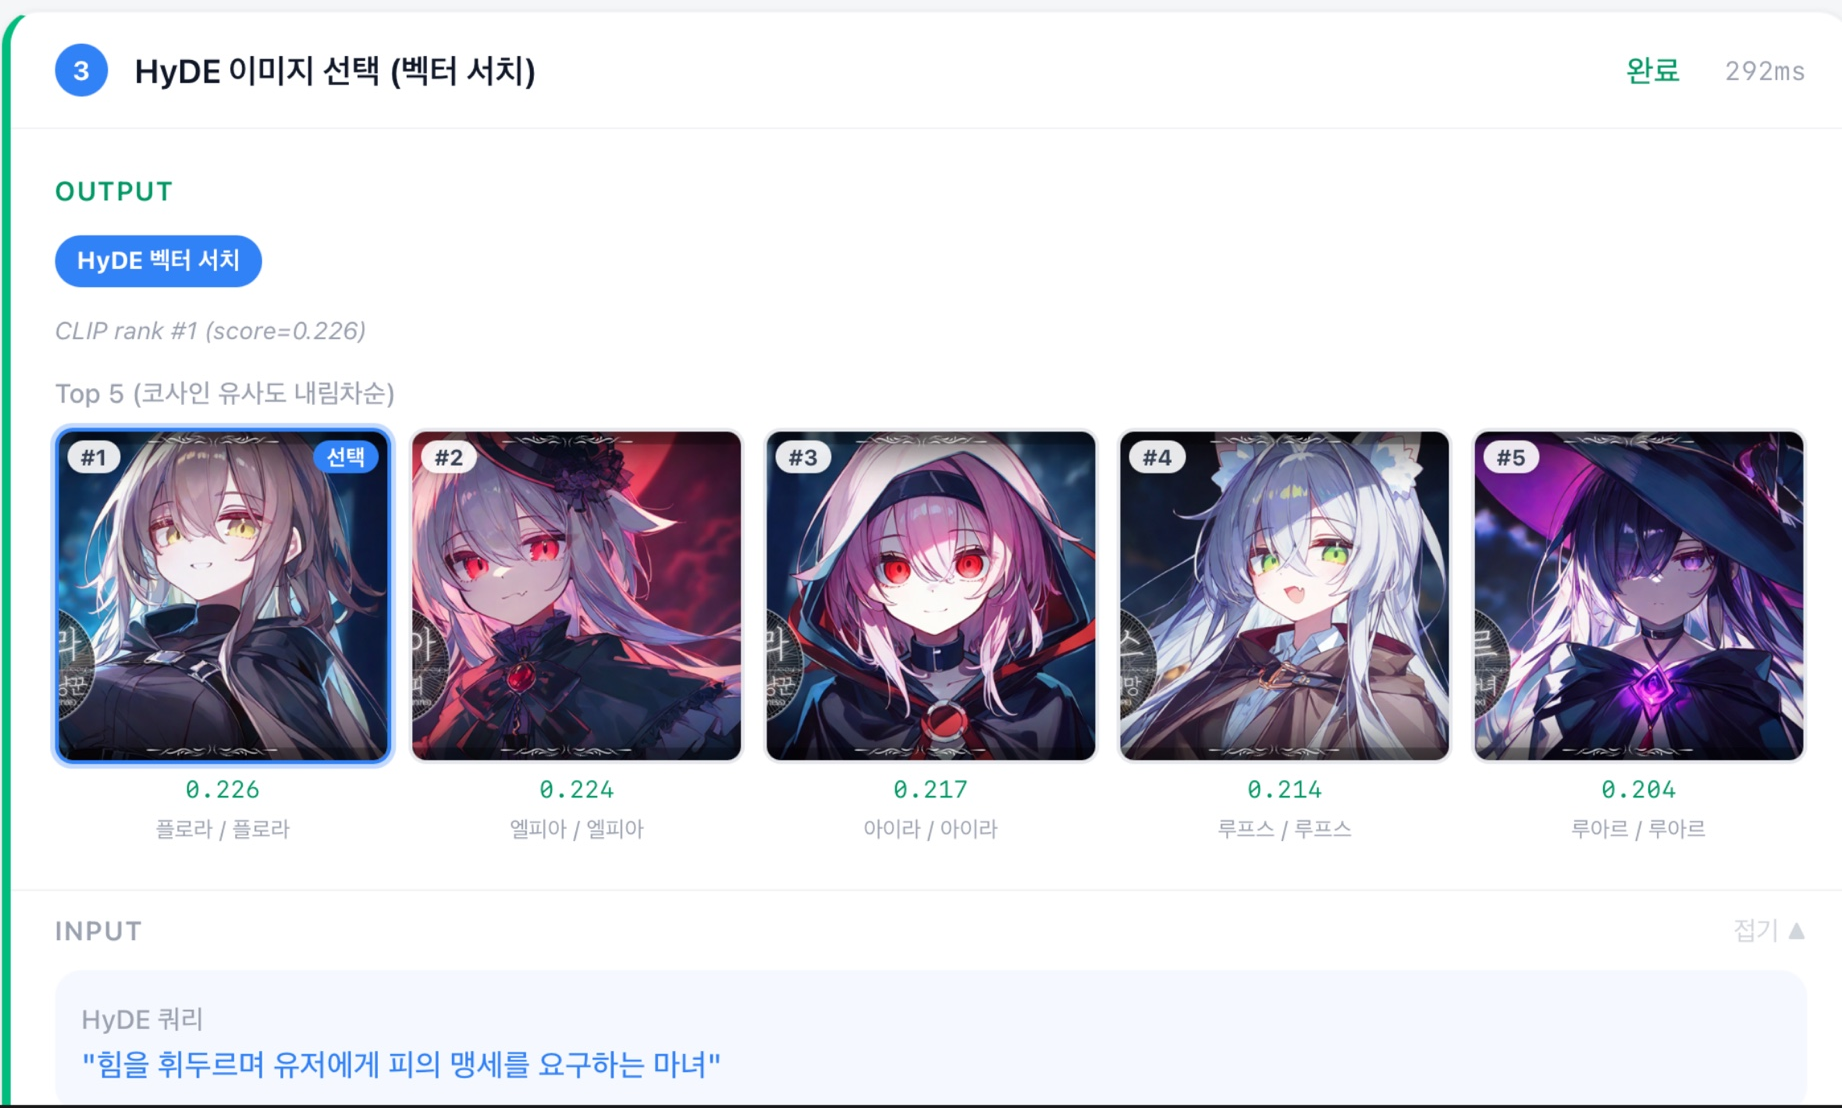
소구점 시각 쿼리로 검색한 이미지 후보
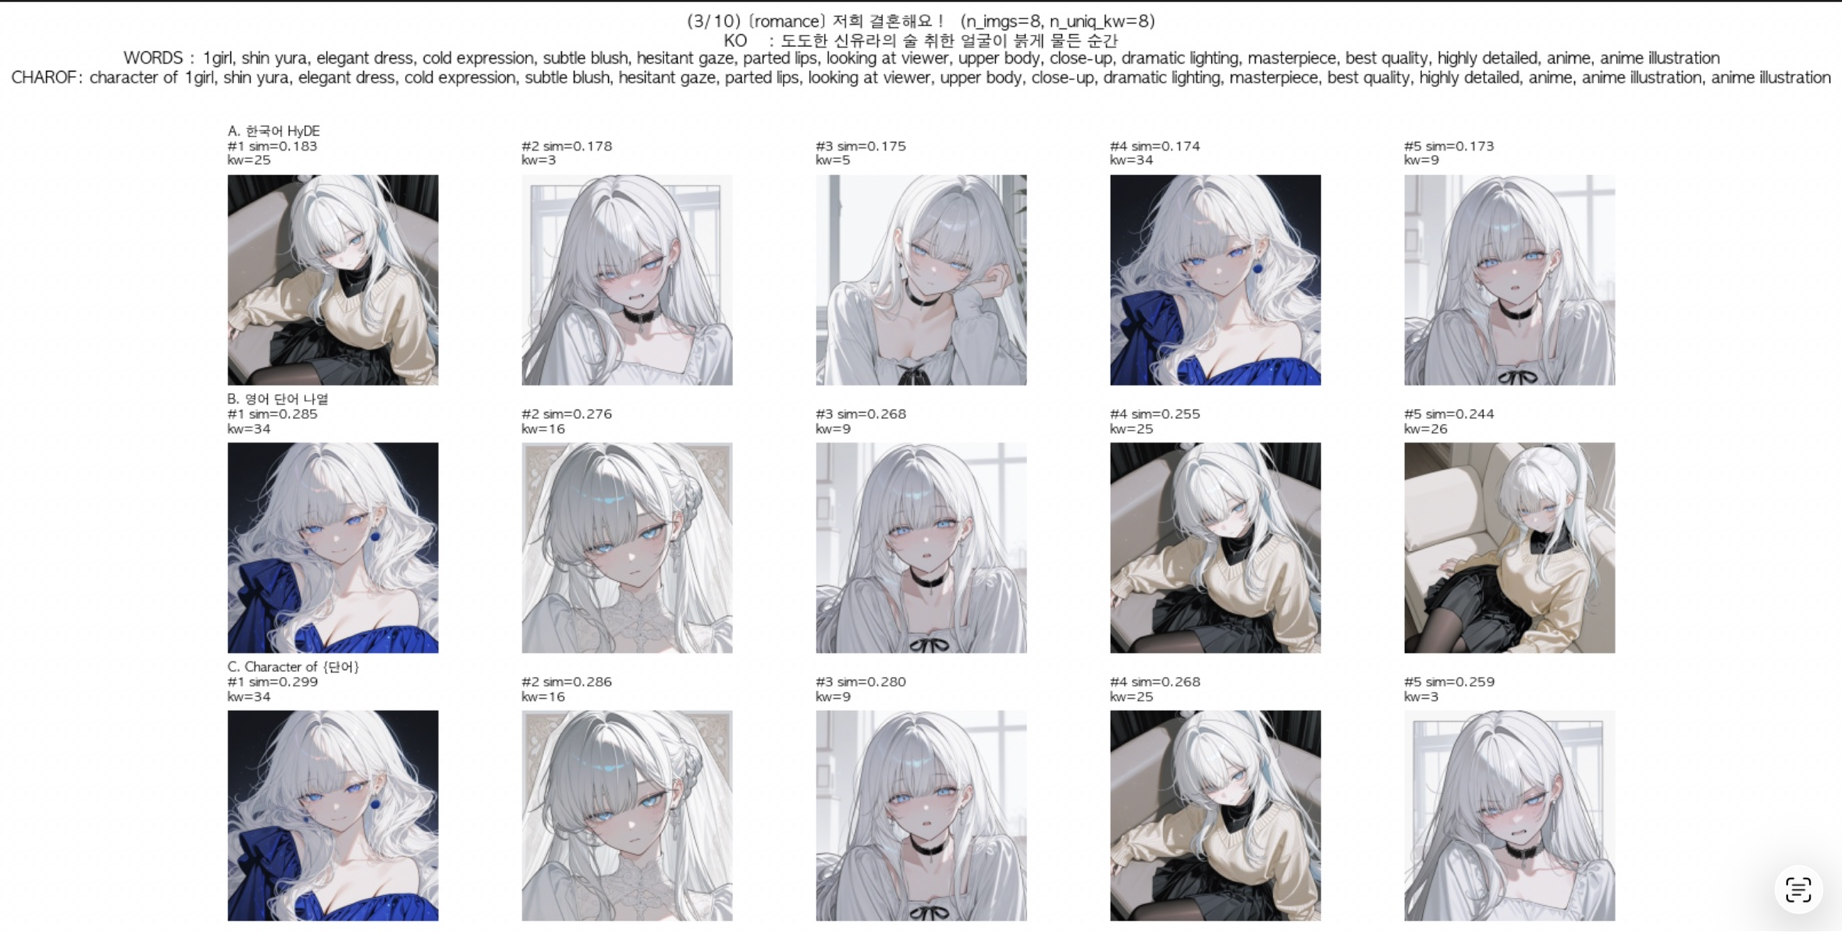
쿼리별 이미지 검색 결과 비교
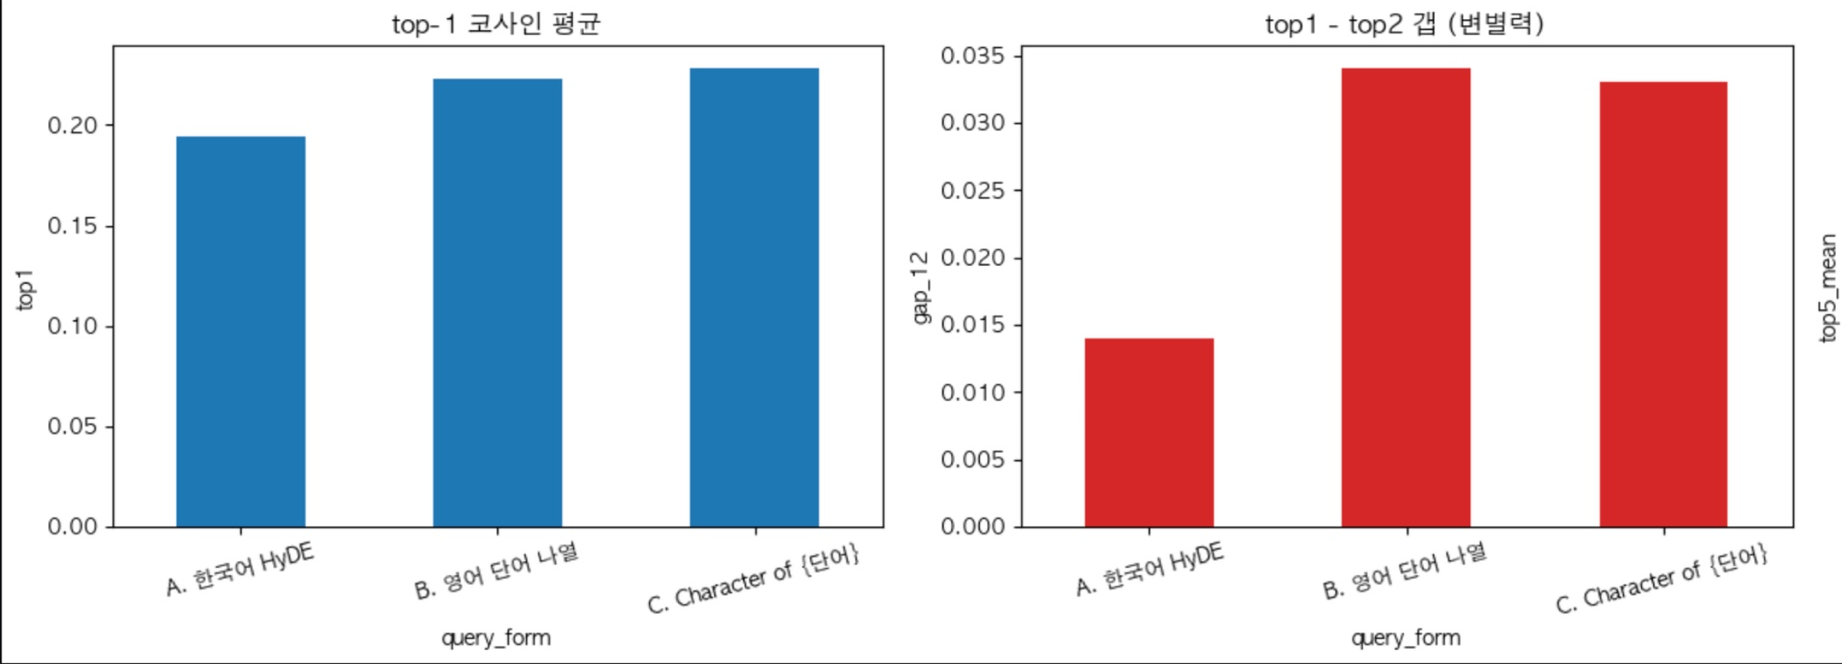
단어형 쿼리의 점수와 후보 간 gap 비교
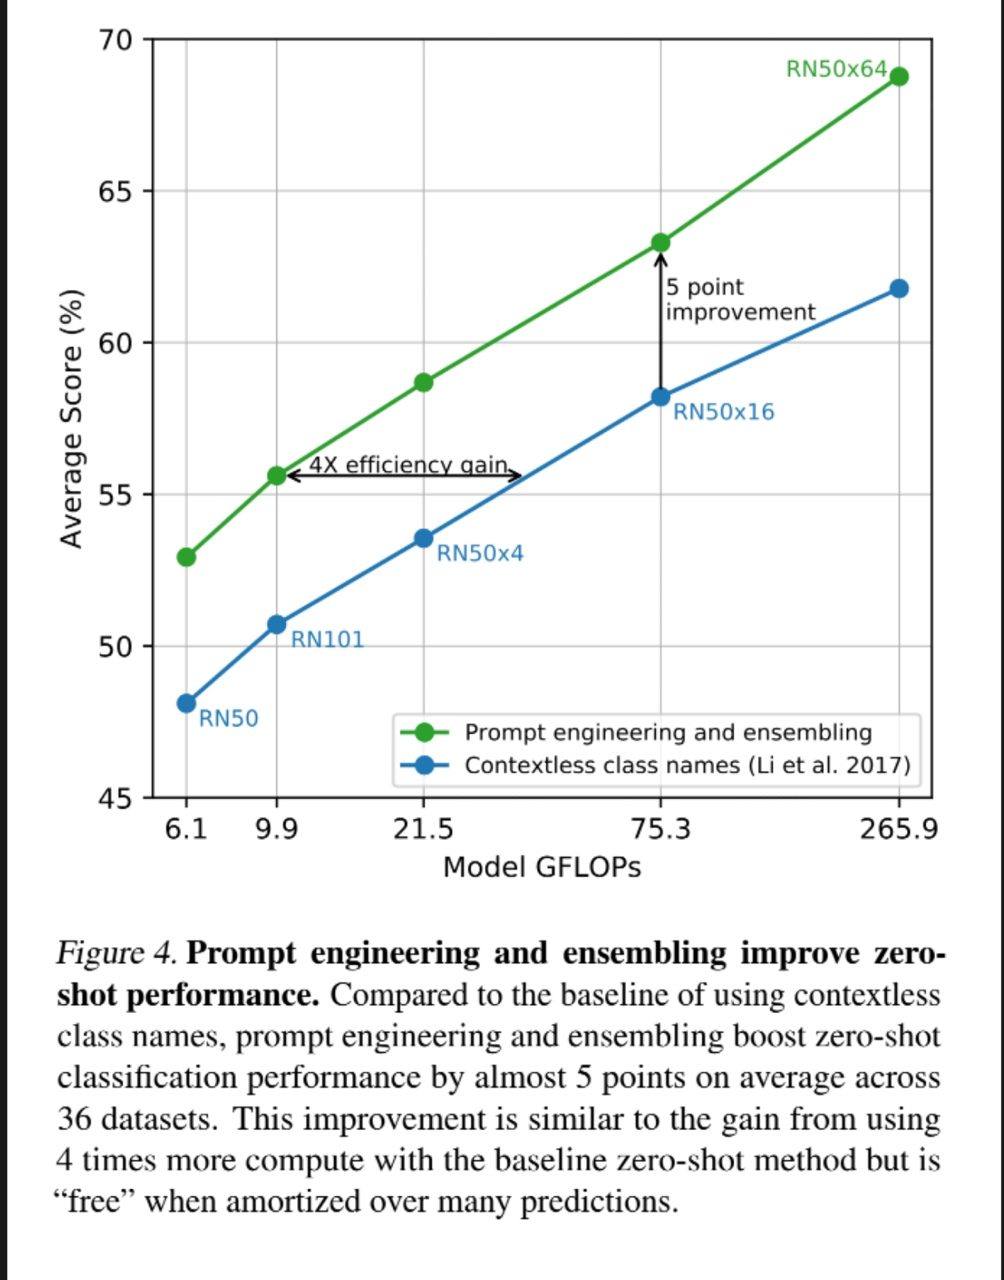
CLIP 논문의 프롬프트별 ImageNet 성능 비교 — Radford et al., CLIP
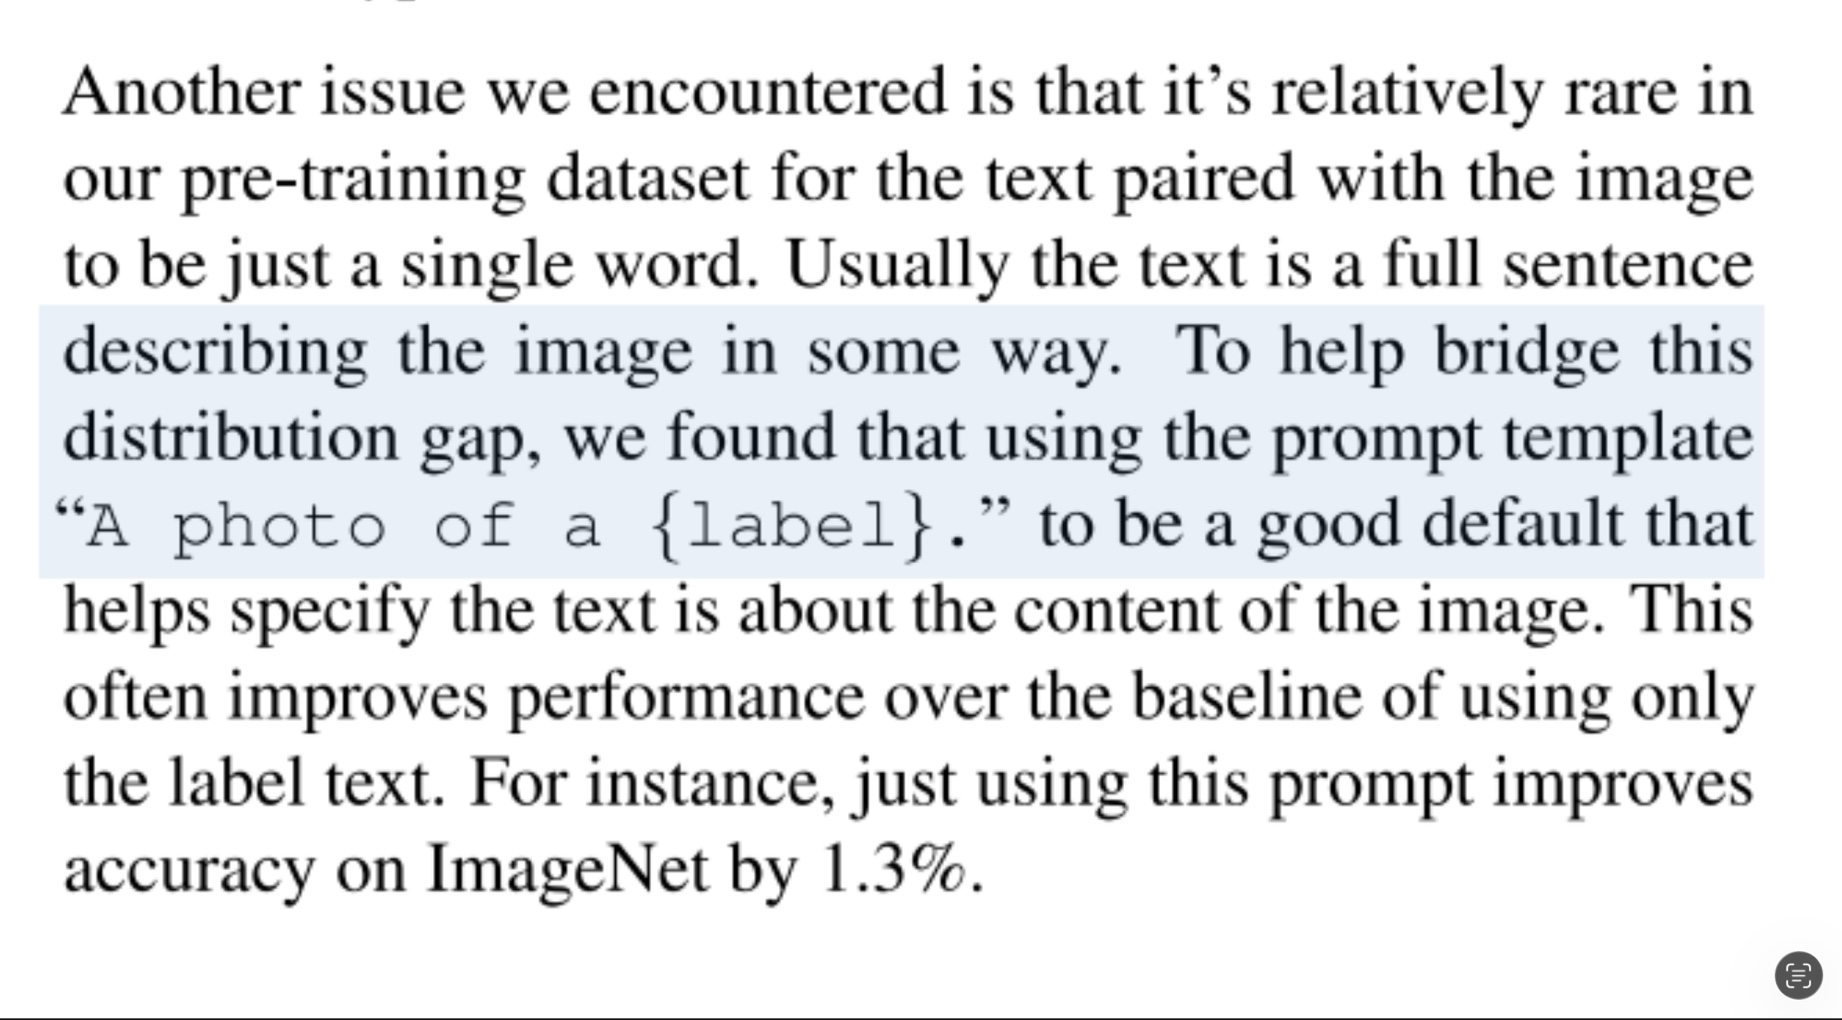
CLIP 논문의 프롬프트 템플릿에 대한 설명 — Radford et al., CLIP
단어형 쿼리에서 코사인 점수와 Top1-Top2 gap이 커지는 경향은 있었다. 그렇지만 기대했던 만큼 크게 개선되지는 않았다. 이미지 에셋이 서로 다른 사물 사진처럼 다양하지 않고, 대부분 같은 캐릭터의 구도 차이였기 때문이라고 추정했다.
점수가 올랐다고 실제로 더 적절한 그림을 골랐다고 단정할 수는 없다. 검색 결과를 눈으로 같이 봐야 했다. 프롬프트를 바꾸는 것만으로 해결할 수 있는 범위가 어느 정도인지 확인한 실험이었다.
소구점마다 CLIP top-1 이미지를 선택하되, 앞의 소구점에서 이미 쓴 그림은 누적해서 제외했다. 서로 다른 카피를 만들었는데 같은 그림만 반복해서 나오는 것도 줄여야 했다.
선택한 그림을 실제 파일로 만들기
이미지 배너 렌더링에는 여러 단계가 들어갔다. 원본에 박힌 글자를 제거하고, 필요한 효과를 넣고, 세로 이미지를 가로 캔버스로 확장한다. 그런 다음 얼굴을 찾고, 카피·폰트·색상·그림을 렌더 상태로 조립한다.
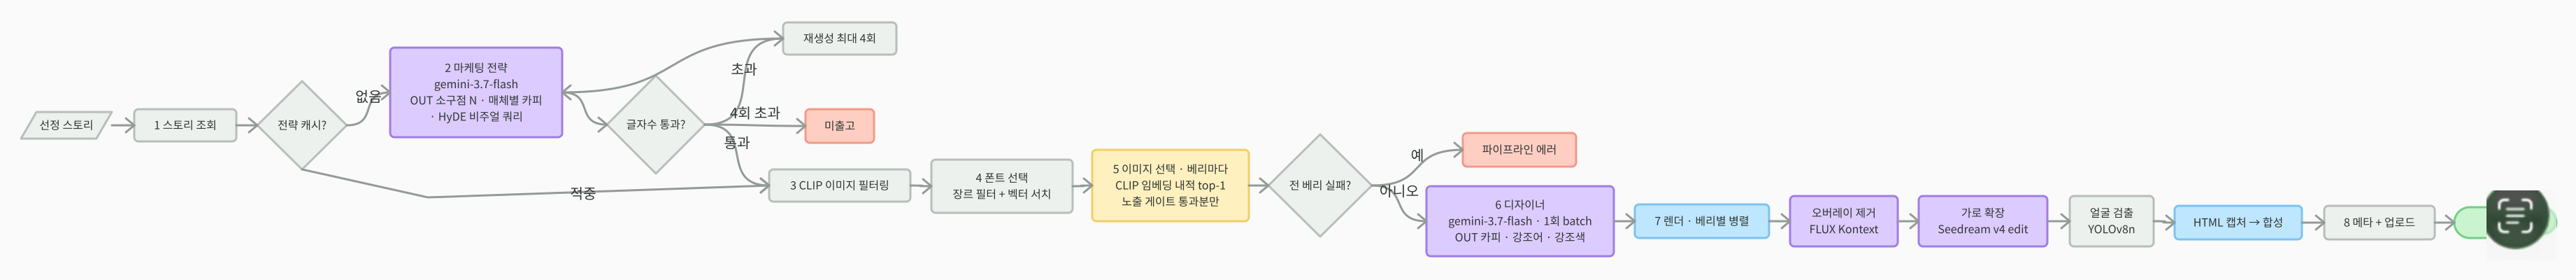
이미지 배너 제작 파이프라인
| # | 단계 | 무엇을 하나 | 산출·캐시 |
|---|---|---|---|
| ① | 오버레이 텍스트 제거 | 원본 그림에 박힌 글자를 FLUX Kontext로 지운다 | overlay_clean_{hash}.png · 실패는 원본으로 조용히 진행 |
| ② | 임팩트 이펙트 (캬라푸) | 일본향 배너용 효과 선처리 | kyarapu_fx_pre_{hash}.png |
| ③ | 가로 아웃페인팅 | 세로 그림을 4000×2000 캔버스로 확장 — 가로 배너 규격을 위해 | outpaint_v2…{hash}.png · DB에 캐시 |
| ④ | 얼굴 검출 | 확장된 이미지에서 얼굴 좌표 검출 | image_assets.face |
| ⑤ | state 조립 | 카피·폰트·색·이미지를 렌더러가 먹는 하나의 상태 객체로 | render state |
| ⑥ | 캡처 | Chromium 하나 + 영속 컨텍스트 N개로 HTML을 2× 슈퍼샘플 캡처 | 1080×1920 원본 + 프리셋별 PNG |
| ⑦ | 후처리 | 정확한 해상도로 다운샘플 + 500KB 이하로 압축 | {prefix}_{preset}.jpg |
HTML을 Chromium으로 캡처한 뒤 매체별 해상도로 줄이고 파일 용량도 맞췄다. 같은 원본에 같은 처리를 반복하지 않도록 오버레이 제거와 아웃페인팅 결과는 캐시했다. 텍스트 제거에 실패하면 원본으로 진행하는 단계가 있는 반면, 아예 결과를 버려야 하는 생성 경로도 있다. 모든 실패에 똑같은 재시도 규칙을 쓰지는 않았다.
얼굴 검출 모델도 도메인을 맞춰야 했다
사이즈 베리에이션 로직은 얼굴 좌표를 기준으로 배치했다. 그래서 얼굴을 못 찾거나 엉뚱한 위치를 찾으면 가로·정사각 배너에서 캐릭터가 잘렸다. 실사 얼굴에 맞춰진 BlazeFace를 쓰다가, 애니메이션 도메인으로 학습한 YOLOv8 nano 기반 모델로 바꿨다.
| 모델명 | BlazeFace | face_detect_v0_n(YOLOv8 nano) |
|---|---|---|
| 학습 도메인 | 실사 인물 사진 (Google open dataset) | Anime 일러스트 |
| 파라미터수 | 110k | 3.01M |
| 모델 사이즈 | ~250KB | 12.1MB |
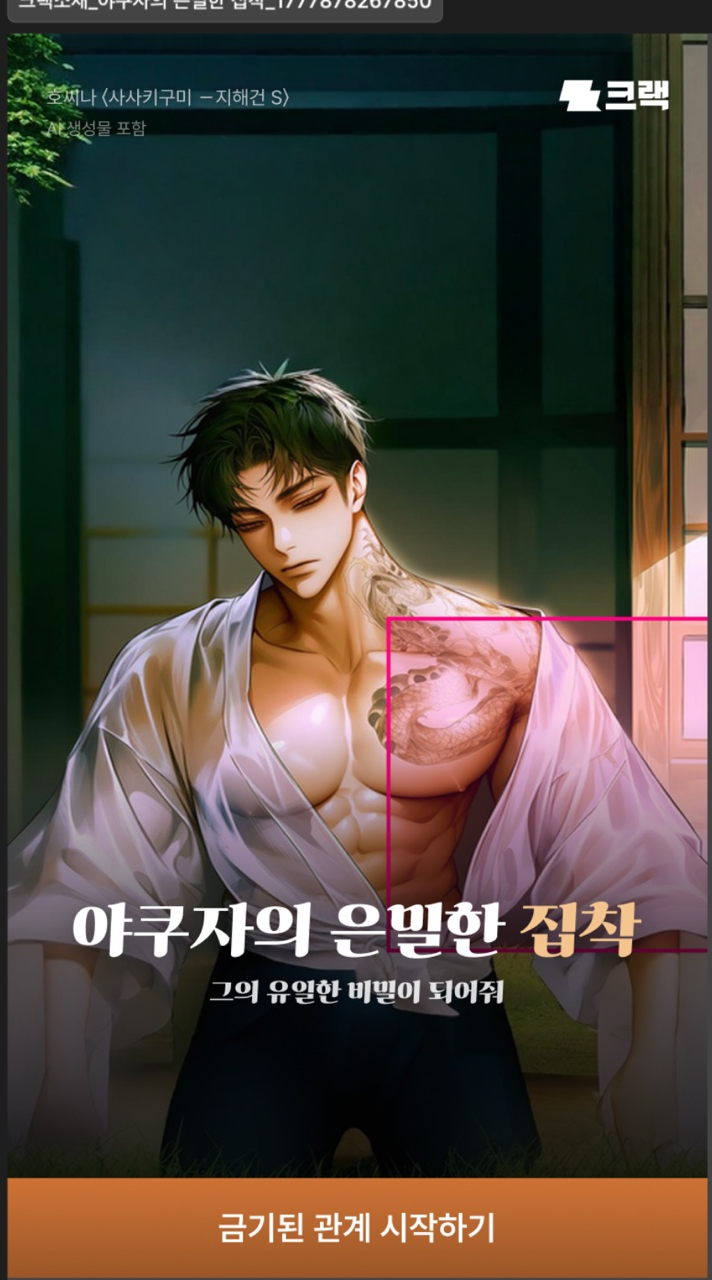
얼굴 좌표를 활용한 세로 배너
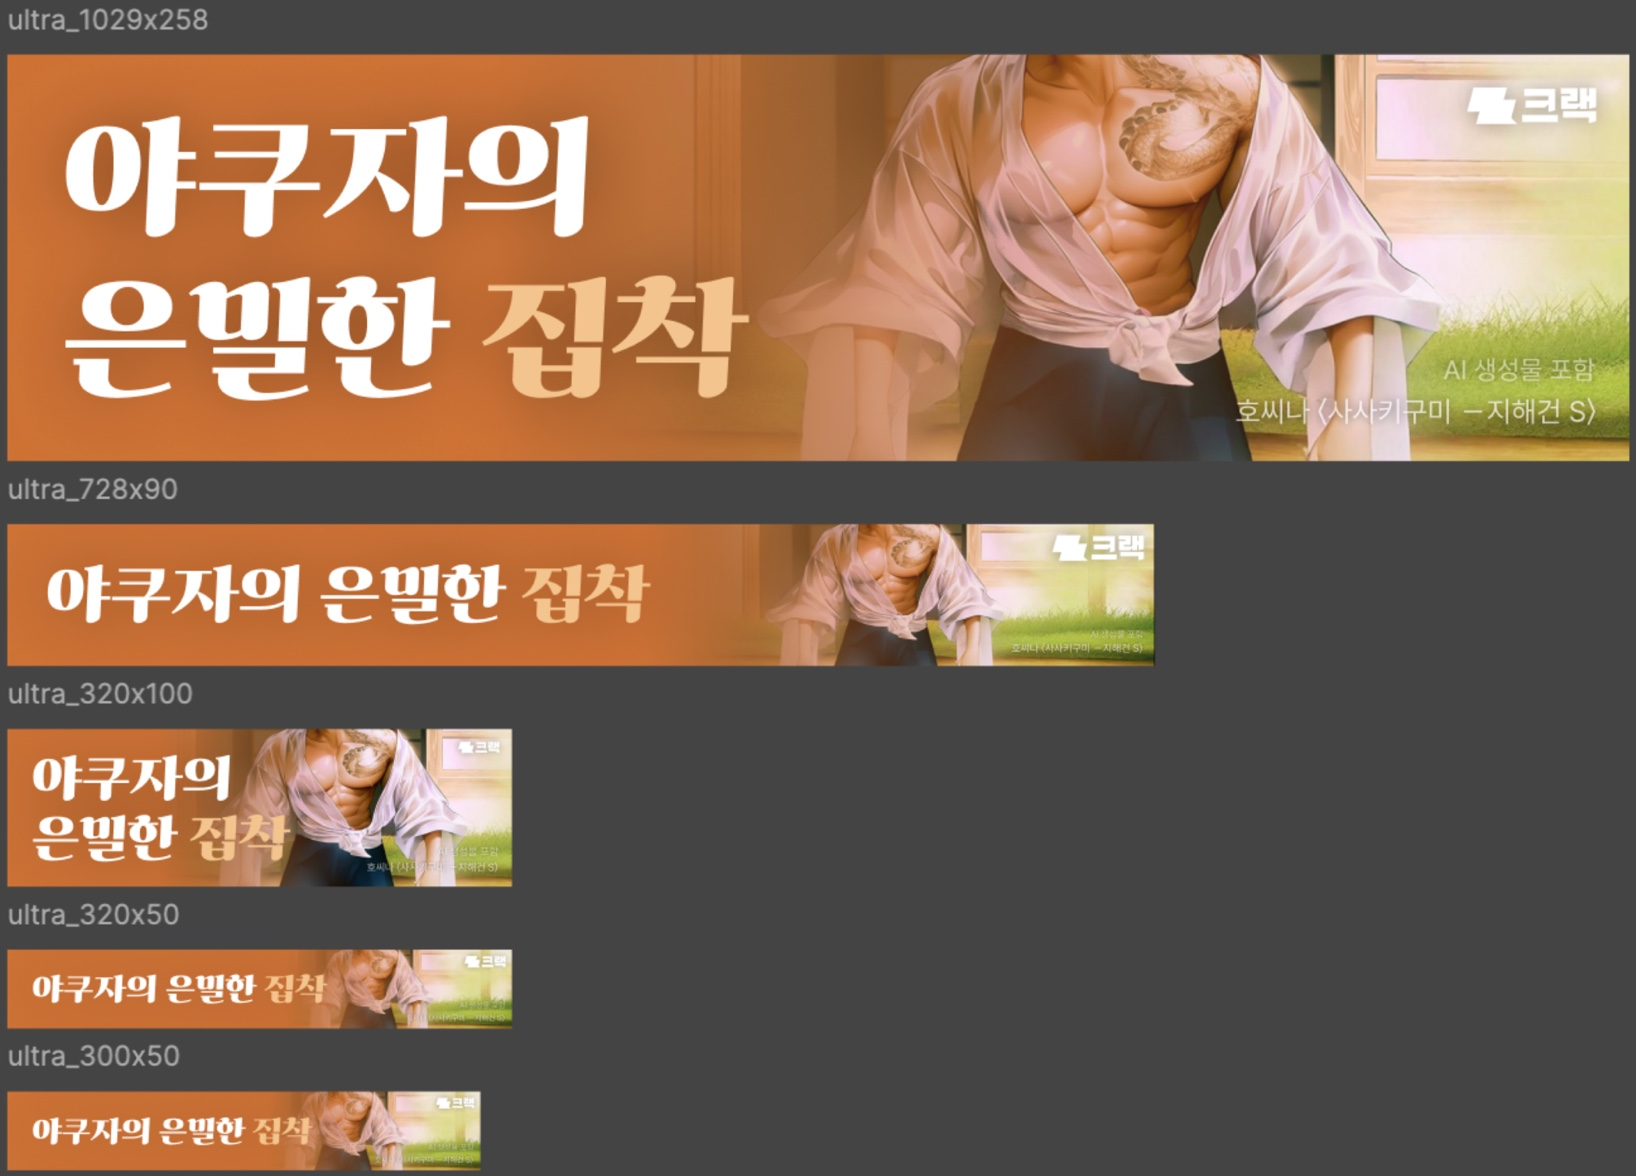
얼굴 기준의 규격별 배너 베리에이션
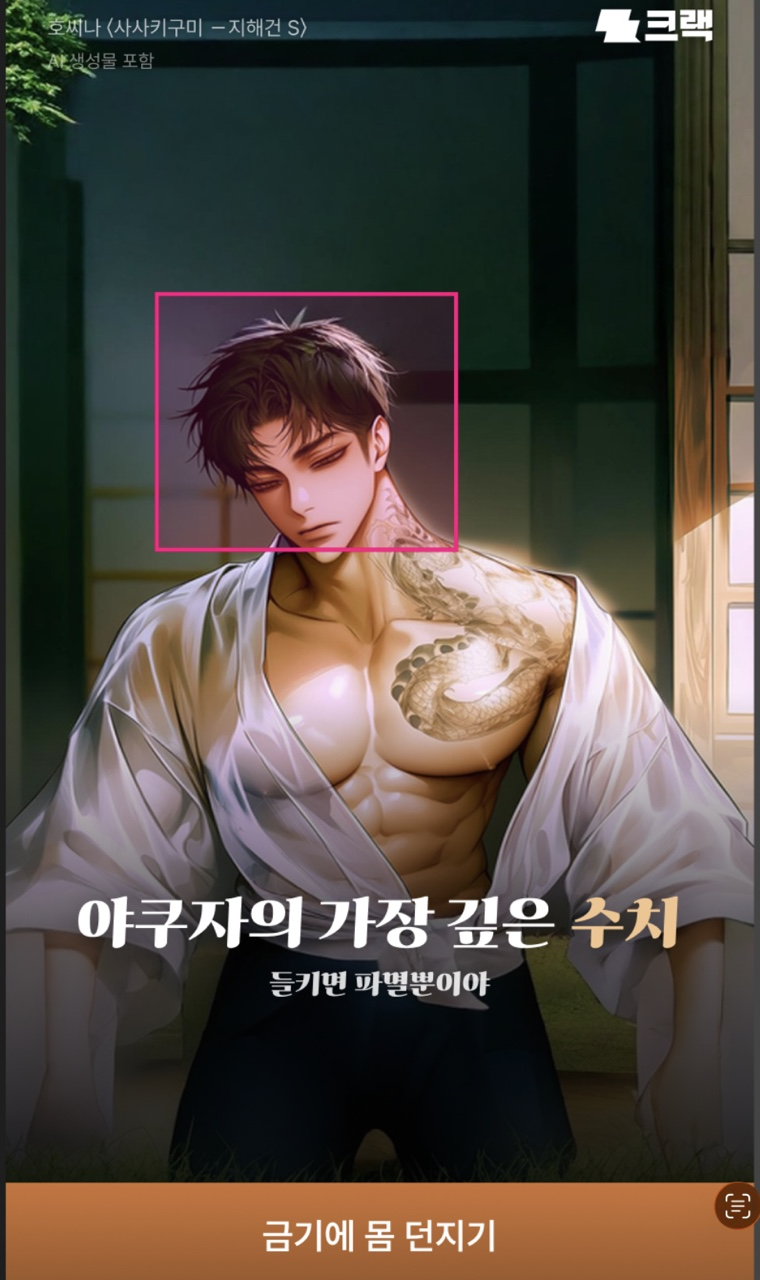
다른 이미지에 적용한 얼굴 기준 배치
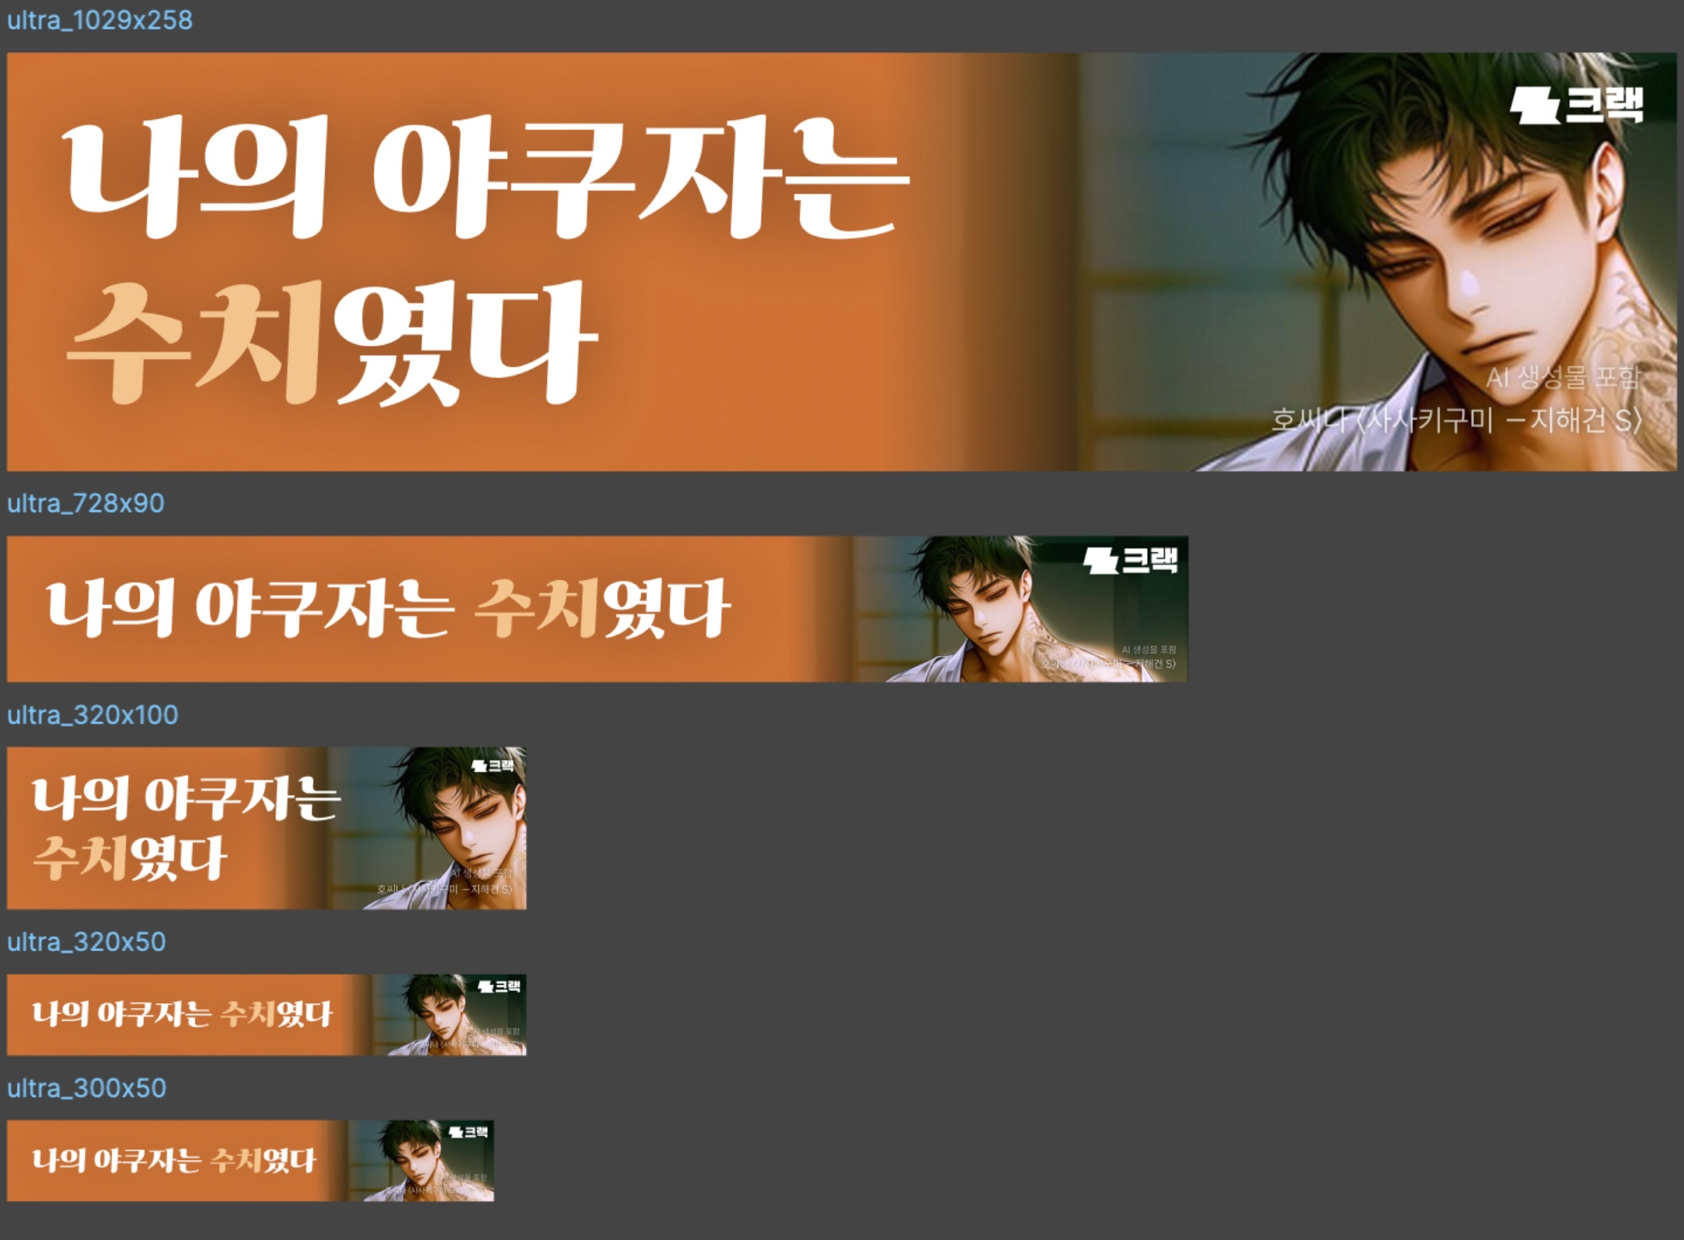
규격 변경 후 캐릭터 배치 사례
교체 후 얼굴 인식과 배너 오류 사례가 개선됐다. 모델의 크기는 더 커졌지만, 우리가 입력으로 넣는 그림은 실사 얼굴이 아니라 애니메이션 캐릭터였다. 이 작업에서는 그 도메인에 맞는 검출 결과가 후속 배치의 기준이 된다. 모델이 가볍다는 장점만 보고 선택할 수는 없었다.
폰트도 검색 대상으로 만들었다
디자이너분이 전달해 주신 폰트들을 임베딩하고, 작품의 장르와 소구점에 맞는 폰트를 벡터 검색으로 고르는 흐름을 만들었다. 같은 카피라도 어떤 폰트를 쓰느냐에 따라 분위기가 다르기 때문이다. 생성 단계에서 저장한 이상적인 폰트 샘플 문장도 이 선택에 연결했다.
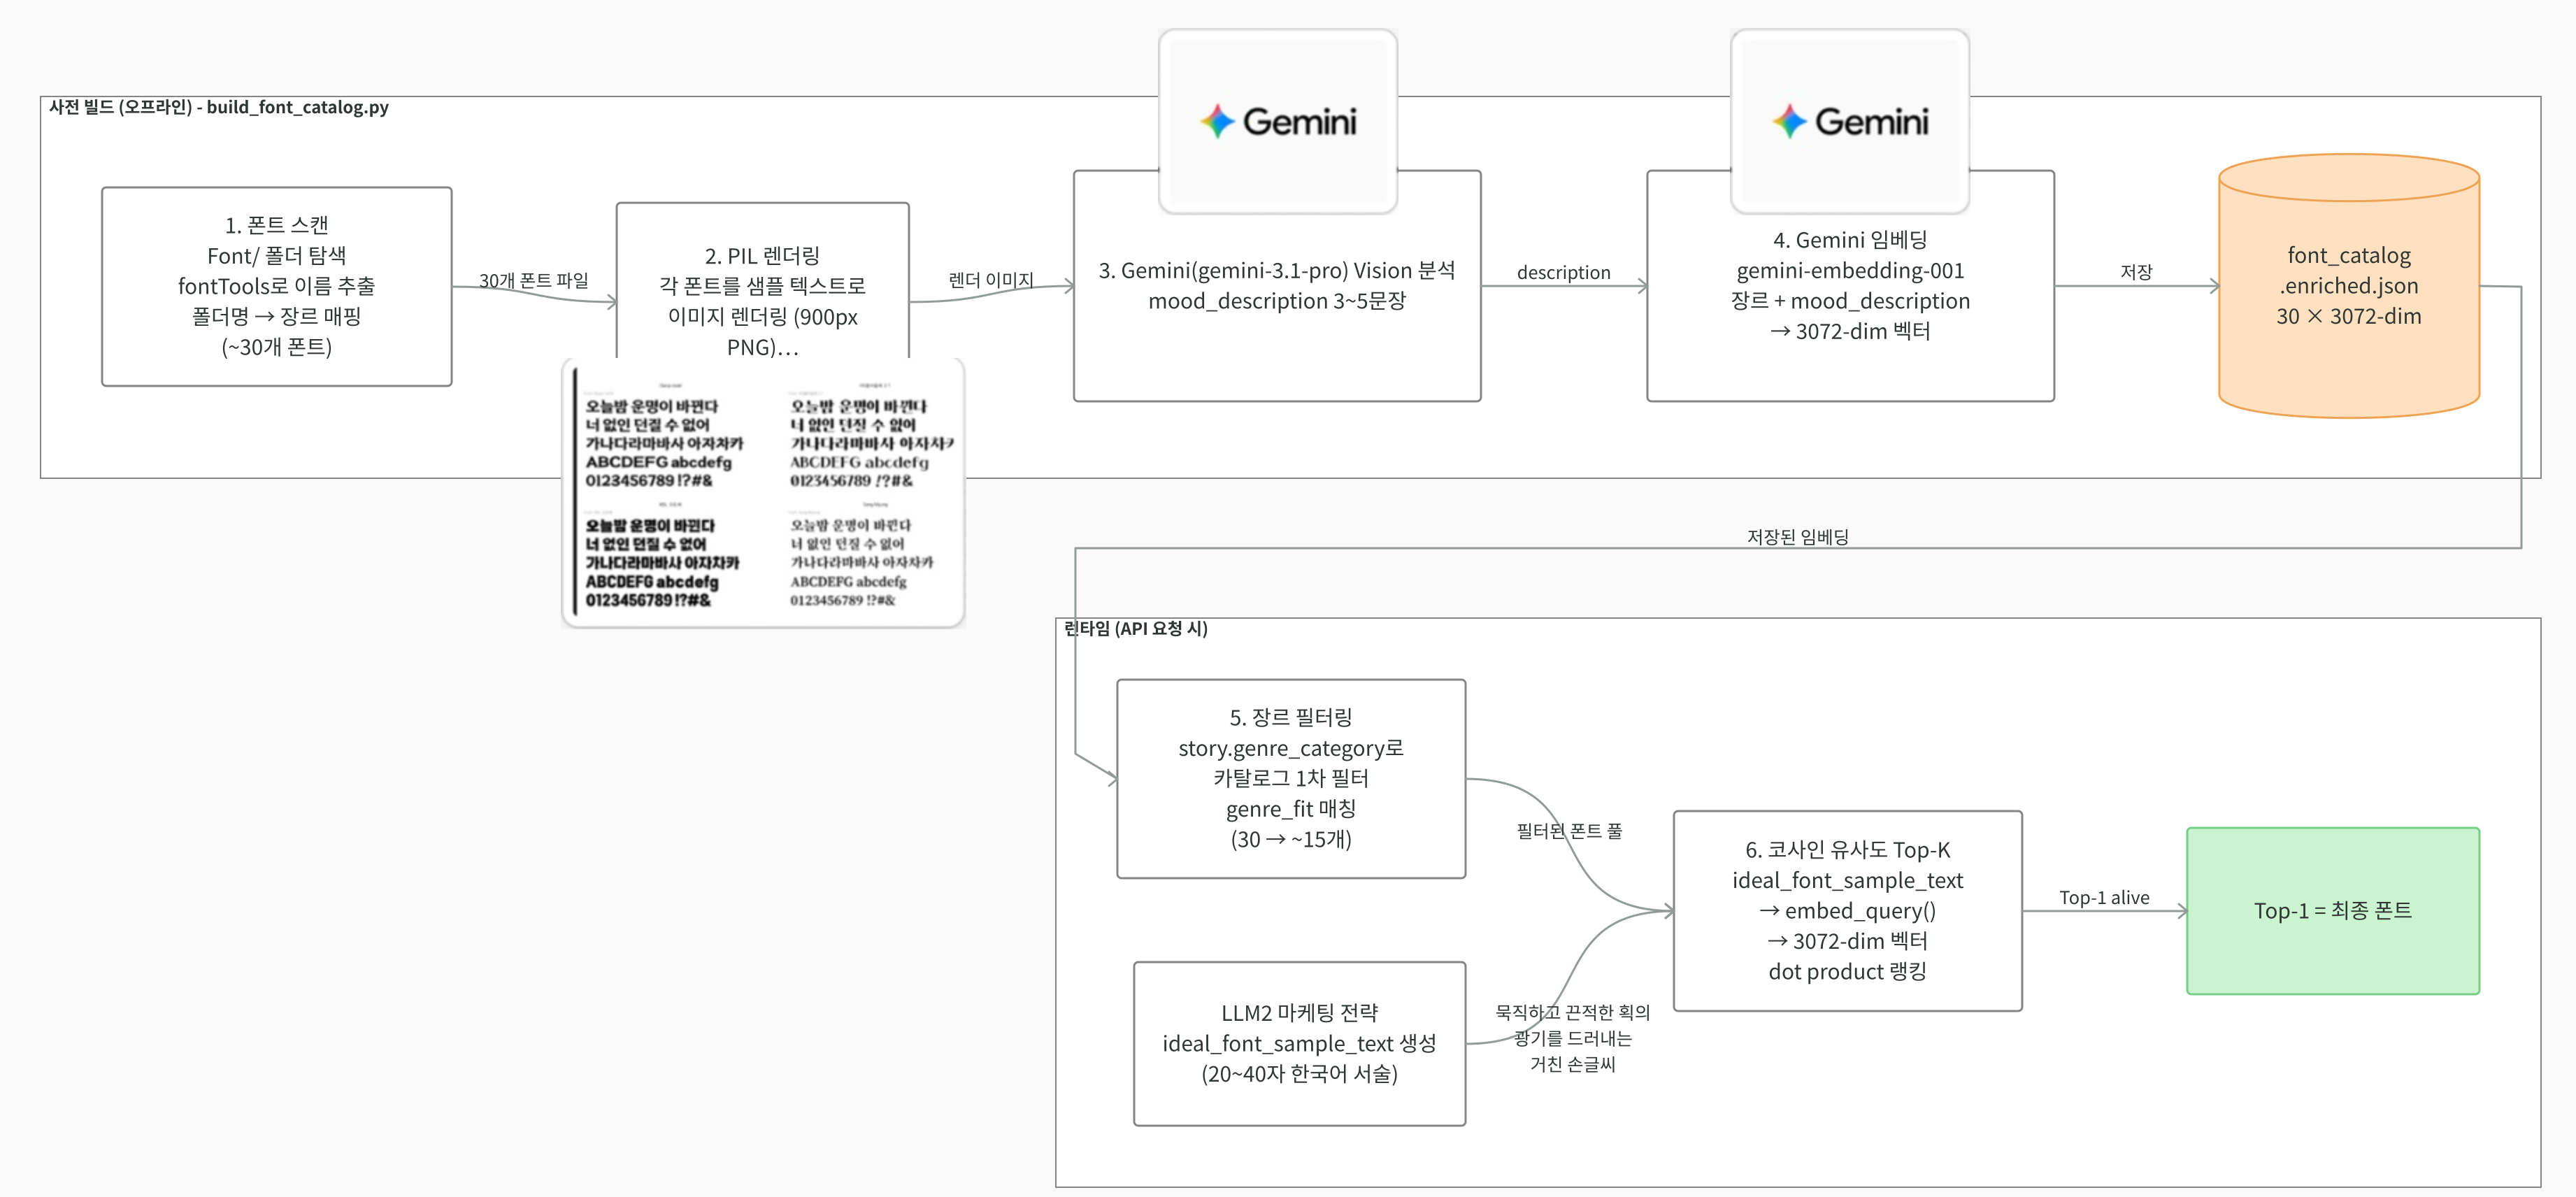
폰트 선택 파이프라인
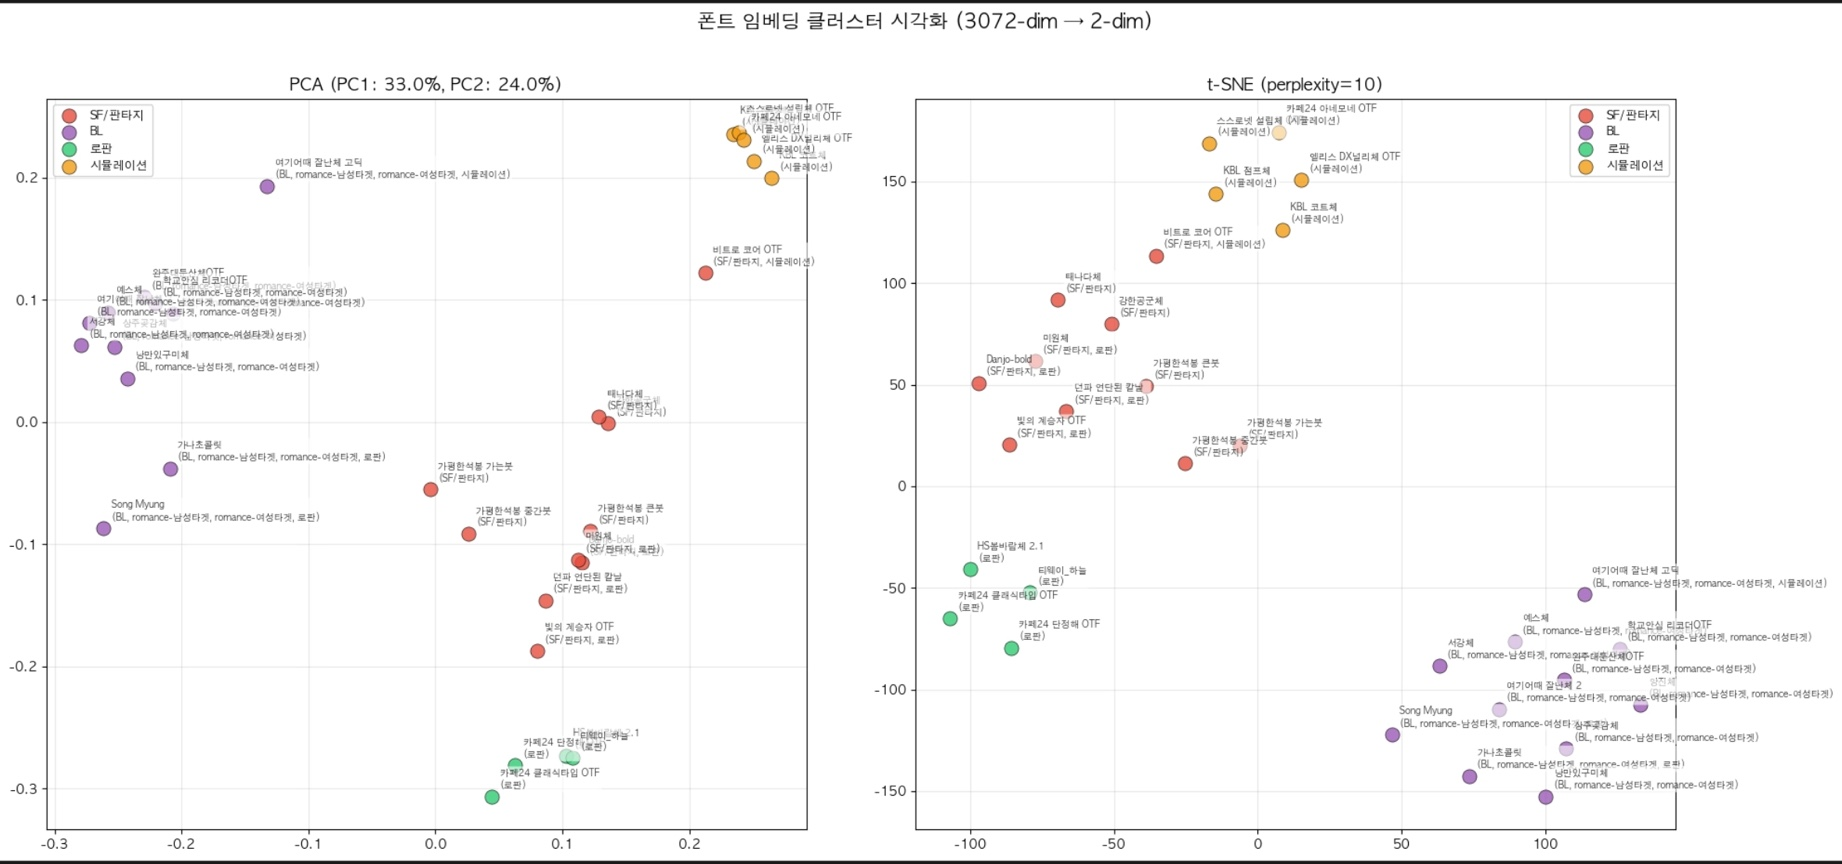
폰트 임베딩의 장르별 분포
임베딩을 보면 장르별로 폰트가 어느 정도 군집을 이뤘다. 같은 장르 안에서는 비슷한 폰트를 고를 수도 있겠다는 생각이 들었지만, 군집이 나뉘는 것과 실제 배너에서 잘 읽히는 것은 따로 봐야 했다. 플레이그라운드에서 기존 광고와 비교하고 정성적인 피드백을 반영하는 방향으로 고도화했다.
이미지 검색, 얼굴 검출, 폰트 선택은 각각 다른 모델의 결과지만 마지막에는 배너 한 장에서 만난다. 중간 점수가 좋아도 얼굴이 잘리거나 카피가 읽히지 않으면 쓸 수 없다. 그래서 개별 단계의 점수와 완성된 배너의 오류 사례를 함께 보면서 바꿔 나갔다.
본문의 데이터 흐름 애니메이션은 3Blue1Brown의 오픈소스 Manim에서 출발한 Manim Community로 만들었다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...