손 뼈 Semantic Segmentation: 분포 분석부터 고해상도 학습까지
손 X-ray의 29개 뼈 클래스를 분할하면서 회전 분포, 작은 뼈의 경계, 제한된 GPU 메모리를 문제로 정의했다. 데이터 전처리와 증강, 고해상도 학습, EMA·PointRend를 비교하고 효과가 있었던 방법을 다음 실험에 반영했다.
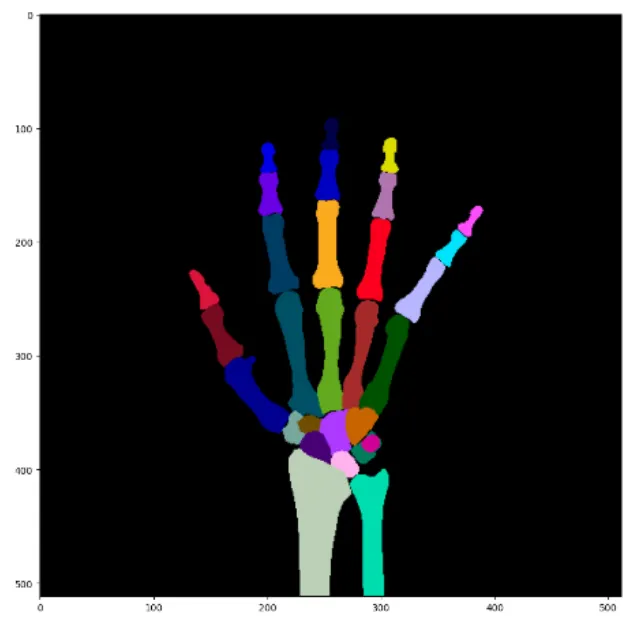
손 뼈 Segmentation에서는 큰 뼈를 대략 찾는 것보다 작은 뼈와 겹치는 경계를 정확하게 나누는 일이 어려웠다. 베이스라인의 Dice는 이미 약 0.94였지만, 클래스별 예측을 보면 작은 손목 뼈와 손가락 끝에서 개선할 부분이 보였다. 모델을 바꾸기 전에 데이터 분포와 입력 해상도, 경계 예측을 따로 확인하고 싶었다.
이 글은 부스트캠프 AI Tech 8기에서 진행한 팀 프로젝트 중 내가 다룬 EDA·전처리·증강과 모델링 실험을 중심으로 정리한 기록이다. 전체 실험과 팀의 모델 조합은 Weekly Review의 Wrap-up Report에 정리했다.
| 항목 | 내용 |
|---|---|
| 기간 | 2025.12.15–2026.01.07 |
| 과제 | 손 X-ray의 29개 뼈 클래스 Semantic Segmentation |
| 데이터 | 2048×2048 이미지 · 학습 800장 · 테스트 288장 |
| 내가 집중한 작업 | EDA·Feature Engineering·전처리·증강·모델링 및 비교 실험 |
| 실험 환경 | Tesla V100 32GB · PyTorch 계열 라이브러리 · W&B·Notion·GitHub |
회전 분포를 확인하고 검증 데이터를 나누기
이미지를 살펴보니 손이 곧게 놓인 경우와 기울어진 경우가 있었다. 회전 여부는 메타데이터에 없어서 새끼손가락 끝의 뼈 f-16과 손목 뼈 Ulna의 중심을 잇는 벡터로 각도를 구했다. 33°를 기준으로 나눠 분포를 비교했더니, 회전된 손의 비율이 테스트에서 학습 데이터보다 약 10배 높았다.
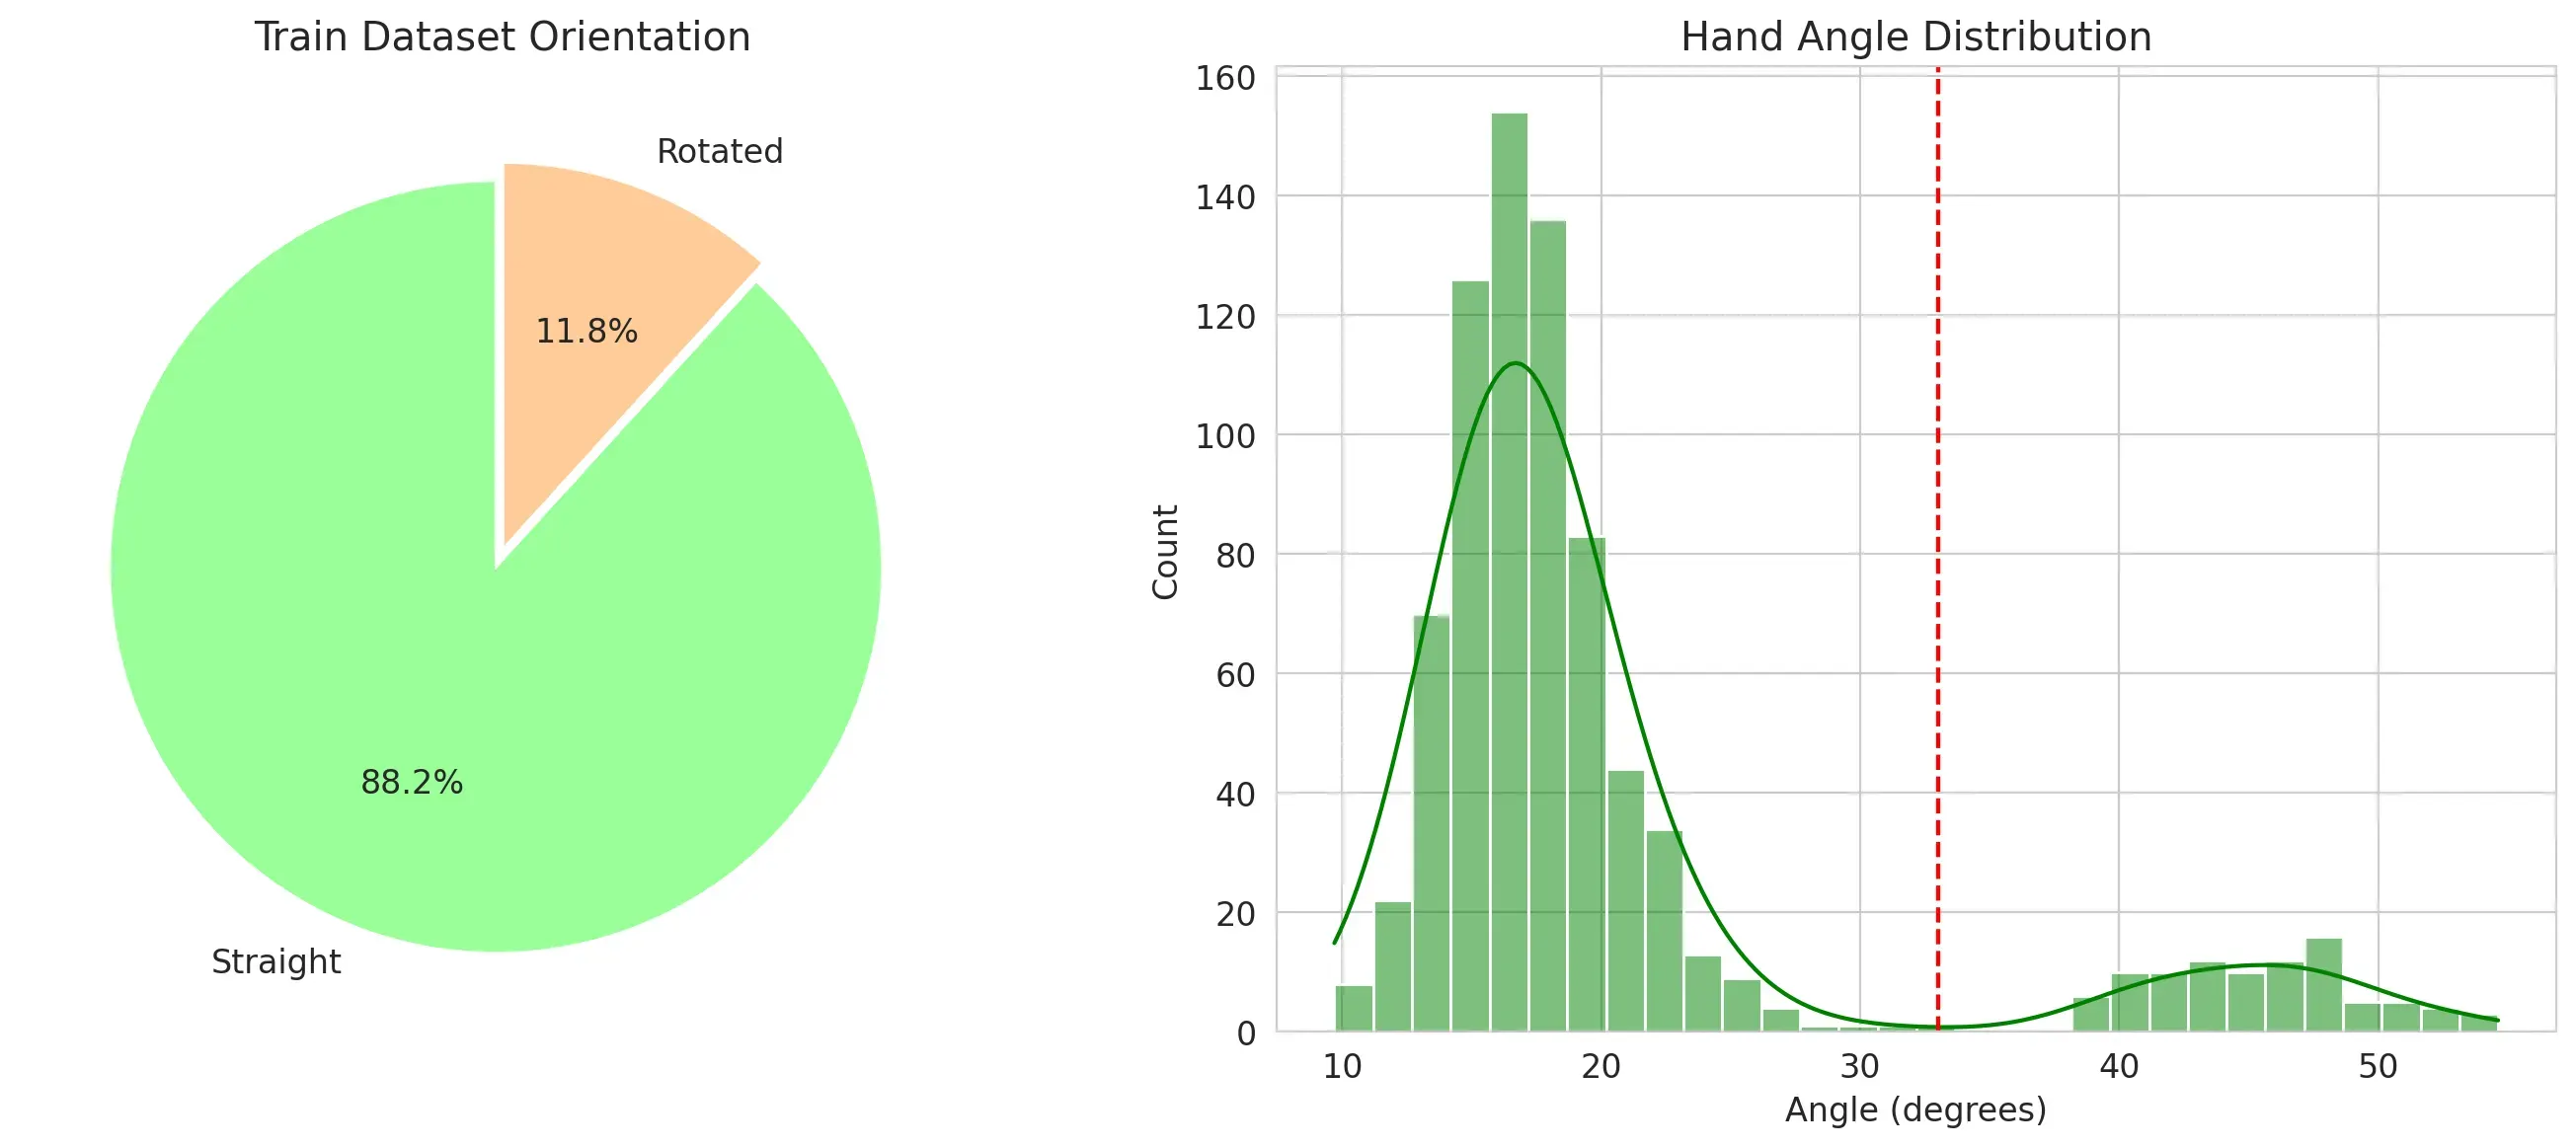
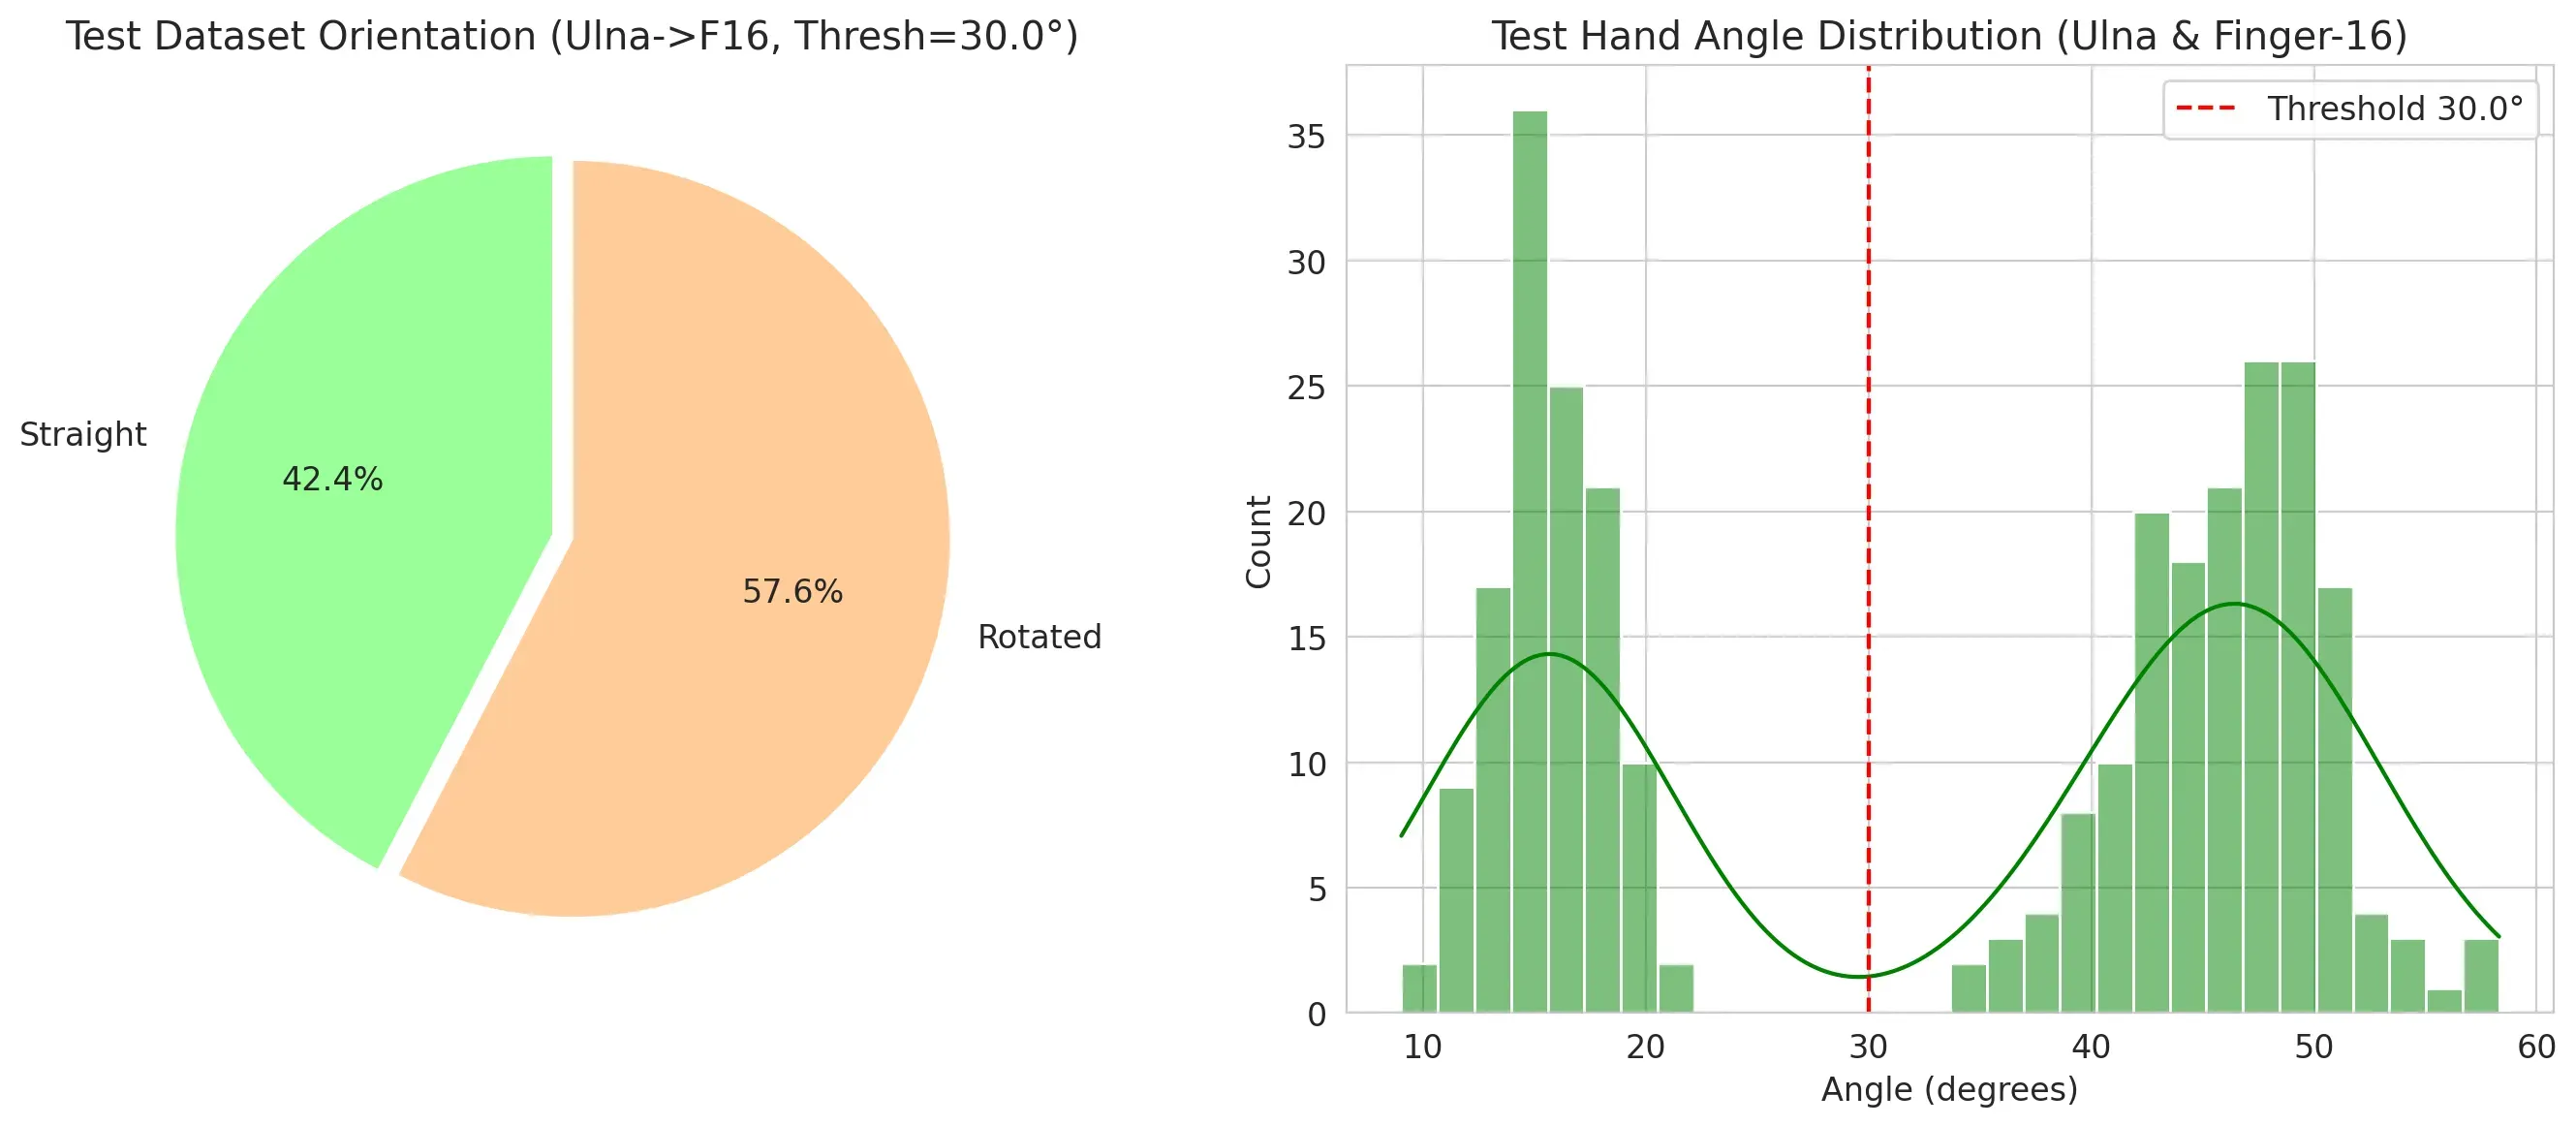
처음에는 이 차이를 오버샘플링으로 맞춰보려고 했다. 회전된 손과 남성 데이터를 더 뽑아 학습했지만, Public과 Validation의 점수 차이가 0.003에서 0.004로 커졌다. 비율을 맞췄다는 이유만으로 모델이 더 잘 일반화하지는 않았다. 이후 실험에서는 이 오버샘플링을 제외했다.
검증 데이터를 나눌 때는 환자 ID를 그룹으로 묶었다. 같은 사람의 양손이 학습과 검증에 나뉘면 서로 비슷한 구조를 보고 평가할 수 있기 때문이다. 성별과 키·몸무게의 관계도 확인했고, GroupRandomK-Fold에서 성별 비율이 크게 치우치지 않아 이 분할을 사용했다.
전처리와 증강은 한 가지씩 바꿔 비교했다
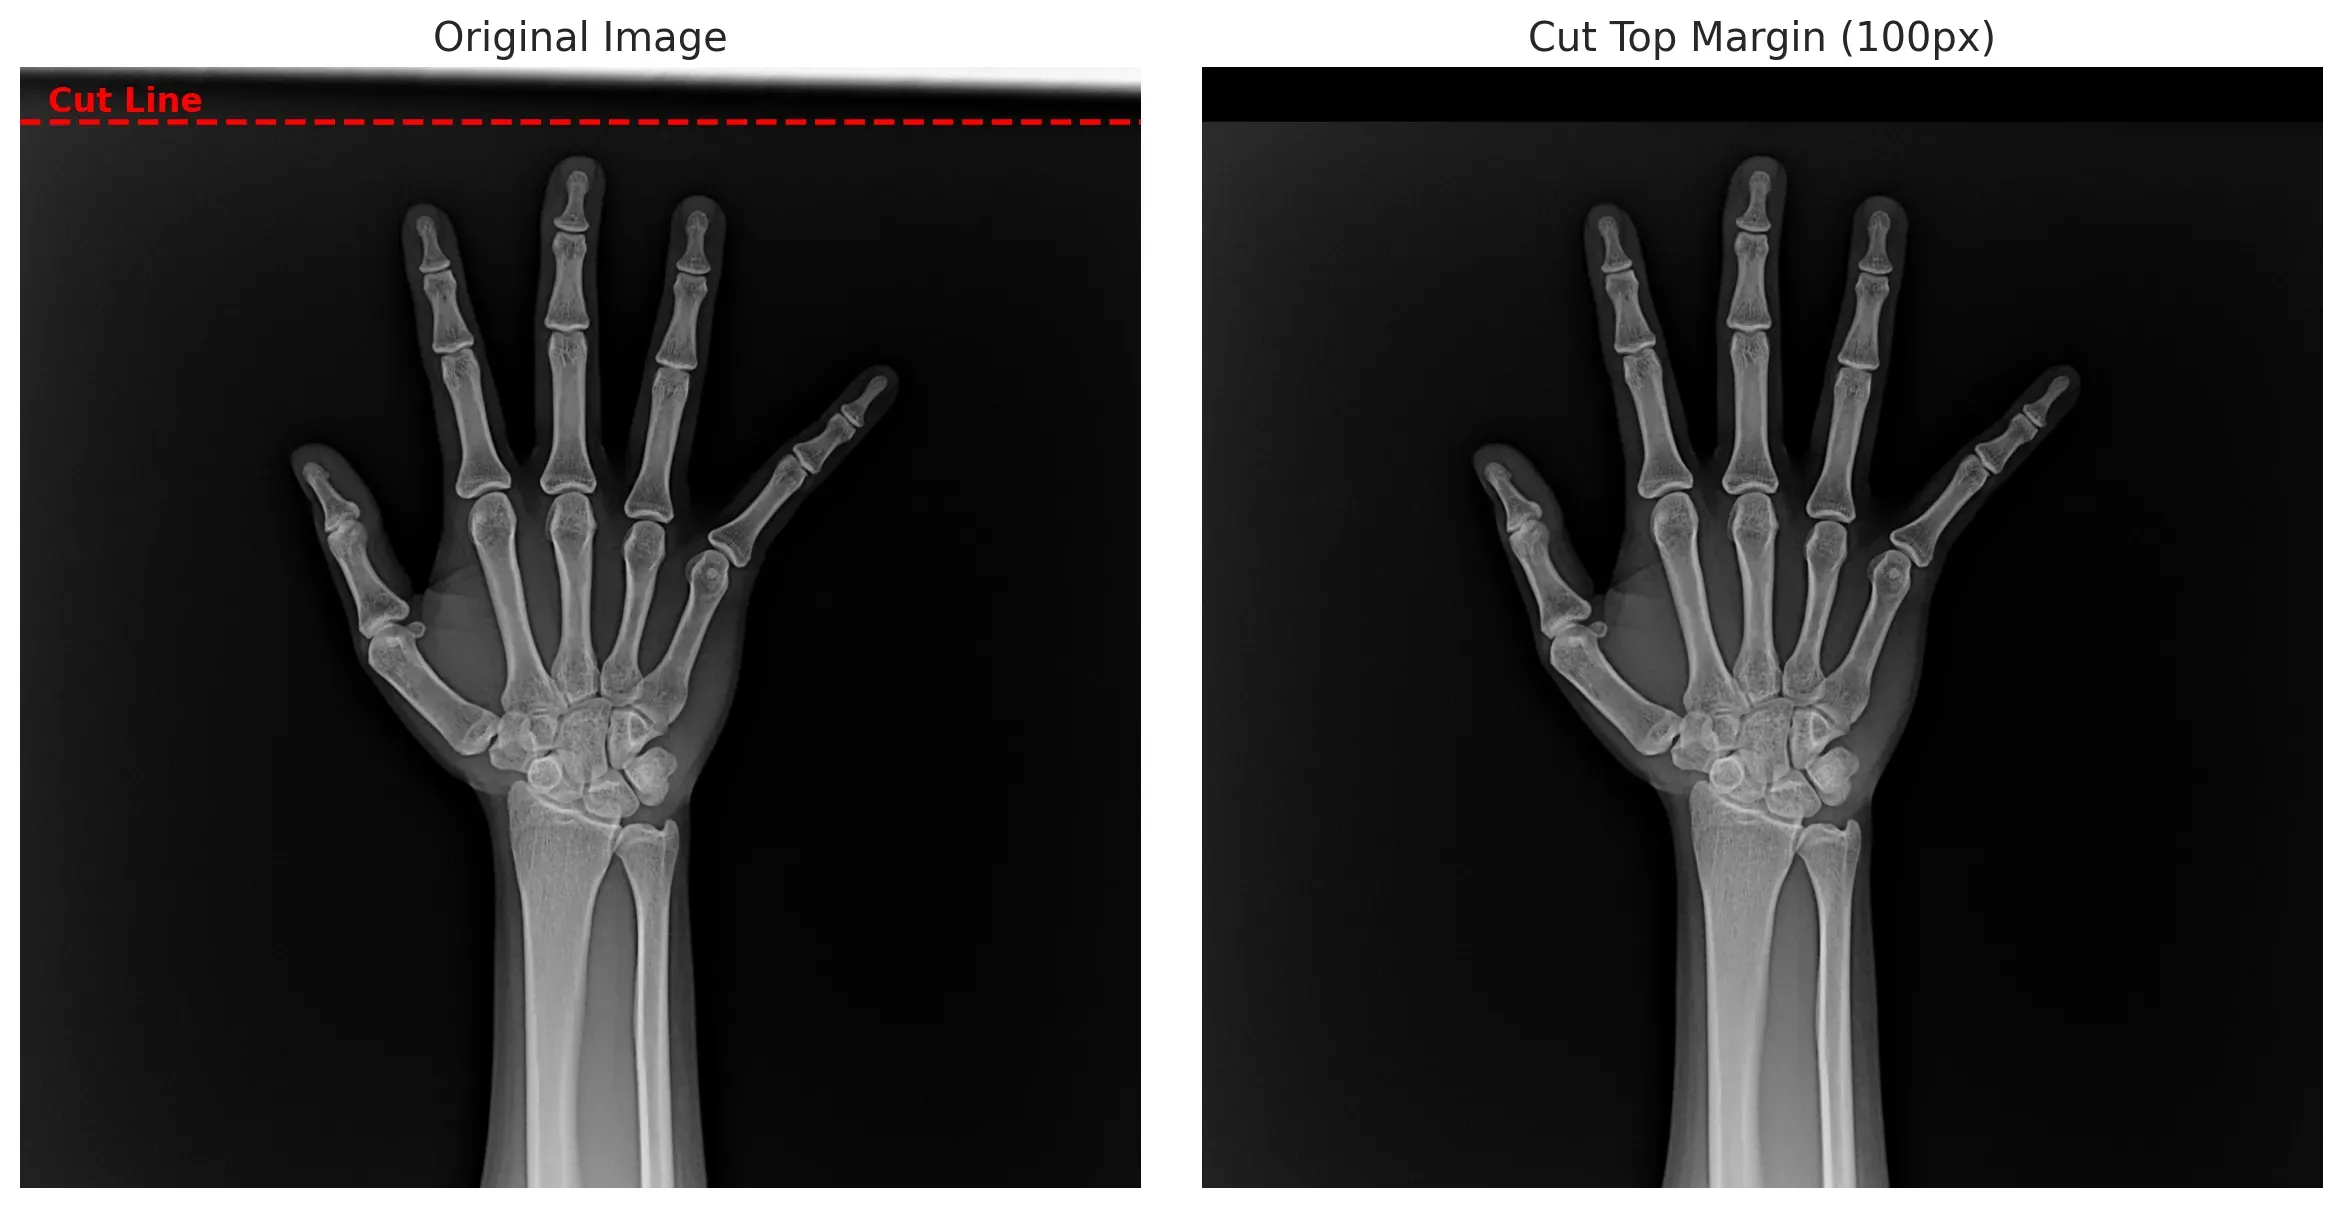
일부 이미지의 상단과 좌측에는 흰색 노이즈가 있었다. 해당 영역의 80픽셀을 제거하고 검은색으로 채우자 학습 초기 수렴이 빨라졌다. 배경 전체를 제거하는 방법도 시도했지만 추가적인 성능 향상은 확인하지 못했다.
밝은 픽셀이 많은 이미지를 이상치로 보고 제거한 실험에서는 오히려 점수가 약 0.001 떨어졌다. 반지나 네일아트가 있다는 이유만으로 학습에서 빼는 방식은 맞지 않았다. 이후에는 Dice가 낮은 예측을 시각화해 annotation이 뒤바뀐 사례와 보형물 사례를 확인했다. 이 사례들을 정리한 실험에서는 test score가 0.0009 높아졌다.
증강도 여러 방법을 한 번에 추가하지 않고 나머지 설정을 통제하면서 비교했다. W&B로 학습 곡선과 지표를 기록하고, 결과를 Notion에 남겨 팀원들과 공유했다.
| 증강 비교 실험 | Validation Dice |
|---|---|
| Baseline | 0.9546 |
| RandomBrightnessContrast | 0.9548 |
| ShiftScaleRotate | 0.9566 |
| GridDistortion | 0.9559 |
| GridDropout | 0.9537 |
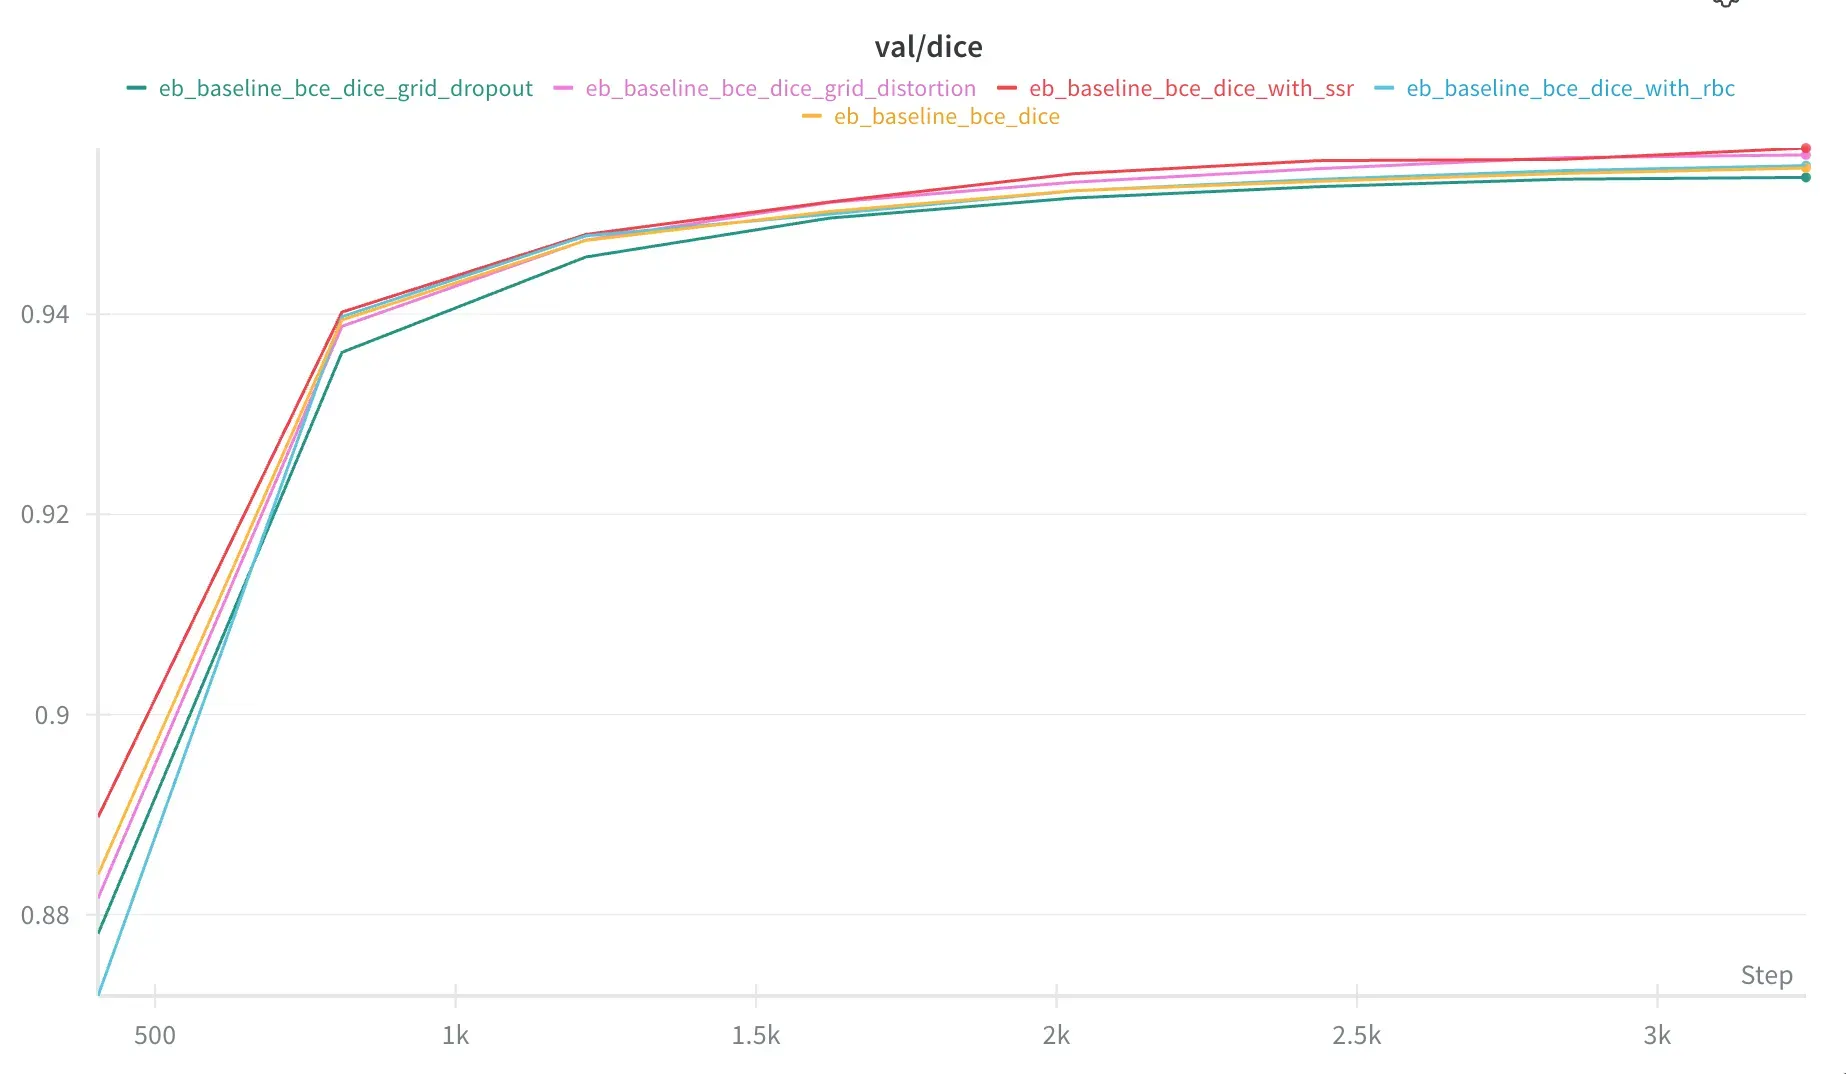
이 비교에서 가장 높은 점수를 낸 방법은 SSR이었다. 이동 범위 0.05, 스케일 범위 0.1, 회전 범위 15°로 작은 변화를 줬고, baseline 대비 Dice가 0.002 높아졌다. 그래서 후속 실험에 SSR을 적용했다. 의료 영상에 자주 쓰는 CLAHE도 비교했지만 일관된 개선은 확인하지 못했다.
분포를 관찰한 것과 그 분포를 보정한 방법이 효과가 있는지는 별도로 봐야 했다. 오버샘플링은 채택하지 않았고, 증강 비교에서는 실제로 성능이 높아진 방법을 남겼다.
해상도를 보존하려고 학습 방식을 바꿨다
2048px 원본을 512px로 줄이면 작은 뼈와 경계의 정보도 함께 줄어든다. 클래스별 Dice와 예측 이미지를 보고, 모델의 파라미터 수를 늘리는 것보다 입력 해상도를 유지하는 쪽을 먼저 실험했다.
해상도를 높일 때는 GPU 메모리가 제한이었다. AMP로 메모리 사용을 줄이고 배치 크기를 낮췄지만, 배치가 1인 환경에서는 Batch Norm을 쓰는 학습이 불안정했다. Group Norm으로 바꿔 작은 배치에서도 학습할 수 있게 하고, HRNet으로 고해상도 특징을 유지하는 조합을 비교했다.
| 모델링 비교 | 해상도 | Dice | 조건 |
|---|---|---|---|
| DeepLabV3+·ResNet50 baseline | 512px | 약 0.94 | 초기 baseline |
| HRNet W48 | 2048px | 0.9648 | 배치 1 · Batch Norm |
| HRNet W48 | 1536px | 0.9755 | 배치 1 · Group Norm |
해상도를 가장 크게 올린 설정이 가장 좋은 결과를 내지는 않았다. 입력 해상도와 작은 배치에서의 정규화 방식을 함께 봐야 했다. 0.9755는 OCR·HRNet의 fold 0 Validation Dice이고, 해당 단일 모델의 Private Dice는 0.9735였다. 모델링 비교와 최종 제출 점수를 같은 성과로 섞지 않았다.
경계 예측과 작은 배치의 학습 안정성 개선
예측 결과에서는 손등의 겹치는 뼈와 경계가 특히 어려웠다. 손등의 Hard Example을 더 다루려고 학습을 두 단계로 나누고, 후반 파인튜닝에서 BCE·Dice 중심의 손실을 BCE·Lovasz 조합으로 바꾸는 실험을 했다.
경계 예측에는 PointRend를 적용했고, 작은 배치에서의 가중치 변동을 줄이기 위해 EMA를 사용했다. 두 방법을 적용한 실험에서는 Public Dice가 0.9697에서 0.9728로 0.0031 상승했다. 이 값은 두 방법을 적용한 조합의 결과이며, 각각의 기여를 따로 더한 수치가 아니다.
Public과 Validation 점수의 차이도 확인했다. 학습률 재시작이 도움이 될 것이라는 가설로 CosineRestartWarmupScheduler를 비교했고, 적용 후 두 점수의 차이는 0.0028이었다. 이 차이가 줄었다는 관찰만으로 수렴 위치나 과적합 원인을 확정하지는 않았다.
개인 실험 결과와 팀 최종 결과
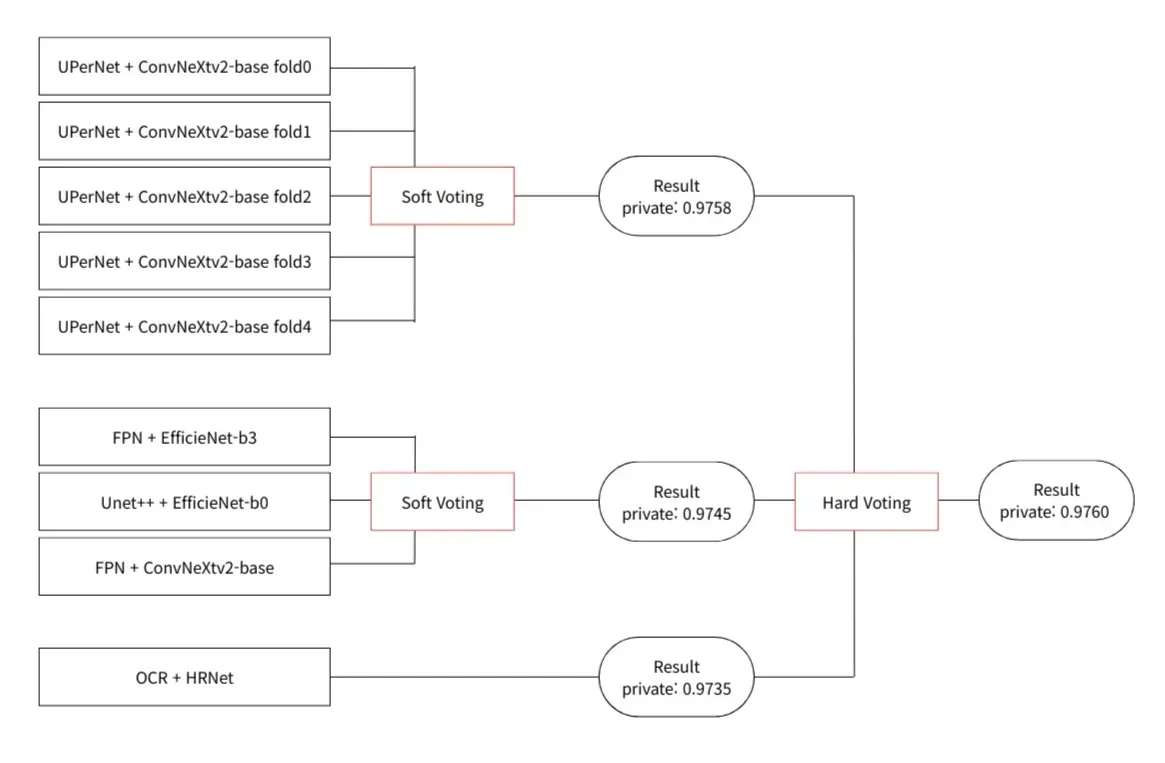
모델별 Validation 점수만 높다고 제출 성능도 높은 것은 아니었다. 서로 다른 fold의 모델을 섞은 앙상블은 Private Dice 0.9624로 떨어졌고, 팀은 다른 조합도 비교했다. 최종적으로 세 예측 결과를 Hard Voting한 제출의 성능이 가장 높았다.
| 확인한 결과 | 지표 | 값 |
|---|---|---|
| SSR 증강 비교 | Validation Dice | 0.9546 → 0.9566 |
| EMA·PointRend 적용 | Public Dice | 0.9697 → 0.9728 |
| OCR·HRNet fold 0 | Validation Dice | 0.9755 |
| OCR·HRNet 단일 모델 | Private Dice | 0.9735 |
| 팀 최종 제출 | Public Dice | 0.9749 |
| 팀 최종 제출 | Private Dice | 0.9760 |
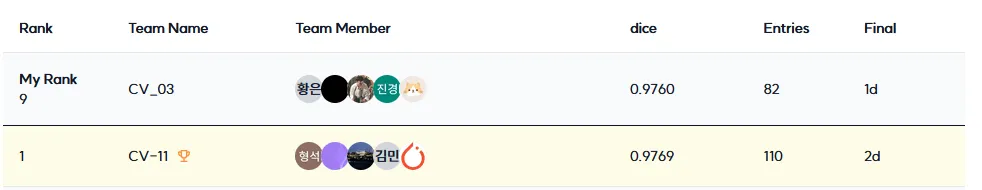
각 행은 서로 다른 실험과 평가 조건이다. 증강·모델링·앙상블의 개선 폭을 모두 더한 결과로 읽으면 안 된다. 내가 집중한 부분은 데이터 분포를 확인하고, 전처리·증강·학습 설정을 바꿔가며 효과를 비교하는 일이었다. 최종 제출 점수는 팀의 모델 탐색과 앙상블을 합친 결과다.
이 프로젝트에서 남긴 기준은 분명했다. 이상치처럼 보이는 이미지를 제거하거나 일반적으로 좋은 증강을 추가하기 전에, 같은 조건에서 실제로 무엇이 달라지는지 확인해야 했다. 잘되지 않은 오버샘플링과 CLAHE 실험도 다음 선택의 근거가 됐다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...