Week13-15_HandBone X-Ray Image Semantic Segmentation Project
WrapupReport
1. 프로젝트 개요
1.1 프로젝트 주제
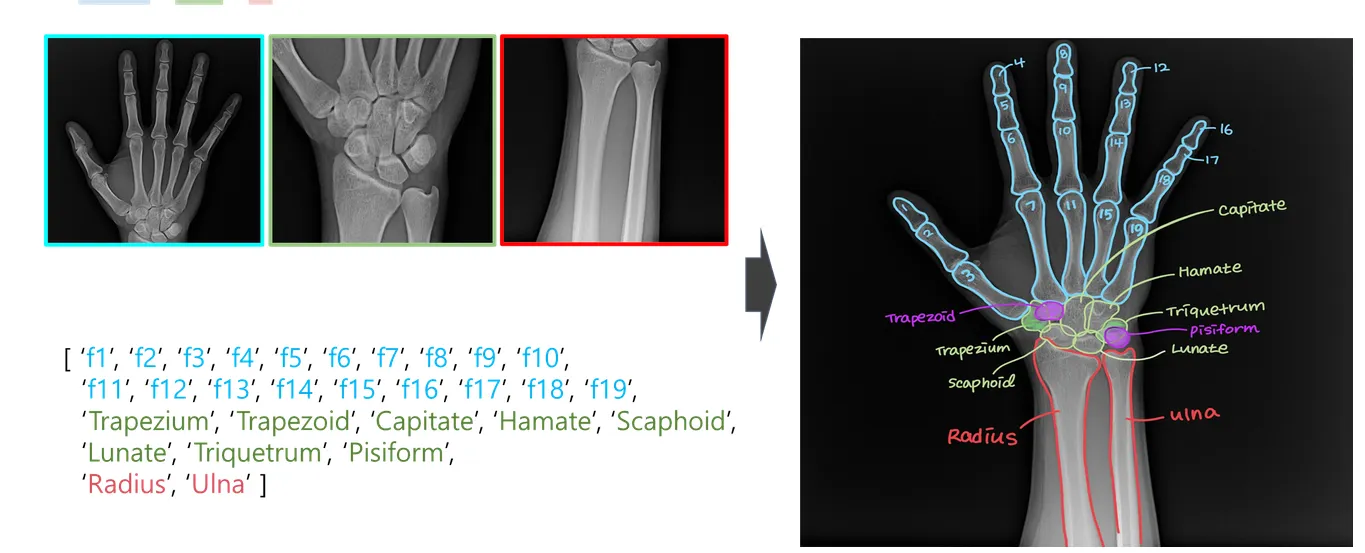
hand bone x-ray 객체가 담긴 이미지, Segmentation Annotation 정보가 담긴 json파일을 Input으로 이용해서 모델은 각 클래스(29개)에 대한 확률 맵을 갖는 멀티채널 예측을 수행하고, 이를 기반으로 각 픽셀을 해당 클래스에 할당하는 Segmentation 모델을 개발
1.2 프로젝트 목표 및 범위
본 프로젝트의 핵심 목표는 2048x2048의 고해상도 X-ray 이미지를 입력받아 각 픽셀이 29개의 뼈 클래스 중 어디에 속하는지를 예측하는 Semantic Segmentation 모델을 개발하는 것이다. 이를 위해 다음과 같은 세부 목표를 수립하였다.
- 데이터 중심의 성능 향상: EDA를 통해 데이터셋의 내재적 분포와 편향을 파악하고, Preprocessing 및 Augmentation 기법을 통해 학습 데이터와 테스트 데이터 간의 분포 격차를 최소화한다.
- 최적의 모델 아키텍처 탐색: U-Net, FPN, DeepLabV3+ 등 기존의 세그멘테이션 모델뿐만 아니라, HRNet, SegFormer, ConvNeXt와 같은 최신 SOTA모델들을 실험하여 모델을 탐색한다.
- 뼈 사이 경계 복원: 뼈와 뼈 사이의 미세한 경계면을 정확히 구분하기 위해 PointRend, Lovasz Loss 등의 기법을 적용하여 Pixel-level의 Dice를 극대화한다.
- 안정적인 학습 및 일반화: EMA(Exponential Moving Average), Group K-Fold, CosineWarmUpRestartScheduler등의 전략을 통해 학습의 안정성을 확보하고 Overfitting을 방지한다.
1.3 개발환경
H/W: Tesla V100 32GB GPU 서버 3대
S/W: SMP, TorchVision, mmsegmentation, monai
실험관리: WandB, Notion, Github
1.4 데이터셋
1.4.1 이미지
- 이미지 크기 : (2048 x 2048)
| Images | Label | |
|---|---|---|
| Train | 800 | O |
| Test | 288 | X |
원본 이미지
Annotation을 시각화한 이미지
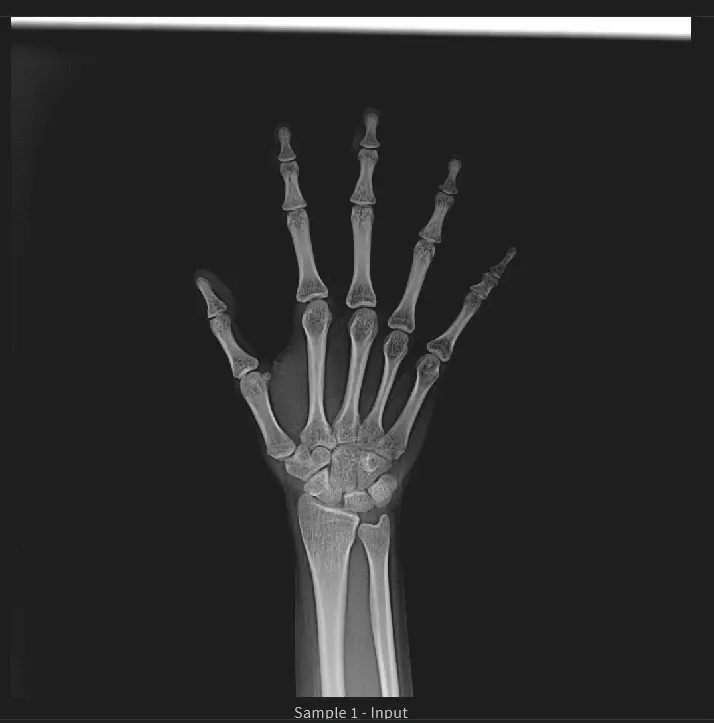
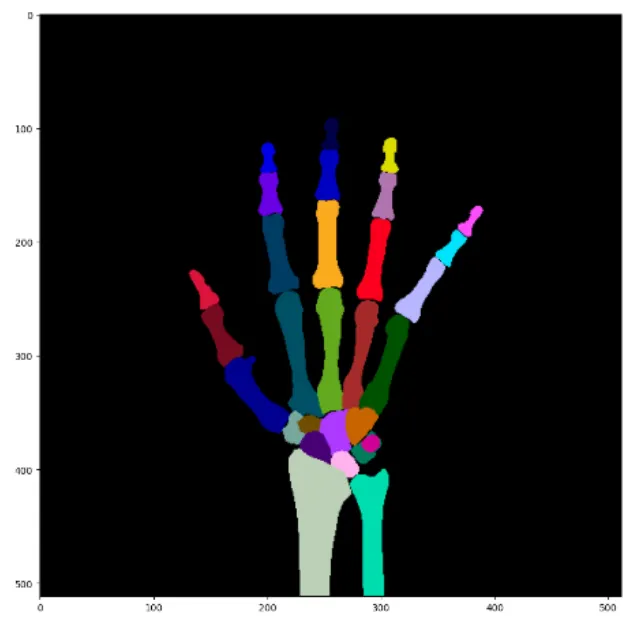
- HandBone X-ray Image가 원본이미지로 주어지고 각 뼈 클래스(29개)에 대한 Annotation이 Json파일형태로 주어진다.
- 양손을 촬영했기 때문에 사람 별로 두 장의 이미지가 존재한다.
1.4.2 메타데이터
환자 ID별로 성별, 나이, 키, 몸무게가 엑셀파일로 주어졌다. 성별의 경우 남, 여로 표준화되어 구분되어있지 않고, 노이즈가 포함된 데이터가 있었다. 메타데이터를 활용하기 위해서 표준화하는 과정을 추가로 진행했다.
2. 프로젝트 팀 구성 및 역할
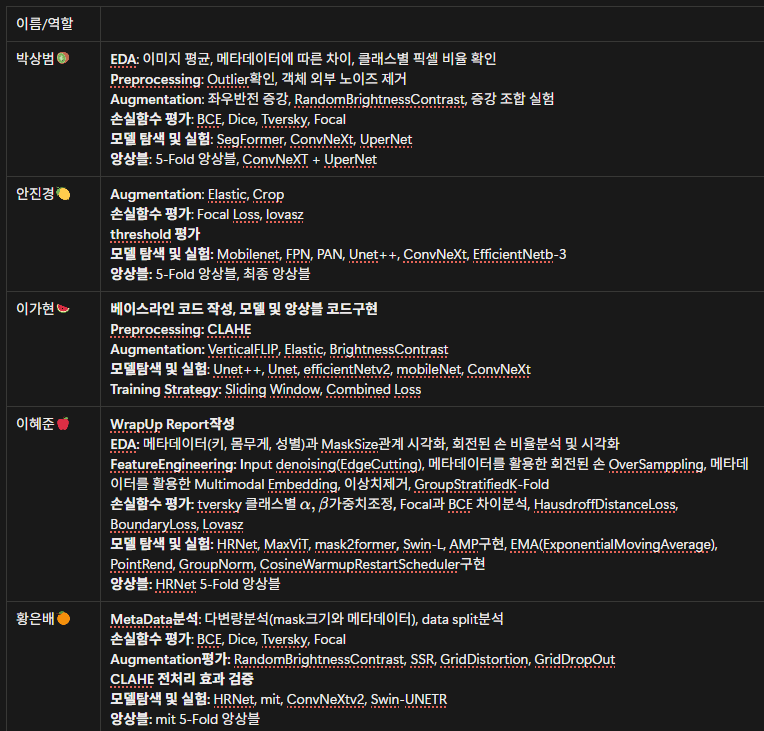
3. 프로젝트 수행 절차 및 방법
3.1 EDA & FeatureEngineering
3.1.1 회전여부 분포 불일치 문제
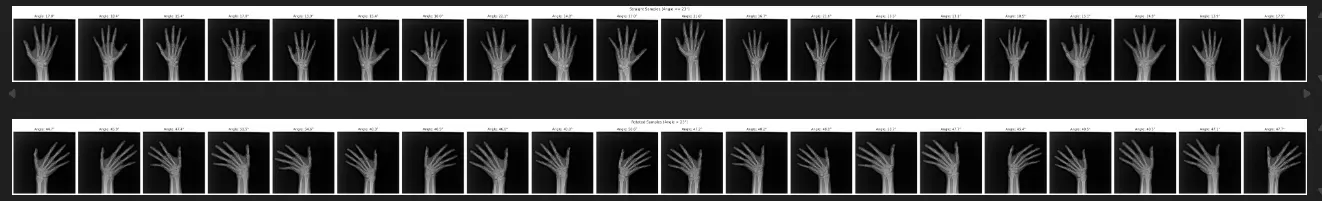
회전되지 않은 손(위), 회전된손(아래)
X-ray 이미지상의 손은 일직선상을 향하고있는 손과, 회전된 손으로 나뉘어져 있음을 확인했다. 그런데, Train과 Test set의 회전여부를 시각화해본 결과 회전여부의 분포가 불일치함을 발견했다. 손의 회전여부는 메타데이터로 주어지지 않았으므로 새끼손가락 끝의 뼈(f-16) 와 새끼손가락과 가까이 있는 손목뼈의 중심(Ulna)의 벡터를 구해서 33도이상 휘어있다면 손이 rotate돼있다고 판단했다.
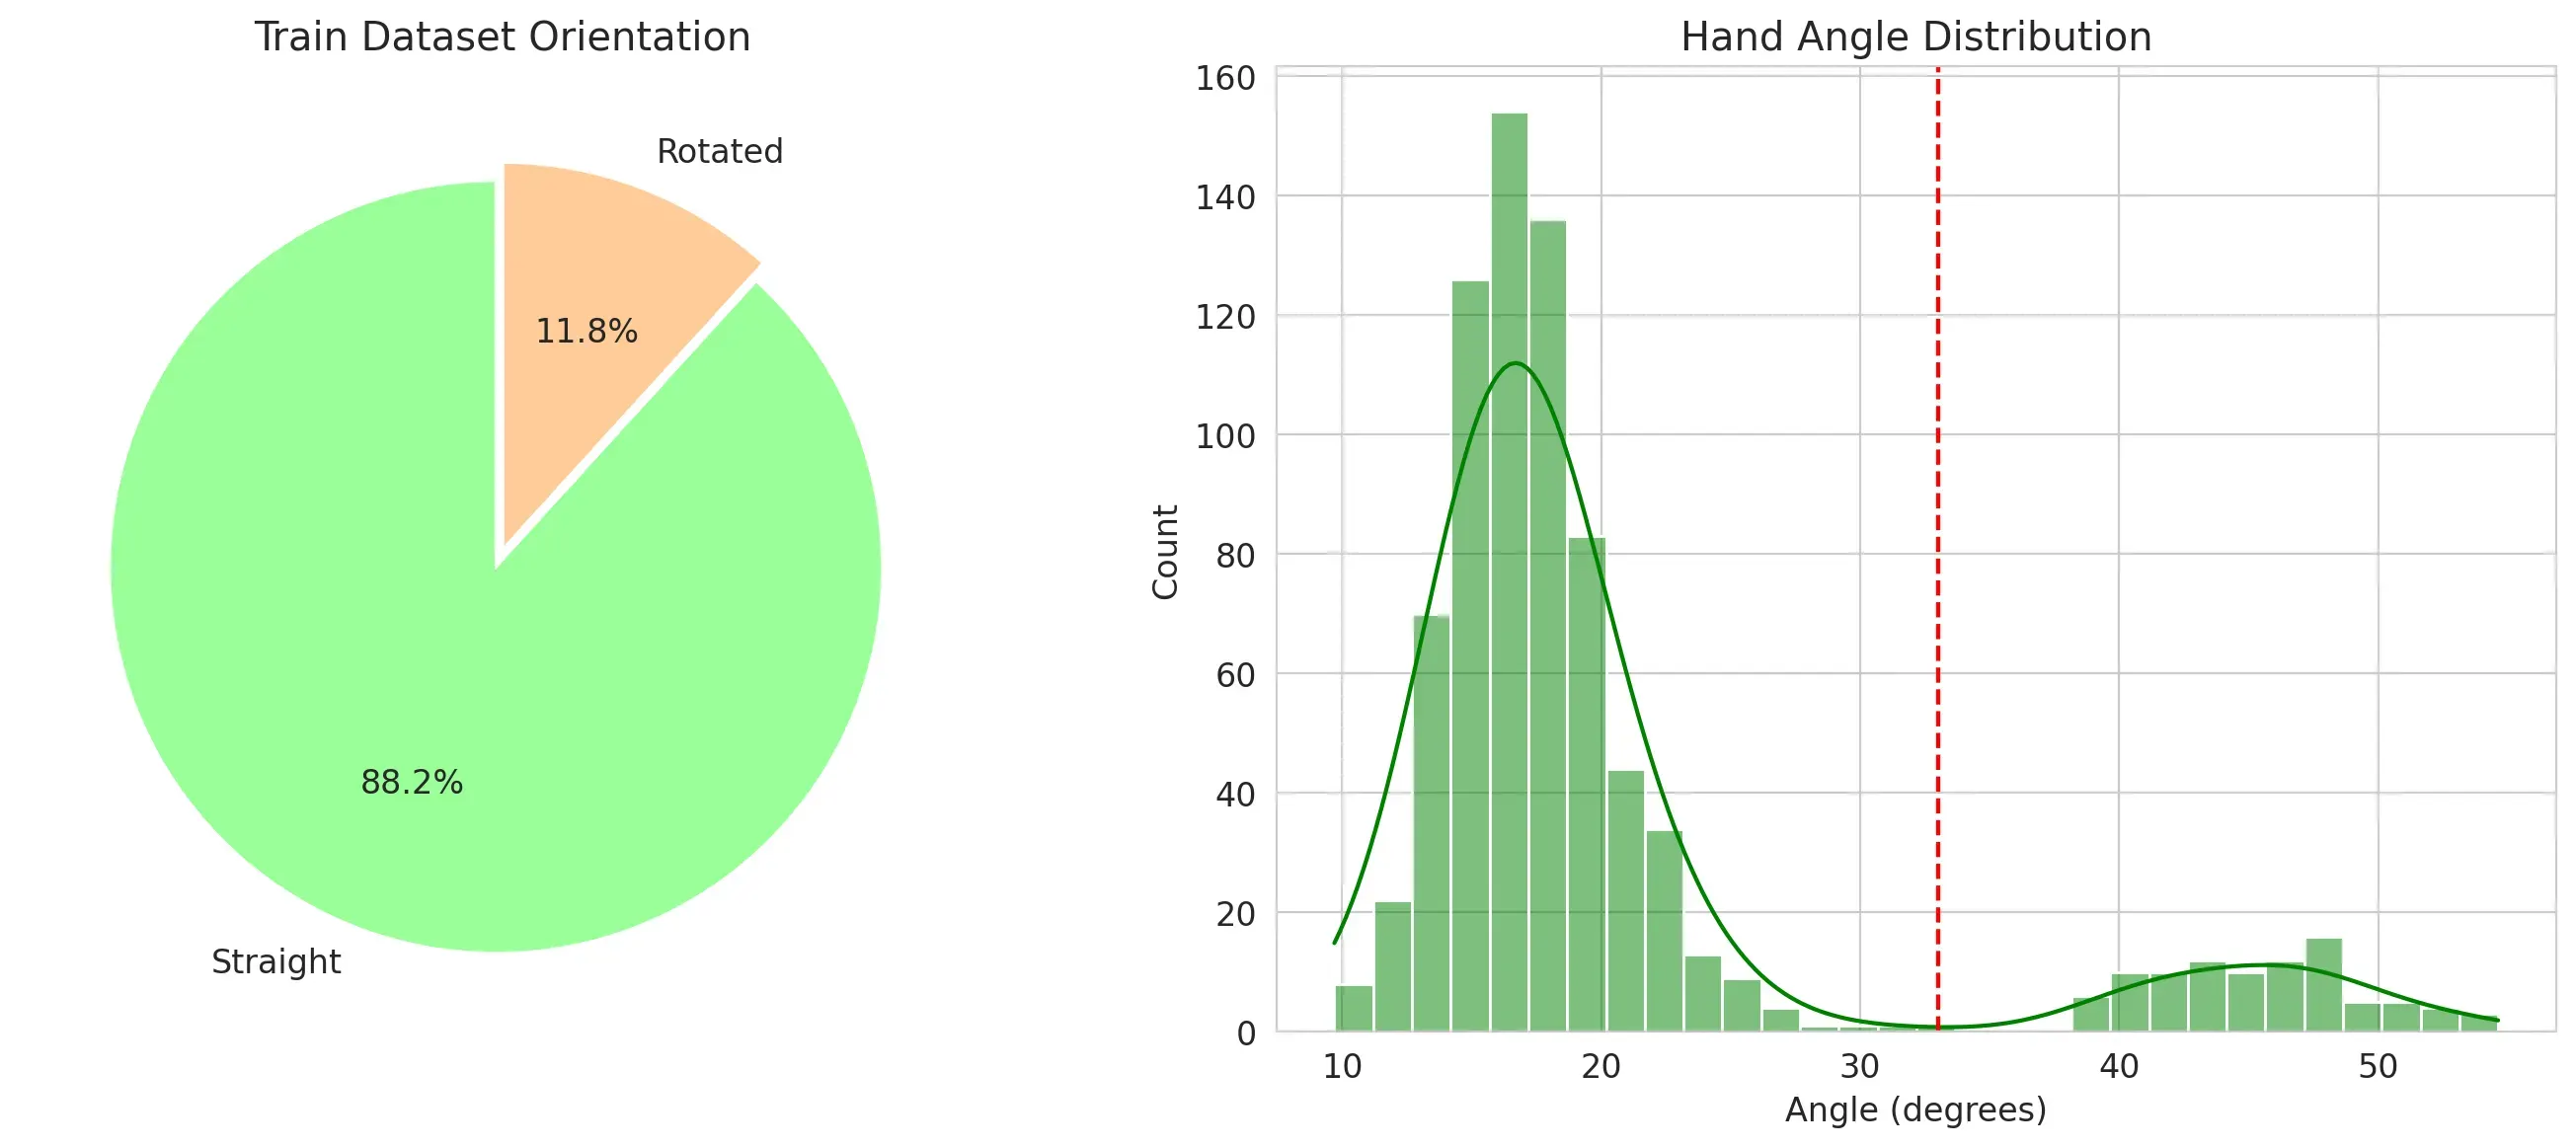
Train Dataset의 손의 회전 각도 분포
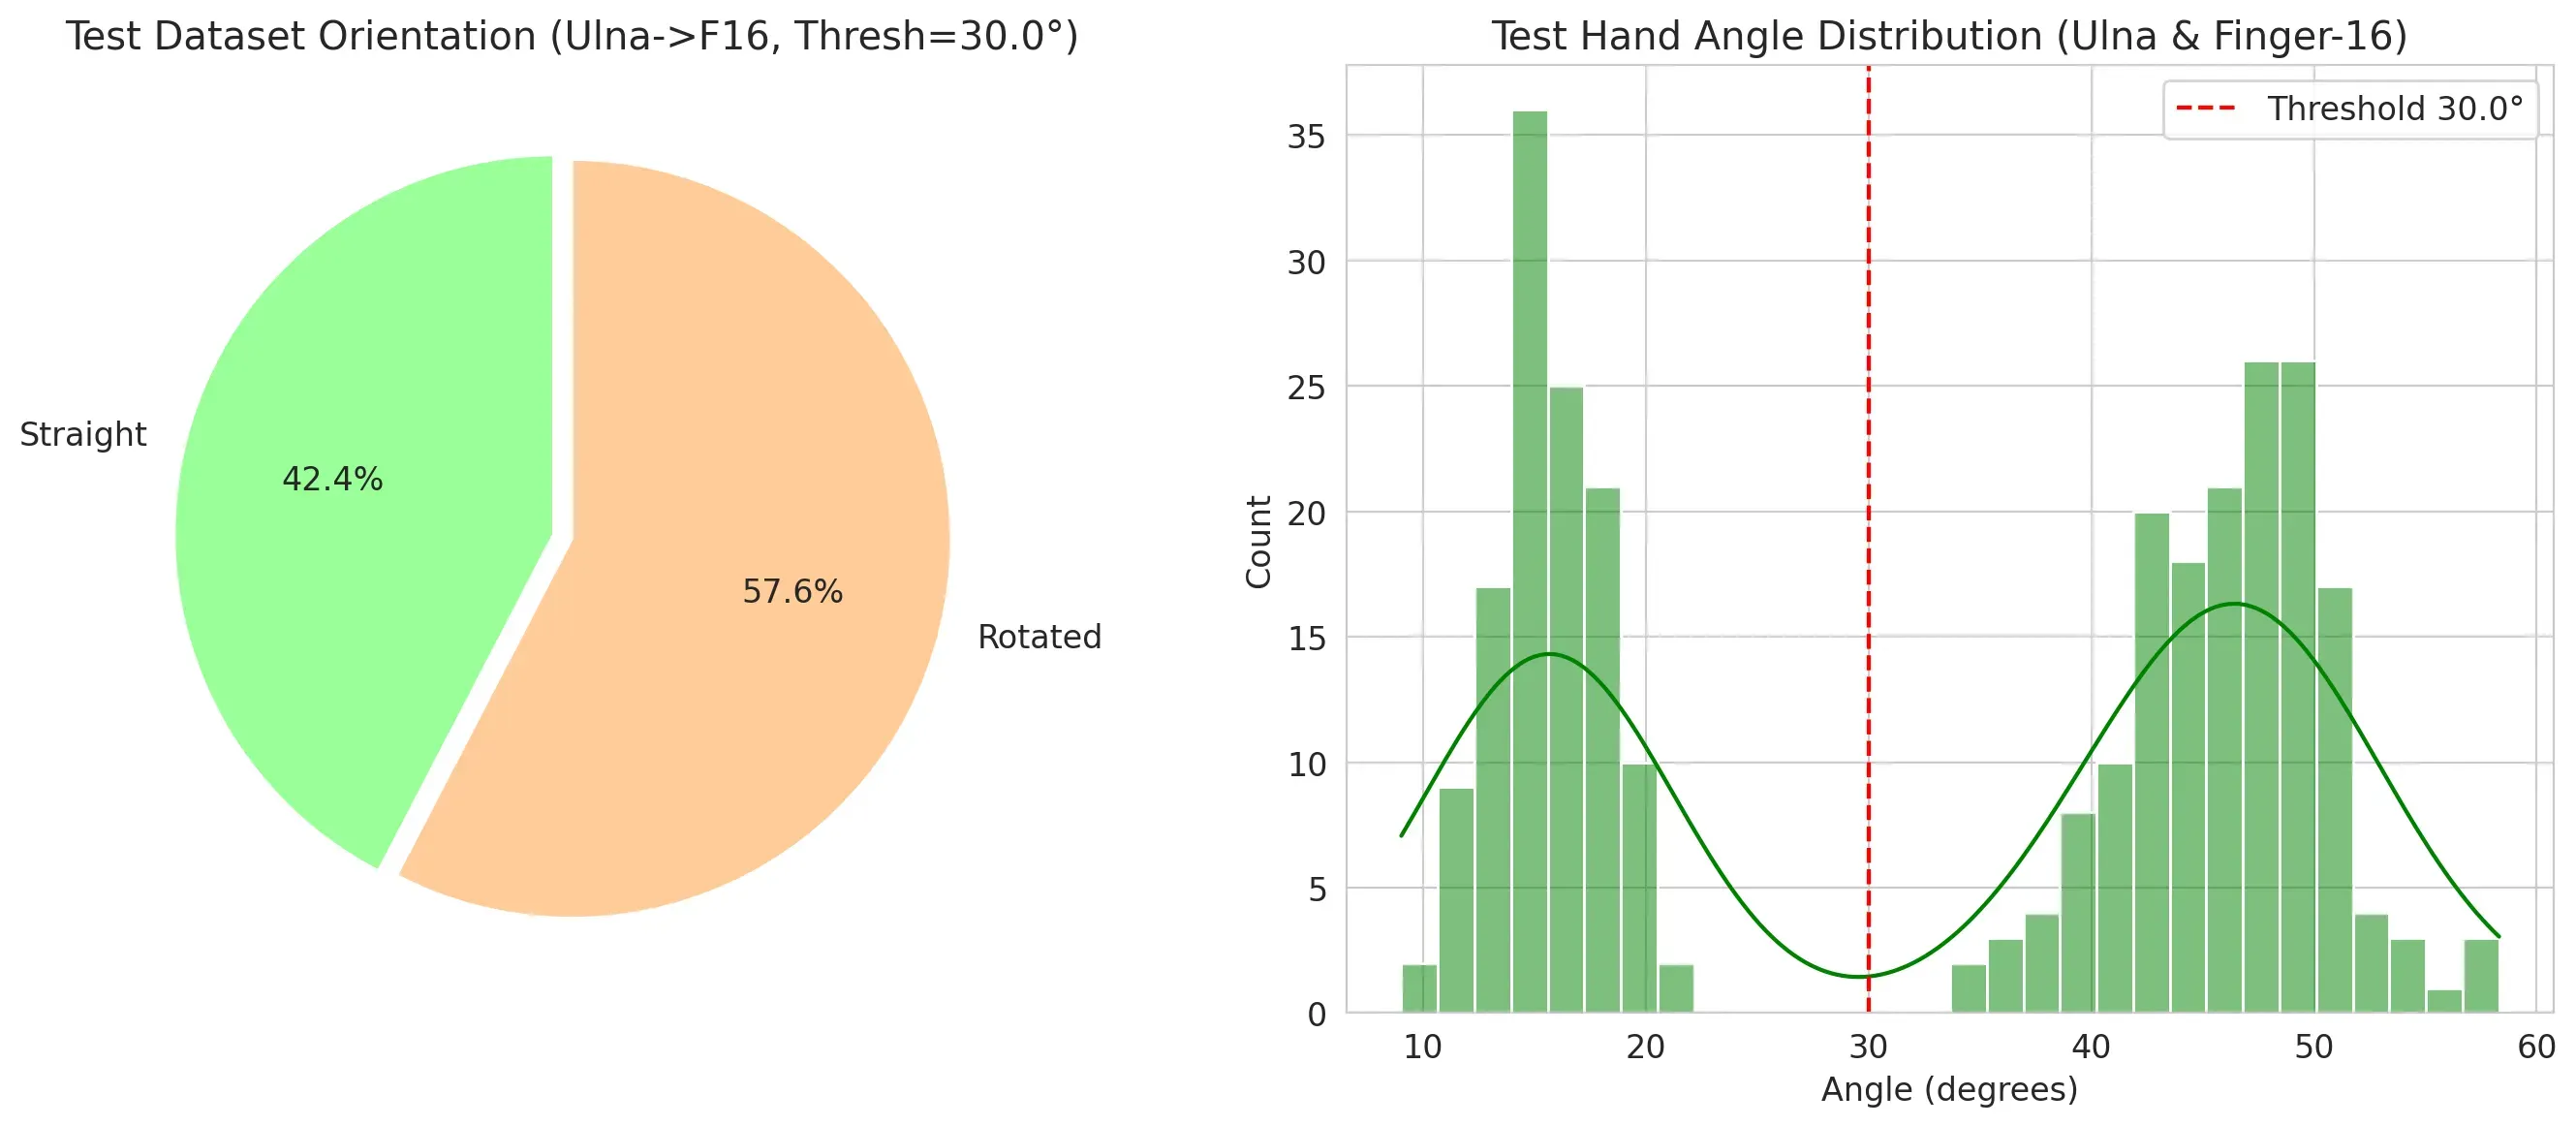
Test Dataset의 손의 회전 각도 분포
Train Dataset과 Test Dataset의 회전 각도 분포를 시각화 해본 결과 임계값을 기준으로, 회전된 손과 회전되지 않은 손으로 나뉘고 있음을 확인했다. 하지만, 회전된 손과 회전되지 않은 손의 비율이 Test Dataset에서 Train Dataset보다 약 10배 많음을 확인했다.
3.1.2 성별 분포 불일치 문제
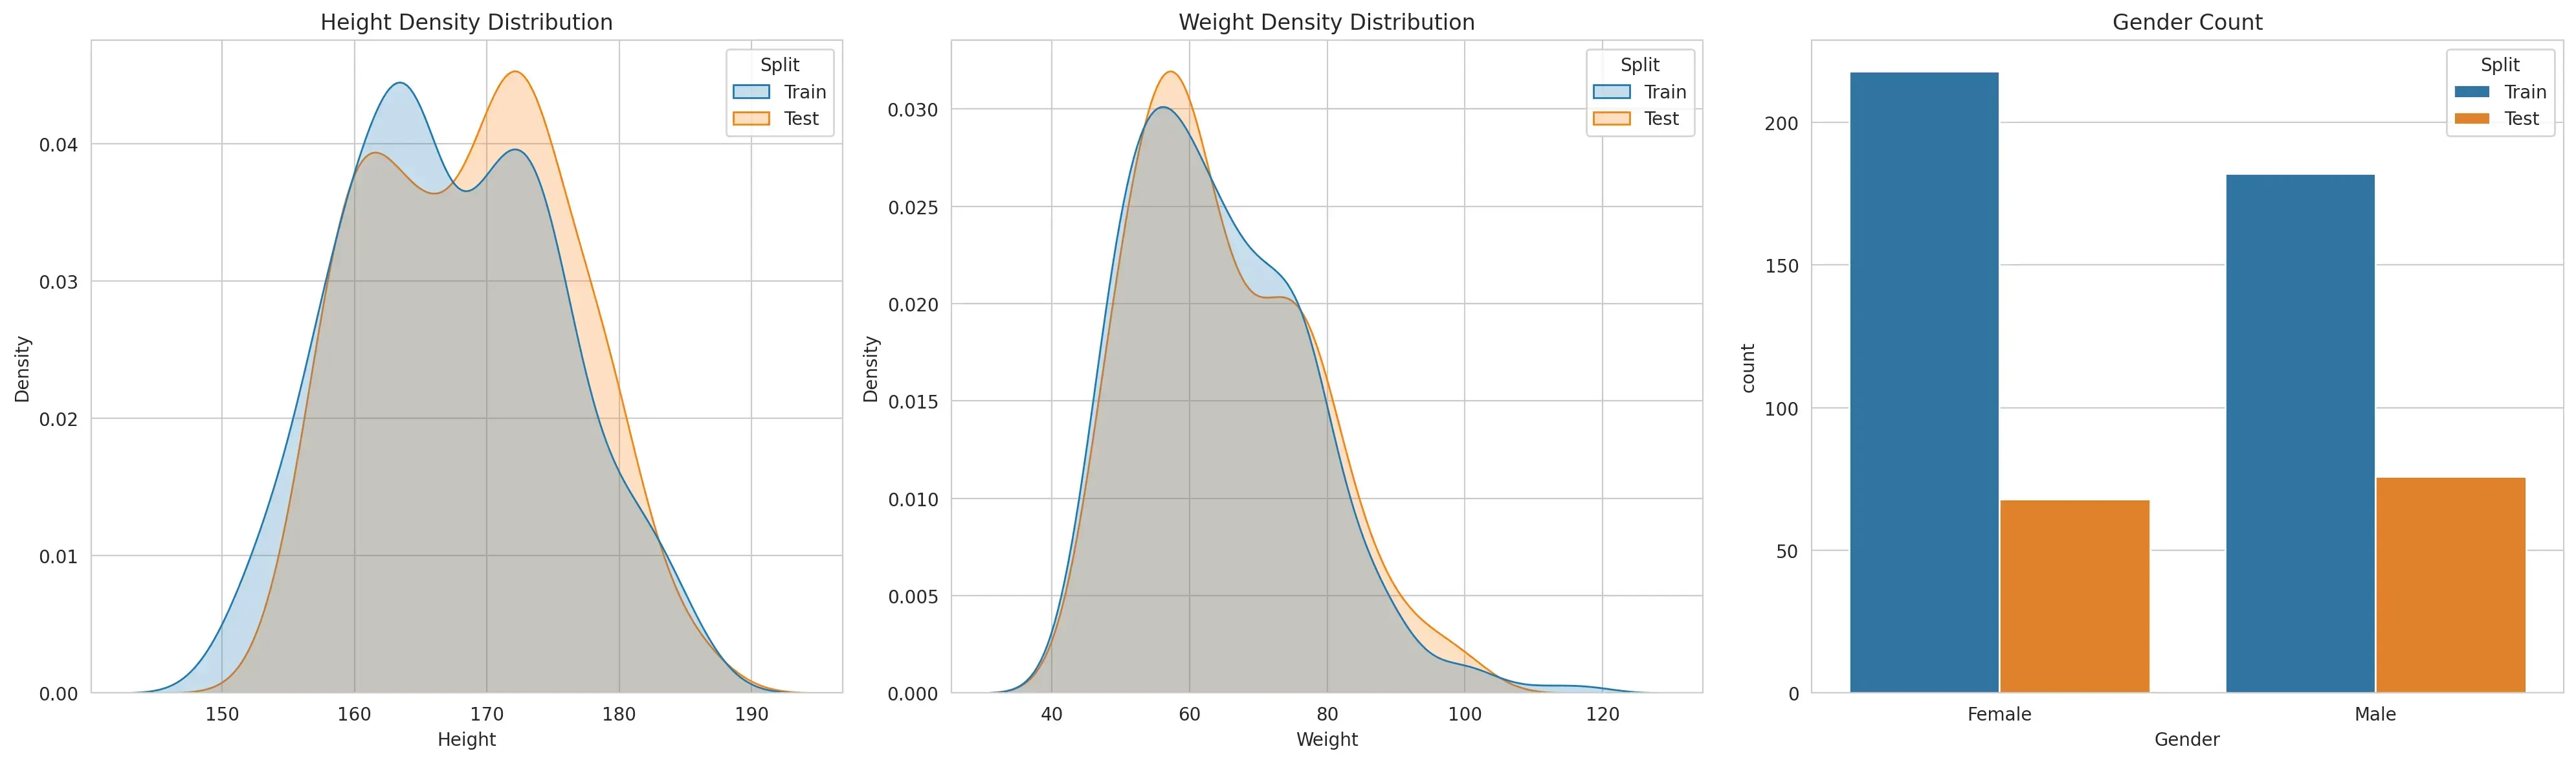
Train: 파란색, Test: 주황색
Train Dataset과 Test Dataset간의 성별분포도 일부 불일치함을 확인했다. 확인 결과 Test dataset이 Train dataset보다 남성이 1.34배 많았다.
3.1.3 분포 불일치 해결
Train과 Test Dataset의 분포가 다르다면 Validartion Score와 Public Score간의 차이가 발생한다. 따라서 분포 불일치를 해결하기 위해 Train Dataset에서 오버샘플링을 진행하는 실험을 진행했다.
환자의 ID를 Group으로 하고, 성별과 손의 회전여부를 기준으로 5-Fold로 GroupStratifiedK-Fold를 적용한 후 회전된 손 10배 오버샘플링, 남성 1.34배 오버샘플링을 진행한 결과 Public과 valid score차이가 0.004로 baseline의 0.003에 비해 소폭 상승하는것을 확인했다.
분포 불일치를 해결하기 위해 진행한 오버샘플링이 오히려 Overfitting을 야기하는것으로 생각하고, 오버샘플링은 이후실험에서 진행하지 않았다.
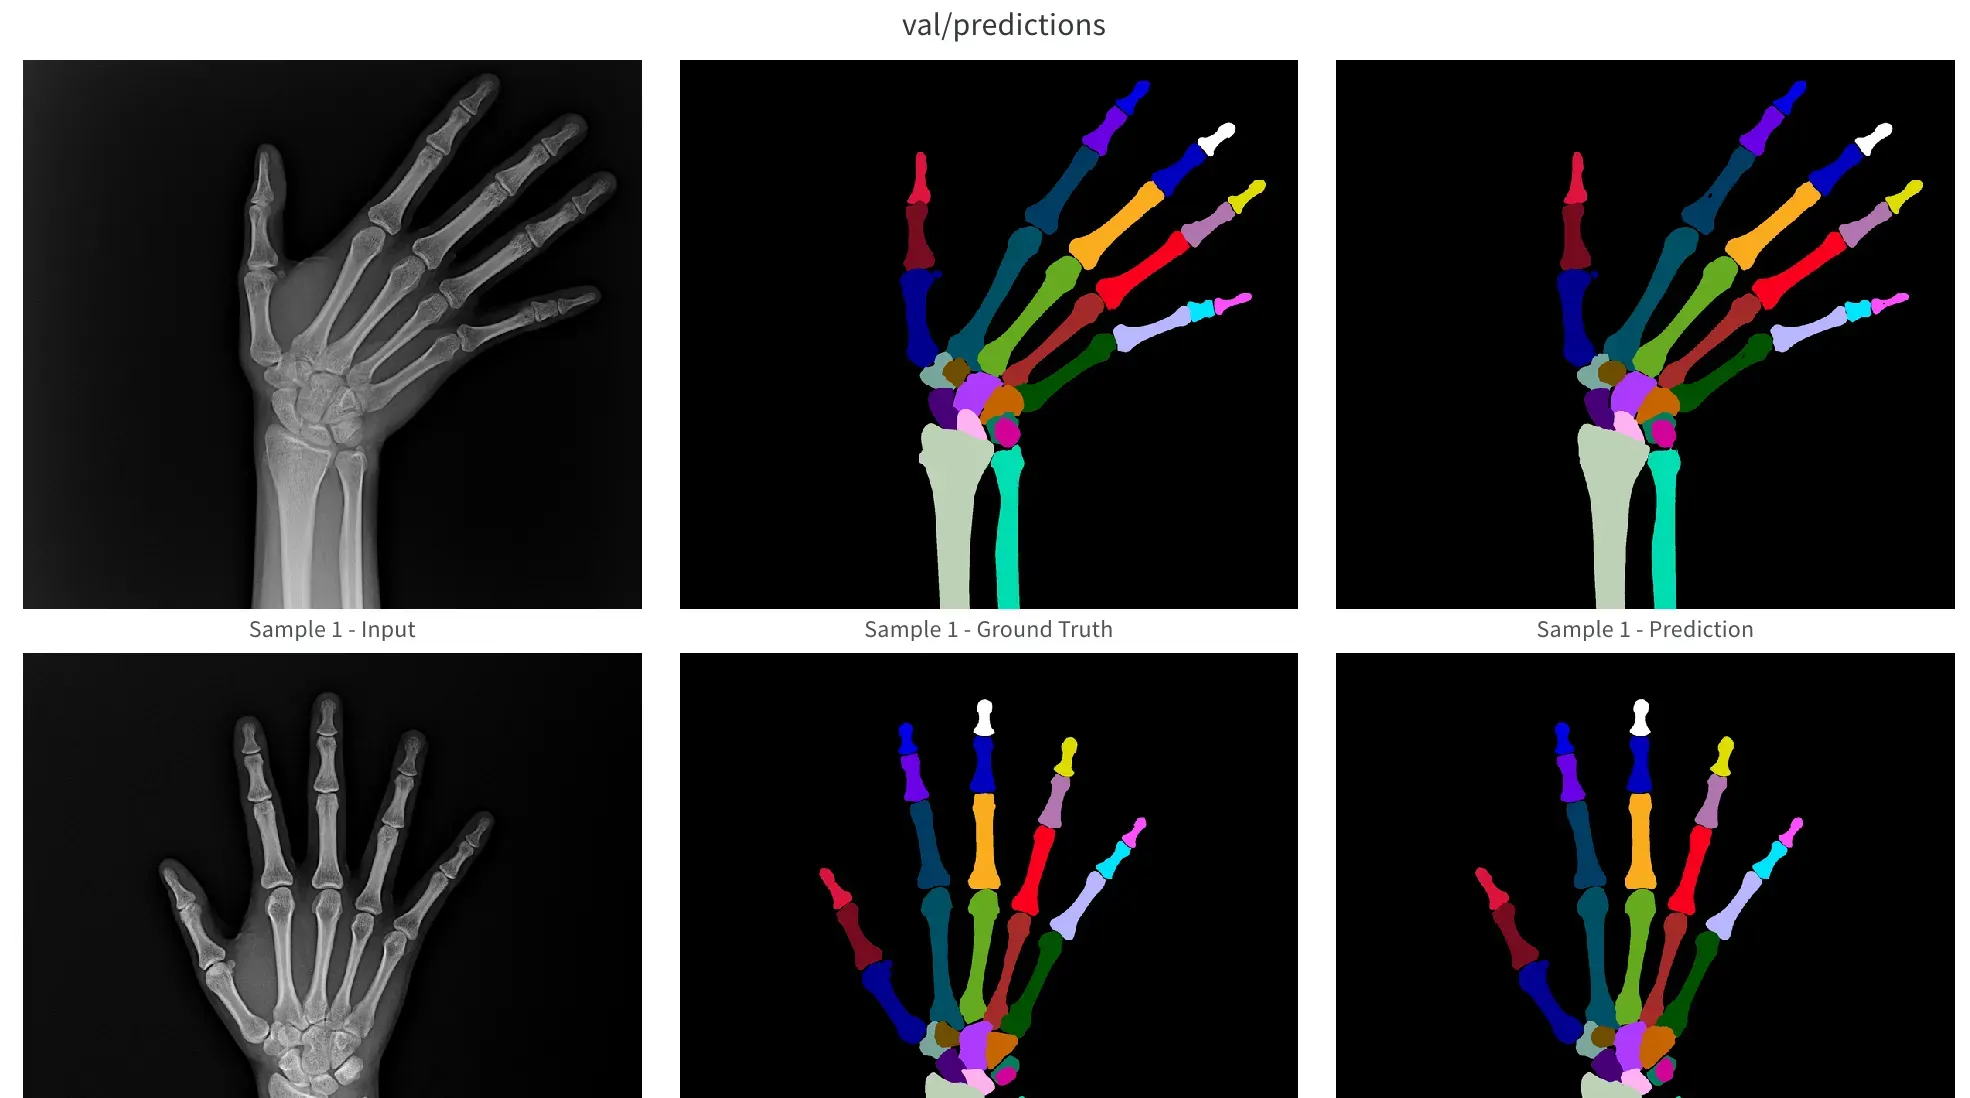
epoch = 50 validation에서의 validation 시각화결과
이후 Validation을 시각화할 때, 첫 번째 이미지로 손목이 꺾인 이미지를 추가하여 실제로 모델이 손의 달라진 각도에 의해 성능이 하락하는 것인지 확인해보았다.
Dice = 0.84인 Epoch = 5의 Validation 이미지를 보면, 손목이 꺾였을 때 뼈들을 잘 잡아내지 못하는 것을 확인할 수 있었다. 그러나 Dice = 0.96을 달성한 학습 후기의 Validation 이미지를 확인해보면, 손목이 꺾인 이미지에서도 육안으로 구분할 수 없을만큼 뼈들을 잘 잡아내는 것을 관찰할 수 있다.
이로인해, 손목의 각도는 학습 초기에는 해결해야 할 문제였음은 어느정도 생각될 수 있으나, 더 긴 학습 시간을 가지면서 모델은 손목 각도의 변화에 따른 이미지에 충분히 강건한 모델이 되었다고 생각되었다.
3.1.4 Grouping과 Stratification
환자의 ID에 따라 Group으로 묶는것은 중요하다. 한 환자의 왼손과 오른손의 뼈의 구조적 특징은 매우 유사하므로 만약 왼손과 오른손이 Train과 valid로 나뉠경우, 데이터 Leakage의 문제가 있을 수 있다. 따라서 Group K-Fold를 적용했다.
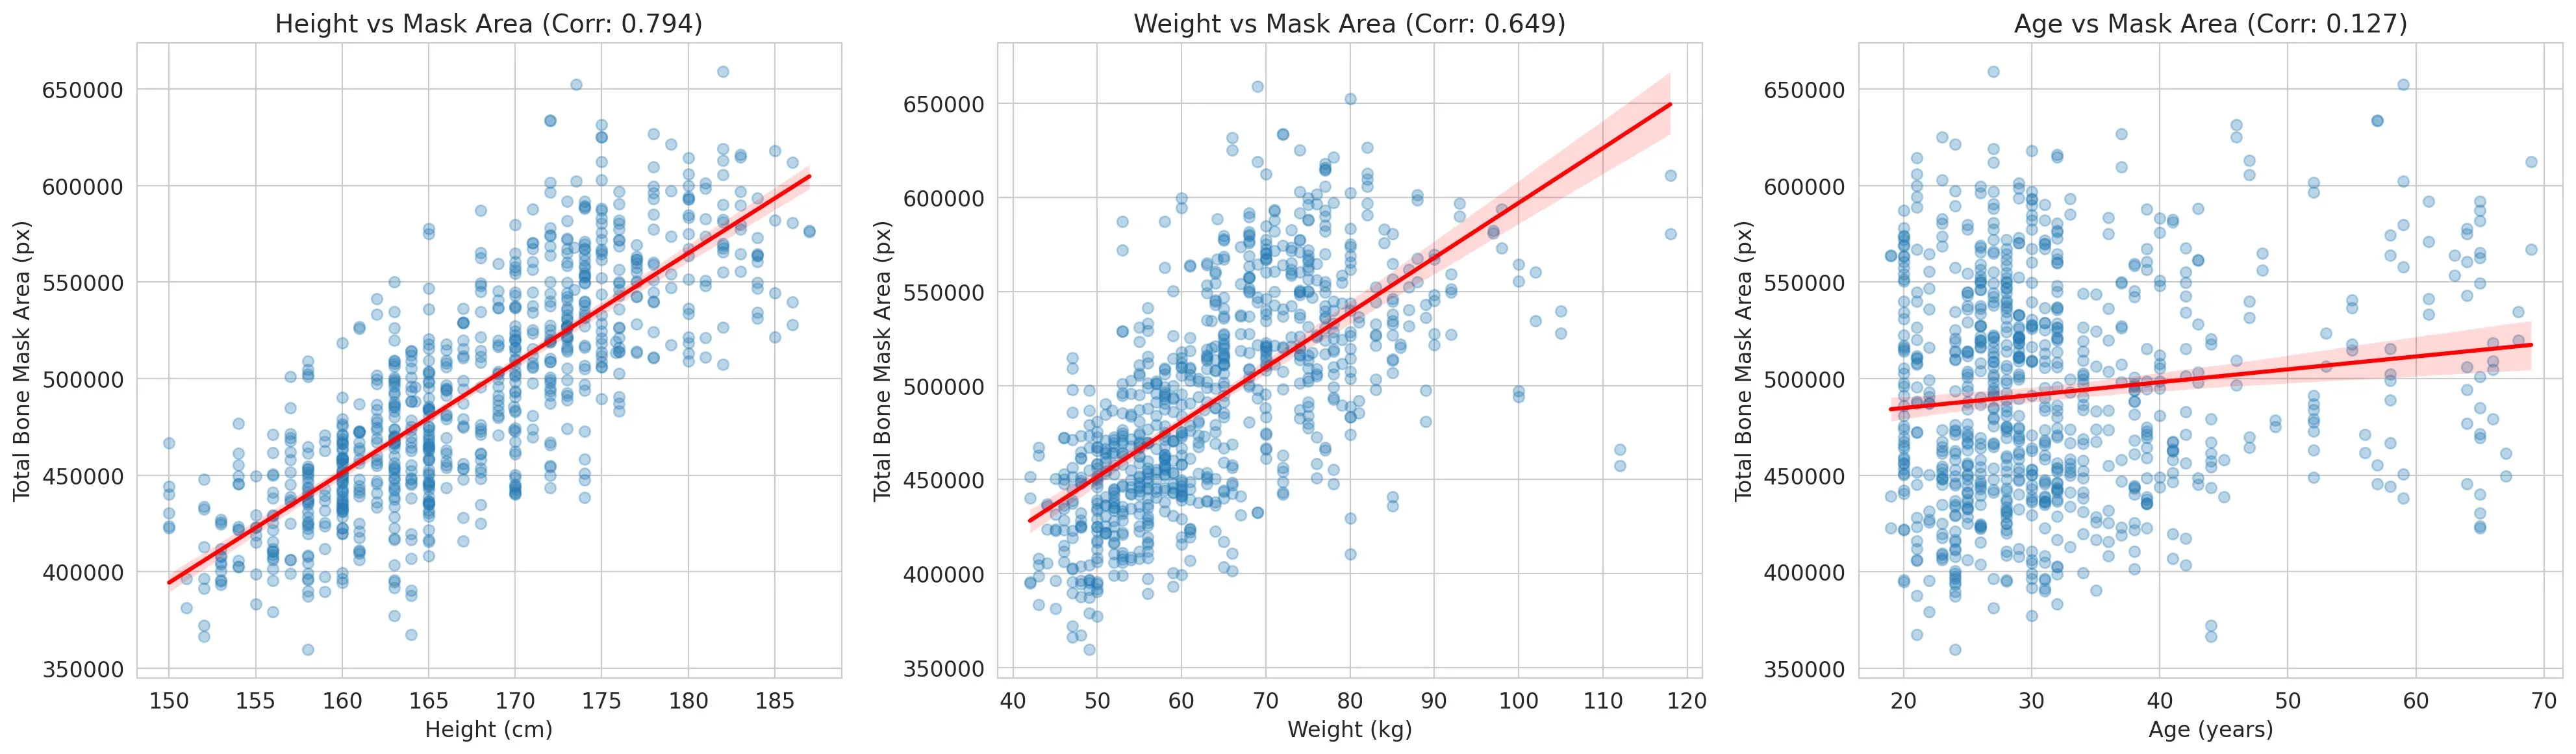
키, 몸무게는 Mask Size와 높은 상관관계(corr = 0.794, 0.649)를 보였지만 나이는 낮은 상관관계를 보였다.(corr = 0.127)
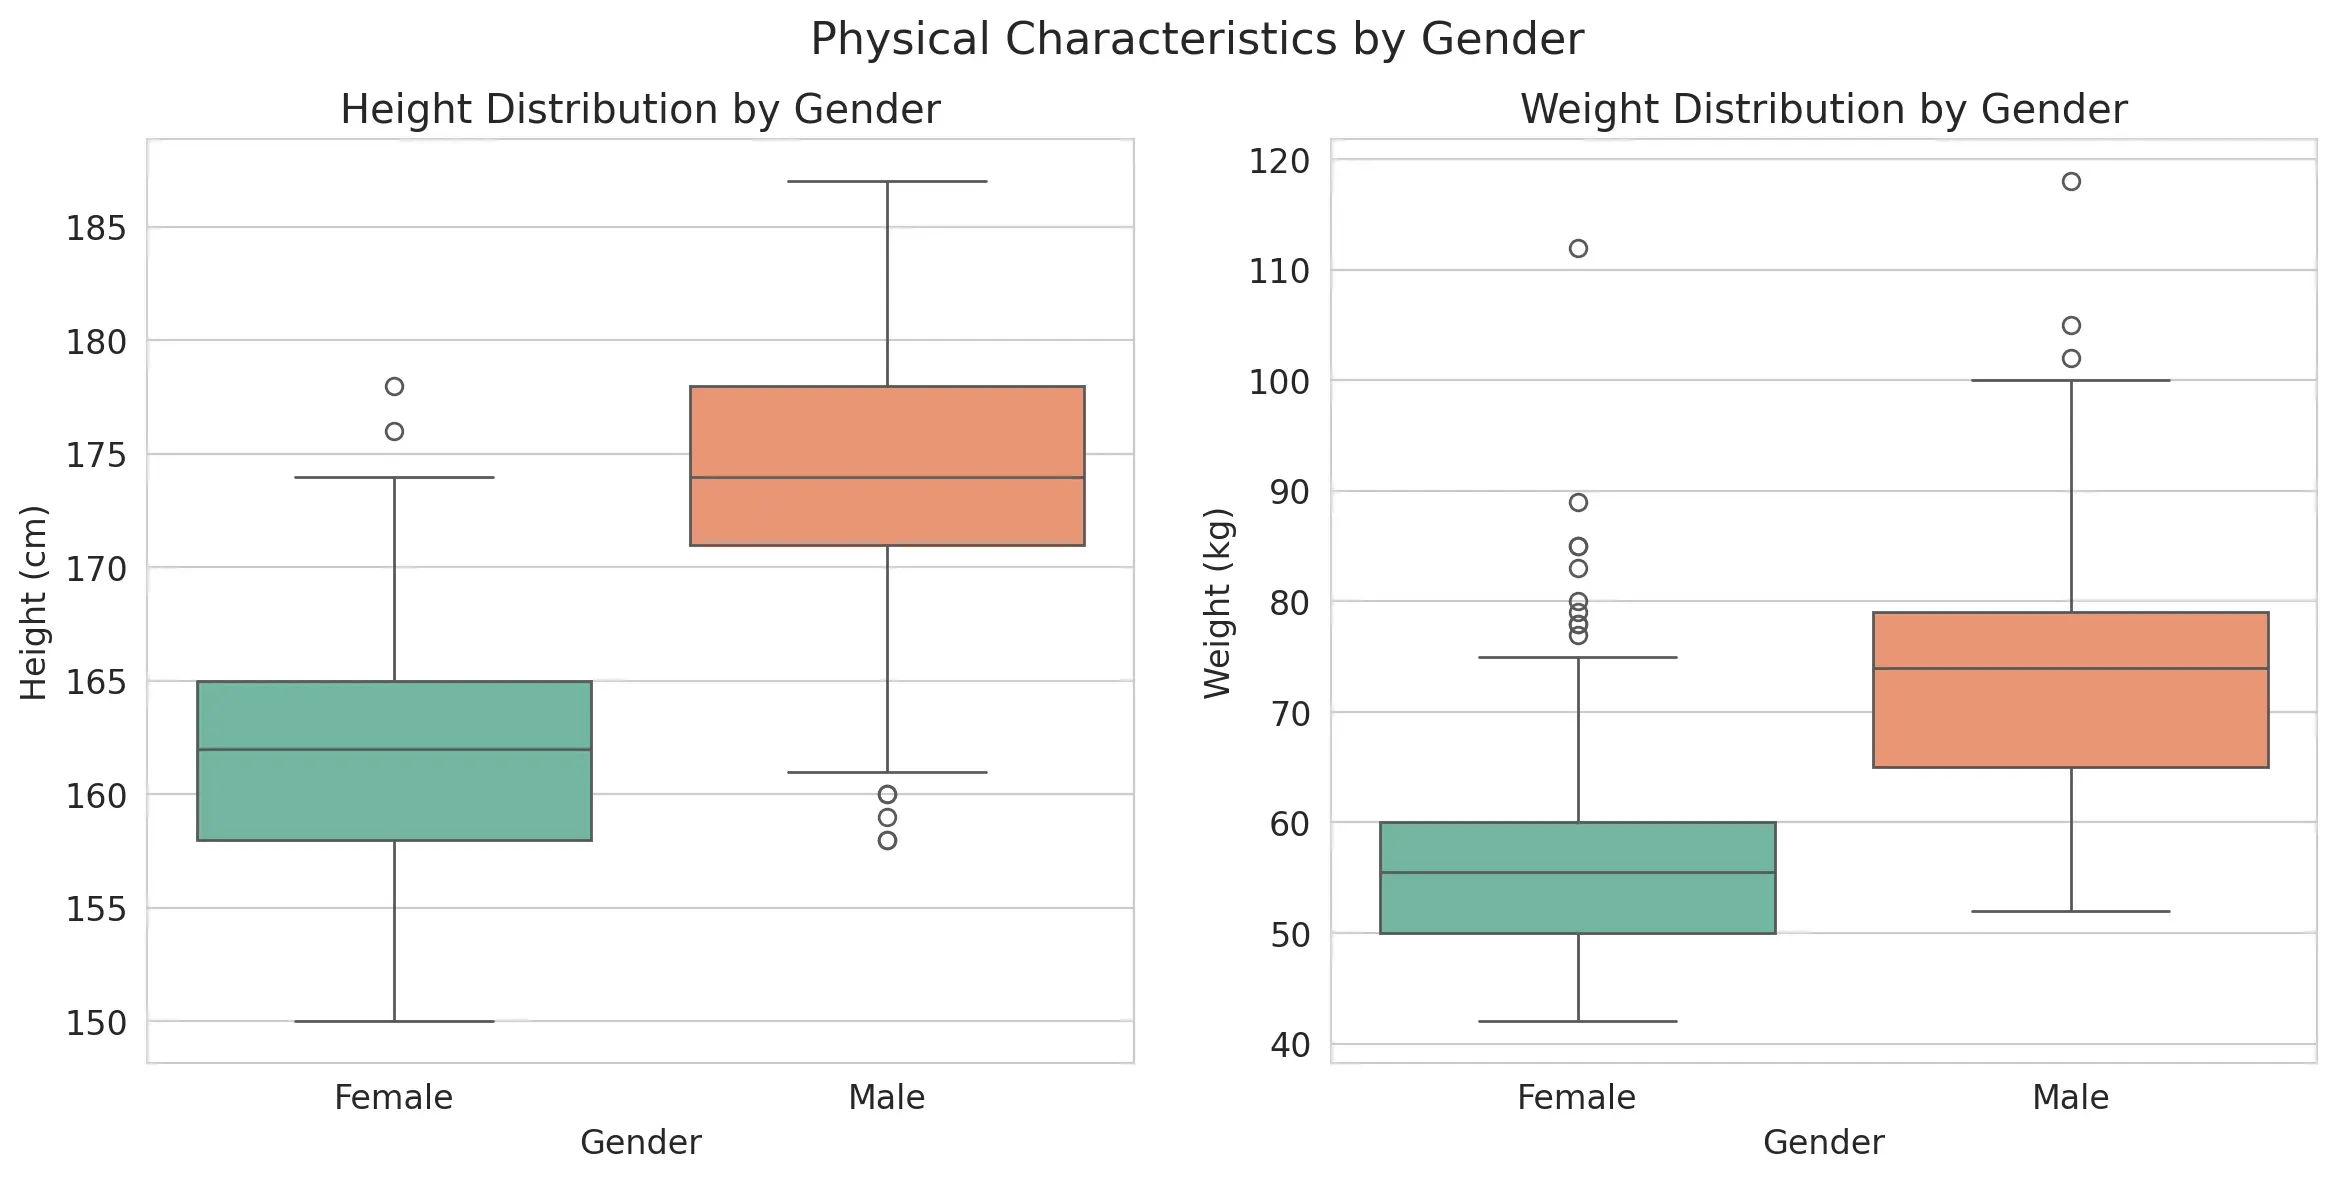
성별또한 mask size에 유의미한 상관관계가 있음을 확인했다.
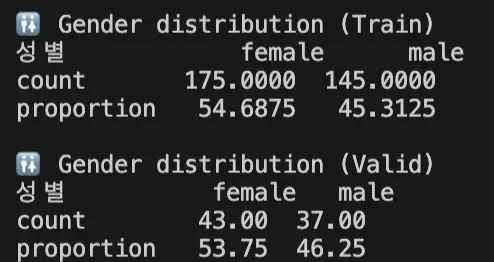
Train과 Valid를 랜덤으로 나눈 결과 성별의 비율이 전체 비율과 크게 다르지 않았다.
환자의 메타데이터에 따라 Stratified하게 K-Fold를 나누는것 또한 매우 중요하다. 하지만 환자의 메타데이터인 몸무게, 키등은 성별과 매우 높은 상관관계를 보이고 있었고, GroupRandomK-Fold적용 결과 거의 성별이 균등하게 Fold별로 나뉘고있음을 확인해서 GroupRandomK-Fold를 사용했다.
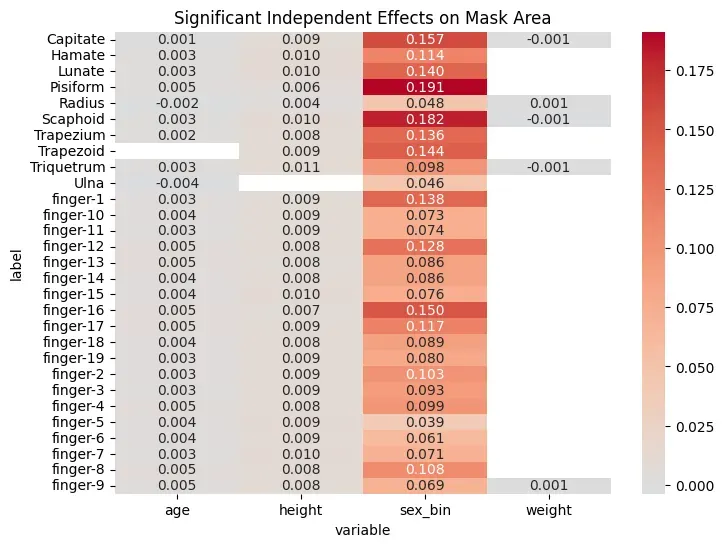
다변량 회귀분석 결과 환자의 메타데이터들은 성별과 강하게 연관되어있음을 확인했다.
3.1.5 객체 외 노이즈 제거
EDA도중 일부 이미지의 경우에는 상단과 좌측에, 흰색으로 노이즈가 있음을 확인했다. 따라서 노이즈를 제거해주기 위해서, 상단과 좌측의 80픽셀을 제거해주었다.
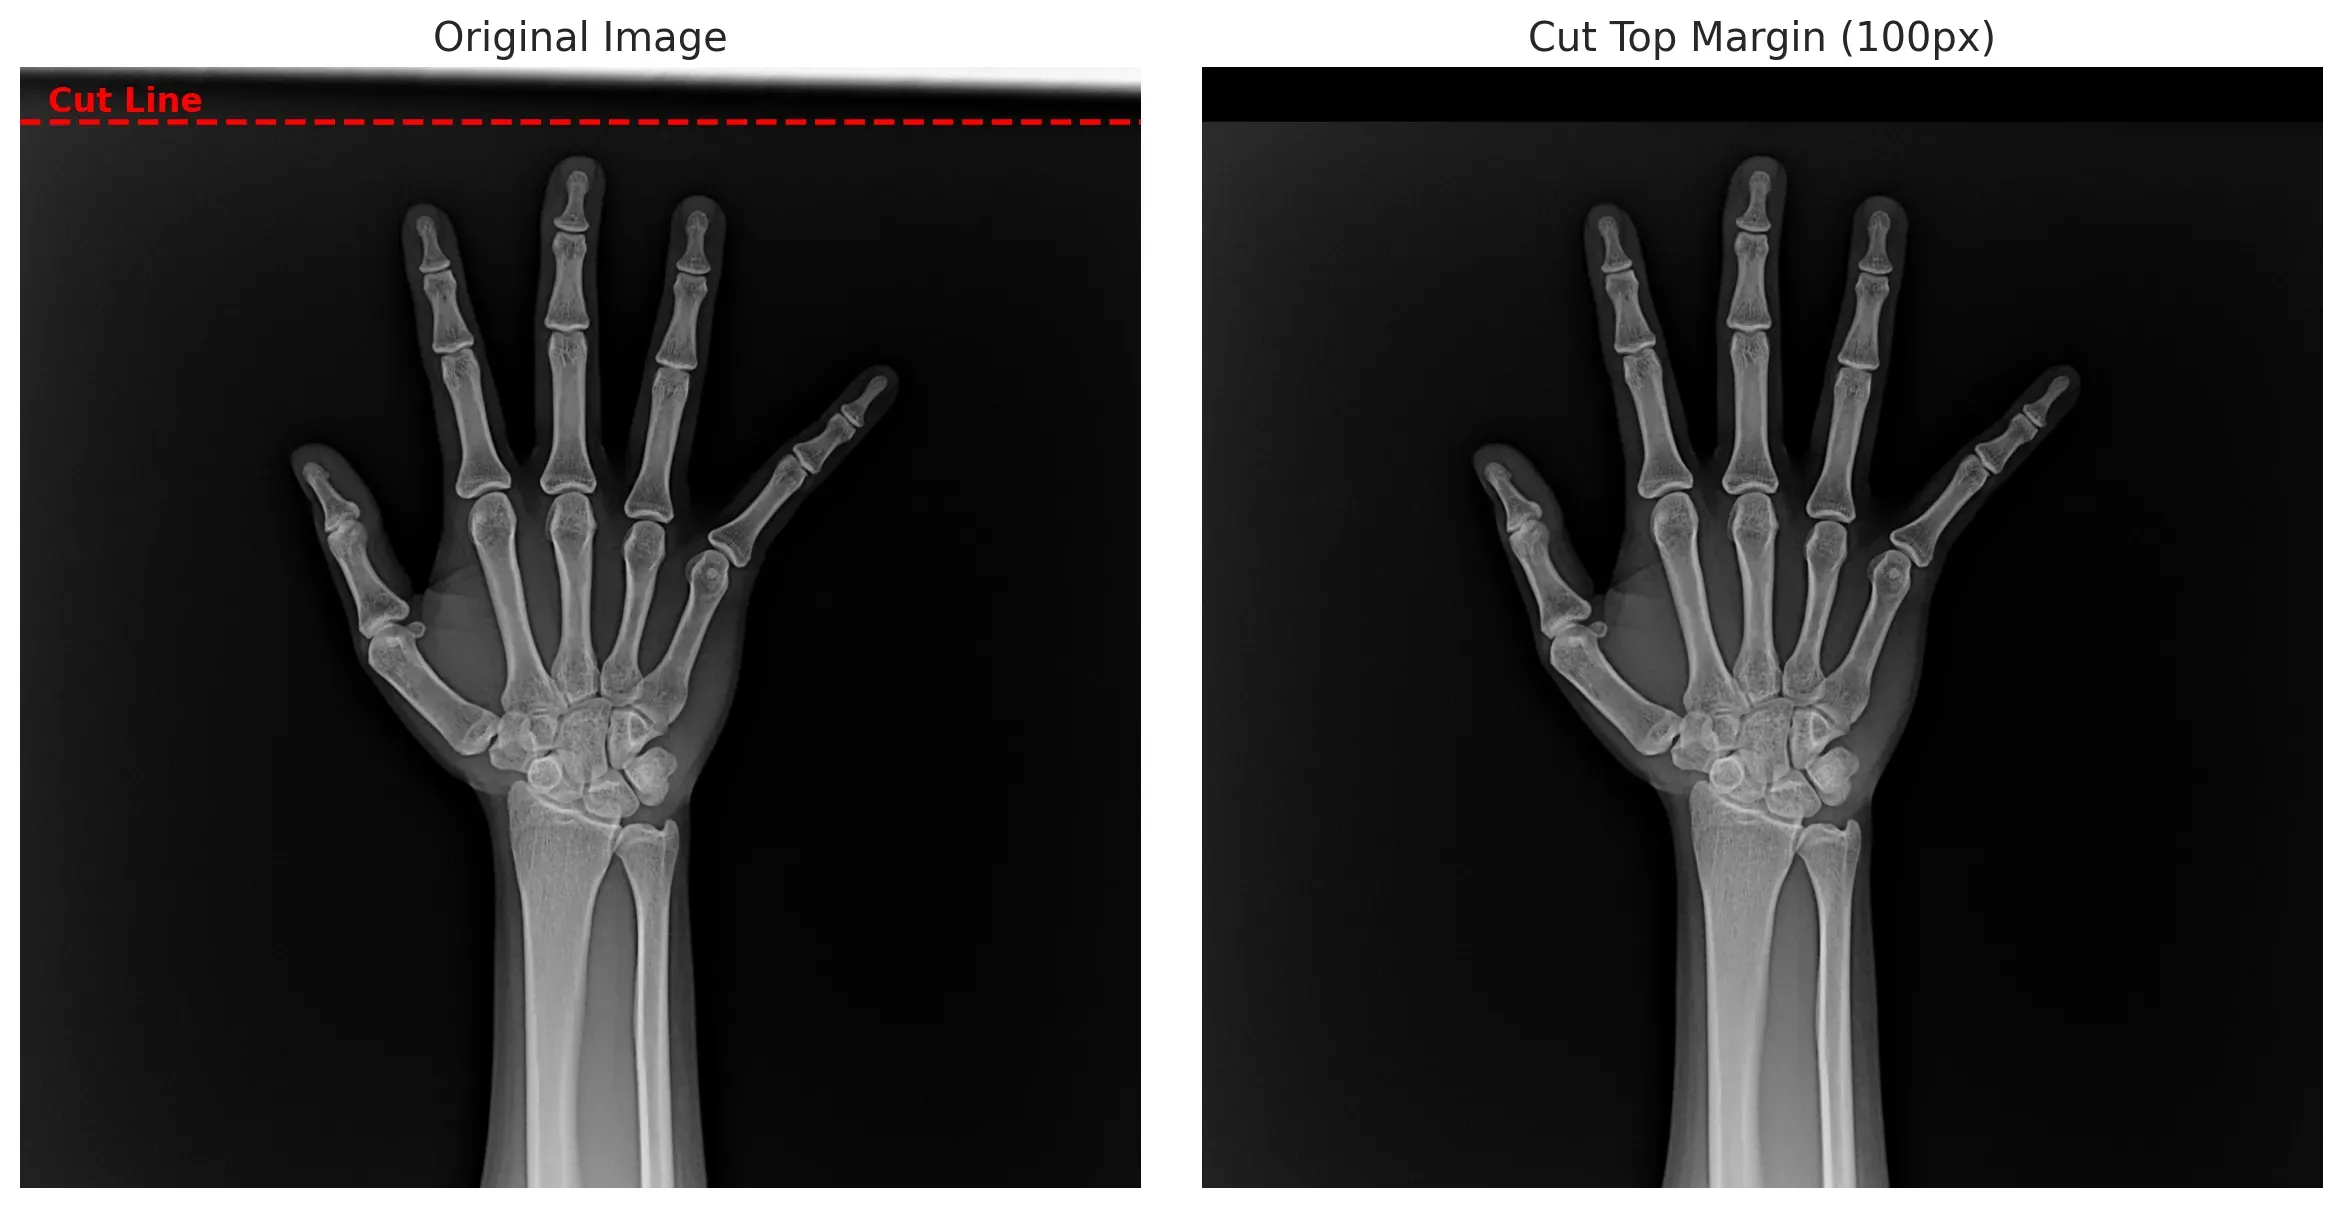
상단에 노이즈가 있는 이미지(좌), 상단의 노이즈를 CuT한 후 검은색픽셀로 채운 이미지(우)
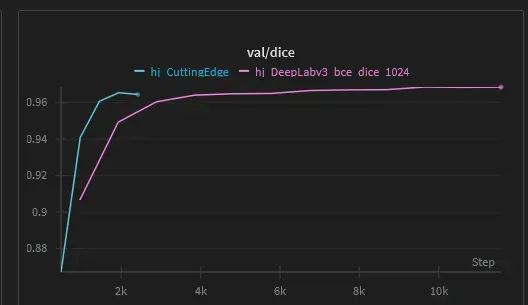
노이즈를 제거해준 결과 초기 수렴속도가 빨라짐을 확인했다.
이후에 상단과 좌측의 노이즈만 제거하는것이 아니라 배경의 모든 노이즈를 제거하기 위해서 픽셀값이 급하게 변하는 경계를 찾고, 외부 경계선을 만들어서, 배경을 모두 제거해버리는 방법을 사용해보았다.
하지만 이 방법의 경우 성능향상이 없었기 때문에 이후실험에서는 사용하지 않았다.
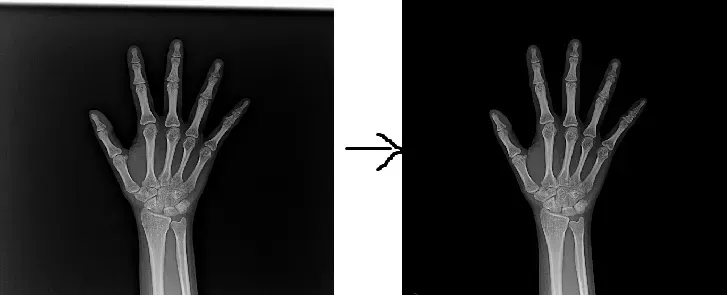
원본이미지(좌), 객체 외부의 모든 픽셀값을 0으로 만든 사진(우)
3.1.6 Outlier확인 및 제거
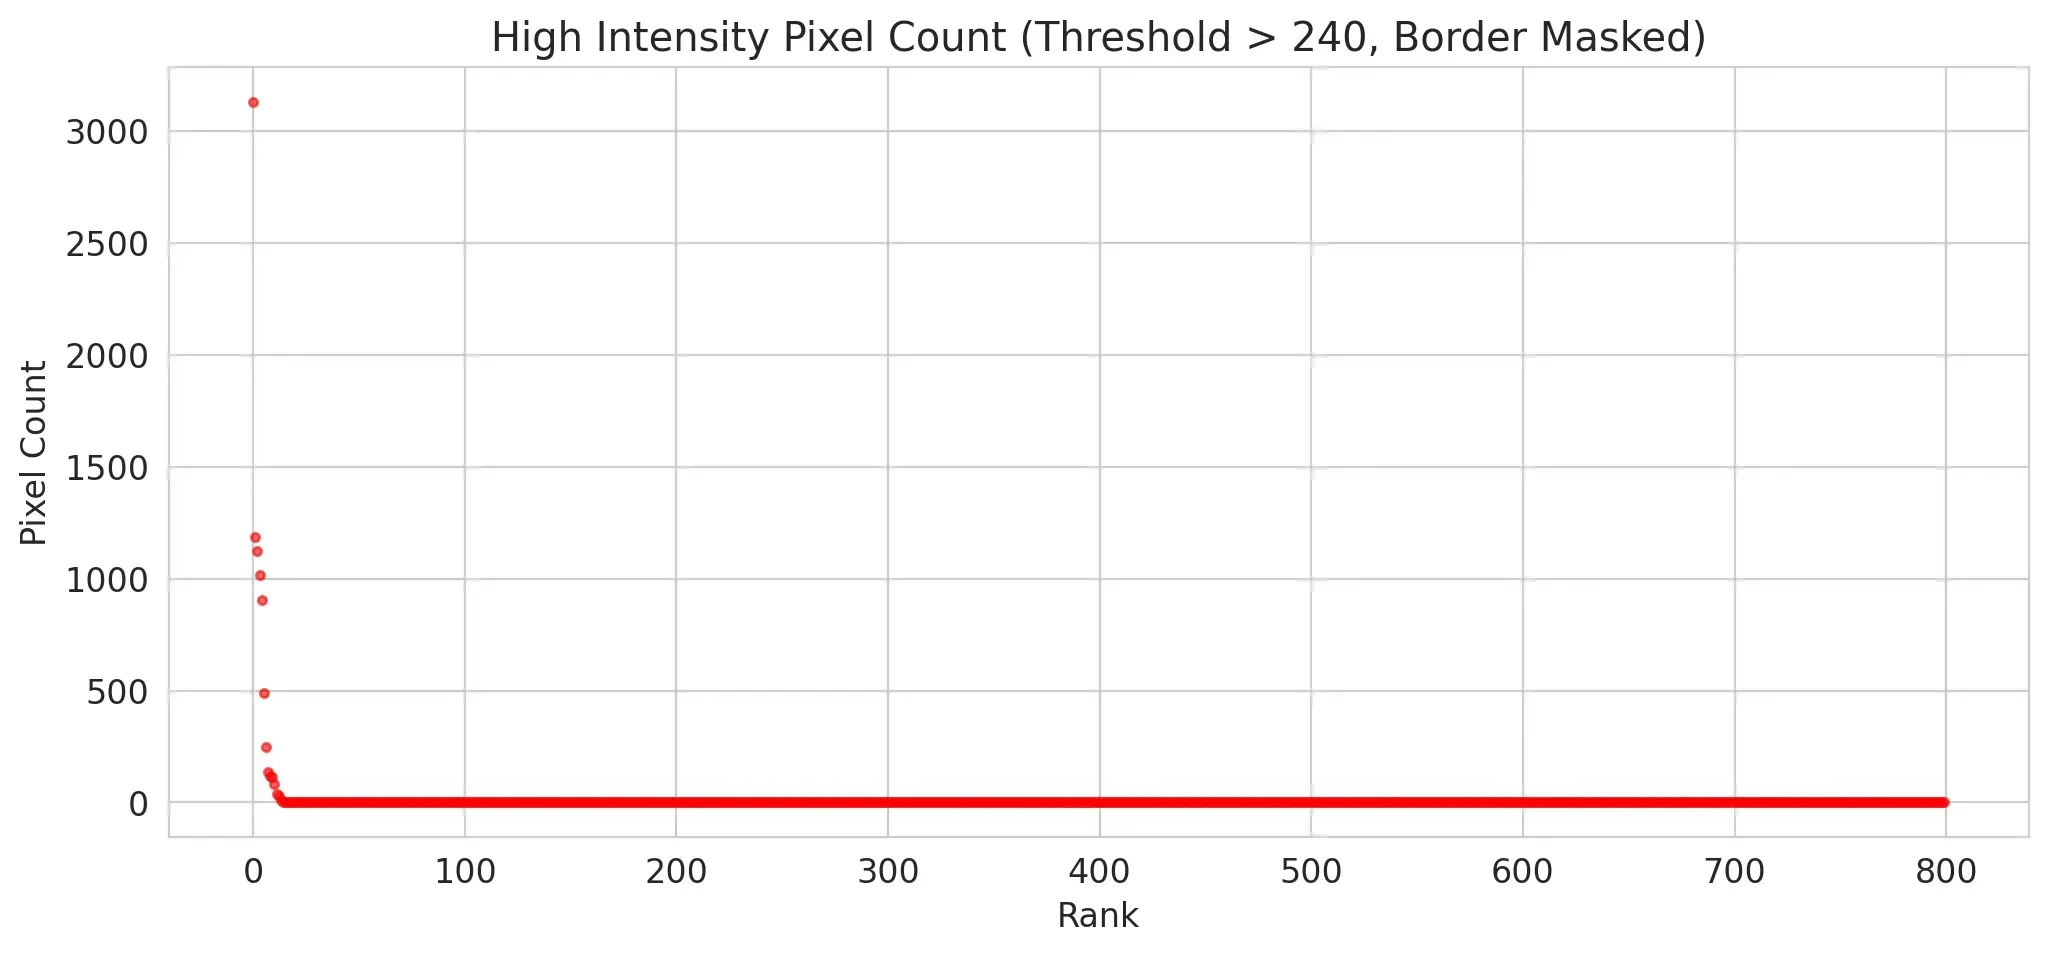
픽셀 밝기가 240 이상인픽셀수를 시각화한 그래프
X-Ray 이미지 데이터셋에는 반지를 끼고 찍은 사진이나, 네일아트가 있는 이미지도 포함되었다. 이러한 이미지들을 우선적으로 Outlier로 판단하고 제거한후 실험을 진행해보았다.
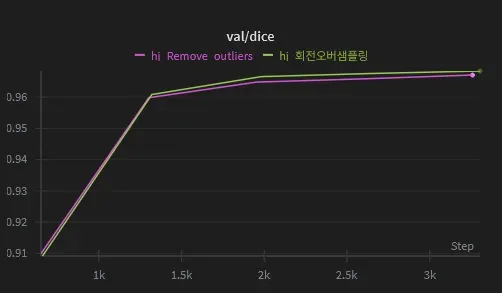
픽셀기준 이상치 제거를 하고 실험한 결과(보라색)
픽셀값을 기준으로 이상치를 탐지하고, 제거해본 결과 성능이 오히려 소폭(0.001) 하락했다.
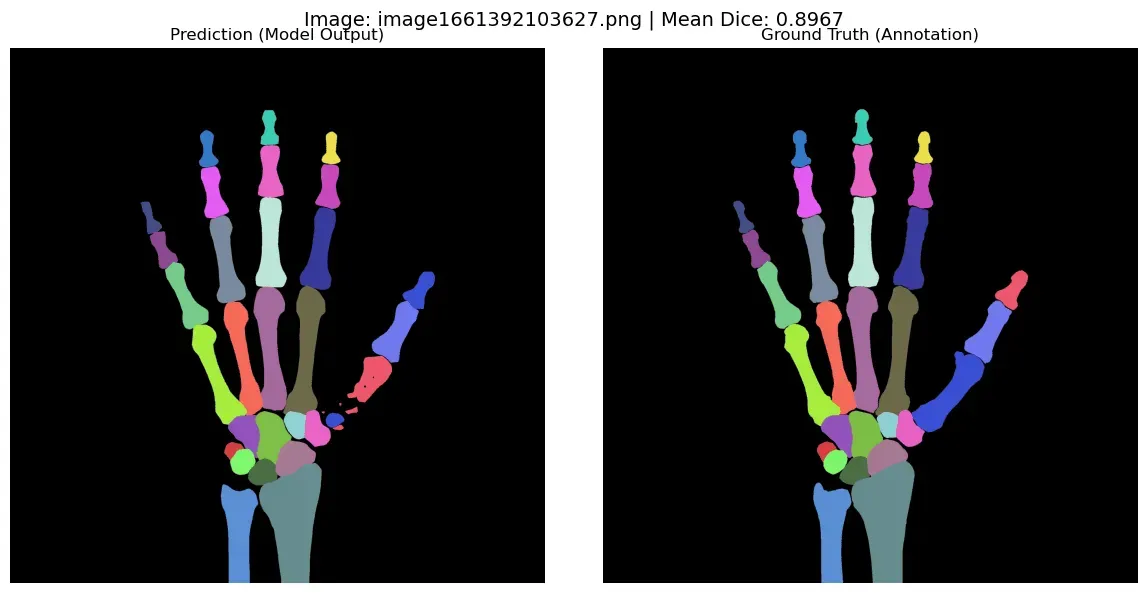
픽셀값을 기준으로 이상치를 판단하는것이 아니라, Train된 모델의 DIce score가 낮은순으로 나열해서 시각화해본 결과 Annotation이 잘못된 이상치를 확인할 수 있었다.
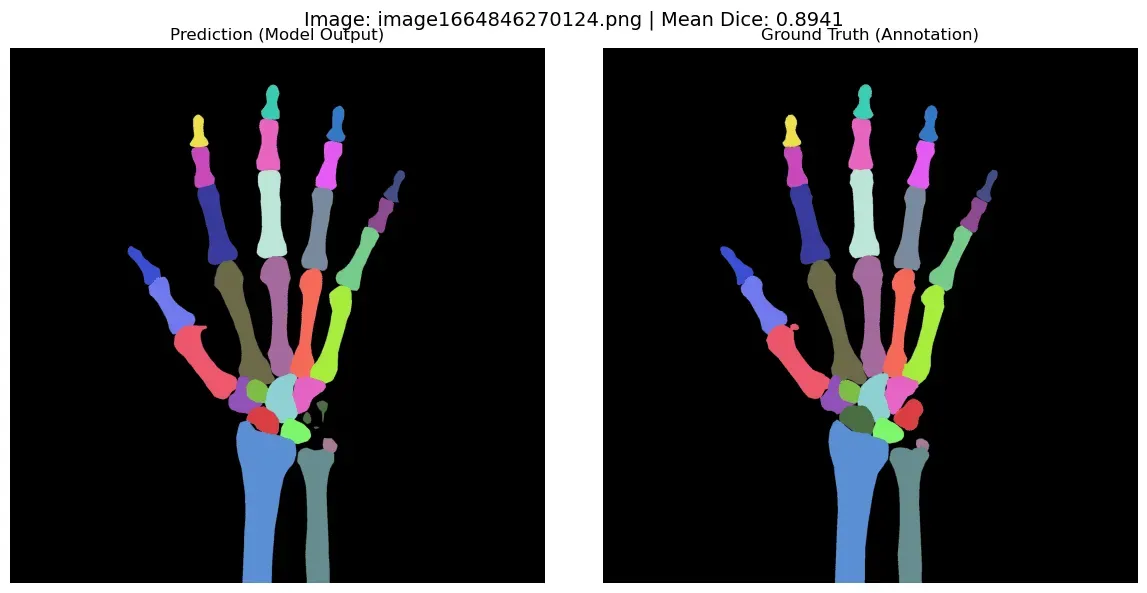
Pisiform(연갈색)과 Trapezoid(진초록색)간의 Annotation이 뒤바뀐 경우
엄지손가락의 뼈 Annotation순서가 뒤바뀐 경우
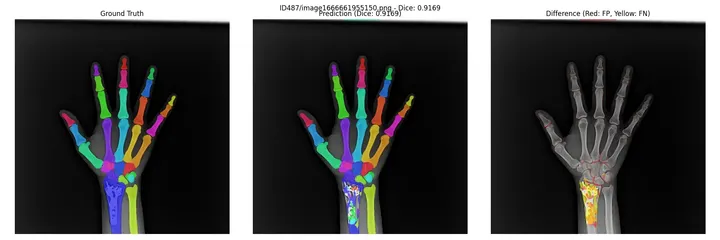
보형물이 포함되어 모델이 예측을 이상하게 하는 경우
따라서 해당 이상치들은 제거하고 실험한 결과 test score기준 0.0009 상승함을 확인했다.
3.2 Augmentation
3.2.1 Horizontal Flip
Train Image가 800장밖에 되지 않아서, 학습할 데이터가 절대적으로 부족하다고 판단했다. 따라서 학습데이터는 많을수록 좋으므로 모든 사진의 좌우반전의 확률을 0.5 로 두는 증강방법을 사용했다.
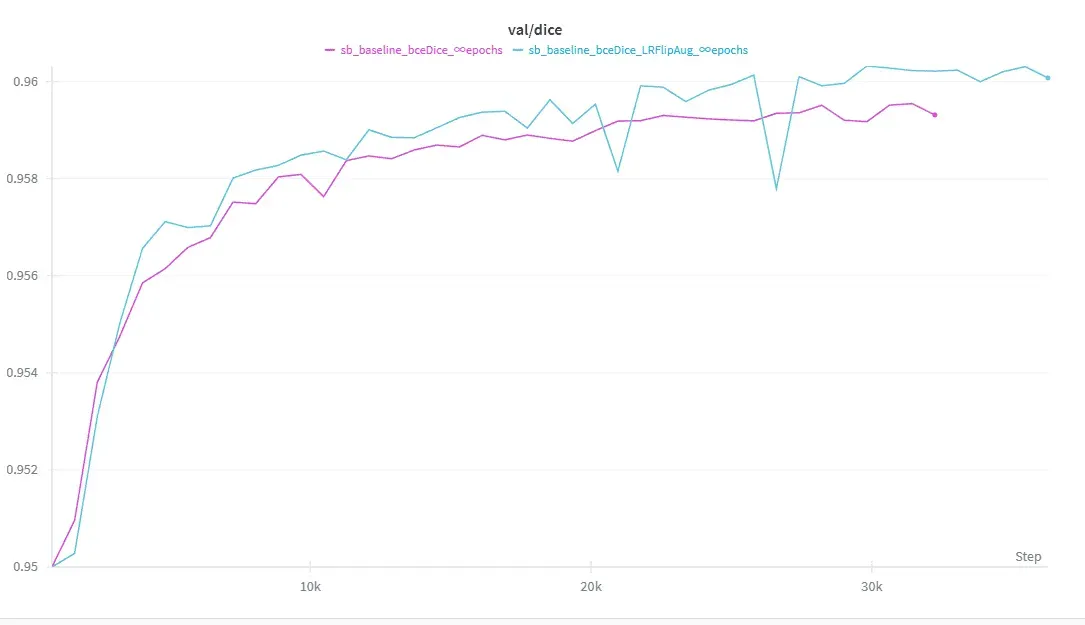
Horizontal Flip결과 (하늘색)이 더 높은 성능을 보임을 확인할 수 있다.
Horizontal Flip을 적용한 결과 더 높은 성능을 보임을 확인할 수 있었다.
3.2.2 RandomBrightnessContrast, SSR, GridDistortion, GridDropout
- RandomBrightnessContrast
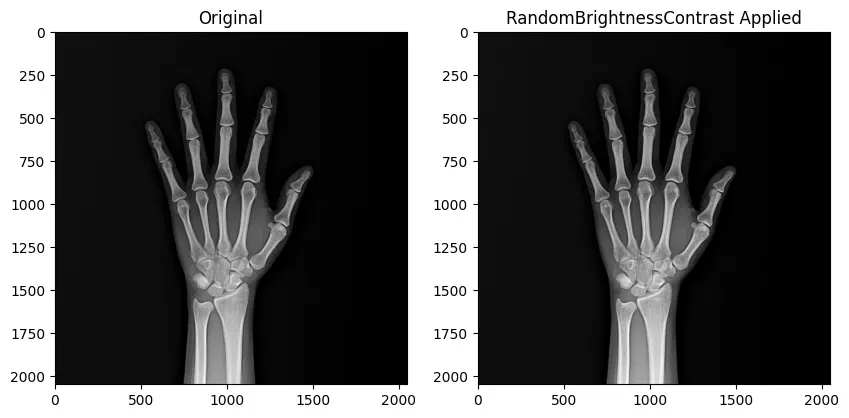
원본사진(좌), 증강사진(우)
# BrightnessContrast (p=0.3 고정)
brightness_contrast: true
brightness_limit: 0.1
contrast_limit: 0.1
Baseline만으로 Dice score가 0.96이상이 나오는 상황에서, 너무 강한 증강은 성능 하락을 야기한다고 가정했다. 따라서 RandomBrightnessContrast는 확률은 0.3으로 고정하고 변화 범위는 0.1 로 작은 범위로 제한했다.
- SSR
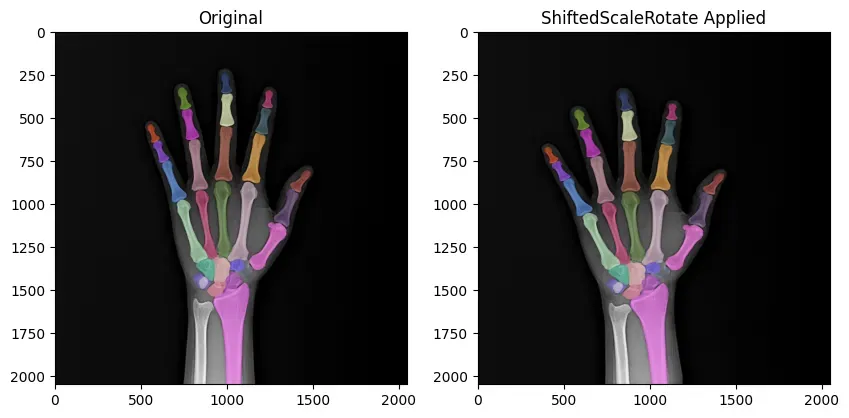
원본사진(좌), 증강사진(우)
shift_scale_rotate: true
shift_limit: 0.05                 # 이동 범위
scale_limit: 0.1                  # 스케일 범위
rotate_limit: 15                  # 회전 범위
SSR도 마찬가지로 작은범위에서 변화를 주되, 회전된 손이나, 메타데이터 차이에 따른 뼈의 형태 차이에 대해 일반화성능이 올라갈것이라고 가정하고 적용했다.
- GridDistortion
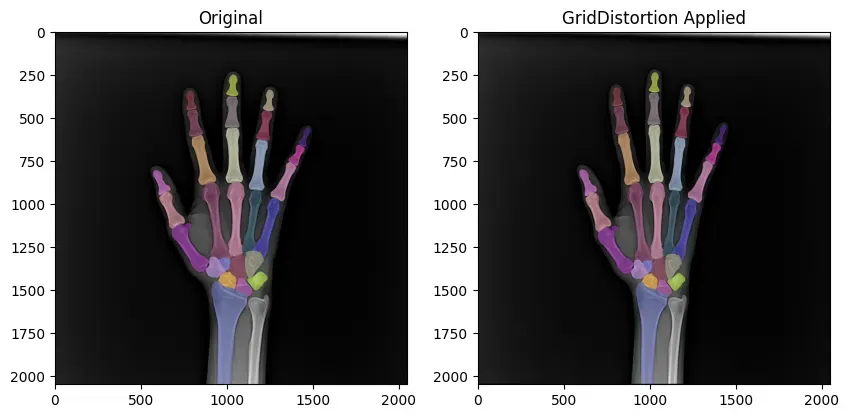
원본사진(좌), 증강사진(우)
U-Net 원본 논문에서 세포 분할(Cell Segmentation) 시 가장 강력했다고 언급한 기법으로 이미지를 젤리처럼 일그러뜨려 사람마다 다른 뼈의 미세한 굴곡을 학습하여 일반화 성능이 향상될것이라고 가정하고 적용했다.
- GridDropout
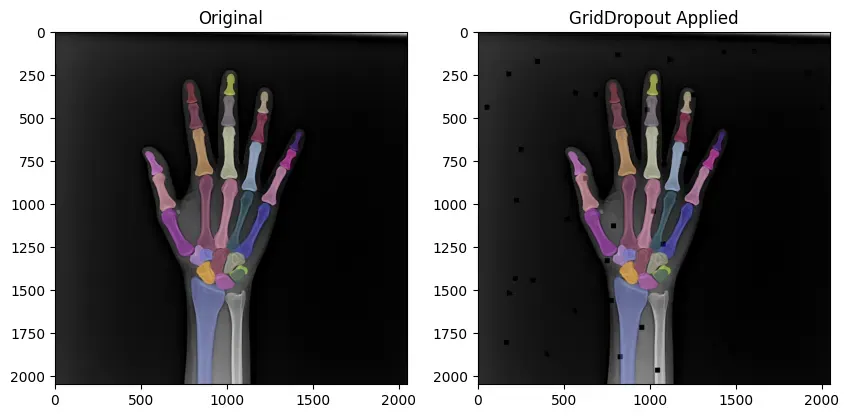
원본사진(좌), 증강사진(우)
가려진 mask에 대해서 문맥을 강제로 학습하도록 강제하면, 뼈의 문맥을 더 잘학습할것이라고 가정하고 GridDropout을 적용했다.
- 결과
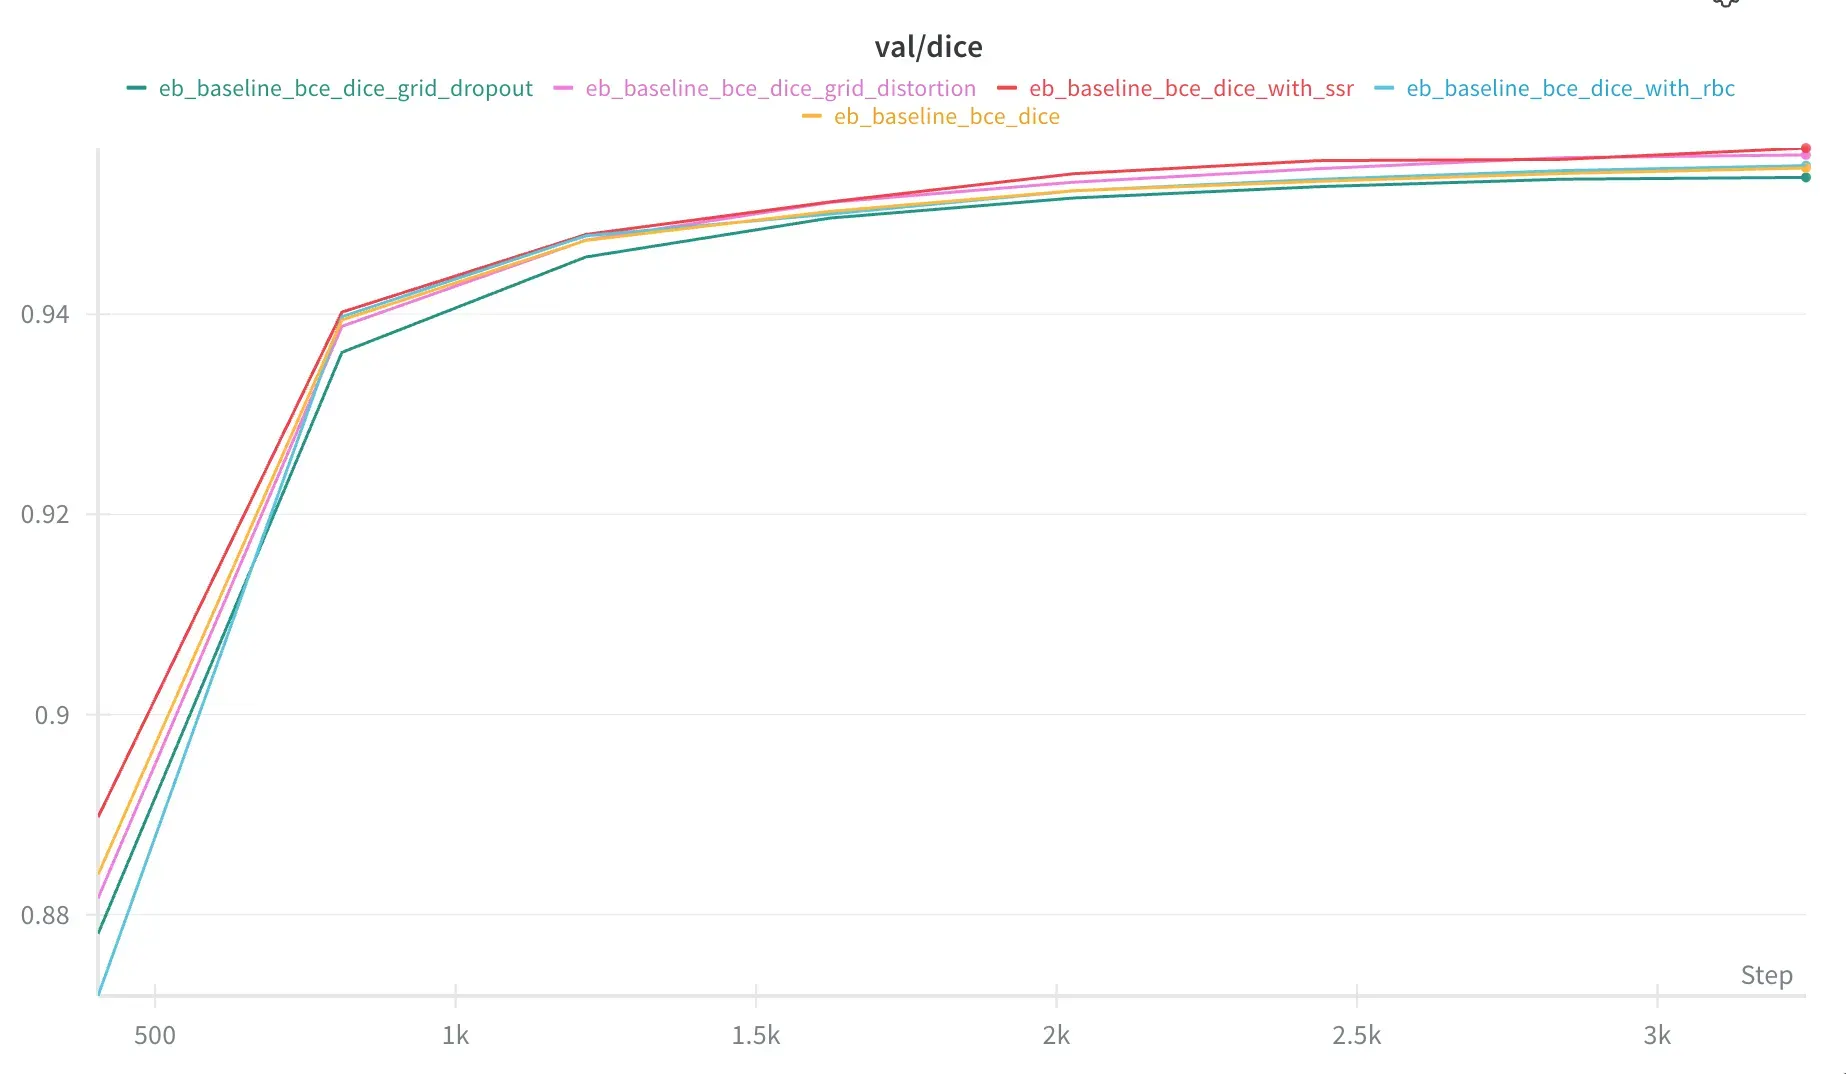
SSR(빨강), griddropout(초록), baseline(노랑), rbc(청록),griddistortion(보라)
baseline:0.9546
RandomBrightnessContrast: 0.9548 ShiftScaleRotate: 0.9566 grid_distortion: 0.9559 grid_dropout:0.9537
SSR을 제외한 나머지 기법들은 baseline에 비해 성능향상이 없었다. 따라서 baseline 대비 0.002의 성능향상이 있었던 SSR만을 이후실험에서 적용했다.
3.2.3 CLAHE
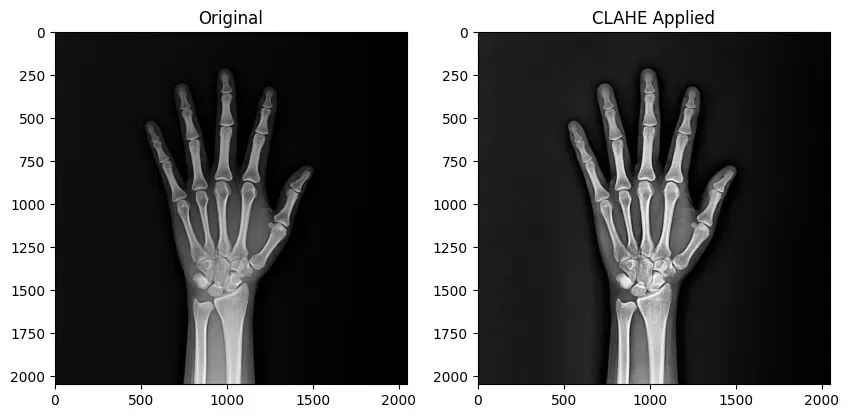
원본사진(좌), 증강사진(우)
일반적으로 X-Ray데이터셋에서 Pixel단위에서 뼈를 더 잘 구분하는Augmentation이라고 알려진 CLAHE를 적용했다. clip_limit=4 로 고정하고, tile_grid_size 를 8,16,24로 실험해보았다.
하지만 실험결과 일관된 성능향상을 확인할 수 없었다.
3.2.4 Elastic Transform
elastic augmentation 기법을 적용하여 중첩 뼈들의 여러 기하학적인 모양을 학습하게하여 더욱 다양한 중첩 부분을 구분하도록 만들기 위해 elastic을 적용하였다.
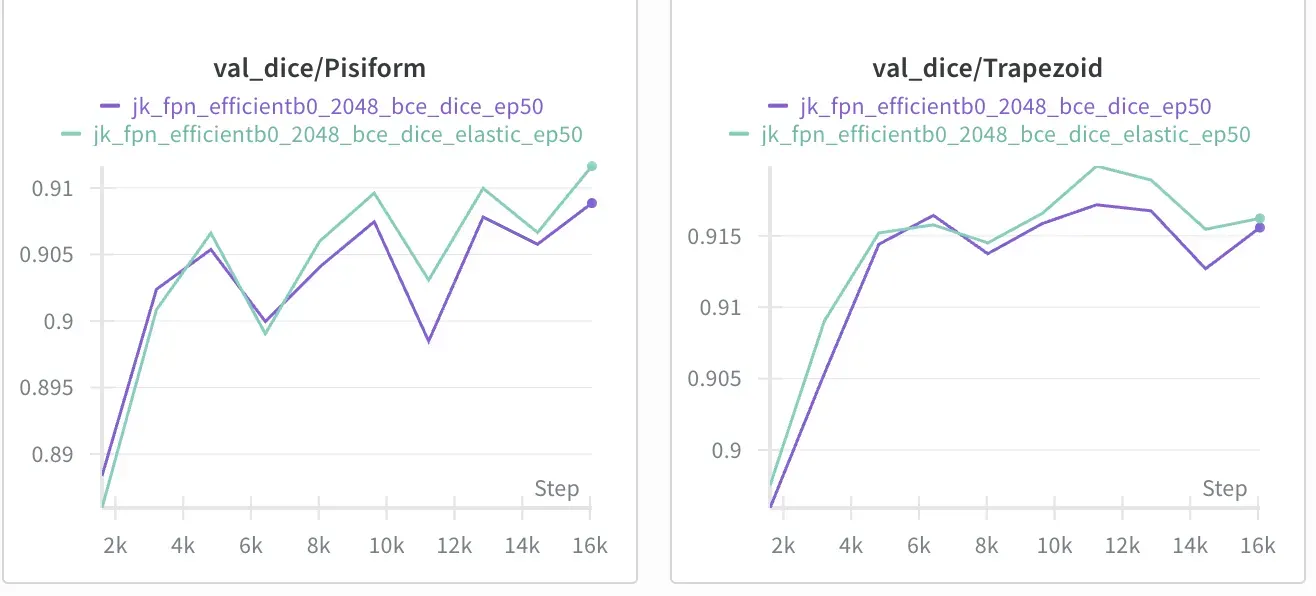
elastic 적용 결과(초록), baseline(보라)
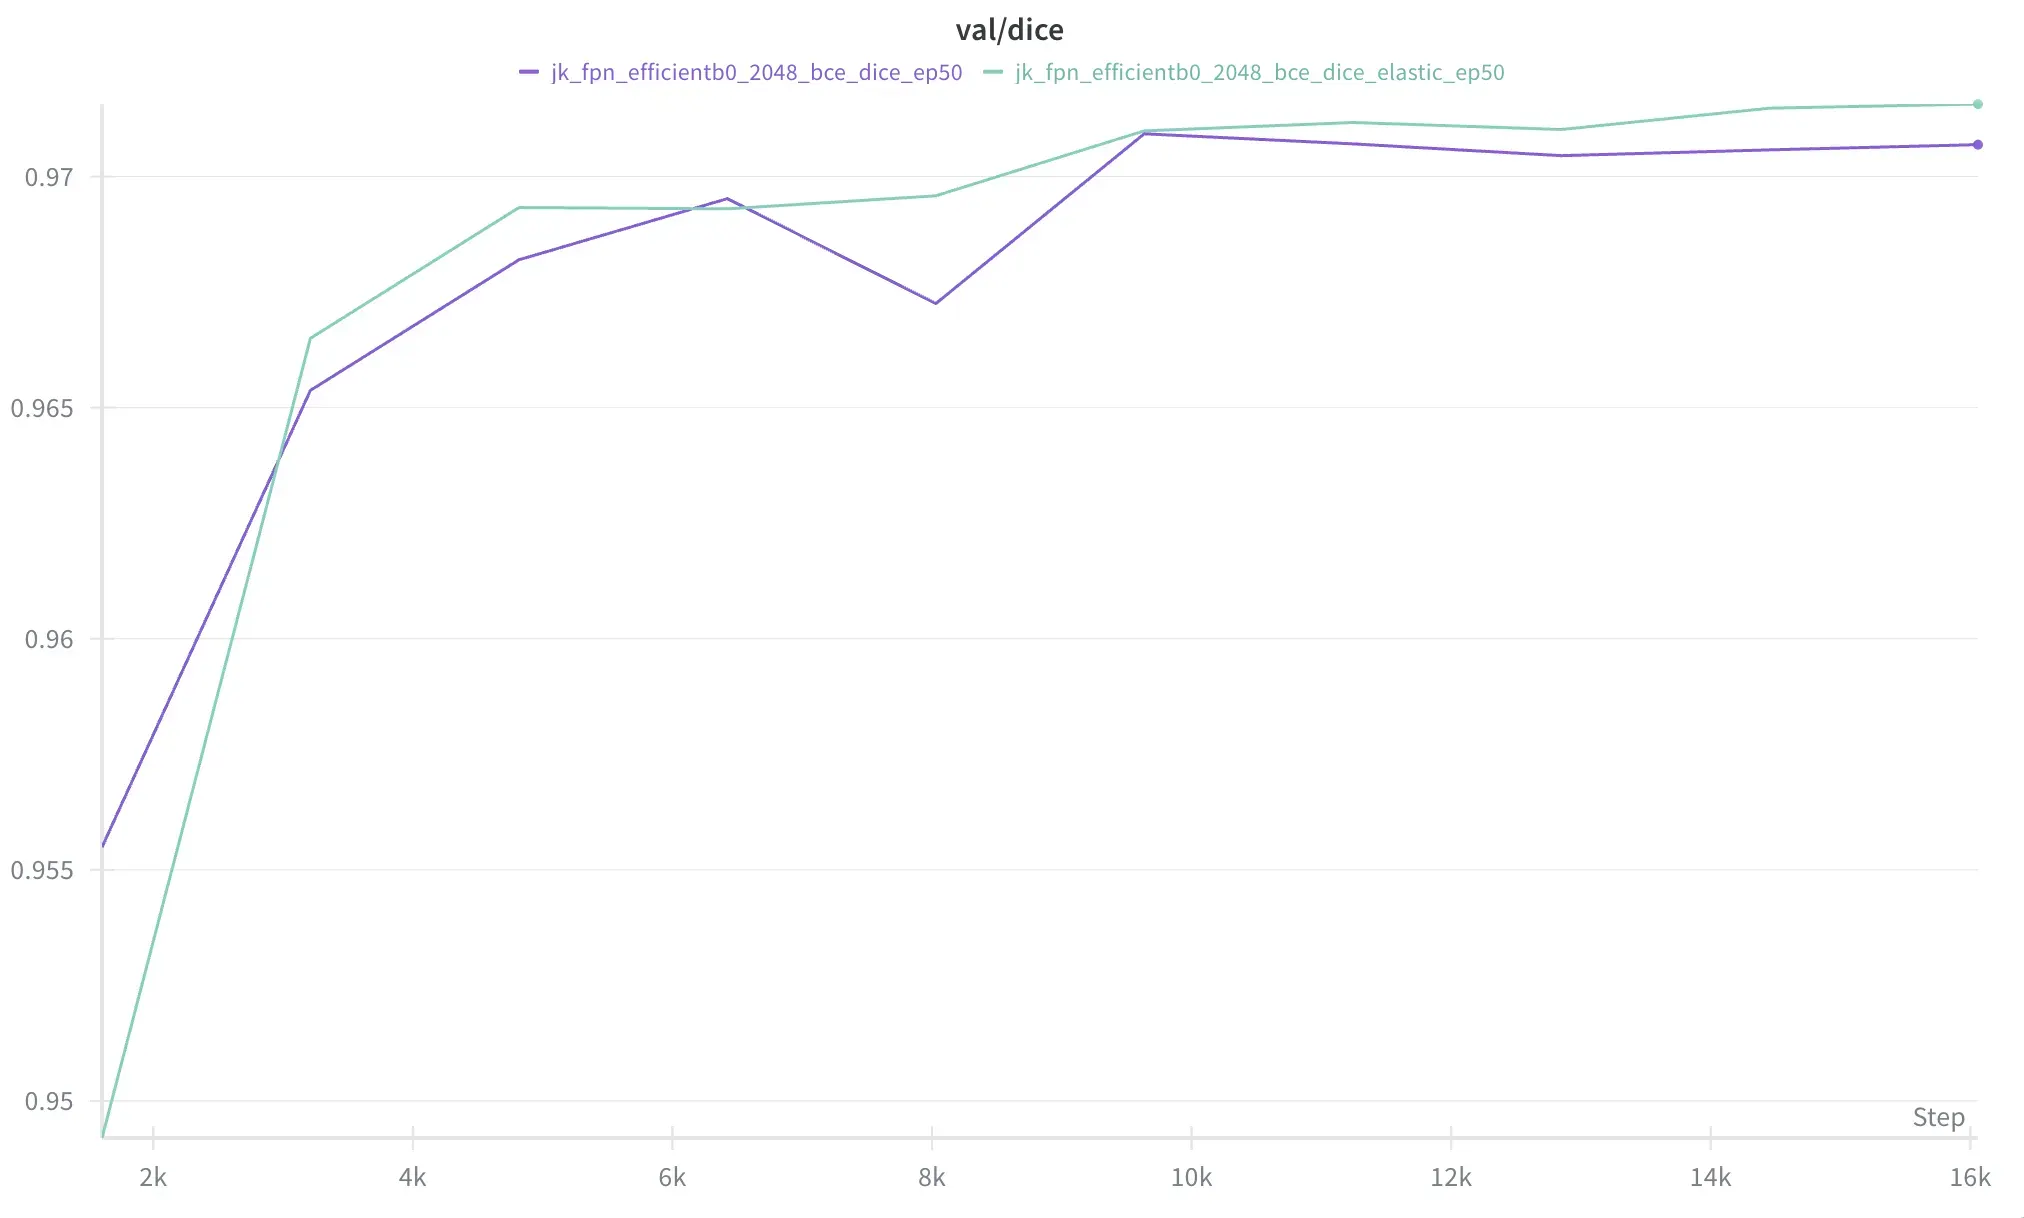
elastic 적용 결과(초록), baseline(보라)
elastic을 적용했을 때와 적용하지 않았을 때 두 뼈의 dice score를 비교해보면, Pisiform, Trapezoid에서 둘 다 val_dice가 약 0.0025정도로 소폭 상승한 것을 관찰할 수 있었다.
또한 평균 dice에서 elastic을 적용했을 경우 dice가 급락하는 지점 없이 꾸준히 우상향하여 과적합에도 좋은 성능을 낸다는 것을 확인하였다.
elastic을 적용, 미적용했을 때의 클래스별 score 차이를 비교해보면, 두 뼈가 가장 많은 score 차이가 발생한 클래스는 아니지만, 난이도가 높은 중첩 뼈인 Pisiform, Trapezoid에서 dice에서 dice가 상승했다는 점과 평균 dice가 급락하는 지점 없이 우상향한다는 점을 미루어봤을 때 elastic augmentation을 적용하는 것은 전체적인 성능 향상에 도움이 되는것을 확인했다.
3.3 모델링
3.3.1 손실함수 평가
손실함수실험1. Focal, Lovasz
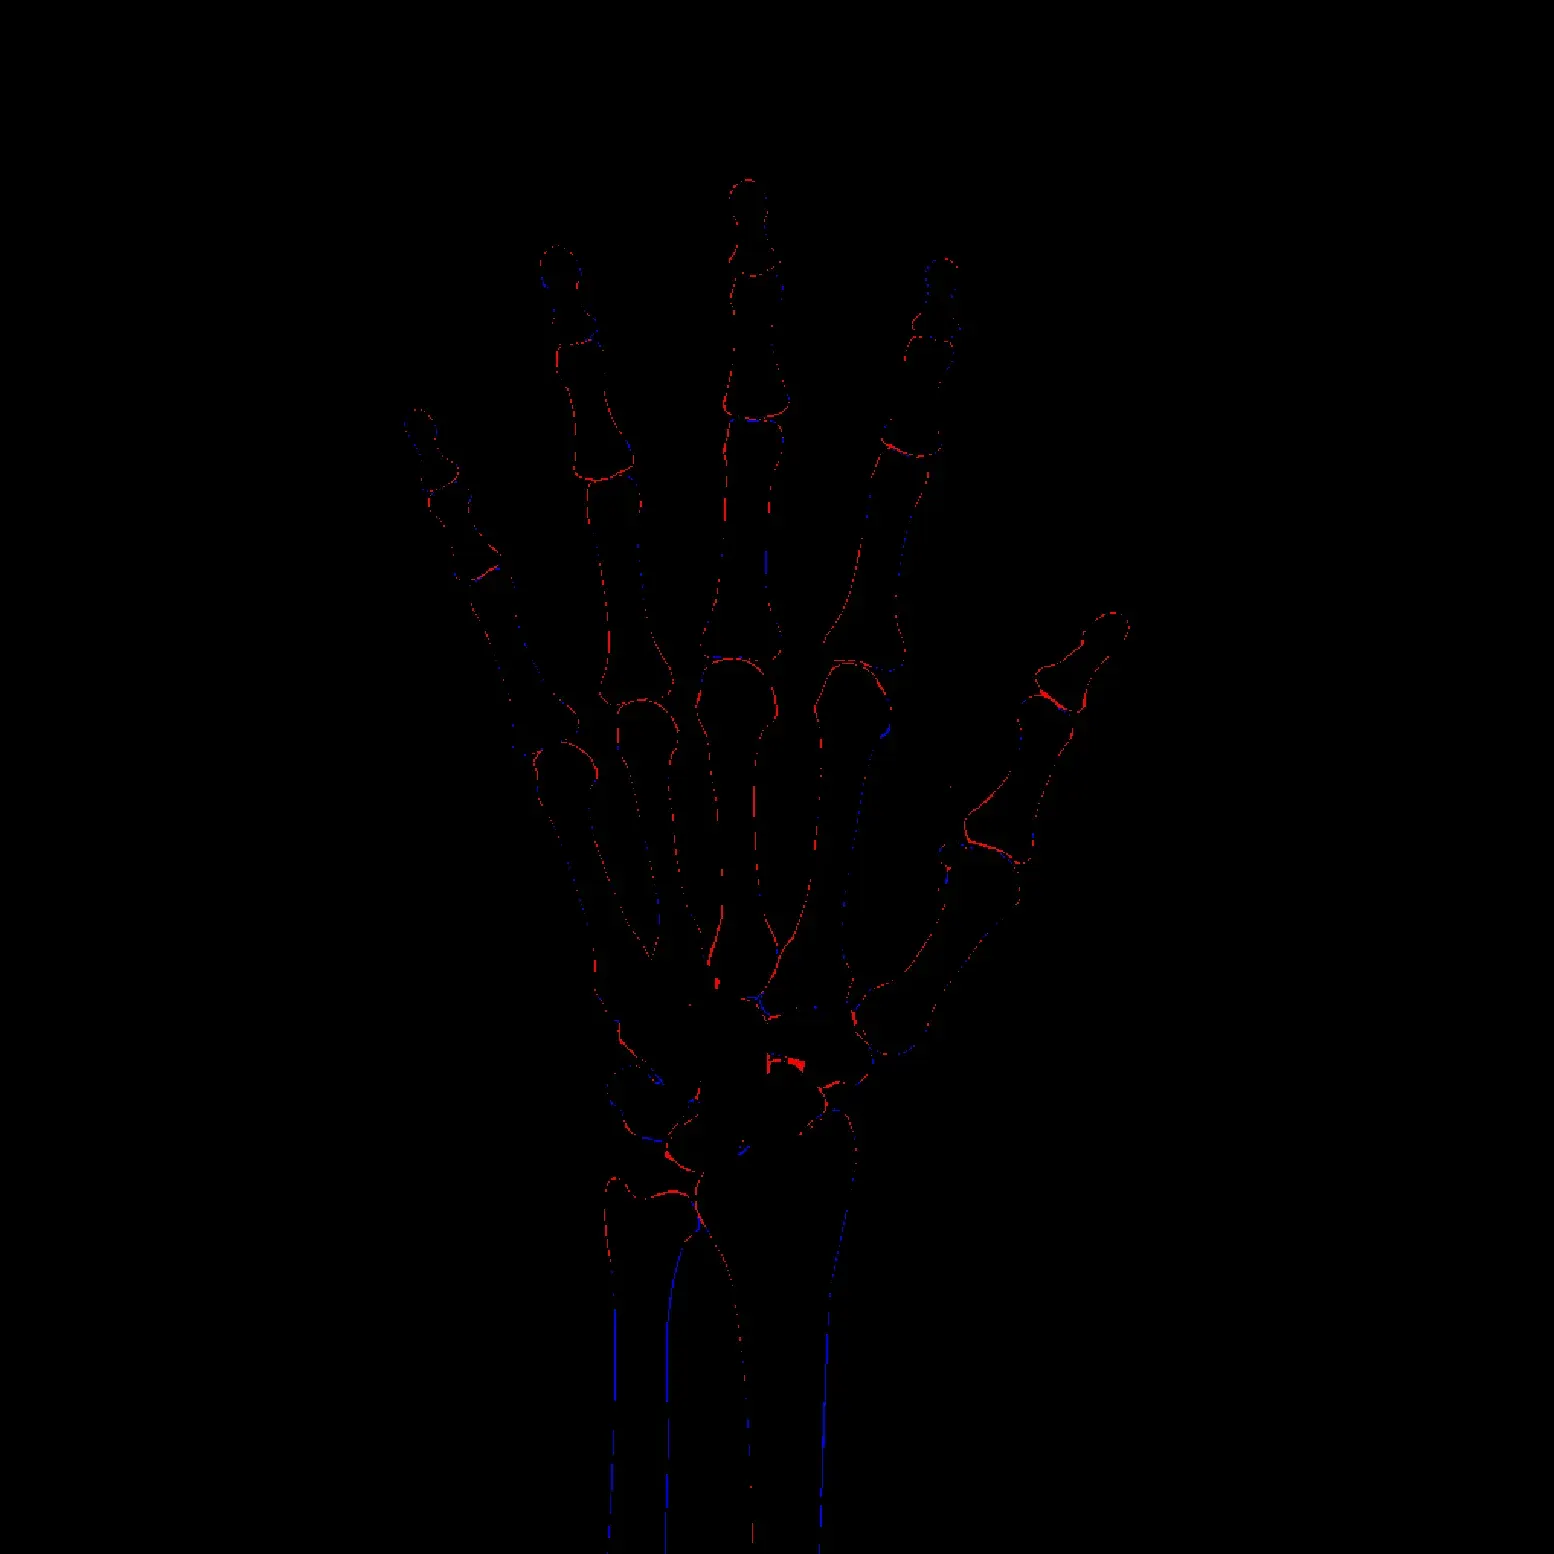
FP(빨간색)와 FN(파란색)을 시각화(bce5 dice5)
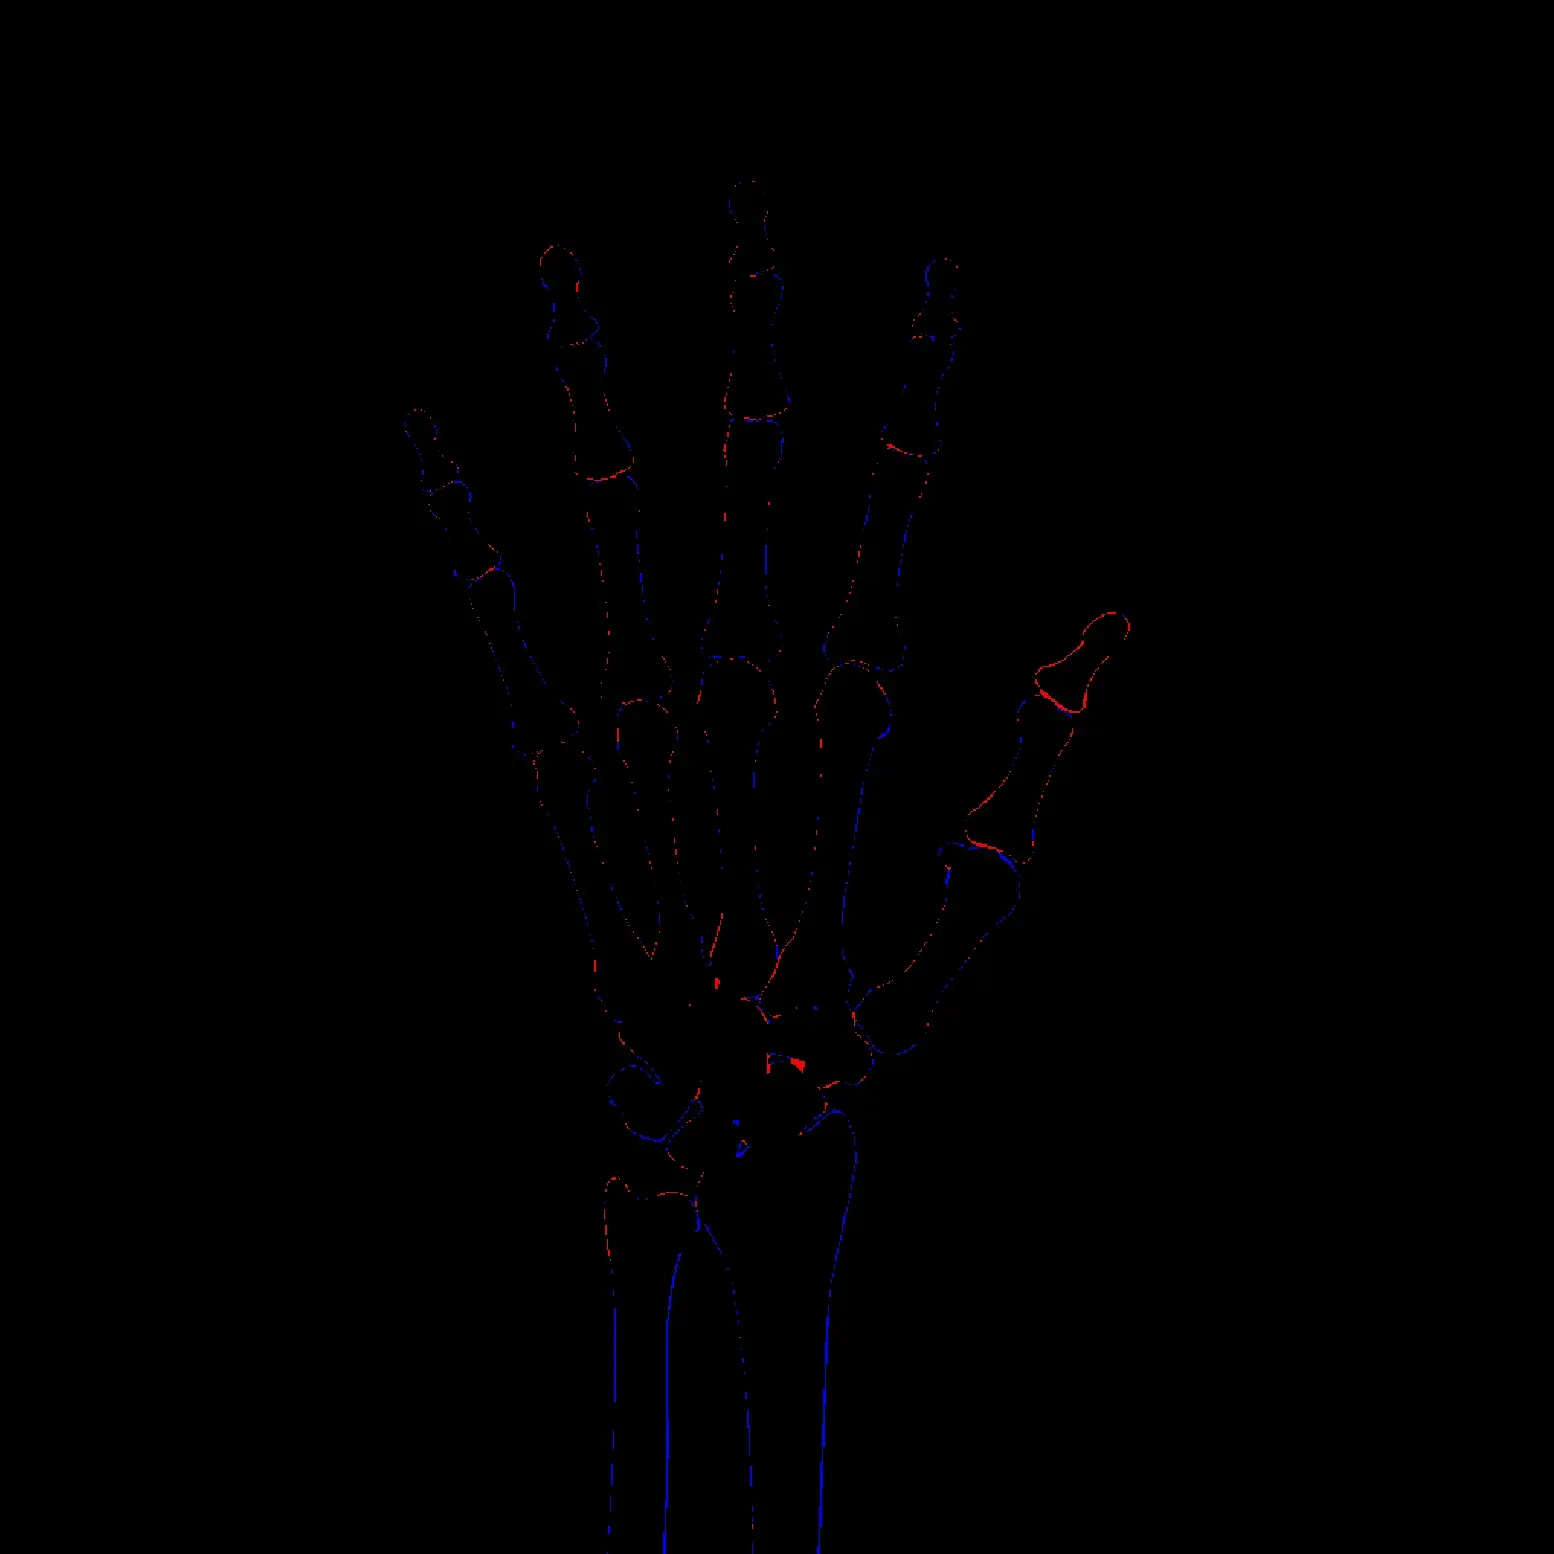
bice 3 dice 4 lovasz 3
시각화 결과 거의 모든 뼈에서 테두리 부분에 False Positive가 몰려있는 것을 관찰할 수 있다. 이는 모델이 비교적 넓은 부위인 뼈의 내부는 잘 잡아내는 반면, 흐릿하고 모호한 뼈의 테두리는 잘 잡아내지 못하는 것을 알 수 있다.
모델 시각화 과정에서 알게된 False Positive 픽셀의 개수를 줄이기 위해 Lovasz Loss를 적용하는 실험을 진행하였다. 시각화 결과 뼈의 테두리와 중첩되는 뼈에서 FP가 많이 검출됨을 확인했고 손실함수를 통해 해결할 수 있다는 가설을 세웠다.
두 사진을 비교해보았을 때, Lovasz를 적용하여 때 기존 BCE 5 dice 5를 적용한 모델 대비 FP(빨간색)의 개수가 눈에 띄게 줄어든 것을 확인할 수 있다. 그러나 Score를 비교해보면 0.967 → 0.961로 Lovasz를 적용했을 때 0.006가량 하락했다.
이는 Lovasz를 적용함으로써, 모델의 경계를 보수적으로 잡아 오히려 탐지하지 못하는 부분이 늘어나서 결론적으로 Dice의 성능을 하락시킨 것 같다. 결론적으로 Lovasz를 사용한 것이 FP를 줄이는데에 기여하였으므로, BCE, Dice, Lovasz의 비율을 조정하여 최종 Score 도 올릴 수 있는 최적의 비율을 찾기위해 실험을 지속하였다.
2-Stage에 Lovasz loss 적용
Lovasz Loss는 어느정도 학습된 모델에 최종적으로 FP를 줄이기 위해 사용하면 효과가 나타날 것이라는 가설 하에 BCE 3 + Dice 4 + Focal 3으로 50 epoch 학습된 모델의 Pretrained Weight를 활용하여 2-stage 모델에 Dice 5 + Lovasz 5를 적용하여 학습을 진행했다. 실험 결과 1-Stage로 사용된 모델보다 Validation score가 0.0003 하락하여 유의미한 성능 향상의 결과를 얻지 못했다.
- Focal Loss
뼈가 겹치는 곳은 해당 픽셀이 A뼈인지 B뼈인지 모델이 헷갈려해서 Confidence가 낮을 것이라는 가설을 세웠다. 따라서 Confidence가 낮은 지점(겹치는 곳)의 분류를 더 잘 수행하기 위해 Confidence가 낮은 곳에 더욱 강한 Loss를 적용하는 Focal Loss를 도입하였다. 실험으로 (BCE 5, Dice 5), (Bce 4 Dice 2 Focal 4), (BCE 3 Dice 4 Focal 3)으로 비교해보았고, 가장 평균 Dice가 높고, 손목 뼈에서도 Dice가 높았던 (BCE 3 Dice 4 Focal 3)를 최종적으로 선택하게 되었다.
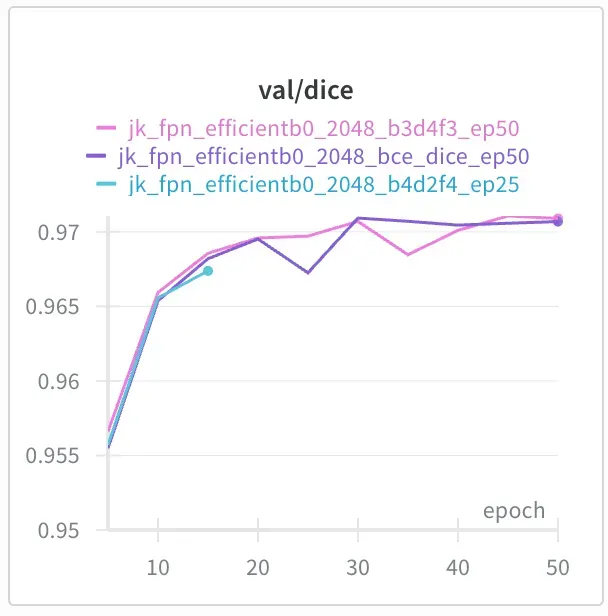
BCE3 Dice4 Focal3(핑크) 결과가 가장 높음을 확인했다.
손실함수 실험2. bce + Lovasz, tversky, Boundary Loss
실험2에서는 stage를 2개로 나눠서 첫번째 stage에서는 bce_dice를 사용해서 0.95 이상의 val/dice를 갖는 Weight을 구축했고, 두번째 stage에서 첫번째 stage의 Weight을 가져와서 다양한 loss를 조작해보며 실험하는 방식으로 진행했다.
Dice는 영역기반 Loss로 어느정도 객체를 잘맞추면, 즉 전체예측에서 오차의 비중이 낮아지면 학습율이 낮아진다. 이와 다르게, Lovasz는 IoU기반이긴 하지만, 오차가 큰순으로 정렬해서 가장 오차가 큰 틀린 픽셀들에 대해서 큰 가중치를 부여한다. Lovasz를 이용해서, stage1의 높은 dice score를 유지하면서, 일부의 오차를 해결할것으로 기대하고 실험을 진행했다.
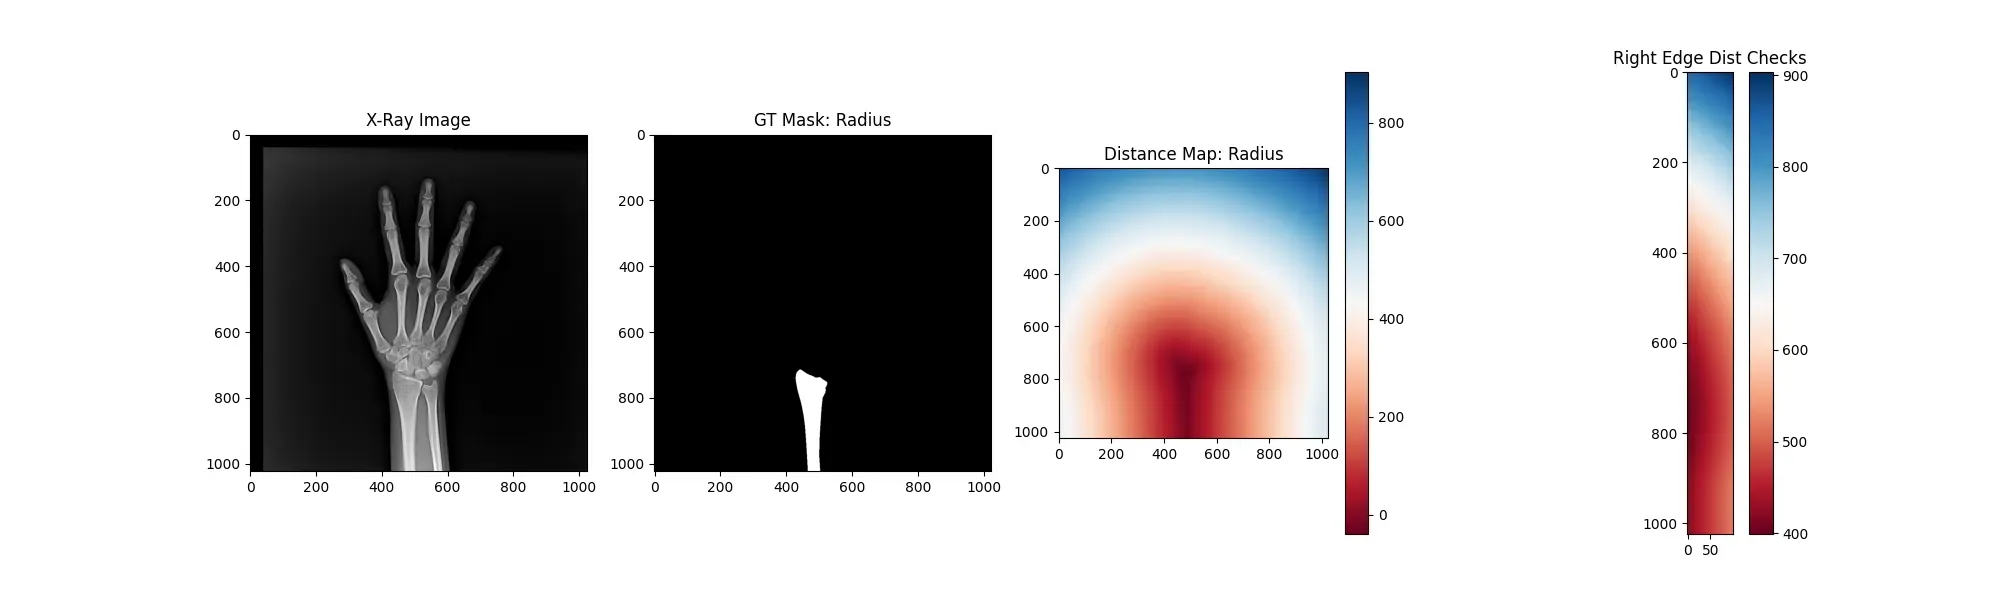
Boundary Loss의 distance_map시각화
Boundary Loss는각 뼈 Class마다 Ground Truth를 기준으로 경계선에서 멀어질수록 큰 Loss를 부여한다. IoU를 기반으로 하는 Lovasz나 Dice를 기반으로 하는 Dice, 각 픽셀의 정답유무를 기준으로 하는 BCE와 달리, 객체의 경계선을 기준으로 하는 Boundary Loss를 도입함으로써, 손등은 물론, 손가락 뼈 마디의 경계를 더 잘 예측할 수 있을것이라고 가설을 수립하고 실험을 진행했다.
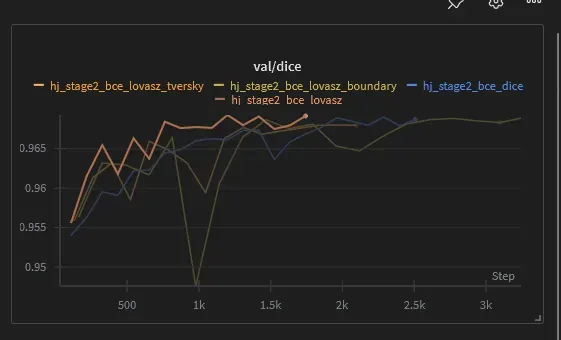
bce+Lovasz(연갈색)로 Finetuning한 결과가 가장 성능이 높음을 확인했다.
bce_lovasz: 베이스라인보다 높은 성능을 확인했다. 하지만 여전히 손등의 겹친 뼈가 많은 영역에서는 과소예측을 통해, 손등뼈는 잘 예측해내지 못하는것을 확인했다. 실험결과 베이스라인(bce_dice) 대비 가장 높은성능(0.9692)을 보였다.
bce_lovasz_tversky: 과대예측하는 손등뼈 클래스는 $\alpha$를 키워서 FP를 줄였고, 과소예측되는 손등뼈 클래스는 $\beta$를 키워서 FN을 줄이도록 노력했지만, bce_lovasz에 비해 성능향상은 없었다.
bce_lovasz_boundary: Boundary Loss를 추가했지만, Lovasz에 비해 크게 성능향상을 보이진 않았다.
3.3.2 EMA(Exponential Moving Average), PointRend
- EMA
배치 사이즈가 1~2로 매우 작아 학습 과정에서 가중치의 변동 폭이 크고 불안정한 문제가 있었다. 이를 해결하기 위해 EMA기법을 적용하였다. 학습 중인 모델 가중치의 이동 평균을 별도로 저장하여 이를 최종 추론 모델로 사용하는 방식으로, 이는 매 스텝마다 서로 다른 시점의 모델들을 앙상블하는 효과를 낸다. EMA 모델은 학습 데이터의 노이즈에 덜 민감하며, 손실 곡면(Loss Landscape) 상에서 Flat Minima에 수렴하도록 도와 일반화 성능을 높였다.
- PointRend
모델이 가장 헷갈려하는 경계면(Uncertain Region)의 품질을 개선하기 위해 PointRend 모듈을 도입하였다. PointRend는별도의 MLP를 통해 객체 경계의 픽셀을 정밀하게 보정한다. 이를 통해 객체 경계에서의 계단 현상없이 벡터 그래픽 수준의 날카로운 경계면을 얻을 수 있었으며, 이는 Dice상승에 직접적으로 기여하였다.
EMA, PointRend 적용 후 Public score: 0.9728로 0.9697에 서 0.0031증가
3.3.3 LR Scheduler
- CosineRestartWarmupScheduler
Public과 validation score간의 점수차이가 모델마다 들쭉날쭉하고, 최소 0.003차이가 났기 때문에, 모델이 Local Minima에 수렴한것으로 가정했다.
따라서 Cosine Restart Warmup Scheduler를 사용함으로써 베이스라인으로 사용하던 cosine annealing, Linear LR과는 다르게, Local Minima에서 탈출할 수 있다고 가설을 세우고 실험했다.
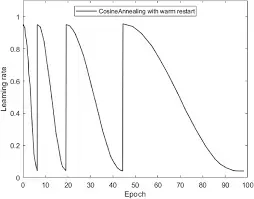
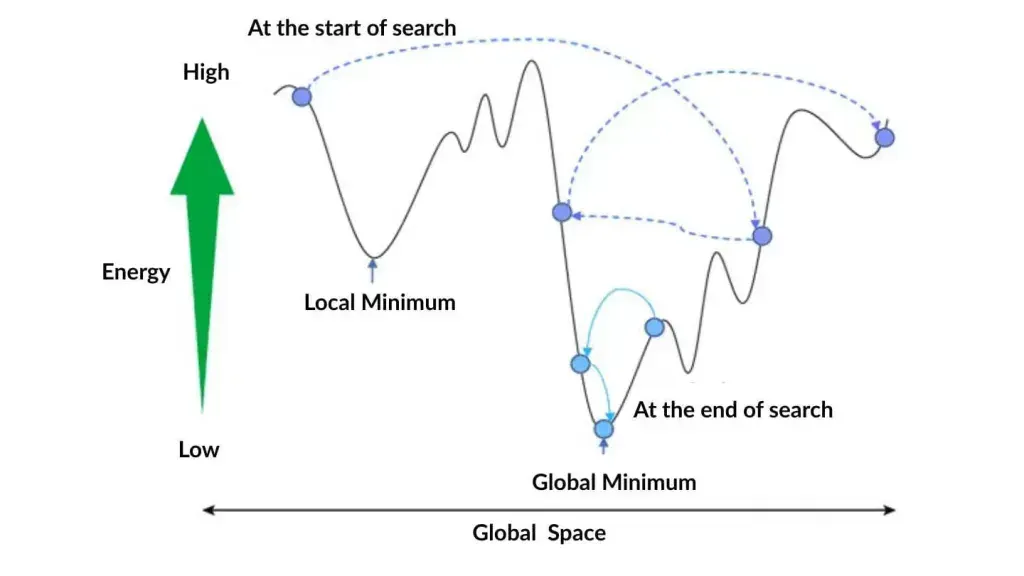
CosineRestartWarmupScheduler를 사용함으로써 Public/valid score간의 점수차이가 0.0028로소폭 하락함을 확인했다.
3.3.4 input 해상도와 모델사이즈간의 관계
Batch Norm에서 GroupNorm으로 바꾼 이후로 배치사이즈를 줄여도 안정적인 학습이 가능해졌다. 가능한 인풋 해상도를 높이고, 백본사이즈에서 타협을 하는게 좋겠다고 판단했다. On the Effect of Image Resolution on Semantic Segmentation 논문에서 주장한바처럼, 백본 사이즈를 줄이더라도, Input 해상도를 최대한 키우는게 성능향상에 도움이 될것이라고 가정했고, Input해상도를 OOM이 뜨지 않는 한 최대한 높여서 이후 실험을 진행했다.
3.4 단일 모델 실험 및 결과
모델실험은 이전의 실험결과에서 효과가 있었던 방법들을 적용하여, 다양한 인코더, 디코더 조합을 사용해서 각자 진행함.
3.4.1 모델실험1
- 다양한 아키텍처 비교 실험 진행. 최종적으로 Mask R-CNN (ConvNeXtV2) 선정.
| Model | Backbone | 비고 |
|---|---|---|
| Unet++ | EfficientNetV2-L | 최종 베이스 모델 선정 (Exp55_v3). 가장 높은 성능 달성. |
| SegFormer | MiT-B4 | 빠른 수렴(50 epoch)과 준수한 성능(Dice 0.9645), 학습 속도 우수. |
| Unet++ | MobileNetV2 | 경량화 모델 실험. 학습 속도는 빠르나 정확도 면에서 V2-L에 비해 열세. |
| Unet | ConvNeXt | Multi-scale Attention 적용 시도. Swin 대비 효율적이나 최종 성능은 낮음. |
3.4.2모델실험 2
- HRNet
- Mix Vision Transformer (mit)
- ConvNeXt V2
| 모델명 | Validation Score |
|---|---|
| hrnet_w18 | 0.9570 |
| hrnet_w32 | 0.9581 |
| hrnet_w48 | 0.9595 |
| mit_b2 | 0.9523 |
| mit_b3 | 0.9552 |
| mit_b4 | 0.9571 |
| convnextv2_tiny | 0.9532 |
| convnextv2_base | 0.9538 |
⇒ 0.1 보다 0.5 일 경우, 더 높은 성능을 보임
⇒ 사전 학습 가중치가 x-ray 이미지에 적응이 필요한 것으로 해석됨
- convnextv2와 2가지 decoder(FPN, UNET) 조합 확인
- 2가지 사이즈에서 동일한 결과를 보일 줄 알았는데 예상과는 다름
tiny의 경우, fpn과의 조합이 더 좋은 성능을 보임 (+0.0045)base의 경우, UNET과의 조합이 더 좋은 성능을 보임 (+0.0021)
- 2가지 사이즈에서 동일한 결과를 보일 줄 알았는데 예상과는 다름
| ConvNeXt V2 | FPN | UNET |
|---|---|---|
| convnextv2_tiny | 0.9670 | 0.9625 |
| convnextv2_base | 0.9685 | 0.9706 |
의료영상 데이터에 특화된 monai 라이브러리의 swin unetr 모델 scratch로 학습 기대한만큼 성능이 나오진 않았다.
3.4.3 모델실험 3
- SegFormer : 0.9665
- 이전 데이터 전처리 단계에서 효과를 본 실험들 간단하게 점검 : 모델 변경 + 나머지 그대로 vs 모델 변경 + 전처리 + 증강
- 학습 안정화 : gradient accumulation, gradient clipping, cosine annealing, ema 개별 적용 후 결과 확인
- ConvNeXt + UperNet : 0.9747
- 이전 데이터 전처리 단계에서 효과를 본 실험들 간단하게 점검 : 모델 변경 + 나머지 그대로 vs 모델 변경 + 전처리 + 증강
- 높은 Dice 점수 확인 후, 5-Fold 학습
3.4.4 모델실험 4
우선 주어진 베이스라인 코드에서는 해상도 512가 적용되어있었다. 하지만 원본 이미지의 크기인 2048을 512로 압축하는 것은 정보 손실이 발생하여 성능 하락의 주요 원인이 될 것이라고 보았다.
실제로 아래의 표는 베이스라인 모델에서 클래스별 Dice Score를 오름차순으로 정리한 결과인데, 상대적으로 크기가 작은 뼈인 손등 뼈와, 손가락 끝 뼈(finger 4, 8, 12, 16)이 모두 순위권 상단을 차지하고, 크기가 큰 뼈인 팔목 뼈(Ulna, Radius)는 모두 하위권을 차지하는 것을 볼 수 있다. 이로 인해 작은 객체를 탐지하는 능력을 보완하는 것이 중요하다는 것을 깨달았고, 512로 이미지를 압축하여 정보가 손실되는 것은 더욱 치명적일 것이라고 생각되었다.
또한 이미 베이스라인의 Dice 점수는 0.94로 높은 점수인 상황이기에 경계선의 디테일을 보존하는 것이 성능을 향상시키는 주요한 원인이 될 것이라고 보았고, 따라서 굳이 파라미터가 많은 무거운 모델을 사용하여 해상도를 낮추는 것 보다는, 적은 파라미터 수를 가진 모델을 활용하여 이미지를 최대한 완전하게 보존하는 방향을 선택하였다.
모델 실험
아래 표는 Loss와 Optimizer, Learning Rate, 해상도 2048, 배치 사이즈 2 등 통제 변인을 갖추고 Backbone과 Decoder를 다양하게 조합하며 실험한 결과이다. 고해상도의 이미지 Input을 입력하고도 OOM이 발생하는 것을 방지하기 위해 경량 모델인 MobileNet과 EfficientNet 위주로 탐색하게 되었으며, 예외적으로 EfficientNet-b4 모델에는 해상도 2048, 배치 2로 학습을 시작할 때 OOM이 발생하여 배치 사이즈를 1로 두고 실험을 진행하였다. 실험 결과 Backbone으로 EfficientNet-b0를 사용하는 것이 가장 높은 성능이 나타나는 것으로 확인 되었다.
뛰어난 모델은 적은 epoch에서도 높은 성능을 띌 것이라 생각하여 MobileNet-v3 + LRASPP와 EfficientNet-b4에서는 초기 성능이 낮아 실험을 중단하였는데, 학습 후반에 급격한 성능이 향상되는 모델의 가능성을 배제하고 성급하게 단정했다는 점이 아쉽고, 이는 차후 실험에서는 모델을 탐색할 때 충분한 epoch를 설정해서 보완해야 한다고 생각되었다.
| Backbone | Decoder | ep10 dice | ep50 dice | loss | 배치 |
|---|---|---|---|---|---|
| MobileNet-v3 | DeepLab-v3 | 0.9607 | 0.9639 | bce + dice | 2 |
| MobileNet-v3 | LRASPP | 0.9596 | x | bce + dice | 2 |
| EfficientNet-b0 | PAN | 0.9299 | 0.9626 | bce + dice | 2 |
| EfficientNet-b0 | FPN | 0.9652 | 0.9706 | bce + dice | 2 |
| EfficientNet-b0 | Unet++ | 0.8210 | 0.9713 | bce + dice | 2 |
| EfficientNet-b4 | FPN | 0.9528 | x | bce + dice | 1 |
Decoder 실험
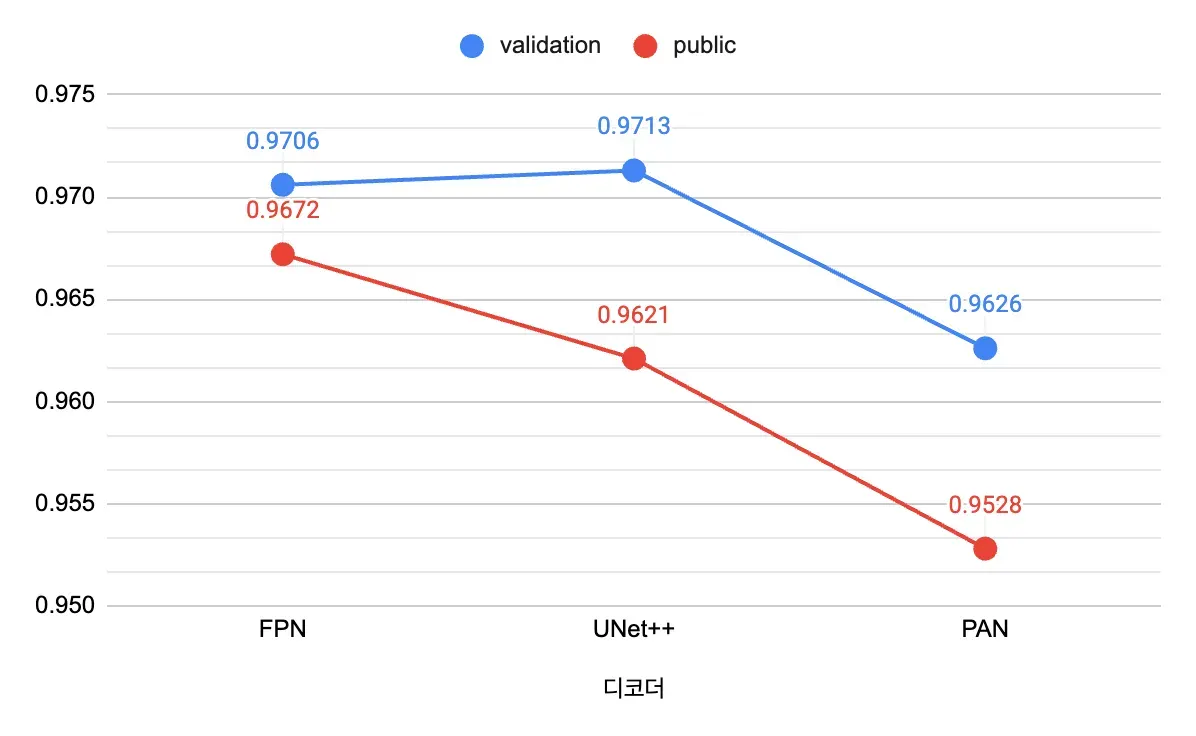
Backbone을 EfficientNet-b0로 고정한 뒤 디코더를 FPN, UNet++, PAN로 교체하며 실험을 진행하였다. 아래 그래프를 보았을 때 UNet++의 Validation 점수가 가장 높았으나 Public 점수는 0.01가량 큰 폭으로 하락한 것을 확인할 수 있다. 반면 FPN의 경우, Validation 점수는 UNet++보다 낮았지만, Public에서 약 0.003으로 소폭 하락하여 public에서 최종적으로 가장 높은 성능을 나타내는 것을 확인할 수 있다.
이론적으로 UNet++은 복잡한 Skip Connection이 적용되어 풍부한 Feature Map을 활용하기 때문에 FPN보다 높은 성능을 띌 것이라고 예상하였고, 실제로 Validation에서는 높은 성적을 띄었지만 Public에서는 크게 점수가 하락한 점에서 의문이 들었다. 이러한 의문점에 대해 다음과 같은 두 가지 가설을 세웠다.
- UNet++ 모델 복잡도에 의해 Train 데이터에 과적합 되어서 Public에서는 좋지 못한 성능을 띄었다.
- 스케쥴러 미사용으로 인해 Local Minima에 수렴되었다.
결론적으로 이론과 실험의 차이에서 어떤 디코더를 사용해야할 지에 대한 고민이 되었지만, 현재 데이터셋에는 실험적으로 입증한 FPN이 더욱 우세할 것이라고 판단되어 최종 모델에도 FPN을 적용하게 되었다.
성능 향상을 위한 모델 실험
최종적으로 성능 향상을 위해 해상도 2048, 배치 사이즈 2를 수용 가능하면서 가능한 OOM이 발생하지 않으면서 GPU 사용량을 최대화할 수 있는 모델을 탐색하게 되었다. Backbone은 기존 EfficientNet-b0 모델에서 파라미터수가 더 많아 정교한 Feature Map을 추출할 수 있는 EfficientNet-b3와 ConvNeXtv2-base 모델로 교체할 수 있었고, 실험 결과 EfficientNet-b3 모델에서 0.0005 더 향상되었다. 따라서 최종 모델로 Backbone에는 EfficientNet-b3 모델을, Decoder는 FPN을 선택하게 되었다.
| Backbone | Decoder | ep50 dice |
|---|---|---|
| ConvNeXtv2-base | FPN | 0.9723 |
| EfficientNet-b3 | FPN | 0.9728 |
최종 모델은 여러 실험적으로 얻은 결과중 성능 향상이 있었던 방법론들만 적용하였으며, 최종 Private Dice 0.9729을 달성하였다.
| Decoder | FPN |
|---|---|
| Backbone | EfficientNet-b3 |
| 해상도 | 2048 |
| 배치 | 2 |
| epoch | 50 |
| Loss | bce 3 dice 4 focal 3 |
| Scheduler | Cosine Warmup(ratio 0.1) |
| Optimizer | AdamW |
| Learning Rate | 0.0001 |
| Augmentation | Elastic, Resize(2048) |
3.4.5 모델실험 5
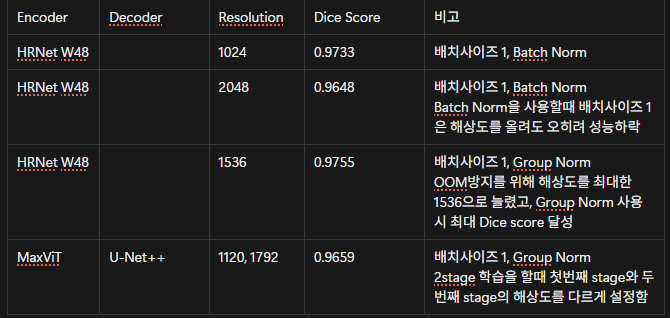
2개의 Stage로 나눠서 학습 진행
- 첫번째 Stage에서는 20epoch로 Dice를 안정시키는것을 목적으로 함
- bce_dice를 이용해서 빠른 수렴
- bce(0.5) + dice(0.5) + pointrend(0.5)
- 두번째 Stage에서는 80Epoch로 FineTuning을 목적으로 함
- bce_lovasz를 사용해서 Hard Example에 대해서 Finetuning
- bce(0.5) + dice(0.5) + pointrend(1.0)
- Point Render의 Weight를 0.5에서 1로 올려서 경계에 대해 더 많은 학습
3.5 모델 앙상블
앙상블을 할 때 단순 여러 모델의 Confidence를 평균내는 Simple Average 앙상블 방법을 써야할 지, 모델마다 가중치를 두는 Weighted 앙상블 방법을 써야할 지에 대한 고민이 많았다. 모델에 가중치를 두는 방법을 보통 선택해왔으나 고민이 되는 이유는 일단 모든 모델에서 대체적으로 점수 차이가 0.01 미만으로 미미하고, 앞으로 하게될 앙상블 모델 조합이 다양해 비록 점수는 낮더라도 다른 부분에서 강점을 보일 수 있기에 Seight를 주는 기준을 세우기가 모호하였다. 따라서 전체 모델에 같은 가중치를 두는 Simple Average Soft Voting 방법을 선택하게 되었고, 아래는 시도해보았던 앙상블 목록이다.
| 앙상블 이름 | Private dice score |
|---|---|
| 최종 단일 모델에 5-fold soft voting | 0.9736 |
| Cross validation Ensemble | 0.9624 |
| 인코더, 디코더 diversity soft voting | 0.9745 |
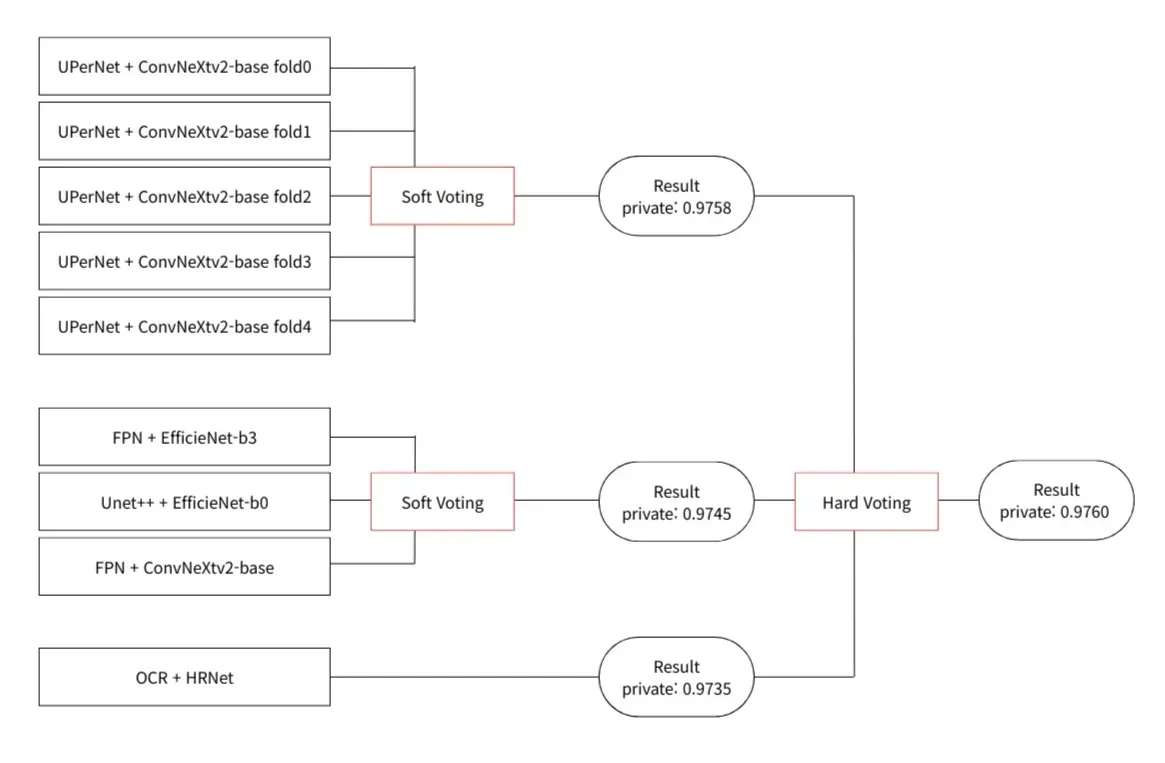
| Top 3 hard voting | 0.9760 |
최종 단일 모델에 5-fold soft voting
전체 학습 데이터를 학습하여 모델의 넓은 시각을 확보하기 위해 K-fold 앙상블을 시도하였다. 개인 최종 모델인 FPN + EfficientNet-b3 모델을 5-fold Soft voting한 결과 private 기준 Dice 0.9729에서 0.9736로 단일 모델로 제출했을 때 보다 0.0007 상승한 것을 확인하였다.
Cross Validation Ensemble
특정 폴드에만 과적합 되는 것을 방지하기 위해 다른 fold를 학습한 각 모델들을 Soft Voting 앙상블 하였다. 앙상블에 사용된 모델 조합은 아래와 같다.
제출 결과 Private Score 0.9624로 다른 앙상블 제출 내역보다 점수가 약 0.01정도 큰 폭으로 하락한 것이 확인되었다.
| fold 번호 | Decoder | Backbone | val dice |
|---|---|---|---|
| fold 0 | OCR | HRNet | 0.9755 |
| fold 1 | UNet++ | EfficientNetv2-L | 0.9733 |
| fold 2 | FPN | MiT | 0.9730 |
| fold 3 | FPN | EfficientNet-b3 | 0.9735 |
| fold 4 | UPerNet | ConvNeXtv2-base | 0.9737 |
| 모델 | private dice |
|---|---|
| UperNet + ConvNextv2-base 5-fold soft voting | 0.9758 |
| FPN+Efficientnet-b3 / Unet++ +Efficientb0 / FPN+ConvNeXt-v2 soft voting | 0.9745 |
| OCR + HRNet 단일 모델 | 0.9735 |
인코더, 디코더 Diversity Soft Voting
인코더와 디코더의 다양성을 확보하여 단일 모델의 구조적 편향을 막기 보완하기 위해 FPN+Efficientnet-b3 / Unet++ +Efficientb0 / FPN+ConvNeXt-v2 세 모델로 soft voting 앙상블을 진행하였다. Private Dice 0.9745를 달성하였으며 FPN+Efficientnet-b3 단일 모델 K-fold 앙상블한 모델의 점수와 비교했을 때 0.0009로 향상한 것을 확인할 수 있었다.
Top 3 Hard Voting - 최종 제출
Validation과 Public의 점수 차이를 방지하기 위해 리더보드 기준 상위 3개 모델의 csv 파일을 활용하여 Hard Voting 앙상블을 진행하였다. 사용된 모델은 아래와 같으며 최종적으로 Hard Voting하여 결과를 제출하였다.
앙상블하여 제출한 결과 Private Dice 0.9760로, 가장 점수가 높았던 UperNet + ConvNextv2-base 5-fold Soft Voting에 비해 0.0002 소폭 상승한 것을 확인할 수 있고, 가장 높은 Dice를 나타내어 최종 제출한 모델로 선정되었다.
K-fold 앙상블로 전체 데이터의 시각을 챙긴 모델, 여러 인코더와 디코더의 조합으로 특징 추출을 다양화한 모델, 그리고 추론 성능이 가장 좋았던 단일 모델을 활용하여 구조적, 다양성 측면에서 좋은 시너지를 내었다고 생각이 된다.
4. 프로젝트 수행 결과
4.1 최종성과
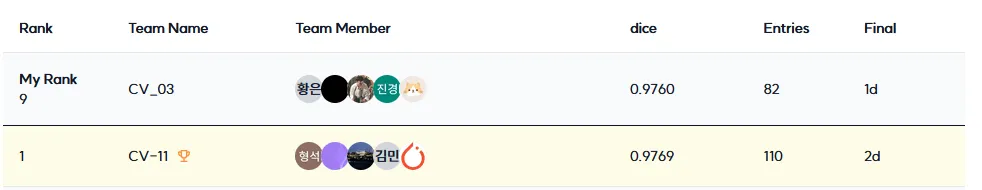
Public Score: 0.9749
Private Score: 0.9760
4.2 자체평가 및 회고
나는 내 학습목표 달성을 위해 무엇을 어떻게 했는가?
팀 프로젝트인 만큼 팀원들과의 협업을 통해 중복된 실험을 최대한 줄이려고 노력했다. WandB를 통해 서로의 실험 진행상황을 실시간으로 공유했고, Notion을 통해 실험 진행상황을 공유했다.
우선 지난 프로젝트인 재활용 쓰레기 Detection 프로젝트에서는 Data의 Annotation이 잘못된 경우가 많았었기 때문에, 최대한 EDA를 통해 이미지의 분포를 확인하고, FeatureEngineering과 Preprocessing을 통해서 데이터를 정제하려고 노력했다.
회전된 손이 test Dataset에서Traindataset에 비해 10배 많다는 사실을 확인했고, 그 사실을 확인하기 위해서 세끼손가락과 손목뼈를 잇는 벡터의 각도를 측정하는 로직을 이용했다. 그리고 성별에 따른 Mask Size의 상관관계를 확인하고, 이를 해소하기 위해 OverSamppling의 방법을 적용해보았다.
분포 불균형을 Oversamppling을 이용해서 해소해보려는 시도는 실패했지만, 분포간의 불균형을 시각화해서 확인했다는 점에서 지난 프로젝트에 비해 발전이 있었고, 변화되었다고 느꼈다.
그리고 최대한 객관적인 결과를 팀원들과 공유하기 위해서 나머지 변인들을 통제하고, 한개의 변인씩만 변경해가면서, 해당 변인의 효과를 증명해나가려고 노력했다. 실제로, 지난 Detection 프로젝트에 비해, 팀원들 모두 한개의 변인씩 실험한 결과를 공유해서 해당 기법이 효과가 있었는지 판단하기가 수월해졌다.
나는 어떤 방식으로 모델을 개선했는가?
데이터를 Preprocessing하고, 모델링측면에서 EMA, PointRend를 적용해서 모델성능향상에 기여했다. 특히 Input 이미지에서 이미지 주변의 흰색 노이즈를 제거한 결과, 초기성능향상을 관찰했고, EMA, Point Rend를 적용한 결과 0.0003이상의 Dice score향상을 관찰했다. 그리고 Public score와 Validation score사이의 차이는Local Minima에 수렴했기 때문이라고 가정했고, Cosine WarmUp Restart Scheduler를 사용한 결과 0.0001수준의 차이를 좁힐 수 있었다.
그리고 학습 후기에 모델의 손등부분의 Hard Example에 대해서 예측을 못함을 확인하고, Dice loss 함수를 Lovasz로 바꾸기 위해서 Stage1,2로 나누어서 Finetuning단계에서만 Lovasz Loss를 사용했다. 그 결과 bce_dice기준 0.0002 score가 향상함을 관찰했다.
모델의 성능개선을 위해서는 Input 이미지의 해상도를 높여주는게 제일 중요하다는것을 실험적으로 확인했다. Input이미지의 해상도를 향상시키기 위해 AMP를 구현해서 제한된 V-ram을 효율적으로 사용하도록 개선했다.
OOM으로 인해 배치사이즈를 키우는데 한계가 있어서, Group Norm을 구현했고, Batch Norm을 사용하던 기존의 방식에서 벗어났다. 그 결과 배치사이즈를 1로 설정한 다음 해상도를 키워서 학습할 수 있었고, 성능향상을 관찰했다.
마주한 한계는 무엇이며, 아쉬웠던 점은 무엇인가?
모든 방법들은 성능향상에 기여하지 않는다는 것이다. 특히 메타데이터를 이미지와 함께 임베딩해서 학습하도록 멀티모달 모델을 만들었었는데, 초반부에는 학습속도가 개선되었지만, 오히려 후반부에는 메타데이터가 Segmentation에 방해되는것을 관찰했다. 가능성을 실험해보는 차원에서 필요했던 실험이었지만, 성능향상이 실질적으로 내 task에서는 없는 기법도 많다는것을 알게되었다.
경진대회에서 0.0001점이라도 올리기 위해서는 라이브러리의 모델을 가져다 쓰는것으로는 부족하다는 것이다. 라이브러리의 모델을 가져다 쓰면 간단하게 코드 몇줄로 설정을 끝마치고 바로 사용이 가능하다. 그런데, 경진대회에서 점수를 조금이라도 올리기 위해서는 모델을 커스텀해서 사용해야한다. OOM을 줄이기 위해 인코더의 사이즈를 커스텀으로 줄인다거나, 인코더의 layer를 Freeze시켜보는등 다양한 실험이 필요하다. 따라서 인코더와 디코더 모델에 대한 이해를 바탕이 되어야만 고득점을 노릴 수 있다는것을 알게되었다.
5. Reference
- https://www.kaggle.com/competitions/siim-acr-pneumothorax-segmentation/writeups/dsmlkz-aimoldin-anuar-1st-place-solution-with-code
- On the Effect of Image Resolution on Semantic Segmentation<https://arxiv.org/pdf/2402.05398
- https://arxiv.org/abs/1703.01780>
- https://research.facebook.com/publications/pointrend-image-segmentation-as-rendering/
- https://arxiv.org/abs/1803.08494
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...