Week11-12_ObjectDetection_WrapupReport
WrapupReport
1. 프로젝트 개요
1.1 프로젝트 주제
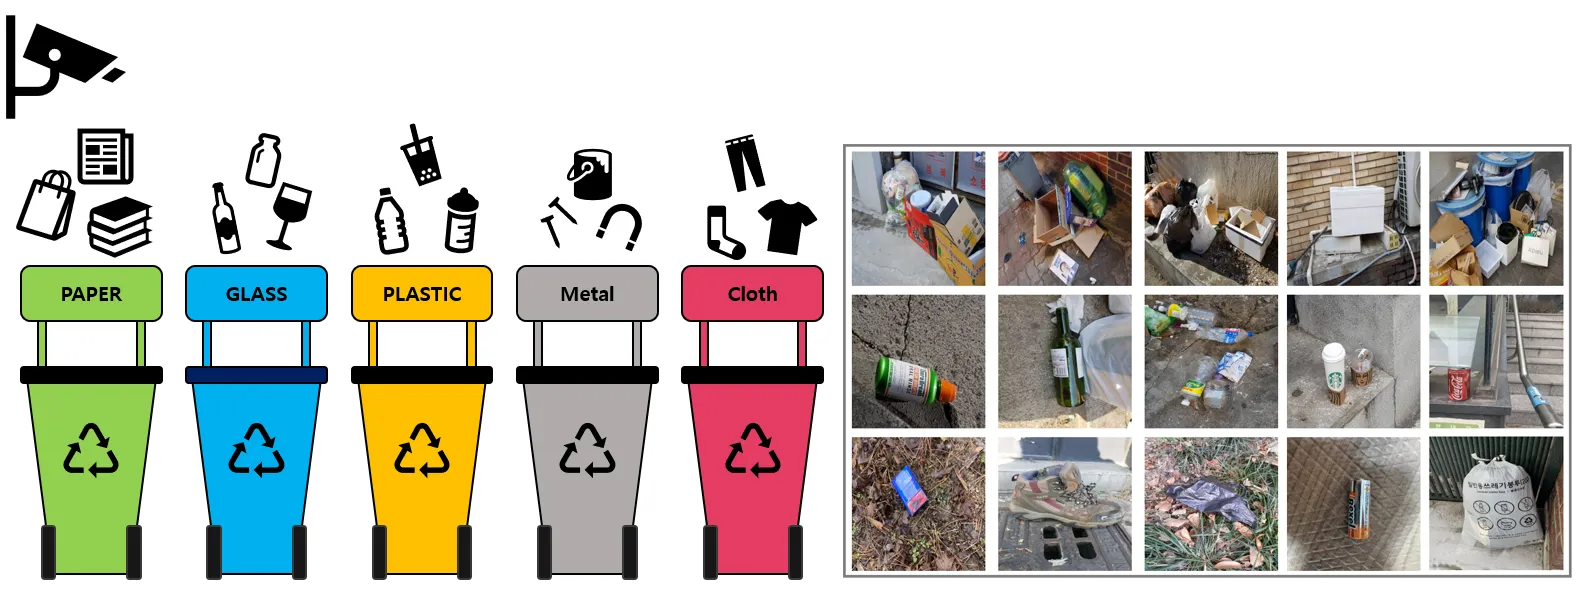
사진에서 쓰레기를 Detection 하는 모델을 만들어서 일반 쓰레기, 플라스틱, 종이, 유리 등 10 종류의 쓰레기가 찍힌 사진 데이터셋에서 Detection을 하는 분류모델을 개발
1.2 프로젝트 구현 내용
SOTA급 모델들을 이용하여, 주어진 데이터셋으로 Finetuning을 진행한 후 Detection을 수행한다. EDA, FeatureEngineering, 클래스 불균형 처리, 모델 앙상블등 다양한 모델 최적화 기법을 적용하여 최종 성능을 향상시킴
1.3 개발환경
H/W: Tesla V100 GPU 서버 3대
S/W: mmdetection, Ultralytics, Python, PyTorch, Pandas, Scikit-learn
실험관리: Wandb, Notion
1.4 데이터셋
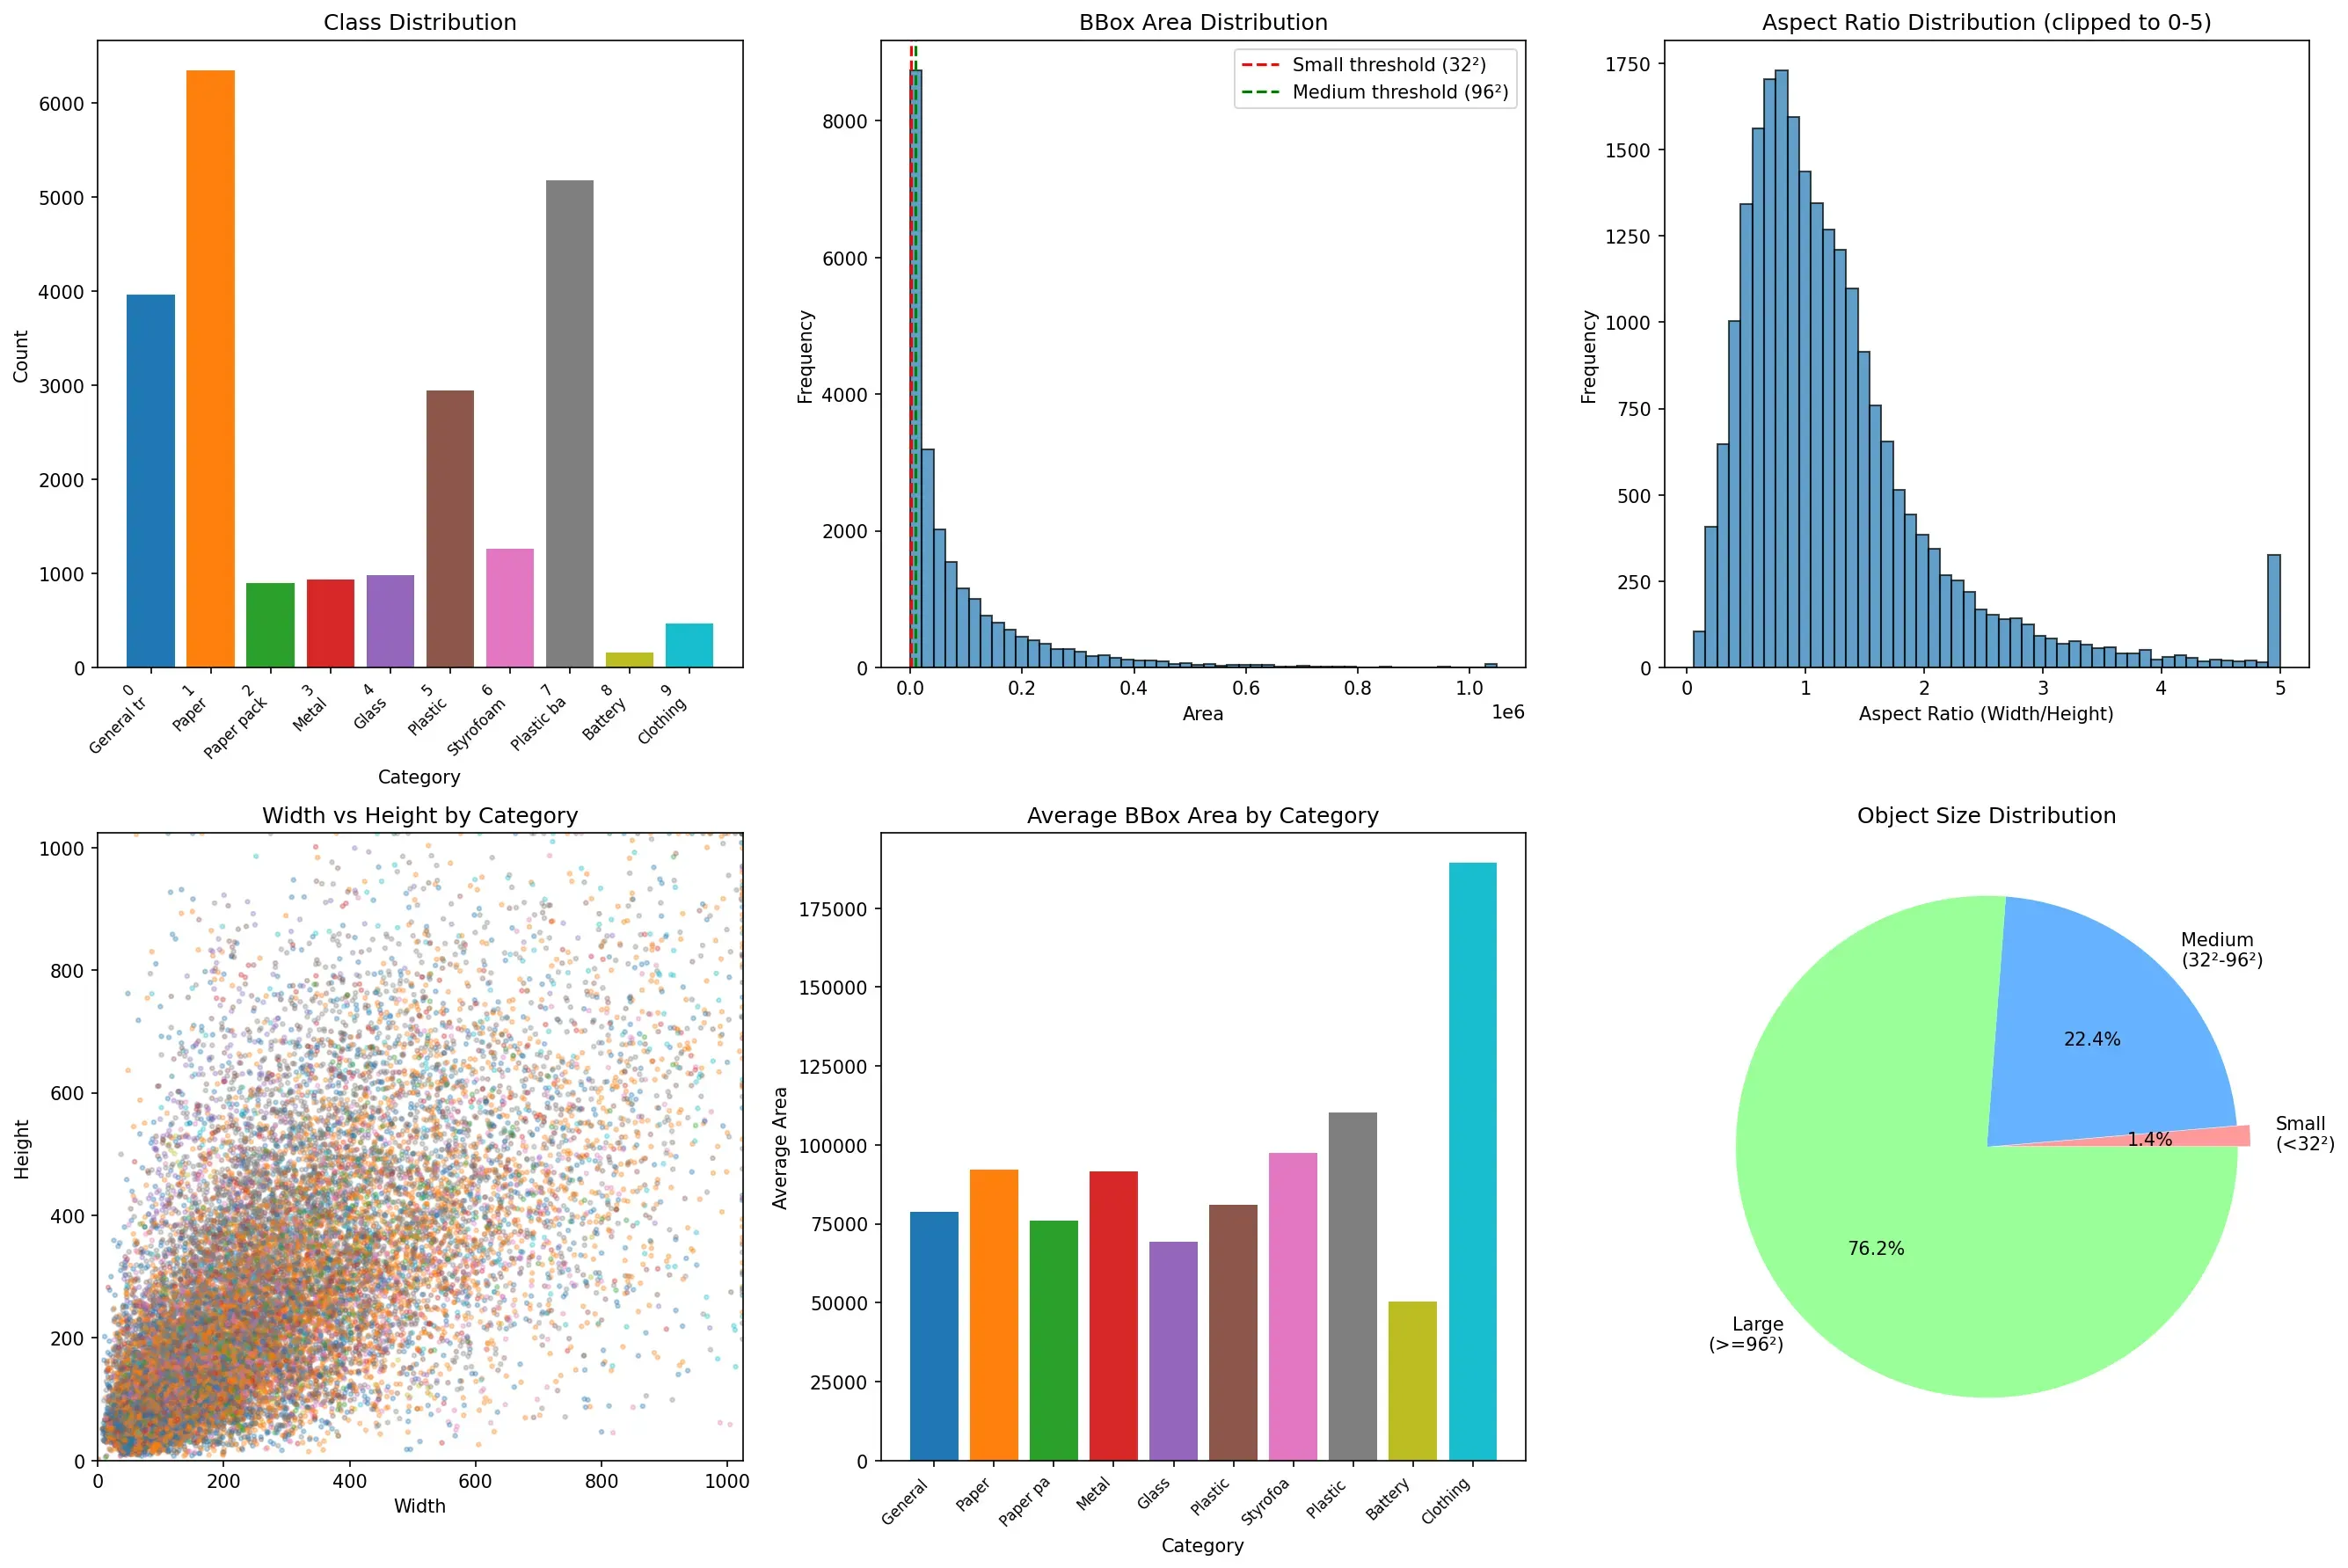
Train 데이터셋
총 이미지 수: 4883, 총 annotation 수: 23144, class 수: 10
Train 클래스별 분포
| Class | Number | Ratio |
|---|---|---|
| Paper | 6352 | 27.45% |
| Plastic Bag | 5178 | 22.37% |
| General Trash | 3966 | 17.14% |
| Plastic | 2943 | 12.72% |
| Styrofoam | 1263 | 5.46% |
| Glass | 982 | 4.24% |
| Metal | 936 | 4.04% |
| Paper pack | 897 | 3.88% |
| Clothing | 468 | 2.02% |
| Battery | 159 | 0.69% |
2. 프로젝트 팀 구성 및 역할
| 팀원 | 역할 |
|---|---|
| 노성환 | Group DETRv2 |
| 박상범 | EDA, RTMDet, Dino, Feature Engineering, NMS, WBF, TTA, 앙상블 |
| 안진경 | Cascade-ResNeXt101, Cascade-Swin-L, AdamW, Augmentation, Focal Loss, Confidence Thr조정 |
| 이가현 | EDA, Cascade RCNN, yolov13, mask RCNN, ConvNeXt, Augmentation, NMS, WBF, 앙상블 |
| 이혜준 | EDA, GroupStratifiedKFold, Augmentation, Dino-swin-L, Oversampling, Focal Loss, TTA, WrapUp Report 작성 |
| 황은배 | yolo, RT-DETR, EDA, Optimizer탐색(SGD, AdamW) |
3. 프로젝트 수행 절차 및 방법
각자의 베이스라인 코드를 가지고 실험한 후 마지막에 앙상블하는 전략을 사용함.
3.1 데이터 분석 및 증강
3.1.1 Faster R-CNN, Cascade R-CNN, Mask R-CNN
- Data Split: 클래스 불균형을 고려하여 Stratified Split 적용 (Train:Valid = 9:1). 학습 데이터 확보에 중점.
- Augmentation 실험
- 전체적으로 이미지의 형태가 가지런 하거나 좌우 구별이 필요없어 augmentation으로 다양한 각도에서도 feature를 볼 수 있도록 augmentation을 설정했다.
- baseline모델 중 pytorch fasterrcnn모델로 augmentation 시 많은 다양성이 보장된다면 성능이 높은지에 대한 실험을 진행했다.
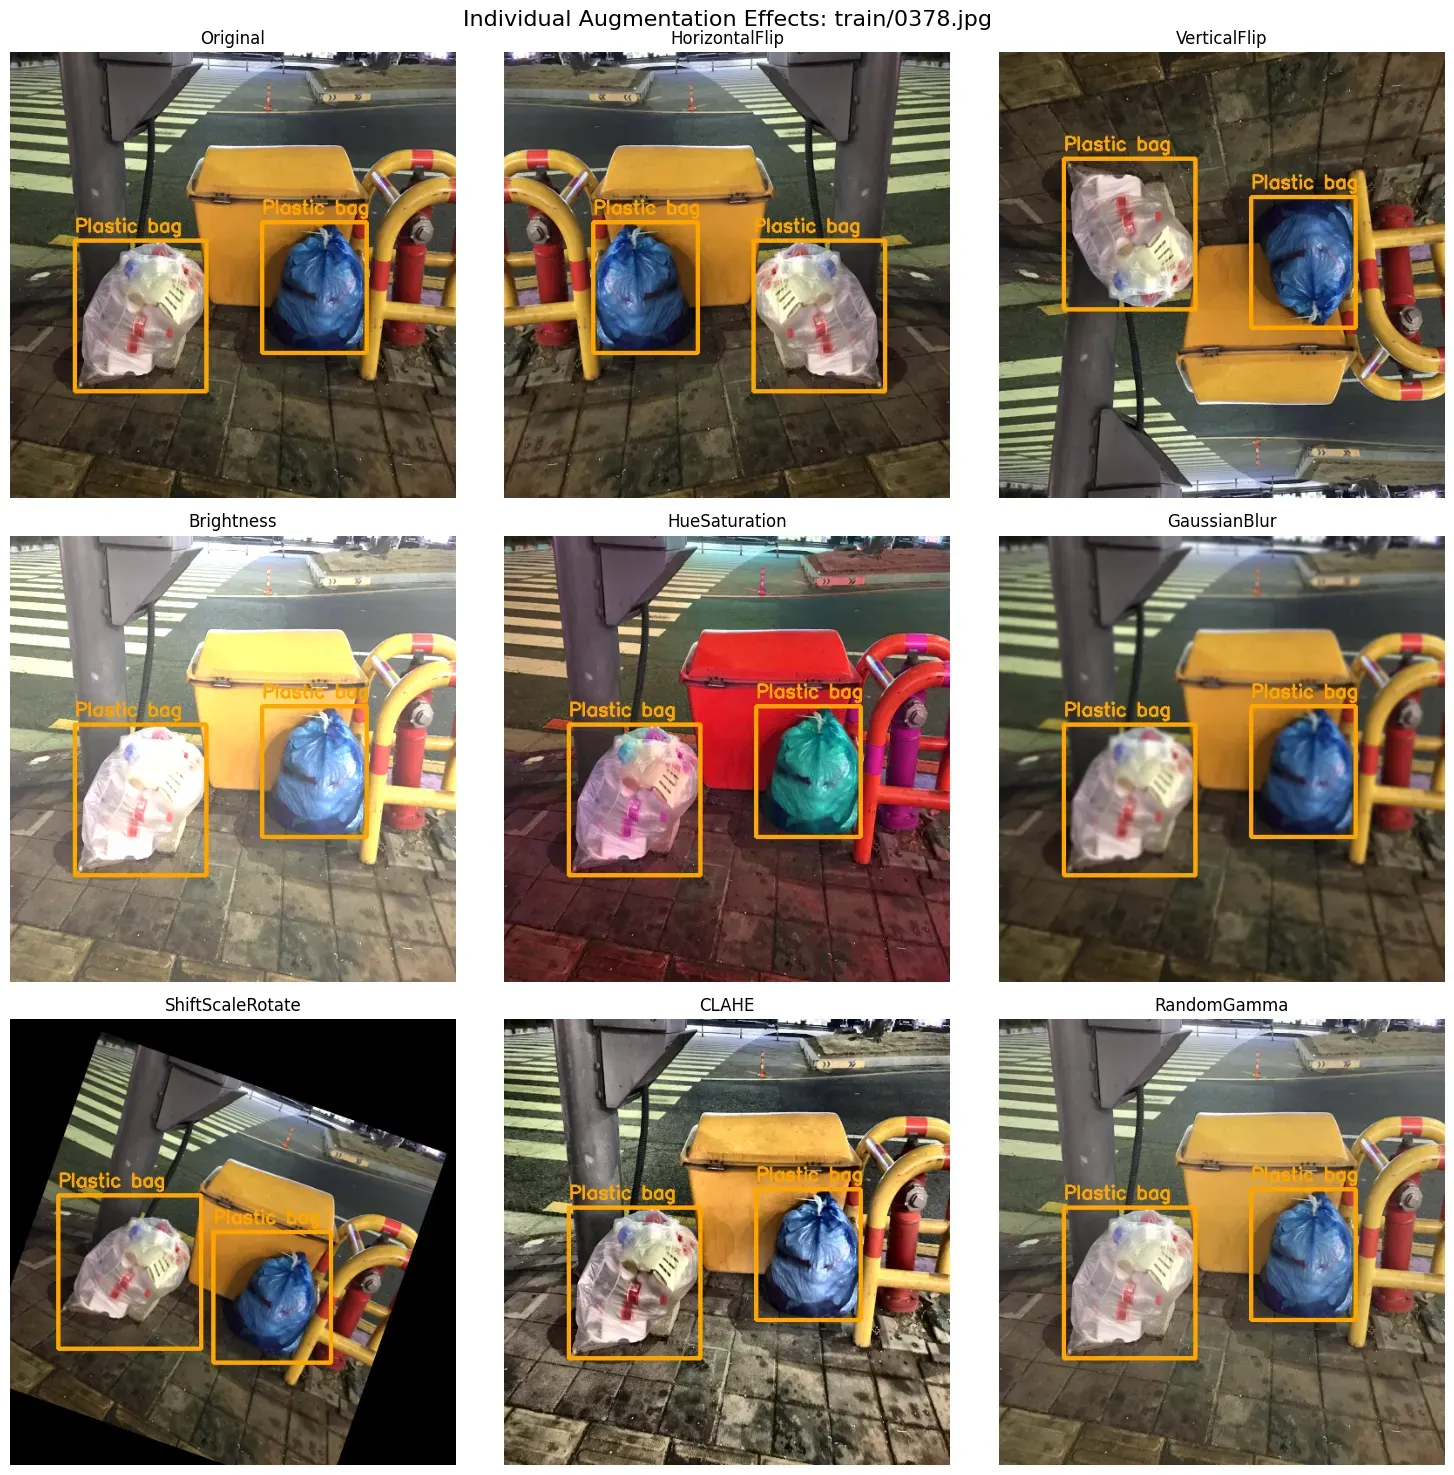
- (resize, HorizontalFlip, VerticalFlip, one of(RandomBrightnessContrast, HueSaturationValue, RandomGamma), one of(Blur, GaussianBlur, MedianBlur), ShiftScaleRotate, CLAHE, Normalize)에서 각 확률이 0.2인 것은 0.3으로 높였다.
- 기본(Flip, ShiftScaleRotate 등)에 강한 기법(RandomSunFlare, JpegCompression 등)을 추가했을 때 mAP가 0.4733 → 0.4629로 하락.
- 분석: 과도한 이미지 왜곡이 오히려 객체 고유의 특징(Feature)을 훼손하여 학습을 방해한 것으로 판단.
3.2.2 Dino-swin-L
train dataset은 Glass, Paper, Metal, Clothing, battery클래스에서 5%도 되지 않을정도로 클래스간 불균형이 크다고 판단했다. 따라서 train, validation데이터셋을 GroupStratified 5-Fold를 이용해서 나눠주었다.
그 결과 각 Fold별로 클래스가 골고루 포함되도록 Fold를 나눌 수 있었다.
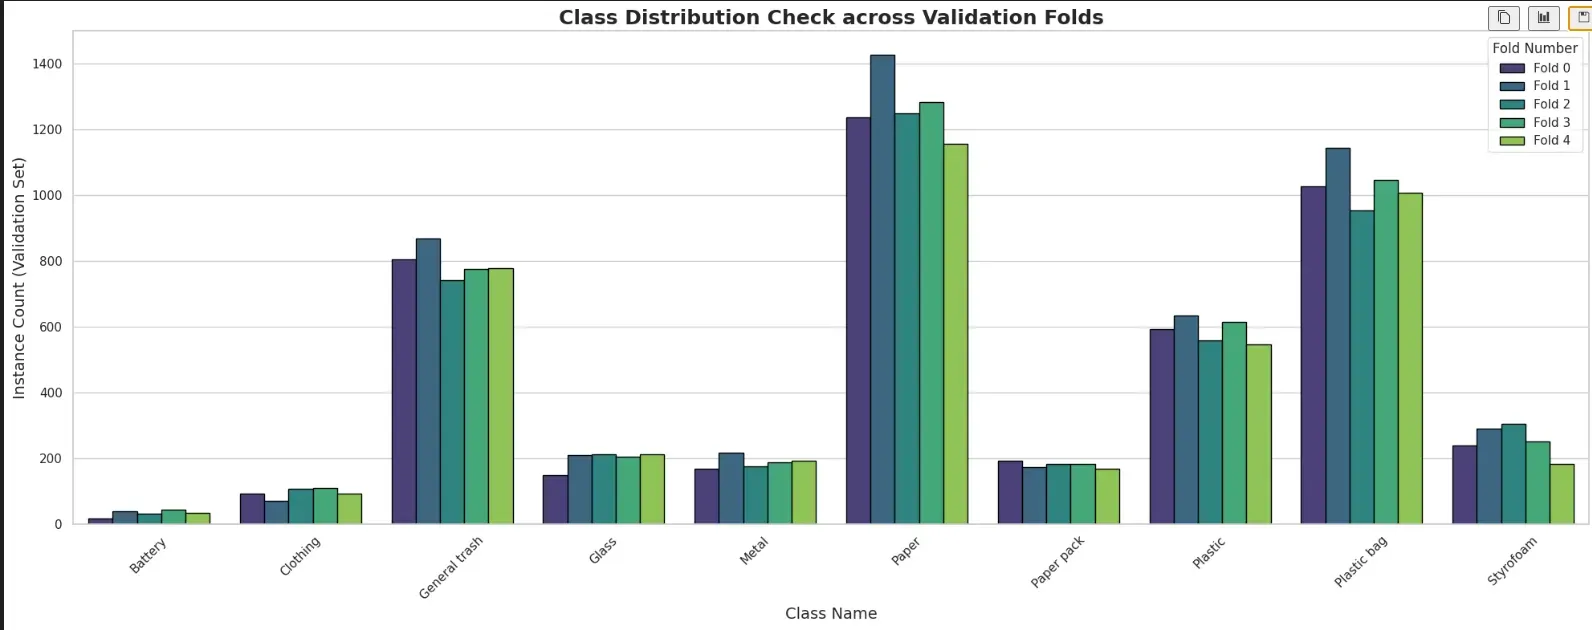
GroupStratified 5-Fold 적용결과
albu 라이브러리를 이용해서 pixel값과 관련된 Augmentation을 진행했다. 이미지 중간에 랜덤하게 구멍을 뚫는 CoarseDropout , 그리고 CLAHE, RandomGamma ,HueSaturationValue를 통해 대비, 휘도를 랜덤하게 조정했고, 밝기, 샤픈도 랜덤으로 조정해서 모델의 강건성을 갖도록 설정해줬다.
이 값들은 주피터 노트북 코드셀에서 사진을 직접 시각화하면서, 너무 변형해서 알아보지 못할정도인지 아닌지를 체크하면서 값들을 조정해주었다. 직관적으로 test dataset에서 나올법한 변형인지 아닌지를 눈으로 확인하면서 값을 조정했다.
MotionBlur랑 ImageCompression은 뺐는데, 오히려 객체의 Texture를 숨겨버려서 학습에 방해된다고 판단했다. 특히 모델은 Metal과 Plastic, Paper Class를 헷갈려하는 경향이 있었는데 블러, Compression을 시켜버리면 사람이 봐도 어려울정도로 객체의 질감을 뭉개버리는 경향이 있었다.
이와 반대로 IAASharpen을 통해 이미지의 샤픈을 랜덤으로 조정해줬는데 샤픈값을 랜덤으로 추가해서 객체의 질감을 더 살려주었다. 모델이 Classification하기 어려워하는 Metal, Plastic, paper사이의 texture를 명확하게 만들어주도록 기대했다.
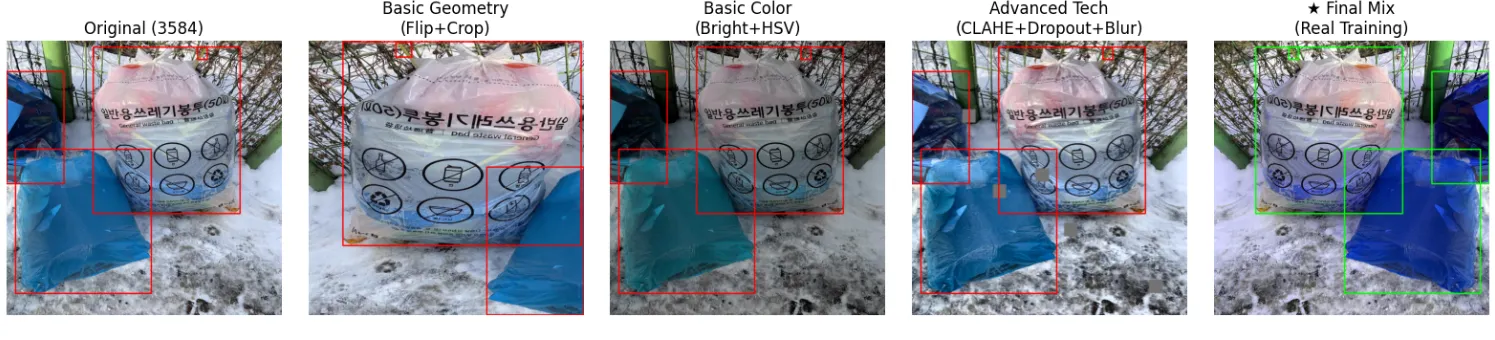 Augmentation 적용 결과
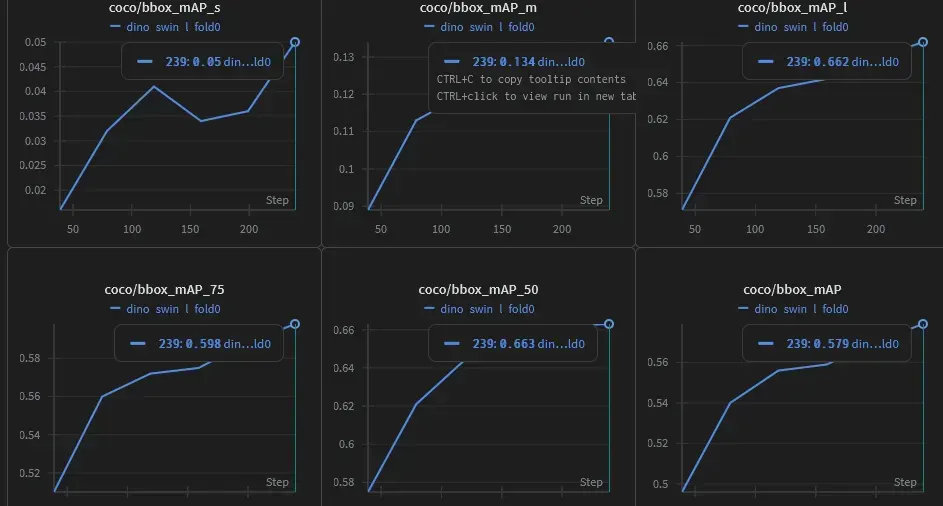
모델의 학습 결과를 보니 mAP_m과 mAP_s는 0.02도 안될정도로 아예 못맞추고 있음을 확인할 수 있었고 mAP_l이 거의 mAP50의 성능을 끌어올리고 있음을 확인할 수 있었다.
작은객체의 mAP를 높이기 위해서 이미지를 확대해서 모델에 넣어줘야겠다고 생각했다. RandomResize를 통해서 이미지를 2.5배까지 랜덤으로 확대해서 dataset으로 넣어주었다.
다양한 사이즈에서 mAP성능을 올리기 위해서 이미지를 우선 모자이크해서 사이즈를 1/4로 만들어줬다. 원래 매우 큰 박스에서의 객체는 1/4가 된다. 그리고 모자이크한 이미지를 0.8~1.5배로 리사이즈해서 모델에 넣어준다. 모델은 이로써 모자이크 후 리사이즈된 이미지를 보고 매우 다양한 크기의 박스를 보고 학습할 수 있게된다.
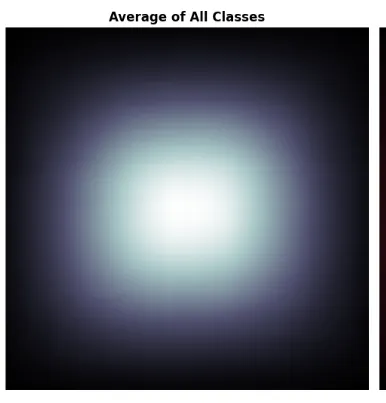
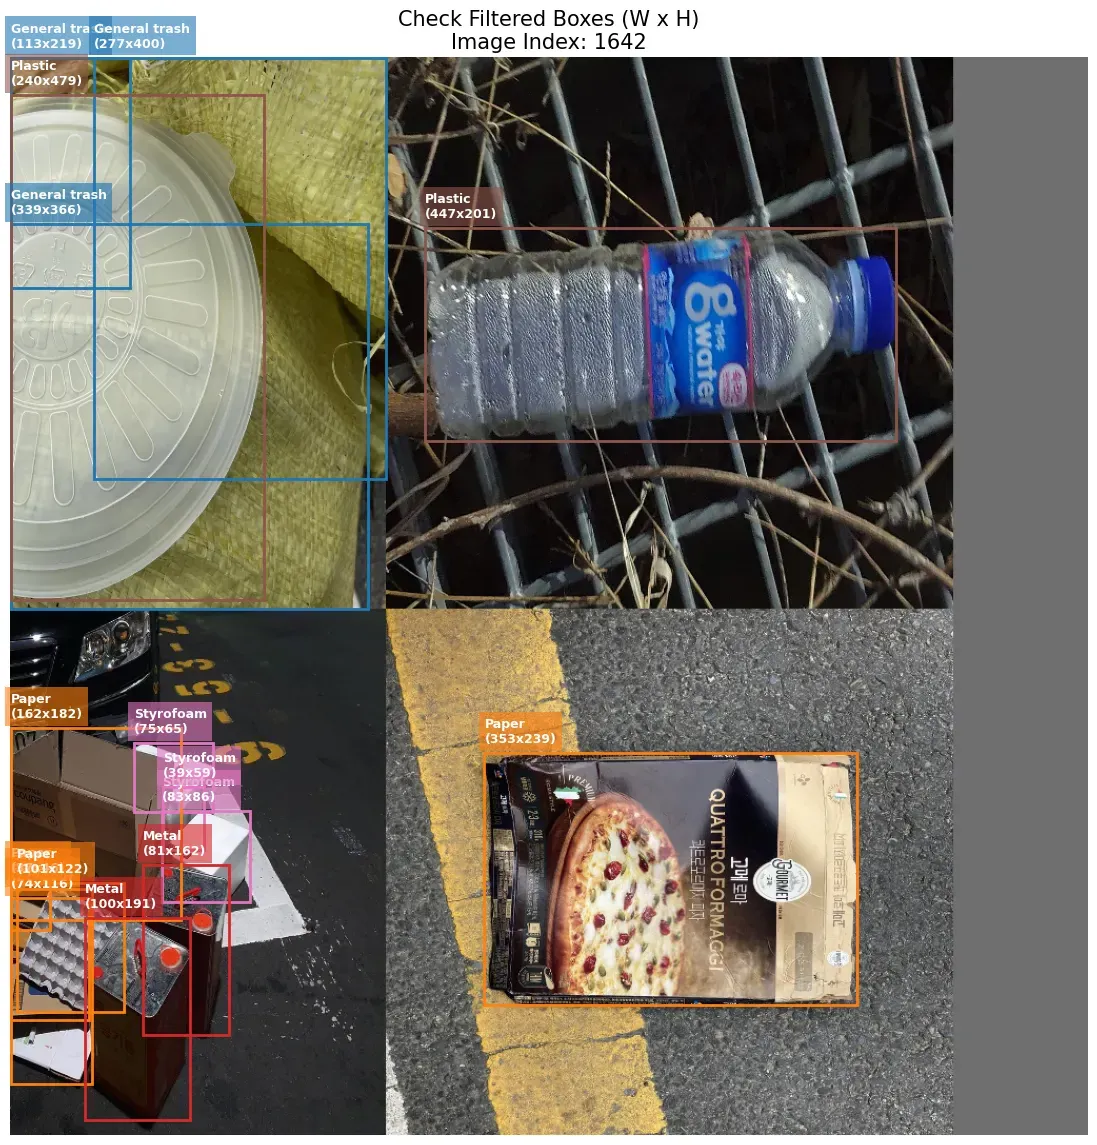
이와 더불어 모자이크를 통해, 서로 같이 자주 등장하지 않는 객체들도 랜덤으로 같이 등장할 수 있고, 사진의 중심부에만 위치하던 객체들이 가장자리에도 골고루 위치할 수 있게 되어 모델이 Robust하게 됨을 기대했다.
3.2 단일 모델 실험 및 결과
3.2.1 RTMDet

Soft NMS를 적용한 결과

NMS를 적용한 결과
- Stratified K-Fold
- TTA, NMS vs WBF 실험
- WBF보다 NMS를 이용했을때 더 높은성능을 관찰했고, Soft NMS보다 hard voting 방식의 NMS를 적용했을때 더 높은 성능(약 0.015향상)이 나옴을 관찰했다.
3.2.2 Dino-Swin-L

Augmentation이 적용되지 않은 기본 모델

Augmentation, Focal Loss, 오버샘플링이 적용된 모델

TTA(0.8배~1.5배 랜덤 리사이징)을 적용한 모델

Pseudo Labeling을 적용한 결과
- 12 epoch
- GroupStratified K-Fold
- 2stage 학습
- 첫번째 stage는 모자이크를 비롯한 Heavy Augmentation, 두번째 stage(마지막 2에폭)은 Augmentation없는 기본 이미지로 학습 진행
- Focal Loss 추가, 오버샘플링
- 클래스 불균형을 고려해서 소수클래스에 더 강하게 학습
Frozen stage = 2- 초기 백본을 얼리고, 뒷단의 layer만 학습진행
- 3으로 설정했을때보다, 1에폭부터 0.59를 달성하며 0.09 mAP50 향상을 관찰
- Heavy Augmentation
- CoarseDropout
- CLAHE, RandomGamma, HueSaturationValue
- IAASharpen
- 결과: 0.6560에서 0.6669로 성능향상을 관찰
- TTA실험
- 결과: TTA를 이용해서 추론한 결과 0.6349로 Public score가 감소하는 결과를 관찰했다.
- Pseudo labeling
- 결과: Pseudo Labeling을 적용한 결과 0.6059로 오히려 Public score가 감소하는 결과를 관찰했다.
3.2.3 Cascade R-CNN
- LinearLR에 비해 ConsineAnnealingLR 적용시 0.4366에서 0.5822로 성능향상
- backbone convnextv2로 교체
- Augmentation
- 너무강한 Augmentation을 적용시 0.4733에서 0.4629로 성능하락 관찰
3.2.4 Mask R-CNN

mask_rcnn모델(ConvNeXt v2)36에폭 실험결과

albu를 이용한 augmentation 이후 실험결과

5Fold Ensemble한 결과
- Cascade R-CNN과 동일
- 같은 세팅에서 Cascade R-CNN보다 더 나은 성능을 보임
- 36epoch과 47epoch을 비교해서 test해본 결과 0.6281에서 0.6174로 성능 하락 관찰 → 너무 많은 epoch은 오버피팅이 발생함을 확인
- K-Fold를 적용하여 10epoch씩 5Fold로 학습 진행 → 0.6420으로 성능향상
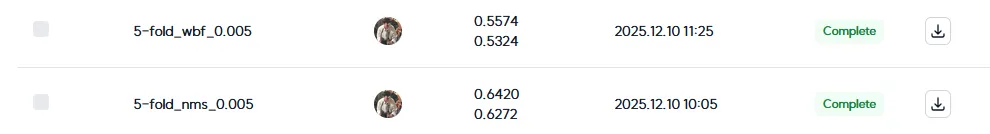
- WBF적용시 오히려 0.5574로 성능하락 관찰 → NMS방법 유지
3.2.5 RT-DETR
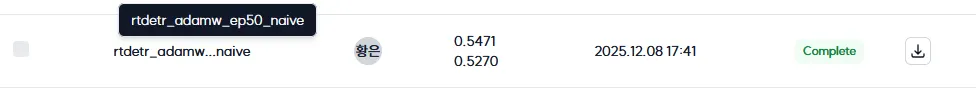



- optimizer 테스트
- 각 모델과 맞는 적절한 optimizer 사용이 성능에 중요함을 이해함
- YOLO → SGD
- RT-DETR → AdamW
- Scheduler 사용
- Cosine Annealing Learning Rate
- 학습 중/후반 과정 곡선의 완만한 감소로 인해 학습 안정성 상승
3.2.5 Yolo
- 더 최신 버전의 모델을 선택 (YOLOv3 → YOLO11)
- 적절한 크기의 모델을 선택 (YOLO11의
m,l,x중l을 선택) - 다양한 크기의 YOLO11 모델의 성능을 테스트
- 학습 데이터셋의 크기에 따라 적절한 크기의 모델을 선택해야 성능이 보장됨
- 2가지 optimizer(SGD, AdamW)를 YOLO 모델에 사용
- AdamW보다 SGD에서 성능이 잘나오는 것을 확인
- 모델 구조와 특성에 따라 적합한 optimizer가 존재한다는 것을 알게 됨
3.3 모델 앙상블
3.3.1 WBF vs NMS
일반적으로 NMS에 비해 WBF방식이 mAP성능 향상에 기여한다고 알려져있다. 이에, Mask-RCNN모델로 Confidence_Threshold 를 0.005로 둔 후 WBF와 NMS방식을 실험해본 결과 실험적으로 NMS방식이 더 좋은 성능을 보임을 확인했다.
3.3.2 모델앙상블


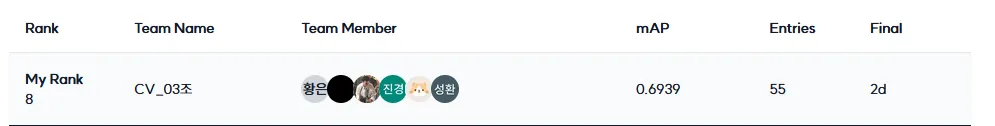
기존에 다양한 아키텍처를 기반으로 실험한 모델들을 앙상블했다. 아키텍처로는 Transformer 기반 Dino(Public score: 0.6669), 2stage모델인 Masked R-CNN 5fold 앙상블모델(Public score: 0.6420), 1stage모델인 RTMDet(public score: 0.6715)을 앙상블하여, 다양성을 갖도록 했다.
그 결과 각 모델의 mAP성능을 Weight로 준 Weighted_ensemble이 Public Score기준 0.6939로 가장 높은 성능을 달성했고, 마찬가지로 NMS방식을 사용하여 3개의 모델을 앙상블한 결과가 0.6927로 두번쨰로 높은 성능을 달성했다.
4. 프로젝트 수행 결과
Public score: 0.6939 (8위/13)
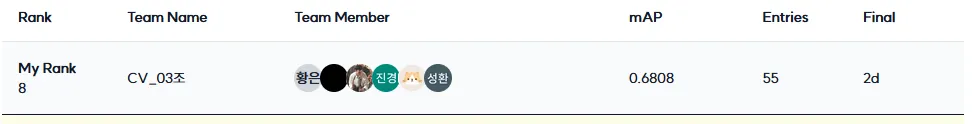
Private Score: 0.6808 (8위/13)
5. 자체 평가 의견
- 충분한 EDA 및 Feature Engineering을 하지못했다.
- 실험결과와 관련해서 팀원들과 왜그런 결과가 나왔는지 의견교환을 많이 해보지 못한게 아쉽다.
- 시간이 부족해 실험이 부족했다.
- 팀 차원에서의 계획 및 역할 분담이 구체적이지 못했다
- 학습보다 프로젝트의 점수를 올리는 방향으로 치우쳤던 것 같다
- 성능 올리는데만 집착하여 정확한 실험 분석을 토대로 데이터 증강 기법을 활용하지 못했던 것이 아쉽다
- 팀 협업 툴 활용 능력도 부족했다.
- 단순 점수(mAP) 높이는 것을 넘어 inference 시간에 대한 문제점도 같이 고민을 하여 더 많은 관점을 고민을 해볼 수 있었다.
- 가능성 있는 모델 확인 과정에서 너무 많은 시간을 소모하였다.
- 팀 차원의 컴페티션 대회가 어떻게 진행되는지 감을 잡을 수 있었다.
머신러닝 프로젝트의 전반적인 과정경험
Object Detection task를 프로젝트로 진행해보며, EDA, FeatureEngineering, Augmentation 탐색, SOTA 모델탐색, 실험 및 피드백의 일련의 과정을 경험해보았다. 특히 EDA를 해보며, 물체의 종횡비, 한 물체당 객체, 클래스의 개수, 클래스의 비율등 데이터셋이 갖고있는 특징들을 눈으로 확인해보고, 모자이크와 같은 기하적 증강, 밝기나, 휘도같은 픽셀적 증강을 적용해보며 mAP성능향상을 확인할 수 있었다.
그리고 DETR기반의 모델이 현재 성능상으로는 SOTA를 달성하고 있음을 확인할 수 있었고, 이번 프로젝트를 발판삼아 추후 프로젝트에서도 DETR기반 모델을 기반으로 모델 탐색 및 앙상블 전략을 수립할 예정이다.
충분한 EDA 및 Feature Engineering의 중요성
결과적으로 Heavy Augmentation을 통해 mAP성능 향상을 확인할 수 있었지만, 모델의 Pretrained된 COCO dataset과 재활용 쓰레기 데이터셋과의 차이점을 EDA해본 후 적절한 Augmentation을 골라서 실험해보는식으로 해보지 못한게 아쉬움이 남는다. 특히 TTA나 학습과정에서 이미지 리사이징을 해봤지만, 오히려 성능이 하락하는것을 보고, 그 원인을 찾지 못한게 아쉬움으로 남는다. 데이터셋의 특징을 조금더 파악해보고, 더 많은 실험적인 Augmentation을 하나씩 적용해본 다음에, 성능 향상 혹은 하락에 원인을 팀원들과 나눠보며 고민해보지 못한것이 아쉬웠다.
실험관리의 중요성
서버를 두명이서 공유해야하고, 2주라는 시간밖에 주어지지 않았으므로, 꼭 필요한 실험들을 중복되지 않게 했어야만 했다. 하지만, 팀원들간의 중복된 실험이 많았고, 최종과정에서는 사용되지 않을 모델들로 실험을 하는등 서버를 효율적으로 사용하지 못했다.
WandB를 slack과 연동하고, 깃허브를 이용해서 고정된 형식의 베이스라인 코드를 공유하 는등 팀원들과 명확히 역할분담을 하는것이 중요하다는것을 깨달았다.
어떤 프로젝트를 하던지, 혼자서 해낼 수는 없기 때문에, 실험관리를 하고, 팀원들과 의견을 나누며 유기적으로 프로젝트를 진행해나가는게 중요함을 알게되었다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...