Week10_AI개발기초_학습회고
AI개발기초_학습회고
목차
- 강의 복습
- 학습 회고
강의복습
1. 소프트웨어 엔지니어링과 AI 엔지니어링
1.1소프트웨어 엔지니어링이란?
소프트웨어 엔지니어링은 소프트웨어를 개발하는 전 과정에서 체계적이고 효율적인 방법을 사용하여 소프트웨어의 품질과 유지보수성을 보장하는 분야다. 단순히 코드를 작성하는 것을 넘어, 계획 → 요구조건 분석 → 설계 → 구현 → 테스트 → 유지보수에 이르는 소프트웨어 개발 라이프 사이클 전체를 다룬다.
소프트웨어는 프론트엔드, 백엔드, 머신러닝, 데이터, 게임, 보안 등 다양한 분야가 있으며, 각 분야에서 집중하는 문제와 기술 스택이 다르다.
1.2 좋은 소프트웨어 설계
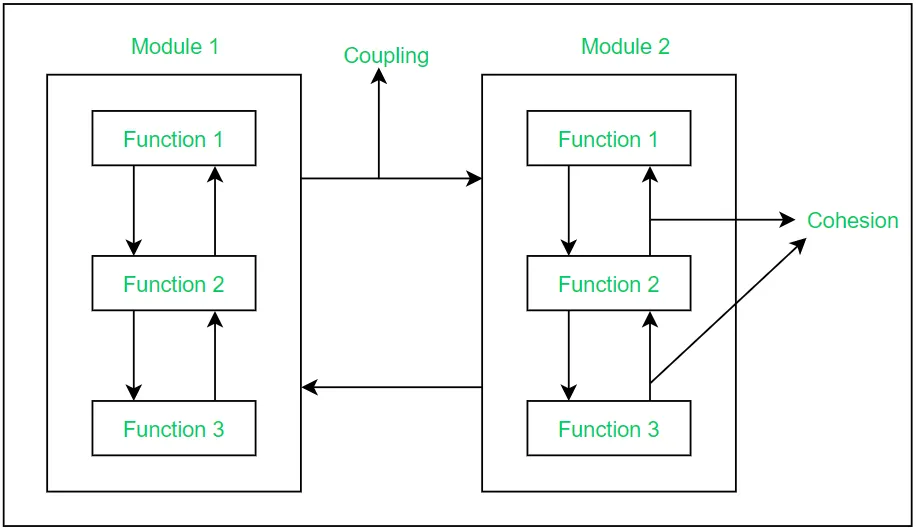
좋은 소프트웨어 설계는 유지보수가 쉽고 확장이 유연한 시스템을 만드는 것을 목표로 한다. 이를 위해 모듈성(Modularity), 응집도(Cohesion), 결합도(Coupling)와 같은 핵심 원칙을 이해하는 것이 중요하다.
https://www.geeksforgeeks.org/software-engineering/effective-modular-design-in-software-engineering/
모듈성(Modularity)
모듈성이란 큰 프로그램을 작고 독립적인 기능 단위(모듈)로 나누는 것을 의미한다. 여러 함수가 모여 하나의 모듈을 이루고, 이 모듈들이 서로 상호작용하며 전체 시스템을 구성한다.
응집도(Cohesion)
응집도는 하나의 모듈 내에서 각각의 기능(함수, 메서드)들이 공동의 목적을 달성하기 위해 얼마나 밀접하게 관련되어 있는가를 나타내는 척도다.
- 높은 응집도 (Good): 모듈이 하나의 명확하고 집중된 목적을 가진다. 예를 들어,
User클래스가 사용자의 이름과 이메일을 가져오는get_name(),get_email()메서드만 가지고 있다면 응집도가 높다고 할 수 있다. - 낮은 응집도 (Bad): 하나의 모듈이 서로 관련 없는 여러 기능을 수행한다. 만약
User클래스에 사용자 정보 확인, 이메일 전송, 유저 정보 출력 등 다양한 기능이 모두 포함되어 있다면, 이는 낮은 응집도를 가진다. 좋은 설계는 목적에 맞게 클래스를 나누고, 명확히 정의된 인터페이스를 통해 교류하도록 하는 것이다.
결합도(Coupling)
결합도는 모듈 간의 상호 의존성 정도를 나타낸다.
- 낮은 결합도 (Good): 각 모듈이 독립적으로 작동하여, 한 모듈의 변경이 다른 모듈에 미치는 영향이 적다. 이는 유지보수와 협업을 용이하게 한다.
- 높은 결합도 (Bad): 모듈들이 서로에게 강하게 의존하여, 하나의 모듈을 수정하면 관련된 다른 모듈들도 함께 수정해야 할 가능성이 크다.
예를 들어, Order 클래스가 Product 클래스의 get_price() 메서드를 직접 호출하여 가격을 계산하는 경우, 두 클래스는 높은 결합도를 가진다. 만약 동료가 get_price() 메서드가 숫자 대신 "$20"와 같은 문자열을 반환하도록 수정한다면, Order 클래스의 calculate_total() 메서드는 오류를 발생시킬 것이다.
반면, Order 클래스가 Product 객체 자체가 아닌 가격 정보([20, 30, 5]) 리스트를 직접 받아서 합계를 계산한다면, Product 클래스의 내부 구현이 변경되어도 Order 클래스는 영향을 받지 않는다. 이는 낮은 결합도를 가지는 좋은 설계다. 좋은 설계를 위해서는 결합도를 낮추어 협업 시 클래스 간의 영향을 최소화해야 한다.
1.3 테스트
테스트는 프로그램이 예상대로 정확하게 작동하는지, 문제가 없는지 확인하는 필수적인 과정이다. 기능이 추가되거나 코드가 수정될 때 기존 시스템에서 오류가 발생하는지, 새로운 버그가 생겼는지 등을 확인함으로써 사용자에게 안정적인 소프트웨어를 제공하는 것을 목표로 한다.
테스트는 단순히 코드만 확인하는 것이 아니라, 요구조건, 아키텍처 설계, 데이터베이스 연결, 서버 부하 등 시스템 전반에 대한 확인을 포함한다.
- Unit Test: 함수나 메서드와 같은 가장 작은 코드 단위를 개별적으로 테스트한다.
- Integration Test: 여러 단위나 컴포넌트를 연결했을 때 상호작용이 올바르게 이루어지는지 테스트한다.
- End to End Test: 실제 사용자 시나리오처럼 처음부터 끝까지 시스템 전체의 흐름을 테스트한다.
- Performance Test: 시스템의 성능(응답 시간, 처리량)과 부하 상태에서의 안정성을 테스트한다.
Pytest
Pytest는 파이썬에서 널리 사용되는 테스트 프레임워크다. assert 키워드를 사용하여 테스트 조건을 간단하게 정의하고 실행할 수 있다.
# content of test_sample.py
def func(x):
    return x + 1

def test_answer():
    assert func(3) == 5
$ pytest
=========================== test session starts ============================
platform linux -- Python 3.x.y, pytest-9.x.y, pluggy-1.x.y
rootdir: /home/sweet/project
collected 1 item

test_sample.py F                                                     [100%]

================================= FAILURES =================================
_______________________________ test_answer ________________________________

    def test_answer():
>       assert func(3) == 5
E       assert 4 == 5
E        +  where 4 = func(3)

test_sample.py:6: AssertionError
========================= short test summary info ==========================
FAILED test_sample.py::test_answer - assert 4 == 5
============================ 1 failed in 0.12s =============================
위의 예시에서 볼 수 있듯 asseret를 사용해서 해당 조건에 부합하지 않으면 에러를 발생함.
1.4 문서화
좋은 소프트웨어는 반드시 좋은 문서를 동반한다. 문서화는 다른 개발자나 미래의 내가 코드를 쉽게 이해하고 사용할 수 있도록 돕는 중요한 과정이다. 주요 문서에는 다음이 포함된다.
- README: 프로젝트의 개요, 설치 방법, 사용법 등을 설명하는 가장 기본적인 문서.
- API 문서: 함수, 클래스, 모듈의 기능, 파라미터, 반환값 등을 상세히 기술한 문서.
- 아키텍처 문서: 시스템의 전체 구조와 구성 요소 간의 관계를 설명하는 문서.
PyTorch는 공식 문서가 매우 잘 작성된 대표적인 예시다. API의 상세한 설명, 사용 가이드, Ecosystem 관련 라이브러리 소개, 블로그, 튜토리얼 등 풍부한 정보를 제공하여 사용자들이 쉽게 배우고 활용할 수 있도록 돕는다. 개인 프로젝트를 진행할 때도 문서화를 신경 쓰는 습관은 매우 중요하다.
1.5 왜 소프트웨어 엔지니어링을 배워야 하는가?
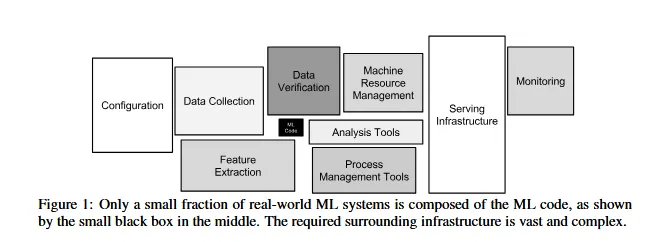
머신러닝 모델을 만드는 것 역시 소프트웨어 엔지니어링 활동의 일부다. 특히, 개발한 머신러닝 모델을 실제 유저가 사용하는 서비스로 만들려면 소프트웨어 엔지니어링에 대한 깊은 이해가 필수적이다.
출처: Hidden Technical Debt in Machine Learning Systems
위 다이어그램에서 볼 수 있듯이, 실제 머신러닝 시스템에서 ML 코드가 차지하는 비중은 매우 작다. 데이터 수집, 검증, 피처 추출, 자원 관리, 서빙 인프라, 모니터링 등 수많은 소프트웨어 엔지니어링 요소들이 모델을 둘러싸고 있다.
트위터와 같은 거대 서비스의 아키텍처를 보면, Prediction Service나 Home Scorer와 같은 AI/ML 관련 컴포넌트는 전체 시스템의 일부로서 다른 여러 서비스와 복잡하게 상호작용한다. 모델보다 훨씬 크고 복잡한 시스템 내에서 자신의 모델이 제 역할을 하도록 만들기 위해서는 소프트웨어 엔지니어링 관점에서 시스템 전체를 이해해야 한다.
앞으로 AI 개발을 전문으로 하는 분야와 AI 기술을 소프트웨어 엔지니어링에 접목하는 분야로 커리어가 나뉠 수 있다. 양쪽을 모두 이해하면 전반적인 시스템을 보는 시야가 넓어져 더 큰 도움이 될 것이다.
1.6 AI 엔지니어링
AI 엔지니어링은 개발된 AI 모델이 웹이나 앱과 같은 실제 서비스에서 안정적으로 동작할 수 있도록 시스템을 구축하는 것을 의미한다. 이는 데이터, 모델, 코드, 인프라 네 가지 요소를 모두 다루는 종합적인 분야다.
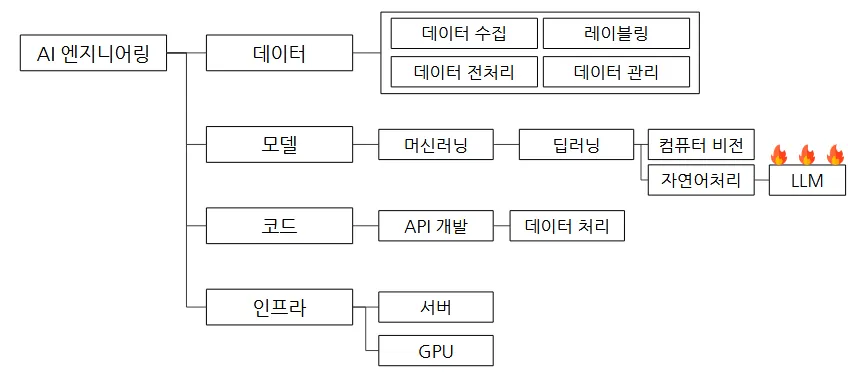
소프트웨어 엔지니어와 AI 엔지니어는 역할과 관심사에서 차이를 보인다.
- AI엔지니어: 모델의 퍼포먼스와 데이터셋, 실험 중요
- 소프트웨어 엔지니어: 변경 용이, 가독성, 소프트웨어 시스템 개발 및 유지보수
AI 엔지니어로서 성장하려면 어떻게 해야할까?
- 특정 도구나 프레임워크에 너무 몰입하기보다, 문제 해결의 관점을 익히고 필요할 때 새로운 기술을 빠르게 습득할 수 있도록 학습의 기초를 다진다.
- 새로운 기술을 접할 때, ‘어떤 맥락에서 이 도구가 생겨났는가?’, ’어떻게 활용하면 좋을까?’를 항상 고민한다.
- 새로운 것을 학습할 때, 과거에 내가 다른 기술을 어떻게 학습했는지 되돌아보며 자신만의 효율적인 학습 방법을 찾아나간다.
2. 파이썬 환경 설정과 디버깅
2.1 파이썬 환경설정
파이썬 개발 환경을 올바르게 설정하는 것은 안정적이고 효율적인 개발의 첫걸음이다. 버전 관리부터 가상 환경 구축, 패키지 관리에 이르기까지 체계적인 접근이 필요하다.
버전 관리(Version Control)
파이썬 버전의 숫자는 단순한 식별자가 아니라 Semver(Semantic Versioning) 정책에 따라 관리된다. Semver는 MAJOR.MINOR.PATCH 형식으로 버전을 구성하며, MAJOR 버전이 변경되면 하위 호환성이 보장되지 않는 큰 변화가 있음을 의미한다. 따라서 파이썬 2.x 버전과 3.x 버전 사이의 코드는 호환되지 않는다.
개발 시 사용하고자 하는 라이브러리가 내가 사용 중인 파이썬 버전과 호환되는지 확인하는 것이 중요하다. 이는 pypi.org와 같은 패키지 저장소에서 확인할 수 있다. 일반적으로 최신 파이썬 버전을 사용하는 것이 좋지만, 안정성을 더욱 중요시하는 경우 최신 버전보다 마이너 버전이 하나 낮은 버전을 선택하기도 한다.
여러 버전의 파이썬을 관리하기 위해 pyenv와 같은 도구를 사용하면 유용하다. pyenv는 커맨드 라인 인터페이스(CLI)를 통해 여러 파이썬 버전을 쉽게 설치하고 프로젝트마다 다른 버전을 지정할 수 있게 해준다. which python 명령어를 사용하면 현재 어떤 파이썬 실행 파일이 사용되고 있는지 경로를 확인할 수 있는데, 버전이 꼬이는 문제가 발생했을 때 이 명령어를 통해 경로를 확인하고 통일하여 문제를 해결할 수 있다.
가상 환경(Virtual Environment)
가상 환경이 없다면 모든 프로젝트가 시스템 전역에 설치된 하나의 패키지 목록을 공유하게 된다. 이 경우, 한 프로젝트에서 특정 패키지의 버전을 업데이트하면 다른 프로젝트에서 버전 충돌이 발생할 수 있다. 이러한 문제를 방지하기 위해 프로젝트별로 독립된 가상 환경을 만들어야 한다. 각 가상 환경은 고유의 파이썬 버전과 설치된 패키지 목록을 가지므로 프로젝트 간의 의존성 문제를 원천적으로 차단한다.
파이썬에서는 venv 모듈을 내장하고 있어 이를 통해 쉽게 가상 환경을 구축할 수 있다.
가상 환경이 활성화되면, 터미널 프롬프트 앞에 (my_env)와 같이 가상 환경의 이름이 표시되어 현재 작업 환경을 명확히 알려준다.
2.2 패키지 매니저
파이썬의 주요 패키지 매니저로는 pip, poetry, conda 등이 있다. 그중 pip는 파이썬에 기본적으로 내장되어 있어 가장 널리 사용된다.
pip를 사용하면 필요한 패키지를 쉽게 설치할 수 있다. 예를 들어 특정 패키지를 설치하려면 다음 명령을 사용한다.
pip는 패키지를 설치할 때 해당 패키지가 의존하는 다른 패키지들(의존성 패키지)도 자동으로 함께 설치해준다. 프로젝트에 직접 필요한 패키지만 확인하고 싶을 때는 다음 명령을 사용할 수 있다.
프로젝트의 의존성을 관리하기 위해 requirements.txt 파일을 사용하는 것이 일반적이다. 이 파일에 필요한 패키지와 버전 목록을 저장해두면, 다른 환경에서도 pip install -r requirements.txt 명령 한 줄로 동일한 환경을 쉽게 구축할 수 있다. 또한, 내장된 pip보다 최신 버전을 사용하는 것이 좋으므로, pip install --upgrade pip 명령으로 주기적으로 업그레이드해주는 것이 권장된다.
2.3 디버깅(Debugging)
디버깅은 소프트웨어 개발 과정에서 발생하는 오류(버그)의 원인을 찾아 해결하고 시스템을 정상화하는 가장 중요한 활동 중 하나다. 때로는 많은 시간이 소요되고 답답함을 유발할 수 있지만, 안정적인 소프트웨어를 만들기 위한 필수적인 과정이다.
버그가 생기는 이유
버그는 다양한 원인으로 발생한다.
- 사람의 실수: 문법을 잘못 작성하거나 비즈니스 로직을 잘못 설계하는 경우.
- 실행 환경: 운영체제(OS), 가상 환경, Docker 컨테이너, 하드웨어, 네트워크 상태 등 코드 외부의 환경적 요인.
- 의존성: 내가 사용하는 라이브러리, 혹은 그 라이브러리가 사용하는 또 다른 라이브러리에 버그가 있는 경우.
- 복잡성: 소프트웨어의 규모가 커지고 복잡해질수록 버그가 발생할 가능성이 높아진다.
- 커뮤니케이션: 요구사항이 명확하지 않거나 팀원 간에 서로 다르게 이해하는 경우.
디버깅 절차
문제가 발생했을 때, 체계적인 절차에 따라 디버깅을 진행하면 보다 효율적으로 문제를 해결할 수 있다.
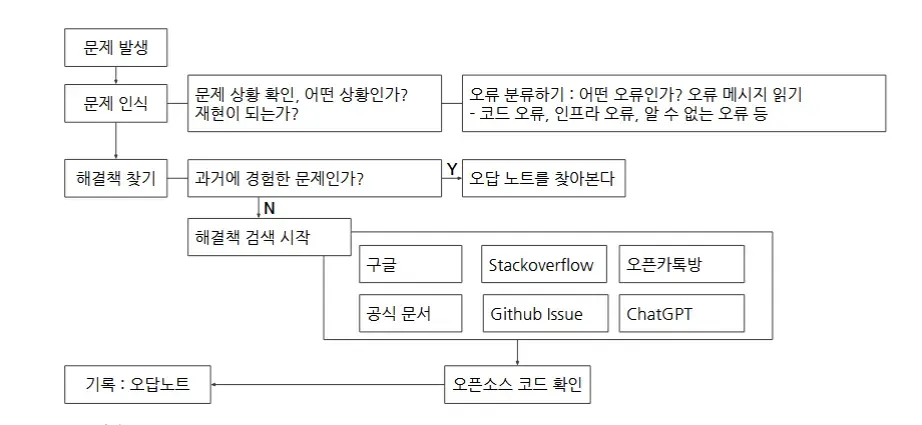
- 문제 인식 및 오류 분류: 가장 먼저 오류 메시지를 주의 깊게 읽고 원인을 파악한다. 문제가 코드의 오류인지, 인프라의 문제인지, 혹은 원인을 알 수 없는 오류인지 분류한다.
- 해결책 찾기: 과거에 비슷한 문제를 경험했는지 자신의 기록(오답노트)을 찾아본다. 경험이 없다면 구글, Stack Overflow, 공식 문서, GitHub Issue 등에서 해결책을 검색한다. 최근에는 ChatGPT와 같은 LLM을 활용하는 것도 좋은 방법이다. 오픈소스 프로젝트의 경우, GitHub 레포지토리의
issue탭에서 에러 메시지로 검색해보면 동일한 문제를 겪은 다른 개발자의 논의를 찾을 수 있으며, 해결된 버그는closed된 이슈에서 확인할 수 있다. - 가설 설정: 수집한 정보를 바탕으로 ’어떤 과정에서 무엇을 하는데 에러가 났다’와 같이 문제 상황을 정리하고, 원인에 대한 가설을 세운다.
- 기록: 문제 상황, 오류 메시지, 그리고 어떻게 해결했는지를 상세히 기록하여 ’오답노트’를 만든다. 이렇게 경험을 데이터화하면 미래에 비슷한 문제가 발생했을 때 더 빠르고 균일한 형태로 해결할 수 있는 귀중한 자산이 된다.
만약 다른 사람에게 도움을 요청해야 할 경우, 상대방이 문제를 쉽게 재현할 수 있도록 운영체제, 가상 환경, 사용 중인 라이브러리 버전 등 실행 환경에 대한 정보를 명확히 제공하는 것이 중요하다.
3. Streamlit을 활용한 웹 프로토타입 구현
3.1 프로토타입이란?
프로토타입은 완벽한 제품이 출시되기 전에 기능이나 디자인을 미리 확인하고 테스트하기 위해 만드는 샘플 버전이다. 특히 AI/ML 분야에서는 개발한 모델의 입력(Input)에 따른 출력(Output)을 시각적으로 쉽게 확인할 수 있도록 웹페이지 형태로 프로토타입을 제작하는 경우가 많다.
일반적으로 데이터 분석가나 사이언티스트는 Jupyter Notebook에서 EDA(탐색적 데이터 분석)를 수행하고 모델을 개발한다. 이 결과를 실제 서비스에 적용하기 전에, 간단한 웹 서비스 형태로 만들어보면 협업 관점에서 매우 유용하다. 예를 들어, 프론트엔드 개발자나 기획자(PM)와 같은 유관 조직과 아이디어를 공유하고 빠른 피드백을 주고받을 수 있다.
일반적인 웹개발 절차
- Explore in a jupyternotebook
- Copy-paste into a python script
- Write Flask app. Think about HTTP requests, HTML, callbacks, JS..
- 유지보수
물론 Jupyter Notebook의 코드를 파이썬 스크립트로 옮겨 Flask와 같은 웹 프레임워크로 앱을 만들 수도 있지만, 프론트엔드 개발자가 아닌 이상 UI를 만들고 유지보수하는 데 많은 어려움이 따른다. 바로 이런 문제를 해결하기 위해 Streamlit과 같은 도구가 등장했다.
3.2 Streamlit
Streamlit은 복잡한 웹 개발 지식 없이 파이썬 스크립트 코드만으로 빠르고 쉽게 데이터 기반의 웹 애플리케이션을 만들 수 있는 오픈소스 프레임워크다.
Streamlit을 사용할 경우의 장점
- 데이터 엔지니어나 분석가가 Jupyter Notebook 코드를 약간만 수정하여 쉽게 프로토타입을 구현할 수 있다.
- 백엔드 개발이나 HTTP 요청과 같은 복잡한 구현 없이도 다양한 UI 컴포넌트를 활용해 대시보드를 구성할 수 있다.
- JavaScript, React, Vue 등을 사용해 프로토타입을 만드는 것에 비해 시간 효율성이 매우 높다.
- Streamlit Cloud를 통해 쉽게 웹에 배포하고 다른 사람과 공유할 수 있다 (단, 무료 Community Plan은 Public GitHub 레포지토리만 지원).
- 화면 녹화(Record) 기능이 내장되어 있어 데모 영상을 쉽게 제작할 수 있다.
Streamlit 대안
물론 Streamlit이 유일한 해결책은 아니다. 프로젝트의 요구 조건에 따라 다른 도구를 고려할 수 있다.
- R의 Shiny: R 사용자들에게 인기 있는 웹 애플리케이션 프레임워크.
- Flask, FastAPI: 직접 백엔드를 구성하고 프론트엔드 작업을 진행해야 하므로 자유도는 높지만 더 많은 노력이 필요하다.
- Dash: 기능이 가장 풍부한 Python 기반 대시보드 라이브러리. 복잡한 상호작용과 레이아웃이 필요할 때 적합하다.
- Gradio: Streamlit과 비슷한 컨셉으로, 머신러닝 모델의 데모를 만드는 데 특화되어 있다.
중요한 것은 특정 도구에 집착하기보다, 프로젝트의 요구 조건에 맞춰 최적의 도구를 선택하고 적용하는 의사결정 능력이다.
3.3 Streamlit 개발 흐름
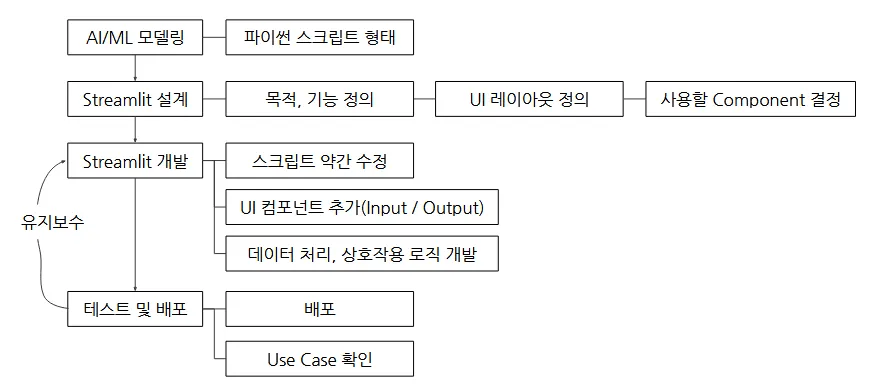
- AI/ML 모델링: 먼저 파이썬 스크립트 형태로 동작하는 모델이나 데이터 처리 로직을 준비한다.
- Streamlit 설계: 프로토타입의 목적과 기능을 정의하고, UI 레이아웃과 사용할 컴포넌트(버튼, 슬라이더, 차트 등)를 결정한다.
- Streamlit 개발: 기존 파이썬 스크립트 코드를 약간 수정하고, Streamlit이 제공하는 UI 컴포넌트를 추가하여 Input/Output을 처리한다. 데이터 처리나 시각화, 상호작용 로직(예: 값이 변경될 때 어떻게 동작할지)을 개발한다.
- 테스트 및 배포: 의도한 대로 작동하는지 Use Case를 확인하고, 필요하다면 Streamlit Cloud 등을 통해 배포한다.
3.4 Streamlit 핵심 기능
Streamlit은 다양한 UI 컴포넌트를 제공하여 손쉽게 인터랙티브한 웹 페이지를 만들 수 있게 한다.
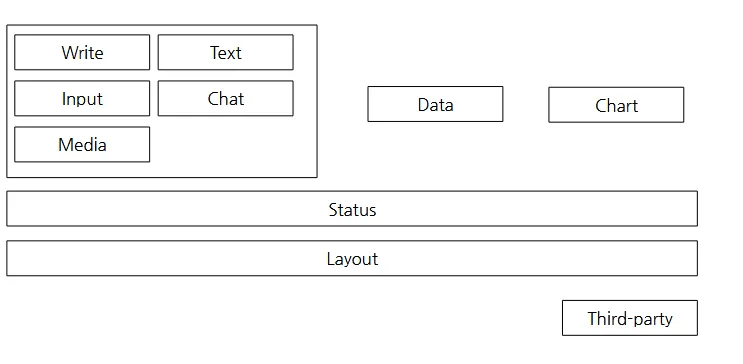
UI Components
- Text 출력: 제목, 헤더, 일반 텍스트 등을 표시한다.
- Input 위젯: 사용자로부터 문자, 숫자, 날짜, 파일 등을 입력받는다.
- 선택 위젯: 여러 옵션 중 하나 또는 여러 개를 선택하게 한다.
- 버튼 및 상태 위젯: 특정 동작을 실행하거나 상태(True/False)를 입력받는다.
- 데이터 및 차트: 데이터프레임, 차트, 지도 등을 시각화한다.
- 레이아웃:
st.sidebar로 사이드바를,st.columns로 화면을 여러 열로 분할하거나,st.expander로 접고 펼 수 있는 섹션을 만든다.
Session State (st.session_state)
Streamlit은 화면에서 무언가 업데이트(예: 버튼 클릭, 텍스트 입력)될 때마다 전체 스크립트 코드를 처음부터 다시 실행한다. 이 특성 때문에 일반 변수에 저장된 값은 상호작용이 일어날 때마다 초기화되어 사라진다.
이 문제를 해결하기 위해 Session State가 사용된다. st.session_state는 Global Variable처럼 동작하여, 스크립트가 다시 실행되어도 값을 계속 유지하고 공유할 수 있게 해준다. 사용자 로그인 상태 유지, 채팅 대화 히스토리 저장, 여러 단계의 Form 데이터 유지 등에 활용된다.
위 코드에서 st.session_state.count는 버튼을 누를 때마다 값이 유지되고 누적된다.
Caching
스크립트가 재실행될 때마다 데이터를 불러오거나 무거운 ML 모델을 로드하는 코드가 반복적으로 실행되면 앱의 성능이 저하될 수 있다. Streamlit은 이러한 성능 이슈를 해결하기 위해 캐싱(Caching) 데코레이터를 제공한다.
캐싱은 시간이 오래 걸리는 함수의 실행 결과를 메모리나 디스크에 저장해두고, 동일한 입력으로 함수가 다시 호출될 때 계산을 반복하는 대신 저장된 결과를 즉시 반환하는 기능이다.
@st.cache_data: 데이터프레임, API 요청의 응답 등 데이터베이스에 저장할 수 있는 형태의 객체를 캐싱하는 데 사용된다.@st.cache_resource: DB 연결, ML 모델과 같이 메모리에 그대로 유지해야 하는 객체를 캐싱하는 데 사용된다.
[st.cache_data vs st.cache_resource 다이어그램]
이처럼 Session State와 Caching은 Streamlit 개발에서 상태를 유지하고 성능을 최적화하는 데 매우 중요한 역할을 한다.
4. Linux 및 쉘 스크립트
Linux와 CLI
Linux는 오픈소스 운영 체제로, 안정성과 유연성 덕분에 서버 환경에서 압도적으로 많이 사용된다. 서버와 상호작용할 때는 주로 그래픽 기반의 GUI(Graphic User Interface) 대신 텍스트 기반의 CLI(Command Line Interface)를 사용한다. 쉘 커맨드와 쉘 스크립트에 익숙해지는 것은 서버를 다루는 개발자에게 필수적인 역량이다.
쉘(Shell)
쉘은 사용자가 입력한 명령어를 해석하여 운영체제의 커널이 실행하도록 전달하는 프로그램이다. 대표적인 쉘의 종류는 다음과 같다.
- sh (Bourne Shell): 최초의 유닉스 쉘.
- bash (Bourne-Again Shell): 대부분의 Linux 배포판에서 표준으로 사용되는 쉘.
- zsh (Z Shell): macOS의 기본 쉘로, 다양한 편의 기능과 플러그인을 제공한다.
쉘은 서버에 원격 접속하여 작업을 하거나, crontab을 이용해 특정 작업을 자동화하고, Docker 컨테이너를 관리하며, 배포 파이프라인을 실행하는 등 서버 개발 및 운영의 모든 과정에서 사용된다.
기본 쉘 커맨드
자주 사용하는 기본 쉘 커맨드는 다음과 같다.
man <command>: 커맨드의 매뉴얼(설명서)을 보여준다.mkdir <dirname>: 새로운 디렉토리를 생성한다.ls: 현재 디렉토리의 파일 및 폴더 목록을 보여준다. (l: 상세 정보,a: 숨김 파일 포함,h: 사람이 읽기 쉬운 용량 단위)pwd: 현재 작업 중인 디렉토리의 전체 경로를 출력한다.cd <path>: 지정된 디렉토리로 이동한다.echo <text>: 터미널에 텍스트를 출력한다.cp <source> <destination>: 파일이나 폴더를 복사한다. (r: 폴더 전체를 재귀적으로 복사)vi <filename>:vi(또는vim) 텍스트 편집기로 파일을 열거나 생성한다.mv <source> <destination>: 파일이나 폴더를 이동시키거나 이름을 변경한다.cat <filename>: 파일의 내용을 출력한다. 여러 파일을 인자로 주면 내용을 합쳐서 보여준다.sudo <command>: 관리자(superuser) 권한으로 명령어를 실행한다.history: 이전에 입력했던 명령어들의 목록을 보여준다.find <path> -name <filename>: 특정 경로에서 지정된 이름의 파일을 검색한다.alias <name>='<command>': 긴 명령어를 짧은 별칭으로 만들어 사용한다.tree: 디렉토리 구조를 시각적인 트리 형태로 보여준다.
텍스트 처리 커맨드
로그 파일 분석이나 데이터 전처리 시 유용한 텍스트 처리 커맨드들이다.
head/tail -n <number> <filename>: 파일의 처음/끝 n행을 출력한다.sort <filename>: 파일의 내용을 행 단위로 정렬한다. (r: 내림차순,n: 숫자 순서로 정렬)uniq: 연속된 중복 행을 제거한다. 주로sort와 함께 사용한다.grep <pattern> <filename>: 파일 내용에서 특정 패턴(문자열)이 포함된 행을 검색한다.cut -d '<delimiter>' -f <fields> <filename>: 파일의 각 행에서 특정 구분자(d)를 기준으로 필드(f)를 잘라내어 추출한다.awk '<pattern> {action}' <filename>: 강력한 텍스트 처리 도구로, 특정 패턴에 맞는 행에 대해 지정된 동작을 수행한다.
표준 스트림과 리다이렉션 & 파이프
Unix 기반 시스템의 프로그램은 실행 시 세 가지 기본 스트림을 가진다.
stdin(0): 표준 입력. 기본적으로 키보드 입력.stdout(1): 표준 출력. 기본적으로 터미널 화면.stderr(2): 표준 에러. 기본적으로 터미널 화면.
리다이렉션은 이러한 스트림의 방향을 바꾸는 기능이다.
>:stdout을 파일로 보낸다 (파일이 있으면 덮어쓰기).>>:stdout을 파일의 끝에 추가한다.- *파이프(
|)**는 한 명령어의stdout을 다른 명령어의stdin으로 직접 연결하는 기능으로, 여러 명령어를 조합하여 복잡한 작업을 수행할 수 있게 한다.
서버에서 자주 사용하는 커맨드
ps: 현재 실행 중인 프로세스의 상태를 보여준다. (ef: 모든 프로세스를 상세 포맷으로)curl <URL>: 커맨드 라인에서 URL을 통해 데이터를 요청하고 응답을 받아오는 도구. API 테스트 등에 유용하다.df: 디스크의 남은 용량을 확인한다. (h: 사람이 읽기 쉬운 단위로)ssh <user>@<host>: 원격 서버에 안전하게 접속하는 프로토콜.[SSH 연결 과정 다이어그램]- VSCode의
Remote-SSH확장 기능을 사용하면 원격 서버에 접속하여 마치 로컬 컴퓨터에서 작업하는 것처럼 파일을 편집하고 터미널을 사용할 수 있다. [VScode RemoteSSH 다이어그램]scp <source> <destination>: SSH를 통해 원격 서버와 안전하게 파일을 주고받는 명령어.nohup <command> &: 터미널을 종료해도 백그라운드에서 작업이 계속 실행되도록 한다. 로그는nohup.out파일에 저장된다.chmod <permission> <filename>: 파일이나 디렉토리의 권한(읽기-4, 쓰기-2, 실행-1)을 변경한다.
쉘 스크립트
쉘 스크립트는 여러 쉘 커맨드를 .sh 파일에 순서대로 작성하여 일괄적으로 실행할 수 있게 하는 것이다. 반복적인 작업을 자동화하는 데 매우 유용하다.
스크립트 파일의 가장 첫 줄에는 #!/bin/bash와 같이 어떤 쉘을 사용하여 이 스크립트를 실행할지 지정하는 Shebang을 작성한다.
쉘 스크립트는 변수, 함수, 조건문, 반복문 등 프로그래밍 언어의 요소를 대부분 포함하고 있다.
- 인자: 스크립트 실행 시 전달하는 인자는
$1,$2, … 와 같은 변수로 접근할 수 있다.$#는 전달된 인자의 총 개수,$@는 모든 인자 목록을 의미한다. - 함수: 파이썬처럼 함수를 정의하고 호출할 수 있다.
- 조건문:
if [ 조건 ]형태로 사용하며,&&(AND),||(OR)로 조건을 조합할 수 있다.
쉘 스크립트 활용 사례
- 모델 학습 자동화: 여러 하이퍼파라미터 조합으로 모델을 순차적으로 학습시킬 때 쉘 스크립트를 활용할 수 있다.
- 로그 파일 분석: 모델 학습 후 생성된 여러 로그 파일에서 특정 정보(예: Loss)를 한 번에 추출하고 분석할 수 있다.
Linux와 쉘 커맨드는 처음에는 낯설 수 있지만, 서버 환경에서 개발하고 운영하기 위해서는 반드시 익숙해져야 하는 도구다. 많은 커맨드를 한 번에 외우려 하기보다, 자주 사용하는 것부터 시작하여 필요할 때마다 검색하고 정리하며 점차 익숙해지는 것이 좋다.
학습회고
본격적인 Production주간이 시작되었다. 이번주간은 AI개발기초 강의를 들으며, 깃허브와 친해지고, 팀원들과 프로젝트 아이디어를 탐색하는 시간을 가졌다.
프로젝트 아이디어 선정
프로젝트 아이디어를 선정하는 과정이 쉽지 않았다. 기술적인 완성도가 있는지, 시장성이 있는지, 어떤 문제를 인식하고 해결해야 하는지 결정해야 하는것들이 많았다. 그리고 가장 어려웠던 것은 이미 시장에 많은 솔루션들이 존재한다는 것이다. 이미 존재하는 솔루션과 차별점을 만들어야 할텐데 설계하는게 쉽지 않은것 같다.
우리조가 선택한 OCR기반에서는 다량의 문서를 읽어들이고 처리할 수 있으므로, 경제, 법률 의료등 다양한 분야에 접목될 가능성이 있어보이지만, 해당분야들에 배경지식이 없어서 쉽지 않은 프로젝트가 될것 같았다.
그래서 그나마 내가 잘 아는 분야인 교육에 OCR을 접목시켜서 에듀테크쪽으로 LMS With AI를 조사하고 제시했다. [최종프로젝트]에듀테크-아이디어
시장성이 있는지, 임팩트를 크게 줄 수 있을지, Finetuning을 통해 모델성능 개선을 보여줄 수 있을지, 실제 문제해결에 기여할 수 있을지등을 팀원들과 더 고려해봐야겠다.
에듀테크 이외에도 아이디어들이 많았지만, 완벽한 아이디어를 찾기가 쉽지 않았다..
깃허브와 친해지기
부스트코스에 제공된 강의를 들으며 깃허브와 친해지는 시간을 가졌다. Commit, Pull, push, add밖에 몰랐었는데, 팀원들과 협업하기 위해 천천히 깃허브와 더 친해져야겠다.
계획한것은 많았지만, 절반정도밖에 이루지 못한 한주였다. 공부할 주제들은 \(O(n^2)\)로 늘어나는데, 모두 흡수하지 못하는것 같다. 훌륭한 멘토님과, 제공되는 v100 GPU, 함께하는 팀원들도 있는데, 정작 내가 기회를 놓치고 있는것 같다. 지나간 시간은 어쩔 수 없으니 이번 주말에는 평일에 계획했던 SAM, Deepseek OCR 포스팅, 기술블로그 글 포스팅을 해내야겠다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...