Week7-8_DomainCommonProject_WrapupReport
WrapupReport
1. 프로젝트 개요
1-1. 프로젝트 주제
영화 리뷰 텍스트를 4개의 클래스(강한 부정, 약한 부정, 약한 긍정, 강한 긍정)로 분류하는 다중 클래스 감성 분류 모델을 개발
1-2. 프로젝트 구현내용
BERT기반의 트렌스포머 모델을 사용하여 영화 리뷰 텍스트의 문맥적 의미를 학습하고 감성을 예측한다. EDA, FeatureEngineering, 커스텀 토크나이저, 클래스 불균형 처리, 모델앙상블, TAPT등 다양한 모델 최적화 기법을 적용하여 최종 성능을 향상시키는것을 목표로 함.
1-3. 개발환경
H/W: Tesla V100 GPU
S/W: Python, PyTorch, Pandas, Scikit-learn
실험관리: Wandb(Weight & Biases)
2. 주요 접근 방식 및 실험과정
프로젝트의 핵심 목표는 단순히 높은 성능을 내는 모델을 찾는 것이 아니라 ‘왜’ 성능이 오르고 내리는지 그 원인을 파악하고 검증.
2-1. EDA 및 초기 가설
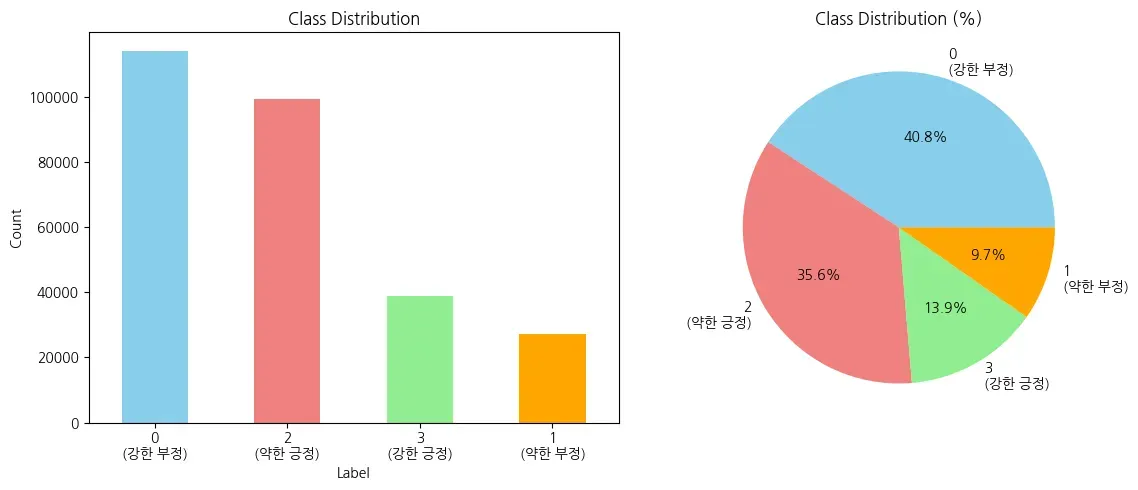
- 데이터 불균형 확인: ‘강한 부정’과 ‘약한 긍정’이 다수를 차지하고, ‘약한 부정’과 ‘강한 긍정’이 소수인 불균형 데이터셋임을 확인했다. 이를 바탕으로 클래스간 불균형을 해소하기 위해 Weighted Cross Entropy(WCE)나 Focal Loss가 필요하다고 가정했다.
--- 수집된 라벨별 상위 감성 패턴 (예시) ---
  [Label 0]: [('ㅠㅠ', 33867), ('ㅋㅋ', 7427), ('ㅡㅡ', 2363), ('ㅎㅎ', 954), ('ㅜㅜ', 519), ('😡', 44), ('★', 33), ('ㅋㅋㅠㅠ', 30), ('ㅡㅡㅋ', 26), ('ㅜㅠ', 24)]
  [Label 1]: [('ㅠㅠ', 9489), ('ㅎㅎ', 2362), ('ㅋㅋ', 1856), ('ㅜㅜ', 86), ('ㅡㅡ', 78), ('★', 26), ('😊', 22), ('🌟', 18), ('ㅠㅜ', 12), ('♥', 11)]
  [Label 2]: [('ㅎㅎ', 19727), ('ㅋㅋ', 9407), ('ㅠㅠ', 5677), ('♥', 832), ('🌟', 640), ('✨', 510), ('ㅜㅜ', 477), ('😊', 415), ('♡', 360), ('👍', 351)]
  [Label 3]: [('ㅎㅎ', 5713), ('ㅠㅠ', 4948), ('ㅋㅋ', 3900), ('♥', 2067), ('♡', 571), ('ㅜㅜ', 391), ('🌟', 330), ('★', 206), ('✨', 142), ('👍', 137)]
------------------------------------------
- 텍스트 특징 발견:
- ‘ㅋㅋ’, ‘ㅠㅠ’, ‘ㅎㅎ’ 같은 자음/모음 반복 및 이모티콘(😊, 👍)이 빈번하게 등장하는 것을 발견했다. 감성분류 Task에서 이러한 토큰은 중요하게 해석되어야 한다. 따라서 커스텀 토크나이저를 통해 ‘ㅋㅋ’, ‘ㅠㅠ’, ‘ㅎㅎ’등은 특수토큰으로 처리하는 방법이 필요하다고 가정했다.
- ‘진짜’, ‘너무’와 같은 부사어는 모든 레이블에서 공통적으로 높은 빈도를 보여, 이를 불용어로 처리해야 할지 고민했다. 하지만 Bi-directional, Self-Attention을 통해 단어 그 자체만 보는게 아니라, 문맥 안에서의 단어 뜻을 파악하므로, 불용어처리를 하기보다는, 최대한 문맥을 살려두기 위해서, 남겨두어야 한다고 가정했다.
2-2. 시행착오 1: Feature Engineering과 과적합
초기에는 성능 향상을 위해 여러기법을 동시에 적용했다.
- 데이터 불균형을 해결하기 위해 WCE(Weighted Cross Entropy)를 적용했다. 이때 가중치는 각 클래스의 백분율을 역수로 두어서 정규화시킨 값을 가중치로 사용했다.
- ‘ㅋㅋ’, ‘ㅠㅠ’및 이모티콘을 특수토큰 처리하고 정규화 하는 커스텀 토크나이저를 구축했다.
- Stratify 5-Fold를 적용하여 모델의 Robustness를 확보했다.
결과 및 문제점: 하지만 이 모델의 성능은 베이스라인보다 오히려 하락(0.79)했다. 특히 Validation Loss가 급격히 상승하는 과적합 현상이 발생했다. WCE가 소수 클래스 특징에 과도하게 집중하면서 발생한 문제로 추정했다. 또한, 여러 변경사항을 한번에 적용하여 성능 하락의 정확한 원인을 파악하기 어렵다는 문제를 깨달았다.
 베이스라인 모델의 성능
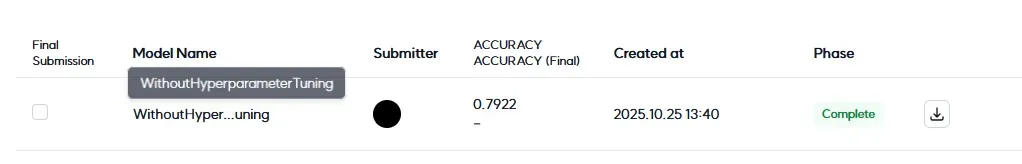 WCE, 커스텀토크나이저, Stratifty 5-Fold를 적용한 모델의 성능
2-3. 시행착오 2: 변인 통제와 Custom Tokenizer
이전의 실패를 바탕으로 변인을 통제하며 가설을 하나씩 검증하는 전략으로 변경했다.
- 가설 1 (불용어): ‘진짜’, ‘너무’ 등의 불용어를 제거/유지하는 실험을 진행했다. BERT기반 모델은 문맥 전체를 통해서 단어의 의미를 파악하기 때문에, 불용어를 없애는게 오히려 모델성능을 하락할 것이라고 생각했다. 결과적으로 성능 차이가 미미(0.0005)하여, BERT 모델에서는 큰 영향이 없음을 확인했다.
- 가설 2 (특수 토큰): ‘ㅋㅋ’, ‘ㅠㅠ’, 이모티콘을
[LAUGH],[CRY],[HEART]등의 특수 토큰으로 매핑하는 커스텀 토크나이저를 구현했다.
결과: 커스텀 토크나이저만 적용했을 때, 베이스라인 대비 약 0.2%의 유의미한 성능 향상을 관측했다. 이는 감정 표현을 명시적으로 토큰화하는 것이 효과적임을 증명했다.
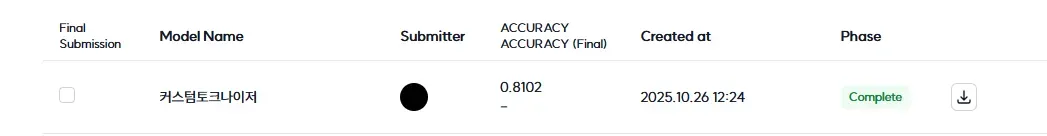
CustomTokenizer를 적용한 모델 성능
2-4. 핵심 발견: 평가 지표와 LossFunction 가중치의 불일치
커스텀 토크나이저의 성공 이후, WCE 대신 Focal Loss를 도입하고 Label Smoothing, Cosine LR Scheduler, Weight Decay, Early Stopping 등 다양한 정규화 기법을 적용했다. 하지만 여전히 과적합이 발생하고 성능이 0.78까지 하락하는 등 문제가 해결되지 않았다.

FocalLoss 및 정규화를 적용한 모델 성능
이 과정에서 세 가지 근본적인 문제를 발견했다.
- 평가지표의 불일치: 과적합을 막기 위해
eval/loss를 모니터링 기준으로 삼았으나, 대회의 최종 평가지표는test/accuracy였다.eval/loss가 낮아도accuracy가 높지 않은 경우가 발생했다. 그리고 평가지표가eval/loss여서eval/accuracy가 감소하며 모델이 과적합 되고 있음에도 early stopping의 기준은 loss여서 early stopping이 작동하지 않는 문제가 있었다. - 잘못된 \(\alpha\) 가중치: 데이터 불균형을 해결하기 위해 클래스 빈도의 역수를 Focal Loss의
alpha가중치로 설정했다([0.11, 0.45, 0.12, 0.32]). 하지만 이는 모델이 소수 클래스를 과도하게 예측하도록 만들었고, 오히려 다수 클래스의accuracy를 깎아 먹는 원인이 되었다. 이전의 WCE와 같은 가중치를 주어서 같은 결과를 얻게 되었다. WCE를 사용할떄는 K-Fold, 커스텀토크나이저와 함께 실험을 해서, 어떤것이 성능에 악영향을 미치는지 알 수 없었지만, 나머지 요인들을 통제변인으로 설정하고 조작변인으로 가중치만을 두어서 실험한 결과, 소수 클래스를 과도하게 예측하는것이 성능에 오히려 악영향을 미침을 확인할 수 있었다. - 하이퍼파라미터 튜닝: Early Stopping, Label Smooting, Learning Rate Scheduler종류, Weight Decay등 모델의 성능에 영향을 미치는 수치들을 임의로 설정해서 정규화를 적용했음에도 성능이 나오지 않는것 같았다. 따라서 하이퍼파라미터 튜닝을 통해 최적의 세팅값을 찾아나가야 함을 발견했다.
전환점: 위의 세가지 문제를 해결하기 위해 세가지를 동시에 수정했다.
- 평가 지표를 eval/loss에서 eval/accuracy로 변경.
- Focal Loss의 \($\alpha\)가중치를 [1,1,1,1], 즉 균등분포로 설정
- 하이퍼파라미터 튜닝. Focal Loss의 \(\gamma\), label Smoothing, Learning Rate Scheduler종류, Weight Decay, Epoch 수 등을
sweep_config에 넣어서wandb_sweep으로 하이퍼파라미터 튜닝을 함
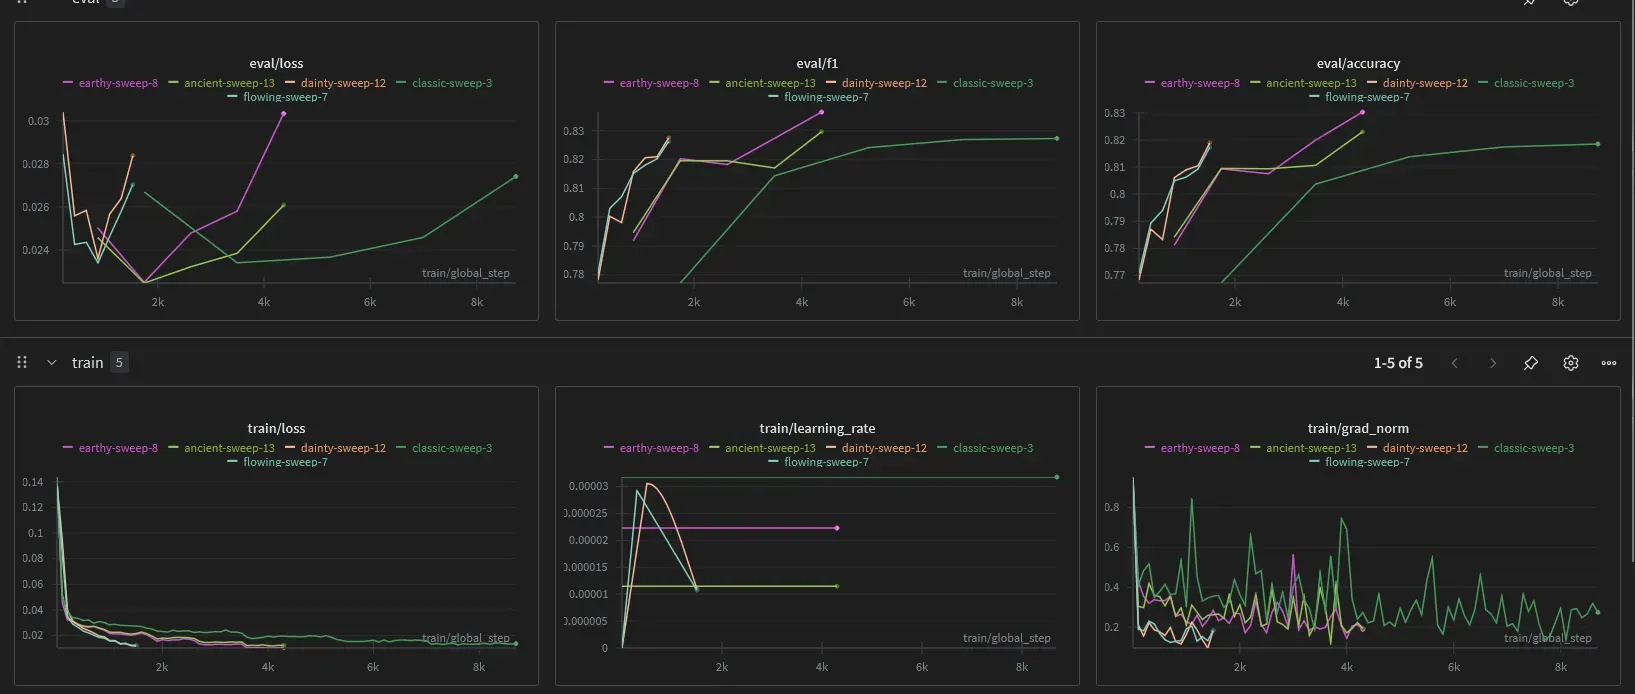
Wandb Sweep을 이용한 하이퍼파라미터 튜닝
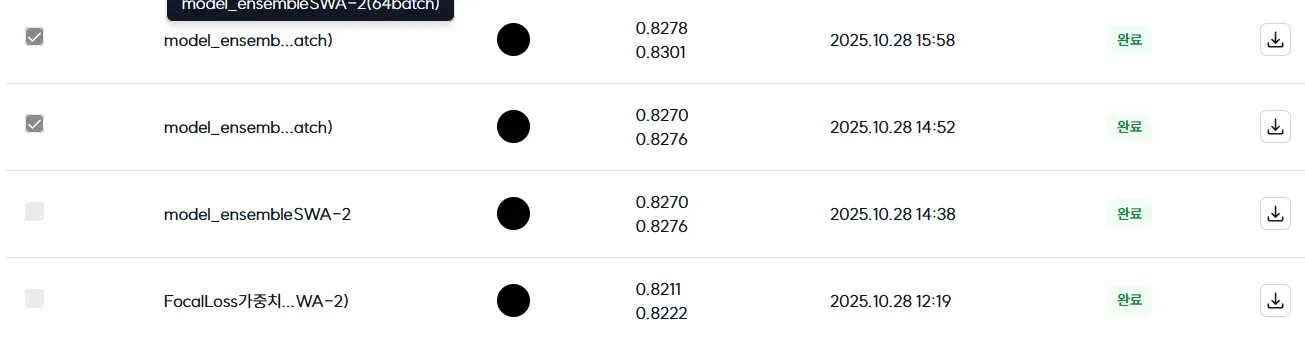
결과: 단일 모델 성능이 0.8211로 급상승하며, 지금까지의 실험 중 최고 성능을 달성했다. 이는 불균형 데이터라 할지라도, 평가지표가 Accuracy일 경우 무조건적인 소수 클래스 가중치 부여가 오히려 성능에 악영향을 미칠 수 있고, 최적의 가중치를 하이퍼파라미터 튜닝으로 찾아야 함을 의미한다. 그리고 BERT기반 3개의 모델을 앙상블 한 결과 가장 높은 성능인 0.8278을 달성함을 확인했다.
2-5 시행착오3: 시간부족으로 시도해보지 못한 시도들..
이전에서 \(\alpha\)가중치를 균등분포로 둔 이후 이 \(\alpha\)가중치를 더 정교하게 튜닝하려고 시도했다. 단순히 균등 가중치와 클래스 빈도 역수 가중치를 혼합하는 새로운 공식을 도입하여 alpha_beta_smooth라는변수명을 추가해서 HyperParameter를 다시 설계했다.
이 튜닝은 focal_loss_gamma, SWA_K, learning_rate 등 다른 주요 하이퍼파라미터까지 모두 포함하는 복잡한 실험이었다. 하지만 대회 마감 시간이 임박하여, HPT는 13 스텝밖에 수행하지 못했다.
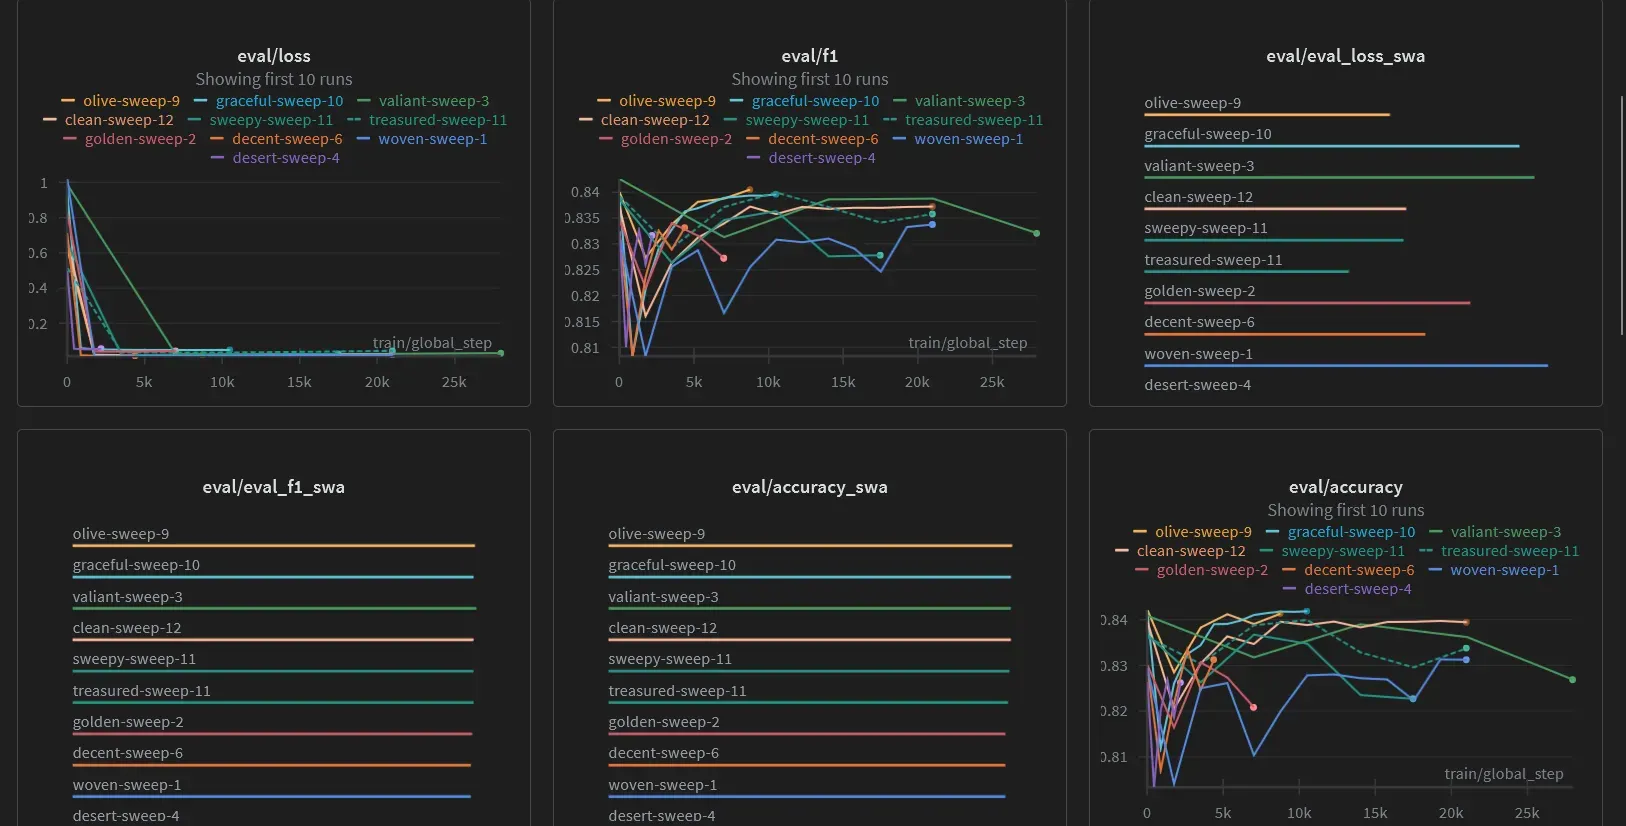
결과적으로 이 실험은 최적의 하이퍼파라미터 조합을 탐색할 충분한 시간을 갖지 못했고, 오히려 13스텝에서 도출된 값은 이전에 수동으로 찾은 균등 가중치(alpha=1)보다 성능이 낮았다. 이로 인해 HPT의 잠재력을 완전히 확인하지 못한 아쉬움이 남는다.
또한, 시간 부족으로 인해 유의미할 것으로 예상했으나 최종적으로 시도하지 못한 실험들은 아래와 같다.
- TAPT (Task-Adaptive Pre-Training): 전체 학습 데이터를 사용하여 Pre-training된 모델을 과제(영화 리뷰) 도메인에 맞게 한 번 더 Pre-training하는 기법이다. 단일모델상에서 MLM을 이용한 TAPT를 사용해서 유의미한 성능향상을 관찰했으나, 앙상블할 5개모델을 전부 Pre-Training하기에는 시간이 부족하여, BERT기반의 모델 3개
klue/bert-base,kykim/bert-kor-base,beomi/kcbert-base만 pretraining 해보고, 나머지 모델은 적용해보지 못했다. - 역번역 (Back-Translation) 데이터 증강: 소수 클래스 데이터를 증강하기 위해 코드로 구현했으나, 번역 품질이 문맥을 해치는 경우가 있어 최종 적용하지 못했다. 다만, 제공됐던 데이터셋은 이미 50%는 LLM으로 증강된 데이터여서, 증강된 데이터를 오히려 추가하면 데이터 shift가 발생할것이라고 생각되어, 증강은 적용해보지 않았다.
- 전체 데이터 재학습: 검증 데이터를 포함한 전체 학습 데이터로 모델을 재학습하여 성능을 극대화하는 단계를 진행하지 못했다. 과적합되지 않는 최적의 epoch 및 하이퍼파라미터를 찾기에는 남은 시간이 부족했고, 단일모델로 실험해본 결과, 과적합의 영향인지 유의미한 성능향상은 관찰할 수 없었다.
2-6. 최종 모델 최적화
- 커스텀 토크나이저:
[LAUGH],[CRY],[HEART],[DISPLEASED]등 감정을 표현하는 자음/모음 반복 및 이모티콘을 10여 개의 특수 토큰으로 정의했다. - Hyperparameter Tuning:
alpha가중치를 균등 분포([0.25, 0.25, 0.25, 0.25], 즉alpha=1)로 설정하는 것이 최적임을 이전의 실험을 통해 확정했다. - SWA (Stochastic Weight Averaging): 모델의 일반화 성능을 높이기 위해 SWA를 적용했다. 이때 가장 eval/acc가 높았던 체크포인트 3개를 앙상블하는 방식을 사용했다.
- Weighted Ensemble: 서로 다른 시드(Seed)를 가진 3개의 BERT 기반 모델을 학습하여 단일모델의 test/acc를 정규화 하여 weight로 주어서 Soft-voting 앙상블을 수행했다.
- Loss Function (Focal Loss):
CustomTrainerWithFocalLoss를 사용하되,alpha가중치를[1, 1, 1, 1]로 설정하여, 클래스 불균형에 대한 가중치 대신gamma를 통한 ‘어려운 샘플’ 가중치에만 집중했다. - 핵심 평가지표 설정:
TrainingArguments에서metric_for_best_model="eval_accuracy"로 설정하고,EarlyStoppingCallback또한accuracy를 모니터링하여 과적합 방지보다 최종 평가지표에 최적화된 모델을 선택했다. - Weighted Ensemble: TAPT가 적용된 3개의 서로 다른 BERT 모델을
kykim/bert-kor-base로 튜닝된 하이퍼파라미터 세트로 각각 학습시켰다. 그리고 각 모델의 test/acc를 weight로 두어서 softvoting하여 최종 레이블을 결정했다. - SWA (Stochastic Weight Averaging): 각 모델의 학습 과정에서
accuracy가 가장 높았던 마지막 3개의 체크포인트를 평균내어(SWA) 모델의 일반화 성능을 높였다. - 기타 정규화:
LabelSmoothing(약 0.18),weight_decay,constantLR 스케줄러 등 하이퍼파라미터 튜닝을 통해 발견한 정규화 기법들을 적용했다.
3. 결과
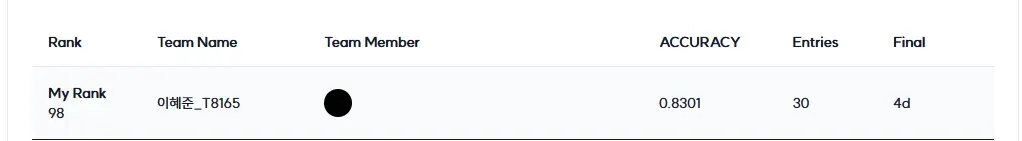
- Public Score: 0.8278
- Private Score: 0.8301 (98위/204)
4. 성찰 및 배운점
이번 프로젝트를 통해 단순히 모델성능을 향상시키는 것을 넘어, 실험을 직접 설계하고 문제의 원인을 파고들어가보는 경험을 해볼 수 있었다.
- 가설은 가설일 뿐, 실험으로 검증하라: ‘불균형 데이터 = 클래스 가중치 부여’라는 교과서적인 접근 방식이 가장 큰 함정이었다. 평가지표(
accuracy)에 맞춰 Focal Loss의alpha가중치를 오히려 균등하게 설정했을 때 성능이 상승하는것을 관찰하고, 모든 가정은 데이터와 평가지표에 기반하여 실험적으로 검증해야 한다는 교훈을 얻었다. - 하이퍼파라미터 튜닝은 가장 마지막에 해야 한다: 이번 대회에서 가장 뼈아프게 느낀 교훈이다. HPT를 미리 수행하고
kykim/bert-kor-base모델의 최적값을 찾았다고 생각했다. 하지만 대회 종료 2일을 남기고 TAPT라는 새로운 기법을 알게 되었다. TAPT를 적용하자 모델의 특성이 변해버렸고, 기존 HPT 결과는 무의미해졌다. 다시 HPT를 돌리기엔 시간이 절대적으로 부족했고, 결국 TAPT 모델에 이전 HPT 값을 그대로 적용하는 타협을 할 수밖에 없었다. EDA, Feature Engineering, TAPT, 데이터 증강 등 모델의 근본적인 구조를 바꾸는 모든 시도가 끝난 ‘최종 모델’을 대상으로, 대회가 끝나기 직전까지 HPT를 수행해야 한다는 것을 깨달았다. - 실험은 ‘전부’ 해볼 수 없다, 우선순위를 정해야 한다: HPT의 실패는 시간 관리의 실패와도 연결된다. TAPT 외에도 역번역(Back-Translation) 데이터 증강, 검증 데이터를 포함한 전체 데이터 재학습 등 시도해보고 싶은 아이디어는 많았고 코드까지 구현한 것도 있었다. 하지만 시간이 부족해 모두 시도조차 못했다. 제한된 시간과 리소스 안에서 가장 성능 향상에 ‘임팩트’가 클 것 같은 실험의 우선순위를 정하는 것이 모델링 실력만큼이나 중요하다는 것을 느꼈다.
- 모델 선정과 실험 자동화의 부재: 이번 대회는 5개의 한정된 모델을 사용했다. 가장 먼저 5개 모델을 모두 돌려보고 SOTA 모델을 확인하여 앙상블 후보군을 미리 정했어야 했다. 또한, 모든 실험을 수동으로 실행하고 결과를 기다리다 보니 하루에 10번의 제출 기회도 다 활용하지 못했다. 실험 스케줄러를 만들어 24시간 GPU를 활용하고, 모든 실험 과정을 자동화하여 제출까지 이어지는 파이프라인을 구축해야함을 배웠다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...