Week6_ML_for_RecSys_학습회고
생성 모델과 변분 추론, 그리고 EM 알고리즘의 수식적 이해를 통한 추천시스템 학습 회고
ML for RecSys 학습 회고(6주차)
목차
- 강의 복습 내용
- 학습 회고
1. 강의 복습 내용
ML for RecSys라는 주제로 추천시스템에 필요한 생성모델 이론들을 배웠다. 추천하기 위해서는 사용자의 입력데이터를 기반으로 사용자가 클릭할 가능성이 높을만한 출력을 뱉는 모델이 필요하다. 이런 모델을 만들기 위해서는 사용자의 입력데이터의 확률분포를 예측해야 하는데, 고차원의 데이터는 파라미터수가 매우 많아지므로 계산하기 어렵다는 문제가 있었다. 이를 해결하기 위해 각종 확률분포와, Jensen`s inequality, KL-divergence, MFVI, Functional derivative등의 사전지식을 배우고 이를 기반으로 Variational Inference를 통해 ELBO를 최적화 해서 사용자의 확률분포를 최적화 하는 이론을 배웠다. 과제에서는 이를 기반으로 사용자의 Kluster를 시각화해보고, 비슷한 영화를 좋아하는 사용자끼리 Klustering해보는 과제도 수행핬다.
추천시스템의 발전 동향
추천시스템 기술은 과거의 단순한 모델에서 복잡하고 정교한 최신 모델로 끊임없이 발전해왔다.
Shallow Model에서 Deep Model로
초기 추천시스템은 주로 Shallow Model에 기반했다. 대표적으로 Matrix Factorization은 사용자-아이템 평가 행렬을 저차원의 잠재 요인 행렬로 분해하여, 행렬의 비어 있는 값을 예측하는 방식으로 작동한다.
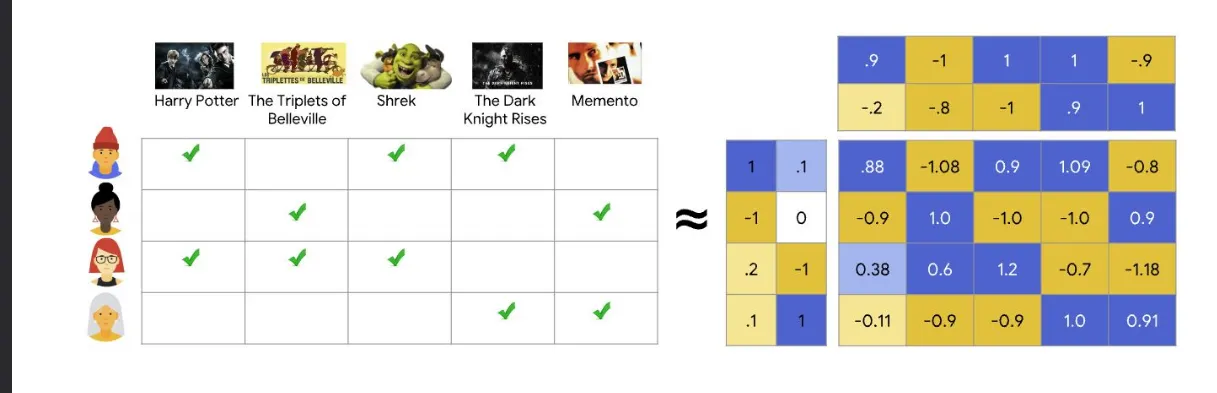
이미지출처:https://developers.google.com/machine-learning/recommendation/collaborative/matrix
이후 딥러닝 기술이 발전하면서 Deep Model이 등장했다. AutoRec과 같은 모델은 Autoencoder 구조를 활용하여 사용자의 평가 기록을 입력받아 압축(encoding)한 후, 다시 복원(decoding)하면서 평가하지 않은 항목의 점수를 예측한다. 이 모델은 비선형적인 사용자-아이템 관계를 학습할 수 있다는 장점이 있다.
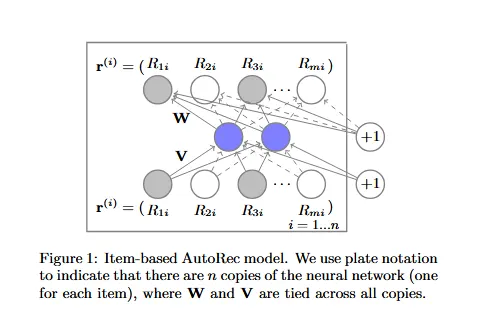
이미지출처:AutoRec: Autoencoders Meet Collaborative Filterin
Large-scale Generative Models
최근에는 Large-scale Generative Models이 추천시스템의 새로운 패러다임으로 떠오르고 있다. P5와 같은 통합 모델은 텍스트 프롬프트를 통해 별점 예측, 리뷰 요약, 직접 추천 등 다양한 추천 관련 태스크를 하나의 Multi-modal 모델로 수행할 수 있다. 또한, 이미지 생성모델인 Diffusion Model을 추천시스템에 적용하려는 연구도 활발히 진행 중이다. 이 모델은 노이즈를 점진적으로 제거하는 과정을 학습하여 새로운 데이터를 생성하는 원리를 이용한다.
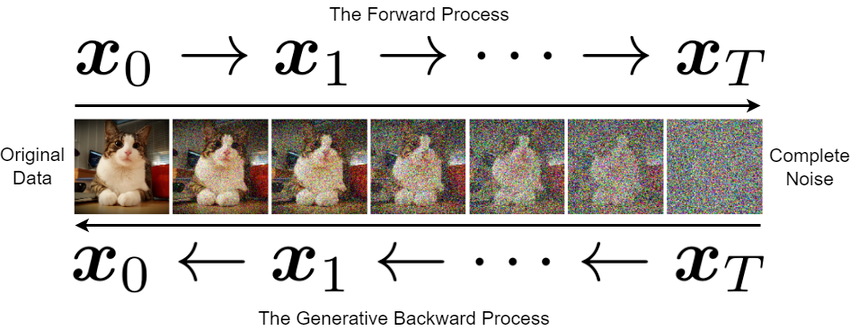
이미지출처:https://www.researchgate.net/figure/The-forward-and-backward-processes-of-the-diffusion-model-The-credit-of-the-used-images_fig1_382128283
GMM, EM 알고리즘, 그리고 변분 추론의 관계
GMM, Intractable Likelihood
가우시안 혼합 모델(Gaussian Mixture Model, GMM)은 데이터가 K개의 가우시안 분포의 혼합으로 표현된다고 가정하는 모델이다. GMM의 확률 밀도 함수는 다음과 같다.
\[p(x) = \sum_{k=1}^{K} \pi_k \mathcal{N}(x \mid \mu_k, \Sigma_k)\]여기서 \(\pi_k\)는 혼합 계수(mixing coefficient)이다. 모델의 파라미터 \(\theta = \{\pi_k, \mu_k, \Sigma_k\}_{k=1}^K\)를 찾기 위해 최대 가능도 추정(MLE)을 사용하면, 로그 가능도 함수는 다음과 같다.
\[log p(X\mid \theta) = \sum_{n=1}^{N} log \left( \sum_{k=1}^{K} \pi_k \mathcal{N}(x_n \mid \mu_k, \Sigma_k) \right)\]로그 함수 안에 합(summation)이 있어 미분을 통해 파라미터에 대한 closed-form 해를 구하기 어렵다(intractable).
GMM에서 \(\theta^*\)와 \(q^*\) 최적화
GMM과 같은 잠재 변수 모델의 학습 목표는 로그 가능도(\(log p(x;\theta)\))를 최대화하는 것이지만, 이는 계산이 불가능(intractable)하다. 대신 변분 추론에서는 로그 가능도의 하한인 ELBO(Evidence Lower Bound)를 최대화하며, 이 과정은 q와 \(\theta\)에 대해 번갈아 최적화를 수행하는 것과 같다. 이는 EM 알고리즘의 E-step과 M-step에 각각 대응된다.
\[ELBO(q, \theta) = \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} \left[ log \frac{p(x_n, z_n; \theta)}{q(z_n \mid x_n)} \right]\]GMM에서의 \(\theta^*\)와 \(q^*\) 최적화 과정
GMM과 같은 잠재 변수 모델의 학습 목표는 로그 가능도(\(log p(x;\theta)\))를 최대화하는 것이지만, 이는 계산이 불가능(intractable)하다. 대신 변분 추론에서는 로그 가능도의 하한인 ELBO(Evidence Lower Bound)를 최대화하며, 이 과정은 q와 \(\theta\)에 대해 번갈아 최적화를 수행하는 것과 같다. 이는 EM 알고리즘의 E-step과 M-step에 각각 대응된다.
ELBO의 기본 식은 다음과 같다.
\[ELBO(q, \theta) = \sum_{n=1}^{N} E_{z_n \sim q(z_n\mid x_n)} \left[ log \frac{p(x_n, z_n; \theta)}{q(z_n\mid x_n)} \right]\]최적의 \(q^*\) 찾기 (E-step의 원리)
먼저, 파라미터 \(\theta\)를 고정한 상태에서 ELBO를 최대화하는 최적의 분포 \(q^*\)를 찾아본다. ELBO와 로그 가능도의 관계식은 다음과 같다.
\[log p(x_n;\theta) = ELBO + D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))\]여기서 \(log p(x_n;\theta)\)는 현재 \(\theta\)에 대해 고정된 상수 값이다. 따라서 ELBO를 최대화하는 것은 \(D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))\) 항을 최소화하는 것과 같다.
KL Divergence는 두 분포가 동일할 때 그 값이 0으로 최소가 된다. 그러므로 최적의 \(q^*\)는 실제 사후 분포(true posterior)와 같다.
\[q^*(z_n\mid x_n) = p(z_n\mid x_n;\theta)\]이 과정이 EM 알고리즘에서 현재 파라미터를 바탕으로 각 데이터 포인트의 잠재 변수 사후 확률\(\gamma(z_{nk})\)을 계산하는 E-step에 해당한다.
최적의 \(\theta^*\) 찾기 (M-step의 원리)
다음으로, 분포 q를 고정한 상태에서 ELBO를 최대화하는 최적의 파라미터 \(\theta^*\)를 찾는다. ELBO 식에서 \(\theta\)와 무관한 항인 \(log q(z_n\mid x_n)\)을 제외하고 식을 정리하면 다음과 같다.
이 식은 로그 가능도의 기댓값을 최대화하는 것과 같다. GMM의 경우, 이 기댓값은 다음과 같이 구체적으로 표현할 수 있다.
- \(log p(z_n; \theta)\)는
k번째 가우시안이 선택될 사전 확률이므로 \(log \pi_k\)에 해당한다. - \(log p(x_n\mid z_n; \theta)\)는
k가 주어졌을 때 \(x_n\)이 나타날 확률이므로 \(log \mathcal{N}(x_n; \mu_k, \Sigma_k)\)에 해당한다 .
따라서 GMM에 대한 목적식 \(J(\mathcal{X};\theta)\)는 다음과 같이 정리된다.
\[J(\mathcal{X};\theta) = \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} \sum_{k=1}^{K} q(z_n=k\mid x_n) (log \pi_k + log \mathcal{N}(x_n; \mu_k, \Sigma_k))\]이 목적식을 각 파라미터(\(\mu_k, \Sigma_k, \pi_k\))에 대해 미분하여 0이 되는 지점을 찾으면, 이것이 바로 EM 알고리즘의 M-step에서 파라미터를 업데이트하는 수식과 동일한 결과를 얻게 된다.
\(q^*\)최적화 (E-step)
먼저, 파라미터 \(\theta\)를 고정한 상태에서 ELBO를 최대화하는 최적의 분포 \(q^*\)를 찾아본다. ELBO와 로그 가능도의 관계식은 다음과 같다.
\[log p(x_n;\theta) = ELBO + D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))\]여기서 \(log p(x_n;\theta)\)는 현재 \(\theta\)에 대해 고정된 상수 값이다. 따라서 ELBO를 최대화하는 것은 \(D_{KL}(q(z_n\mid x_n) \mid \mid p(z_n\mid x_n;\theta))\) 항을 최소화하는 것과 같다.
KL Divergence는 두 분포가 동일할 때 그 값이 0으로 최소가 된다. 그러므로 최적의 \(q^*\)는 실제 사후 분포(true posterior)와 같다.
\[q^*(z_n\mid x_n) = p(z_n \mid x_n;\theta)\]이 과정이 EM 알고리즘에서 현재 파라미터를 바탕으로 각 데이터 포인트의 잠재 변수 사후 확률(\(\gamma(z_{nk})\))을 계산하는 E-step에 해당한다.
\(\theta^*\) 최적화 (M-step)
다음으로, 분포 q를 고정한 상태에서 ELBO를 최대화하는 최적의 파라미터 \(\theta^*\)를 찾는다. ELBO 식에서 \(\theta\)와 무관한 항인 \(log q(z_n\mid x_n)\)을 제외하고 식을 정리하면 다음과 같다.
이 식은 로그 가능도의 기댓값을 최대화하는 것과 같다. GMM의 경우, 이 기댓값은 다음과 같이 구체적으로 표현할 수 있다.
- \(log p(z_n; \theta)\)는
k번째 가우시안이 선택될 사전 확률이므로 \(log \pi_k\)에 해당한다. - \(log p(x_n\mid z_n; \theta)\)는
k가 주어졌을 때 \(x_n\)이 나타날 확률이므로 \(log \mathcal{N}(x_n; \mu_k, \Sigma_k)\)에 해당한다.
따라서 GMM에 대한 목적식 \(J(\mathcal{X};\theta)\)는 다음과 같이 정리된다.
\[J(\mathcal{X};\theta) = \underset{\theta}{\mathrm{argmax}} \sum_{n=1}^{N} \sum_{k=1}^{K} q(z_n=k\mid x_n) (log \pi_k + log \mathcal{N}(x_n; \mu_k, \Sigma_k))\]이 목적식을 각 파라미터(\(\mu_k, \Sigma_k, \pi_k\))에 대해 미분하여 0이 되는 지점을 찾으면, 이것이 바로 EM 알고리즘의 M-step에서 파라미터를 업데이트하는 수식과 동일한 결과를 얻게 된다.
EM : Intractable한 GMM에서 분포 구하기
Intractable 문제를 해결하기 위해 잠재 변수(latent variable) z를 도입한다. z는 데이터 포인트 \(x_n\)이 어떤 가우시안 분포에서 생성되었는지를 나타내는 K차원의 이진 랜덤 벡터이다.
잠재 변수를 도입하면, 로그 가능도의 하한(ELBO)을 최대화하는 문제로 전환할 수 있으며, 기대값-최대화(Expectation-Maximization, EM) 알고리즘을 통해 파라미터를 반복적으로 업데이트하여 해를 찾을 수 있다.
-
E-step (Expectation): 현재 파라미터 \(\theta^{old}\)를 사용하여 잠재 변수의 사후 확률(posterior)인 \(\gamma(z_{nk})\)을 계산한다. 이는
\[\gamma(z_{nk}) = p(z_{nk}=1 \mid x_n, \theta^{old}) = \frac{\pi_k^{old} \mathcal{N}(x_n \mid \mu_k^{old}, \Sigma_k^{old})}{\sum_{j=1}^{K} \pi_j^{old} \mathcal{N}(x_n \mid \mu_j^{old}, \Sigma_j^{old})}\]n번째 데이터가k번째 가우시안으로부터 생성되었을 확률을 의미한다. -
M-step (Maximization): E-step에서 계산한 책임을 사용하여 완전 데이터 로그 가능도의 기댓값을 최대화하는 새로운 파라미터 \(\theta^{new}\)를 계산한다.
\(\mu_k^{new} = \frac{\sum_{n=1}^{N} \gamma(z_{nk}) x_n}{\sum_{n=1}^{N} \gamma(z_{nk})}\) \(\Sigma_k^{new} = \frac{\sum_{n=1}^{N} \gamma(z_{nk}) (x_n - \mu_k^{new})(x_n - \mu_k^{new})^T}{\sum_{n=1}^{N} \gamma(z_{nk})}\) \(\pi_k^{new} = \frac{\sum_{n=1}^{N} \gamma(z_{nk})}{N}\)
변분 추론: 더 일반적인 접근
EM 알고리즘은 GMM처럼 잠재 변수의 사후 확률 \(p(z\mid x, \theta)\)를 정확하게 계산할 수 있는 모델에 효과적이다. GMM은 prior가 Gaussian distribution이기 때문에 posterior를 정확하게 계산할 수 있다. 하지만 VAE와 같은 복잡한 딥러닝 모델에서는 이 사후 확률이 매우 복잡하여 계산이 불가능(intractable)하다.
변분 추론(Variational Inference, VI)은 이러한 경우에 사용되는 더 일반적인 근사 추론 기법이다. VI는 계산 불가능한 실제 사후 분포 \(p(z \mid x)\)를 다루기 쉬운 간단한 분포 \(q(z\mid x)\)(예: 가우시안 분포)로 근사한다. VI의 목표는 \(q(z\mid x)\)와 \(p(z\mid x)\) 사이의 KL Divergence를 최소화하는 것이다. 이는 데이터의 로그 가능도에 대한 증거 하한(Evidence Lower Bound, ELBO)을 최대화하는 것과 같다.
결론적으로, EM 알고리즘은 VI의 특별한 경우로 볼 수 있다. 즉, EM 알고리즘의 E-step이 바로 근사 분포 q(z)를 실제 사후 분포 p(z\mid x)와 같게 설정하는 과정에 해당한다. VI는 여기서 더 나아가 사후 분포를 직접 계산할 수 없을 때, 이를 근사하는 q(z)를 도입하여 문제를 해결하는 일반적인 방식이다.
VAE와 Variational Inference
VAE의 목표와 변분 추론의 역할
VAE는 잠재 변수 z를 포함하는 생성 모델로, 가능도 \(p(x)\)는 다음과 같이 표현된다.
이 적분은 계산이 불가능하므로, 변분 추론을 통해 ELBO를 최대화하는 방향으로 모델을 학습시킨다.
ELBO(Evidence Lower Bound)의 상세 유도 과정
데이터 포인트 \(x_i\)의 로그 가능도 \(log p(x_i)\)는 다음과 같이 전개된다. 여기서 \(q_i(z)\)는 \(q(z\mid x_i)\)를 의미한다.
\[\begin{aligned} log p(x_i) &= log \int p(x_i, z) dz \\ &= log \int q_i(z) \frac{p(x_i, z)}{q_i(z)} dz \\ &= log E_{z \sim q_i(z)} \left[ \frac{p(x_i, z)}{q_i(z)} \right] \\ &\ge E_{z \sim q_i(z)} \left[ log \frac{p(x_i, z)}{q_i(z)} \right] \quad (\text{젠슨 부등식, log는 concave 함수}) \\ &= E_{z \sim q_i(z)} [log p(x_i, z) - log q_i(z)] \\ &= E_{z \sim q_i(z)} [log p(x_i\mid z)p(z) - log q_i(z)] \\ &= E_{z \sim q_i(z)} [log p(x_i\mid z)] + E_{z \sim q_i(z)} [log p(z) - log q_i(z)] \\ &= E_{z \sim q_i(z)}[log p_\theta(x_i\mid z)] - D_{KL}(q_\phi(z\mid x_i) \mid \mid p(z)) \end{aligned}\]마지막 줄의 식이 바로 ELBO이다.
ELBO와 KL Divergence의 관계
로그 가능도는 ELBO와 KL Divergence의 합으로 정확히 분해될 수 있다.
\[\begin{aligned} D_{KL}(q_i(z) \mid \mid p(z\mid x_i)) &= E_{z \sim q_i(z)} \left[ log \frac{q_i(z)}{p(z\mid x_i)} \right] \\ &= E_{z \sim q_i(z)} \left[ log \frac{q_i(z) p(x_i)}{p(x_i, z)} \right] \\ &= E_{z \sim q_i(z)} [log q_i(z) - log p(x_i, z) + log p(x_i)] \\ &= -ELBO + log p(x_i) \end{aligned}\]따라서, \(log p(x_i) = ELBO + D_{KL}(q_i(z) \mid \mid p(z\mid x_i))\) 이다. \(log p(x_i)\)는 고정된 값이므로, ELBO를 최대화하는 것은 근사 사후 분포 \(q_i(z)\)와 실제 사후 분포 \(p(z\mid x_i)\) 간의 KL Divergence를 최소화하는 것과 같다.
VAE의 손실 함수와 KL Divergence 계산
VAE의 손실 함수 \(L_i = -ELBO\)는 다음과 같이 두 항으로 구성된다.
\[L_i = \underbrace{-E_{z \sim q_\phi(z\mid x_i)}[log p_\theta(x_i\mid z)]}_{\text{Reconstruction Loss}} + \underbrace{D_{KL}(q_\phi(z\mid x_i) \mid \mid p(z))}_{\text{Regularization Loss}}\]여기서 정규화 항인 KL Divergence는 \(q_\phi(z\mid x_i) = \mathcal{N}(\mu_q, \Sigma_q)\)와 \(p(z) = \mathcal{N}(\mu_p, \Sigma_p)\) (일반적으로 표준정규분포) 사이의 거리로, 다음과 같이 해석적으로 계산할 수 있다.
Reparameterization Trick
VAE 학습에서 잠재 변수 z는 확률 분포 \(q_\phi(z\mid x)\)로부터 샘플링되는데, 이 과정은 미분이 불가능하여 역전파(backpropagation)가 중단된다. 이를 해결하기 위해 Reparameterization Trick을 사용한다. z를 직접 샘플링하는 대신, \(\mu\)와 \(\sigma\)는 결정적으로 계산하고 랜덤 노이즈 \(\epsilon\)을 외부에서 샘플링하여 연산하는 방식으로 z를 계산한다. 이를 통해 샘플링된 \(\mu, \sigma\)는 그라디언트가 흐를 수 있어서, 미분을 통한 최적화가 가능해진다.
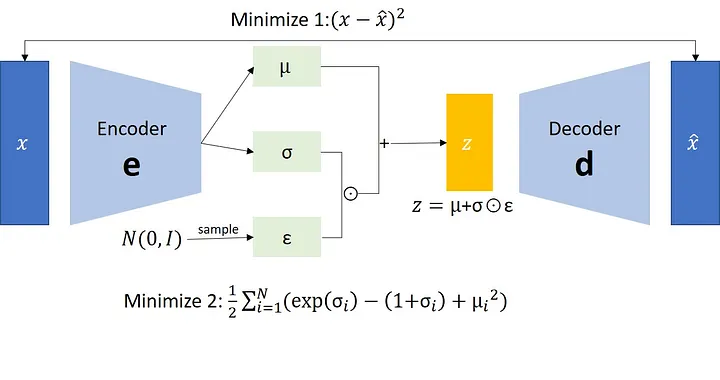
이미지출처: https://www.google.com/url?q=https%3A%2F%2Fmedium.com%2Fgeekculture%2Fvariational-autoencoder-vae-9b8ce5475f68
추천시스템 구현 실습
이론 학습을 바탕으로 AutoRec과 VAE 모델을 직접 구현하고, MovieLens 데이터셋에 적용하여 추천시스템을 구축했다.
AutoRec 모델 구현 및 학습
import torch
import torch.nn as nn
import torch.optim as optim

class AutoRec(nn.Module):
    def __init__(self, input_size, hidden_size):
        super(AutoRec, self).__init__()
        self.encoder = nn.Linear(input_size, hidden_size)
        self.decoder = nn.Linear(hidden_size, input_size)

    def forward(self, ratings):
        encoded = torch.sigmoid(self.encoder(ratings))
        decoded = self.decoder(encoded)
        return decoded
손실 함수: \(loss = \text{criterion}(inputs, outputs) + 0.5 \times \text{weight_decay_loss}(\text{model, lambda_value})\)
VAE 모델 구현 및 학습
class VAE(nn.Module):
    def __init__(self, input_dim, latent_dim):
        super(VAE, self).__init__()
        # Encoder, Decoder 생략...
        self.encoder = nn.Sequential(
            nn.Linear(input_dim, 512),
            nn.ReLU(),
            nn.Linear(512, 256),
            nn.ReLU(),
            nn.Linear(256, latent_dim * 2) # mu, logvar
        )
        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, 256),
            nn.ReLU(),
            nn.Linear(256, 512),
            nn.ReLU(),
            nn.Linear(512, input_dim),
        )

    def reparameterize(self, mu, logvar):
        std = torch.exp(0.5 * logvar)
        eps = torch.randn_like(std)
        return mu + eps * std

    def forward(self, x):
        encoded = self.encoder(x)
        mu, logvar = encoded[:,:self.latent_dim], encoded[:, self.latent_dim:]
        z = self.reparameterize(mu, logvar)
        decoded = self.decoder(z)
        return decoded, mu, logvar
Loss_function: \(Loss=MSE+KLD\) \(KLD=−0.5×∑(1+logvar−μ2−exp(logvar))\)
def loss_function(recon_x, x, mu, logvar):
    MSE = nn.functional.mse_loss(recon_x, x)
    KLD = -0.5 * torch.sum(1 + logvar - mu**2 - torch.exp(logvar))
    return MSE + KLD
VAE 잠재 벡터를 활용한 사용자 클러스터링
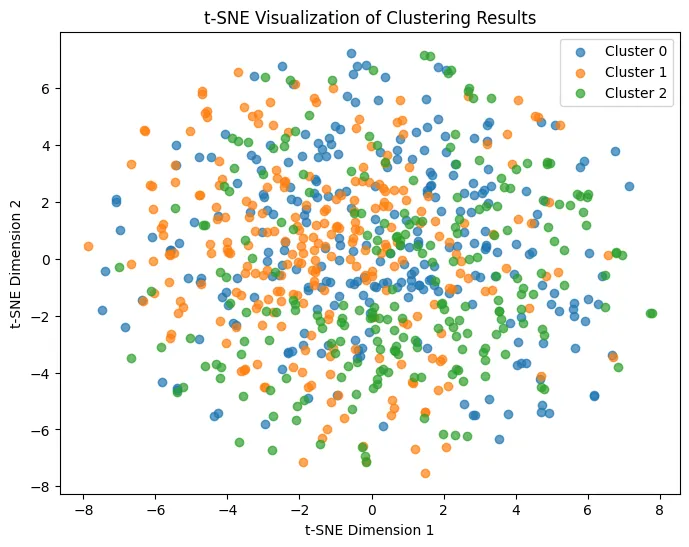
학습된 VAE의 Encoder를 통해 얻은 사용자 잠재 벡터 z를 K-Means로 클러스터링하고 t-SNE로 시각화했다. 이를 통해 모델이 사용자의 선호도 패턴을 어떻게 잠재 공간에 인코딩했는지 확인할 수 있었다.
2. 학습 회고
이번주는 생성모델의 이론적 기반을 주로 다루었다. diffusion모델에서도 사용되는 Variational Inference는 계산하기 어려운 (Intractable)한 수식을 ELBO를 최적화 함으로써 확률분포를 근사하는 방식인데, 필요한 배경지식이 상당히 많이 필요한데, 배경지식이 없어서 찾아보며 공부했다. 이번주 공부하며 느낀것이 있는데, RecSys든 CV든 NLP든 백본은 어차피 모두 같다는 것이다. Transformer모델을 Vision에서 사용하는것은 이미 트렌드를 넘어선 고전이 되었고, diffusion모델에서만 사용하는 줄 알았던 VI는 RecSys에서 확률분포를 근사해서 추천을 하는데에도 사용이 되고있다. 어느분야든지 백본은 연결되어있다는 인상을 받았다.
공부를 하면 할수록 알아야할 내용도 많아지고 내 머리는 감자라는 생각이 자꾸 든다. 1강부터 확률분포 종류가 쏟아지는데, 각 확률분포의 Probability Density Function들이 너무 낯설어서 의미를 생각하는데에도 시간이 많이 걸렸다. 한주가 끝나고 주말이 지난 지금도, 변분추론을 통한 확률분포 근사가 완벽하게 이해되지는 않은 것 같다. 다만, 왜 근사를 해야하고, MFVI가 왜필요했는지, 어떤 방식과 과정을 통해 근사를 하는지는 이해를 해나갔다.
이번주 학습을 통해서 생성모델과 조금더 친해진것 같다. 그런데, 더 친해지려면 \(KL(내머리\mid \mid Generative Model)\)를 줄여야겠다. 그러려면 변분추론을 이용한 diffusion모델 논문도 읽어보고, 아직 읽어보지 못한 생성모델을 이용한 RecSys 논문도 읽어봐야 겠다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...