Week5_NLP_학습회고
Week5_NLP_학습회고
Computer Vision 학습 회고 (4주차)
목차
- 강의 복습 내용
- 학습 회고
1. 강의 복습 내용
일주일간 자연어 처리(NLP)의 기초적인 개념부터 순차적인 모델링까지 학습한 내용을 정리하고 회고한다. 토큰화, 단어 임베딩, 그리고 순환 신경망(RNN)의 구조와 문제점, 그리고 그 해결책인 LSTM과 GRU에 대해 다룬다.
자연어의 벡터 표현
컴퓨터가 자연어를 이해하고 처리하기 위해서는 텍스트를 숫자 형태의 벡터로 변환하는 과정이 필수적이다. 이 과정은 토큰화와 임베딩으로 나눌 수 있다.
토큰화 (Tokenization)
토큰화는 주어진 텍스트(Corpus)를 토큰(Token)이라는 의미 있는 단위로 분리하는 작업이다. 자연어 처리 모델은 이 토큰을 입력으로 받아 처리하며, 토큰화 방식에 따라 모델의 성능이 크게 달라질 수 있다.
토큰화의 종류
토큰화는 분리하는 단위에 따라 크게 3가지로 나눌 수 있다.
- 단어 수준 토큰화 (Word-level Tokenization): 텍스트를 띄어쓰기나 형태소(의미 단위)를 기준으로 분리한다. 직관적이지만, 사전에 없는 단어(Out-of-Vocabulary, OOV)가 등장하면 모두
[UNK](Unknown) 토큰으로 처리되어 정보 손실이 발생하는 단점이 있다. - 문자 수준 토큰화 (Character-level Tokenization): 텍스트를 문자(철자) 단위로 분리한다. 이 방식은 OOV 문제를 해결할 수 있다는 장점이 있지만, 토큰의 개수가 너무 많아져 문장이 길어질 경우 처리하기 어렵고, 각 토큰이 유의미한 의미를 갖기 힘들어 모델 성능이 저하될 수 있다.
- 서브워드 수준 토큰화 (Subword-level Tokenization): 단어와 문자 수준 토큰화의 장점을 결합한 방식이다. 자주 사용되는 단어는 그대로 유지하고, 자주 사용되지 않는 단어는 의미 있는 서브워드(subword) 단위로 분리한다. 이를 통해 OOV 문제를 해결하면서도 토큰의 길이를 효율적으로 관리할 수 있다.
Byte Pair Encoding (BPE)
BPE는 대표적인 서브워드 토큰화 알고리즘이다. 동작 원리는 다음과 같다.
- 모든 단어를 문자(character) 단위로 분리하여 초기 단어장(vocabulary)을 구성한다.
- 학습 데이터에서 가장 빈번하게 등장하는 문자 쌍(pair)을 찾아 하나의 새로운 토큰으로 병합하고, 단어장에 추가한다.
- 원하는 단어장 크기가 될 때까지 2번 과정을 반복한다.
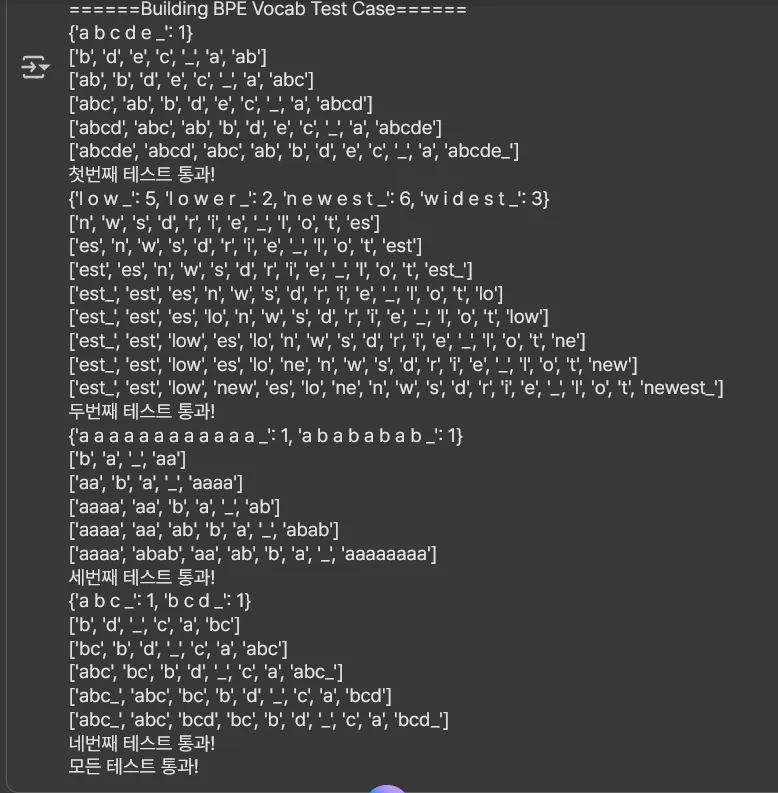
새로운 텍스트가 입력되면, 사전에 정의된 가장 긴 문자열을 우선적으로 찾아 토큰으로 매칭한다. 예를 들어, 단어장에 “est”와 “st”가 모두 있다면 “newest”는 [“n”, “e”, “w”, “est”]로 토큰화된다.
단어 임베딩 (Word Embedding)
토큰화된 단어들을 밀집 벡터(Dense Vector)로 표현하는 것을 단어 임베딩이라고 한다.
One-Hot Encoding의 한계
One-Hot 인코딩은 단어를 Categorical 변수로 보고, 단어장의 크기만큼의 차원을 가진 벡터에서 해당 단어의 인덱스만 1로, 나머지는 0으로 표현하는 방식이다. 이 방식은 단어 간의 유사도를 계산할 수 없다는 치명적인 단점이 있다. 모든 단어 벡터 간의 내적은 0이고, 유클리드 거리는 항상 \(\sqrt{2}\) 이기 때문이다.
분산 표현 (Distributed Representation)
이러한 한계를 극복하기 위해 등장한 것이 분산 표현, 즉 밀집 벡터(Dense Vector) 표현이다. 단어의 의미를 여러 차원에 분산하여 표현하며, 벡터 간의 유사도(코사인 유사도, 유클리드 거리 등)를 통해 단어의 의미적 유사성을 나타낼 수 있다.
Word2Vec
Word2Vec은 단어를 밀집 벡터로 표현하는 대표적인 방법론이다. “단어의 의미는 주변 단어에 의해 결정된다”는 분포 가설에 기반한다.
- Skip-gram: 중심 단어를 이용해 주변 단어를 예측하는 모델이다.
- CBOW (Continuous Bag of Words): 주변 단어들을 이용해 중심 단어를 예측하는 모델이다.
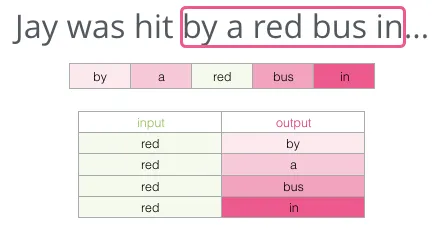
Word2Vec은 간단한 신경망 구조를 가진다. 예를 들어 “I study math”라는 문장에서 ‘study’라는 입력(중심 단어)이 주어졌을 때 ‘math’(주변 단어)를 예측하는 과정은 다음과 같다.
\[y = \text{softmax}(W_2 W_1 x)\]여기서 \(x\)는 ‘study’의 One-hot 벡터이고, \(W_1\)과 \(W_2\)는 각각 입력층에서 은닉층으로, 은닉층에서 출력층으로 가는 가중치 행렬이다. 학습을 통해 이웃한 단어의 임베딩 벡터는 높은 내적 값을 갖도록, 즉 유사도가 높아지도록 \(W_1\)과 \(W_2\)가 업데이트된다.
학습된 단어 벡터는 단어들 간의 의미적, 문법적 관계를 벡터 공간에 표현한다. 예를 들어, 다음과 같은 유추(Analogy)가 가능하다.
\[vec(\text{"queen"}) - vec(\text{"king"}) \approx vec(\text{"woman"}) - vec(\text{"man"})\]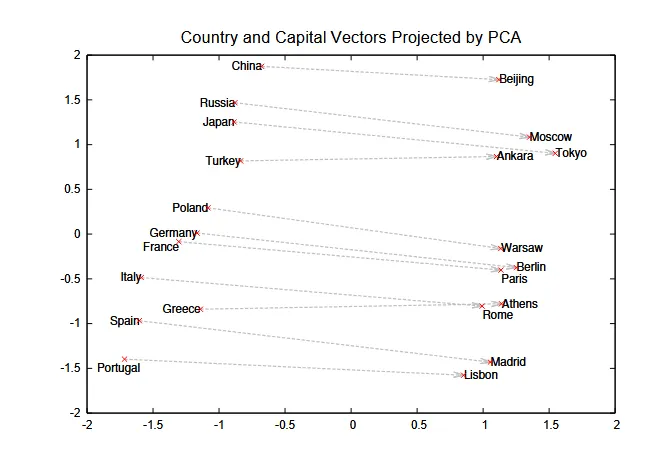
Word2Vec 학습 효율화
Word2Vec의 Skip-gram 모델은 출력층에서 Softmax를 계산할 때 단어장(Vocabulary)의 모든 단어에 대한 확률을 계산해야 하므로 계산 비용이 매우 크다. 이를 해결하기 위한 방법들이 제안되었다.
-
Negative Sampling: 전체 단어장을 대상으로 하는 다중 분류 문제를 “두 단어가 이웃하는가?”를 맞추는 이진 분류 문제로 변환한다. 실제 주변 단어(Positive sample)와 임의로 뽑은 관련 없는 단어들(Negative samples)을 구분하도록 모델을 학습시킨다. 목적 함수는 다음과 같다.
\[\log \sigma({v'_{w_O}}^{\top} v_{w_I}) + \sum_{i=1}^{k} \mathbb{E}_{w_i \sim P_n(w)}[\log \sigma(-{v'_{w_i}}^{\top} v_{w_I})]\]이 식은 정답 쌍(\(w_O, w_I\))의 내적 값은 커지게 하고, 노이즈(오답) 쌍(\(w_i, w_I\))의 내적 값은 작아지도록 학습한다.
-
Sub-sampling: “the”, “a”와 같이 매우 빈번하게 등장하는 단어들은 정보적 가치가 낮으면서 학습량만 늘리는 경향이 있다. 이러한 단어들을 특정 확률에 기반하여 학습에서 제외시켜 속도와 정확도를 높인다. 단어를 제외할 확률은 다음과 같이 계산된다.
\[P(w_i) = 1 - \sqrt{\frac{t}{f(w_i)}}\]여기서 \(f(w_i)\)는 단어 \(w_i\)의 빈도, \(t\)는 임계값이다.
순차 데이터 모델링
텍스트나 시계열 데이터와 같이 순서가 중요한 데이터를 처리하기 위해 RNN(Recurrent Neural Network)이 고안되었다.
RNN (Recurrent Neural Network)
RNN은 가변적인 길이의 시퀀스(Sequence) 데이터를 처리할 수 있는 신경망이다. 이전 타임 스텝(time step)의 정보를 현재 타임 스텝의 입력과 함께 사용하여 출력을 계산하는 순환 구조를 가진다.
RNN의 기본 구조
각 타임 스텝 \(t\)에서 RNN은 입력 벡터 \(x_t\)와 이전 타임 스텝의 은닉 상태(hidden state) \(h_{t-1}\)을 받아 새로운 은닉 상태 \(h_t\)를 계산한다.
\[h_t = f_W(h_{t-1}, x_t)\]일반적으로 활성화 함수로 tanh를 사용하여 다음과 같이 표현한다.
그리고 현재 은닉 상태 \(h_t\)를 이용해 출력 \(y_t\)를 계산할 수 있다.
\[y_t = W_{hy}h_t\]중요한 점은 모든 타임 스텝에서 동일한 가중치 행렬 \(W_{hh}\), \(W_{xh}\), \(W_{hy}\)가 공유된다는 것이다.
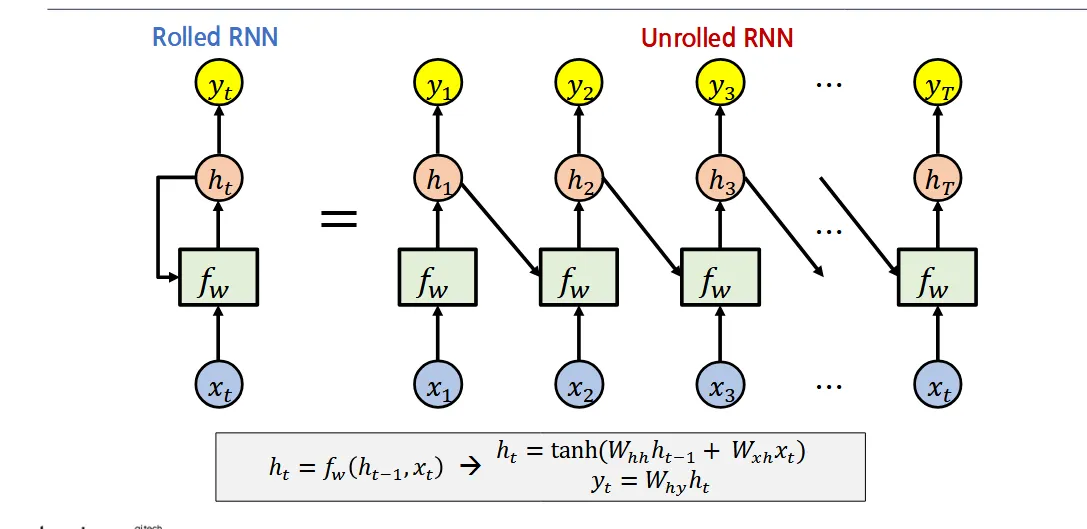
RNN은 입출력의 형태에 따라 다양하게 활용될 수 있다.
- one-to-many: 이미지 캡셔닝 (하나의 이미지 입력, 문장 출력)
- many-to-one: 감성 분석 (문장 입력, 긍정/부정 출력)
- many-to-many: 기계 번역, 개체명 인식 (시퀀스 입력, 시퀀스 출력)
RNN의 학습과 장기 의존성 문제
RNN은 BPTT(Backpropagation Through Time)를 통해 학습한다. 이는 시간의 흐름에 따라 네트워크를 펼친 후, 역전파 알고리즘을 적용하는 방식이다. 하지만 시퀀스가 길어질 경우 심각한 문제가 발생한다.
기울기 소실 및 폭주 (Vanishing/Exploding Gradients)
BPTT 과정에서 그래디언트는 체인 룰(chain rule)에 의해 여러 타임 스텝을 거슬러 전파된다. 이 과정에서 동일한 가중치 행렬(\(W_{hh}\))이 반복적으로 곱해지게 된다.
\[\frac{\partial L}{\partial h_k} = \frac{\partial L}{\partial h_t} \frac{\partial h_t}{\partial h_{t-1}} \frac{\partial h_{t-1}}{\partial h_{t-2}} \dots \frac{\partial h_{k+1}}{\partial h_k} = \frac{\partial L}{\partial h_t} \prod_{i=k+1}^{t} \frac{\partial h_i}{\partial h_{i-1}}\]이때 \(\frac{\partial h_i}{\partial h_{i-1}}\)에 해당하는 값(정확히는 \(W_{hh}\)의 고유값(Eigenvalue))의 크기가 1보다 크면 그래디언트가 기하급수적으로 커져 폭주(Exploding)하고, 1보다 작으면 0에 가깝게 사라져 소실(Vanishing)된다.
- 기울기 폭주 (Exploding Gradient): 학습이 불안정해지고 파라미터가 발산한다.
- 기울기 소실 (Vanishing Gradient): 먼 과거의 정보가 현재까지 전달되지 못해 장기 의존성(Long-term dependency) 학습에 실패한다.
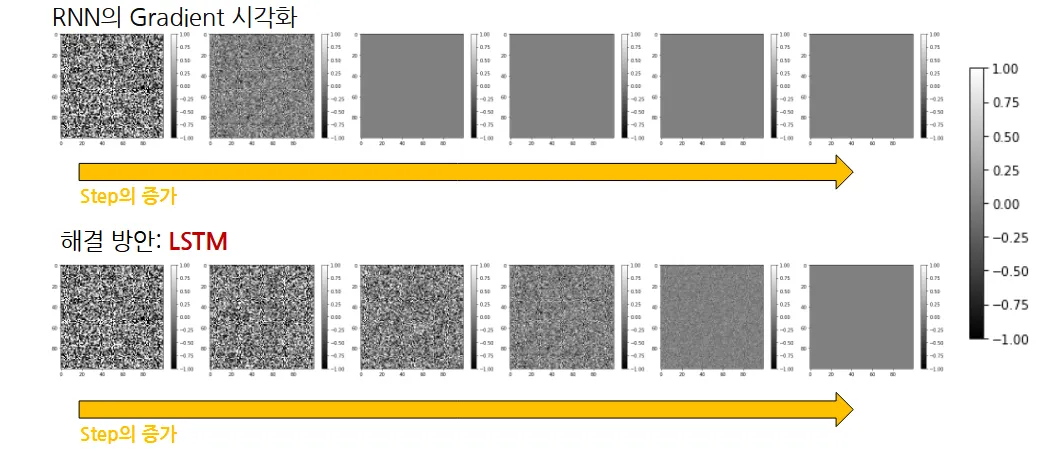
이를 해결하기 위한 방법으로는 그래디언트의 크기가 특정 임계값을 넘지 못하도록 잘라내는 그래디언트 클리핑(Gradient Clipping)이나, 전체 시퀀스가 아닌 일정 길이의 청크(chunk) 단위로만 역전파를 수행하는 Truncated BPTT 등이 있다.
LSTM과 GRU
기울기 소실 문제를 근본적으로 해결하기 위해 RNN의 내부 구조를 개선한 모델이 LSTM과 GRU이다.
LSTM (Long Short-Term Memory)
LSTM은 셀 상태(Cell State)라는 별도의 정보 흐름 경로를 추가하여 그래디언트가 장기간에 걸쳐 잘 흐르도록 설계되었다. 셀 상태는 컨베이어 벨트와 같아서, 약간의 선형적인 상호작용만 거치며 정보를 전달한다.
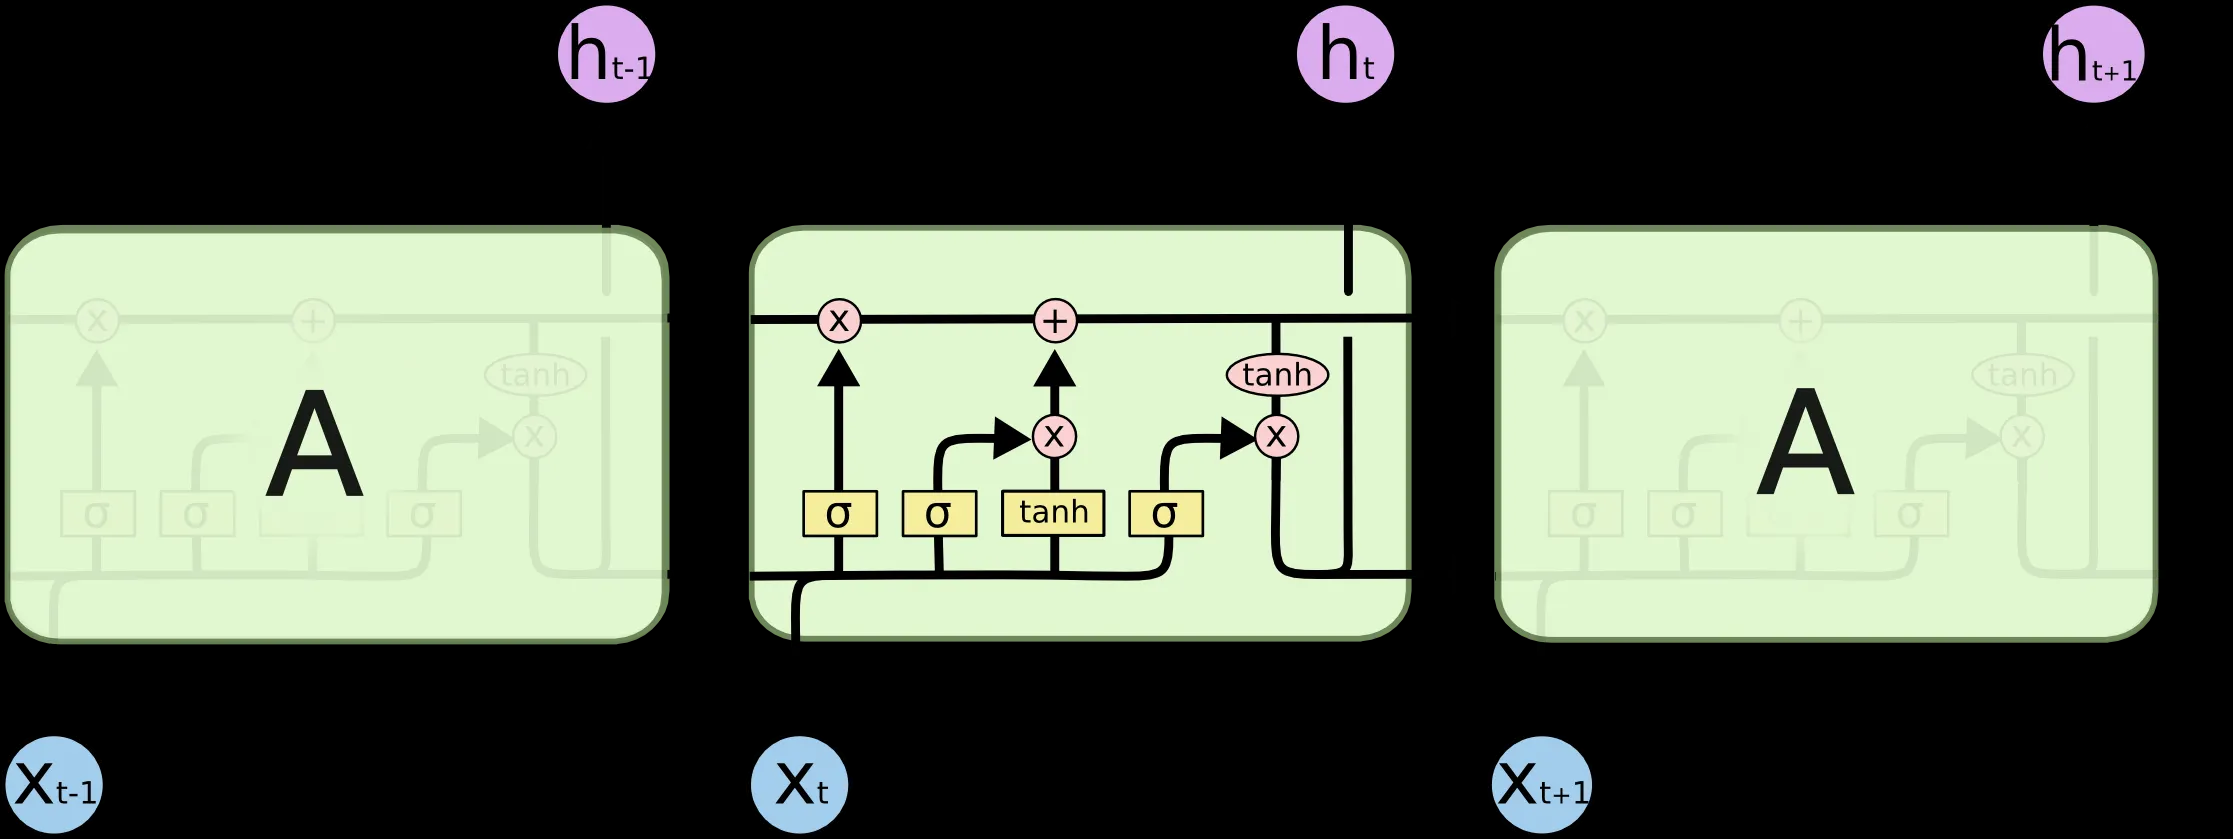
LSTM은 3개의 게이트(Gate)를 통해 셀 상태의 정보를 조절한다.
- Forget Gate (\(f_t\)): 과거 정보를 얼마나 잊을지 결정한다. Sigmoid 함수를 통해 0(모두 잊음)과 1(모두 기억) 사이의 값을 출력한다. \(f_t = \sigma(W_f[h_{t-1}, x_t] + b_f)\)
- Input Gate (\(i_t\)): 현재 정보를 얼마나 셀 상태에 저장할지 결정한다. \(i_t = \sigma(W_i[h_{t-1}, x_t] + b_i)\) \(\tilde{C}_t = \tanh(W_C[h_{t-1}, x_t] + b_C)\)
- Output Gate (\(o_t\)): 셀 상태의 정보를 얼마나 외부(hidden state)로 내보낼지 결정한다. \(o_t = \sigma(W_o[h_{t-1}, x_t] + b_o)\) \(h_t = o_t * \tanh(C_t)\)
최종적으로 새로운 셀 상태 \(C_t\)는 이전 셀 상태 \(C_{t-1}\)에서 잊을 부분을 제거하고, 새로운 정보 \(\tilde{C}_t\)에서 추가할 부분을 더하여 업데이트된다.
\[C_t = f_t * C_{t-1} + i_t * \tilde{C}_t\]이 구조에서 셀 상태의 그래디언트는 곱셈이 아닌 덧셈 연산을 통해 전달되므로, 기울기 소실 문제로부터 비교적 자유롭다.
GRU (Gated Recurrent Unit)
GRU는 LSTM의 구조를 단순화한 모델이다. 셀 상태와 은닉 상태를 하나로 통합하고, 게이트의 수도 2개(Update Gate, Reset Gate)로 줄여 계산 효율성을 높였다. 성능은 LSTM과 유사하거나 특정 태스크에서는 더 좋은 경우도 있다.
2. 소감
어느정도 공부하는데 감을 잡은것 같은 한주였다. 이번주 강의는 주재걸 교수님께서 간단하고 짧게 설명하셨는데, 오히려 Futher reading에서는 LSTM의 각 gate에 대한 설명, Gradient의 Exploding/Vanishing이 발생하는 BackPropagation에서의 이유에서 tanh 합성함수를 계속 미분했을때 공비와 연관된 문제가 있다는것, skip-gram모델을 extension해서 sub-sampling과 Negative-sampling을 사용하고, 단어의 임베딩 벡터사이의 선형연관을 밝혀낸 논문등 읽고 공부할것들이 많았다.
그리고 과제에서도 Data_preprocessing&Tokenization은 간단하게 몇줄 채워넣는 정도의 과제여서 어렵지 않았지만, 코드를 뜯어보며 이해하고 정리하는데는 시간이 걸렸었고, 특히 2번째 과제 Subword-level LanguageModel에서 코딩테스트 문제를 푸는듯하게 Counter library도 오랜만에 써서, 문장을 split()으로 분리하고, 리스트로 만들고, dict를 이용해서 id를 token으로만들고 다시 token을 id로 만드는 과정들을 돌아보며 쉽지 않았던 것 같다.
그래도 이번주는 전반적으로 LLM을 쓰지 않고 혼자서 문제들을 해결해보려 했고, 혼자서 코드들을 작성해서 문제를 해결해서 뿌듯하다. 아직 부족한게 많긴 하지만, 어떻게 무엇을 공부해야 할지 방향성이 확실하게 잡힌것 같아서 안개가 서서히 걷혀가는 기분이다.
아직 해야할게 많다. CV논문들도 봐야하고, PyTorch공부, PCA와 EigenVector, EigenValue를 이해하기 위한 선형대수도 공부해야하고, Github도 공부해야한다. 그리고 Kaggle이나 dacon 경진대회 참여를 위한 준비도 해볼 예정이다.
너무 할게 많아서 갇혀버린 기분이 들때는 가끔 학교에가서 동기들과 얘기도하고 쉬어가는 시간을 가졌던게 큰 도움이 된것 같다. 앞으로도 루틴을 유지하면서 할일을 해나가야겠다.
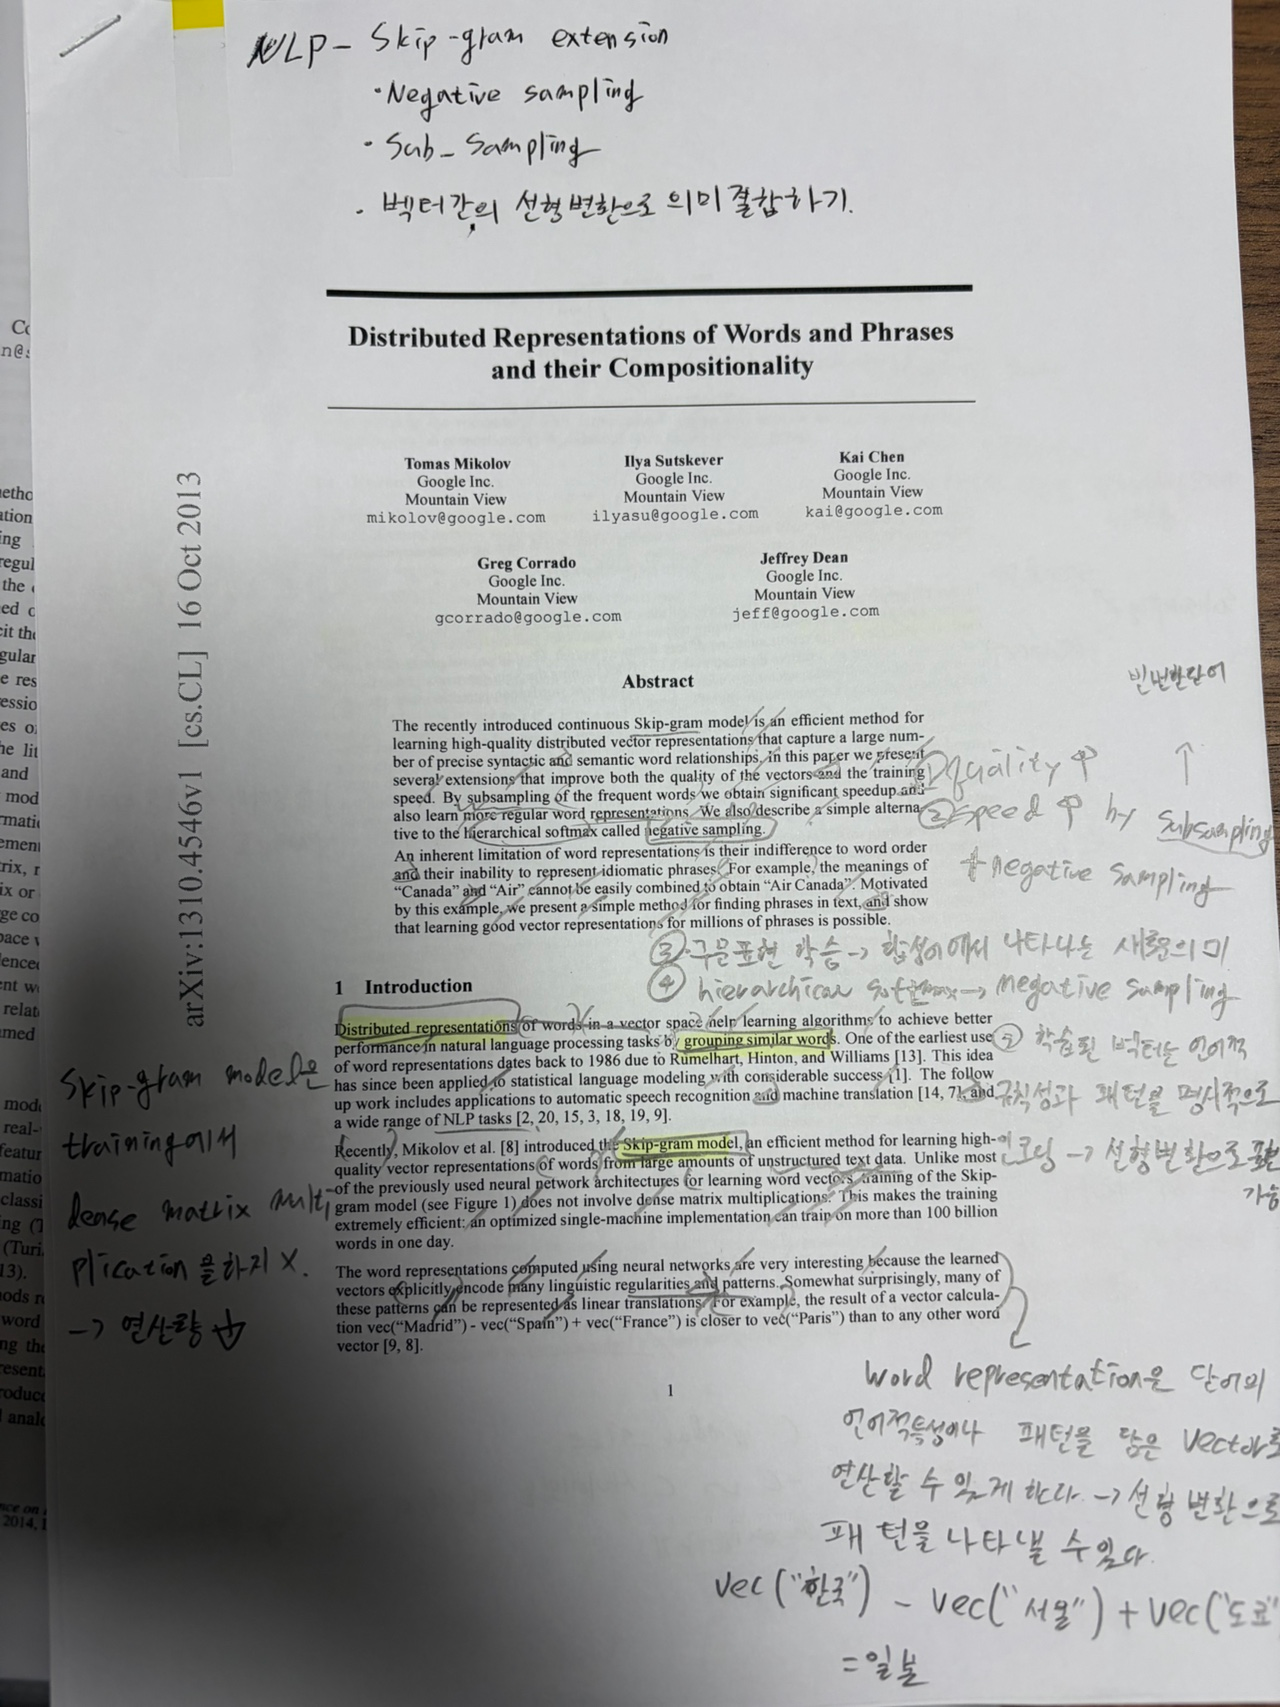 열심히공부한 흔적 1
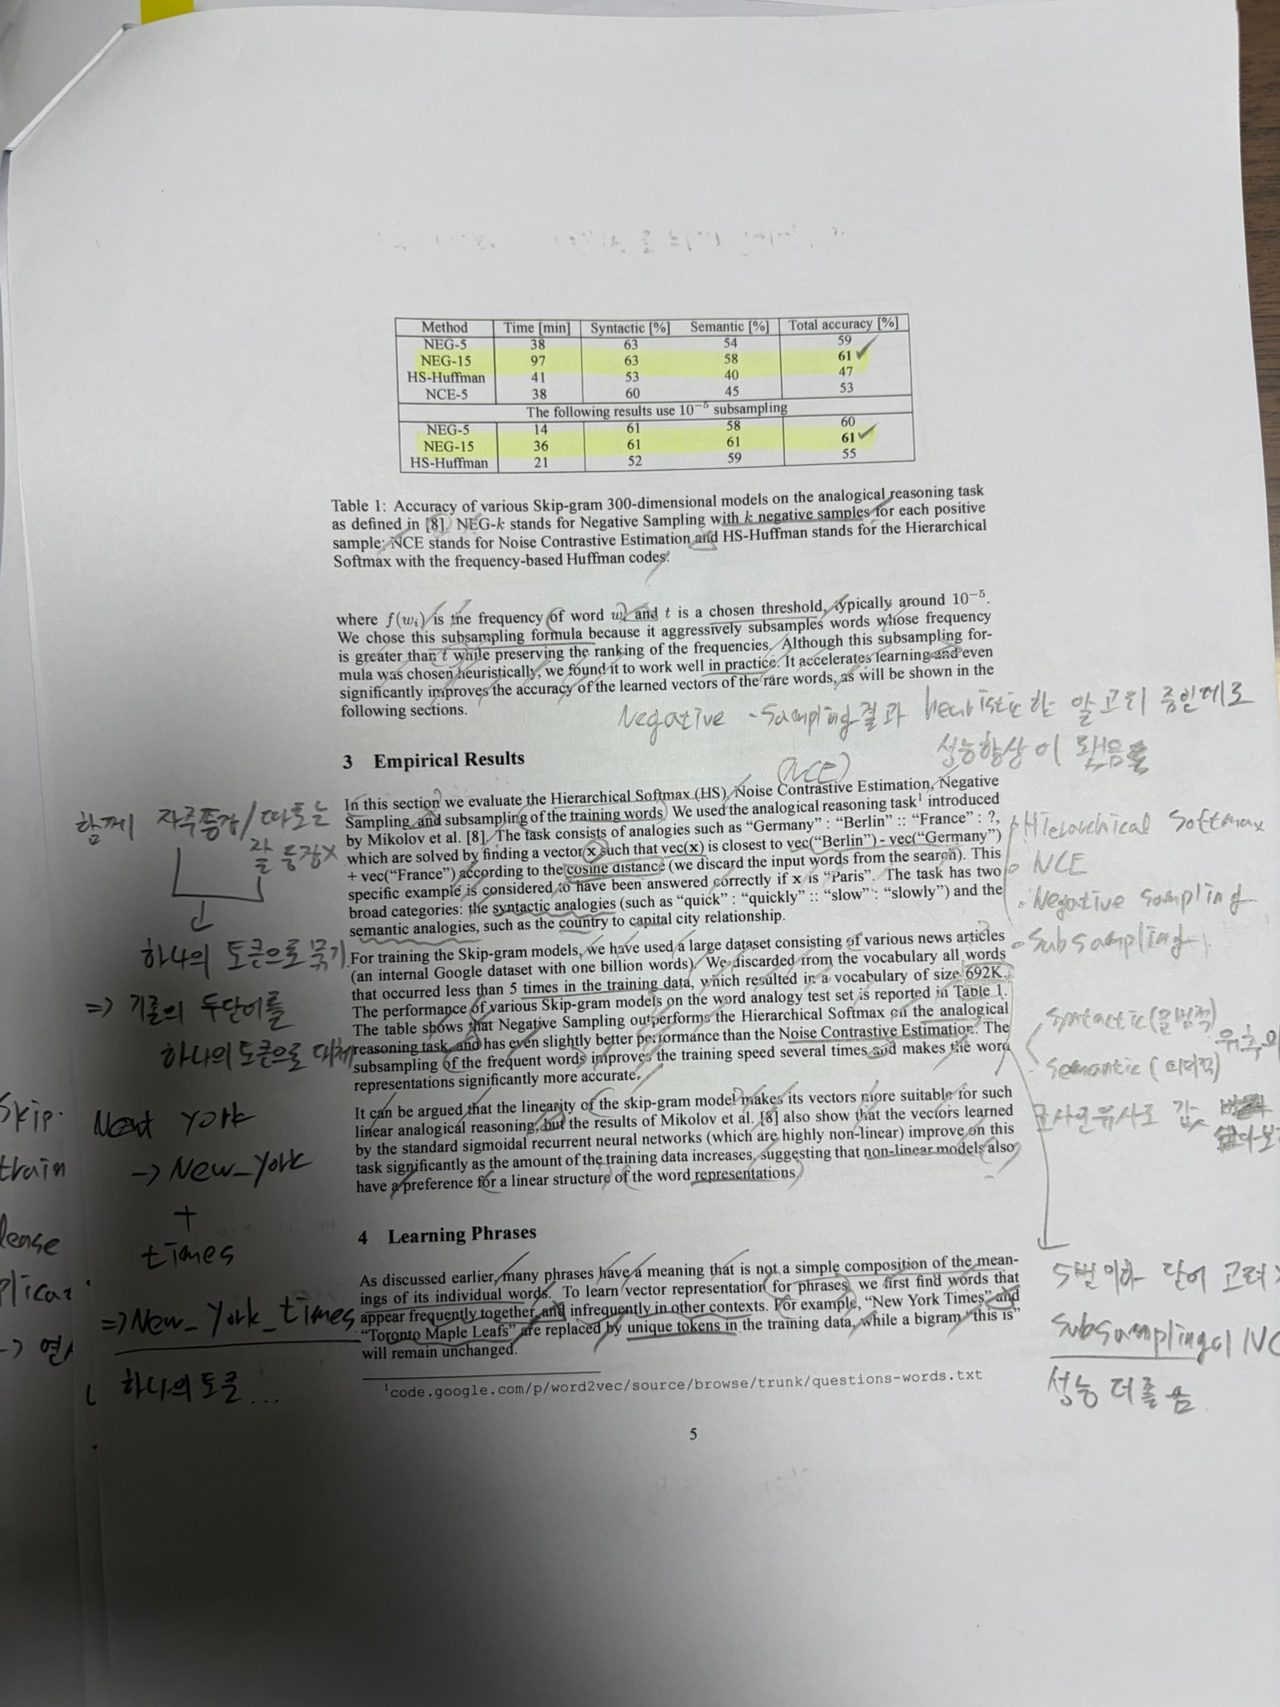 열심히 공부한 흔적 2
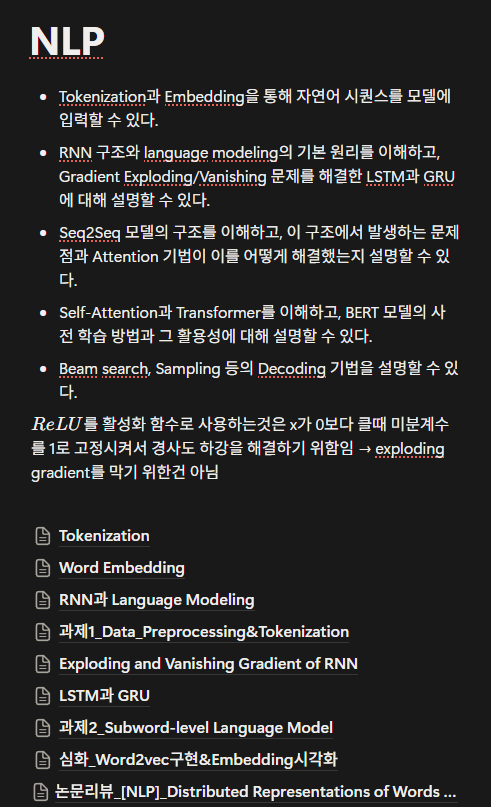 이번주에 정리한 노션
 나도실습가고싶다..
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...