Week4_Computer_Vision_학습회고
4주차 Computer Vision 회고
Computer Vision 학습 회고 (4주차)
목차
- 강의 복습 내용
- 학습 회고
1. 강의 복습 내용
1. Introduction to Computer Vision
컴퓨터 비전은 기계가 시각적 세계를 ‘이해’하고 ‘해석’하게 하는 인공지능 분야다. 본질적으로 3차원 세계가 2차원 평면에 투영된 이미지로부터 의미 있는 정보(Semantic attributes)를 추출하는 ‘Inverse Rendering’ 과정으로 정의할 수 있다. 이 과정은 빛이 카메라 센서를 통해 디지털 신호로 변환되어, 각 픽셀이 특정 밝기 값을 갖는 숫자 행렬로 표현되는 것으로부터 시작된다.
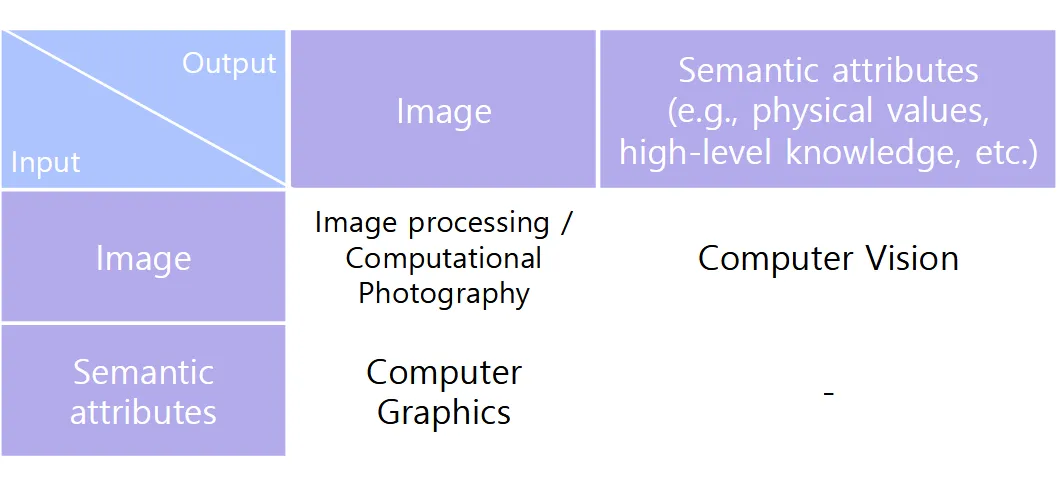
2. 핵심 아키텍처: CNN에서 ViT까지
2.1. Convolutional Neural Networks (CNN)
CNN은 이미지의 공간적, 지역적 특징을 효과적으로 학습하기 위해 고안된 모델이다. 모든 픽셀을 연결하는 Fully Connected 방식과 달리 Local feature learning(지역적 특징 학습)과 Parameter sharing(파라미터 공유)을 통해 효율적인 학습이 가능하다.
- CNN의 발전사: AlexNet부터 ResNet까지
- AlexNet (2012): ILSVRC에서 우승하며 딥러닝 시대의 서막을 연 모델이다. ReLU 활성화 함수를 통해 Vanishing Gradient 문제를 완화하고, Dropout을 사용해 과적합을 방지했다.
- VGGNet (2014): 3x3의 작은 컨볼루션 필터와 2x2 맥스 풀링만을 사용하여 더 깊고 간단한 구조를 구현했다. 이를 통해 더 큰 Receptive Field(수용 영역)를 확보하면서도 파라미터 수를 줄이는 효과를 보았다.
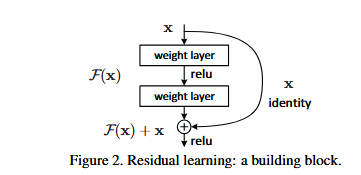
-핵심 모델: ResNet (2016)과 Degradation Problem 극복 네트워크가 무작정 깊어지면 오히려 학습 에러와 테스트 에러가 모두 커지는 Degradation Problem(성능 저하 문제)이 발생한다. 이는 과적합과는 다른 최적화의 문제다. ResNet은 이 문제를 해결하기 위해 Residual Block을 제안했다.
-Residual Block: 핵심 아이디어는 Skip Connection (Shortcut)이다. 입력 $x$를 여러 레이어를 건너뛰어 출력에 그대로 더해줌으로써, 네트워크는 전체 출력 $H(x)$를 학습하는 대신 변화량(residual)인 $F(x)$만 학습하면 된다. 이는 Gradient가 소실되지 않고 깊은 레이어까지 잘 전달되도록 돕는다. -목표 함수: \(H(x) = F(x) + x\) -학습 대상 (Residual):\(F(x) = H(x) - x\)
2.2. Vision Transformer (ViT)
자연어 처리(NLP) 분야에서 큰 성공을 거둔 Transformer 모델을 이미지에 직접 적용하려는 시도에서 탄생했다.
- Transformer의 핵심: Self-Attention RNN의 Long-term dependency 문제를 해결하기 위해 등장했다. 입력 시퀀스 내의 모든 요소 간의 관계를 한 번에 계산하여 거리에 상관없이 의존성을 모델링한다.
- 입력 feature $X$로부터 가중치 행렬 $W^Q, W^K, W^V$를 곱해 Query(Q), Key(K), Value(V) 세 벡터를 생성한다.
- 어텐션 스코어는 Query와 Key의 유사도를 계산하고, 이를 Value에 가중합하여 최종 출력 Z를 얻는다. 이 과정은 다음 수식으로 요약된다.
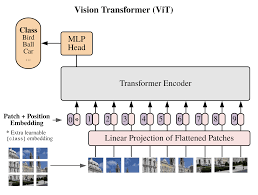
- ViT 아키텍처
- 이미지 패치화 (Image Patching): 이미지를 고정된 크기(e.g., 16x16)의 여러 패치(Patch)로 나눈다.
- Linear Projection: 각 패치를 Flatten하여 1D 벡터로 만들고, Linear Projection을 통해 임베딩한다.
- Position Embedding: Self-Attention은 순서 정보에 불변(order-invariant)하므로, 각 패치의 위치 정보를 알려주기 위해 Position Embedding을 더해준다.
-
[CLS]토큰 추가: 이미지 전체의 정보를 요약하고 최종 분류에 사용하기 위해 학습 가능한[CLS](Classification) 토큰을 시퀀스 맨 앞에 추가한다. - Transformer Encoder: 완성된 시퀀스를 Transformer Encoder에 입력하여 패치 간의 관계를 학습한다.
- MLP Head: Encoder의
[CLS]토큰 최종 출력값을 MLP Head에 통과시켜 클래스를 예측한다.
- Scaling Law: ViT의 가장 큰 특징 중 하나는, 데이터와 모델 크기가 커질수록 성능이 비례하여 향상되는 Scaling Law를 잘 따른다는 점이다. 이는 대규모 데이터셋으로 사전 학습했을 때 CNN을 능가하는 성능을 보이는 기반이 된다.
3. 모델 해석 및 성능 향상 기법
3.1. CNN Visualization
CNN은 종종 ‘블랙박스’로 불리지만, 시각화 도구를 통해 내부 동작을 분석하고 디버깅할 수 있다.
- 모델 동작 분석 (Analysis of Model Behaviors)
- Filter Visualization: 초기 레이어의 필터는 색상, 엣지 등 Low-level feature를, 깊은 레이어는 더 복잡한 High-level feature를 학습하는 경향이 있다.
- Embedding Feature Analysis:
- Nearest Neighbors: 특정 이미지의 Feature Vector와 가장 가까운 다른 이미지들을 찾아, 모델이 어떤 이미지를 ‘유사하다’고 판단하는지 분석한다.
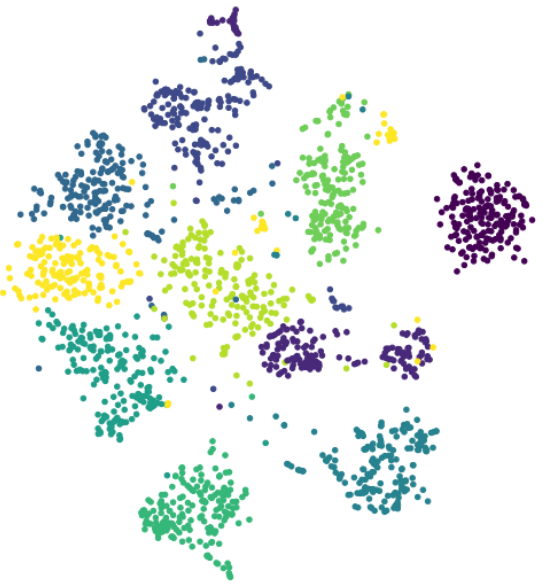
- t-SNE: 고차원의 Feature Vector를 2차원으로 차원 축소하여 시각화함으로써, 모델이 클래스를 얼마나 잘 군집화하는지 확인할 수 있다.
- Activation Investigation:
- Maximally Activating Patches: 특정 뉴런(채널)을 가장 강하게 활성화시키는 이미지 패치들을 모아 해당 뉴런의 역할을 유추한다.
-
Class Visualization: 특정 클래스의 점수를 최대화하는 이미지를 생성(Gradient Ascent)하여, 모델이 해당 클래스를 어떻게 ‘상상’하는지 본다.
- 모델 결정 설명 (Model Decision Explanation)
- CAM (Class Activation Mapping): 모델이 이미지의 어느 부분을 보고 특정 클래스로 판단했는지 히트맵으로 보여준다. 이를 위해 마지막 FC Layer를 GAP (Global Average Pooling) Layer로 대체하고 재학습해야 하는 단점이 있다.
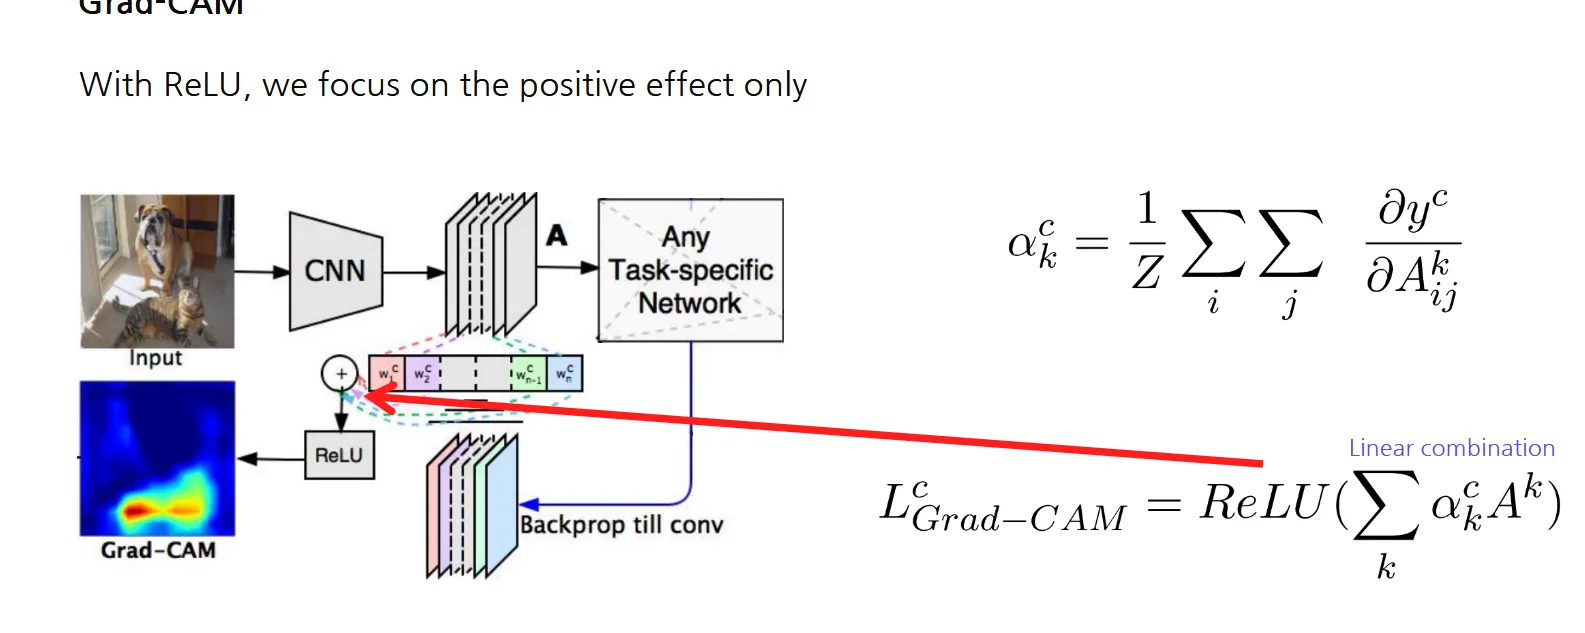
- Grad-CAM: CAM의 단점을 보완하여 모델 구조 변경 없이 Gradient 정보를 이용해 중요도 가중치를 계산한다. 특정 클래스에 대한 예측 점수를 마지막 컨볼루션 레이어의 Feature Map으로 미분하여 그래디언트를 구하고, 이를 GAP하여 각 채널의 중요도(\(\alpha_k^c\))를 얻는다. -가중치 계산: \(\alpha_k^c = \frac{1}{Z}\sum_i \sum_j \frac{\partial y^c}{\partial A_{ij}^k}\)
- Grad-CAM 생성:\(L_{Grad-CAM}^c = ReLU(\sum_k \alpha_k^c A^k)\) ReLU를 통해 양의 영향을 미친 부분에만 집중한다.
3.2. Data Augmentation
학습 데이터는 실제 세계의 모든 분포를 완벽하게 반영하지 못한다. 이로 인한 편향(bias)을 줄이고 모델의 일반화 성능을 높이기 위해 데이터 증강은 필수적이다.
- 기본 및 최신 기법:
- 기본 기법:
Rotate,Flip,Crop,Brightness조절 등 기본적인 이미지 변환을 적용한다.
# 예시: OpenCV를 이용한 이미지 회전 및 뒤집기
img_rotated = cv2.rotate(image, cv2.ROTATE_90_CLOCKWISE)
img_flipped = cv2.rotate(image, cv2.ROTATE_180)

# 예시: Numpy를 이용한 밝기 조절
def brightness_augmentation(img):
# numpy array img has RGB value (0-255) for each pixel
img[:,:,0] = img[:,:,0] + 100 # add 100 to R value
img[:,:,1] = img[:,:,1] + 100 # add 100 to G value
img[:,:,2] = img[:,:,2] + 100 # add 100 to B value
img[:,:,0][img[:,:,0] > 255] = 255 # clip R values over 255
img[:,:,1][img[:,:,1] > 255] = 255 # clip G values over 255
img[:,:,2][img[:,:,2] > 255] = 255 # clip B values over 255
return img
-CutMix: 두 이미지를 잘라 붙여 새로운 학습 데이터를 생성한다. 레이블도 잘린 영역의 비율에 따라 soft label(e.g., [0.7, 0.3])로 혼합하여 모델이 객체를 더 잘 지역화(localize)하도록 돕는다.
-RandAugment: 수많은 증강 기법 중 최적의 조합과 강도를 자동으로 탐색하여 적용한다.
-Synthetic Data: 실제 데이터 수집이 불가능하거나 매우 어려운 경우(e.g., Video Motion Magnification), 시뮬레이션을 통해 학습 데이터를 생성하기도 한다.
4. 핵심 CV Tasks: Segmentation & Detection
4.1. 이미지 분할 (Segmentation)
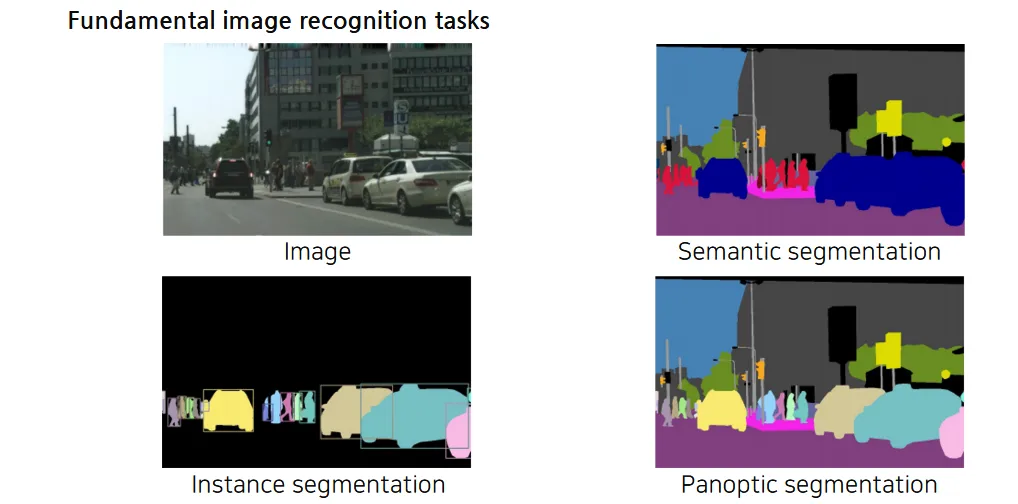
-Semantic Segmentation: 이미지의 모든 픽셀을 특정 클래스(e.g., 사람, 자동차, 하늘)로 분류한다. 객체 각각을 구분하지는 않는다.
- FCN (Fully Convolutional Network): FC 레이어 대신 1x1 Conv를 사용하여 공간 정보를 유지하고, Upsampling과 Skip connection을 통해 coarse한 feature map의 해상도를 복원하여 정확도를 높인다.
- U-Net: FCN을 기반으로, 대칭적인 인코더(Contracting Path)-디코더(Expanding Path) 구조를 가지며 Skip connection을 통해 low-level feature를 효과적으로 전달하여 정교한 분할이 가능하다.
-Instance Segmentation: Semantic Segmentation에서 한 단계 더 나아가, 같은 클래스에 속하는 객체라도 각각의 개체(instance)를 구별하여 분할한다.
- Mask R-CNN: Two-stage detector인 Faster R-CNN에 Mask를 예측하는 작은 FCN 브랜치를 추가한 구조다.
(Classification + Bounding Box) + Mask를 동시에 수행한다.
4.2. Object Detection
객체의 클래스를 분류하고, 그 위치를 Bounding Box로 찾는 task다.
- One-stage vs. Two-stage Detectors: Two-stage detector(e.g., R-CNN)는 후보 영역 제안과 분류를 순차적으로 진행해 정확도가 높고, One-stage detector(e.g., YOLO)는 이를 동시에 처리해 속도가 빠르다.
- Focal Loss: One-stage detector에서 발생하는 극심한 클래스 불균형(대부분이 배경) 문제를 해결하기 위해 제안되었다. 예측이 쉬운 샘플(well-classified examples)의 loss는 줄이고, 어려운 샘플(hard examples)의 loss에 더 큰 가중치를 부여한다.
- Focal Loss 수식: \(FL(p_t) = -(1-p_t)^\gamma \log(p_t)\) 여기서 $(1-p_t)^\gamma$ 항이 가중치 역할을 한다.
-DETR (DEtection TRansformer): Object Detection을 ‘집합 예측(set prediction)’ 문제로 재정의한 Transformer 기반 모델이다. Object Queries와 Bipartite Matching을 통해 NMS 같은 후처리 없이 end-to-end 학습이 가능하다.
5. Computational Imaging
이미징 파이프라인에 컴퓨터 연산을 추가하여 기존 카메라의 한계를 극복하거나 새로운 기능을 구현하는 분야다. Denoising, Super-resolution, Deblurring 등이 대표적이다.
-학습 데이터 생성의 중요성: Computational Imaging에서는 (Degraded image, Ground-truth) 데이터 쌍을 구하기 어려운 경우가 많아, 현실적인 합성 데이터를 만드는 것이 성능에 큰 영향을 미친다.
- Denoising: 깨끗한 이미지에 가우시안 노이즈를 추가하여 학습 데이터를 생성한다.
- Super-resolution: 단순히 고해상도 이미지를 Downsampling하는 것보다, 실제 렌즈의 초점 거리(focal length)를 변경하여 촬영한 이미지 쌍을 사용하는 RealSR 방식이 더 현실적인 데이터셋을 구축하는 데 효과적이다.
- Deblurring: 고속 카메라로 촬영한 여러 장의 선명한 프레임을 평균 내어 블러 이미지를 합성하는 GoPro dataset이나, 빔 스플리터를 이용한 듀얼 카메라 시스템으로 블러/선명 이미지를 동시에 촬영하는 RealBlur 방식이 있다.
-고품질 결과를 위한 Loss Functions:
- L1/L2 Loss의 한계: 픽셀 값의 차이만 계산하므로, 사람이 보기에 부자연스럽고 흐릿한(blurry) 평균적인 이미지를 생성하는 경향이 있다.
- Adversarial Loss (GAN): Discriminator가 실제 이미지와 구별할 수 없을 정도로 사실적인 이미지를 생성하도록 Generator를 학습시킨다. 평균적인 결과가 아닌, 실제 이미지 분포 내에 있는 하나의 선명한 결과물을 생성한다.
- Perceptual Loss: 사전 학습된 VGG와 같은 네트워크의 중간 Feature Map을 이용해 Loss를 계산한다. 픽셀 공간이 아닌 Feature 공간에서의 유사도를 측정함으로써, 사람이 인지하기에 더 자연스러운 결과를 얻는다.
2. 소감
관련 논문만 10개가 넘는다. SAM, DETR, CAM, grad-CAM, VGG, ResNet, ViT등등 읽고 리뷰해야할 논문이 쏟아진 한주였다. 읽고 정리해보려 했는데, 어려운 과제내용을 정리하기 바빴고, 과제에 사용되는 모듈과 함수들을 익히기 바빴다. 제대로 해낸건 하나없는것 같은데 한주가 가버렸다. 열심히 한다고 하는데, 열심히해서 되는건 없는것 같고 그냥 해야만 할 것 같다.
내가 재밌어서 그동안 공부하고 싶었던 주제인 CV를 드디어 제대로 배우게 되었는데, 할 줄아는건 없고, 아는것도 없고, 한주가 스쳐지나가버린것 같다. 이 기회를 놓쳐버리고 싶지 않다.
강의를 들으면서 와 이건진짜 신기하네. 어떻게 이런 생각을 해서 문제를 해결하지? 라는 생각을 계속했다. 특히 Debluring task에서 블러는 방향도 포함하고, blur의 정도도 포함해서 해결하기 어려운 task인데, 단순히 gaussian noise를 주는것에서 벗어나서 짧은 노출 사진 여러개를 concat해서 노출을 늘리는 방법, 이렇게 만든 Data로 학습하는 Gan, 그리고 L1, L2Loss는 ‘평균적’으로 비슷한 이미지만 classification하므로 Perceptual Loss와 Adversarial Loss를 사용하는 획기적인 방법들을 보며 감탄했다. 다만, 이렇게 놀라운 방법들은 수학적인 원리를 기반으로 하고 있기 때문에 단번에 이해하기 어려웠다. 그런데 피어세션과 페어리뷰를 하며 내가 배우는 내용들은 다른사람들도 어렵다는걸 듣고 위안을 얻기도 했다.
당연히 CV로 푸는 문제가 간단하진 않으니까 Heuristic한 알고리즘으로는 해결하지 못하고, Deeplearning을 이용하는 것이다. 어려운건 당연하니깐, 문제를 직면하고, 해결하는법을 이해해봐야겠다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...