Week3_AI_LifeCycle_학습회고
3주차 AI LifeCycle내용 회고
AI LifeCycle 학습 회고 (3주차)
목차
- 강의 복습 내용
- 과제 결과물 정리
- 학습 회고
1. 강의 복습 내용
1. 선형대수와 머신러닝의 기초
1.1. 선형 회귀 (Linear Regression)
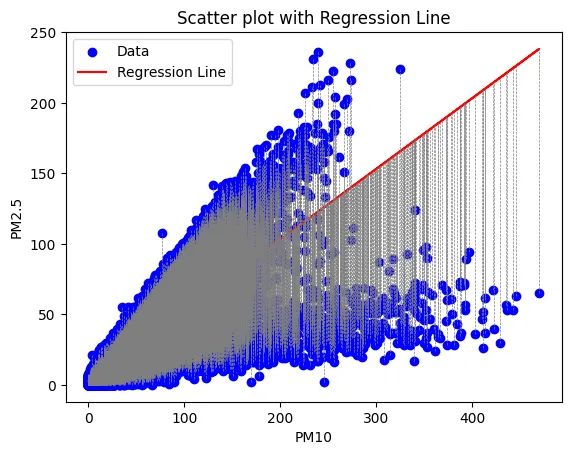
회귀 분석은 독립 변수 $x$를 기반으로 종속 변수 $y$를 예측하는 모델을 만드는 과정이다. 선형 회귀는 이 관계가 선형적이라고 가정한다.
-
방정식: 가장 기본적인 형태는 \(y = mx + b\)로 표현된다. 여러 독립 변수를 다루는 다중 선형 회귀는 \(y = b_0 + b_1x_1 + b_2x_2 + ... + b_nx_n\)으로 확장된다.
- 최소 제곱법 (OLS): 모델의 최적 매개변수 $m$과 $b$를 찾는 방법 중 하나로, 실제 값과 예측 값의 차이, 즉 잔차(residual)의 제곱합을 최소화하는 값을 찾는다. 비용 함수는 다음과 같다. \(cost(m, b) = \sum(y_i - (mx_i + b))^2\)
- 모델 평가: 모델의 성능은 다양한 지표로 평가한다.
- MAE (Mean Absolute Error): \(MAE = \frac{1}{n}\sum_{i=1}^{n}|y_i - \hat{y}_i|\)
- MSE (Mean Squared Error): \(MSE = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2\)
- RMSE (Root Mean Squared Error): \(RMSE = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2}\)
- 결정 계수 ($R^2$): \(R^2 = 1 - \frac{\sum_{i=1}^{n}(y_i - \hat{y}_i)^2}{\sum_{i=1}^{n}(y_i - \bar{y})^2}\)
1.2. K-최근접 이웃 (K-Nearest Neighbor, K-NN)
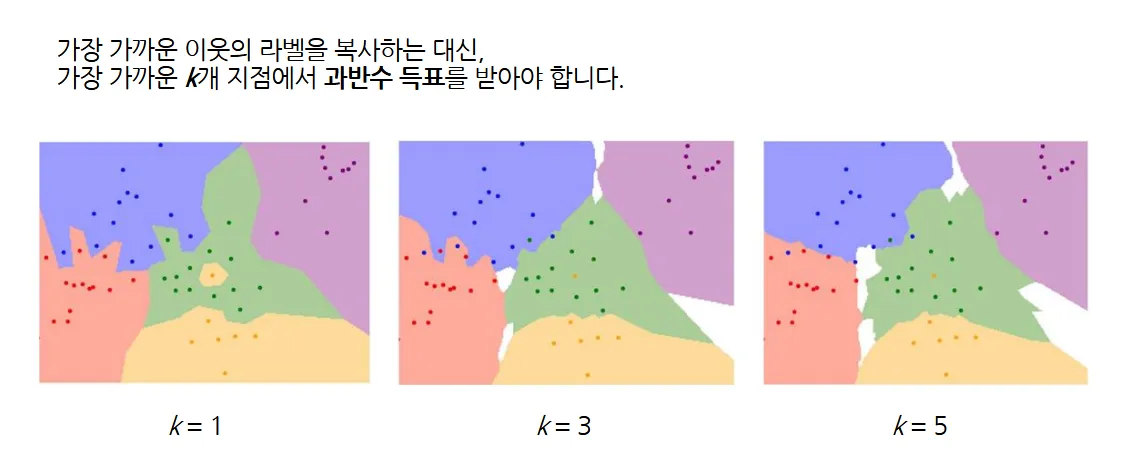
K-NN은 가장 직관적인 분류 알고리즘 중 하나다. 예측하려는 데이터와 가장 가까운 $k$개의 훈련 데이터의 레이블을 보고 다수결로 분류를 결정한다.
- 거리 측정: 데이터 간의 ‘가까움’을 측정하기 위해 거리 척도를 사용한다.
- L1 거리 (맨해튼 거리): \(L_1(A, B) = \sum_{i,j}|A_{i,j} - B_{i,j}|\)
- L2 거리 (유클리드 거리): \(L_2(A, B) = \sqrt{\sum_{i,j}(A_{i,j} - B_{i,j})^2}\)
- 구현 예시:
import numpy as np class NearestNeighbor: def __init__(self): pass def train(self, images, labels): # simply remembers all the training data self.images = images self.labels = labels def predict(self, test_image): # assume that each image is vectorized to 1D min_dist = float('inf') min_index = -1 for i in range(self.images.shape[0]): dist = np.sum(np.abs(self.images[i, :] - test_image)) if dist < min_dist: min_dist = dist min_index = i return self.labels[min_index] - 한계:
- 느린 예측 속도: 예측 시 모든 훈련 데이터와의 거리를 계산해야 하므로 데이터가 많을수록 매우 느리다.
- 차원의 저주: 데이터의 차원이 높아질수록 데이터 간의 거리가 무의미해지고, 분류에 필요한 데이터 수가 기하급수적으로 증가한다.
- Semantic Gap: 픽셀 값 기반의 거리는 이미지의 의미론적 유사성을 반영하지 못한다.
1.3. 선형 분류기 (Linear Classifier)
K-NN의 한계를 극복하기 위해 매개변수적 접근(Parametric Approach)을 사용한다. 입력 데이터와 레이블을 매핑하는 함수 $f$를 학습하는 방식이다.
- 모델: \(f(x, W) = Wx + b\)
- $x$: 입력 이미지 픽셀을 펼친 벡터
- $W$: 가중치 행렬. 각 클래스에 대한 템플릿 역할을 한다.
- $b$: 편향 벡터.
- 장점:
- 학습이 완료되면 가중치 $W$만 저장하면 되므로 공간 효율성이 높다.
- 예측 시 행렬-벡터 곱 연산 한 번으로 끝나므로 매우 빠르다.
- Softmax 분류기: 선형 분류기의 점수(score)를 확률로 변환하기 위해 사용된다. 각 클래스에 속할 확률을 0과 1 사이의 값으로 정규화하며, 모든 클래스에 대한 확률의 총합은 1이 된다. \(p(y=c_i|x) = \frac{e^{s_i}}{\sum_j e^{s_j}}\)
1.4. 손실 함수와 최적화
- 손실 함수 (Loss Function): 모델의 예측이 얼마나 틀렸는지를 정량화하는 함수다. 손실이 클수록 모델 성능이 나쁘다는 의미다. 대표적으로 교차 엔트로피 (Cross-Entropy) 손실이 분류 문제에 널리 쓰인다. \(\mathcal{L} = -\frac{1}{N}\sum_{i=1}^{N}\sum_{k=1}^{K}y_{ik}\log(\hat{y}_{ik})\)
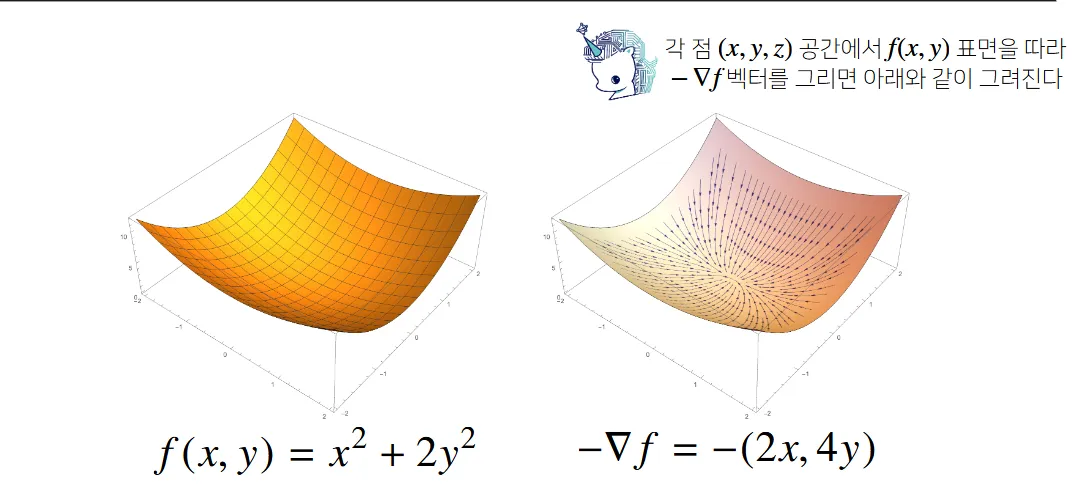
- 최적화 (Optimization): 손실 함수를 최소화하는 가중치 $W$를 찾는 과정이다. 경사 하강법 (Gradient Descent)이 가장 기본적이고 강력한 방법이다. 손실 함수의 기울기(gradient)를 계산하여 기울기가 낮아지는 방향으로 가중치를 점진적으로 업데이트한다. \(\Theta^{new} = \Theta^{old} - \alpha \nabla_{\Theta}J(\Theta)\)
- 확률적 경사 하강법 (SGD): 전체 데이터 대신 미니배치(mini-batch)를 사용하여 기울기를 근사 계산함으로써 학습 속도를 높인다.
2. 기초 신경망 이론
선형 모델은 데이터의 복잡한 비선형 관계를 학습하는 데 한계가 있다. 신경망은 여러 개의 선형 모델을 층층이 쌓고 그 사이에 비선형 활성화 함수를 추가하여 이 문제를 해결한다.
2.1. 퍼셉트론과 다층 퍼셉트론 (MLP)
- 퍼셉트론: 인간의 뉴런 구조에서 영감을 받은 모델. 입력에 가중치를 곱하고 편향을 더한 뒤, 활성화 함수를 통과시켜 출력을 결정한다. \(f(\sum_i w_i x_i + b)\)
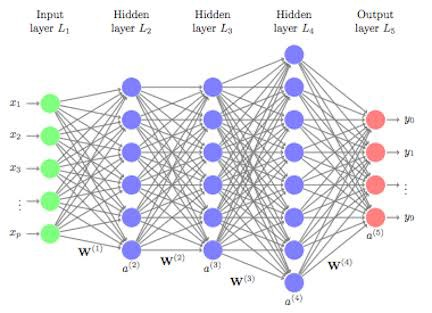
- MLP: 퍼셉트론으로 이루어진 층(layer)을 여러 개 쌓아 만든 구조다. 층 사이에 비선형성을 추가하기 위해 활성화 함수(Activation Function)를 사용한다.
2.2. 활성화 함수 (Activation Functions)
활성화 함수는 신경망에 비선형성을 부여하여 표현력을 높이는 핵심 요소다.
- Sigmoid: 출력을 (0, 1) 사이로 압축한다. 과거에 많이 사용되었으나, 기울기 소실(Vanishing Gradient) 문제와 출력이 Zero-centered가 아니라는 단점이 있다. \(\sigma(x) = \frac{1}{1 + e^{-x}}\)
-
Tanh: 출력을 (-1, 1) 사이로 압축하며 Zero-centered 문제를 해결했지만, 기울기 소실 문제는 여전하다.
- ReLU (Rectified Linear Unit): 입력이 양수면 그대로, 음수면 0을 출력한다. 연산이 간단하고 수렴 속도가 빠르며, 양수 영역에서 기울기 소실 문제가 없다. 현대 신경망에서 가장 널리 사용된다. \(f(x) = \max(0, x)\)
- 단점으로는 ‘죽은 ReLU(Dead ReLU)’ 문제가 발생할 수 있다. 이를 보완하기 위해 Leaky ReLU, ELU 등이 제안되었다.
2.3. 역전파 (Backpropagation)
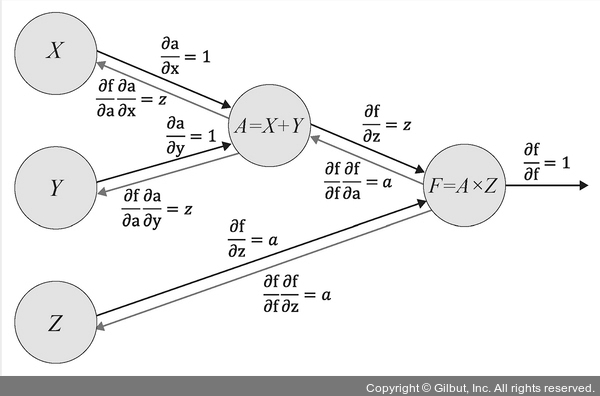
역전파는 연쇄 법칙(Chain Rule)을 이용하여 출력층에서부터 입력층 방향으로 손실에 대한 각 가중치의 기울기를 효율적으로 계산하는 알고리즘이다. 계산된 기울기는 경사 하강법을 통해 가중치를 업데이트하는 데 사용된다.
-
구현 예시 (2-Layer MLP):
  import numpy as np
  from numpy.random import randn

  n, d, h, c = 64, 1000, 100, 10
  x, y = randn(n, d), randn(n, c)
  w1, w2 = randn(d, h), randn(h, c)
  learning_rate = 1e-4

  for t in range(1000):
      # Forward pass
      y_0 = x.dot(w1)
      h_0 = 1 / (1 + np.exp(-y_0))
      y_pred = h_0.dot(w2)
      loss = np.square(y_pred - y).sum()
      print(t, loss)

      # Backward pass (Backpropagation)
      grad_y_pred = 2.0 * (y_pred - y)
      grad_w2 = h_0.T.dot(grad_y_pred)
      grad_h = grad_y_pred.dot(w2.T)
      grad_w1 = x.T.dot(grad_h * h_0 * (1 - h_0))

      # Weight update
      w1 -= learning_rate * grad_w1
      w2 -= learning_rate * grad_w2
3. 심화 신경망 학습 기술
신경망을 더 깊고 안정적으로 학습시키기 위한 다양한 기법들이 있다.
3.1. 가중치 초기화 (Weight Initialization)
-
가중치를 너무 작게 초기화하면 활성화 값이 0으로 수렴하여 기울기가 소실되고, 너무 크게 초기화하면 활성화 값이 극단으로 치우쳐 기울기가 소실된다.
-
Xavier 초기화: 이전 층의 노드 수($d_{in}$)를 고려하여 가중치를 초기화함으로써 신호가 너무 작아지거나 커지지 않도록 방지한다.
W = np.random.randn(d_in, d_out) / np.sqrt(d_in)
3.2. 학습률 스케줄링 (Learning Rate Scheduling)
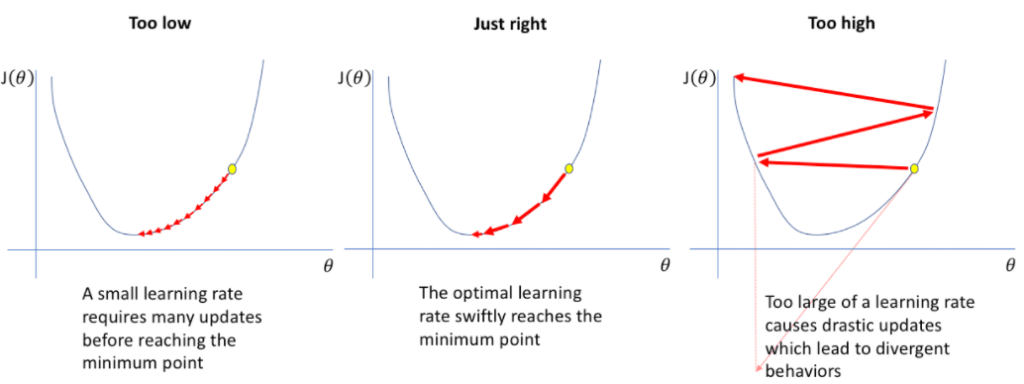
학습 초기에는 큰 학습률로 빠르게 최적점에 다가가고, 최적점 근처에서는 작은 학습률로 미세 조정을 하기 위해 학습 과정을 조절하는 기법이다. Step Decay, Cosine Annealing 등의 방법이 있다.
3.3. 데이터 전처리 및 증강 (Preprocessing & Augmentation)
-
전처리: 데이터를 Zero-centering하고 정규화(Normalization)하면 학습을 더 안정적으로 만들 수 있다.
-
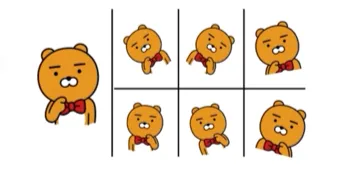
증강: 제한된 훈련 데이터를 변형(예: 이미지 좌우 반전, 무작위 자르기, 색상 변환)하여 데이터의 양을 늘리는 효과를 냄으로써 모델의 일반화 성능을 높인다.
4. 순환 신경망 (RNN)과 시퀀스 모델
RNN은 시계열 데이터나 자연어와 같이 순서가 있는 데이터를 처리하기 위해 고안된 모델이다. 이전 타임스텝의 정보를 현재 타임스텝의 입력으로 재귀적으로 사용하는 구조를 가진다. \(h_t = f_W(h_{t-1}, x_t)\)
4.1. 장기 의존성 문제 (Long-Range Dependency)
- 기울기 소실/폭발: RNN은 시퀀스가 길어질수록 역전파 과정에서 동일한 가중치 행렬이 반복적으로 곱해지면서 기울기가 0으로 수렴(소실)하거나 무한대로 발산(폭발)하는 문제가 발생한다. 이로 인해 시퀀스 초반의 정보를 제대로 학습하기 어렵다. \(\frac{\partial \mathcal{L}_t}{\partial W_{hh}} \propto W_{hh}^{t-1}\)
-
해결책:
-
기울기 클리핑 (Gradient Clipping): 기울기 폭발을 막기 위해 기울기 값의 임계치를 설정한다.
-
LSTM / GRU: 기울기 소실 문제를 완화하기 위해 ‘게이트(gate)’라는 개념을 도입했다. Forget gate, Input gate, Output gate를 통해 어떤 정보를 기억하고, 어떤 정보를 버릴지를 학습하여 장기 의존성을 포착하는 능력을 향상시켰다.
-
%20이미지]}.png)
4.2. Seq2Seq 모델
입력 시퀀스와 출력 시퀀스의 길이가 다를 수 있는 문제(예: 기계 번역)를 해결하기 위해 인코더-디코더 구조를 사용한다.
-
인코더: 입력 시퀀스를 하나의 고정된 크기의 벡터, 즉 문맥 벡터(context vector)로 압축한다.
-
디코더: 문맥 벡터를 받아 출력 시퀀스를 하나씩 생성한다.
-
구현 예시 (PyTorch):
  # Encoder
  class EncoderLSTM(nn.Module):
      # ... 초기화 코드 ...
      def forward(self, x):
          embedding = self.dropout(self.embedding(x))
          outputs, (hidden_state, cell_state) = self.LSTM(embedding)
          return hidden_state, cell_state

  # Decoder
  class DecoderLSTM(nn.Module):
      # ... 초기화 코드 ...
      def forward(self, x, hidden_state, cell_state):
          x = x.unsqueeze(0)
          embedding = self.dropout(self.embedding(x))
          outputs, (hidden_state, cell_state) = self.LSTM(embedding, (hidden_state, cell_state))
          predictions = self.fc(outputs)
          predictions = predictions.squeeze(0)
          return predictions, hidden_state, cell_state

  # Seq2Seq Model
  class Seq2Seq(nn.Module):
      # ... 초기화 코드 ...
      def forward(self, source, target):
          # ... forward pass 로직 ...
          hidden_state, cell_state = self.Encoder_LSTM(source)
          # <SOS> 토큰으로 시작
          x = target[0]
          for i in range(1, target_len):
              output, hidden_state, cell_state = self.Decoder_LSTM(x, hidden_state, cell_state)
              # ... 다음 입력(x)과 출력 저장 로직 ...
          return outputs
하지만 문맥 벡터 하나에 모든 정보를 압축하는 것은 정보 손실을 야기하며, 이는 긴 시퀀스에서 성능 저하의 원인이 된다.
5. 트랜스포머와 어텐션 메커니즘
트랜스포머는 RNN의 순차적, 재귀적 구조를 완전히 배제하고 어텐션(Attention) 메커니즘만으로 시퀀스 데이터의 관계를 학습하는 획기적인 모델이다. 이 접근법은 입력 시퀀스를 한 번에 처리하여 병렬 계산을 극대화했고, 이는 학습 속도의 비약적인 향상으로 이어졌다. 또한, RNN의 고질적인 장기 의존성 문제를 해결하며 더 긴 시퀀스의 복잡한 관계를 효과적으로 포착할 수 있게 했다.
5.1. 어텐션 메커니즘 (Attention Mechanism)
어텐션의 핵심 아이디어는 Seq2Seq 모델의 고정된 크기 문맥 벡터가 갖는 정보 병목 현상을 해결하는 것이다. 디코더가 특정 시점의 단어를 예측할 때, 인코더의 전체 입력 시퀀스에서 가장 관련 있는 부분에 ‘집중(attend)’하여 해당 정보를 직접 활용한다.
- Query, Key, Value: 어텐션 연산은 쿼리(Query)가 주어졌을 때, 모든 키(Key)와의 유사도를 계산하고, 이 유사도(어텐션 스코어)를 가중치로 삼아 값(Value)들의 가중합을 구하는 과정으로 요약할 수 있다.
- Query: 현재 예측하려는 단어의 정보 (예: 디코더의 이전 은닉 상태)
- Key: 입력 시퀀스의 각 단어 정보 (예: 인코더의 모든 은닉 상태)
- Value: Key와 동일하게, 입력 시퀀스의 각 단어 정보
- Scaled Dot-Product Attention: 트랜스포머에서는 내적(dot-product)을 통해 Query와 Key의 유사도를 계산하고, 이를 Key 벡터 차원의 제곱근($\sqrt{d_k}$)으로 나누어 스케일링한다. 이 스케일링 과정은 기울기 소실을 방지하여 학습을 안정화시키는 중요한 역할을 한다. \(Attention(Q, K, V) = \text{softmax}(\frac{QK^T}{\sqrt{d_k}})V\)
5.2. 트랜스포머 아키텍처
트랜스포머는 크게 인코더와 디코더, 두 부분으로 구성되며, 각각 여러 개의 동일한 블록을 쌓은 구조를 가진다.
]}.png)
-
셀프 어텐션 (Self-Attention): 트랜스포머의 가장 혁신적인 개념. 문장 내 단어들 간의 관계를 파악하기 위해 문장 자신이 스스로에게 어텐션을 수행한다. 즉, 입력 시퀀스 내의 모든 단어가 서로에 대한 Query, Key, Value 역할을 수행하며 상호 관계를 계산한다. 이를 통해 각 단어는 문맥 속에서 자신의 의미를 동적으로 재조정하게 된다.
-
멀티 헤드 어텐션 (Multi-Head Attention): 하나의 어텐션이 아닌, 여러 개의 어텐션을 병렬적으로 수행하여 서로 다른 관점의 관계를 학습하는 구조다. 입력 임베딩을 여러 ‘헤드’로 나누어 각각 독립적으로 어텐션을 계산한 뒤, 그 결과를 다시 하나로 합친다. 이를 통해 모델은 예를 들어 한 헤드에서는 문법적 관계를, 다른 헤드에서는 의미적 관계를 학습하는 등 다차원적인 정보를 포착할 수 있다.
-
위치 인코딩 (Positional Encoding): 단어의 순서 정보를 모델에 제공하기 위해 각 단어의 위치에 대한 고유한 정보를 담은 벡터를 입력 임베딩에 더해준다. 순서 개념이 없는 트랜스포머에게 단어의 상대적, 절대적 위치 정보를 알려주는 필수적인 장치다. \(PE_{(pos, 2i)} = \sin(pos / 10000^{2i/d_{\text{model}}})\) \(PE_{(pos, 2i+1)} = \cos(pos / 10000^{2i/d_{\text{model}}})\)
-
인코더-디코더 구조:
- 인코더 블록: 멀티 헤드 셀프 어텐션 층과 피드 포워드 신경망(Feed-Forward Network)으로 구성되며, 각 층 이후에는 잔차 연결(Residual Connection)과 층 정규화(Layer Normalization)가 적용된다.
- 디코더 블록: 인코더 블록의 구성 요소에 더해, 인코더의 출력(Key, Value)과 디코더의 이전 출력(Query) 간의 어텐션을 수행하는 Encoder-Decoder Attention 층이 추가된다. 또한, 디코더의 셀프 어텐션은 현재 위치 이후의 단어들을 참고하지 못하도록 마스킹(Masking) 처리된다.
5.3. BERT와 ViT
-
BERT (Bidirectional Encoder Representations from Transformers): 트랜스포머의 인코더 구조만을 사용하여 대규모 텍스트 데이터로 사전 학습한 언어 모델. Masked Language Model (MLM)을 통해 문장의 빈칸을 예측하는 과정에서 문맥을 양방향으로 깊게 이해하는 능력을 학습한다. 입력은 Token, Segment, Position Embedding 세 가지의 합으로 구성된다.
-
ViT (Vision Transformer): 이미지를 여러 개의 고정된 크기 패치(patch)로 나누고, 이 패치들의 시퀀스를 트랜스포머의 입력으로 사용하여 이미지 분류를 수행하는 모델. CNN의 공간적 inductive bias(지역성 등) 없이, 대규모 데이터로부터 직접 이미지 내의 전역적인 관계를 학습하는 능력을 보여주었다.
결론
이번 일주일간의 학습은 선형 모델이라는 단순한 아이디어에서 출발하여, 어떻게 비선형성, 순차적 정보, 그리고 단어 간의 복잡한 관계를 모델링하는 방향으로 발전해왔는지를 명확히 보여주었다. 특히 RNN의 한계를 극복하기 위한 어텐션을 사용하는 방법을 알게되었고, 트랜스포머가 현재 AI 분야의 핵심 아키텍처로 자리잡은걸 알게됐다. 아직은 이론적인 이해에 머물러 있지만, 이 개념들을 코드로 직접 구현하고 실험하며 더 깊은 이해에 도달해야겠다.
2. 과제 결과물 정리
과제 1: Numpy로 구현한 선형 회귀 (Linear Regression)
첫 번째 과제는 Numpy를 이용해 대기오염 데이터셋의 PM10 농도로 PM2.5 농도를 예측하는 선형 회귀 모델을 만드는 것이었다.
핵심 구현 내용 및 코드
모델의 핵심은 정규방정식(Normal Equation)을 사용하여 최적의 가중치(weights)와 편향(bias)을 한 번에 계산하는 것이었다.
# 정규방정식을 이용한 가중치 계산
self.weights = np.linalg.pinv(X.T @ X) @ X.T @ y
행렬 연산으로 한 번에 처리하기 위한 트릭이었다. 편향 b를 가중치 벡터 W에 포함시키기 위해, 모든 데이터 샘플에 항상 1의 값을 가지는 가상의 특성(x_0)을 추가했다. 이렇게 하면 수식은 y=W′X′ 형태로 단순화된다. 이 과정은 np.hstack를 통해 구현했다.
# 모든 샘플에 bias 항을 위한 특성 '1'을 추가
X = np.hstack((np.ones((X.shape[0], 1)), X))
이렇게 계산된 가중치 벡터의 첫 번째 값 weights[0]이 바로 편향(bias)이 되고, 나머지가 실제 특성에 대한 가중치 weights[1:]가 된다.
느낀점 및 알게된 점
편향(bias)의 의미: 이론으로만 배우던 편향(y절편)을 왜 가중치 행렬에 포함시켜 계산하는지, 그리고 이를 위해 왜 모든 입력 데이터에 ‘1’을 추가하는지 그 트릭을 코드로 직접 구현하며 명확히 이해하게 됐다. 이는 단순히 계산의 편의성을 넘어, 모델이 데이터를 더 유연하게 표현할 수 있도록 하는 중요한 장치임을 깨달았다.
데이터 전처리의 중요성: dropna()를 이용해 결측치가 있는 행을 제거하고, train_test_split 함수를 직접 구현하며 데이터를 훈련용과 테스트용으로 나누는 과정의 중요성을 다시 한번 느꼈다. 모델의 성능은 결국 데이터의 질에 달려있다는 것을 알게됐다.
과제 2: Numpy로 구현한 역전파 (Backpropagation)
두 번째 과제는 MNIST 손글씨 데이터셋을 분류하는 2-Layer 신경망을 Numpy만으로 구현하는 것이었다. 순전파(Forward Propagation)와 역전파(Backpropagation)를 직접 코딩해야 했다.
핵심 구현 내용 및 코드
모델의 구조는 다음과 같은 수식으로 표현된다. \(\hat{Y}=softmax(σ(X⋅W1+b1)⋅W2+b2)\)
가중치 초기화는 Xavier 초기화 방법을 사용했다. 이는 각 층의 입출력 뉴런 수에 맞춰 가중치의 초기 분산을 조절하여, 학습 과정에서 발생할 수 있는 기울기 소실(vanishing gradient)이나 폭주(exploding gradient) 문제를 완화하기 위함이다. 균등분포를 사용할 경우, 초기화 범위는 다음과 같이 설정된다. \(limit=\frac{6}{n_{in}+n_{out}}\)
# Xavier 초기화를 사용한 가중치 행렬 생성
 W1 = np.random.uniform(
     low=-np.sqrt(6 / (input_dim + num_hiddens)),
     high=np.sqrt(6 / (input_dim + num_hiddens)),
     size=(input_dim, num_hiddens)
 )
역전파 과정에서는 출력층에서부터 입력층 방향으로 손실 함수의 기울기를 연쇄 법칙(Chain Rule)에 따라 계산해 나갔다. 예를 들어, 출력층의 가중치 W_2에 대한 기울기는 다음과 같이 구했다.
# 역전파 구현
 dl_dz2 = (ff_dict['y'] - Y) / X.shape[0]  # Softmax와 Cross-Entropy 손실의 미분
 dl_dW2 = ff_dict['a1'].T @ dl_dz2
 dl_db2 = np.sum(dl_dz2, axis=0)
느낀점 및 알게된 점
하이퍼파라미터: 처음에는 학습률(learning rate)을 0.00001로 매우 작게 설정했더니 학습이 거의 진행되지 않았다. 이를 0.01로 높이자 손실이 눈에 띄게 감소하며 학습이 원활히 진행되는 것을 보고 하이퍼파라미터 튜닝의 중요성을 체감했다.
활성화 함수: 처음에는 활성화 함수로 Sigmoid를 사용했는데, 최종 테스트 정확도가 약 91.5%에 그쳤다. 이후 ReLU로 바꾸어 다시 학습시켜보니, 학습 속도가 더 빨라지고 최종 정확도도 95.2%까지 향상됐다. 이는 Sigmoid 함수가 특정 구간에서 기울기가 0에 가까워져 발생하는 기울기 소실 문제 때문임을 이론과 실제 결과를 통해 명확히 알게 됐다.
오버플로우 방지: Softmax 함수를 구현할 때, 지수 함수 np.exp()의 특성상 입력값이 조금만 커져도 오버플로우가 발생할 수 있다. 이를 방지하기 위해 입력 벡터의 최댓값을 각 원소에서 빼주는 기법을 사용했다. 이런 작은 트릭 하나가 코드의 안정성을 크게 좌우한다는 것을 배웠다.
과제 3: 멀티 헤드 셀프 어텐션 구현 (Multi-head Self-Attention)
핵심 구현 내용 및 코드
어텐션의 기본 수식은 다음과 같다. \(Attention(Q,K,V)=softmax(\frac{Q\cdot K^T}{d_k})V\)
멀티 헤드 어텐션은 hidden_size를 num_heads 개수만큼으로 쪼개어 여러 개의 어텐션을 병렬로 수행하는 방식이다. 이를 위해 tp_attn (Transpose for Attention)이라는 함수를 통해 텐서의 차원을 재배열하는 과정이 필수적이었다.
예를 들어, [batch_size, seq_len, hidden_size] 형태의 텐서를 [batch_size, num_heads, seq_len, attn_head_size] 형태로 바꾸어 각 헤드가 독립적으로 어텐션 계산을 수행할 수 있도록 했다.
# 텐서의 차원을 어텐션 계산에 맞게 재배열하는 함수
 def tp_attn(self, x):
     # (batch, seq_len, hidden_size) -> (batch, seq_len, num_heads, attn_head_size)
     x_shape = x.size()[:-1] + (self.num_heads, self.attn_head_size)
     x = x.view(*x_shape)
    # -> (batch, num_heads, seq_len, attn_head_size)
     return x.permute(0, 2, 1, 3)
이후 각 헤드별로 계산된 어텐션 결과를 다시 합치고 nn.Linear 층을 통과시켜 최종 출력을 얻는다.
느낀점 및 알게된 점
텐서 차원 조작의 중요성: 멀티 헤드 어텐션의 핵심은 텐서의 view와 permute를 이용한 차원 변환에 있다는 것을 깨달았다. hidden_size를 여러 개의 attn_head_size로 나누어 병렬 처리함으로써, 모델이 입력 시퀀스의 다양한 부분 공간(subspace)에서 정보를 동시에 학습할 수 있게 된다는 개념을 코드를 통해 직관적으로 이해할 수 있었다.
수식과 코드의 연결: Q, K, T 계산을 위해 torch.matmul(Q_layer, K_layer.transpose(-1, -2)) 코드를 작성하며, 행렬 곱셈을 위해 키(K) 텐서의 마지막 두 차원을 전치(transpose)해야 하는 이유를 명확히 알게 됐다. 수식으로만 보던 개념이 실제 코드에서 어떻게 구현되는지 알 수 있었다.
3. 소감
내 포트폴리오를 정리하고, 내가 공부한 내용들을 정리할 블로그 하나 갖고 싶었다. 드디어 깃허브에 나만의 블로그를 만들어 정착한것 같아 기분이 좋다. 이번주에 풀이한 알고리즘 문제들과 과제풀이들도 포스팅해 올렸고, 앞으로도 올릴 예정이다. 다만 이번주는 블로그에 내용정리하느라 시간을 너무 많이써서 복습에 소홀했다. 앞으로는 복습을 먼저 우선적으로 하고 정리를 해야겠다.
Transformer를 공부하며 ViT에 대해 궁금한점이 많아졌다. 이미지를 Sequence Data로 이용해서 기존의 CNN모델을 제치고 어떻게 SOTA를 달성했는지 궁금하다. 이번 주말에는 이번주에 배운내용을 복습하며 ViT논문을 공부해야겠다.
요즘 이런저런 이걸 해볼까, 이건 어떨까 고민, 생각만 깊게하고 뭔가 제대로 이뤄낸건 없는 것 같다. 일단 완벽하진 않더라도 시작부터 하고, 틀린게 있으면 그때부터 고쳐나가면 좀 더 발전하지 않을까 싶다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...