[AILifeCycle][3주차_과제_2] BackPropagation with Numpy
MNIST데이터셋 분류를 위한 Two-layer Fully-connected neural network 구현하기
과제2-BackPropagation-with Numpy
MNIST데이터셋 분류를 위한 Two-layer Fully-connected neural network 구현하기
MNIST는 손글씨 이미지 데이터셋이다. 이를 대상으로 두개의 레이어를 갖는 CNN을 구현한다. 이때 PyTorch같은 딥러닝 프레임 워크를 이용하지 않고 Numpy연산만으로 Forward와 BackPropagation을 구현해보자.
- 모델구현
- 모델 학습 및 평가
두개의 레이어를 통해 CNN을 구현해보자
import numpy as np
import matplotlib.pyplot as plt
def sigmoid(z):
	return 1/(1+np.exp(-z))

def softmax(X):
logit=np.exp(X-np.amax(X,axis=1, keepdims = True))
	return logit/np.sum(logit, axis = 1, keepdims = True)
softmax 함수 코드 설명
오버플로우를 방지하기 위해서 X의 각행(axis = 1)에서 각 행의 최댓값을 빼준다.
keepdims=True 를 통해서 최댓값을 계산한 후에도 배열의 차원을 (N,1) 로 유지시켜 준다. → 이렇게 해야 X에서 열벡터를 빼는 브로드캐스팅 연산이 올바르게 일어난다.
분모는 분자의 모든 값들을 각 행 별 총합을 모두 더해준다. 이때도 keepdims = True 를 통해 브로드캐스팅이 가능하도록 Shape을 (N,1) 로 유지시켜준다.
2-Layer Neral Network
class TwoLayerNN:
	def initialize_paramter(self, input_dim, num_hiddens, num_classes):
		  W1 = np.random.uniform(low = -np.sqrt(6/(input_dim+num_hiddens)), high = np.sqrt(6/(input_dim+num_hiddens)), size = (input_dim, num_hiddens))
      W2 = np.random.uniform(low = -np.sqrt(6/(num_hiddens+num_classes)), high = np.sqrt(6/(num_hiddens+num_classes)), size = (num_hiddens, num_classes))
      b1 = np.zeros((num_hiddens))
      b2 = np.zeros((num_classes))

      return {'W1':W1, 'W2':W2, 'b1':b1, 'b2':b2
  def forward(self,X):
	  z1 = X@self.params['W1'] + self.params['b1']
    a1 = sigmoid(z1)
    z2 = a1@self.params['W2'] + self.params['b2']
    y = softmax(z2)

    ff_dict = {'z1':z1, 'a1':a1, 'z2':z2, 'y':y}

    return y, ff_dict

	 def backward(self, X, Y, ff_dict):
		  # Loss: cross-entropy, y_hat = softmax(z2)
      dl_dz2 = (ff_dict['y']-Y) / X.shape[0]

      dl_db2 = np.sum(dl_dz2, axis = 0)
      dl_dW2 = ff_dict['a1'].T @ dl_dz2
      dl_da1 = dl_dz2 @ self.params['W2'].T

      dl_dz1 = dl_da1 * ff_dict['a1'] * (1-ff_dict['a1'])

      dl_db1 = np.sum(dl_dz1, axis = 0)
      dl_dW1 = X.T @ dl_dz1

      return {'dl_dW1':dl_dW1, 'dl_db1':dl_db1, 'dl_dW2':dl_dW2, 'dl_db2':dl_db2
xavier초기화의 목표는 가중치 행렬 $W$의 분산을 아래와 같이 설정하는게 목표다.
\[Var(W) = \frac{2}{n_{in} + n_{out} }\]분모의 in, out은 입력뉴런의 수, 출력뉴런의 수이다. ($d_{in}, d_{out}$)
이때 np.random.uniform 균등분포를 사용하므로 -limit, limit 내에서 모든 수가 나올 확률이 동일한 균등분포에서 값을 샘플링 해야한다.
균둥분포의 두 범위를 xavier초기화의 목표 분산에 맞게 설정하면 limit 는 \(\sqrt{\frac{6}{n_{in}+n_{out}}}\)이 됨.
    def train_step(self, X_batch, Y_batch, batch_size, lr):
        _, ff_dict = self.forward(X_batch)
        grad = self.backward(X_batch, Y_batch, ff_dict)

        self.params['W2'] = self.params['W2'] - lr * grad['dl_dW2']
        self.params['b2'] = self.params['b2'] - lr * grad['dl_db2']
        self.params['W1'] = self.params['W1'] - lr * grad['dl_dW1']
        self.params['b1'] = self.params['b1'] - lr * grad['dl_db1']
X_batch를 forward 후 backward시킨 grad를 이용해서 파라미터들을 lr을 이용해서 업데이트한다.
  def evaluate(self, Y, Y_hat):
        N = Y.shape[0]
        return np.sum(np.argmax(Y, axis = 1) == np.argmax(Y_hat, axis = 1)) /
Y는 (N,C)형태로 C개의 클래스를 갖는 원핫 인코딩이 N개 있는 형태이다. 데이터 수는 Y.shape[0] 이고, 한번 배치를 돌때마다 N개씩 데이터를 본다.
evaluate 함수는 정확도를 return하므로 원핫백터 Y의 argmax인 정답과 예측값인 $\hat{Y}$의 가장 확률이 높은 클래스가 같다면 맞은 케이스이므로 sum해준다. 이를 N으로 나눠주면 정확도를 측정할 수 있다.
# 모델 인스턴스화
model = TwoLayerNN(input_dim=784, num_hiddens=128, num_classes=10)
# 모델 훈련 및 평가 ( w. val data )
lr = 0.01
n_epochs = 100
batch_size = 256

model.train(X_train, Y_train, X_valid, Y_valid, lr, n_epochs, batch_size)
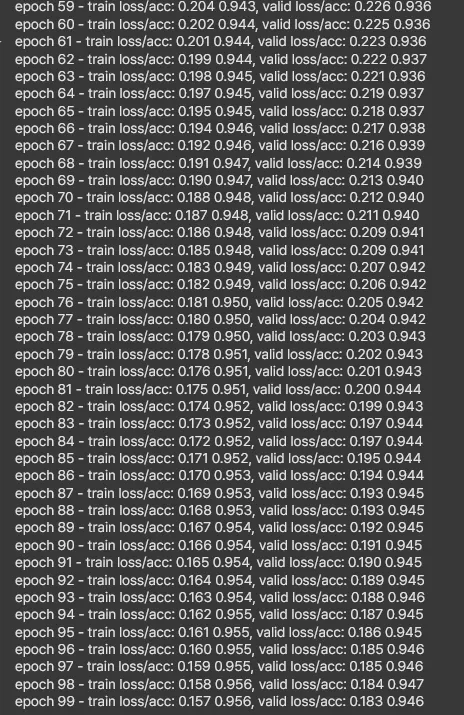
lr을 처음에는 0.00001로 설정했는데, 너무 작으니깐 학습이 너무 느리게 일어났다. 그래서 0.01로 설정하니, loss와 acc가 초기에 큰폭으로감소하는것을알수 있었다.
.png)
epochs를 너무 크게 주면 overfitting이 일어나서 train과 valid loss와 acc가 큰차이가 나야하지만, 100으로 주었기 때문에 적절한 수준에서 학습이 일어났고, train data와 valid data간의 유의미한 acc와 loss차이는 없었다.
# 모델 평가 ( w. test data )
Y_hat, _ = model.forward(X_test)
test_loss = model.compute_loss(Y_test, Y_hat)
test_acc = model.evaluate(Y_test, Y_hat)
print("Final test loss = {:.3f}, acc = {:.3f}".format(test_loss, test_acc)
#Final test loss = 0.304, acc = 0.915
최종적으로 loss는 0.3, acc는 0.9가 나왔다.
MNIST는 보통 0.98정도까지 acc를 올릴 수있다고 하는데, sigmoid함수를 activation Function으로 사용해서 학습이 잘 일어나지 않은것 같다.
아래에서 ReLU를 Activation Function으로 사용한 후 학습을 시켜보니 학습이 더 빠르고, 정확도가 더 높은 결과가 나옴을 알 수 있었다.
Y_hat, _ = model_relu.forward(X_test)
test_loss = model_relu.compute_loss(Y_test, Y_hat)
test_acc = model_relu.evaluate(Y_test, Y_hat)
print("Final test loss = {:.3f}, acc = {:.3f}".format(test_loss, test_acc)
#Final test loss = 0.165, acc = 0.952
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...