[AILifeCycle][3주차_과제_1] Linear Regression with Numpy
대기오염 데이터셋.CSV를 불러와서 PM10과 PM2.5사이의 Linear Regression진행하기
과제1. Linear Regression with Numpy
대기오염 데이터셋.CSV를 불러와서 PM10과 PM25사이의 Linear Regression 진행하기
import itertools
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import warnings
from google.colab import drive
drive.mount('/content/drive')
dataset = pd.read_csv("파일경로", on_bad_lines = "skip")
#판다스의 read_csv로 csv파일을 불러올 수 있고, on_bad_lines:로 규칙에 맞지 않는 행은 스킵할 수 있다.
dataset.head()
#가장 위의 5줄 불러오기
sns.scatterplot(x = dataset['PM10'], y = dataset['PM25'])
plt.show()
seaborn라이브러리의 scatterplot으로 x축에 그릴값, y축에 그릴 값을 지정해줄 수 있고, matplotlib.show()로 시각적으로 출력할 수 있다.
data = dataset.dropna(subset=['중요한 열'])
중요한열을 subset으로 설정해서 중요한 열이 없는 행은 지워버린다. → 중요한 열을 바탕으로 LInear Regression을 할꺼니까 중요한 열이 없는 행은 drop해버림
# 데이터셋을 train셋과 test셋으로 분할
def train_test_split(data, test_size=0.2, random_state=None):
    if random_state:
        np.random.seed(random_state)

    # 데이터프레임의 인덱스를 permutation으로 섞기
    indices = np.random.permutation(len(data))

    """
    data.shape은 [헹,열]형태의 리스트다. 따라서 행의 수는 shape[0]임
    """
    test_samples = int(data.shape[0] * 0.2)

    # 위에서 구한 test_samples로 랜덤한 수 리스트인 indices에서 수를 슬라이싱선택
    test_indices = indices[:test_samples]
    train_indices = indices[test_samples:]

    """
    data중 중요한 열만 선택해서 iloc을 이용해서 리스트를 이용해서 data 슬라이싱
    만약 열이름으로 슬라이싱 하고싶으면 loc이용하기 - pandas
    """
    train_data = data[['PM10', 'PM25']].iloc[train_indices]
    test_data = data[['PM10','PM25']].iloc[test_indices]

    return train_data, test_data

train_data, test_data = train_test_split(data)

'''
X는 2차원 배열로 변환해서 사용해야됨 -> reshape(-1,1)해주기
'''
X_train = np.array(train_data['PM10']).reshape(-1, 1)
y_train = np.array(train_data['PM25'])
X_test = np.array(test_data['PM10']).reshape(-1, 1)
y_test = np.array(test_data['PM25'])
class LinearRegression:
    def __init__(self):
        self.weights = None
        self.bias = None

    def fit(self, X, y):
        '''
	      [W,  [X, 이렇게 행렬곱으로 나타낼 수 있는데, bias를 W랑 같은 행렬에 있도록 해서 추가함
	       b]  1]
	       여기서는 hstack을 이용해서 수평으로 X랑 bias를 위한 특성인 1을 stack함
        '''
        X = np.hstack((np.ones((X.shape[0], 1)), X))

        """
        최소 제곱법(closed form)
        """
        self.weights = np.linalg.pinv(X.T @ X) @ X.T @ y

        """
        weights의 첫 번째 값에는 맨 처음에 X에 추가한것처럼 bias가 있고, 1번째부터는 weights가 있음
        """
        self.bias = self.weights[0]
        self.weights = self.weights[1:]

    def predict(self, X):
        # X에 절편 항 추가
        X = np.hstack((np.ones((X.shape[0], 1)), X))

        """
        bias랑 weights 수평으로 쌓은다음에 X랑 내적하면 pred나옴
        """
        y_pred = X.dot(np.hstack(([self.bias], self.weights)))

        return y_pred
X에 절편(bias) 항 추가하기
fit 메소드 안의 코드를 보겠습니다.
X = np.hstack((np.ones((X.shape[0], 1)), X))
선형 회귀의 수학식은 y=w_1x_1+w_2x_2+⋯+b 입니다. 여기서 b는 편향(bias) 또는 y절편(intercept)이라고 불리는 항입니다.
이 식을 행렬 연산으로 한 번에 처리하기 위해, b를 가중치의 일부처럼 취급하는 트릭을 사용합니다. 즉, y=w_1x_1+w_2x_2+⋯+w_0x_0 으로 식을 바꾸는 것이죠. 여기서 w_0이 b가 되고, x_0는 항상 1인 가상의 특성(feature)이 됩니다.
np.ones((X.shape[0], 1)) 코드는 바로 이 값이 1인 가상의 특성 열을 만드는 부분입니다.
X.shape[0]은 X의 행 개수(데이터 샘플의 수)를 의미합니다.np.ones(...)는 이 행 개수만큼 1로 채워진 열 벡터를 생성합니다.
그리고 np.hstack를 이용해 이 ‘1로 채워진 열’을 원래의 데이터 X의 맨 앞에 수평으로 붙여주는 것입니다.
결과적으로 모든 데이터 샘플에 x_0=1 이라는 특성이 추가되고, 우리는 나중에 이 x_0에 곱해지는 가중치 w_0를 찾아내기만 하면 됩니다. 그 w_0가 바로 bias가 되는 것이죠.
Bias와 가중치(Weights) 추출하기
self.weights = np.linalg.pinv(X.T @ X) @ X.T @ y
이 코드는 정규방정식(Normal Equation)을 사용하여 최적의 가중치 벡터를 한 번에 계산합니다. 여기서 계산된 self.weights는 bias에 해당하는 가중치(w_0)를 포함하고 있습니다.
위에서 1로 채워진 열을 맨 앞에 붙였기 때문에, 계산된 가중치 벡터 self.weights의 맨 첫 번째 값이 바로 bias(w_0)가 됩니다.
self.bias = self.weights[0]- Python 리스트나 Numpy 배열에서
[0]은 첫 번째 원소를 의미합니다. 따라서 이 코드는 가중치 벡터의 첫 번째 값(bias)을self.bias변수에 저장합니다.
- Python 리스트나 Numpy 배열에서
self.weights = self.weights[1:][1:]는 “1번 인덱스부터 끝까지”를 의미하는 슬라이싱(slicing)입니다.- 따라서 이 코드는 첫 번째 원소(bias)를 제외한 나머지 원소들, 즉 순수한 특성(feature)들에 대한 가중치(w_1,w_2,…) 만을 다시
self.weights변수에 덮어씌웁니다.
결과적으로 self.bias에는 절편 값이, self.weights에는 각 특성에 곱해질 가중치 값들이 분리되어 저장됩니다.
model = LinearRegression()
model.fit(X_train, y_train)
#model 인스턴스로 불러온 다음에 fit메서드로 Xtrain, ytrain넘겨줘서 학습킴
predictions = model.predict(X_test)
#predict메서드에 X_test넘겨줘서 predictions 생성
def mean_squared_error(y_true, y_pred):
# 제곱오차 구하기
    squared_errors = (y_true - y_pred)**2
# 제곱오차 평균내서 평균 제곱오차 구하기
    mse = np.mean(squared_errors)

    return mse
def r_squared(y_true, y_pred):

    #실제 값의 평균
    mean_y_true = y_true / len(y_true)

    #총 제곱합(TSS)을 계산
    tss = np.sum((y_true - mean_y_true)**2)


    #잔차 제곱합(RSS)을 계산

    rss = np.sum((y_true - y_pred)**2)
    #결정 계수를 계산

    r2 = 1- (rss / tss)

    return r2
plt.scatter(X_test, y_test, color='blue', label='Data')  # Scatter plot
"""
회귀선을 그리는 아래 코드의 빈칸을 채워 완성해주세요.
"""
plt.plot(X_test, predictions, color='red', label='Regression Line')

for i in range(len(X_test)):
    plt.plot([X_test[i], X_test[i]], [y_test[i], predictions[i]], color='gray', linestyle='--', linewidth=0.5)

plt.xlabel('PM10')
plt.ylabel('PM2.5')
plt.title('Scatter plot with Regression Line')
plt.legend()
plt.grid(False)
plt.show()
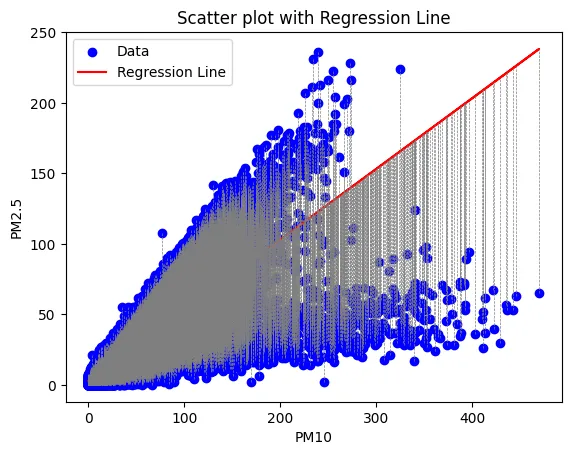
PM10을 X축으로, PM2.5를 y축으로 한 뒤 두 값의 선형회귀 선을 빨간색으로 나타내었다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...