[CV][4주차_과제_2] Traning ViT with DataAugmentation
Traning ViT with DataAugmentation
과제2_Traning ViT with DataAugmentation
Traning ViT with DataAugmentation
문제정의
ViT에서 다양한 DataAugmentation을 적용해보기!
diverse한 image생성을 통해 overfitting을 방지하고, interpolation(데이터 보간)을 통한 data distribution공간을 dense하게 만드는 효과를 낸다.
데이터셋 정보
- CIFAR-10 데이터셋 - 10개의 클래스, 32*32 컬러이미지
- Pytorch Lightning
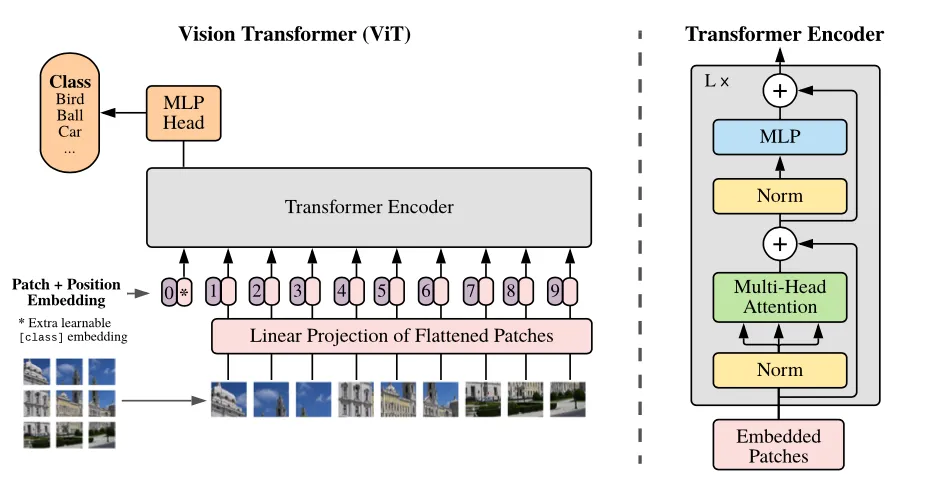
이미지 사이즈 모델에 맞게 변형하기
# Visualize 32x32 image to 224x224
import torchvision.transforms as transforms
from PIL import Image
import matplotlib.pyplot as plt

original_img = train_ds[0]['img']

# 이미지 크기를 224x224로 변환하는 변환기를 정의한다.
#CIFAR-10은 32*32의 이미지데이터셋인데, 크기를 resize해줌
transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor()
])

# 이미지를 변환 -> Transform을 이용해서 사이즈 키워주기
transformed_img = transform(original_img)

# 텐서를 이미지로 변환
transformed_img = transforms.ToPILImage()(transformed_img)

# 이미지를 시각화
plt.imshow(transformed_img)
plt.axis('off')  # 축을 표시하지 않기
32*32 이미지를 불러와서 224*224로 ViT모델에 맞는 크기로 Resize해준 다음 이미지로 변환하기
Augmentation을 하는 transforms 정의하기
from torchvision.transforms import (CenterCrop,
                                    Compose,
                                    Normalize,
                                    RandomHorizontalFlip,
                                    RandomResizedCrop,
                                    Resize,
                                    ColorJitter,
                                    GaussianBlur,
                                    RandomGrayscale,
                                    ToTensor)

normalize = Normalize(mean=image_mean, std=image_std) #이미지 normalize
_train_transforms = Compose(
        [
# train_dataset에 다양한 Augmentation 적용하기
            Resize(size),
            RandomHorizontalFlip(),
            RandomResizedCrop(size),
            ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.2),
            GaussianBlur(kernel_size=3),
           #RandomGrayscale(p=0.2),
            ToTensor()
    )

_val_transforms = Compose(
        [
            Resize(size),
            CenterCrop(size),
            ToTensor(),
            normalize,
        ]
    )

# 모든 train과 val 데이터에 대해서 위에서 정의한 transform을 적용하기
def train_transforms(examples):
    examples['pixel_values'] = [_train_transforms(image.convert("RGB")) for image in examples['img']]
    return examples

def val_transforms(examples):
    examples['pixel_values'] = [_val_transforms(image.convert("RGB")) for image in examples['img']]
    return examples
convert(’RGB’) 는 ViT의 입력 형식에 맞게 이미지를 RGB채널형태로 변환시키는 역할을 함. → 흑백이미지나 RGBA이미지도 RGB채널로 맞춰줌
Visualizing augmentated images
viz_data = train_ds[3]
original_image = viz_data['img']
augmented_image = viz_data['pixel_values']

transform = transforms.Resize((224, 224))
original_image = transform(original_image)
augmented_image = transform(augmented_image)

fig, axes = plt.subplots(1,2, figsize=(10,5))

axes[0].imshow(original_image) #첫번째 공간에 original_image 그리기
axes[0].set_title("Original Image") #제목설정
axes[0].axis('off') #불필요한 축 숨기기

axes[1].imshow(augmented_image.permute(1,2,0)) #두번째 공간에 augmented_image 그리기
axes[1].set_title("Augmented Image") #제목설정
axes[1].axis('off') #불필요한 축 숨기기

plt.tight_layout() #subplot간 간격 자동조절

plt.show()
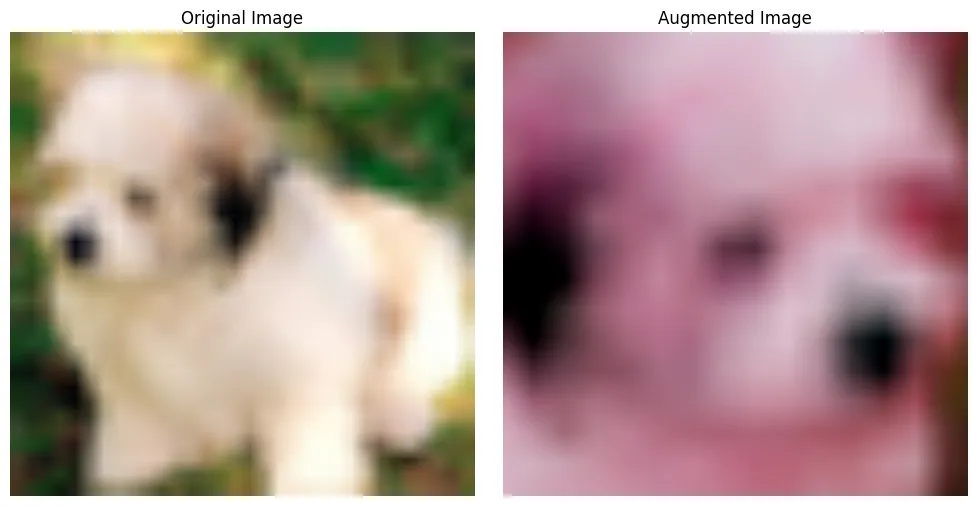
원하는 augmentation이 잘 적용되고 있는지 Visualizing해보는 과정이 필수적이다. → 실수방지, Loss로는 파악하기 힘든 모델의 성능파악
- 이미지의 channel order를 고려해야한다. PyTorch에서는 일반적으로 RGB순서로 학습을 진행하지만 cv2의 경우에는 기본이 BGR이라고 함 →
Permute()로 채널 순서를 맞춰줘야됨 - 각 dimension이 무엇을 의미하는지도 확인해야된다. cv2는
(height, width, channel)순서로 이미지를 처리하지만, torch는(batch, channel, height, width)순서로 tensor를 입력받는다. →permute()를 통해 channel순서를 바꿔주거나sqeeze(),unsqueeze()등을 통해 dimension을 생성, 제거해줘야됨 - GPU에 올라간 이미지는 numpy, matplotlib, OpenCV를 사용하려면 CPU에올려야됨
- PyTorch(GPU) vs NumPy(CPU)
- NumPy, Matplotlib, OpenCV 등 대부분의 파이썬 과학 라이브러리는 CPU의 메모리(RAM)에서만 동작합니다. 이들은 GPU 메모리에 직접 접근하는 방법을 모릅니다.
- PyTorch 텐서는 CPU 또는 GPU의 메모리에 위치할 수 있습니다. 또한, PyTorch는 자동 미분(autograd)을 위해 어떤 연산을 거쳤는지 연산 기록(computation graph)을 추적할 수 있습니다.
→ gradient가 계산되는 경우
detach()같은 함수를 사용해야 하는 경우도 있음cpu에 올리려면
cpu()같은 함수를 써야됨
데이터로더 및 모델정의
torch.utils.data 에서 DataLoader 를 import하면 DataLoader를 쉽게 생성할 수 있음
LightningModule을 사용해서 모델을 정의해서 사용하기
Train the model with augmented images
- Version_0:
RandomHorizontalFlip(), RandomResizedCrop(size)만 적용 - Version_1: Version_0에
ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.2),GaussianBlur(kernel_size=3),RandomGrayscale(p=0.2)추가적용 - Version_2: Version_1에 GrayScale을 뺐음
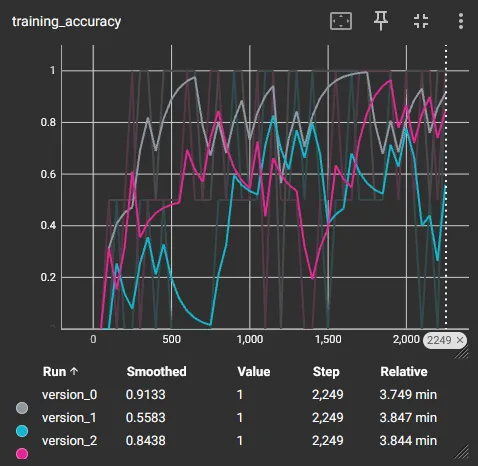
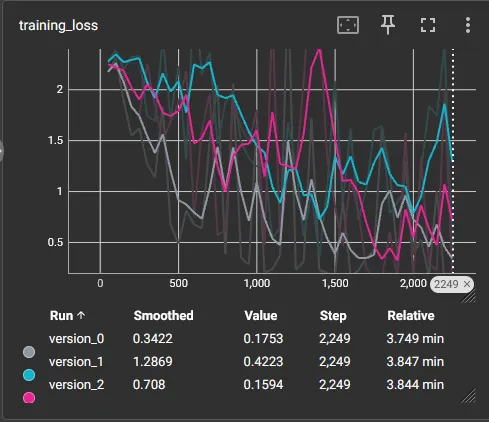
기본버전인 version_0이 가장 training_accuracy가 높고, training_loss가 낮음을 알 수 있다.
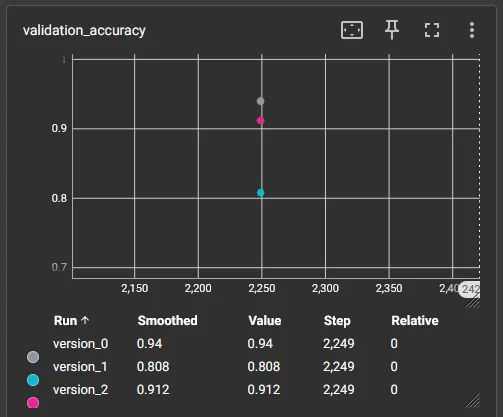
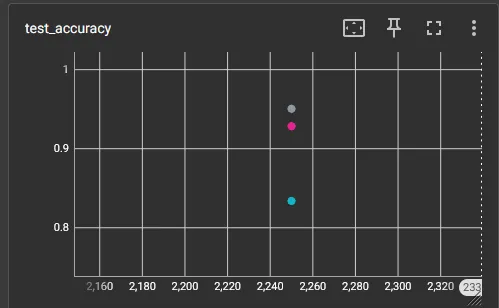
test, validation_accuracy도 같은 맥락으로 version_0에 대해서 가장 잘 예측해냈다.
다양한 Augmentation을 적용했는데도, 강의에서 들었던것과는 다르게 비약적인 성능향상은 없었고, 오히려 성능이 하락했다.
그 원인은 ViT모델의 사전학습된 부분을 고정하고 분류기만 새로 학습하는 Fine-tuning을 했기 떄문인데, ViT의 백본은 고정시킨 상태에서 분류기만 새로 학습하면 augmentation의 효과가 떨어질 수 있다고 한다. Augmentation을 하는 이유는 Feature extractor를 rubust하게 만드는것인데, 이부분이 고정되어 학습이 불가능하기 때문이다. backbone(Feature extractor)이 다양한 변화에도 흔들리지 않고 일관된 특징을 추출하도록 학습해야 하지만, backbone이 고정되고 분류기만 학습하는 경우 이미 특징추출이 끝난 고정된 벡터값만 보게 되므로, 데이터증강의 효과가 떨어진다.
Augmentation의 순서가 이미지에 미치는 영향
기하적 변환끼리는 순서가 중요하지만, 색상변환과 기하적 변환 사이의 순서는 결과에 미치는 영향이 크지 않다. 대부분의 색상변환은 이미지 전체에 적용되므로 색상변환과 기하변환의 순서는 최종결과물에 큰 영향을 주지 않는다. 하지만 기하적 변환의 순서는 매우 큰 영향을 미친다.
색상 변환이 모델 성능 향상에 도움이 되는 이유
색상은 모델의 본질적인 특징이 아니기 때문에, 비본질적인 특징에 과적합되는것을 막기 때문이다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...