[PyTorch][1주차_기본과제_3] Logistic_Regression
Logistic_Regression
과제3_Logistic_Regression
Pytorch를 이용해서 cars-Purchase Decision데이터에 대해 차량 구매 여부를 예측하는 로지스틱 회귀분석
- 로지스틱 회귀 분석에 필요한 pytorch 구성 요소들을 구현할 수 있다.
- 실제 데이터에 대해 로지스틱 회귀 분석을 실시할 수 있다.
- 주어진 데이터셋에 맞는 Dataset 클래스를 작성할 수 있다.
Pytorch Dataset 클래스 작성하기
Cars 데이터셋을 다루는 Dataset 클래스를 작성하기
import pandas as pd
import torch
from torch.utils.data import Dataset
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split

class CarsPurchaseDataset(Dataset):
    def __init__(self, file_path="car_data.csv", mode="train"):
        # file_path에 있는 파일을 읽어서 data로 저장하기
        data = pd.read_csv(file_path, sep = ",", header = 0)


        # x는 두 열을 drop하고, y는 purchased만 가져오기
        X = data.drop(columns = ["User ID","Purchased"])
        y = data["Purchased"]


        X['Gender'] = X.Gender.apply(lambda x: 0 if x == "Male" else 1)
        X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

        scaler = StandardScaler()
        X_train[['Age','AnnualSalary']] = scaler.fit_transform(X_train[['Age', 'AnnualSalary']])
        X_test[['Age','AnnualSalary']] = scaler.transform(X_test[['Age','AnnualSalary']])

        # mode에 따라 인자 값 다르게 지정해주기
        if mode == "train":
            self.X = torch.FloatTensor(X_train.values)
            self.y = torch.FloatTensor(y_train.values).unsqueeze(1)
        else:
            self.X = torch.FloatTensor(X_test.values)
            self.y = torch.FloatTensor(y_test.values).unsqueeze(1)


    def __len__(self):
        # len함수를 이용해서 길이 반환
        return len(self.X)


    def __getitem__(self, idx):
        # idx를 이용해서 해당 idx의 변수를 반환
        return self.X[idx], self.y[idx]
생성한 데이터셋 객체를 바탕으로 DataLoader 객체를 생성
- 학습용 데이터로더는 배치사이즈를 32로 하고, 랜덤으로 셔플된 데이터가 반환되도록 생성
- 평가용 데이터로더 객체는 배치사이즈를 64로 해서 생성
from torch.utils.data import DataLoader
# trainloader와 test_loader를 DataLoader의 인스턴스로 생성
train_loader = DataLoader(train_data, batch_size = 32, shuffle = True)
test_loader = DataLoader(test_data, batch_size = 64)
Logistic Regression 모형 작성하고 학습
로지스틱 회귀 모델을 위한 클래스를 작성
import torch.nn as nn

class LogisticRegressionNN(nn.Module):
    def __init__(self, input_size):
        super(LogisticRegressionNN, self).__init__()
        # 입력차원은input_size, 출력차원은 1인 Linear 인스턴스 생성
        self.linear = nn.Linear(input_size,1)

    def forward(self, x):
        # Linear로 forward 함수 정의
        return self.linear(x)
import torch.optim as optim

input_size = 3
model = LogisticRegressionNN(input_size)
criterion = nn.BCEWithLogitsLoss()
optimizer = optim.Adam(model.parameters(), lr = 0.01)
input_size를 hyperparameter로 지정하고,model을 인스턴스로 생성한다.- 손실함수로
BCEWithLogitsLoss()를 사용한다. - Optimizer로 Adam을 사용하고, Learning rate로 0.01을 준다.
train()함수 완성하기
def train(model, criterion, optimizer, dataloader, device, num_epoch=100):
    model.train()
    model.to(device)

    for epoch in range(num_epoch):
        epoch_loss = 0.0
        for inputs, targets in dataloader:
            inputs = inputs.to(device)
            targets = targets.to(device)

            optimizer.zero_grad()
            outputs = model(inputs)
            loss = criterion(outputs, targets)
            loss.backward()
            optimizer.step()
            epoch_loss += loss.item()


        print(f"Epoch {epoch+1}, Loss: {epoch_loss}")
train(model, criterion, optimizer, train_loader, device, 100)
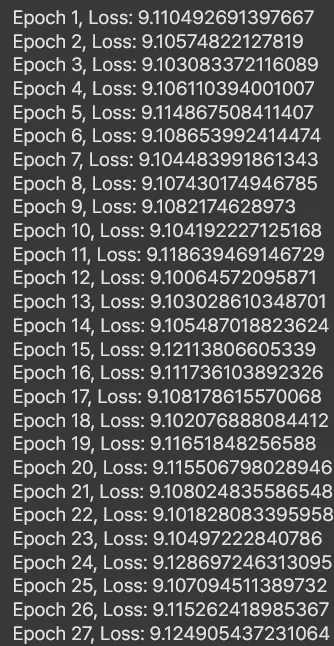
train까지 완성한 후 train() 을 돌려보면 epoch마다 loss가 감소하는것을 볼 수 있다.
모델평가함수 test()
def test(model, dataloader):
    model.eval()
    correct = 0 # 예측한 레이블이 정답과 일치하는 개수를 저장하기 위한 변수
    n_data = 0 # 전체 데이터의 개수를 저장하기 위한 변수
    for inputs, targets in test_loader:
        # inputs,targets를 'cuda'에 올리기
        inputs = inputs.to(device)
        targets = targets.to(device)
        #모델을 돌려서 y_pred를 뽑기
        y_pred = model(inputs)
        #y_pred에 대해서 0.5보다 크면 1, 아니면 0을 저장
        y_pred_class = (y_pred>0.5).float()
        correct += (y_pred_class == targets).sum().item()
        n_data += targets.size(0)

    print(f"accuracy: {correct/n_data}")
test(model, test_loader)
>>>accuracy:0.785
test() 를 이용해서 정확도를 측정해보면 0.785가 나온다.
Scikit-Learn 결과와의 비교
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 로지스틱 회귀 모델 초기화 및 학습
logistic_regression_model = LogisticRegression()
logistic_regression_model.fit(train_data.X, train_data.y)

y_pred = logistic_regression_model.predict(test_data.X)
accuracy = accuracy_score(test_data.y, y_pred)
print(f"Test Accuracy: {accuracy}")
>>>Accuracy:0.79
scikit-Learn결과와 비교해보면 비슷하게 적합함을 알 수 있다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...