[CV][논문 리뷰] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
ViT
[논문 리뷰] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
1. Abstract
- Attention은 CNN과 함께만 제한적으로 사용돼왔음. → Patch로 image를 나눠서 attention의 입력 sequence로 사용하는 방법 제시
- 기존의 방식보다 Resource를 훨씬 적게 사용하고도 Sota모델과 비슷하거나 더 좋은 성능을 냈음
Transformer 아키텍처는 자연어 처리(NLP)의 표준이 되었지만, 컴퓨터 비전 분야에서의 적용은 제한적이었다. 기존 비전 분야의 어텐션은 CNN과 함께 사용되거나, CNN의 전체적인 구조는 유지한 채 일부 구성 요소만을 대체하는 방식으로 사용되었다. 이 연구는 이러한 CNN에 대한 의존이 필수적이지 않음을 보인다. 대신, 이미지를 여러 고정된 크기의 패치(patch) 시퀀스로 만들어 순수 트랜스포머에 직접 적용하는 것만으로도 이미지 분류 작업에서 매우 좋은 성능을 낼 수 있음을 증명한다. 이 모델, Vision Transformer (ViT)는 대규모 데이터셋으로 사전 훈련되었을 때, ImageNet, CIFAR-100, VTAB 등 다수의 중간 혹은 작은 크기의 이미지 인식 벤치마크에서 SOTA(State-of-the-art) CNN 모델과 비교하여 뛰어난 결과를 달성한다. 특히 주목할 점은, 이러한 성과를 달성하는 동시에 모델 훈련에 필요한 컴퓨팅 자원은 훨씬 적게 요구한다는 점이다.
2. Introduction
- NLP에서는 Transformer덕에 매우 큰 Dataset을 학습할 수 있었지만, Computer Vision에서는 Specialized attention patterns때문에 modern hardware accelerators를 효율적으로 사용하지 못하는 한계가 있었음
- Transformer모델에서 최소한의 변형으로 CNN과 hybrid하는 기존의 연구와는 다르게, image를 패치로 나눠서 입력으로 사용한다.
- CNN의 locality나 inductive biases가 유리한 벤치마크에서도 결과적으로 큰 dataset에서 학습한 ViT는 SOTA급의 성능과 좋은 효율성을 보여줬다.
NLP 분야에서 트랜스포머는 large text corpus로 사전 훈련 후 특정 task에 fine-tune하는 접근법을 통해 지배적인 모델이 되었다. 하지만 컴퓨터 비전 분야에서는 여전히 ResNet과 같은 CNN 기반 아키텍처가 SOTA를 유지하고 있었다. CNN은 설계 자체가 이미지 데이터의 특성(inductive biases)을 잘 반영하도록 만들어졌기 때문이다.
이 연구는 NLP에서의 트랜스포머 스케일링 성공에 영감을 받아, 표준 트랜스포머를 최소한의 수정만으로 이미지에 직접 적용하는 실험을 진행한다. 이를 위해 이미지를 여러 개의 패치로 분할하고, 이 패치들의 선형 임베딩 시퀀스를 트랜스포머의 입력으로 사용한다. 즉, 이미지 패치를 NLP에서의 토큰(단어)처럼 동일하게 취급한다.
ImageNet과 같은 중간 크기의 데이터셋에서 이 모델을 훈련했을 때, 비슷한 크기의 ResNet보다 정확도가 몇 퍼센트 포인트 낮은, 다소 실망스러운 결과를 보였다. 이는 트랜스포머가 CNN에 내재된 귀납적 편향(inductive biases), 예를 들어 지역성(locality, 인접 픽셀 간의 강한 상관관계)과 translation equivariance( 객체의 위치가 변해도 동일하게 인식하는 특성)이 부족하기 때문이다. CNN은 컨볼루션 연산을 통해 이러한 편향을 모델의 모든 계층에 자연스럽게 주입하지만, 트랜스포머는 이러한 사전 가정 없이 데이터로부터 모든 공간적 관계를 학습해야 한다. 따라서 데이터가 충분하지 않으면 일반화 성능이 잘 나오지 않는다.
하지만 모델을 1,400만장에서 3억장에 이르는 더 큰 데이터셋으로 훈련했을 때, 결과는 완전히 달라진다. 대규모 데이터 학습이 귀납적 편향을 이긴다(large scale training trumps inductive bias)는 중요한 사실을 발견한다. ViT는 충분한 규모의 데이터셋(ImageNet-21k, JFT-300M)으로 사전 훈련되었을 때, 여러 이미지 인식 벤치마크에서 SOTA에 도달하거나 능가하는 성능을 보였다.
특히 데이터셋의 크기를 키워도 성능이 satuation을 보이지 않아서, 데이터셋을 더 키우면 성능이 더 향상될 수 있음을 시사한다.
3. Related Work (관련 연구)
- 이미지에 대한 Self-Attention 적용: Self-attention을 이미지에 직접 적용하는 것은 픽셀 수에 대해 이차비용(quadratic cost)이 발생하여 현실적인 입력 크기에서는 확장이 불가능하다. 이를 해결하기 위해 각 픽셀의 지역적 이웃에만 어텐션을 적용하거나(local self-attention), 미리 정의된 희소한 패턴에 적용하거나(Sparse Transformers), 가로축과 세로축을 따라 순차적으로 적용하는(axial attention) 등의 근사 방법이 제안되었다. 하지만 이러한 방법들은 특화된 어텐션 패턴을 사용하기 때문에 하드웨어 가속기(modern hardware accelerator)에서 효율적으로 구현하기 위한 복잡한 엔지니어링을 요구한다. → ViT에서는 Transformer의 Encoder에서 최소한의 변형으로 이미지 패치를 sequence 입력으로 주는것으로 모델을 사용한다. → 훨씬 단순하다.
- Hybrid(CNN과 Self-Attention의 결합): CNN의 feature map을 어텐션으로 보강하여 중요한 특징을 강조하거나, CNN의 최종 출력을 어텐션으로 후처리하여 객체 탐지, 비디오 처리 등의 성능을 높이는 연구도 있었다.
- 가장 유사한 연구:
- Cordonnier et al. (2020): 2x2 크기의 매우 작은 패치를 추출하고 그 위에 self-attention을 적용한 유사한 모델을 제안했다. 하지만 이 연구는 ViT가 증명한 대규모 사전 훈련이 SOTA CNN을 능가하는 핵심 열쇠임을 보여주지 못했고, 작은 패치 크기로 인해 저해상도 이미지에만 적용 가능했다.
- Image GPT (iGPT): 이미지 해상도와 색 공간을 줄인 뒤 픽셀 단위로 트랜스포머를 적용한 생성 모델이다. 비지도 학습 방식으로 훈련되어 ImageNet에서 최대 72%의 정확도를 달성했다.
- 대규모 데이터 학습: 이 연구는 ImageNet-21k나 JFT-300M 같은 대규모 데이터셋을 사용하여 SOTA를 달성한 선행 연구들(e.g., BiT)의 흐름을 따르되, 모델 아키텍처를 기존의 ResNet 기반 모델 대신 트랜스포머로 대체했다는 점에서 근본적인 차이가 있다. 결과적으로 Dataset을 많이 때려넣으니 성능 satuation없이 성능이 향상함을 밝혀냈다.
4. Method
모델 설계는 NLP 분야의 확장성을 그대로 활용하기 위해 원본 트랜스포머(Vaswani et al., 2017)를 최대한 가깝게 따른다. 이러한 단순한 설계는 확장성 높은 NLP 트랜스포머 아키텍처와 그 효율적인 구현체를 거의 수정 없이 사용할 수 있다는 장점이 있다.
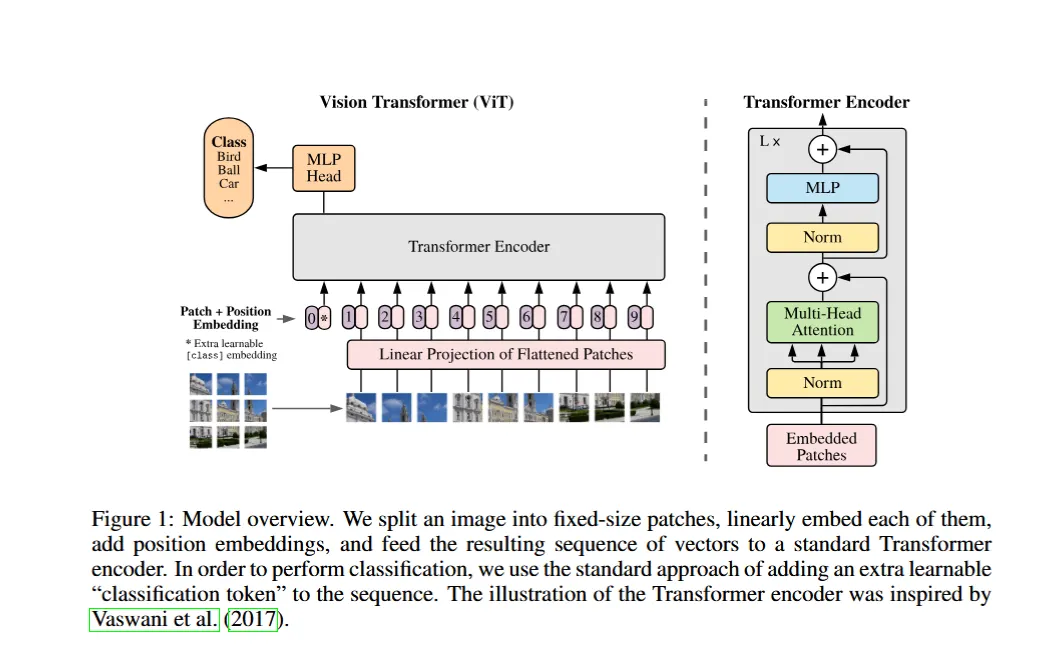
- 이미지 패치단위로 나누기
- patch를 embedding하고 positional embedding과 더하기
- Classification을 위해
[CLS]토큰과 함께 transformer model에 넣어주기
4.1 Vision Transformer (ViT)
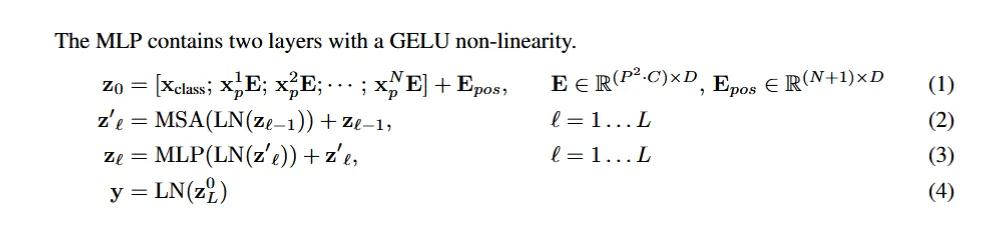
- 패치화 및 임베딩: 2D 이미지 \(x \in \mathbb{R}^{H \times W \times C}\)를 평탄화된(flattened) 2D 패치의 시퀀스 \(x_p \in \mathbb{R}^{N \times (P^2 \cdot C)}\)로 재구성한다. 여기서 \((P, P)\)는 각 패치의 해상도이고, \(N=HW/P2\)는 패치의 개수이자 트랜스포머의 유효 입력 시퀀스 길이가 된다. 이 패치들을 학습 가능한 선형 투영(linear projection)을 통해 트랜스포머의 모든 계층에서 사용되는 고정된 D차원의 벡터로 매핑하여 ‘패치 임베딩’을 생성한다.
- Class Token: BERT의
[class]토큰과 유사하게, 학습 가능한 임베딩 \((z_0^0 = x_{class})\)을 패치 임베딩 시퀀스의 맨 앞에 추가한다. 트랜스포머 인코더의 최종 출력에서 이 토큰에 해당하는 상태 \((z_L^0)\)가 이미지 전체의 표현(representation)으로 사용되어 최종 분류를 수행한다. - Position Embedding: 패치로 분할하면서 손실된 위치 정보를 유지하기 위해, 학습 가능한 1D 위치 임베딩을 각 패치 임베딩에 더한다. 이 임베딩을 통해 모델은 각 패치의 상대적, 절대적 위치를 학습하게 된다.
- Transformer Encoder: 인코더는 멀티헤드 셀프 어텐션(MSA) 블록과 MLP 블록이 번갈아 나타나는 구조로 구성된다. 각 블록 이전에는 LayerNorm(LN)이 적용되어 입력을 정규화하고, 이후에는 잔차 연결(residual connection)이 적용되어 깊은 네트워크의 학습을 안정시킨다. MLP는 두 개의 레이어와 GELU 활성화 함수로 구성된다.
- 귀납적 편향 (Inductive Bias): ViT는 CNN에 비해 이미지 특화적인 귀납적 편향이 훨씬 적다. CNN은 Locality, 2차원 이웃 구조, Translation equivariance가 컨볼루션 연산 자체에 내재되어 모델 전체에 적용된다. 반면 ViT에서는 MLP 레이어만 지역적이고, 셀프 어텐션 레이어는 모든 패치 쌍 간의 관계를 계산하므로 전역적(global)이다. 2차원 구조 정보는 초기 패치 분할 단계와 미세 조정 시 위치 임베딩을 보간할 때만 제한적으로 사용되며, 그 외 모든 공간적 관계는 데이터로부터 처음부터 학습되어야 한다.
- 하이브리드 아키텍처 (Hybrid Architecture): 이미지 패치 대신 CNN의 Feature map에서 추출한 패치 시퀀스를 ViT의 입력으로 사용할 수도 있다. 이 경우 CNN이 저수준 특징을 효과적으로 추출하고, 트랜스포머가 이를 바탕으로 전역적 관계를 모델링하는 역할을 분담한다.
4.2 Fine-tuning and Higher Resolution
일반적으로 ViT는 대규모 데이터셋에서 pretrain된 후, 더 작은 Downstream task에 Fine-tuning된다. 이때 사전 훈련에 사용된 예측 헤드를 제거하고, 목표 클래스 수(K)에 맞는 새로운, 0으로 초기화된 \(D×K\) FeedForward layer를 부착한다.
사전 훈련 때보다 높은 해상도의 이미지로 Fine-tuning하는 것이 종종 성능 향상에 도움이 된다. 더 많은 세부 정보를 포착할 수 있기 때문이다. 이 경우 패치 크기는 동일하게 유지되므로 시퀀스 길이가 길어진다. 사전 훈련된 위치 임베딩은 더 이상 유효하지 않으므로, 원본 이미지에서의 위치에 따라 2D interpolation을 통해 새로운 시퀀스 길이에 맞게 크기를 조정한다. 이 해상도 조정과 패치 추출 과정이 ViT에 2D 이미지 구조에 대한 귀납적 편향을 수동으로 주입하는 유일한 지점이다.
5. Experiments
5.1 실험 환경
- 데이터셋: 사전 훈련용으로 ImageNet(1.3M 이미지), ImageNet-21k(14M 이미지), JFT-300M(303M 이미지)을 사용하고, 전이 학습 평가용으로 ImageNet, CIFAR-10/100, Oxford-IIIT Pets 등과 19개 과제로 구성된 VTAB 벤치마크를 사용한다.
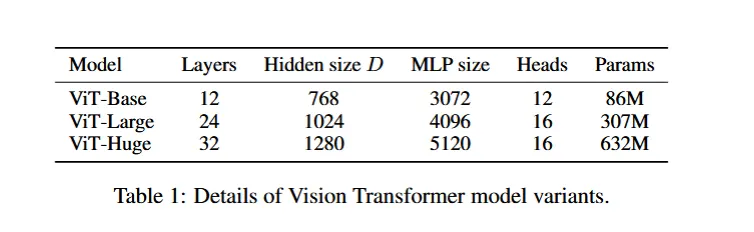
- 모델: BERT 설정을 기반으로 ViT-Base(86M 파라미터), ViT-Large(307M 파라미터), ViT-Huge(632M 파라미터) 모델을 구성한다. ResNet(BiT) 모델과 하이브리드 모델을 비교군으로 사용한다.
- 훈련: 사전 훈련은 Adam 옵티마이저를, 미세 조정은 SGD with momentum을 사용한다.
- 평가: Finetuning 정확도(Fine-tuning accuracy)와 퓨샷 정확도(Few-shot accuracy)를 측정한다.
5.2 SOTA 모델과의 비교
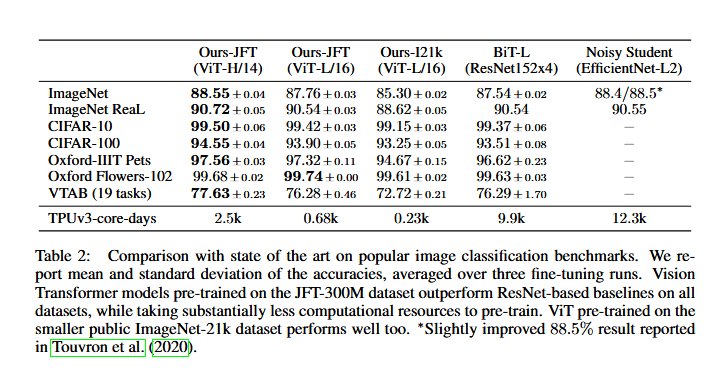
- JFT-300M으로 사전 훈련된 ViT-L/16 모델은 동일 데이터셋으로 훈련된 BiT-L(ResNet)보다 모든 과제에서 더 나은 성능을 달성했다. (예: ImageNet 87.76% vs 87.54%) 동시에 사전 훈련에 필요한 계산 자원은 BiT-L의 9.9k TPUv3-core-days 대비 0.68k로 현저히 적었다.
- 더 큰 모델인 ViT-H/14는 성능을 더욱 향상시켜 ImageNet에서 88.55%의 정확도를 달성했다.
- 공개 데이터셋인 ImageNet-21k로 훈련된 ViT-L/16 또한 우수한 성능을 보였다.
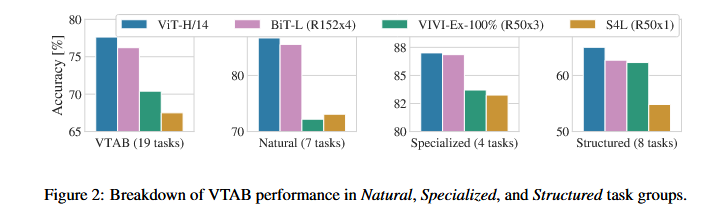
- VTAB 벤치마크 분석 결과, ViT-H/14는 자연 이미지(Natural) 및 구조적 이해(Structured) 과제 그룹에서 다른 SOTA 모델들보다 우수한 성능을 기록했다. 이러한 밴치마크들은 기하적 이해가 필요한 task인데, 이러한 task에서도 ViT모델들이 우수한 성능을 보임을 알 수 있다.
5.3 Pre-train 데이터 요구 사항
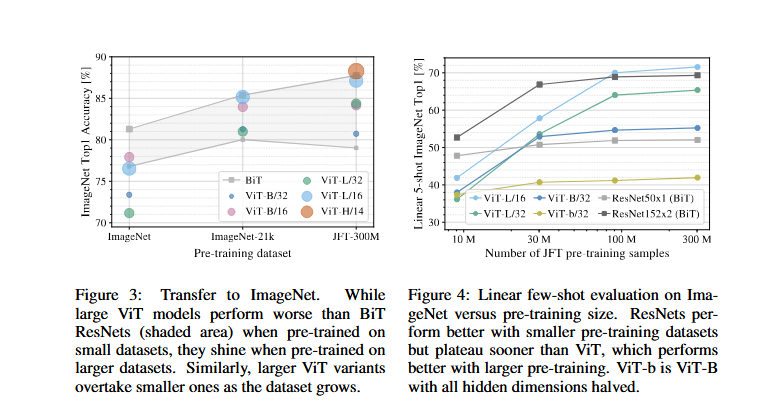
- ViT 모델을 점차 큰 데이터셋(ImageNet → ImageNet-21k → JFT-300M)으로 사전 훈련한 결과, 가장 작은 ImageNet에서는 ViT-Large 모델이 ViT-Base보다도 성능이 낮았지만, 데이터셋이 커질수록 ViT가 CNN을 능가했다. 이는 큰 ViT 모델이 작은 데이터셋에서는 과적합되기 쉽다는 것을 의미한다.
- JFT-300M의 부분 집합(9M, 30M, 90M)으로 훈련했을 때도, 적은 데이터에서는 ResNet이 우수했지만 90M 이상의 데이터에서는 ViT가 더 나은 성능을 보였다. 이는 CNN의 Inductive biases가 작은 데이터셋에서는 유용하지만, 큰 데이터셋에서는 데이터로부터 직접 패턴을 학습하는 것이 더 효과적임을 명확히 시사한다.
5.4 확장성 연구 (Scaling Study)
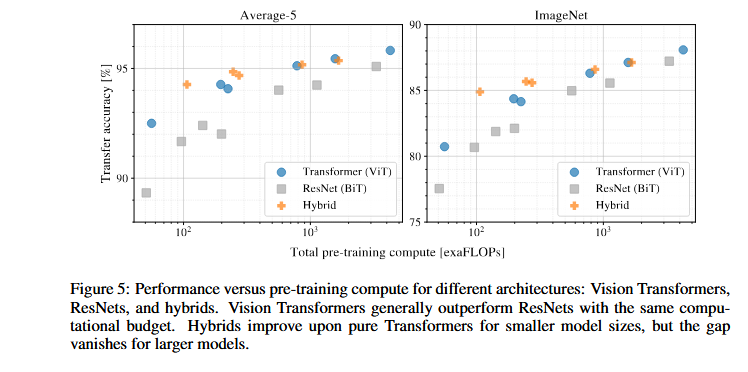
- 데이터 크기가 병목이 아닌 JFT-300M 환경에서 사전 훈련 비용 대비 성능을 비교한 결과, ViT는 ResNet보다 동일 성능 달성에 약 2-4배 적은 계산량을 사용하며 압도적인 효율성을 보였다.
- 하이브리드 모델은 작은 계산 예산에서는 순수 ViT보다 약간 우수했지만, 모델이 커지면서 그 차이는 사라졌다. 이는 모델 규모가 충분히 크면 CNN의 Low-level Feature 추출 능력이 ViT의 학습 능력에 흡수될 수 있음을 시사한다.
- ViT의 성능은 실험 범위 내에서 Saturation되지 않아, 추가적인 확장을 통해 성능 향상이 가능함을 시사한다.
5.5 ViT 내부 분석
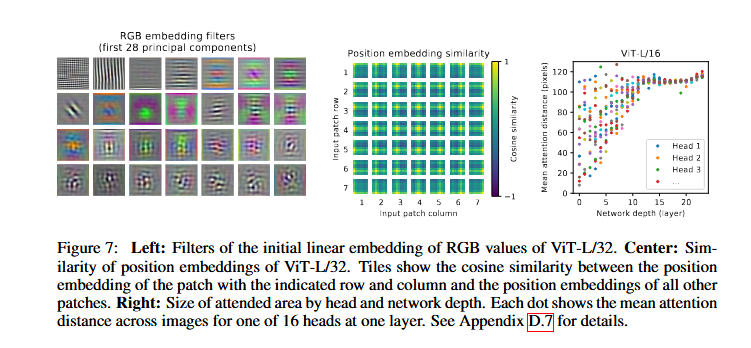
- 임베딩 필터: 첫 레이어의 학습된 임베딩 필터는 각 패치 내부의 미세 구조를 표현하기 위한 그럴듯한 basis functions와 유사한 형태(수직/수평/대각선, 색상 그래디언트 등)를 보여, Low-level Feature을 학습함을 확인했다.
- 위치 임베딩: 모델은 위치 임베딩의 유사도를 통해 이미지 내의 거리와 행-열 구조를 인코딩하는 법을 스스로 학습했다. 가까운 패치일수록, 그리고 같은 행이나 열에 있는 패치일수록 더 유사한 임베딩을 가졌다. 이때 스스로 위치임베딩을 학습하므로 hand-crafted 2D-embedding은 성능이 낮게 나옴을 확인할 수 있었다.
- 어텐션 거리: CNN의 수용 영역(receptive field)과 유사한 개념으로, 낮은 레이어의 일부 헤드는 처음부터 이미지 전체에 걸쳐 정보를 통합하는 전역적(grobal) 역할을, 다른 헤드들은 지역적(Local) 역할을 수행했다. 그러나 네트워크 깊이가 깊어질수록(deeper) 모든 헤드의 어텐션 거리는 증가했다. 따라서 depth가 깊어질수록 이미지 전체를 볼 수 있다는 의미이다. 이 지역적 어텐션은 하이브리드 모델에서는 덜 뚜렷하게 나타나, CNN의 초기 컨볼루션 레이어와 유사한 기능을 수행할 수 있음을 암시한다.
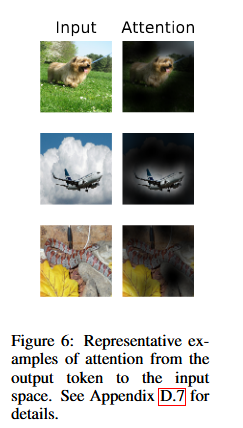
- 결과적으로 모델은 분류에 의미적으로 관련된 이미지 영역에 집중하는 경향을 보였다.
5.6 자기지도학습 (Self-Supervision)
- BERT의 마스크 언어 모델링을 모방하여, 이미지 패치의 50%를 가리고(masking) 그 가려진 패치의 평균 3비트 색상 값을 예측하는 ‘마스크 패치 예측(masked patch prediction)’을 예비 실험으로 수행했다.
- 이 방식으로 사전 훈련한 ViT-B/16 모델은 ImageNet에서 79.9%의 정확도를 달성하여, 처음부터 학습하는 것보다는 2% 높은 유의미한 성능 향상을 보였지만, 지도학습 사전 훈련(83.97%)보다는 4% 낮았다. 이는 자기지도학습의 가능성을 보여주지만, 지도학습과의 격차를 줄이기 위한 추가 연구가 필요함을 시사한다.
6. Conclusion (결론)
이 연구는 트랜스포머를 이미지 인식에 직접 적용하는 방법을 탐구했다. 이미지 특화적인 귀납적 편향을 거의 도입하지 않고, 이미지를 패치 시퀀스로 해석하여 표준 트랜스포머 인코더로 처리하는 단순한 전략이 대규모 데이터셋 사전 훈련과 결합될 때 매우 효과적임을 보였다. 즉, 데이터의 규모가 모델의 귀납적 편향을 압도할 수 있음을 증명했다. 그 결과 ViT는 다수 벤치마크에서 SOTA를 달성하면서도 사전 훈련 비용이 상대적으로 저렴했다.
향후 과제로는 ViT를 객체 탐지나 분할과 같은 다른 비전 과제에 적용하는 것, 자기지도학습 사전 훈련 방법의 격차를 줄이는 것, 그리고 ViT의 추가적인 확장을 통해 성능을 향상시키는 것이 남아있다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...