[PyTorch][심화과제] Without_torch.nn
WithOut_torch.nn
심화과제_Without_torch.nn
torch.nn을 사용하지 않고 MLP를 구현하고,torch.nn을 사용해서 구현한 MLP와 비교- 3가지 이상 카테고리를 분류하는 Multi-Class classification 구현
데이터셋 개요
Iris 데이터셋은 꽃잎과 꽃받침의 길이와 너비를 이용하여 iris 꽃의 품종을 분류하는 데이터셋이다. 총 3개의 class로 구성되어 있으며 각 class는 iris꽃의 품종을 나타낸다.
- iris data: iris 꽃의 꽃잎과 꽃받침의 길이와 너비를 나타내는 feature
- iris target: iris 꽃의 품종을 나타내는 label
데이터셋 불러오기
- Iris 데이터셋을 불러오고 Pytorch의 Dataset 클래스를 상속받아 정의된 클래스로 변환하기
__init__메소드에서self.X, self.y를 각각 iris 데이터와 iris target으로 초기화하기__len__메소드에서 데이터셋의 길이를 반환하기__getitem__메소드에서 index에 해당하는 데이터와 레이블을 반환하기
sklearn.datasets.load_iris() :iris 데이터셋을 불러오는 함수
sklearn.model_selection.train_test_split() : 데이터셋을 train과 test로 나누는 함수
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from torch.utils.data import DataLoader, Dataset
import torch

class IrisDataset(Dataset):
    def __init__(self, mode="train", random_state=0):
        # mode인자를 통해 train인지 test인지 구분하기 -> 사용하는 데이터 달라짐
        iris = load_iris()
        train_X, test_X, train_y, test_y = train_test_split(
            iris.data,
            iris.target,
            stratify=iris.target,
            test_size=0.2,
            random_state=random_state,
        )


        if mode == "train": # mode가 train일때는 train_X, train_y를 올려주기
            self.X = torch.tensor(train_X, dtype = torch.float)
             # feature가 되는 X 값을 PyTorch float 형태로 변환
            self.y = torch.tensor(train_y, dtype = torch.long)
            # Target이 되는 y 값을 PyTorch long 형태로 변환

        else: # mode가 test일떄는 test_X, test_y를 올려주기
            self.X = torch.tensor(test_X, dtype = torch.float)
            self.y = torch.tensor(test_y, dtype = torch.long)


    def __len__(self):
        # len()함수로 입력X길이 반환
        return len(self.X)

    def __getitem__(self, idx):
        # getitem함수에서는 idx에 해당하는 x와 y를 반환
        return self.X[idx], self.y[idx]
#배치사이즈는 16으로 설정
batch_size = 16

# train_dataset은 인스턴스로 생성
train_dataset = IrisDataset()
#PyTorch의 DataLoader를 이용해서 train_loader인스턴스 생성
train_loader = DataLoader(train_dataset, batch_size = batch_size, shuffle = True)

#test_dataset도 마찬가지로 인스턴스로 생성
test_dataset = IrisDataset()
test_loader = DataLoader(test_dataset, batch_size = batch_size, shuffle = False)
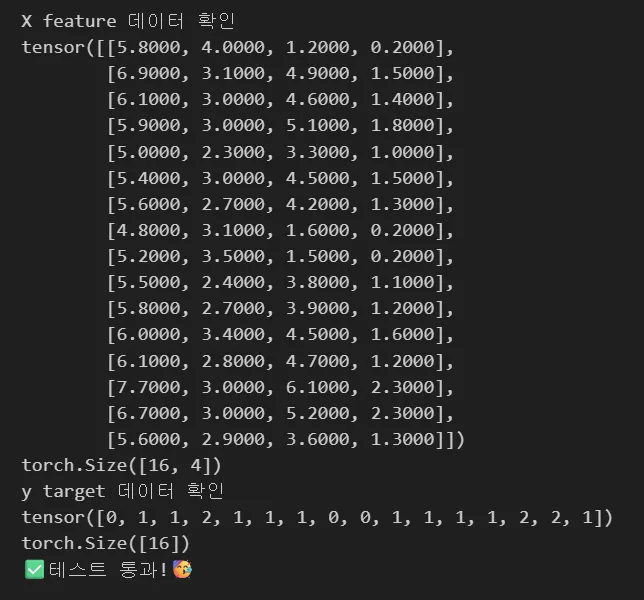
모델구현(Without torch.nn)
Define Linear layer
# 선형 레이어를 정의합니다. 이 레이어는 입력 특성과 출력 특성의 수를 받아서 가중치와 편향을 초기화합니다.
class WithoutNNLinear:
    def __init__(self, in_features, out_features):
        # weight는 randn()으로 가우시안 랜덤으로 초기화하기
        self.weight =  torch.randn(out_features, in_features, requires_grad = True)
        #bias는 zeros()로 0으로 초기화하기
        self.bias = torch.zeros(out_features, requires_grad = True)


    # 입력값 x를 받아 선형변환 수행
    def __call__(self, x):
        # weight과 x를 내적하고, bias를 더해서 Linear 연산을 수행
        return torch.matmul(self.weight,x.T).T + self.bias

    # weight과 bias를 device에 올리기
    def set_device(self, device):
        self.weight = self.weight.to(device)
        self.bias = self.bias.to(device)

    # 모델의 파라미터[Wiehgt, bias]를 반환하기.
    def parameters(self) -> list:
        return [self.weight, self.bias]
init()메서드는self.weight, self.bias를 초기화함call()메서드는x를 받아 선형변환 수행set_device메서드에서는 연산을 수행할 device에다weight, bias올려주기parameters메서드에서는weight와bias를 반환
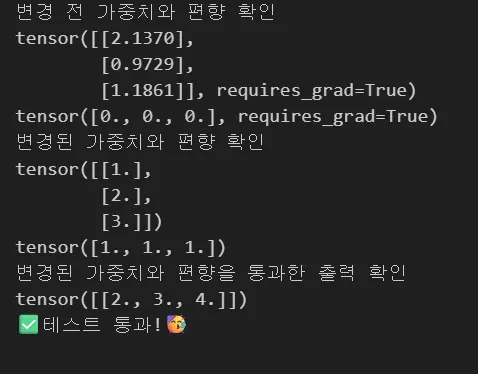
Linear layer의 계산 시각화
가중치행렬 Weight: \(W = \begin{bmatrix} 1.0 \\ 2.0 \\ 3.0 \\ \end{bmatrix}\)
편향벡터 bias: \(b = \begin{bmatrix} 1.0 & 1.0 & 1.0 \end{bmatrix}\)
입력데이터 x : \(x = [1.0]\)
\(y = xW^T + b\)인 선형계산을 하는과정
\[W^T = \begin{bmatrix}1.0 &2.0 & 3.0 \end{bmatrix}\]연산차원을 맞춰주기 위해서 Weight에 Transpose를 해준다.
\[xW^T = \begin{bmatrix}1.0 * 1.0 & 1.0 * 2.0 & 1.0 * 3.0\end{bmatrix}\]x와 elementwise 곱연산을 해준다.
\[xW^T + b = \begin{bmatrix}1.0 & 2.0 & 3.0\end{bmatrix} + \begin{bmatrix}1.0 & 1.0 & 1.0\end{bmatrix}\]bias와 더해준다.
최종결과
\[y = \begin{bmatrix}2.0 & 3.0 & 4.0\end{bmatrix}\]Define ReLU layer
\[ReLU(x) = max(0,x)\]ReLU연산은 0과 x중 더 큰값을 선택하는 연산이다. 즉 입력이 양수면 그대로를 출력하고, 그렇지 않으면 0을 출력한다.
class WithoutNNReLU:
    def __init__(self):
        pass

    def __call__(self, x):
        return torch.relu(x)
torch의 함수 relu를 불러와서 정의해준다.
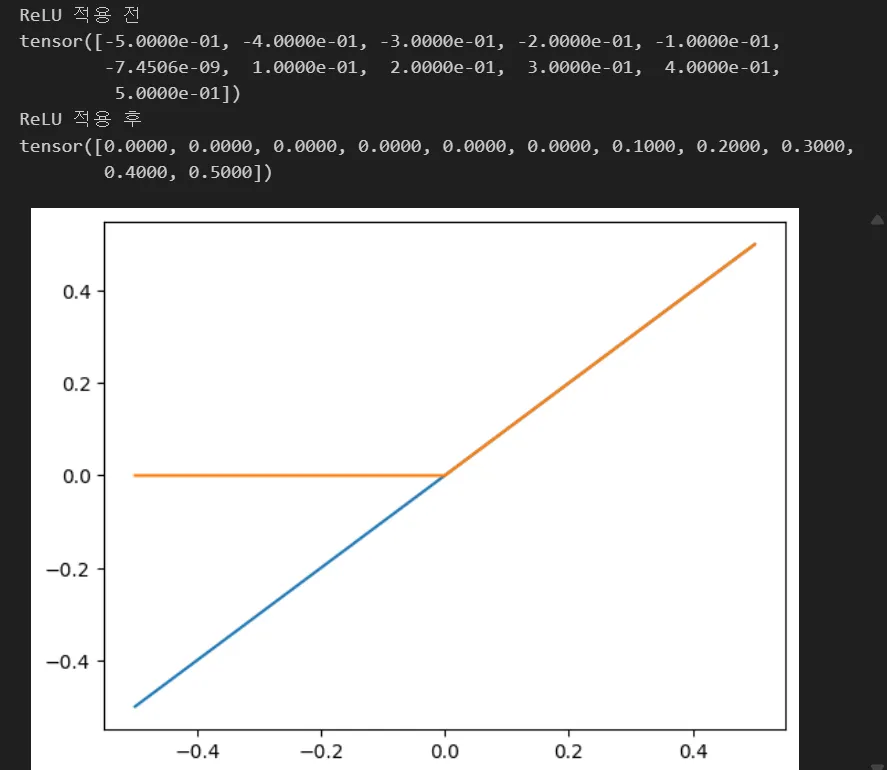
ReLU적용 전과 후를 시각화해보면 주황색그래프를 봤을때, 0보다 작은값들은 0으로 바뀐것을 볼 수 있다.
Define MLP(Multi-layer Perceptron)
class WithoutNNMLP:
    def __init__(self, in_features, hidden_features, out_features):

        # 두개의 선형 layer와 relu를 정의해준다.
        self.linear1 = WithoutNNLinear(in_features,hidden_features)
        self.relu =   WithoutNNReLU()# ReLU 활성화 함수
        self.linear2 = WithoutNNLinear(hidden_features, out_features)

    # 이 메서드를 통해 forward연산을 한다(linear1통과, relu, linear2 통과)
    def __call__(self, x):
        y = self.linear1(x)
        z = self.relu(y)
        return self.linear2(z)

    # Linear와 relu를 device에 올려준다.
    def set_device(self, device):
        self.linear1.set_device(device)
        self.relu.set_device(device)
        self.linear2.set_device(device)

    # 각 Linear의 weight와 bias를 리스트형태로 반환한다.
    def parameters(self) -> list:
        return [self.linear1.weight, self.linear1.bias, self.linear2.weight, self.linear2.bias]
Define CrossEntropyLoss
\[\hat{y}_{i,c} = \text{softmax}(z_{i,c}) = \frac{e^{z_{i,c}}}{\sum_{j=1}^{C} e^{z_{i,j}}}\]\(\hat{y}\)는 입력x를 통해 예측한값임
- \(z_i\)는 클래스 \(i\)에 대한 입력값 \(logit\)
- \(\sum_{j=1}^{c} e^{z_j}\)는 모든 클래스에 대한 입력값 지수의 합
- \(CrossEntropyLoss\) 공식 적용하면 정답 label인 \(y\)와 예측값인 \(\hat{y}\)사이의 loss를 구할 수 있음
- \(N\)은 샘플의 수
- \(C\)는 클래스의 수
class WithoutNNCrossEntropyLoss:
    def __init__(self, reduce="mean"):
        self.reduce = reduce

    # output인 예측값과 target인 label사이의 CrossEntropyLoss를 계산함.
    def __call__(self, output, target):
	    #output에 softmax를적용한 후 log를 취함
        y_hat = torch.log_softmax(output, dim = 1)
        #target을 원핫벡터로 만들어주기
        target = torch.nn.functional.one_hot(target, num_classes = output.size(1))
        #CrossEntropy공식 적용
        loss = -(torch.sum(target * y_hat)) / output.size(0)
        return loss
torch.log_softmax:softmax함수를 적용한 후 log를 취함torch.softmax: softmax 함수를 적용함
모델학습(Without torch.nn)
# 학습 데이터셋과 데이터 로더를 정의
batch_size = 16
train_dataset = IrisDataset()
train_loader = DataLoader(train_dataset, batch_size = batch_size, shuffle = True)

# 테스트 데이터셋과 데이터 로더를 정의
test_dataset = IrisDataset()
test_loader = DataLoader(test_dataset, batch_size = batch_size, shuffle = False)

# model, Lossfunction, optimizer, trainloader를 받아서 train하는 함수 정의
def train(model, criterion, optimizer, train_loader) -> float:

    # train단계에서는 미분할 수 있도록 설정
    torch.set_grad_enabled(True)

    running_loss = 0
    for X, y in train_loader:
        optimizer.zero_grad() # 그래디언트를 초기화.
        outputs = model(X) # model돌려서 output계산.
        loss = criterion(outputs, y)  # output이랑 label을 lossfunc에다 넣기.
        loss.backward()  # backprop연산.
        optimizer.step()  # 파라미터를 업데이트.
        running_loss += loss.item()  # 전체loss누적.

    return running_loss / len(train_loader)  # 평균 loss을 반환

def test(model, test_loader, criterion) -> tuple[float, float]:

    running_loss = 0
    correct = 0
    total = 0

    with torch.no_grad(): #Test에서는 미분하지 않도록 설정
        for X, y in test_loader:
            predictions = model(X) # 모델에다가 input 넣기.
            loss = criterion(predictions,y) # loss연산.
            running_loss += loss.item() # loss을 누적.
            _, predicted = torch.max(predictions.data, 1) # 가장 큰 값의 인덱스를 예측값으로 사용.
            correct += (predicted == y).sum().item() # 정답을 카운트.
            total += y.size(0) # 전체 개수를 카운트.
    return running_loss / len(test_loader), 100 * correct / total # 평균 loss과 정확도를 반횐.

def main():
    # Main에서는 model, optimizer, Lossfunc를 가져오기
    model = WithoutNNMLP(4, 100, 3) #이전에 정의한 MLP모델 인스턴스로 가져오기
    criterion = WithoutNNCrossEntropyLoss() #CrossEntropy를 인스턴스로 가져오기
    optimizer = torch.optim.SGD(model.parameters(), lr=0.01) #SGD를 torch에서 optimizer로 가져오기

    train_loss_list, test_loss_list, test_acc_list = [], [], []
    for epoch in range(50):
        train_loss = train(model, criterion, optimizer, train_loader)
        train_loss_list.append(train_loss)
        test_loss, test_acc = test(model, test_loader, criterion)
        test_loss_list.append(test_loss)
        test_acc_list.append(test_acc)
        print(
            f"Epoch: {epoch + 1}, Train Loss: {train_loss:.4f}, Test Loss: {test_loss:.4f}, Test Acc: {test_acc:.4f}"
        )

    plt.plot(train_loss_list, label="train loss")
    plt.plot(test_loss_list, label="test loss")
    plt.legend()
    plt.show()

    plt.plot(test_acc_list, label="test acc")
    plt.legend()
    plt.show()

    return train_loss_list, test_loss_list, test_acc_list
- train, test DataSet과 DataLoader를 선언
- train함수에서는 모델을 학습하고 학습 loss를 반환
- test함수에서는 모델을 평가하고 평가 loss와 accuracy를 반환
- main함수에서는 model, lossfunc, optimizer, train_lodaer를 받아서 학습진행
Train MLP
train_loss_list, test_loss_list, test_acc_list = main()
Epoch: 1, Train Loss: 21.3201, Test Loss: 4.0824, Test Acc: 60.0000 Epoch: 2, Train Loss: 7.4944, Test Loss: 1.0846, Test Acc: 68.3333 Epoch: 3, Train Loss: 11.1940, Test Loss: 8.5829, Test Acc: 66.6667 Epoch: 4, Train Loss: 6.9451, Test Loss: 6.7730, Test Acc: 66.6667 Epoch: 5, Train Loss: 6.5654, Test Loss: 3.1718, Test Acc: 66.6667 Epoch: 6, Train Loss: 4.3504, Test Loss: 0.4089, Test Acc: 85.0000 Epoch: 7, Train Loss: 4.9807, Test Loss: 0.3415, Test Acc: 88.3333 Epoch: 8, Train Loss: 8.5464, Test Loss: 16.7203, Test Acc: 66.6667 Epoch: 9, Train Loss: 6.6198, Test Loss: 2.0498, Test Acc: 68.3333 Epoch: 10, Train Loss: 5.8897, Test Loss: 6.2224, Test Acc: 54.1667 Epoch: 11, Train Loss: 4.3317, Test Loss: 10.2501, Test Acc: 66.6667 Epoch: 12, Train Loss: 3.4176, Test Loss: 14.7438, Test Acc: 66.6667 Epoch: 13, Train Loss: 6.0909, Test Loss: 18.1354, Test Acc: 66.6667 Epoch: 14, Train Loss: 4.3075, Test Loss: 8.4764, Test Acc: 66.6667 Epoch: 15, Train Loss: 1.8319, Test Loss: 0.1171, Test Acc: 95.0000 Epoch: 16, Train Loss: 3.1668, Test Loss: 0.2417, Test Acc: 95.0000 Epoch: 17, Train Loss: 2.7136, Test Loss: 4.7655, Test Acc: 65.0000 Epoch: 18, Train Loss: 2.7916, Test Loss: 2.8870, Test Acc: 67.5000 Epoch: 19, Train Loss: 3.0060, Test Loss: 14.5628, Test Acc: 66.6667 Epoch: 20, Train Loss: 7.1704, Test Loss: 0.1215, Test Acc: 95.0000 Epoch: 21, Train Loss: 0.3979, Test Loss: 0.1396, Test Acc: 94.1667 Epoch: 22, Train Loss: 0.6002, Test Loss: 0.6878, Test Acc: 87.5000 Epoch: 23, Train Loss: 0.8169, Test Loss: 1.2221, Test Acc: 80.0000 Epoch: 24, Train Loss: 1.9611, Test Loss: 0.6791, Test Acc: 87.5000 Epoch: 25, Train Loss: 0.5712, Test Loss: 4.5675, Test Acc: 67.5000 Epoch: 26, Train Loss: 0.8539, Test Loss: 0.2061, Test Acc: 95.8333 Epoch: 27, Train Loss: 0.2541, Test Loss: 0.3387, Test Acc: 93.3333 Epoch: 28, Train Loss: 0.5439, Test Loss: 0.1925, Test Acc: 92.5000 Epoch: 29, Train Loss: 1.1831, Test Loss: 1.1068, Test Acc: 82.5000 Epoch: 30, Train Loss: 2.0127, Test Loss: 3.5232, Test Acc: 66.6667 Epoch: 31, Train Loss: 1.1963, Test Loss: 0.5649, Test Acc: 88.3333 Epoch: 32, Train Loss: 1.9448, Test Loss: 3.0002, Test Acc: 68.3333 Epoch: 33, Train Loss: 1.1180, Test Loss: 1.0866, Test Acc: 79.1667 Epoch: 34, Train Loss: 3.6422, Test Loss: 0.4868, Test Acc: 90.8333 Epoch: 35, Train Loss: 0.4537, Test Loss: 0.7108, Test Acc: 88.3333 Epoch: 36, Train Loss: 0.4420, Test Loss: 0.2116, Test Acc: 95.8333 Epoch: 37, Train Loss: 1.3080, Test Loss: 0.1779, Test Acc: 96.6667 Epoch: 38, Train Loss: 0.3244, Test Loss: 4.3625, Test Acc: 66.6667 Epoch: 39, Train Loss: 0.6277, Test Loss: 0.2484, Test Acc: 92.5000 Epoch: 40, Train Loss: 0.4307, Test Loss: 0.4766, Test Acc: 91.6667 Epoch: 41, Train Loss: 0.9256, Test Loss: 0.2649, Test Acc: 92.5000 Epoch: 42, Train Loss: 0.6906, Test Loss: 0.4549, Test Acc: 92.5000 Epoch: 43, Train Loss: 0.4643, Test Loss: 4.0705, Test Acc: 67.5000 Epoch: 44, Train Loss: 1.0212, Test Loss: 1.5202, Test Acc: 80.0000 Epoch: 45, Train Loss: 1.0390, Test Loss: 0.3747, Test Acc: 91.6667 Epoch: 46, Train Loss: 0.2813, Test Loss: 0.1601, Test Acc: 96.6667 Epoch: 47, Train Loss: 0.4228, Test Loss: 0.2893, Test Acc: 95.0000 Epoch: 48, Train Loss: 0.2731, Test Loss: 0.5005, Test Acc: 90.8333 Epoch: 49, Train Loss: 0.2122, Test Loss: 0.1552, Test Acc: 96.6667 Epoch: 50, Train Loss: 0.2465, Test Loss: 0.1721, Test Acc: 92.5000
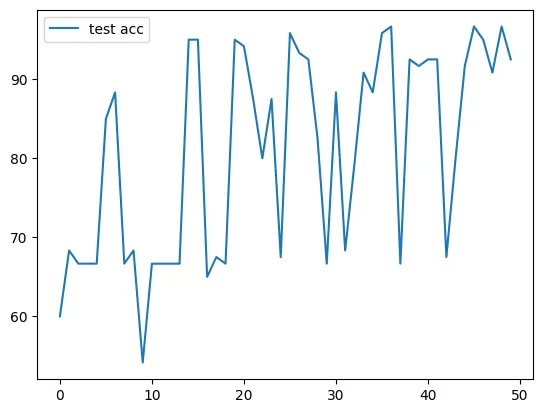
Test ACC가 결과적으로 90이상까지 올라갔음을 볼 수 있다.
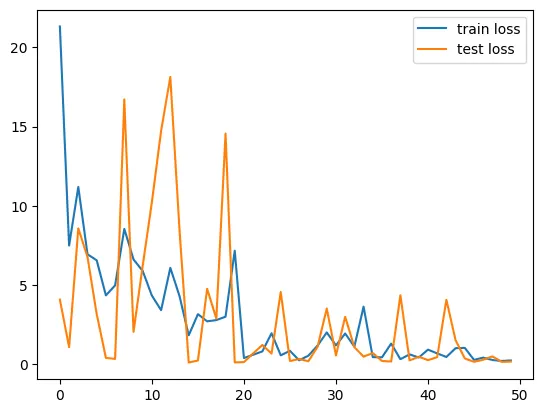
trainloss와 testloss를 시각화해보면 점차 줄어드는 추세를 볼 수있다. 다만 Optimizer로 SGD를 사용했으므로, 그래프의 개형이 들쭉날쭉함도 확인할 수 있다.
모델구현(With torch.nn)
torch.nn.Linear: Linear layer를 정의torch.nn.ReLU: ReLU layer를 정의torch.nn.CrossEntropyLoss: Cross Entropy Loss를 정의
import torch.nn as nn
# input_size = 1, output_size = 3인 Linear_layer를 정의
nn_linear = nn.Linear(1,3)
#relu정의
nn_relu = nn.ReLU()
Combine components
import torch.nn as nn

class MLP(nn.Module):
    def __init__(self, in_features, hidden_features, out_features):
        # lienar layer와 relu 정의해주기
        super().__init__()   # 상속받은 부모 클래스의 생성자 호출
        self.linear1 = nn.Linear(in_features, hidden_features)
        self.relu = nn.ReLU()
        self.linear2 = nn.Linear(hidden_features, out_features)

    def forward(self, x):
        # Linear1, relu, linear2 순서대로 쌓아주기
        y = self.linear1(x)
        z = self.relu(y)
        return self.linear2(z)
모델 학습
# nn.Module을 이용해서 train하는 함수
def train_nn(model, criterion, optimizer, train_loader):
    model.train()  # 모델을 학습 모드로 설정
    running_loss = 0
    for X, y in train_loader:
        optimizer.zero_grad() # 그래디언트를 0으로 초기화
        outputs = model(X) # 모델의 출력을 계산
        loss = criterion(outputs, y) # 손실을 계산
        loss.backward() # 역전파를 수행
        optimizer.step() # 가중치를 업데이트
        running_loss += loss.item() # 손실을 누적
    return running_loss / len(train_loader)  # 평균 손실을 반환

# nn.Module을 이용해서 test하는 함수
def test_nn(model, test_loader, criterion):
    model.eval()  # 모델을 평가 모드로 설정
    running_loss = 0
    correct = 0
    total = 0
    with torch.no_grad():  # 그래디언트 계산을 비활성화
        for X, y in test_loader:  # 테스트 데이터를 반복
            predictions = model(X) # 모델의 출력을 계산
            loss = criterion(predictions, y) # 손실을 계산
            running_loss += loss.item() # 손실을 누적
            _, predicted = torch.max(predictions,1)  # 가장 높은 확률을 가진 클래스를 예측
            correct += (predicted == y).sum().item() # 정확한 예측의 수를 누적
            total += y.size(0) # 전체 레이블의 수를 누적
    return running_loss / len(test_loader), 100 * correct / total  # 평균 손실과 정확도를 반환

# 모델을 돌리는 main함수
def main_nn():
    model = MLP(4, 100, 3)  # 모델을 생성
    criterion = nn.CrossEntropyLoss()  # 손실 함수를 정의
    optimizer = torch.optim.SGD(model.parameters(), lr=0.01)  # 최적화 알고리즘을 정의

    train_loss_list, test_loss_list, test_acc_list = (
        [],
        [],
        [],
    )  # 손실과 정확도를 저장할 리스트
    for epoch in range(50):  # 50 에포크 동안 학습
        train_loss = train_nn(
            model, criterion, optimizer, train_loader
        )  # 학습 손실을 계산
        train_loss_list.append(train_loss)  # 학습 손실을 저장
        test_loss, test_acc = test_nn(
            model, test_loader, criterion
        )  # 테스트 손실과 정확도를 계산
        test_loss_list.append(test_loss)  # 테스트 손실을 저장
        test_acc_list.append(test_acc)  # 테스트 정확도를 저장
        print(
            f"Epoch: {epoch + 1}, Train Loss: {train_loss:.4f}, Test Loss: {test_loss:.4f}, Test Acc: {test_acc:.4f}"
        )  # 에포크, 학습 손실, 테스트 손실, 테스트 정확도를 출력

    # 학습 손실과 테스트 손실을 그래프로 그림
    plt.plot(train_loss_list, label="train loss")
    plt.plot(test_loss_list, label="test loss")
    plt.legend()
    plt.show()

    # 테스트 정확도를 그래프로 그림
    plt.plot(test_acc_list, label="test acc")
    plt.legend()
    plt.show()

    return train_loss_list, test_loss_list, test_acc_list
Epoch: 1, Train Loss: 1.2110, Test Loss: 1.0636, Test Acc: 33.3333 Epoch: 2, Train Loss: 0.9644, Test Loss: 0.8945, Test Acc: 66.6667 Epoch: 3, Train Loss: 0.8138, Test Loss: 0.7550, Test Acc: 66.6667 Epoch: 4, Train Loss: 0.7220, Test Loss: 0.7044, Test Acc: 66.6667 Epoch: 5, Train Loss: 0.6809, Test Loss: 0.6342, Test Acc: 66.6667 Epoch: 6, Train Loss: 0.6383, Test Loss: 0.5987, Test Acc: 80.0000 Epoch: 7, Train Loss: 0.6095, Test Loss: 0.5539, Test Acc: 71.6667 Epoch: 8, Train Loss: 0.6122, Test Loss: 0.5313, Test Acc: 95.8333 Epoch: 9, Train Loss: 0.5246, Test Loss: 0.5288, Test Acc: 79.1667 Epoch: 10, Train Loss: 0.5148, Test Loss: 0.4969, Test Acc: 70.8333 Epoch: 11, Train Loss: 0.5079, Test Loss: 0.4777, Test Acc: 80.8333 Epoch: 12, Train Loss: 0.4936, Test Loss: 0.4735, Test Acc: 92.5000 Epoch: 13, Train Loss: 0.4782, Test Loss: 0.4803, Test Acc: 78.3333 Epoch: 14, Train Loss: 0.4583, Test Loss: 0.5844, Test Acc: 66.6667 Epoch: 15, Train Loss: 0.4582, Test Loss: 0.4727, Test Acc: 66.6667 Epoch: 16, Train Loss: 0.4668, Test Loss: 0.4430, Test Acc: 70.0000 Epoch: 17, Train Loss: 0.4332, Test Loss: 0.4147, Test Acc: 84.1667 Epoch: 18, Train Loss: 0.4284, Test Loss: 0.4653, Test Acc: 66.6667 Epoch: 19, Train Loss: 0.4325, Test Loss: 0.4323, Test Acc: 68.3333 Epoch: 20, Train Loss: 0.4156, Test Loss: 0.3859, Test Acc: 94.1667 Epoch: 21, Train Loss: 0.4014, Test Loss: 0.4121, Test Acc: 71.6667 Epoch: 22, Train Loss: 0.3999, Test Loss: 0.4223, Test Acc: 70.0000 Epoch: 23, Train Loss: 0.3759, Test Loss: 0.4708, Test Acc: 67.5000 Epoch: 24, Train Loss: 0.3901, Test Loss: 0.3851, Test Acc: 80.8333 Epoch: 25, Train Loss: 0.3787, Test Loss: 0.3531, Test Acc: 94.1667 Epoch: 26, Train Loss: 0.3712, Test Loss: 0.4013, Test Acc: 80.0000 Epoch: 27, Train Loss: 0.3743, Test Loss: 0.3473, Test Acc: 96.6667 Epoch: 28, Train Loss: 0.3434, Test Loss: 0.3384, Test Acc: 94.1667 Epoch: 29, Train Loss: 0.3495, Test Loss: 0.3420, Test Acc: 92.5000 Epoch: 30, Train Loss: 0.3382, Test Loss: 0.3760, Test Acc: 81.6667 Epoch: 31, Train Loss: 0.3412, Test Loss: 0.3223, Test Acc: 94.1667 Epoch: 32, Train Loss: 0.3257, Test Loss: 0.3147, Test Acc: 94.1667 Epoch: 33, Train Loss: 0.3269, Test Loss: 0.3093, Test Acc: 96.6667 Epoch: 34, Train Loss: 0.3271, Test Loss: 0.3053, Test Acc: 96.6667 Epoch: 35, Train Loss: 0.3087, Test Loss: 0.3014, Test Acc: 98.3333 Epoch: 36, Train Loss: 0.3063, Test Loss: 0.2991, Test Acc: 94.1667 Epoch: 37, Train Loss: 0.2971, Test Loss: 0.3536, Test Acc: 81.6667 Epoch: 38, Train Loss: 0.3078, Test Loss: 0.2928, Test Acc: 94.1667 Epoch: 39, Train Loss: 0.2895, Test Loss: 0.2951, Test Acc: 95.0000 Epoch: 40, Train Loss: 0.2935, Test Loss: 0.2934, Test Acc: 93.3333 Epoch: 41, Train Loss: 0.2944, Test Loss: 0.2785, Test Acc: 97.5000 Epoch: 42, Train Loss: 0.3021, Test Loss: 0.2804, Test Acc: 94.1667 Epoch: 43, Train Loss: 0.2818, Test Loss: 0.2700, Test Acc: 95.8333 Epoch: 44, Train Loss: 0.2870, Test Loss: 0.2658, Test Acc: 96.6667 Epoch: 45, Train Loss: 0.2636, Test Loss: 0.2654, Test Acc: 97.5000 Epoch: 46, Train Loss: 0.2677, Test Loss: 0.2749, Test Acc: 92.5000 Epoch: 47, Train Loss: 0.2657, Test Loss: 0.2645, Test Acc: 96.6667 Epoch: 48, Train Loss: 0.2602, Test Loss: 0.2543, Test Acc: 95.8333 Epoch: 49, Train Loss: 0.2631, Test Loss: 0.2951, Test Acc: 85.0000 Epoch: 50, Train Loss: 0.2698, Test Loss: 0.2473, Test Acc: 96.6667
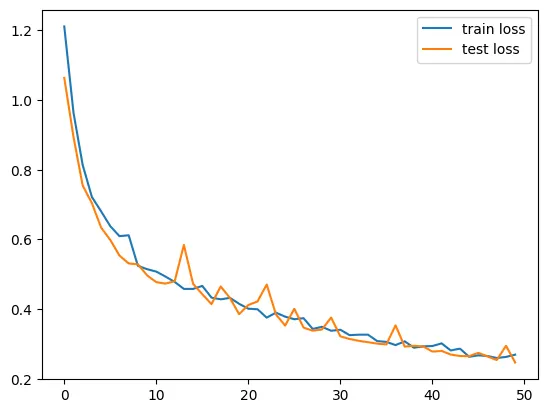
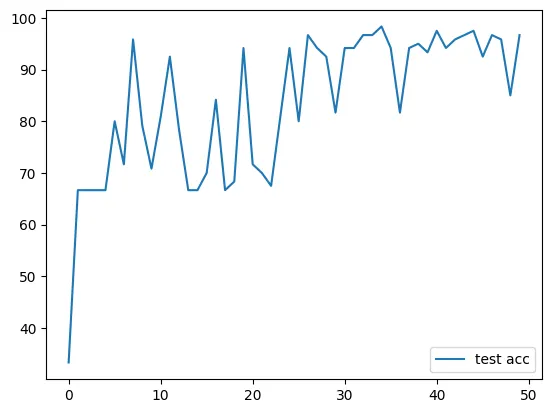
내가 handcraft로 만든 모델보다 더 안정적으로 loss가 줄어들고 test acc가 증가함을 볼 수 있다.
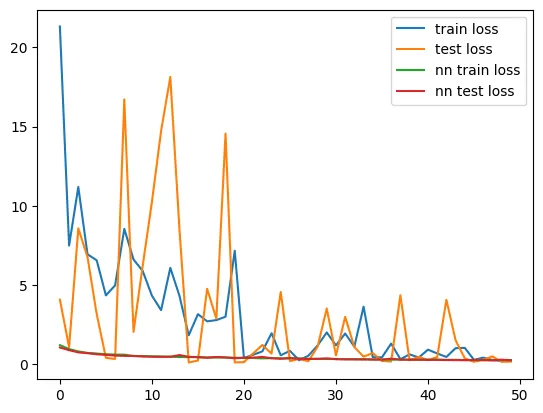
직접 그래프 값을 비교해보면, nn.Module 을 사용한 모델이 훨씬 loss가 낮고 안정적임을 볼 수 있다. 다만 학습이 점차 진행될 수록 내가 만든 모델도 안정적으로 loss가 수렴해감을 볼 수 있다.
이러한 차이는 nn.Module 에서는 ‘Xavier초기화’나 ‘He초기화’같은 기법을 사용하기 때문이다. 이 기법들은 모델의 입력과 출력의 분산을 비슷하게 유지하여, 학습 초기에 Vanishing gradient나 exploding gradient같은 문제가 발생하는것을 막아준다,
결과적으로 모델이 처음부터 안장적인 상태에서 학습을 시작할 수 있게 해주며, 초기부터 낮고 안정적인 Loss를 갖게된다.
weights = torch.randn(input_dim, output_dim)
bias = torch.zeros(output_dim)
내가 handcraft로 만든 모델은 표준졍구분포를 따르는 랜덤값으로 초기화를 했다. 이런방식을 사용하면 비정상적인 출력값이 Lossfunction을 통과하면 매우 큰 Loss가 계산되어 학습시 안정적이지 않다. → 모델을 만들때는 Xavier초기화를 애용하자.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...