[CV][논문 리뷰]: Deep Inside Convolutional Networks: Visualising Image Classification Models and Saliency Maps
[CV][논문 리뷰]: Deep Inside Convolutional Networks: Visualising Image Classification Models and Saliency Maps
논문 리뷰: Deep Inside Convolutional Networks: Visualising Image Classification Models and Saliency Maps
서론 (Introduction)
이 논문은 심층 합성곱 신경망(ConvNets)을 사용하여 학습된 이미지 분류 모델의 시각화를 다룬다. 두 가지 시각화 기법을 고려하는데, 둘 다 입력 이미지에 대한 클래스 점수의 그래디언트(gradient)를 계산하는 것에 기반한다.
첫 번째 기법은 클래스 점수\(S_c\)를 최대화하는 이미지를 생성하여 ConvNet에 의해 포착된 클래스의 개념을 시각화하는 것이다.
두 번째 기법은 특정 이미지와 클래스에 대한 클래스 saliency 맵을 계산하는 것이다. 논문은 이러한 맵이 약지도 학습(weakly supervised) 방식의 객체 분할에 사용될 수 있음을 보여준다.
마지막으로, 그래디언트 기반 ConvNet 시각화 방법과 deconvolutional networks 사이의 연관성을 확립한다.
논문은 다음과 같은 세 가지 기여를 한다.
- 입력 이미지의 \(argmaxS_c(I)\)를 사용하여 ConvNet 분류 모델의 이해 가능한 시각화를 얻을 수 있음을 보여준다. 이 방법은 weakly supervised learning이고, classification task에서 어떤 뉴런을 최대화해야 하는지 알고 있다는 점에서 비지도 학습 사례와 차이가 있다.
- 주어진 이미지에서 특정 클래스의 spatial support, 즉 이미지별 클래스 saliency 맵을 single Back-propagation으로 계산하는 방법을 제안한다.
- 그래디언트 기반 시각화 방법이 DeconvNet을 일반화한다는 것을 보여준다.
2.Class Model Visualisation
이 기법은 학습된 분류 ConvNet과 관심 클래스가 주어졌을 때, 해당 클래스를 대표하는 이미지를 수치적으로 생성하는 것으로 구성된다.
공식적으로, ConvNet의 분류 계층에 의해 계산된 클래스 c의 점수를 \(S_c(I)\)라고 할 때, \(S_c\)점수가 높은 L2-ragulated 이미지를 찾고자 한다. 최적화 문제는 다음과 같다. \(\arg\max_I S_c(I) - \lambda\|I\|_2^2\)
여기서 \(\lambda\)는 regularisation 파라미터이다. 국소적으로 최적인 이미지 I는 역전파 방법을 통해 찾을 수 있다. 이 과정에서 Weight는 Train 단계에서 찾은 값으로 고정시키고, 최적화는 입력 이미지에 대해 수행된다. → 일반적인 Backpropagation과정과는 다르다.
최적화는 zero image로 초기화되었고, 결과에 훈련 세트 평균 이미지를 더했다. 소프트맥스 계층이 반환하는 클래스 사후 확률\(P_c\)대신 정규화되지 않은 클래스 점수\(S_c\)를 사용했는데, 그 이유는 클래스 사후 확률의 최대화는 다른 클래스의 점수를 최소화함으로써 달성될 수 있기 때문이다. 따라서 최적화가 해당 클래스 c에만 집중하도록 \(S_c\)를 최적화했다. \(P_c\)를 최적화하는 실험도 진행했으나 결과가 시각적으로 두드러지지 않았다. 따라서 직관적이게 \(S_c\)를 직접 maximize하는 최적화 문제를 푼다.
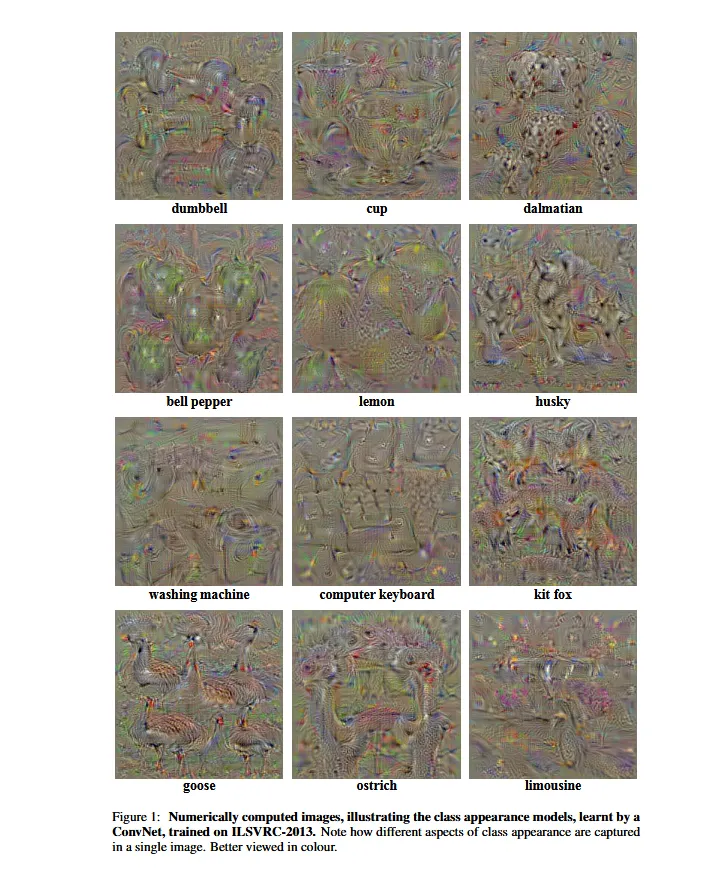 BackPropagation을 통해 Image를 Gradient Ascent로 생성한 결과, 모델이 해당 Class에 대해 보고있는 개념을 시각화 할 수 있다.
3. Image-Specific Class Saliency Visualisation
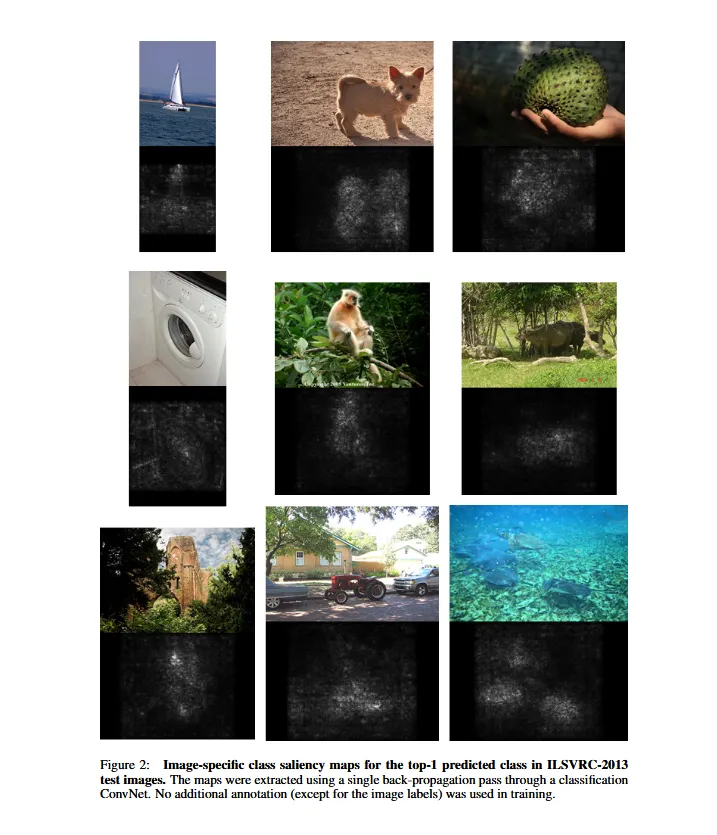
이미지가 특정 class에 대해 spatial support하는 classification ConvNet은. 이미지 \(I_0\)와 클래스 c가 주어졌을 때, \(I_0\)의 픽셀들을 \(S_c(I_0\)) 점수에 미치는 영향에 따라 순위를 매기는 것이 목표이다.
ConvNet에서 클래스 점수 \(S_c(I)\)는 I에 대한 복잡한 비선형 함수이다. 단순한 선형변환으로 Score를 구할 수는 없다고 한다. 따라서 주어진 이미지 \(I_0\)의 이웃에서 \(S_c(I\))를 1차 테일러 expension을 통해 선형 함수로 근사할 수 있다.
\[S_c(I) \approx w^T I + b\]여기서 \(w\)는 점 \(I_0\)에서 이미지 I에 대한 \(S_c\)의 도함수(derivative)이다.
\[w = \frac{\partial S_c}{\partial I}\bigg|_{I_0}\]이 식을 통해 Gradient가 큰 픽셀일 수록 중요도가 높다고 해석할 수 있고 이를 시각화하면 Saliency map으로 추출할 수 있다.
3.1 클래스 Saliency 추출 (Class Saliency Extraction)
주어진 이미지 \(I_0\)와 클래스 c에 대해, 클래스 saliency 맵 \(M \in \mathbb{R}^{m \times n}\)은 다음과 같이 계산된다.
- Gradient w를 역전파를 통해 찾는다.
- w 벡터의 원소들을 재배열하여 saliency 맵을 얻는다.
- 그레이스케일 이미지의 경우, 맵은 \(M\_{ij} = \mid w\_{h(i,j)}\mid\)로 계산된다.
- 다중 채널(예: RGB) 이미지의 경우, 각 픽셀 (i, j)에 대해 모든 색상 채널에 걸쳐 w의 최대 크기를 취한다: \(M\_{ij} = \max\_c\mid w\_{h(i,j,c)}\mid\)
이 saliency 맵은 이미지 레이블에 대해 훈련된 분류 ConvNet을 사용하여 추출되므로, Bounding Box나 Mask와 같은 추가적인 Supervising이 필요하지 않다. 계산은 단일 역전파 통과만 필요하므로 매우 빠르다.
3.2 Weakly Supervised Object Localisation
클래스 saliency 맵은 주어진 이미지에서 해당 클래스 객체의 위치를 인코딩하므로 객체 탐지에 사용될 수 있다.
하지만 이렇게 얻어낸 saliency map은 객체탐지의 결정적인 부분만 강조하고(예를들어 강아지의 얼굴) 객체 전체를 보여주지 않을 수 있다. 따라서 상위 95%의 quantile보다 높은 픽셀에서 foreground를 추출하고, 하위 30%에서 backgrond를 추출해서 GraphCut알고리즘을 돌려서 최종 mask를 생성해서 전체 객체를 나타낸다. 아래 사진속 3번째 사진에서 파란색은 Foreground, 빨간색은 BackGround이고 마지막 4번재 사진은 GraphCut알고리즘을 돌려서 객체탐지를 마친 사진이다. 객체 전체의 모습을 잘 탐지함을 볼 수 있다.
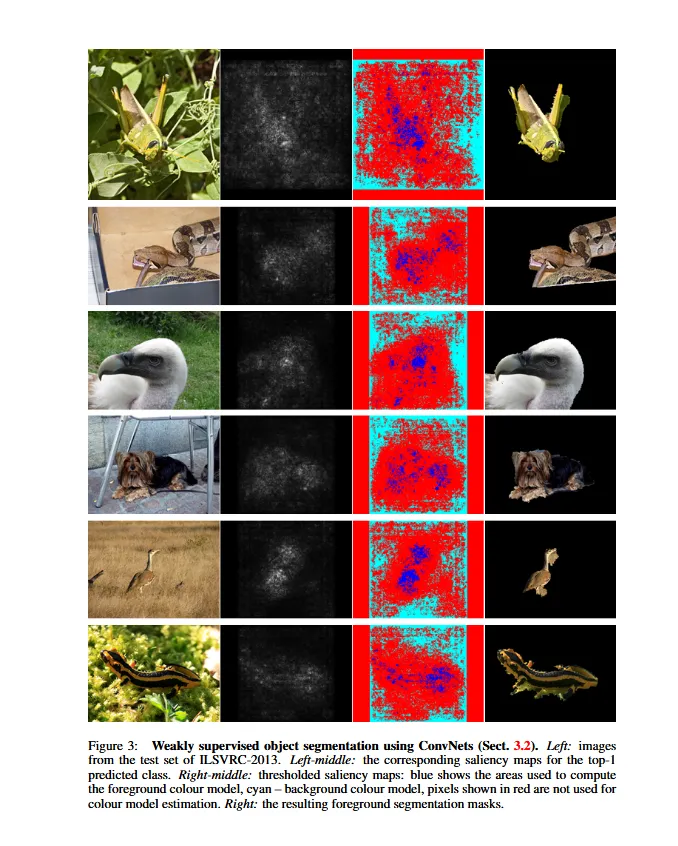
이 방법은 ILSVRC-2013 탐지 챌린지에 제출되었고, top-5 예측 클래스 각각에 대해 절차를 반복했다. 이 방법은 테스트 세트에서 46.4%의 top-5 오류를 달성했다. 이 방법은 약지도 학습 방식이며, 훈련 중에 객체 탐지 작업이 고려되지 않았음에도 불구하고, 동일한 데이터셋을 사용한 ILSVRC-2012 챌린지 제출물(50.0% 탐지 오류)보다 성능이 뛰어났다.
4. Relation to Deconvolutional Networks
이 섹션은 그래디언트 기반 시각화와 DeconvNet 아키텍처 사이의 연관성을 확립한다. n번째 계층 입력 \(X_n\)의 DeconvNet 기반 재구성은 시각화된 뉴런 활동 f의 \(X_n\)에 대한 그래디언트를 계산하는 것과 동등하거나 유사하다.
- Convolutional 계층 (\(X_{n+1} = X_n * K_n\)): 그래디언트는 \(\partial f/\partial X_n = \partial f/\partial X_{n+1} * \tilde{K}_n\)으로 계산되며, 여기서 \(\tilde{K}n\)은 뒤집힌 커널이다. 이는 DeconvNet에서의 n번째 계층 재구성 \(R_n = R{n+1} * \tilde{K}_n\)과 정확히 일치한다.
- RELU 계층 (\(X_{n+1} = \max(X_n, 0\))): 부경사도(sub-gradient)는 \(\partial f/\partial X_n = \partial f/\partial X_{n+1} \cdot \mathbf{1}(X_n > 0\)) 형태를 취하며, 여기서 \(\mathbf{1}\)은 원소별 지시 함수이다. 이는 DeconvNet RELU 재구성 \(R_n = R_{n+1} \cdot \mathbf{1}(R_{n+1} > 0)\)과 약간 다르다. 부호 지시자가 계층 입력 \(X_n\)대신 출력 재구성 \(R_{n+1}\)에 대해 계산된다.
- MaxPooling 계층: 부경사도는 \(\partial f/\partial X_n(s) = \partial f/\partial X_{n+1}(p) \cdot \mathbf{1}(s = \arg\max_{q \in \Omega(p)} X_n(q))\)로 계산된다. 여기서 \(\arg\max\)는 DeconvNet의 “스위치”에 해당한다.
결론적으로 RELU 계층을 제외하고, DeconvNet을 사용한 근사적 특징 맵 재구성 \(R_n\)은 역전파를 사용한 Gra dient \(\partial f/\partial X_n\)계산과 동등하다. 따라서 그래디언트 기반 시각화는 DeconvNet의 일반화로 볼 수 있으며, 그래디언트 기반 기법은 Conv layer뿐만 아니라 모든 layer의 Activation Visualization에 적용될 수 있다.
5. 결론 (Conclusion)
이 논문에서는 Deep Classification ConvNet을 위한 두 가지 시각화 기법을 제시했다. 첫 번째는 Class of Interest를 대표하는 인공적인 이미지를 생성하는 것이다. 이를 통해 모델이 해당 클래스에 대해 이해하고있는 개념을 Visualization할 수 있었다.
두 번째는 주어진 이미지에 대해 특정 클래스에 구별되는 영역을 강조하는 Image-spacific saliency 맵을 계산하는 것이다. 이러한 saliency 맵은 dedicated segmentation이나 detection model을 훈련할 필요 없이 GraphCut 기반 객체 분할을 초기화하는 데 사용될 수 있음을 보였다.
마지막으로, 그래디언트 기반 시각화 기법이 DeconvNet 재구성 절차를 일반화함을 입증했다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...