[NLP][미션]NLP:텍스트 전처리, RNN,LSTM 구현
[NLP][미션]NLP:텍스트 전처리, RNN,LSTM 구현
[NLP][미션]NLP:텍스트 전처리, RNN,LSTM 구현
- Text PreProcessing, Embedding 구현
- RNN cell을 구현하고, RNN 모델을 구현
- LSTM cell을 구현하고, LSTM 모델구현
Text Preprocessing and Tokenization
- 주어진 텍스트를 word단위로 구분해서 token으로 preprocessing을 해보자
def simple_tokenize(text):
    #1. 텍스트를 소문자로 변환하기
    text = text.lower()

    #2. ..!?;,는 하나의 토큰으로 구분하기 위해 앞뒤로 공백추가하기
    for char in ['.','!','?',';',',']:
        text = text.replace(char, ' ' + char + ' ')

    # 공백을 기준으로 리스트로 token화하기
    tokens = text.split()

    return tokens
- 텍스트로부터 어휘사전을 구축하는 클래스를 구현하자
class Vocabulary:
    def __init__(self):
        # padding과 unknown은 0과 1로 먼저 초기화를 해준다.
        self.word2idx = {'<PAD>': 0, '<UNK>': 1}
        self.idx2word = {0: '<PAD>', 1: '<UNK>'}
        #처음에 초기화를 해주고 나면 초기 vocab_size는 2이다,
        self.vocab_size = 2

    def build_vocab(self, texts):
        # 단어 빈도 계산
        word_counts = {}
        for text in texts:
            tokens = simple_tokenize(text)
            # token을 불러와서 dict에서 token의 빈도를 count한다.
            for token in tokens:
                if token in word_counts:
                    word_counts[token] += 1
                else:
                    word_counts[token] = 1

        # word2idx, isx2word update
        # vocab_size를 idx로 token을 encoding하는 dict를 만든다.
        for token in word_counts.keys():
            if token not in self.word2idx:
                self.word2idx[token] = self.vocab_size
                self.idx2word[self.vocab_size] = token
                self.vocab_size += 1

    def encode(self, text):

        tokens = simple_tokenize(text)
        # 토큰을 인덱스로 변환 (없는 단어는 <UNK> 사용)
        indices = []
        for token in tokens:
            # token에 대응하는 idx로 encoding한다.
            if token in self.word2idx.keys():
                indices.append(self.word2idx[token])
            else:
                indices.append(self.word2idx['<UNK>'])
        return indices

    def decode(self, indices):
        # 인덱스를 단어로 변환
        words = []
        for idx in indices:
            #idx 에 맞는 token으로 decoding한다.
            words.append(self.idx2word[idx])
        return words
- 단어 인덱스를 고정 크기 벡터로 변환하는 embedding table을 구현 → 임베딩 벡터의 차원은 정해져있고, 그보다 길이가 짧다면 padding을 해주어서 길이를 똑같이 맞춰준다.
class WordEmbedding(nn.Module):
    def __init__(self, vocab_size, embed_dim, padding_idx=0):
        super(WordEmbedding, self).__init__()
        self.vocab_size = vocab_size
        self.embed_dim = embed_dim
        self.padding_idx = padding_idx

        # 임베딩 테이블 생성 (vocab_size x embed_dim)
        # 이떄 nn.Parameter메서드를 써서 parameter로 vocab_size와 embed_dim을 초기화해준다.
        #xavier초기화로 임베딩 테이블 생성
        self.embedding_table = nn.Parameter(torch.empty(vocab_size, embed_dim))
        nn.init.xavier_uniform_(self.embedding_table)

        # 가중치 초기화 (평균 0, 표준편차 0.1)
        nn.init.normal_(self.embedding_table, mean=0.0, std=0.1)

        # 패딩 토큰을 영벡터로 설정
        self._reset_padding()

    def _reset_padding(self):

        if self.padding_idx is not None:
            with torch.no_grad():
               # padding_idx가 존재할때 embedding_table에서 해당 idx를 0으로 패딩시킨다.
                self.embedding_table[self.padding_idx] = 0

    def forward(self, indices):
			# indices텐서를 받아서, 임베딩 벡터들의 텐서로 embedding함
        embeddings = self.embedding_table[indices]

        return embeddings
RNN cell 구현
- RNN cell의 forward 연산을 구현하자.
- x_t: 현재 시점 입력
(batch_size, input_size) - h_prev: 이전 시점 은닉상태
(batch_size, hidden_size) - W_hh: 은닉-은닉 가중치
(hidden_size, hidden_size) - W_xh: 입력-은닉 가중치
(input_size, hidden_size) - b_h: 편향
(hidden_size,) - h_t: 현재시점 은닉상태 (
batch_size, hidden_size)
def rnn_cell(x_t, h_prev, W_hh, W_xh, b_h):
    h_t = torch.tanh(h_prev @ W_hh + x_t @ W_xh + b_h)
    return h_t
텐서내적연산은 @로 구현, 여기서는 텐서끼리 연산할때, Weight에 Transpose를 해주지 않아도, 내적차원이 맞추어져 있으므로, forward 수식 그대로 연산을 진행한다.
- RNN cell을 이용해서 전체 시퀀스를 처리하는 RNN 클래스를 구현해보자.
class SimpleRNN(nn.Module):
    def __init__(self, input_size, hidden_size):
        super(SimpleRNN, self).__init__()
        self.hidden_size = hidden_size
        self.input_size = input_size

        # 학습가능한 파라미터로 Weight와 bias를 randn초기화로 진행한다.
        self.W_hh =  nn.Parameter(torch.randn(hidden_size, hidden_size))
        self.W_xh = nn.Parameter(torch.randn(input_size, hidden_size))
        self.b_h = nn.Parameter(torch.randn(hidden_size))

        # 가중치 초기화
        self._init_weights()

    def _init_weights(self):
# Xavier초기화 코드로 구현
        std = 1.0 / (self.hidden_size) ** 0.5
        for weight in self.parameters():
            weight.data.uniform_(-std, std)

    def forward(self, x, hidden=None):

        batch_size, seq_len, input_size = x.size()

        # 초기 은닉상태에서 None일때는 0벡터로 초기화한다.
        if hidden is None:
            # hidden을 0벡터로 초기화
            hidden = torch.zeros(batch_size, self.hidden_size)

        outputs = []

        # 시퀀스 각 시점에 대해 RNN 셀 적용
        for t in range(seq_len):
            # 1. x_t는 t시점에서의 x이므로 seq_len의 t번째 값만을 가져온다.
            x_t = x[:, t, :]

            # rnn_cell함수를 이용해서 t에서의 hidden vector 구하기
            h_t = rnn_cell(x_t, hidden, self.W_hh, self.W_xh, self.b_h)

            # output list에 h_t를 append하기
            #이때 아래서 dim=1을 기준으로 cat해야하므로 unsqueeze를 이용해서 dim=1을 추가해준다.
            outputs.append(h_t.unsqueeze(1))
            # 각 sequence step에서의 hidden update
            hidden = h_t

        # 모든 시점의 출력을 하나의 텐서로 결합
        outputs = torch.cat(outputs, dim=1)
        return outputs, hidden
- bi-directional RNN을 구현해서 시퀀스를 앞뒤로 모두 처리해보자.
- bi_output
:(batch_size, seq_len, hidden_size*2)- output size를 맞추려면 forward, backward로 RNN을 돌린 후
hidden_sizedimension으로 concat을 해주면 된다.
- output size를 맞추려면 forward, backward로 RNN을 돌린 후
class BiRNN(nn.Module):
    def __init__(self, input_size, hidden_size):
        super(BiRNN, self).__init__()
        self.hidden_size = hidden_size

        # 순방향과 역방향 RNN -> SimpleRNN의 인스턴스로 생성
        self.forward_rnn = SimpleRNN(input_size, hidden_size)
        self.backward_rnn = SimpleRNN(input_size, hidden_size)

    def forward(self, x, hidden=None):
        batch_size, seq_len, input_size = x.size()

        # 순방향 RNN
        forward_out, forward_hidden = self.forward_rnn(x, hidden)

        # 시퀀스 뒤집기 -> torch.flip()함수 이용
        x_reverse = torch.flip(x,dims=[1])
        backward_out, backward_hidden = self.backward_rnn(x_reverse, hidden)

        # 출력도 다시 뒤집기 -> forward와 concat하기 위해 시간순서 다시 맞춰주기
        backward_out = torch.flip(backward_out, dims = [1])

        # 순방향과 역방향 출력 연결
        bi_output = torch.cat((forward_out,backward_out),dim=2)

        return bi_output, (forward_hidden, backward_hidden)
x_reverse = torch.flip(x,dims=[1]) : torch.flip()은 인자로 들어온 텐서를 dims를 기준으로 뒤집는 함수이다. 이때 x텐서는 batch_size, seq_len, hidden_size 를 순서대로 가지므로, seq_len 를 뒤집어야 문장을 역방향으로 학습할 수 있다. 따라서 dims=[1] 을 인자로 줘서 역방향으로 학습하도록 한다.
forward_out과 backward_out 을 concat할때는 bi_output 이 hidden_size*2 를 가져야 하므로 dim=2 를 인자로주어 concat을 해야 한다.
LSTM 게이트 구현
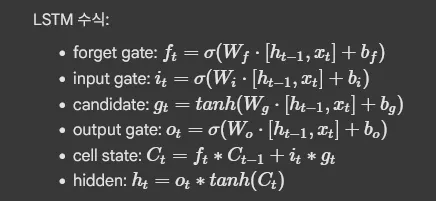
lstm_cell_forward()함수를 구현해서 LSTM셀의 한스텝 연산을 수행하는 함수를 구현하자.
def lstm_cell(x_t, h_prev, c_prev, W_f, W_i, W_g, W_o, b_f, b_i, b_g, b_o):
    # [h_{t-1},x_t]를 구현하기 위해 concat을 해준다.
    combined =  torch.cat((h_prev,x_t),dim=1)

    # 각 게이트 수식을 코드로 구현
    f_t = torch.sigmoid(combined@W_f + b_f)
    i_t = torch.sigmoid(combined@W_i + b_i)
    g_t = torch.tanh(combined@W_g+ b_g)
    o_t = torch.sigmoid(combined@W_o + b_o)

    # 셀 상태와 은닉 상태 업데이트
    c_t = f_t*c_prev + i_t *g_t
    h_t = o_t * torch.tanh(c_t)

    return h_t, c_
x_t(torch.Tensor): 현재 시점의 입력(batch_size, input_size)h_prev(torch.Tensor): 이전 시점의 은닉 상태(batch_size, hidden_size)c_prev(torch.Tensor): 이전 시점의 셀 상태(batch_size, hidden_size)W_*, b_*(torch.Tensor): 각 게이트(forget, input, gate, output)의 가중치와 편향
각 게이트의 수식에 맞게 코드로 구현해주었다. 이때 셀상태와 은닉상태를 업데이트 할때 elementwise multiplication은 *으로 수행해준다. 내적은 @ 연산자로 수행해준다.
- 앞에서 구현한 LSTM cell을 사용해서 SimpleLSTM 클래스를 구현해보자
class SimpleLSTM(nn.Module):
    def __init__(self, input_size, hidden_size, forget_bias=1):
        super(SimpleLSTM, self).__init__()
        self.hidden_size = hidden_size
        self.input_size = input_size

        # 모든 Weight를 학습가능한 파라미터로 설정해준다.
        self.W_f = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size))
        self.W_i = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size))
        self.W_o = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size))
        self.W_g = nn.Parameter(torch.randn(input_size + hidden_size, hidden_size))

        # 편향도 마찬가지로 학습가능한 파라미터로 설정해준다.
        self.b_f = nn.Parameter(torch.ones(hidden_size) * forget_bias)
        self.b_i = nn.Parameter(torch.zeros(hidden_size))
        self.b_o = nn.Parameter(torch.zeros(hidden_size))
        self.b_g = nn.Parameter(torch.zeros(hidden_size))

        self._init_weights()

    def _init_weights(self):
        #Weight를 xavier초기화 해주는 헬퍼함수
        std = 1.0 / np.sqrt(self.hidden_size)
        for weight in [self.W_f, self.W_i, self.W_o, self.W_g]:
            weight.data.uniform_(-std, std)

    def forward(self, x, hidden=None):
        batch_size, seq_len, input_size = x.size()

        # hidden이 None일때 0벡터로 초기화해준다.
        if hidden == None:
            h_0 = torch.zeros(batch_size, self.hidden_size)
            c_0 = torch.zeros(batch_size, self.hidden_size)
        else:
        #hidden이 존재할때는 hidden을 h_0,c_0으로 사용한다.
            h_0, c_0 = hidden

        outputs = []
        h_t, c_t = h_0, c_0

        for t in range(seq_len):
            x_t = x[:,t,:]

            #lstm_cell 함수 이용해서 step진행
            h_t, c_t = lstm_cell(x_t, h_t, c_t, self.W_f, self.W_i, self.W_g, self.W_o, self.b_f, self.b_i, self.b_g, self.b_o)
            outputs.append(h_t.unsqueeze(1))

        outputs = torch.cat(outputs, dim=1)
        return outputs, (h_t, c_t)
- LSTM의 장기기억능력 분석 및 성능개선
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

def train_and_evaluate(forget_bias, seq_len=20, vocab_size=5, hidden_size=128,
                      epochs=200, batch_size=64):

    model = LSTMClassifier(vocab_size, hidden_size, forget_bias)
    optimizer = optim.Adam(model.parameters(), lr=0.01, weight_decay=1e-5)  # 학습률 증가
    criterion = nn.CrossEntropyLoss()

    # Learning rate scheduler 추가
    scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5)

    losses = []
    accuracies = []

    for epoch in range(epochs):
        # 훈련 데이터 생성
        x_train, y_train = generate_first_token_copy_data(batch_size, seq_len, vocab_size)

        # 훈련
        model.train()
        optimizer.zero_grad()
        pred = model(x_train)
        loss = criterion(pred,y_train)
        loss.backward()

        # Gradient clipping 추가
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)

        optimizer.step()
        scheduler.step()  # 학습률 스케줄링

        losses.append(loss.item())

        # 평가 (매 5 에포크마다)
        if epoch % 5 == 0:
            model.eval()
            with torch.no_grad():
                x_test, y_test = generate_first_token_copy_data(200, seq_len, vocab_size)  # 더 많은 테스트 데이터
                test_outputs = model(x_test)
                predictions = torch.argmax(test_outputs, dim=1)
                accuracy = (predictions == y_test).float().mean().item()
                accuracies.append(accuracy)

                print(f"Forget Bias {forget_bias} - Epoch {epoch}: Loss={loss.item():.4f}, Acc={accuracy:.4f}")

    return losses, accuracies
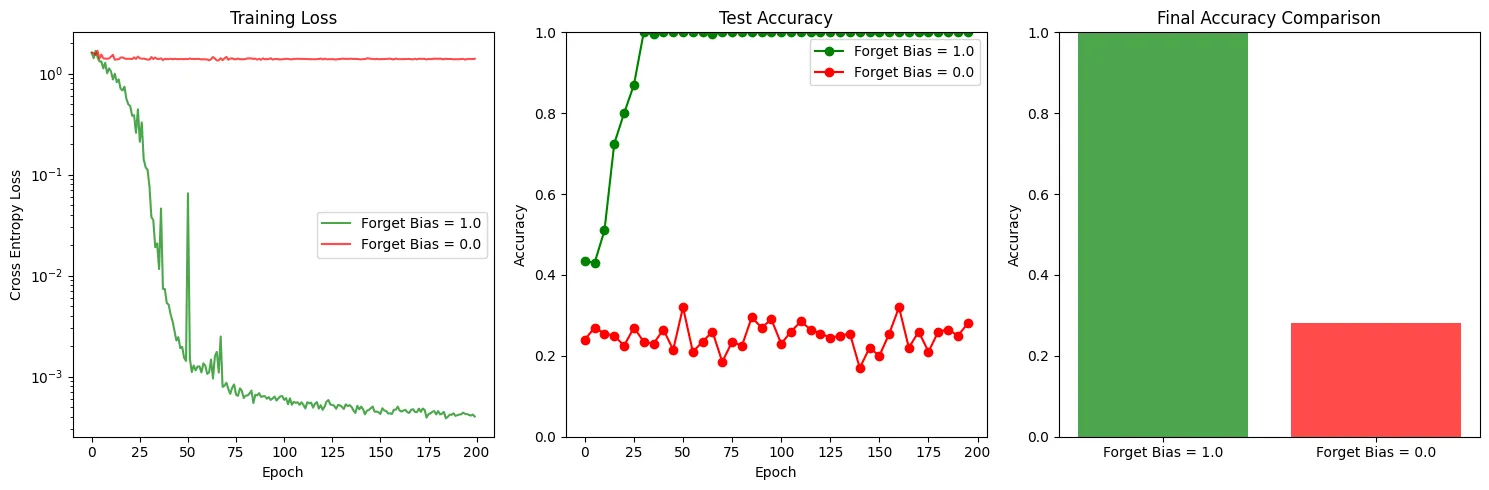
forget gate의 값이 1로 시작하면, 초기의 과거 정보를 기억하는 상태에서 학습을 시작하므로 초기의 정보를 잘 forget하지 않고, 정보소실없이, 안정적으로 학습이 일어난다. 하지만 forget_bias값이 0으로 시작하면, sigmoid 함수를 거쳤을때 0.5에 초기출력값이 가까워지고, 이는 과거 정보의 절반을 처음부터 버리고 시작하는것과 같아서, Gradient Vanishing문제가 발생한다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...