[RecSys][과제1] 기본통계학
[RecSys][과제1] 기본통계학
과제1_기본통계학
- 중심 극한 정리의 개념을 실습을 통해 이해할 수 있다.
- conjugate prior의 의미를 실습으로 체득할 수 있다.
- 확률분포를 코드로 구현하는 방법과 plot하는 방법을 배울 수 있다.
중심극한정리(CLT)
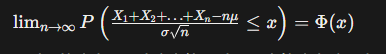
중심극한정리는 독립적인 확률 변수들의 합이나 평균이 표본의 크기가 커질수록 정규분포에 근사하는 현상이다.
\(X_n\)은 독립적이고 동일한 분포를 가진 i.i.d확률변수
\(n\):표본의 크기
\(\mu\): 확률변수의 평균
\(\sigma\): 확률변수의 표준편차
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import uniform, norm

# 균등 분포로부터 표본 추출하는 함수
def sample_uniform_distribution(n, sample_size):
    samples =  np.random.rand(n, sample_size)
    sample_means = np.mean(samples, axis=1)
    return sample_means

# 히스토그램을 통한 정규 분포 확인
def plot_normal_distribution(sample_means, n):
    plt.figure(figsize=(8, 6))
    plt.hist(sample_means, bins=20, density=True, alpha=0.6, color='g')

    # 표준 정규 분포를 평균과 표준 편차 계산하여 함께 플롯
    mu = np.mean(sample_means)
    sigma = np.std(sample_means)
    x = np.linspace(mu - 3*sigma, mu + 3*sigma, 100)
    plt.plot(x, norm.pdf(x, mu, sigma), 'r-', lw=2)

    plt.title(f'Distribution of Sample Means (n={n})')
    plt.xlabel('Sample Mean')
    plt.ylabel('Density')
    plt.legend(['Normal Distribution', 'Sample Means'])
    plt.show()

# 표본 크기와 추출 횟수 설정
sample_size = 100  # 각 표본의 크기
n = [10, 50, 1000]  # 표본 추출 횟수

for size in n:
    sample_means = sample_uniform_distribution(size, sample_size)
    plot_normal_distribution(sample_means, size)
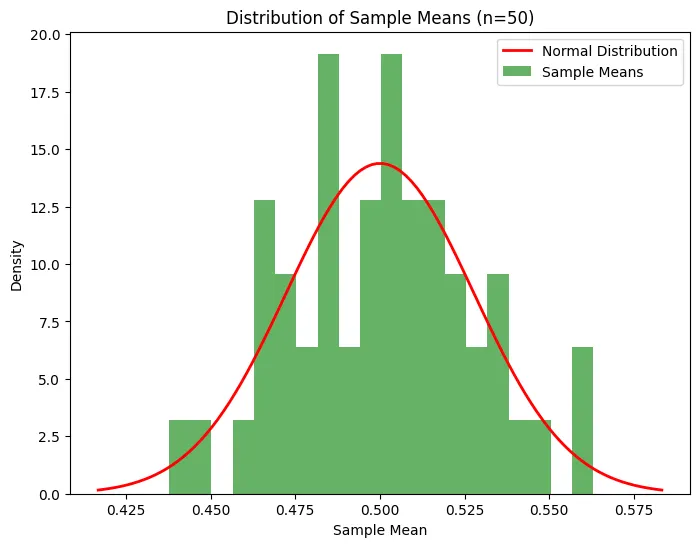
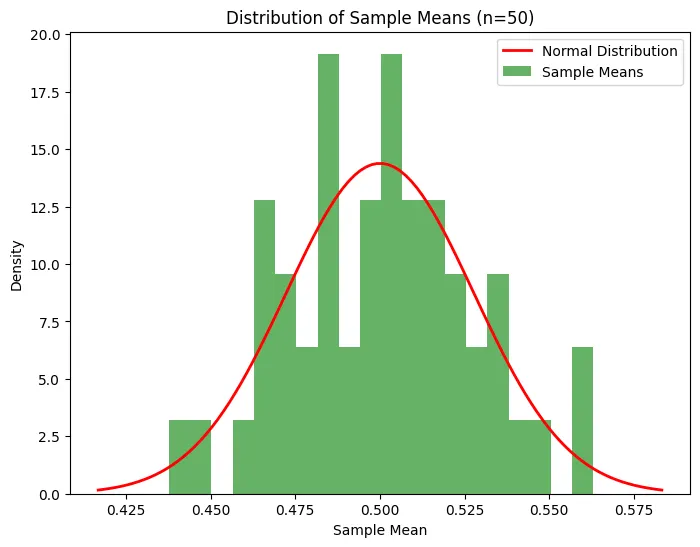
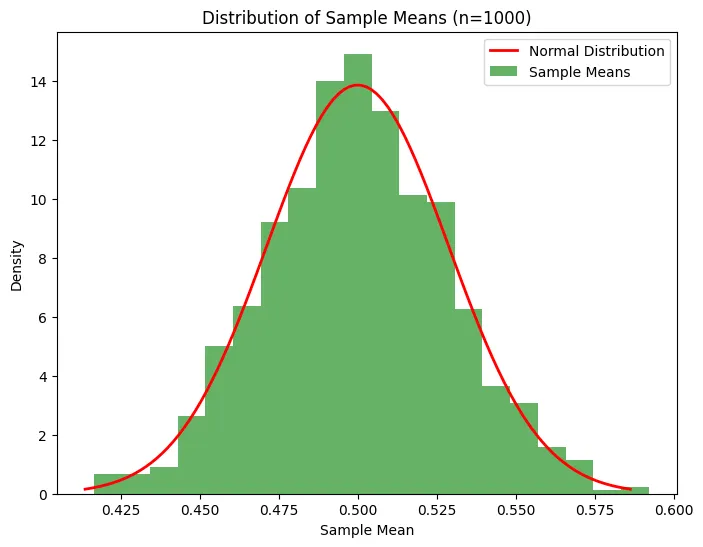
sample_size 를 100으로 고정하고 표본추출 횟수 n을 10, 50, 1000으로 늘려보면 표본 추출 횟수 \(n\)이 커질수록 표본평균은 정규분포와 가까워짐을 확인할 수 있다.
Conjugate Prior(켤레 사전 확률)
사전확률분포(Prior)와 사후 확률 분포(Posterior)가 같은 종류의 확률분포가 되도록 만들어주는 특별한 관계의 사전분포를 의미한다.
즉 베이즈정리에서 Prior와 likelihood의 곱은 Posterior와 비례관계에 있는데, prior와 likelihood의 곱이 prior의 확률분포꼴을 띠게 되는 관계이다.
이 관계에 있는 확률분포들은 복잡한 계산 없이 파라미터만 업데이트 하면 바로 Posterior를 얻을 수 있다.
왜사용할까?
원래 Posterior를 정확히 계산하려면 베이즈정리의 분모에 해당하는 복잡한 적분계산이 필요하다. 하지만 켤레 관계를 이용하면 이 과정을 생략하고, 사전 분포의 파라미터를 데이터의 정보를 이용해서 업데이트하는것 만으로도 Posterior를 얻을 수 있다.
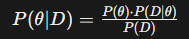
즉 분모의 \(P(D)\)를 구하려면 복잡한 적분과정을 거쳐야 하는데, 그러한 과정 없이 파라미터 업데이트만으로 Posterior를 구할 수 있음.
베르누이 - 베타분포
베르누이 분포: 이항분포에서 시행횟수가 한번의 시행에서 성공할 확률이 p인경우를 모델링
베타분포: 0과 1사이의 값을 가지는 연속 확률분포
베타분포를 prior로, 베르누이분포를 likelihood로 모델링하면 사후분포 또한 베타분포이다.
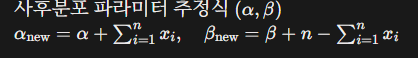
베타분포의 PDF는 $\alpha, \beta$에 의해서 결정된다.
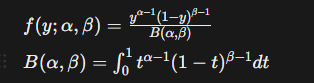
따라서 알파와 베타를 파라미터 추정식으로 업데이트 해준다.
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import beta

# 데이터 생성 (동전 던지기 시뮬레이션)
np.random.seed(42)  # 재현성을 위한 랜덤 시드 설정

data = np.random.binomial(n=1, p=0.7, size=20)  # 동전 던지기를 통한 데이터 생성 (20번 던진 경우)

# 사전분포 (베타 분포)
alpha_prior = 1  # 베타 분포의 알파 파라미터
beta_prior = 1   # 베타 분포의 베타 파라미터
prior_distribution = beta(alpha_prior, beta_prior)

# 데이터를 이용하여 사후분포 갱신
alpha_posterior = alpha_prior + np.sum(data)  # 사전분포의 알파 파라미터 갱신
beta_posterior = beta_prior + len(data) - np.sum(data)  # 사전분포의 베타 파라미터 갱신
posterior_distribution = beta(alpha_posterior, beta_posterior)

# 사전분포와 사후분포 시각화
x = np.linspace(0, 1, 1000)
plt.plot(x, prior_distribution.pdf(x), label='Prior', color='blue')
plt.plot(x, posterior_distribution.pdf(x), label='Posterior', color='red')
plt.title('Conjugate Prior: Beta Prior and Posterior for Bernoulli Distribution (Coin Flip Example)')
plt.xlabel('p (Probability of heads)')
plt.ylabel('Density')
plt.legend()
plt.show()
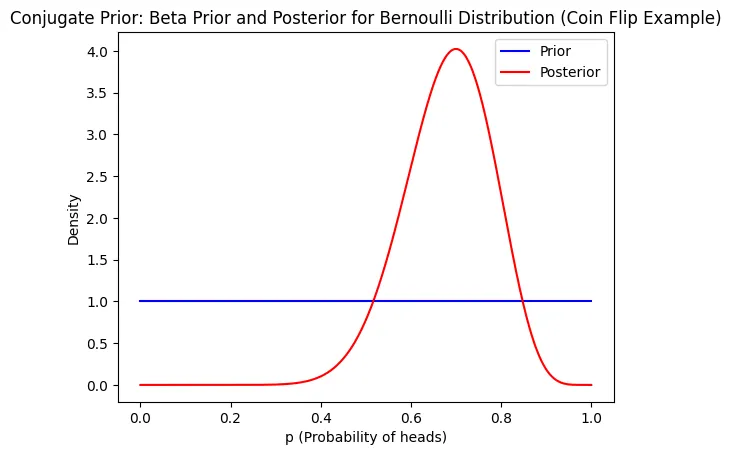
prior의 초기상태에서 Posterior를 업데이트 해서 베르누이 분포의 0.7에서의 확률이 가장 높게 파라미터가 업데이트 됐음을 알 수 있다.
포아송 분포 - 감마분포
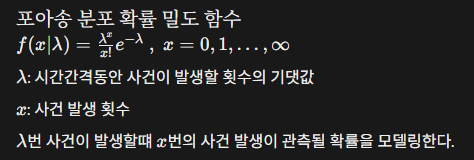
포아송분포: 주어진 시간간격동안 발생한 사건의 횟수를 모델링하는 이산 확률 분포
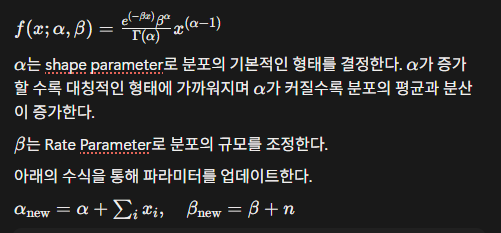
감마분포: 시간을 모델링하는 연속 확률 분포
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import gamma, poisson

# 데이터 생성 (가상의 포아송 분포 데이터)
np.random.seed(42)  # 재현성을 위한 랜덤 시드 설정
data = np.random.poisson(lam=3, size=50)  # 포아송 분포를 따르는 데이터 생성 (평균 λ=3, 데이터 수=50)

# 사전분포 (감마 분포)
alpha_prior = 2  # 감마 분포의 알파 파라미터
beta_prior = 1   # 감마 분포의 베타 파라미터
prior_distribution = gamma(alpha_prior, scale=1/beta_prior)

# 데이터를 이용하여 사후분포 갱신
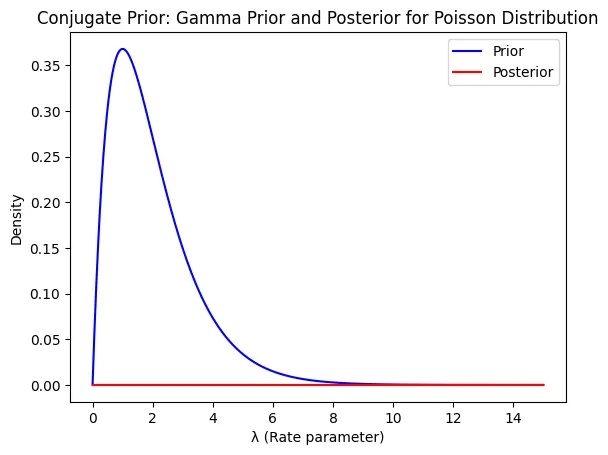
alpha_posterior = alpha_prior + np.sum(data)
beta_posterior =  beta_prior + len(data)
posterior_distribution = gamma(alpha_posterior, beta_posterior)

# 시각화
x = np.linspace(0, 15, 1000)
plt.plot(x, prior_distribution.pdf(x), label='Prior', color='blue')
plt.plot(x, posterior_distribution.pdf(x), label='Posterior', color='red')
plt.title('Conjugate Prior: Gamma Prior and Posterior for Poisson Distribution')
plt.xlabel('λ (Rate parameter)')
plt.ylabel('Density')
plt.legend()
plt.show()
정규분포 - 정규분포
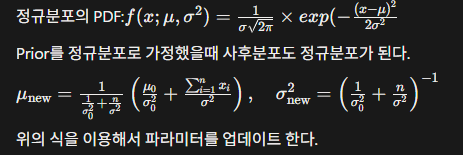
정규분포는 CLT의 성질을 활용할 수 있는 이점이 있기 때문에 모델링할때 자주 사용되는 연속확률 분포이다.
\(\mu, \sigma^2\)를 파라미터로 이용해서 모델링한다.
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm

# 데이터 생성 (가상의 정규 분포 데이터)
np.random.seed(42)
data = np.random.normal(loc=10, scale=2, size=10)  # 평균이 10이고 표준편차가 2인 정규 분포를 따르는 데이터 생성

# 사전분포 선택 (정규 분포)
mu_prior = 0  # 평균의 초기값
sigma_prior = 1  # 표준편차의 초기값
prior_distribution = norm(mu_prior, sigma_prior)
data_sigma = 2

# 데이터를 이용한 사후분포 갱신
mu_posterior = (1 / ((1 / sigma_prior**2) + (len(data) / data_sigma**2))) * ((mu_prior / sigma_prior**2) + (np.sum(data) / data_sigma**2))
sigma_posterior = np.sqrt(1 / ((1 / sigma_prior**2) + (len(data) / data_sigma**2)))
posterior_distribution = norm(mu_posterior, sigma_posterior)

# 시각화
x = np.linspace(-5, 15, 1000)
plt.plot(x, prior_distribution.pdf(x), label='Prior', color='blue')
plt.plot(x, posterior_distribution.pdf(x), label='Posterior', color='red')
plt.title('Conjugate Prior: Normal Prior and Posterior for Normal Distribution')
plt.xlabel('μ (Mean)')
plt.ylabel('Density')
plt.legend()
plt.show()
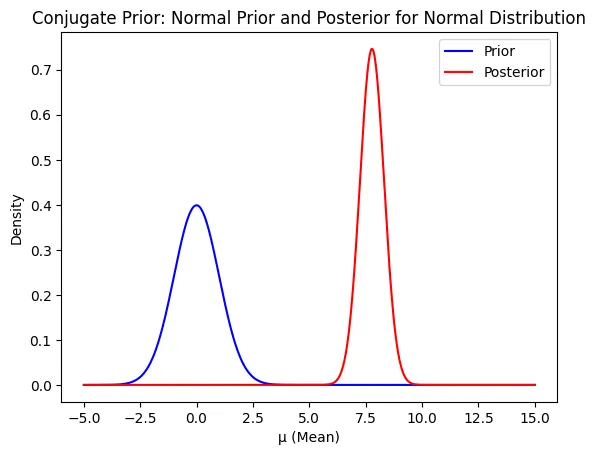
prior와 posterior 둘다 모두 정규분포임을 볼 수 있다.
분포간의 근사관계
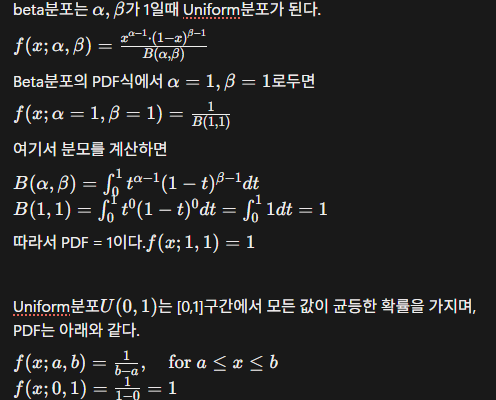
베타분포 - UniForm분포
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import beta, uniform

# Beta 분포의 모수 설정
alpha_prior = 1
beta_prior = 1

alpha_prior2 = 0.5
beta_prior2 = 0.5

alpha_prior3 = 2
beta_prior3 = 3

# Uniform 분포의 범위 설정
x = np.linspace(0, 1, 1000)

# Beta 분포와 Uniform 분포의 확률 밀도 함수 계산
beta_pdf = beta(alpha_prior, beta_prior).pdf(x)
beta_pdf2 = beta(alpha_prior2, beta_prior2).pdf(x)
beta_pdf3 = beta(alpha_prior3, beta_prior3).pdf(x)
uniform_pdf = uniform.pdf(x)

# 시각화
plt.plot(x, beta_pdf, label='Beta Distribution (α=1, β=1)')
plt.plot(x, beta_pdf2, label='Beta Distribution (α=0.5, β=0.5)')
plt.plot(x, beta_pdf3, label='Beta Distribution (α=2, β=3)')
plt.plot(x, uniform_pdf, label='Uniform Distribution', linestyle='--', color='red')
plt.title('Comparison of Beta and Uniform Distributions')
plt.xlabel('x')
plt.ylabel('Probability Density')
plt.legend()
plt.show()
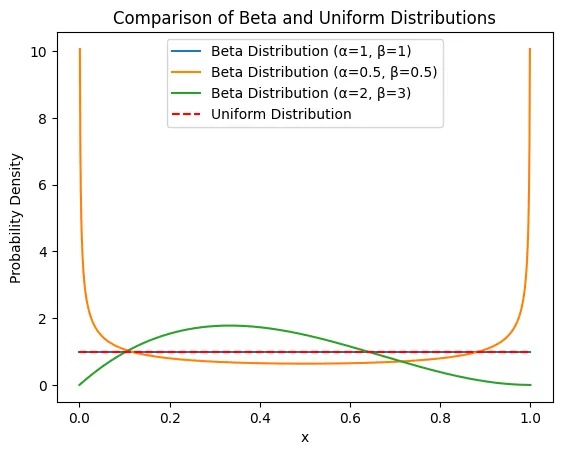
\(\alpha = 1, \beta = 1\)에서 파란색과 빨간색 그래프가 일치함을 확인할 수 있다.
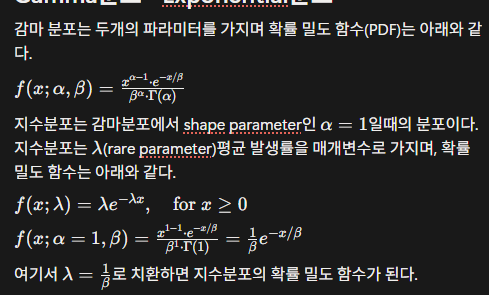
Gamma분포 - Exponential분포
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import gamma, expon

# Gamma 분포의 모수 설정
alpha1 = 1
beta1 = 1

alpha2 = 2
beta2 = 3

# Exponential 분포의 모수 설정
lambda_ = 1

# 범위 설정
x = np.linspace(0, 5, 1000)

# Gamma 분포와 Exponential 분포의 확률 밀도 함수 계산
gamma_pdf1 = gamma.pdf(x, alpha1, scale=1/beta1)
gamma_pdf2 = gamma.pdf(x, alpha2, scale=1/beta2)
exponential_pdf = expon.pdf(x, scale=1/lambda_)

# 시각화
plt.plot(x, gamma_pdf1, label='Gamma Distribution (α=1, β=1)')
plt.plot(x, gamma_pdf2, label='Gamma Distribution (α=2, β=3)')
plt.plot(x, exponential_pdf, label='Exponential Distribution', linestyle='--', color='red')
plt.title('Comparison of Gamma and Exponential Distributions')
plt.xlabel('x')
plt.ylabel('Probability Density')
plt.legend()
plt.show()
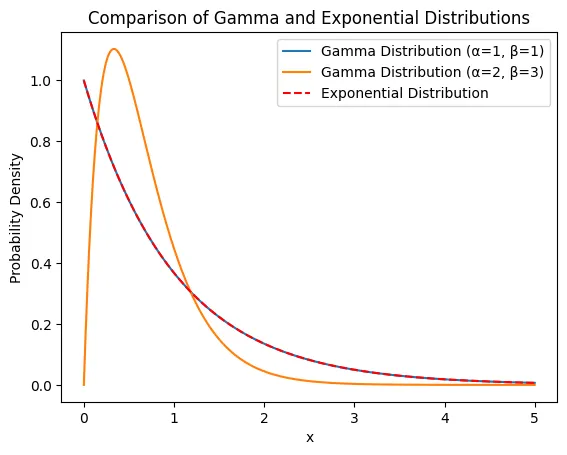
감마분포에서 \(\alpha=1\)로 주었을때 지수분포와 같음을 확인할 수 있다..
Binomial분포 - Normal분포
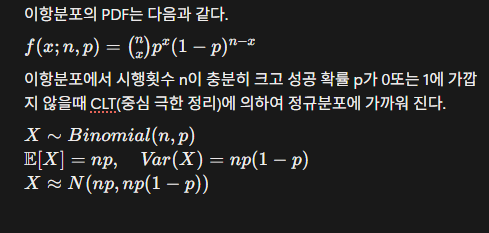
\(X \sim \text{Binomial}(n, p)\) \(E[X]=np, {Var}(X)=np(1-p)\) \(X \approx N(np,np(1-p))\)
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import binom, norm

# 이항 분포의 모수 설정
n = 20  # 시행 횟수
p = 0.5  # 성공 확률

# 정규 분포의 모수 설정 (이항 분포의 기댓값과 분산을 사용)
mean = n*p
variance = mean*(1-p)
std_dev =  np.sqrt(variance)

# 범위 설정
x = np.arange(0, 20)

# 이항 분포의 확률 질량 함수 계산
binomial_pmf = binom.pmf(x, n, p)

# 정규 분포의 확률 밀도 함수 계산
normal_pdf = norm.pdf(x, mean, std_dev)

# 시각화
plt.plot(x, binomial_pmf, label='Binomial Distribution (n=20, p=0.5)', color='blue')
plt.plot(x, normal_pdf, label='Normal Distribution', linestyle='--', color='red')
plt.title('Comparison of Binomial and Normal Distributions')
plt.xlabel('x')
plt.ylabel('Probability Density')
plt.legend()
plt.show()
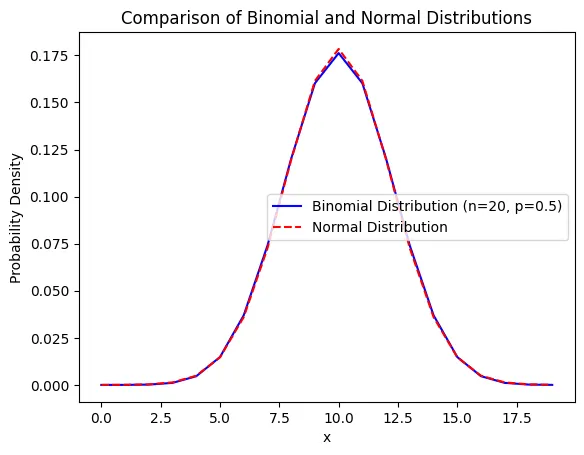 \(n=20\)이고 \(p=0.5\)인 이항분포는 정규분포를 따름을 확인할 수 있다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...