[Domain_Common_Project][과제3]Pretrained 모델파인튜닝
[Domain_Common_Project][과제3] Pretrained 모델파인튜닝
과제3_Pretrained 모델파인튜닝
Transformer 라이브러리를 활용하여 BERT 기반 모델을 IMDB 감성 분석 데이터셋에 대해 영화 리뷰 문장이 긍정인지 부정인지 분류하는 모델을 파인튜닝하는 과제이다.
- Hugging Face Datasets 및 Transformers 라이브러리의 활용법 이해
- 사전 학습된 Transformer 모델을 활용한 텍스트 분류 파인튜닝 실습
- 모델 평가를 위한 정확도, 정밀도, 재현율, F1-score 계산 능력
- 새로운 문장에 대한 모델 예측 시연
- BERT, Tokenizer 로드하기
- IMDB 텍스트 데이터셋 로드하고, 전처리하기
- PyTorch 기반 학습 및 평가 데이터로 변환하기
- AutoModelSequenceClassification 모델을 이용해서 Fine-Tuning하기.
- 훈련 손실 및 평가Metric을 기반으로 성능 측 정하기
- 새로운 문장 입력에 대한 감성 예측 시연하기
BERT,Tokenizer, 데이터셋 로드
raw_datasets = datasets.load_dataset("imdb")

#사전 학습모델선택, 토크나이저 로드
model_name = "bert-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(model_name)

#토크나이징, 전처리
def tokenize_function(examples):
    return tokenizer(
        examples["text"], truncation=True, padding="max_length", max_length=512)

#모든 샘플에 토크나이징 함수를 mapping하기
tokenized_datasets = raw_datasets.map(tokenize_function, batched=True)

#데이터셋 전처리 및 준비
tokenized_datasets = tokenized_datasets.remove_columns(["text"])
tokenized_datasets.set_format("torch")

# 최종 학습 및 검증 데이터셋 준비
train_dataset = tokenized_datasets["train"]
eval_dataset = tokenized_datasets["test"]
- Hugging Face datasets라이브러리를 사용해서 “imdb”데이터셋을 로드한다. 이 데이터셋은 ‘train’과 ‘test’로 나뉘어 있다.
- “bert-base-uncased”모델을 선택한다. 이 모델은 대소문자를 구분하지 않는 BERT의 기본 모델이다. 그리고 모델에서 AutoTokenizer를 불러와서
tokenizer로 인스턴스를 만들어준다. - 모든 텍스트 데이터를 BERT모델의 입력형식에 맞게 토크나이징 한다.
truncation:모델의 최대 입력길이를 초과하는 텍스트는 잘라내기padding: 배치 내에서 가장 긴 시퀀스 길이에 맞춰 패딩토큰 추가max_length: 최대 시퀀스 길이 지정
- 토크나이징된 데이터셋에서 “text”컬럼을 없애고, “label”컬럼을 “torch”로 format을 변경한다. → 파이토치 기반으로 학습 및 평가데이터로 변환한다.
- train 과 eval로 학습, 검증 데이터셋으로 분할한다.
평가 Metric 정하기, Fine-tuning
# 3. 모델 로드
model = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=2)

import numpy as np
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score

# 4. 평가 지표 정의
def compute_metrics(eval_pred):
    # 평가 예측 결과를 사용하여 정확도, 정밀도, 재현율, F1 점수를 계산합니다.
    predictions, labels = eval_pred
    # 가장 logit이 높은값만 1로  preds에 저장한다.
    preds = np.argmax(predictions, axis = 1)
    accuracy = accuracy_score(labels, preds)
    precision = precision_score(labels, preds)
    recall = recall_score(labels, preds)
    f1 = f1_score(labels, preds)
    return {
        "accuracy": accuracy,
        "precision": precision,
        "recall": recall,
        "f1": f1,
    }

# 5. 학습 설정
# TrainingArguments를 사용하여 학습 설정을 정의합니다.
# TrainingArguments는 모델 학습에 필요한 다양한 하이퍼파라미터를 설정합니다.
# 여러 변수를 필요에 따라 조정해보세요.
# 예:
# 학습 결과(모델 체크포인트 등), 로그를 저장할 디렉토리
# 모델을 평가나 저장할 방식
# 학습률 설정 (파라미터 업데이트 크기)
# 디바이스(GPU/CPU) 당 학습 배치 크기
# 디바이스 당 평가 배치 크기
# 전체 학습 데이터를 몇 번 반복할지 (에폭 수)
# 과적합 방지를 위한 가중치 감쇠 계수
# 로그를 기록할 스텝 간격
training_args = TrainingArguments(output_dir = "./results",
                                  num_train_epochs = 2, # 총 훈련 에폭 수
                                  per_device_train_batch_size = 16, #device당 훈련 배치 크기
                                  per_device_eval_batch_size = 64, #device당 평가 배치 크기
                                  learning_rate = 5e-5,
                                  weight_decay = 0.01,

                                  # evaluation_strategy = "epoch", #epoch마다 평가
                                  # save_strategy = "epoch", #epoch마다 모델저장
                                  logging_dir = "./logs",
                                  logging_steps = 100, #100스탭마다 기록
                                  # load_best_model_at_end = True #훈련 종료시 가장 성능이 좋았던 모델을 로드
                                  )

# 6. Trainer 정의 및 학습
# Trainer를 사용하여 모델을 학습하고 평가합니다.
# Trainer는 모델, 학습 인자, 데이터셋 등을 포함하여 학습 및 평가를 관리합니다.
# training_args 사용하여 학습 설정을 정의합니다.
# 앞서 정의한 compute_metrics 함수를 사용하여 평가 지표를 계산합니다.
trainer = Trainer(model = model,
                  args = training_args,
                  train_dataset = train_dataset,
                  eval_dataset = eval_dataset,
                  compute_metrics = compute_metrics)

trainer.train()
trainer.evaluate()
이부분에서 device가 cpu로 설정되어있는줄 모르고 학습을 돌렸다가, 리소스가 초과돼서 자꾸 튕기는 문제가 있었다. colab에서 학습을 돌릴떄는 호스팅된 런타임이 GPU인지 CPU인지 항상 확인하는 습관을 가져야 겠다.
compute_metrics() 함수를 통해 eval_pred 를 받아와서 평가지표를 dict로 반환한다. sklearn.metrics 에 acc, precision, recall, f1을 계산할 수 있는 함수가 있어서, 라이브러리를 import해서 함수안에 labels와 preds를 넣어서 계산해주었다. 이때 preds는 MultiClassification Task임을 고려해서 Logit이 있는 Predictions에서 가장 logit이 높은값만 1로 저장해주었다.
그 다음은 training_args에서의 학습 설정이다. 여기서는 config 처럼 trainer에 넘겨줄 학습 설정을 정의한다.
num_train_epochs: 총 훈련 에폭 수per_device_train_batch_size: device당 훈련 배치 크기per_device_eval_batch_size: device당 평가 배치 크기learning_rate: 러닝레이트(학습률)weight_decay: Loss function에 정규화를 적용하는 비율logging_dir:로그를 저장할 디렉토리logging_steps: 해당 스탭마다 로그를 기록
그 다음은 Trainer를 이용해서 모델을 학습하고 평가한다. 여기서는 사용할 모델, 학습인자, 데이터셋을 포함해서 학습 및 평가를 관리한다.
model: 어떤 모델을 사용할건지 사전에 정의한 인스턴스를 넘겨준다.args: 바로 위에서 정의한 training_args를 넘겨준다.train_dataset,eval_dataset:train과 검증 데이터셋을 넘겨준다.compute_metrics:위에서 정의한 함수를 넘겨줘서 acc,recall, precision, f1을 측정한다.
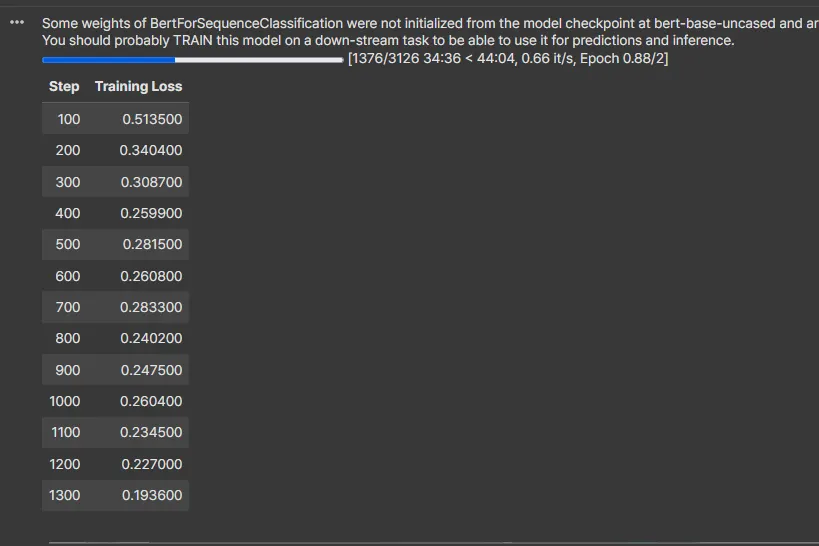
처음에 epoch을 5로 뒀는데 총 학습시간이 3시간이 나와서 epoch을 2로 줄였다.. 확실히 데이터셋이 2만개가 넘어가니깐 epoch한번 도는데 시간이 상당히 많이 소요됨을 알 수 있다. 이런 학습을 CPU로 돌릴려고 했으니 당연히 리소스가 넘쳐서 튕길만도 하다.
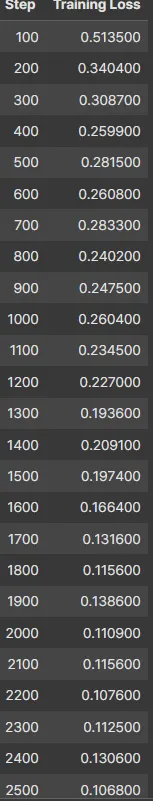
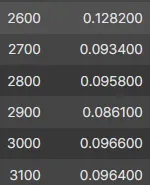

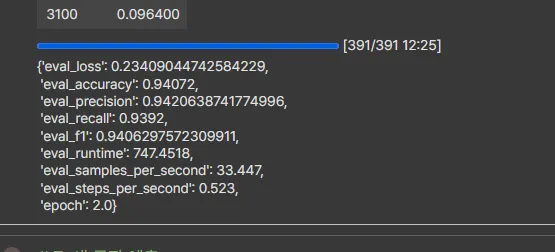
1시간 23분+12분에 거쳐서 2에폭 학습을 완료시켰다.
학습결과 94퍼센트의 정확도, 93퍼센트의 recall, 94퍼센트의 f1등 예쁘게 점수가 나온것을 확인할 수 있다.
새로운 문장에서의 Inference
# 7. 새 문장 예측
model.eval()  # 모델을 평가 모드로 설정
new_sentences = [
    "This movie was absolutely fantastic! I highly recommend it.",
    "What a terrible film. I wasted my time watching it.",
    "The plot was a bit confusing, but the acting was superb.",
    "I loved every single moment of this incredible story.",
]

inputs = tokenizer(
    new_sentences, return_tensors="pt", padding=True, truncation=True, max_length=512
)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
with torch.no_grad():
    outputs = model(**inputs)
    probs = torch.softmax(outputs.logits, dim=-1)

for i, sentence in enumerate(new_sentences):
    pred = torch.argmax(probs[i]).item()
    label = "긍정 (Positive)" if pred == 1 else "부정 (Negative)"
    print(f"\n문장: '{sentence}'")
    print(f"예측: {label} (부정 확률: {probs[i][0]:.4f}, 긍정 확률: {probs[i][1]:.4f})")

with torch.no_grad():
    outputs = model(**inputs)
    print(outputs.logits)
새로운 문장들인 new_sentences 를 학습할때와 마찬가지로 토크나이저로 토큰화를 한 후 모델을 돌린다.
logit값인 probs를 argmax 에 넣어서 pred값을 얻는다. 따라서 pred가 1이면 긍정으로 예측하고 pred가 0이면 부정으로 예측한다.
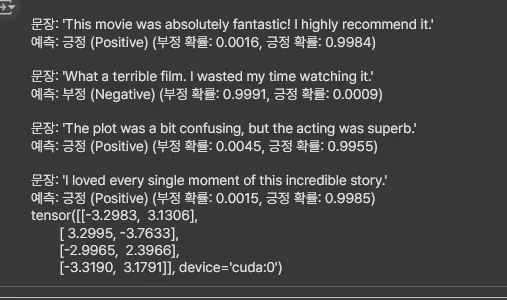
새로운 문장에대해서 Inference를 해보면 긍정적인 문장과 부정적인 문장은 거의 99%의 확신을 가지고 예측해냄을 볼 수 있다. 뭔가 대견하고 기특하다.
Living point
- 모델과 토크나이저를 라이브러리에서 간단하게 가져와서 학습시킬 수 있었다. 이 파이프라인은 기억해두자..
- 실제로 경진대회를 할때는 데이터를
df.head()로 찍어보고 컬럼중 필요한 컬럼만 남기고, 데이터를 분리해야한다. - colab에서 Train시킬떄는 항상 런타임이 GPU에 연결되어있는지 확인하기.
- 평가 metrics를 계산하는 함수는
sklearn.metrics에 다 구현되어있으니까 가져다 쓰기만 하면됨 - MultiClassification task의 logit은 여러개의 클래스에 대한 예측값이 담겨있는 텐서이므로,
argmax()함수에 넣으면 가장 높은 확률의 클래스만 1로 남기고 나머지는 0으로 남기는 sparse vector의 형태가 된다. - transformers라이브러리에서 TrainingArguments, Trainer는 기억해두고 계속 두고두고 확인해야겠다. 이 함수들의 인자로 넘겨주는 값들은 내가 조정할 수 있다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...