[논문 리뷰]_[RecSys]_Zero-Shot Recommendation as Language Modeling
[RecSys][논문리뷰]Zero-Shot Recommendation as Language Modeling
Abstract
현재의 추천 시스템은 주로 Collaborative Filtering이나 Content-based 기술, 혹은 이 둘의 하이브리드 방식에 의존한다.
- 협업 필터링 (CF): (USER, ITEM, INTERACTION) 튜플 형태의 데이터를 기반으로 한다.
- 콘텐츠 기반 (CB): (ITEM, FEATURES) 쌍의 데이터를 기반으로 한다.
이 두 가지 표준 방식은 모두 정형화된 데이터structured data를 필요로 하며, 이 데이터를 수집하는 과정은 비용이 많이 든다(costly).
Zero-shot recommendation
이 논문은 위와 같은 정형화된 학습 데이터 대신 오직 비정형 텍스트 코퍼스(unstructured text corpora)로만 학습된 Pre-trained LanguageModel(LM)을 활용하는 Zero-shot추천모델을 제안했다.
즉, (사용자, 아이템, 평점)과 같은 데이터를 전혀 사용하지 않고, GPT-2와 같이 단순히 웹 텍스트로 학습된 모델을 사용해 추천을 수행한다.
Introduction
웹 사용자들은 이미 포럼이나 리뷰 등에서 “Films like Beyond the Black Rainbow, Lost River…”와 같이 아이템에 대한 자신의 선호를 비정형 텍스트로 표현하고 있다. GPT-2와 같은 언어 모델은 이러한 방대한 웹 코퍼스를 학습한다. 이를 이용해서 추천을 효율적으로 수행할 수 있다.
LM은 기본적으로 다음 단어 예측을 통해 학습되며, 논문에서 언급된 손실 함수는 다음과 같다.
\[{L}_{LM}=-log\Sigma_{i}P(w_{i}\mid w_{i-k}...w_{i-1};\Theta)\]이 손실 함수는 LM이 이전 단어가 주어졌을 때 다음 단어를 예측하도록 학습하는, 표준적인 언어 모델링의 목적 함수이다. 이 과정을 통해 LM은 “어떤 텍스트 시퀀스가 자연스러운가” 혹은 “그럴듯한가”를 학습하게 된다.
이 논문은 LM이 학습한 이 ‘그럴듯함’(plausibility) 측정 능력을 추천에 직접 적용한다. Reddit같은 웹 코퍼스에는 이미 “A, B와 비슷한 영화 C” 처럼 유사한 아이템을 함께 언급하는 비정형 텍스트가 풍부하므로, LM이 학습한 ‘텍스트의 그럴듯함’은 아이템 간의 유사성을 내포하고 있다는 것이 핵심 가정이다.
[방법론]:
- 사용자 \(u\)가 좋아한 아이템 목록(\(<m_1>...<m_n>\))을 기반으로 텍스트 프롬프트 \(p_u, i\)를 구성한다. .
(여기서 \(<m_i>\)는 추천 후보 아이템이다.)
- LM이 이 프롬프트 시퀀스 전체가 하나의 자연스러운 문장으로서 등장할 확률인\(P_{\Theta}(p_{u,i})\)을 계산한다.
- 이 확률값을 사용자와 아이템 i 간의 관련성 점수(relevance score) \(\tilde{R}_{u,i}\)로 직접 사용한다. 이 점수는 얼마나 item이 user와 연관있는지를 나타내는 score이다.
이 점수가 높은 순서대로 아이템을 정렬하여 사용자 u에게 추천한다.
중간정리
- 표준 LM을 이용한 추천 모델(프롬프트 기반)을 제안한다.
- 코퍼스 분석(레딧같은 웹사이트)을 통해 다양한 프롬프트 구조를 도출하고 그 영향을 비교한다.
- 제안된 LM 기반 추천을 NSP(Next Sentence Prediction) 방식과 비교한다.
Related Work
Language models and recommendations
이전에도 언어 모델링을 추천에 활용하려는 시도는 있었다. 하지만 이들 연구는 자연어를 사용하지 않았다. 대신, 사용자의 아이템 상호작용 시퀀스\((u,i)\)를 마치 ’문장’처럼 취급했다. 그런 다음 Word2Vec이나 BERT 같은 NLP를 이 시퀀스 데이터에 적용하여 아이템 임베딩을 학습했다. 이 논문은 LM 아키텍처만 빌려 쓰는 것이 아니라, LM이 학습한 ‘자연어’ 지식 자체를 프롬프트를 통해 직접 활용한다.
zero-shot prediction with language models
LM은 BERT같은 모델을 사용해서 번역(Translate english to french: “cheese” =>)이나 지식 탐색(Paris in
정형화된 데이터 없이 추천을 시도한 유일한 연구는 Penha 등의 연구이다. 이들은 BERT의 NSP(Next Sentence Prediction) 태스크를 사용했다. (예: 프롬프트 문장과 후보 아이템 문장 간의 이어질 확률을 계산)
- NSP는 BERT 등 특정 모델에서만 사용 가능하며, 모든 LM이 지원하는 기능이 아니다.
- Penha 등의 연구는 BERT의 지식을 탐색하는 수준이었으며, 표준 추천 모델(예: Matrix Factorization)과의 성능 비교가 부족했다. 이 논문은 Penha 연구의 한계였던 표준 추천 모델(MF)과의 비교를 수행한다.
Experiments
- 데이터셋: MovieLens 1M 데이터셋을 사용했다. (6040 사용자, 3090 영화)
- 데이터정의: 별점이 4점이상이면 긍정적, 2.5이하이면 부정적인 영화로 분류
- \(r \ge 4.0\) (긍정적), \(r \le 2.5\)부정적).
- 평가 방식: 테스트 사용자별로 긍정적 영화 1개와 부정적 영화 4개를 숨겨두고, 모델이 이 5개 중 긍정적 영화 1개를 1위로 랭크하는지 확인한다.
- 평가 지표: MAP@1 (Mean Average Precision at rank 1). (모델이 1위로 예측한 항목이 정답일 확률의 평균)
- 사용 모델: GPT-2 base (117M 파라미터)를 기본으로 사용한다.
프롬프트 구조 탐색
레딧 데이터를 분석해서 가장 많이 등장하는 패턴을 기반으로 프롬프트를 만들었다.
- 분석 결과,
, , (쉼표 나열)이나 Movies like 같은 패턴이 자주 발견되었다.
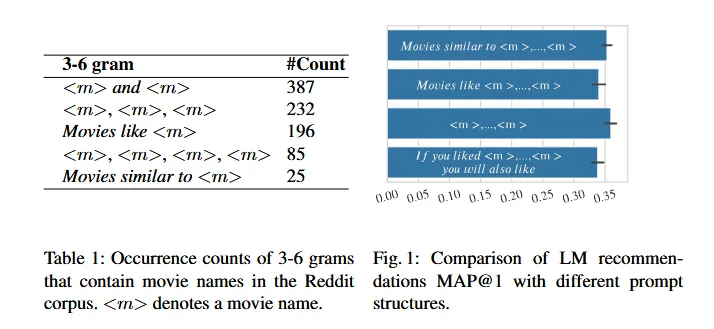
- Reddit 코퍼스에서 도출된 자연스러운 프롬프트들(예: Movies like
…, … )이12 번 연구에서 사용된 인위적인 프롬프트(If you liked…)보다 **월등히 높은 성능**을 보였다. - 가장 성능이 좋았던 상위 3개 프롬프트 간의 성능 차이는 크지 않았다.
가장 단순하면서도 성능이 우수한 **
… , ** (영화 제목만 쉼표로 나열) 구조를 나머지 실험의 기본 프롬프트로 채택했다.
입력 영화 수(n)의 영향
프롬프트에 포함되는 사용자 긍정 영화의 개수(n)가 추천 정확도에 미치는 영향을 분석했다.
결과를 보면 무작정 입력 영화수를 늘린다고 성능(MAP)가 향상됨이 아님을 알 수 있다.
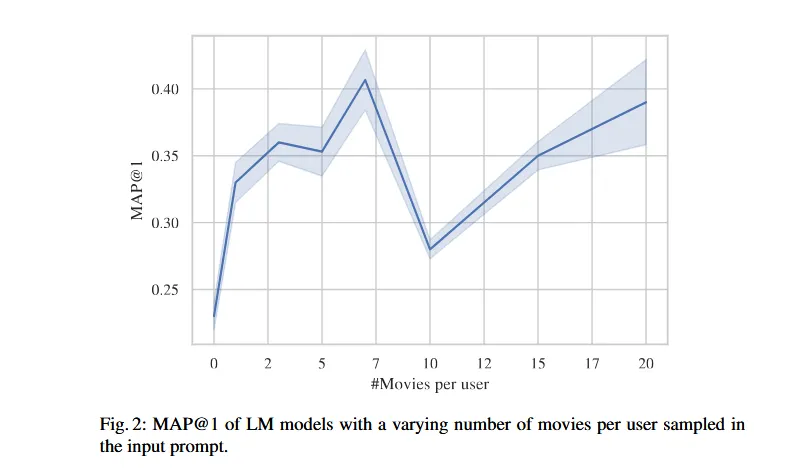
- 입력 영화 수를 늘릴수록 성능이 증가하다가, n=5 근처 또는 n = 7 근방에서 성능이 가장 좋았다.
- n = 5 이후로는 성능 향상이 둔화되고 불안정성이 증가했다.
- 재미있는점은 n = 0일 때, 즉 프롬프트가 비어있을 때조차도 성능이 무작위(chance level)보다 높게 나타났다. 이는 LM이 프롬프트가 없어도 아이템(영화 제목) 자체의 ‘인기도’(popularity) 정보를 포착하고 있음을 시사한다.
베이스라인 모델과의 성능 비교
제안하는 제로샷 LM 방식을 두 가지 주요 베이스라인과 비교했다.
- BPR (Bayesian Personalised Ranking): (USER, ITEM) 데이터로 학습하는 표준적인 매트릭스 인수분해(MF) **지도학습 모델 즉 기존에 사용하던 모델이다.
- BERT-NSP: Penha 등이 제안한 제로샷 방식 (BERT-base, BERT-large 사용).
- 제안 모델: GPT-2-base (117M), GPT-2-medium (345M) (학습 사용자 0명, 즉 완전 제로샷).
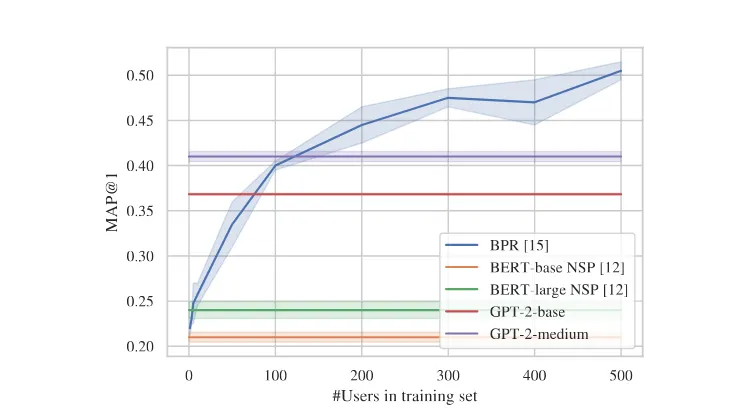
- vs. NSP: 제안하는 GPT-2(LM likelihood) 방식이 BERT-NSP 방식보다 성능이 월등히 높았다. (저자들은 NSP가 단순 일관성만 보는 차별적(discriminative) 작업인 반면, LM은 실제 텍스트 확률을 모델링하는 생성적(generative) 작업이기 때문으로 추측한다.)
- vs. BPR (Cold-Start): 이것이 가장 중요한 발견이다. BPR 학습 사용자가 매우 적은 콜드 스타트 영역 (GPT-2-base는 50명 미만, GPT-2-medium은 100명 미만)에서는, 정형화된 데이터로 학습한 **BPR보다 제로샷 LM의 성능이 더 높았다. LM 기반 제로샷 추천은 데이터가 극히 부족한 콜드 스타트 상황에서 성능이 상대적으로 잘나오는것을 확인할 수 있다.
Qualitative Analysis
LM을 ‘점수 계산’(scoring)이 아닌 ‘텍스트 생성’(generation)에 사용했을 때의 결과를 관찰했다.
- 프롬프트 (P1): Forrest Gump, Blade Runner, Modern Times, Amelie, Lord of the Rings The Return of the King, Shaun of the Dead, Alexander, Pan’s Labyrinth, Cashback, Avatar:
- 생성 (C1): 3, The Hunger Games: Mockingjay Part 2, King Arthur, A Feast for Crows, The Hunger Games: Catching Fire, Jackass, Jackass 2, King Arthur
- (P1)의 경우, LM이 유효한 영화 제목들을 이어서 생성했다.
- 프롬프트 (P2): Independence Day, Winnie the Pooh and the Blustery Day, Raiders of the Lost Ark, Star Wars Episode VI - Return of the Jedi, Quiet Man, Game, Labyrinth, Return to Oz, Song of the South, Matrix:
- 생성 (C2): and many more. The list can beread by clicking on the relevant section at the left of the image. To access the list of releases
- (P2)의 경우, 영화 제목이 아닌 일반적인 웹 텍스트를 생성했다.
LM의 생성 기능을 추천에 활용하려면, 생성된 텍스트가 실제 아이템 이름과 일치하는지 검증하는 후처리(post-processing) 과정이 필요하다.
결론 (Conclusion)
연구 요약
표준 언어 모델(LM)은 별도의 정형화된 학습 데이터 없이도 제로샷 아이템 추천을 수행할 수 있다.
주요 발견
이 제로샷 방식은 학습 사용자가 매우 적은(100명 미만) 콜드 스타트 환경에서 지도학습 기반의 매트릭스 인수분해(MF) 모델과 경쟁력 있는 성능을 보인다. 돈없으면 LM기반 zero-shot모델 쓰자.
시사점
결론적으로, LM은 아이템이 웹 텍스트에서 자주 논의되는 경우, 추천 시스템을 킥스타트 kickstart하는 데 유용하게 사용될 수 있다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...