우리 아이가 달라졌어요: 텍스트에 워터마크를 어떻게 넣을까
뤼튼에서 인턴으로 일하던 올해 여름, 같은 IAB중 PM들이 사용할 PRD Generator Agent를 만드는 동료 인턴이 있었다. 8월쯤 PM분들이 에이전트 성능이 이상하다는 이야기를 들었다. 심지어 클로드가 이상한말을 해서 직접 타자를 쳐서 PRD를 작성까지한다고 들었다..!(AI없이, 26년 8월에..?) Clau
이 글은 DEVOCEAN에도 게재되었습니다. DEVOCEAN에서 읽기
우리 아이가 달라졌어요: PRD 에이전트가 이상한말을 해요.
뤼튼에서 인턴으로 일하던 올해 여름, 같은 IAB중 PM들이 사용할 PRD Generator Agent를 만드는 동료 인턴이 있었다. 8월쯤 PM분들이 에이전트 성능이 이상하다는 이야기를 들었다. 심지어 클로드가 이상한말을 해서 직접 타자를 쳐서 PRD를 작성까지한다고 들었다..!(AI없이, 26년 8월에..?) Claude Fable API 출력에 텍스트 워터마크가 들어가기 시작한 뒤 단어 선택이 눈에 띄게 어색해졌고, PM들이 결국 Agent에서 Fable 대신 gemini나, GPT계열 모델들을 쓰게 됐다는 내용이었다.
아니 근데 어떻게 text에 워터마크를 넣나? 궁금했다. 이미지는 픽셀값을 미세하게 변형하거나 메타데이터에 워터마크를 박는게 쉬울텐데..
먼저 PM들이 작성하는 PRD는 누가 읽어도 요구사항을 같은 뜻으로 이해해야 하는 문서다. 문장은 얼핏 그럴듯한데 단어가 어색하면, 읽는 사람이 의도를 다시 해석해야 한다. 문서 작성을 도와주는 Agent가 오히려 문장을 고치는 일을 늘린다면 사용하는 입장에서는 모델을 바꿀 이유가 충분하다.
텍스트에 흔적을 남긴다는 건
최근 내가 자주보는 유튜버인 임커밋님의 「텍스트 워터마크..? 어떻게?」도 참고했다. 다음 단어를 고르는 과정에 어떻게 흔적을 남길 수 있는지 이해하는 데 도움이 됐다.
처음 동료가 알려준 텍스트에 워터마크 넣는 방식은 Red-Green논문을 읽어보라고 해서 그 논문부터 시작했다. 특정단어의 확률을 높이는걸로, 워터마크를 넣는다면, 일단 결정론적이지가 않고 확률로만 그게 AI작성글인지 아닌지를 알 수 있을테다. 그리고 토큰수가 많아질수록(표본이 커질수록) 신뢰도가 높아질거다.
“바나나, 원숭이” 라는 문장을 가지고는 당연히 ai작성인지 아닌지 판단을 못할테다.
먼저 LLM이 다음 토큰을 고르는 방식
LLM은 문장을 한 번에 완성하지 않는다. 지금까지 쓴 내용을 보고, 다음에 올 토큰의 확률을 계산한 뒤 하나를 고른다. 토큰은 모델이 텍스트를 다루는 단위로, 단어 하나일 수도 있고 단어의 일부일 수도 있다. 여기서는 단어 하나처럼 생각하면 된다.
예를 들어 ‘변경 이력은 _’ 다음에 올 후보가 이렇게 나왔다고 해보자.
| 다음 표현 | 선택될 확률 |
|---|---|
| 보관한다 | 60% |
| 저장한다 | 30% |
| 기록한다 | 10% |
이렇게 후보별로 선택될 가능성을 나열한 것이 확률분포다. 이 분포에서 하나를 뽑는 과정을 샘플링이라고 한다. ‘보관한다’가 가장 자주 나오겠지만, ‘저장한다’나 ‘기록한다’도 나올 수 있다.
텍스트 워터마크는 이 선택 과정에 개입한다. 자연스럽게 이어질 표현이 여러 개라면, 비밀 규칙에 맞는 후보가 조금 더 자주 나오도록 선택 방식을 바꾸는 것이다. 한 번의 선택만 보면 티가 나지 않는다. 하지만 이런 선택이 글 전체에 쌓이면, 나중에 같은 규칙으로 그 흔적을 찾아볼 수 있다.
이 비밀 규칙을 만드는 데 쓰는 값이 ‘키’다. 생성기는 앞선 문맥과 키로 이번 위치에서 어떤 후보를 선호할지 정한다. 검출기는 완성된 글을 읽으며 같은 문맥과 키로 그 규칙을 다시 만든다. 그래서 글에 별도 표시를 붙이지 않아도, 선택된 토큰들을 통해 흔적을 확인할 수 있다.
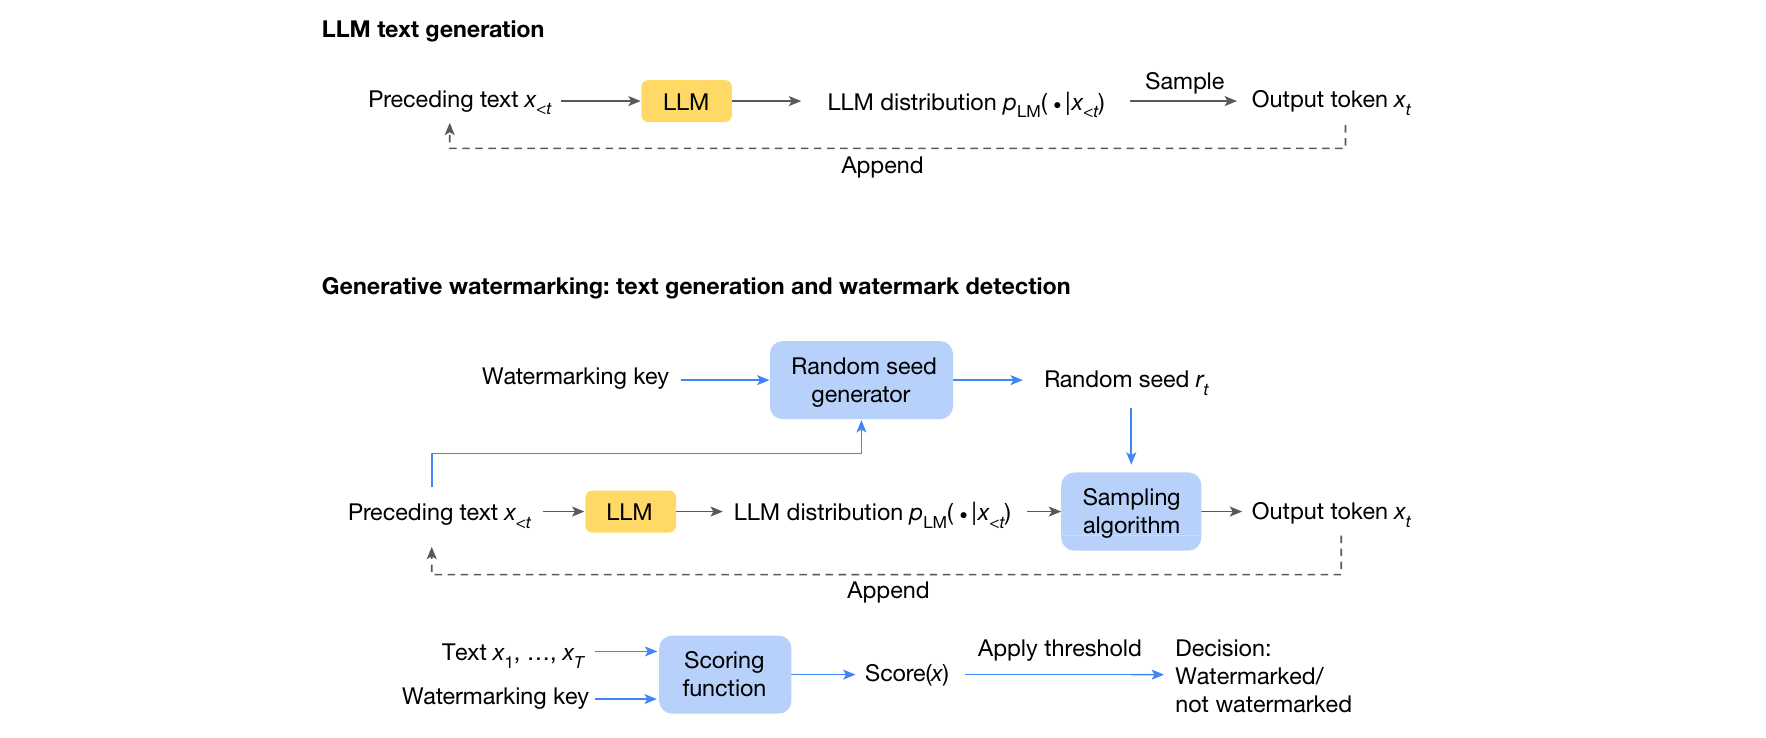
그림 1. SynthID-Text 논문의 Fig. 1을 캡처했다. 생성할 때 샘플링에 키가 개입하고, 검출할 때 텍스트와 키를 사용한다. 출처: Dathathri et al., 2024.
KGW: 특정 후보가 조금 더 자주 나오게 만들기
동료가 알려준 Red–Green 방식부터 보면 원리가 가장 직관적이다. KGW는 다음 토큰을 고를 때 후보들을 Green과 Red라는 두 그룹으로 나누고, Green에 속한 후보가 뽑힐 확률을 조금 높인다. KGW 논문
Green은 좋은 단어, Red는 나쁜 단어라는 뜻이 아니다. 문맥과 키로 정한 임의의 구분이라, 같은 단어도 앞선 문맥이 바뀌면 다른 그룹에 들어갈 수 있다.
아까 예시에서 ‘저장한다’가 Green에 들어갔다고 해보자. 그러면 ‘저장한다’의 선택 확률을 원래의 30%보다 높이고, 전체 확률의 합이 100%가 되도록 나머지 후보의 확률도 조정한다. ‘저장한다’를 무조건 출력하게 만드는 게 아니라, 이전보다 자주 뽑히게 만드는 것이다.
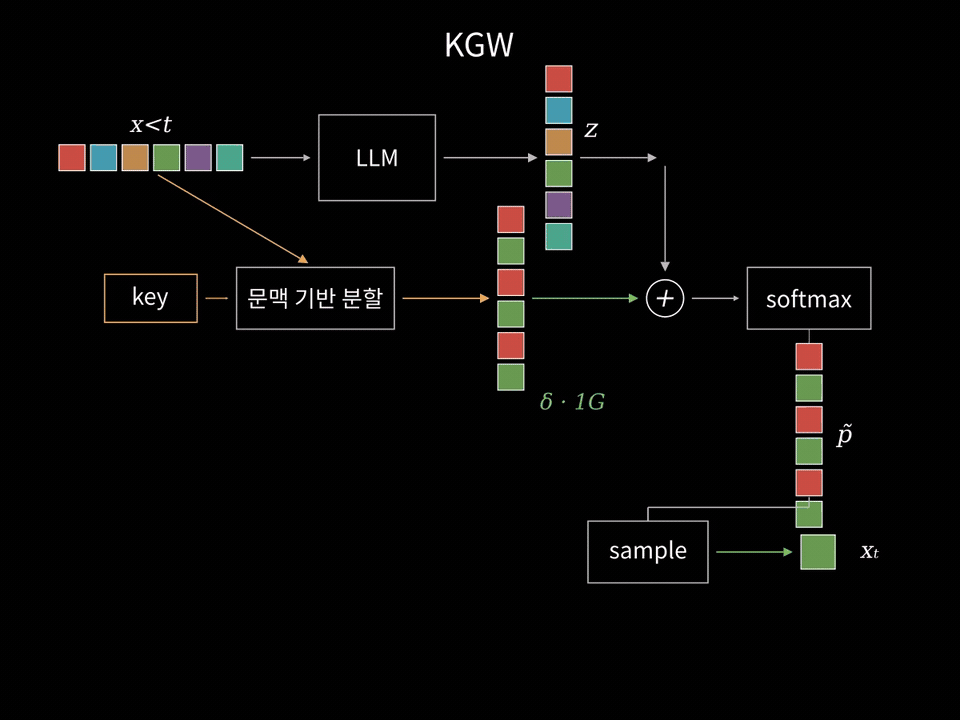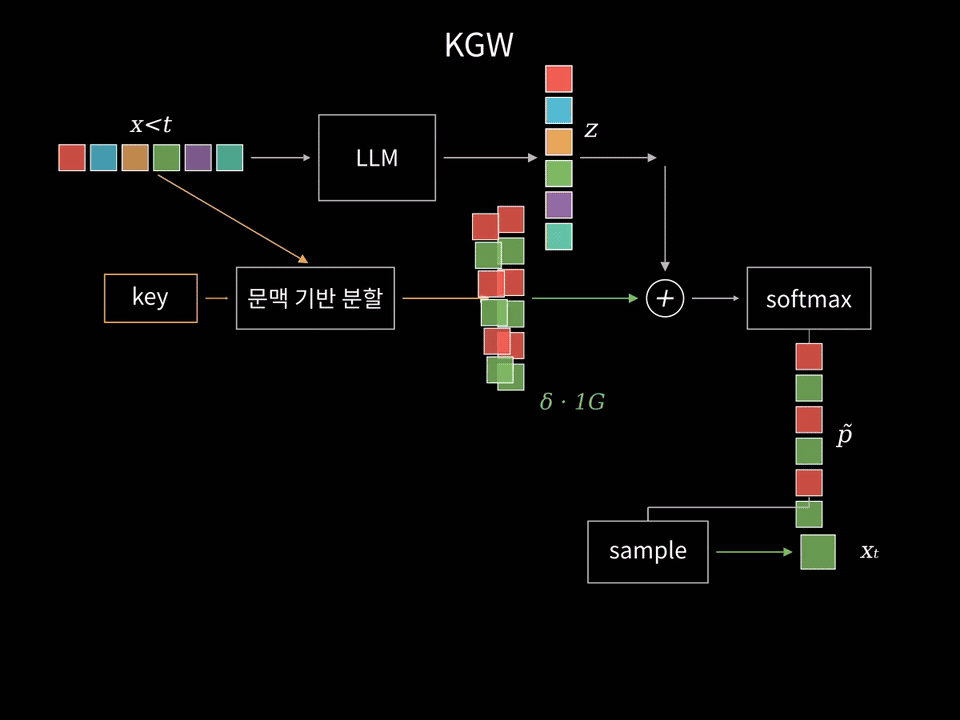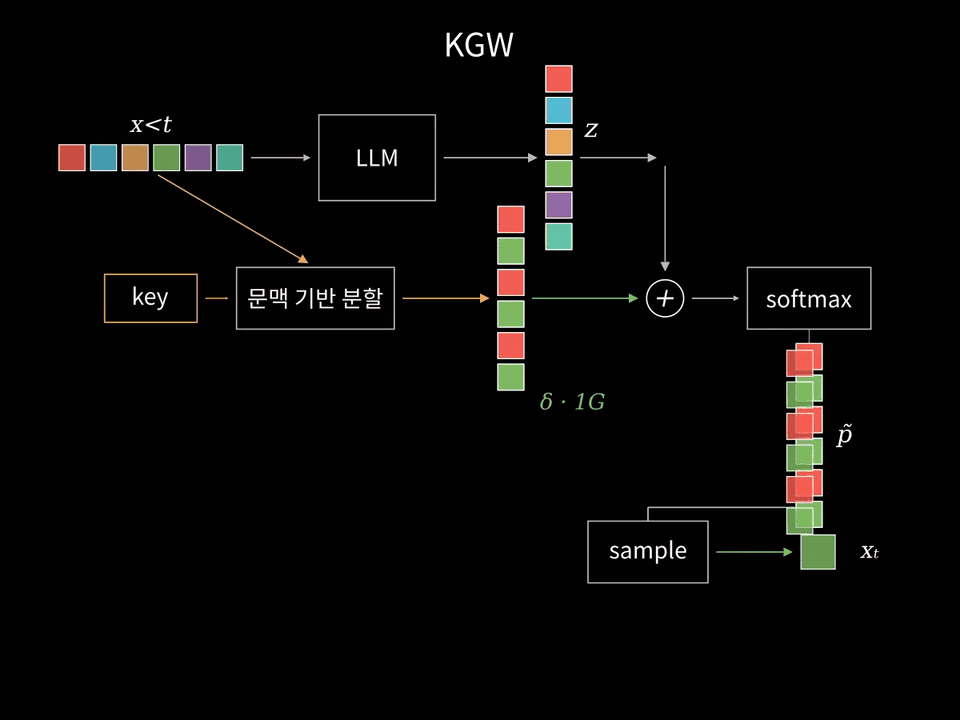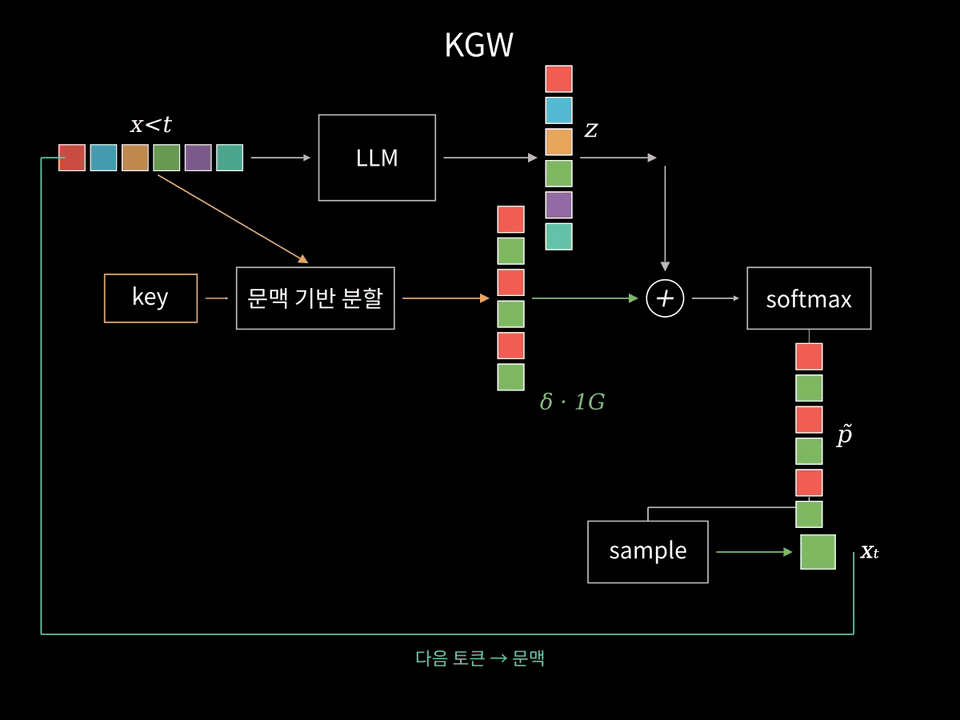
위 애니메이션은 후보를 나누고, Green 후보에 보너스를 준 뒤, 다음 토큰을 뽑는 흐름을 보여준다. 이 과정을 토큰 하나를 생성할 때마다 반복한다.
나중에는 그 흔적을 센다
검출할 때는 글의 각 위치에서 Green 그룹을 다시 만들고, 실제로 선택된 토큰이 Green이었는지 센다.
예를 들어 우연이라면 100개 중 약 50개가 Green일 상황에서, 실제 글에서는 70개가 Green이었다고 해보자. 검출기는 이 차이를 보고 ‘우연히 나왔다고 보기에는 Green이 꽤 많네?’라고 판단한다. 생성할 때 Green을 더 자주 선택하도록 했던 흔적이 남은 것이다.
여기서 비결정론적이라는 말이 연결된다. 표시가 있으면 바로 확정하는 방식이 아니라, 이런 선택이 우연히 나왔을 가능성을 따져보는 방식이다. 글이 길수록 비교할 토큰이 많아져, 그 경향을 더 잘 볼 수 있다.
SynthID-Text: 후보끼리 토너먼트를 시키기
KGW가 후보의 확률에 직접 보너스를 준다면, SynthID-Text는 먼저 모델의 원래 확률분포에서 후보를 뽑는다. 그리고 문맥과 키로 만든 점수를 이용해 후보끼리 겨루게 한다. SynthID-Text 논문
예를 들어 후보 네 개를 뽑았다고 해보자. 두 개씩 겨뤄 둘을 남기고, 남은 둘이 다시 겨뤄 최종 토큰 하나를 고른다. 모델이 원래 선호하던 토큰은 처음 후보를 뽑을 때 더 자주 등장하고, 대결에서는 키로 정한 점수가 선택에 개입한다.
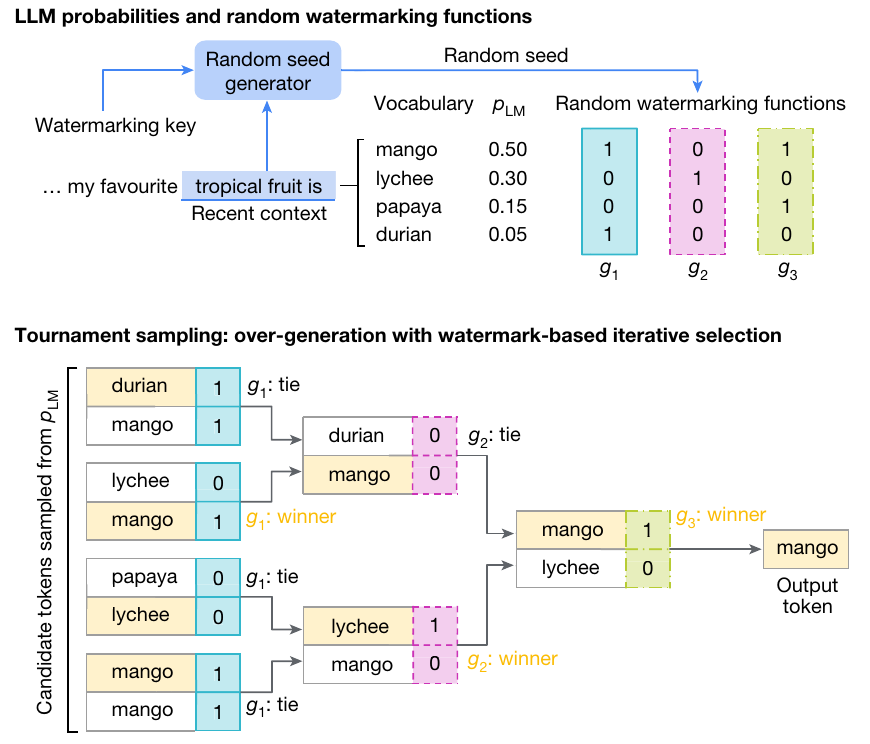
그림 2. SynthID-Text 논문의 Fig. 2. 위는 문맥·키로 만드는 점수, 아래는 후보 토큰의 토너먼트다. 출처: Dathathri et al., 2024.
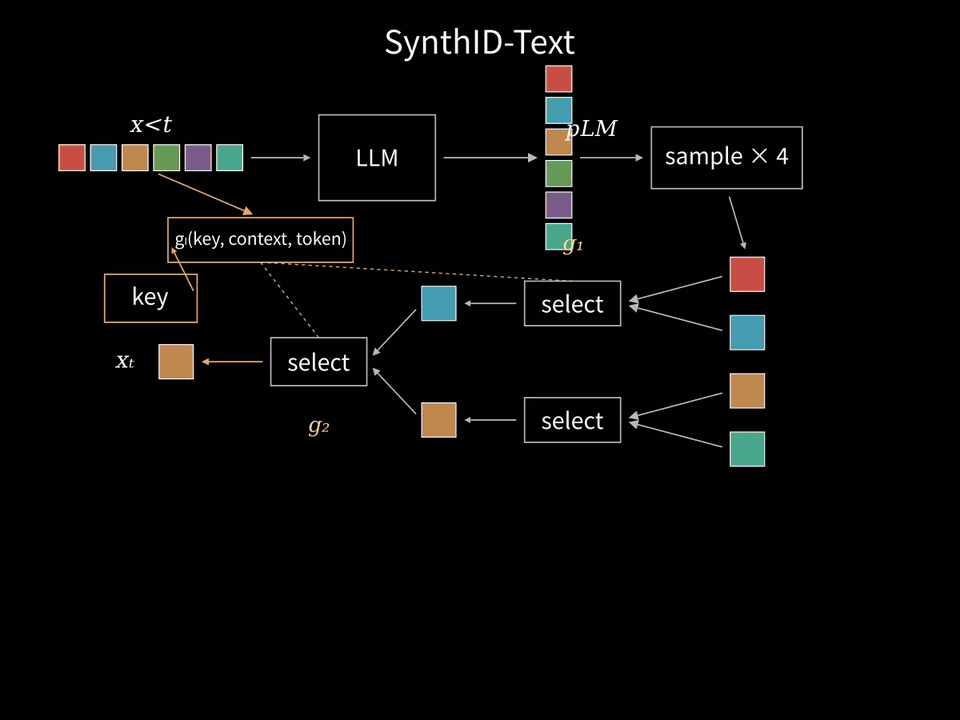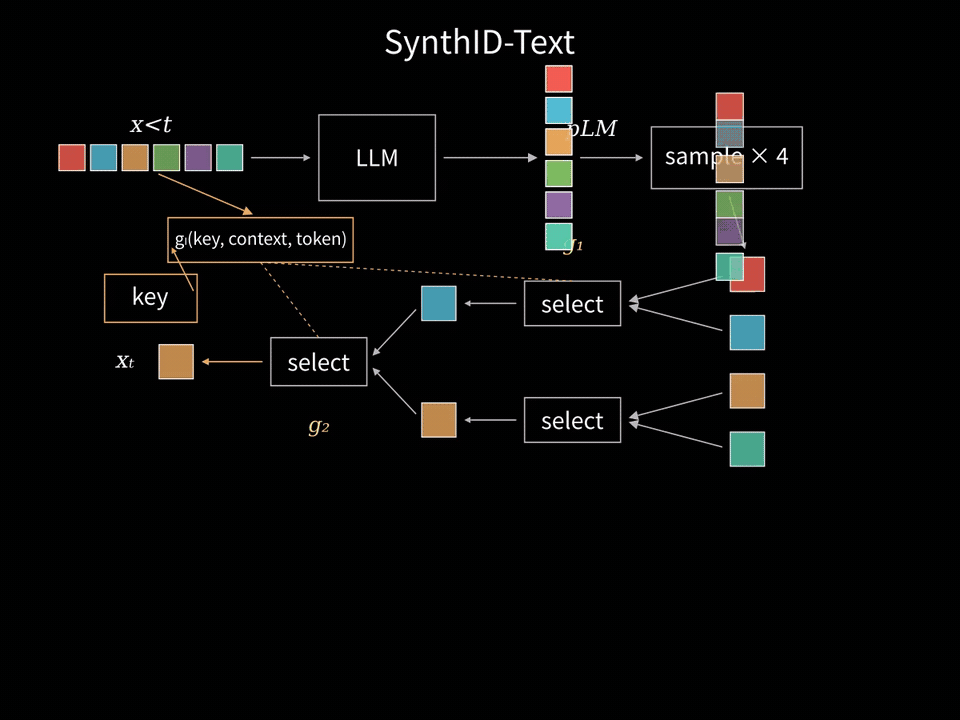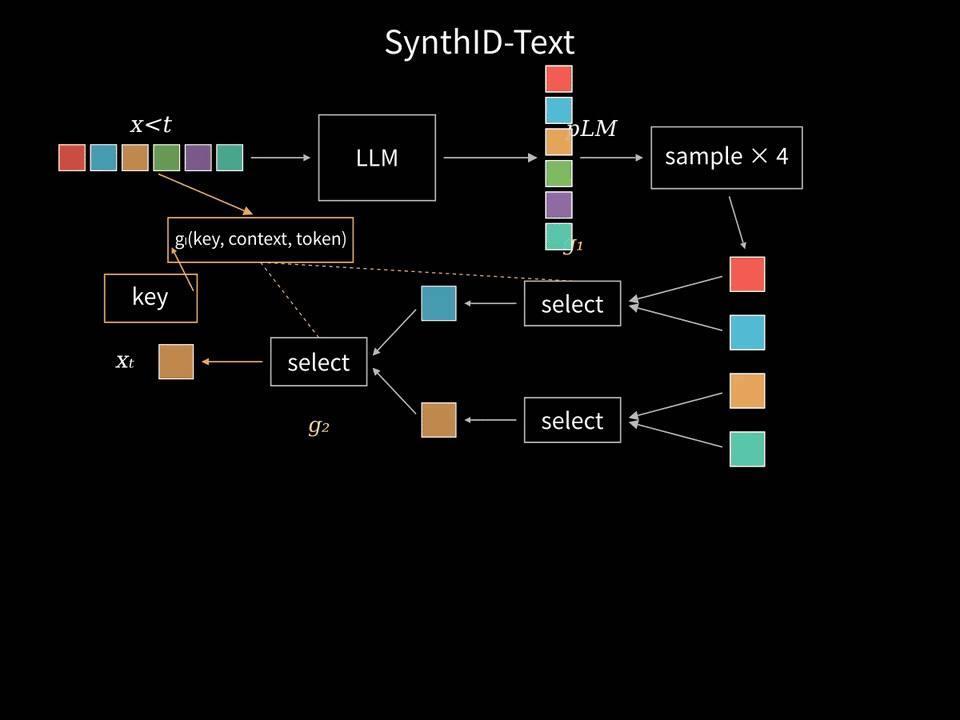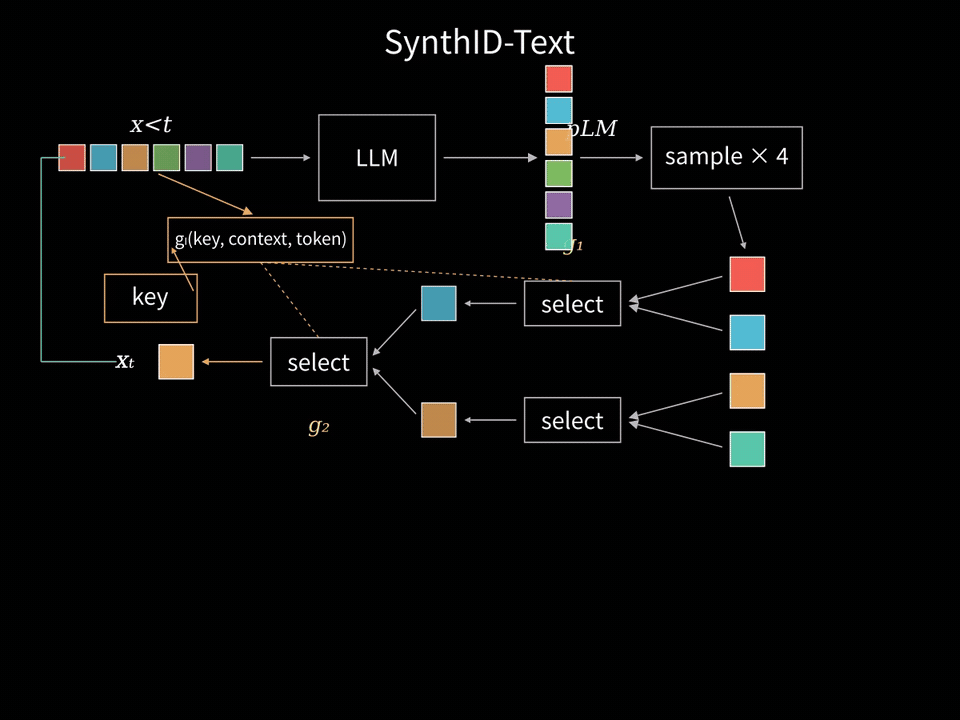
이 점수는 문장을 얼마나 잘 쓰는지 평가한 점수가 아니다. 워터마크를 남기기 위해 키로 정한 점수다. 점수가 높은 후보가 대결에서 더 자주 살아남으면, 완성된 글에도 그 점수의 흔적이 쌓인다. 검출기는 같은 규칙으로 선택된 토큰의 점수를 다시 계산해 그 경향을 확인한다.
KGW와의 차이는 선택에 개입하는 위치다. KGW는 뽑기 전에 후보의 확률을 바꾸고, SynthID-Text는 뽑아 놓은 후보들 중에서 승자를 고른다.
textGrain: 후보를 묶어서 고르기
textGrain은 후보 토큰들을 여러 묶음으로 나눈다. 그리고 문맥과 키를 이용해 어떤 묶음에서 고를지를 조절한다. 묶음을 고른 뒤에는 그 안에서 토큰 하나를 뽑는다. textGrain 기술보고서
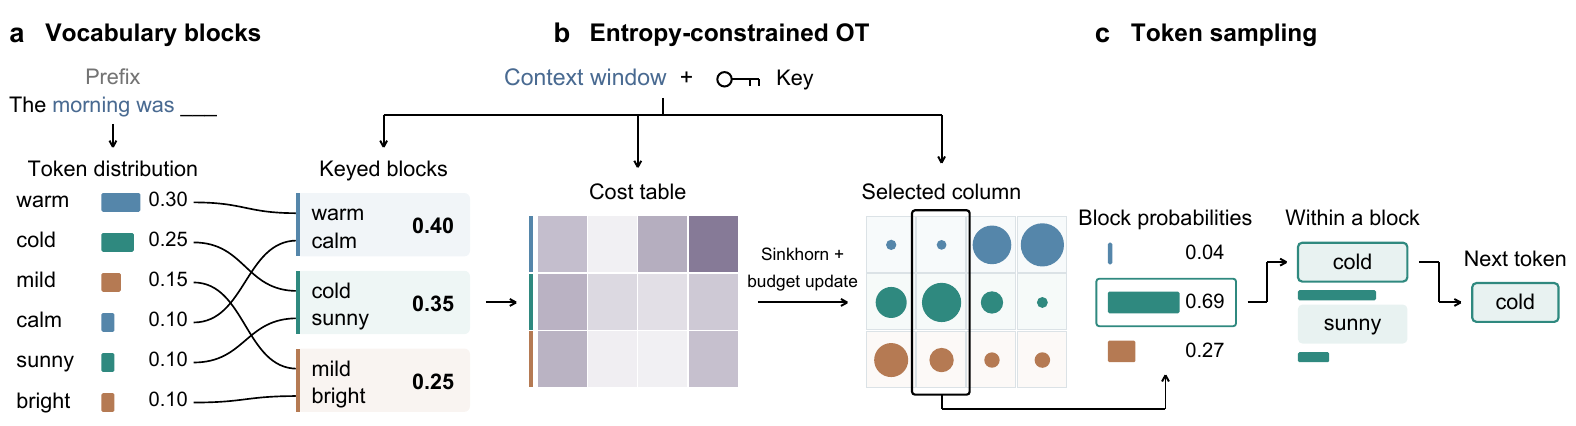
그림 3. textGrain 보고서의 Fig. 1. 토큰을 키 기반 블록으로 묶고, 엔트로피 예산 아래에서 블록의 조건부 분포를 구성한 뒤 토큰을 뽑는다. 출처: OpenAI 기술보고서, 2026.
예를 들어 ‘보관한다’와 ‘기록한다’가 한 묶음에 들어갔다면, 그 묶음 안에서는 모델이 원래 선호하던 비율을 유지한다. 앞의 예시에서는 둘의 확률이 60%와 10%였으니, 묶음 안에서도 ‘보관한다’가 여섯 배 자주 뽑히는 식이다. 키는 어떤 묶음을 고를지에 개입하고, 묶음 안의 선택에는 원래의 상대적인 선호를 사용하는 것이다.
여기에 워터마크가 선택을 지나치게 좌우하지 않도록 제한을 둔다. 쉽게 말하면, 흔적은 남기되 다음 표현을 고를 자유가 얼마나 줄어드는지도 관리하는 방식이다. 후보가 다양하게 뽑힐 수 있던 상황에서 키 때문에 선택이 한쪽으로 너무 몰리지 않도록 조절한다.
검출기는 출력된 토큰이 어느 묶음에 속했는지와 키로 만든 점수를 다시 확인한다. 키와 연결된 선택이 글 전체에서 얼마나 자주 나타났는지를 보는 것이다.
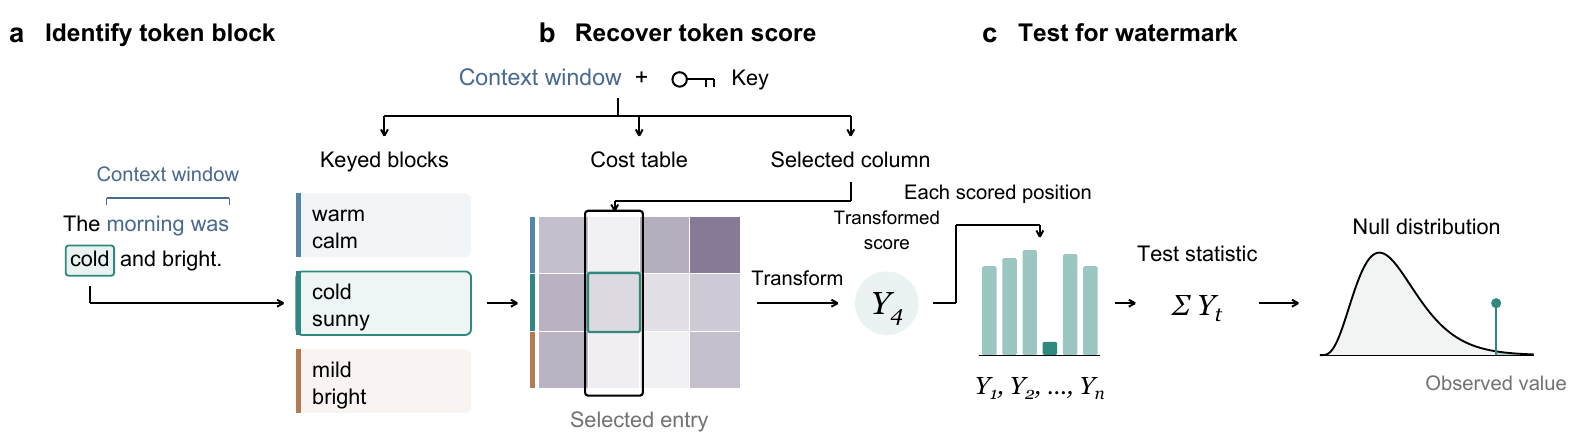
그림 4. textGrain 보고서의 Fig. 2. 관측한 토큰의 블록과 키 기반 점수를 복원해 검정 통계량을 만든다. 출처: OpenAI 기술보고서, 2026.
세 방식의 핵심은 같은 곳에 있다
| 방식 | 흔적을 남기는 방법 | 나중에 확인하는 것 |
|---|---|---|
| KGW | Green 후보가 뽑힐 확률을 높인다 | Green 후보가 얼마나 많이 나왔는지 |
| SynthID-Text | 뽑은 후보들을 키 점수로 겨루게 한다 | 선택된 토큰의 점수가 얼마나 높은지 |
| textGrain | 키에 따라 후보 묶음의 선택을 조절한다 | 선택된 묶음과 키 점수가 얼마나 연결되는지 |
세 방식 모두 다음 토큰을 고르는 과정에 키를 끼워 넣는다. 같은 문맥과 키에서 특정 후보를 선호하도록 선택을 조절하고, 그 흔적을 완성된 글에서 찾는다. SynthID-Text와 textGrain은 여러 키의 경우를 평균냈을 때 원래의 토큰 확률을 유지하도록 설계하면서도, 개별 선택에는 키의 흔적을 남긴다.
내가 처음 궁금했던 ‘텍스트에 워터마크를 어떻게 넣지?’의 답은 여기에 있었다. 토큰을 고르는 확률에 개입해서 글 전체에 통계적인 흔적을 남긴다. KGW처럼 확률분포를 직접 비틀 수도 있고, 후보끼리 겨루게 하거나 묶음을 고르는 과정에서 선택을 바꿀 수도 있다.
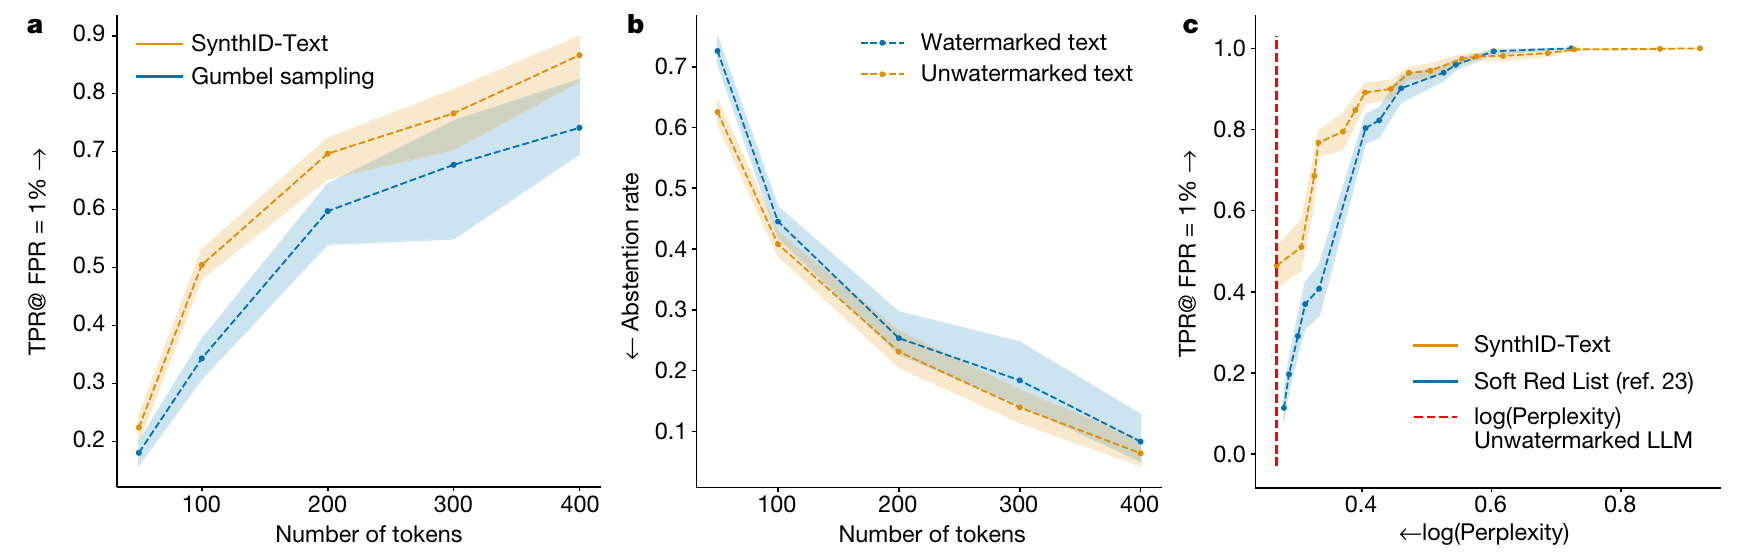
그림 5. SynthID-Text 논문의 Fig. 3. 왼쪽은 길이에 따른 검출률, 가운데는 선택적 검출의 보류 비율, 오른쪽은 분포를 바꾸는 설정의 검출률·log perplexity 관계다. 출처: Dathathri et al., 2024.
다시 PRD Generator Agent로
처음에는 텍스트 안에 표시를 어떻게 숨기는지가 궁금했다. 결과만 보자면 다음 표현을 고르는 과정에 통계적인 워터마크를 남기는 것이었다.
예를 들어 ‘사용자는 결제 전에 총액을 확인할 수 있어야 한다’에서 ‘있어야 한다’를 ‘있을 수 있다’로 바꾸면, 요구사항의 강도가 달라진다. ‘저장한다’와 ‘보관한다’도 문맥에 따라 다르게 읽힐 수 있다. 그런데 PRD에서는 문장이 자연스러운지와 함께, 원래 의도가 그대로 전달되는지가 중요하다.
그래서 이 Agent를 평가한다면 PM이 어색한 표현을 얼마나 고치는지, 요구사항의 의미가 유지되는지, 문서를 완성하는 데 얼마나 걸리는지를 보고 싶다. 오픈소스로 풀려있는 humanizer스킬들을 보면 AI 말투 몇가지를 룰베이스로 정해두고, 그런 말투를 출력하지 않도록 프롬프트로 막는것을 보았을때, 일반적으로 “AI말투”라는걸 정의할 수 있어보이긴 하지만, 사용해본결과 완벽하진 않다..!
비결정론적인 워터마크라는개념을 처음알게되었는데, 신기하다..! 이젠 AI가 쓴글을 규칙기반으로 찾던 GPT-killer같은 앱이 필요없어질지도 모르겠다.
참고 자료
- Dathathri et al. — SynthID-Text, Nature, 2024
- Li et al. — textGrain 기술보고서, 2026
- Kirchenbauer et al. — A Watermark for Large Language Models, 2023
- Anthropic — How Claude’s text watermark works, 2026.08.14
- Claude 모델별 워터마크 적용 범위
- OpenAI — Our approach to EU text provenance rules, 2026.10.05
- 임커밋 — 텍스트 워터마크..? 어떻게?, 2026.09.10
본문의 데이터 흐름 애니메이션 2개는 3Blue1Brown의 오픈소스 Manim에서 출발한 Manim Community로 만듬
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...