시골쥐의 서울 상경기: W&B Meetup과 Claude Session
비전공자에 지방러라 신청도 못 하던 밋업을 인턴으로 상경해 다녀왔다. 강남 위워크의 W&B Meetup(4/10)과 센터필드의 Claude Session(6/16)에서 코드보다 문제 정의와 판단 기준이 중요해지는 걸 봤다.
내가 이런 세션에 참여한다고?
지방에 살면서는 이런 밋업에 갈 기회가 있으면 꼭 가보고 싶었다. 근데, 비전공자에다가, 지방에 살고있었기 때문에, 신청을 해도 참여할 수 없었다..(소속 회사나 연구실을 필수로 작성해야한다)
인턴을 하러 서울로 상경하게 되면서 그 기회가 생겼다. 신청서에 소속 회사란을 적을때, 그동안은 등줄기에 땀이 흘렀는데, 이번에는 배에 힘을 주고 “뤼튼 테크놀로지스”라고 적었다.
이곳은 서울 강남. 그렇게 다녀온 두 행사를 한 번에 정리해 보려 한다.
- 2026년 4월 10일, 강남 위워크: Weights & Biases 밋업
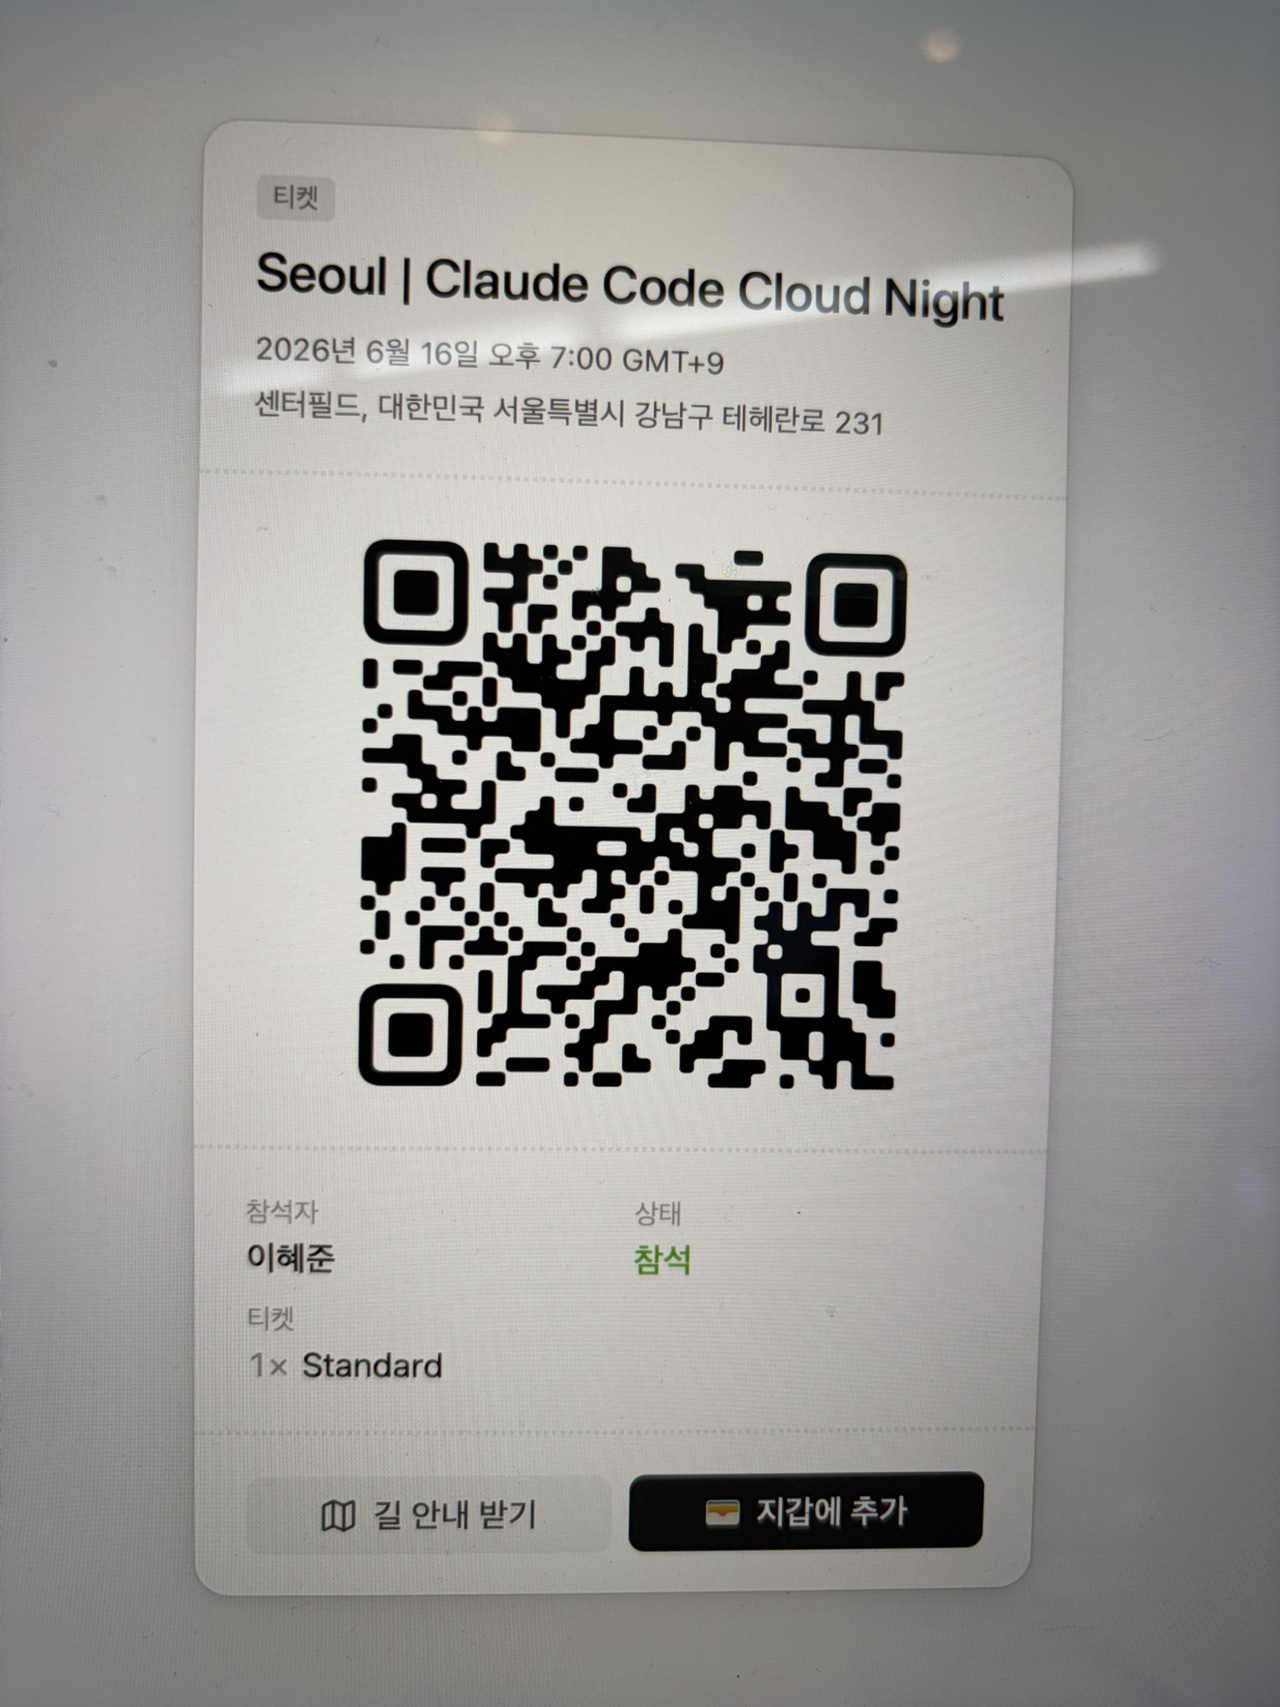
- 2026년 6월 16일, AWS 강남 센터필드(서울 강남구 테헤란로 231): Seoul · Claude Code Cloud Night
결론부터 정리하자면, 최근 트렌드는 코드를 잘 짜는 능력보다, 무엇을 문제로 정의하고 무엇을 기준으로 판단할지가 중요해지고 있다는 것이 중요한것 같다.
1. W&B 세션: 강남 위워크에서
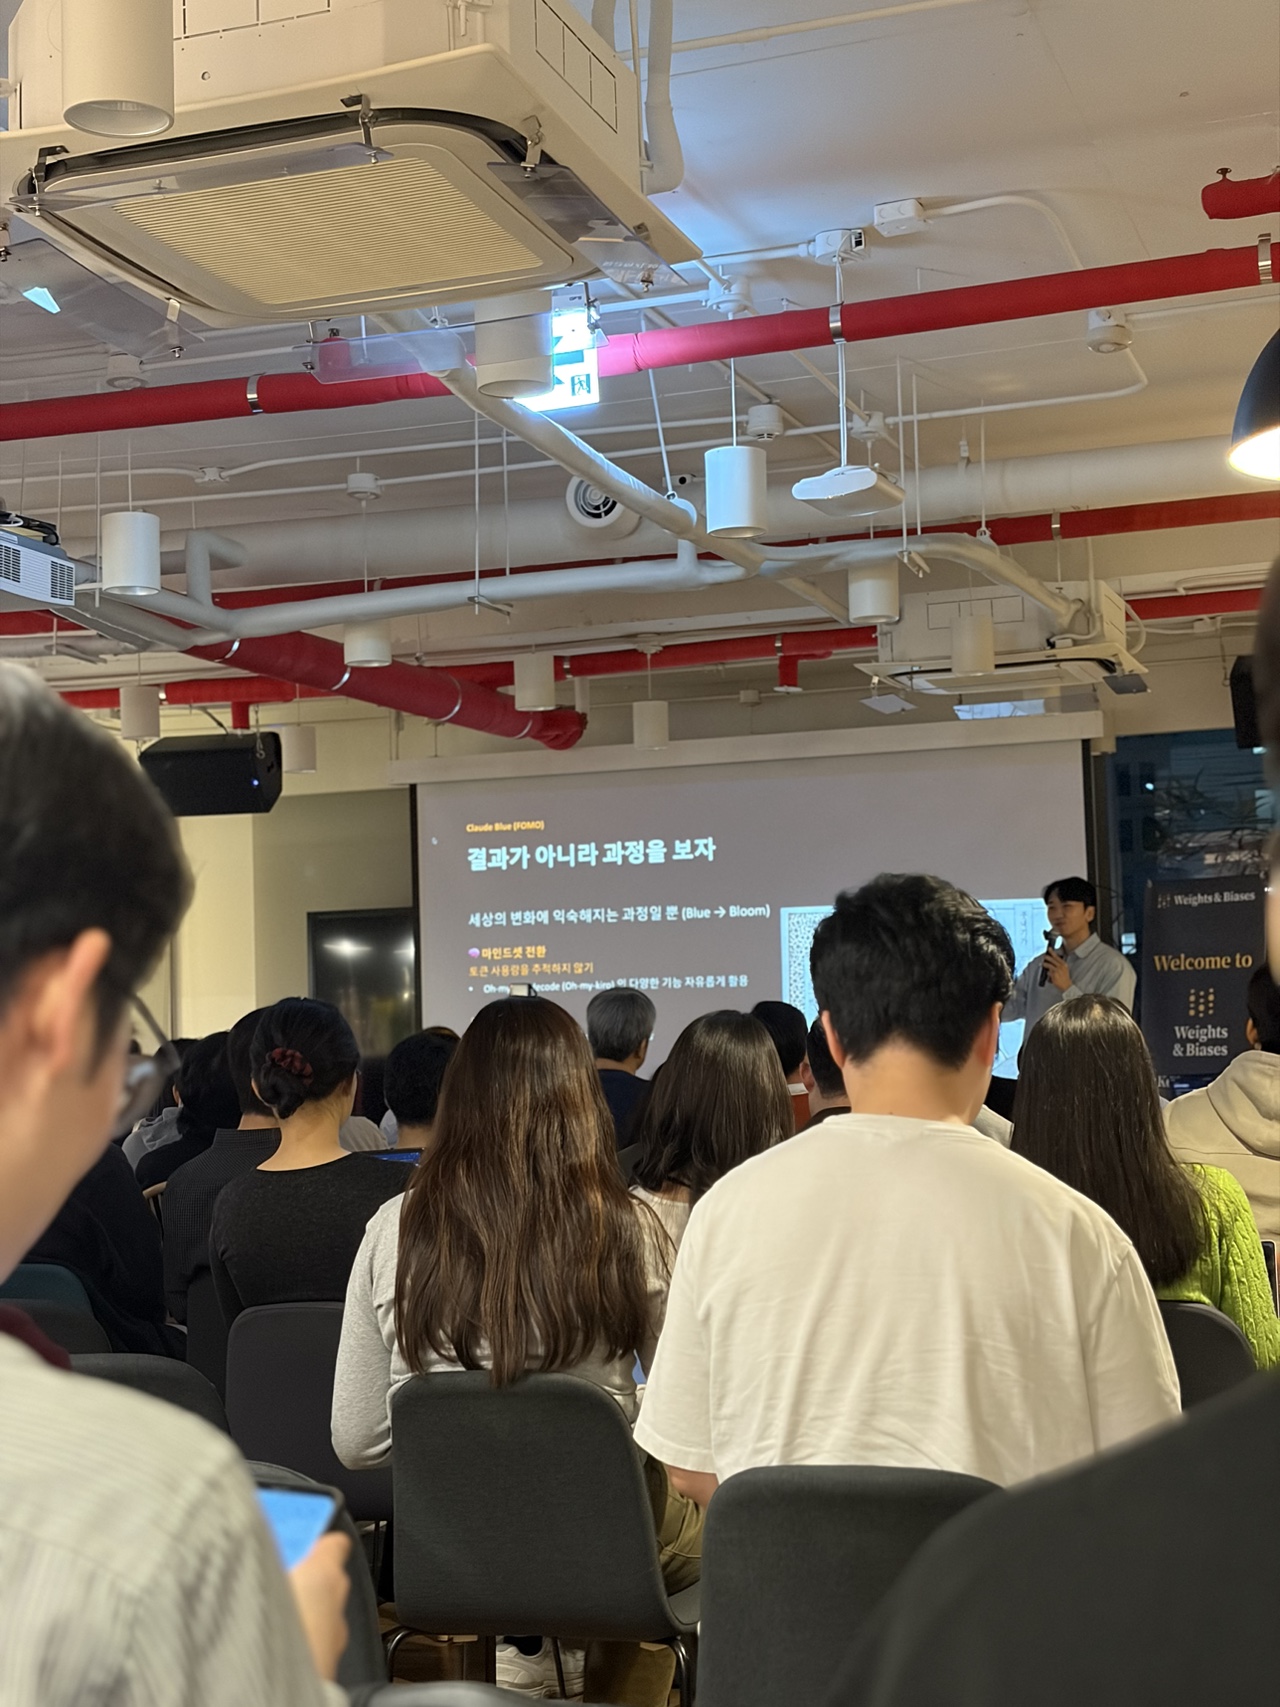
현장에 도착하니 입구부터 W&B 배너가 서 있었고, 체크인하면서 받은 스티커를 손에 들고 자리를 잡았다.
import wandb로 유명한 회사
모델을 학습하거나 실험할 때 import wandb로 쓰는 그 W&B가 맞다. 자료를 찾아보니 지금은 제품이 네 가지로 나뉘어 있다고 한다.
- Models: 실험 추적과 모델 관리, 뒷단 자동화.
- Inference: 만들어진 모델을 추론·서빙으로 상품화.
- Train: 서빙에서 수집한 결과로 파인튜닝과 포스트트레이닝을 돕는 제품.
- Weave: 생성형 AI 애플리케이션과 에이전트의 트레이스, 평가, 모니터링.
W&B는 Finetuning할때 자주 사용하던 툴이다! 네이버 부스트캠프에서 파인튜닝을 하던 시절, 팀원들과 워크스페이스에서 epoch에 따른 loss와 loss function, lr scheduler, learning rate 같은 실험결과를 공유하는 로깅 플랫폼, 그리고 베이지안 Hyper Parameter Optimization Sweep기능을 자주 썼다. 그때는 실험 기록용 툴 정도로만 생각했는데, 이렇게 제품군이 넖은줄 몰랐다.
여기서 호랑이 리더보드도 처음 알게 됐는데(반짝이는 스티커도 받았다!), 한국어 기준으로 모델 성능을 비교하는 리더보드였다. 나중에 실무에서 한국 도메인에 특화된 맥락, 예를 들어 5·18이나 4·19 혁명, 전두환·노무현 같은 정치적 맥락이나 성적 맥락을 필터링할 모델을 고를 때 이 리더보드를 참고했다.
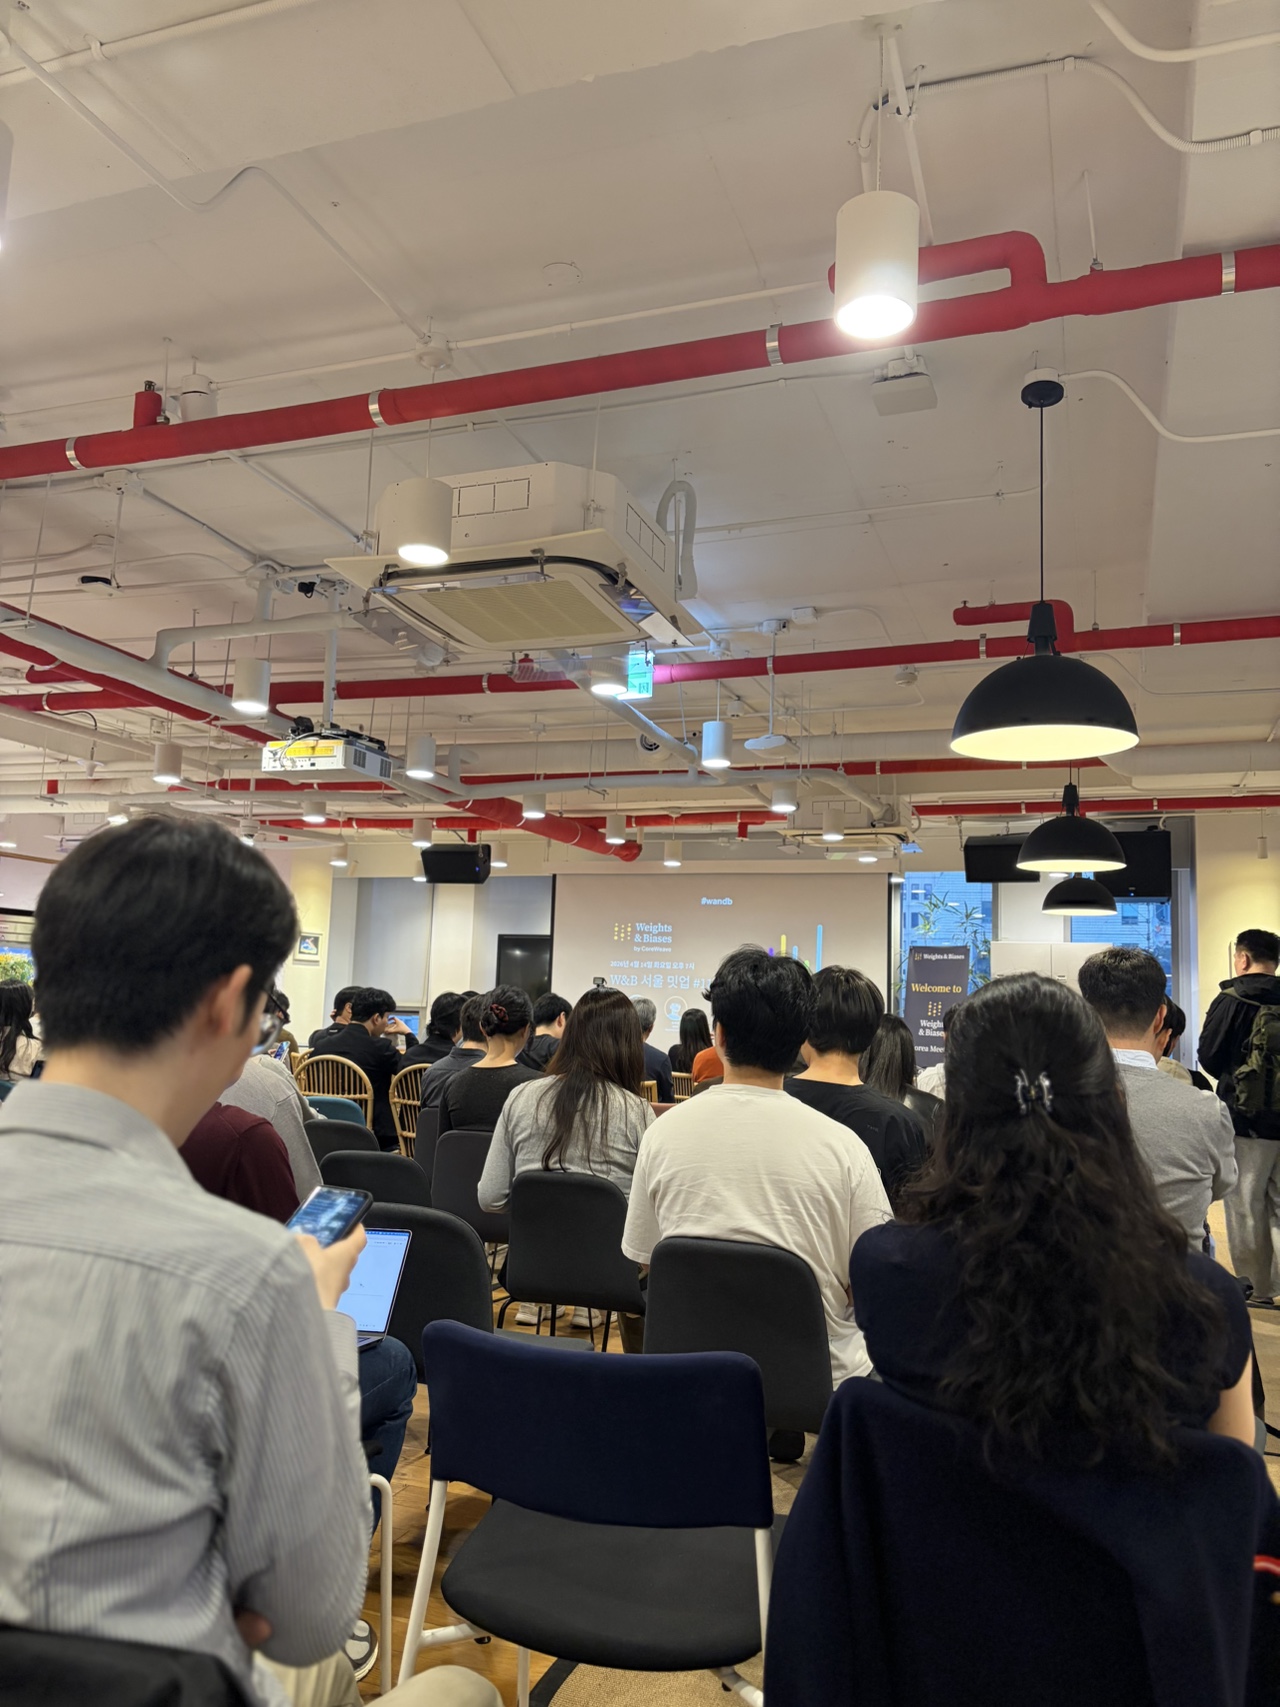
첫 발표는 코히어(Attention Is All you Need 1저자가 세운 회사로 유명하다!)의 머신러닝 엔지니어 김준희님이 맡았다.
코히어 김준희님: 측정에서 정의, 그리고 판단으로
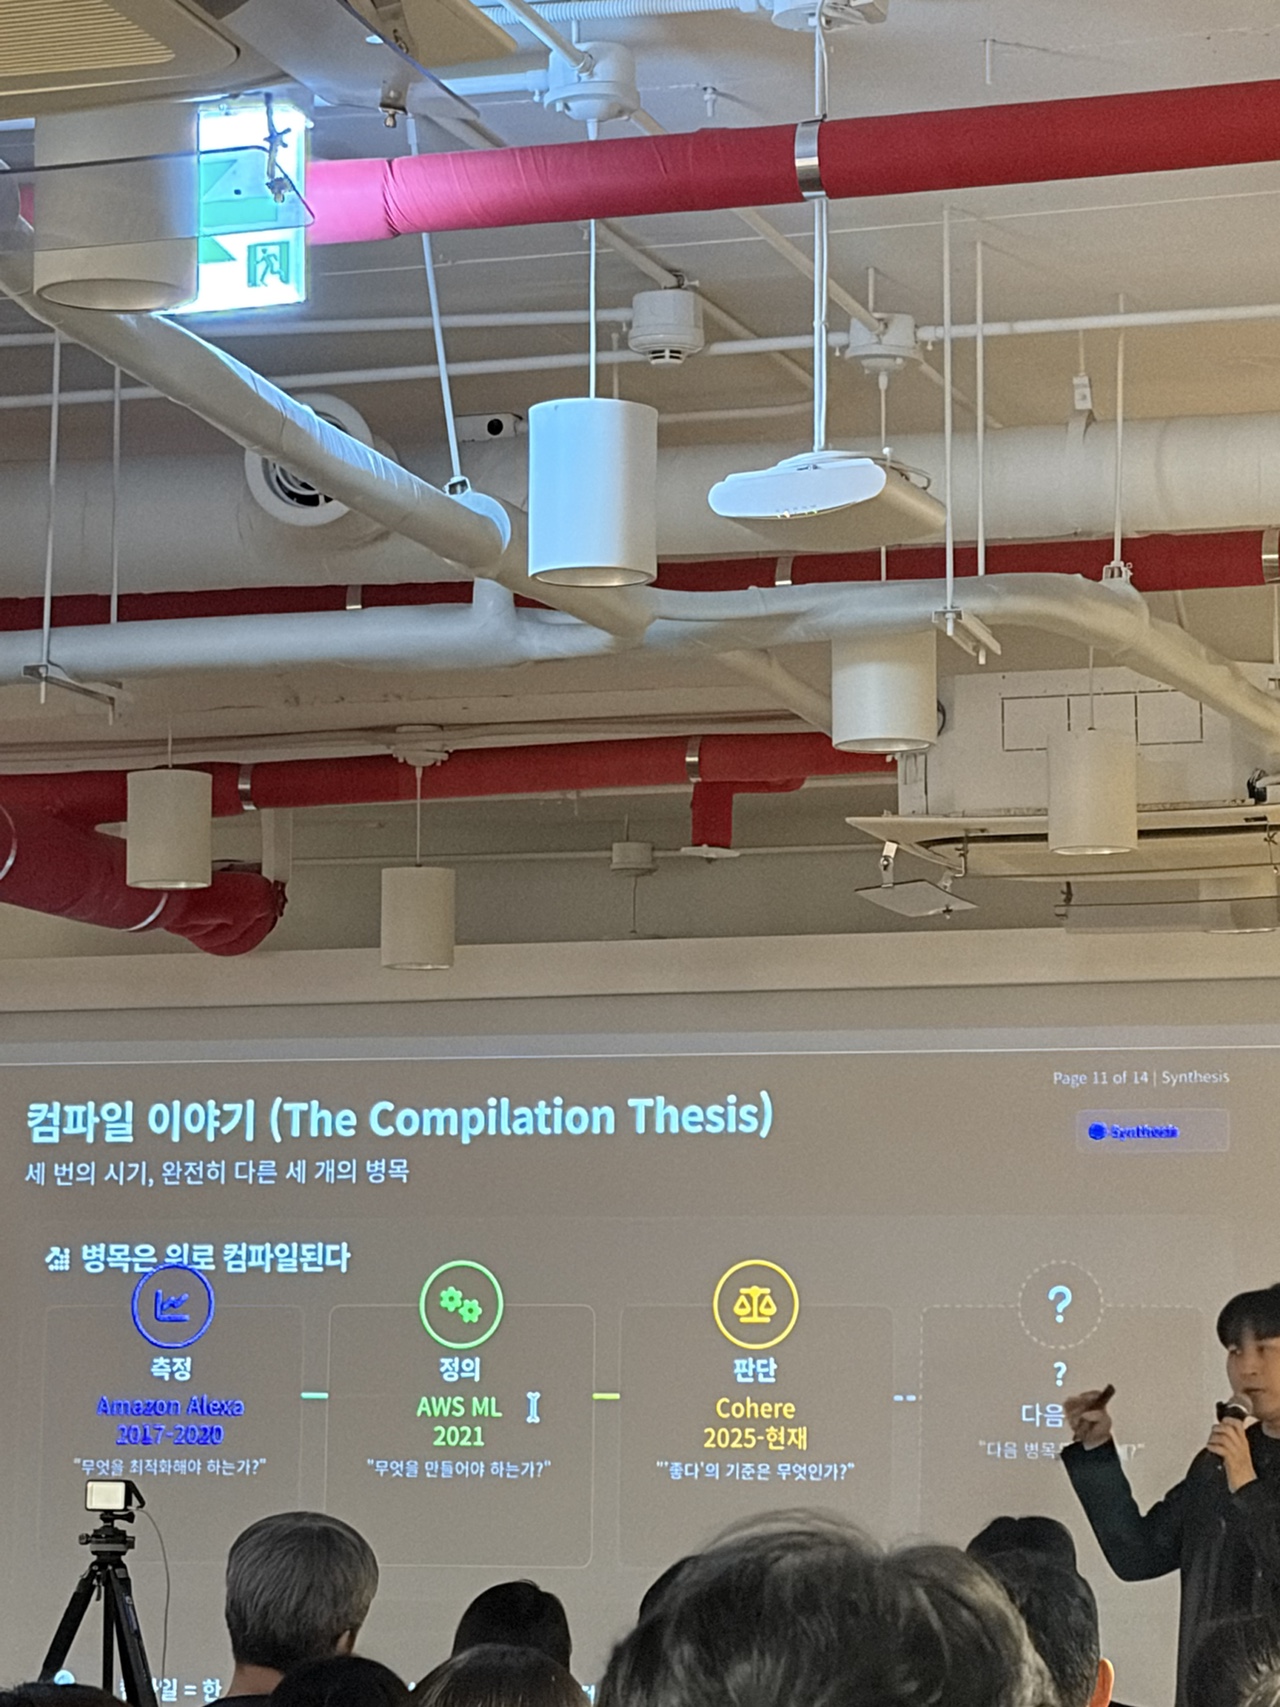
발표 주제는 “몇 년 동안 아주 열심히 해온 일인데, 그 문제 자체가 사라지는 패턴”이었다. 2017년 알렉사(Amazon Alexa)에서 시작해 2021년 AWS ML을 거쳐 2025년부터 코히어에서 일해 온 준희님은, 회사를 옮길 때마다 하는 일은 완전히 달라졌지만 병목의 위치만 계속 이동했다고 말했다. 그는 이를 The Compilation Thesis라고 불렀다.
- 측정 (Amazon Alexa, 2017–2020): 무엇을 최적화해야 하는가?
- 정의 (AWS ML, 2021): 무엇을 만들어야 하는가?
- 판단 (Cohere, 2025–현재): ‘좋다’의 기준은 무엇인가?
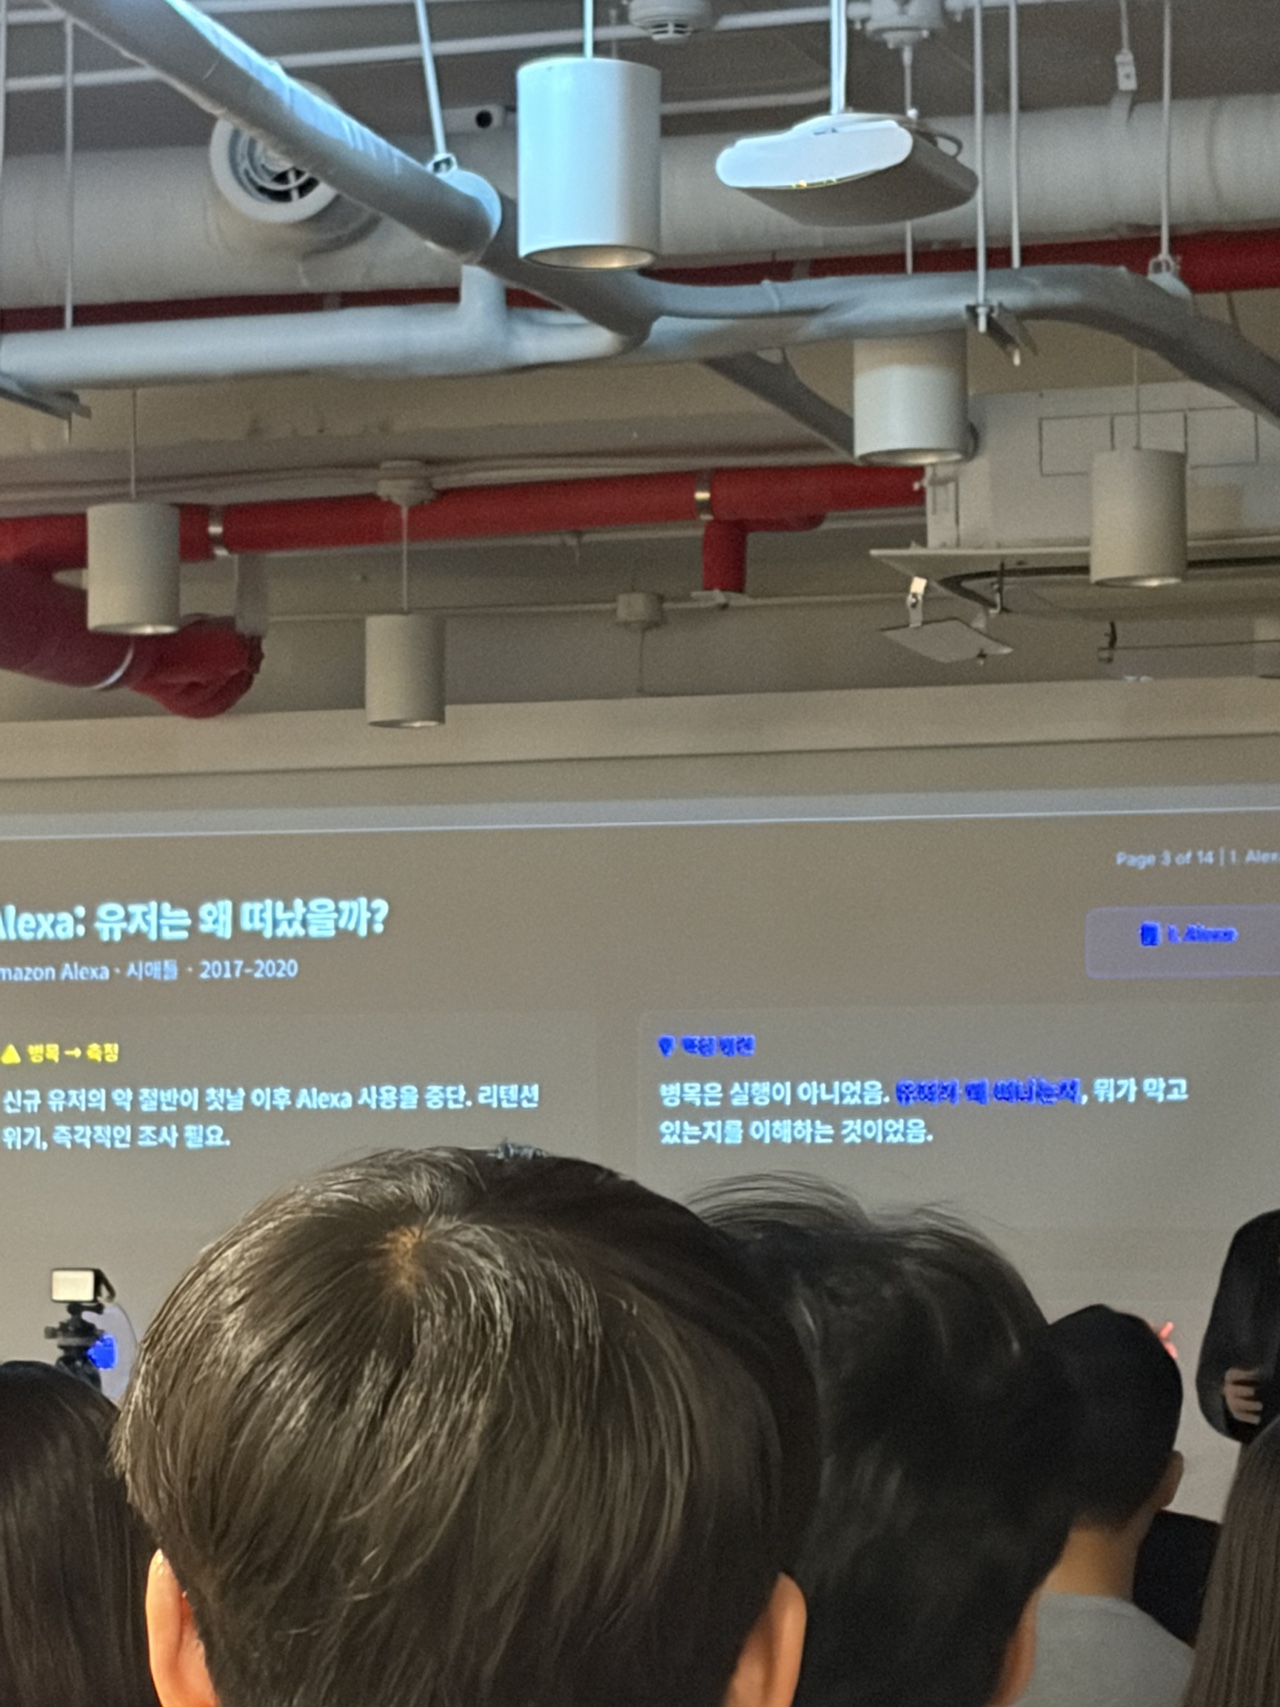
Alexa 시절의 출발점은 모델링이 아니었다. 신규 유저의 약 절반이 첫날 이후 사용을 멈췄고, 데이터를 뜯어보니 이탈은 대부분 음악을 틀어주는 순간에 일어났다. 유저의 상당수가 프라임이나 스포티파이 계정이 없었던 게 원인이었고, 그래서 첫 구매 고객에게 음악을 무료로 들려주자는 제안을 리더십에 올렸다. 머신러닝 엔지니어의 일이 모델을 만드는 것만이 아니라 “문제 진단과 실행”에 가깝다는 걸 이때 배웠다고 한다.
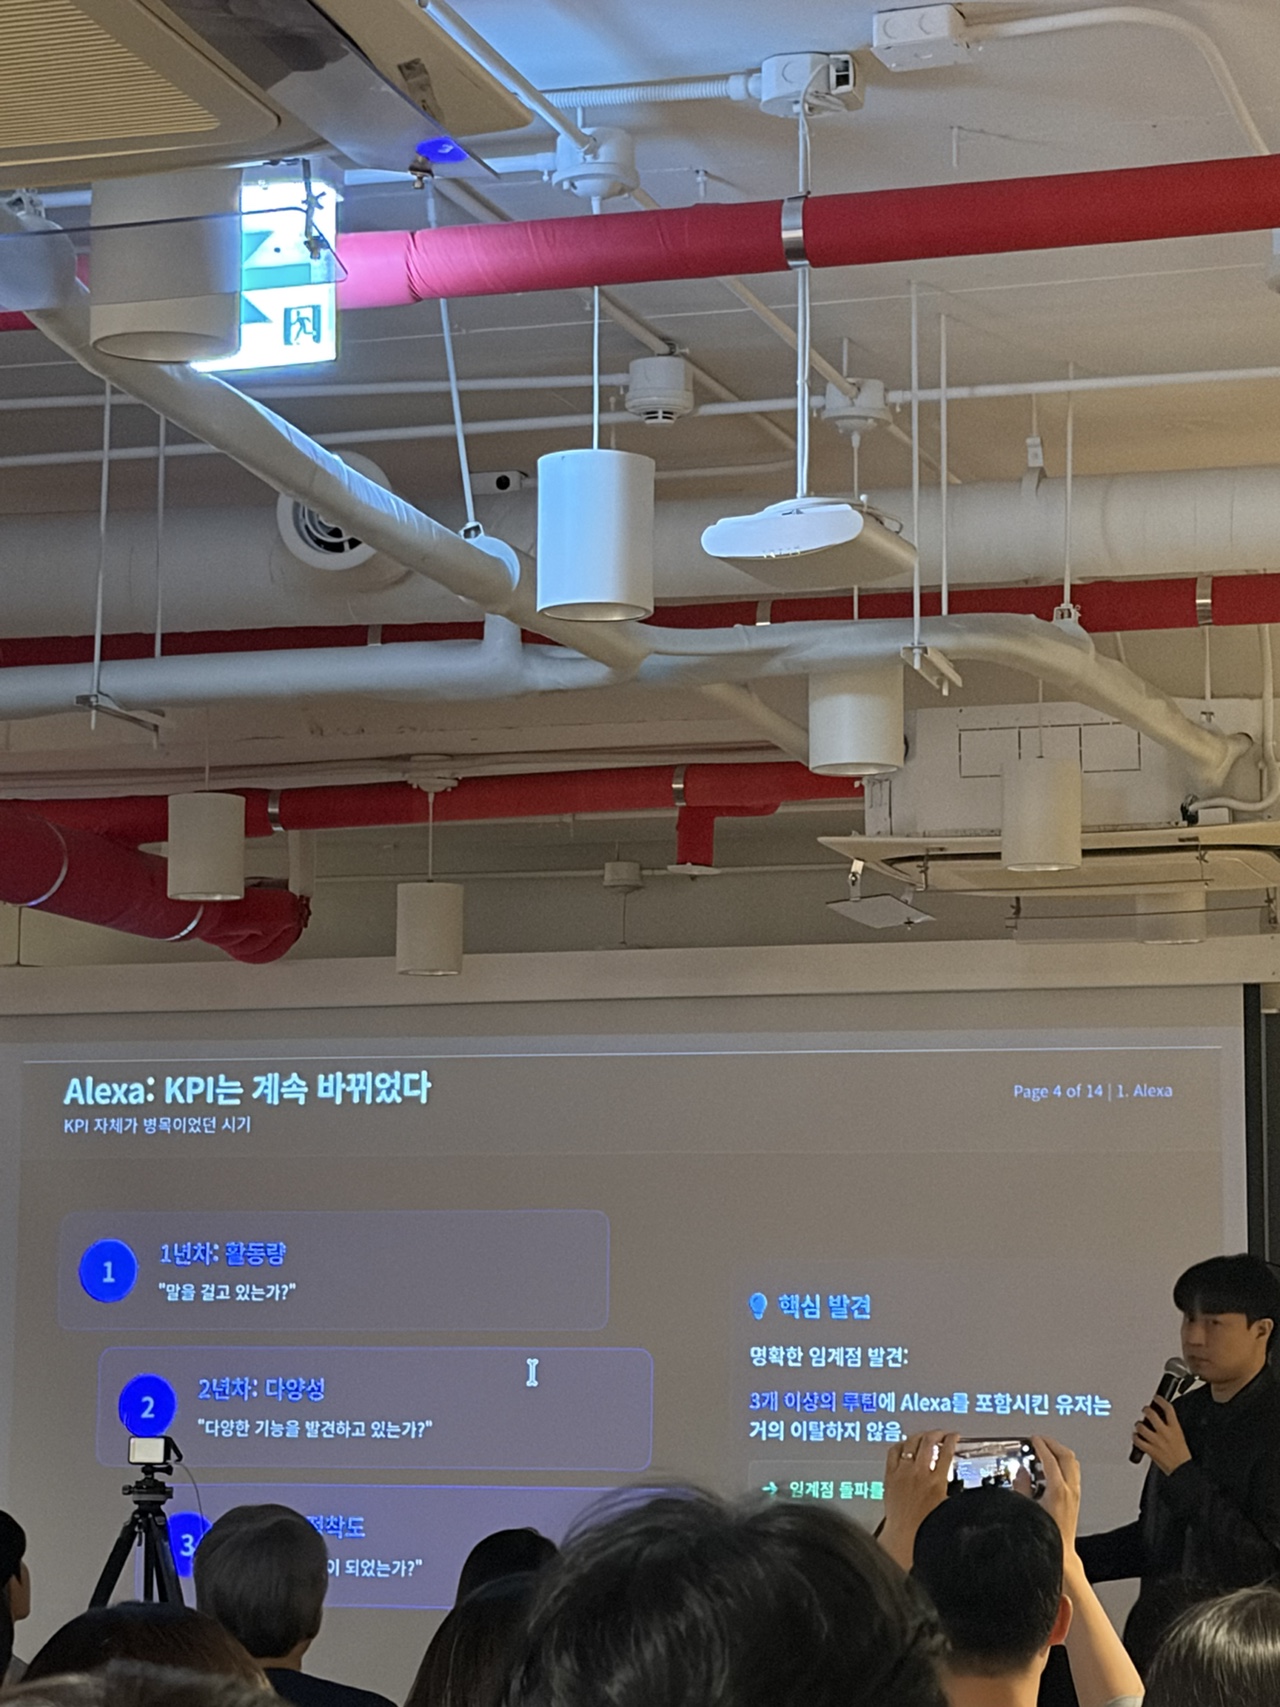
KPI도 계속 바뀌었다. 1년 차엔 활동량(“많이 말을 걸고 있는가?”), 2년 차엔 다양성(“다양한 기능을 발견하고 있는가?”), 3년 차엔 습관과 정착도(“의존하게 되었는가?”). 데이터를 보니 루틴이 3개 이상인 유저는 거의 이탈하지 않았고, 그래서 다음 목표는 “네 번째 습관”을 찾아 주는 것이 됐다.
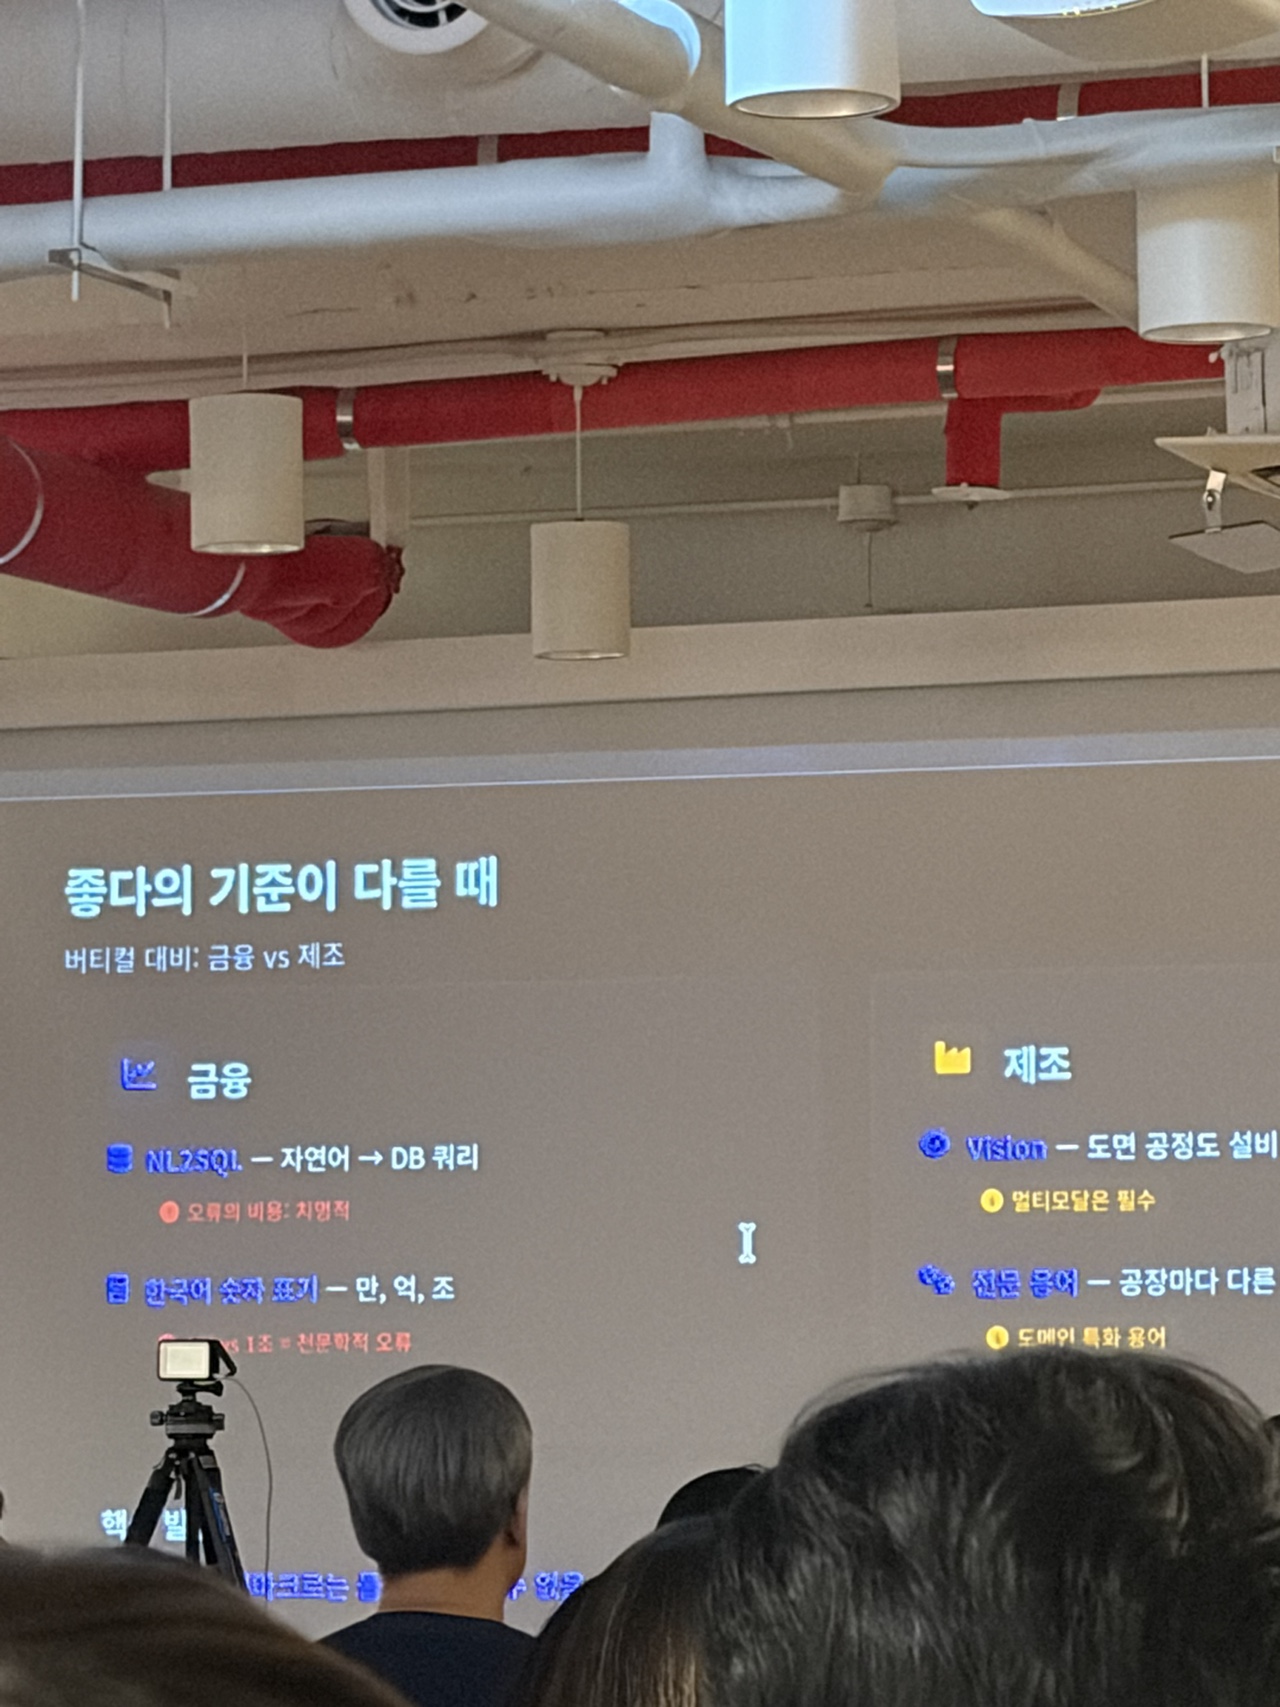
코히어에서 마주한 병목은 “판단”이었다. B2B로 특정 버티컬을 위해 문제를 푸는데, 같은 “좋다”라도 버티컬마다 기준이 완전히 다르다. 금융에서는 자연어를 DB 쿼리로 바꾸는 NL2SQL이 중요하고, 만·억·조 같은 한국어 숫자 표기가 틀리면 그 순간 결과는 0점에 가까워진다. 제조에서는 도면과 공정 이미지를 다루는 Vision, 그리고 공장마다 다른 전문 용어가 핵심이 된다.
그래서 그가 강조한 건 평가(evaluation)였다. 평가는 계기판이자 나침반이라서, 무엇을 평가할지 정하지 못하면 모델이 어디로 가야 하는지도 알 수 없다. 한국 금융이나 특정 버티컬에는 마땅한 벤치마크가 없는 경우가 많아서, 평가 세트와 평가지표를 직접 만들어야 하는 일이 많다고 했다. 이 과정에서 방향성을 시각화하고 여러 모델을 비교하는 데 W&B를 자주 쓴다고도 했다.
“올해 들어서는 코딩을 거의 안 했다”는 말도 했다. 안드레이 카파시도 비슷한 이야기를 한다고 언급하면서, 코드를 직접 치는 일은 점점 줄고 문제를 정의하고 평가 기준을 세우는 일이 커지고 있다고 했다. 다음 병목은 아직 아무도 모르는, 다 같이 찾아가야 하는 것이라고 덧붙였다.
2. AWS 세션: Seoul | Claude Code Cloud Night
두 번째로 다녀온 건 6월 16일, 센터필드에서 열린 Claude Code Cloud Night였다. AWS는 처음가봤고, 클로드 공식행사도 처음가봐서 설랬다..!
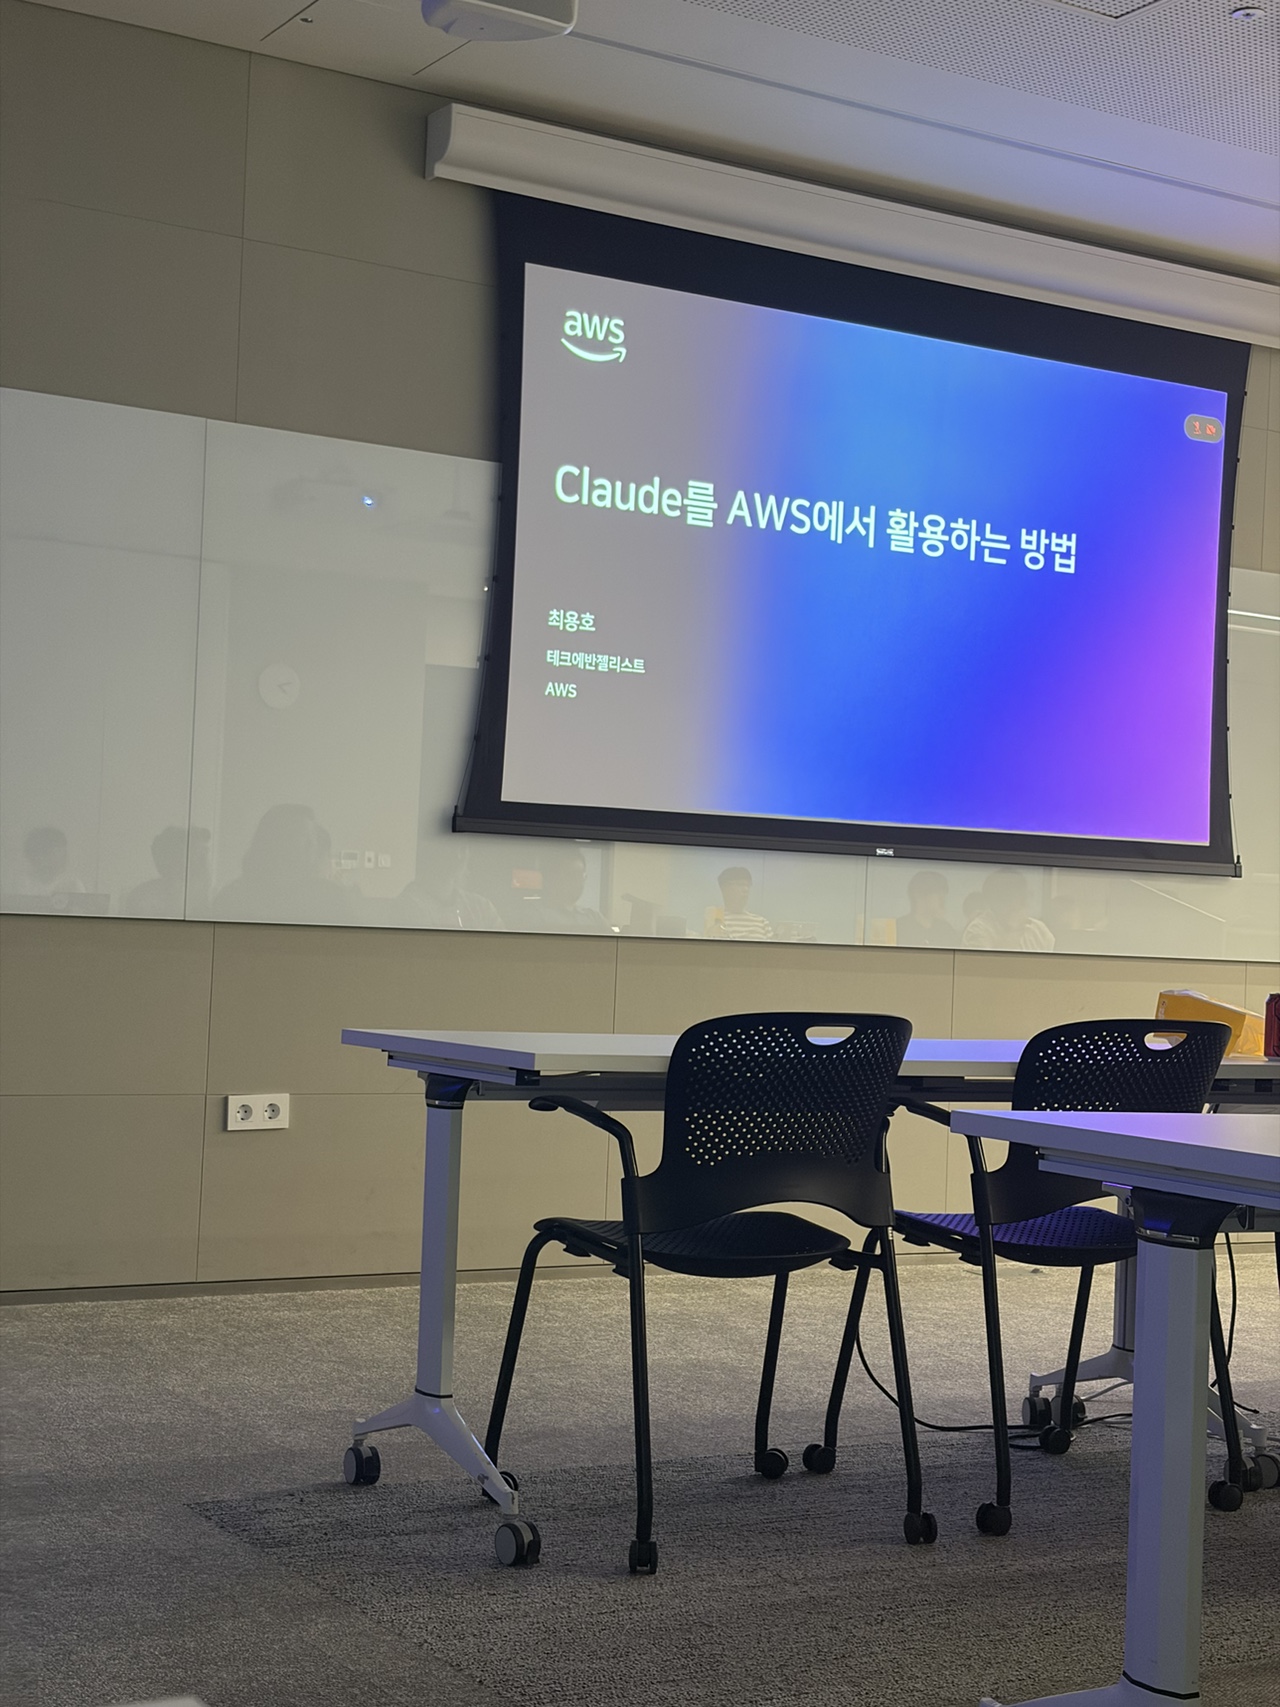
Claude를 AWS에서 사용하는 방법 (최용호님, AWS)
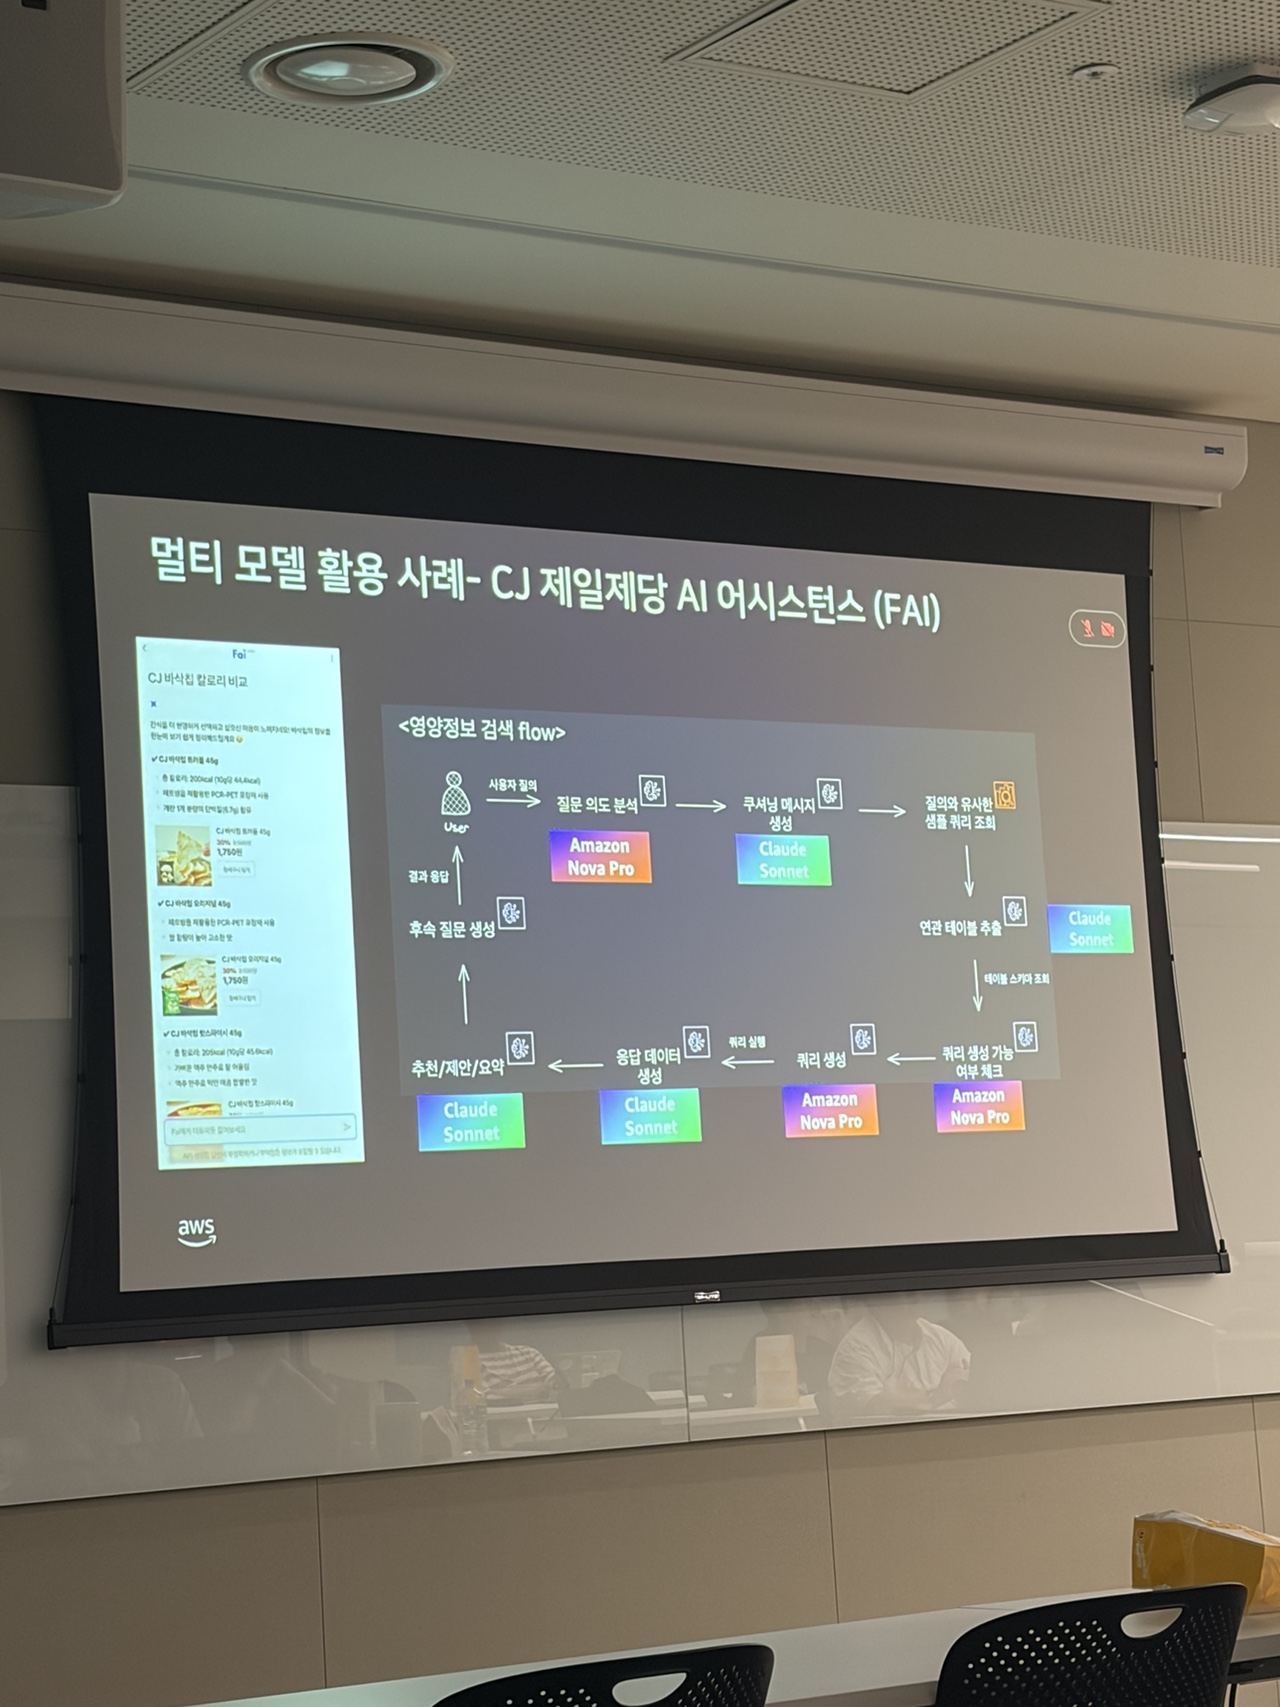
첫 발표는 최용호님의 “Claude를 AWS에서 사용하는 방법”이었다. 핵심은 생성형 AI 애플리케이션을 만들 때 모델만 고르는 게 아니라, 그 뒤의 인프라와 보안까지 함께 설계해야 한다는 것이었다.
- Amazon Bedrock: 엔터프라이즈 환경에서 AI 서비스를 쓰기 위한 관리형 기반.
- Private 통신 구조: 데이터가 오가는 경로까지 프라이빗하게 연결.(B2B로 어플리케이션 납품도 한다!)
- 생성형 AI 애플리케이션 설계: 아키텍처 설계, 네트워크 설계, 데이터 저장을 함께 고려.
- 코드 개발 시 보안: “우리 코드를 안전하게 전송하고 싶다면?” 같은 질문.
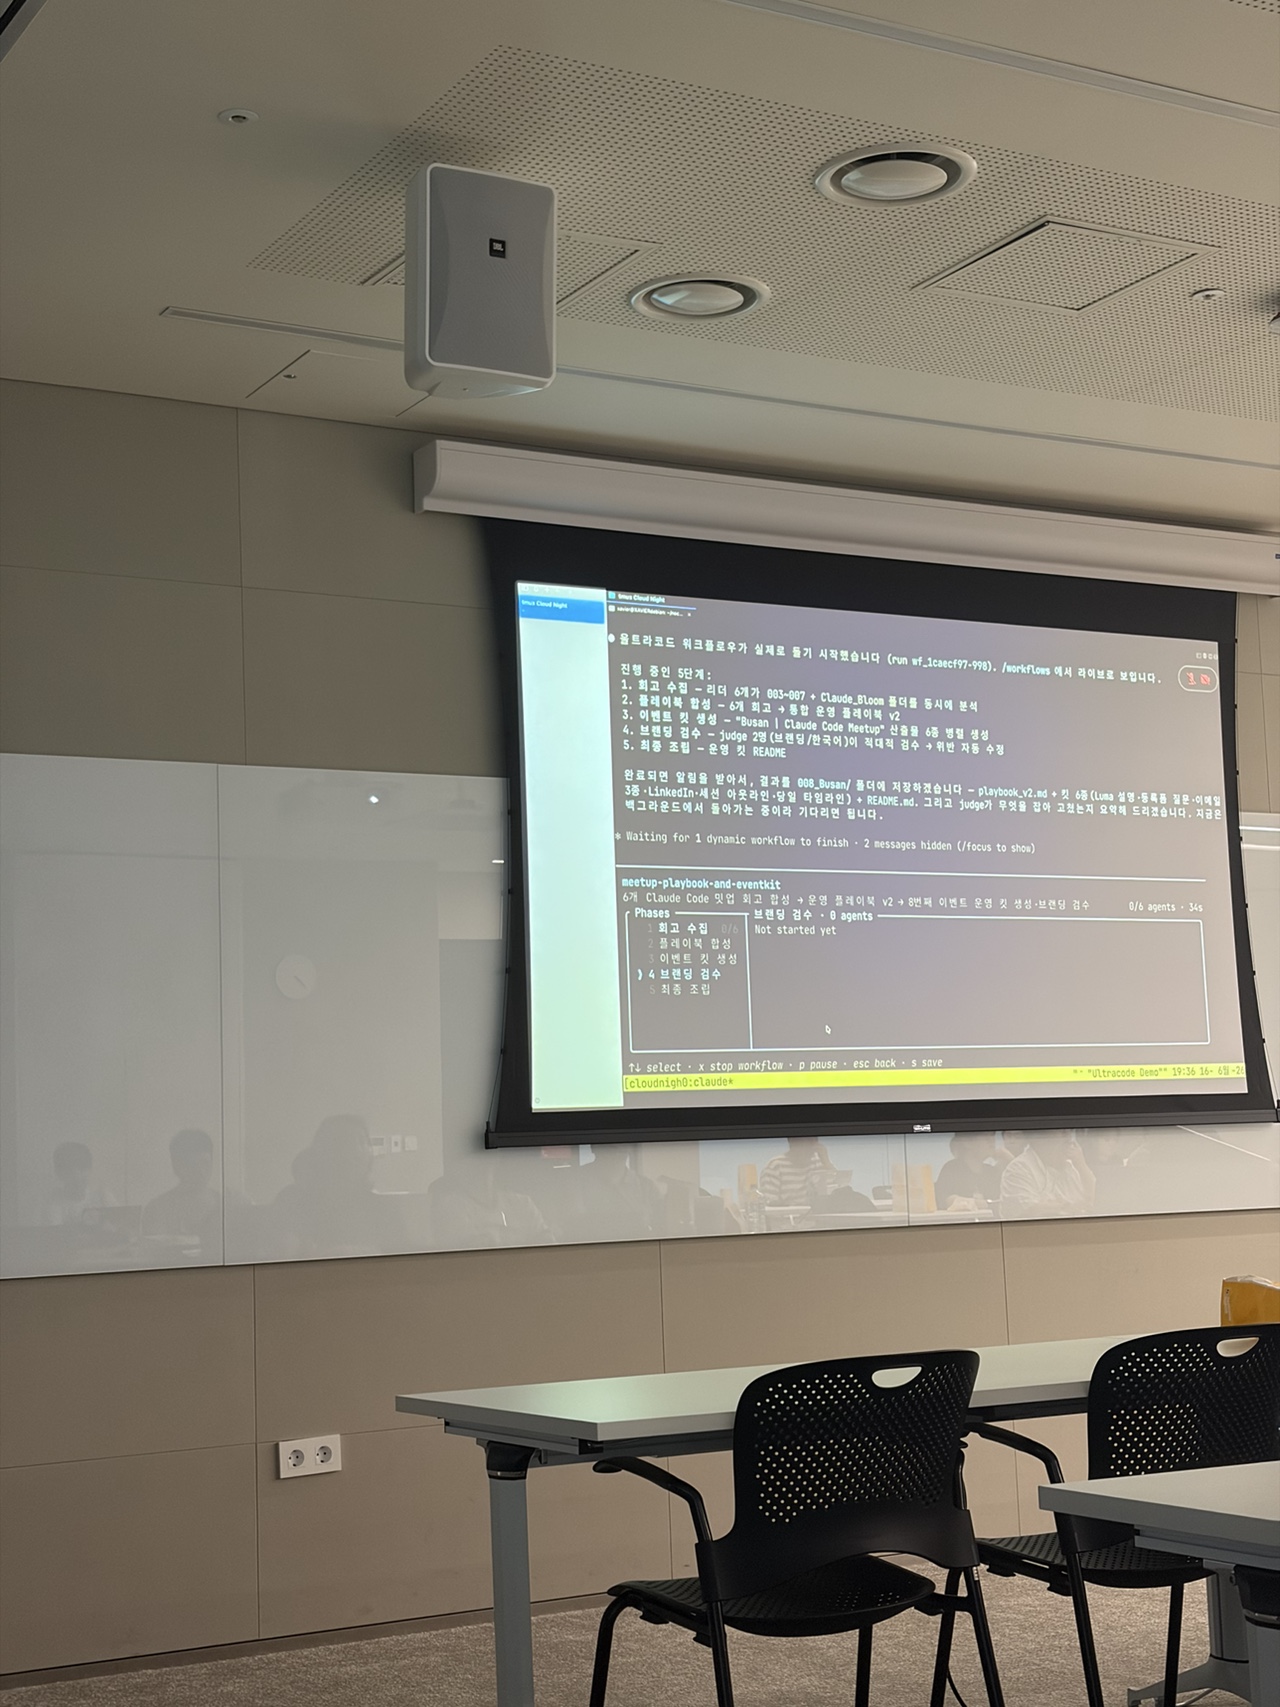
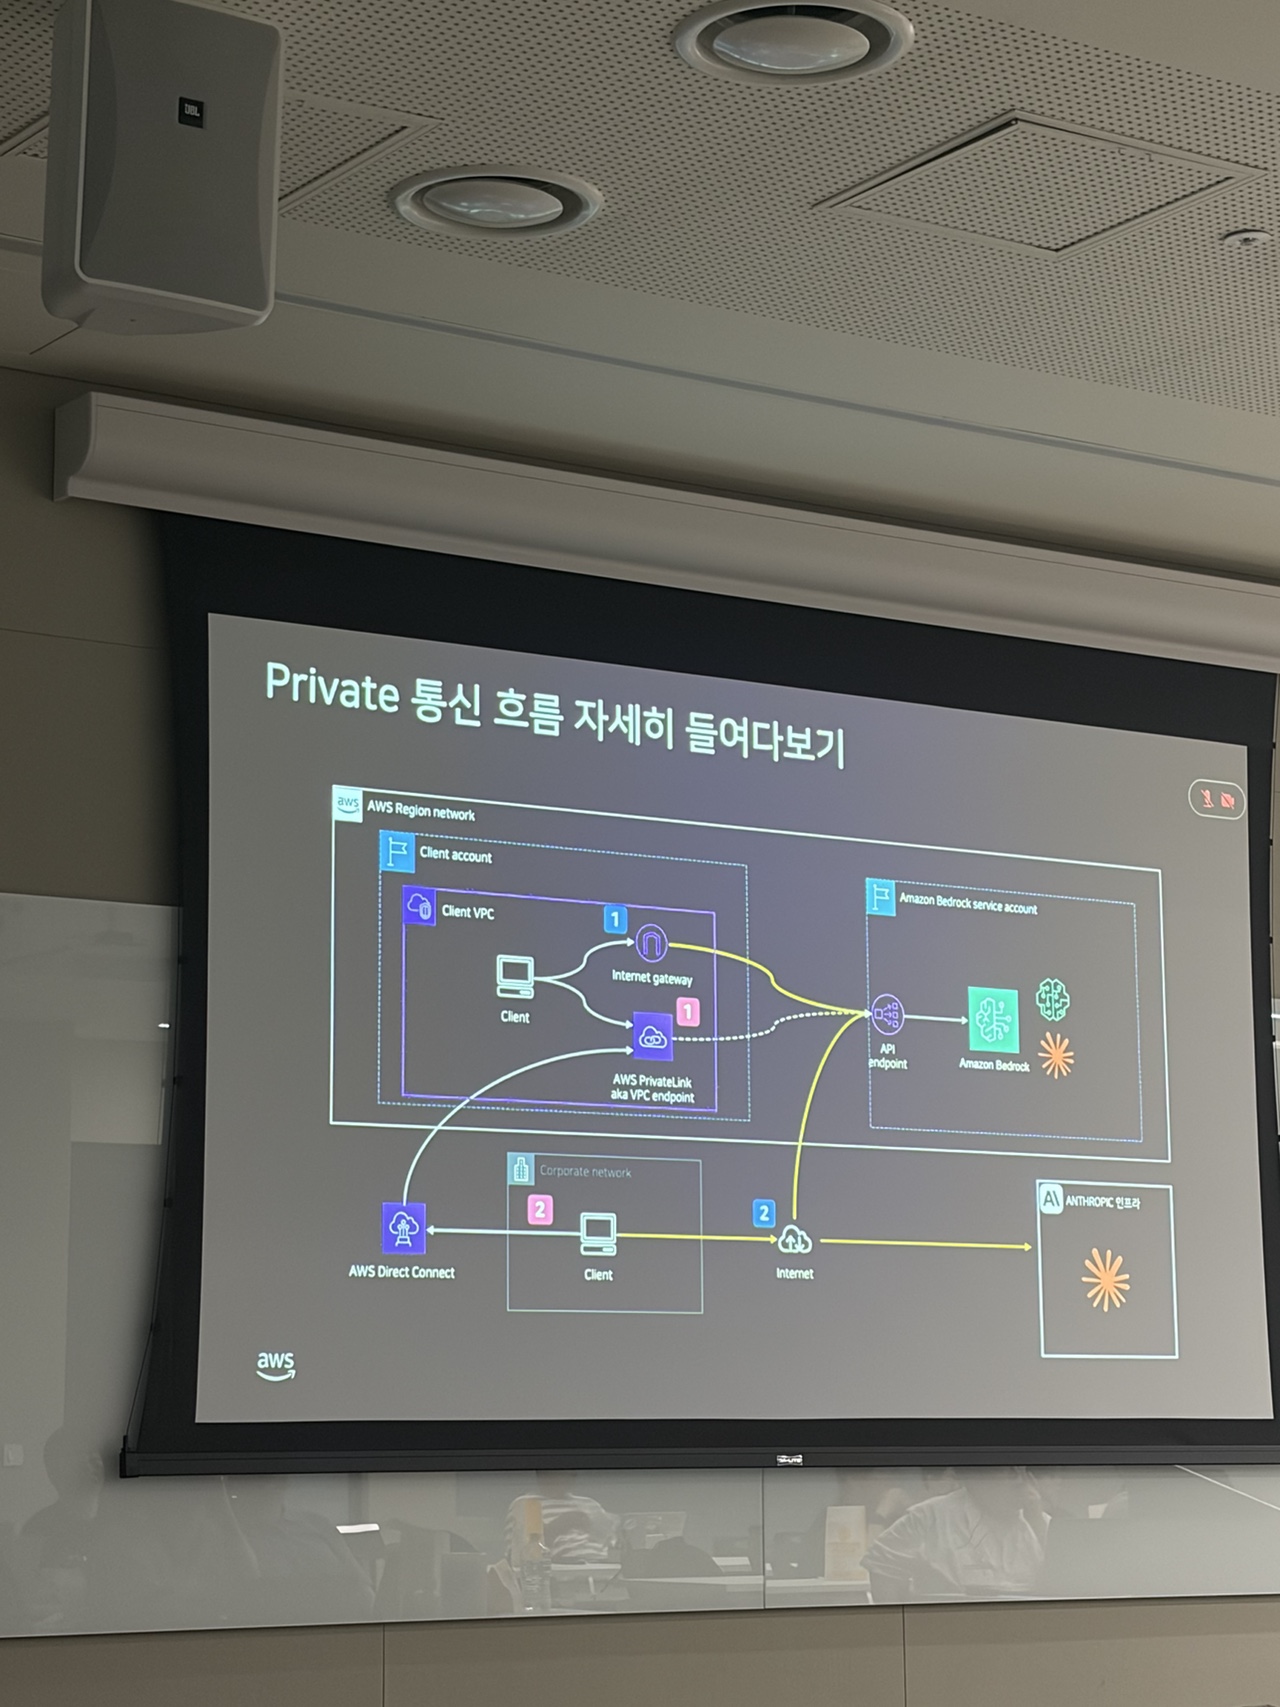
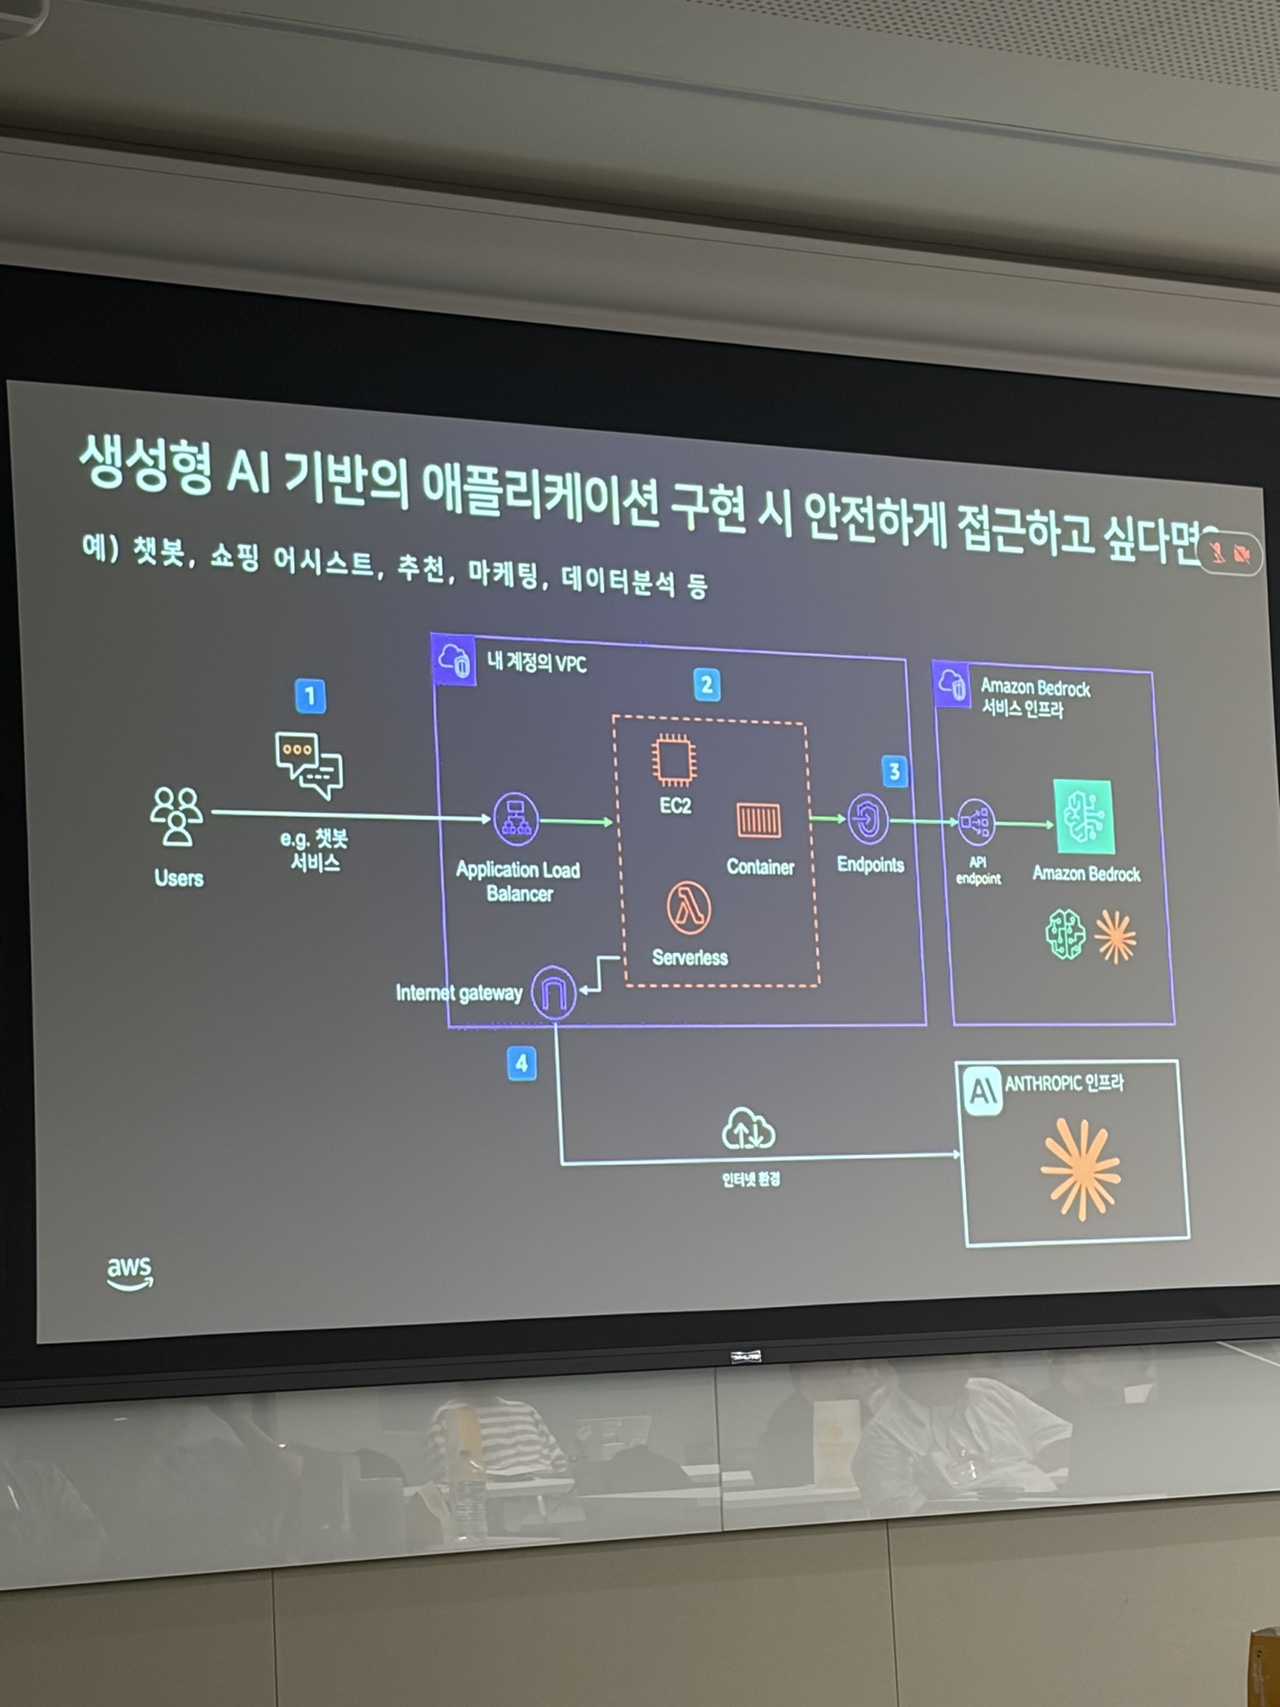
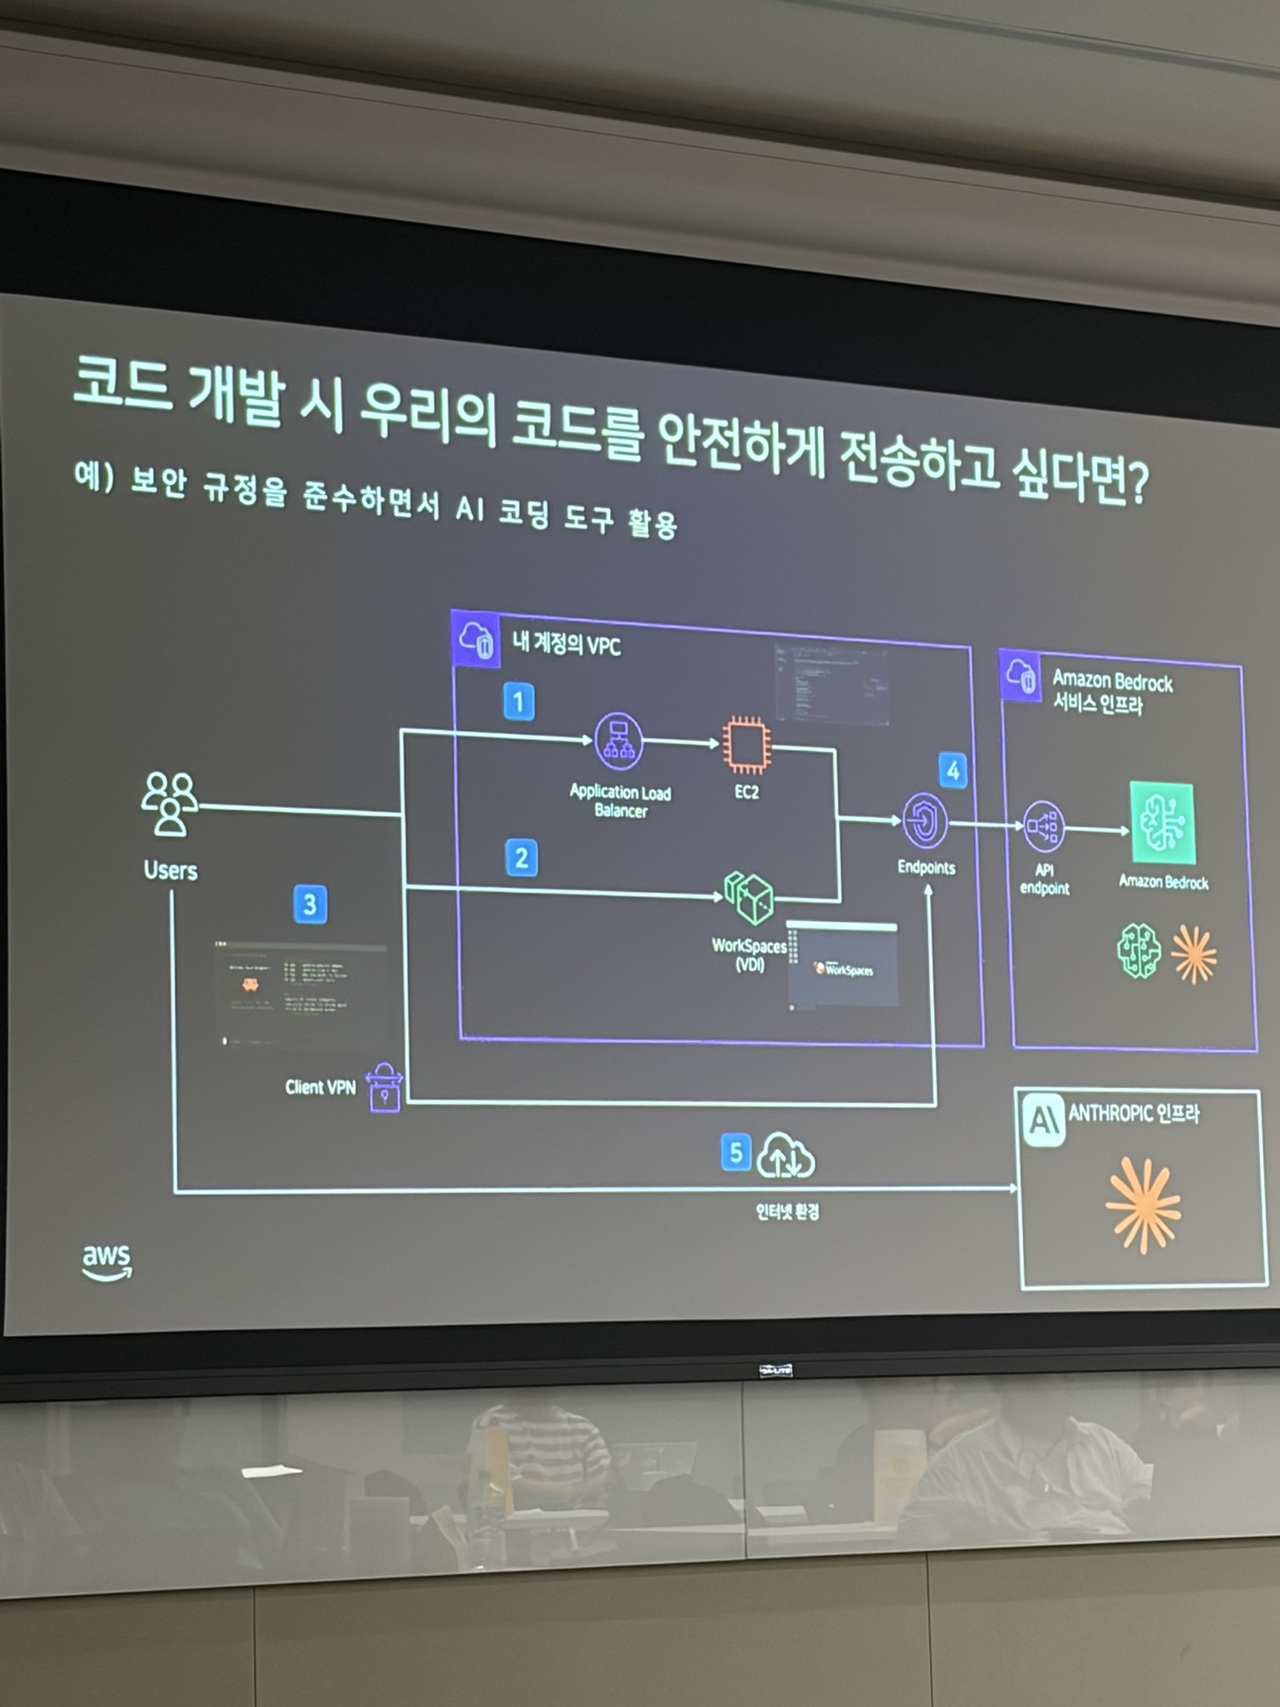
데모 화면에서는 Claude Code로 밋업 자료를 자동으로 만드는 워크플로우가 돌아가고 있었다.
AI 엔지니어로서, 만약 엔지니어로 남는다면
세 가지 목표를 꼽았는데, 유용함(누군가 필요로 하는 걸 해결하는 것), 시야(작은 시장의 1등에 매몰되지 않는 것), 그리고 스피드. 스피드는 사람마다 가속도의 한계가 있어서, 관성을 붙여 조금씩 올리는 게 중요하다고 했다.
가장 인상적이었던 건 모델을 만드는 일보다 그 앞뒤의 문제 정의와 하니스에 대한 이야기였다. 전 회사에서 RAG 시스템을 구축하는 팀이 컨텍스트를 유저 턴이 아니라 시스템 프롬프트에 넣고 있었는데, 그 방식은 멀티턴에서 컨텍스트가 바뀌면 앞선 턴의 근거가 사라져 버리는 문제가 있었다. 시스템 프롬프트를 두 번 넣는 식으로 우회했지만, 시스템·유저·어시스턴트 사이의 우선순위(instruction hierarchy)를 모델이 학습한 적 없는 조합이 돼 버렸다. API와 모델을 제대로 쓰려면 결국 학습 방식까지 알아야 한다는 결론이었다.
나는 아무래도 회사에서 광고배너 제작 AX를 하고있으니, 어떤 CLIP으로 이미지 Semantic Search를 할때 어떤 이미지를 선택해야 유저가 클릭할 확률이 가장 높을지를 고민했던적이 있었다. OpenAI에서 학습한 CLIP으로 이미지를 임베딩하고, 가장 크랙에서 소구점과 유사한 이미지(이 스토리를 좋아할만한 유저들이 클릭할만한 이미지)를 선택하는 Task를 풀고 있었는데 이떄 CLIP이 학습할때와 같은 언어형식 HyDE를 사용해서 성능을 높인 경험이 있었다.(영어, 단어위주, ‘The Character of{word set…}’) 형태의 HyDE를 적용했는데, 내가 풀었던 내용과 비슷한 말이어서 공감하면서 들었다.
데이터와 노하우 이야기도 흥미로웠다. 파운데이션 모델을 만드는 회사의 해자는 학습 노하우와 데이터인데, 둘 다 돈이 너무 많이 들어서 쉽게 복제되지 않는다. 데이터도 100개, 1000개까지는 쉽지만 100만 개, 1000만 개가 되면 의도와 다른 저품질 샘플이 섞여 들어간다.
그는 최근 스스로 세 가지 규칙을 세웠다고 했다. 토큰 사용량을 추적하지 않기, 권한 풀기(단, 고객사 환경에서는 하지 않기), 그리고 퇴근 전에 오늘 돌릴 작업을 정해 두고 자기 전에 돌리기. “내가 코드를 짜야 한다”는 자존심을 내려놓는 것도 그중 하나였다.
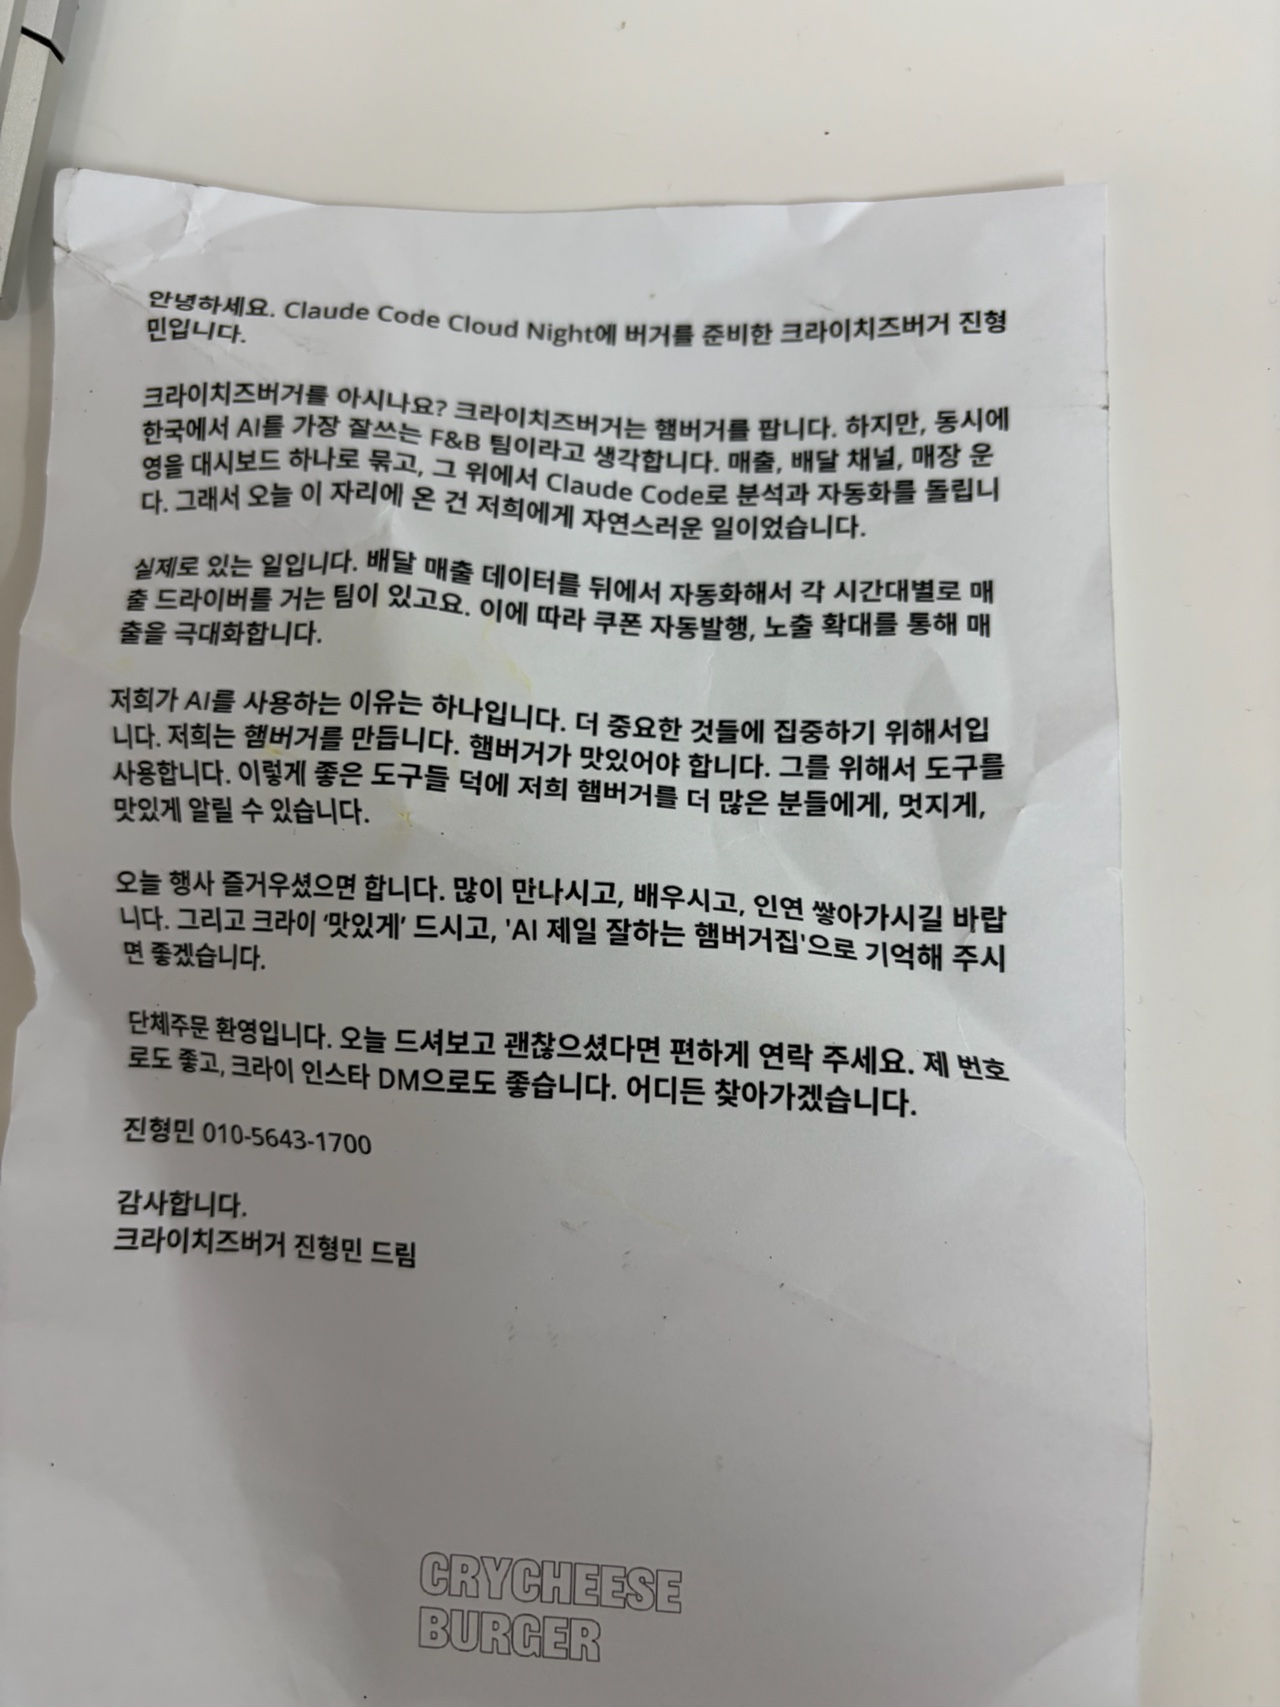
행사장에서는 크라이치즈버거 팀의 안내문도 받았다. F&B 매출 데이터를 Claude Code로 분석하고 자동화한다는 내용이 적혀 있었는데, 버거 브랜드가 이런 테크 밋업을 후원하고 직접 홍보한다는 걸 이번에 처음 알았다. 행사가 끝나고 나눠 준 버거도 맛있었다.
느낀 점: 두 세션을 통해 얻은것
서로 다른 행사였지만 두 세션은 같은 곳을 가리키고 있었다. 앞으로 AI 엔지니어에게 중요해지는 건 코드를 잘 짜는 능력이 아니었다.(심지어 빅테크의 엔지니어도!)
- 문제를 정의하는 능력. 모호한 비즈니스 문제를 “무엇을 풀어야 하는가”로 바꾸는 것.
- 메트릭을 정의하는 능력. 이 도메인에서 ‘좋다’의 기준이 무엇인지 세우는 것.
- 메트릭을 기반으로 문제를 해결해 나가는 능력. 세운 나침반을 보고 방향을 고쳐 가는 것.
코히어 발표자의 측정 → 정의 → 판단이라는 흐름과 “평가는 계기판이자 나침반”이라는 말이 정확히 그 이야기였다. AWS 세션의 “인프라와 보안까지 함께 설계해야 한다”는 이야기도, 결국 무엇을 문제로 정의하느냐의 문제로 이어졌다.
코드를 직접 치지 않아도 된다는 말이 안심이 됐다기보다는, 그만큼 내가 무엇을 문제로 세우고 무엇을 기준으로 판단할지 더 치열해져야 한다는 압박으로 다가왔다. 인턴으로서 지금 내가 하는 일도 결국 이 질문으로 수렴한다. 무엇을 만들지 정하고, 좋다의 기준을 세우고, 그 기준으로 다시 고쳐 나가는 것.
다음에는 내가 정의한 문제와 지표를 들고 다시 이 자리에 오고 싶다는 생각을 했다.
Continue exploring
더 읽어보기
CTR을 예측할 수 있을리가 없잖아 무리무리!(무리가아니었다!?): nemotron persona
어떤 광고 배너가 잘될지는 결국 집행 비용을 써봐야 알 수 있었다. 배너를 많이 만들 수 있어도, 그중 무엇을 내보낼지 고르는 데는 여전히 돈이 들었다. 집행 전에 후보를 걸러낼 수 있을지 확인하려고 NVIDIA Nemotron Persona-Korea 데이터셋으...
카피 A/B 테스트와 밈으로 광고 성과를 끌어올리기
광고 배너를 자동으로 만들 수 있게 된 뒤에는 어떤 카피를 얹을지가 다음 과제였다. 성과가 높은 카피, 재밌는 카피에는 정해진 Ground Truth가 없었다. 여러 톤앤매너와 밈 RAG로 후보를 만들고 실제 광고 성과를 비교했다.
성과가 난 광고에서 다음 스토리를 찾는 위닝앵글 검색
초기 AX 제작은 좋아요 랭킹 순으로 스토리를 넓게 탐색하는 방식이었다. 이후에는 이미 성과가 난 광고에서 다음 후보를 찾는 경로를 만들었다. 다른 팀원이 만든 에이전트의 광고 성과 분석과 인사이트를 받아, 비슷한 소구점이나 이미지를 가진 새로운 스토리를 발굴하는...